作者
novlan1
2026.06.10
可领取"格子点击没反应
2026-06-29
问题根因
TaskListModal._fillContent 里对 LoginTaskItem 这一项绑定了一个 capture 阶段 的 TOUCH_END 监听器,里面直接 stopPropagation:
inst.on(Node.EventType.TOUCH_END, (e: any) => {
    if (e) e.propagationStopped = true;
}, this, true);   // ← 第 4 个参数 true = capture 阶段
Cocos 的事件传递顺序是 capture(父→子)→ target → bubble(子→父)。当用户点 cell 时:
- 事件先沿 capture 阶段往下走,到外层
inst节点 → 这里立刻propagationStopped = true - 于是事件根本到不了内部 cell 节点,
LoginTaskItemCard._onCellTap永远不会触发。
而下面的普通任务卡片之所以正常,是因为它的"按钮点击监听"也在 capture 阶段绑定(同一时机),同时收到事件并做了业务处理。但签到 cell 的点击是绑在内部子节点上的 bubble 阶段回调,被外层 capture 提前吞掉了。
修复
外层 inst 不应该用 capture 阶段 stopPropagation,应该改成 bubble 阶段(默认)—— 让事件先正常派发到 cell 子节点触发回调,然后再冒泡到 inst 时再停掉,避免穿透到蒙层。这与 _buildPanel 中 panel 的处理方式(bubble 阶段 stopPropagation)一致:
看
_buildPanel的注释也明确说过: "仅在 bubble 阶段拦截:保证子节点(如 CloseButton)的 TOUCH_END 先响应,之后冒泡到 panel 时再 stop,避免穿透到蒙层。(旧实现 capture=true 会在按钮分发前先吞掉事件,导致关闭按钮失效)"
完全是同一个坑。
顺手把下面 TaskItem 列表项的 capture 阶段拦截也评估一下 —— 普通任务卡片的"去完成"按钮点击是 _bindTaskItemAction 里也用 capture 阶段绑的,所以事件能在外层 capture 之前/之后被拿到。但更精准地说,capture 阶段是从父到子按 addChild 顺序触发的,外层 inst 的 capture 监听会先于内部 button 节点触发,所以现在 TaskItem 也存在隐患(之前能工作可能因为 button 节点也早早地处理了)。但这不是当前用户问题的范围,先不动。
总结
修复了一行 capture 参数的问题:
TaskListModal.ts 中给 LoginTaskItem 实例绑定的 TOUCH_END 监听器:
  inst.on(Node.EventType.TOUCH_END, (e: any) => {
      if (e) e.propagationStopped = true;
- }, this, true);
+ }, this);
原理
事件沿 capture(父→子)→ target → bubble(子→父) 流动:
旧实现用 capture=true,导致事件在到达内部 cell 节点之前就被外层 propagationStopped 吃掉,LoginTaskItemCard._onCellTap 永远不会触发,所以"可领取"点击没反应。
改为默认的 bubble 阶段后,事件先正常到达 cell → 触发内部回调 → 调 _onLoginCellTap → claimable 时调 TaskService.claimTaskReward → 触发 getDynaTaskReward;之后才冒泡到外层 inst 被拦截,不会再穿透到 mask 蒙层导致弹窗被误关。
这与同文件中 _buildPanel 修过的同类坑一模一样(注释里也明确写了"capture=true 会在按钮分发前先吞掉事件")。
证书 profie 意思,为什么苹果的只要私钥证书和 profile 就可以
2026-06-27
一、Profile 翻译 + 含义
翻译
官方标准中文名称:描述文件 口语简写:配置文件 / 授权文件 读音:/ˈprəʊfaɪl/
核心含义(苹果 & 鸿蒙逻辑同源)
Profile 是一份系统认可的授权契约文件,由厂商后台(苹果开发者中心 / 华为AGC)生成,里面绑定三样东西:
- 你的开发者公钥证书(cer)
- 唯一应用包名(Bundle ID)
- 权限/设备白名单(调试包会绑定手机UDID)
设备安装App时,系统校验 Profile: 这个证书能不能给这个包签名、允许在哪台设备安装、能调用哪些系统权限。
二、苹果 iOS 签名体系(你说的只两样是简化说法,完整拆解)
苹果确实只需要两类核心文件打包:
- 证书(Certificate .cer / p12):公私钥,证明你开发者身份,给代码签名防篡改
- Profile(.mobileprovision):描述文件,授权凭证
苹果两种场景
- 开发调试(Development)
- 证书:开发证书
- Profile:开发描述文件,内置所有测试机UDID,只能装登记设备
- 上架发布(Distribution)
- App Store 发布Profile:只能上传App Store Connect,不能本地电脑安装到手机
- AdHoc 内测Profile:绑定UDID,可私下发包给测试机安装
苹果打包最简三件套(你本地要存)
- p12(私钥+公钥证书)
- mobileprovision(profile描述文件)
- 应用Bundle ID前后一致
三、对比:苹果 VS 纯血鸿蒙 HarmonyOS NEXT
1. 苹果 iOS
打包仅需要: p12私钥库 + mobileprovision(Profile) 没有额外单独cer文件,Xcode会自动解析p12里的证书公钥。
2. 纯血鸿蒙(多一层拆分,所以文件多)
鸿蒙拆成了独立三份,逻辑和苹果一一对应,只是拆开了:
.p12= 和苹果p12完全一样,本地私钥.cer= 单独导出的公钥证书(苹果藏在p12里不单独导出).p7b= 鸿蒙版的 Profile 描述文件(等价苹果 .mobileprovision)
对应关系对照表:
| 苹果文件 | 鸿蒙等价文件 | 作用 |
|---|---|---|
| .p12 | .p12 | 本地私钥,签名代码 |
| 内置在p12的公钥证书 | .cer | 华为官方颁发的开发者凭证 |
| .mobileprovision(Profile) | .p7b | 授权契约:包名、设备、权限 |
四、回答你的问题:苹果是不是只要私钥证书+profile就够?
是的,日常打包只需要这两个,不用单独导出cer。 原因: 苹果把公钥证书打包进p12文件内部,Xcode自动读取,不用你单独上传、下载cer; 而鸿蒙安全设计强制把公钥证书拆成独立cer文件,多了一步操作,所以文件看着更繁琐。
五、通俗大白话总结
- Profile = 描述文件,一份官方授权单;
- 苹果:私钥p12 + profile(mobileprovision) 两套搞定打包;
- 鸿蒙:把苹果p12里的证书拆出来单独成cer,变成 p12 + cer + p7b(profile) 三件套;
- 两者底层安全逻辑一模一样,只是华为拆分了文件,步骤变多。
t-comm 中 docs:gen 生成 GalileoLogSortType[undefined]
2026-06-25
为什么 docs:gen 执行后会生成这些 undefined 内容,然后导致 docs:build 失败
[vitepress:local-search] Could not load /@localSearchIndex (imported by node_modules/.pnpm/vitepress@1.6.3_@algolia+client-search@5.25.0_@types+node@17.0.45_axios@1.9.0_less@4.5.6333351eba3c171df7eaf4a4397a9e7c/node_modules/vitepress/dist/client/theme-default/components/VPLocalSearchBox.vue?vue&type=script&setup=true&lang.ts): MiniSearch: duplicate ID /t-comm/zh/galileo-api.html#GalileoMessageSearch [vitepress:local-search] Could not load /@localSearchIndex (imported by node_modules/.pnpm/vitepress@1.6.3@algolia+client-search@5.25.0_@types+node@17.0.45_axios@1.9.0_less@4.5._6333351eba3c171df7eaf4a4397a9e7c/node_modules/vitepress/dist/client/theme-default/components/VPLocalSearchBox.vue?vue&type=script&setup=true&lang.ts): MiniSearch: duplicate ID /t-comm/zh/galileo-api.html#GalileoMessageSearch
问题根因分析
1. 为什么 docs:gen 后生成 [undefined]?
script/docs-jsdoc/markdown.js 用的是 jsdoc-to-markdown(jsdoc 解析器),它原生不支持 TypeScript 语法。
log.ts 里对每个枚举成员都加了 JSDoc 注释:
export enum GalileoLogSortType {
  /** 默认倒序 */     // 👈 这里
  DEFAULT = 0,
  /** 正序 */         // 👈 这里
  ASC = 1,
  /** 倒序 */         // 👈 这里
  DESC = 2,
}
jsdoc 解析器看到这些 /** */,会把它们当成"独立的成员",但因为它不认识 DEFAULT = 0 这种 TS 枚举成员的 AST,于是生成出来的成员名 name 为 undefined。然后模板 template.hbs 里渲染时用了 {{@parent}}{{@accessSymbol}}{{name}} 的格式,最终就拼出了:
GalileoLogSortType[undefined]
GalileoLogSortType[undefined]
GalileoLogSortType[undefined]
可以对照 location-interface.ts 里的 LocationFlag(用 // 行注释而不是 /** */),就完全不会出现这个问题。
2. 为什么 docs:build 失败?
VitePress 的本地搜索(local-search)对每个 markdown heading 自动生成锚点 ID(基于 ## 标题)。
生成的 galileo-api.md 里出现了多个完全相同的 heading:
### `GalileoLogSortType[undefined]`     ← 重复 3 次
### `GalileoMessageFilterType[undefined]`  ← 重复 3 次
### `GalileoMessageSearchType[undefined]`  ← 重复 5 次
它们生成的锚点 ID 也都一模一样(如都是 #galileologsorttypeundefined),于是 MiniSearch 抛出:
MiniSearch: duplicate ID /t-comm/zh/galileo-api.html#GalileoMessageSearchbuild 直接挂掉。
修复方案
我推荐最小改动方案:把 log.ts 里枚举成员上面的 /** ... */ JSDoc 注释改成普通的 // 行内注释,跟项目里其他 enum(比如 LocationFlag)保持一致。这样 jsdoc 就不会把成员当成独立条目去解析,避免生成 [undefined]。
⚠️ 这里只动
log.ts,没动构建脚本,是因为这是项目里唯一一个把/** */加在枚举成员上的写法,其他 enum 都是用//。这是最小、最低风险、最一致的改法。
是否帮你直接改 log.ts?改完后再 npm run docs:gen && npm run docs:build 应该就能通过了。
如果你坚持希望在源码里保留 /** */ 形式(因为它在 IDE hover 时更友好),还有另一个方案:在 markdown.js 里加一个清洗步骤,把生成结果中包含 [undefined] 的 heading 整段过滤掉。但这个改动面更大、更"hack",所以优先推荐方案一。 。
小程序打包异常
2026-06-23
为什么构建机上,没有生成 dist/build/mp-weixin/node-modules/@tencent/press-ui/press-transition/press-transition.js,但是有 json,wxml 文件,本地可以生成呢,执行 npm run build:mp 的时候
诊断结论
1. press-transition 是怎么进入 dist 的
press-transition 在你项目的 src 里没有任何代码直接 import。它是被 @tencent/press-ui 其它组件(press-overlay、press-toast、press-notify、press-image、press-back-top 等)作为子组件 usingComponents 间接引用而被打包进来。
更关键的:@tencent/press-ui 是源码发布的 press-transition.vue、css/index.scss),需要项目自己用 vite-plugin-uni 把 .vue 编译成 wxml/json/wxss/js 这一整套四件套。
2. 构建机上"只有 json/wxml/wxss,缺 js"的根因
这种"四件套只少 .js"的现象,几乎只有一种原因:
构建过程中,vite/rollup 在编译
press-transition.vue的<script>阶段失败/被跳过,但<template>(→ wxml)、<style>(→ wxss)、usingComponents元信息(→ json)依然由@dcloudio/uni-mp-vue的元数据收集流程正常输出了。
在 uni-app vue3 + vite 编译模型里,模板和样式分别由 template-compiler、style-compiler 独立生成产物(输出在 emitFile 那一层),而 .js 是由 rollup 把 <script> 转换 + tree-shaking + chunk 之后才 emit。所以 script 阶段出问题时,会出现你看到的"只缺 js"现象。
构建机和本地出现差异,最常见的几个具体诱因如下,按可能性从高到低排列:
✅ 可能原因 A(最常见):node_modules 大小写敏感 + symlink/pnpm 结构差异
- 你本地是 macOS(默认 大小写不敏感 APFS),构建机一般是 Linux(大小写敏感 ext4)。
- pnpm 在 Linux 下使用真实 symlink,且本仓库的
.pnpm/@tencent+press-ui@5.0.29/...是源码 +.vue文件。 - 实际产物路径
dist/build/mp-weixin/node-modules/@tencent/press-ui/...(注意是node-modules不是node_modules,这是 uni-mp-weixin 故意改名规避小程序限制)。如果构建机 vite 解析.vue路径时大小写/真实路径错配,rollup 会把它当成"外部模块"而不输出.js,但 template/style 已经被 uni 插件 hook 走了产物输出。
✅ 可能原因 B:构建机用了 npm ci / npm i 而不是 pnpm i
- 本仓库根本是 pnpm 项目(有
pnpm-lock.yaml、.pnpm目录)。 - 用 npm 安装时,
@tencent/press-ui会被扁平化平铺到node_modules/@tencent/press-ui,但对等依赖(peerDependencies)、嵌套.vue解析、@dcloudio/uni-cli-shared对 node_modules 的扫描白名单都和 pnpm 行为不一致,常导致.vue的 script 部分被识别为"已经是产物,无需编译"而跳过。
✅ 可能原因 C:构建机用了 NODE_ENV=production + Tree-shaking 把空模块当死代码删了
- 看 press-transition.js 的内容,整个模块就只是
wx.createComponent(...),没有任何 export。 - 在生产模式 + 严格 sideEffects 配置下,rollup 可能判断此 chunk "无副作用且无被导入处",整条 chunk 被裁掉,但 emitFile 已经吐出了 wxml/wxss/json。
- 注意
@tencent/press-ui的package.json是否把*.vue标记为"sideEffects": false。
✅ 可能原因 D:构建机 vite 缓存(node_modules/.vite)旧 / 内存 OOM
- vite 6 在大型 uni-app 项目上偶发 worker 崩溃,单个 chunk emit 失败但不中止整个构建。
- 构建日志里通常有
[plugin:vite:vue] failed to transform .../press-transition.vue这样的 warning,但 exitCode 仍为 0。
✅ 可能原因 E:构建机 Node 版本 < 16 或 pnpm 版本与本地不一致
- 项目
engines.node >= 16,但pnpm大版本(7 / 8 / 9)的 hoist 策略不同。pnpm 8+ 的 isolated 模式会让@dcloudio找不到@tencent/press-ui内部依赖(比如press-transition内部 mixin),从而在 transform 阶段抛错却不终止。
排查与解决建议(建议按顺序)
拿到构建机的完整 build log 重点搜:
press-transition、failed to transform、Could not resolve、plugin:vite:vue。这是最直接的证据。统一包管理器 构建机改成
pnpm install --frozen-lockfile,并使用与本地一致的 pnpm 版本(pnpm -v比对)。package.json里加:json"packageManager": "pnpm@7.x.x"清缓存重试 构建机 CI 步骤里加:
bashrm -rf node_modules dist .vite node_modules/.vite pnpm install --frozen-lockfile npm run build:mp强制 include 该依赖(验证 A/B 假设) 修改 vite.config.ts 的
optimizeDepsIncludes,加入@tencent/press-ui,确认是不是依赖优化把它漏了:tsoptimizeDepsIncludes: [ 'md5', 'qrcode', '@tencent/pmd-network', '@tencent/press-ui', ],核对 Node/OS 大小写敏感性 构建机执行
uname -a && node -v && pnpm -v,确认与本地差异;本仓库源码中所有from '@tencent/press-ui/press-xxx/press-xxx'大小写必须严格一致。临时兜底方案 如果时间紧、必须先发版,可以在
src任意entry(如 [main.ts] 或 App.vue)里加一行显式 import 触发 rollup 真正把它编译为产物:tsimport '@tencent/press-ui/press-transition/press-transition.vue';这会强制构建产出
.js文件。
pfbs
2026-06-17
你这里代码里的 pfbs 是 Buffer.from(string, 'utf8') 的简写 / 封装函数,全称:Plain Flat Binary String,前端 / NodeJS 常用工具方法,作用:
把 JS 字符串 → 二进制字节 Buffer(二进制数组)
直译为“扁平原生二进制字符串”
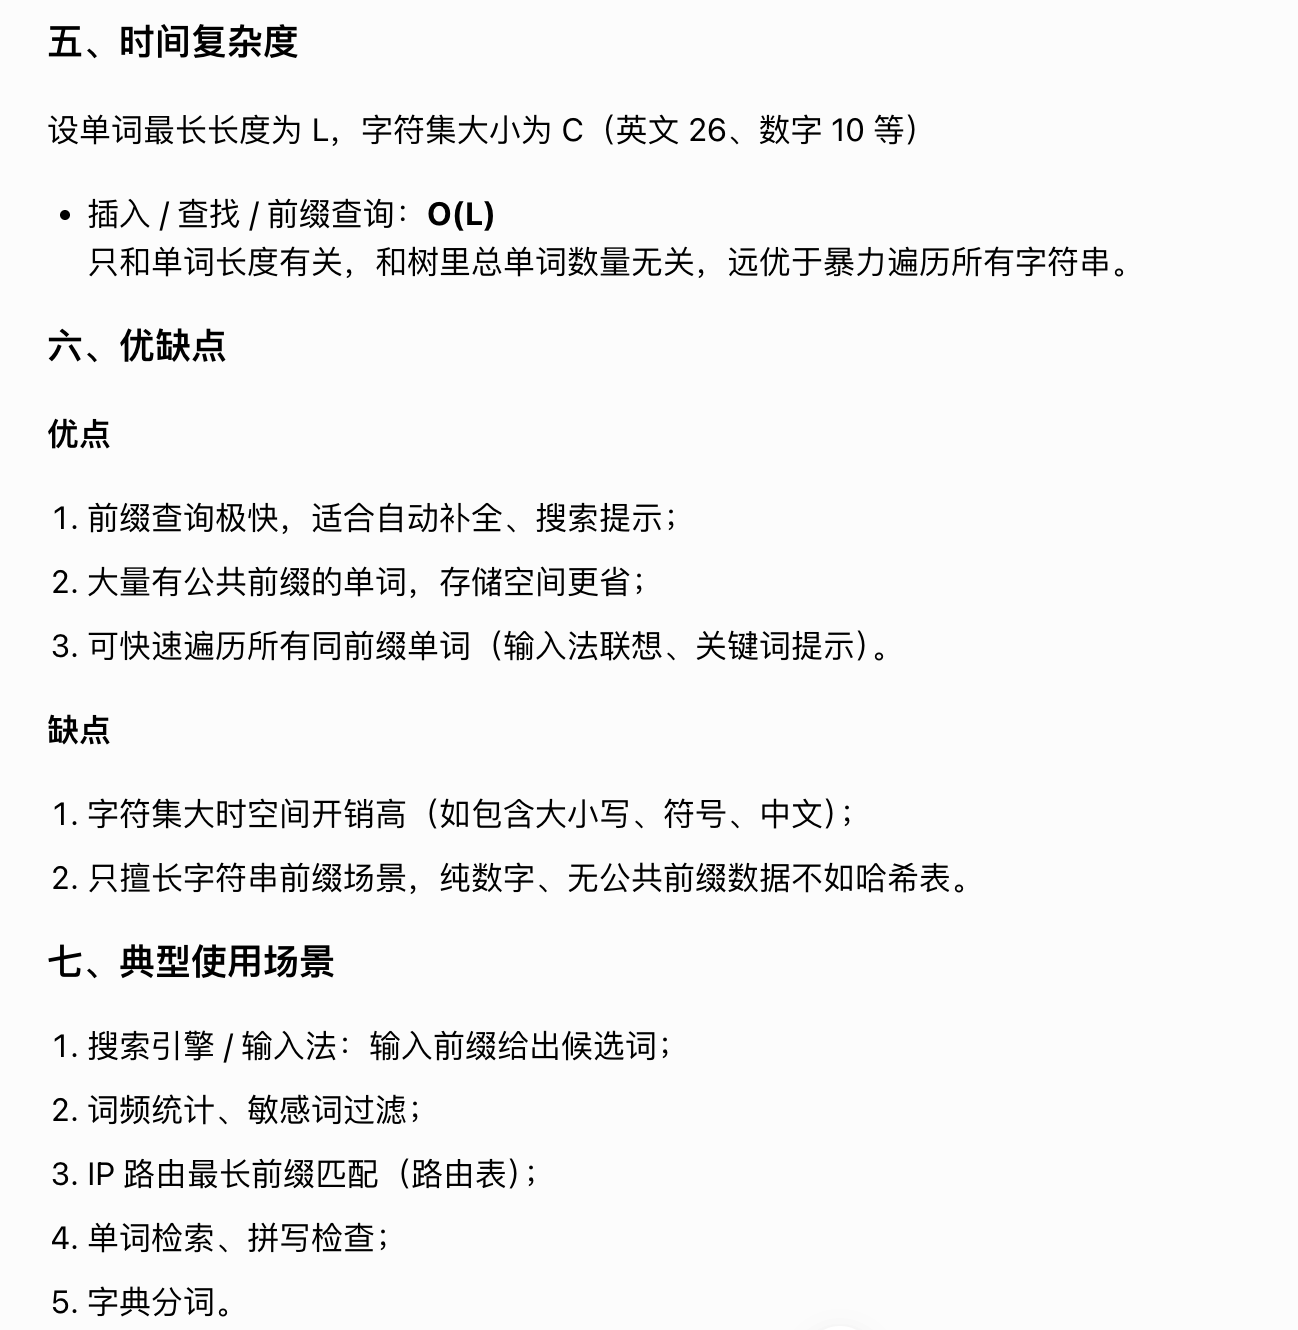
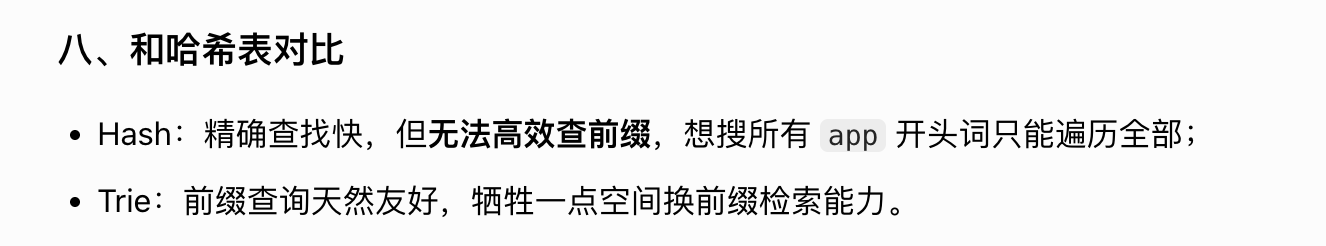
trie 优缺点、时间复杂度
2026-06-16
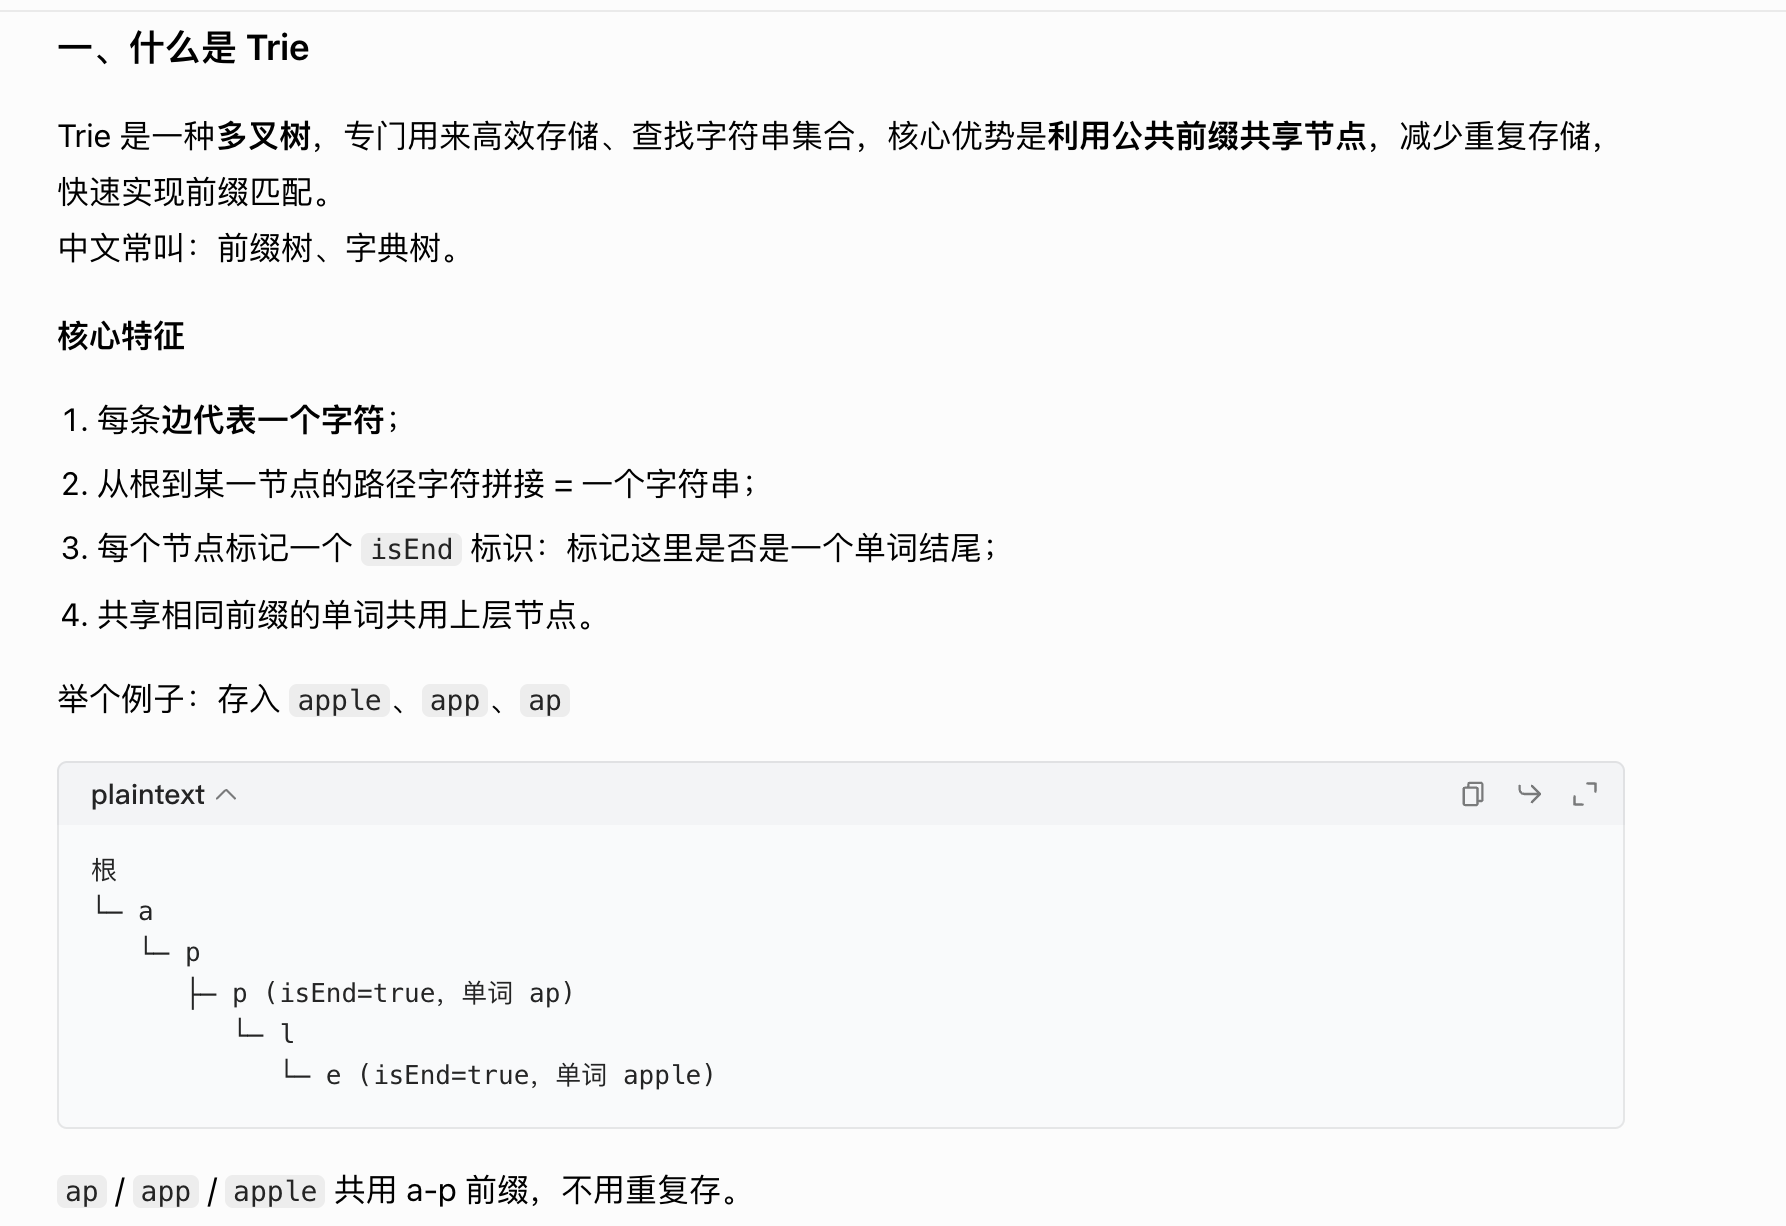
trie 是什么
2026-06-16
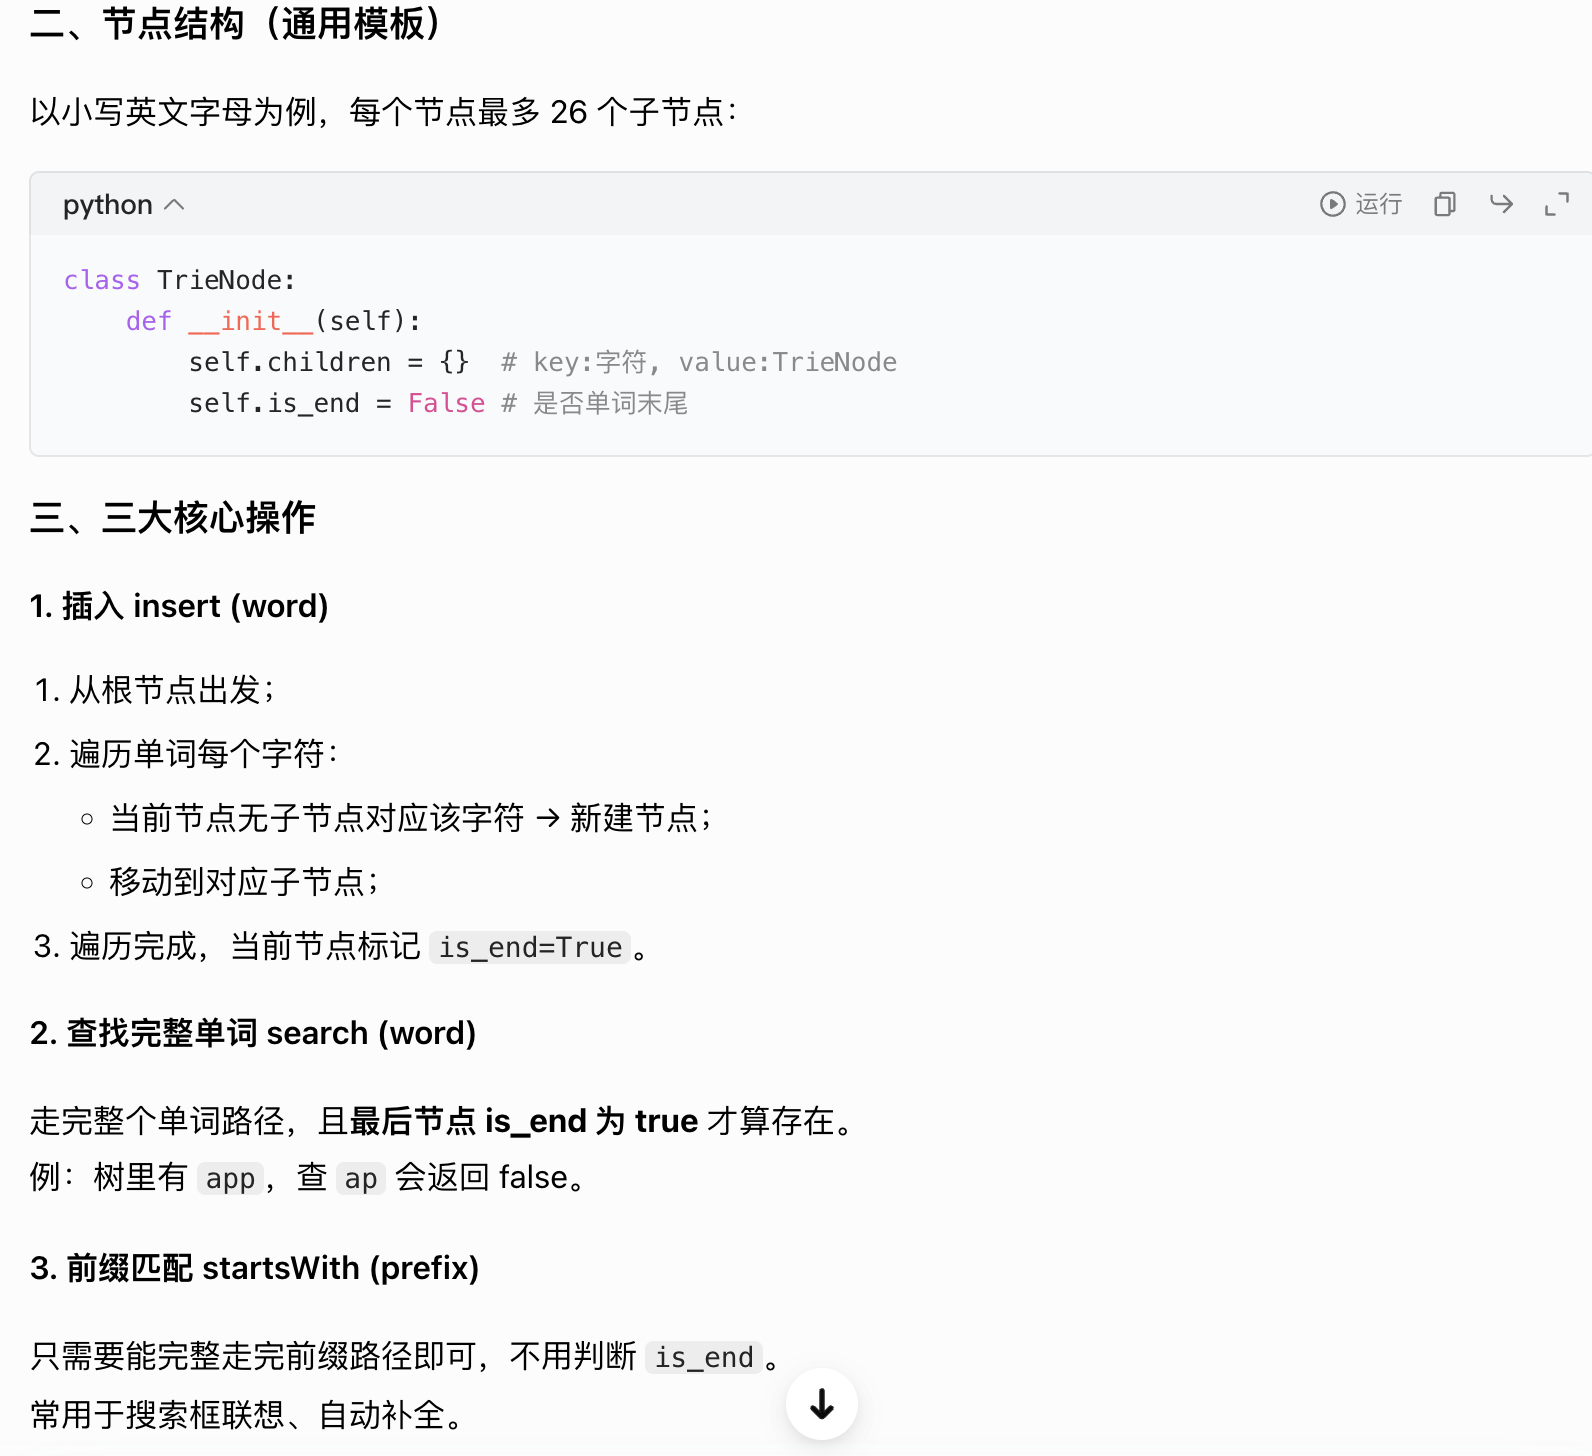
trie
2026-06-16
这里不能写成 temp[newR] = Math.max(temp[newR], temp[r] + num); 是为什么
2026-06-16
temp[newR] = Math.max(temp[newR], dp[r] + num); 这里不能写成 temp[newR] = Math.max(temp[newR], temp[r] + num); 是为什么
因为必须用本轮更新前的旧值来做转移,不能用已经被当前 num 污染过的值。
举个例子:假设 dp = [0, -Inf, -Inf],当前 num = 2。
正确做法(读 dp[r]):
r=0:newR = (0+2)%3 = 2,tmp[2] = max(-Inf, dp[0]+2) = 2r=1:newR = (1+2)%3 = 0,tmp[0] = max(0, dp[1]+2) = max(0, -Inf) = 0r=2:newR = (2+2)%3 = 1,tmp[1] = max(-Inf, dp[2]+2) = -Inf
结果:tmp = [0, -Inf, 2] ✅ 只选了一次 num=2
错误做法(读 tmp[r]):
r=0:newR = 2,tmp[2] = max(-Inf, tmp[0]+2) = 0+2 = 2← 此时 tmp[2] 变成 2r=2:newR = 1,tmp[1] = max(-Inf, tmp[2]+2) = 2+2 = 4❌
tmp[2] 已经是"选了 num"的结果(值为 2),再从 tmp[2] 转移相当于把同一个 num 加了两次(0→2→4),这就错了。
本质原因: 每个 num 只能选一次(0/1 背包思想)。读 dp[r](旧状态)保证每个数字只被考虑加入一次;如果读 tmp[r](新状态),同一个数字可能被重复叠加。
为什么是 (r + num) % 3
2026-06-16
这是模运算的基本性质:
两个数之和的余数 = 各自余数之和的余数
即 (a + b) % 3 === ((a % 3) + (b % 3)) % 3
在这段代码中:
dp[r]代表"和对 3 取余为r"的最大子集和,所以这个和的余数就是r- 当我们把
num加进去后,新的总和为dp[r] + num - 新总和对 3 的余数 =
(dp[r] + num) % 3
因为 dp[r] % 3 === r(这是 dp[r] 的定义),所以:
(dp[r] + num) % 3 === (dp[r] % 3 + num % 3) % 3 === (r % 3 + num % 3) % 3 === (r + num) % 3直接用 r 代替 dp[r] % 3,避免了对一个可能很大的数取模,也更清晰地表达了状态转移的含义:旧余数 r + 新数字 num → 新余数 newR。
iid 与 id 的含义完全不同
2026-06-16
- id 系统中全局唯一
- iid 项目中唯一,它的值会对应网页中的 URL,例如项目中的第 10 号 Issue
提交统计
2026-06-15
姓名 + 邮箱 + 提交次数
git log --all --format='%an <%ae>' | sort | uniq -c | sort -nr只统计当前分支(去掉 --all)
# 当前分支总提交
git rev-list HEAD --count
# 当前分支提交人数
git log --format='%ae' | sort -u | wc -l
填空题
2026-06-15
好的面试官会继续问用cos和结构化表会有哪些好处和坏处,碰到过哪些问题,用了哪些方法。
而不是只问”填空题“。技术难题从来不是标准解,否则技术岗位就真的完全被AI替代了
面试还问算法题吗
2026-06-15
- 岗位方向的计算机基础知识面考察(有足够广的知识面,才能够解决你向 AI 提问时到底问什么,因为我们不可能问出 不知道自己不知道 的东西)
- AI 的编程技巧(本质是学习能力,如果能够快速地学会现在最好的 AI 编程技巧,就意味着以后的认知升级,他也能够快速地学会)
- 思维能力题目(也就是智商测试,有些因为擅长死记硬背而拿高分进大学的傻子,是不可能用好 AI 的)
personal_access_token vs private_token
2026-06-15
工蜂仅支持 personal_access_token 推拉代码,private_token 无法使用
maxSubArray VS lengthOfLongestSubstring
2026-06-15
确实很像!它们属于同一类思维模式。下面做个对比分析:
核心相似点:「以当前位置结尾」+ 「要不要前面」
| 最大子数组和 (Kadane) | 最长无重复子串 (滑动窗口) | |
|---|---|---|
| 问题本质 | 找最优的连续子数组 | 找最长的连续子串 |
| 遍历思路 | 遍历每个位置,维护「以 i 结尾」的最优解 | 遍历每个位置(right),维护「以 right 结尾」的最长窗口 |
| 核心决策 | 前面的累积有益吗?有益就接上,无益就丢弃重新开始 | 前面的窗口合法吗?合法就扩展,不合法就收缩左边界 |
| 全局答案 | 遍历过程中取 max | 遍历过程中取 max |
决策逻辑对比
// Kadane — 最大子数组和
curr = Math.max(curr + nums[i], nums[i]);
//       ↑ 接上前面       ↑ 从这里重新开始
// 判断依据:curr > 0 时前面有正收益,否则抛弃// 滑动窗口 — 最长无重复子串
if (map.has(ch) && map.get(ch) >= left) {
left = map.get(ch) + 1; // 收缩左边界,"丢掉"前面冲突的部分
}
// 判断依据:窗口内有重复时,左边界右移本质统一:贪心地维护「以当前位置结尾的最优子问题」
两题的思想可以统一为:
从左到右扫描,对每个位置 i,决定"从哪里开始"到 i 是最优的。
- Kadane:起点隐式由
curr决定 ——curr < 0时等价于起点重置为 i - 滑动窗口:起点显式由
left决定 —— 遇到冲突时left右移
关键差异
| Kadane | 滑动窗口 | |
|---|---|---|
| 分类 | DP / 贪心 | 双指针 / 滑动窗口 |
| 左边界移动 | 隐式(curr 归零 = 重新开始) | 显式(left 右移) |
| 移动方向 | 左边界可能跳到当前位置(大幅跳跃) | 左边界只会向右(单调递增) |
| 辅助结构 | 无 | 需要 Map 记录字符位置 |
一句话总结
两题都是**「扫描到 i 时,贪心地决定要不要带上前面」**的模式——Kadane 看的是前面累积是否为正收益,滑动窗口看的是前面窗口是否合法。掌握了这个模式,遇到「连续子数组/子串」求最优的问题,第一反应就是:维护一个以当前位置结尾的最优状态,遍历一遍取全局最大。
LCS/maxSubArray/lengthOfLongestSubstring 区别
2026-06-15
这三道题确实容易混淆,因为名字里都有"最长/最大"和"子xxx",但它们的核心思路完全不同。下面做个对比:
三题对比
| 维度 | 最长公共子序列 (LCS) | 最大子数组和 | 无重复字符的最长子串 |
|---|---|---|---|
| 题号 | LC 1143 | LC 53 | LC 3 |
| 输入 | 两个字符串 | 一个数组 | 一个字符串 |
| "子"的含义 | 子序列(不要求连续) | 子数组(必须连续) | 子串(必须连续) |
| 求什么 | 公共子序列的最大长度 | 连续子数组的最大和 | 无重复字符的连续子串最大长度 |
| 方法 | 二维 DP | 一维 DP (Kadane) | 滑动窗口 |
| 时间复杂度 | O(m×n) | O(n) | O(n) |
| 空间复杂度 | O(m×n) | O(1) | O(字符集) |
核心区别
1. 子序列 vs 子串/子数组
- 子序列:可以跳着选,不要求连续(如
"ace"是"abcde"的子序列) - 子串/子数组:必须连续
这决定了 LCS 需要二维 DP 来枚举两个串的所有前缀组合,而后两者只需一次遍历。
2. 为什么方法不同
| 题目 | 核心决策 | 为什么选这个方法 |
|---|---|---|
| LCS | 当前字符相同→继承对角线+1;不同→取左/上的较大值 | 两个序列交叉对比,天然二维 |
| 最大子数组和 | curr + nums[i] vs nums[i](接上 or 重新开始) | 只关心"以 i 结尾"的最优解,一维就够 |
| 最长无重复子串 | 右指针扩张,遇重复则收缩左指针 | 维护一个"合法窗口",窗口内无重复 |
3. 状态定义对比
// LCS: dp[i][j] = text1 前 i 个字符与 text2 前 j 个字符的 LCS 长度
dp[i][j] = text1[i-1] === text2[j-1]
  ? dp[i-1][j-1] + 1
  : Math.max(dp[i-1][j], dp[i][j-1]);

// 最大子数组和: curr = 以当前元素结尾的最大和
curr = Math.max(curr + nums[i], nums[i]);

// 最长无重复子串: 没有 dp 数组,用滑动窗口 [left, right]
if (map.has(ch) && map.get(ch) >= left) {
  left = map.get(ch) + 1;
}
max = Math.max(max, right - left + 1);
一句话总结
- LCS:两个序列找公共部分 → 二维 DP
- 最大子数组和:一个数组找最优连续段 → Kadane(一维 DP)
- 最长无重复子串:一个字符串找最长合法连续段 → 滑动窗口
它们"像"的原因是都在求某种最优子结构,但因为约束不同(两序列 vs 单序列、连续 vs 不连续、求和 vs 求长度),方法各异。 需要找 session_log_record 工具来记录日志: 该工具列表中没有直接的 session_log_record,让我查看所有 pmd-mcp 工具是否有记录类工具:
本次对话属于无文件变更的简单问答(仅读取已有文件做对比分析),按规则不记录 session log。
总结一下,这三道题表面相似(都求"最优子xxx"),但本质区别在于:
- 连续性约束:子序列可以不连续,子串/子数组必须连续
- 输入数量:LCS 是双输入对比问题,另外两个是单输入优化问题
- 优化目标:LCS 求长度、最大子数组求和、最长子串求长度但有"无重复"约束
这三种不同的问题结构,分别对应三种经典算法模式:二维 DP → 一维 DP (Kadane) → 滑动窗口。
disk usage & disk free
2026-06-15
du = disk usage 磁盘使用量 df = disk free 磁盘剩余空间
df → 看分区整体剩余 du → 看文件 / 目录占用
du -sh 含义
- du = disk usage,统计磁盘占用。
- -s = summary,只显示总大小,不列出子文件。
- -h = human-readable,用 K/M/G 等易读单位显示。
用法示例
# 查看当前目录总大小
du -sh

# 查看指定目录/文件大小
du -sh /home
du -sh test.txt

# 查看当前目录下各子目录大小
du -sh *# 查看所有挂载磁盘分区使用率、剩余空间
df -h
# 只看当前所在分区
df -h .!.pixiderc/webpack.js 为什么不生效
2026-06-15
.eslintignore 下面这样不生效
!.pixiderc/webpack.js这里 .pixiderc 整个目录其实并没有显式写在 ignore 里,但因为内置默认忽略 .xxx/,等价于"父目录已被忽略"。
按 gitignore 规范:如果父目录被忽略了,子文件就无法用 ! 重新加回来,必须先 unignore 父目录,再 unignore 子文件。
改成下面这样
# 默认 ESLint 会忽略 .xxx/ 点目录,这里需要先反向放开父目录,
# 然后再忽略目录下其他文件,单独把 webpack.js 放出来 lint
!.pixiderc/
.pixiderc/*
!.pixiderc/webpack.js
lcs 的 dp
2026-06-15
这个 lcs 的dp如果是 Array.from({ length: m }, () => new Array(n ).fill(0)); 可以吗
不可以。 如果用 Array.from({ length: m }, () => new Array(n).fill(0)),dp 表的大小是 m × n,而这题需要的是 (m+1) × (n+1)。
原因:
- 需要多一行一列作为边界条件 —
dp[i][j]表示 text1 前i个字符与 text2 前j个字符的 LCS 长度,i和j从 0 到 m/n,所以需要m+1行、n+1列。 dp[0][*]和dp[*][0]作为 base case(全为 0),表示其中一个字符串为空时 LCS 为 0。- 如果只建
m × n的表,当访问dp[m][n]时会越界(下标最大只到m-1/n-1)。
所以正确写法必须是:
const dp = Array.from({ length: m + 1 }, () => new Array(n + 1).fill(0));单词拆分,workbreak 里为什么 j 一定要小于 i
2026-06-15
j < i 的原因是由状态转移的语义决定的:
dp[i] 表示 s[0..i-1](前 i 个字符)能否被拆分。 转移方程是把前 i 个字符拆成两部分:
s[0..j-1] | s[j..i-1]
dp[j] 字典匹配j是"分割点",表示左半部分的长度(0 到 i-1)s.slice(j, i)是右半部分,它必须是一个非空子串
如果 j == i,那么 s.slice(j, i) 就是空串 "",这没有意义——字典里不会有空串,也不应该用空串去匹配。
所以 j 的范围是 [0, i-1],即 j < i,保证:
- 右半部分
s[j..i-1]至少有一个字符 - 左半部分
s[0..j-1]可以为空(j=0时,dp[0]=true代表空串合法)
简单说:j 是切割位置,切出来的右段不能为空,所以 j 必须严格小于 i。
props 同步是对的,token 是不是也可以用脚本,不走llm,type check 也不用走llm,自己跑,跑完人来改
2026-06-15
你这个判断完全正确,而且比我之前给的方案更狠、更好。让我重新摆一下牌:
你的提议本质:LLM 出局,全靠确定性脚本
┌──────────────────────────────────────────┐
│ Phase 1: sync-props.mjs                  │
│   ts-morph 解析 baseline → patch target  │
│   产物:types.ts + uvue 的 defineProps    │
└──────────────────────────────────────────┘
┌──────────────────────────────────────────┐
│ Phase 2: sync-tokens.mjs                 │
│   解析 baseline.less → 抽 css var 表      │
│   patch target.less                      │
└──────────────────────────────────────────┘
┌──────────────────────────────────────────┐
│ Phase 3: typecheck.mjs                   │
│   tsc --noEmit + uvue 编译检查            │
│   有错就把错列成 markdown 报告            │
└──────────────────────────────────────────┘
            ↓
报告丢给人,人来改优点是革命性的:
| 维度 | LLM 路线 | 纯脚本路线 |
|---|---|---|
| 单组件耗时 | 半小时 | 5 秒 |
| 准确性 | 50-70% | 100% |
| 幻觉 | 编 UniInputEvent | 不存在 |
| token 成本 | $0.5-2/组件 | 0 |
| 可重复 | 每次结果不一样 | 决定论 |
| 调试 | LLM 是黑盒 | 就是普通 JS |
具体能不能落地?我来一项项算账
✅ Phase 1:props 同步(100% 可行)
baseline 那边的数据源:
props.ts是tdesign-api自动生成的,有标准的InputPropsinterface,字段名 + 类型 + 默认值 + JSDoc 描述全都齐- ts-morph 一行
getInterface('InputProps').getProperties()就能拿到
target 那边要改的:
t-input.types.ts的InputPropsinterfacet-input.uvue的defineProps({ ... })runtime 声明(这个稍微麻烦点,但 ts-morph 也能 patch)
稍微 tricky 的点:uvue 是 .uvue 后缀,ts-morph 默认不解析,需要把 <script setup lang="uts"> 拎出来当 ts 解析。但已经有现成方案:用 @vue/compiler-sfc 的 parse 拿 script 块内容 → 喂 ts-morph → 改完拼回去。
✅ Phase 2:token 同步(100% 可行,且比 props 还简单)
baseline less 的样子:
@td-input-bg-color: var(--td-input-bg-color, #ffffff);
@td-input-text-color: var(--td-input-default-text-color, #181818);
@td-input-vertical-padding: var(--td-input-vertical-padding, 16px);这就是结构化数据,正则就够了,连 less parser 都不用:
const TOKEN_RE = /@(td-[\w-]+):\s*var\((--td-[\w-]+),\s*([^)]+)\)/g;
// → { lessVar, cssVar, defaultValue }对比策略:
- 提取 baseline 的 token 表 → Map A
- 提取 target 的 token 表 → Map B
- 缺的(A 有 B 无) → 插入 target less 顶部
- 默认值不一致的 → 列出报告(不自动改,留人决定)
✅ Phase 3:typecheck(100% 可行)
uniapp-x 的 tsconfig 已经在了。直接:
const { execSync } = await import('node:child_process');
try {
  execSync('npx tsc --noEmit -p packages/uniapp-x-components', { stdio: 'pipe' });
} catch (e) {
  fs.writeFileSync('reports/typecheck.md', formatTscErrors(e.stdout));
}
uvue 编译检查可以用 unocli/vite build 跑一遍 H5 平台,错就抓出来。
⚠️ 但有 1 件事必须诚实告诉你
视觉对齐这件事,纯脚本搞不定。
- 字段对齐 → 脚本搞定 ✅
- token 表搬运 → 脚本搞定 ✅
- 类型检查 → 脚本搞定 ✅
- 像素级视觉对齐 → 脚本搞不定 ❌
因为 baseline 用 vue 渲染、target 用 uvue 渲染,渲染管线、字体、CSS reset 都不一样——同一份样式在两边跑出来就是不一样。
所以纯脚本路线能保证的是:API + 主题 token 100% 对齐。但视觉上仍可能有 1-3% diff——这部分你要么接受、要么人工 case by case 调。
截图对比这件事的新定位:从"LLM 输入"降级为"人审清单"——脚本跑完后,截图差大于 X% 的 case 会列在报告里,人扫一眼自己决定要不要处理。
我的最终推荐路线
┌─────────────────────────────────────────────┐
│ /cli/sync                                   │
│   ├── sync-props.mjs       ← ts-morph       │
│   ├── sync-tokens.mjs      ← regex          │
│   ├── typecheck.mjs        ← tsc            │
│   ├── snapshot-diff.mjs    ← playwright     │
│   └── report.mjs           ← 汇总 markdown   │
└─────────────────────────────────────────────┘

# 用法
npm run sync -- t-input
# → 5 秒后产出 reports/t-input.md
#   - ✅ props 已同步
#   - ✅ token 已同步
#   - ⚠️ tsc 1 个错:t-input.uvue:120 缺 import
#   - ⚠️ 视觉 diff: button-default 2.3% (轻微)
#                  button-loading 0.8% (通过)
# → 人看报告,10 分钟把 1 个 tsc 错和 1 个视觉 case 改了
ROI 估算:
- 原 LLM 路线:1 组件半小时 + 50% 失败率 = 实际 1 小时
- 新脚本路线:1 组件 5 秒脚本 + 10 分钟人改 = 10 分钟
20+ 组件总共:~3-4 小时全部对齐完。
你拍板,我马上动手
A)我直接砍掉 LLM 部分:
- 删
cli/harness/run.mjs的 LLM 调用 - 保留截图模块(降级为验收)
- 新增
cli/sync/sync-props.mjs+sync-tokens.mjs+typecheck.mjs - 输出统一 markdown 报告
B)保留 LLM 模块作为可选实验,新增 cli/sync/* 与之并行:
- 想用脚本就
npm run sync - 想试 LLM 就
npm run harness
我推荐 A,简单干净。LLM 模块保留在 git 历史里随时能翻回来。
你说"动手"我就开始写。 第一个动手对象就是 t-input,跑通了再扩到其他组件。
这种 harness 路线是正确的吗,我怎么感觉这个效率很低,而且准确性很低
2026-06-15
你这个怀疑是对的。让我抛开"已经写了一半"的沉没成本,客观分析一下。
直面问题:当前路线的效率/准确性硬伤
❌ 效率低的根因
| 环节 | 单轮耗时 | 问题 |
|---|---|---|
| 截图(baseline + target × N case) | 30-60s | playwright 启浏览器、等页面、等动画、等字体、等 HBuilderX HMR |
| LLM 调用(kimi-k2.6 长 context) | 30-90s | 每轮把 props.ts + types + variants + uvue + theme.less 全塞,4-8K tokens |
| HBuilderX HMR 回弹 | 3s 硬等 | 还经常没编译完就截下一张 |
| 单轮总时长 | 2-4 分钟 | × 8 rounds = 半小时只调一个组件 |
而且:截图本身决定了上限。HBuilderX 跑出来的 H5 和 baseline 跑的 H5 是两套渲染管线、两套字体、两套 css base,diffRatio 永远不可能降到 0.5%——当前 worst case 是 6.23%,里面 80% 是字体抗锯齿差异这种你修不掉的噪音。
❌ 准确性低的根因(真正致命)
- LLM 看图修像素是反直觉的任务:人类设计师都需要量尺寸、量颜色、量行高,LLM 从一张 375×600 的 png 里靠肉眼"猜"
padding: 16pxvs12px,本质就是抽卡。 - uvue 不是 vue:你已经看到 LLM 编
UniInputEvent这种不存在的类型——它没见过 uvue/uts 的训练数据,写一行错一行。 - 修了 A 破了 B:每轮 LLM 重写整个文件,不可避免地丢失上一轮已经修对的细节,你看到的"幻觉"和"重复同步"本质都是这个。
- 没有单元测试 / 编译反馈:apply 后只有"截图 diff 又变小"这一个信号,编译错都看不到——改坏了的代码继续往下跑。
- API 对齐和视觉对齐被混在一起:types.ts 改一行就能补 props(这是机械活),但被裹在视觉修复的大包里一起发给 LLM,浪费 token + 引入幻觉风险。
我建议的新路线:机械活归脚本,创意活才上 LLM,且必须可验证
🎯 核心思想:Codegen 优先 → LLM 兜底 → 编译/类型/快照硬验证
                  ┌─────────────────────────────────────────┐
                  │  baseline props.ts(已有 schema 数据)   │
                  └────────────────┬────────────────────────┘
                                   │
                  ┌────────────────▼────────────────────────┐
                  │  Phase 1: 纯脚本 codegen(0 LLM)        │
                  │  - 自动补齐 target/types.ts 的 missing   │
                  │  - 自动补齐 defineProps runtime 声明     │
                  │  - 字段排序、JSDoc 同步                  │
                  │  → npm run typecheck 必须 100% 通过     │
                  └────────────────┬────────────────────────┘
                                   │
                  ┌────────────────▼────────────────────────┐
                  │  Phase 2: 视觉修复用 design token diff   │
                  │  - 不再喂截图给 LLM                     │
                  │  - 而是从 baseline less 中抽 token 表   │
                  │    对比 target less 的 token 表         │
                  │    → 列出"baseline 有 / target 没有"    │
                  │       的 css var 缺失列表               │
                  │  → LLM 只做:把 token 名加进 less       │
                  └────────────────┬────────────────────────┘
                                   │
                  ┌────────────────▼────────────────────────┐
                  │  Phase 3: 视觉验收(不是修复手段)       │
                  │  - 截图 diff 只用来"判定通过/不通过"    │
                  │  - 不通过 → 把 worst case 的截图地址    │
                  │    + 缺的 css var 给人,不给 LLM        │
                  └─────────────────────────────────────────┘
具体落地:3 个高 ROI 的脚手架
① Props 同步脚本(替代 LLM 改 types.ts,零幻觉)
// cli/codegen/sync-props.mjs
// 输入:baseline 的 props.ts(标准 TS 文件)
// 输出:直接 patch target 的 t-input.types.ts
//
// 实现:
//  - 用 ts-morph 解析 baseline props.ts
//  - 把 baseline 没有 / target 有的字段 → 删除
//  - 把 baseline 有 / target 没有的字段 → 插入(保留注释、type、default)
//  - 字段按字典序排序
//  - 同时 patch t-input.uvue 里的 defineProps({}) runtime 声明
//
// 验证:跑完 → tsc --noEmit这一步完全不需要 LLM,且 100% 准确。你之前的 audit 已经能列出 missing props,只需要再写"应用"这一步。
② CSS Token 提取/对比脚本(视觉对齐的最大公约数)
// cli/codegen/diff-css-tokens.mjs
// 输入:baseline.less + target.less
// 输出:
//   缺失 token:--td-input-bg-color, --td-input-label-color, ...
//   不一致默认值:--td-input-vertical-padding (baseline=16px, target=12px)
//
// LLM 只做一件事:根据这个表,把缺失的 token 加进 target 的 less
// 不需要 LLM 看截图,也不需要"猜"像素
这能把"视觉对齐"任务从"LLM 看图猜代码"变成"LLM 把表格转成 css 行"。LLM 转 schema 的准确率 > 95%,肉眼像素 < 50%。
③ TSC 反馈回路(self-heal)
// 每次 LLM patch 后必跑:
//   1. tsc --noEmit  → 收集编译错误(行号 + 信息)
//   2. 如果有错 → 把错误塞进 round-N+1 的 prompt 让 LLM 修
//   3. 3 轮自纠还过不了 → 回滚 + 标红等人介入
截图对比要不要保留?
保留,但降级用途:
- ✅ 最终验收信号(diffRatio 低于阈值 → 这一组 case 通过)
- ❌ 不再作为 LLM 的输入(LLM 看图改像素 = 抽卡)
也就是说:截图变成测试,不是指令。
我的诚实建议(直说)
当前 harness 路线,对于"视觉对齐"这件事是错的,对于"API 对齐"这件事是过度工程的。
推荐重构动作
- ✂️ 砍掉:把截图喂 LLM 的视觉修复链路(保留截图作为验收)
- ✅ 新增:cli/codegen/sync-props.mjs — 纯 ts-morph 脚本同步 props
- ✅ 新增:cli/codegen/diff-css-tokens.mjs — token 表对比
- ✅ 新增:
cli/harness/lib/typecheck.mjs— patch 后跑 tsc,错就回喂 LLM - 🔧 改造:LLM prompt 不再含截图,只含"待补 props 表 + 待补 token 表 + 当前文件"
- 📐 新指标:不再追求 diffRatio < 0.5%(不可能达到),改为追求 "props 100% 对齐 + token 100% 覆盖 + tsc 0 error"——这三个都能确定性达到
时间预估
按这个新路线,单组件对齐时间从"半小时不收敛" → 3-5 分钟稳定收敛:
- props 同步:脚本 5s
- token diff:脚本 5s
- LLM 补 token:30s
- tsc 验证:10s
- 截图验收:30s
你想怎么走?
A)我推倒重来:把现有 fix 流程改成上面的新路线(保留截图模块作为验收,砍掉 LLM 看图)
B)渐进改良:先加 sync-props 脚本和 tsc 反馈回路,截图喂图先留着观察一两轮再决定砍不砍
C)你来定:你觉得视觉对齐这件事到底要不要追求 < 1% diff?这是路线分叉的关键。如果你只要求"看起来差不多",A 路线足够;如果你真要 < 1%,那只能放弃 LLM、人工设计 token。
我个人选 A,因为我现在能看到 LLM 在编 UniInputEvent 这种事,这种错误不会因为多跑几轮而消失——它是模型能力边界,不是 prompt 问题。
你定个方向,我马上开干。
uniapp x 同步模式
2026-06-15
/uniapp-x-components 这里有一些 uniapp x 的组件,但是 cli 模式没法直接运行。所以想把这个项目当作发 npm 包的工具,然后通过脚本同步到 /tdesign-uniapp-x-starter-hx 这个项目中。也就是 这个项目的 uniappx组件是源,改了后,在 tdesign-uniapp-x-starter-hx 中调试。
另外,之前做非uniappx ,也就是uniapp组件的时候,已经有一套同步机制了,npm run uniapp -- run dev, npm run uniapp -- run init 就有
架构方案分析
✅ 你这个架构合理,而且已经走在正确的路线上了
我看了一下 packages/uniapp-x-components 的当前状态,发现你自己已经把这套机制搭了 80%:
cli/sync-to-hbuilderx.mjs已经实现了完整的"源 → HBuilderX 项目"同步链路.sync-targets.json多目标配置(gitignored,每台机器自己配)pnpm sync/pnpm sync:watch/pnpm sync:dry三种模式齐了- 而且做了关键的
.ts → .uts/.vue → .uvue路径与扩展名映射
所以你问的不是 "要不要这么做",而是 "这个架构在 uni-app x 生态里是不是主流"。答案是:是主流,且是被迫只能这么做。
🎯 为什么这个架构是合理的(甚至是唯一选择)
1. uni-app x 的硬约束:.uvue 离不开 HBuilderX
| 限制 | 后果 |
|---|---|
.uvue 编译器闭源、只内嵌在 HBuilderX 里 | VSCode/cli 跑不起来真机 |
.uts 不是标准 TypeScript(语法子集 + 平台扩展) | 不能用 vitest/jest 直接跑 |
| Vue3 SFC 工具链(vite/volar)对 uvue 支持极弱 | 类型提示、单测、ESLint 都得绕路 |
→ 结论:必须把"开发包"和"运行/调试包"物理拆开。
2. tang-ui / FirstUI-uvue 都是这个思路
刚才看了下两个参考:
FirstUI-uvue:本身就是个完整的 HBuilderX 项目,组件 + demo 页面 + tabbar 全在一个仓里,没有"独立组件库 + 独立 starter"的拆分。胜在简单,输给可测试性。- tang-ui:相对工程化,有
eslint.config.mjs、vite.config.ts、tailwind、husky,但components/直接就在 HBuilderX 项目根下,也是单仓。
而你目前的方案 = tang-ui 的工程化 + Shadcn registry 分发 + sync-to-hbuilderx 双仓 = 更彻底的工程化。
3. 和你已有的非-x uniapp 同步机制一脉相承
npm run uniapp -- run dev 实际是 pnpm -C packages/tdesign-uniapp,那一套是根目录 monorepo 内 demo 项目的模式:组件在 packages/uniapp-components/,demo 在 packages/tdesign-uniapp/,靠 pnpm workspace 软链。
但 uniapp-x 没法走 workspace 软链——HBuilderX 不识别符号链接里的 uvue。所以你只能"复制 + 重写扩展名",也就是现在 sync-to-hbuilderx.mjs 干的事。
📐 推荐的最终架构
三个角色职责
| 仓 / 包 | 角色 | 必须有 |
|---|---|---|
packages/uniapp-x-components | 唯一可写源 + 测试 + 类型 + 文档 | .uvue、.vue 镜像、.ts、vitest spec、registry build |
tdesign-uniapp-x-starter-hx | 只读消费方 + demo pages + HBuilderX 真机调试 | components/ 全是 sync 出来的,不要手改 |
registry/*.json | 对外分发产物 | shadcn 兼容 schema |
⚠️ 几个建议(针对你现有方案的小优化)
1. starter-hx 的 components/ 目录 .gitignore
既然内容是脚本生成,starter-hx 可以选两条路:
- A. 不入 git:
.gitignore加components/,开发者第一次 clone 后必须先在主仓跑pnpm sync才能开 HBuilderX。推荐。 - B. 入 git 但禁止手改:在 components/ 顶部加
// AUTO-GENERATED FROM @tdesign/uniapp-x, DO NOT EDIT头注释,pre-commit 校验未篡改。
2. 在 starter-hx 里加一个反向校验 hook
防止有人"在 starter-hx 里直接改了 uvue 但忘了同步回源仓"——
# starter-hx 的 pre-commit
diff -r components/ ../tdesign-miniprogram/packages/uniapp-x-components/dist-hx/ || exit 1
3. sync 脚本可以增加"反向初始化"模式
类似你说的 npm run uniapp -- run init:在 starter-hx 里第一次启动时,跑一个脚本,自动从源仓 pnpm sync 一次。可以在 starter-hx 的 package.json 加:
"scripts": {
  "init": "node ../tdesign-miniprogram/packages/uniapp-x-components/cli/sync-to-hbuilderx.mjs",
  "dev": "pnpm init && echo '请在 HBuilderX 中打开本目录运行'"
}
4. 把现在的 .sync-targets.json 升级支持别名
当前每台机要写绝对路径。可以考虑读环境变量 TDESIGN_UNIAPP_X_STARTER 兜底,CI 上更顺手。
5. registry 和 sync 是两条互补路径,不冲突
- sync:开发期,本地 HBuilderX 调试
- registry:发布期,让别人
npx shadcn add @tdesign/uniapp-x/button拷贝过去
两条都保留,不要二选一。
🆚 备选方案对比
| 方案 | 优点 | 缺点 | 评价 |
|---|---|---|---|
| 现方案:源 + sync + starter | 工程化好、可测试、可发包、双 IDE 协作 | 需要维护 sync 脚本 | ✅ 推荐 |
| 单仓(FirstUI 模式) | 零配置 | 不能跑 vitest、不能发 npm、组件和 demo 耦合 | ❌ 不适合一个组件库 |
| pnpm workspace 软链 | 改了立即生效 | HBuilderX 跟随软链有大量 bug(uvue 编译丢失、类型异常) | ❌ 实测不行 |
| Git submodule starter-hx → 源仓 components | 版本可追 | 反向依赖、修改流程别扭 | ❌ 反人类 |
只发 npm 包,让 starter-hx pnpm i 装 | 干净 | uvue 在 node_modules 里 HBuilderX 解析有坑、调试代码不能改了立刻看到 | ⚠️ 发布后 OK,开发期不行 |
🧭 一句话结论
你这个架构合理且最佳,实质上就是"uni-app x 版的 m2w(miniprogram-to-web)双仓模式"。继续按现在的 sync-to-hbuilderx.mjs 走,把 .sync-targets.json 指到 /Users/guowangyang/Documents/github/tdesign-uniapp-x-starter-hx,然后 pnpm sync:watch 即可——和你旧的 npm run uniapp -- run dev 体验等价,且更适配 uni-app x 的生态约束。
要不要我帮你:
- 把
.sync-targets.example.json的 root 改成 starter-hx 的实际路径并生成.sync-targets.json? - 在 starter-hx 加一个
npm run init脚本反向触发同步? - 给 starter-hx 加 components/ 的
.gitignore和 README 说明"不要直接改这里"?
告诉我哪一项需要动手,我再操作(按规则避免擅自修改)。
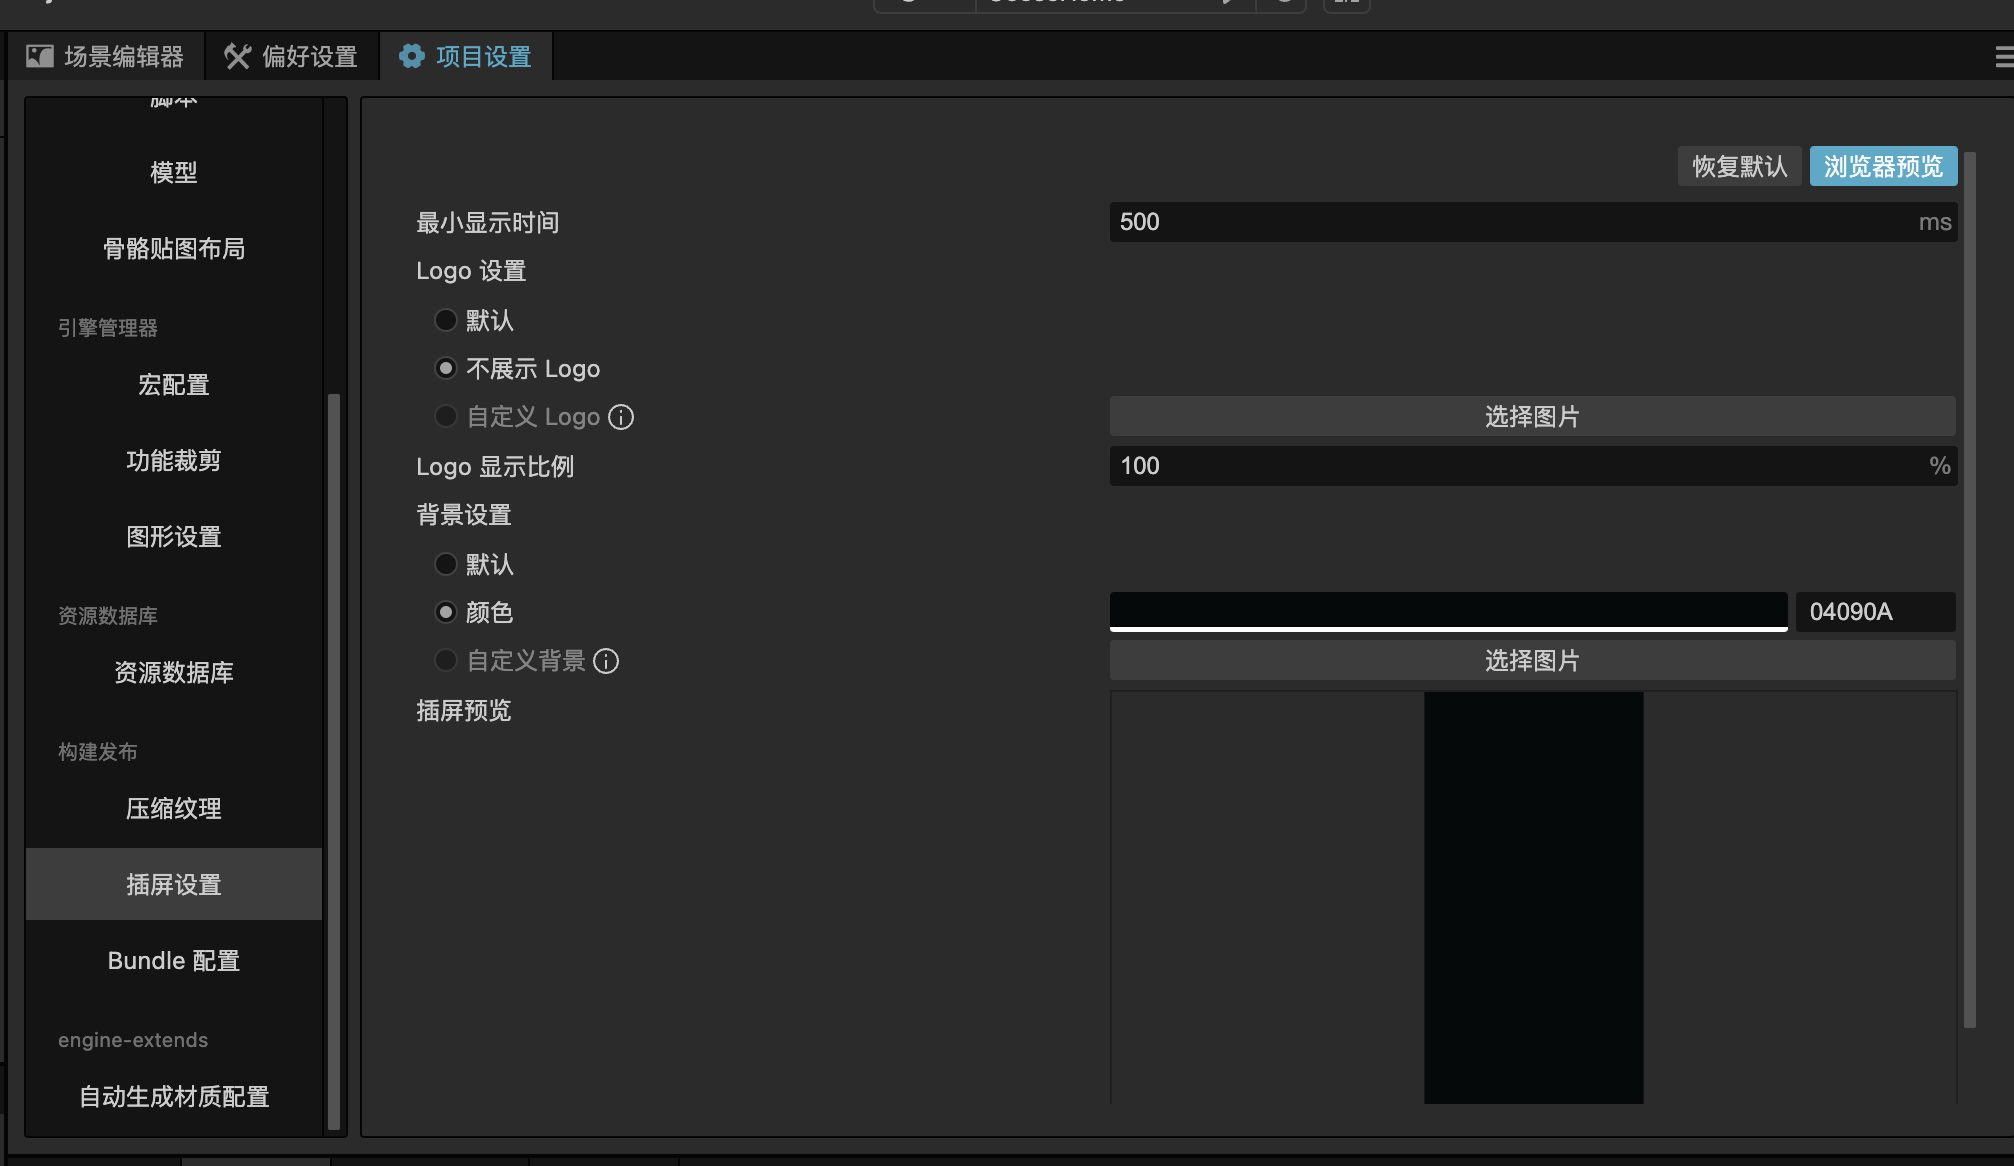
cocos 自定义首屏 logo
2026-06-15
项目 - 项目设置 - 插屏设置,这里可以去掉 cocos 的首屏 logo,或者自定义 logo
leetcode/02-array-string/15-min-subarray-len.js 和 leetcode/05-dp/02-max-subarray.js 有啥区别
2026-06-15
这两道题虽然都涉及连续子数组,但本质差别很大:
对比总结
| LeetCode 209 最小子数组长度 | LeetCode 53 最大子数组和 | |
|---|---|---|
| 目标 | 找和 ≥ target 的最短子数组长度 | 找和最大的子数组的和 |
| 返回值 | 长度 | 和 |
| 数据约束 | 全是正整数 | 可含负数 |
| 核心方法 | 滑动窗口 | 动态规划(Kadane) |
| 为什么能用该方法 | 元素全正 → 窗口扩大时 sum 单调递增,可以贪心收缩左边界 | 含负数无法用滑动窗口,需要 DP 决策「接上前面 vs 重新开始」 |
关键区别
滑动窗口 vs DP
- 209 的元素全为正,所以右移 right 时 sum 只增不减,满足条件后收缩 left 即可 → 典型滑动窗口。
- 53 含负数,窗口和不单调,无法用滑动窗口;用 Kadane 算法逐元素决策「是否从当前位置重新开始」。
优化的维度不同
- 209 优化的是长度(找最短的满足条件的窗口)。
- 53 优化的是和(找和最大的子数组)。
判断逻辑
- 209:
while (sum >= target)时缩窗,记录最小长度。 - 53:
curr = max(curr + nums[i], nums[i]),每步更新全局最大值。
- 209:
简单记:209 是"定和求最短长度",53 是"不定长求最大和"。
uniapp Vue3 组件多根问题
2026-06-13
⚠️ [Vue warn]: Extraneous non-props attributes (id) were passed to component but could not be automatically inherited because component renders fragment or text root nodes.
原因:调用栈 <Index> → <AsyncComponentWrapper> → <PageBody> → <Page>。uni-app 内部的 Page 组件给页面注入了一个 id 属性,但 vue3 透传需要单根节点;而我上一轮把 user/base 页的外层 <view :class :data-theme> 包裹去掉后,模板变成了多根:
<NavBar />
<view class="home-container">...</view>
<CustomTabBar />
<ActivityFilterPopup />
vue 不知道把 id 透传到哪个根上,于是警告。
修复:恢复一个简单的单根 <view> 包裹(不带 class/data-theme,纯结构作用),把所有顶层节点包进去。
user/index.vue整体重写 template,最外层单根<view>包住 NavBar、user-page、CustomTabBarbase/index.vue在最外层加单根<view>包住 NavBar、home-container、CustomTabBar、ActivityFilterPopup
验证 chat-markdown 表格的横向滚动
2026-06-12
const markdownData = `
**普通表格**

| 左对齐     | 居中对齐 | 右对齐 | 内容 |
| :--------- | :------: | -----: | ----- |
| 单元格     |  单元格  | 单元格 | 单元格 |
| 长文本示例 | 长文本示例长文本示例长文本示例 |   $100 | 文本内容 |
| 文本示例   | 文本内容 | $100 |  文本内容 |

**超宽表格(可横向滚动)**

| 城市 | 销售额(万元) | 同比增长 | 环比增长 | 客单价 | 复购率 | 备注信息 |
| :--- | -----------: | :------: | :------: | -----: | -----: | :------- |
| 北京海淀 | 12345.67 | +18.5% | +3.2% | 256.78 | 42.3% | 一线核心商圈 |
| 上海浦东新区 | 23456.78 | +22.1% | +5.7% | 312.45 | 48.6% | 高端写字楼集群 |
| 广州天河 | 9876.54 | +12.3% | +1.8% | 198.32 | 38.1% | 老牌商业区 |
| 深圳南山 | 18765.43 | +25.6% | +6.1% | 289.67 | 45.9% | 科技创新中心 |
`;
验证 image-viewer 组件的 preventScrollThrough 属性
2026-06-12
<!--
  [临时验证] preventScrollThrough 属性
  使用步骤:
   1. 滚动整个页面,让 ActionSheet 触发按钮位于屏幕中间或者上半部分
   2. 依次点击下方三个按钮,弹出 ActionSheet 后,把手指放在【遮罩层(半透明黑色背景)】上左右/上下滑动
   3. 对比:
        - true :底层页面不会跟着动(防止穿透 ✅)
        - false:底层页面会跟着滑动(穿透了 ❌,对照组)
        - 透传 popupProps.preventScrollThrough=false:组件仍优先取自身 preventScrollThrough,
          可对比验证 popup 的 prevent-scroll-through 是否被 actionSheet 透传/覆盖。
   4. 验证完毕后,直接删除本 demo 文件 + 删除 _example/action-sheet.vue 中临时验证区块即可。
-->
<template>
  <view>
    <!-- 上方占位长内容,制造可滚动的页面 -->
    <view class="filler">
      <view
        v-for="i in 30"
        :key="i"
        class="filler-line"
      >
        占位内容 {{ i }} —— 用于让页面可上下滚动,方便验证遮罩层是否阻止穿透
      </view>
    </view>

    <t-action-sheet
      :visible="visible"
      :prevent-scroll-through="preventScrollThrough"
      :popup-props="popupProps"
      :items="items"
      cancel-text="取消"
      @selected="onSelected"
      @close="onClose"
      @cancel="onClose"
    />

    <t-button
      size="large"
      variant="outline"
      block
      theme="primary"
      @click="open(true)"
    >
      preventScrollThrough = true(默认,应阻止穿透 ✅)
    </t-button>

    <t-button
      size="large"
      variant="outline"
      block
      theme="warning"
      @click="open(false)"
    >
      preventScrollThrough = false(穿透 ❌,对照组)
    </t-button>

    <t-button
      size="large"
      variant="outline"
      block
      theme="default"
      @click="openWithPopupProps()"
    >
      自身 true + popupProps.preventScrollThrough=false(透传场景)
    </t-button>

    <!-- 下方占位长内容 -->
    <view class="filler">
      <view
        v-for="i in 30"
        :key="i"
        class="filler-line"
      >
        占位内容 {{ i + 30 }}
      </view>
    </view>
  </view>
</template>

<script>
import TActionSheet from '@tdesign/uniapp/action-sheet/action-sheet.vue';
import TButton from '@tdesign/uniapp/button/button.vue';

export default {
  components: {
    TButton,
    TActionSheet,
  },
  data() {
    return {
      visible: false,
      preventScrollThrough: true,
      popupProps: {},
      items: ['选项一', '选项二', '选项三'],
    };
  },
  methods: {
    open(prevent) {
      this.preventScrollThrough = prevent;
      this.popupProps = {};
      this.visible = true;
      console.log('[ActionSheet] preventScrollThrough =', prevent);
    },
    openWithPopupProps() {
      this.preventScrollThrough = true;
      this.popupProps = { preventScrollThrough: false };
      this.visible = true;
      console.log('[ActionSheet] self=true, popupProps.preventScrollThrough=false');
    },
    onSelected(e) {
      console.log('[ActionSheet] selected:', e);
      this.visible = false;
    },
    onClose() {
      this.visible = false;
    },
  },
};
</script>

<style lang="less" scoped>
.filler {
  padding: 16rpx 0;
}
.filler-line {
  padding: 24rpx 32rpx;
  font-size: 28rpx;
  color: #888;
  border-bottom: 1rpx solid #eee;
}
</style>
删除多余的 pages
2026-06-12
[...document.querySelectorAll('tr')]
  .map(item => item.querySelectorAll('td')[0])
  .filter(Boolean)
  .map(item => item.innerText.trim())
  .filter(item => item.startsWith('pmd-ai-e2e-') && item!== 'pmd-ai-e2e.pages.woa.com')
2的n次方和n的阶乘,哪个大
2026-06-11
n! 比 2ⁿ 大(当 n 足够大时)。
直观对比
| n | 2ⁿ | n! |
|---|---|---|
| 2 | 4 | 2 |
| 3 | 8 | 6 |
| 4 | 16 | 24 ← 从这里开始 n! 超过 2ⁿ |
| 5 | 32 | 120 |
| 10 | 1,024 | 3,628,800 |
| 20 | ~10⁶ | ~2.4×10¹⁸ |
为什么
把两者都写成连乘的形式:
- 2ⁿ = 2 × 2 × 2 × ... × 2(n 个 2 相乘)
- n! = 1 × 2 × 3 × ... × n(从 1 乘到 n)
当 n ≥ 4 时,n! 的大部分因子(3, 4, 5, ..., n)都比 2 大,所以 n! 增长远快于 2ⁿ。
增长率排序
常见复杂度从小到大:
O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(2ⁿ) < O(n!) < O(nⁿ)所以全排列 O(n × n!) 比子集 O(n × 2ⁿ) 慢得多,这也符合直觉——n 个元素的排列数 n! 远多于子集数 2ⁿ。
子集问题时间复杂度 O(n × 2ⁿ) 的推导
2026-06-11
1. 子集总数
对于 n 个元素,每个元素有「选」或「不选」两种状态,所以子集总数 = 2ⁿ。
以 [1,2,3] 为例:2³ = 8 个子集。
2. 递归树的结构
                  []
          /        |        \
        [1]       [2]       [3]
       /   \       |
    [1,2]  [1,3] [2,3]
      |
[1,2,3]每个节点都是一个合法子集,所以树的节点总数 = 2ⁿ。
3. 每个节点的开销
每进入一次 backtrack,都执行 result.push([...path]),拷贝当前 path。
path 的平均长度是多少?所有子集的元素总数 = Σ(k=0 到 n) k × C(n,k) = n × 2ⁿ⁻¹。
所以平均每次拷贝长度 = n/2,量级为 O(n)。
4. 汇总
| 部分 | 次数 | 单次开销 | 小计 |
|---|---|---|---|
| backtrack 调用 | 2ⁿ | O(1)(循环本身) | O(2ⁿ) |
| 拷贝 path 到结果 | 2ⁿ | 平均 O(n/2) → O(n) | O(n × 2ⁿ) |
主导项是拷贝操作,总时间复杂度 = O(n × 2ⁿ)。
5. 直觉理解
输出共 2ⁿ 个子集,所有子集的元素总数为 n × 2ⁿ⁻¹,光是写出所有答案就需要 O(n × 2ⁿ) 时间,这就是下界。
6. 对比全排列
| 问题 | 结果数 | 每个结果长度 | 总复杂度 |
|---|---|---|---|
| 全排列 | n! | n | O(n × n!) |
| 子集 | 2ⁿ | 平均 n/2 | O(n × 2ⁿ) |
两者的模式一样:结果数 × 单个结果长度。
全排列时间复杂度 O(n × n!) 的推导
2026-06-11
1. 递归树的结构
以 [1,2,3] 为例,回溯形成一棵决策树:
第 0 层:n = 3 个分支选择
第 1 层:n-1 = 2 个分支选择
第 2 层:n-2 = 1 个分支选择(叶子节点)
2. 计算总节点数(即 backtrack 调用次数)
每层的节点数:
- 第 0 层:1 个节点,产生 n 个分支
- 第 1 层:n 个节点,每个产生 n-1 个分支
- 第 2 层:n×(n-1) 个节点
- ...
- 第 k 层:n!/(n-k)! 个节点(即 P(n,k))
总节点数 = Σ(k=0 到 n) n!/(n-k)! = n! × Σ(k=0 到 n) 1/k!
由于 Σ(1/k!) 趋近于 e ≈ 2.718,所以总调用次数 ≈ e × n!,量级仍是 O(n!)。
3. 每个叶子节点的额外开销
到达叶子时执行 result.push([...path]),拷贝长度为 n 的数组,开销 O(n)。
叶子节点恰好有 n! 个(就是全排列的个数)。
4. 汇总
| 部分 | 次数 | 单次开销 | 小计 |
|---|---|---|---|
| 非叶节点的循环 + 选择/撤销 | O(n!) | O(1) | O(n!) |
| 叶子节点拷贝结果 | n! | O(n) | O(n × n!) |
主导项是叶子节点的拷贝,因此总时间复杂度 = O(n × n!)。
5. 直觉理解
你最终输出了 n! 个排列,每个排列长度为 n,光是写出所有答案就需要 O(n × n!) 的时间,这是下界,算法不可能比这更快。
所以代码注释里写的 O(n × n!) 就是这么来的。
微信安全防护
2026-06-11
微信安全防护: https://developers.weixin.qq.com/miniprogram/security/gateway/config/security.html
综合账号身份、设备、用户行为特征、环境等小程序场景下多重维度数据分析。
可以接入微信安全插件,他会给出风险等级和当前设备登录当前小程序的UV数量,就是看这个设备是不是专门用来刷的,可以根据风险等级进行相应的验证码、短信验证。
对比清晰模式和庞杂模式
2026-06-10
在项目上完全胜任的成员可能处在庞杂的认知模式下(Complicated),他们完成任务的行为是:感知(理解用户故事的上下文,以及验收条件)- 分析(按照测试工序指引,分解任务)- 响应(依据任务列表逐步完成工作)。
项目上不完全胜任的成员可能处于复杂的认知模式下(Complex),他们完成任务的行为是:探测(尝试 spike 一下故事卡中某些不清楚的地方)- 感知(按照得到的结果,重新理解要如何完成整张卡片)- 响应(逐步试错,完成功能)
而刚毕业没有什么编程经验的成员,可能完全就是混乱模式了。他们甚至不会仔细辨别到底要做什么功能,就被巨大的恐慌驱动,冲过去写代码了。那么带来的自然是大量的返工和修改。
对比清晰模式和庞杂模式的区别,清晰模式的关键是分类(categorize),庞杂模式的关键是分析(analyze)。那么这句是什么意思呢?其实是说我们检查软件质量时,主要应该依赖自动化测试,只有在极少的情况下,才需要手动测试。
CI/CD
2026-06-10
持续构建发布、持续质量保障(eslint/ts)、持续自动化协作(白名单审核、pmd-mcp更新)、持续运维和监控(磁盘)、持续安全治理(审核)
CI 和 CD 的区别
2026-06-10
一、字面定义
| 缩写 | 全称 | 中文 |
|---|---|---|
| CI | Continuous Integration | 持续集成 |
| CD | Continuous Delivery / Continuous Deployment | 持续交付 / 持续部署 |
注意 CD 有两个含义,很多人混淆就在这里。
二、各自负责什么
CI(持续集成)—— 解决"代码合得进去吗?"
开发者每次提交代码后,自动完成:
拉代码 → 安装依赖 → Lint → 单元测试 → 构建产物目标:尽早发现集成冲突和质量问题,保证 main 分支随时是绿的。
CD - Continuous Delivery(持续交付)—— 解决"代码随时能发吗?"
在 CI 基础上,自动把构建产物发布到类生产环境(预发/灰度/staging),并准备好可发布的制品。
关键:最后上生产那一步是手动点按钮(人为审批)。
CD - Continuous Deployment(持续部署)—— 解决"代码自动上线"
比持续交付更激进一步:通过所有自动化测试后,直接自动发到生产,全程无人工干预。
三、流程对比图
三者关系:CI ⊂ Continuous Delivery ⊂ Continuous Deployment(后者包含前者)。
四、本质区别(核心)
| 维度 | CI | CD (Delivery) | CD (Deployment) |
|---|---|---|---|
| 关注点 | 代码质量 | 发布能力 | 发布动作 |
| 解决的问题 | "合并不冲突、测试通过" | "随时可发布" | "随时已发布" |
| 产物终点 | 构建产物(artifact) | 预发/staging 环境 | 生产环境 |
| 人工干预 | 无 | 有(决定何时上线) | 无 |
| 价值对象 | 开发团队 | 业务/产品决策 | 终端用户 |
| 失败的代价 | 重新提交即可 | 回滚 staging | 影响线上用户 |
一句话本质区别
- CI 关心"代码能不能被信任"(质量门禁)
- CD 关心"产品能不能被交付"(部署管道)
CI 是面向代码的工程实践,CD 是面向价值流的业务实践。CI 让你"敢合代码",CD 让你"敢发版本"。
五、结合你项目的实例
看你 bk 目录里的脚本就是典型 CI/CD 流水线拆分:
| 文件 | 阶段 | 类型 |
|---|---|---|
bk/12.npm-publish/3.auditor.js(审核) | 代码合并前检查 | CI |
bk/12.npm-publish/4.check-audit.js | 测试 / 构建 | CI |
bk/4.cos-all-in-one/5.upload-to-cos.js(上传 CDN) | 产物分发到 CDN | CD |
bk/3.gray-publish/*(灰度发布) | 灰度上线、人工确认 | CD-Delivery |
bk/1.all-in-one-publish.backend/*(k8s 镜像构建+部署) | 自动部署到 BCS | CD-Deployment |
bk/14.HoK 商户赛部署(用 BCS 模板发布) | 部署生产环境 | CD |
可以看到:CI 主要是 lint/test/build/audit;CD 是 cos 上传、镜像 push、bcs 滚动更新这些"动产物"的事情。
六、容易混淆的点
- "自动化 ≠ CI/CD":写个脚本一键发布只是自动化,频率高 + 触发自动 + 有质量门禁才叫 CI/CD。
- CI 不是测试:CI 包含测试,但本质是集成——多人代码频繁合到主干。
- 没有 CI 就谈 CD 是耍流氓:CD 必须建立在可靠的 CI 之上,否则只是把 bug 更快地推给用户。
- DevOps ≠ CI/CD:CI/CD 是 DevOps 的工程实践之一,DevOps 还包括监控、IaC、协作文化等。
如果只让我用一句话总结:
CI 是把代码持续地"集成进主干",CD 是把主干持续地"交付给用户"。前者保证写得对,后者保证发得快。
找到环的入口节点 这个不理解,为什么 fast 是 a+b+b+c
2026-06-10
图解 fast 走过的路径
先看链表结构:
head ——→ ... ——→ 入口 ——→ ... ——→ 相遇点 ——→ ... ——→ (回到入口)
|←———— a ————→|←—— b ——→|←———— c ————→|a:head 到环入口的距离b:环入口到相遇点的距离c:相遇点再走回环入口的距离- 环长 =
b + c
slow 走过的路径
slow 进入环后,还没走完一圈就会被 fast 追上(上面证明过),所以:
slow 走的距离 =
a + b
fast 走过的路径
fast 在 slow 进入环之前,已经在环里转了若干圈。关键点:
- fast 也走了
a步到达入口 - 然后在环里转,到相遇时 fast 走过的环内距离是
b + n圈
取最简情况 n=1(fast 比 slow 多走了恰好一圈环):
fast 走的距离 =
a + b + (b + c)=a + 2b + c
其中 (b + c) 就是多走的那一整圈环。
为什么是多走一圈?
因为 fast 速度是 slow 的 2 倍:
fast的距离 = 2 × slow的距离
a + 2b + c = 2(a + b)
解方程:
a + 2b + c = 2a + 2b
        c = a        ← 关键结论!
更严谨地说
如果 fast 多走了 n 圈(n ≥ 1):
fast = a + b + n(b + c)
2(a + b) = a + b + n(b + c)
a + b = n(b + c)
a = n(b + c) - b = (n-1)(b+c) + c
即 a = (n-1)圈 + c。
所以从 head 走 a 步 = 从相遇点走 c 步 + 转 (n-1) 整圈,最终都停在环入口。这就是为什么让两个指针分别从 head 和相遇点出发、各走一步,一定在入口相遇。
一句话总结
a + 2b + c 的含义是:走 a 步到入口 → 走 b 步到相遇点 → 继续走完环剩下的 c 步回到入口 → 再走 b 步到相遇点,即 fast 在环里多绕了一圈才和 slow 碰上。
lengthOfLIS2 详解——贪心 + 二分
2026-06-10
核心思想
我们维护一个辅助数组 tails,其中 tails[i] 表示:所有长度为 i+1 的递增子序列中,末尾元素的最小值。
为什么要"最小末尾"?因为末尾越小,后面能接上更大元素的机会就越大——这就是贪心策略。
tails 数组的关键性质
tails 始终是严格递增的。原因直觉上很好理解:更长的递增子序列,其末尾一定比更短的那个大。
算法流程
遍历 nums 中的每个 num,做一件事:在 tails 里二分查找第一个 ≥ num 的位置 l,然后 tails[l] = num。
这会产生两种情况:
| 情况 | 含义 |
|---|---|
l === tails.length | num 比 tails 所有元素都大,追加到末尾,LIS 长度 +1 |
l < tails.length | 替换 tails[l],让长度为 l+1 的子序列末尾变得更小(贪心优化),LIS 长度不变 |
用示例走一遍 [10, 9, 2, 5, 3, 7, 101, 18]
| 步骤 | num | 二分找到位置 l | 操作 | tails 状态 |
|---|---|---|---|---|
| 1 | 10 | 0(空数组) | 追加 | [10] |
| 2 | 9 | 0(9 < 10,替换) | 替换 | [9] |
| 3 | 2 | 0(2 < 9,替换) | 替换 | [2] |
| 4 | 5 | 1(5 > 2,追加) | 追加 | [2, 5] |
| 5 | 3 | 1(3 < 5,替换) | 替换 | [2, 3] |
| 6 | 7 | 2(7 > 3,追加) | 追加 | [2, 3, 7] |
| 7 | 101 | 3(101 > 7,追加) | 追加 | [2, 3, 7, 101] |
| 8 | 18 | 3(18 < 101,替换) | 替换 | [2, 3, 7, 18] |
最终 tails.length = 4,即 LIS 长度为 4。
二分部分逐行解释
function lengthOfLIS2(nums) {
  const tails = [];
  for (const num of nums) {
    let l = 0;
    let r = tails.length;       // 右边界是开区间
    while (l < r) {
      const m = (l + r) >> 1;   // 取中点
      if (tails[m] < num) l = m + 1;  // mid 太小,往右找
      else r = m;               // mid >= num,收缩右边界
    }
    tails[l] = num;             // l 就是第一个 >= num 的位置
  }
  return tails.length;
}这是标准的左边界二分(lower_bound):找到 tails 中第一个 ≥ num 的下标。
注意点
tails不是真正的 LIS 序列(只保证长度正确,元素可能被替换过)。- 时间复杂度 O(n log n):外层遍历 O(n),内层二分 O(log n)。
- 空间复杂度 O(n):
tails最长和nums等长。
JS 中的 >> 1
2026-06-10
>> 1 是位运算右移 1 位,等价于 除以 2 并向下取整(即 Math.floor(x / 2))。
在代码中的作用
const m = (l + r) >> 1;这里就是计算二分查找的中间下标:m = Math.floor((l + r) / 2)。
为什么用 >> 1 而不是 / 2?
- 性能微优:位运算比除法快(现代引擎差异极小,更多是习惯写法)
- 自动取整:
>> 1天然丢弃小数位,不需要额外调用Math.floor() - 避免浮点:
/ 2在 JS 中返回浮点数(如7 / 2 = 3.5),而>> 1直接得到整数3
几个例子
| 表达式 | 二进制过程 | 结果 |
|---|---|---|
6 >> 1 | 110 → 011 | 3 |
7 >> 1 | 111 → 011 | 3(向下取整) |
10 >> 1 | 1010 → 0101 | 5 |
总结:(l + r) >> 1 就是取 l 和 r 的中点,是二分查找的标准写法。
二叉树遍历
2026-06-10
前序:根→左→右(用于复制树、序列化) 中序:左→根→右(BST 中输出有序序列) 后序:左→右→根(用于删除树、计算表达式)
子集和全排列的关键区别
2026-06-10
- 全排列:每层都从 0 遍历,用 used 标记避免重选同一个元素
- 子集:通过 start 参数只往后选,保证 [1,2] 和 [2,1] 不会重复出现,且每进入一次函数就收集结果(因为任何长度都是合法子集)
searchLeftBound, 每次优先从左边判断,就会拿最左边的数字,这句话对吗
2026-06-10
这句注释不太准确,容易产生误导。
searchLeftBound 能找到最左边的 target,核心原因不是"优先从左边判断",而是:
当 nums[mid] >= target 时,不立即返回,而是收缩右边界 right = mid,继续往左搜索。
具体来说:
nums[mid] < target→left = mid + 1(排除 mid,往右找)nums[mid] >= target→right = mid(mid 可能是答案,但不排除左边还有更早的,所以继续往左逼近)
这个"找到了也不停,继续往左压缩"的行为,才是它能拿到最左边那个 target 的原因。
对比 searchRightBound,它把条件分界改为 nums[mid] <= target → left = mid + 1,即找到了也不停、继续往右压缩,所以拿到的是最右边。
建议把那行注释改为更准确的描述: 总结一下:
| 说法 | 正确性 |
|---|---|
| "优先从左边判断" → 拿最左边 | ❌ 不准确 |
找到 >=target 时不停,继续收缩右边界往左逼近 → 拿最左边 | ✅ 正确 |
关键区别在于 else { right = mid } 这一步——它让算法在"可能已经找到答案"时仍然不停下来,继续向左压缩搜索区间,直到区间为空,此时 left 就是第一个 >= target 的位置。