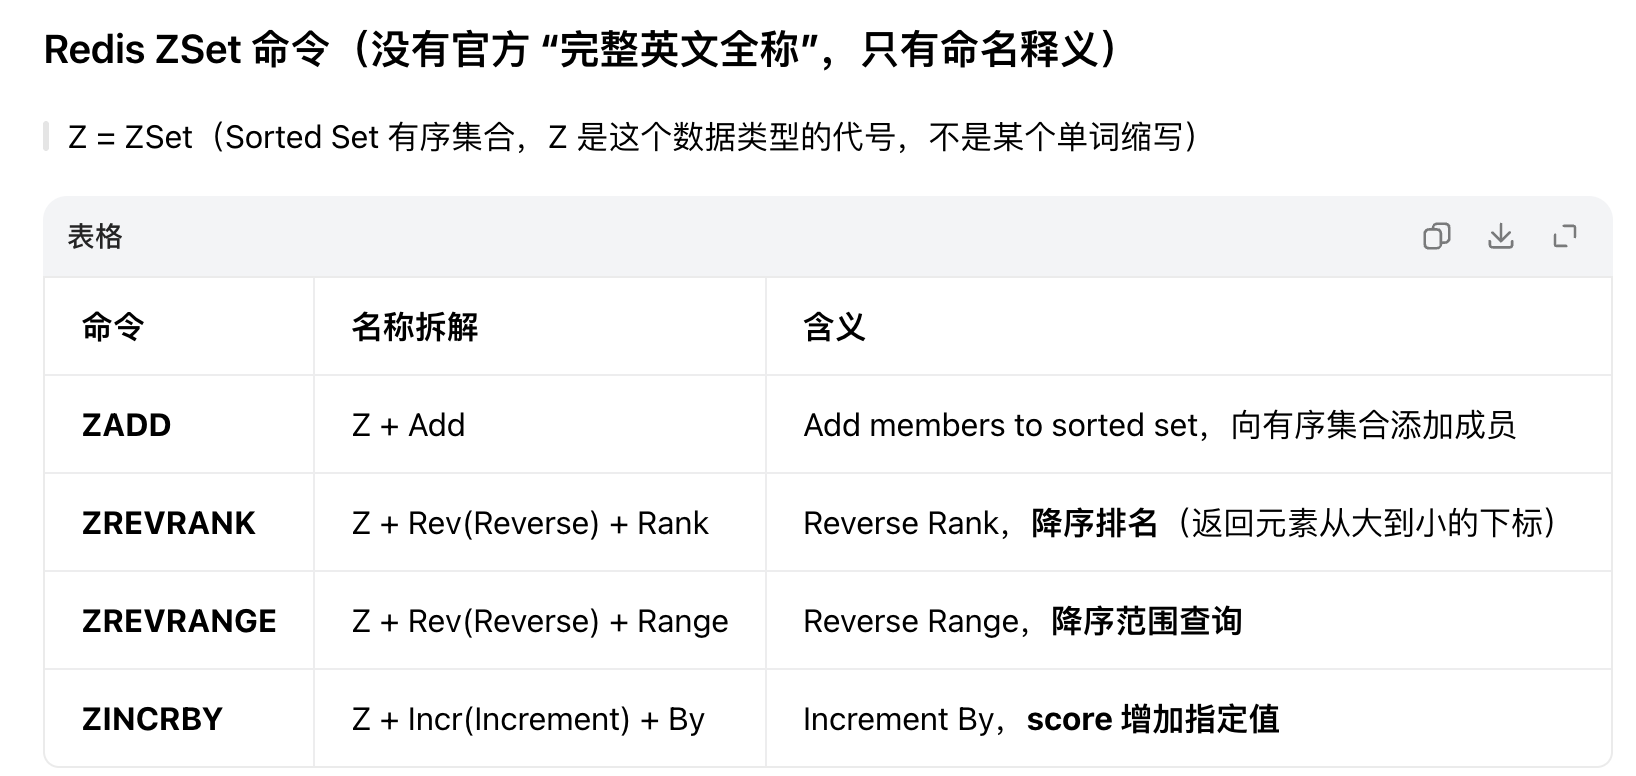
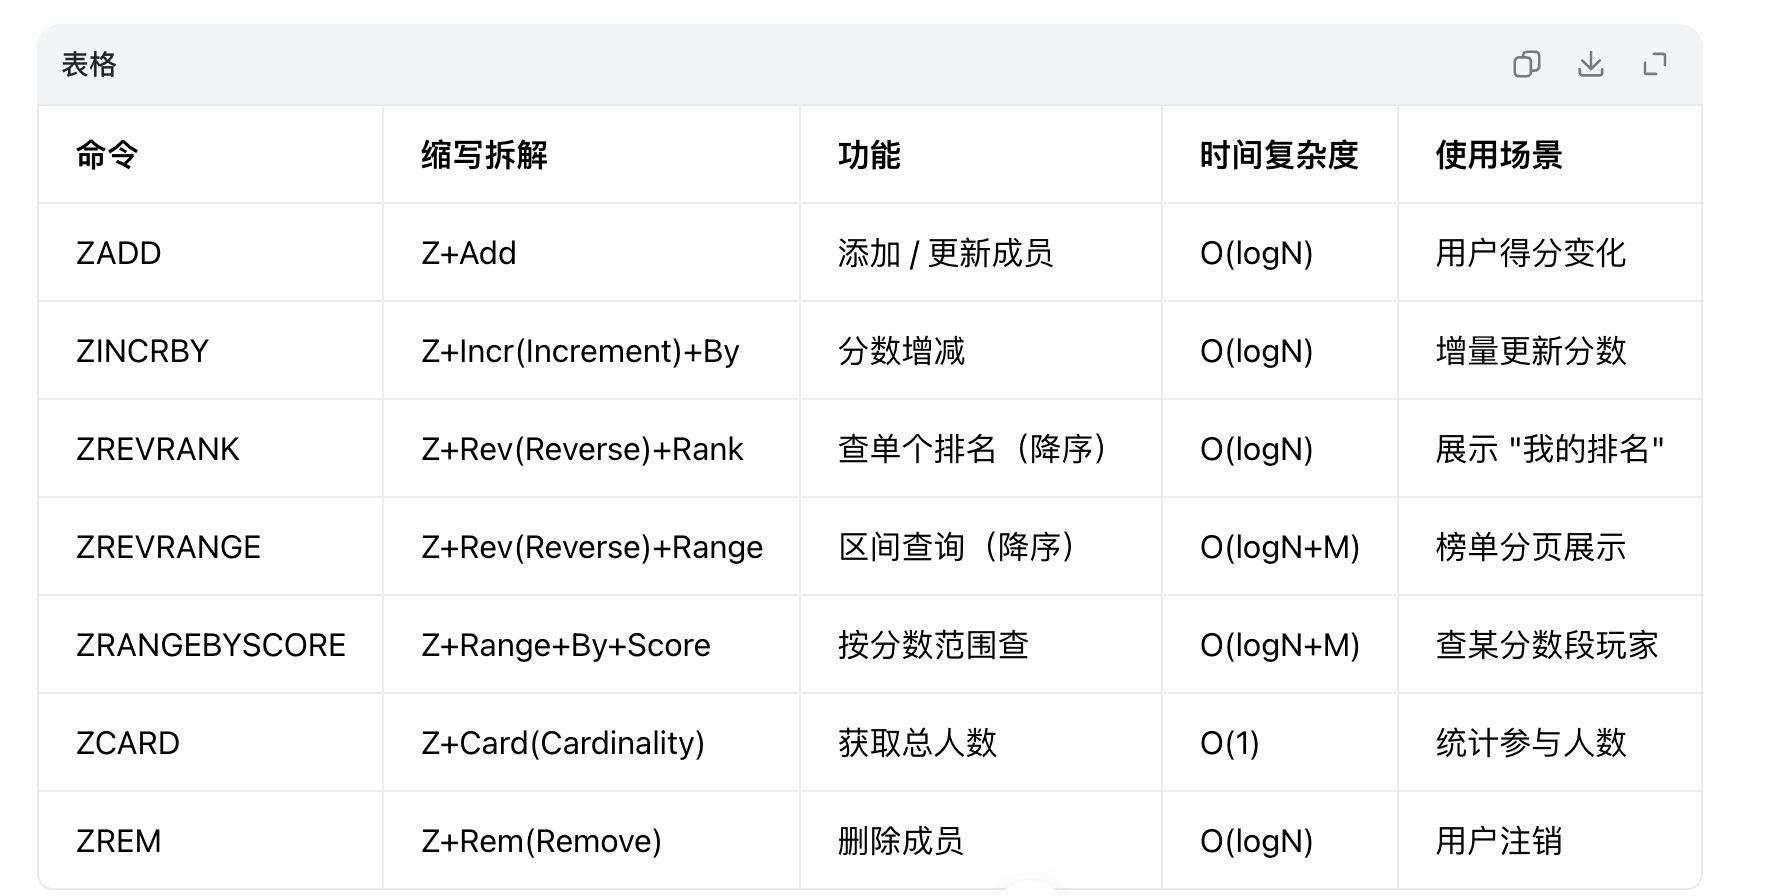
1. Redis 主从复制的实现原理是什么?
1.1. 核心要点
Redis 的主从复制,简单来说就是让从节点(Slave)认一个主节点(Master)做大哥,大哥有什么数据,小弟就跟着同步一份。这样既能做读写分离减轻大哥压力,也能在数据丢了时有个备份。
它的实现原理,可以分为三个阶段来讲:
1)第一阶段是:建立连接与全量同步
当从节点第一次连上主节点时,会发送 PSYNC 命令。因为是第一次,主节点会执行一次全量复制。
具体就是主节点会在后台生成一份 RDB 快照文件发给从节点,从节点拿到后先清空自己的旧数据,然后加载这份快照。
💡这里有个细节
在生成和发送快照的这段时间里,主节点是不会停止服务的,它会把这段时间新收到的写命令,先暂存在一个叫 Replication Buffer 的内存缓冲区里。等快照发完了,再把这个缓冲区里的命令发给从节点,这样就保证了数据不丢失。
2)第二阶段是:命令传播
全量同步完成后,主从之间就会建立一个长连接。以后主节点每收到一个写命令,就会异步地发送给从节点,从节点跟着执行就好了。这期间他们还会互相发心跳包(Ping/Ack)来确认对方还活着。
3)第三阶段是:断线重连与增量同步
网络总是不稳定的,如果从节点掉线了一小会儿又连上了,重新搞一次全量同步太浪费资源了。
所以 Redis 2.8 以后引入了增量同步。主节点内部有一个环形的缓冲区叫 repl_backlog_buffer(积压缓冲区)。
如果从节点连上来,告诉主节点:“我刚才读到偏移量 1000 了”,主节点一看积压缓冲区里 1000 之后的数据还在,就会只把断线期间这部分数据补发给从节点,这就叫增量复制。
但如果断线太久,缓冲区的数据被覆盖了,那就只能无奈地重新发起全量同步了。
具体流程图如下所示: 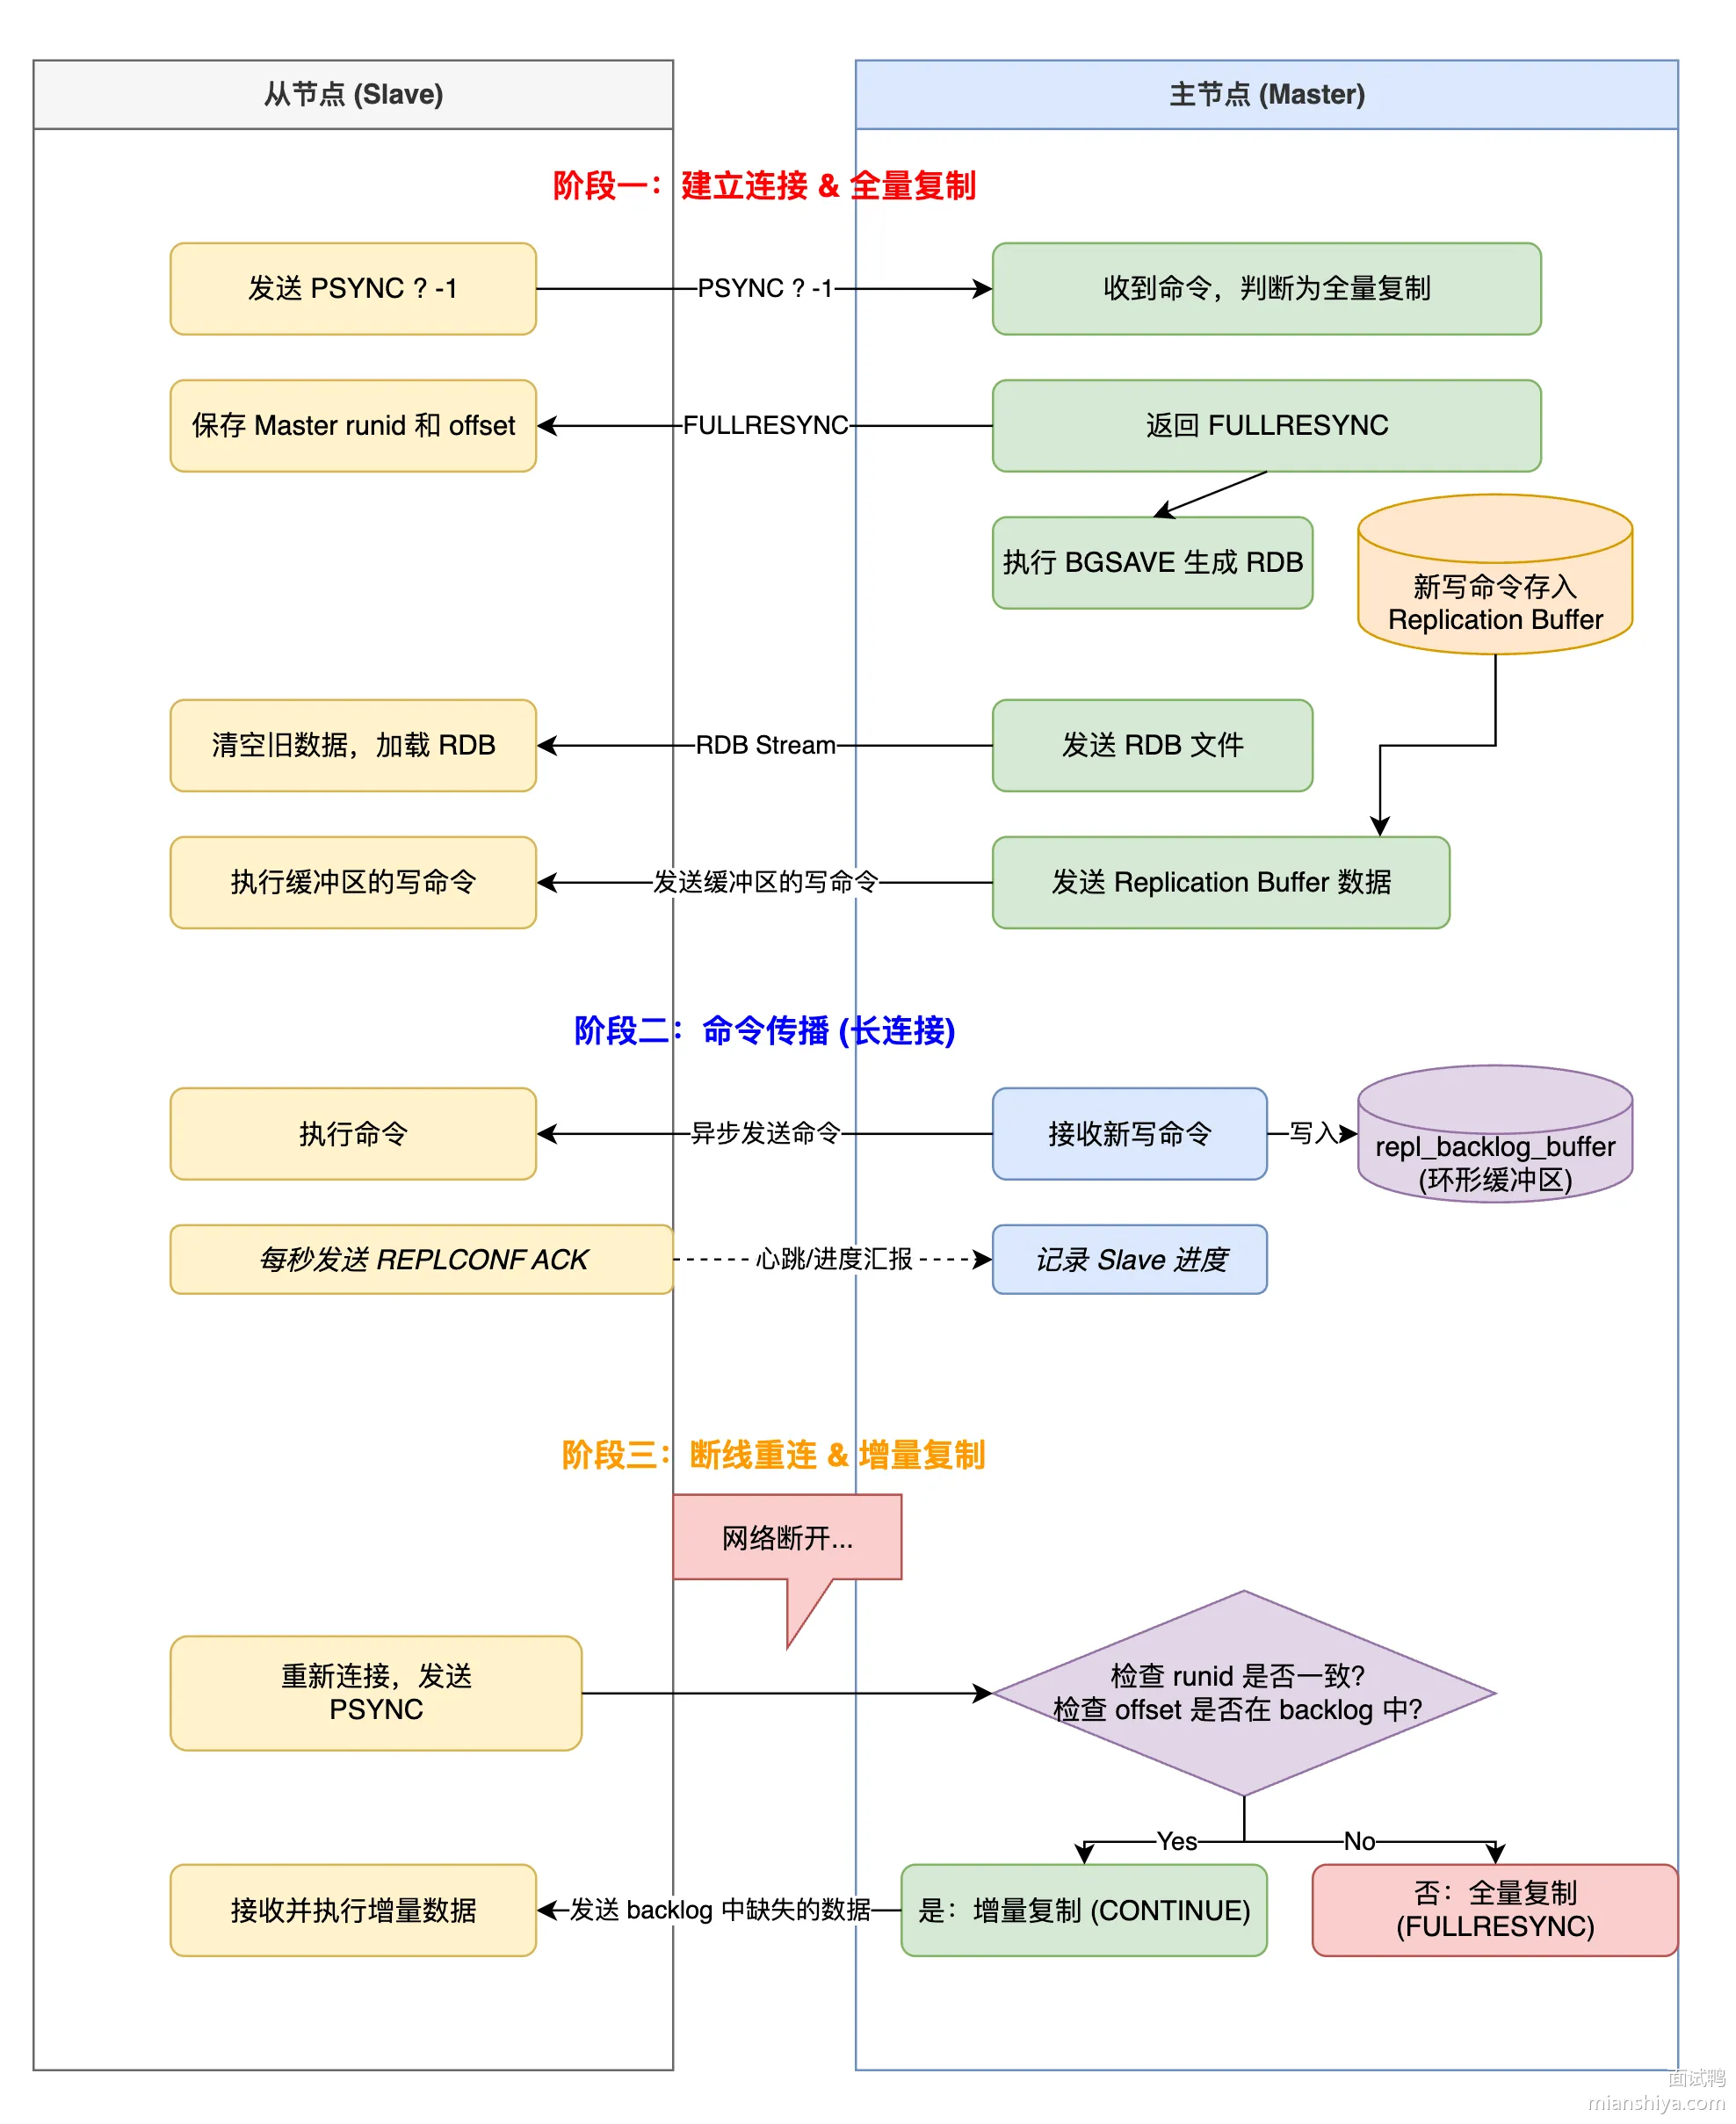
1.2. 扩展知识
1.2.1. Redis 主从架构
下图就是一个 Redis 主从架构图:
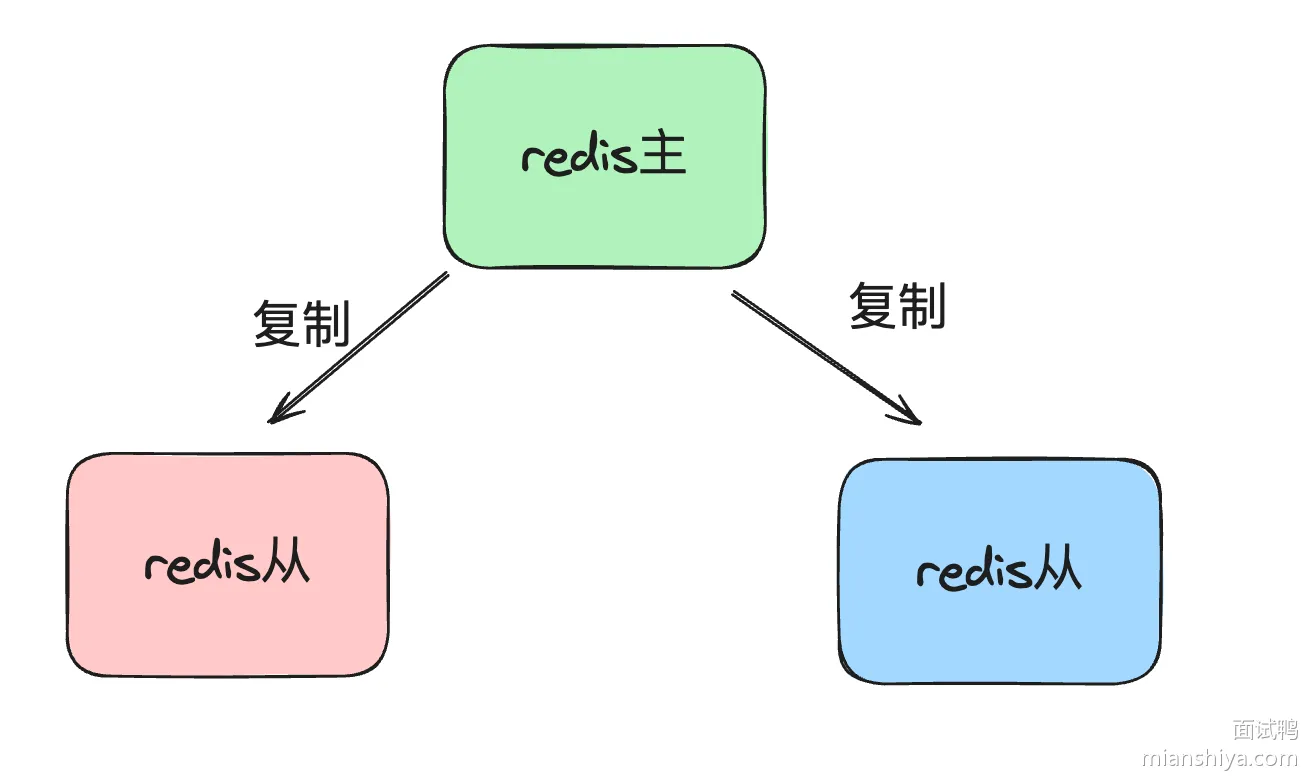
主从架构可以实现读写分离。写操作可以请求主节点,而读操作只请求从节点,这样就能减轻主节点的压力。
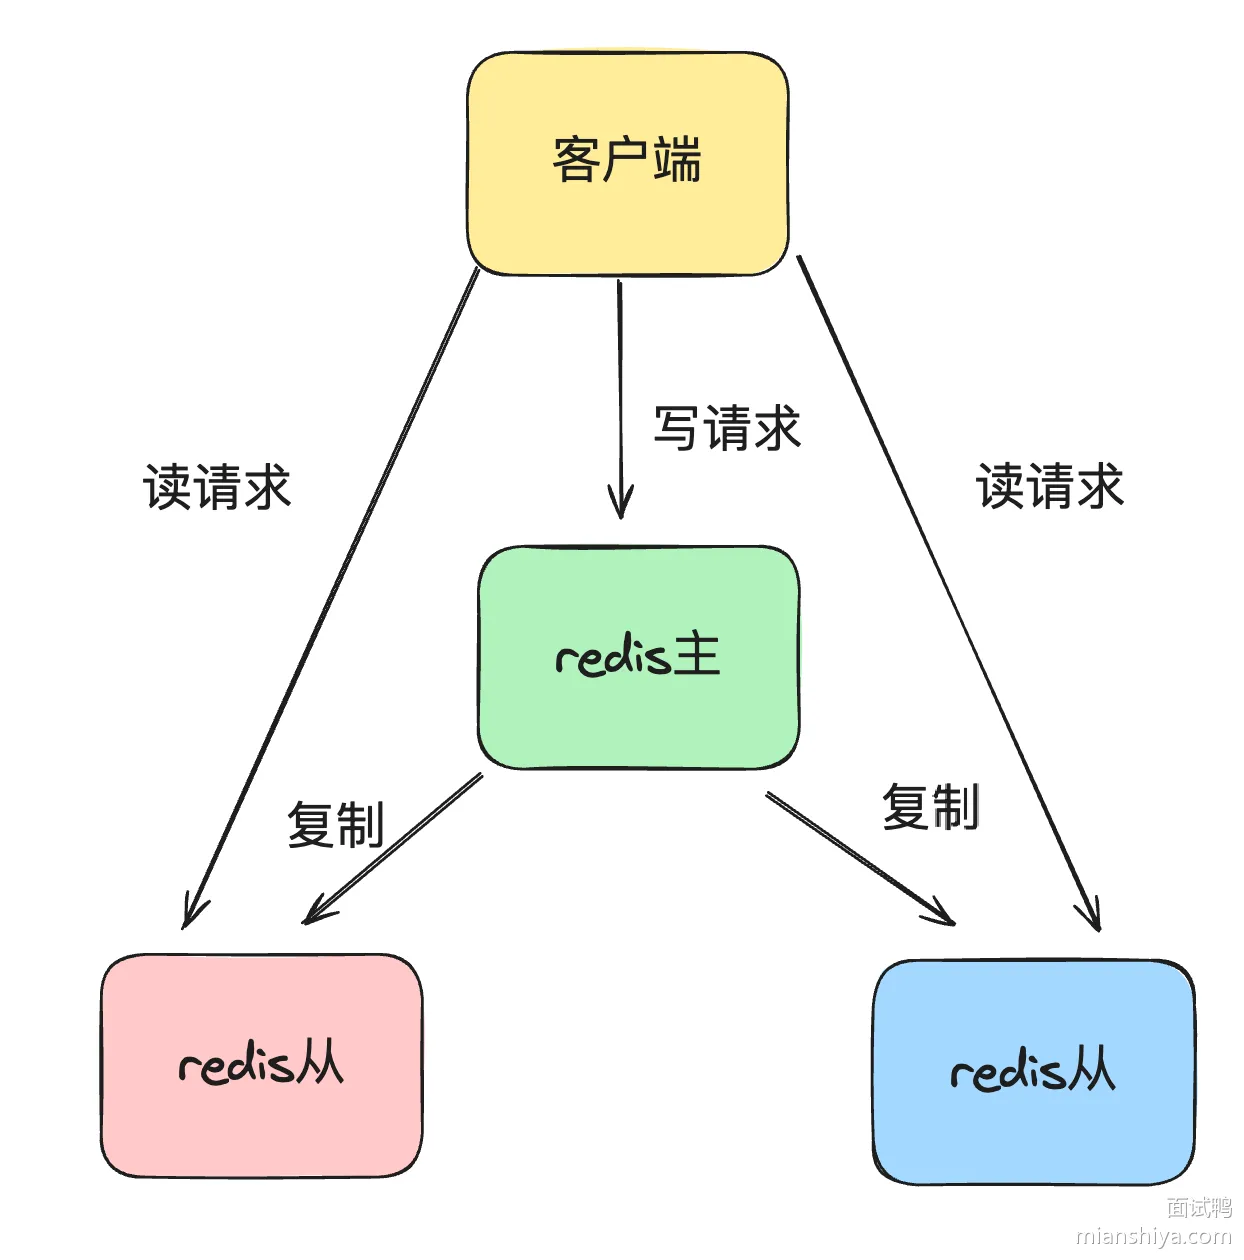
整个主从集群仅主节点可以写入,其它从节点都通过复制来同步数据,这样就能保证数据的一致性。并且对读请求分散到多个节点,提高了 Redis 的吞吐量,从一定程度上也提高了 Redis 的可用性。
1.2.2. 主从复制原理详解
Redis 之间主从复制主要有两种数据同步方式,分别是全量同步和增量同步。
1) 全量同步
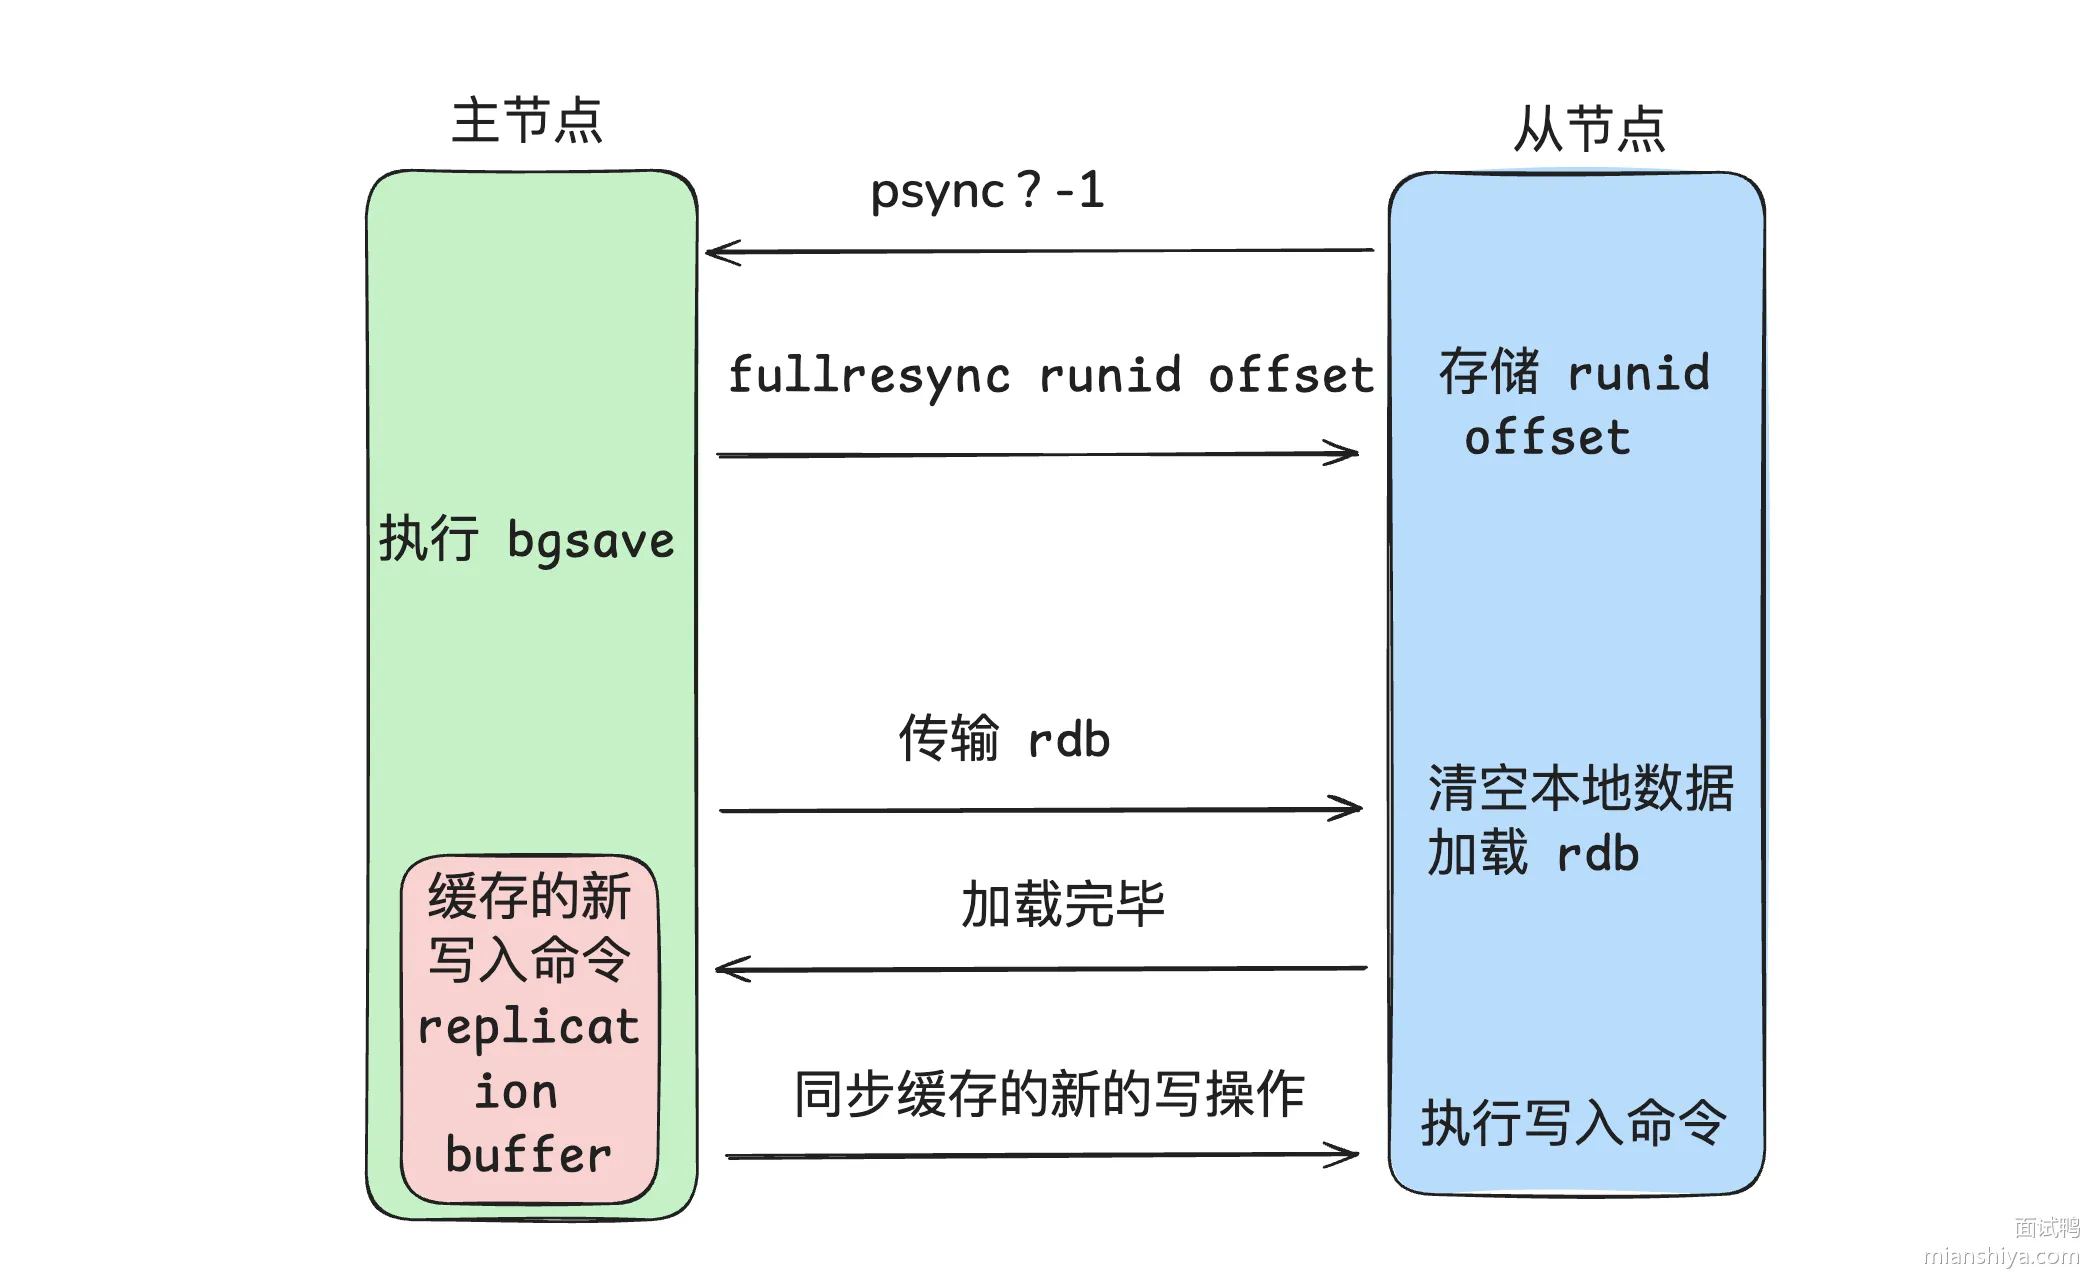
- runid 指的是主服务器的 run ID,从节点第一次同步不知道主节点 ID,于是传递 "?"。
- offset 为复制进度,第一次同步值为 -1。
文字版本的流程:
- 从节点发送
psync ? -1,触发同步。 - 主节点收到从节点的 psync 命令之后,发现 runid 没值,判断是全量同步,返回 fullresync 并带上主服务器的 runid 和当前复制进度,从服务器会存储这两个值。
- 主节点执行 bgsave 生成 RDB 文件,在 RDB 文件生成过程中,主节点新接收到的写入数据的命令会存储到
replication buffer中。 - RDB 文件生成完毕后,主节点将其发送给从节点,从节点清空旧数据,加载 RDB 的数据。
- 等到从节点中 RDB 文件加载完成之后,主节点将 replication buffer 缓存的数据发送给从节点,从节点执行命令,保证数据的一致性。
待同步完毕后,主从之间会保持一个长连接,主节点会通过这个连接将后续的写操作传递给从节点执行,来保证数据的一致。
2) 增量同步
主从之间的网络可能不稳定,如果连接断开,主节点部分写操作未传递给从节点执行,主从数据就不一致了。
此时有一种选择是再次发起全量同步,但是全量同步数据量比较大,非常耗时。因此 Redis 在 2.8 版本引入了增量同步(psync 其实就是 2.8 引入的命令),仅需把连接断开其间的数据同步给从节点就好了。
此时需要介绍下 repl_backlog_buffer。
repl_backlog_buffer 是一个环形缓冲区,默认大小为 1m。主节点会将写入命令存到这个缓冲区中,但是大小有限,待写入的命令超过 1m 后,会覆盖之前的数据,因为是环形写入。
增量同步也是 psync 命令,如果主节点判断从节点传递的 runid 和主节点一致,且根据 offset 判断数据还在repl_backlog_buffer中,则说明可以进行增量同步。
于是就去 repl_backlog_buffer 查找对应 offset 之后的命令数据,写入到 replication buffer 中,最终将其发送给 slave 节点。slave 节点收到指令之后执行对应的命令,一次增量同步的过程就完成了。
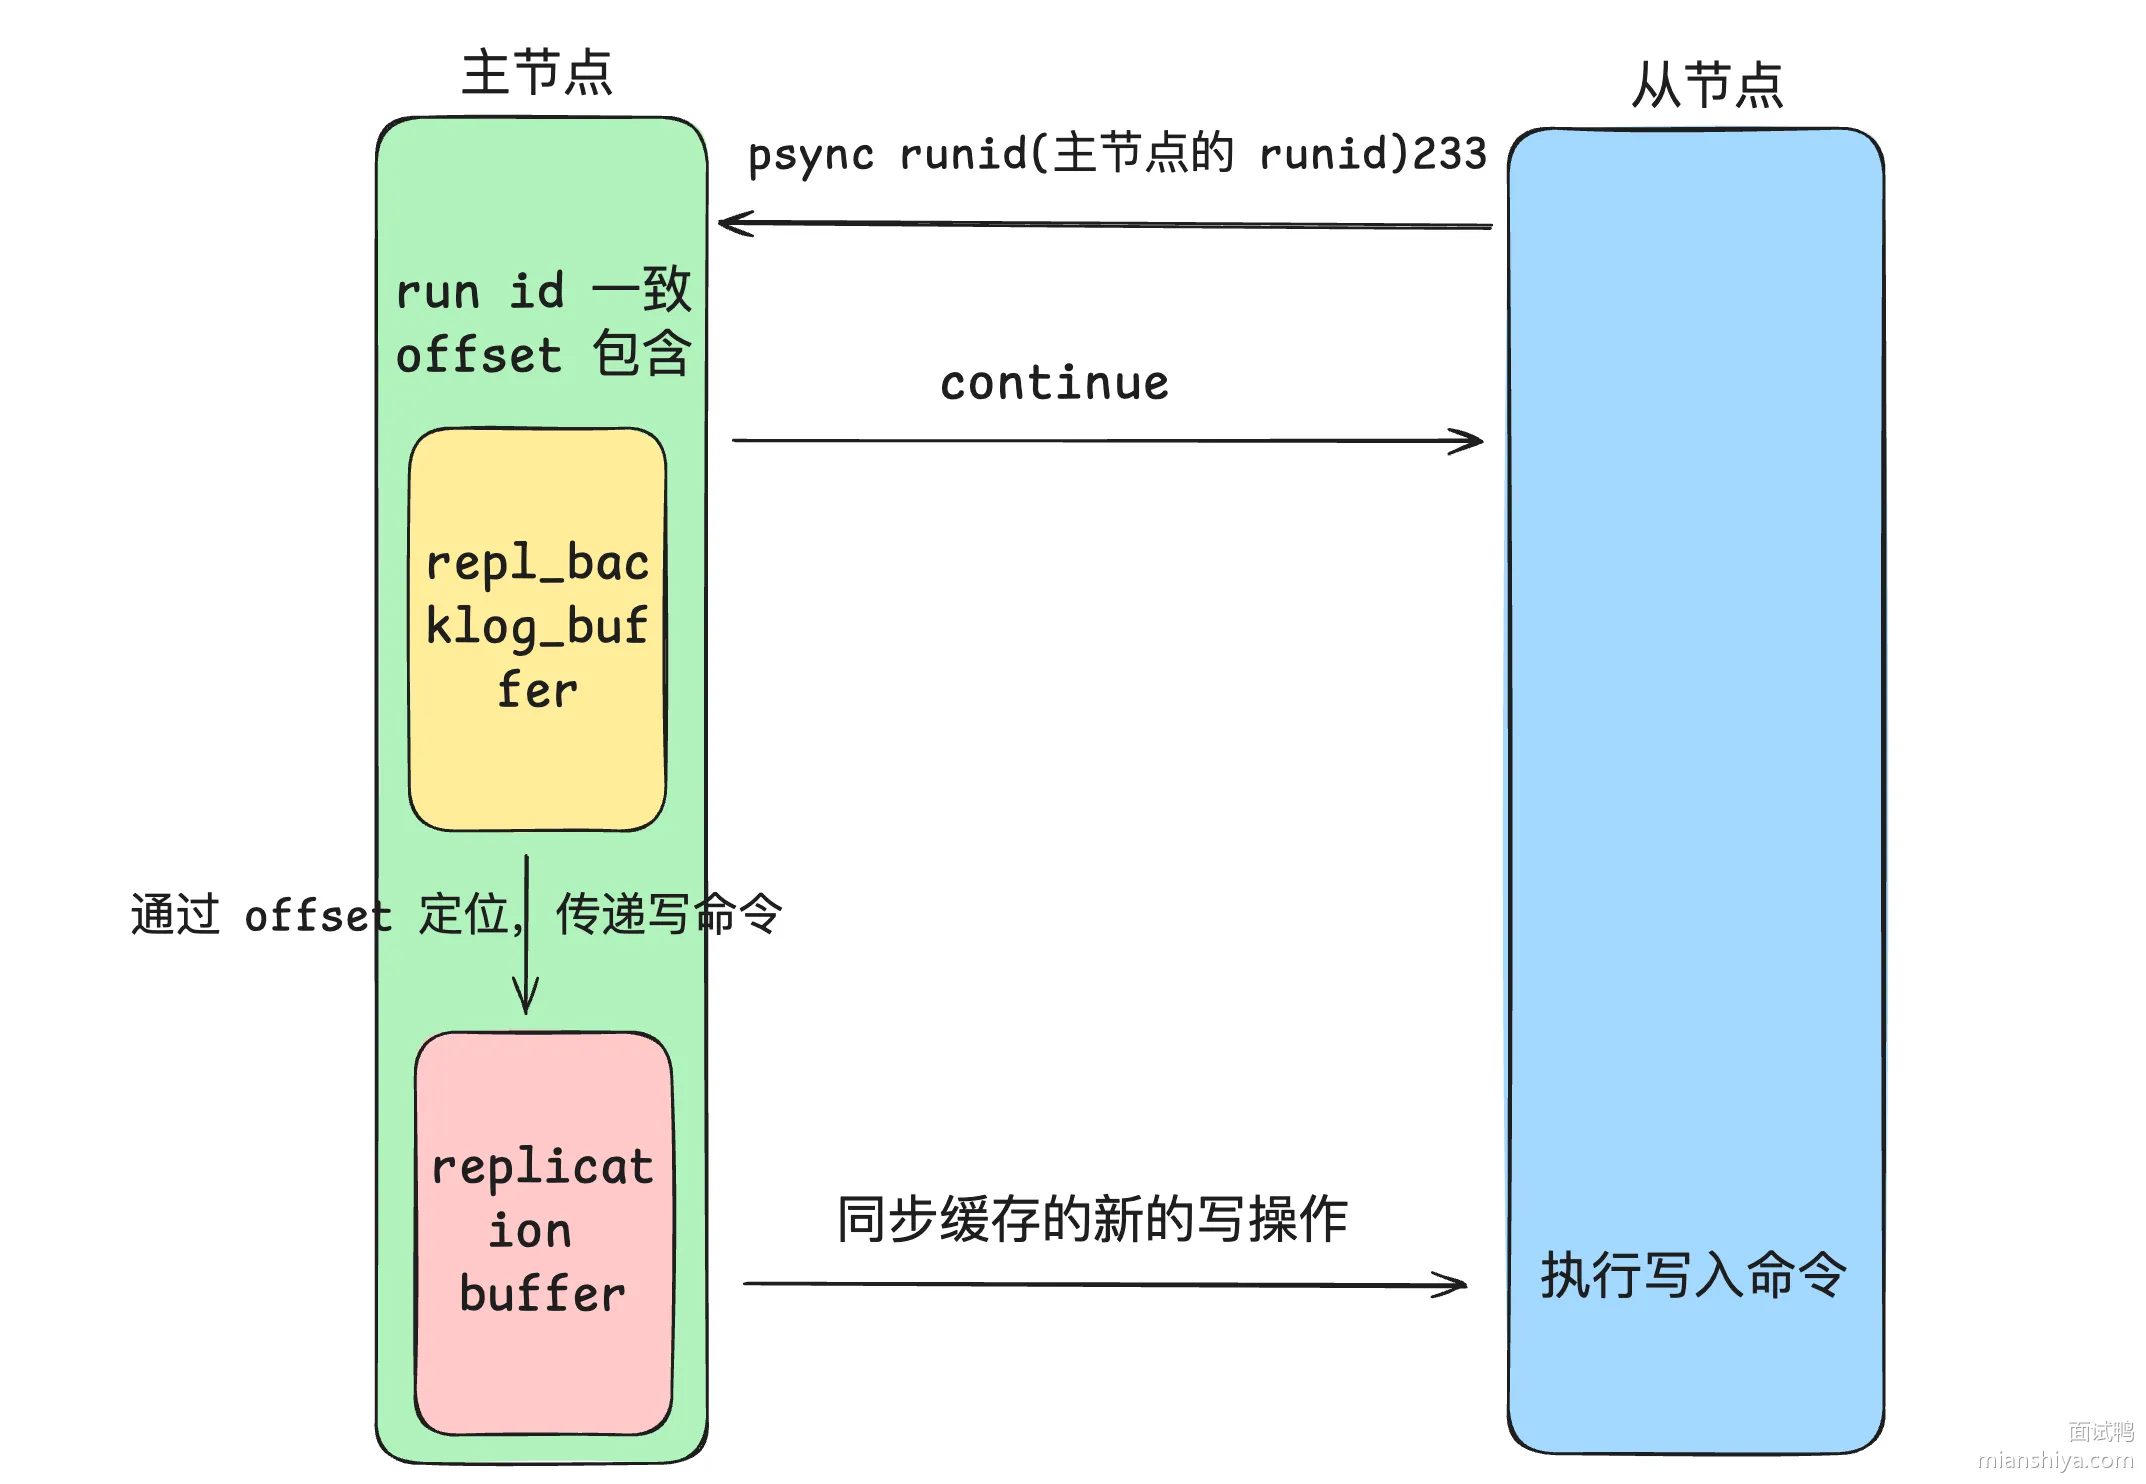
如果根据 offset 判断数据已经被覆盖了,此时只能触发全量同步!
因此可以调整 repl_backlog_buffer 大小,尽量避免出现全量同步。
1.2.3. 两个缓冲区的区别
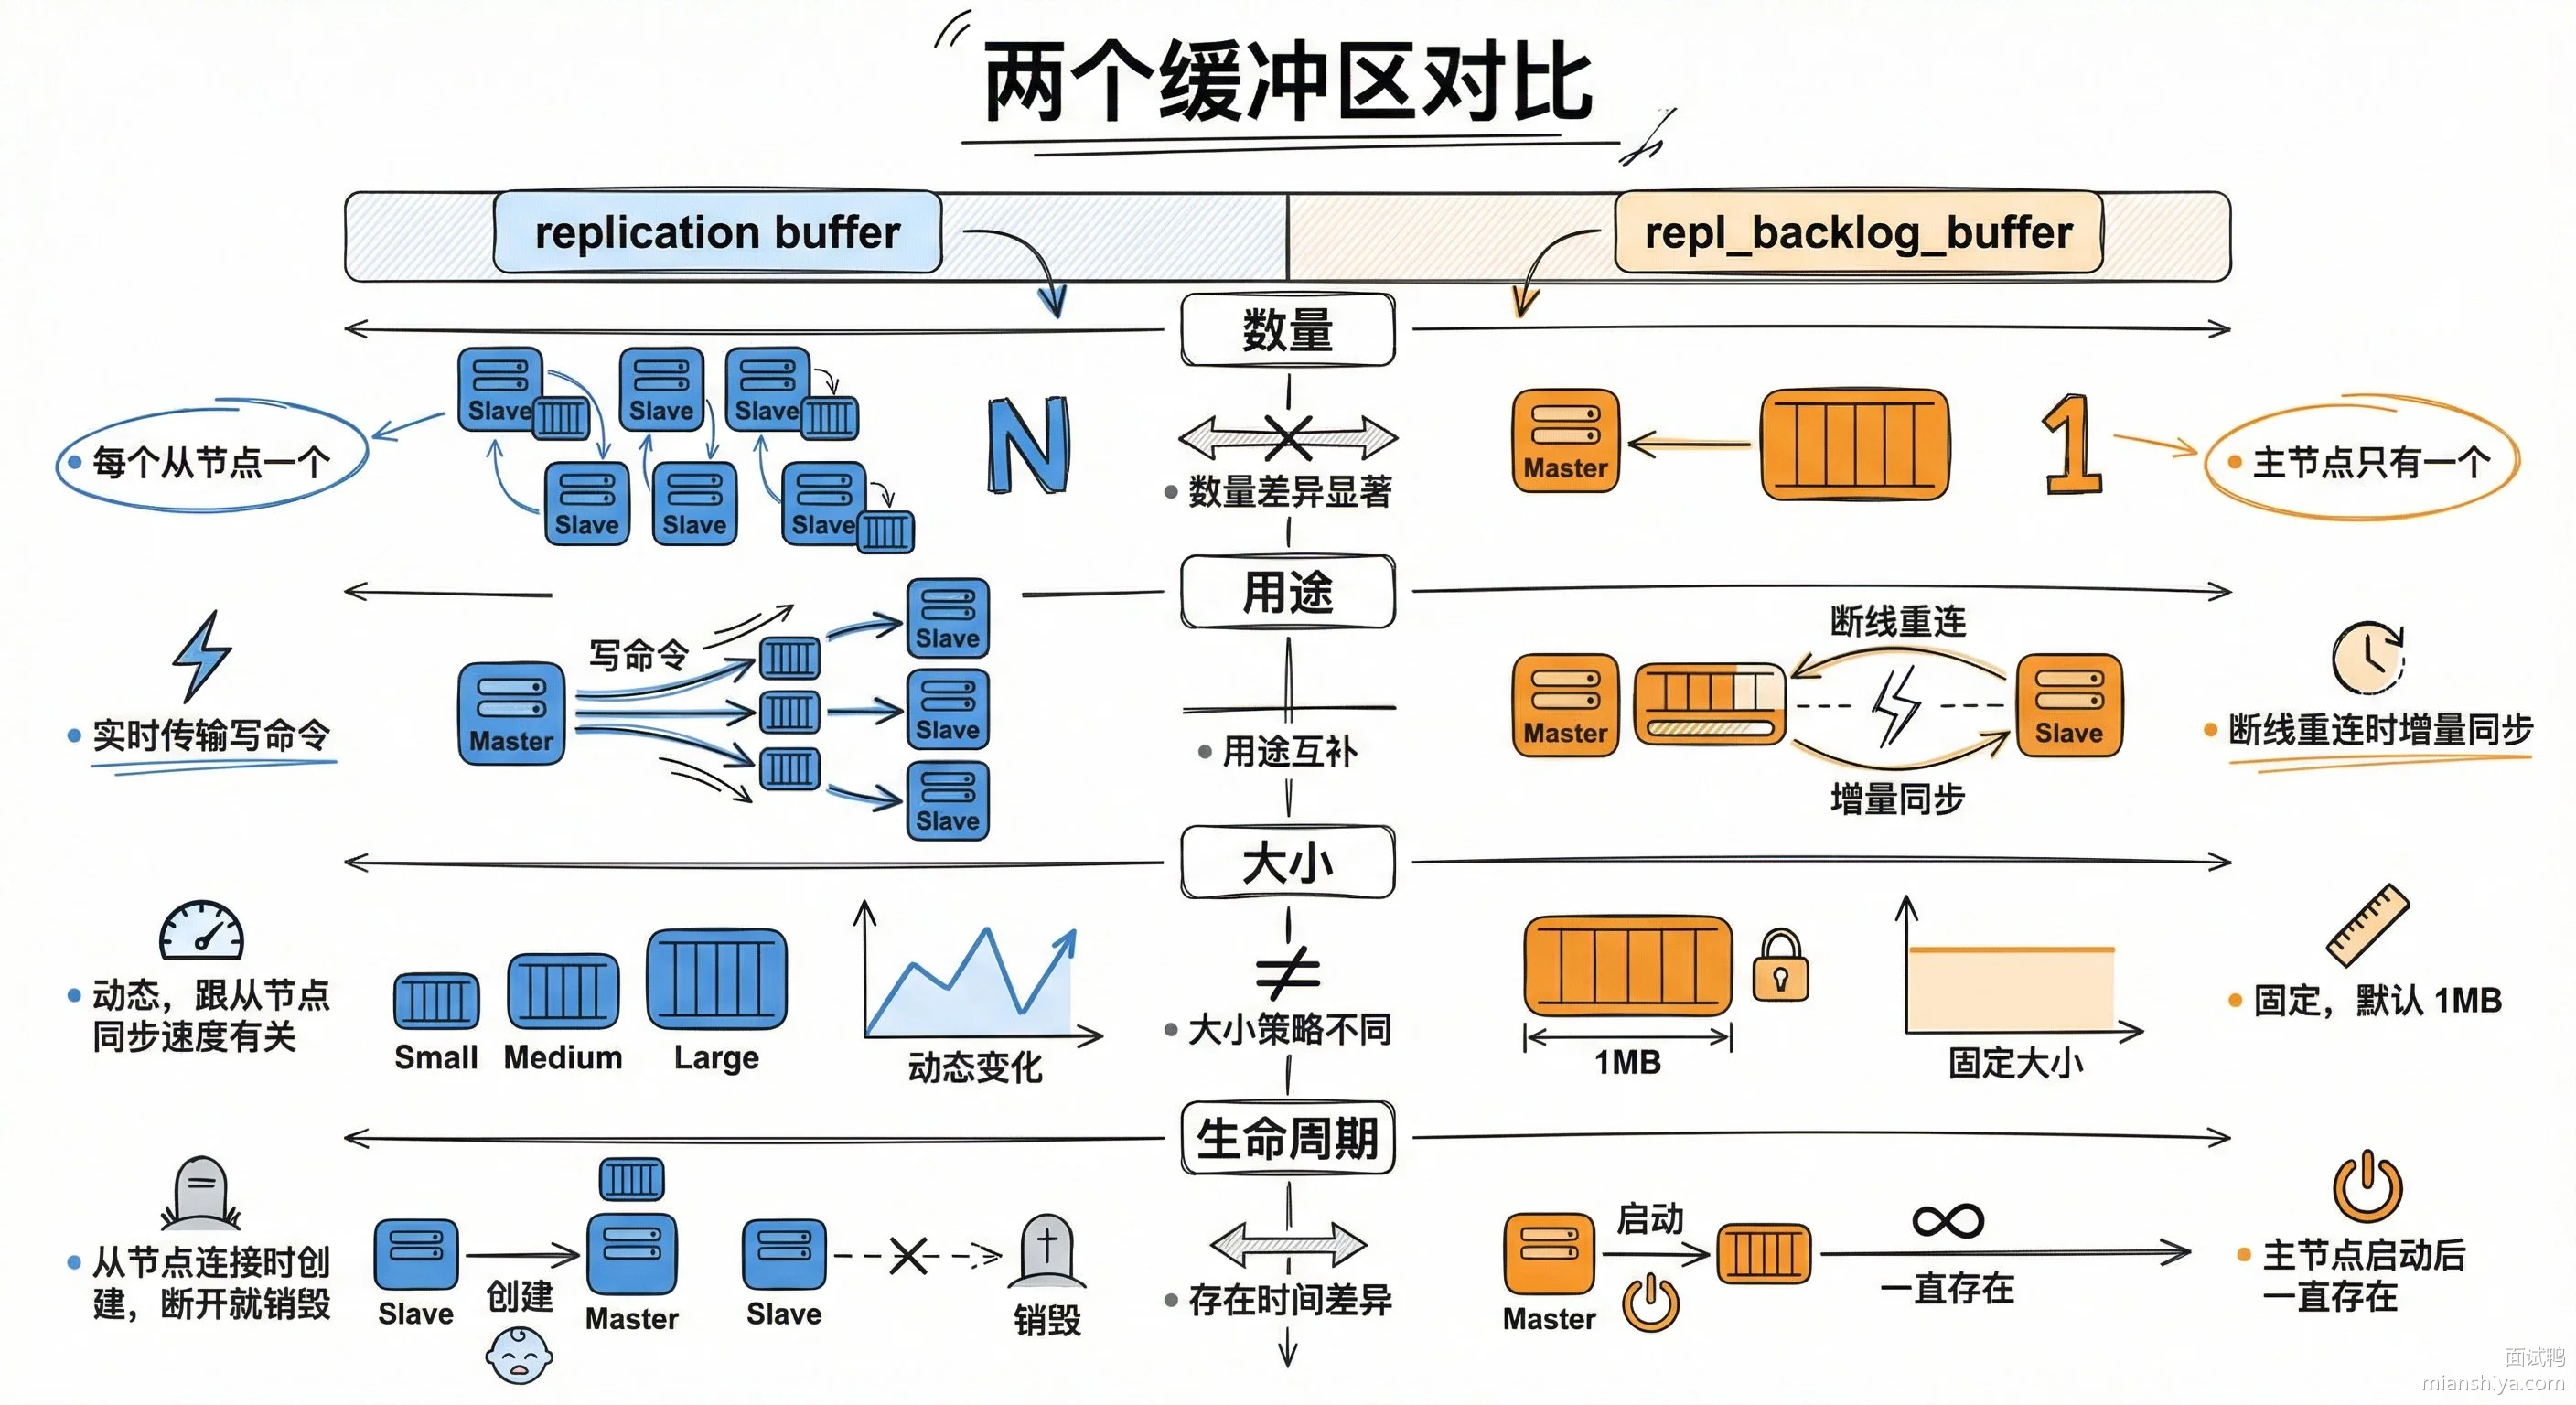
很多人分不清 replication buffer 和 repl_backlog_buffer,它俩作用完全不一样。
replication buffer 是给正在连接的从节点用的,主节点有几个从节点就有几个 buffer。它的大小可以通过 client-output-buffer-limit 控制:
client-output-buffer-limit slave 256mb 64mb 60意思是从节点的输出缓冲区超过 256MB,或者超过 64MB 持续 60 秒,就断开连接。断开后从节点重连还得重新全量同步。
repl_backlog_buffer 是给断线重连的从节点用的。它是环形缓冲区,写满了就覆盖最早的数据。默认 1MB 太小了,生产上建议调大:
repl-backlog-size 100mb调多大合适?看你能接受多长时间的断线。假设主节点每秒写入 1MB 数据,你想支持 100 秒内的断线增量同步,就配 100MB。
1.2.4. 全量同步的性能开销
全量同步很重,能避免尽量避免:
1)主节点要 fork 子进程生成 RDB,fork 期间主线程阻塞,数据量大的时候可能卡几十毫秒
2)RDB 文件要通过网络传输,10GB 的数据至少要传几十秒
3)从节点加载 RDB 期间无法对外服务
4)加载完 RDB 还要重放 replication buffer 里的命令
所以生产上要做两件事:一是把 repl_backlog_buffer 调大减少全量同步的概率;二是控制单个 Redis 实例的数据量,一般建议不超过 10GB。
1.2.5. 主从复制是异步的
主节点收到写命令,写完自己的就直接返回客户端成功,不等从节点同步完。这样性能高但有风险:主节点写完还没来得及同步就挂了,数据就丢了。
Redis 3.0 引入了 WAIT 命令,可以让客户端等待指定数量的从节点同步完成:
SET key value
WAIT 1 1000  # 等待至少 1 个从节点同步,最多等 1000ms
但这只是客户端行为,Redis 本身的复制还是异步的。
1.3. 常见问题
1.3.1. 从节点能不能再挂从节点?形成级联复制?
可以的。从节点可以配置成另一个从节点的主节点,形成链式结构。这样做的好处是减轻主节点的复制压力。假设有 10 个从节点都直接连主节点,主节点要维护 10 个 replication buffer,要发 10 份数据。如果用级联结构,主节点只连 2 个从节点,这 2 个再各自连 4 个,主节点的压力就小多了。缺点是链路越长延迟越高,最底层的从节点数据延迟会叠加。
1.3.2. 主从复制的时候从节点还能对外提供读服务吗?
默认可以,但读到的可能是旧数据。如果要求严格,可以配置 slave-serve-stale-data no,这样从节点在同步完成前拒绝所有读请求,只返回 SYNC with master in progress 错误。一般不建议这么配,会影响可用性。
1.3.3. 主节点挂了从节点会自动升级成主节点吗?
详细解答可以看:Redis 的哨兵机制是什么?
不会。单纯的主从复制没有自动故障转移能力。从节点发现主节点挂了,就一直等着,不会自己升级。要实现自动切换得上哨兵或者 Redis Cluster。哨兵会监控主从节点状态,主节点挂了自动选一个从节点提升成新主节点。
1.3.4. repl_backlog_buffer 是所有从节点共用一个,那怎么知道每个从节点同步到哪了?
每个从节点会记录自己的复制偏移量 offset,主节点也记录自己当前写到哪个 offset 了。从节点重连时把自己的 offset 告诉主节点,主节点拿这个 offset 去 repl_backlog_buffer 里查。buffer 里每条数据都有对应的 offset 范围,能查到就增量同步,查不到说明数据被覆盖了就全量同步。
2. Redis 集群的实现原理是什么?
2.1. 核心要点
Redis 集群主要解决了单机内存和并发的瓶颈,它通过多个 Redis 实例组成,每个实例存储不同的数据分片。
它的实现原理,可以用三个关键词来概括:分片、Gossip 协议、去中心化。
1)数据怎么存的?
Redis 集群引入了哈希槽的概念,把整个数据集群划分为 16384 个槽。集群里的每个主节点负责维护一部分槽。
存一个 Key 时,Redis 先对 Key 算一个 CRC16 值,然后对 16384 取模,算出它属于哪个槽,再把数据存到负责这个槽的节点上。
这样做的好处是扩容缩容非常方便。要加一个新节点,只需要把其他节点身上的一部分槽"过户"给新节点就行了,不需要像传统哈希那样重新计算所有数据的位置。
2)节点之间怎么联系?
集群里的节点是去中心化的,没有所谓的"中心大脑"。它们之间通过 Gossip 协议互相通信。
每个节点定期随机选几个邻居,交换彼此的状态信息,比如"我负责哪些槽"、"我是否还活着"。这样只需要很短的时间,集群的所有节点就能达成一致,知道整个集群的拓扑结构。
3)客户端怎么找数据?
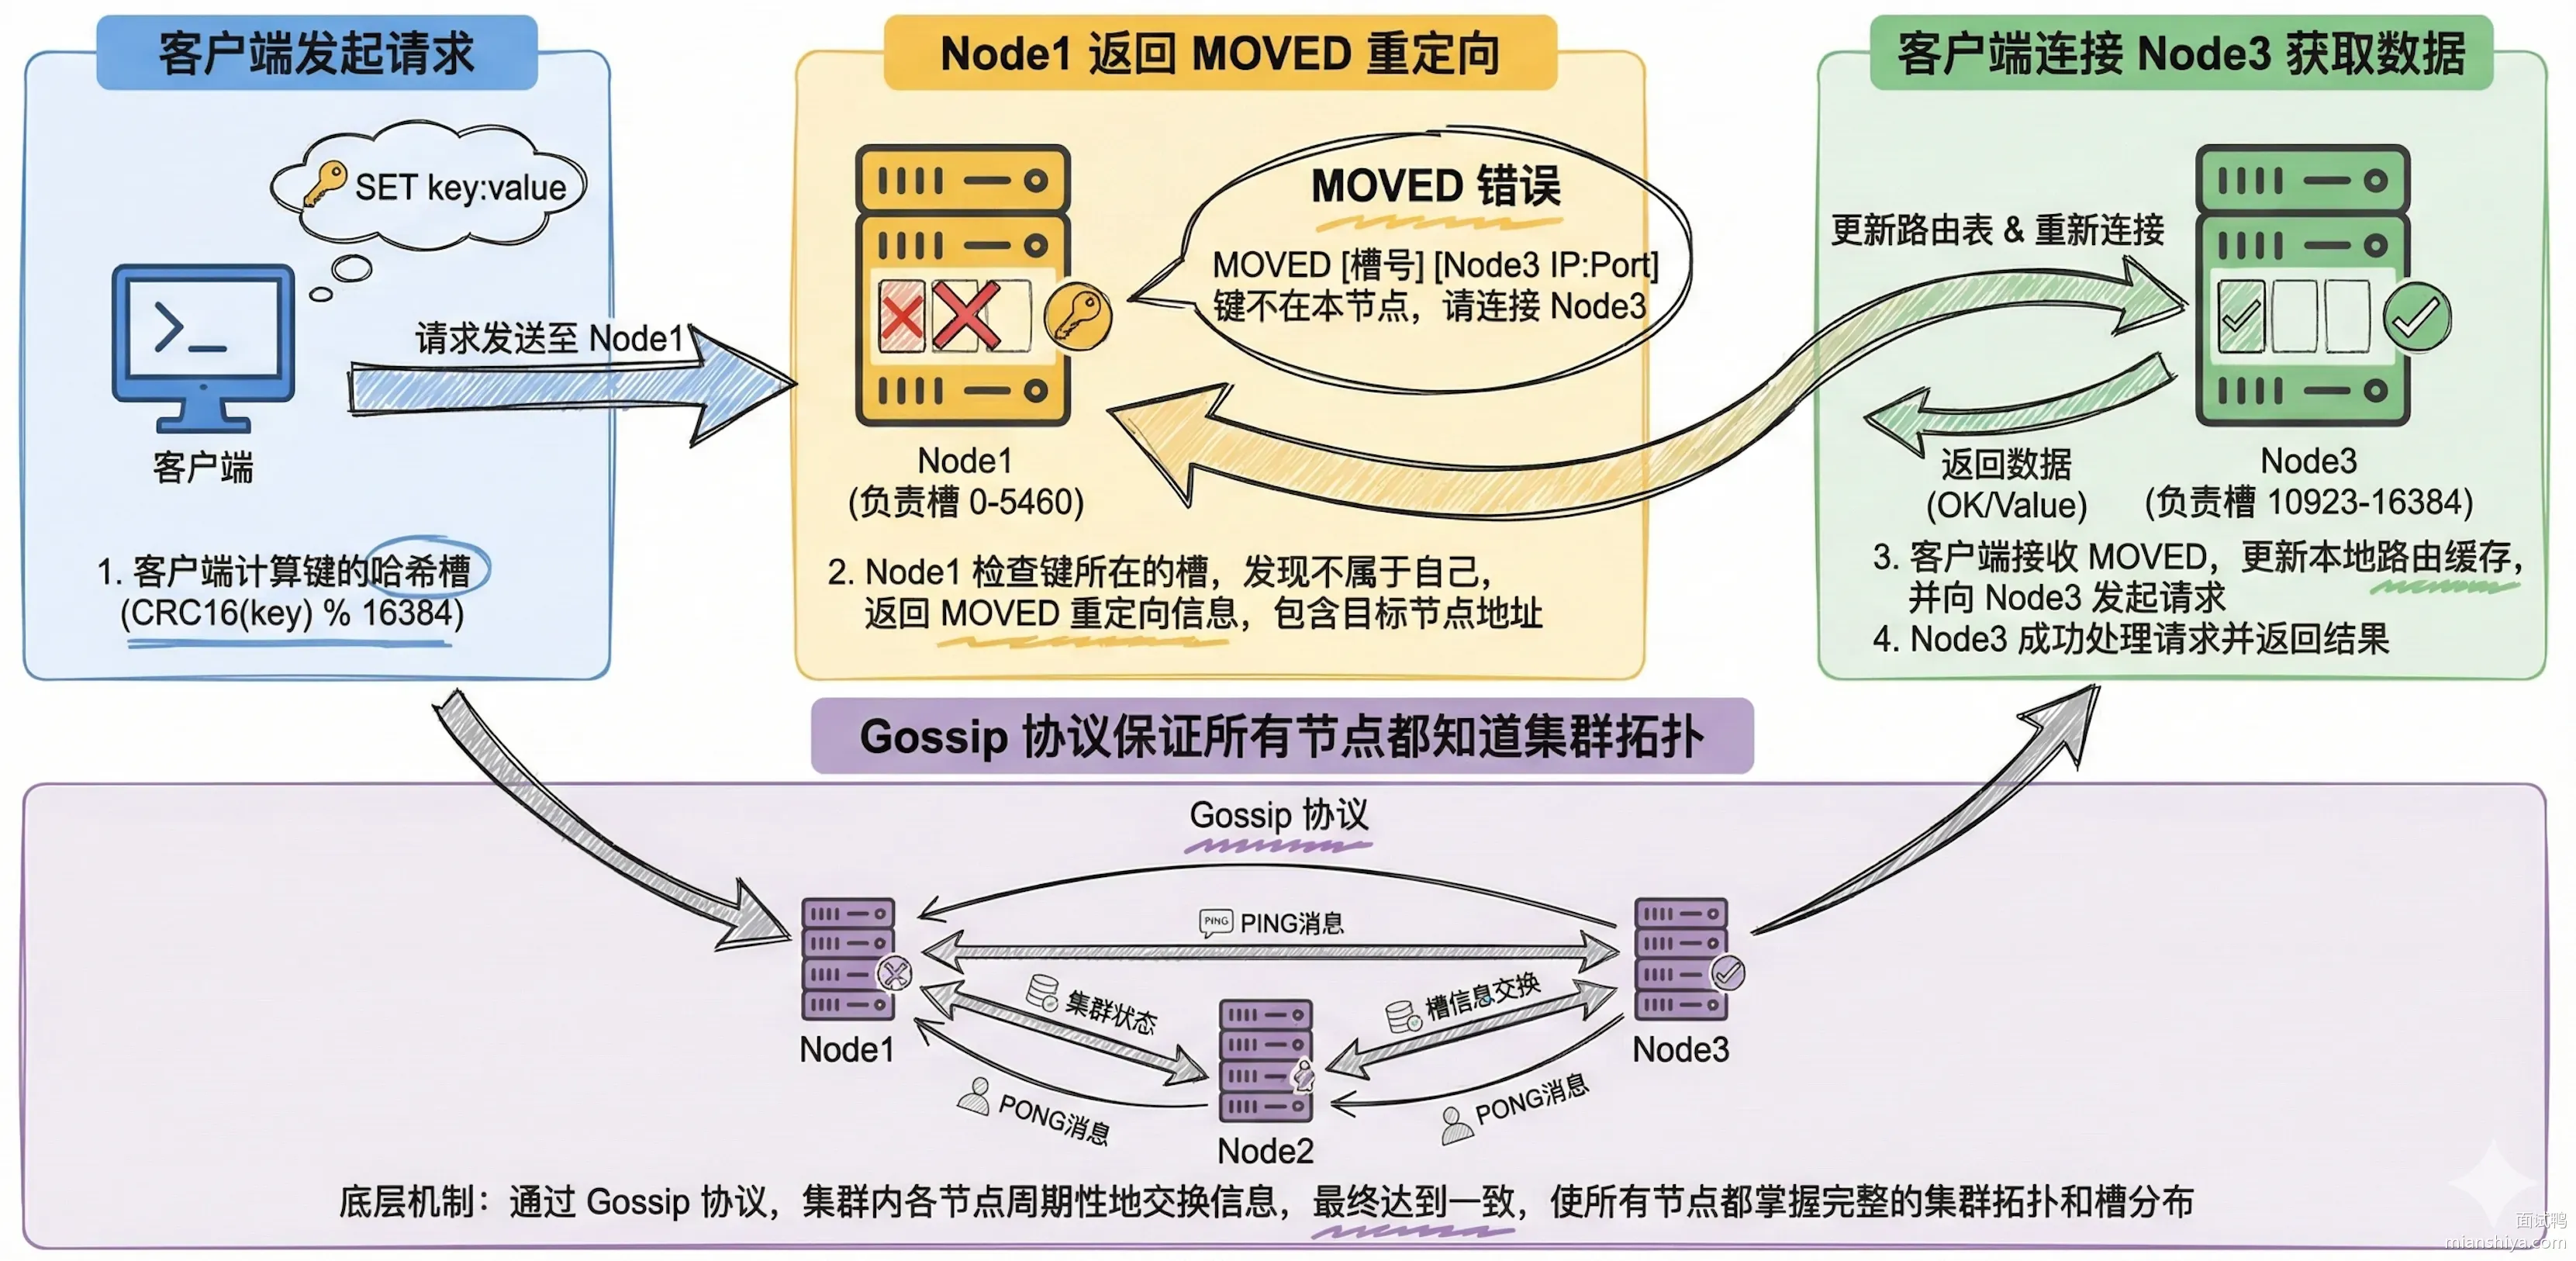
客户端可以连接集群的任意一个节点。如果客户端要找的 Key 刚好在这个节点上,那就直接返回;如果不在,这个节点不会充当代理去转发请求,而是会返回一个 MOVED 错误,告诉客户端:"这个 Key 不归我管,你去连 IP:Port 这个节点吧。"
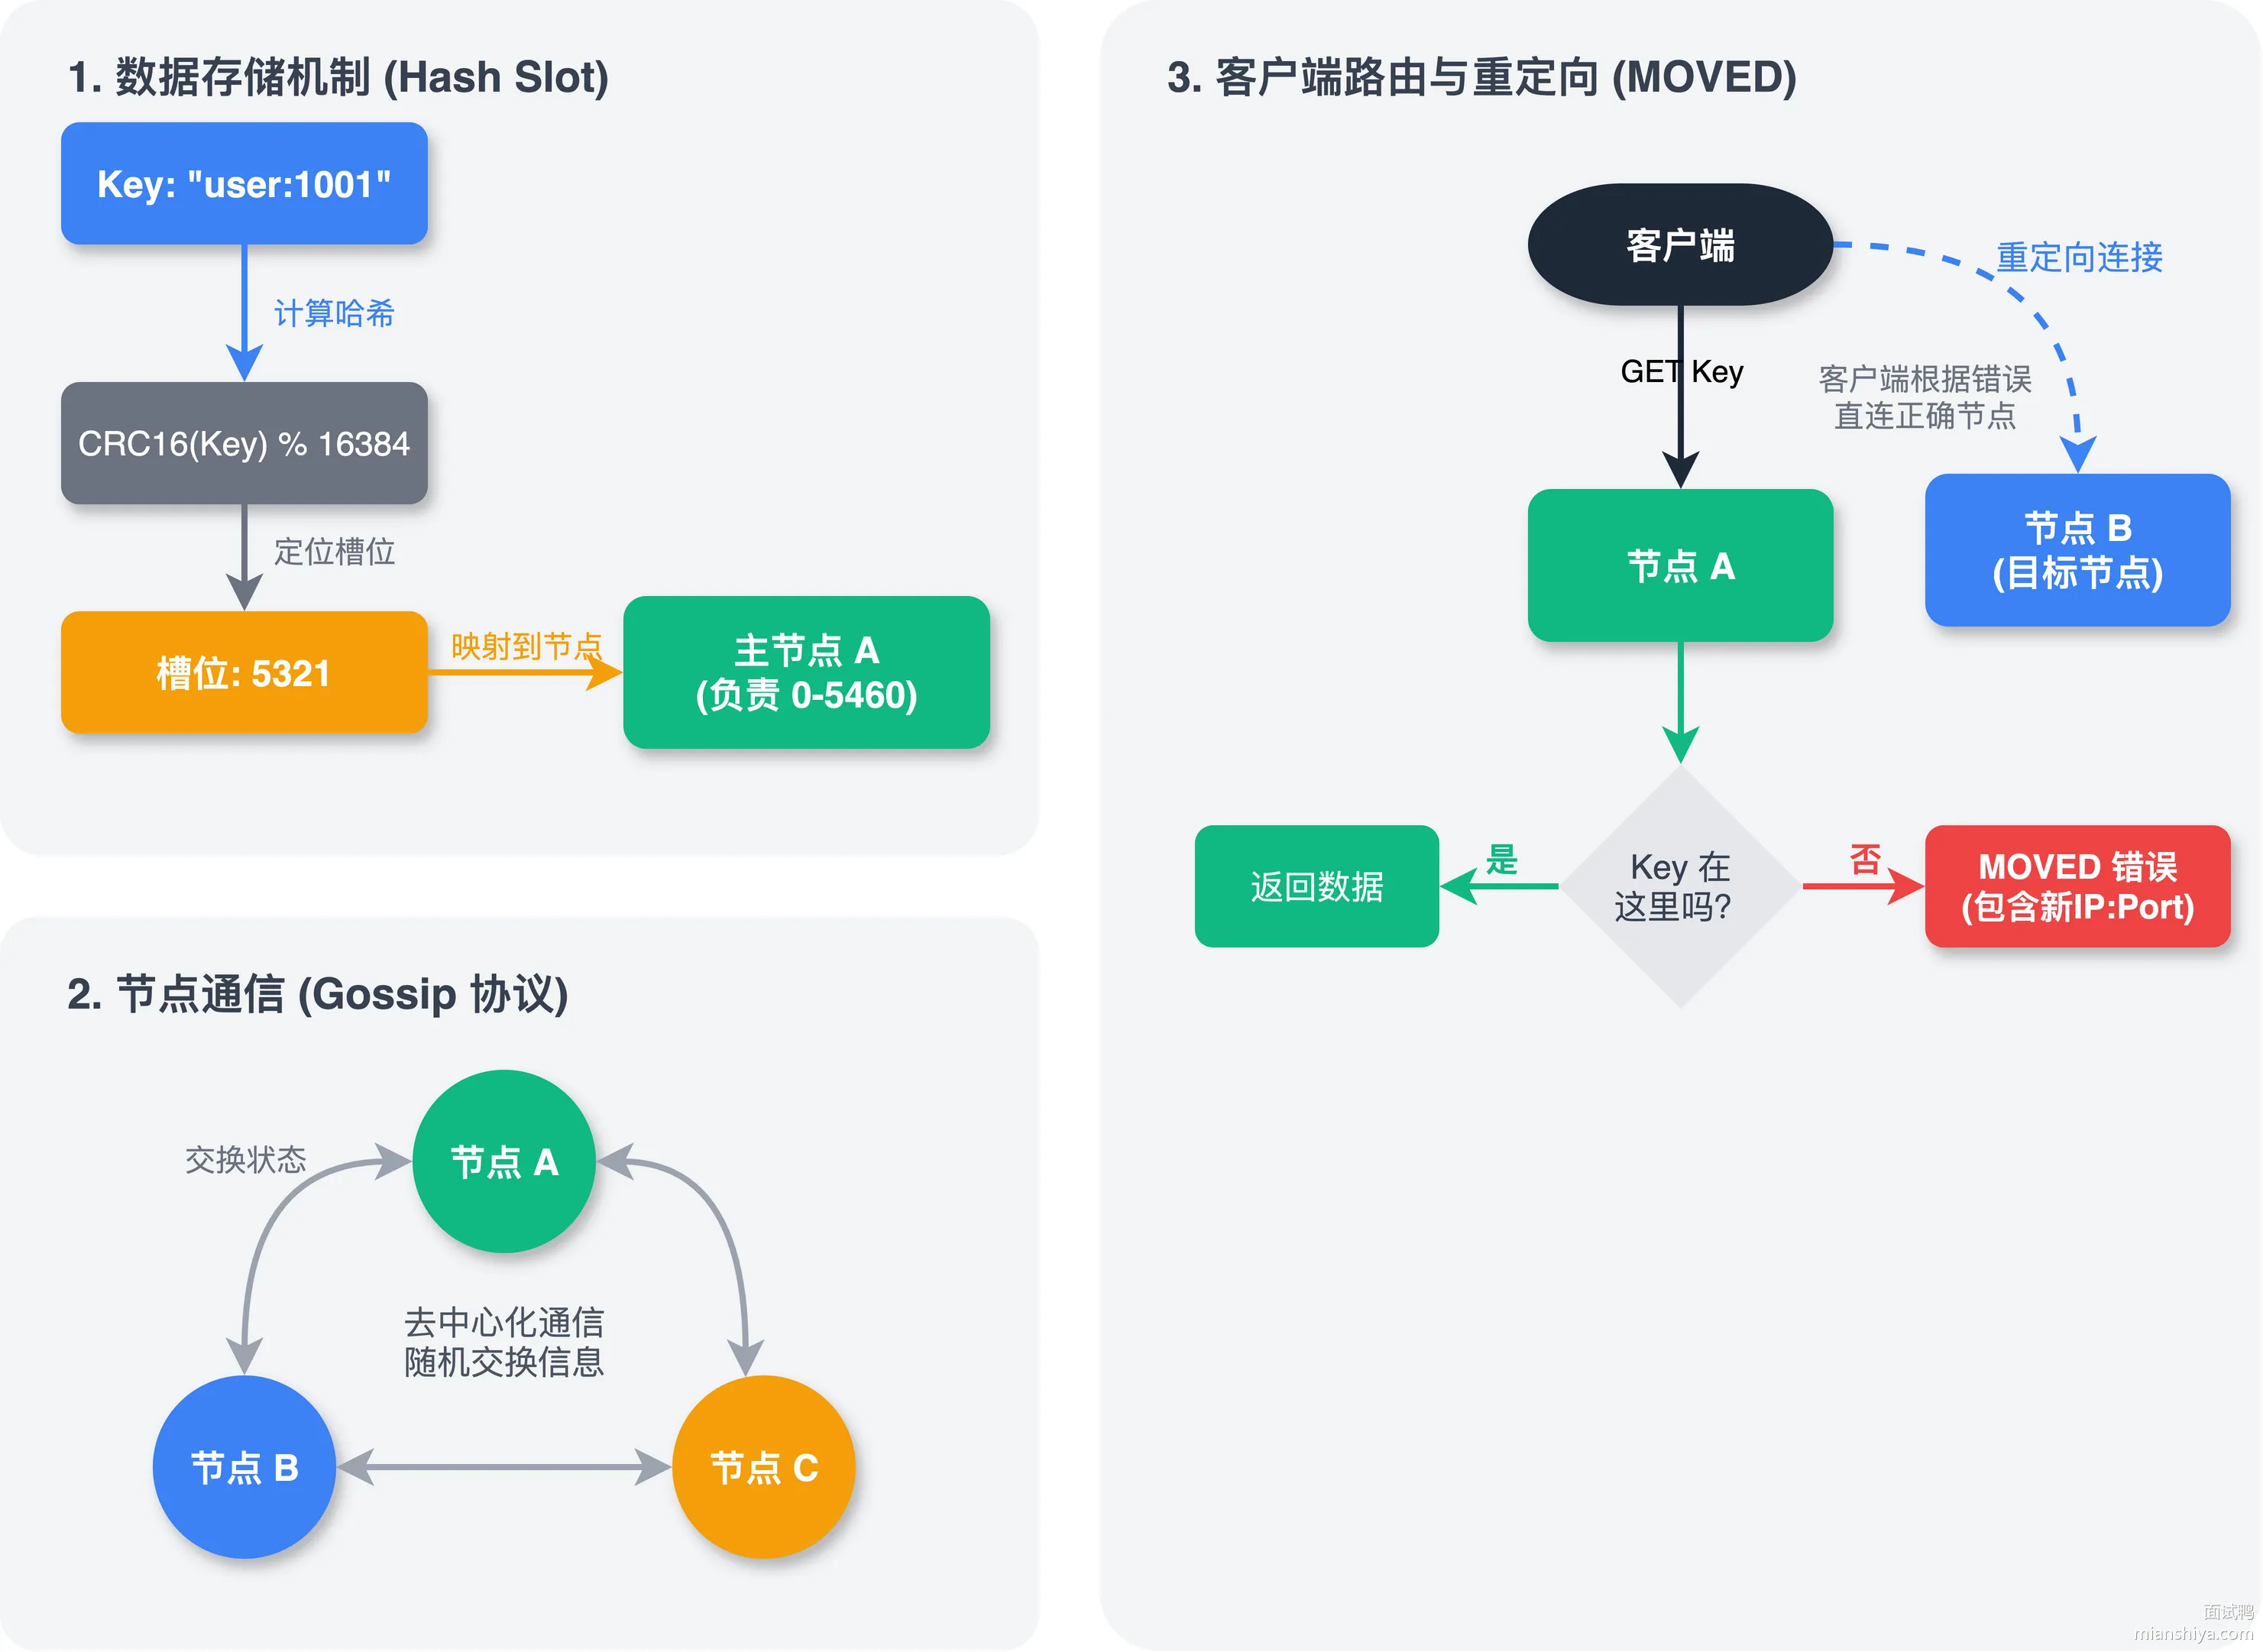
2.2. 扩展知识
2.2.1. 为什么哈希槽是 16384 个?
github 上有人向作者提问过:
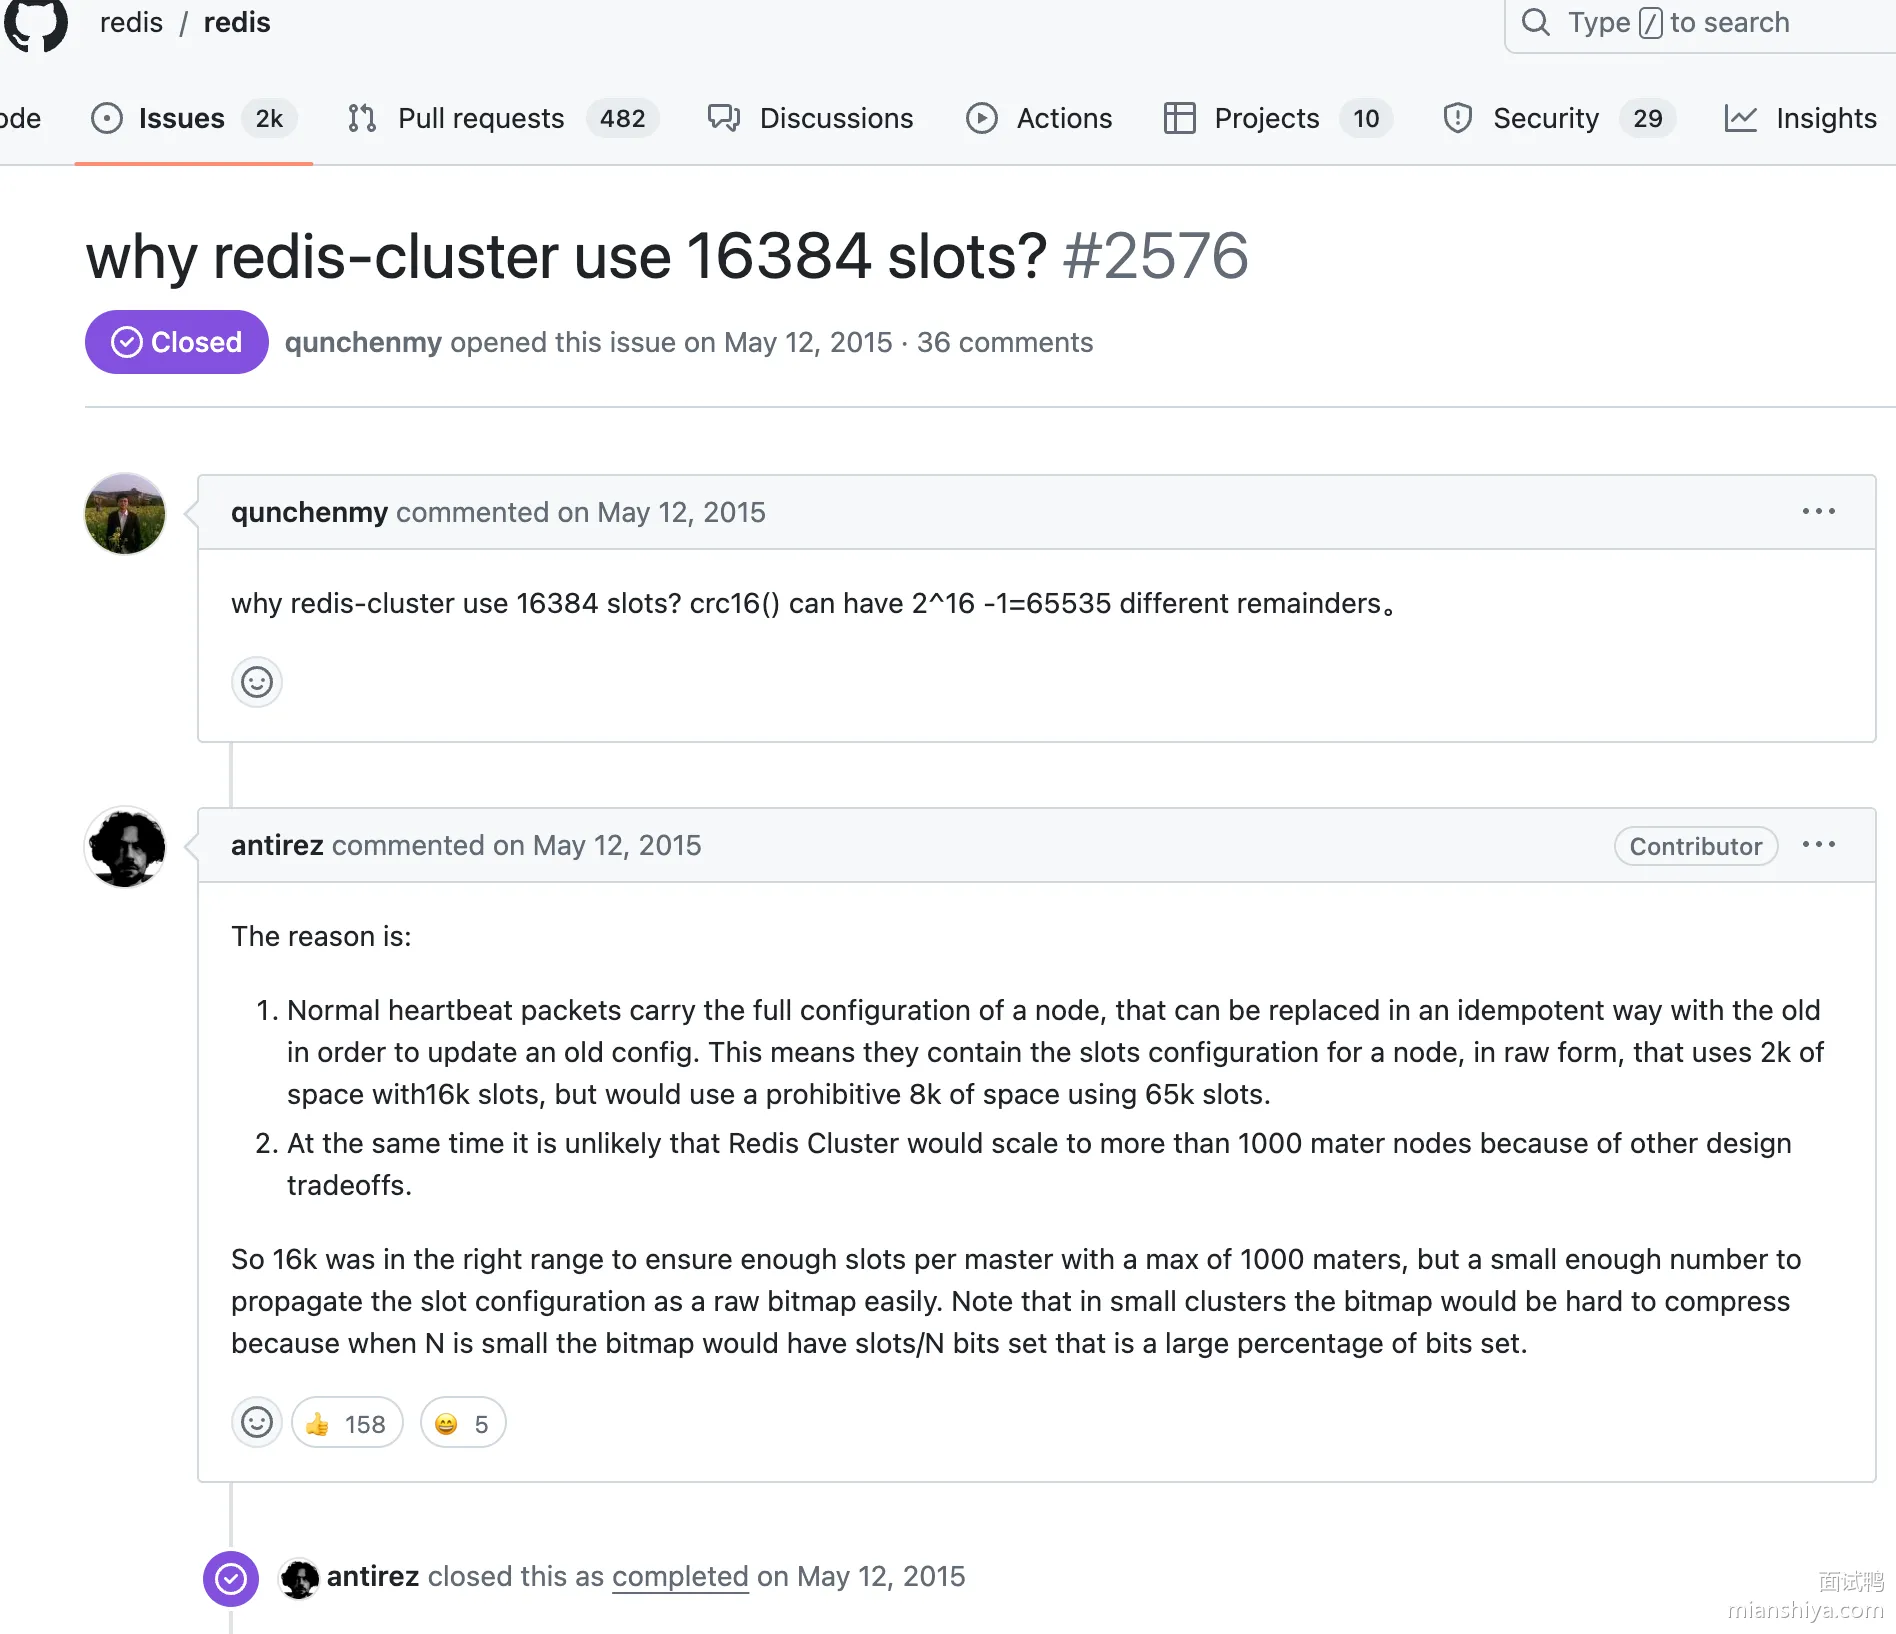
1)首先是消息大小的考虑
正常的心跳包需要带上节点完整配置数据,心跳还是比较频繁的,所以需要考虑数据包的大小。用 16384 数据包只要 2KB,用 65535 则需要 8KB。
槽位信息用一个长度为 16384 位的数组来表示,节点拥有哪个槽位,就将对应位置设为 1,否则为 0。
心跳数据包就包含槽位信息如下图所示:
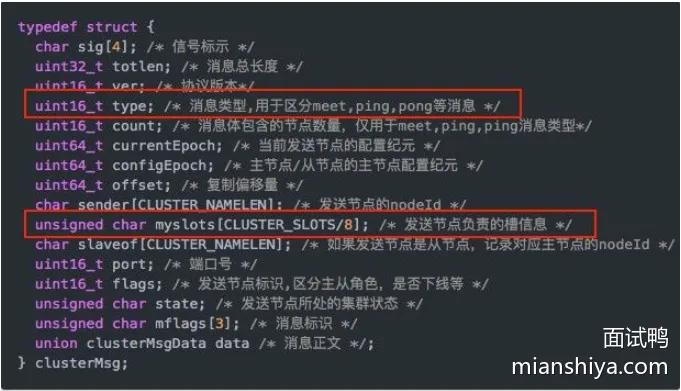
消息头中最占空间的是 myslots[CLUSTER_SLOTS/8]:
- 槽位为 65536 时,大小是 65536÷8÷1024=8KB
- 槽位为 16384 时,大小是 16384÷8÷1024=2KB
如果槽位为 65536,ping 消息的消息头就太大了,浪费带宽。
2)集群规模的考虑
集群不太可能会扩展超过 1000 个节点,16384 够用且使得每个分片下的槽又不会太少。
2.2.2. 集群哈希槽分片原理
Redis 集群会将数据分散到 16384 个哈希槽中,集群中的每个节点负责一定范围的哈希槽,使用 CRC16 哈希算法计算键的哈希槽,以确定该键应存储在哪个节点。
集群哈希槽分片如下图所示:
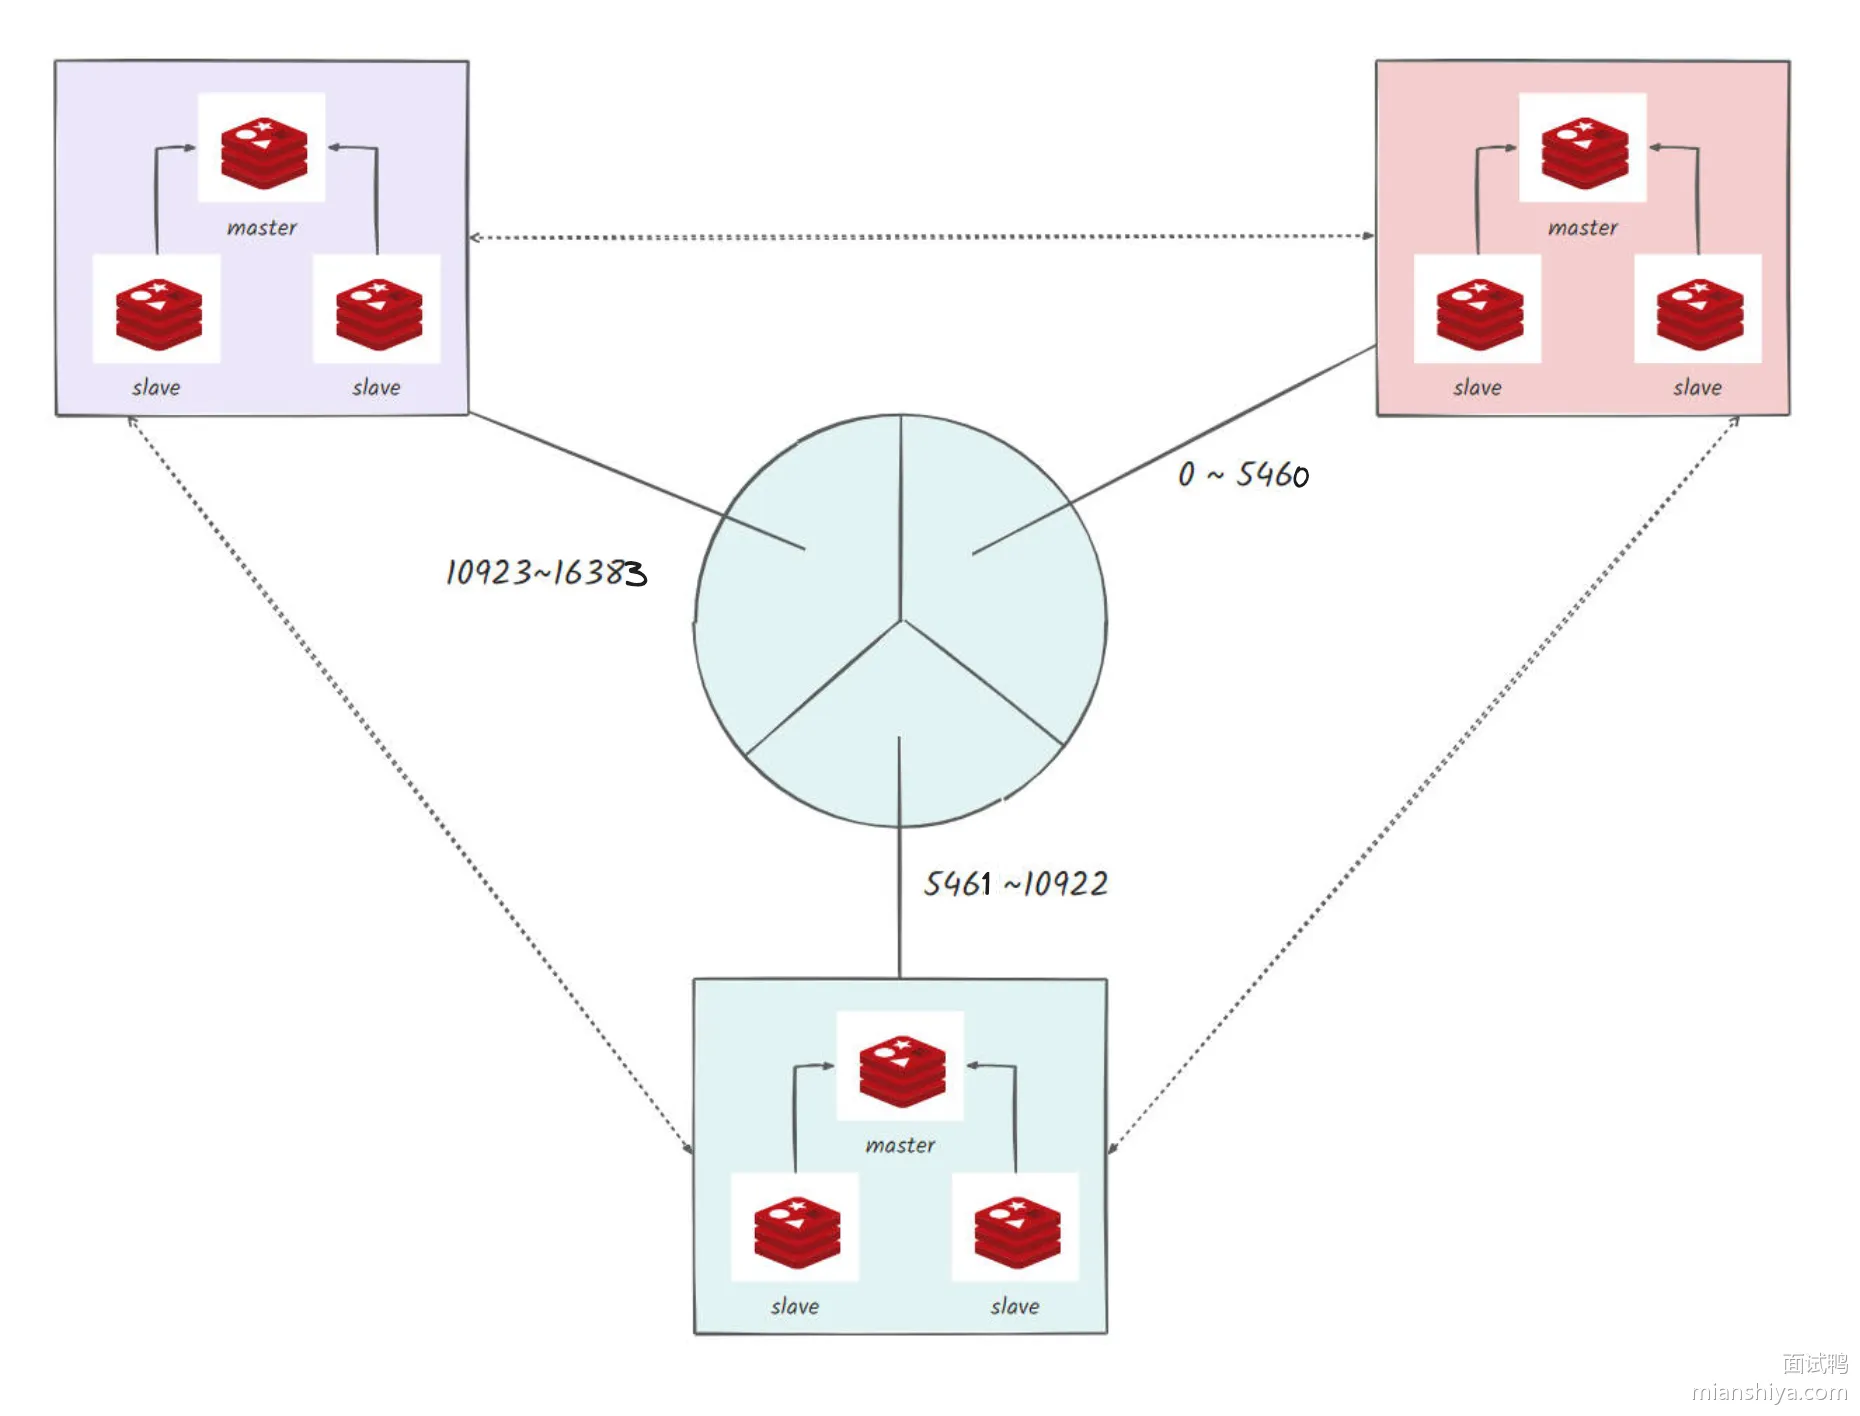
每个节点会拥有一部分槽位,对应的键值会根据其本身的 key 映射到一个哈希槽中,主要流程:
- 根据键值的 key,按照 CRC16 算法计算一个 16 bit 的值,然后对 16384 取余,得到一个对应的哈希槽编号
- 根据每个节点分配的哈希槽区间,对应编号落在哪个区间上,就能找到对应的分片实例
以三个节点为例:
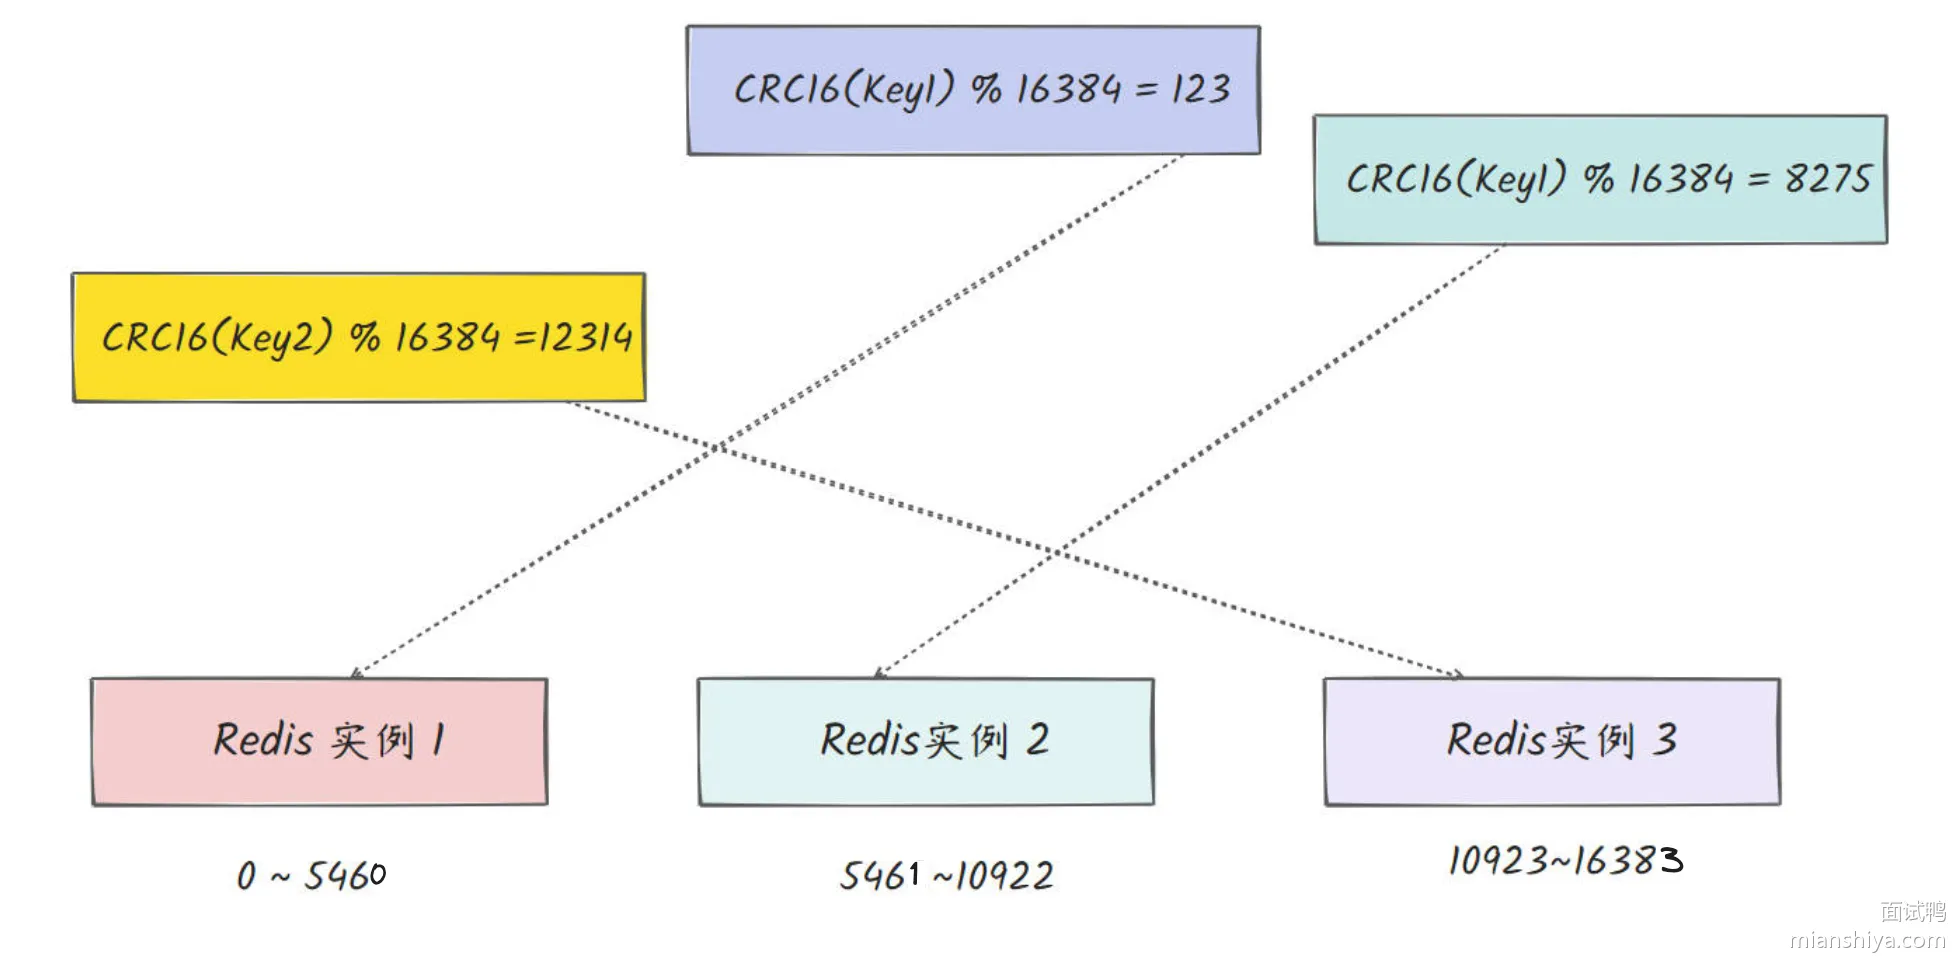
还有一点需要强调,redis 客户端可以访问集群中任意一台实例,正常情况下这个实例包含这个数据。
但如果槽被转移了,客户端还未来得及更新槽的信息,当前实例没有这个数据,则返回 MOVED 响应给客户端,将其重定向到对应的实例(因 Gossip 集群内每个节点都会保存集群的完整拓扑信息)
2.2.3. 存储数据示例
假设有一个 Redis 集群,包含三个主节点,它们分别负责以下哈希槽:
- Node1: 哈希槽 0-5460
- Node2: 哈希槽 5461-10922
- Node3: 哈希槽 10923-16383
现在要存储一个键为 user:1001 的数据。
计算哈希槽
1)使用 CRC16 哈希算法计算 user:1001 的 CRC16 值 2)假设计算结果为 12345 3)计算该值对应的哈希槽 = 12345 % 16384 = 12345
确定目标节点
12345 落在 Node3 的负责范围 10923-16383,因此 user:1001 会被存储在 Node3 中。
2.2.4. 跨节点请求示例
如果客户端连接的是 Node1,但需要访问存储在 Node3 的键 user:1001,查询过程如下:
1)客户端使用 CRC16 算法计算 user:1001 的哈希值 12345,计算哈希槽:12345 % 16384 = 12345 2)因为客户端连接的是 Node1,所以发送 GET user:1001 到 Node1 3)Node1 检测到这个键属于 Node3,返回一个 MOVED 错误,里面带着 Node3 的 IP 和端口 4)客户端根据返回的目标节点信息,建立与 Node3 的连接 5)客户端向 Node3 发送 GET user:1001 6)Node3 查询到值并返回结果
2.2.5. Gossip 协议
Gossip 协议是一种非常像"八卦传播"一样的分布式系统通信协议。
核心思想就是:像人传闲话一样,随机找几个节点聊聊天,把消息扩散出去,最后整个集群都会知道这个消息。
想象一下一个村子里有人发现了八卦,他不会挨家挨户去通知所有人,那样太慢太累了。他只告诉了 3 个朋友,这 3 个朋友又各自告诉另外 3 个朋友……没几轮,整个村子就都知道了。
三种常见模式
1)Push 模式:节点 A 知道了新消息,就随机挑几个节点把消息直接推过去。被推的节点再随机推给其他人,像病毒一样主动传播。
2)Pull 模式:节点定期互相打招呼:"喂,你最近有什么新八卦吗?"如果对方有自己没有的消息,就拉过来。像大家定期聚会交换小道消息。
3)Push+Pull 混合模式:既主动推也定期拉,传播速度最快,也最可靠。这是最常用的模式。
优缺点对比
| 方面 | 表现 | 说明 |
|---|---|---|
| 去中心化 | 极强 | 无单点故障,所有节点对等 |
| 容错能力 | 极强 | 节点批量宕机、网络分区、抖动都不影响最终收敛 |
| 可扩展性 | 线性扩展 | 从 10 台到 10000 台都不需要改架构 |
| 传播延迟 | 中等 | 几秒到几十秒收敛,不适合毫秒级强一致性场景 |
| 消息冗余 | 较高 | 同一条更新会被多次传播,带宽利用率不是最优 |
| 一致性强度 | 最终一致性 | 不提供强一致性保证,不能用于扣款、分布式锁等场景 |
2.3. 常见问题
2.3.1. 集群扩容的时候,数据迁移会不会影响线上读写?
会有一定影响,但 Redis 做了优化。扩容时槽处于 MIGRATING 状态,这时候如果客户端访问正在迁移的 key,源节点会返回 ASK 重定向,告诉客户端去新节点取数据。和 MOVED 不同的是,ASK 只是临时重定向,不会更新客户端的槽映射缓存。整个迁移过程中数据是可读可写的,只是可能会多一次重定向开销。
2.3.2. Redis 集群能保证强一致性吗?数据会不会丢?
详细解答可以看:Redis 集群会出现脑裂问题吗?
保证不了强一致性,数据确实可能丢。Redis 集群用的是异步复制,主节点写完就返回成功,不等从节点确认。如果主节点刚写完就挂了,从节点还没收到数据就被选为新主,那这部分数据就丢了。想要更强的一致性,可以开启 WAIT 命令等待指定数量的从节点同步完成,但这会牺牲性能。金融级别的场景,Redis 集群真不太合适。
2.3.3. 集群模式下,Lua 脚本和 MGET 这种多 key 操作还能用吗?
能用,但有限制。多个 key 必须落在同一个槽里,否则会报 CROSSSLOT 错误。解决办法是用 Hash Tag,比如 {user}:1001 和 {user}:1002,Redis 只会对花括号里的 user 计算哈希,这样就能保证它们落在同一个槽。实际开发中,需要批量操作的 key 最好在设计 key 命名规则时就考虑好这个问题。
2.3.4. 16384 个槽,如果集群有 1000 个节点,平均每个节点才 16 个槽,这不会影响性能吗?
理论上不会。槽的数量影响的是管理粒度和消息大小,不影响查找性能。key 找槽是 O(1) 的 CRC16 计算,槽找节点也是 O(1) 的数组查找。不过 1000 节点的集群已经很大了,实际上 Redis 官方建议集群规模控制在 1000 以内,因为节点越多,Gossip 消息的数量会增加,对网络带宽和 CPU 都有压力。
3. Redis 通常应用于哪些场景?
Redis 在项目中主要作用是:作为缓存提升性能和用于一些分布式协调场景。
主要有以下几个场景:
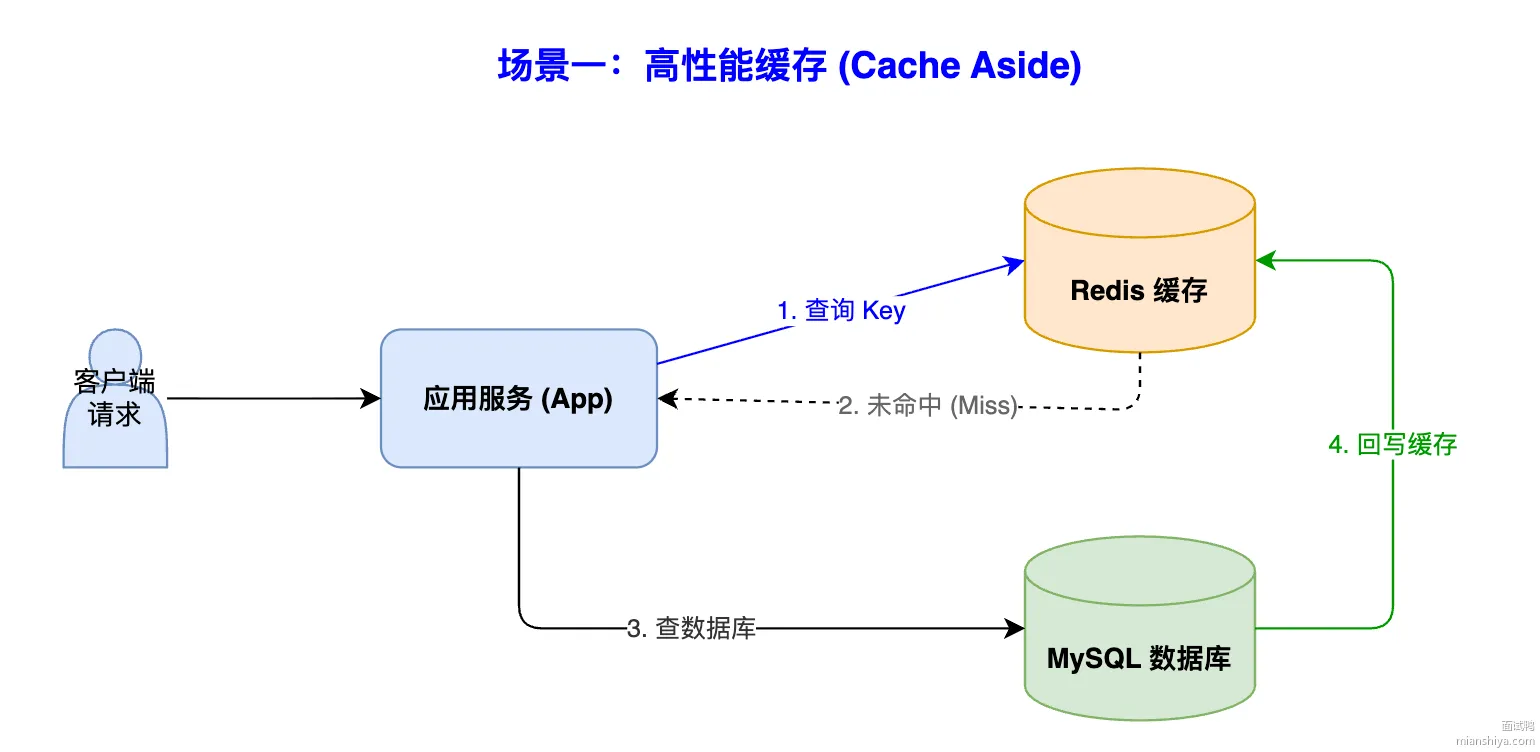
1)第一,最核心的肯定是做缓存
因为 MySQL 是存磁盘的,并发一高就容易挂。Redis 是纯内存操作,读写速度非常快。
我们通常用 String 类型缓存用户信息、Session 会话,或者缓存一些复杂的查询结果,比如热点商品的详情页。这样能挡住绝大部分请求,保护后端的数据库。
2)第二,解决并发问题的分布式锁
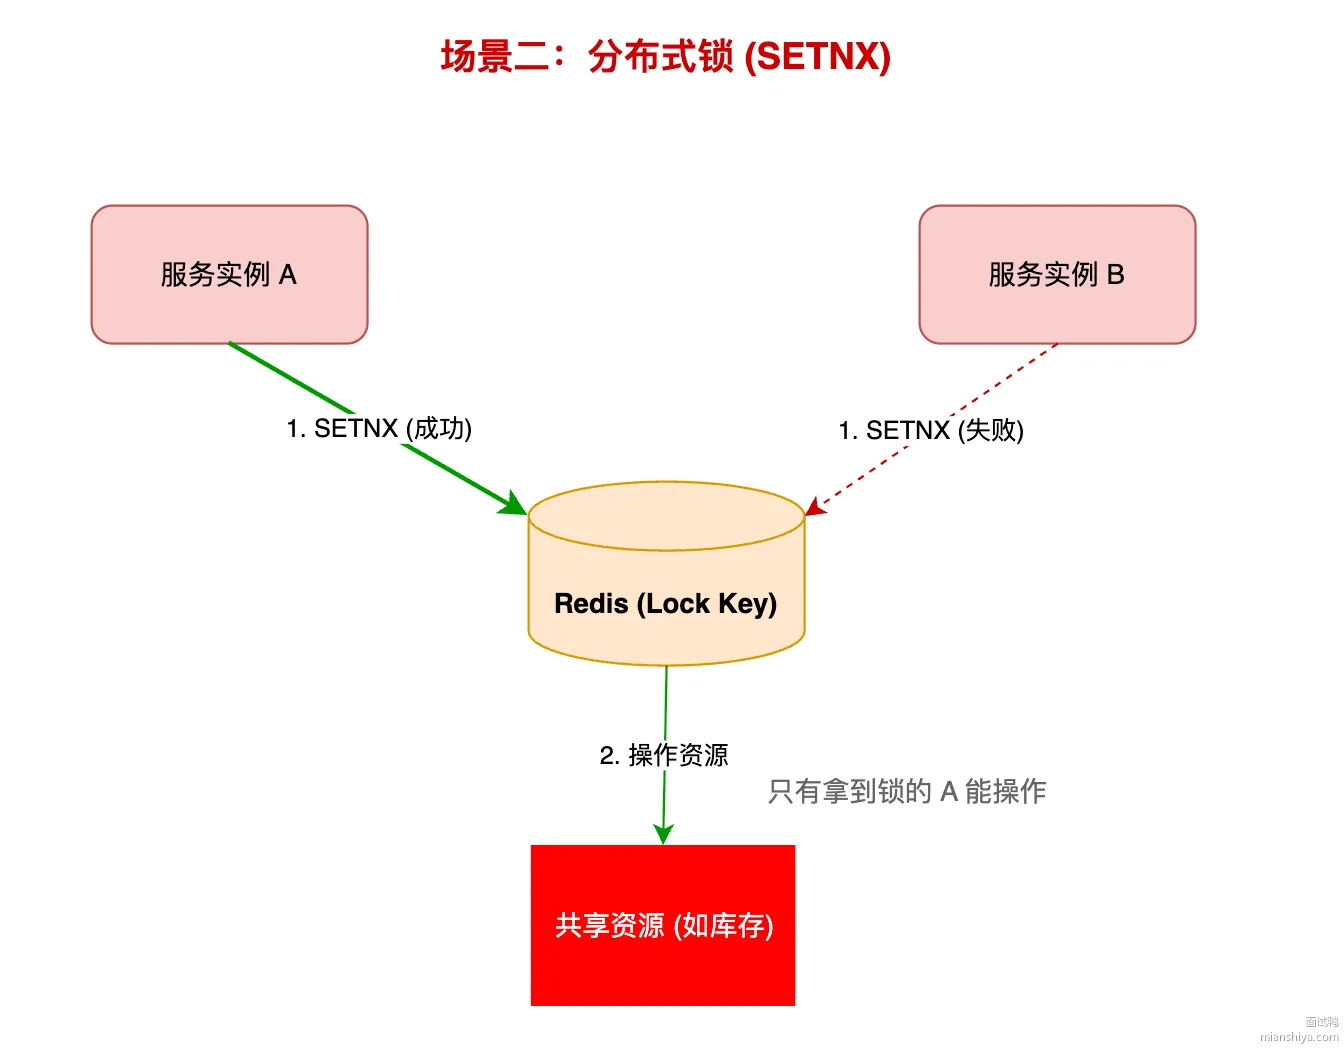
现在都是微服务集群部署,Java 自带的 synchronized 锁不住别的机器上的线程。我们利用 Redis 的 SETNX 命令或者 Redisson 框架。
因为 Redis 是单线程处理命令的,它天生能保证原子性,谁先写入谁就拿到锁,非常适合用来防止超卖或者重复提交。
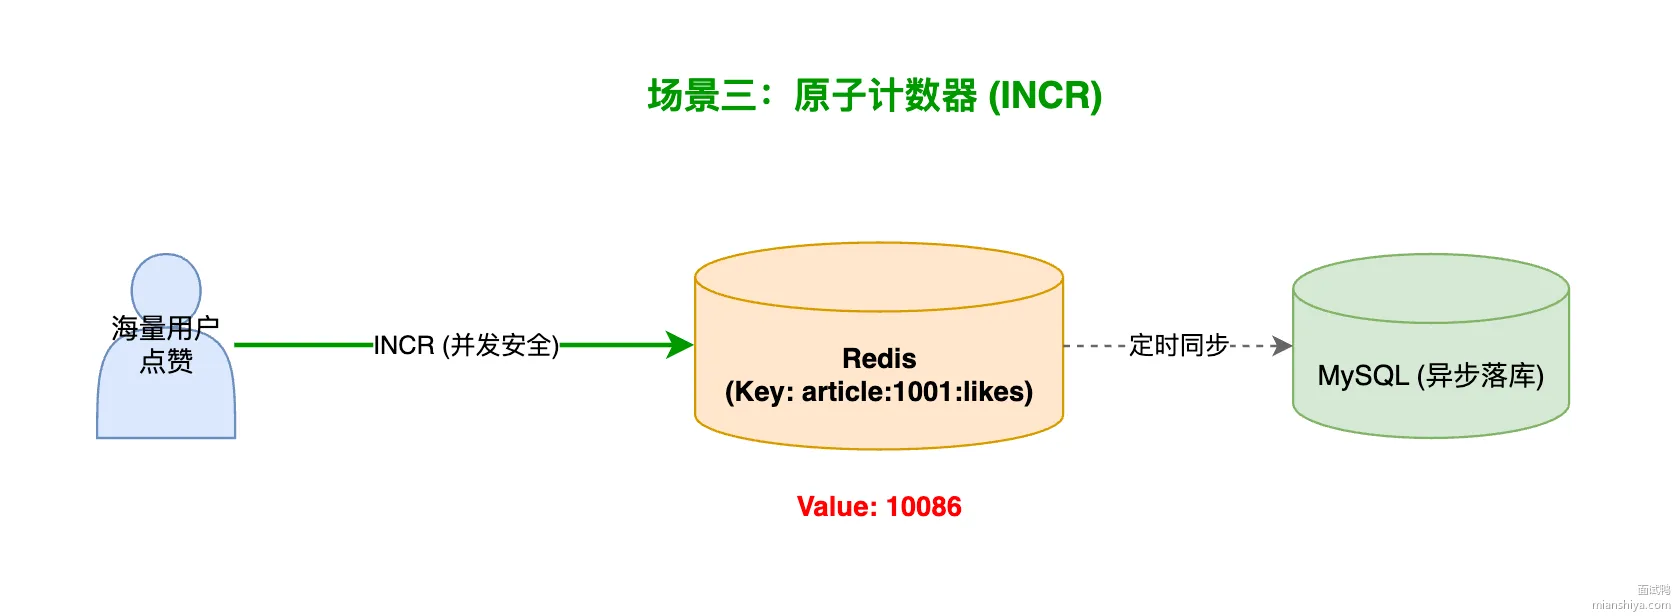
3)第三,高频的计数器与限流
如果用 MySQL 做计数,比如文章阅读量、点赞数,每次都要 update 数据库,锁竞争太严重了。 Redis 基于内存性能高很多,还是因为 Redis 单线程原子性的特点,用 INCR 命令自增,性能极高且不会算错。
另外,我们还会用 Lua 脚本配合 Redis 做 API 的限流,比如一分钟只能调 100 次。
4)第四,复杂的排行榜业务
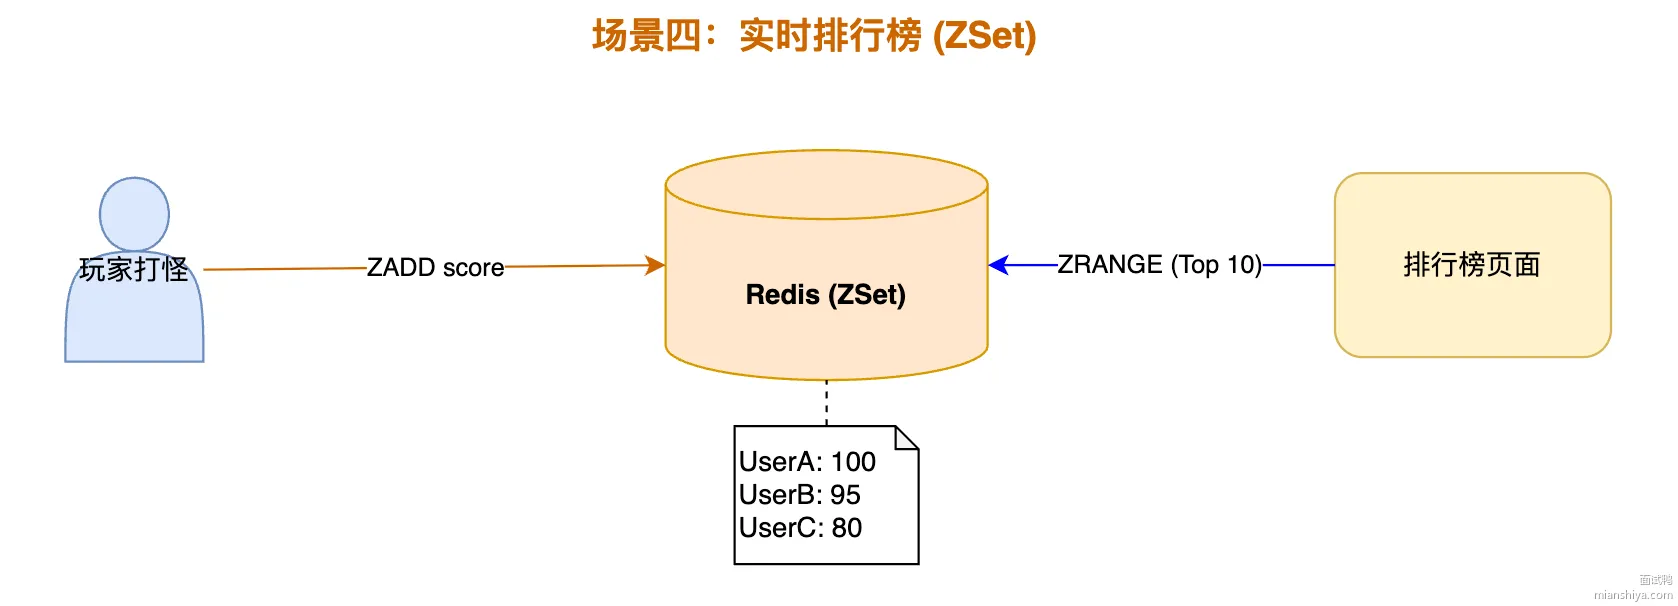
如果在数据库里做实时排名,需要全表扫描排序,数据量一大数据库就崩了。
Redis 有个专门的数据结构叫 ZSet,它写入时就自动排好序了。我们在做直播间贡献榜、游戏战力榜时,直接用 ZADD 和 ZRANGE 就能毫秒级拿到前 10 名。
5)第五,轻量级的消息队列
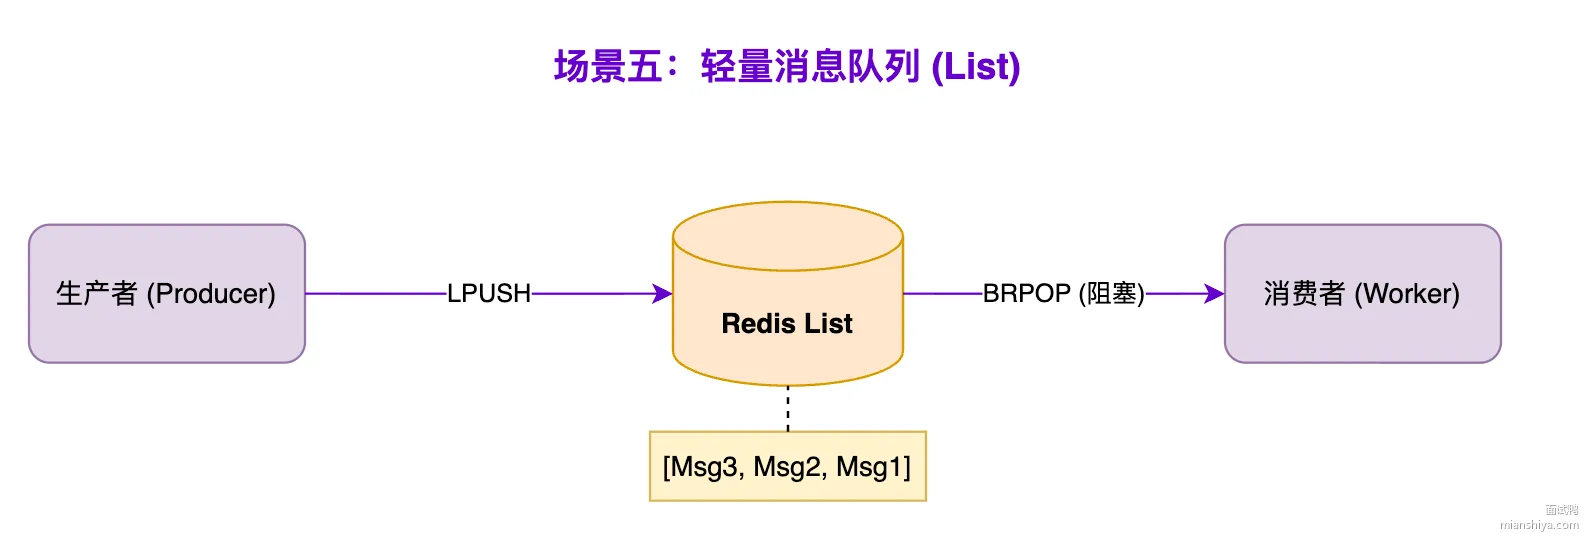
有时候不想引入 Kafka 那么重的中间件,只是做个简单的异步处理。 我们会用 List 结构的 LPUSH 和 RPOP 来做简单的任务队列。
当然,如果对消息可靠性要求很高,我们还是会选专业的 MQ。
3.1. 扩展知识
3.1.1. 缓存设计的三个常问点
缓存看着简单,用不好坑很多。
缓存穿透:查一个压根不存在的数据,每次都打到数据库。解决办法是缓存空值,或者用布隆过滤器拦截。
缓存击穿:热点 key 突然过期,大量请求同时打到数据库。解决办法是用互斥锁,只让一个请求去加载数据,其他请求等着。
缓存雪崩:大批 key 同时过期,数据库瞬间被打爆。解决办法是给过期时间加个随机值,让 key 分散过期。
数据一致性也是个头疼的问题。常见策略是"先更新数据库,再删缓存",配合消息队列做重试。强一致性场景可以考虑 Canal 监听 binlog 来同步。
更多细节可以看:27. Redis 中如何保证缓存与数据库的数据一致性?
3.1.2. 分布式锁的坑
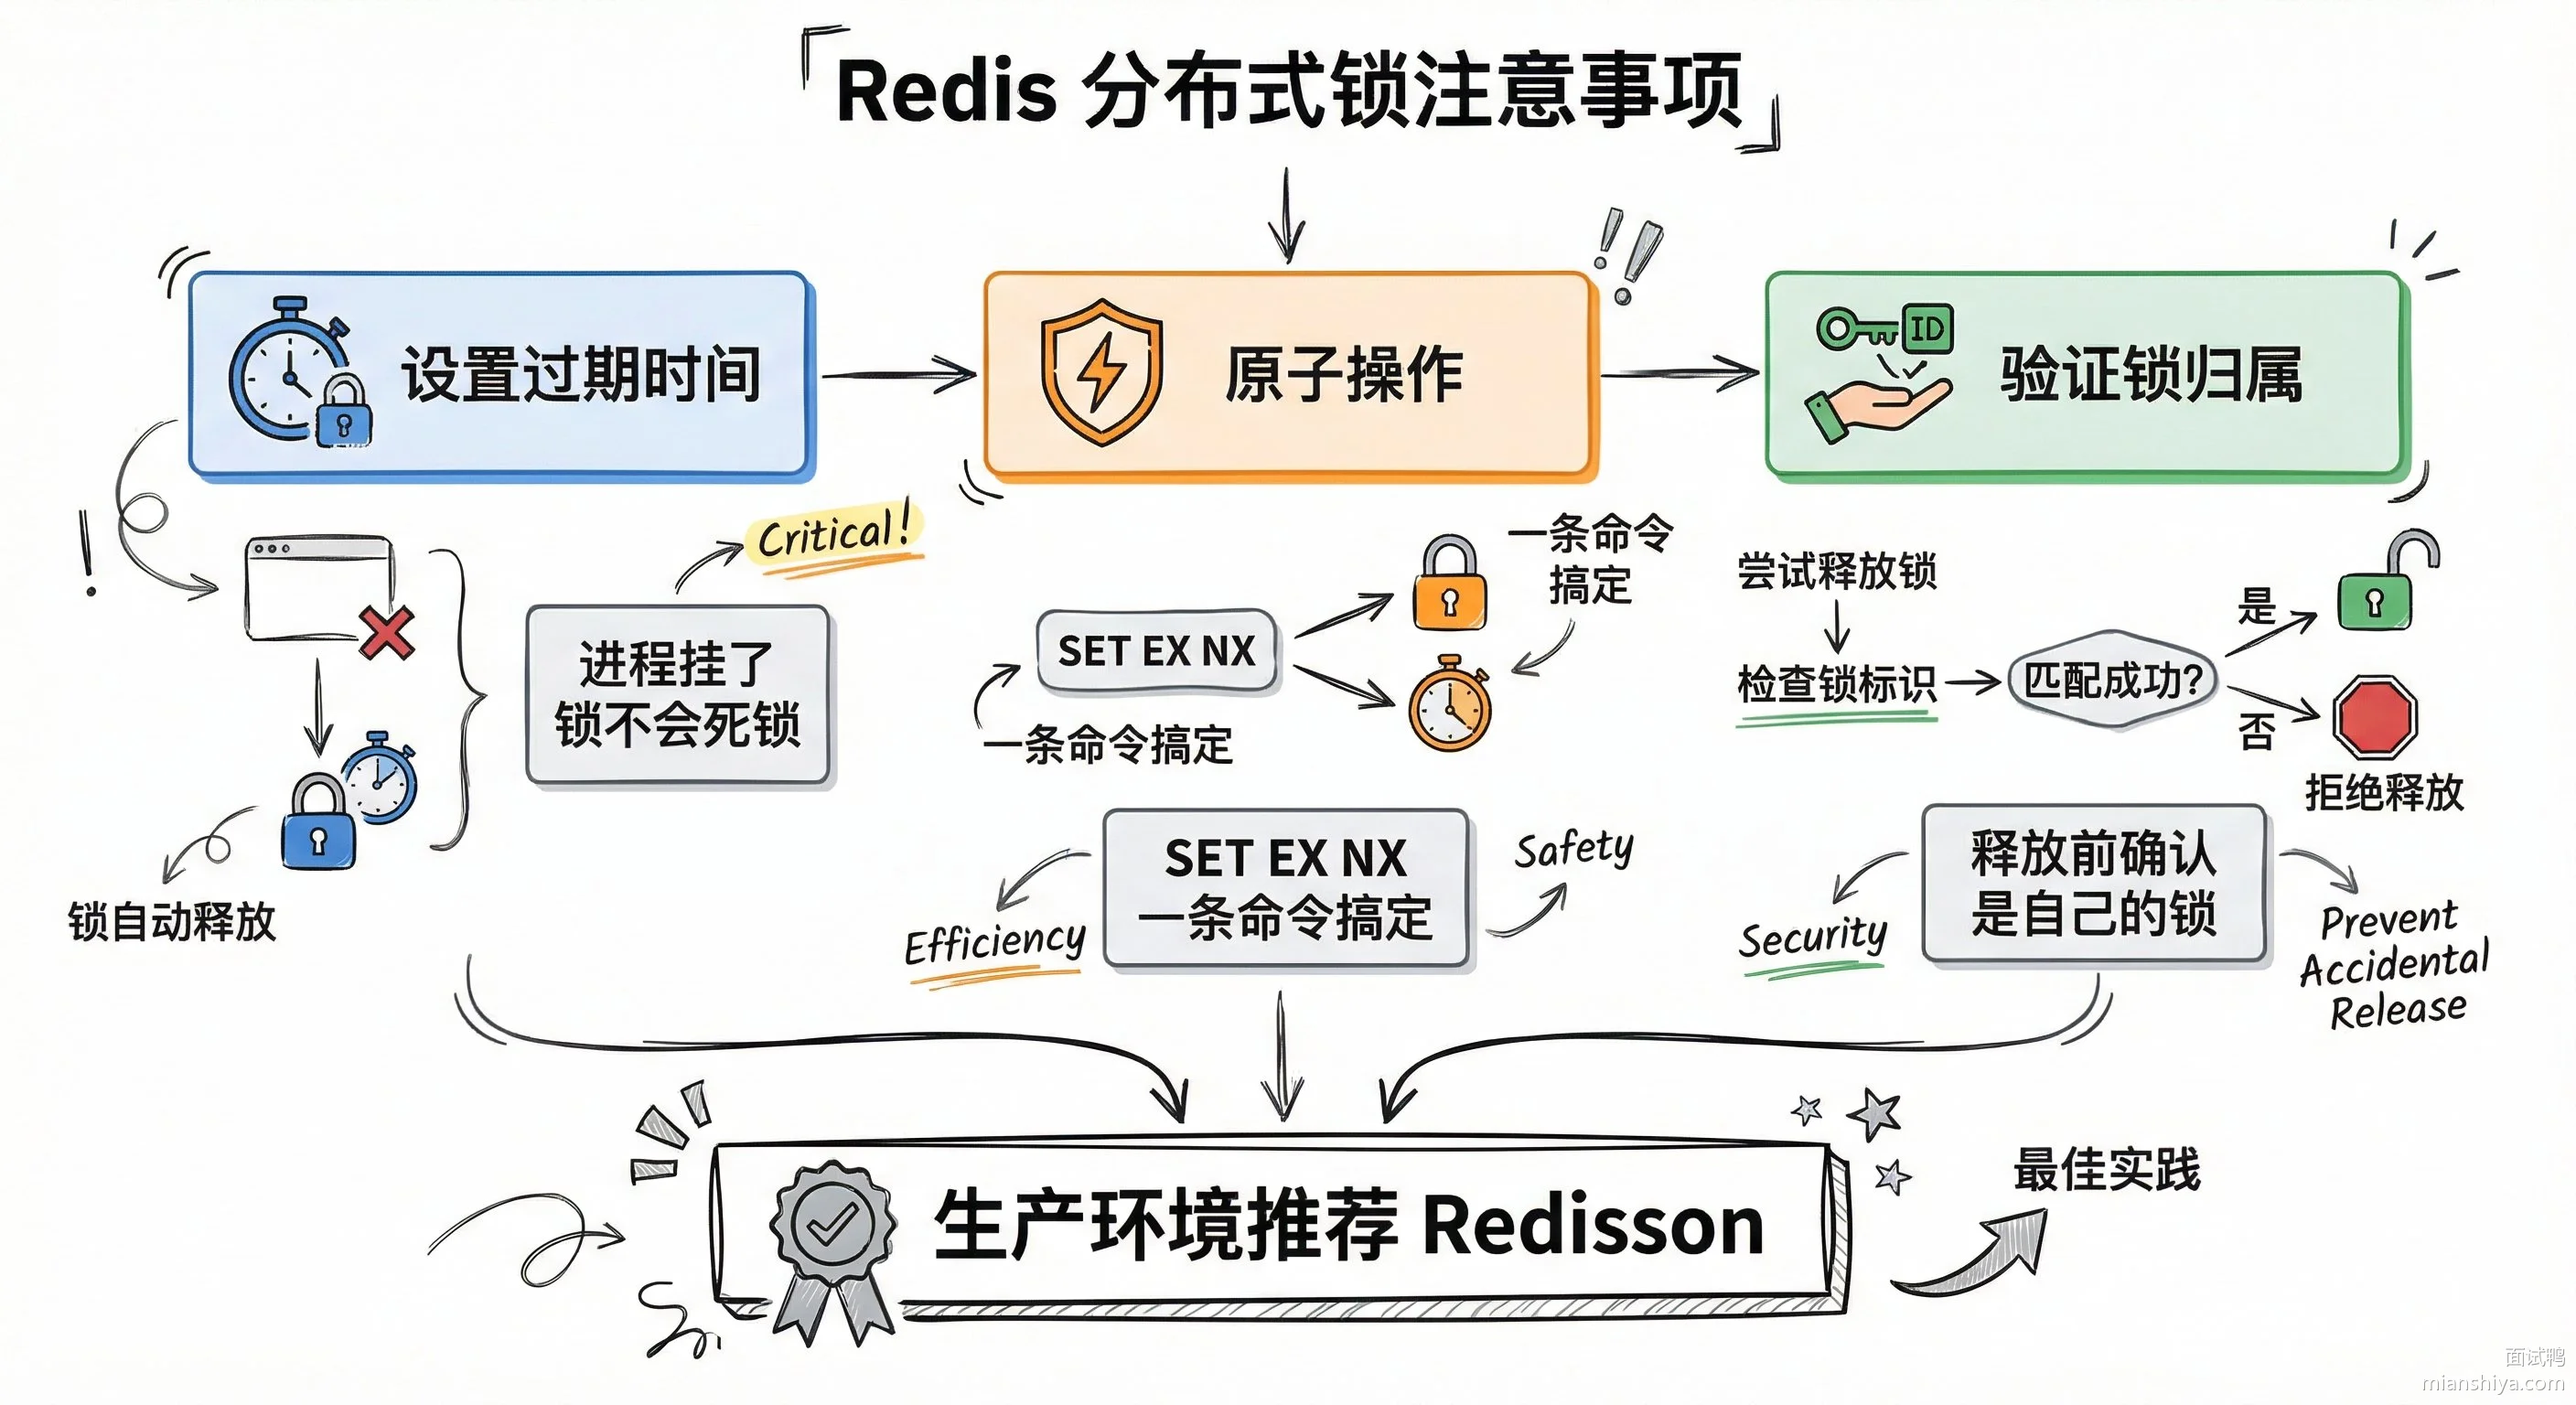
SETNX 加锁看着简单,但有几个细节容易出问题:
1)锁要设过期时间,不然进程挂了锁就死了 2)SET key value EX 30 NX 要用这种原子命令,不能分两步执行 3)释放锁要验证是不是自己的锁,防止误删别人的
生产环境建议直接用 Redisson,它帮你处理了锁续期、可重入、公平锁这些脏活累活。
更多细节可以看:22. Redis 中如何实现分布式锁?
3.1.3. 排行榜的花式玩法
ZSet 底层是跳表 + 哈希表,插入、删除、按分数范围查询都是 O(logN)。
// 玩家得分更新
jedis.zadd("game:rank", 1500, "player:1001");
// 获取前 10 名
Set<Tuple> top10 = jedis.zrevrangeWithScores("game:rank", 0, 9);
// 查某个玩家排名
Long rank = jedis.zrevrank("game:rank", "player:1001");
实时排行榜数据量大的时候,可以按时间分桶,比如每小时一个 key,定期合并到总榜。
更多细节可以看:29. 如何使用 Redis 快速实现排行榜?
3.1.4. Redis 5.0 的 Stream
List 做消息队列有个问题:消息消费完就没了,没法回溯,也没有消费者组的概念。
Redis 5.0 引入了 Stream,专门用来做消息队列:
1)支持消费者组,多个消费者可以分摊消息 2)消息有 ID,支持 ACK 确认 3)支持消息回溯,消费失败可以重新处理
不过 Stream 的可靠性还是比不上 Kafka、RocketMQ,适合对消息丢失容忍度较高的场景。
3.2. 常见问题
3.2.1. 缓存和数据库双写,你们怎么保证一致性的?
详细解答可以看:Redis 中如何保证缓存与数据库的数据一致性?
我们用的是"先更新数据库,再删缓存"的策略。删缓存失败的话,会发消息到 MQ 做异步重试。核心业务还会配合 Canal 监听 binlog,binlog 变了就触发缓存更新,兜底保证最终一致性。
3.2.2. Redisson 的看门狗机制是怎么回事?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
加锁时如果不指定过期时间,Redisson 会启动一个后台线程,默认每 10 秒检查一次锁是否还被持有,如果是就自动续期到 30 秒。这样既能防止业务没执行完锁就过期,又能在进程挂掉后锁自动释放。
3.2.3. 你说 Redis 单线程能抗 10 万 QPS,那为什么不用多线程?
详细解答可以看:为什么 Redis 设计为单线程?6.0 版本为何引入多线程?
Redis 的瓶颈不在 CPU,而在网络 IO 和内存带宽。单线程避免了锁竞争和上下文切换的开销,代码也简单。6.0 版本引入的多线程只是用来处理网络 IO,命令执行还是单线程的。
4. Redis 为什么这么快?
4.1. 核心要点
Redis 快的核心原因就三个:纯内存操作、单线程 + IO 多路复用、高效的数据结构。
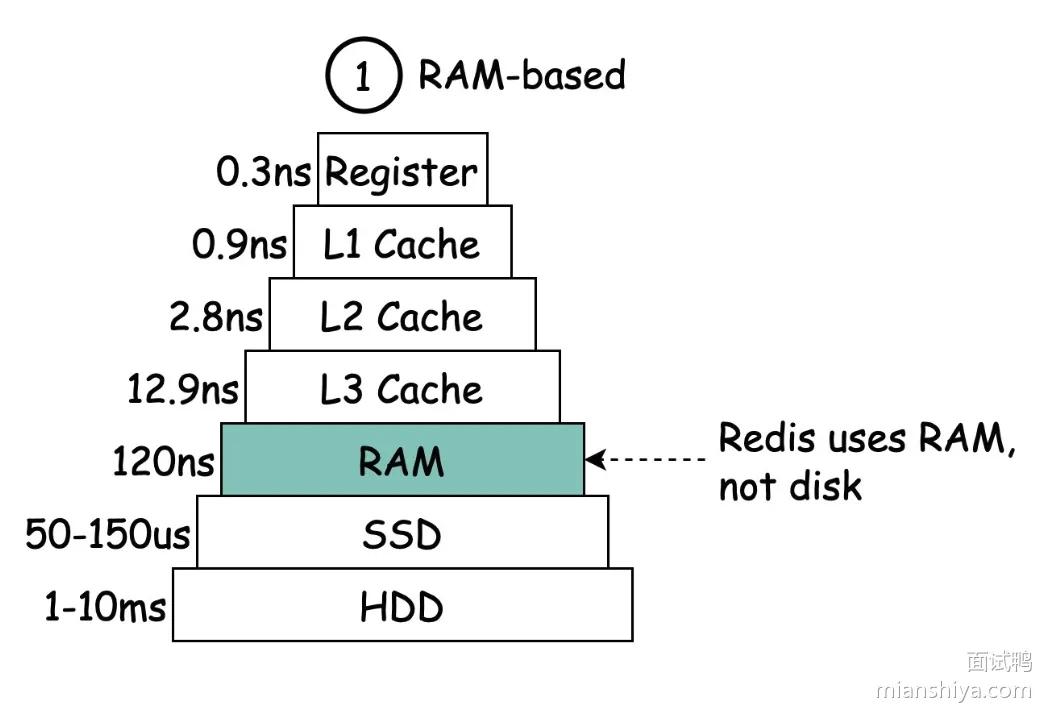
1)内存 vs 磁盘
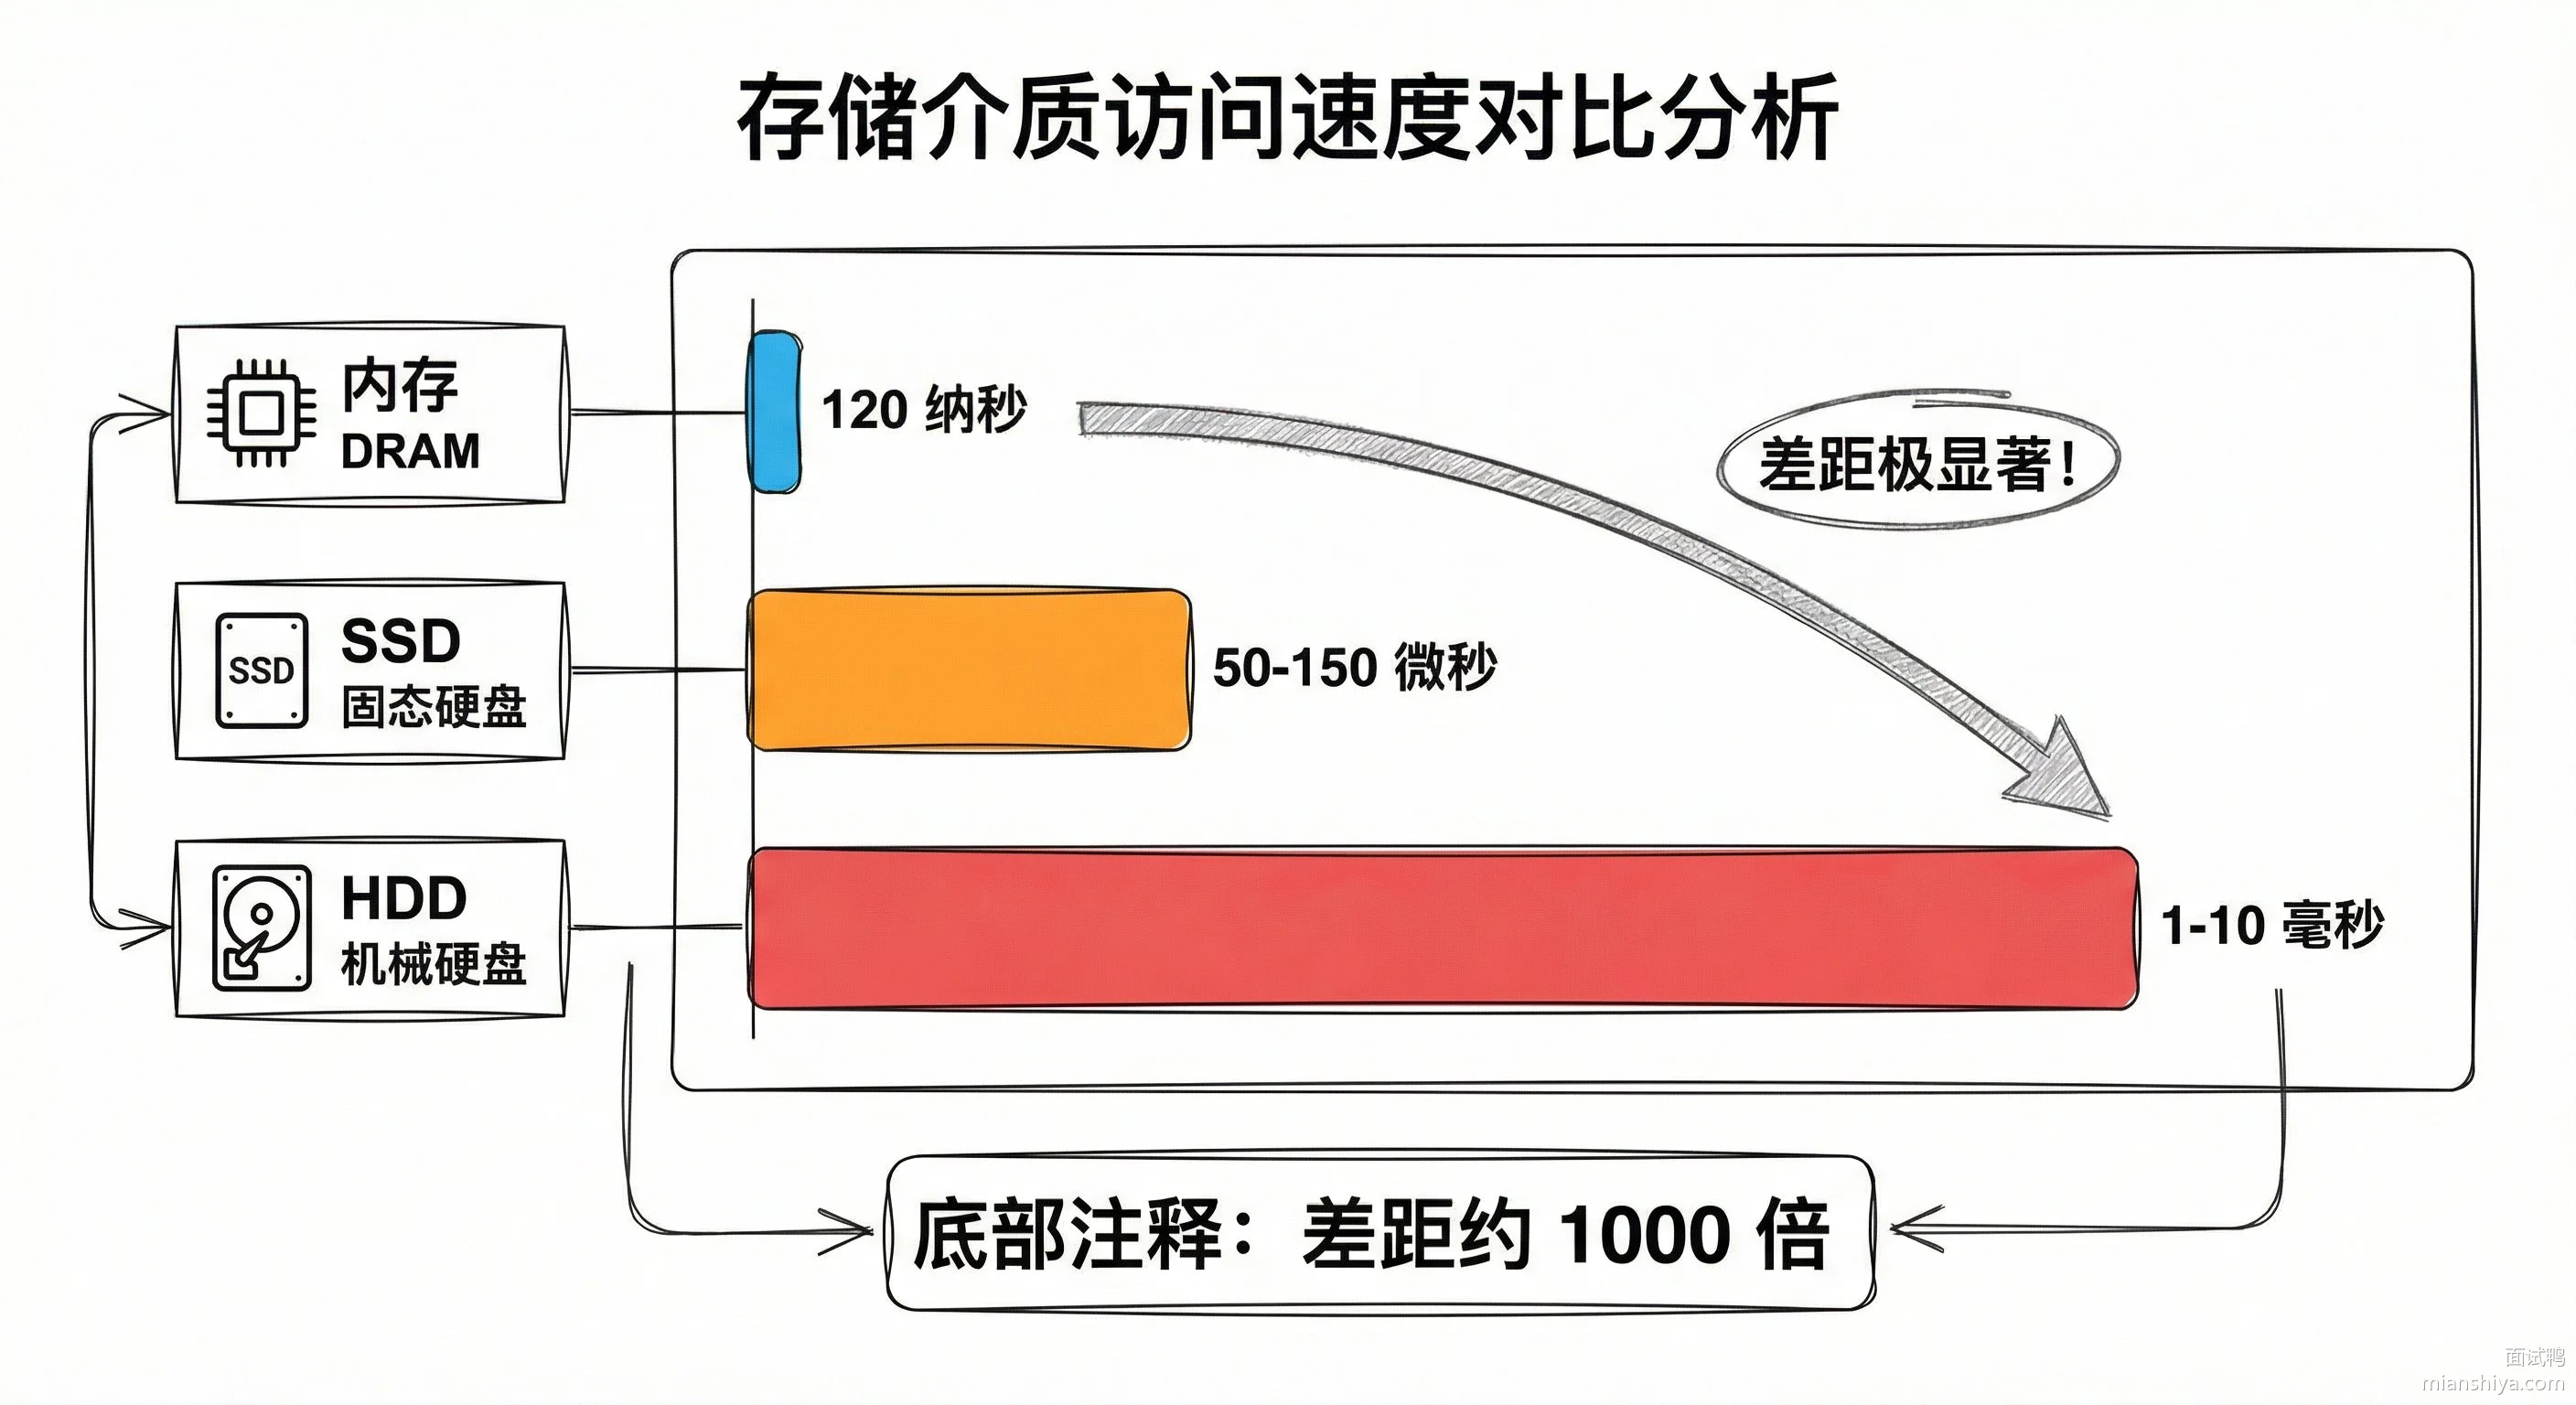
访问一次内存大概 120 纳秒,访问一次 SSD 要 50-150 微秒,传统机械硬盘更慢,要 1-10 毫秒。内存比磁盘快了将近 1000 倍。Redis 把数据全放内存里,除了持久化,基本不跟磁盘打交道。
2)单线程 + IO 多路复用
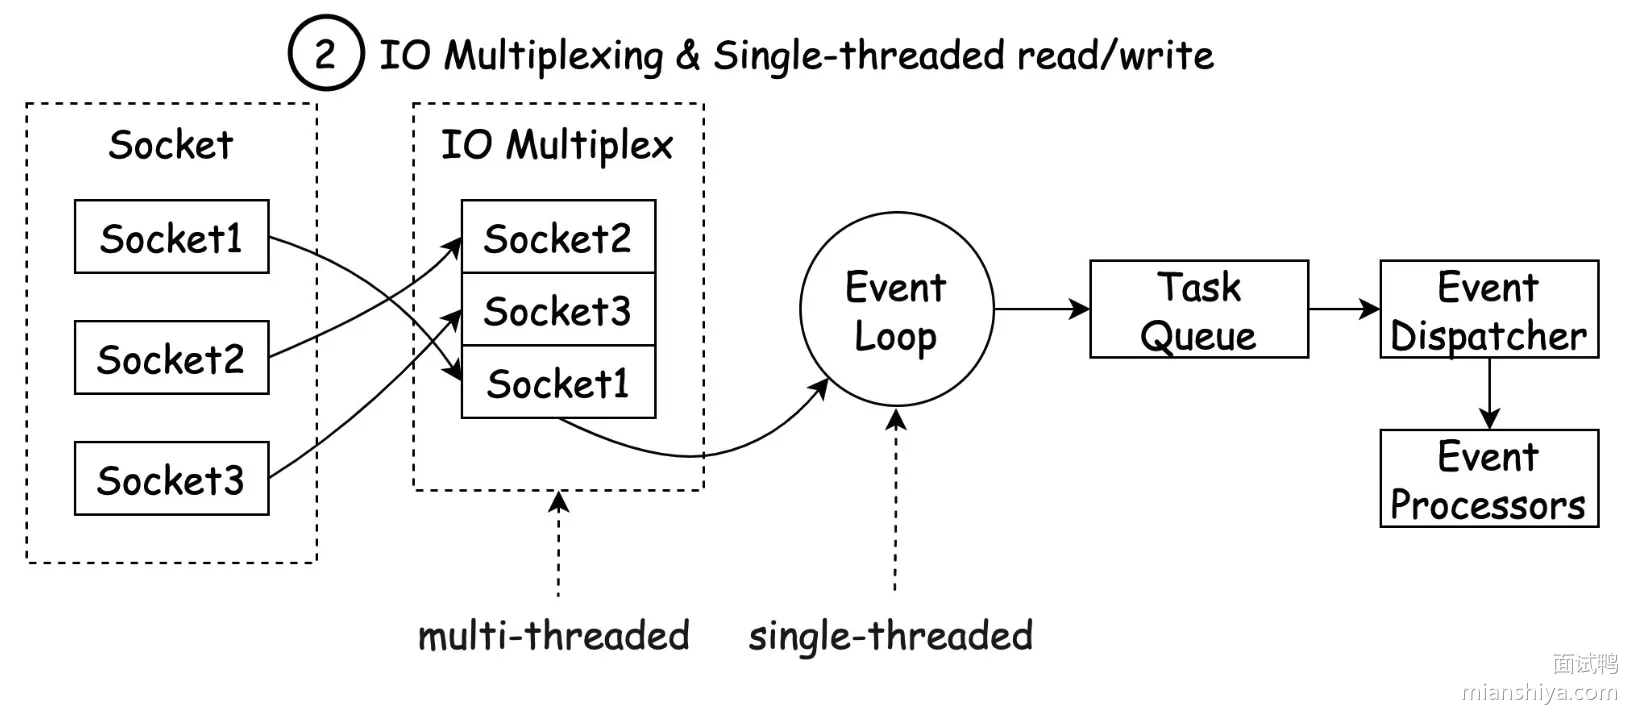
Redis 用单线程执行命令,没有锁竞争,没有上下文切换。网络 IO 用 epoll 多路复用,一个线程就能同时盯着几万个 socket 连接,哪个连接有数据就处理哪个,不用傻等。
3)数据结构精心设计
Redis 的数据结构都是为快而生的。String 底层是 SDS,O(1) 获取长度;Hash 小数据量用 ziplist 省内存,大数据量用 hashtable 保证 O(1) 查询;ZSet 用跳表,插入查询都是 O(logN)。
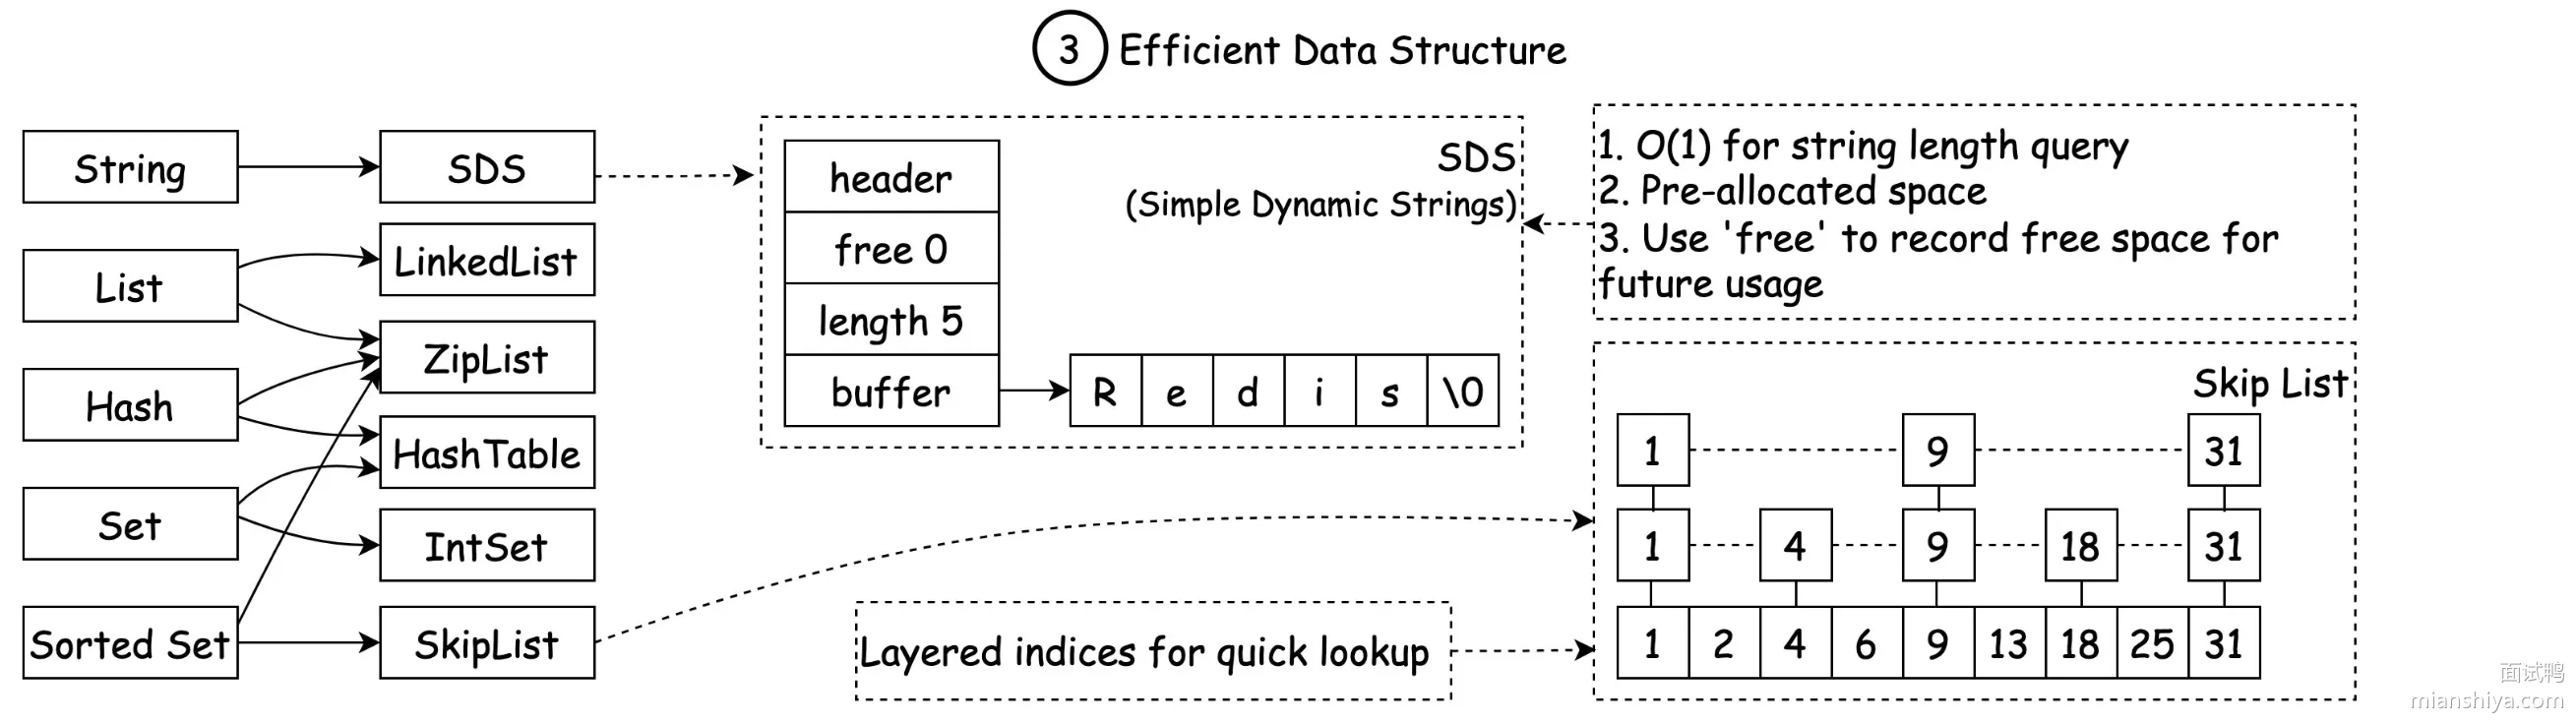
备注:上图来自 ByteByteGo
4.2. 扩展知识
4.2.1. 内存访问为什么这么快
CPU 访问内存走的是总线,数据直接从内存条的 DRAM 芯片读到 CPU 缓存,整个过程是电信号传输,纳秒级别。
访问磁盘就不一样了。机械硬盘要等磁头寻道、盘片旋转,物理动作就慢。SSD 虽然没有机械部件,但要经过主控芯片、闪存颗粒的寻址,还有 PCIe 或 SATA 总线的协议开销,怎么都比内存慢一个数量级。
Redis 就是吃准了这个速度差,把热数据全放内存,冷数据才落盘。
4.2.2. IO 多路复用的原理
传统的阻塞 IO,一个线程只能盯一个连接,连接多了就得开很多线程,线程切换开销大。
IO 多路复用是让一个线程同时监听多个文件描述符。Linux 下常用的是 epoll:
1)把要监听的 socket 注册到 epoll 实例 2)调用 epoll_wait 阻塞等待 3)有事件就绪时,epoll_wait 返回就绪的 socket 列表 4)挨个处理这些 socket 的读写
Redis 在 Linux 下用 epoll,macOS 下用 kqueue,Windows 下用 select。底层实现不一样,但思路都是一样的:用事件驱动替代线程轮询。
相关知识点:
- 说说你知道的几种 I/O 模型
- Select、Poll、Epoll 之间有什么区别?
4.2.3. 单线程为什么不是瓶颈
Redis 的瓶颈不在 CPU,而在网络带宽和内存带宽。一条简单的 GET/SET 命令,CPU 执行时间是微秒级,网络往返才是大头。
单线程的好处: 1)没有锁,代码简单,不容易出 bug 2)没有线程切换开销,上下文切换一次要几微秒 3)CPU 缓存命中率高,数据结构不会被别的线程改
Redis 官方实测,单机单线程能跑到 10 万+ QPS,大多数业务场景够用了。
4.2.4. 6.0 的多线程到底改了啥
Redis 6.0 引入了多线程,但只是用来处理网络 IO,命令执行还是单线程的。
以前的流程:单线程读网络数据 → 解析命令 → 执行命令 → 写响应
现在的流程:多线程并行读网络数据 → 单线程执行命令 → 多线程并行写响应
网络 IO 是瓶颈的场景,比如大量小包请求,多线程能提升 1 倍左右的吞吐量。命令执行还是单线程,所以不用担心数据一致性问题。
配置方法:
# redis.conf
io-threads 4          # 开 4 个 IO 线程
io-threads-do-reads yes  # 读也用多线程
4.2.5. 数据结构的精妙设计
Redis 的每种数据结构都有讲究:
SDS(Simple Dynamic String):比 C 语言原生字符串多存了一个 len 字段,获取长度 O(1),还支持二进制安全,能存图片、序列化对象。
ziplist:紧凑的连续内存结构,省内存但查询是 O(N)。Hash、List、ZSet 在数据量小的时候都用它。
quicklist:Redis 3.2 之后 List 的底层实现,把多个 ziplist 用双向链表串起来,兼顾内存和性能。
skiplist:ZSet 的底层之一,查询、插入、删除都是 O(logN),实现比红黑树简单,范围查询更方便。
更多细节:
4.3. 常见问题
4.3.1. 你说单线程能跑 10 万 QPS,那什么情况下会成为瓶颈?
两种情况。第一是大 key 操作,比如删一个几百 MB 的 Hash,单线程删的时候别的命令都得等着,整个服务卡住。第二是 CPU 密集型命令,比如 KEYS * 遍历所有 key,或者 Lua 脚本里有复杂计算。这些场景要尽量避免,或者用 SCAN 替代 KEYS,用 UNLINK 替代 DEL。
4.3.2. epoll 和 select 有什么区别?为什么 Redis 选 epoll?
详细解答可以看:Select、Poll、Epoll 之间有什么区别?
select 有两个问题。第一,监听的文件描述符有上限,默认 1024 个。第二,每次调用都要把整个 fd_set 从用户态拷到内核态,然后内核遍历一遍看哪个就绪,连接多了效率很低。epoll 用红黑树管理 fd,增删改都是 O(logN),而且只返回就绪的 fd 列表,不用遍历全部。连接数上万的时候,epoll 的优势就很明显了。
4.3.3. Redis 4.0 引入的 UNLINK 命令是干嘛的?
DEL 命令删大 key 会阻塞主线程,UNLINK 是异步删除,主线程只负责把 key 从 keyspace 里摘掉,实际的内存回收交给后台线程慢慢做。删一个几百 MB 的 key,DEL 可能卡几秒,UNLINK 几乎不卡。
4.3.4. Redis 的持久化会影响性能吗?
会。RDB 做 fork 的时候,如果数据量大,fork 本身就要几百毫秒。AOF 如果配置成 always 同步刷盘,每条命令都要等磁盘写完,QPS 会掉到几千。生产环境一般用 everysec,每秒刷一次盘,性能和安全性折中。
5. 为什么 Redis 设计为单线程?6.0 版本为何引入多线程?
5.1. 核心要点
Redis 用单线程是因为它的瓶颈压根不在 CPU,而在内存和网络 IO。
单线程的好处很明显:代码简单不容易出 bug,没有锁竞争,没有上下文切换开销。一个线程配合 IO 多路复用,单机就能跑到 10 万+ QPS,大多数业务够用了。
6.0 引入多线程,是因为业务量上来之后,网络 IO 成了瓶颈。数据从内核拷贝到用户空间这一步是同步的,并发量高的时候,单线程处理不过来。多线程分摊网络读写的工作,命令执行还是单线程,既提升了吞吐量,又不用担心线程安全问题。
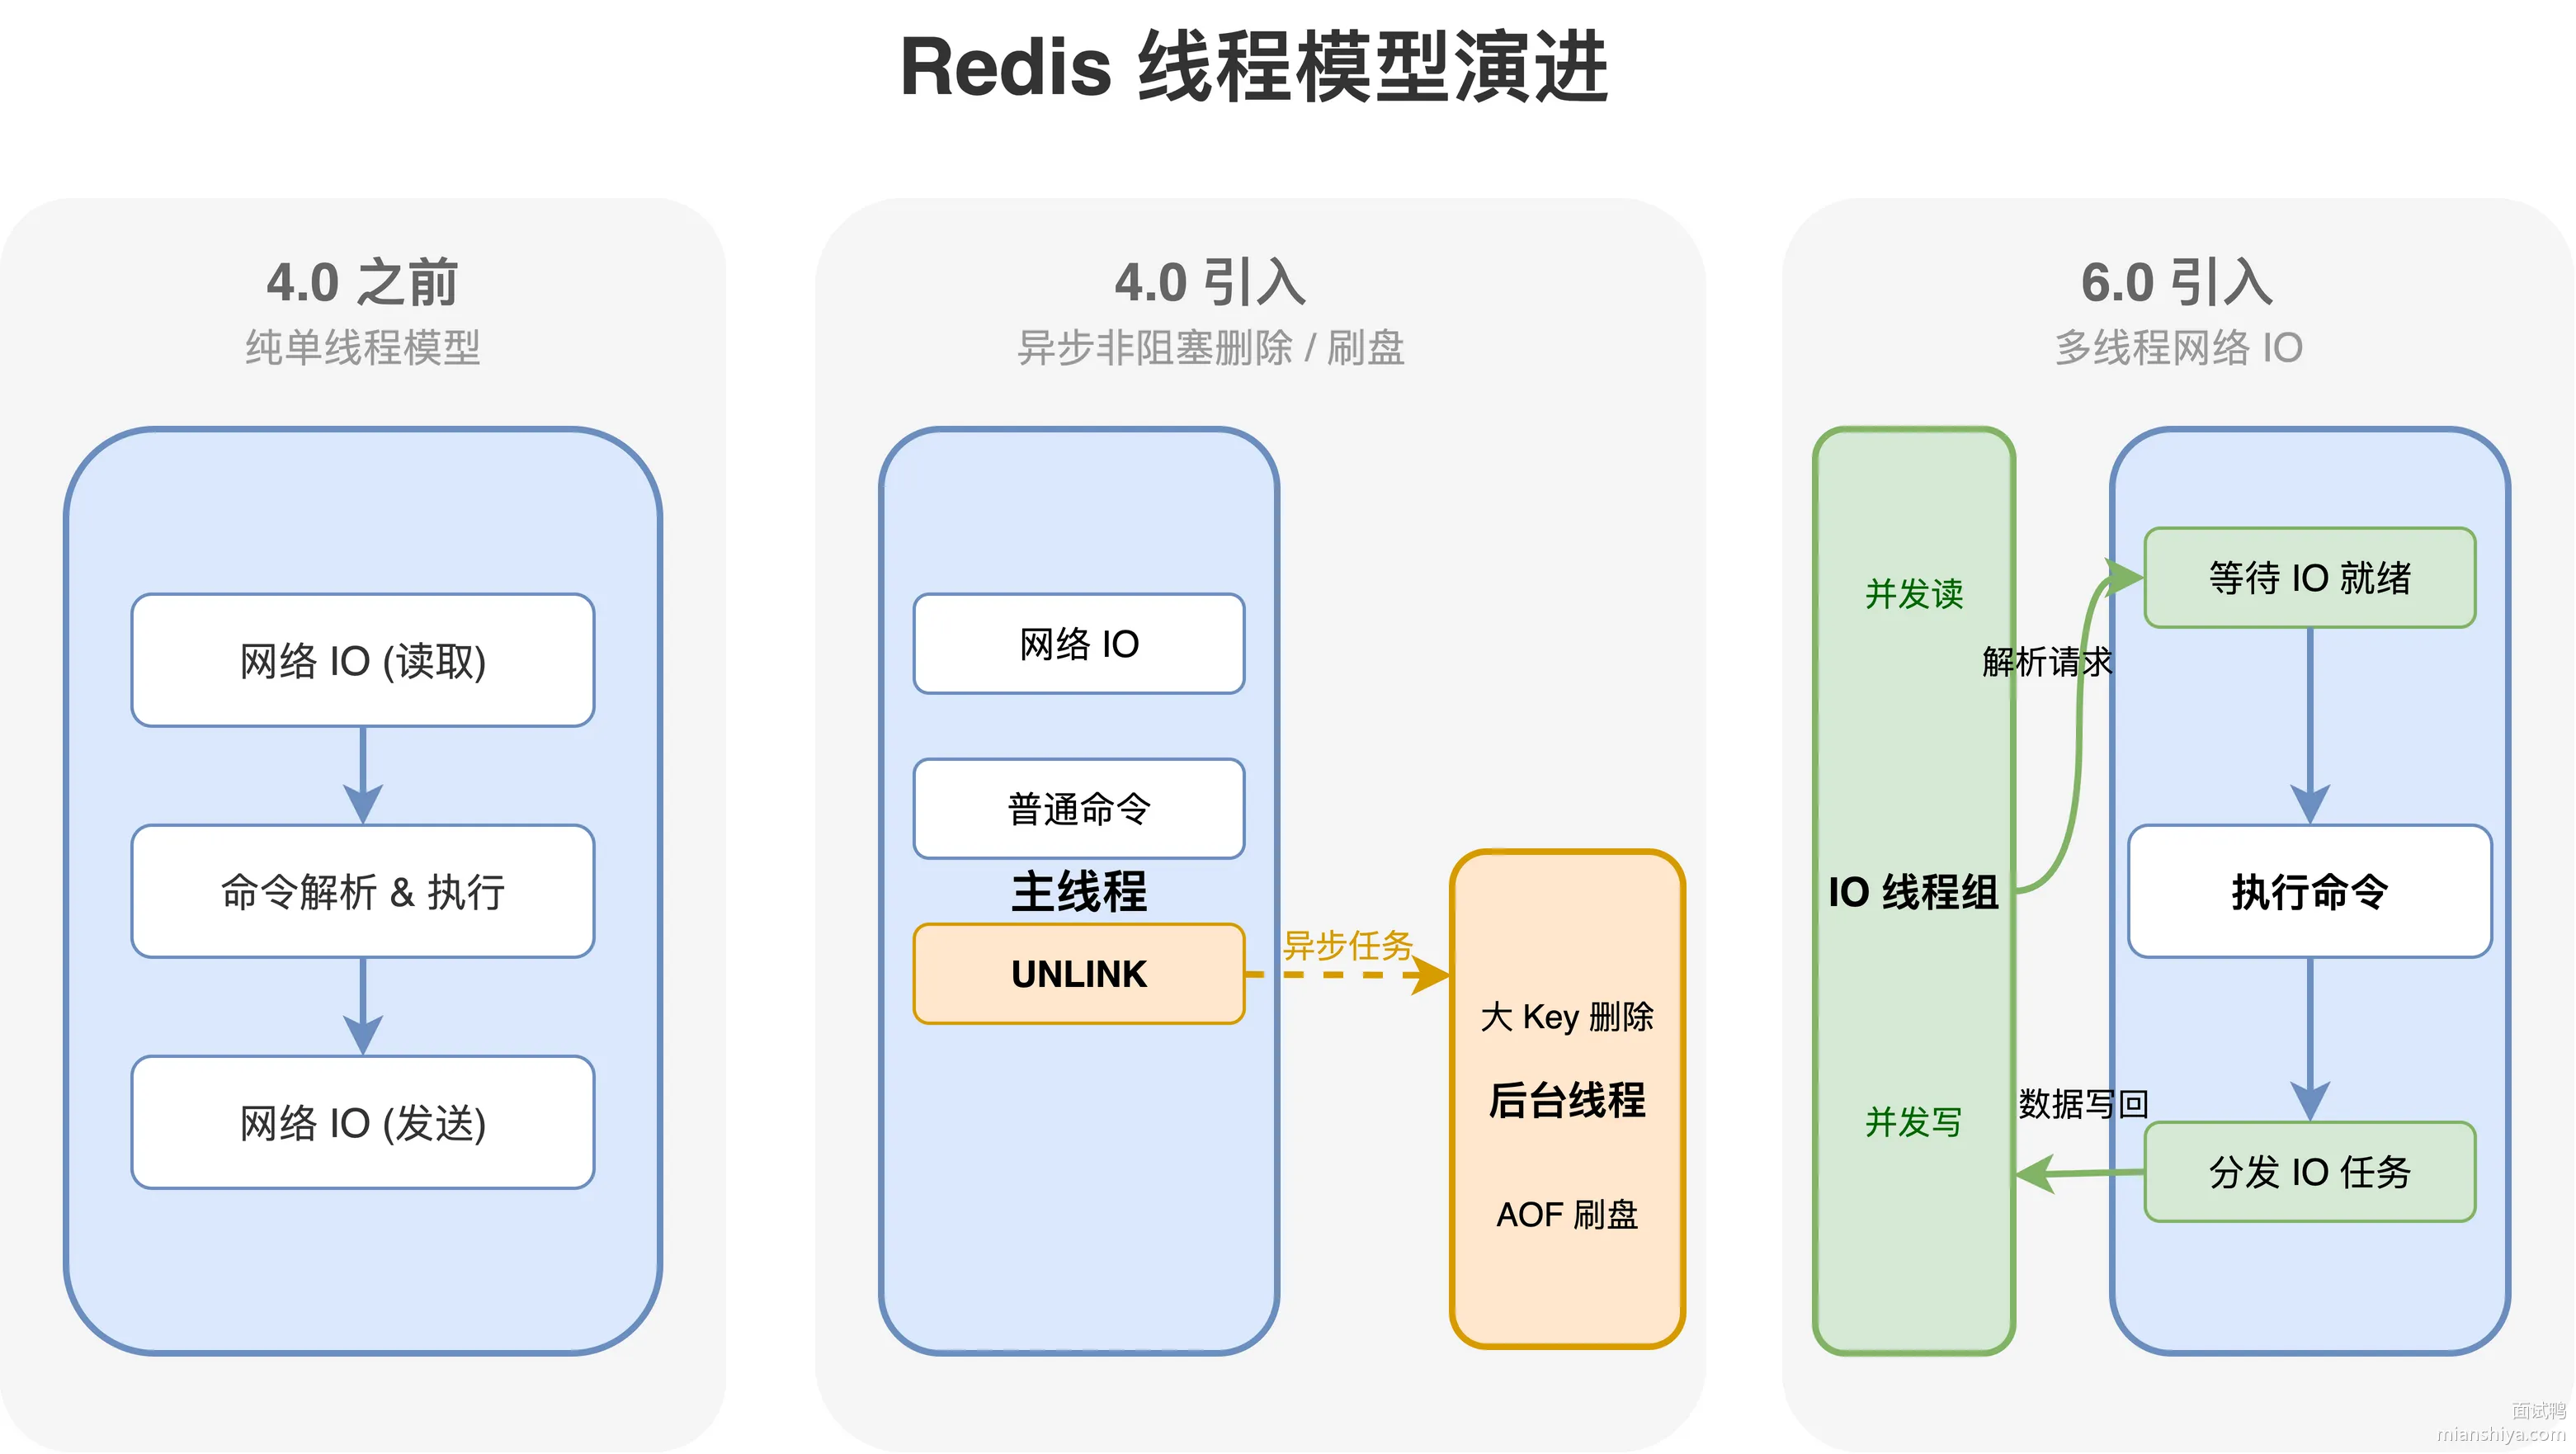
4.0 之前:纯单线程,网络 IO、命令执行都在主线程
4.0 引入:后台线程处理大 key 删除、AOF 刷盘这些耗时操作
6.0 引入:多线程处理网络 IO,主线程只负责执行命令
5.2. 扩展知识
5.2.1. 单线程指的是什么
说 Redis 单线程,指的是网络 IO 和命令执行在一个线程里完成。其实 Redis 一直有后台线程,比如:
- bio_close_file:关闭大文件
- bio_aof_fsync:AOF 持久化刷盘
- bio_lazy_free:4.0 引入的异步删除大 key
这些后台线程处理的是那些可能阻塞主线程的脏活累活,主线程只专注于处理客户端请求。
5.2.2. 为什么单线程反而更快
多线程不一定比单线程快,得看瓶颈在哪。
Redis 一条 GET 命令,CPU 执行时间大概几微秒,网络往返时间是毫秒级,差了 3 个数量级。CPU 根本不是瓶颈,上多线程反而增加复杂度。
多线程的开销:
- 线程创建和销毁要消耗资源
- 上下文切换一次要几微秒
- 多线程访问共享数据要加锁,锁竞争也是开销
- 代码复杂度上升,bug 更多
Redis 选择单线程 + IO 多路复用,简单高效。Nginx 也是类似的设计思路。
5.2.3. 6.0 多线程的工作原理
6.0 的多线程只用于网络 IO,命令执行还是单线程。
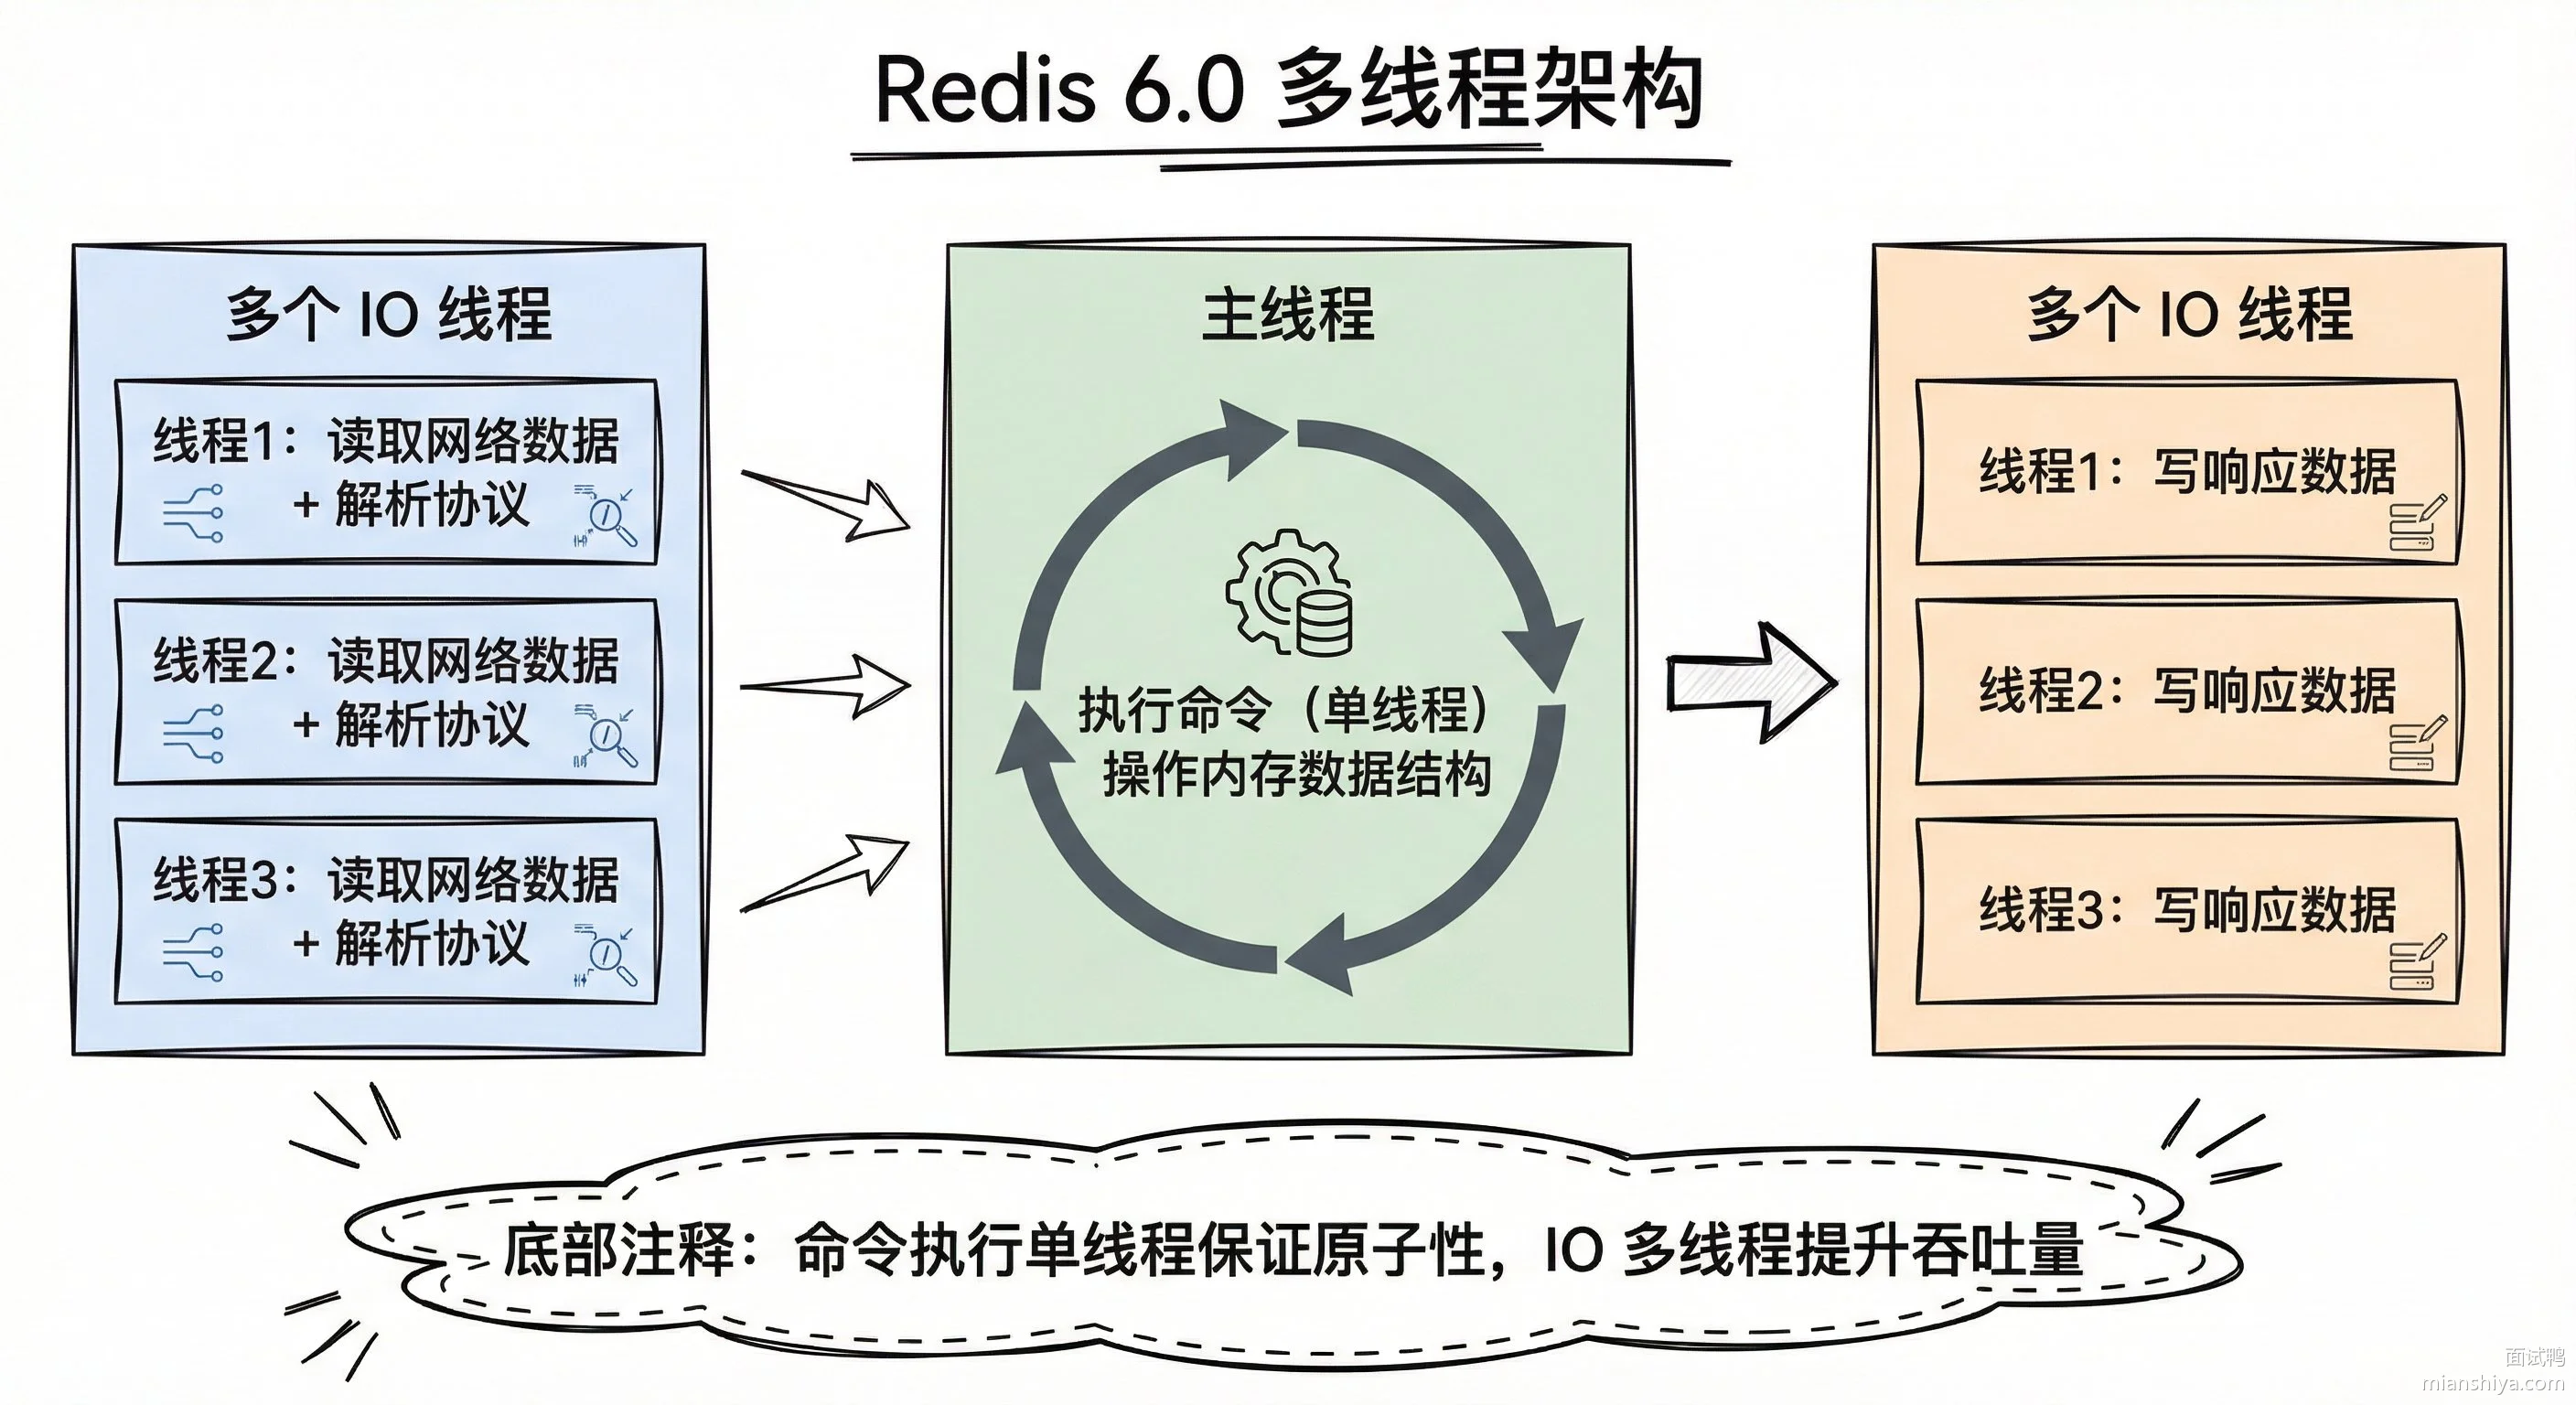
具体流程:
- 主线程接收到客户端连接,把待读取的 socket 分配给 IO 线程
- IO 线程并行读取网络数据,解析成 Redis 命令
- 主线程单线程执行所有命令
- 执行完毕后,IO 线程并行写响应数据
配置方法:
# redis.conf
io-threads 4              # 开 4 个 IO 线程,建议设为 CPU 核心数
io-threads-do-reads yes   # 读也用多线程,默认只有写用多线程
默认是关闭的,大部分业务用不上。官方建议 4 核以上机器开启,能提升 1 倍左右的网络吞吐量。
5.2.4. 为什么命令执行不用多线程
一句话:不值得。
命令执行用多线程,意味着多个线程要同时操作 Dict、ZSet 这些数据结构,就得加锁。Redis 的数据结构本身不是线程安全的,改造成本很高。
更关键的是,命令执行本身很快,几微秒的事,不是性能瓶颈。网络 IO 才是瓶颈,6.0 多线程解决的就是这个问题。
Memcached 一开始就是多线程设计,数据结构加了锁,性能并没有比 Redis 高多少,代码复杂度倒是上去了。Redis 作者 antirez 权衡之后选择了单线程执行命令的设计。
5.2.5. IO 多路复用的同步等待问题
IO 多路复用本质还是同步 IO。调用 epoll_wait 之后,如果有数据,需要把数据从内核缓冲区拷贝到用户空间,这一步主线程得等着。
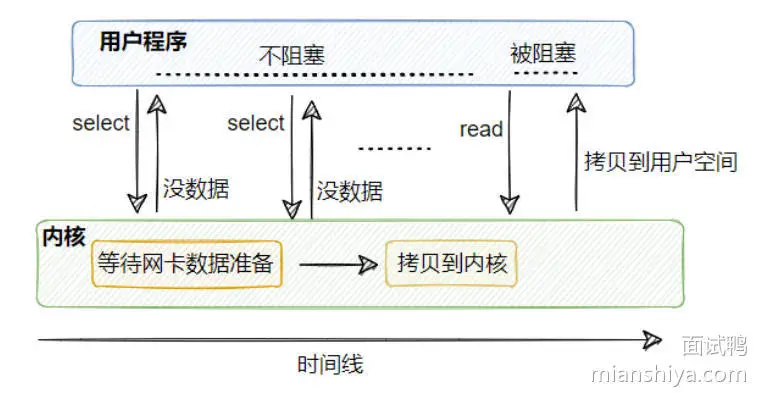
并发量高的时候,大量连接同时有数据到达,单线程处理这些拷贝操作就忙不过来了。6.0 引入多线程,就是让多个线程并行处理这些网络读写,分摊主线程的压力。
相关知识点:
- 五种 I/O 模型
- 同步、异步、阻塞、非阻塞的I/O的区别?
5.3. 常见问题
5.3.1. 开了多线程之后,Redis 还是线程安全的吗?
是的。多线程只处理网络 IO,命令执行还是单线程串行的。所有写操作都在主线程里完成,数据结构不会被并发修改,天然线程安全。
5.3.2. io-threads 设置多少合适?
官方建议是 CPU 核心数,最多不超过 8 个。IO 线程太多反而会有竞争开销。另外这个功能主要提升的是网络密集型场景的性能,如果业务的瓶颈在大 key 操作或者复杂计算,开多线程帮助不大。
5.3.3. 4.0 引入的 UNLINK 和 6.0 的多线程有什么关系?
没有直接关系,解决的是不同的问题。UNLINK 是把大 key 的内存回收放到后台线程,防止 DEL 阻塞主线程。6.0 多线程是解决网络 IO 瓶颈,提升连接并发能力。两个优化可以同时用。
5.3.4. Redis Cluster 模式下,多线程有什么需要注意的?
Cluster 每个节点都是独立的 Redis 实例,多线程配置互不影响。需要注意的是,如果机器 CPU 核心数有限,开了 IO 多线程会和业务进程抢 CPU。建议用专机部署,或者根据实际压测结果调整 io-threads 数量。
6. Redis 中常见的数据类型有哪些?
6.1. 核心要点
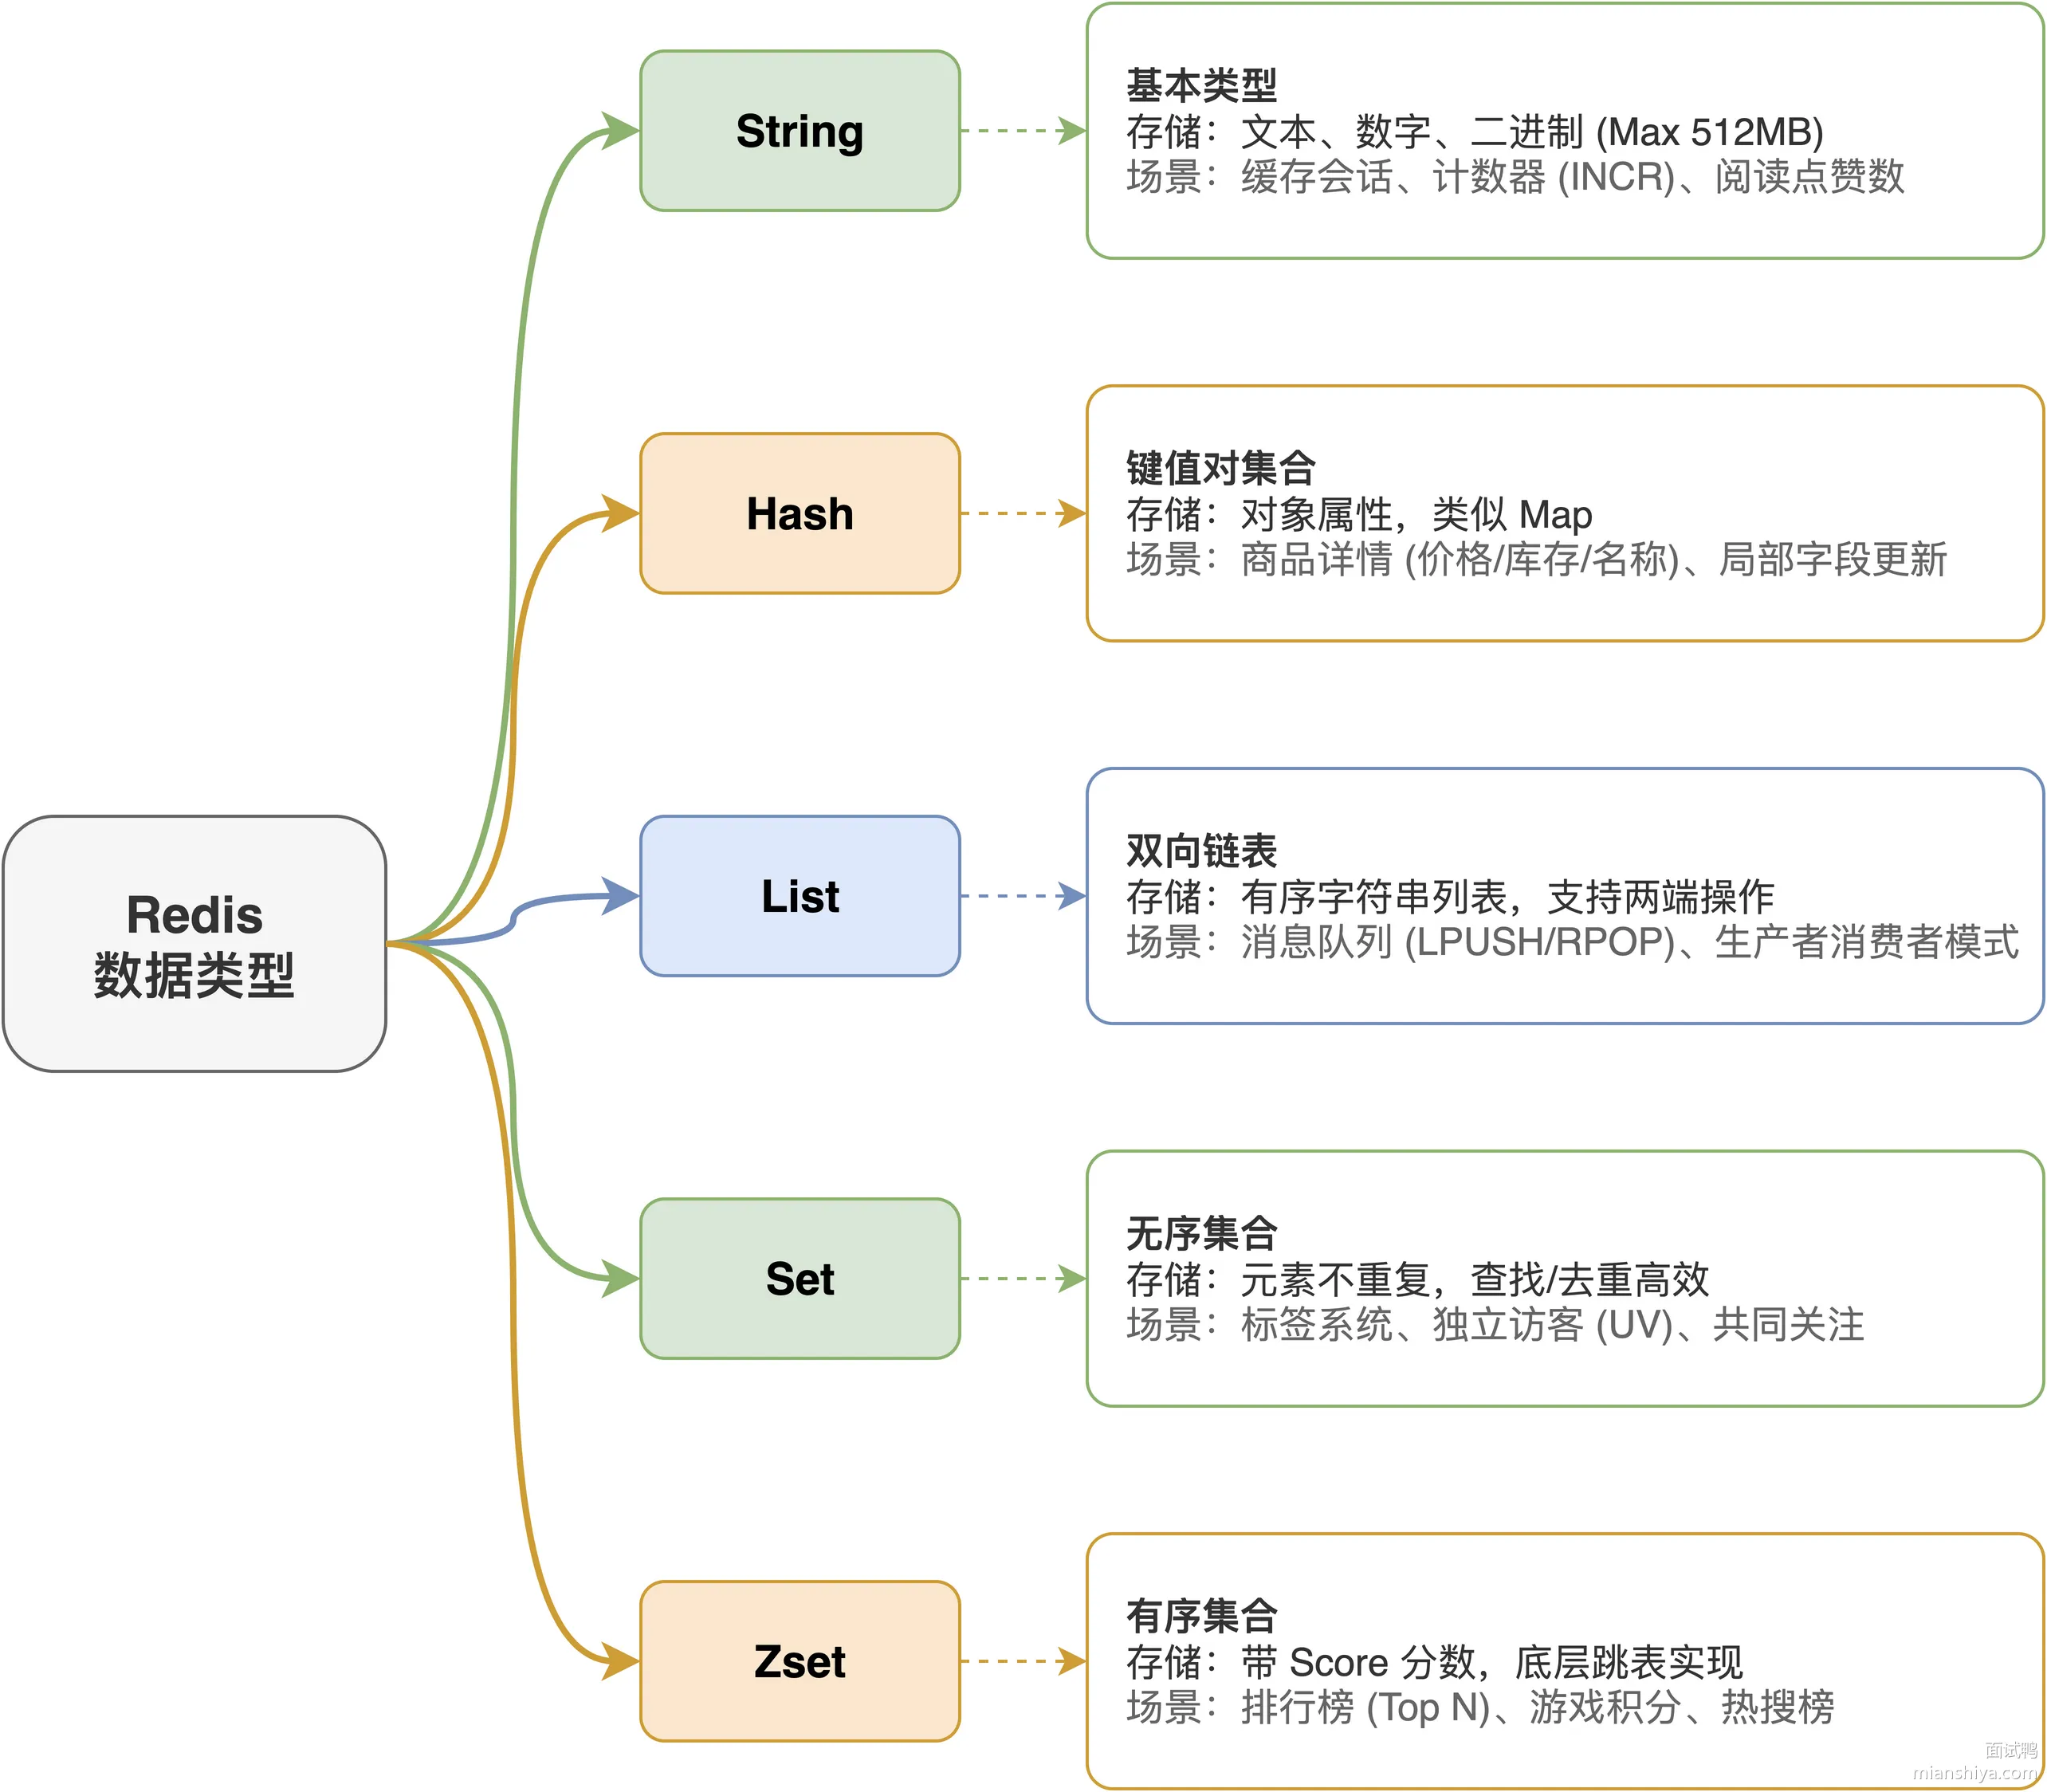
Redis 常见的数据结构主要有五种:String、List、Hash、Set、Zset。
String 是最基本的类型,能存文本、数字、二进制,最大 512MB。典型场景就是缓存用户会话、页面数据,或者做计数器,比如文章阅读量、点赞数,直接用 INCR 原子递增就行。
Hash 本质上是个键值对集合,特别适合存对象属性。比如存商品详情,商品ID作为key,价格、库存、名称这些字段都塞进一个 Hash 里,改单个字段不用整体覆盖。
List 是有序的字符串列表,底层是双向链表,支持两端操作。最常用的场景就是消息队列,LPUSH 生产消息,RPOP 消费消息,简单的生产者消费者模式就搞定了。
Set 是无序且元素不重复的集合,查找和去重效率很高。适合做标签系统、记录某个页面的独立访客、共同关注等需要去重或集合运算的场景。
Zset 跟 Set 类似,但每个元素都带一个 score 分数用来排序,底层用跳表实现。最典型的就是排行榜,比如游戏积分榜、热搜榜,按 score 排序后直接取 Top N。
6.2. 扩展知识
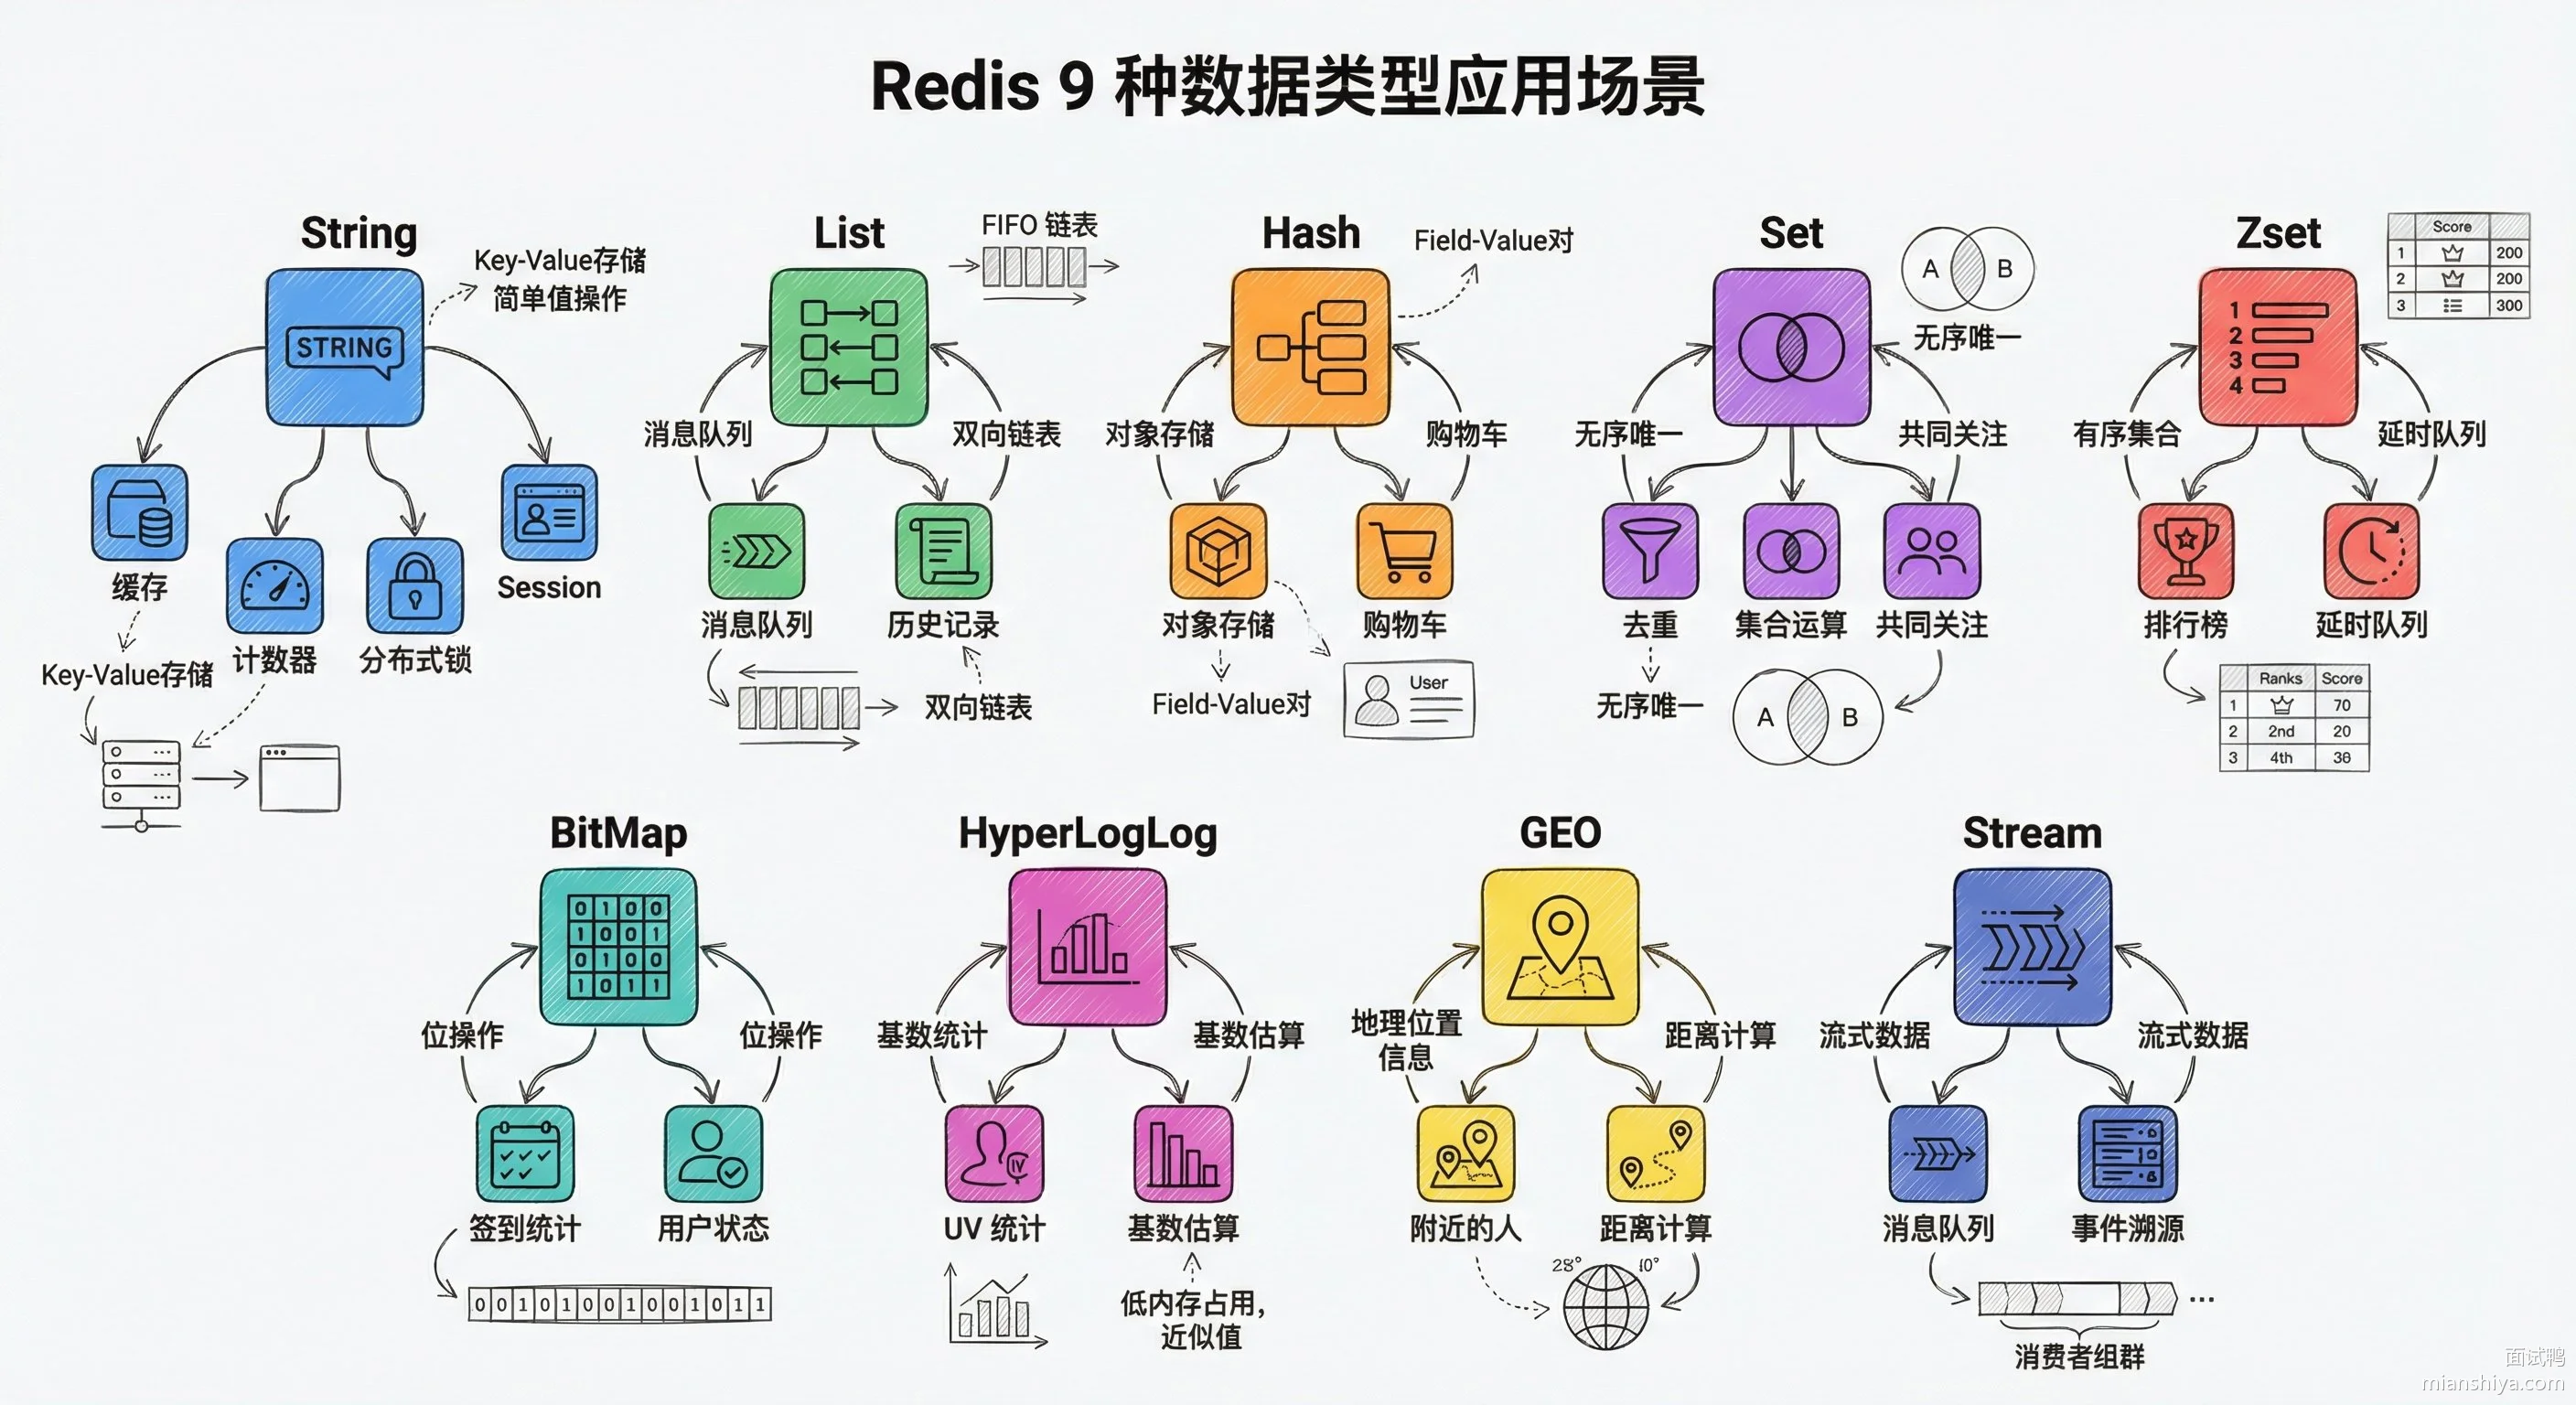
6.2.1. 四种高级数据类型
随着 Redis 版本迭代,后面陆续加了 BitMap、HyperLogLog、GEO、Stream 四种高级类型。
BitMap 在 2.2 版本引入,用位来存数据,每个 bit 只占 0 或 1,空间利用率极高。比如统计 1000 万用户的签到情况,每个用户只占 1 bit,总共才 1.2MB。用 SETBIT 设置状态,GETBIT 读取状态:
SETBIT user:sign:202409 12345 1  # 用户 12345 在 9 月签到
GETBIT user:sign:202409 12345    # 查询签到状态
HyperLogLog 在 2.8 版本引入,是个概率性数据结构,专门用来估算基数。不管塞进去多少数据,固定只占 12KB 内存,代价是有 0.81% 左右的误差。适合统计网站 UV 这种对精度要求不高但数据量巨大的场景:
PFADD page:uv user1 user2 user3  # 记录访问用户
PFCOUNT page:uv                  # 估算独立用户数
GEO 在 3.2 版本引入,用来存地理位置信息,支持经纬度存储和空间查询。底层其实是用 Zset 实现的,经纬度会被编码成 score。典型场景就是"附近的人"、外卖配送距离计算:
GEOADD riders 116.403 39.915 "rider001"   # 存骑手位置
GEORADIUS riders 116.4 39.9 5 km          # 查 5 公里内的骑手
Stream 在 5.0 版本引入,是专门为消息队列设计的数据结构。相比 List 做队列,Stream 多了两个关键特性:自动生成全局唯一消息 ID,支持消费组模式。相比 Pub/Sub 最大的优势是消息可以持久化,消费者挂了重启还能继续消费。
6.2.2. 数据类型与底层编码的关系
Redis 的每种数据类型在底层可能有多种编码实现,会根据数据量和元素大小自动切换:
| 数据类型 | 小数据量编码 | 大数据量编码 | 切换阈值 |
|---|---|---|---|
| String | int/embstr | raw | 44 字节 |
| List | quicklist | quicklist | ~ |
| Hash | listpack | hashtable | 512 个字段或单值超 64 字节 |
| Set | intset/listpack | hashtable | 512 个元素或含非整数 |
| Zset | listpack | skiplist+hashtable | 128 个元素或单值超 64 字节 |
这些阈值可以通过配置调整,比如 hash-max-listpack-entries 控制 Hash 转换的元素数阈值。
6.2.3. 关联问题
- 28. Redis String 类型的底层实现是什么?(SDS)
- Redis 的 hash 是什么?
- Redis Zset 的实现原理是什么?
- Redis 中的 Ziplist 和 Quicklist 数据结构的特点是什么?
- Redis 的 ListPack 数据结构是什么?
6.3. 常见问题
6.3.1. String 类型最大能存 512MB,那实际生产中你会存这么大的值吗?
详细解答可以看:Redis 字符串类型的最大值大小是多少?
肯定不会。Redis 是单线程模型,一个大 key 的读写会阻塞其他请求。一般建议单个 value 控制在 10KB 以内,超过 1MB 就得考虑拆分了。大 key 还会导致集群迁移 slot 时卡顿,主从同步也会被拖慢。
6.3.2. Zset 底层为什么用跳表不用红黑树?
详细解答可以看:为什么 Redis Zset 用跳表实现而不是红黑树?B+树?
主要是跳表实现简单,范围查询效率高。红黑树做范围查询得先找到起点再中序遍历,跳表直接在底层链表上顺着走就行。另外跳表调整平衡只需要改指针,红黑树还得旋转,并发场景下跳表也更好加锁。
6.3.3. HyperLogLog 说有 0.81% 误差,那能不能合并多个 HyperLogLog 的结果?
可以的,用 PFMERGE 命令就能把多个 HyperLogLog 合并成一个。比如统计周 UV,可以先分别统计 7 天的日 UV,最后合并起来得到周 UV,误差率不会叠加。
6.3.4. Stream 和 Kafka 比起来怎么样?用 Redis Stream 能替代 Kafka 吗?
替代不了。Redis Stream 适合轻量级场景,比如几千 QPS 的内部消息传递。Kafka 是分布式的,能扛住几十万 QPS,有多副本容灾、消息回溯、exactly-once 语义这些企业级特性。Redis Stream 更像是 Redis 顺便提供的消息队列能力,Kafka 是专门干这事的。
7. Redis 中跳表的实现原理是什么?
7.1. 核心要点
跳表本质上是一个多层链表,底层链表保存所有元素,上层链表是下层的子集,通过这种分层索引结构把链表的 O(n) 查找优化到 O(logn)。
查找的时候从最高层开始,先往右走,遇到比目标值大的节点就往下走一层,重复这个过程直到找到目标或确定不存在。比如查找 50,从顶层的 10 开始,跳到 40 发现比 50 小继续往右,发现下一个是 70 比目标大,就往下走一层,在第二层从 40 往右一步就找到 50 了。
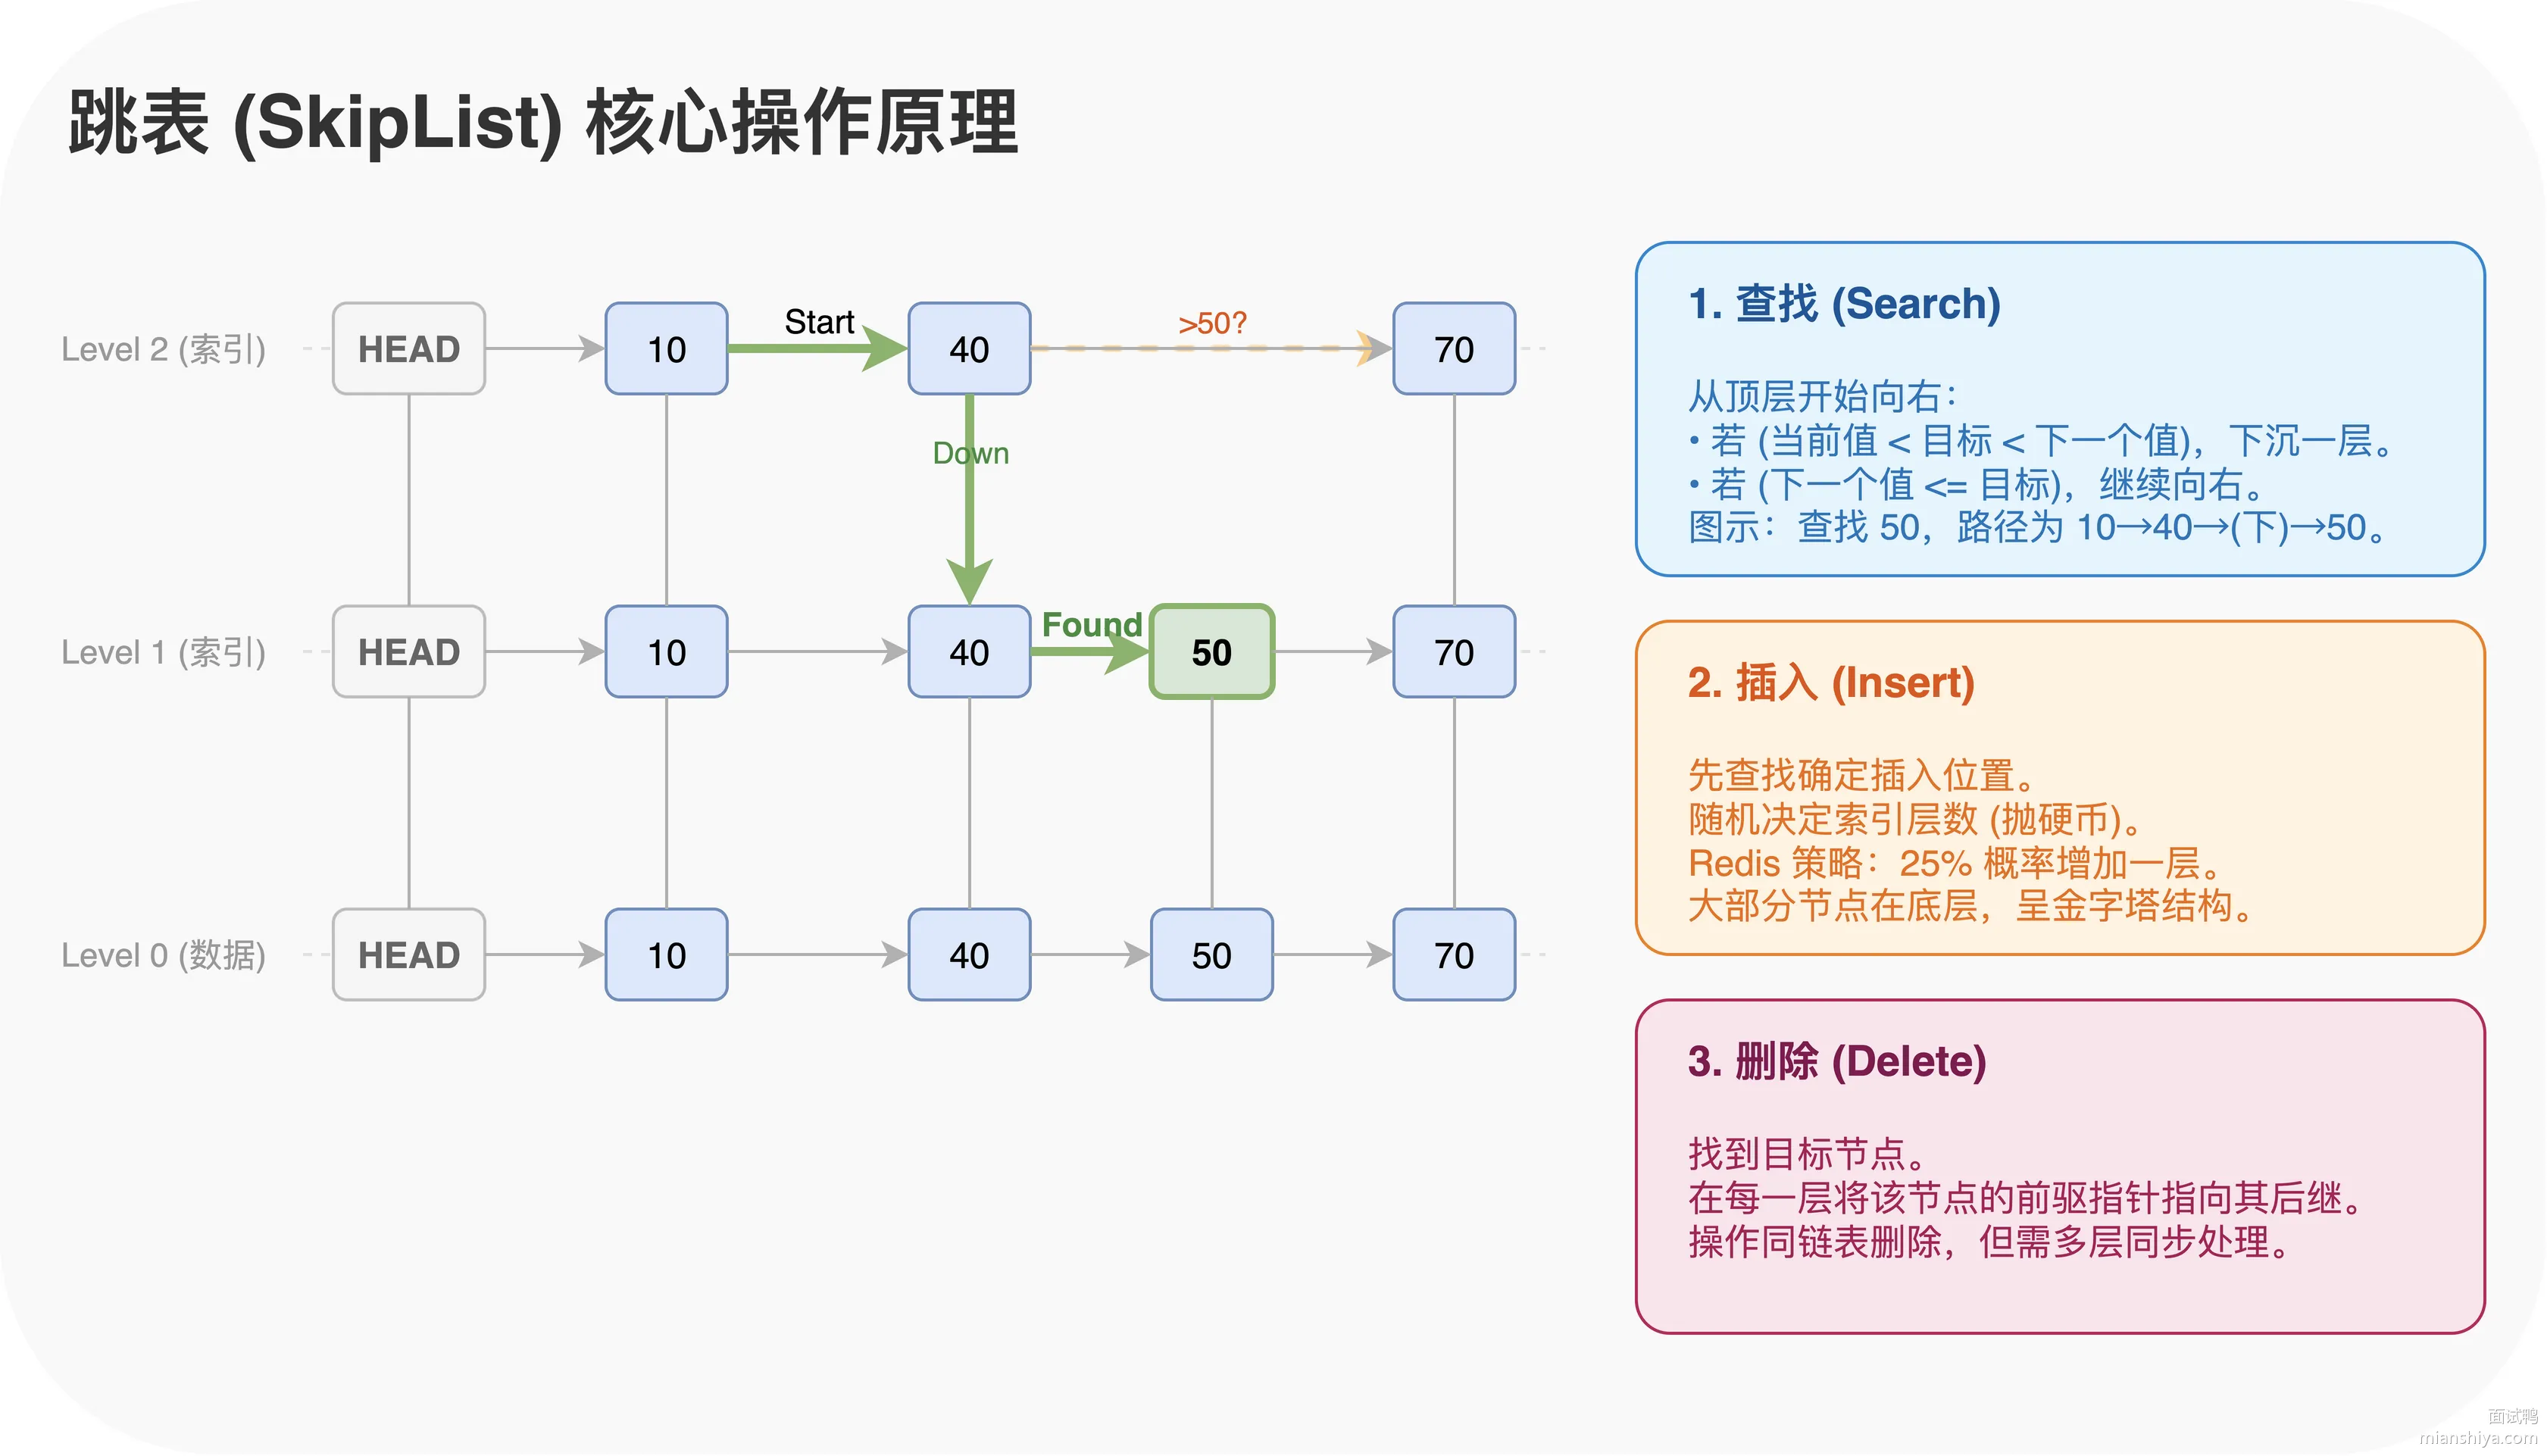
插入的时候,先用查找的方式定位到插入位置,然后随机决定新节点要建几层索引。Redis 用 25% 的概率往上加一层,所以大部分节点只在底层,少部分节点会出现在高层索引中。
删除就是先找到节点,然后把这个节点在各层的前后指针都接上,跟普通链表删除一样,只是要在多层都操作一遍。
7.2. 扩展知识
7.2.1. 跳表查询过程详解
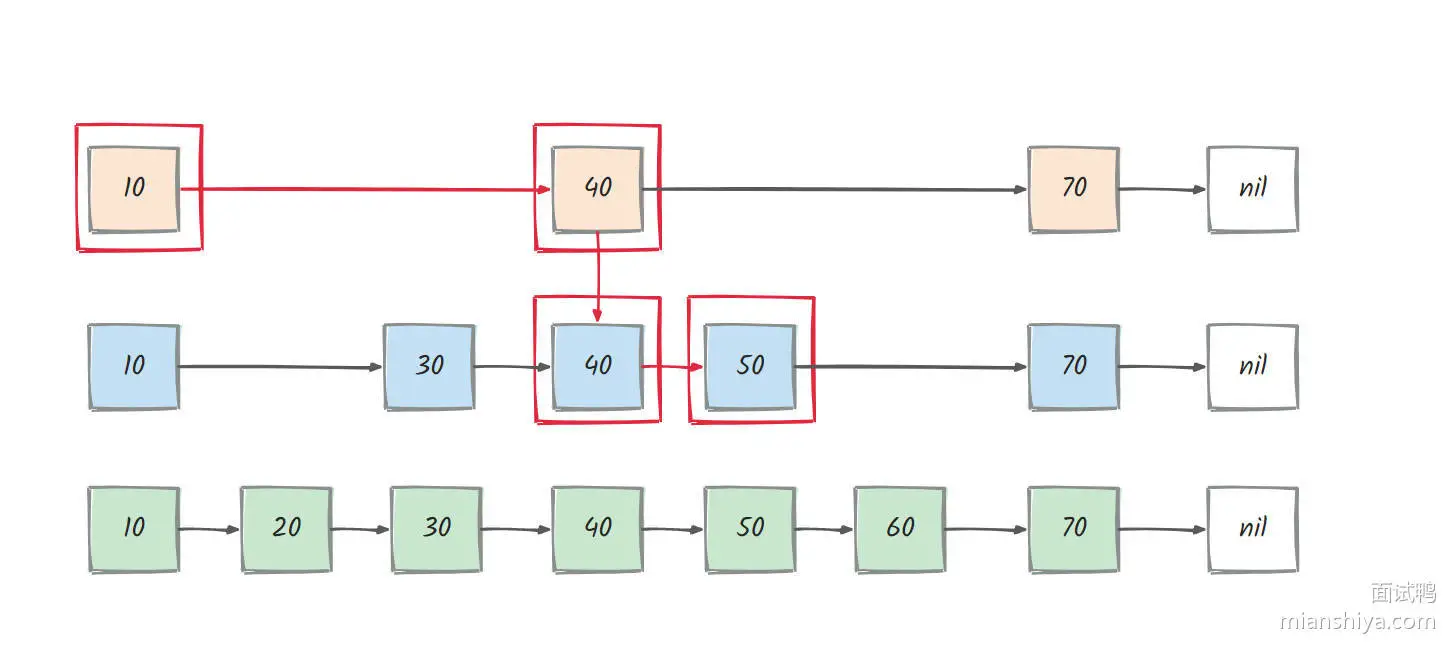
跳表的查询效率比普通链表高太多了。假设要查找 50,普通链表得从头一个个遍历,10 → 20 → 40 → 50,要走 4 步。
跳表就不一样了,从最顶层开始,10 → 40 只要 1 步,发现 40 的下一个是 70 比目标大,就下沉到第二层,40 → 50 又是 1 步,总共就 3 次跳转。元素越多这个差距越明显,跳表平均 O(logn),最差 O(n)。
7.2.2. Redis 跳表的特殊设计
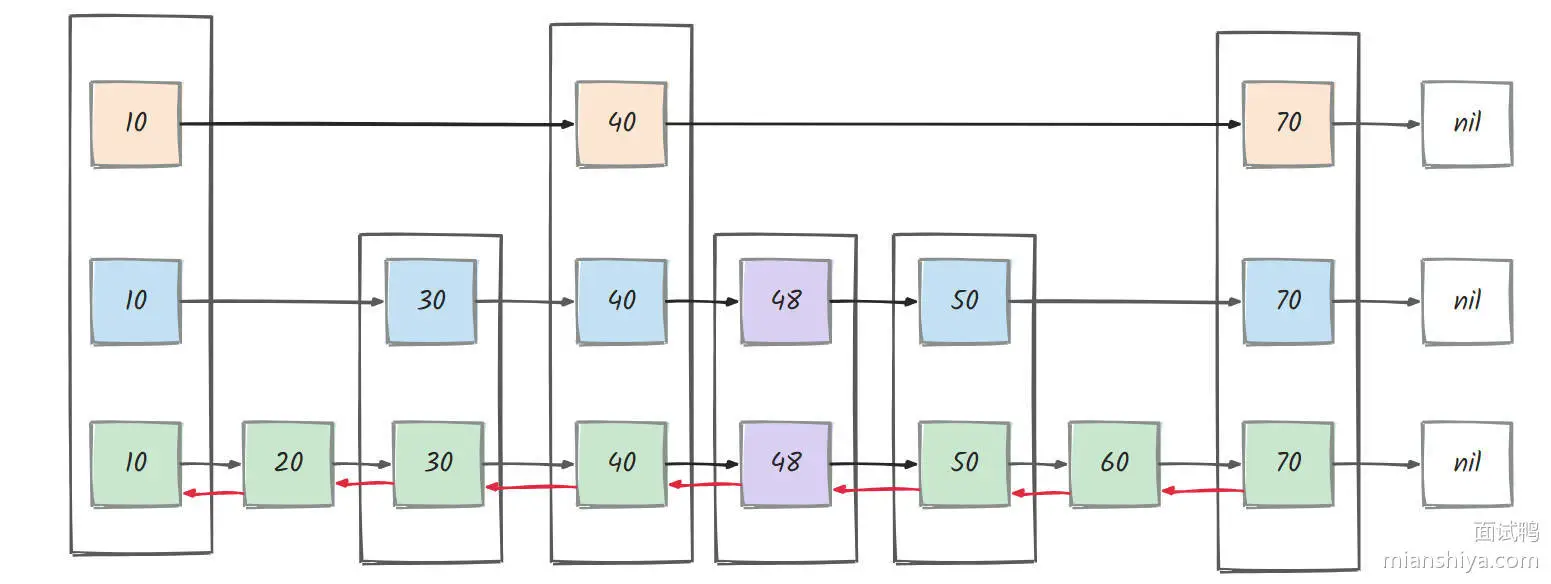
Redis 的跳表跟教科书上的标准跳表有两点不同:多了个回退指针(前驱指针),而且 score 允许重复。
看一下 Redis 7.0 的源码结构:
typedef struct zskiplistNode {
    sds ele;                      // 元素值,用 SDS 存储
    double score;                 // 分数,用于排序
    struct zskiplistNode *backward;  // 回退指针,指向前一个节点
    struct zskiplistLevel {
        struct zskiplistNode *forward;  // 前进指针
        unsigned long span;              // 跨度,记录两节点间距离
    } level[];                    // 层级数组
} zskiplistNode;
几个关键字段: 1)ele 存的是 Zset 的成员值,用 SDS 实现 2)score 是排序依据,浮点数类型 3)backward 就是回退指针,只在最底层有效,方便反向遍历 4)level 数组存每一层的前进指针和跨度,span 字段在计算排名的时候特别有用
下图的红色箭头就代表回退指针:
为什么 Redis 跳表实现多了个回退指针?
主要是为了支持反向遍历。
Redis 的跳表在最底层(level 0)为每个节点增加了一个 backward 指针,指向前一个节点,使得底层链表变成了一个双向链表。
这样做的核心原因是 Redis 有序集合(ZSet)需要支持反向查询命令,例如:
ZREVRANGE:按分数从大到小返回指定范围的成员ZREVRANGEBYSCORE:按分数从大到小返回指定分数区间的成员ZREVRANK:返回成员的逆序排名
有了回退指针,这些反向操作只需先定位到目标位置,然后沿 backward 指针往前逐个遍历即可,时间复杂度为 O(N)(N 为返回的元素数量)。如果没有回退指针,反向遍历就无法直接实现,要么需要额外的数据结构,要么需要代价很高的重复查找。
注意:回退指针只存在于最底层(level 0),每个节点只有一个回退指针,而不是每层都有。这是因为反向遍历只需要在底层逐个访问节点即可,不需要多层跳跃。
7.2.3. 随机层级的概率算法
新节点要建几层索引是随机决定的,Redis 用了一个很巧妙的概率算法(以下源码来自 redis7.0):
#define ZSKIPLIST_MAXLEVEL 32
#define ZSKIPLIST_P 0.25

int zslRandomLevel(void) {
    static const int threshold = ZSKIPLIST_P*RAND_MAX;
    int level = 1;
    while (random() < threshold)
        level += 1;
    return (level<ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL;
}
通过调用 zslRandomLevel 方法来决定新插入的节点所在的层数(level)。可以看到 level 从 1 开始,通过 while 循环,当产生的随机数小于 RAND_MAX 的 0.25 倍时,level 加 1(即每次循环有 25% 的概率累加层数),反之则退出循环;最终层数不超过 ZSKIPLIST_MAXLEVEL(32)。
每次循环有 25% 的概率加一层、75% 的概率终止循环,因此节点最终停留在第 n 层的概率为:
1)第 1 层:75% 的概率(第一次循环就终止) 2)第 2 层:18.75% 的概率(第一次循环加层,第二次终止,即 0.25 × 0.75) 3)第 3 层:4.6875% 的概率(前两次循环加层,第三次终止,即 0.25² × 0.75) 4)第 n 层:0.25^(n-1) × 0.75 的概率
Redis 7.0 最多 32 层,足够支撑 2^64 个元素了,实际场景完全够用。
7.2.4. 为什么用跳表不用红黑树
Redis 选跳表有几个原因:
1)实现简单,红黑树那套左旋右旋太复杂,跳表就是多层链表,好写好调试
2)范围查询效率高,Zset 经常要取排名 10-20 的数据,跳表在底层链表上顺着走就行,红黑树得中序遍历
3)并发友好,跳表只需要锁住相关的几个节点,红黑树旋转的时候可能要锁一大片(这里可以提一嘴不过 Redis 执行命令是单线程的,所以并发不是主要考虑的点。说出并发友好这点的目的,能体现出你不仅知道数据结构差异、并发锁和性能的关系还有 Redis 的执行模型)
4)内存占用可控,跳表每个节点平均 1.33 个指针,红黑树每个节点固定 3 个指针
7.3. 常见问题
7.3.1. 跳表的空间复杂度是多少?比普通链表多占多少内存?
跳表空间复杂度是 O(n)。因为每个节点有 25% 概率升一层,所以平均每个节点的层数是 1/(1-0.25) = 1.33 层。总指针数大约是 n * 1.33,比普通链表多 33% 左右的指针开销。
7.3.2. 跳表最高层数为什么是 32 层?能不能设成更大?
32 层是够用的。每层节点数是上一层的 4 倍,32 层理论上能索引 4^32 也就是 2^64 个元素,远超实际需要。层数太多反而浪费内存,每多一层就多一个指针。Redis 5.0 之前是 64 层,后来改成 32 就是因为实际场景用不到那么多。
7.3.3. 跳表的层级概率为什么是 25% 而不是 50%?
这是空间和时间的权衡。50% 的话每两个节点就有一个上升,索引层太密集,浪费内存。25% 的话平均每 4 个节点有一个上升,既能保证 O(logn) 的查询效率,又不会占太多额外空间。Redis 这个 0.25 是经过实测调优的。
7.3.4. 跳表插入和删除会不会导致索引层不平衡?
不会,因为层级是随机决定的。只要随机函数够均匀,插入删除多少次,整体的层级分布都会趋近于理论值。这跟红黑树不一样,红黑树必须靠旋转维护平衡,跳表靠概率天然就是平衡的。
8. Redis 的 hash 是什么?
8.1. 核心要点
Redis 的 Hash 是一种键值对集合,能把多个字段和值存在同一个 key 下面,特别适合存对象的属性。比如存用户信息,用 user:1001 作为 key,里面放 name、age、city 这些字段,改单个字段不用整体覆盖,比用 String 存 JSON 灵活多了。
Hash 底层有两种编码方式。数据量小的时候用 listpack 存储,紧凑省内存;数据量大了自动切换成 hashtable,查询效率 O(1)。切换阈值默认是 512 个字段或者单个值超过 64 字节。
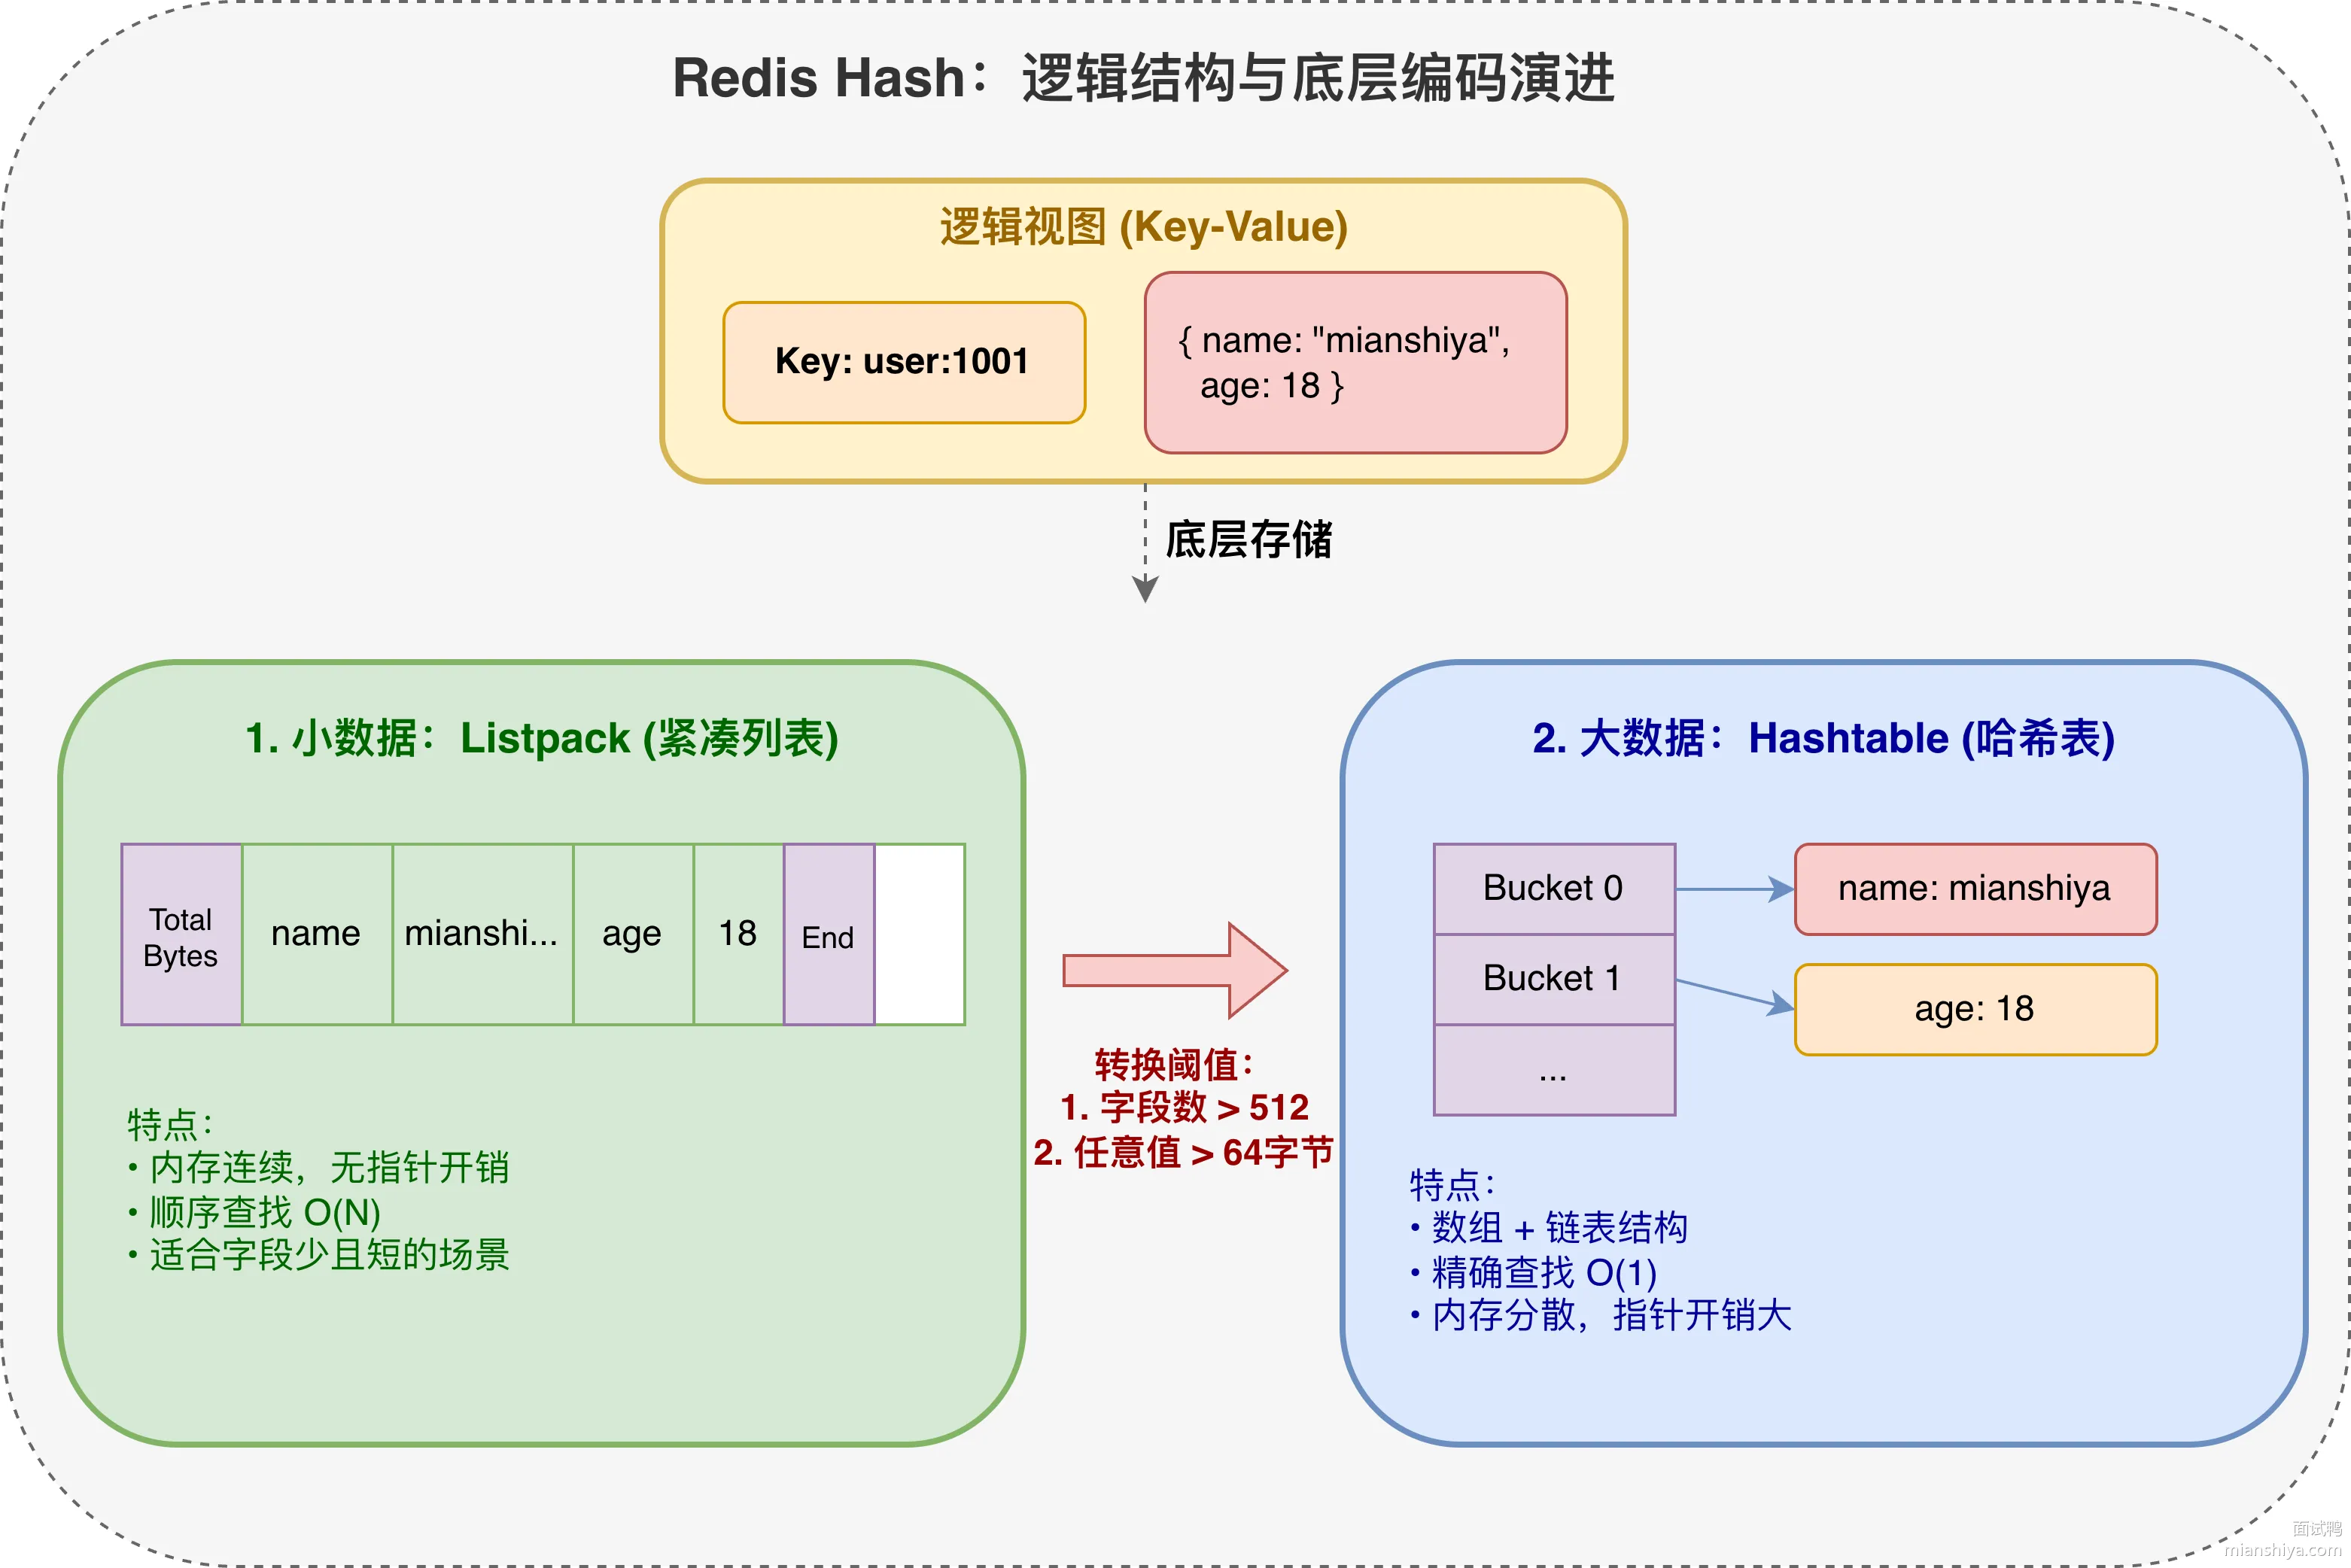
常用操作就那几个:HSET 写字段、HGET 读字段、HMSET 批量写、HMGET 批量读、HDEL 删字段、HINCRBY 对数值字段做原子加减。
HSET user:1001 name "mianshiya" age 18
HGET user:1001 name
HINCRBY user:1001 age 1
8.2. 扩展知识
8.2.1. Hash 底层编码的演进
Hash 的底层编码经历过几次变化:
1)Redis 6 及之前用的是 ziplist + hashtable 2)Redis 7 之后换成了 listpack + hashtable
ziplist 和 listpack 都是紧凑型数据结构,查找复杂度都是 O(n),主要区别是 listpack 解决了 ziplist 的级联更新问题。ziplist 每个节点存了前一个节点的长度,改一个节点可能导致后面一串节点都要更新。listpack 改成只存当前节点的长度,彻底避免了这个问题。
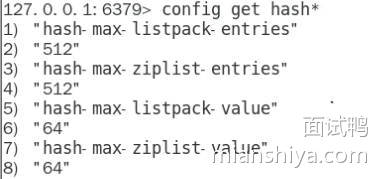
什么时候用 listpack,什么时候用 hashtable?由两个参数控制:
| 参数 | 默认值 | 含义 |
|---|---|---|
| hash-max-listpack-entries | 512 | 字段数上限 |
| hash-max-listpack-value | 64 | 单个字段/值的字节上限 |
只要字段数超过 512,或者任意一个字段名/值超过 64 字节,就会从 listpack 转成 hashtable。注意这个转换是单向的,转成 hashtable 之后不会再退回去。
8.2.2. Hashtable 的内部结构
Hashtable 相关知识点也值得深入了解。
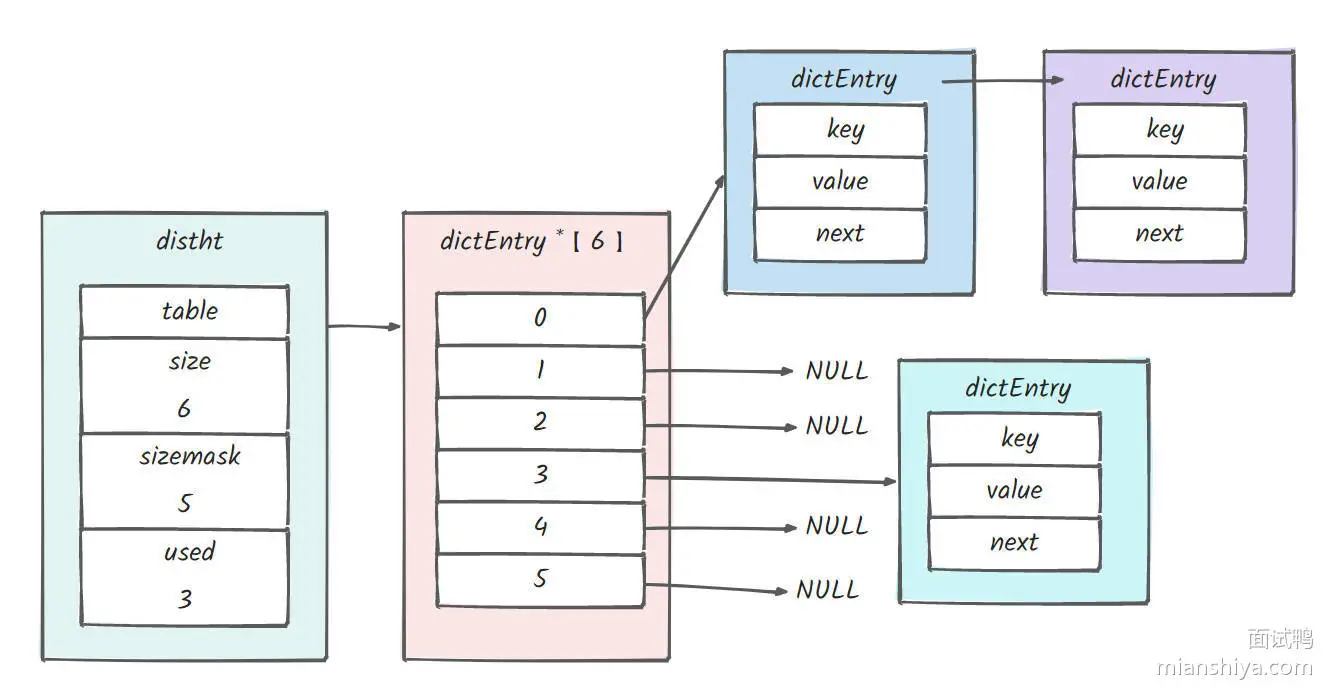
Hashtable 就是标准的哈希表实现,查询 O(1)。看一下核心结构:
typedef struct dictht {
    dictEntry **table;      // 哈希桶数组
    unsigned long size;     // 哈希表大小
    unsigned long sizemask; // 大小掩码,值是 size-1
    unsigned long used;     // 已使用的节点数
} dictht;

typedef struct dictEntry {
    void *key;              // 键
    union {
        void *val;
        uint64_t u64;
        int64_t s64;
        double d;
    } v;                    // 值,用联合体节省内存
    struct dictEntry *next; // 链表指针,解决哈希冲突
} dictEntry;
几个设计细节:
1)sizemask 永远等于 size-1,计算桶位置用 hash & sizemask,比取模快 2)值用联合体存储,如果是整数或浮点数可以直接塞进去,省掉一次指针跳转 3)哈希冲突用链表法解决,冲突的元素挂在同一个桶的链表上
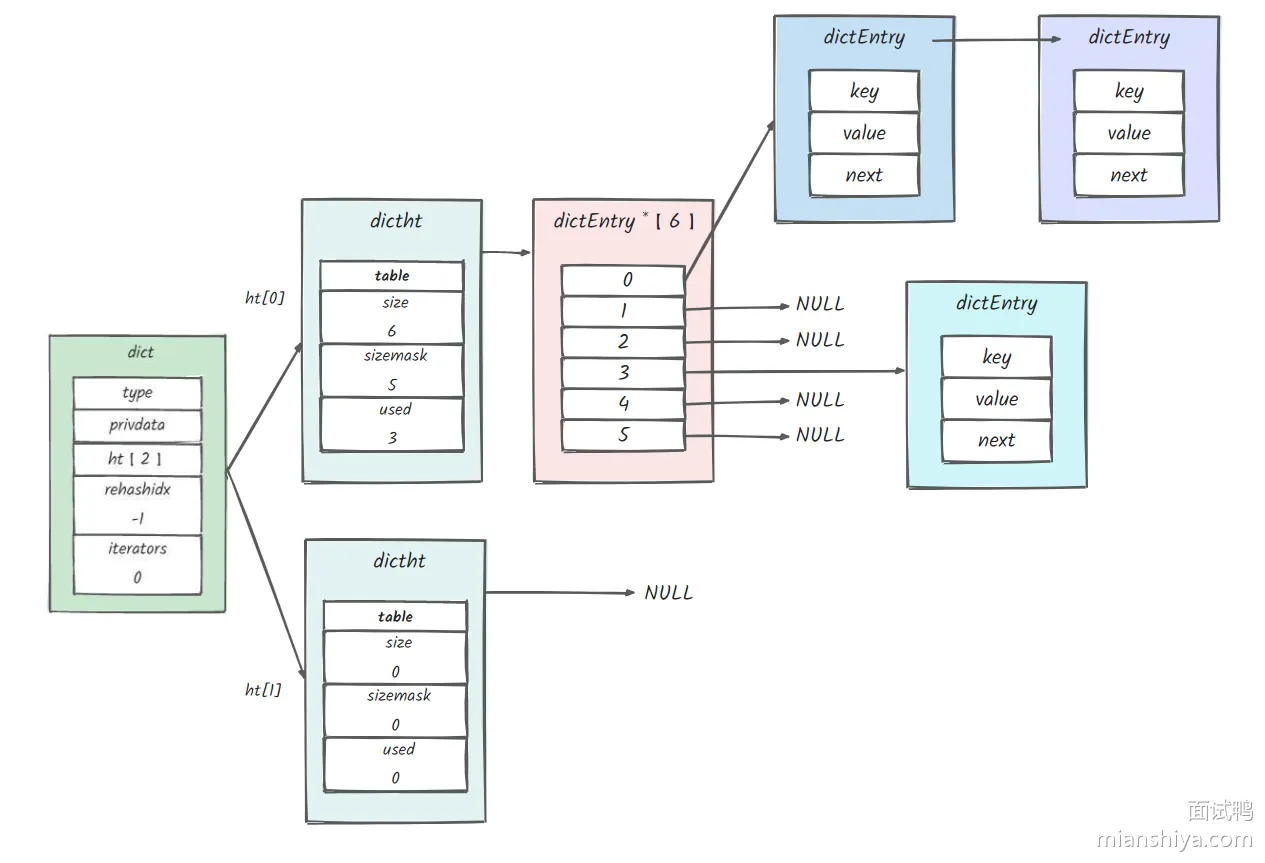
8.2.3. 渐进式 rehash
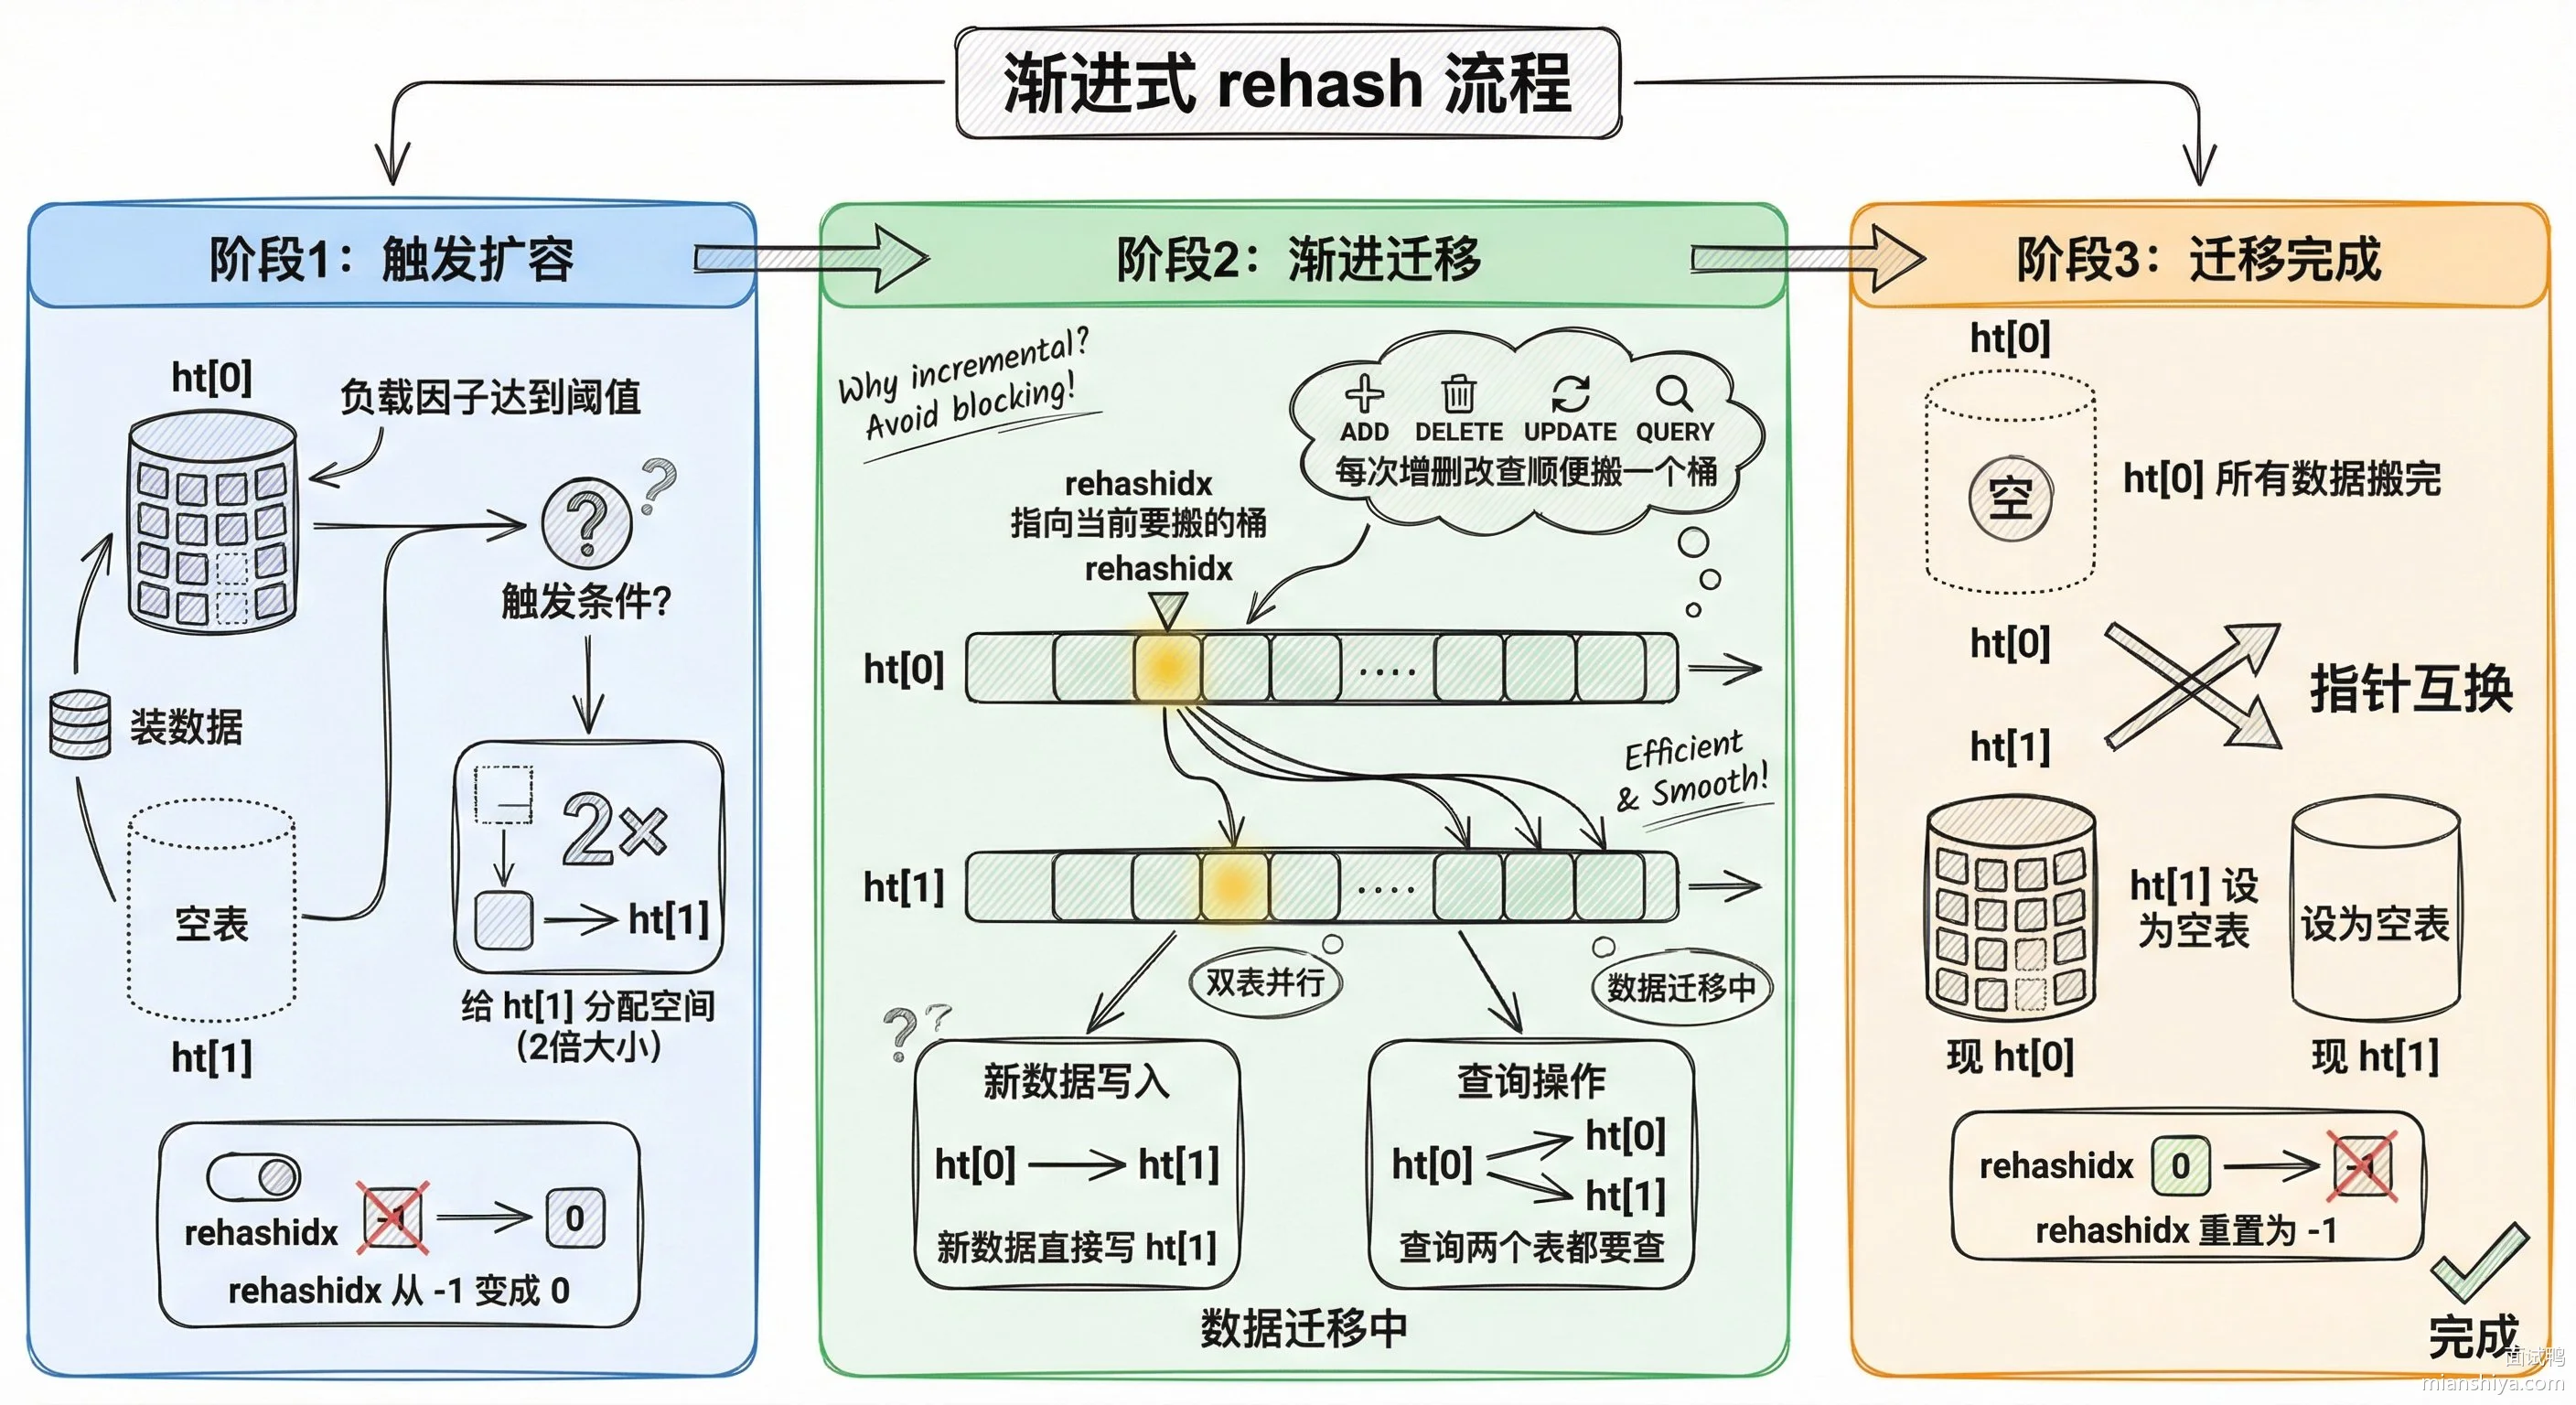
Redis 的哈希表扩容不是一次性搬完的,而是分多次慢慢搬,这就是渐进式 rehash。
为什么要这么设计?因为 Redis 是单线程的,如果一次性搬几十万个 key,这段时间其他请求全得等着,服务直接卡死。
具体流程是这样的:
1)触发扩容后,给 ht[1] 分配空间,大小是第一个大于等于 ht[0].used * 2 的 2 次方幂。比如原表的值是 1024,那个其扩容之后的新表大小就是 2048。 2)把 rehashidx 的值从 -1 设成 0,标记开始 rehash 3)每次对 Hash 做增删改查,顺便把 rehashidx 对应的桶从 ht[0] 搬到 ht[1],然后 rehashidx++ 4)新插入的数据直接写 ht[1],查询的时候两个表都要查 5)搬完之后 ht[0] 和 ht[1] 指针互换,rehashidx 重置为 -1
8.2.4. 扩容和缩容的触发条件
扩容看负载因子,公式是 used / size:
1)负载因子 >= 1 且没在做 RDB/AOF 持久化,触发扩容 2)负载因子 >= 5,这个时候说明哈希冲突非常严重了,不管有没有持久化,强制扩容
为什么持久化的时候不扩容?因为 RDB 和 AOF 重写会 fork 子进程,用了写时复制机制。这时候如果父进程大量修改内存,会产生大量内存拷贝,所以尽量避免。
缩容是负载因子 < 0.1 时触发,新表大小是第一个大于等于 used 的 2 次方幂。例如老表的 used = 1000,那么新表的大小就是 1024。同样,持久化期间不缩容。
8.3. 常见问题
8.3.1. Hash 和 String 存 JSON 相比,各有什么优缺点?
Hash 的优势是能单独改某个字段,不用整个对象读出来改完再写回去,省网络带宽也省 CPU。缺点是不支持嵌套结构,只能存一层键值对。String 存 JSON 能存复杂嵌套结构,但改单个字段得整体覆盖。一般对象属性平铺的用 Hash,结构复杂的用 String 存 JSON。
8.3.2. 渐进式 rehash 期间,读写操作是怎么处理的?
写操作直接写到新表 ht[1],保证新数据不会被搬两次。读操作先查 ht[0],没找到再查 ht[1]。删除和更新也是两个表都要检查。每次操作完顺便搬一个桶,所以 rehash 期间每个请求会稍微慢一点,但不会出现长时间阻塞。
8.3.3. 为什么扩容是 2 倍而不是 1.5 倍?
因为哈希表大小必须是 2 的幂次,这样计算桶位置可以用位运算 hash & (size-1) 代替取模,效率高很多。2 倍扩容刚好还是 2 的幂次。另外 2 倍扩容时,原来的元素要么在原位置,要么在原位置 + 原大小的位置,只用看 hash 值新增的那一位是 0 还是 1,迁移逻辑也简单。
8.3.4. Hash 的大 key 问题怎么处理?
详细解答可以看:Redis 中的 Big Key 问题是什么?如何解决?
一个 Hash 存几十万个字段就是大 key,删除的时候会阻塞很久。解决办法是拆分,比如按字段名哈希取模拆成多个小 Hash。或者用 HSCAN 分批删除,每次删一部分。Redis 4.0 之后有 UNLINK 命令可以异步删除,不会阻塞主线程。
9. Redis 和 Memcached 有哪些区别?
9.1. 核心要点
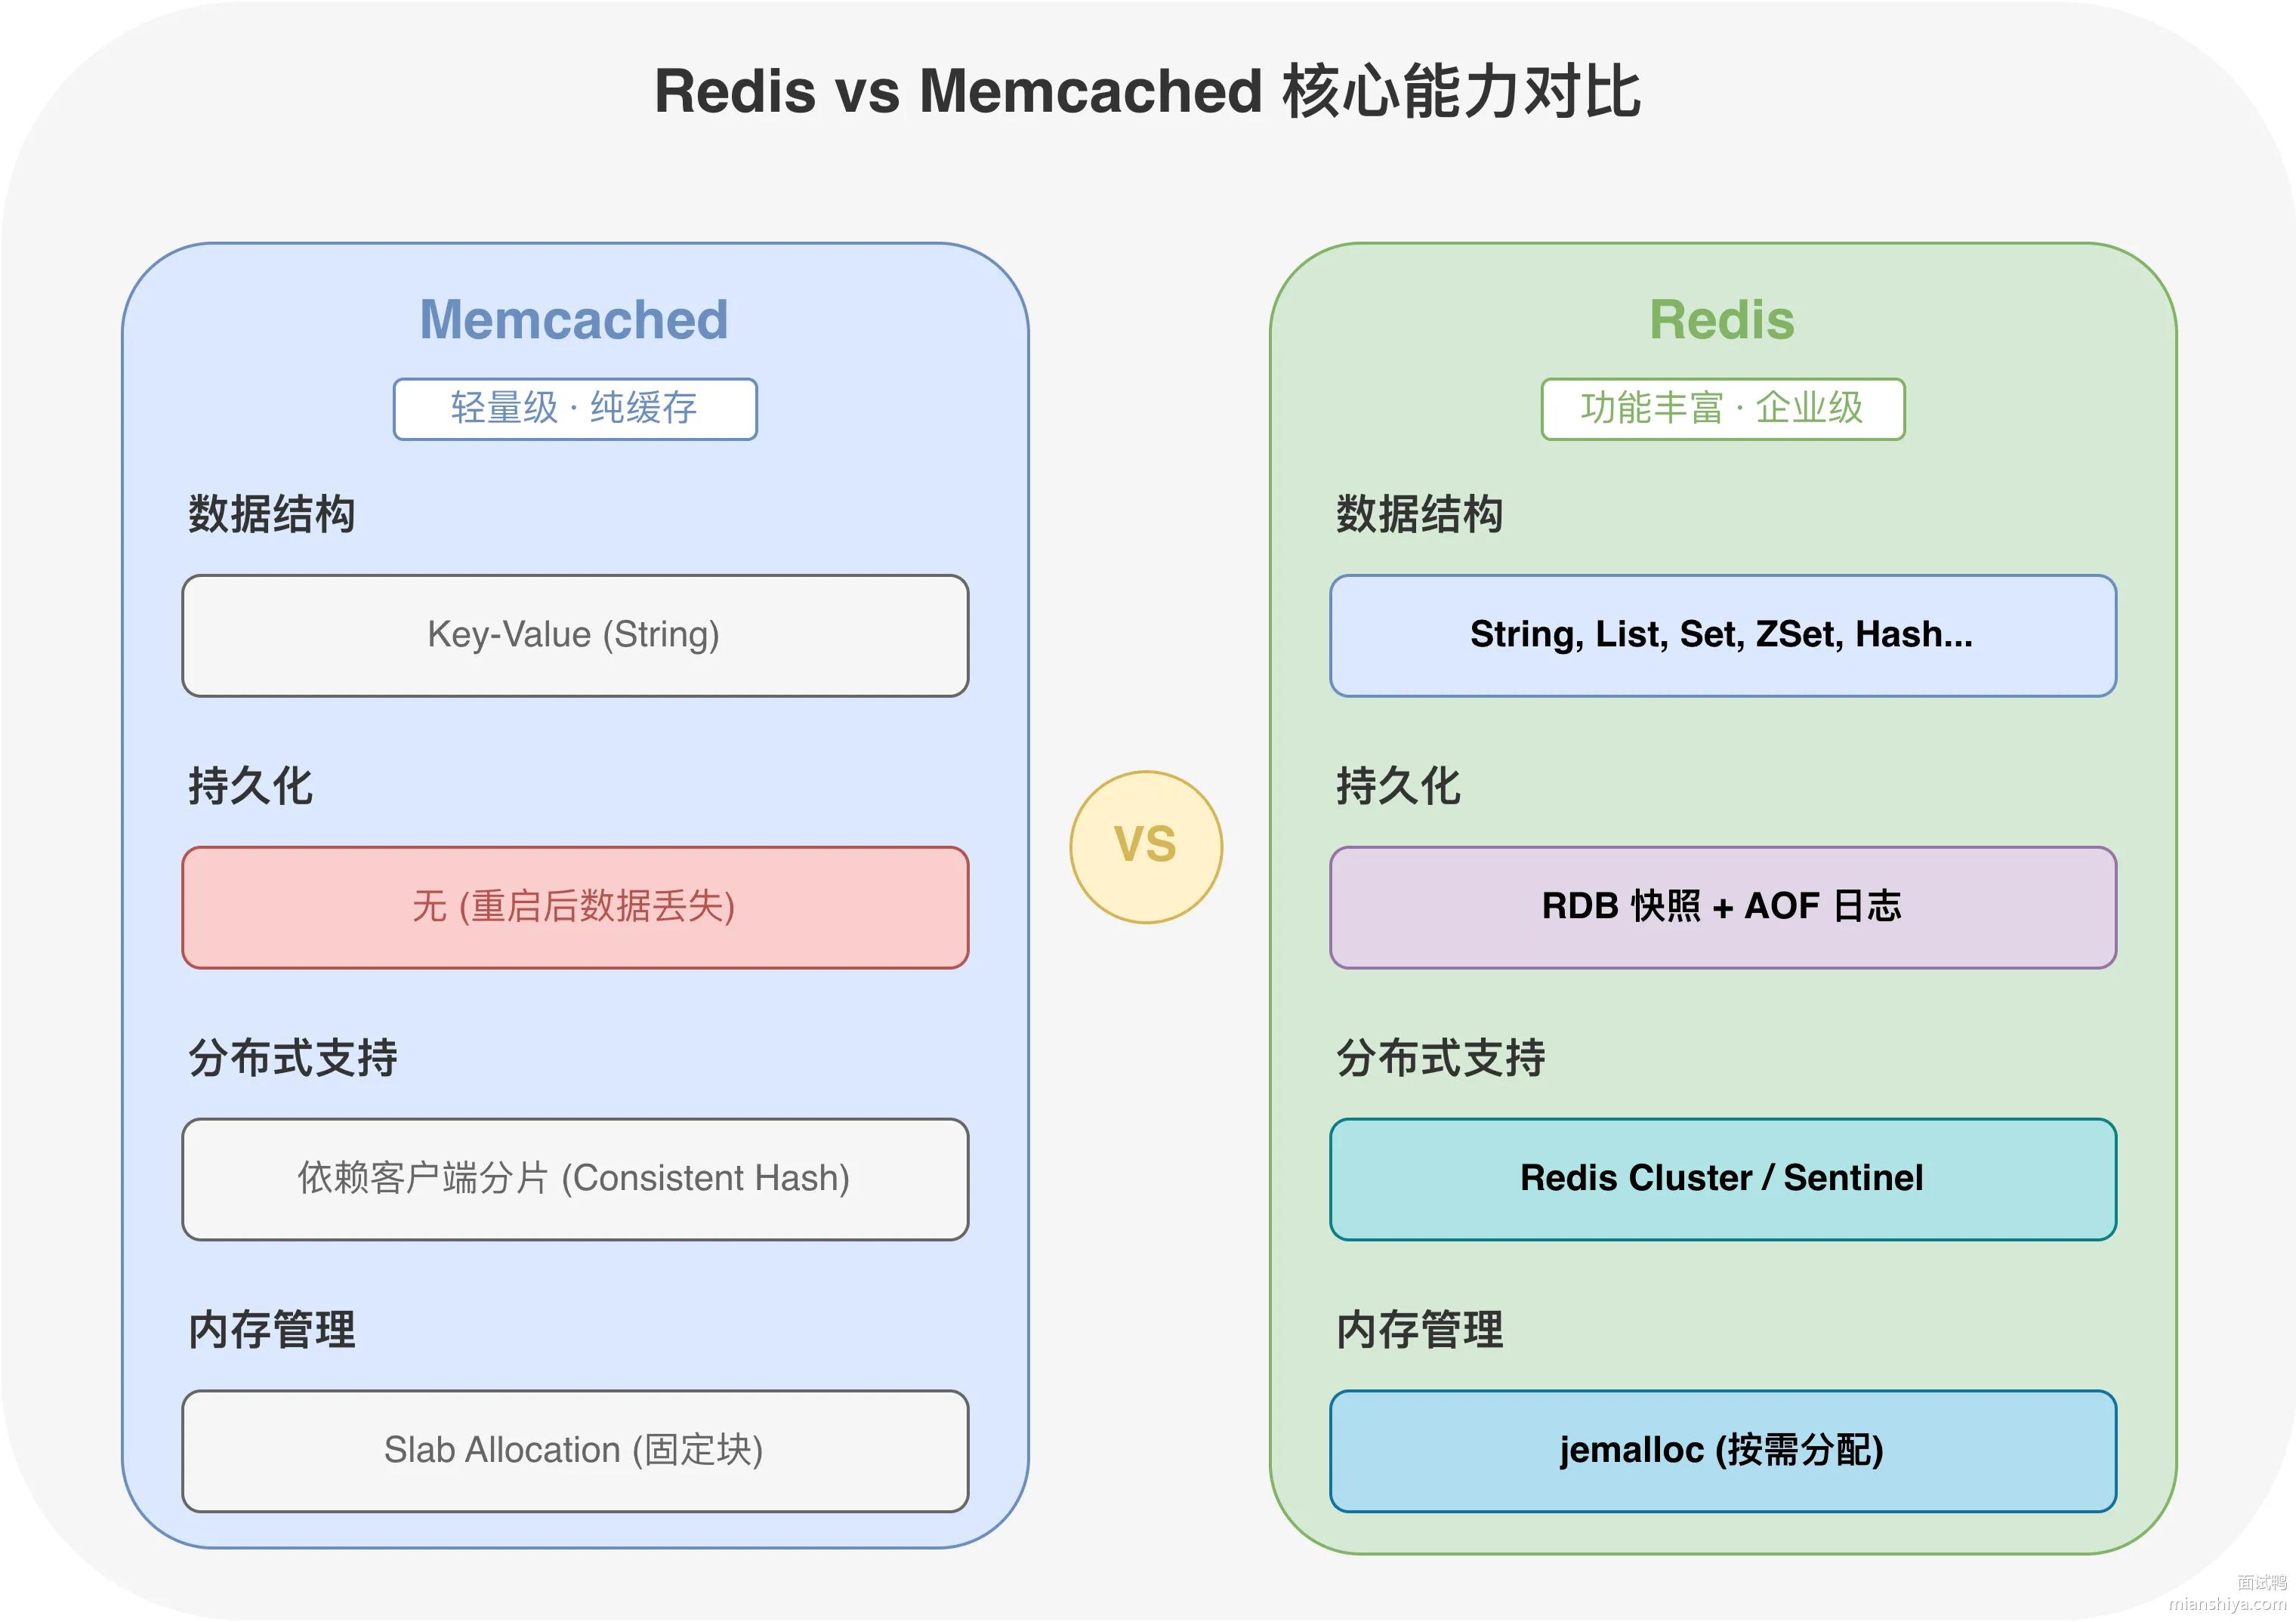
Redis 和 Memcached 都是内存级别的缓存系统,但 Redis 功能更丰富,Memcached 更轻量纯粹。
数据结构方面,Redis 支持 String、List、Set、Sorted Set、Hash 五种基础结构,还有 HyperLogLog、Bitmap、Geo 等扩展类型;Memcached 只支持简单的 key-value 字符串存储。
持久化方面,Redis 提供 RDB 快照和 AOF 日志两种方式,服务重启数据还在;Memcached 压根没有持久化,一重启数据全没了。
分布式方面,Redis 原生支持主从复制、哨兵和 Redis Cluster 集群模式;Memcached 服务端没有分布式逻辑,分片全靠客户端自己算 hash 来分发。
功能方面,Redis 支持发布订阅、Lua 脚本、事务、Stream 消息队列等;Memcached 就是纯粹的缓存,啥扩展功能都没有。
9.2. 扩展知识
9.2.1. 内存管理机制差异
Memcached 用的是 slab 分配器,把内存预先切成固定大小的块,比如 64B、128B、256B 这样的规格。存数据的时候找一个最接近的 slab 塞进去,好处是不会产生外部碎片,坏处是会浪费空间——你存个 65B 的数据,也得占一个 128B 的 slab。
Redis 用的是 jemalloc 内存分配器,按需分配更灵活。内存满了之后 Redis 有 8 种淘汰策略可选:noeviction 直接报错、allkeys-lru 全局 LRU、volatile-lru 只淘汰设了过期时间的 key、allkeys-lfu 全局 LFU、volatile-lfu 等等。Memcached 只有 LRU 一种。
9.2.2. 线程模型差异
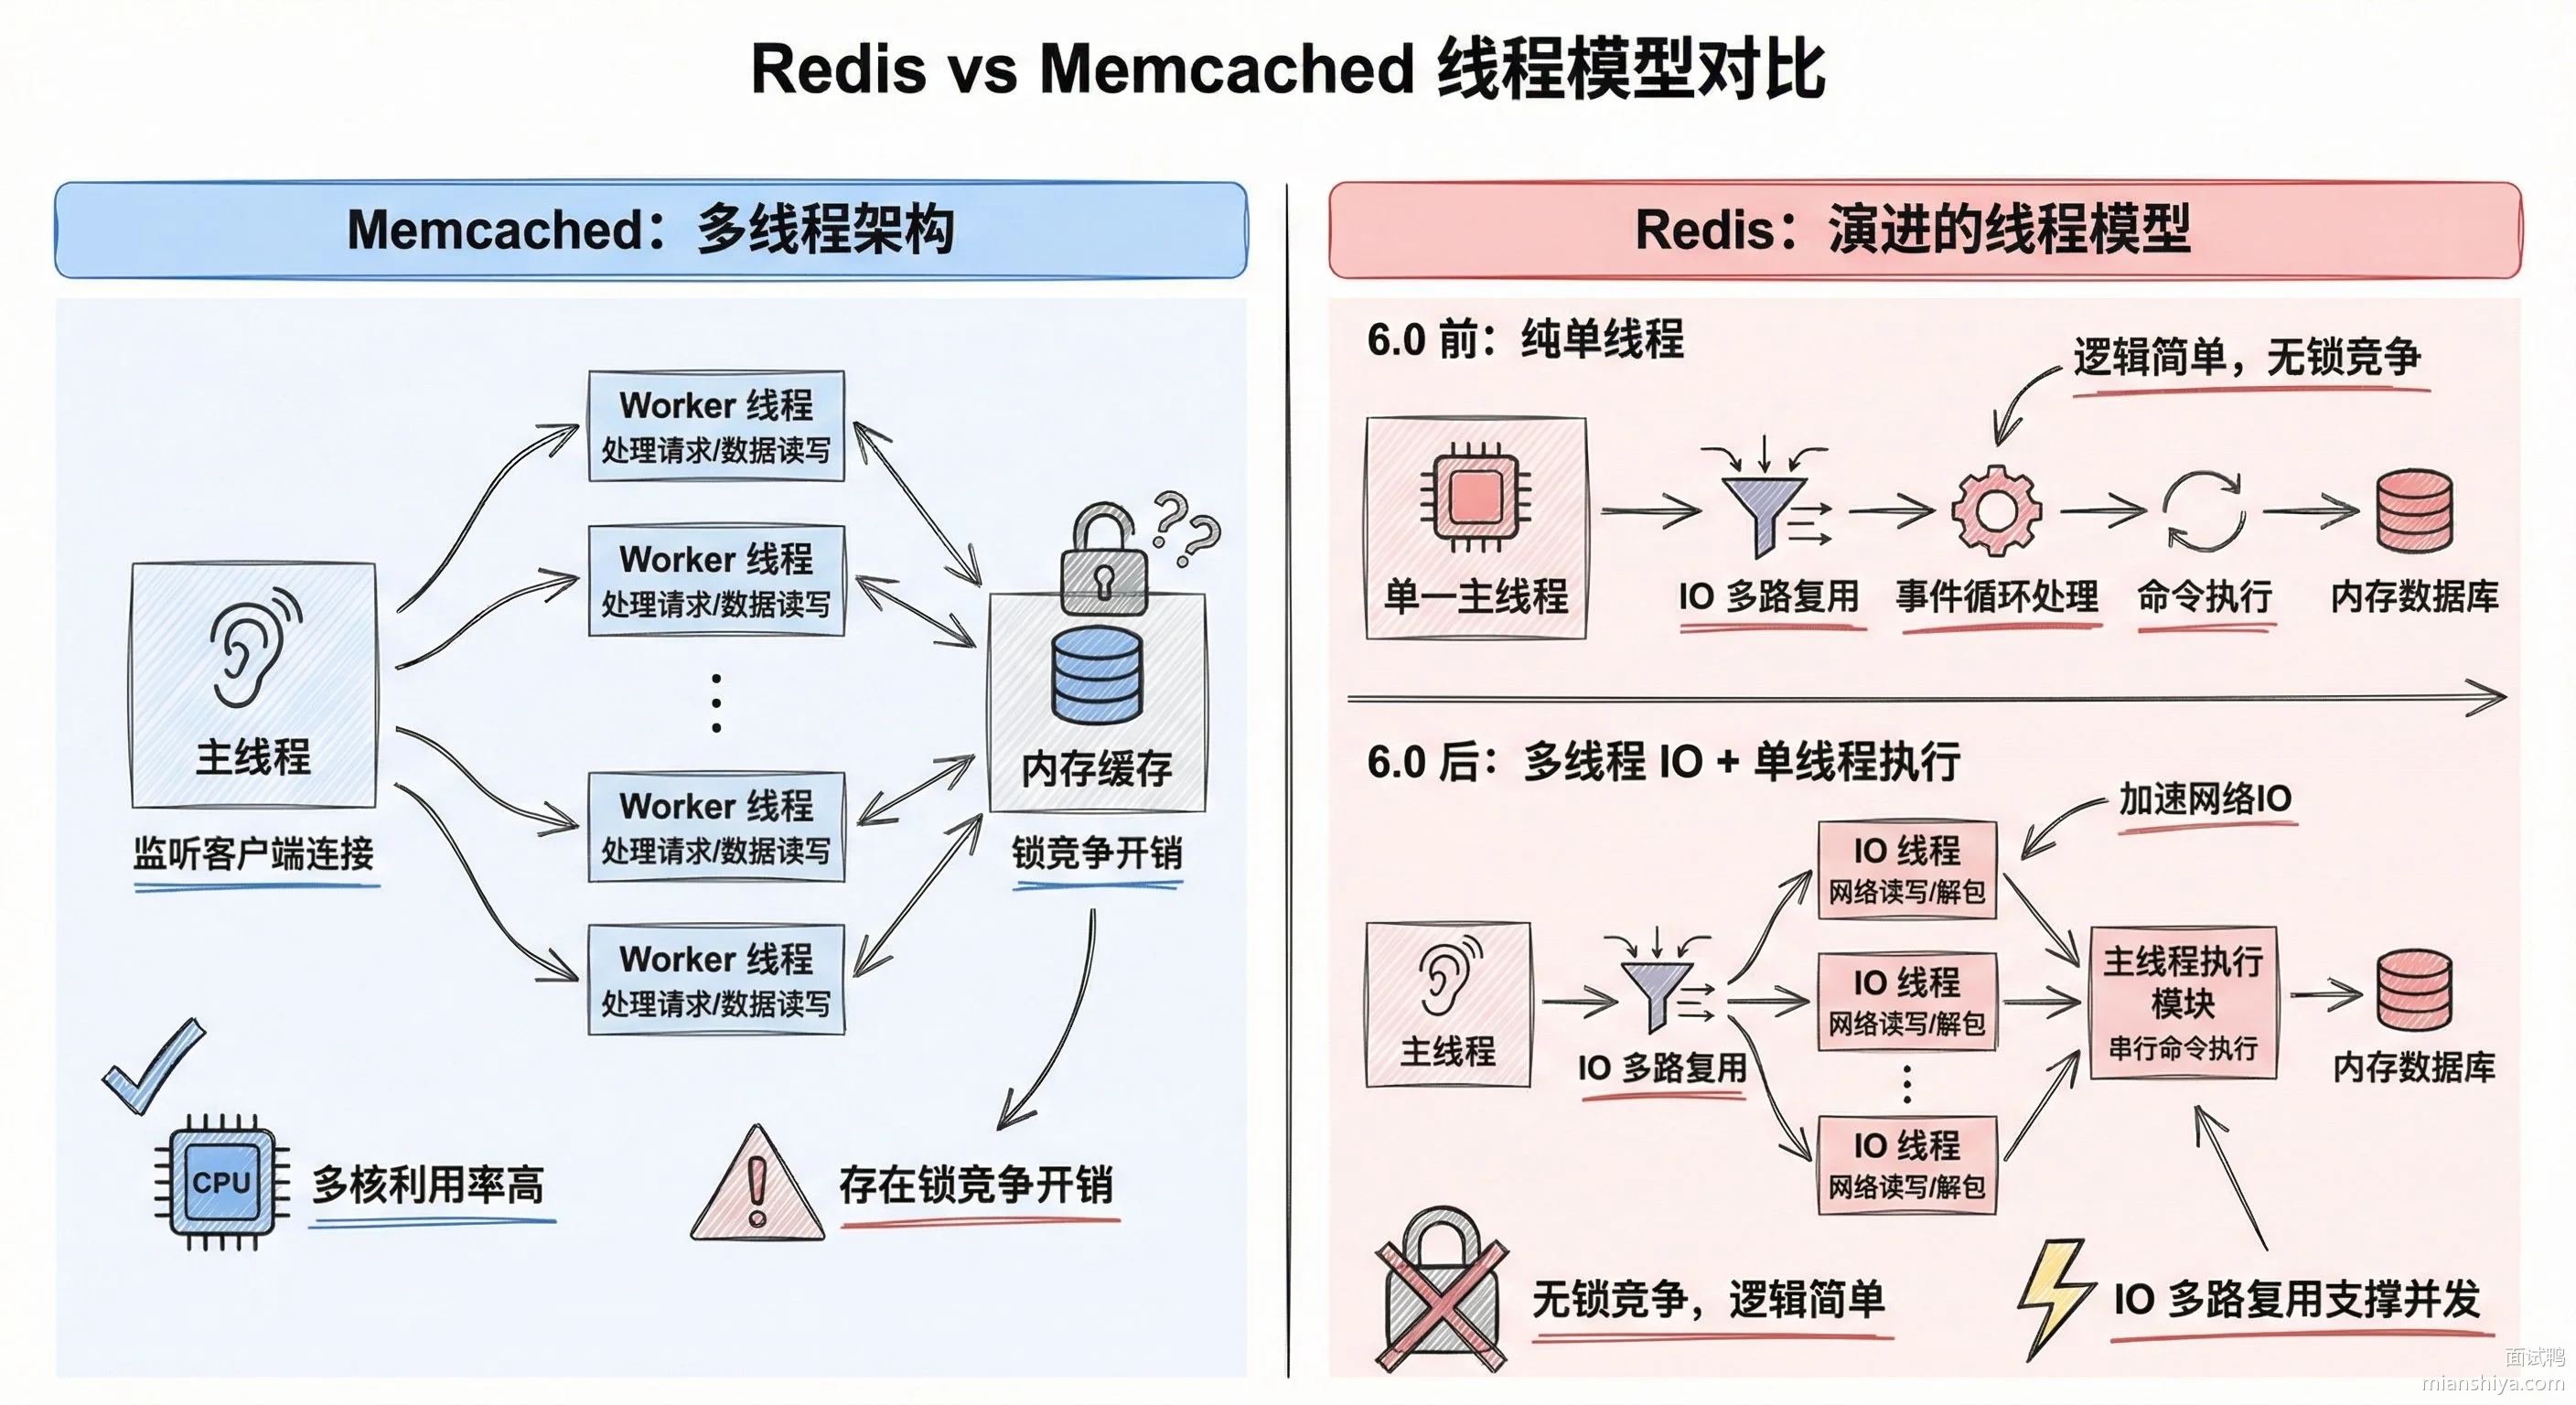
Memcached 从一开始就是多线程架构,用 libevent 做事件驱动,主线程负责监听连接,worker 线程处理请求。多核利用率高,但锁竞争会带来一些开销。
Redis 6.0 之前是纯单线程,所有命令串行执行,靠 IO 多路复用撑起高并发。6.0 之后引入了多线程 IO,但命令执行还是单线程,这样既能提升网络吞吐,又不用处理并发竞争问题。
9.2.3. 适用场景选择
Memcached 适合的场景:纯 key-value 缓存、数据结构简单、对持久化没要求、需要多线程跑满 CPU。典型例子是 Facebook 用 Memcached 缓存用户 session。
Redis 适合的场景:需要复杂数据结构、要做排行榜/计数器/分布式锁、需要持久化、想用发布订阅做消息通知。现在大部分互联网公司默认选 Redis。
9.2.4. 集群方案对比
Memcached 的分布式方案完全依赖客户端。最常见的是一致性 hash,客户端根据 key 算出该访问哪台节点。节点挂了或者扩容,客户端要重新计算,可能导致大量缓存失效。
Redis Cluster 是官方的分布式方案,把 key 空间分成 16384 个 slot,每个节点负责一部分 slot。客户端访问错节点会收到 MOVED 指令自动重定向。支持在线扩缩容,数据自动迁移。
9.3. 常见问题
9.3.1. 什么情况下你会选 Memcached 而不是 Redis?
现在很少有新项目选 Memcached 了。但如果场景满足这几个条件可以考虑:只需要简单的 key-value 缓存、数据丢了能接受重新加载、想榨干多核 CPU 性能、不需要持久化。比如纯粹缓存 HTML 片段或者图片缩略图路径这种场景。
9.3.2. Redis 单线程为什么还能这么快?
详细解答可以看:Redis 为什么这么快?
几个原因叠加在一起。第一,数据全在内存里,内存操作本身就是纳秒级别。第二,用了 IO 多路复用,一个线程能同时监听几万个连接,谁有数据就处理谁。第三,单线程没有锁竞争、没有上下文切换开销,反而更高效。第四,Redis 的数据结构都是精心设计的,比如 ziplist、quicklist、skiplist,操作复杂度都控制得很好。
9.3.3. Redis 6.0 引入多线程后,为什么命令执行还是单线程?
详细解答可以看:为什么 Redis 设计为单线程?6.0 版本为何引入多线程?
主要是为了保持简单和正确性。Redis 的卖点之一就是单线程模型带来的原子性保证,所有命令天然串行执行,不用加锁。如果命令执行也多线程化,那事务、Lua 脚本、WATCH 这些功能都要重新设计,复杂度爆炸。6.0 的多线程只用在网络 IO 上,把收发数据的活分出去,命令执行还是老样子,这样风险最小收益最大。
10. Redis 支持事务吗?如何实现?
10.1. 核心要点
Redis 支持事务,但它和 MySQL 事务完全是两码事。Redis 事务只保证命令打包执行不被其他客户端插队,不支持回滚。
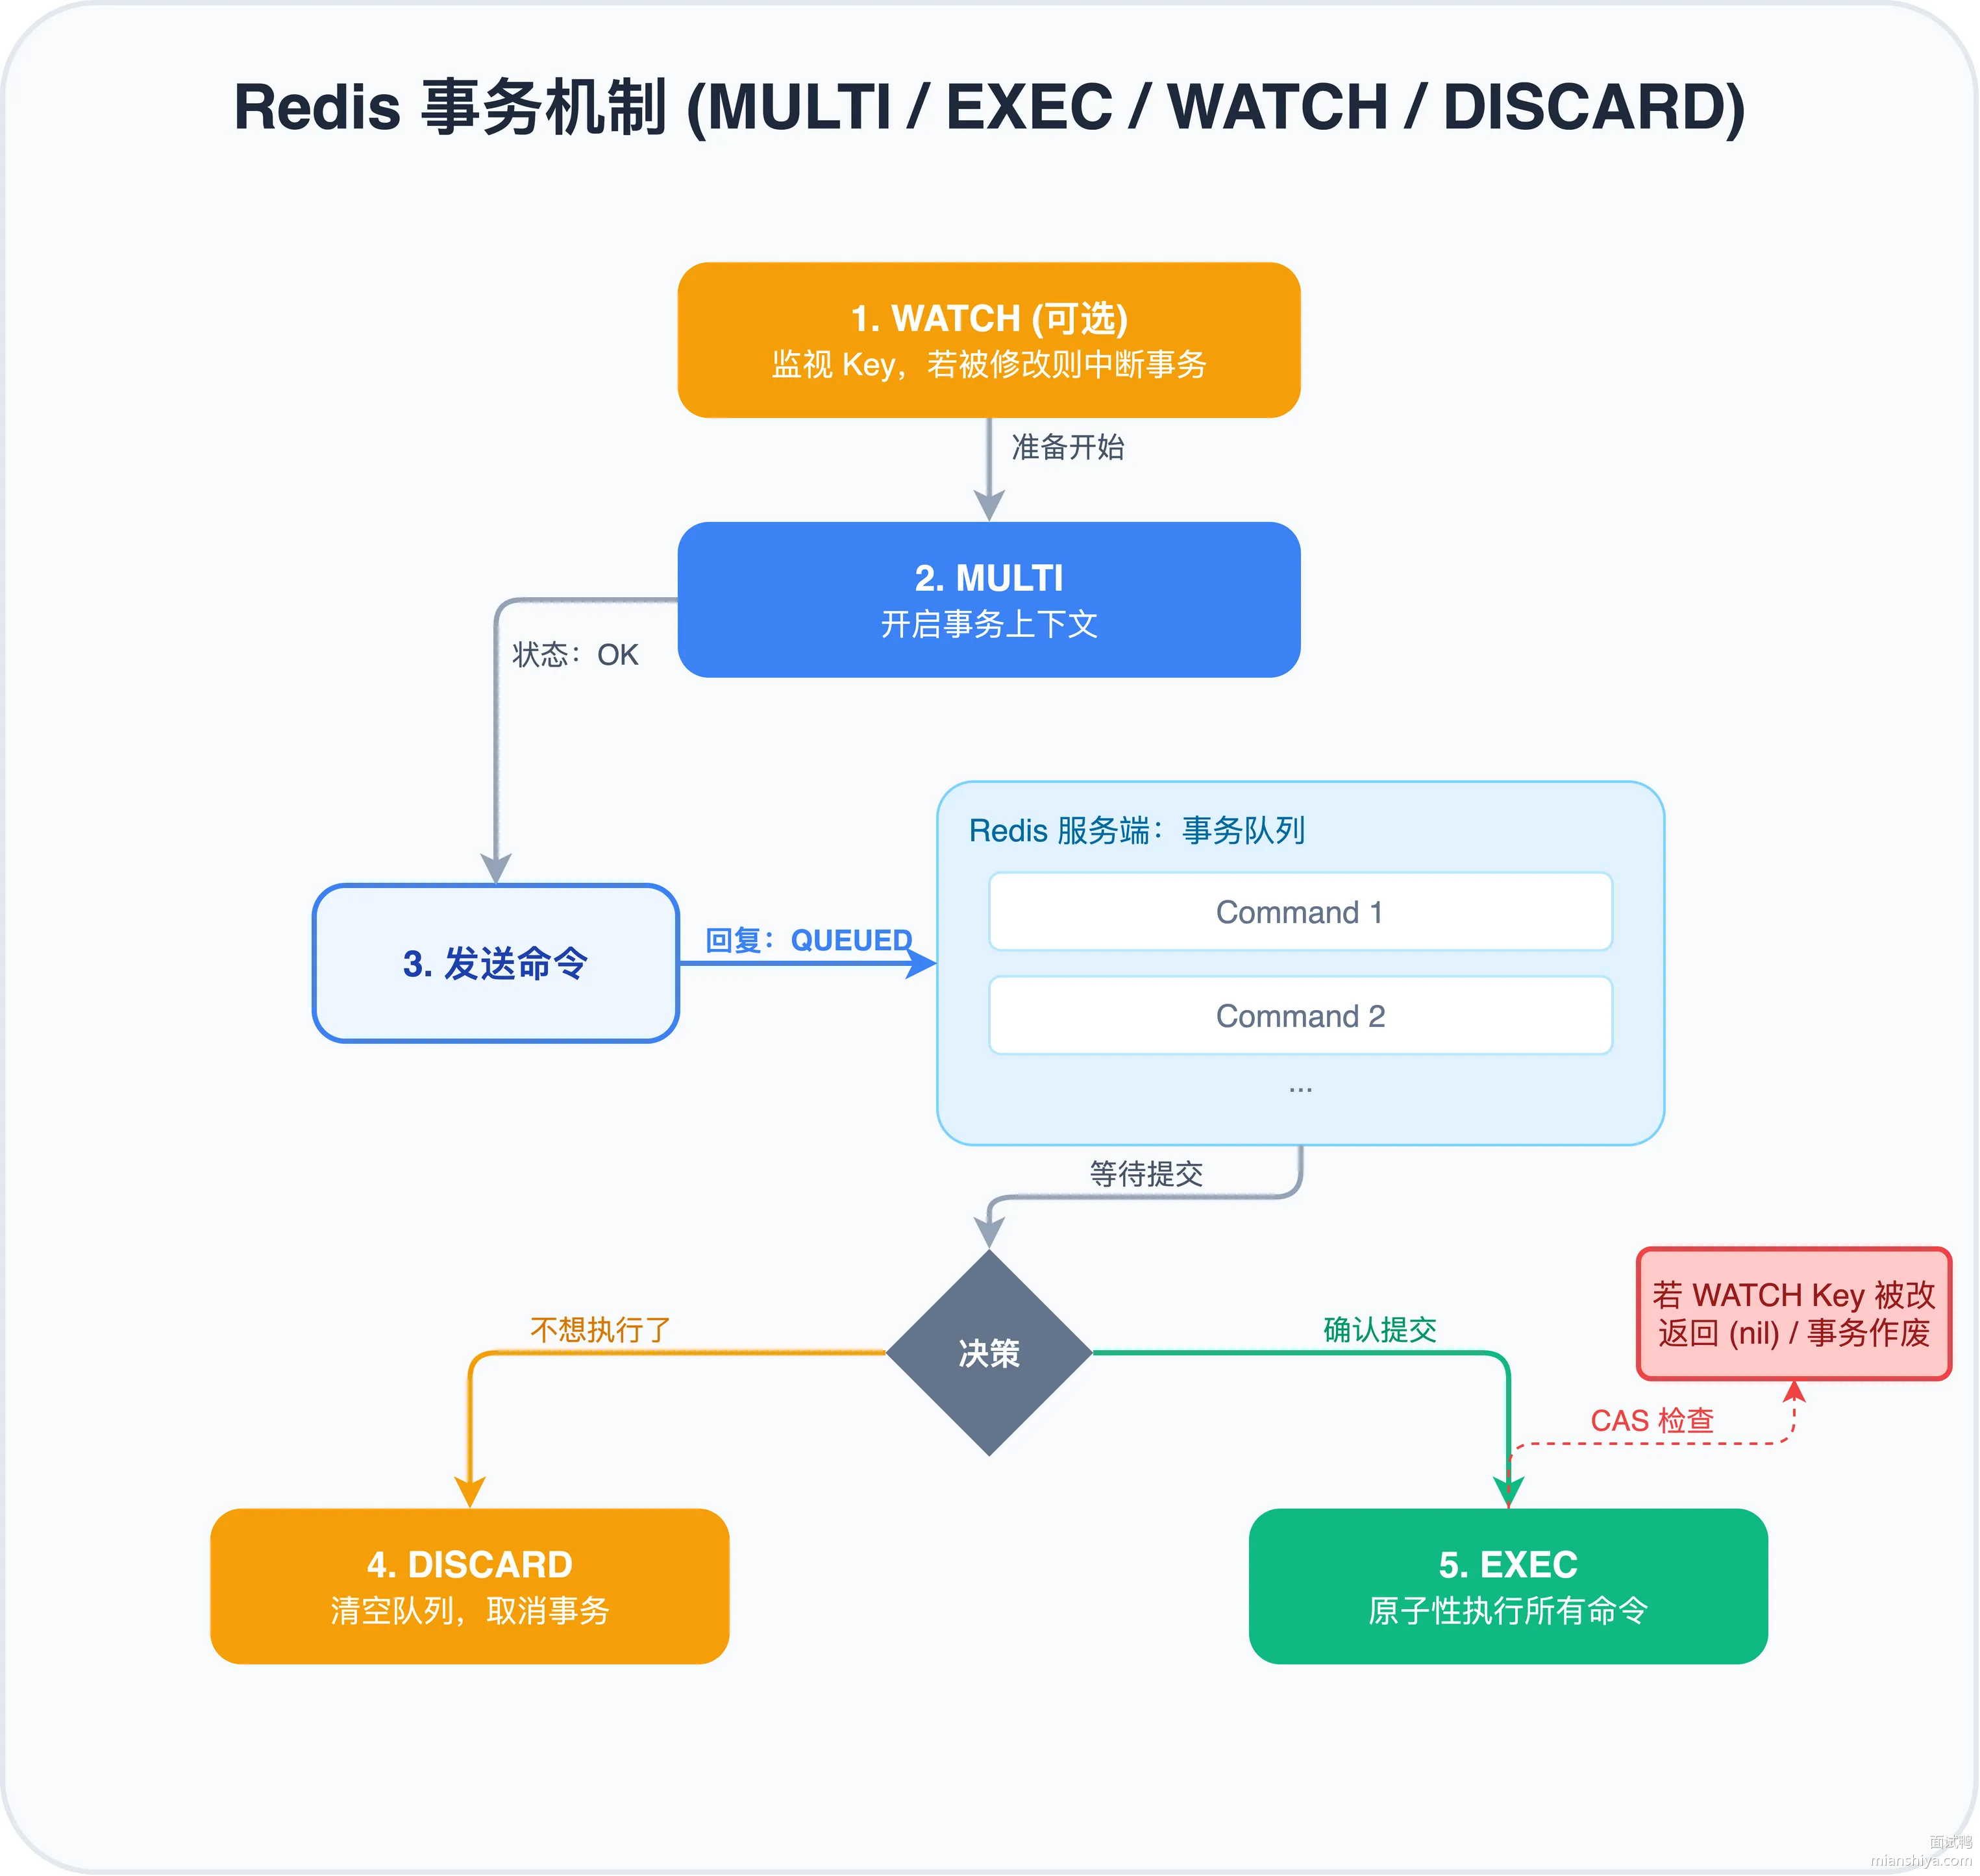
Redis 事务用 MULTI、EXEC、WATCH、DISCARD 四个命令实现:
- MULTI 开启事务,之后发的命令不会立即执行,而是进入一个队列排队
- 队列里可以塞任意多条命令,Redis 会回复 QUEUED 表示入队成功
- EXEC 一次性把队列里的命令全部执行,期间不会被其他客户端的命令打断
- 如果中途不想执行了,用 DISCARD 丢弃整个队列
- WATCH 可以在 MULTI 之前监视某些 key,如果这些 key 在 EXEC 之前被别人改了,整个事务作废
最重要的一点:MySQL 事务执行到一半出错可以回滚,Redis 不行。Redis 事务里某条命令执行失败,剩下的命令照样继续跑,已经执行的也不会撤销。
10.2. 扩展知识
10.2.1. 为什么 Redis 不支持回滚
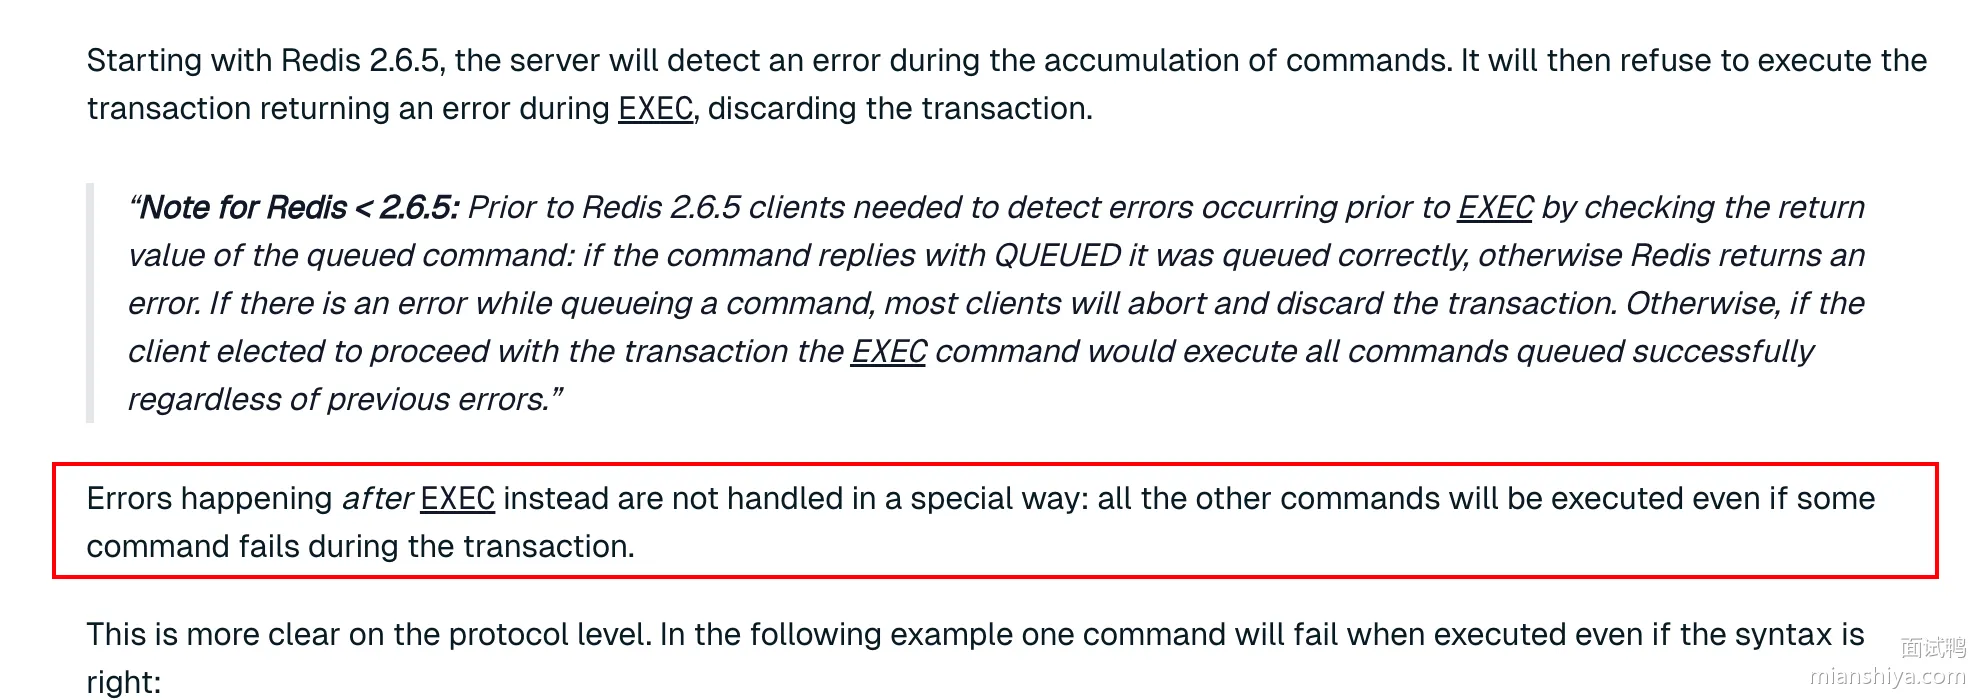
Redis 官方给的理由很直接:Redis 命令出错只有两种情况,一是语法错误,二是对错误类型的 key 执行操作。这两种都是程序 bug 导致的,不应该靠回滚来兜底,应该在开发阶段就发现并修复。
还有一个原因是性能。实现回滚需要记录 undo log,每条命令执行前都要先记一笔,这和 Redis 追求极致性能的设计理念冲突。
10.2.2. 事务中的错误处理
Redis 2.6.5 之后,入队阶段就会做语法检查。如果命令格式明显有问题,比如参数个数不对,入队就会报错,后续 EXEC 会直接拒绝执行整个事务。
> MULTI
OK
> SET a 1 2 3  # 参数太多,语法错误
(error) ERR wrong number of arguments for 'set' command
> EXEC
(error) EXECABORT Transaction discarded because of previous errors
但如果命令语法没问题,只是执行时类型不匹配,比如对字符串执行 LPUSH,那入队能成功,EXEC 时这条命令报错,其他命令照常执行:
> SET name "zhangsan"
OK
> MULTI
OK
> LPUSH name "value"  # 语法对,但 name 是字符串不是列表
QUEUED
> GET name
QUEUED
> EXEC
1) (error) WRONGTYPE Operation against a key holding the wrong kind of value
2) "zhangsan"  # 这条还是执行了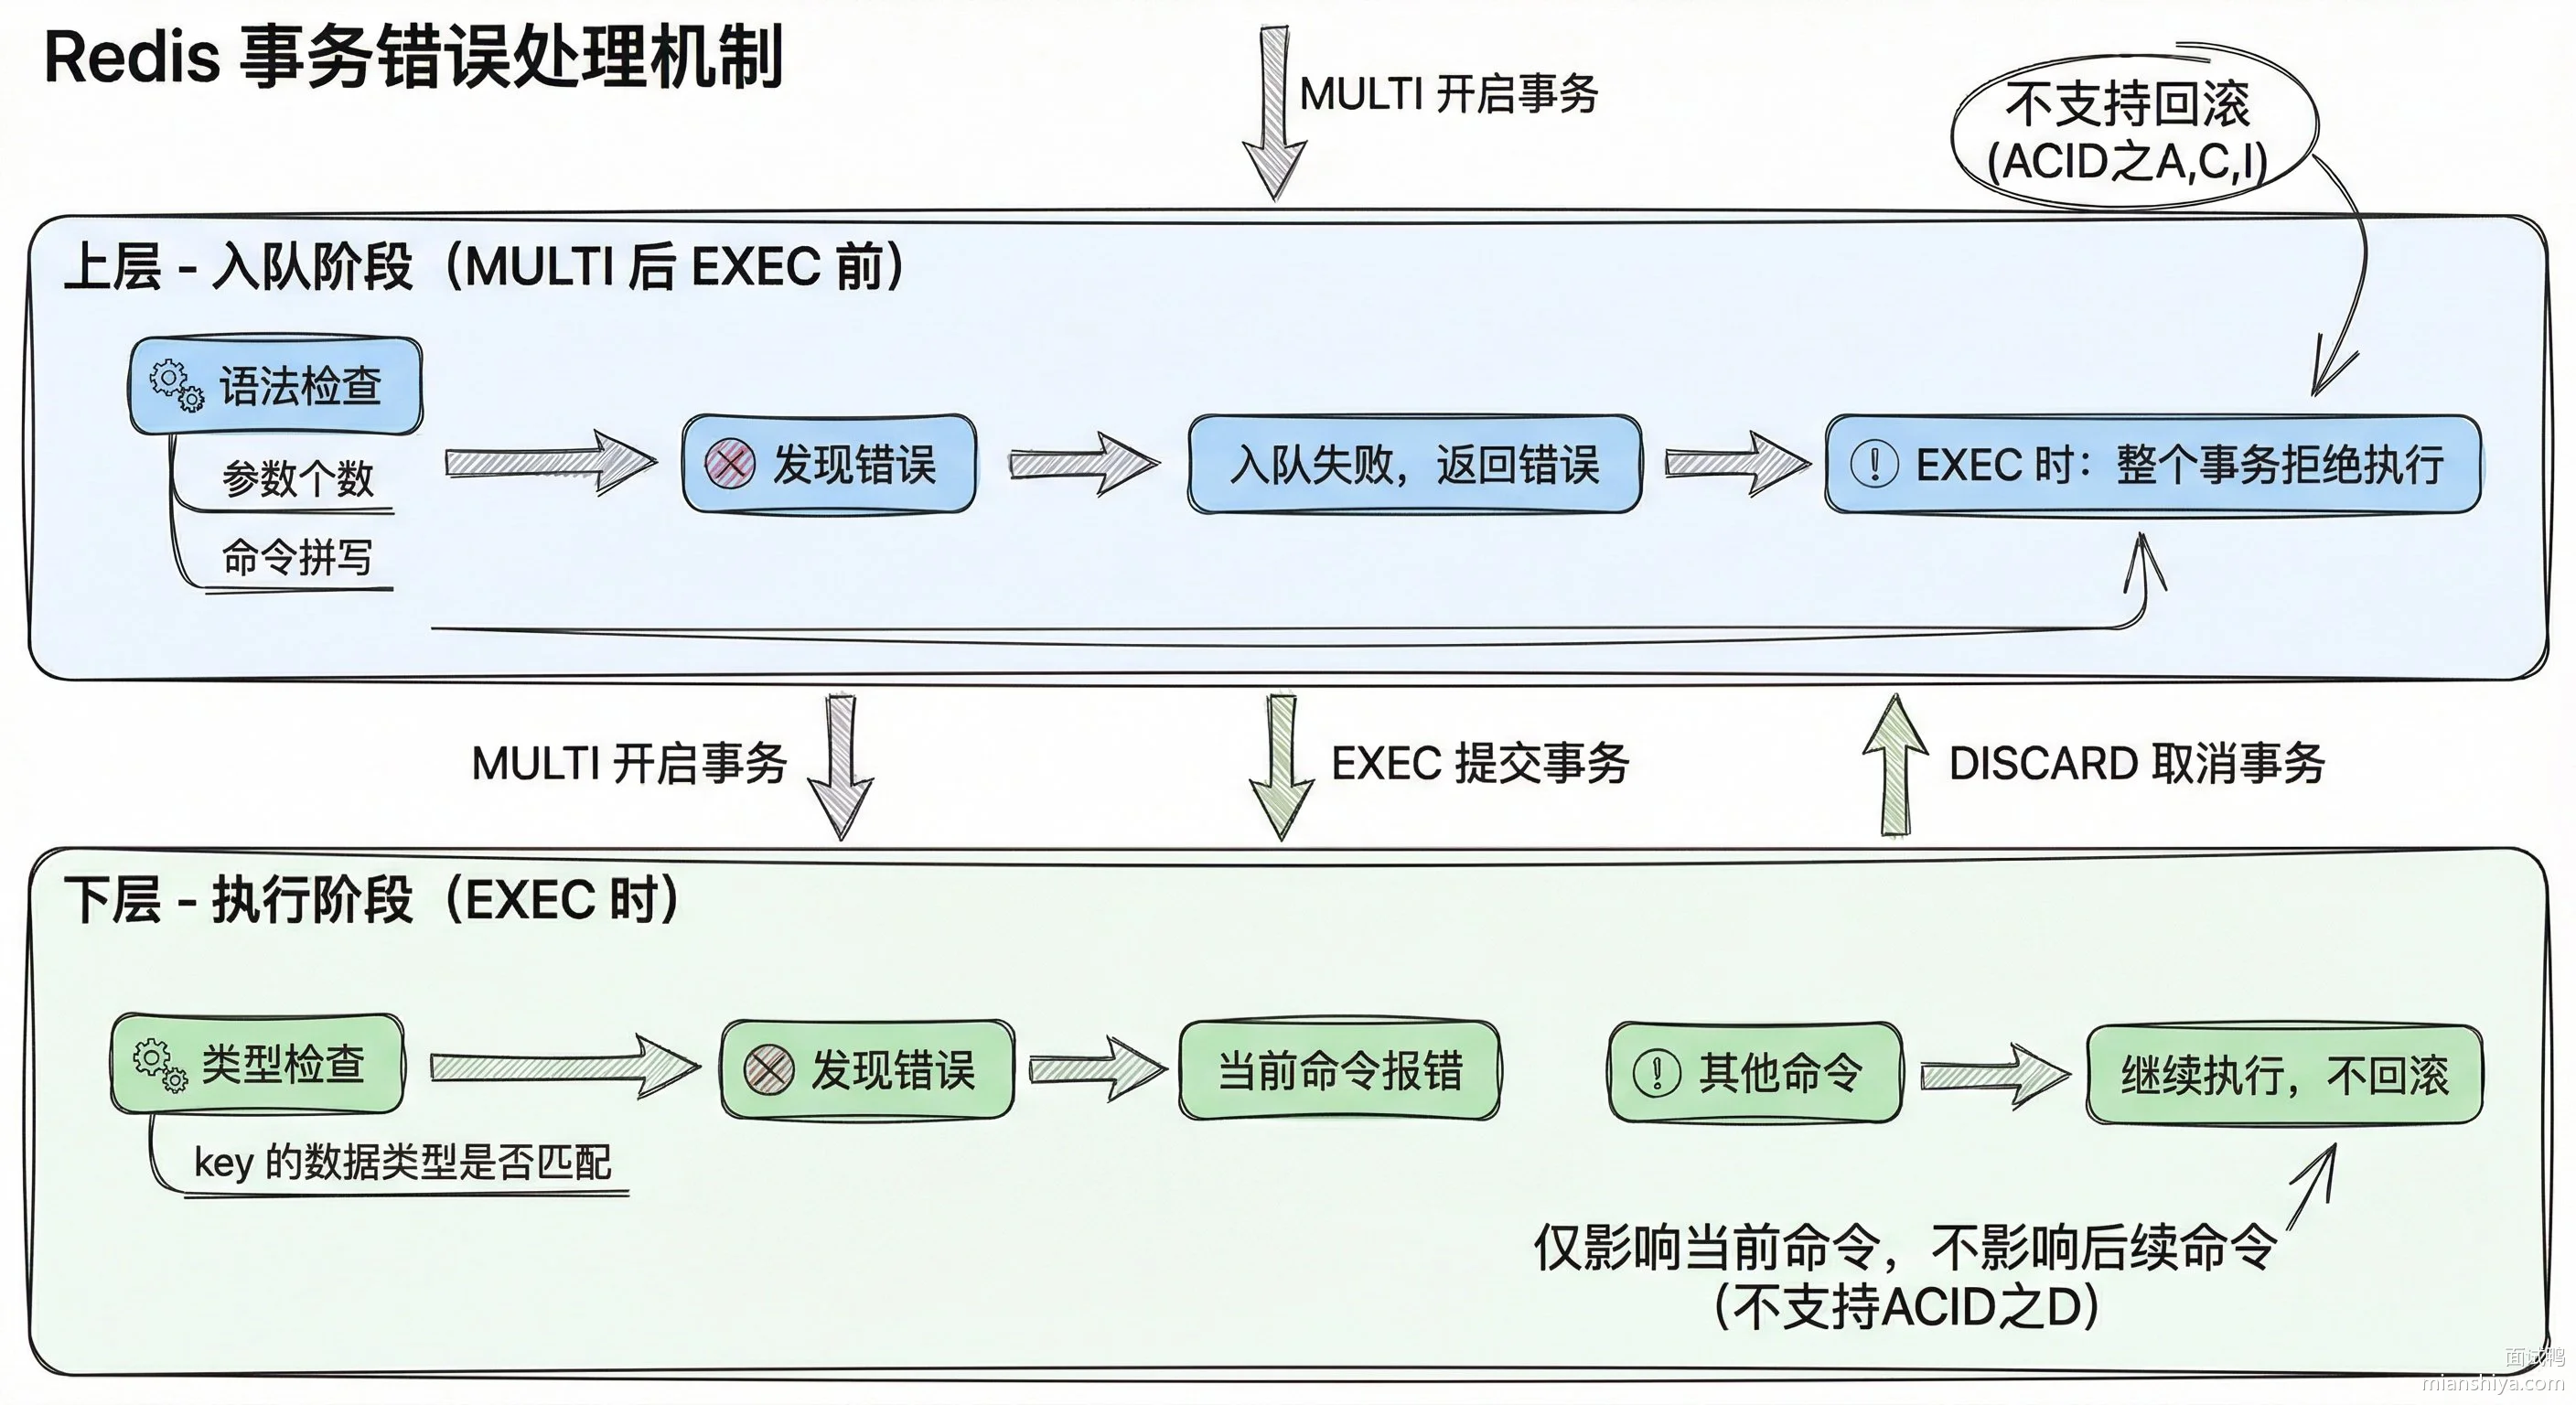
10.2.3. WATCH 实现乐观锁
WATCH 命令可以实现类似 CAS 的乐观锁效果。经典场景是扣库存:
WATCH stock
val = GET stock
if val > 0:
    MULTI
    DECR stock
    EXEC
else:
    放弃
WATCH 之后如果 stock 被别的客户端改了,EXEC 会返回 nil 表示事务被放弃,这时候重新读取 stock 再试一次就行。
底层实现是 Redis 给每个被 WATCH 的 key 维护一个客户端列表,key 被修改时标记这些客户端的事务为失效状态。
10.2.4. Redis 事务 vs MySQL 事务
| 特性 | Redis 事务 | MySQL 事务 |
|---|---|---|
| 原子性 | 打包执行不被打断,但不支持回滚 | 完整的原子性,支持回滚 |
| 隔离性 | 单线程串行执行,天然隔离 | 支持 4 种隔离级别 |
| 持久性 | 取决于 AOF 配置 | 通过 redo log 保证 |
| 一致性 | 不保证,部分失败不回滚 | 通过回滚保证 |
| 性能 | 极高,无额外开销 | 需要记录日志,有开销 |
10.2.5. Lua 脚本是更好的选择
实际开发中,需要原子执行多条命令时,Lua 脚本比事务更好用。Lua 脚本在 Redis 里是原子执行的,而且可以写逻辑判断,比事务灵活得多:
-- 扣库存的 Lua 脚本
local stock = redis.call('GET', KEYS[1])
if tonumber(stock) > 0 then
    redis.call('DECR', KEYS[1])
    return 1
else
    return 0
end
用 EVAL 或 EVALSHA 执行,整个脚本原子执行,中间不会被其他命令插队。
10.3. 常见问题
10.3.1. WATCH 监视的 key 被当前客户端自己改了会怎样?
WATCH 监视的是任何对 key 的修改,不区分修改来源。所以如果在 MULTI 之后、EXEC 之前被改了,事务会失败。
10.3.2. Redis 事务能保证隔离性吗?
能,而且是最高级别的串行化隔离。因为 Redis 命令执行是单线程的,事务里的命令打包在一起执行,中间不会穿插其他客户端的命令。不存在脏读、不可重复读、幻读这些问题。
10.3.3. 生产环境你会用 Redis 事务吗?
基本不用,Lua 脚本更香。事务的问题在于不支持回滚,而且 WATCH 乐观锁在高并发下重试次数可能很多。Lua 脚本既能原子执行又能写条件判断,出错也容易定位,Redis Cluster 环境下只要操作的 key 在同一个 slot 也能用。
11. Redis 数据过期后的删除策略是什么?
11.1. 核心要点
Redis 过期 key 的删除靠惰性删除 + 定期删除两种策略配合使用。
惰性删除是被动触发的:每次读写某个 key 之前,Redis 先检查这个 key 是不是过期了,过期了就顺手删掉,然后返回空。这样做的好处是不用额外占 CPU 去扫描,坏处是如果一个 key 过期了但一直没人访问,它就一直赖在内存里不走。
定期删除是主动清理的:Redis 每 100ms 触发一次定时任务,随机抽一批设了过期时间的 key 检查,发现过期的就删掉。但它不会一股脑把所有过期 key 都扫一遍,而是有限制地做采样清理,避免清理动作本身把 CPU 吃满。
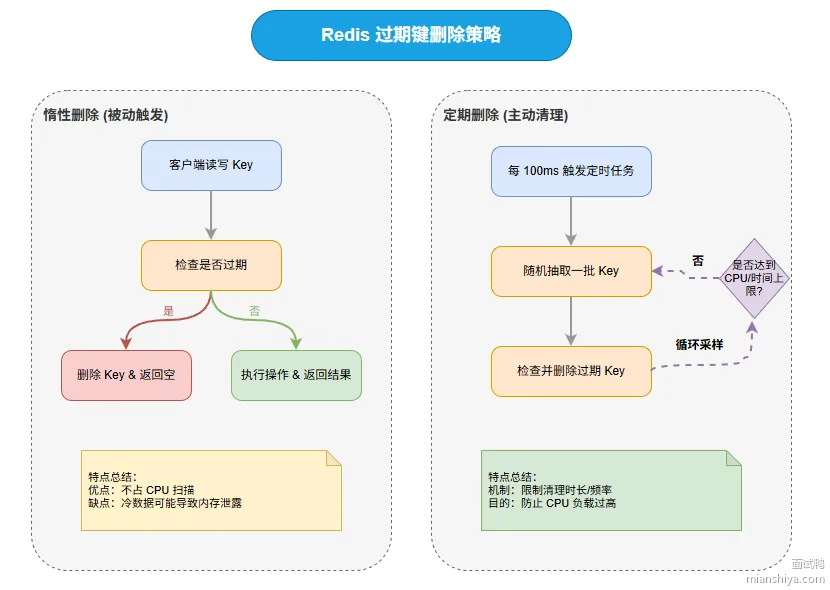
两种策略各有缺陷,惰性删除可能漏删,定期删除可能删不完,所以必须一起用才能兜住。
11.2. 扩展知识
11.2.1. 定期删除的具体流程
定期删除任务每次执行的逻辑是这样的:
1)从设置了过期时间的 key 集合里随机取 20 个 2)删掉其中已过期的 3)如果过期的比例超过 25%,说明过期 key 可能还挺多,继续取下一批 20 个 4)如果过期比例低于 25%,说明差不多了,本轮结束 5)整个过程有个硬性时间上限 25ms,超时强制结束,防止主线程被卡住
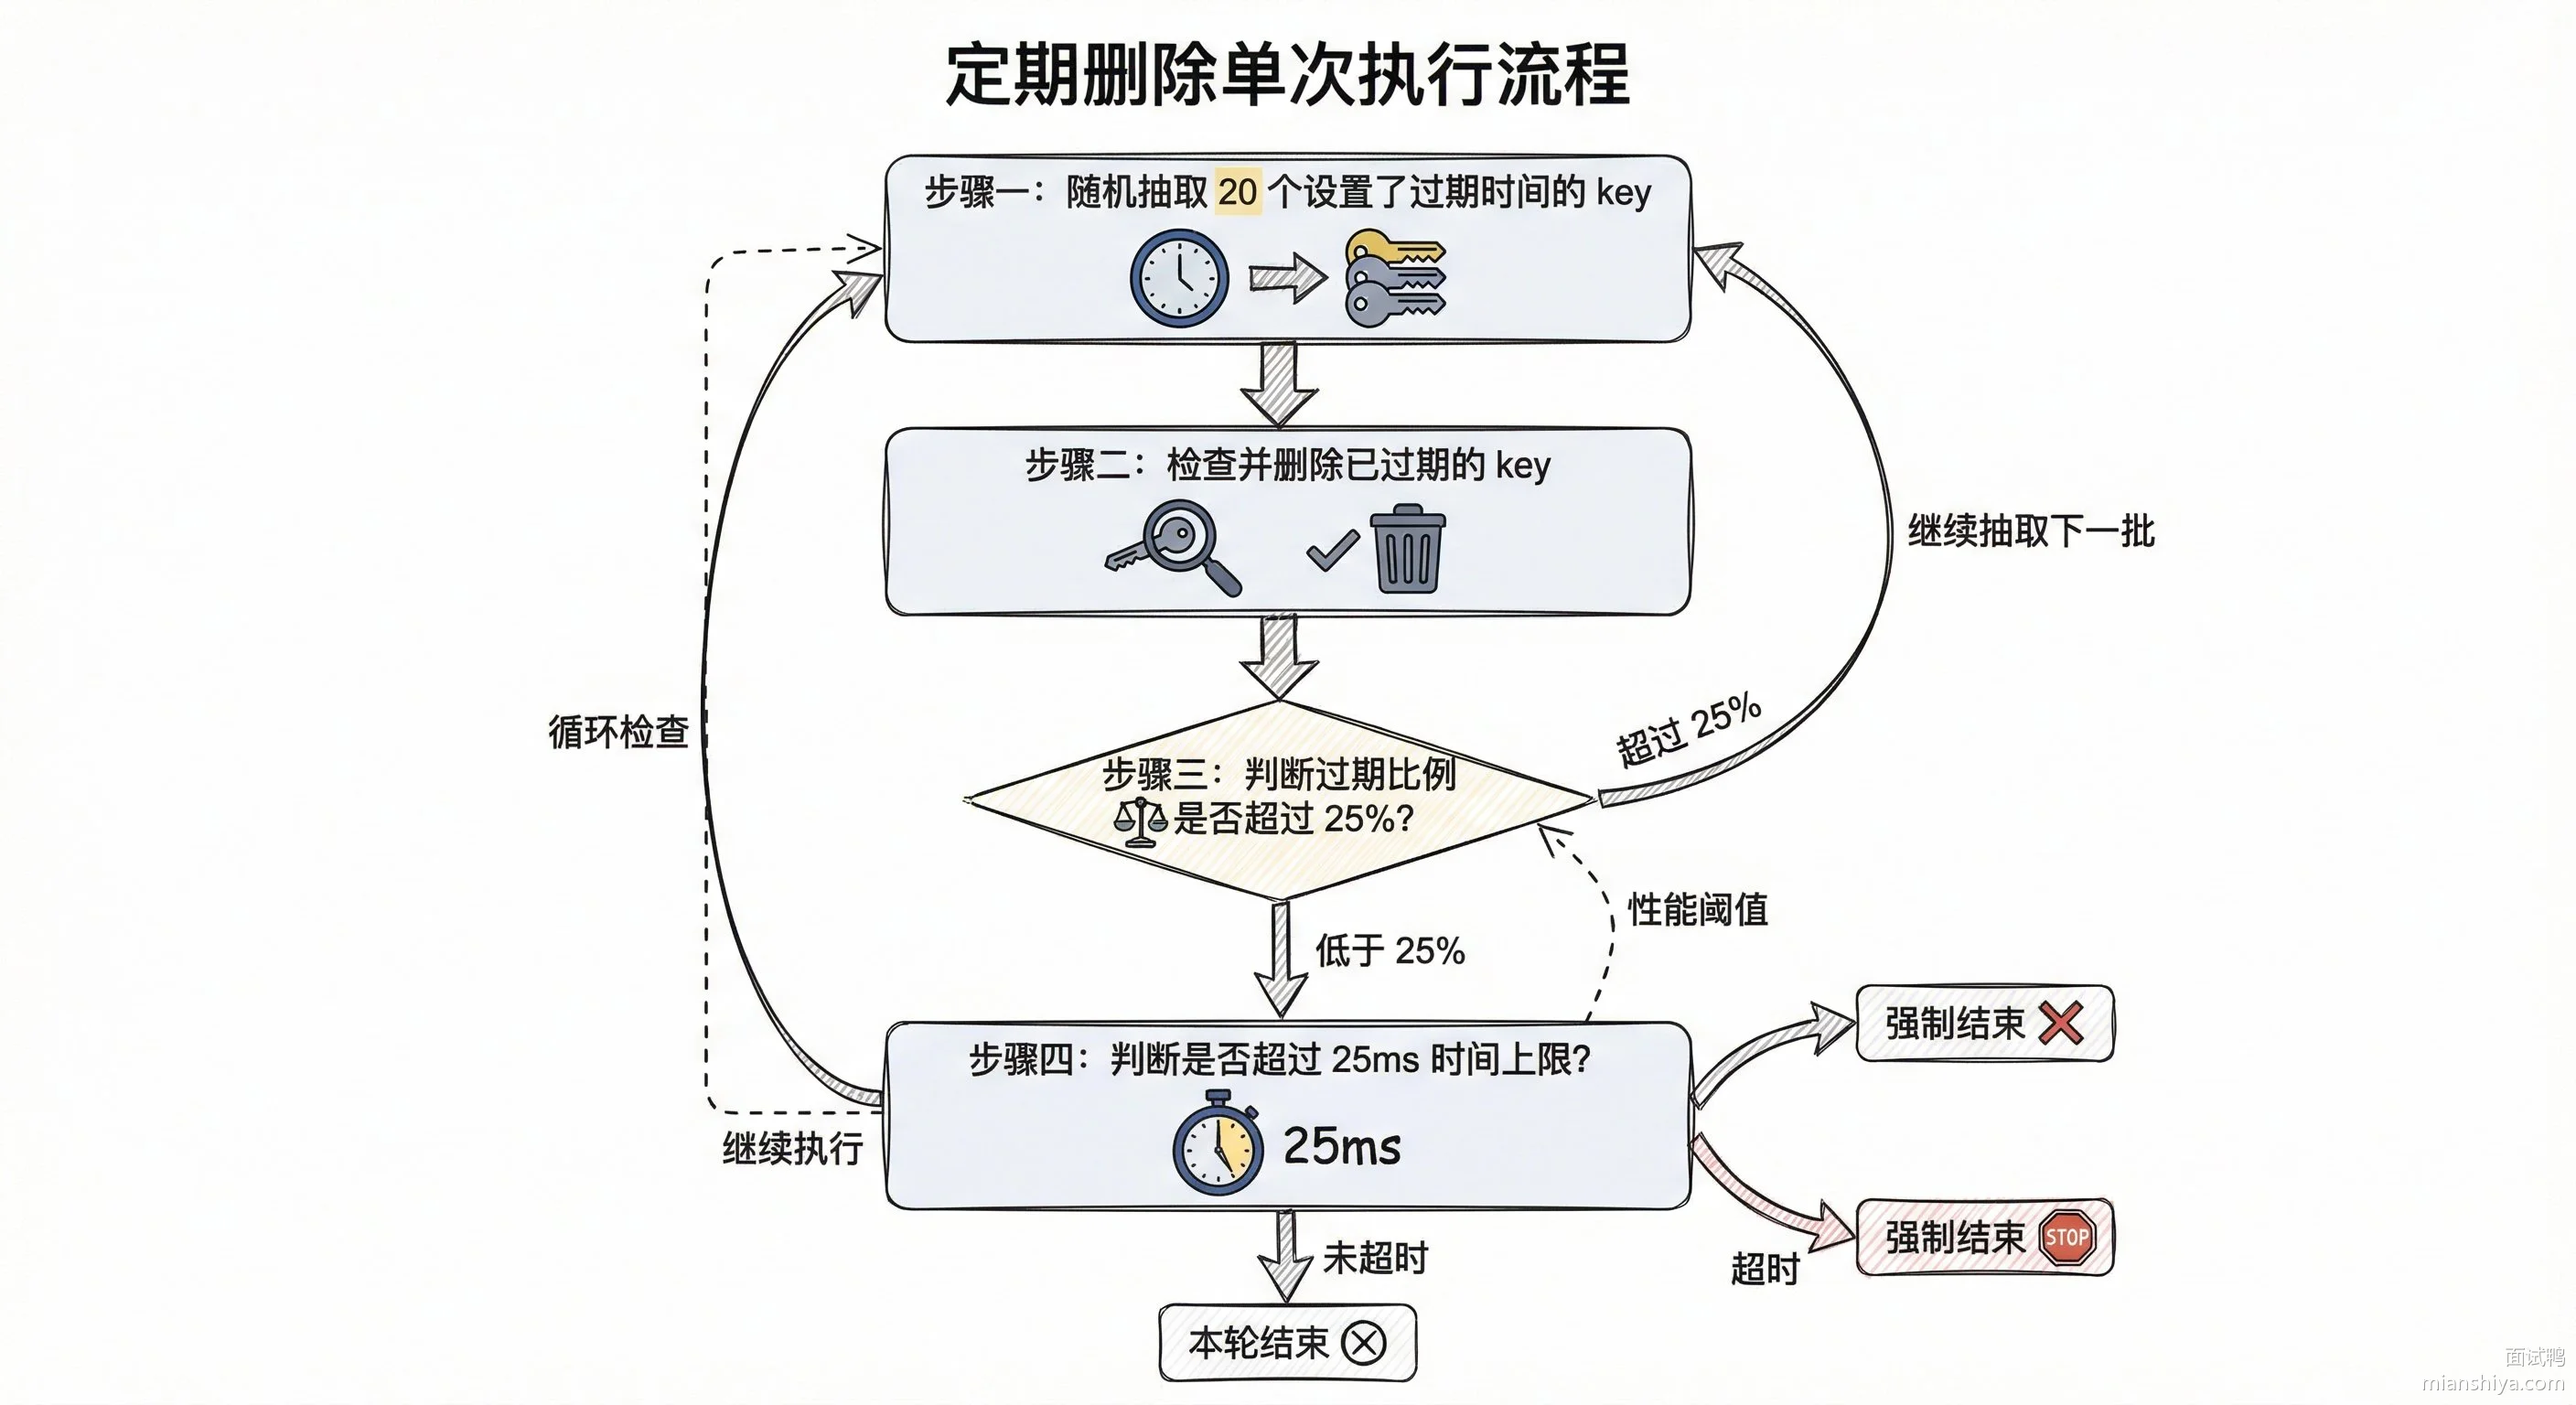
这个设计很精妙。25% 阈值保证了在过期 key 多的时候能加速清理,25ms 上限保证了不会影响正常请求处理。Redis 是单线程的,定期删除任务跑的时候其他命令都得等着,所以必须控制好时间。
11.2.2. 内存淘汰策略
如果惰性删除和定期删除都没能及时清理,内存还是涨到了 maxmemory 上限,这时候写入新数据会触发内存淘汰机制。
Redis 提供了 8 种淘汰策略:
| 策略 | 作用范围 | 淘汰规则 |
|---|---|---|
| noeviction | 不淘汰 | 直接报错拒绝写入 |
| allkeys-lru | 所有 key | 最近最少使用的先淘汰 |
| allkeys-lfu | 所有 key | 使用频率最低的先淘汰 |
| allkeys-random | 所有 key | 随机淘汰 |
| volatile-lru | 设了过期时间的 key | 最近最少使用的先淘汰 |
| volatile-lfu | 设了过期时间的 key | 使用频率最低的先淘汰 |
| volatile-random | 设了过期时间的 key | 随机淘汰 |
| volatile-ttl | 设了过期时间的 key | 剩余存活时间短的先淘汰 |
生产环境最常用的是 allkeys-lru 和 volatile-lru。如果你的缓存数据都设了过期时间,用 volatile-lru 更安全,不会误删没设过期时间的重要数据。
11.2.3. LRU 和 LFU 的区别
LRU 看的是"最近有没有用过",最近没访问过的先干掉。但有个问题:一个 key 平时访问频率很低,偶尔被访问一次,它就变成"最近访问过"的了,短期内不会被淘汰。
LFU 看的是"用了多少次",访问频率低的先干掉。Redis 4.0 引入的,用 24 bit 记录访问次数,还有个衰减机制防止历史热点数据长期霸占内存。
一般来说,如果访问模式比较稳定,LFU 比 LRU 命中率更高。
11.2.4. 过期时间相关命令
# 设置过期时间
EXPIRE key 60          # 60 秒后过期
PEXPIRE key 60000      # 60000 毫秒后过期
EXPIREAT key 1735689600    # Unix 时间戳到期
PEXPIREAT key 1735689600000  # 毫秒级时间戳

# 设值的同时设过期时间
SET key value EX 60    # 推荐,原子操作
SETEX key 60 value     # 老写法,效果一样

# 查看剩余时间
TTL key      # 返回秒数,-1 表示永不过期,-2 表示 key 不存在
PTTL key     # 返回毫秒数

# 移除过期时间
PERSIST key  # key 变成永不过期
11.2.5. 过期 key 的存储结构
Redis 内部维护了一个专门的字典叫 expires dict,用来存放所有设了过期时间的 key。key 是指针指向实际的 key 对象,value 是过期时间的毫秒级 Unix 时间戳。
检查 key 是否过期就是拿当前时间和 expires dict 里存的时间戳比一下。惰性删除在每次访问 key 前检查,定期删除则是从 expires dict 里随机抽样检查。
11.3. 常见问题
11.3.1. 主从复制的时候,从节点会自己删除过期 key 吗?
从节点不会主动删除过期 key,它只等主节点发 DEL 命令过来才删。Redis 3.2 之前从节点读过期 key 还能读到数据,3.2 之后优化了,从节点读过期 key 会返回空,但 key 还在内存里,等主节点的 DEL 同步过来才真正删除。
11.3.2. 大量 key 同时过期会有什么问题?
会卡。定期删除任务发现过期比例超过 25% 就会循环继续删,虽然有 25ms 上限,但这 25ms 主线程是阻塞的,其他请求都得等着。如果同时过期的 key 特别多,可能连续好几轮都在删,造成请求延迟抖动。解决办法是给过期时间加个随机偏移,比如 3600 + random(300),让过期时间分散开。
11.3.3. AOF 重写的时候会处理过期 key 吗?
会。AOF 重写时会检查每个 key 是否过期,过期的直接不写进新 AOF 文件。这是个顺便清理的好机会,能减小 AOF 文件体积。RDB 持久化也一样,生成 RDB 快照时过期 key 不会写进去。
12. Redis 中有哪些内存淘汰策略?
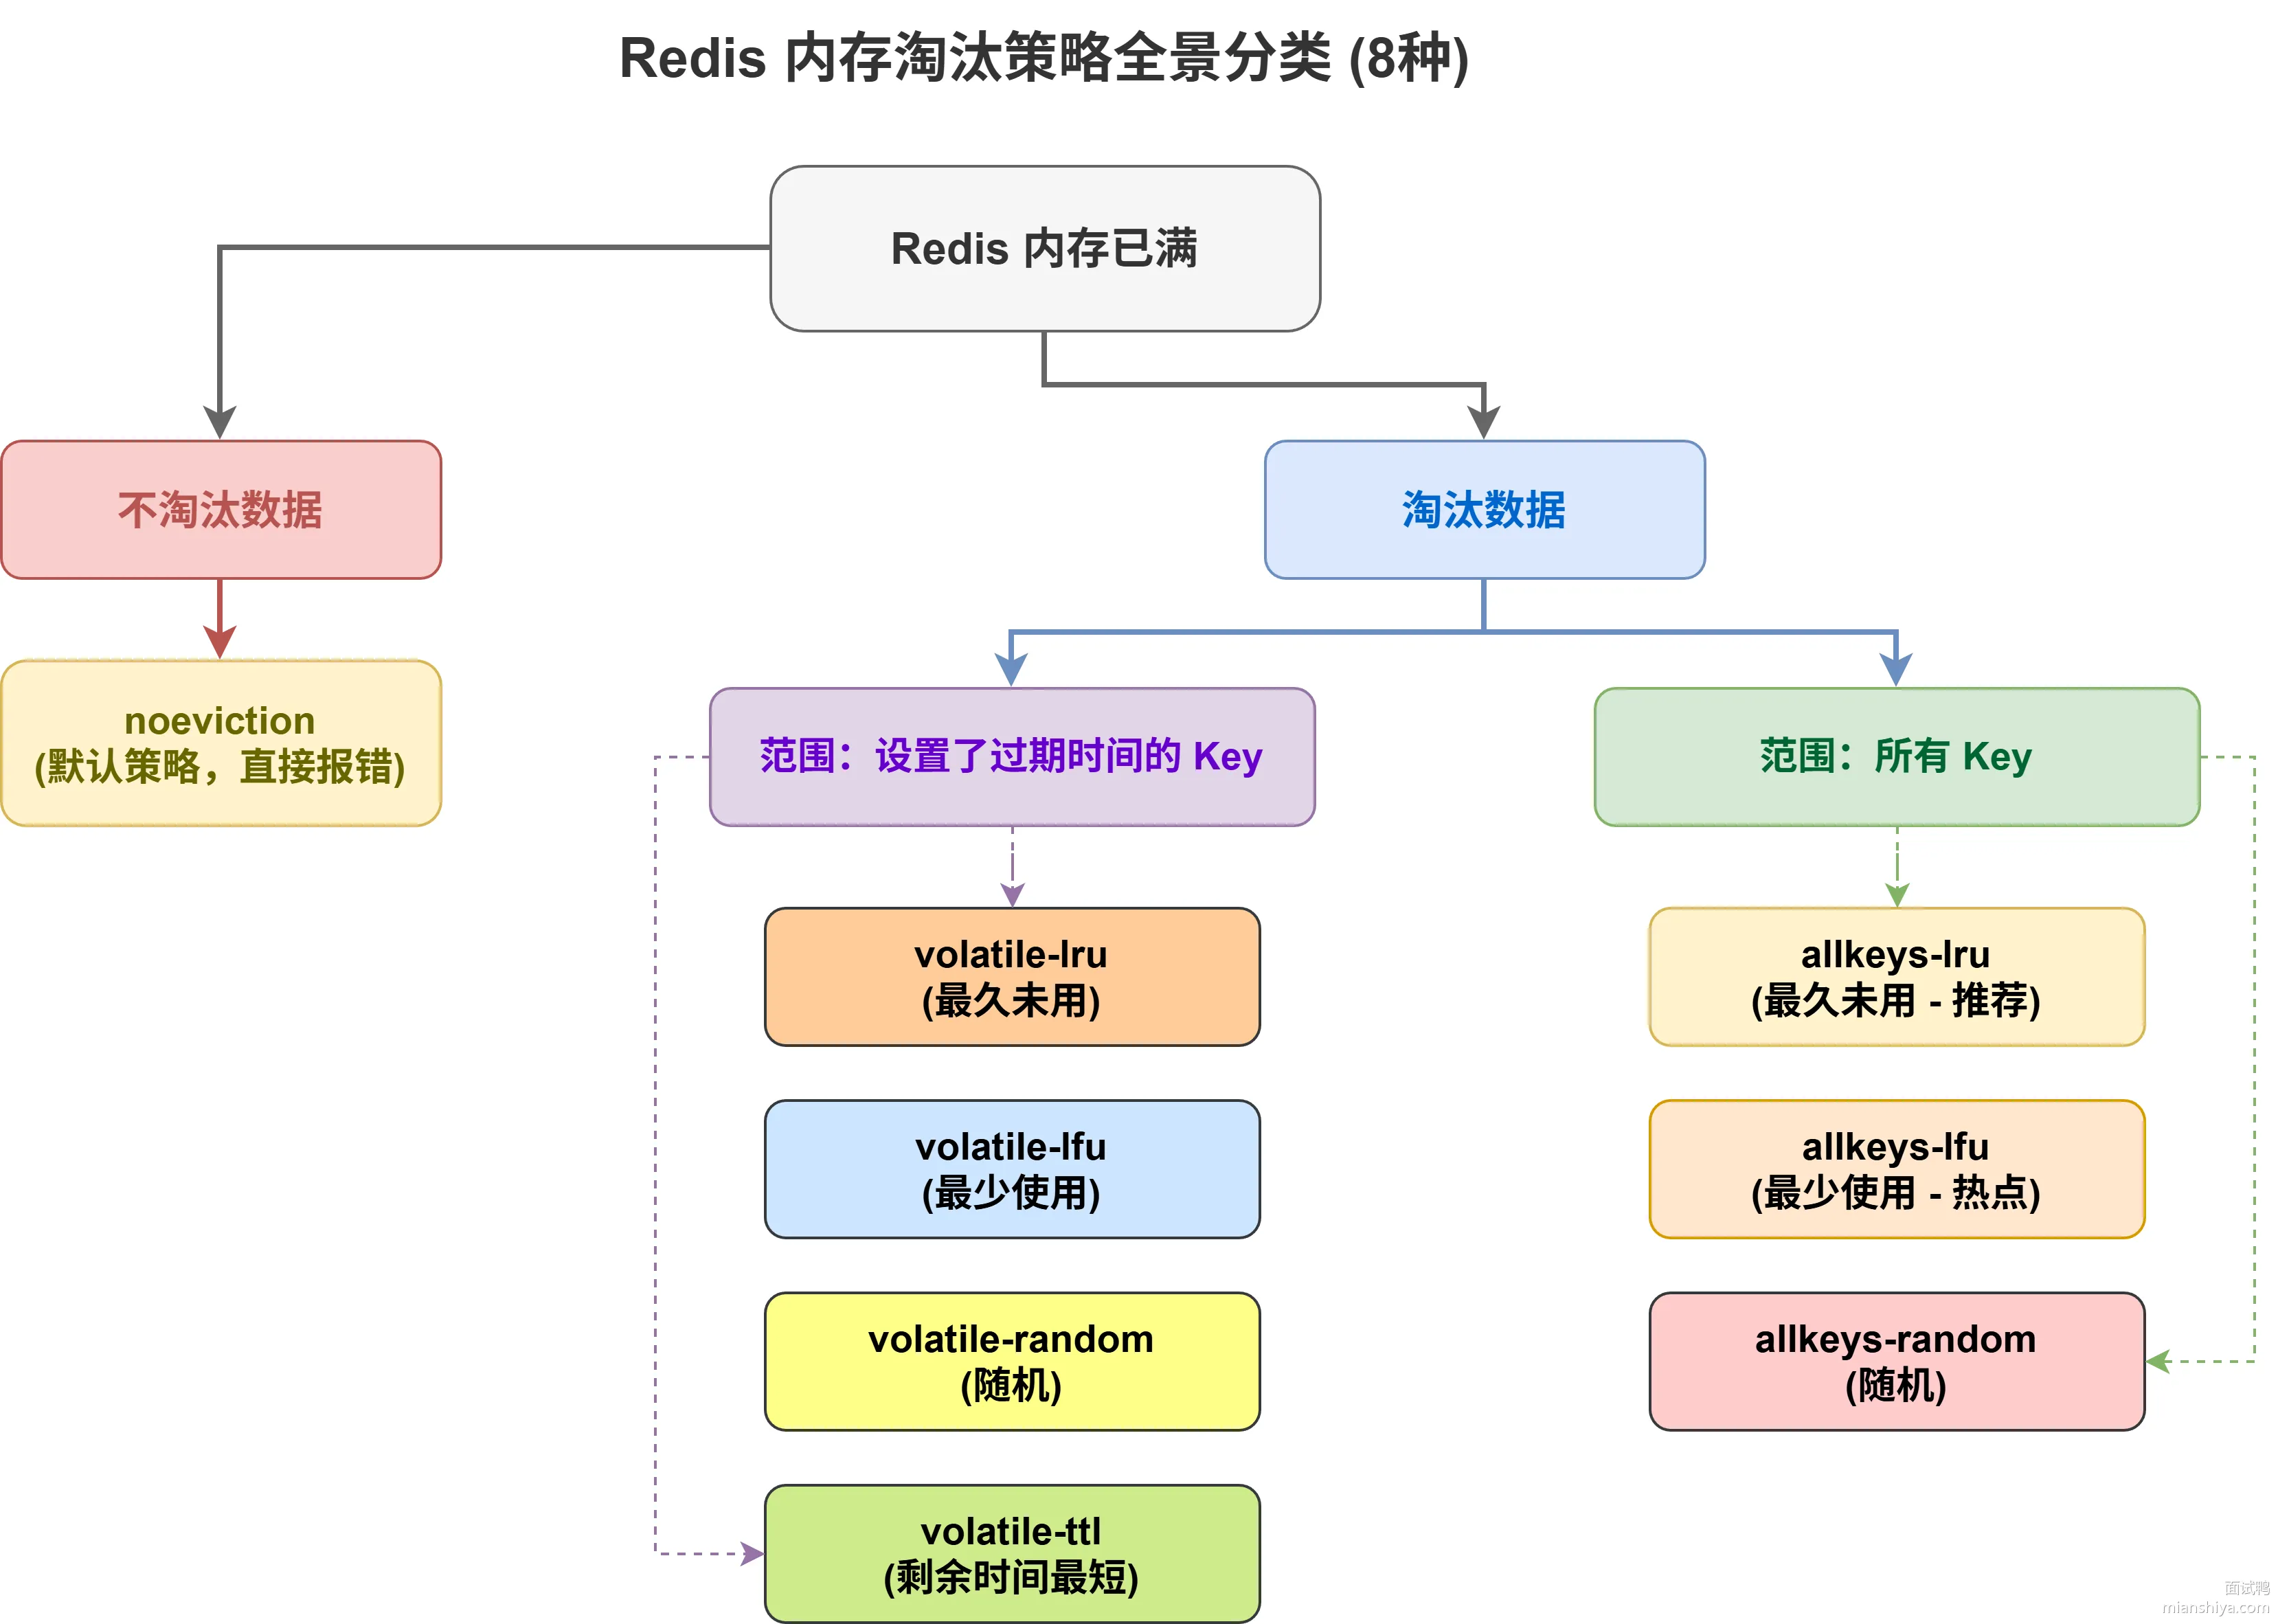
12.1. 核心要点
Redis 内存淘汰策略一共 8 种,分成两大类:不淘汰数据和淘汰数据。淘汰数据又能细分成针对设了过期时间的 key 和针对所有 key 两种。
不淘汰数据:
1)noeviction:内存满了直接报错,禁止写入,Redis 默认就是这个策略
针对设了过期时间的 key 淘汰:
1)volatile-random:随机干掉设了过期时间的 key
2)volatile-ttl:优先干掉剩余存活时间最短的 key
3)volatile-lru:淘汰最久没被访问的 key
4)volatile-lfu:淘汰访问频率最低的 key,Redis 4.0 新增
针对所有 key 淘汰:
1)allkeys-random:随机干掉任意 key
2)allkeys-lru:淘汰最久没被访问的 key
3)allkeys-lfu:淘汰访问频率最低的 key,Redis 4.0 新增
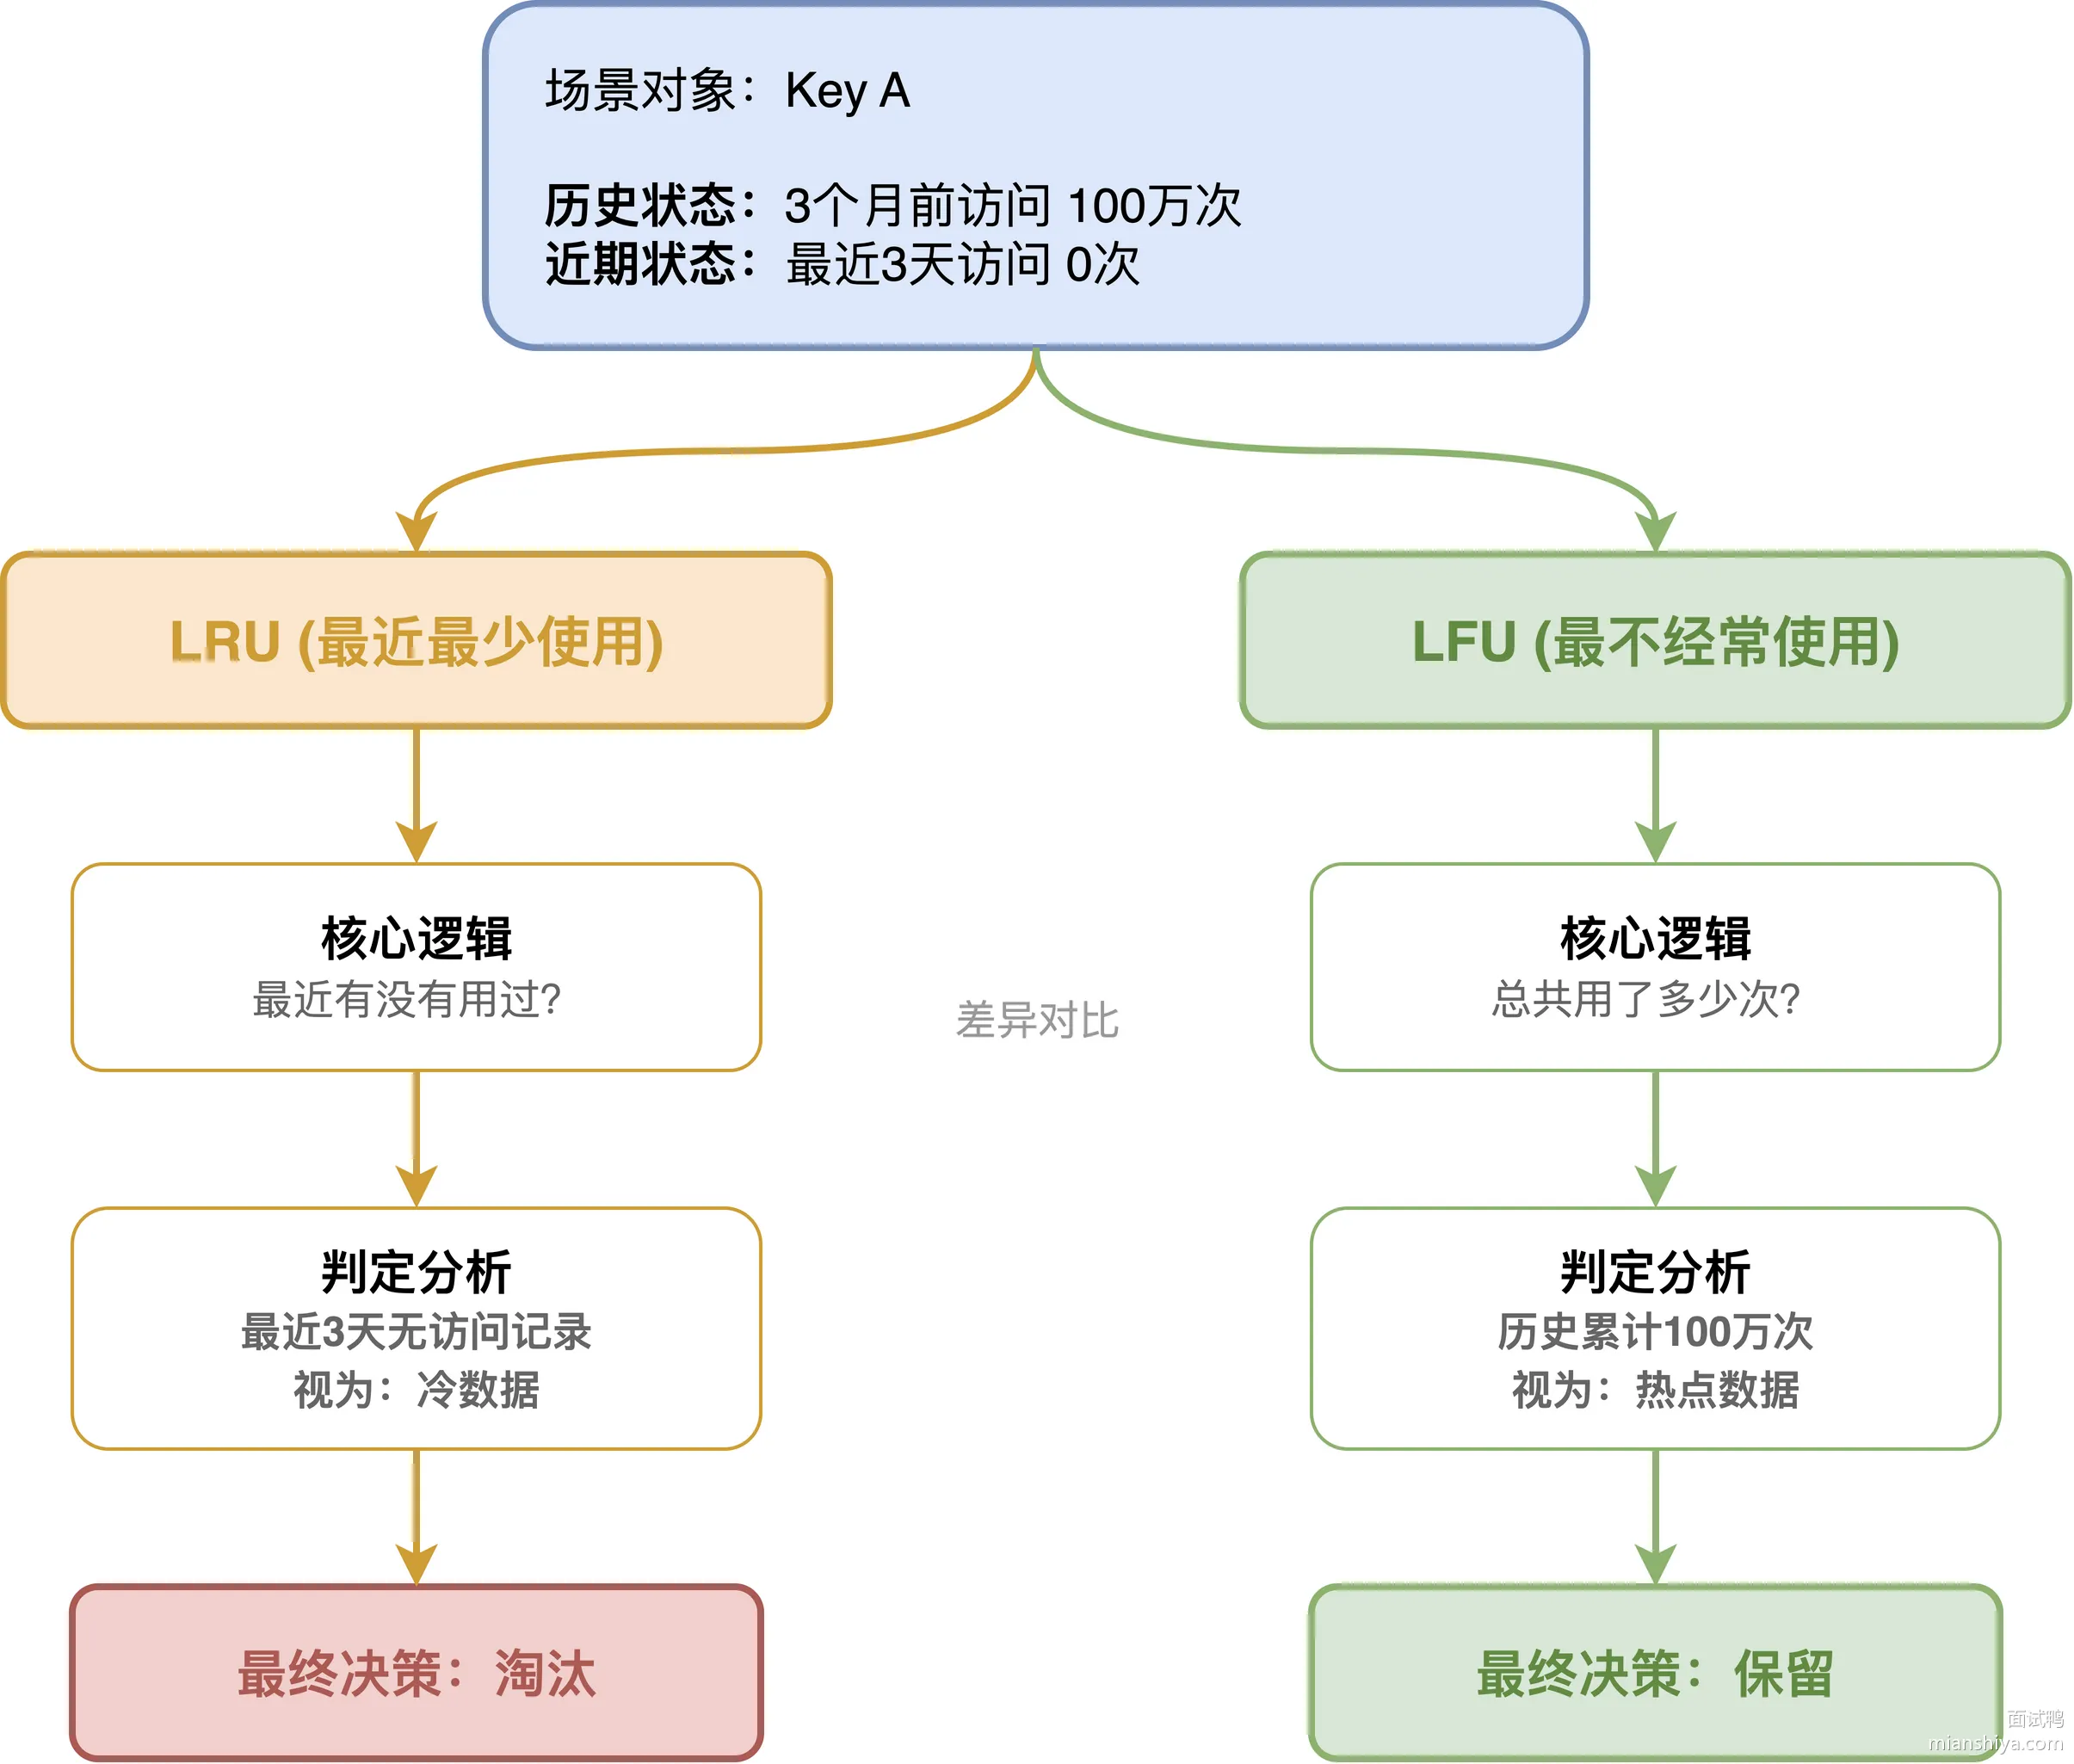
这里要注意 LRU 和 LFU 的区别:LRU 看的是"最近有没有用过",LFU 看的是"总共用了多少次"。假设有个 key 三个月前被疯狂访问了 100 万次,但最近三天一次都没被访问,LRU 会认为它该淘汰,LFU 反而觉得它是热点数据要留着。
12.2. 扩展知识
12.2.1. LRU vs LFU 的选择
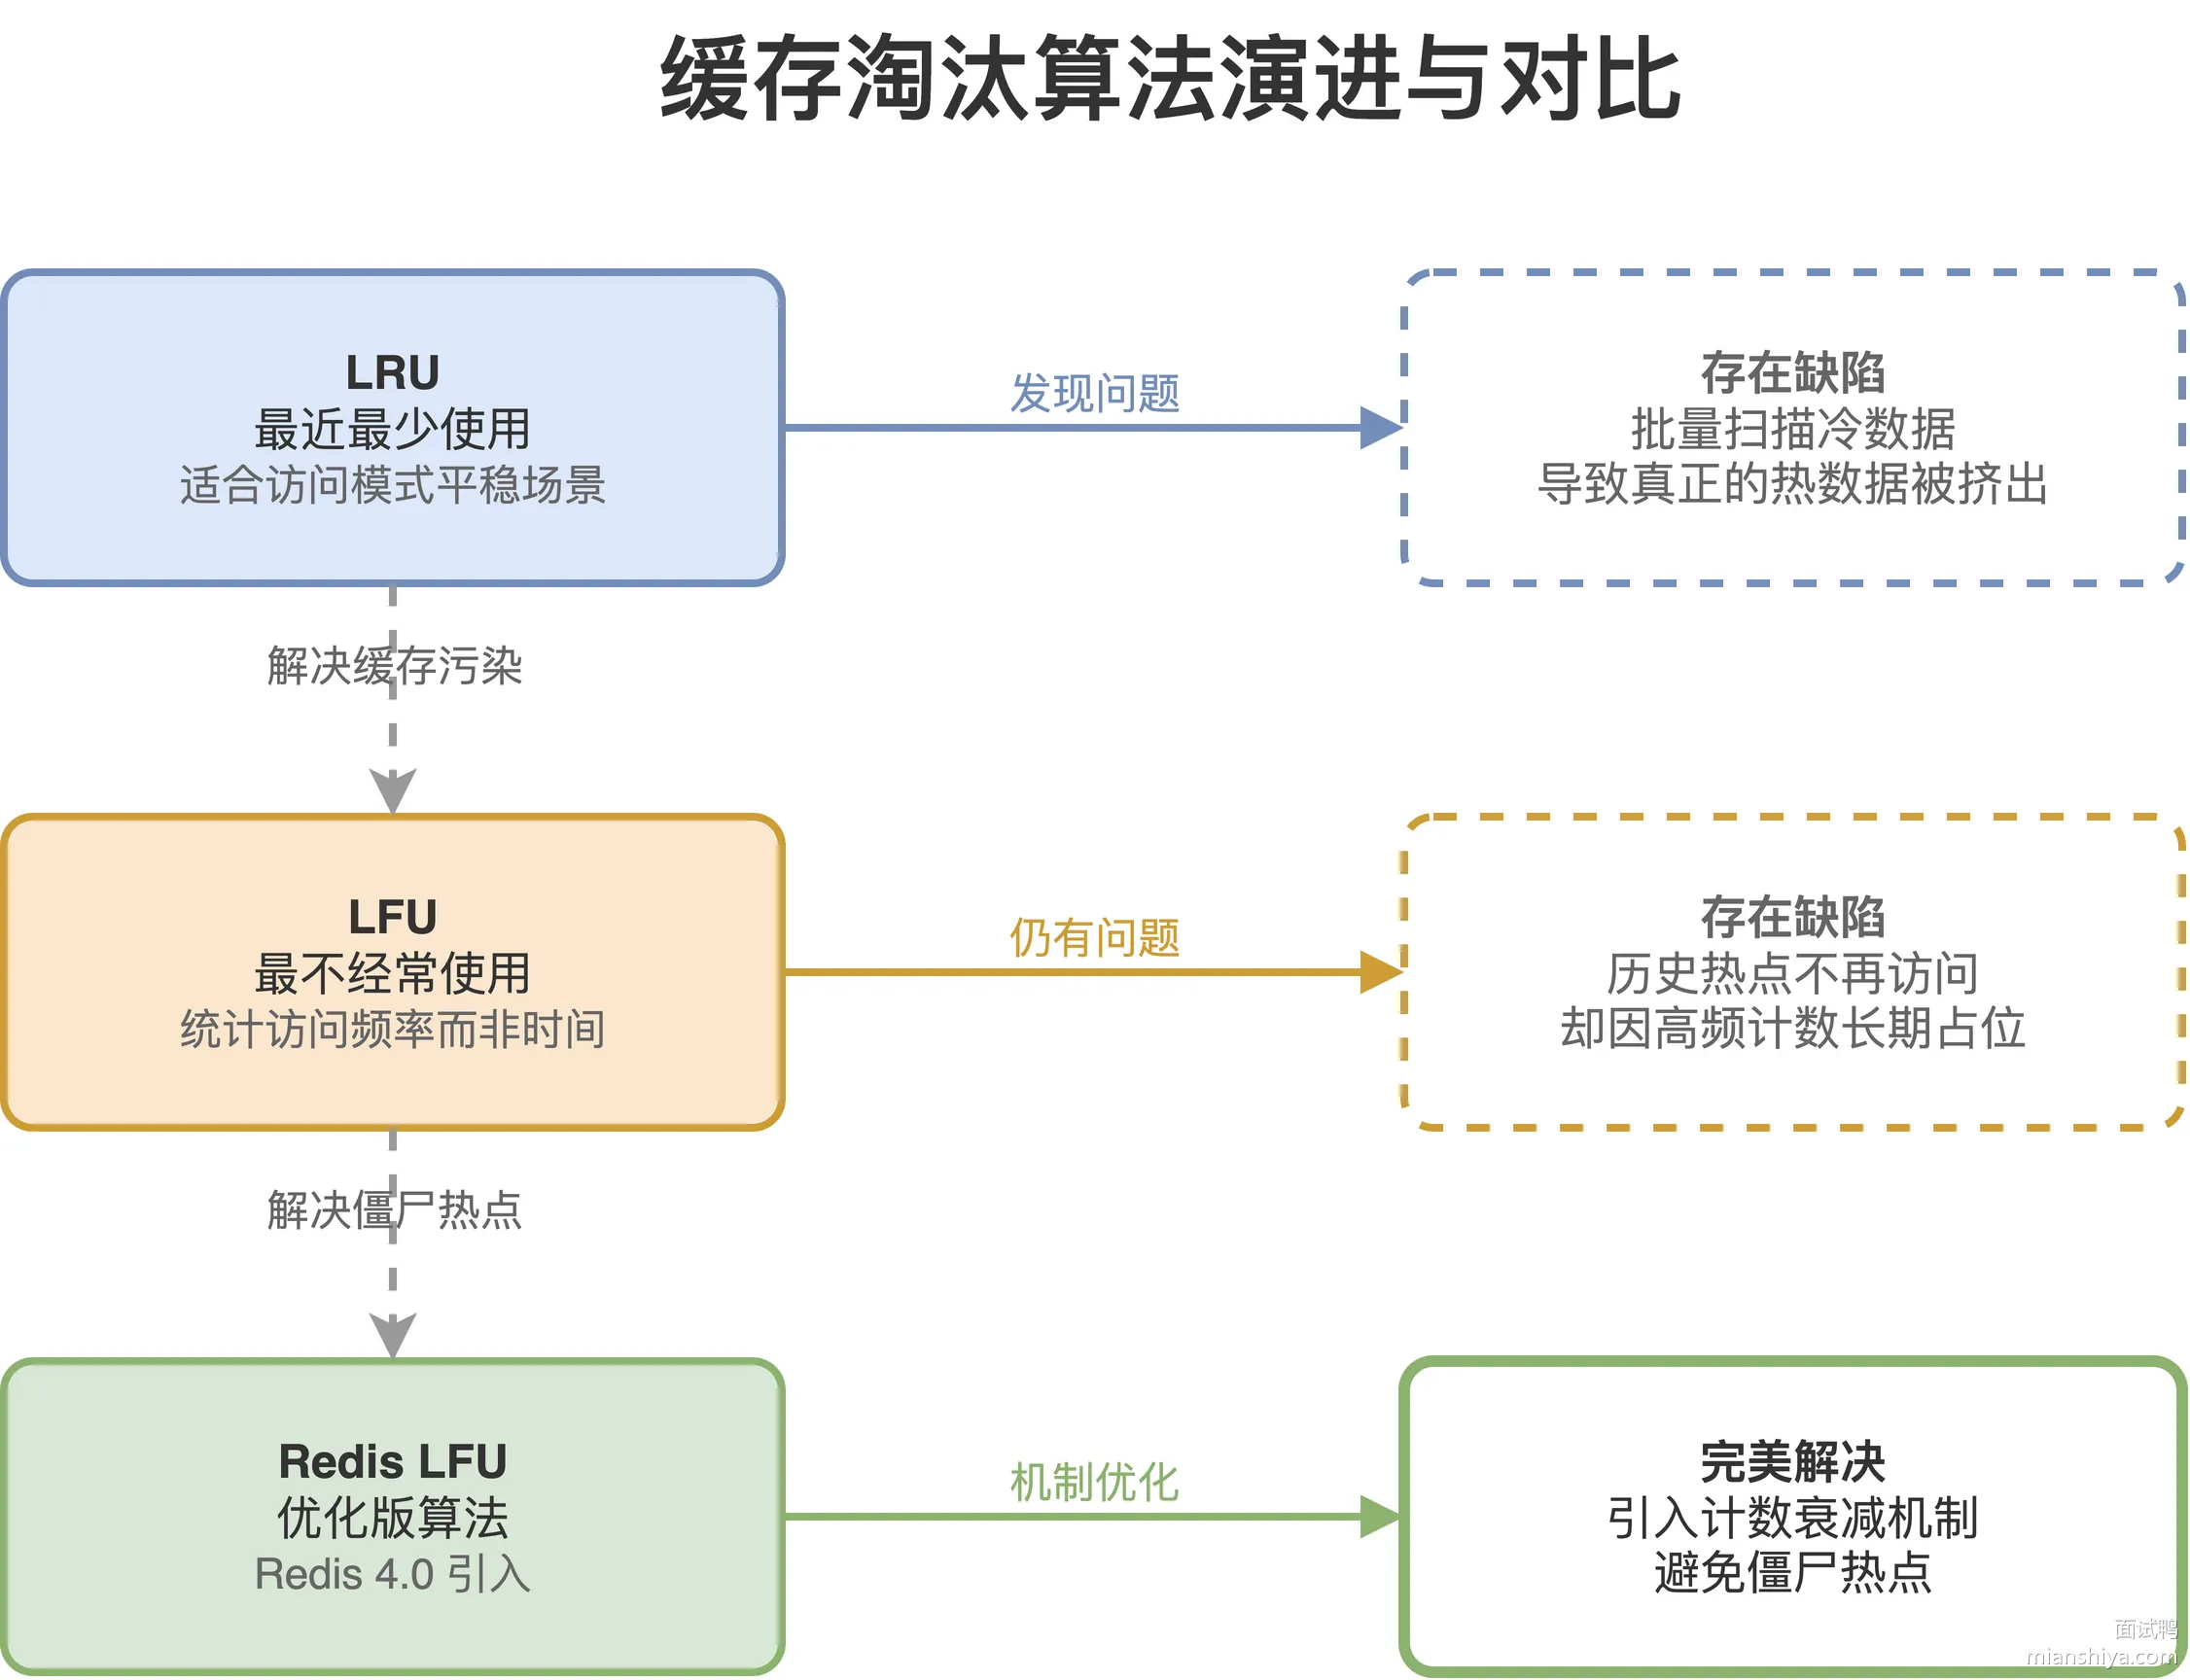
LRU 适合访问模式比较平稳的场景,比如普通的缓存服务。但 LRU 有个问题:如果某段时间有大量冷数据被批量扫描,会把真正的热数据挤出去。
LFU 就是为了解决这个问题,它统计访问频率而不是访问时间。但 LFU 也有坑:如果某个 key 历史上被访问很多次,但现在已经不热了,它还是会一直占着内存。Redis 4.0 引入的 LFU 算法做了优化,访问计数会随时间衰减,不会出现"僵尸热点"的情况。
12.2.2. 实际生产环境怎么选
1)大多数业务场景直接用 allkeys-lru 就行,简单粗暴又有效
2)如果业务有明确的热点数据,比如电商的爆款商品、社交平台的热门帖子,用 allkeys-lfu 更合适
3)如果 Redis 里存的数据分两类,一类是缓存数据设了过期时间,另一类是持久化数据没设过期时间,那就用 volatile-lru,这样只淘汰缓存数据,持久化数据不会被误删
4)noeviction 一般用在 Redis 当消息队列的场景,数据丢了可能造成业务异常,宁可写入失败也不能丢数据
12.2.3. 内存淘汰配置方式
两种方式设置淘汰策略:
1)改配置文件 redis.conf,重启生效,重启后不丢失:
maxmemory-policy allkeys-lru2)命令动态设置,立即生效,但重启就没了:
CONFIG SET maxmemory-policy allkeys-lru还有个参数 maxmemory-samples 也很重要,Redis 的 LRU/LFU 并不是精确算法,而是采样近似。默认采样 5 个 key,从中选一个淘汰。把这个值调大能提高淘汰精度,但会增加 CPU 开销。一般 5-10 就够用了。
12.2.4. 内存满了会发生什么
配置了 noeviction 策略时,内存满了 Redis 不会崩,已有数据照样能读能删,只是新数据写不进去。这时候执行 SET、LPUSH 这类写命令会返回 OOM 错误:
(error) OOM command not allowed when used memory > 'maxmemory'另外,64 位系统如果不设 maxmemory 或者设成 0,Redis 不限制内存使用,能用多少取决于物理内存。32 位系统最多用 3GB。
12.3. 常见问题
12.3.1. Redis 的 LRU 是精确的 LRU 算法吗?如果不是,为什么要这么设计?
不是精确 LRU,是近似 LRU。精确 LRU 需要维护一个全局的访问时间链表,每次访问都要更新链表,这个开销太大了。Redis 选择采样近似,每次淘汰时随机抽 5 个 key,从中挑最老的那个干掉。这样只需要在每个 key 上记一个最后访问时间戳,不用维护全局链表。根据 Redis 官方测试,采样 10 个 key 的近似 LRU 效果已经非常接近精确 LRU 了。
12.3.2. volatile 开头的策略和 allkeys 开头的策略有什么本质区别?
区别在于淘汰范围不同。volatile 系列只在设了过期时间的 key 里面选,allkeys 系列在所有 key 里面选。如果你的 Redis 里没有任何 key 设置了过期时间,用 volatile 系列策略等于没设,内存满了还是会报 OOM。所以生产环境如果用 volatile 策略,一定要确保业务上确实有大量 key 设置了过期时间。
12.3.3. LFU 算法里的访问频率是怎么统计的?会不会无限增长?
Redis 用一个 8 位的计数器记录访问频率,最大值就是 255。但这个计数器不是每次访问都加 1,而是用概率递增:计数值越大,递增概率越低。同时这个计数值会随时间衰减,衰减速度可以通过 lfu-decay-time 参数控制。这样既防止了计数无限增长,又避免了历史热点数据长期霸占内存的问题。
13. Redis 的 Lua 脚本功能是什么?如何使用?
13.1. 核心要点
Redis 允许用户在 Redis 服务器端执行自定义的 Lua 脚本,用来实现原子操作和复杂逻辑。
其核心点包括:
- 原子性:Lua 脚本的所有命令在执行过程中是原子的,避免了并发修改带来的问题。
- 减少网络往返次数:通过在服务器端执行脚本,减少了客户端和服务器之间的网络往返次数,提高了性能。
- 复杂操作:可以在 Lua 脚本中执行复杂的逻辑,比如批量更新、条件更新等,超过了单个 Redis 命令的能力。
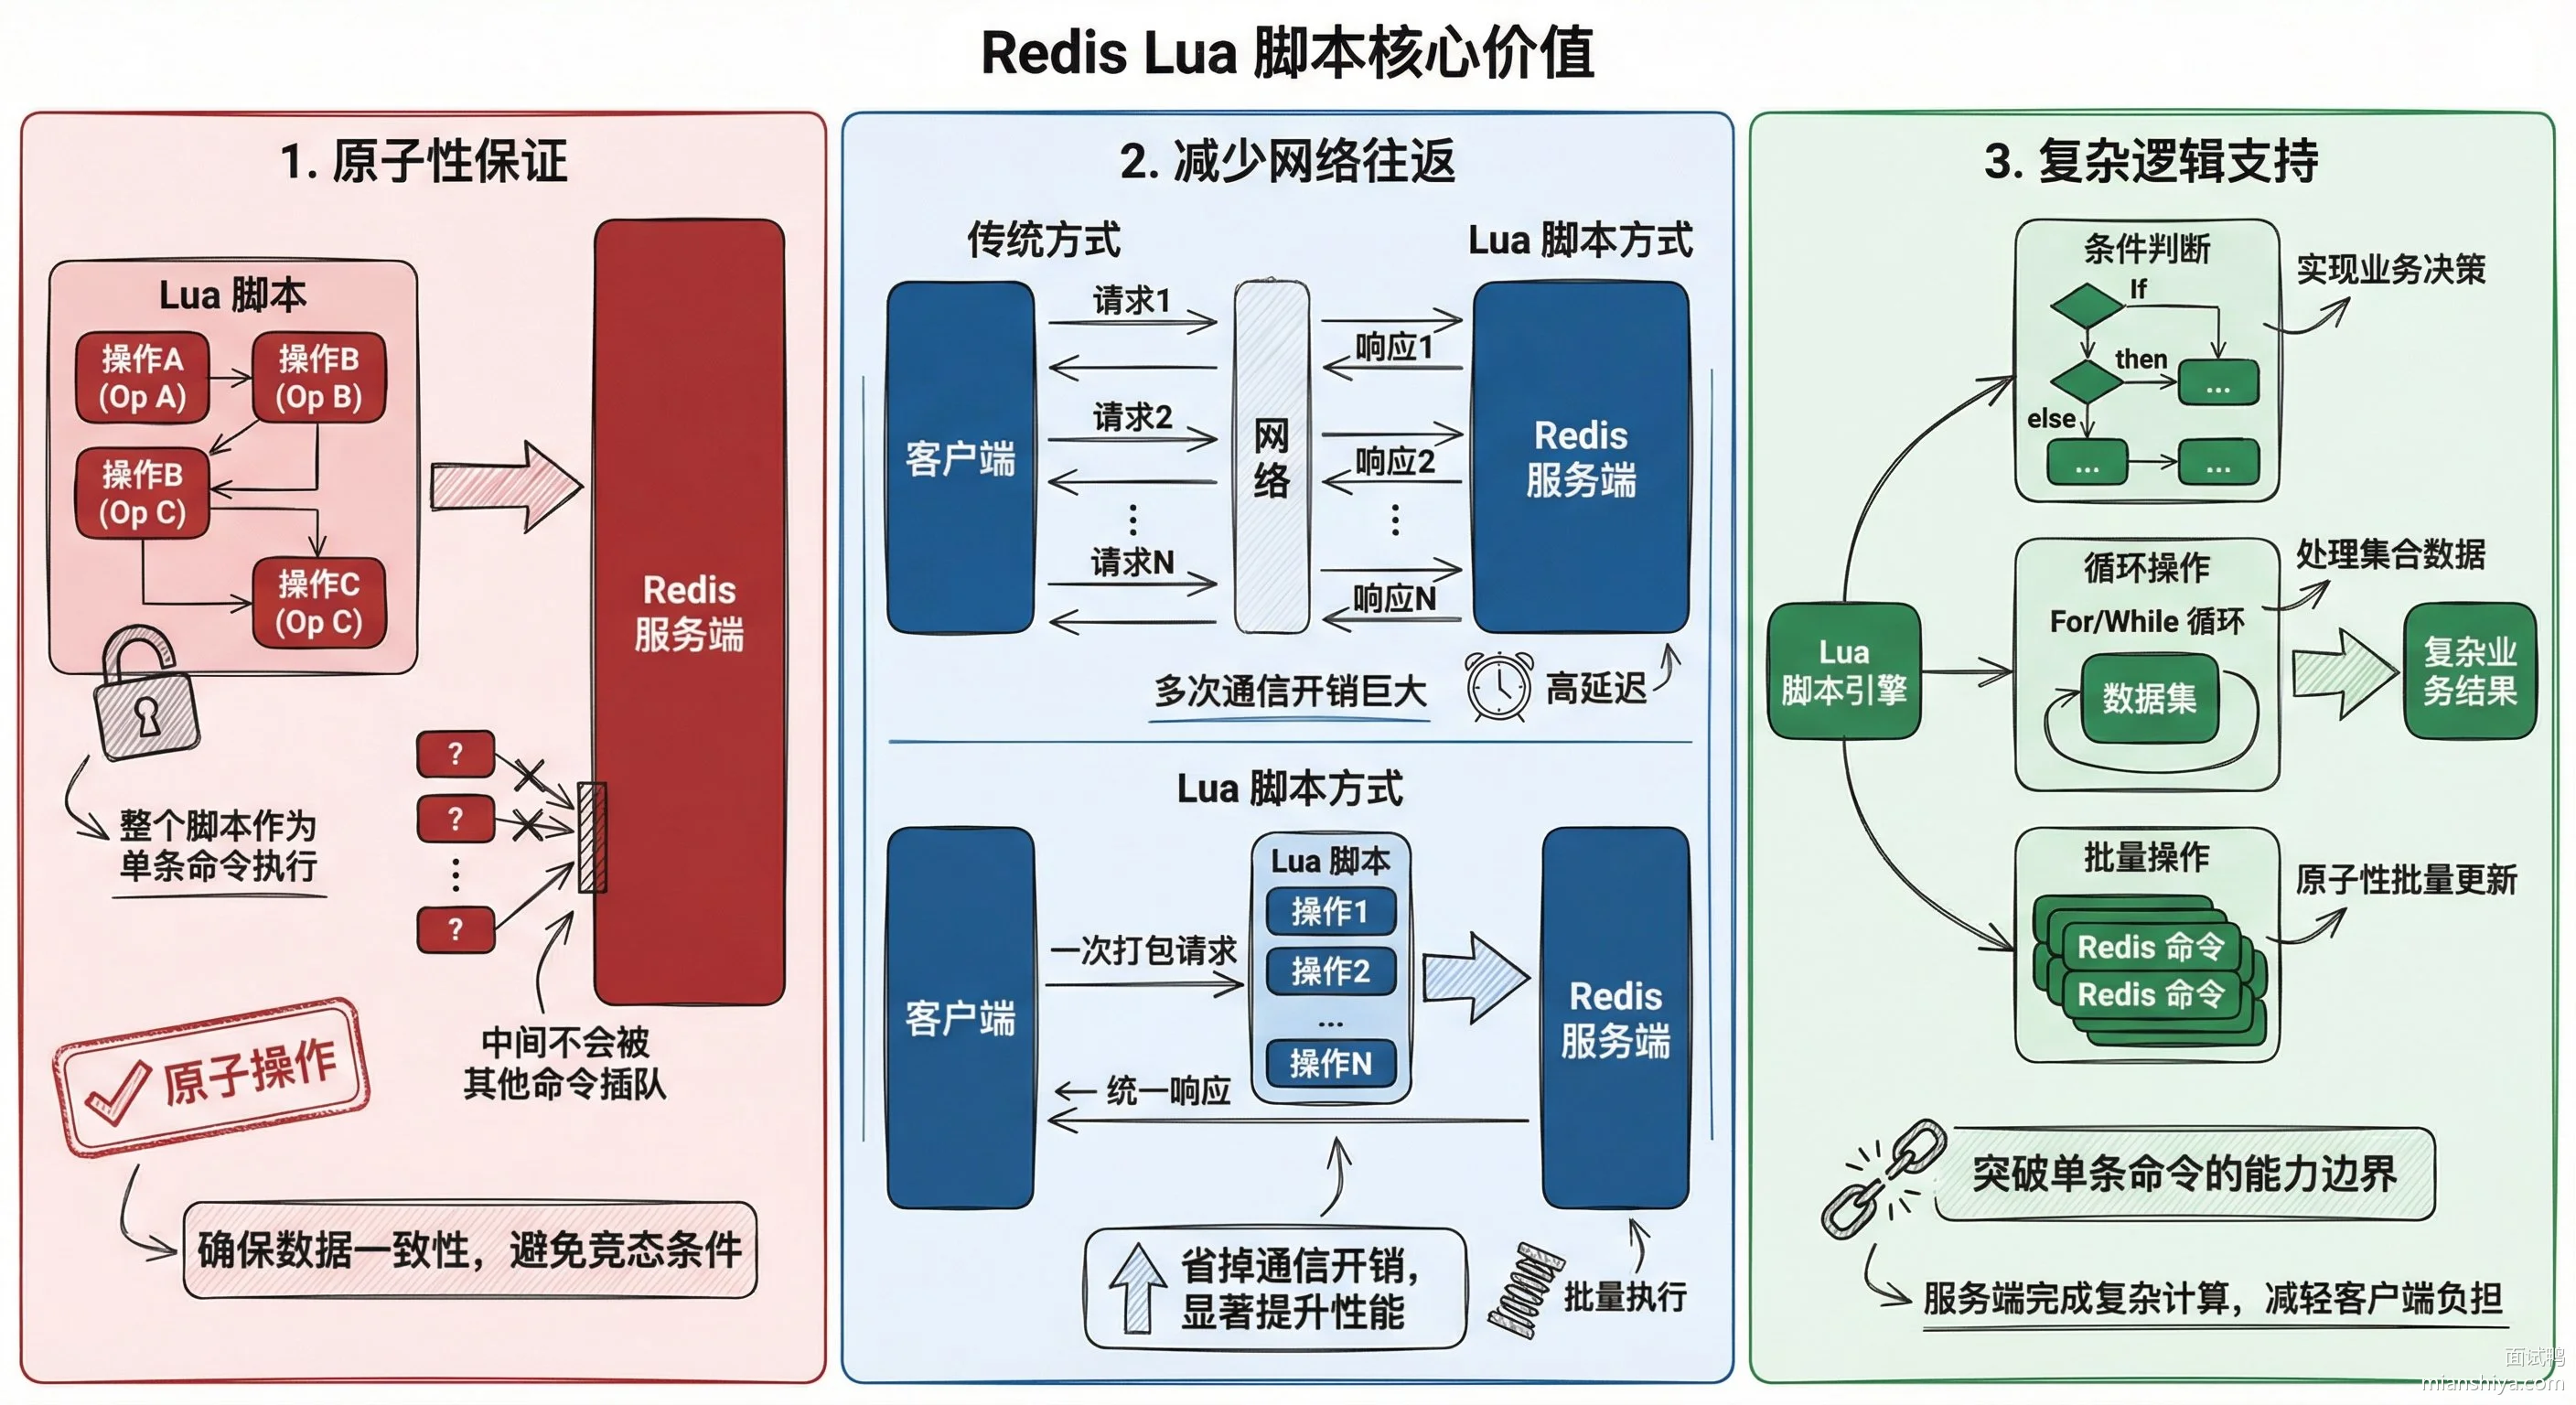
最典型的场景就是分布式锁。释放锁的时候需要先判断锁是不是自己的,是的话再删除。如果用两条命令分开执行,中间可能被别的请求插进来,导致误删别人的锁。用 Lua 脚本把判断和删除包在一起,就不会出这种问题。
基本用法是 EVAL 命令:
EVAL "local value = redis.call('GET', KEYS[1]) if not value then redis.call('SET', KEYS[1], ARGV[1]) end return value" 1 mykey "default_value"KEYS 是传入的键名数组,ARGV 是传入的参数数组,数字 1 表示有 1 个 key。
不过要注意:Lua 脚本本身不具备原子性,但 Redis 是单线程执行命令的,它把整个 Lua 脚本当成一个命令来跑,执行期间不处理任何其他请求,也就使得执行过程中不会被其他命令打断,看起来好像有了原子性。
13.2. 扩展知识
13.2.1. redis.call vs redis.pcall
脚本里调用 Redis 命令有两种方式:
- redis.call:命令执行失败直接抛错,整个脚本中断
- redis.pcall:命令执行失败返回错误信息,脚本继续往下跑
一般用 redis.call 就行,出错了早点暴露。用 redis.pcall 主要是想自己处理异常的场景。
13.2.2. 脚本预加载提升性能
每次 EVAL 都要把完整脚本发给 Redis,脚本长的话网络开销不小。可以用 SCRIPT LOAD 先把脚本缓存到 Redis:
SCRIPT LOAD "return redis.call('GET', KEYS[1])"返回一个 SHA1 哈希值,后面用 EVALSHA 加哈希值执行就行,省掉传输脚本内容的开销:
EVALSHA "sha1值" 1 mykey生产环境建议都用 EVALSHA,尤其是脚本会被频繁调用的场景。
13.2.3. 限流器实战示例
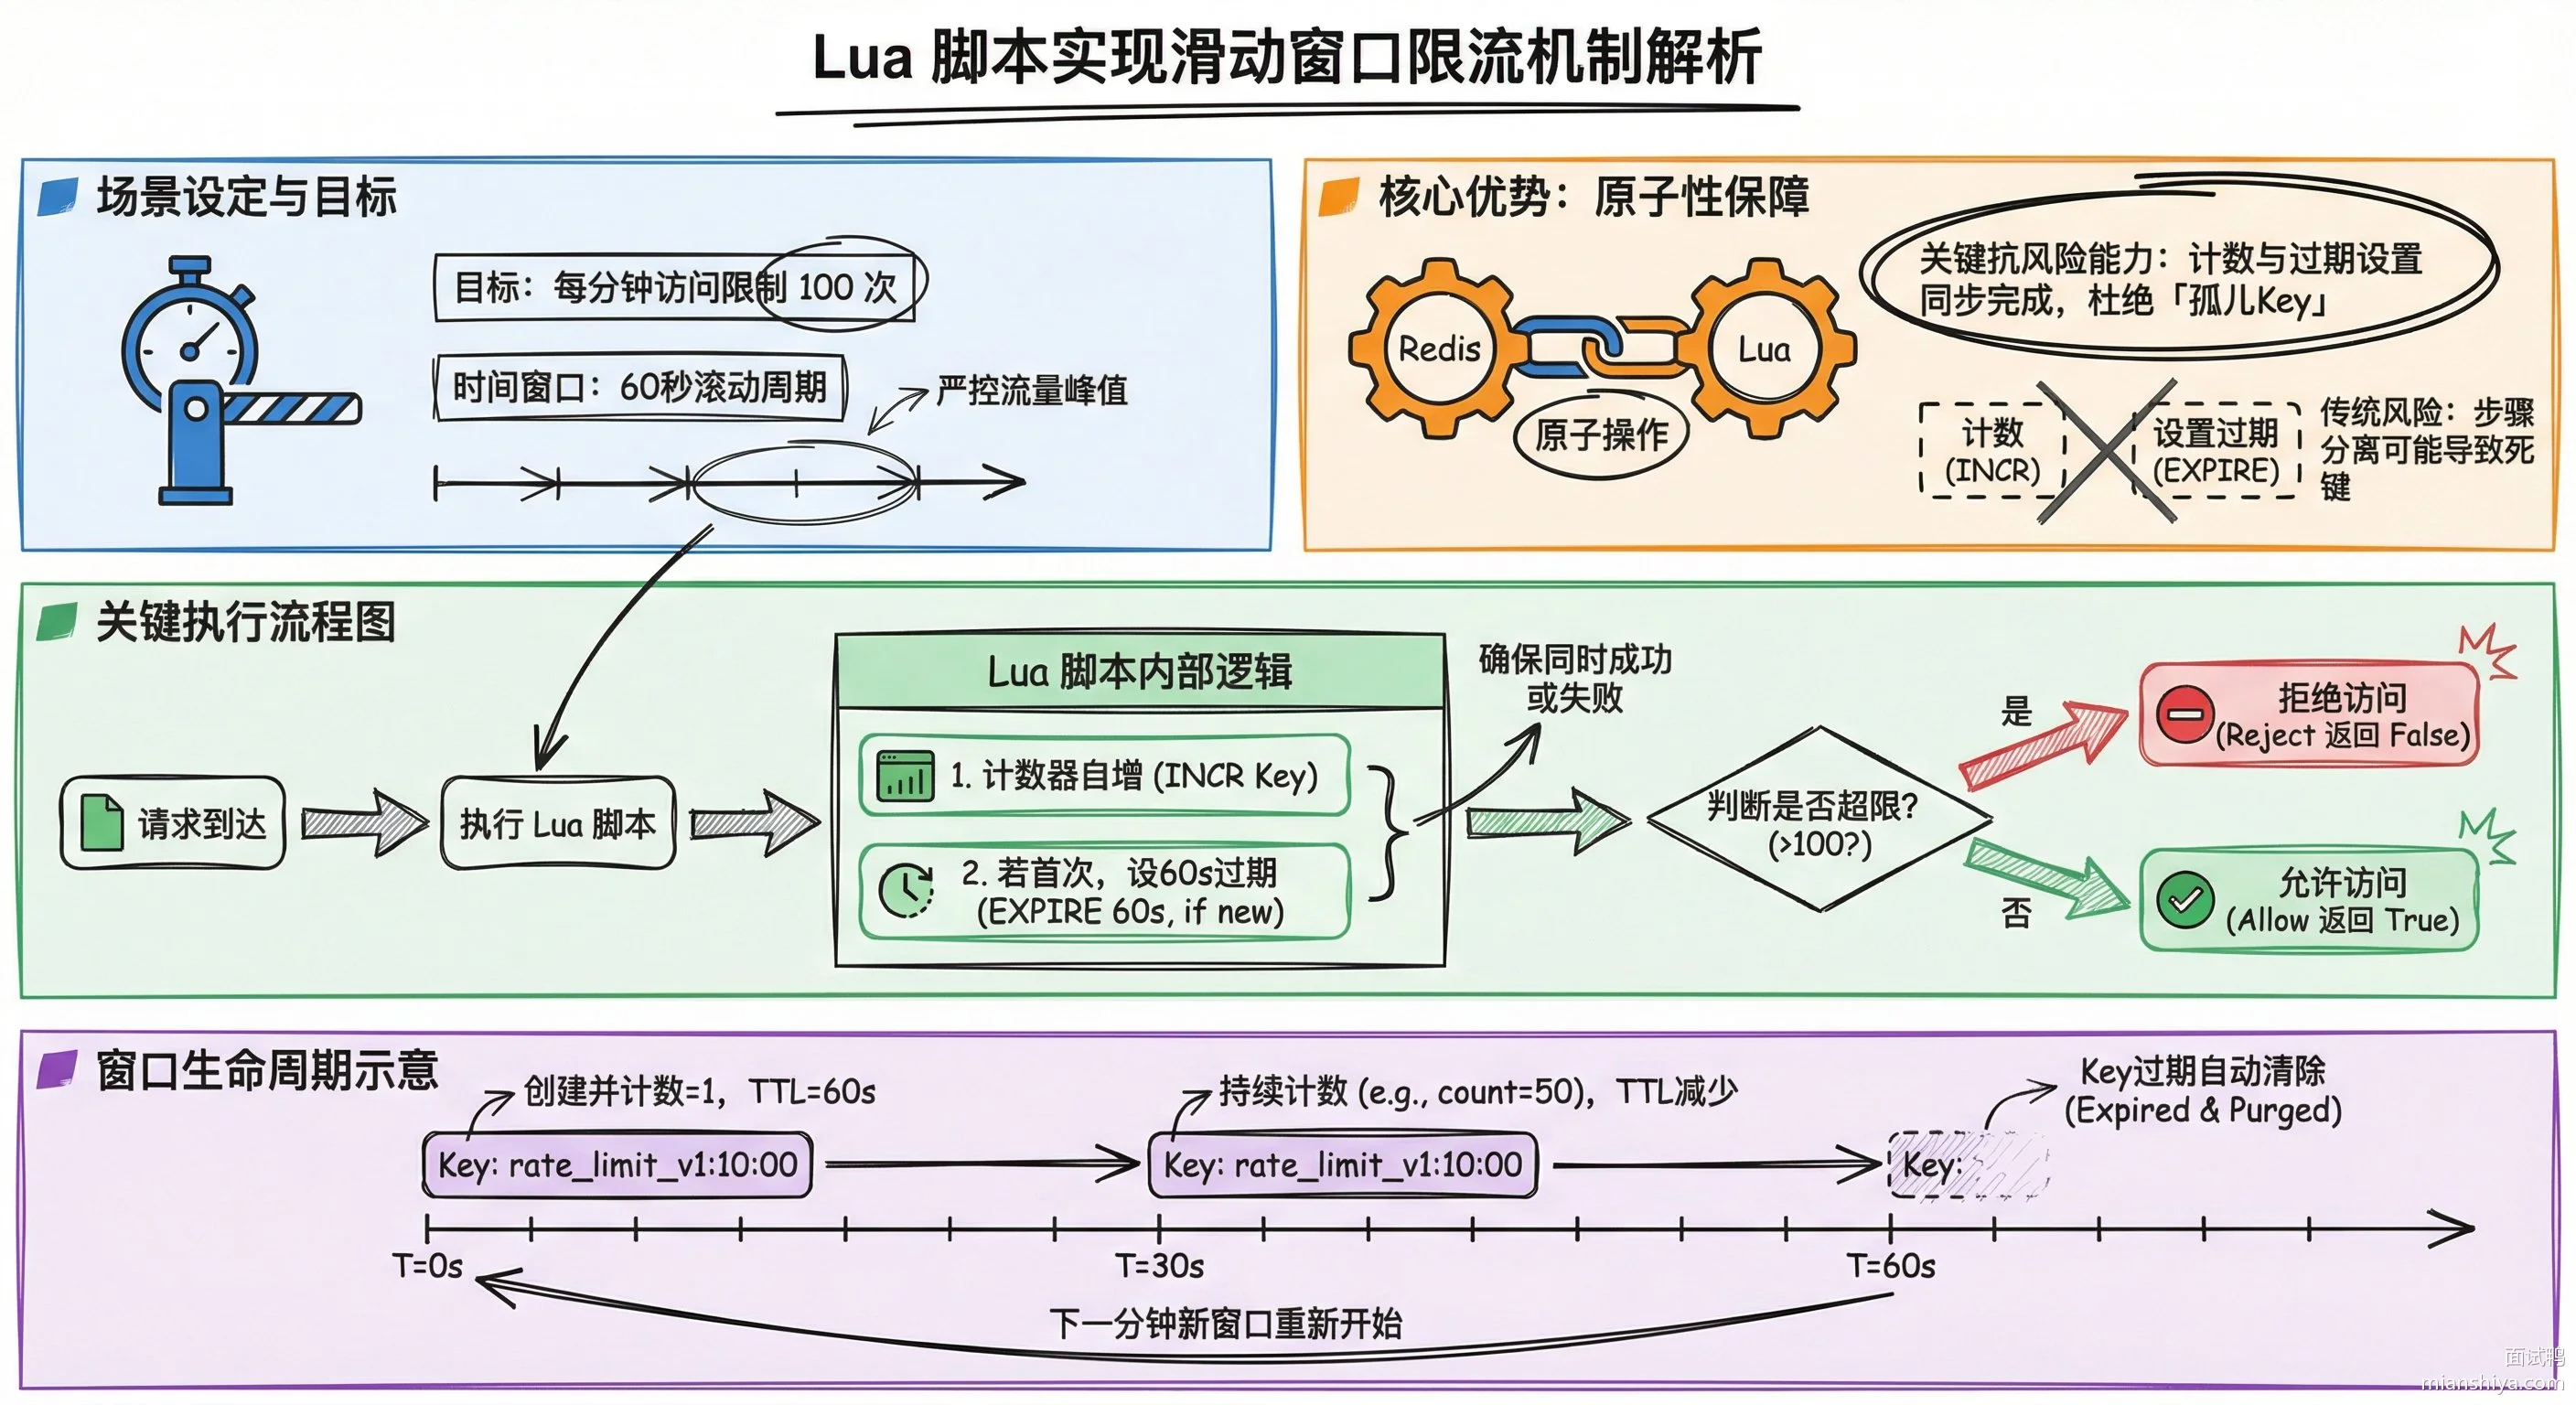
假设我们要实现一个简单的限流器,每分钟允许访问 100 次。
EVAL [[
  local key = KEYS[1]
  local limit = tonumber(ARGV[1])
  local current = redis.call('INCR', key)
  if current == 1 then
    redis.call('EXPIRE', key, 60)
  end
  return current <= limit
]] 1 rate_limit_key 100步骤:
- 直接 INCR 计数。
- 如果得到 current 值为 1,说明新周期开始,则设置过期时间。
- 判断 current 是否超过限制,返回布尔值表示是否允许访问。
13.2.4. 脚本执行失败不回滚
Lua 脚本的原子性有个坑:如果脚本执行到一半某条命令失败了,前面执行成功的命令不会回滚。
redis.call("SET", "my_key", "mianshiya")
redis.call("HSET", "my_hash", "field_mianshiya") -- 缺少值参数,会报错
执行这段脚本,my_key 会被成功设置,但 HSET 因为参数不对报错。my_key 不会回滚。
所以实际上 lua 脚本并不能完全保证原子性。
Redis 官方的态度是:这种错误属于开发者写出来的 bug,正常情况下不应该发生,属于开发者的人为因素,所以不提供回滚机制。想要真正的事务回滚能力,得用 Redis 7.0 引入的 Redis Functions 配合其他机制。
13.2.5. 脚本阻塞风险
Lua 脚本执行期间 Redis 不处理任何其他命令,脚本跑太久会把整个 Redis 卡住。
生产环境写 Lua 脚本要注意:
1)逻辑尽量简单,别在脚本里搞复杂的循环或者大量数据遍历
2)如果确实需要处理大量数据,考虑分批执行
3)可以通过 lua-time-limit 调整超时时间,但不建议调太大
13.2.6. 为什么选 Lua
Lua 是个轻量级脚本语言,C 语言写的,特点是小巧、快、容易嵌入。游戏开发里用得很多,比如魔兽世界、愤怒的小鸟的插件系统都是 Lua。Redis 选它主要看中两点:解释器只有几百 KB,不会让 Redis 变臃肿;执行速度快,不会拖累 Redis 的性能。
13.3. 常见问题
13.3.1. EVAL 和 EVALSHA 有什么区别?生产环境用哪个?
EVAL 每次都要把完整脚本内容传给 Redis,EVALSHA 只传脚本的 SHA1 哈希值。生产环境用 EVALSHA,先用 SCRIPT LOAD 把脚本缓存到 Redis 拿到哈希值,后面调用只传哈希值就行。脚本几十行的话,网络传输能省不少。但要注意 Redis 重启后脚本缓存会丢,代码里要处理 NOSCRIPT 错误,遇到了就重新 LOAD 一次。
13.3.2. Lua 脚本能保证原子性,那它和 Redis 事务有什么区别?
详细解答可以看:Redis 支持事务吗?如何实现?
Redis 事务用 MULTI/EXEC 包裹多个命令,但它只保证这批命令连续执行不被插队,不保证执行结果符合预期。比如 WATCH 的 key 被改了,事务直接不执行,但不会告诉你失败原因。Lua 脚本能在执行过程中拿到中间结果做判断,灵活度高很多。另外事务里的命令是排队执行的,Lua 脚本是在服务端一次性跑完,网络往返只有一次。
13.3.3. 分布式锁释放的时候为什么一定要用 Lua 脚本?
详细解答可以看:Redis 实现分布式锁时可能遇到的问题有哪些?
释放锁需要两步:先判断锁是不是自己的,是的话再删除。如果用两条命令分开执行,判断完到删除之间可能锁已经过期被别人抢走了,这时候删除就把别人的锁给删了。用 Lua 脚本把判断和删除包在一起,整个操作原子执行,就不会出现这种竞态条件。Redisson 的分布式锁底层就是这么实现的。
13.3.4. Lua 脚本执行超时会发生什么?
默认 5 秒超时,超时后 Redis 不会立刻杀掉脚本,而是开始接受客户端的 SCRIPT KILL 命令。如果脚本没有执行过写操作,SCRIPT KILL 能把它终止掉;如果已经执行过写操作,SCRIPT KILL 也搞不定,只能用 SHUTDOWN NOSAVE 强制关闭 Redis。所以写 Lua 脚本一定要控制好复杂度,别让它跑太久。
14. Redis 的 Pipeline 功能是什么?
14.1. 核心要点
Pipeline 让客户端把多条命令打包一次性发给 Redis,不用等每条命令的响应就能继续发下一条,最后再一起收结果。核心价值是减少网络往返次数,性能提升非常明显。
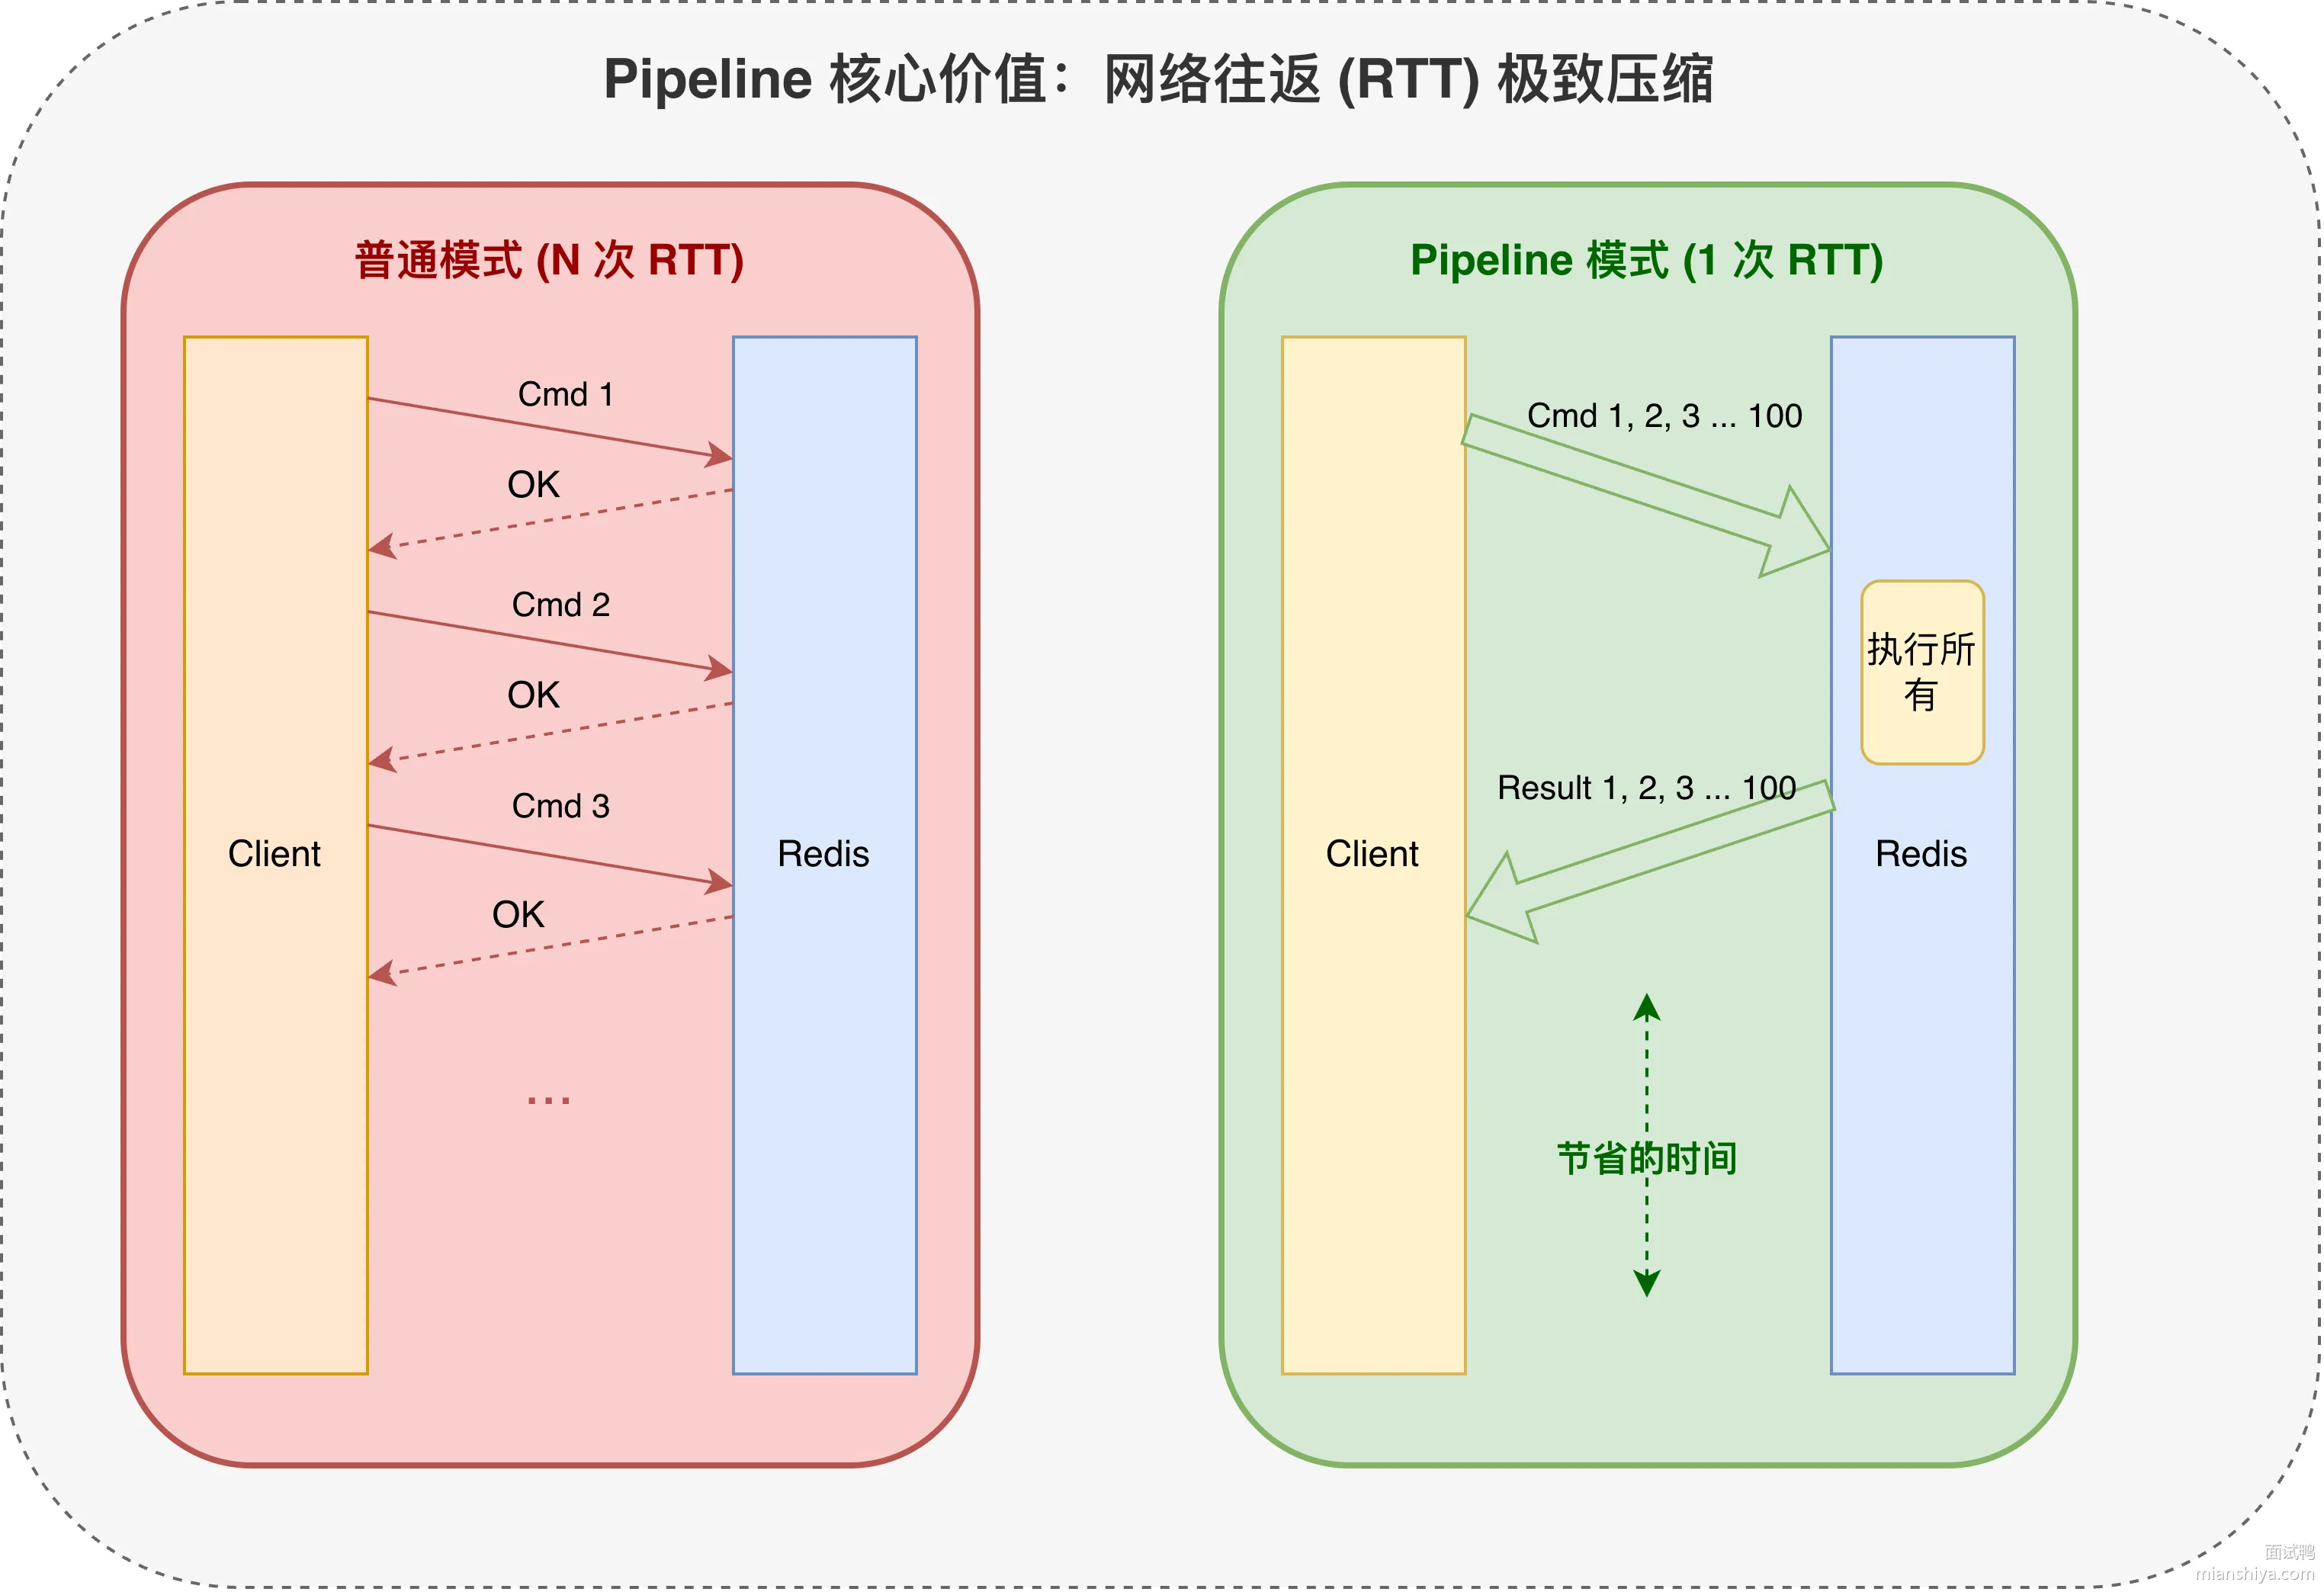
正常执行 100 条命令,客户端要和 Redis 来回通信 100 次。用 Pipeline 的话,100 条命令一次性发过去,Redis 按顺序执行完,结果一次性返回,网络往返只有 1 次。
假设网络延迟 1ms,100 条命令正常执行光网络等待就要 100ms,用 Pipeline 只要 1ms。命令越多、网络延迟越高,Pipeline 的收益越大。
Pipeline 的好处:
1)节省网络往返时间,RTT 从 N 次降到 1 次
2)减少系统调用的上下文切换开销,100 条命令只需要 1 次用户态到内核态的切换
14.2. 扩展知识
14.2.1. Pipeline vs 事务 vs Lua 脚本
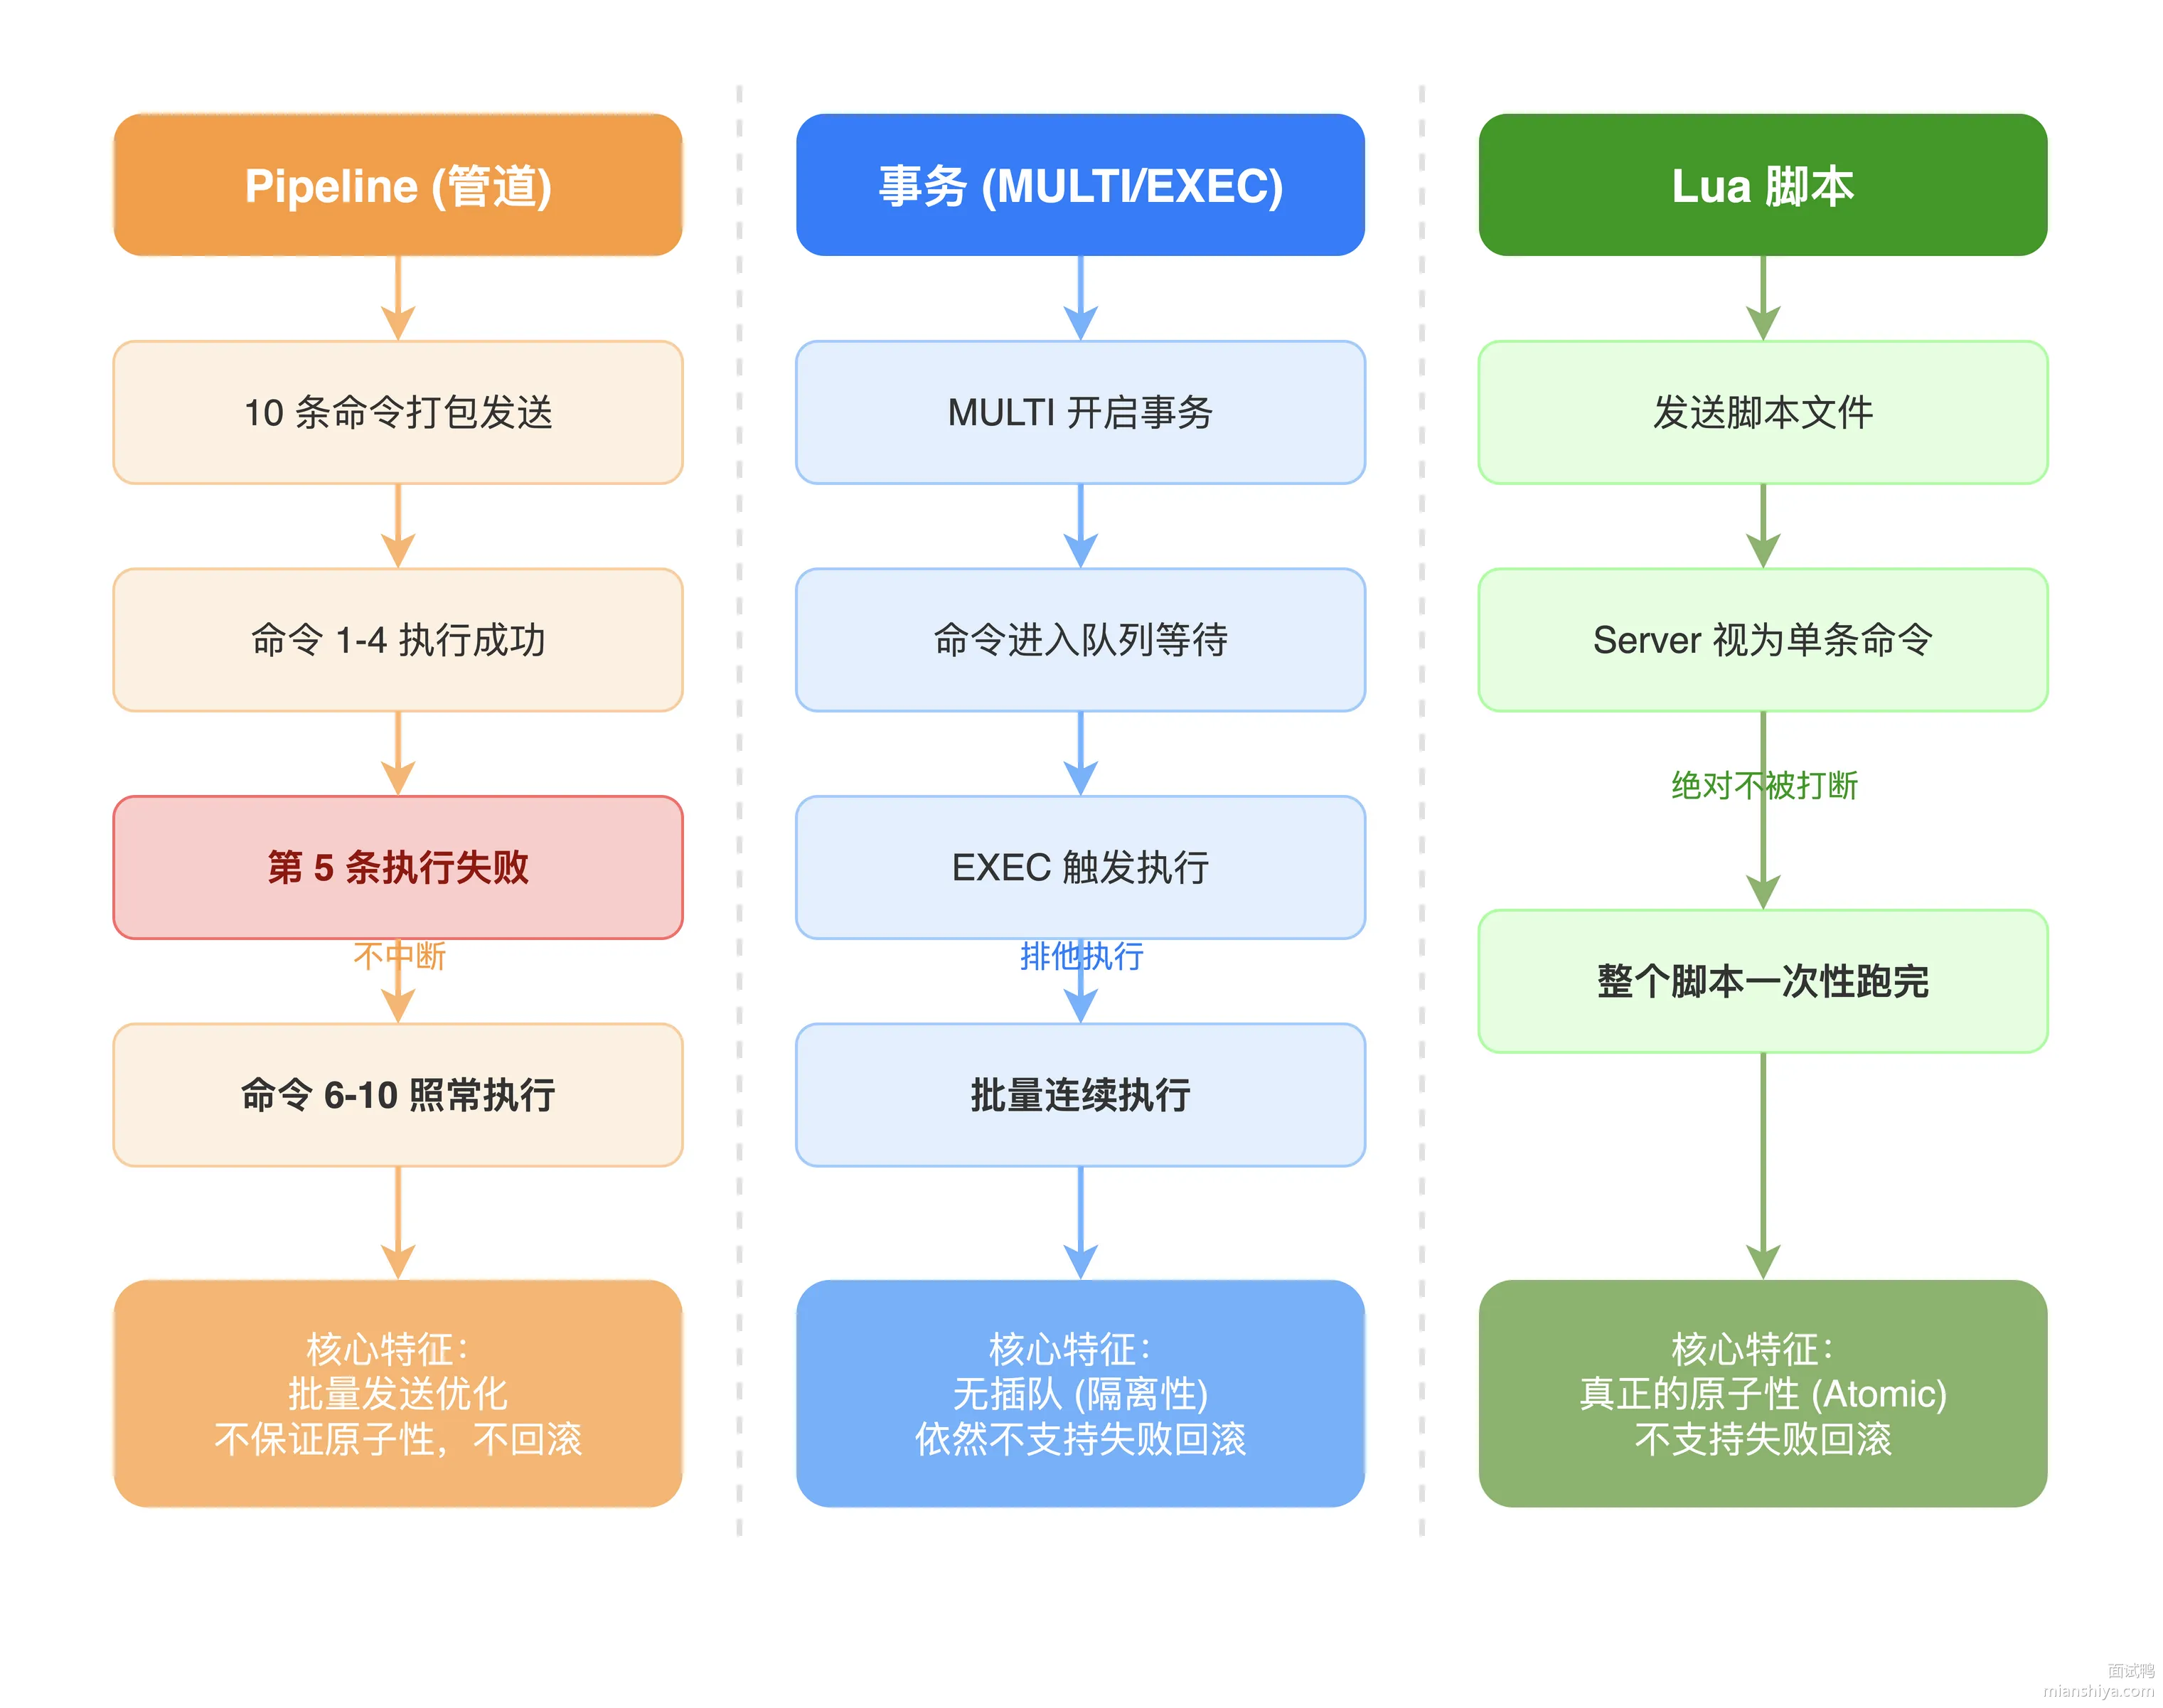
Pipeline 不保证原子性。10 条命令打包发过去,第 5 条执行失败了,前 4 条不会回滚,后 5 条照样执行。它只是个批量发送的优化手段,跟原子性没关系。
事务用 MULTI/EXEC 包裹命令,能保证这批命令连续执行不被其他客户端的命令插队,但也不支持回滚。
Lua 脚本是真正的原子执行,整个脚本作为一条命令跑,中间不会被打断。但 Lua 脚本也不支持失败回滚。
| 特性 | Pipeline | 事务 | Lua 脚本 |
|---|---|---|---|
| 原子性 | 不保证 | 命令连续执行,不被插队 | 整体原子执行 |
| 失败回滚 | 不支持 | 不支持 | 不支持 |
| 条件判断 | 不支持 | 不支持 | 支持 |
想要原子性用 Lua 脚本,只想提升批量操作性能用 Pipeline。
14.2.2. 使用限制
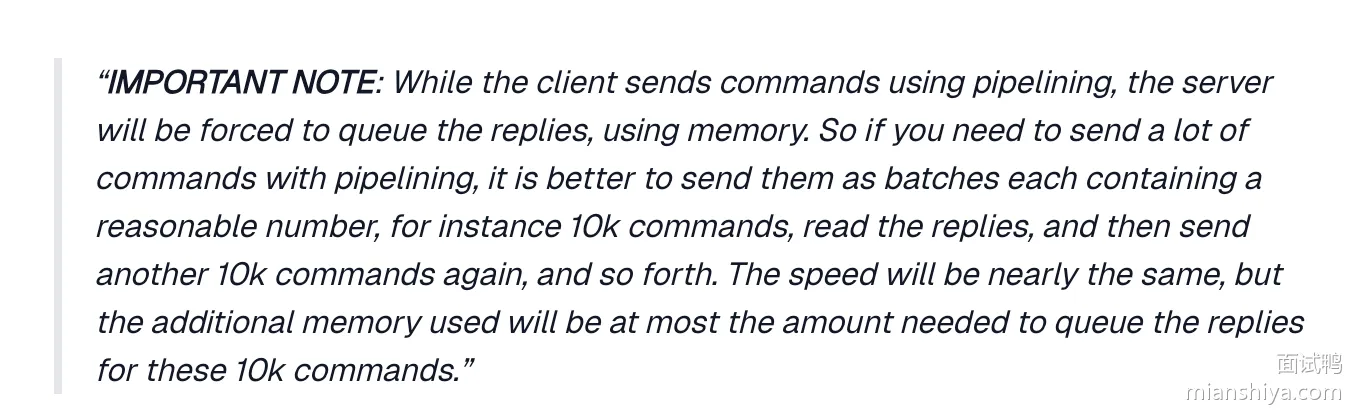
官方建议单次 Pipeline 最多打包 10000 条命令。命令太多会有两个问题:
1)客户端发完请求要等所有结果返回才能处理,命令太多等待时间太长
2)Redis 要把所有响应存在内存里,命令太多内存占用会飙升
实际生产中一般控制在 1000 条以内,够用了。
14.2.3. Java 代码示例
用 Jedis 实现 Pipeline:
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Pipeline;

public class RedisPipelineExample {
    public static void main(String[] args) {
        Jedis jedis = new Jedis("localhost", 6379);
        Pipeline pipeline = jedis.pipelined();

        // 批量写入 1000 个 key
        for (int i = 0; i < 1000; i++) {
            pipeline.set("key" + i, "value" + i);
        }

        // 执行并获取结果
        pipeline.sync();
        jedis.close();
    }
}
如果需要拿到每条命令的返回值,用 pipeline.syncAndReturnAll() 替代 sync()。
14.2.4. 性能对比
网上有实测数据,同样执行 1 万条命令:
1)不用 Pipeline:耗时约 1073 毫秒
2)用 Pipeline:耗时约 10 毫秒

性能提升 100 倍,主要省在网络往返上。Redis 本身执行命令很快,瓶颈往往在网络 IO。
14.2.5. 底层原理
正常情况下客户端发一条命令,Redis 收到后执行,结果通过 TCP 返回,客户端收到响应后才发下一条。每条命令都要经历一次完整的请求-响应周期。
Pipeline 打破了这个模式。客户端不等响应,连续把命令写到发送缓冲区,一股脑推给 Redis。Redis 那边按顺序执行,把结果存到响应缓冲区,最后一起返回。
从系统调用角度看,100 条命令正常执行要 100 次 write 和 100 次 read,用 Pipeline 可能就 1 次 write 和 1 次 read。用户态和内核态的切换次数大幅减少,这也是性能提升的重要原因。
14.2.6. 适用场景
1)批量数据导入:一次性写入几万条数据
2)批量查询:一次性查多个 key 的值
3)数据迁移:从一个 Redis 实例搬数据到另一个
4)统计任务:批量执行 INCR、HINCRBY 这类计数操作
不适合的场景:后面的命令依赖前面命令的结果,这种情况 Pipeline 搞不定,得用 Lua 脚本。
14.3. 常见问题
14.3.1. Pipeline 和 MGET、MSET 这类批量命令有什么区别?
MGET、MSET 是 Redis 原生的批量命令,只能操作同一种数据类型,比如 MGET 只能批量获取 String 类型的值。Pipeline 是通用的批量机制,可以把 SET、GET、LPUSH、HSET 各种命令混在一起打包发送。另外 MGET 操作的 key 必须在同一个 Redis 节点上,在 Redis Cluster 模式下可能跨 slot 报错;Pipeline 配合客户端的 smart client 可以自动按 slot 分组发送。
14.3.2. Redis Cluster 模式下 Pipeline 还能用吗?有什么限制?
能用但有限制。Cluster 模式下数据按 slot 分布在不同节点,Pipeline 打包的命令如果涉及多个 slot,客户端需要按 slot 分组,分别发送到对应节点。Jedis 的 JedisCluster 不直接支持 Pipeline,得用 JedisClusterPipeline 或者 Lettuce 这类支持 Cluster Pipeline 的客户端。另外如果命令涉及的 key 在不同节点,原子性就更没保障了。
14.3.3. Pipeline 会阻塞 Redis 吗?
不会比普通命令更阻塞。Pipeline 只是把命令打包发送,Redis 还是一条一条按顺序执行的。该执行多久还是多久,只是网络往返省了。但如果 Pipeline 里塞了特别多命令,Redis 执行完这批命令的时间会比较长,这段时间其他客户端的请求确实要排队等着。所以还是建议控制单次 Pipeline 的命令数量。
15. Redis 中的 Big Key 问题是什么?如何解决?
15.1. 核心要点
Redis 中的 "big Key" 是指一个内存空间占用比较大的键(Key),它的危害是:
- 内存分布不均。在集群模式下,不同 slot 分配到不同实例中,如果大 key 都映射到一个实例,则分布不均,查询效率也会受到影响。
- 由于 Redis 单线程执行命令,操作大 Key 时耗时较长,从而导致 Redis 出现其它命令阻塞的问题。
- 大 Key 对资源的占用巨大,在你进行网络 I/O 传输的时候,导致你获取过程中产生的网络流量较大,从而产生网络传输时间延长甚至网络传输发现阻塞的现象,例如一个 key 2MB,请求个 1000 次 2000 MB。
- 客户端超时。因为操作大 Key 时耗时较长,可能导致客户端等待超时。
解决 Big Key 问题可以从三个方向入手:
开发层面:把大对象拆成小对象,一个 Hash 100 万个 field 可以按 ID 取模拆成 100 个 Hash;对存储的数据做压缩,比如用 Snappy、LZ4 压一下再存进去;选合适的数据结构,有些用 String 存 JSON 的场景换成 Hash 能省不少内存。
业务层面:只存必要的数据,用户的详细地址、历史订单这些低频数据没必要全塞 Redis 里,用的时候再查数据库;从根源上避免大 Key 产生,比如评论列表只缓存前 100 条热门的。
架构层面:用 Redis Cluster 部署,把大 Key 拆分后散落到不同节点,响应速度能快一截。
15.2. 扩展知识
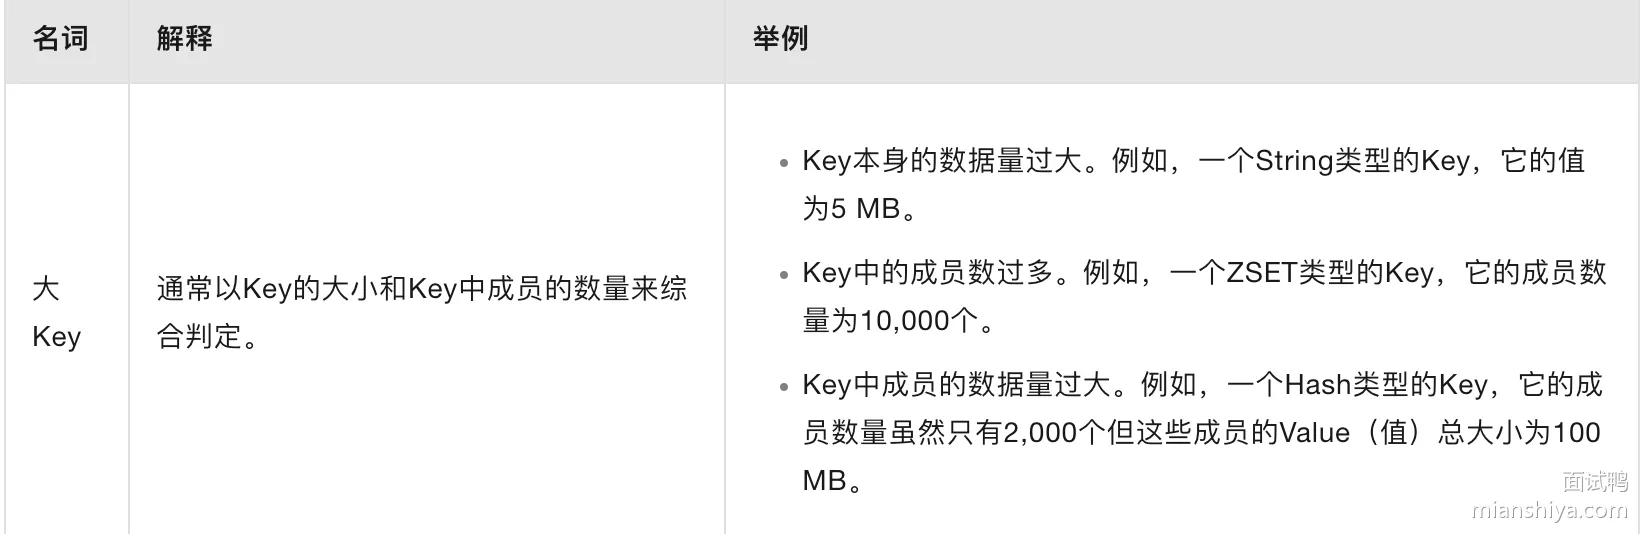
15.2.1. 怎样算 Big Key
没有绝对标准,主要看业务场景和实例配置。阿里云给的参考值是:
1)String 类型 value 超过 1MB 2)Hash、List、Set、ZSet 元素超过 5000 个
实际生产中我见过更严格的标准,String 超过 10KB 就算大 Key,因为高并发场景下这点数据量乘以 QPS 也够呛。
大 Key 可能长这样:
# 一个巨大的字符串
SET article:content:12345 "这里是一篇十几万字的文章内容..."

# 一个塞了几百万用户的集合
SADD hot_users user:1 user:2 user:3 ... user:5000000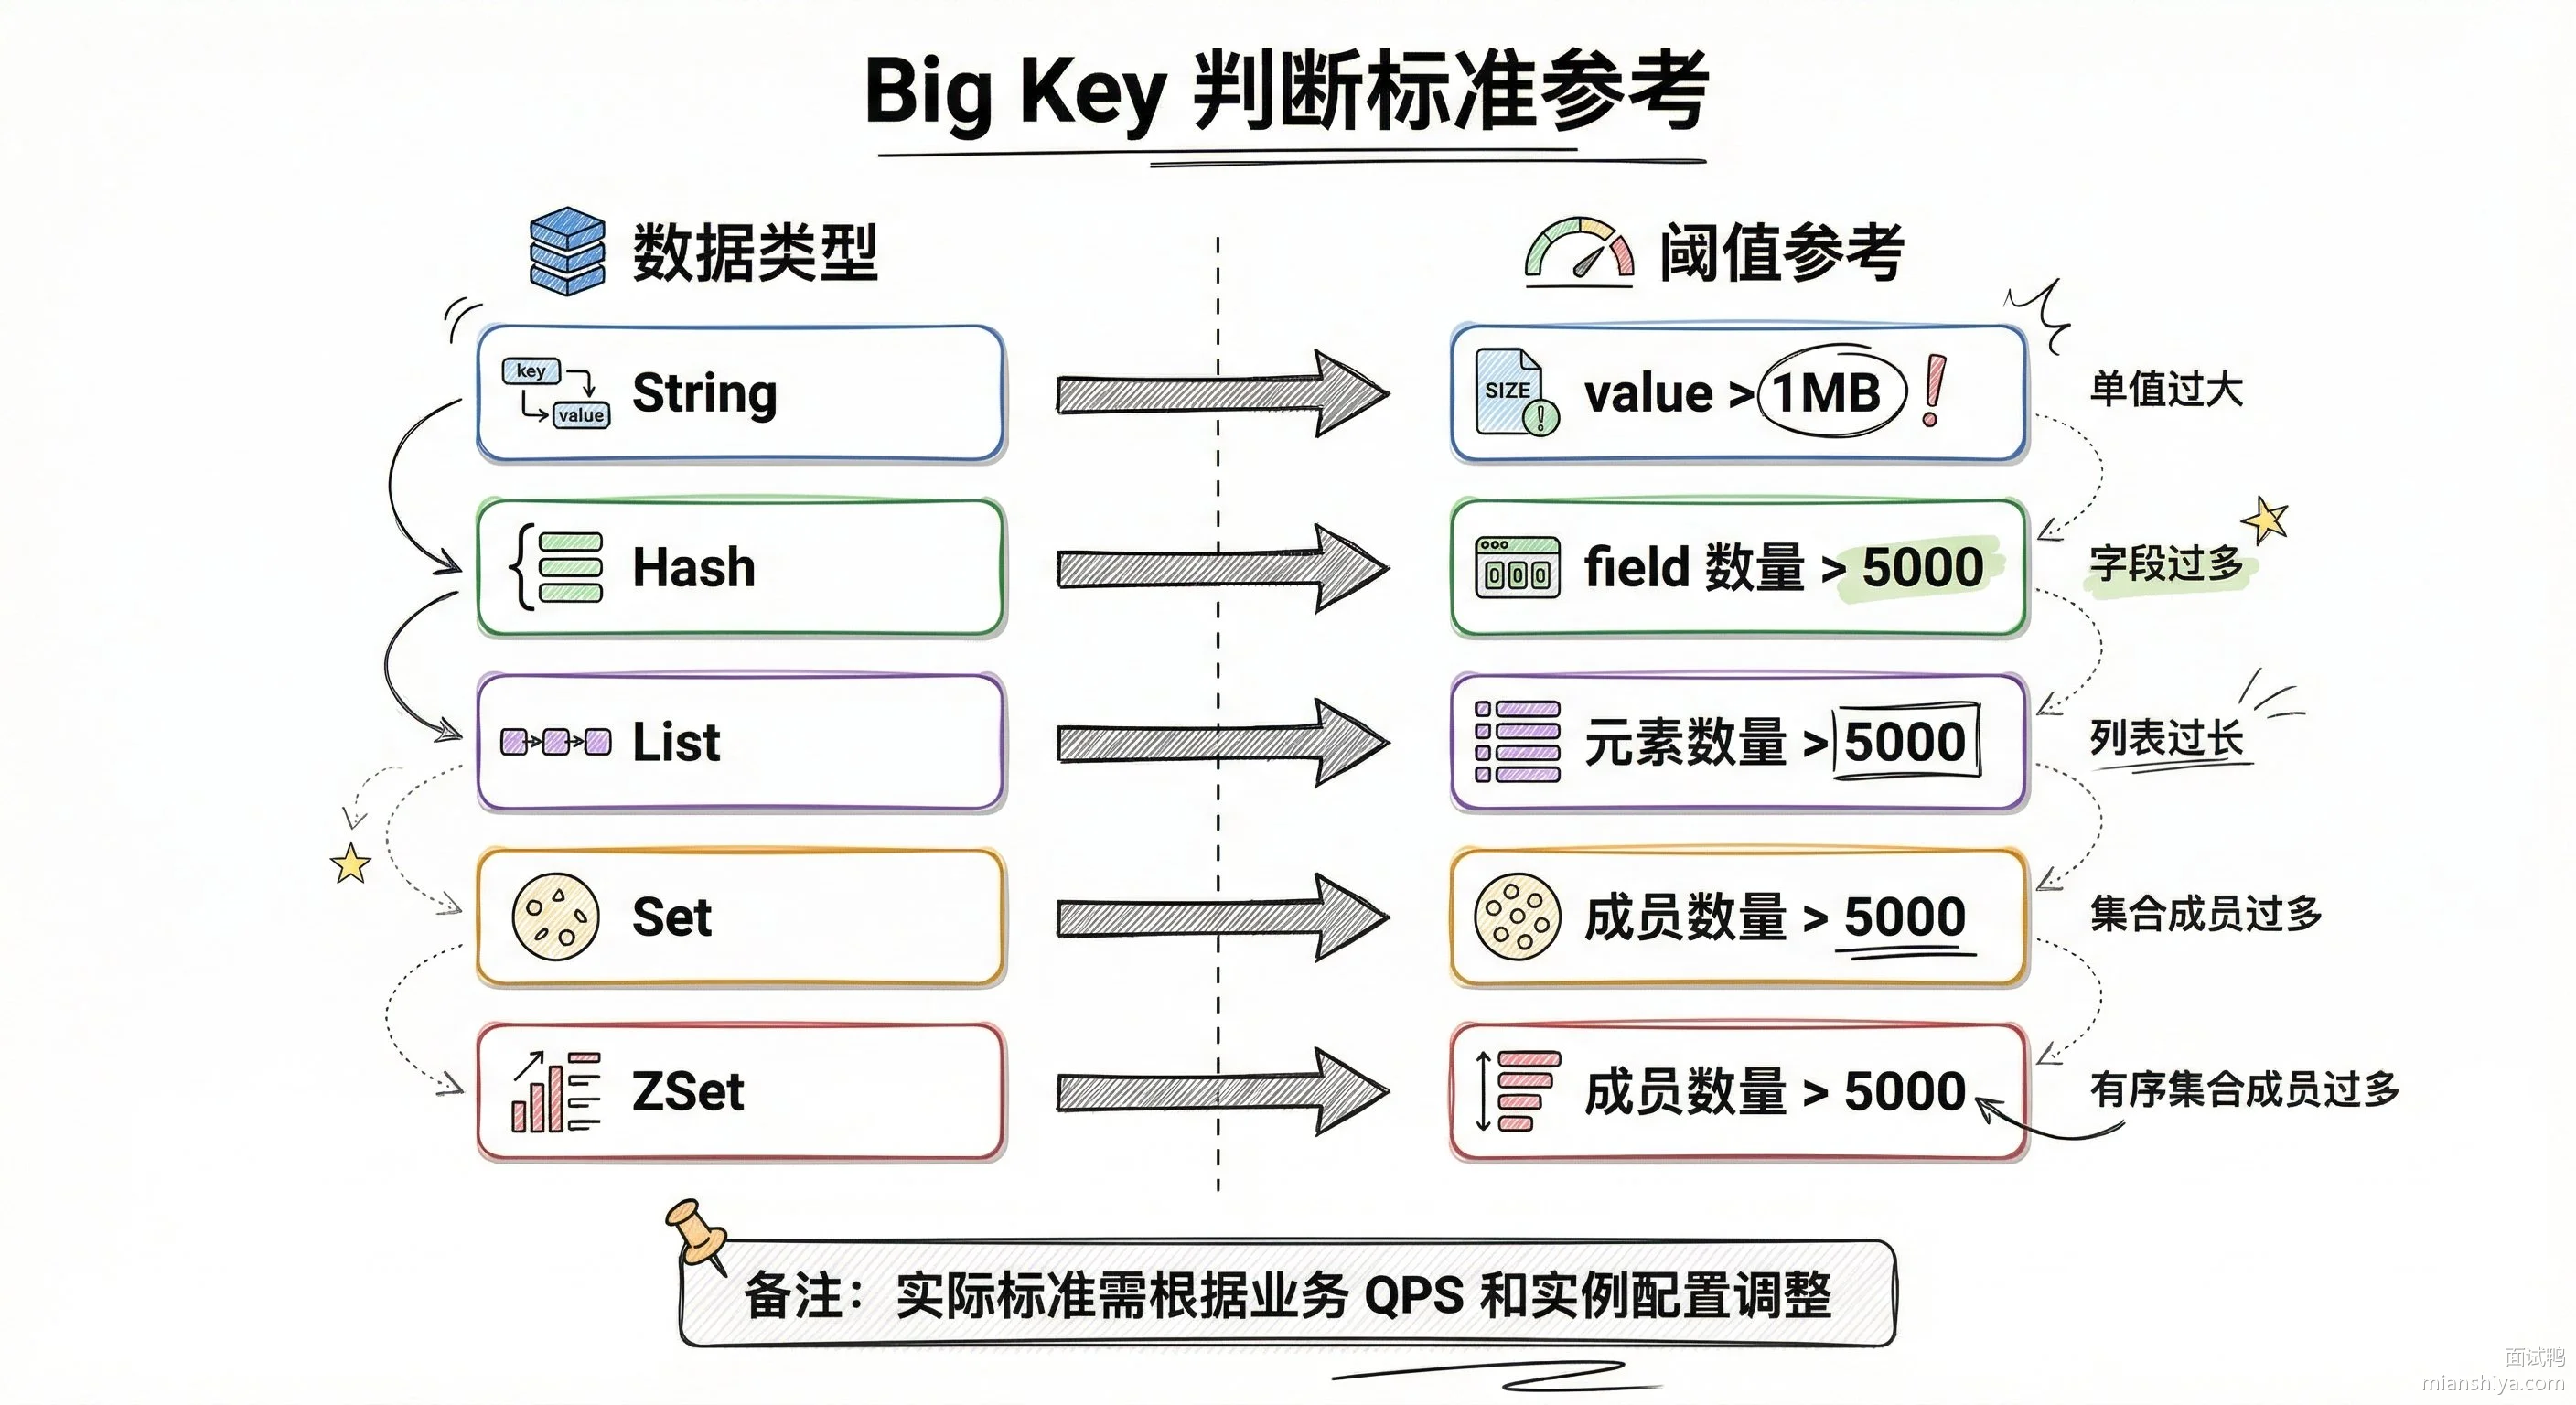
15.2.2. 如何发现 Big Key
redis-cli --bigkeys 是 Redis 自带的扫描命令,能找出每种数据类型中最大的 Key:
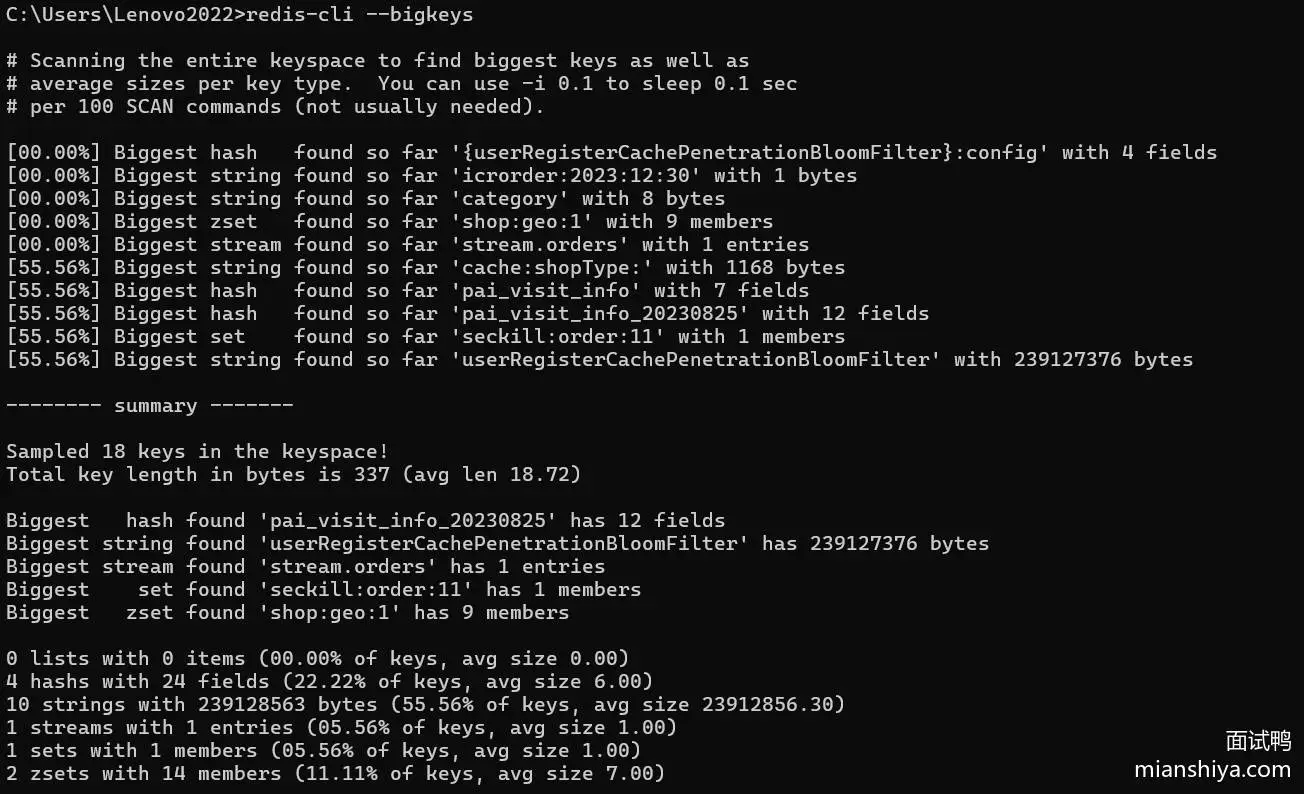
推荐用 -i 命令控制扫描的休息间隔,比如:
redis-cli --bigkeys -i 0.1-i 0.1 表示每扫描 100 个 key 休息 0.1 秒,避免对线上造成太大压力。这命令底层就是 SCAN + STRLEN/HLEN/SCARD 那一套,能看到每种类型的最大 Key 和统计信息。
不过要注意,元素多不等于占用内存多。一个 Hash 有 1 万个 field,但每个 value 只有 10 字节,加起来也就 100KB;另一个 Hash 只有 100 个 field,每个 value 1KB,那就是 100KB。所以还得结合 MEMORY USAGE key 命令看实际内存占用。
还可以用 RDB 分析工具离线分析,比如 redis-rdb-tools 能解析 RDB 文件生成 CSV 报告,把所有大 Key 都列出来,适合做全量排查。
15.2.3. 删除 Big Key 的正确姿势
直接 DEL 一个大 Key 是很危险的操作。删一个 100 万元素的 Hash,Redis 要一个个释放内存,可能阻塞好几秒,线上服务直接就挂了。
Redis 4.0 之后推荐用 UNLINK 命令,它只在主线程里把 Key 从键空间摘掉,实际的内存释放交给后台线程异步处理,主线程几乎不阻塞。
如果是 4.0 之前的版本,只能分批删:Hash 用 HSCAN + HDEL,Set 用 SSCAN + SREM,List 用 LTRIM,每次删几百个元素,分多次删完。
15.3. 常见问题
15.3.1. 线上怎么监控 Big Key?总不能天天手动跑 bigkeys 命令吧?
可以在 Redis Proxy 层埋点,记录每个命令的响应大小,超过阈值就告警。也可以定时任务用 SCAN 扫描采样,配合 MEMORY USAGE 算内存占用,异常的 Key 直接推消息到钉钉或飞书。阿里云、腾讯云的托管 Redis 都自带 Big Key 分析功能,能看到 Top N 的大 Key 列表。
15.3.2. Big Key 导致主从同步延迟怎么处理?
主库写入大 Key 的时候,写命令会完整传给从库回放,从库单线程处理这个大 Key 的写入也会阻塞,延迟就上来了。根本解决方案还是拆 Key,把大对象拆成小对象。临时方案可以把从库的 slave-output-buffer-limit 调大一点,避免因为缓冲区溢出导致全量同步。
15.3.3. 删大 Key 的时候用 UNLINK,那如果这个 Key 还在被读怎么办?
UNLINK 执行后,Key 立刻就从键空间消失了,后续的读请求会返回 nil。已经在处理中的读操作不受影响,因为它们持有的是 Key 对象的引用。内存释放是异步的,但对客户端来说就是"删完了"。
16. 如何解决 Redis 中的热点 key 问题?
16.1. 核心要点
热点 Key 就是被高频访问的 Key,比如微博热搜、秒杀商品详情这种,一秒钟几十万请求全砸到同一个 Key 上。Redis 是单线程处理命令的,热点 Key 会把单个节点的 CPU 吃满,其他请求只能干等着,集群模式下还会导致流量严重倾斜。
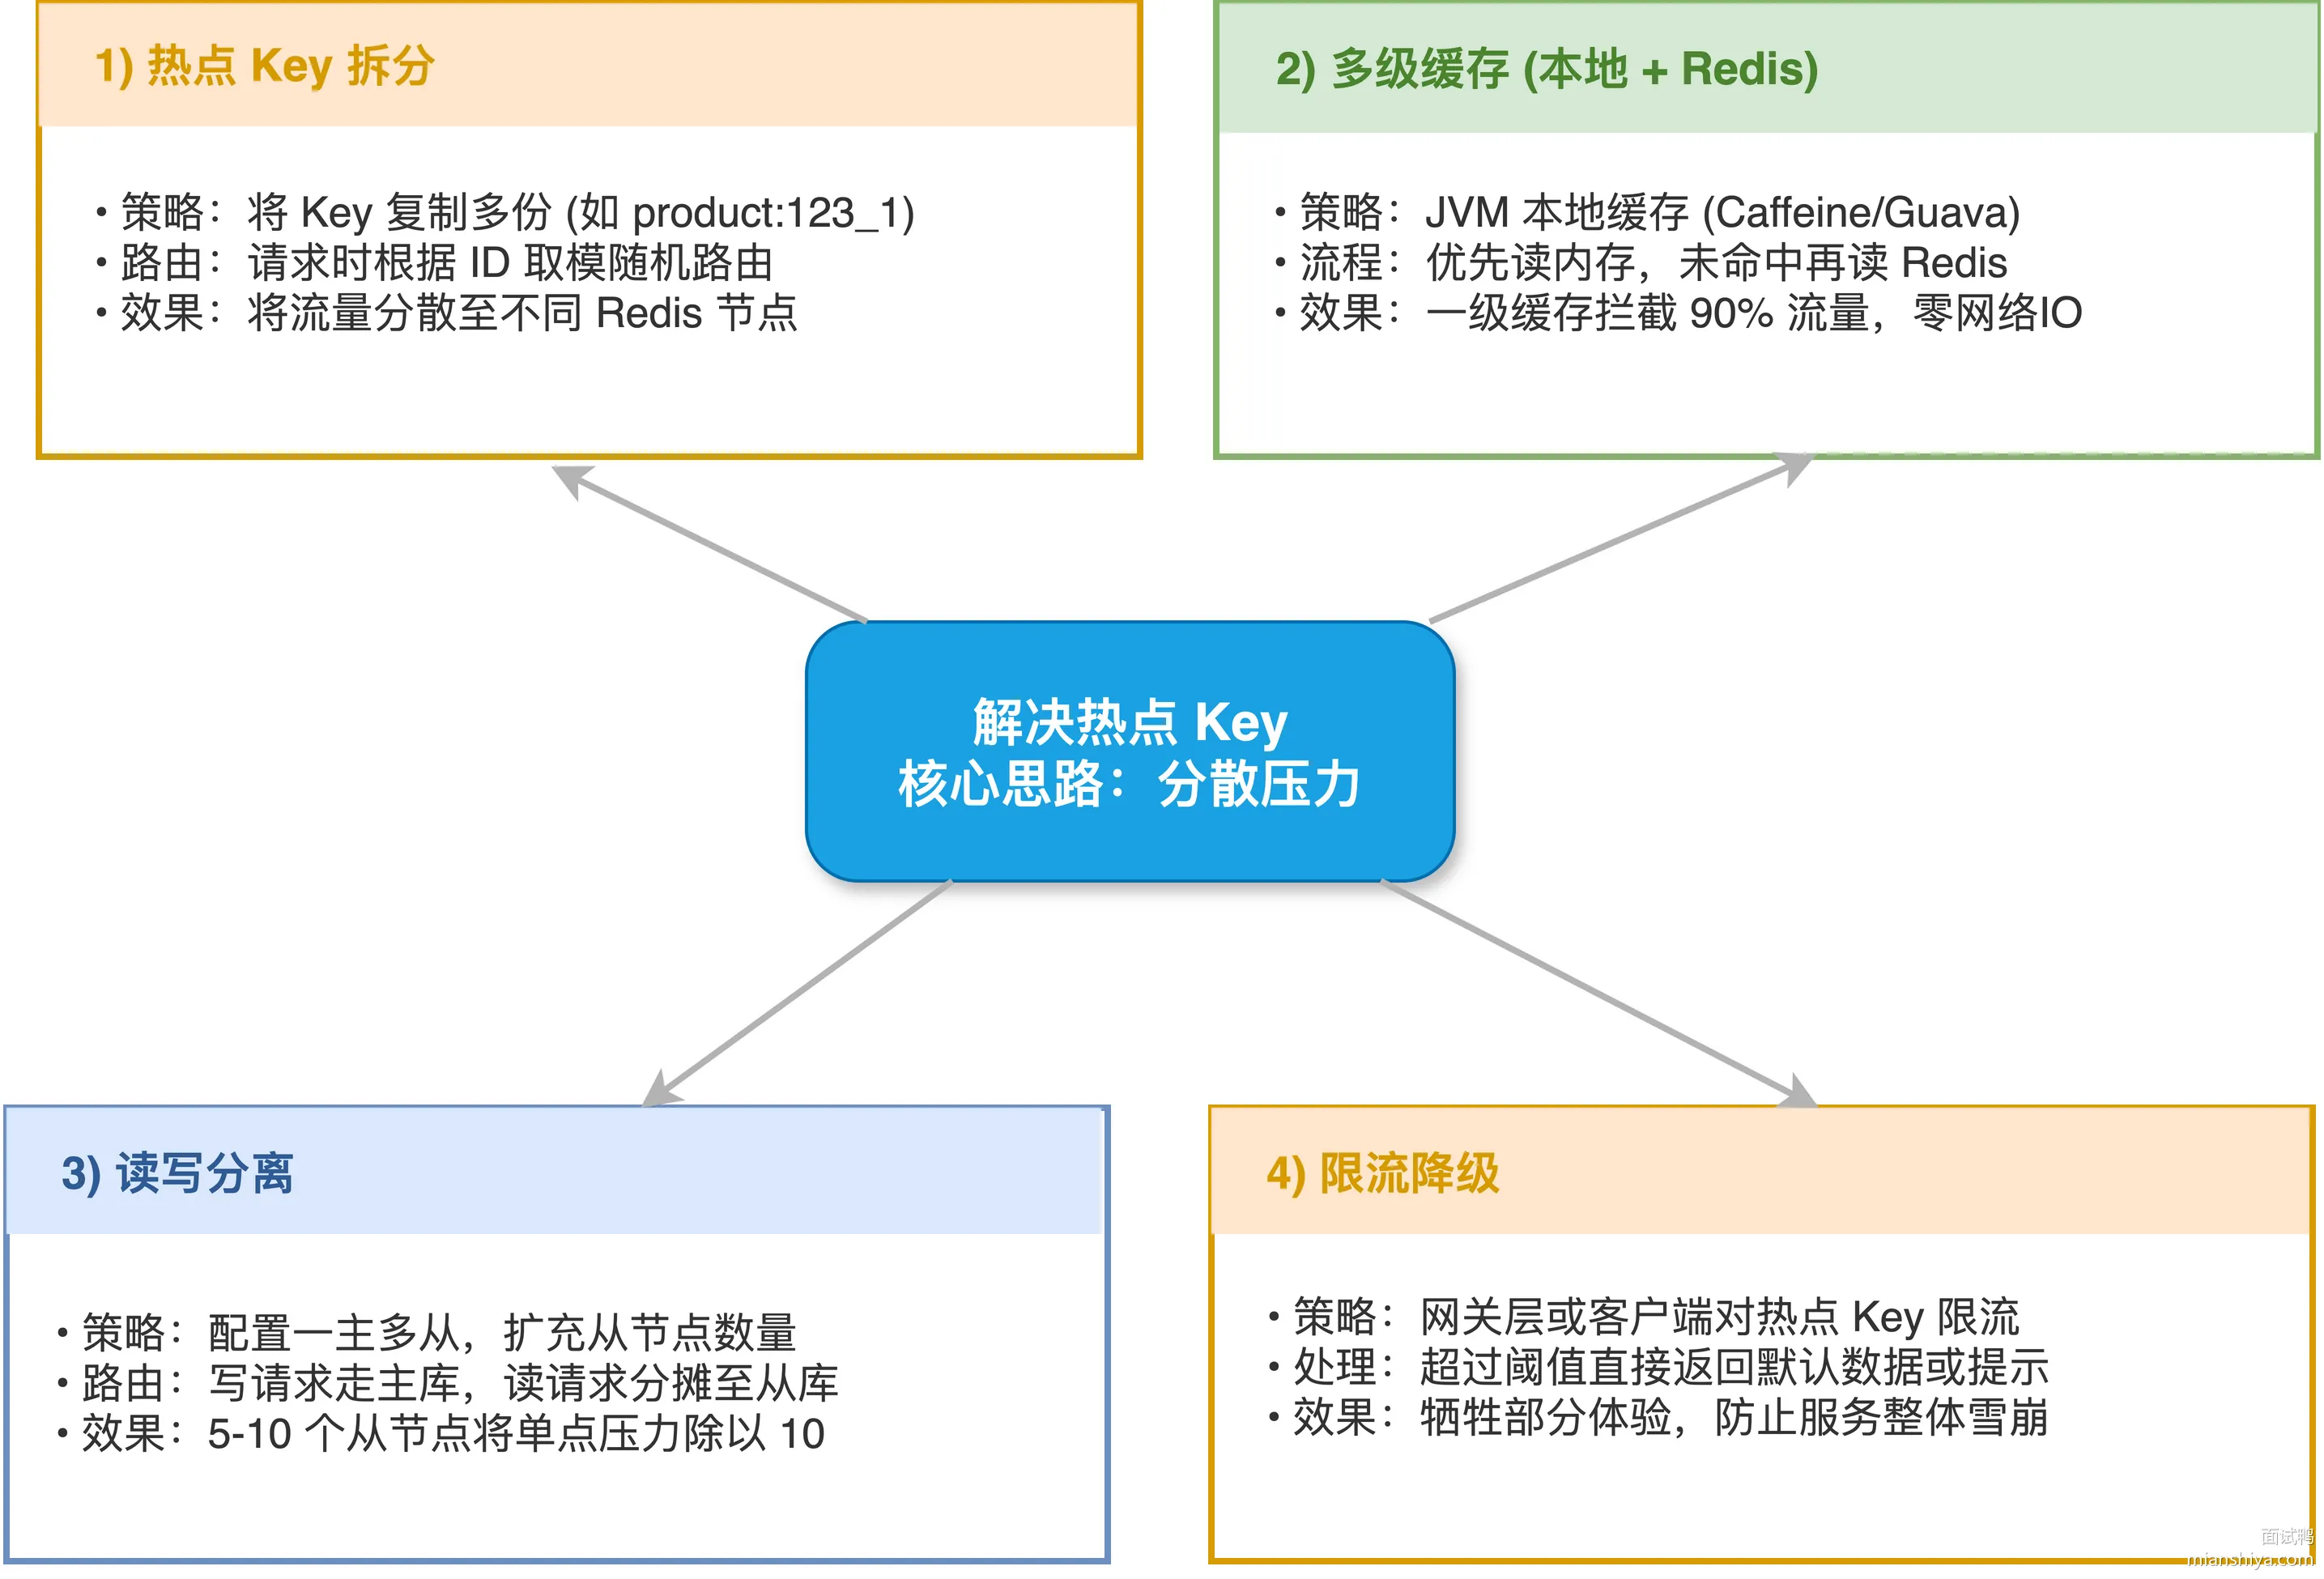
解决热点 Key 的核心思路就是分散压力:
1)热点 Key 拆分。把一个 Key 复制成多份,比如 product:12345 拆成 product:12345_0、product:12345_1、product:12345_2,请求时根据用户 ID 取模选一个。多个 Key 散落在不同节点上,压力就分散开了。
2)多级缓存。在 Redis 前面加一层本地缓存,比如 Caffeine、Guava Cache,热点数据直接从 JVM 内存里读,压根不走网络。一级缓存命中率能到 90% 以上,Redis 的压力直接降一个量级。
3)读写分离。配置多个从节点,读请求打到从库上,主库只负责写。一个热点 Key 的读请求可以分摊到 5-10 个从节点,单节点压力直接除以 10。
4)限流降级。在网关层或客户端对热点 Key 做限流,超过阈值的请求直接返回降级数据或友好提示。宁可让部分用户看到"太火爆了",也不能让整个服务崩掉。
16.2. 扩展知识
16.2.1. 怎样算热点 Key
我们可以参考阿里云 Redis 对热 key 的定义:
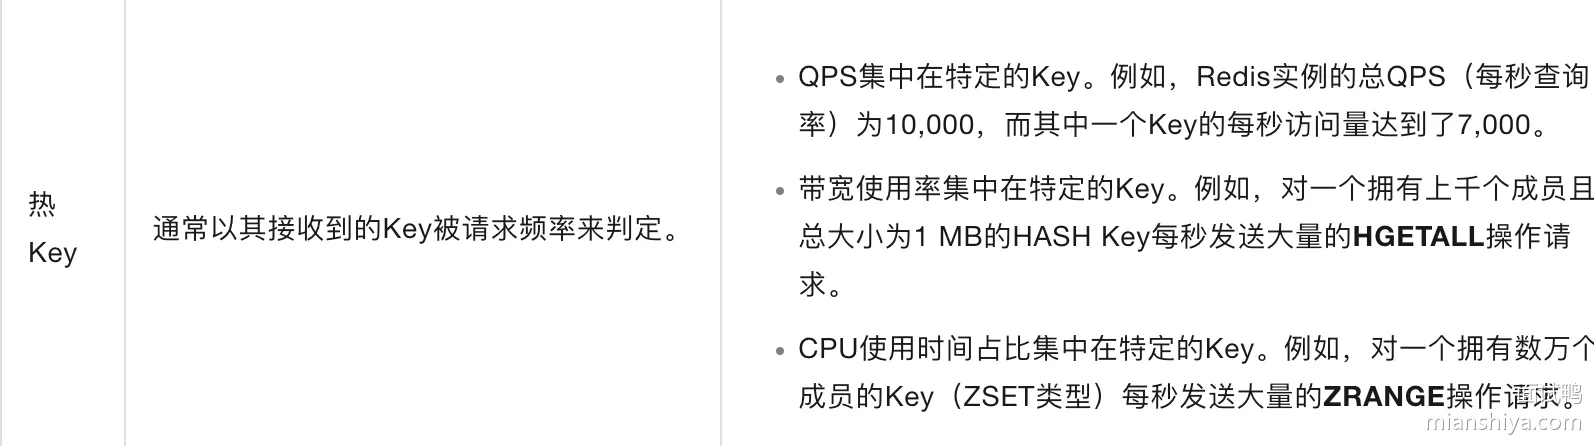
可以看到,如果一个 key 的访问频率占比过大,或带宽占比过大,都属于热点 key。
实际生产中还要看具体场景。一个 8 核的 Redis 实例,整体 QPS 能到 10 万,单个 Key 如果 QPS 超过 5000 就得警惕了,超过 1 万基本可以确定是热点。
16.2.2. 如何发现热点 Key
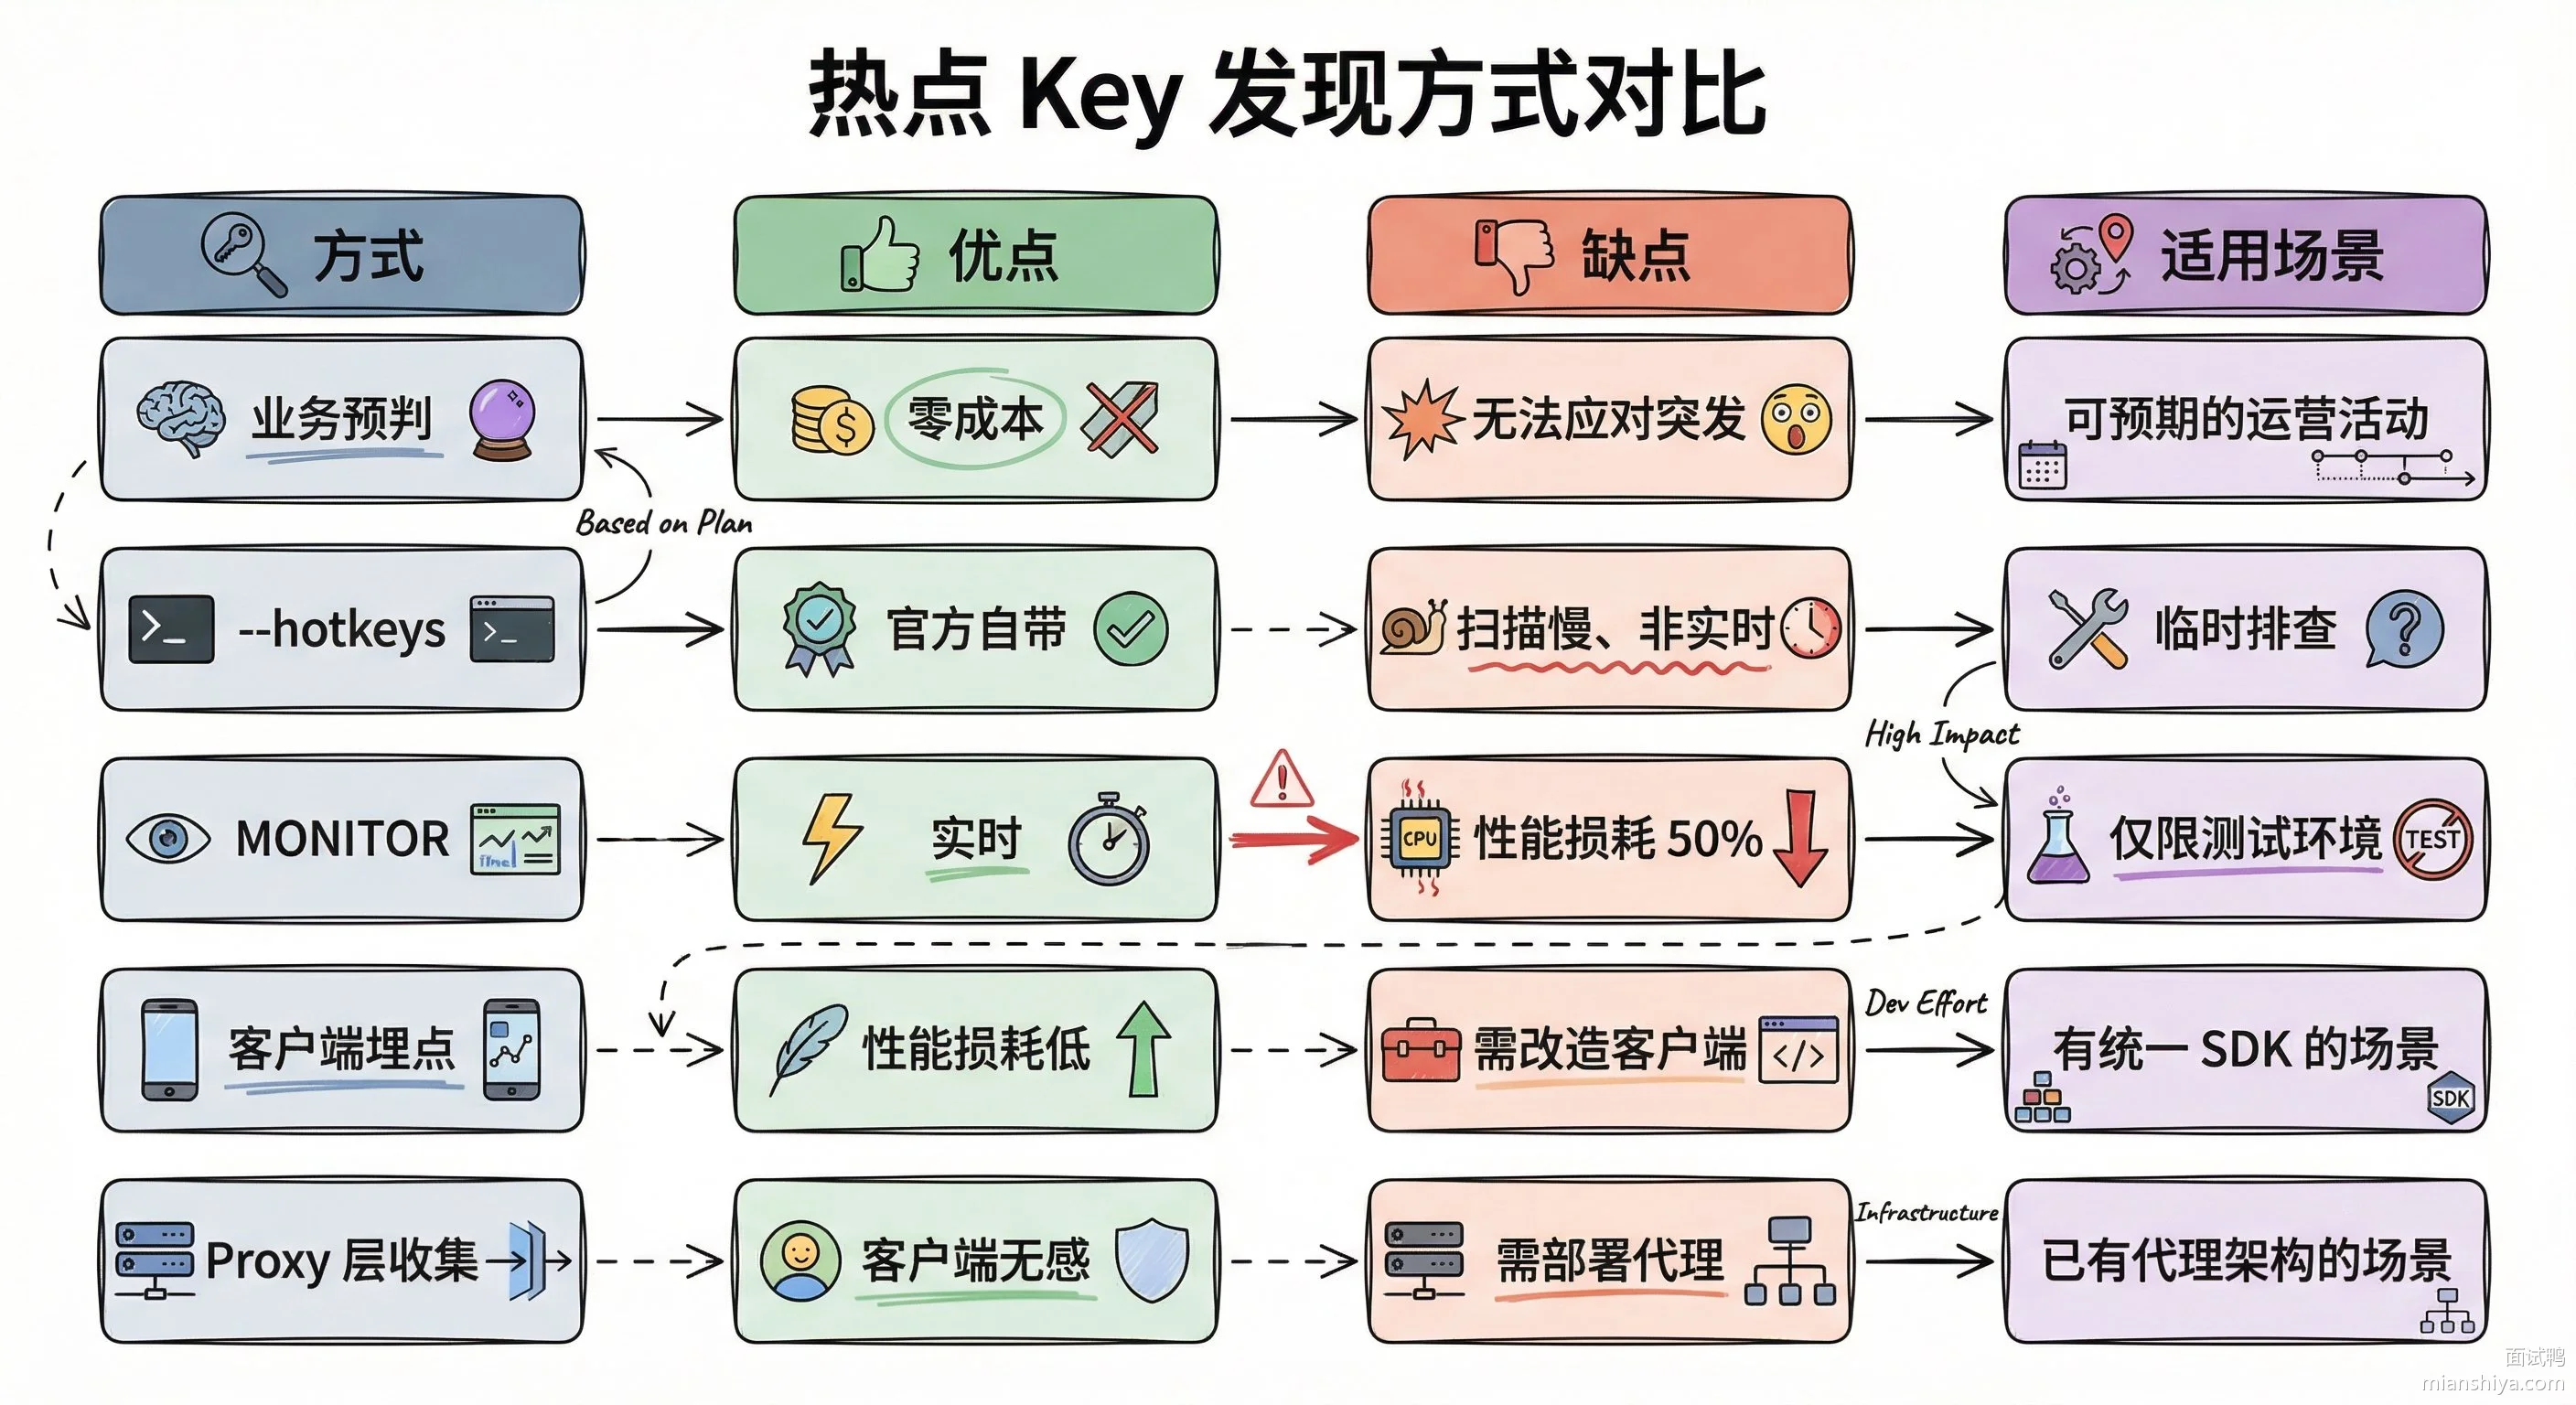
业务预判是最直接的方式。秒杀商品、春晚互动这种能提前预判的场景,上线前就把热点 Key 的应对方案准备好。不过突发事件没法预判,还得靠监控兜底。
redis-cli --hotkeys 是 Redis 4.0 之后自带的命令,底层是 SCAN 配合 OBJECT FREQ 实现的,能扫出访问频次最高的 Key。缺点是要扫全量 keyspace,Key 多的时候跑得慢,而且只能看某个时间点的快照,实时性不够。
MONITOR 命令能实时监控所有命令执行,配合脚本统计 Key 频次。但这玩意太狠了,官方 benchmark 显示开启 MONITOR 会损耗 50% 的性能,线上环境千万别用。
客户端埋点是比较靠谱的方案。在 Redis 客户端 SDK 里加统计逻辑,每次操作完把 Key 和耗时上报到 Kafka,后端用 Flink 实时聚合,QPS 超过阈值就告警。性能损耗低,实时性好,就是改造成本高一些。
Proxy 层收集适合已经有 Redis 代理的架构,比如用了 Twemproxy、Codis 这类中间件。在代理层统计 Key 频次,客户端完全无感,还能做到多语言统一。
16.2.3. 热点 Key 拆分的两种模式
全量复制模式适合热点数据量不大但访问量爆炸的场景,比如秒杀商品详情。把 product:12345 复制成 product:12345_0 到 product:12345_9 共 10 份,内容完全一样。请求时用 userId % 10 算出后缀,10 个 Key 分布在 10 个节点上,压力均摊。数据更新时要保证 10 份同时更新,可以用 Lua 脚本或 Pipeline 批量写。
分片存储模式适合热点数据量也很大的场景,比如直播弹幕。把 danmu:room:12345 拆成 danmu:room:12345_0 到 danmu:room:12345_9,每份存不同时间段或不同发送者的弹幕。用户拉取时只拉一个分片,看到的是部分弹幕,但体验上没什么区别。
16.2.4. 多级缓存架构实践
典型的三级缓存架构:CDN + 本地缓存 + Redis。
CDN 缓存静态资源,比如商品图片、详情页 HTML。热点商品的图片 CDN 命中率能到 95% 以上。
本地缓存用 Caffeine 或 Guava Cache,缓存最近 1 分钟内访问过的热点数据。热点 Key 的本地缓存命中率通常在 80%-95% 之间,剩下的请求才会穿透到 Redis。要注意设置合理的过期时间,太长容易出现数据不一致,太短又起不到缓存效果。
多级缓存要注意数据一致性问题。更新数据时,先更新 DB,再删除 Redis 缓存,本地缓存靠过期时间自动失效。对一致性要求高的场景,可以用消息队列广播缓存失效事件,各节点收到消息后主动清理本地缓存。
16.3. 常见问题
16.3.1. 热点 Key 拆分之后,数据更新怎么保证一致性?
全量复制模式下,更新操作用 Lua 脚本,保证原子性。如果某个分片写失败了,要有重试机制,最终一致就行。分片存储模式更简单,每个分片是独立数据,更新哪个写哪个,不存在一致性问题。
16.3.2. 本地缓存和 Redis 数据不一致怎么办?
短时间不一致是可以接受的,大多数业务容忍几秒到几十秒的延迟。本地缓存设置短一点的过期时间,比如 5-10 秒,过期后自动从 Redis 刷新。对一致性要求高的场景,可以用 Redis Pub/Sub 或消息队列广播失效事件,各节点收到消息后主动清理本地缓存。
16.3.3. 秒杀场景下热点 Key 怎么处理?
详细解答可以看:如何设计一个秒杀功能?
秒杀商品的库存 Key 是典型的热点。通常的做法是把库存预热到多个分片,比如 100 件商品拆成 10 份,每份 10 件。用户请求时路由到不同分片扣减库存,扣完了就标记这个分片售罄。最后还可以做库存回收,把各分片剩余的零头汇总到一个分片。配合本地缓存预判库存状态,库存为 0 直接在本地拦截,不打 Redis。
16.3.4. Cluster 模式下热点 Key 一定会导致节点倾斜吗?
不一定,取决于热点 Key 的分布。Redis Cluster 按 Key 的 CRC16 值对 16384 取模分配 slot,如果多个热点 Key 恰好落在不同节点上,压力还是分散的。但现实中热点 Key 往往是单个爆款商品或热搜话题,就是那一个 Key 被疯狂访问,肯定会导致某个节点压力集中。这时候只能靠拆分 Key 或者加本地缓存来解决。
17. Redis 的持久化机制有哪些?
17.1. 核心要点
Redis 提供两种主要的持久化机制:RDB 和 AOF,4.0 之后又引入了混合持久化。
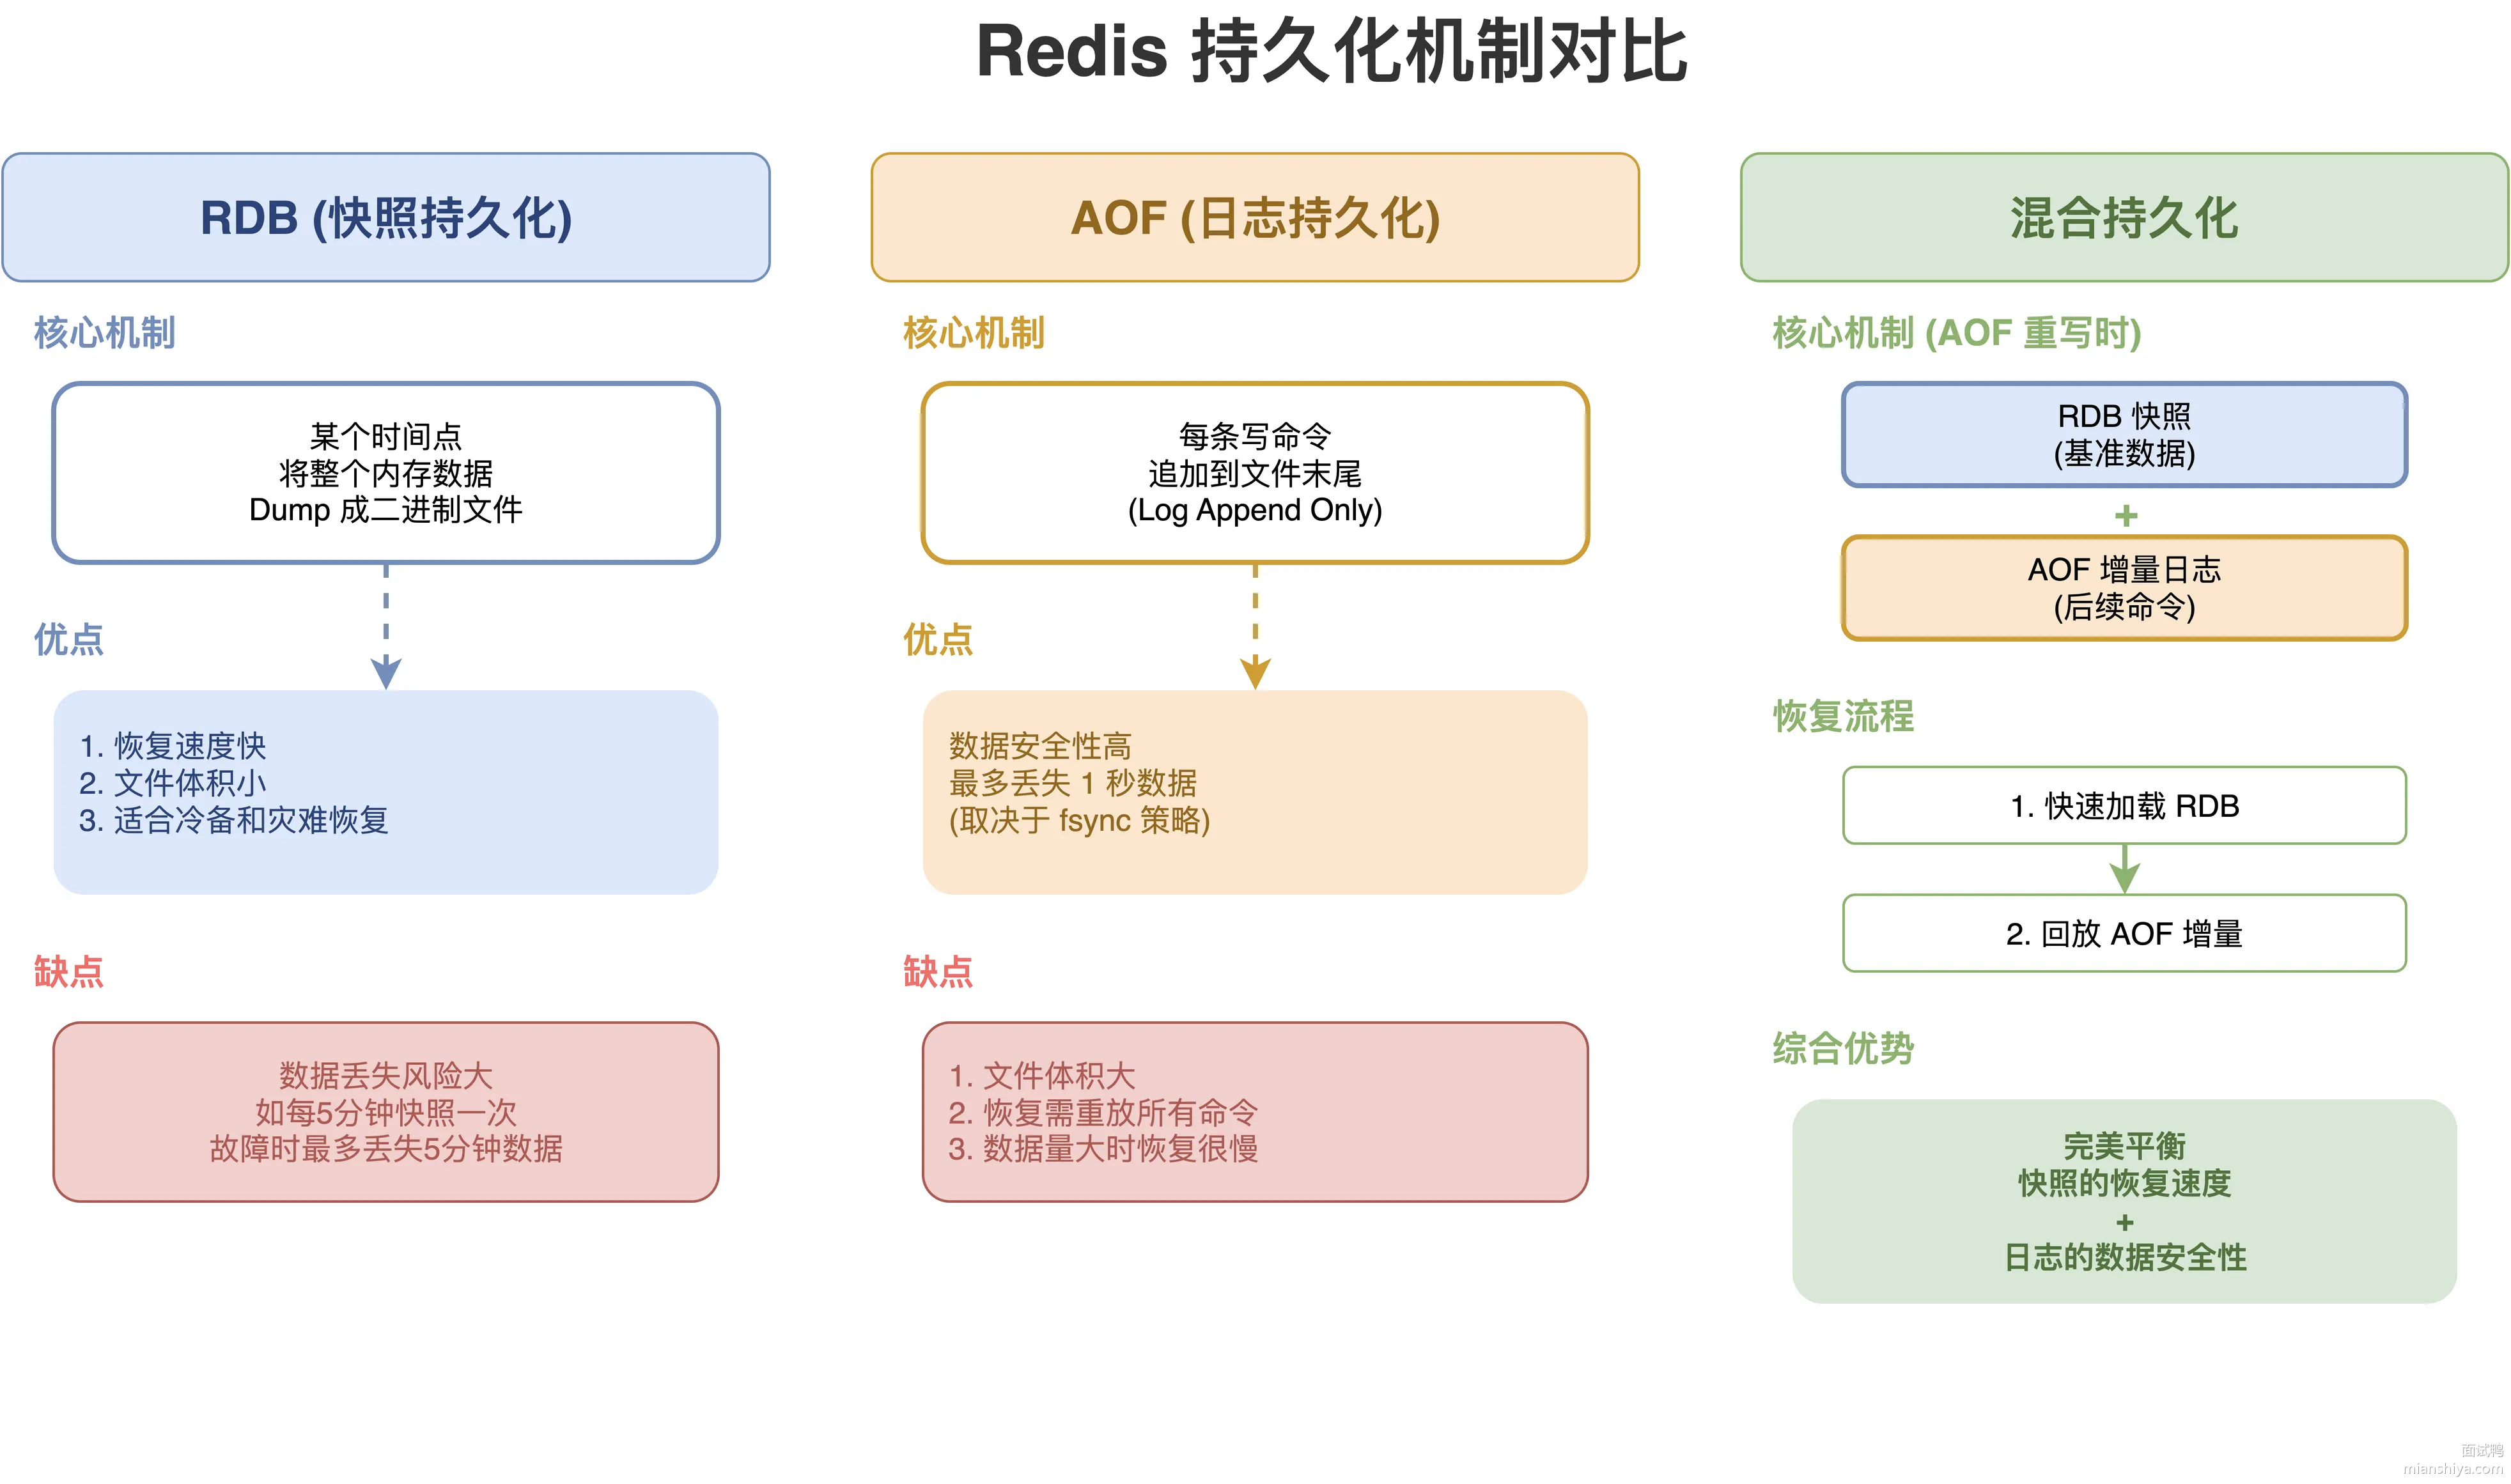
RDB 是快照持久化,某个时间点把整个内存数据 dump 成一个二进制文件。恢复速度快,文件体积小,适合做备份和灾难恢复。缺点是两次快照之间的数据如果 Redis 挂了就丢了,比如每 5 分钟做一次快照,最多可能丢 5 分钟的数据。
AOF 是日志持久化,每条写命令都追加到文件里。数据安全性高,最多丢 1 秒的数据。缺点是文件体积大,恢复的时候要把所有命令重新执行一遍,数据量大的时候恢复很慢。
混合持久化把两者结合起来:AOF 重写的时候先写一份 RDB 快照,后面的增量命令再用 AOF 格式追加。恢复时先加载 RDB 部分,再回放 AOF 部分,兼顾了恢复速度和数据安全性。
17.2. 扩展知识
17.2.1. RDB 持久化详解
RDB 通过 fork 子进程来生成快照,主进程继续处理请求,子进程把内存数据写到临时文件,写完后替换旧的 dump.rdb 文件。
触发 RDB 的方式有两种:
1)save 命令:在主线程里生成 RDB,生成期间整个 Redis 阻塞,不能处理任何请求。几乎不用这个命令,除非是停机维护。
2)bgsave 命令:后台生成 RDB,fork 出子进程来干活。fork 本身有微秒级的阻塞,之后主进程就不受影响了。默认用这个。
bgsave 的完整流程:
- 先检查有没有正在跑的 AOF 或 RDB 子进程,有的话直接返回错误
- 调用 rdbSaveBackground 触发持久化
- fork 出子进程,子进程开始生成 RDB 文件
- 主进程继续处理客户端请求
- 子进程写完后用新文件替换旧文件,然后退出
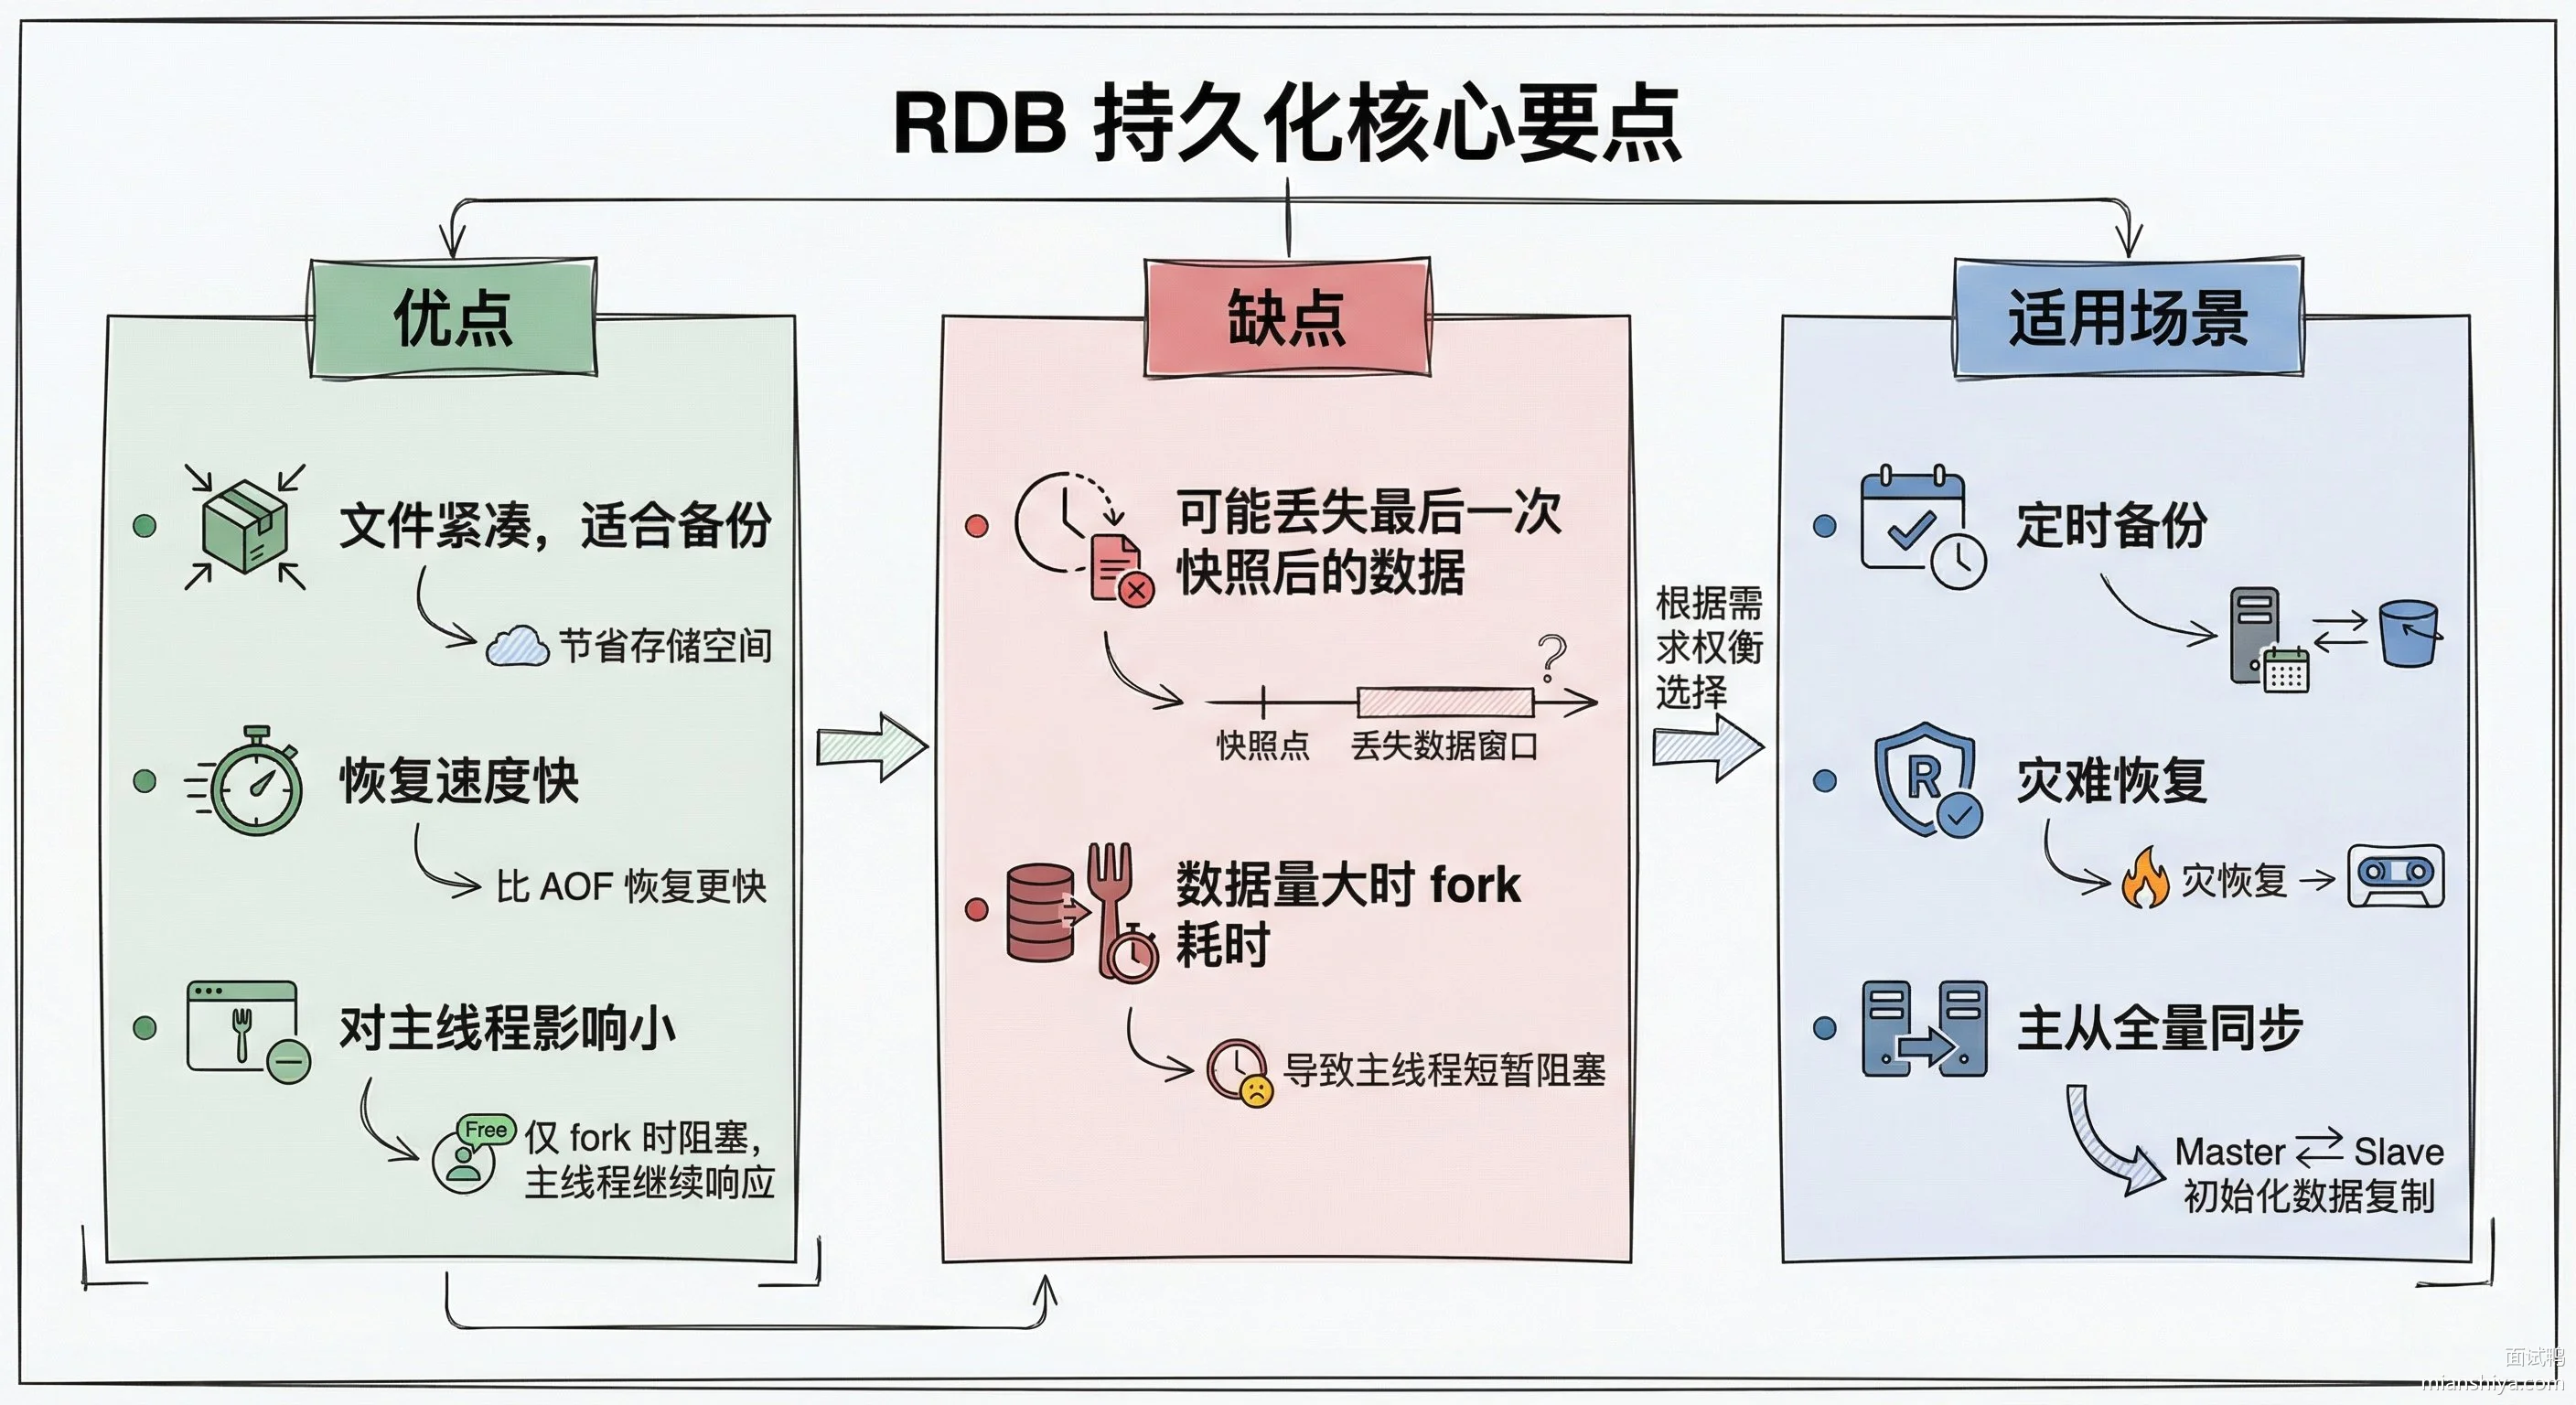
有个关键点是 fork 的写时复制机制,类似 CopyOnWriteArrayList。子进程创建时并不会真的复制一份内存,父子进程共享同一块内存。只有当某个进程要修改数据时,才会把对应的内存页复制一份出来单独修改。这样既省内存又省时间。
更多可看:
17.2.2. AOF 持久化详解
AOF 把每条写命令追加到文件末尾,重启时重新执行这些命令就能恢复数据。
AOF 比 RDB 安全,因为记录的是每条命令,配合合适的写回策略,最多丢 1 秒数据。代价是 AOF 文件比 RDB 大得多,恢复也慢得多。
17.2.3. AOF 写回策略
AOF 有三种写回策略,控制命令什么时候真正落盘:
1)always:每条命令执行完立刻 fsync,数据最安全,但性能最差,每次写操作都要等磁盘。
2)everysec:每秒 fsync 一次,性能和安全性的折中,默认用这个。最多丢 1 秒数据。
3)no:不主动 fsync,让操作系统自己决定什么时候刷盘。性能最好,但 Redis 挂了可能丢比较多数据。
有个常见误区:设置 always 就一定不丢数据?不对!Redis 是先执行命令再写 AOF,如果命令执行完、AOF 还没写进去 Redis 就挂了,这条命令就丢了。所以 Redis 持久化做不到绝对不丢数据。
17.2.4. AOF 重写机制
AOF 文件会随着写操作不断膨胀。一个 Key 被 set 了 100 次,AOF 里就有 100 条命令,但实际上只有最后一条有意义。AOF 重写就是根据内存当前状态生成一份最精简的 AOF 文件。
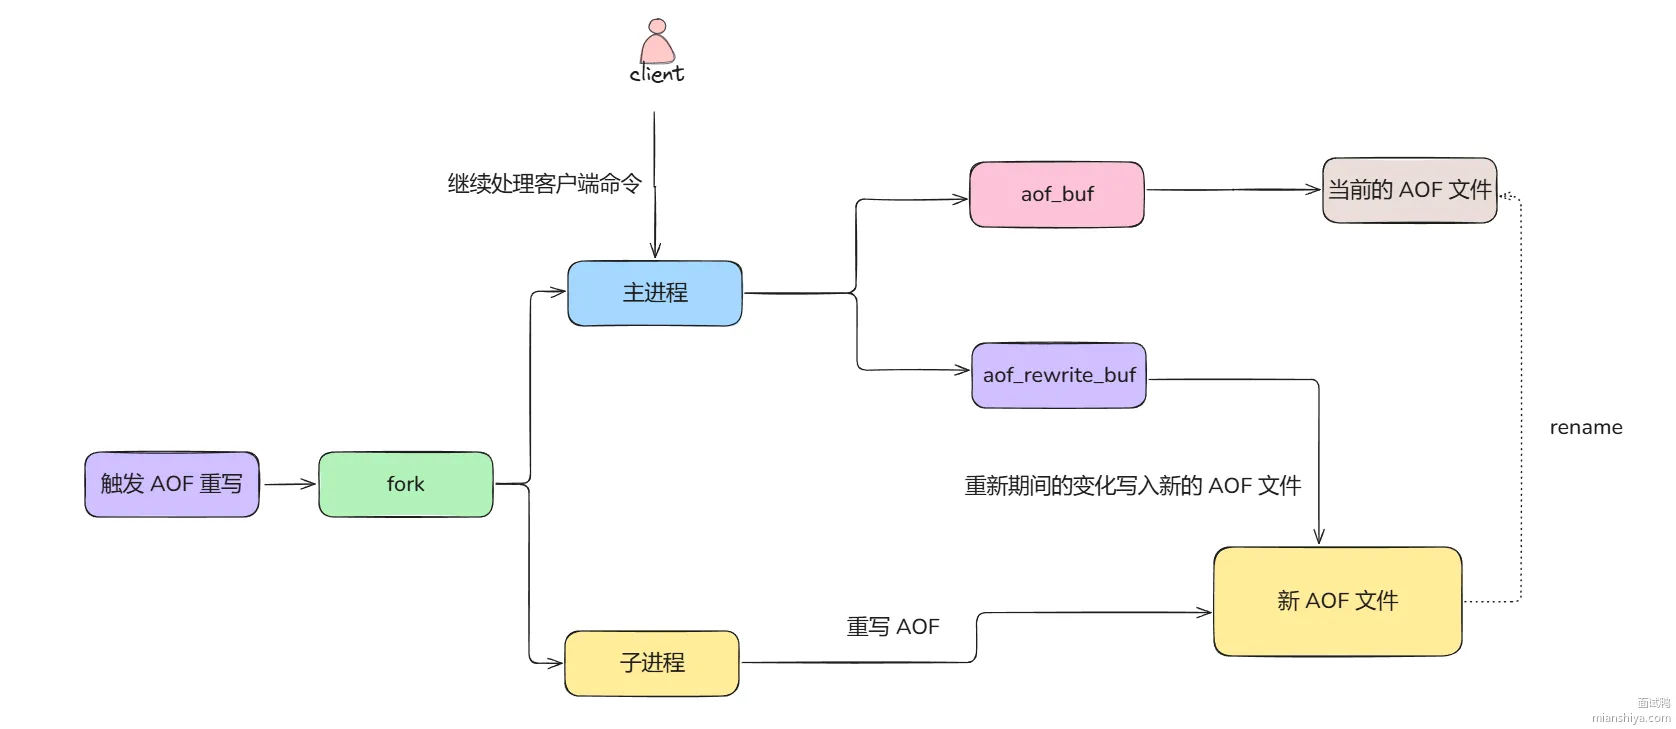
重写流程:
1)主进程 fork 出子进程 2)子进程根据内存快照生成新的 AOF 文件 3)重写期间主进程的新写命令同时追加到旧 AOF 和重写缓冲区 4)子进程写完后,主进程把重写缓冲区的命令追加到新 AOF 文件 5)用新文件替换旧文件
AOF 重写可以手动触发 BGREWRITEAOF,也可以配置自动触发:
auto-aof-rewrite-min-size:AOF 文件达到多大才允许重写,默认 64MBauto-aof-rewrite-percentage:相比上次重写后文件增长了多少百分比才触发重写
17.2.5. 混合持久化
RDB 恢复快但可能丢数据,AOF 数据安全但恢复慢。Redis 4.0 引入混合持久化,通过 aof-use-rdb-preamble 配置开启。
触发时机是 AOF 重写的时候。重写时先把当前内存数据以 RDB 格式写到新 AOF 文件开头,重写期间的增量命令以 AOF 格式追加在后面。
恢复时先加载 RDB 部分,再回放 AOF 部分的增量命令,速度比纯 AOF 快很多,数据安全性又比纯 RDB 高。
17.2.6. Redis 7.0 MP-AOF
7.0 之前的 AOF 重写有三个问题:
1)内存浪费:aof_buf 和 aof_rewrite_buf 里有大量重复数据 2)CPU 浪费:主进程要往两个 buf 写数据,还要把 rewrite_buf 发给子进程 3)磁盘浪费:同一份数据要写两次磁盘
7.0 引入了 MP-AOF 机制,把单个 AOF 文件拆成多个:
- base file:基础文件,相当于某个时间点的快照
- incremental files:增量文件,记录基础文件之后的写操作
- manifest file:清单文件,管理所有 base 和 incremental 文件
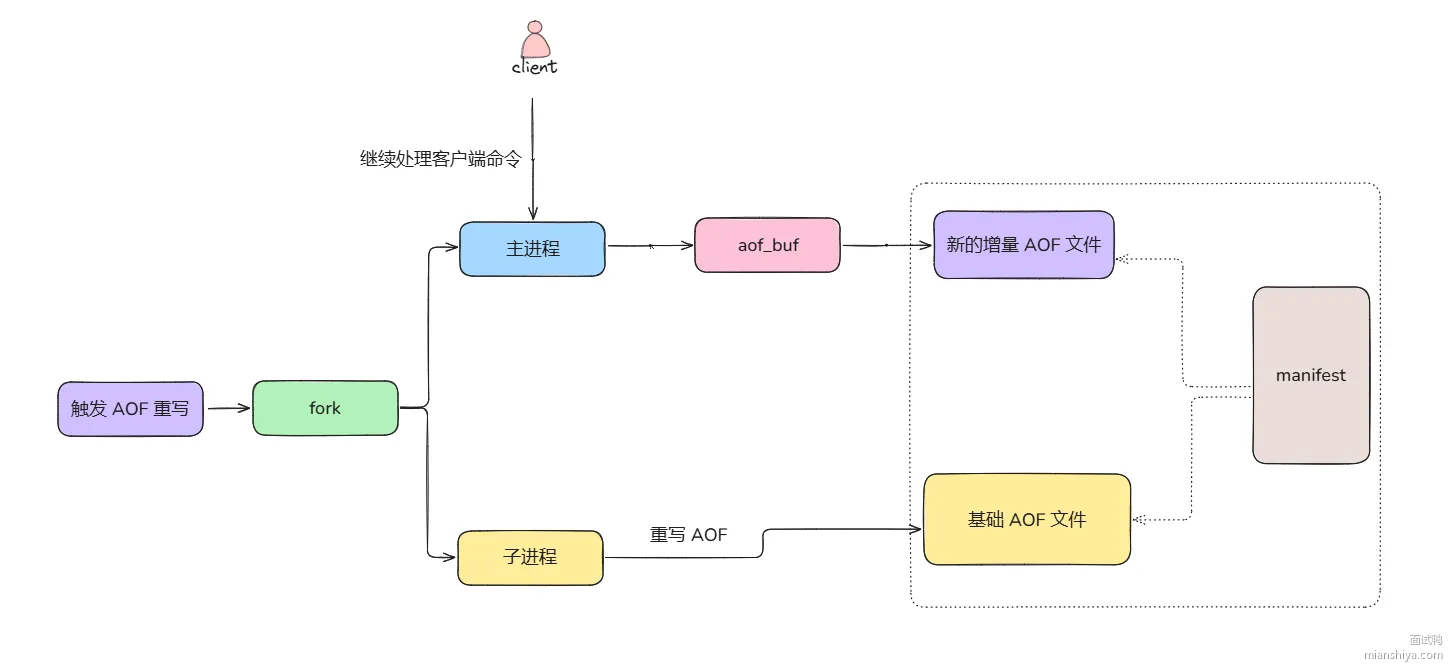
重写期间新的写命令直接写到新的增量文件,不需要同时往两个 buf 写了。子进程独立生成新的 base 文件,跟主进程没有交互。重写完成后更新 manifest 文件,把旧文件标记为历史文件异步删除。
17.2.7. AOF 文件修复
如果 AOF 文件因为系统崩溃损坏了,可以用 redis-check-aof --fix 命令修复。这个工具会截断文件末尾不完整的命令,让文件恢复到一致状态。
17.3. 常见问题
17.3.1. 生产环境一般怎么配置持久化?
大多数场景用混合持久化,兼顾恢复速度和数据安全。everysec 的 AOF 写回策略够用了,最多丢 1 秒数据。同时配合定时 RDB 备份做异地容灾,比如每天凌晨低峰期做一次全量 RDB 传到 OSS。对数据安全性要求极高的场景才考虑 always,但要评估性能影响。
17.3.2. RDB 的 fork 操作会阻塞主线程吗?
详细解答可以看:Redis 在生成 RDB 文件时如何处理请求?
会,但只是微秒到毫秒级别。fork 本身需要复制页表,内存越大页表越大,阻塞时间越长。10GB 内存的实例 fork 大概阻塞 10-20 毫秒。写时复制让 fork 不用真的复制数据,只复制页表,所以还算快。但如果 fork 期间父进程写操作很多,会触发大量的写时复制,子进程需要更多时间完成 RDB。
17.3.3. AOF 重写期间 Redis 挂了会怎样?
没事,旧的 AOF 文件还在。新文件是写到临时文件里的,只有完全写完并且追加完重写缓冲区的数据后,才会原子地替换旧文件。重写到一半挂了,下次重启还是用旧的 AOF 恢复,数据不会丢。
17.3.4. 为什么 Redis 不用 WAL 而是 AOF?
详细解答可以看:什么是 Write-Ahead Logging (WAL) 技术?它的优点是什么?MySQL 中是否用到了 WAL?
传统数据库的 WAL 是先写日志再改数据,Redis 的 AOF 是先改内存再写日志。因为 Redis 是纯内存操作,改内存本身就是原子的,不需要日志来保证一致性。AOF 主要是为了持久化,不是为了保证事务。而且 Redis 追求的是高性能,先写日志会增加每次操作的延迟。
18. Redis 在生成 RDB 文件时如何处理请求?
18.1. 核心要点
Redis 生成 RDB 快照用的是 bgsave 命令,核心机制就是 fork 子进程。主进程把内存页表复制一份给子进程,子进程拿着这份页表去遍历数据、写磁盘,主进程该干嘛干嘛,继续处理客户端请求。
整个流程大致是这样:
1)客户端发起 bgsave 命令 2)主进程 fork 出一个子进程,这一步会短暂阻塞 3)fork 完成后,主进程立刻恢复正常处理请求 4)子进程在后台遍历内存数据,写入 RDB 文件 5)子进程写完后退出,通知主进程 RDB 生成完毕
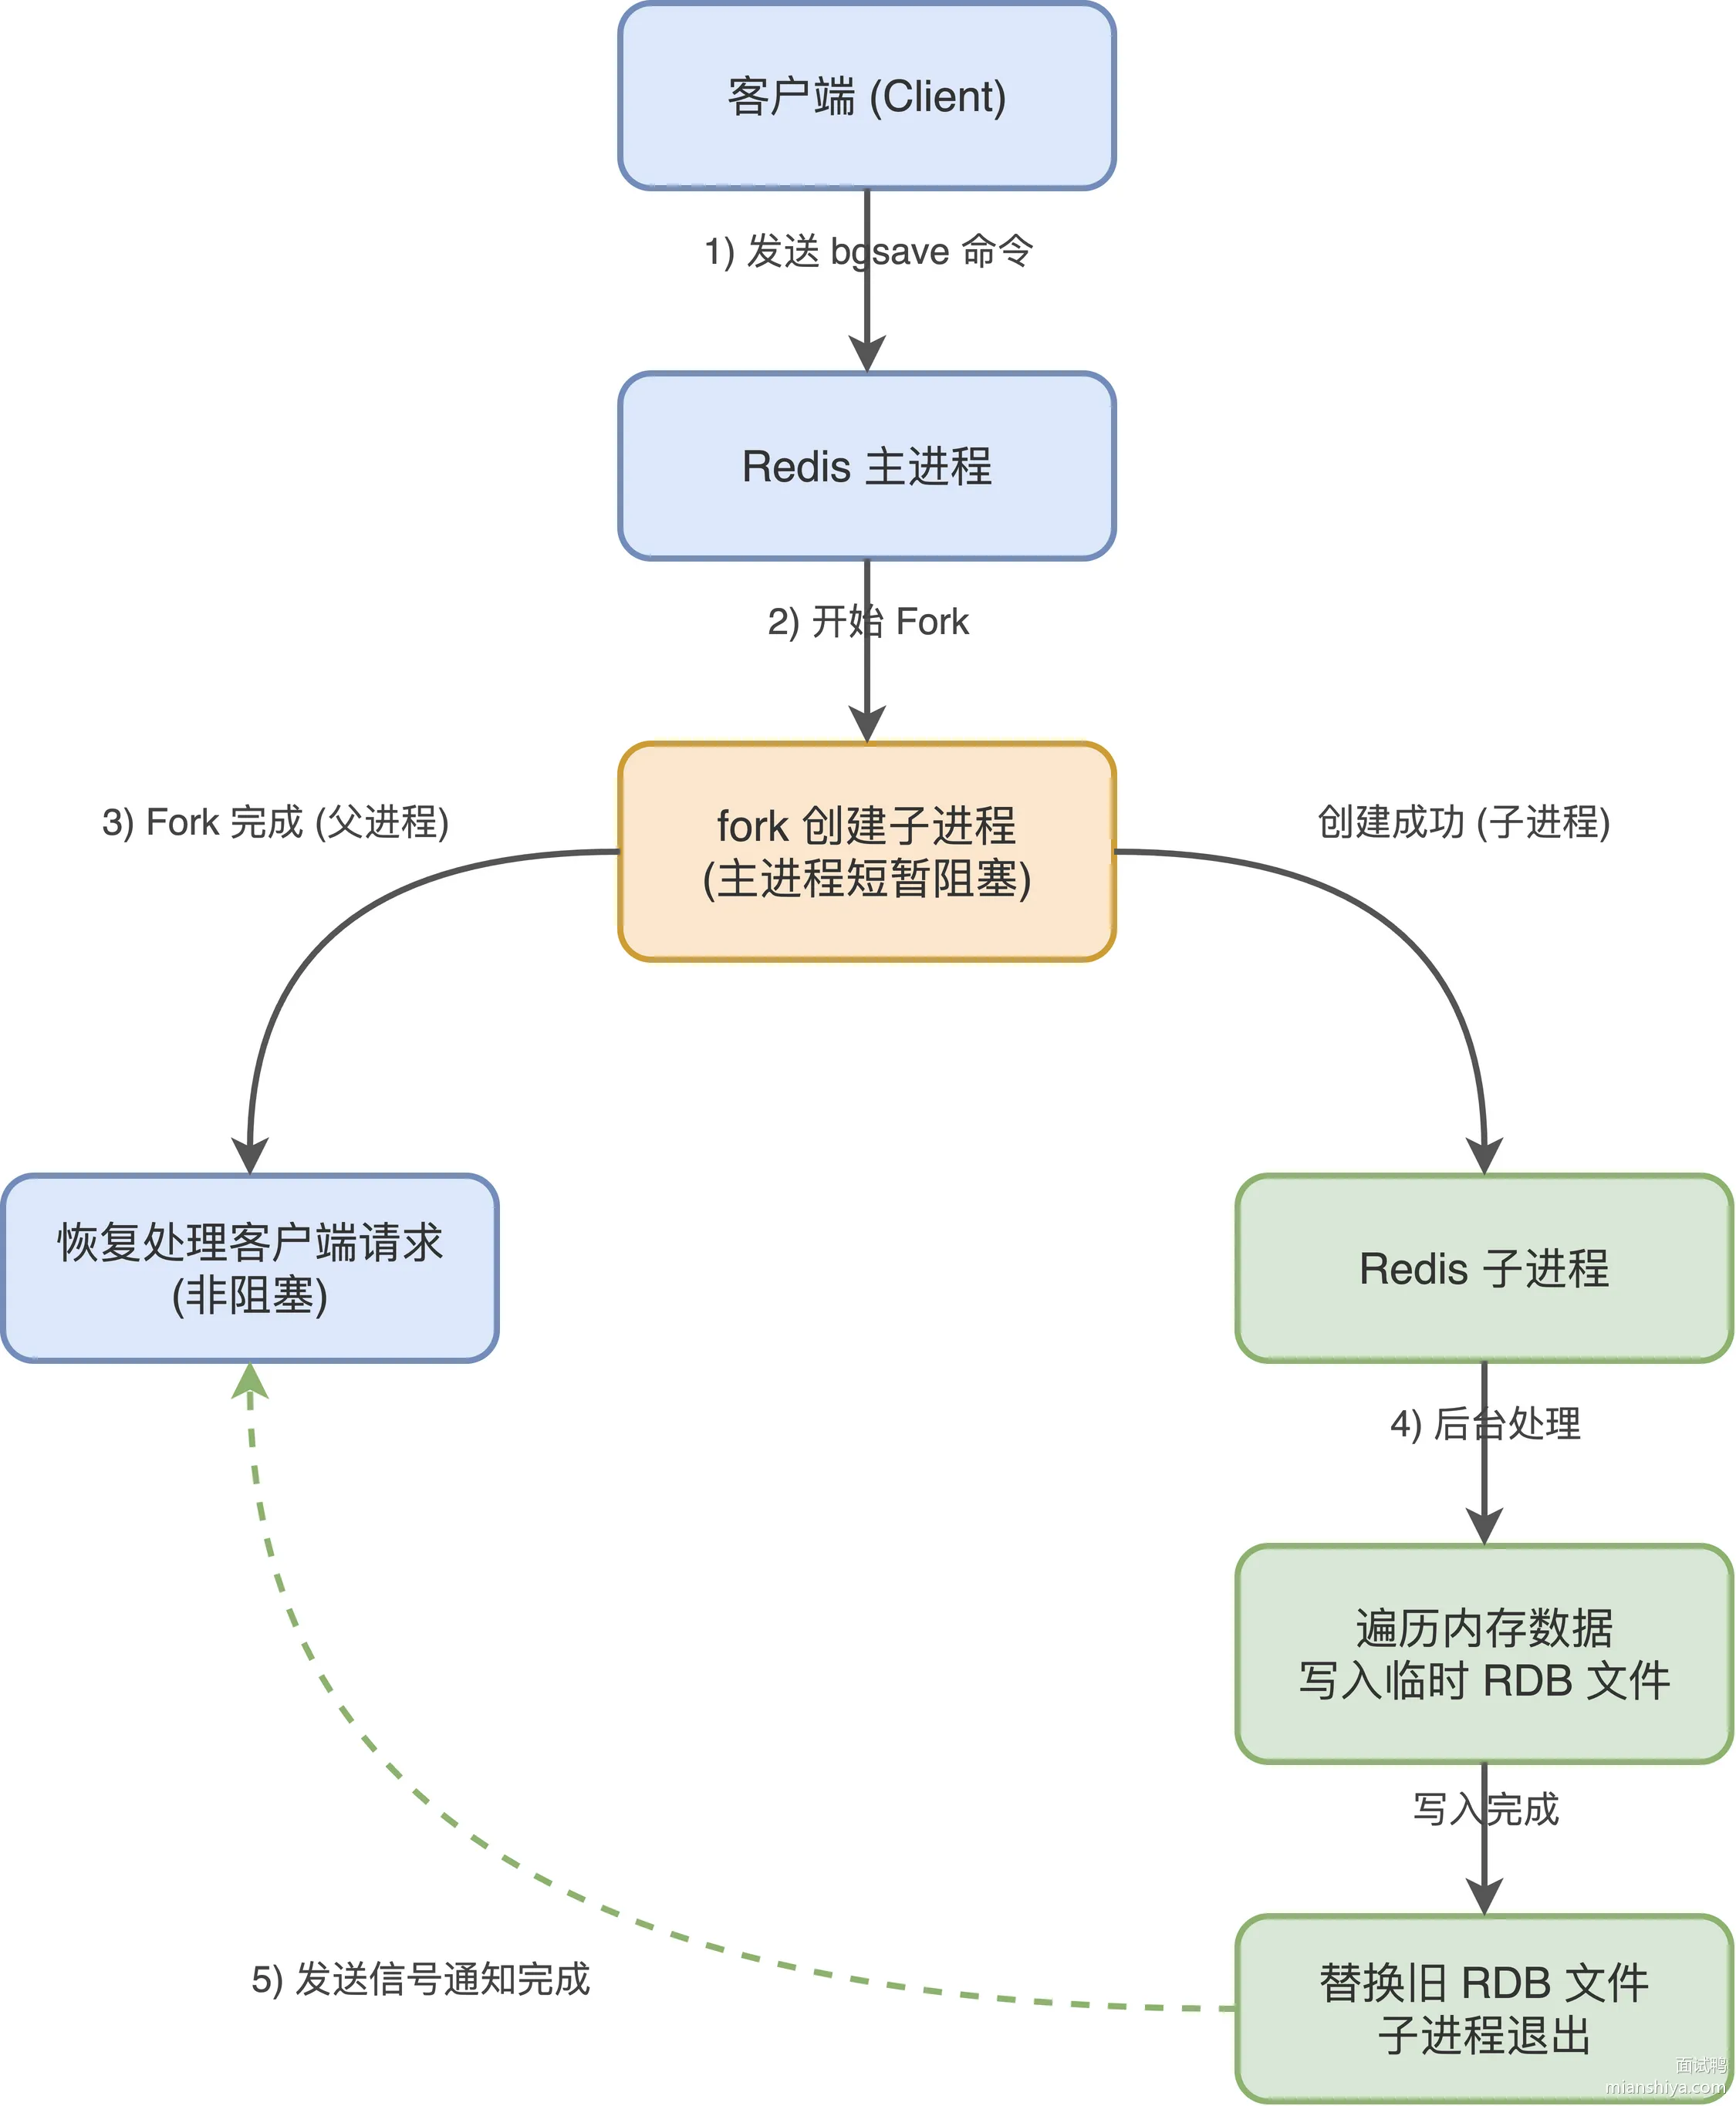
所以从外部看,Redis 在生成 RDB 期间服务不会中断,最多就是 fork 那一瞬间有个毫秒级的卡顿。
18.2. 扩展知识
18.2.1. 快照期间数据能改吗?
当然能改。主进程正常接收写命令,但问题来了:子进程在遍历数据写文件,主进程又在改数据,那快照的一致性怎么保证?
答案是 写时复制(Copy-On-Write)。
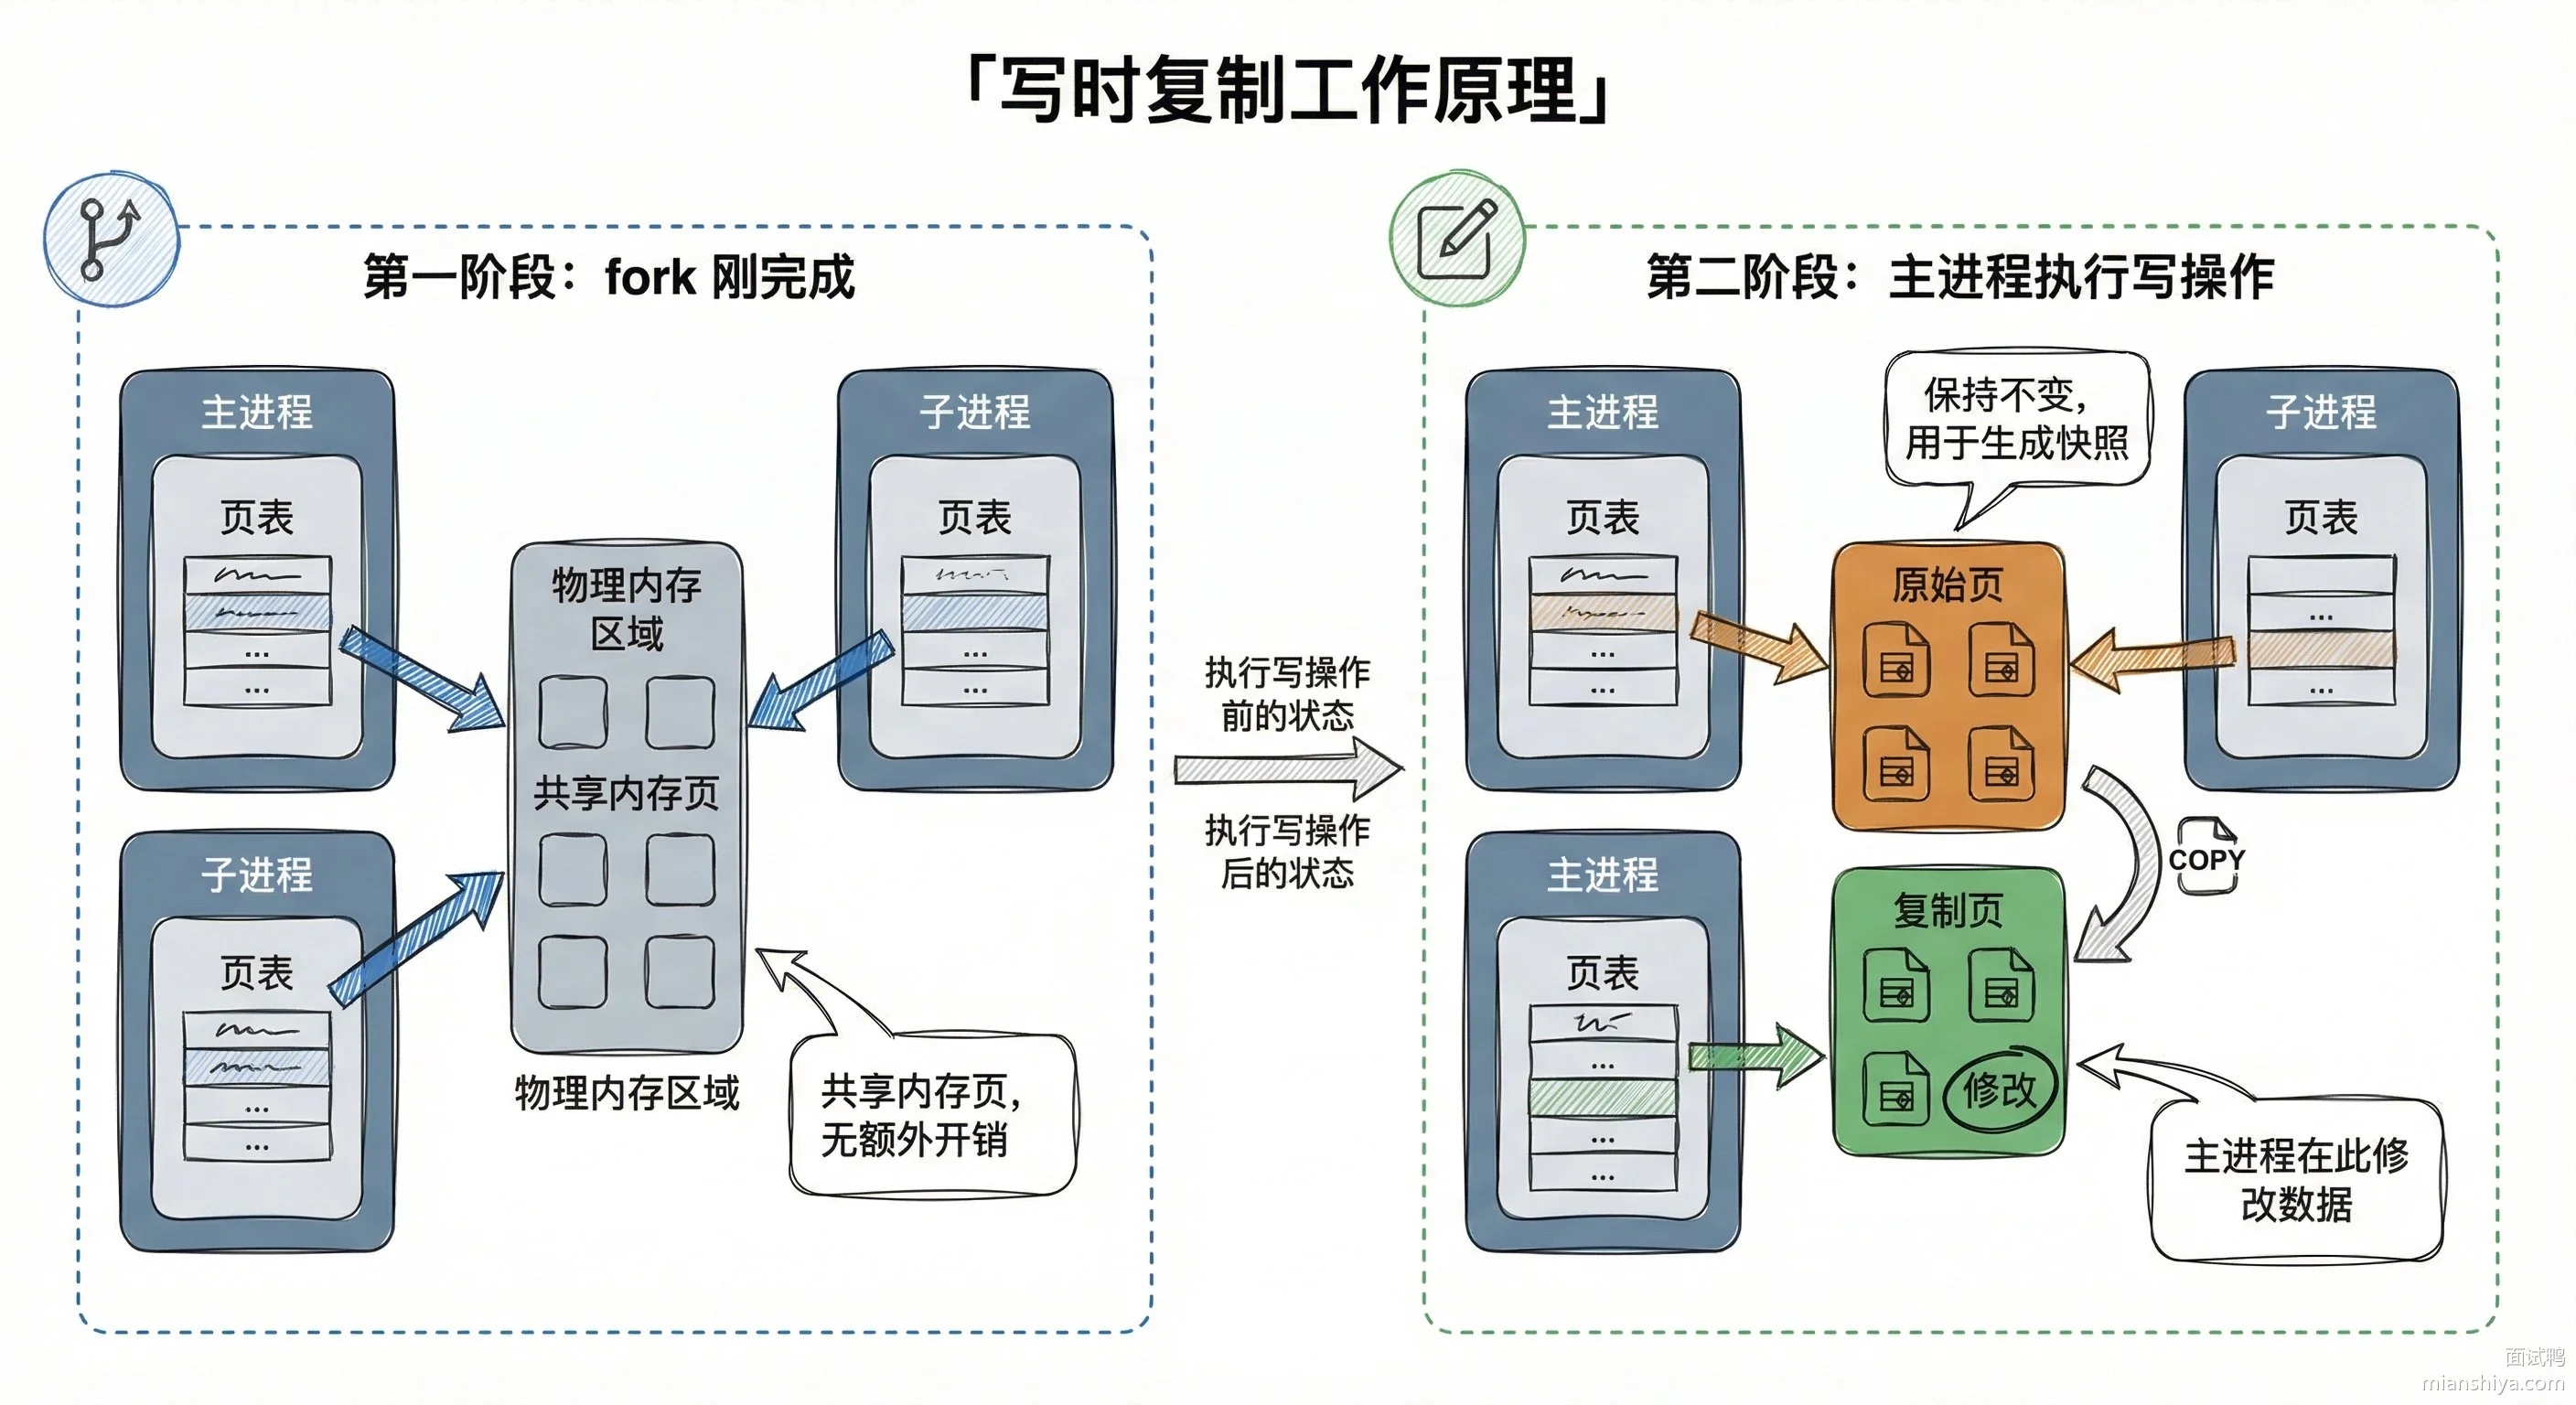
fork 的时候,子进程并不是把主进程的内存完整复制一份,那样太慢了。它只是复制了页表,页表里存的是物理内存的地址,所以父子进程实际上指向同一块物理内存。
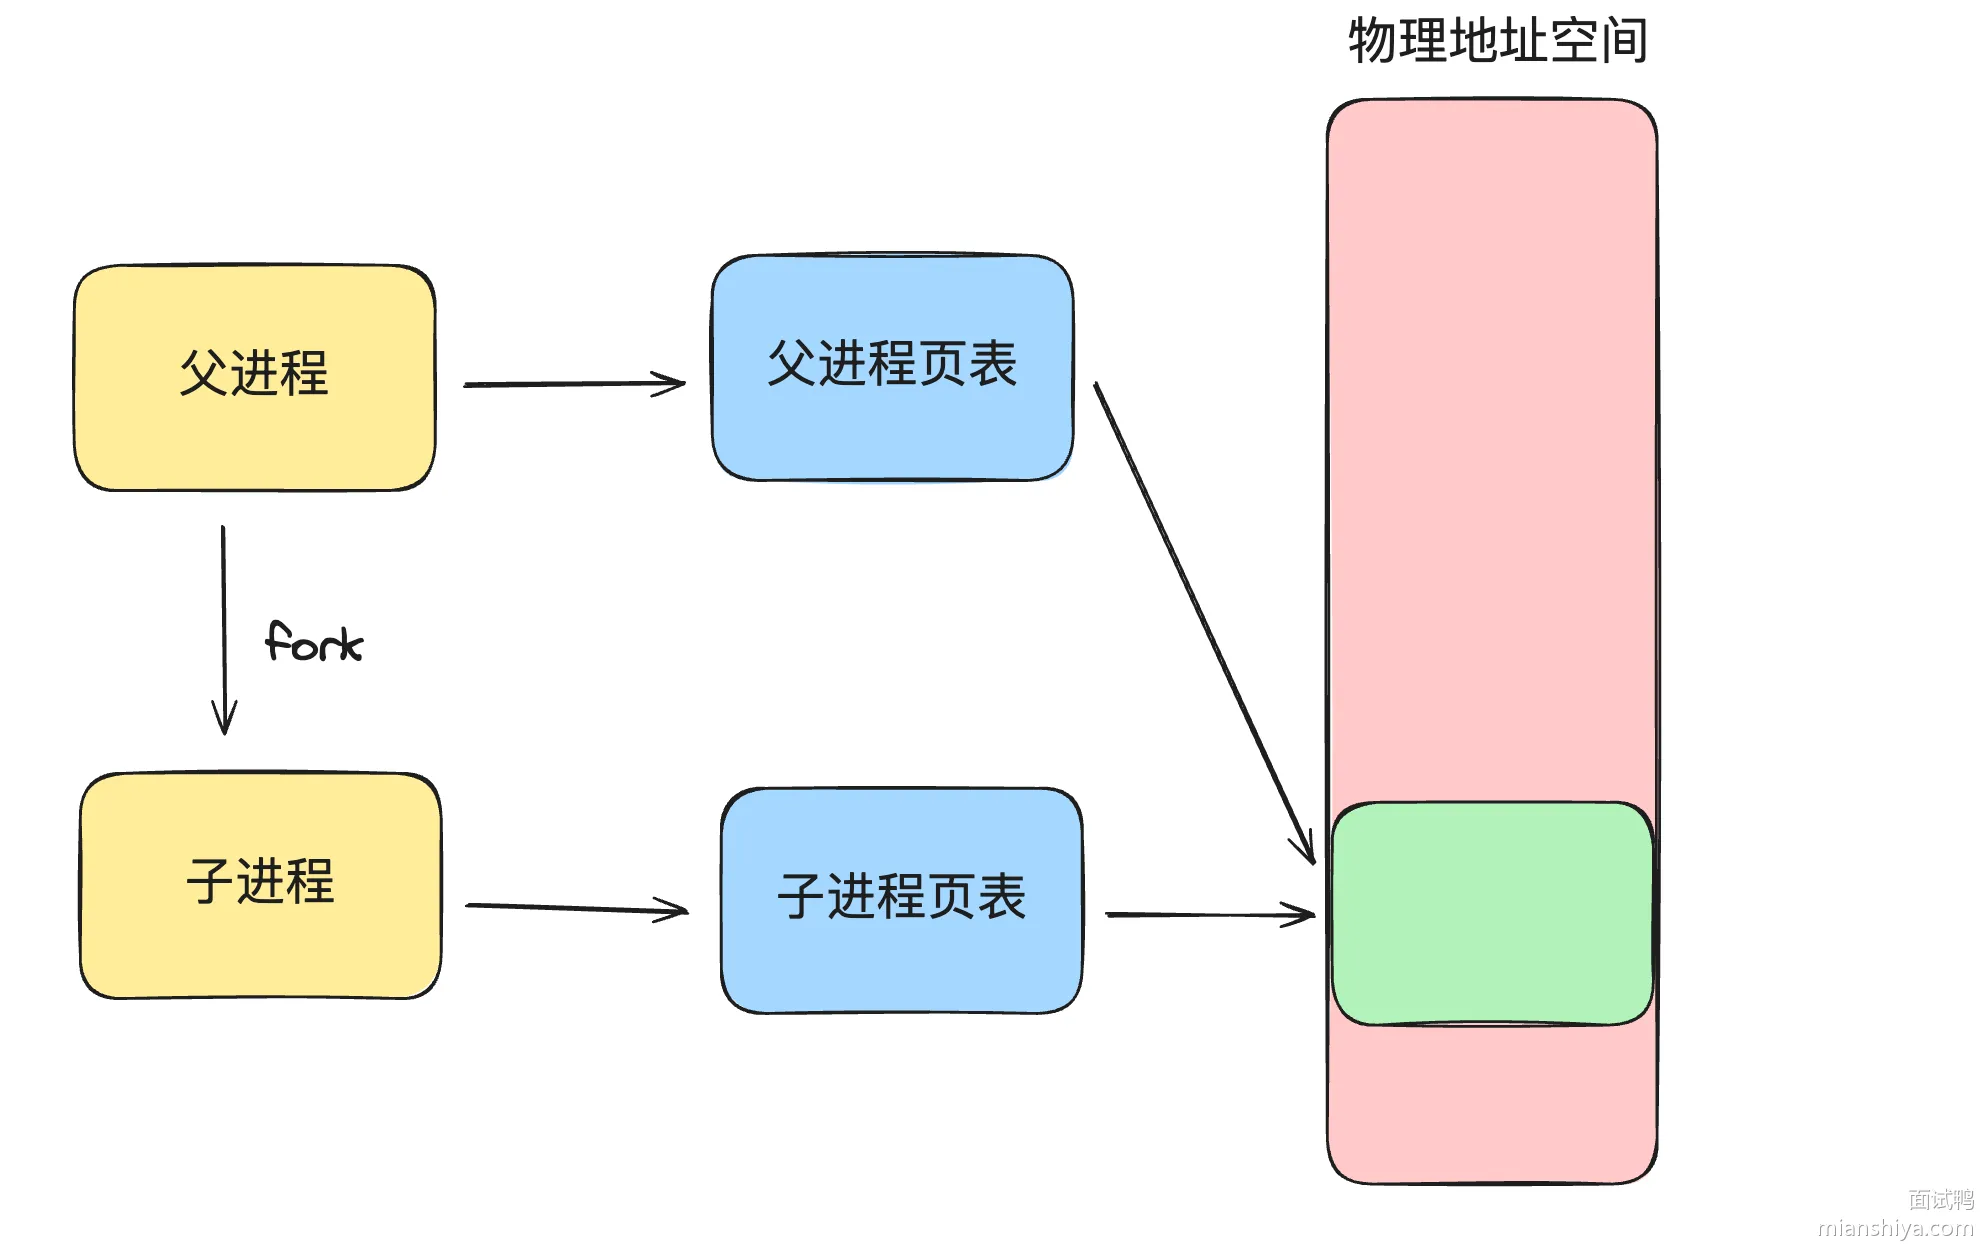
当主进程要修改某个数据时,操作系统会把那个内存页复制一份出来,主进程在副本上改,子进程看到的还是原来的老数据。
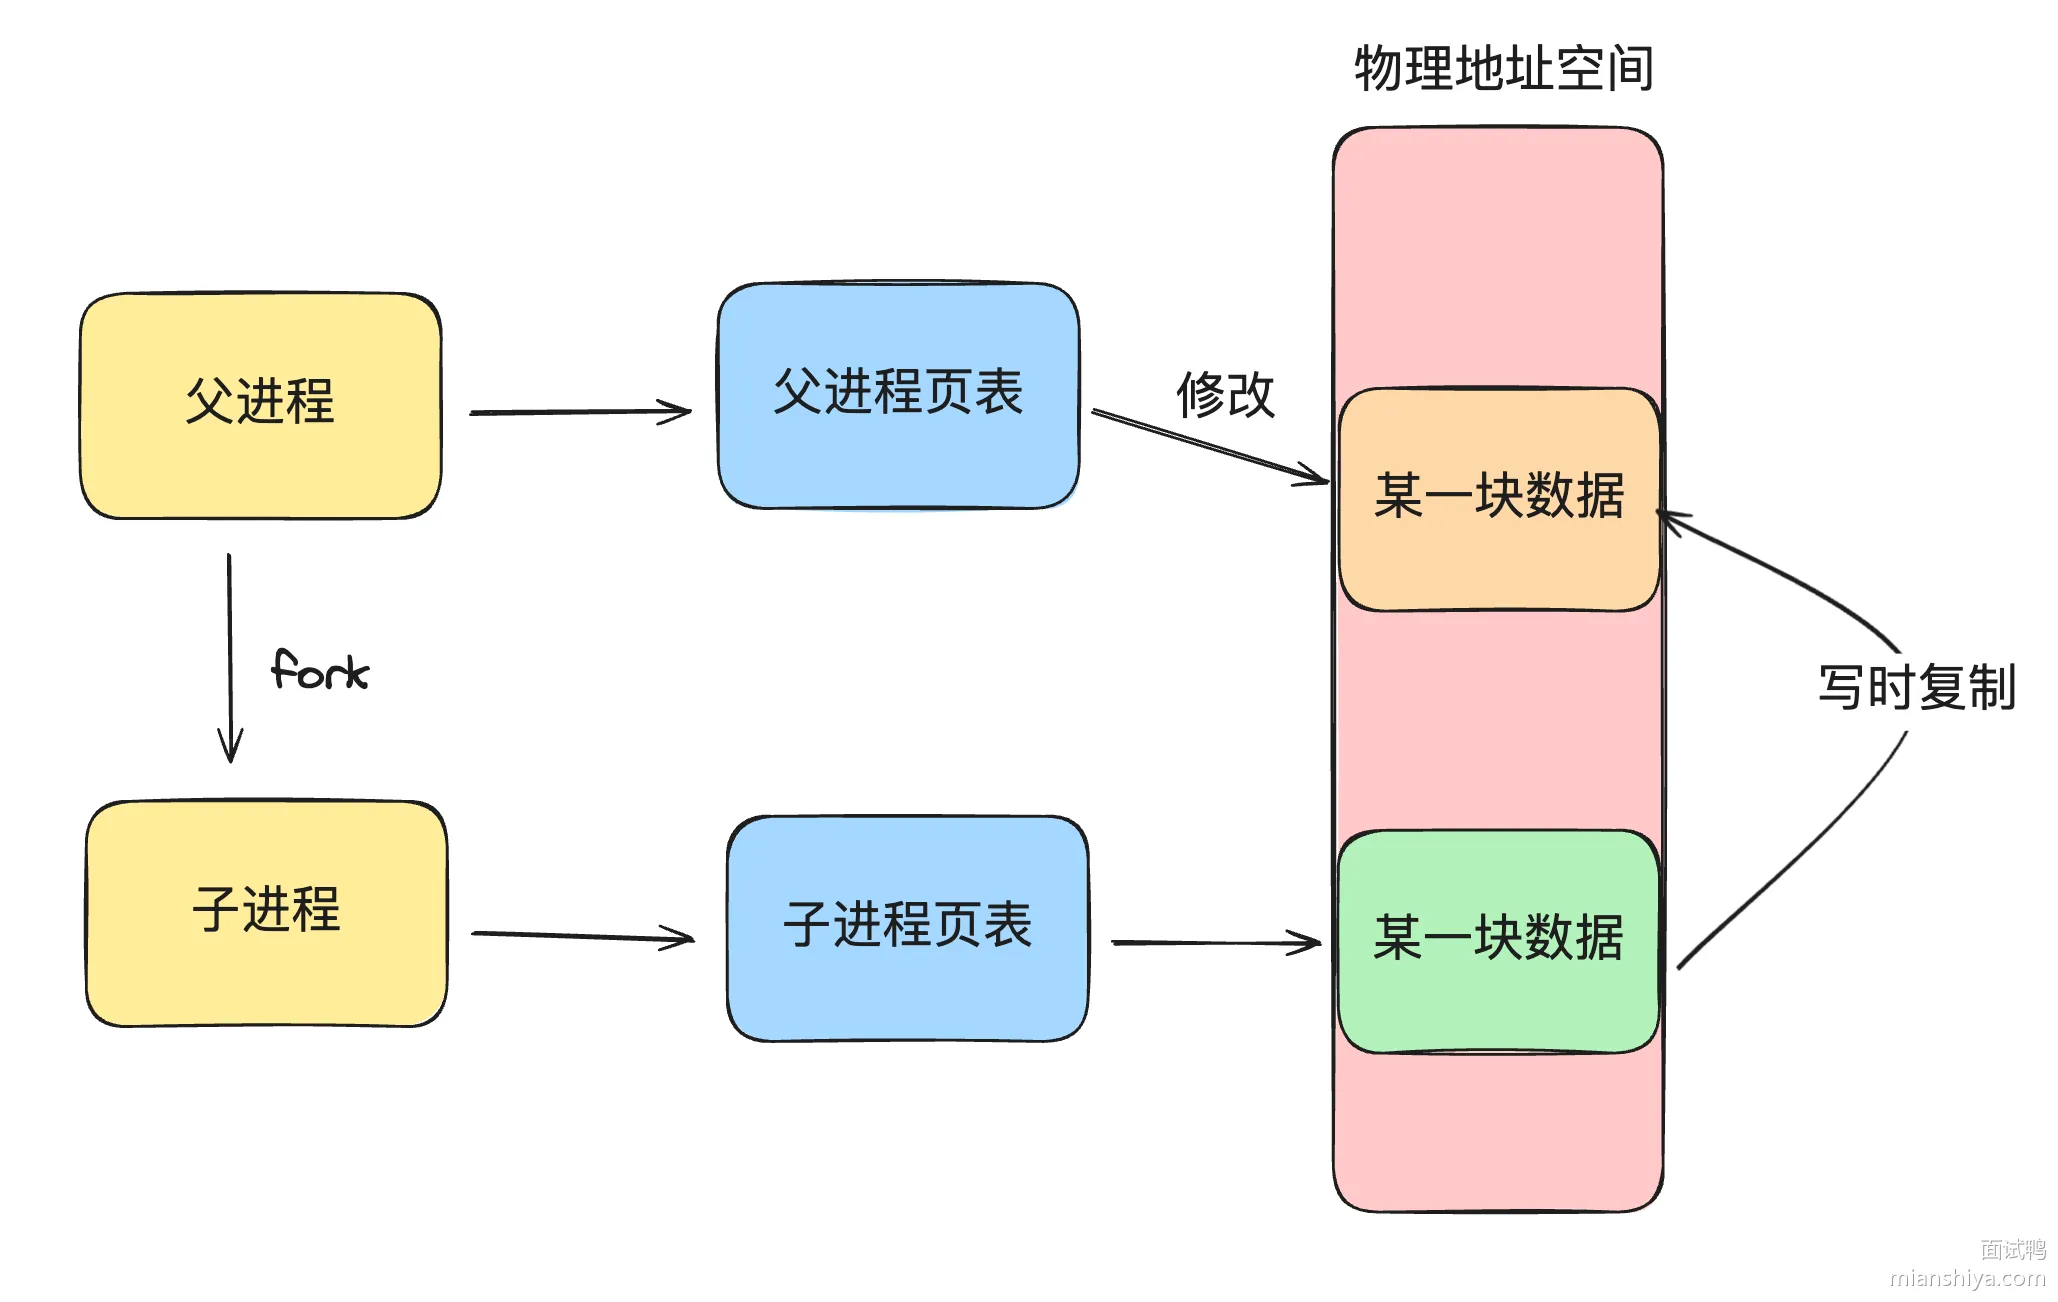
这样子进程写出去的 RDB 文件就是 fork 那一刻的数据快照,不会被后续的写操作污染。
总结原理:
18.2.2. 高峰期做 RDB 的坑
虽然 fork + 写时复制看起来很美好,但高峰期做 RDB 还是有风险的:
1)内存膨胀:如果写并发很高,极端情况下每一页都被改过,内存占用就会翻倍。假设你 Redis 用了 16GB,最坏情况下要预留 32GB 内存
2)磁盘 I/O 压力:子进程要把整个数据集写到磁盘,10GB 的数据集写一次 RDB 可能要几十秒到几分钟。这期间磁盘 I/O 被占满,会影响 AOF 刷盘和其他系统进程
3)fork 阻塞:fork 虽然只复制页表,但数据量大的时候(比如 20GB+ 的实例),fork 本身也要几十毫秒甚至上百毫秒,这段时间主进程完全卡住
所以生产环境通常把 bgsave 放到凌晨低峰期跑,或者用从节点来做 RDB,主节点专心处理请求。
18.3. 常见问题
18.3.1. fork 的时候为什么会阻塞主进程?不是说只复制页表吗?
页表也是有大小的。Redis 用的是虚拟内存,每个内存页通常是 4KB,如果 Redis 占了 20GB 内存,页表本身就有几十 MB。内核要把这几十 MB 的页表复制一份给子进程,这个过程主进程必须暂停。数据量越大,页表越大,阻塞时间越长。实测 20GB 的实例 fork 一次大概要 50-100ms。
18.3.2. 如果 RDB 生成到一半机器挂了怎么办?
没关系,Redis 写 RDB 是先写临时文件,写完后再 rename 成正式的 dump.rdb。rename 是原子操作,要么成功要么失败,不会出现写到一半的损坏文件覆盖掉老文件的情况。机器重启后还是加载上一次完整的 RDB。
18.3.3. bgsave 和 save 有什么区别?生产上用哪个?
save 是同步的,主进程亲自干活,生成期间完全不响应任何请求。bgsave 是后台异步的,fork 子进程去干。生产上必须用 bgsave,用 save 等于把服务停了。save 只适合运维做紧急备份、或者关机前确保数据落盘这种场景。
19. Redis 的哨兵机制是什么?
19.1. 核心要点
Redis Sentinel 就是一套 高可用监控系统,专门盯着主从集群,主节点挂了能自动把从节点提上来顶替,客户端也能自动感知到新主节点的地址。
它干三件事:
1)监控:每秒给所有 Redis 节点发 PING,看谁没响应 2)故障转移:主节点挂了,从从节点里选一个升级成新主节点 3)通知:把新主节点的地址推送给客户端和其他从节点
典型的哨兵架构长这样:
- 3 个哨兵节点组成集群,互相通信
- 1 个 Redis 主节点处理写请求
- 2 个 Redis 从节点做读请求和数据备份
- 哨兵节点监控所有 Redis 节点的状态
- 主节点挂了,哨兵选出新主节点并通知客户端
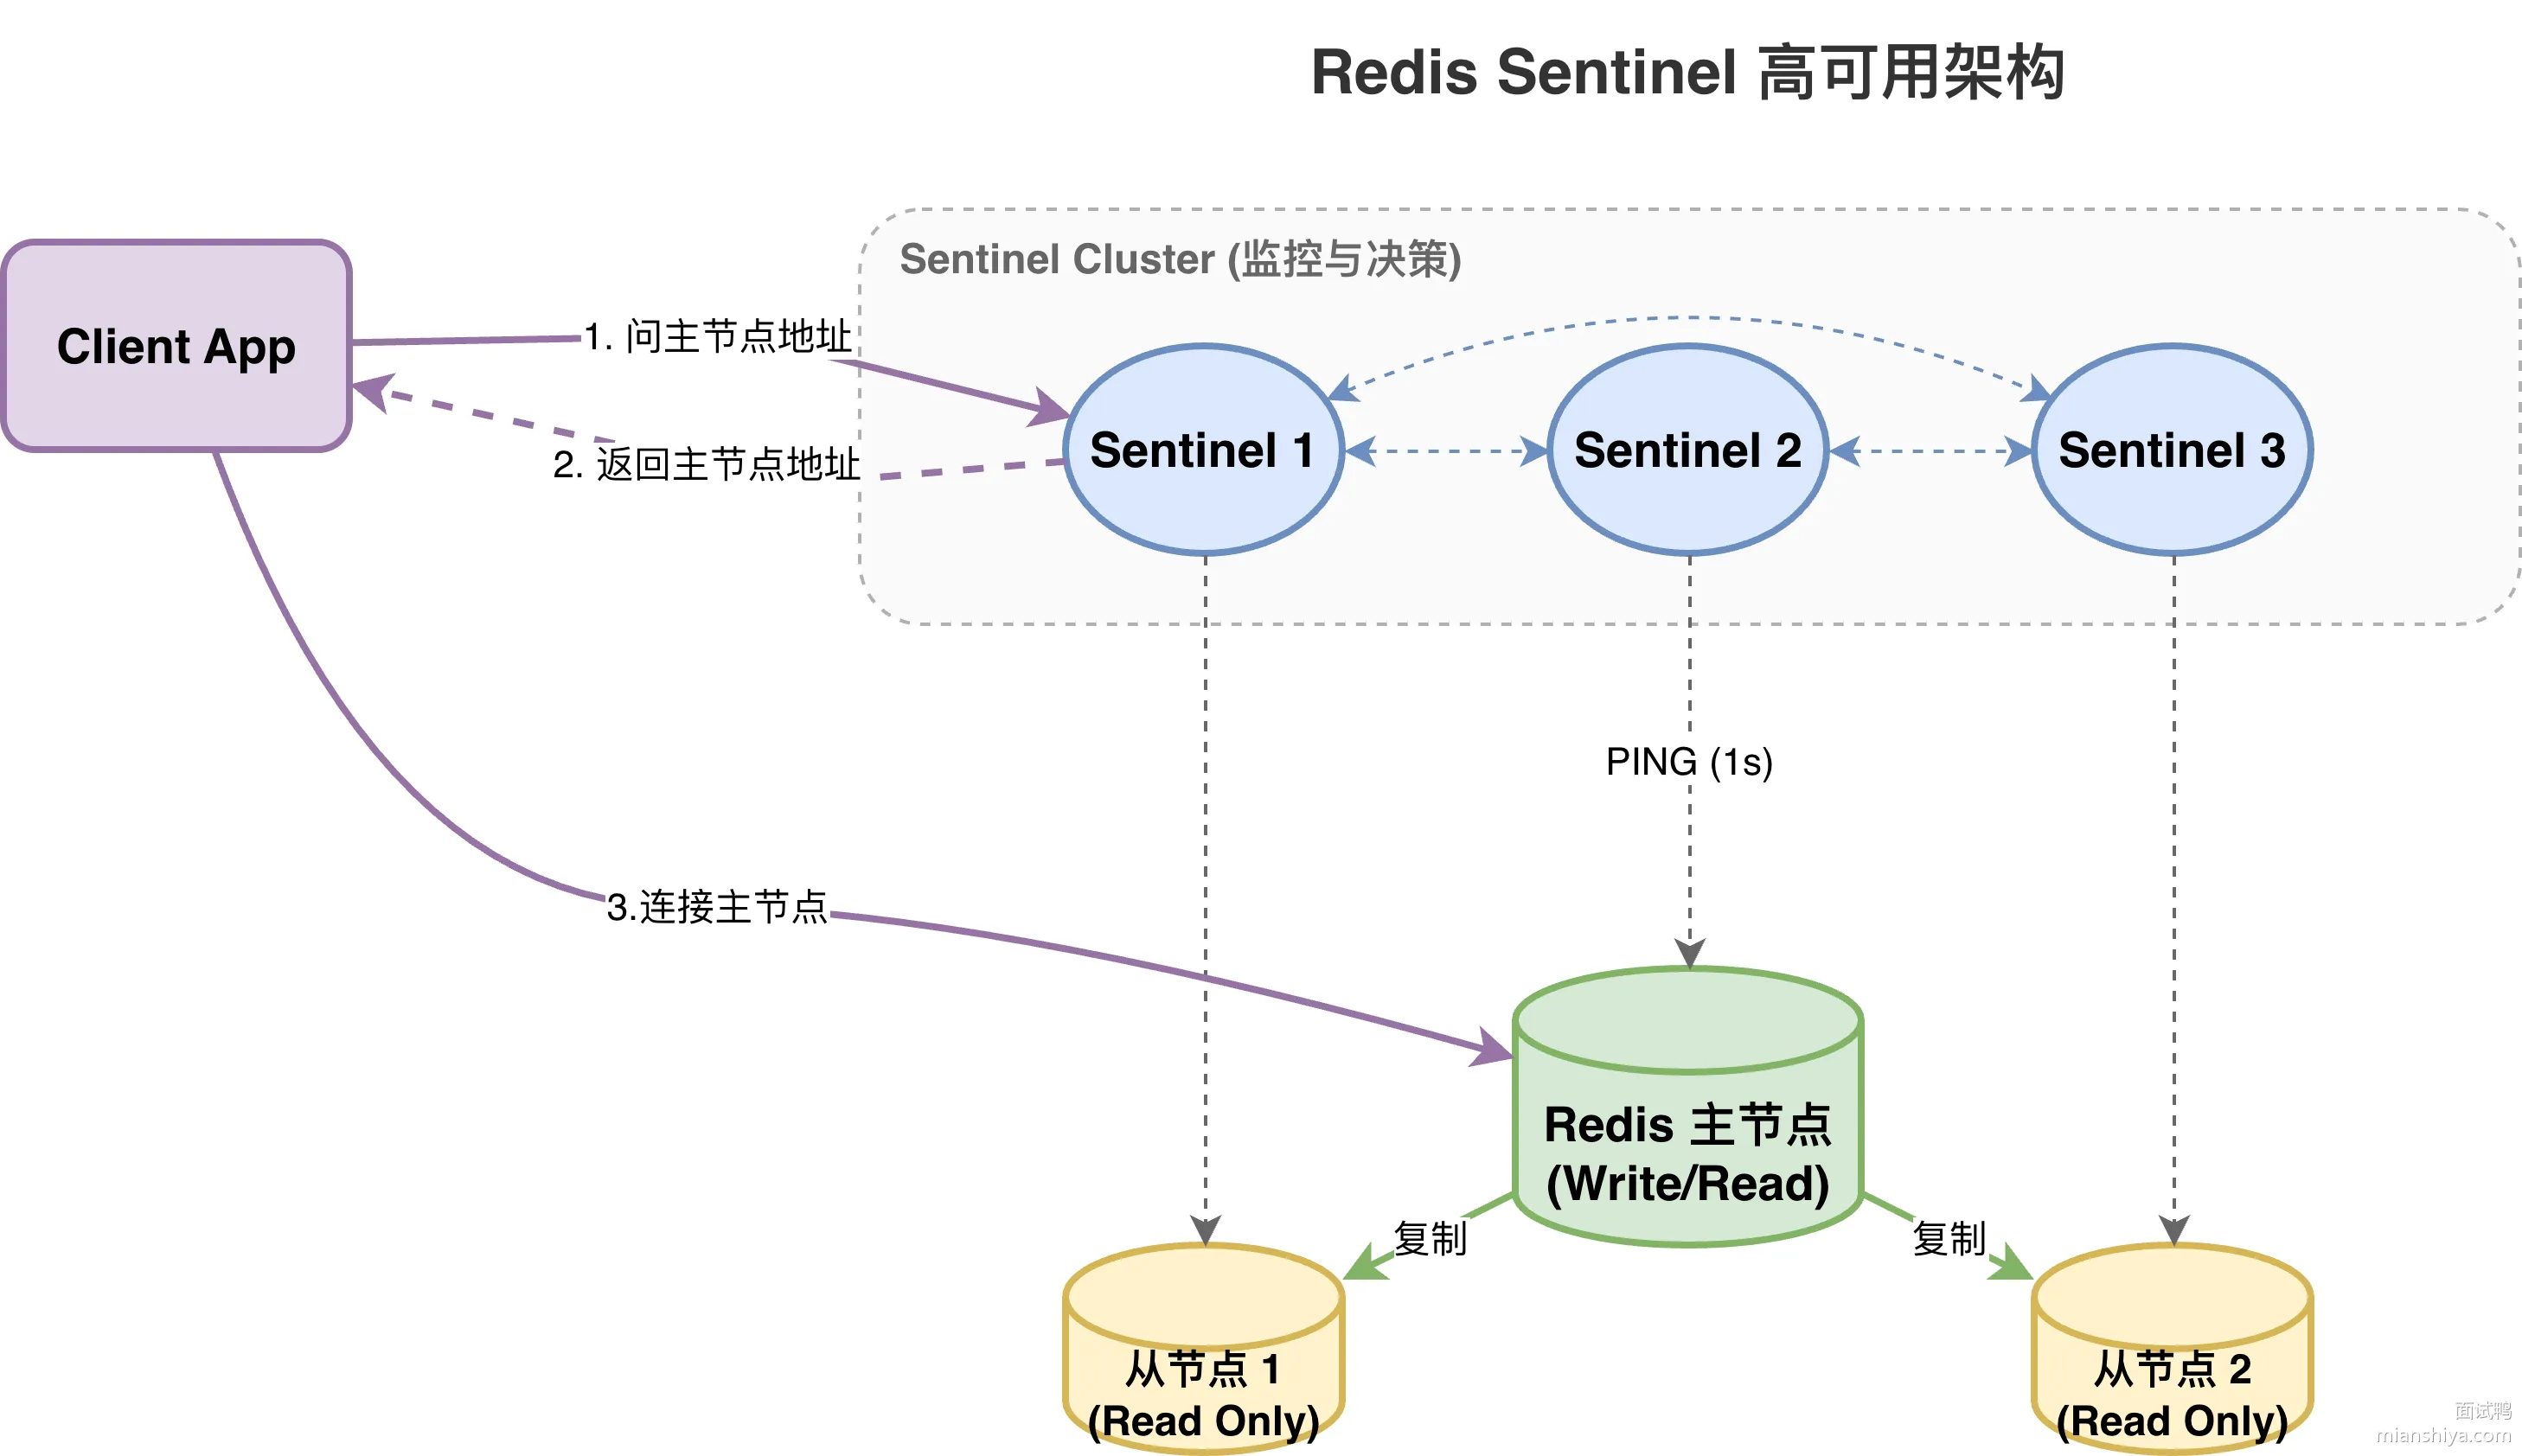
生产环境至少部署 3 个哨兵节点,单数个,这样投票的时候不容易出现平票。
19.2. 扩展知识
19.2.1. 为什么需要哨兵
主从架构做读写分离的时候,主节点负责写,从节点负责读。假如主节点挂了,没有自动切换机制的话,写请求就全部报错,得运维半夜爬起来手动切换,少说也要几分钟到十几分钟。
哨兵就是为了解决这个问题:主节点挂了,1-2 秒内就能自动完成切换,把某个从节点提升成新主节点,客户端自动重连到新主节点,业务几乎无感知。
19.2.2. 怎么判断主节点挂了
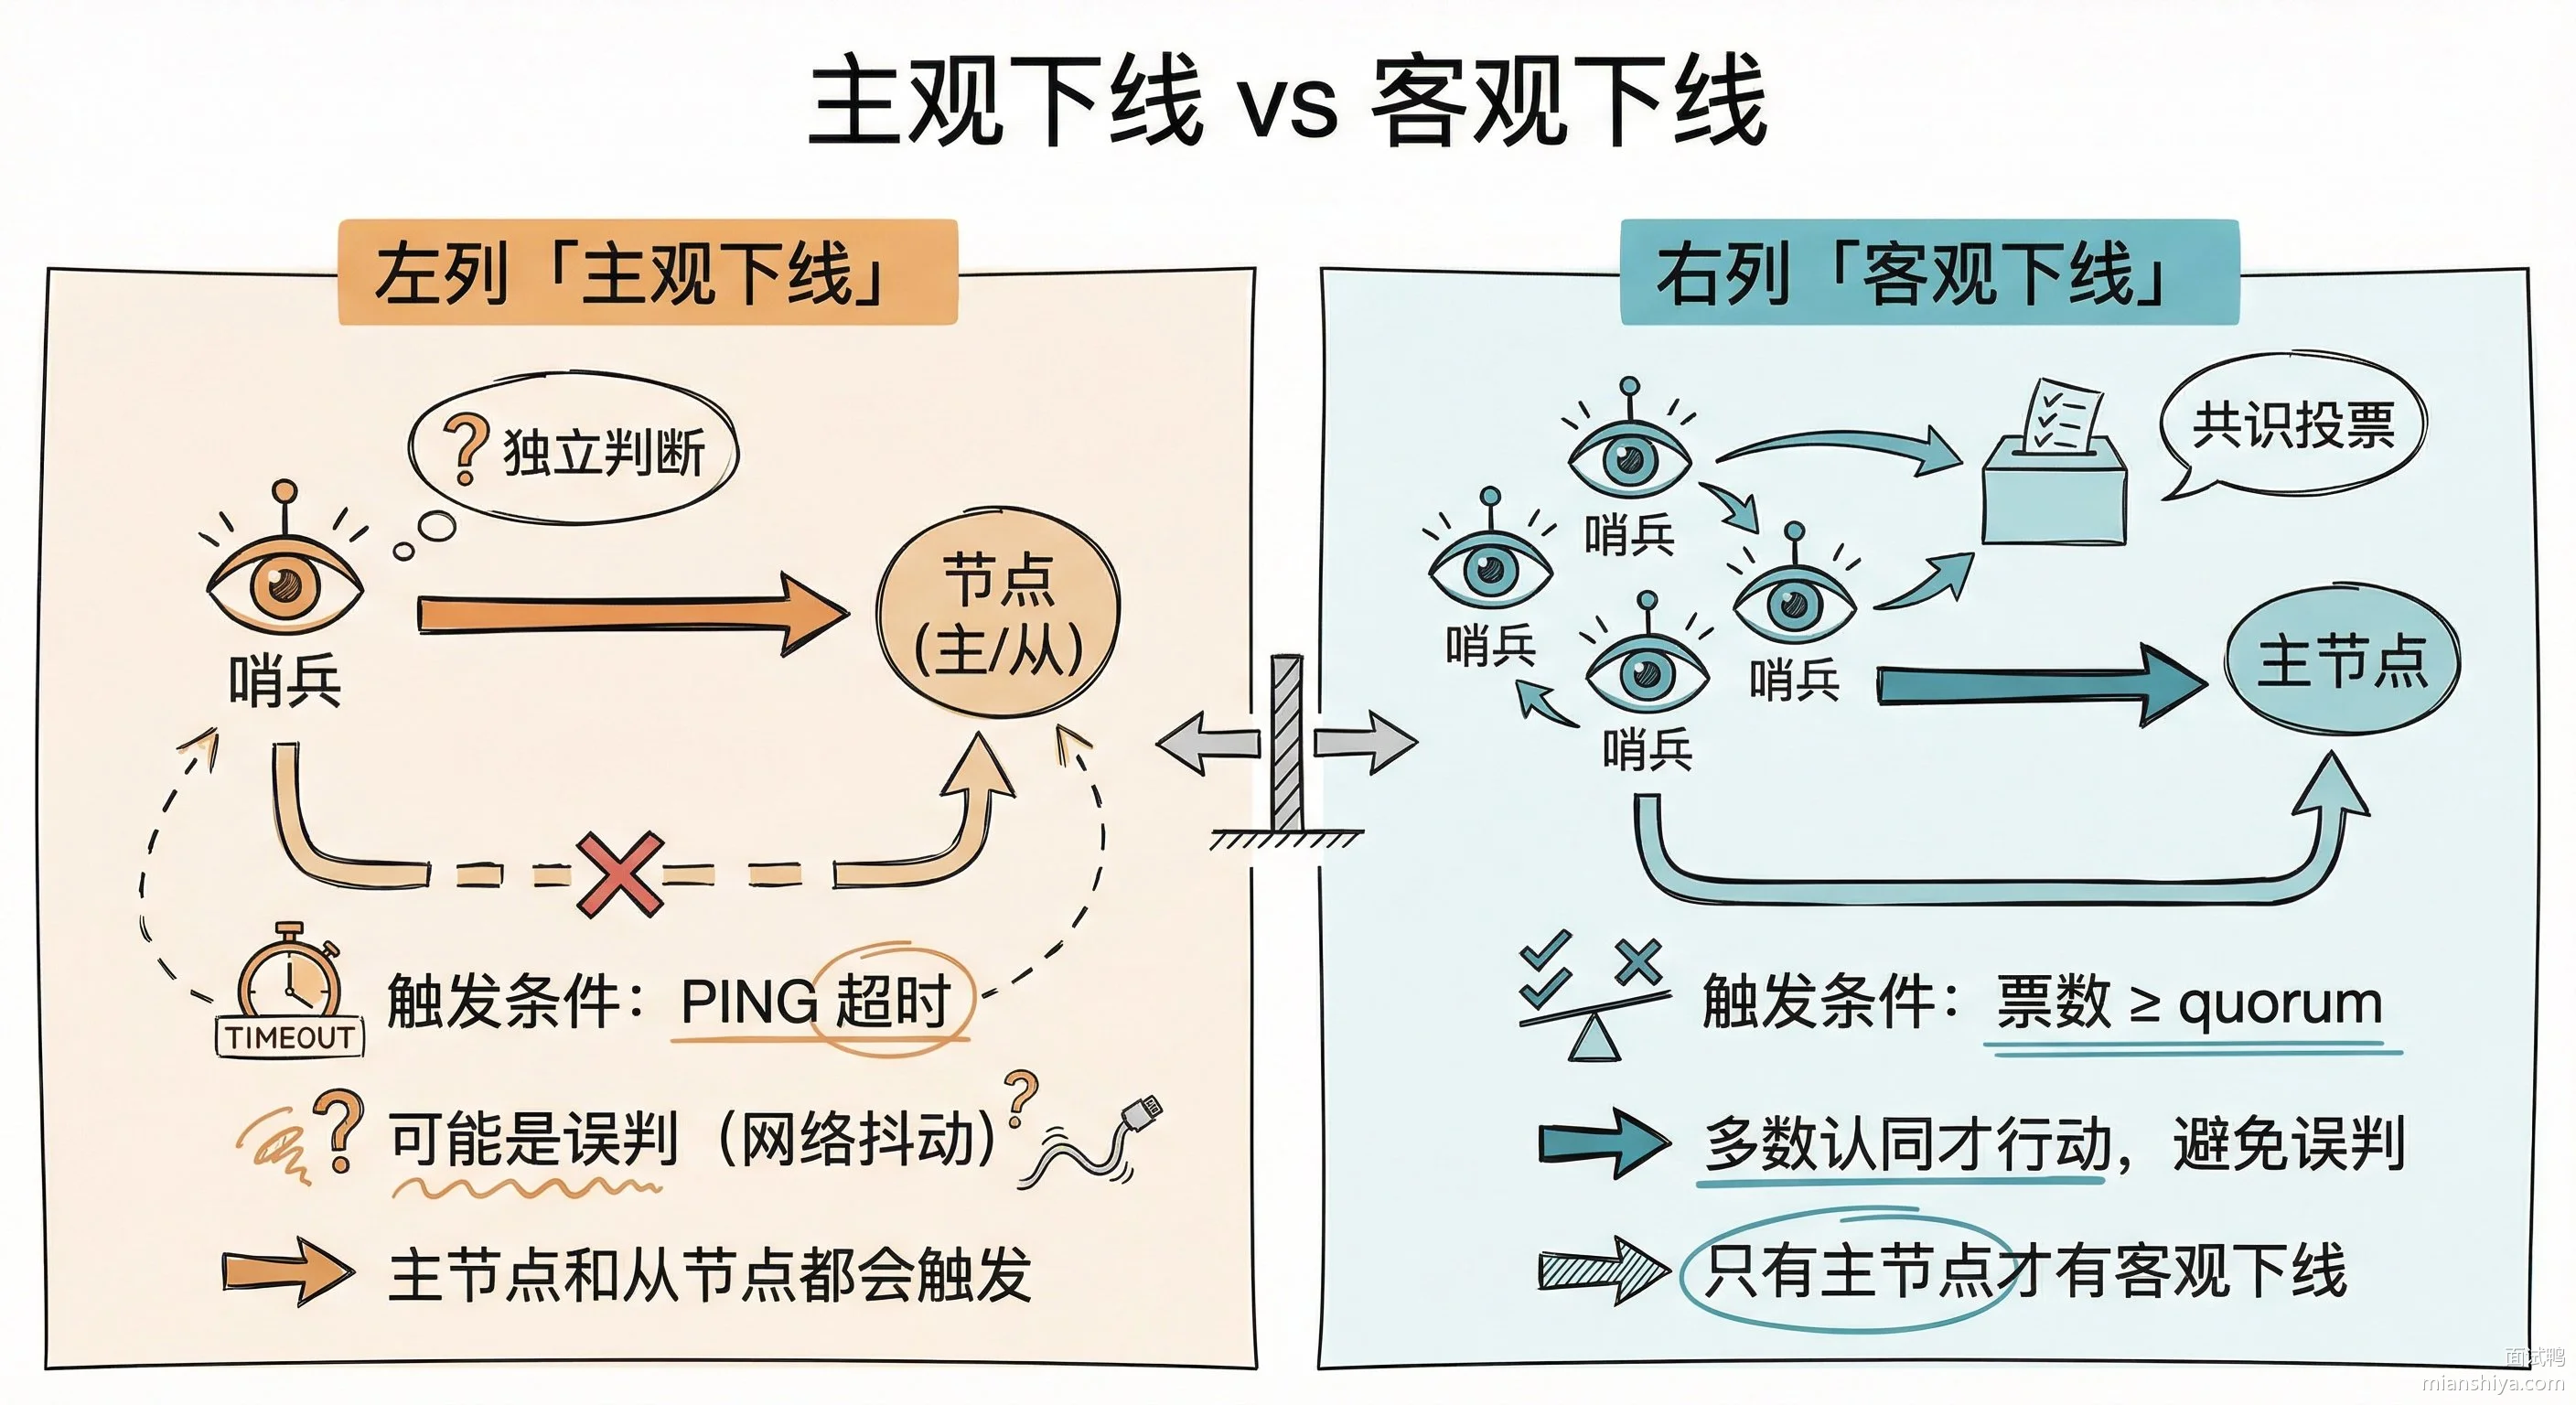
哨兵判断节点下线分两步:主观下线 和 客观下线。
主观下线:单个哨兵的判断
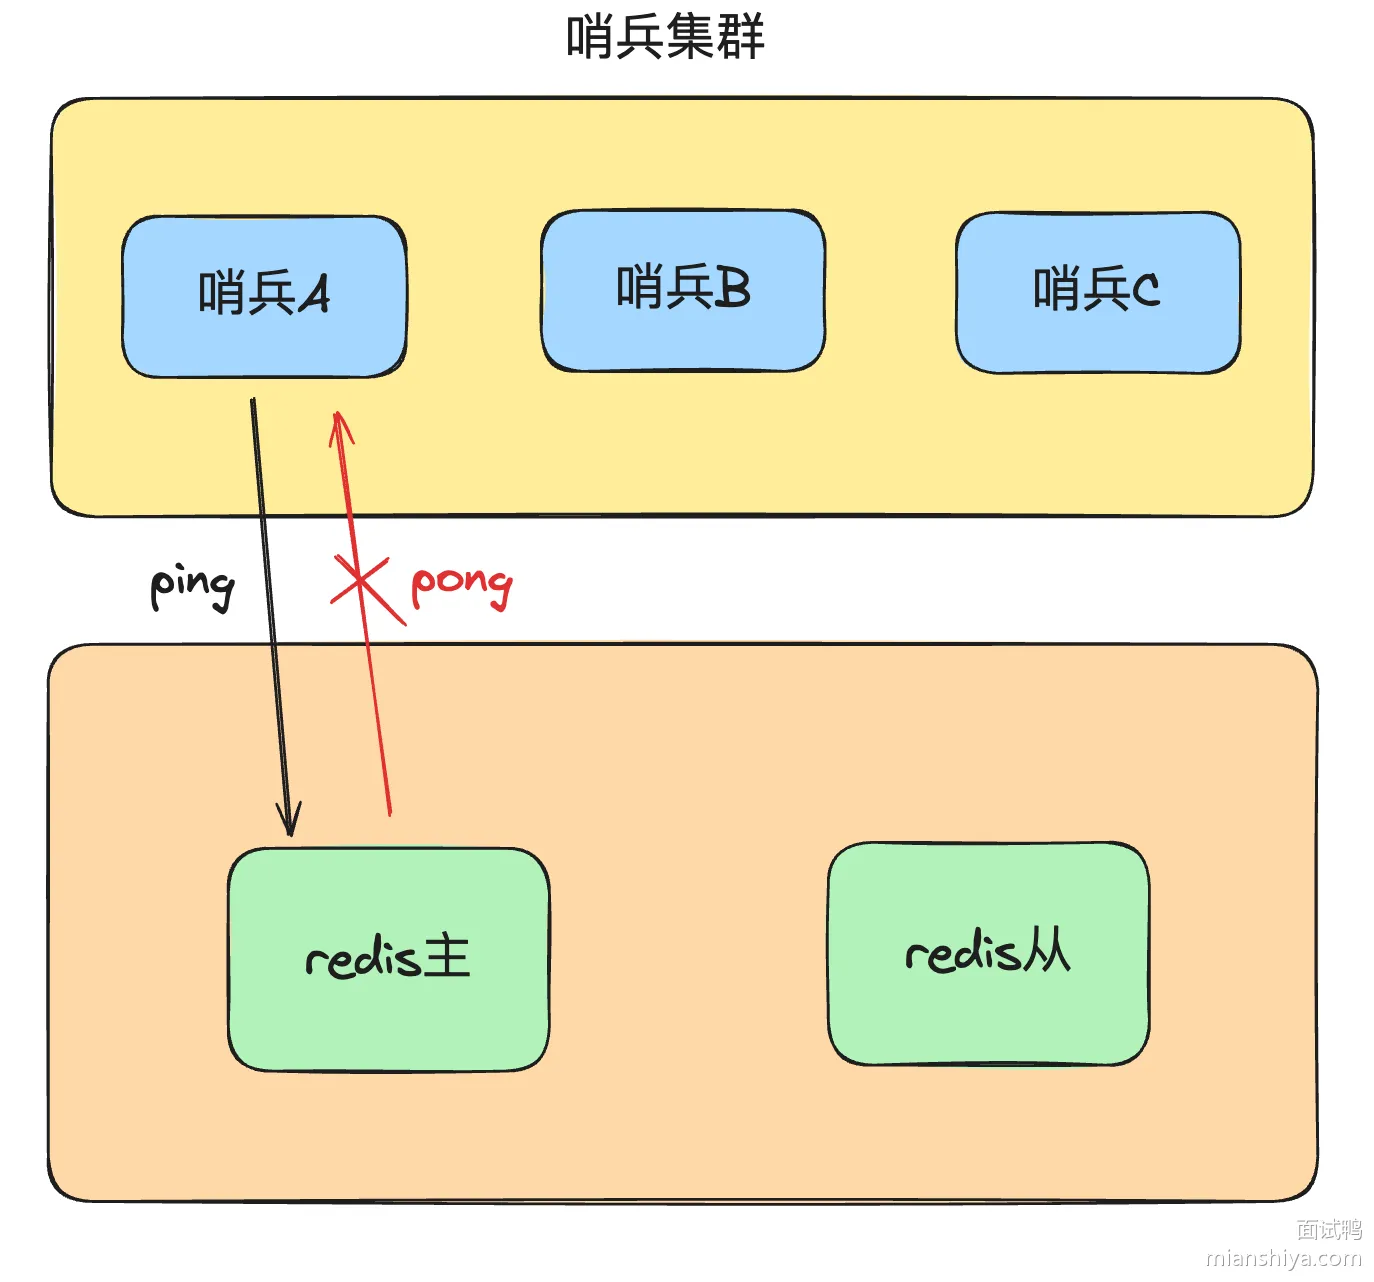
每个哨兵每隔 1 秒给所有节点发 PING,如果超过 down-after-milliseconds 配置的时间还没收到 PONG,这个哨兵就认为该节点主观下线了。这个超时时间默认是 30 秒,生产上一般设成 5-10 秒。
客观下线:多个哨兵达成共识
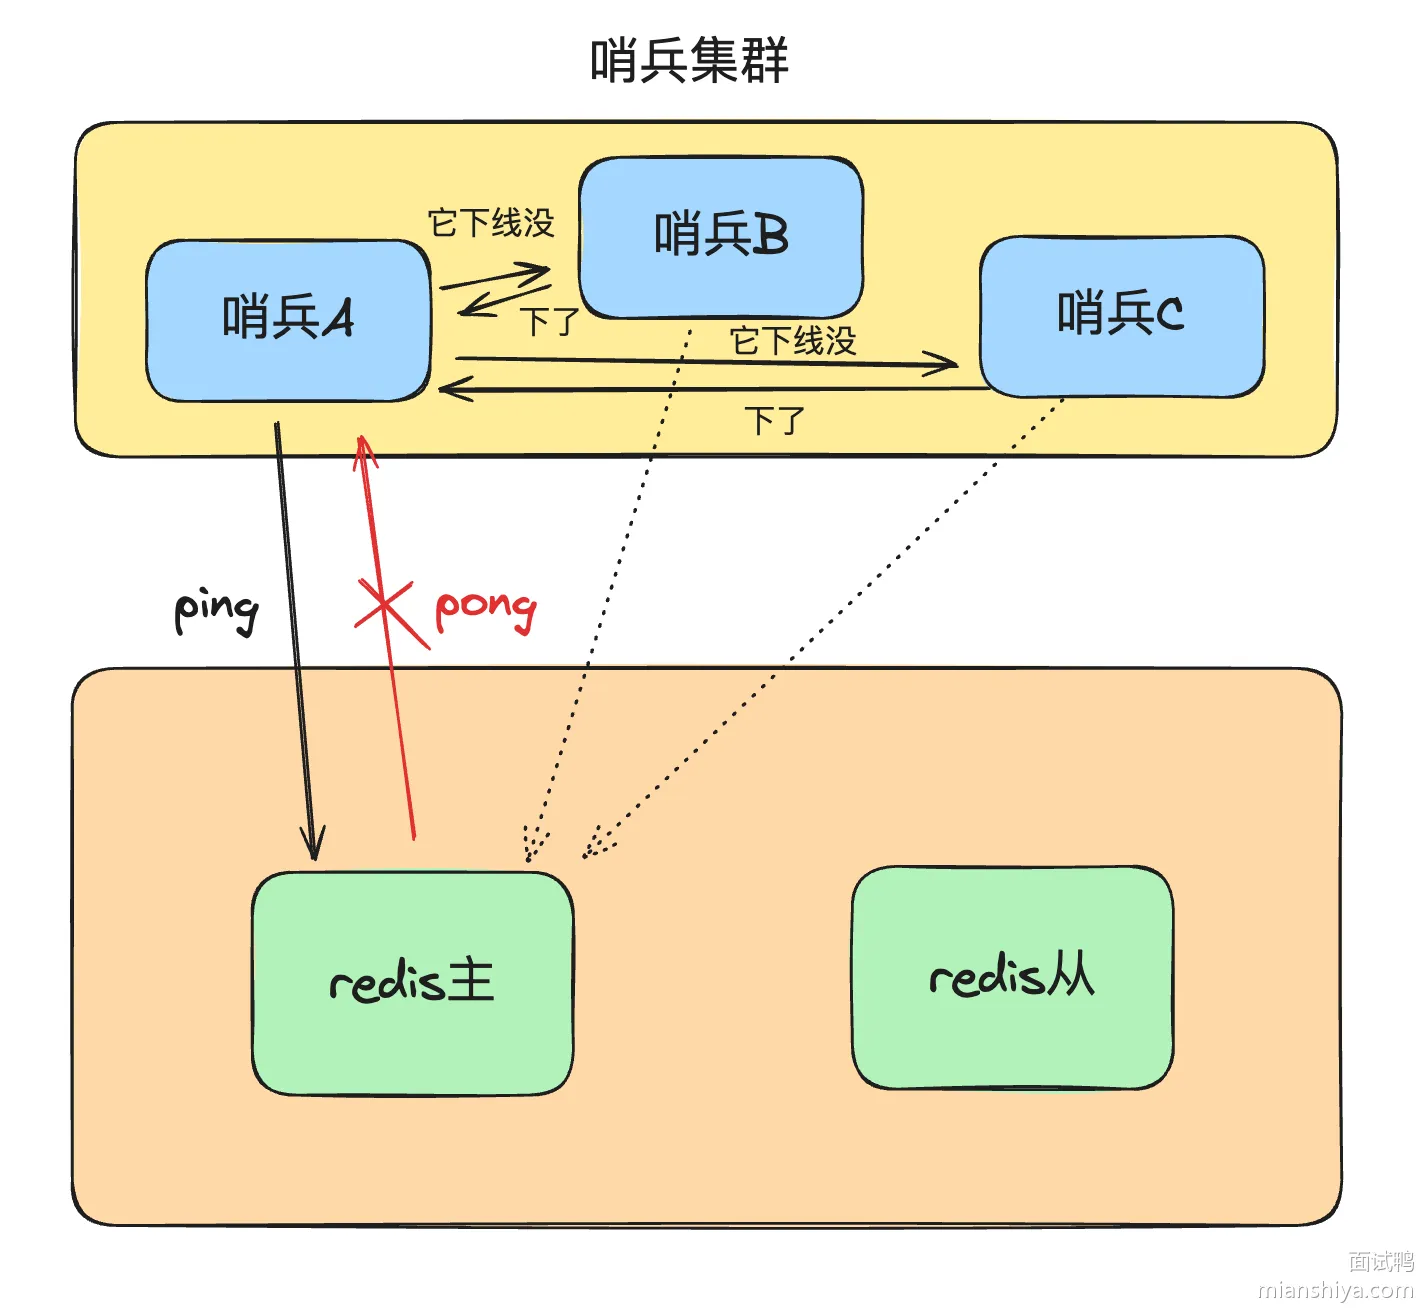
一个哨兵说主节点挂了,可能是网络抖动导致的误判。所以这个哨兵会问其他哨兵:"你们觉得主节点挂没挂?"
其他哨兵收到询问后,也会检查主节点状态,然后投票。如果投"挂了"的票数达到 quorum 值,就认定主节点客观下线,开始走故障转移流程。quorum 一般配成哨兵总数的一半加一,3 个哨兵就配 2。
19.2.3. 哨兵 Leader 选举
确定主节点客观下线后,得选一个哨兵出来主持故障转移,这个哨兵叫 Leader。
选举用的是 Raft 算法的思路:
1)第一个发现主节点主观下线的哨兵成为候选者,先投自己一票 2)然后向其他哨兵拉票:"投我当 Leader" 3)每个哨兵手里只有一票,谁先来就投谁,投完就不能改了 4)候选者拿到半数以上的票就当选 Leader
如果同时有两个哨兵发起选举,可能出现平票。这时候会等一个随机时间后重新选举。所以哨兵节点数要配成奇数,减少平票概率。
19.2.4. 新主节点怎么选
哨兵 Leader 选出来后,要从剩下的从节点里挑一个当新主节点。选择标准按优先级排:
1)先看 slave-priority 配置值,值越小优先级越高,0 表示永不参选 2)priority 相同就看复制偏移量 offset,offset 越大说明数据越新 3)offset 也相同就比 run_id,选 ID 最小的那个
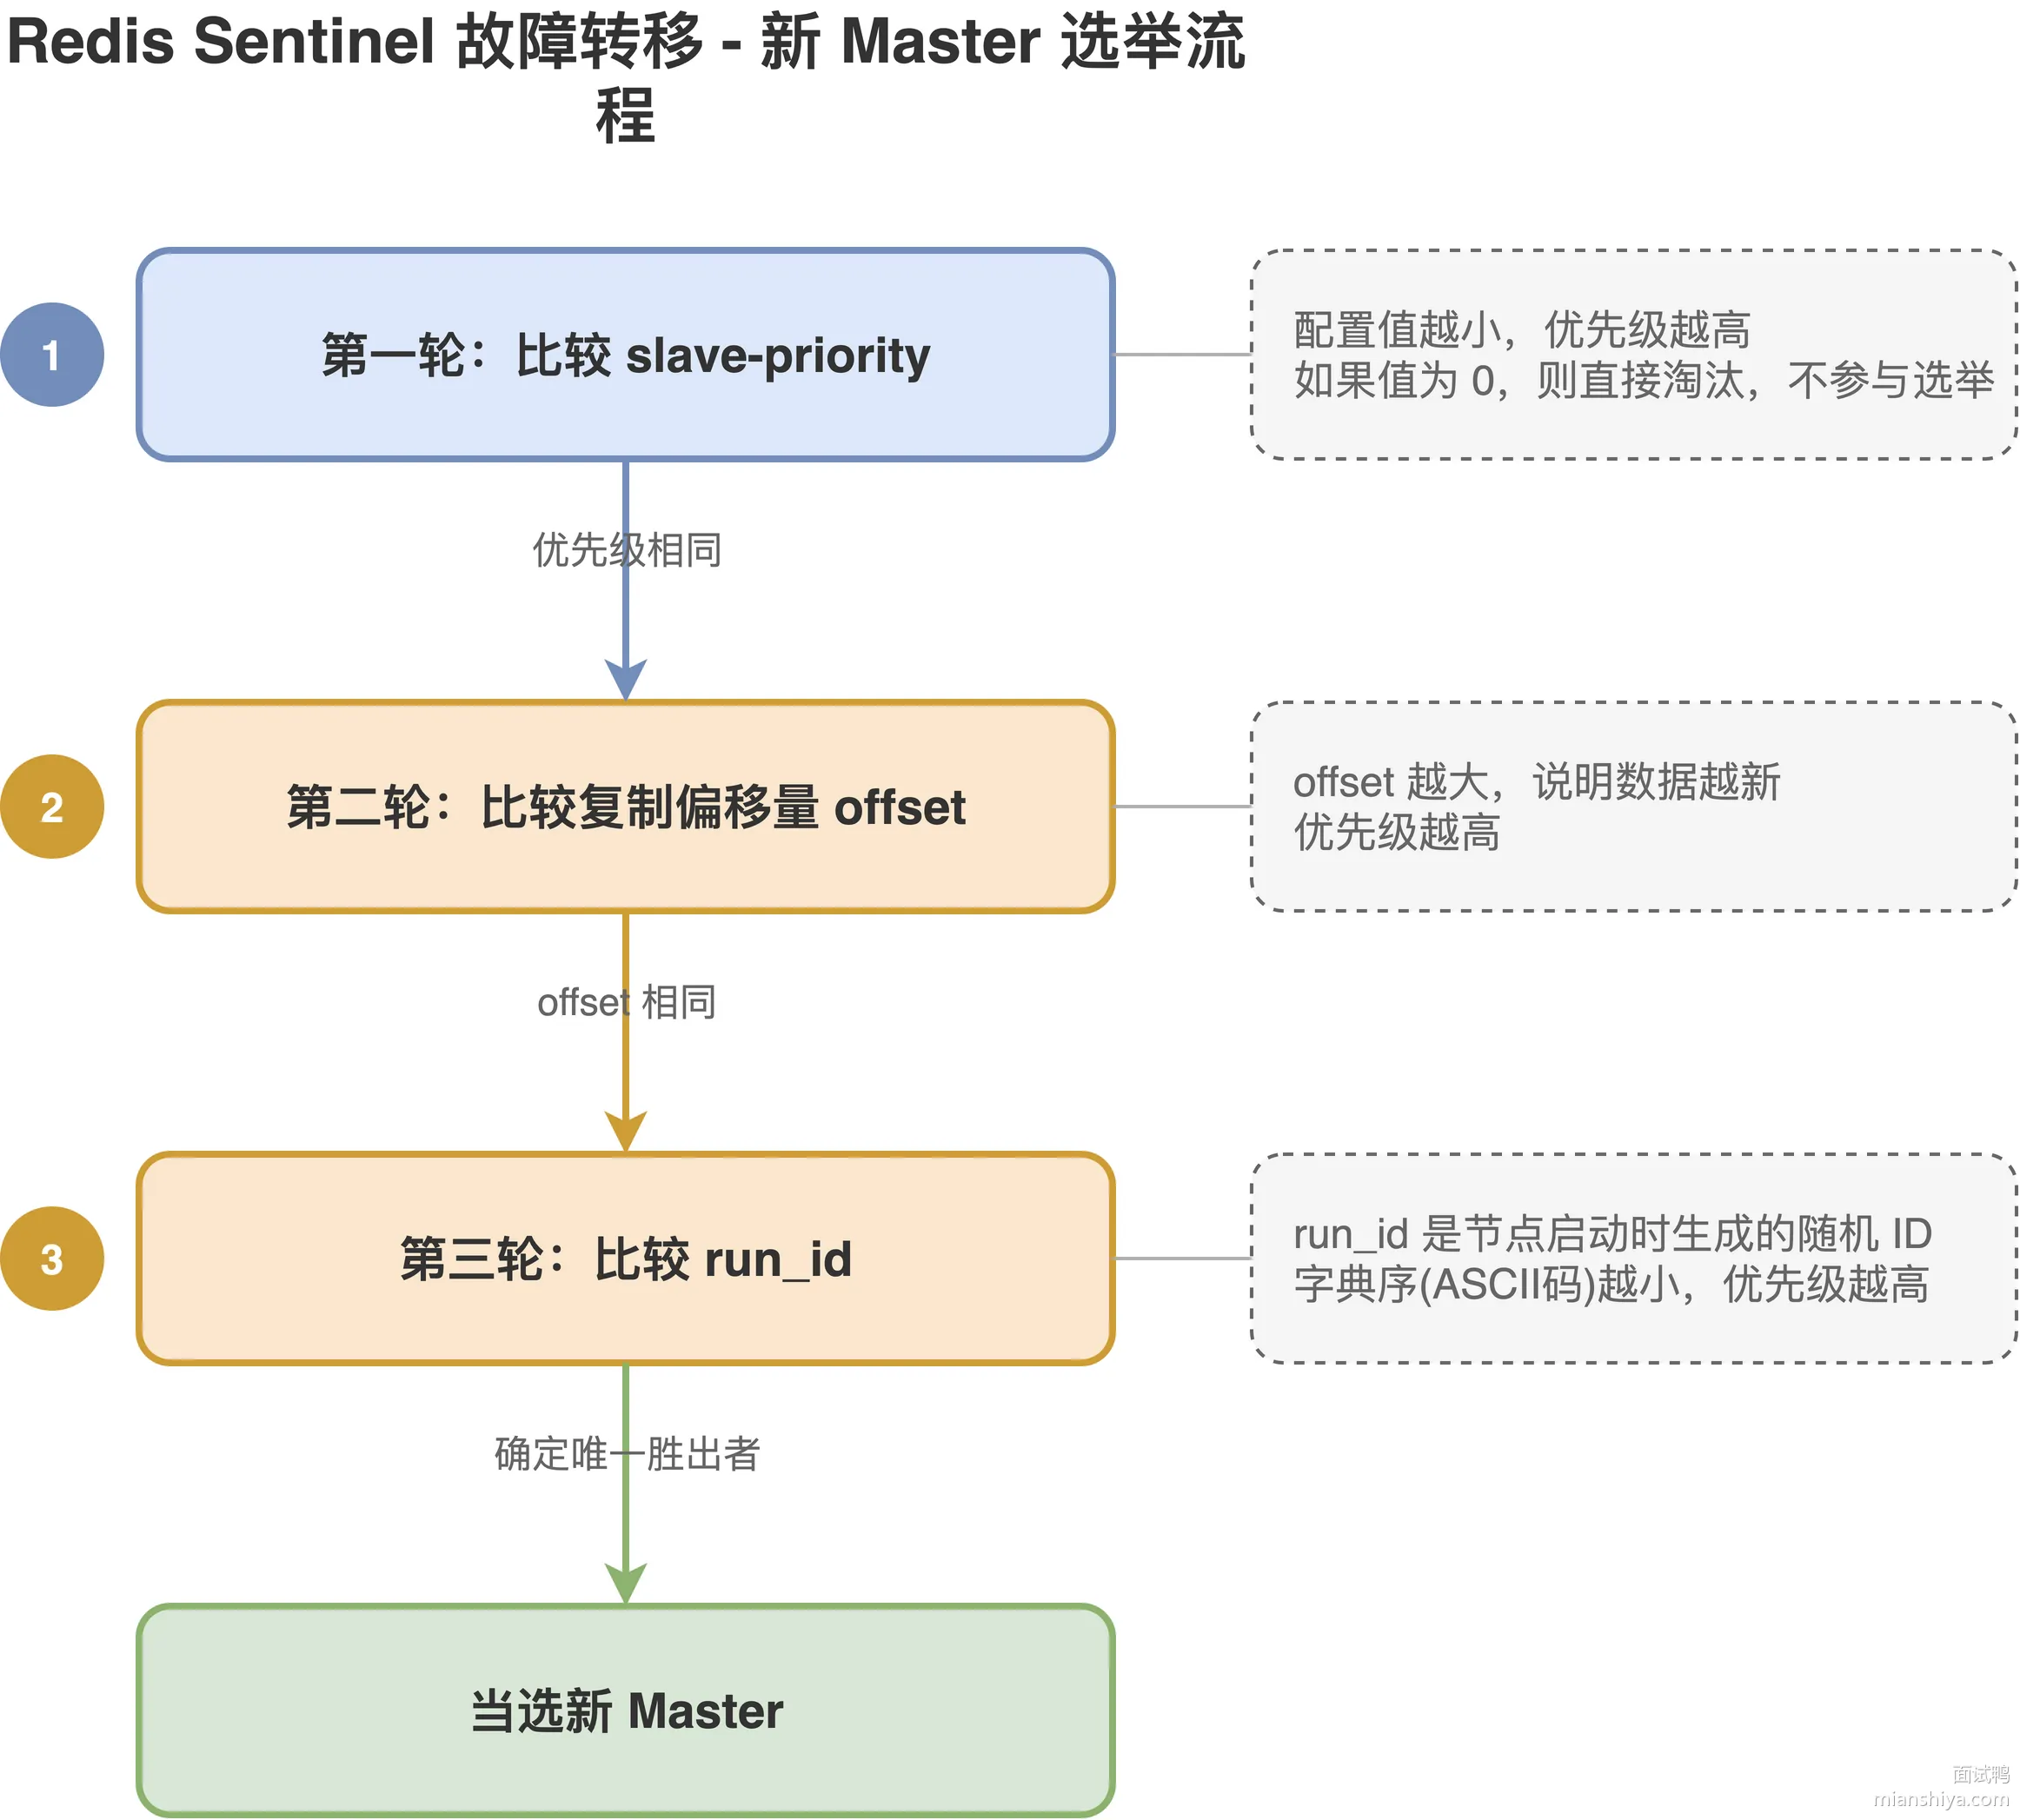
选好新主节点后,哨兵 Leader 会:
1)给新主节点发 SLAVEOF NO ONE,让它不再是任何人的从节点 2)给其他从节点发 SLAVEOF 新主节点IP 端口,让它们跟新主节点同步 3)通过发布订阅机制把新主节点地址推给客户端
19.2.5. 老主节点恢复了怎么办
假如老主节点只是网络闪断,过一会儿又好了,哨兵会给它发 SLAVEOF 命令,让它变成新主节点的从节点。不会出现双主的情况。
19.3. 常见问题
19.3.1. 哨兵为什么要配成奇数个?配 2 个行不行?
2 个不行。首先客观下线投票要求票数超过 quorum,2 个哨兵的 quorum 至少是 2,意味着必须两个都同意才能判定下线。如果其中一个哨兵自己挂了,另一个就永远凑不够票,故障转移就卡住了。选 Leader 也要求半数以上,2 个里面要 2 票,同样道理。3 个哨兵挂一个还能正常工作,2 个挂一个就彻底瘫痪。
19.3.2. 哨兵模式下客户端是怎么知道主节点地址变了的?
客户端连的是哨兵,不是直接连 Redis。客户端启动时先问哨兵:"现在主节点是谁?" 哨兵告诉它地址,客户端再去连 Redis。主节点切换后,哨兵会通过发布订阅通道推送新地址。Jedis、Lettuce 这些客户端库都内置了订阅逻辑,收到通知就自动重连新主节点。所以业务代码不用改,客户端库帮你处理了。
19.3.3. 哨兵能保证数据不丢吗?
不能完全保证。主从复制是异步的,主节点写完就返回客户端成功,不等从节点同步完。如果主节点刚写完还没来得及同步就挂了,那这条数据就丢了。可以配置 min-slaves-to-write 和 min-slaves-max-lag 来降低丢数据的概率,要求至少有几个从节点在指定延迟内,否则主节点拒绝写入。但这只是降低概率,不是彻底解决。要强一致可以使用 WAIT 命令等待从节点同步,或者使用其他支持强一致性的存储系统。
20. Redis 集群会出现脑裂问题吗?
20.1. 核心要点
会出现,而且这是分布式系统的经典问题。当发生网络分区时,Redis 集群可能出现多个主节点同时提供写入服务,导致数据不一致。
举个典型场景:假设一个主节点和它的从节点之间网络断了,哨兵检测到主节点失联后会选举一个从节点升级为新主。但原来的主节点其实还活着,只是网络不通而已。这时候就出现了两个主节点,客户端往哪个主写数据都会导致数据不一致。
更麻烦的是,等网络恢复后,旧主节点会被降级为从节点,它会从新主节点同步数据,之前客户端写到旧主的数据就直接丢了。
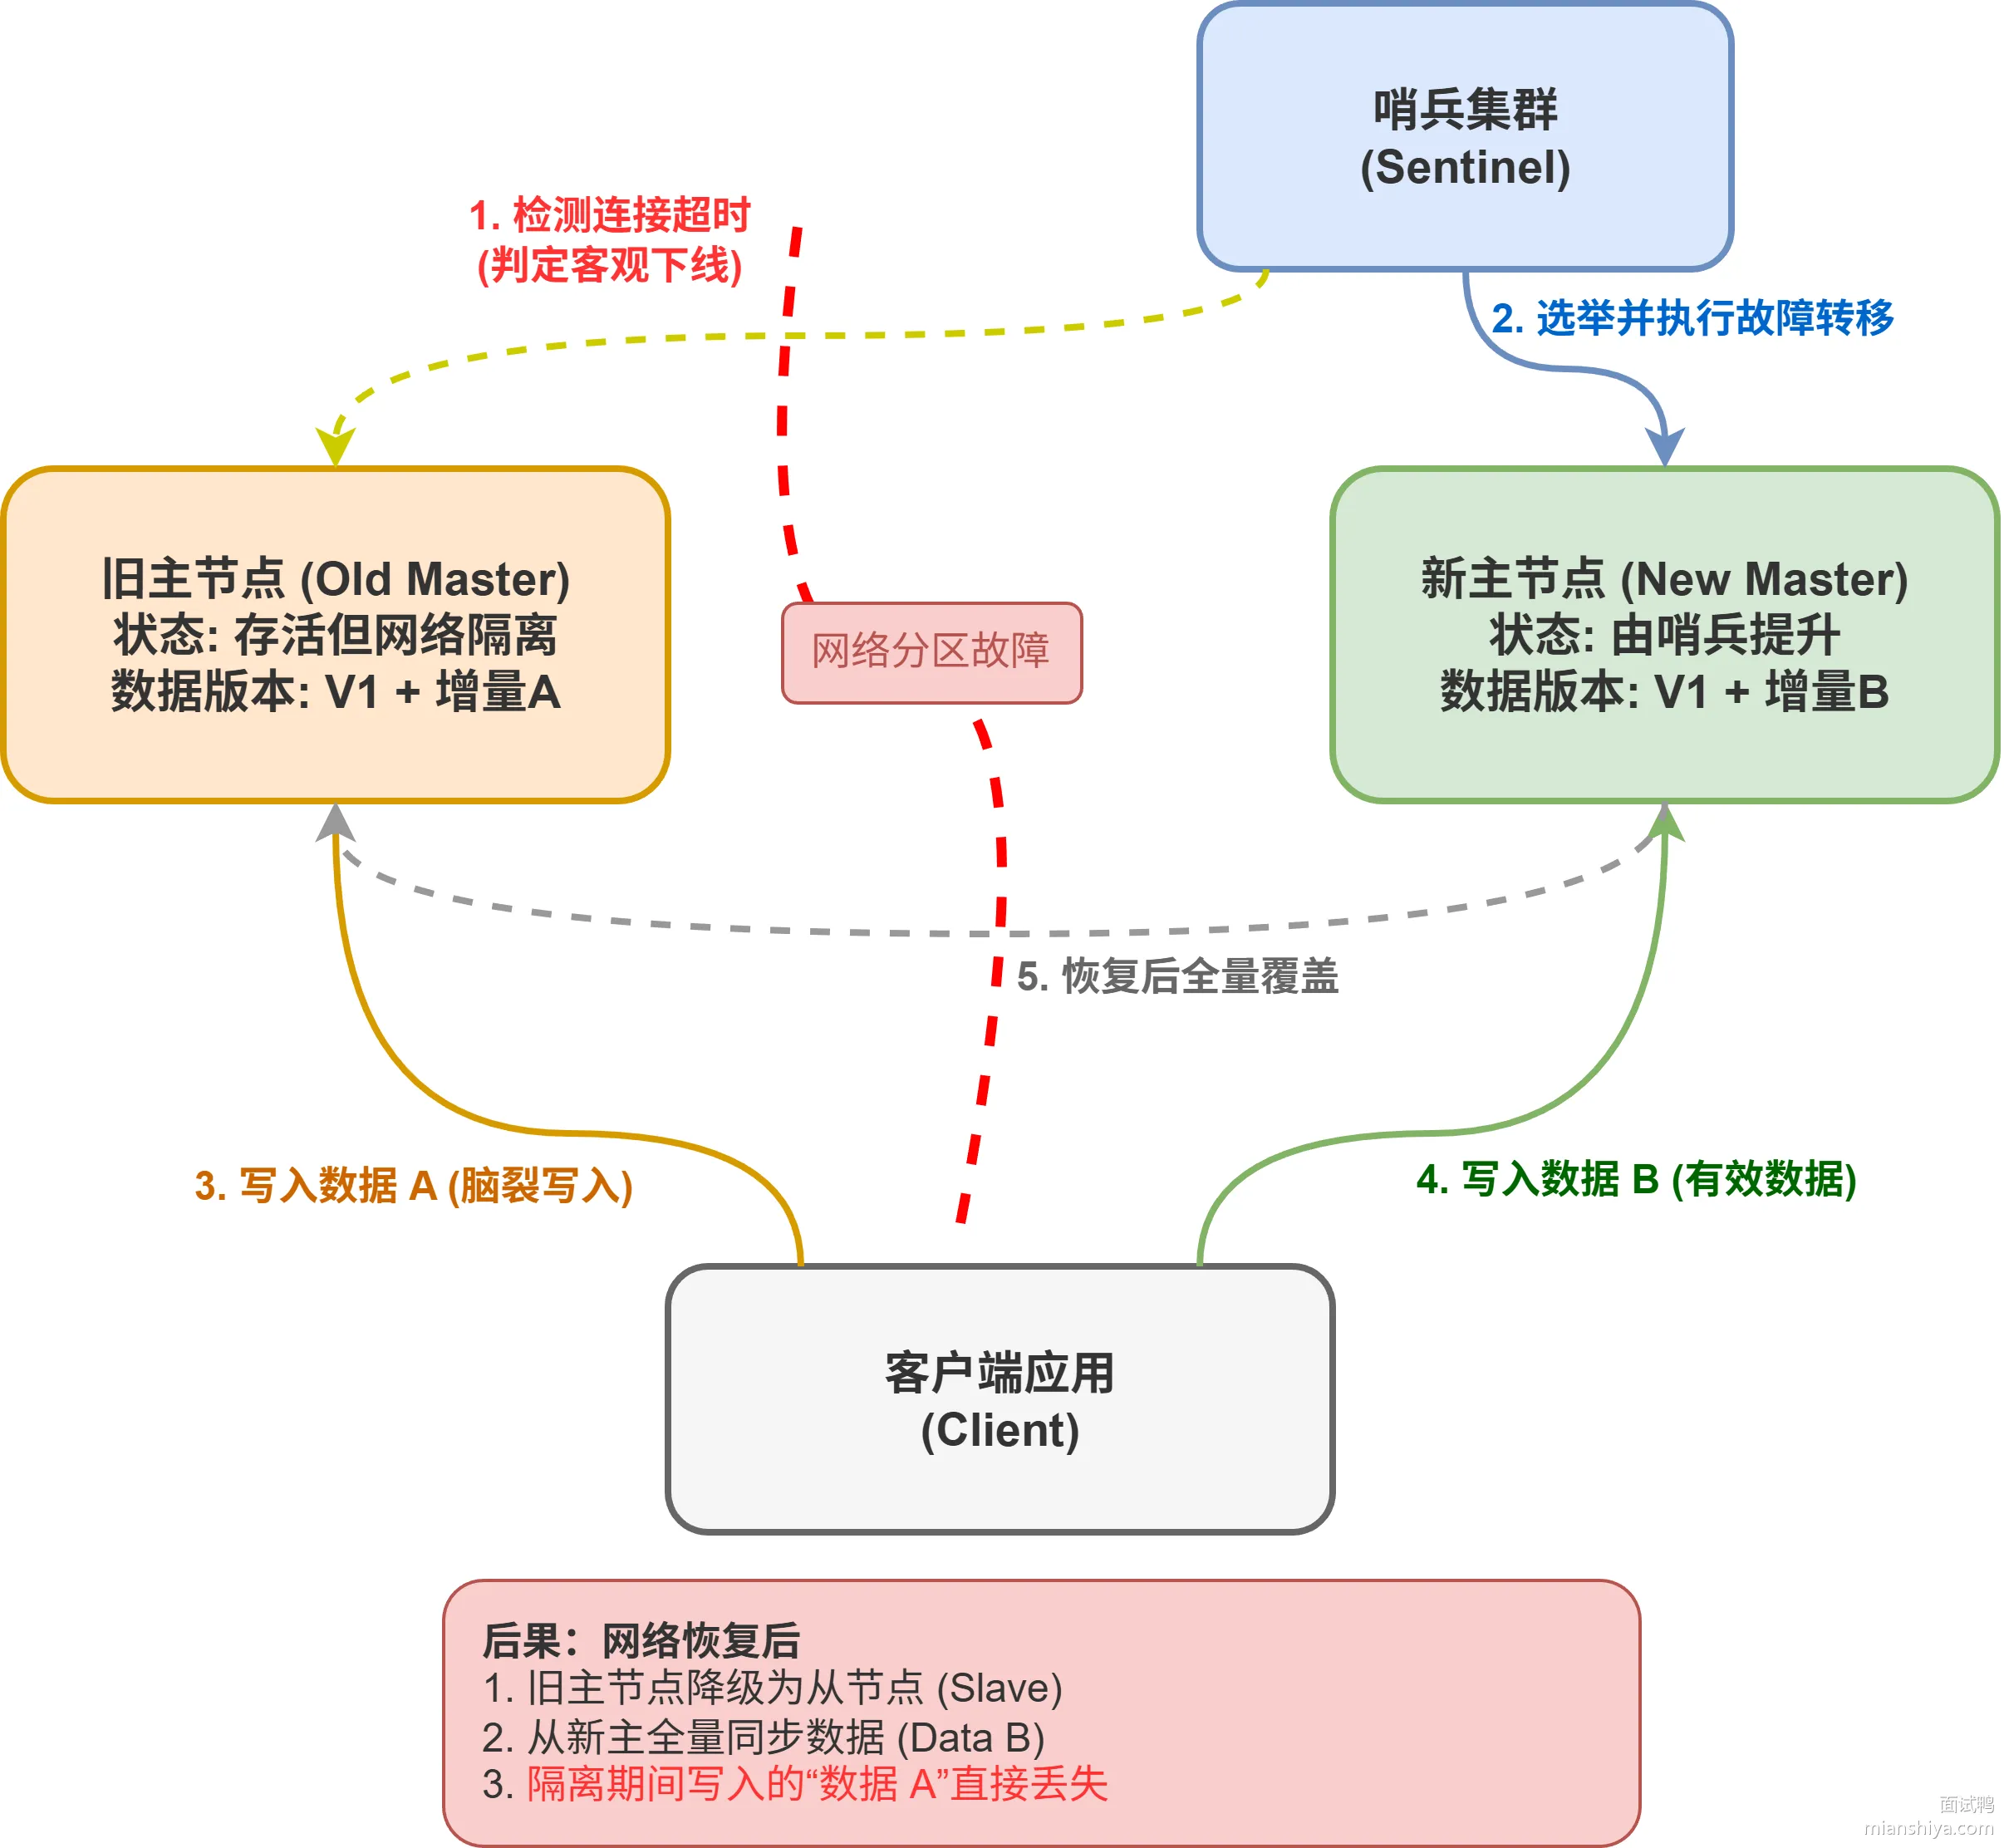
Redis 提供了两个参数来缓解脑裂问题:
min-slaves-to-write:主节点必须有至少 N 个从节点确认才能执行写操作min-slaves-max-lag:从节点最大延迟秒数,超过这个值就不算有效从节点
比如配置 min-slaves-to-write=2 和 min-slaves-max-lag=10,主节点只有在至少 2 个从节点延迟不超过 10 秒时才接受写入。发生脑裂时,被隔离的主节点因为没有足够的从节点,就会拒绝写入。
20.2. 扩展知识
20.2.1. 什么是脑裂
脑裂是分布式系统中一个很形象的比喻。正常情况下,集群只有一个"大脑"在指挥,所有节点步调一致。但如果网络分区把集群劈成两半,每一半都以为自己是完整的系统,各自选出一个大脑来指挥。这就像一个人脑子裂成两半,两边各想各的,做出的决定互相矛盾。
分布式系统就像一个团队在干活,如果发生了脑裂,就好比这个团队因为通信出了问题分成了几个小团体。每个小团体都以为自己是整个团队,都在按自己的方式工作,各自为政,对同一件事有不同的决策和做法。这样一来整个系统就乱套了,数据也变得不一致。
导致脑裂的根本原因就是网络分区。
20.2.2. Redis 中的脑裂过程
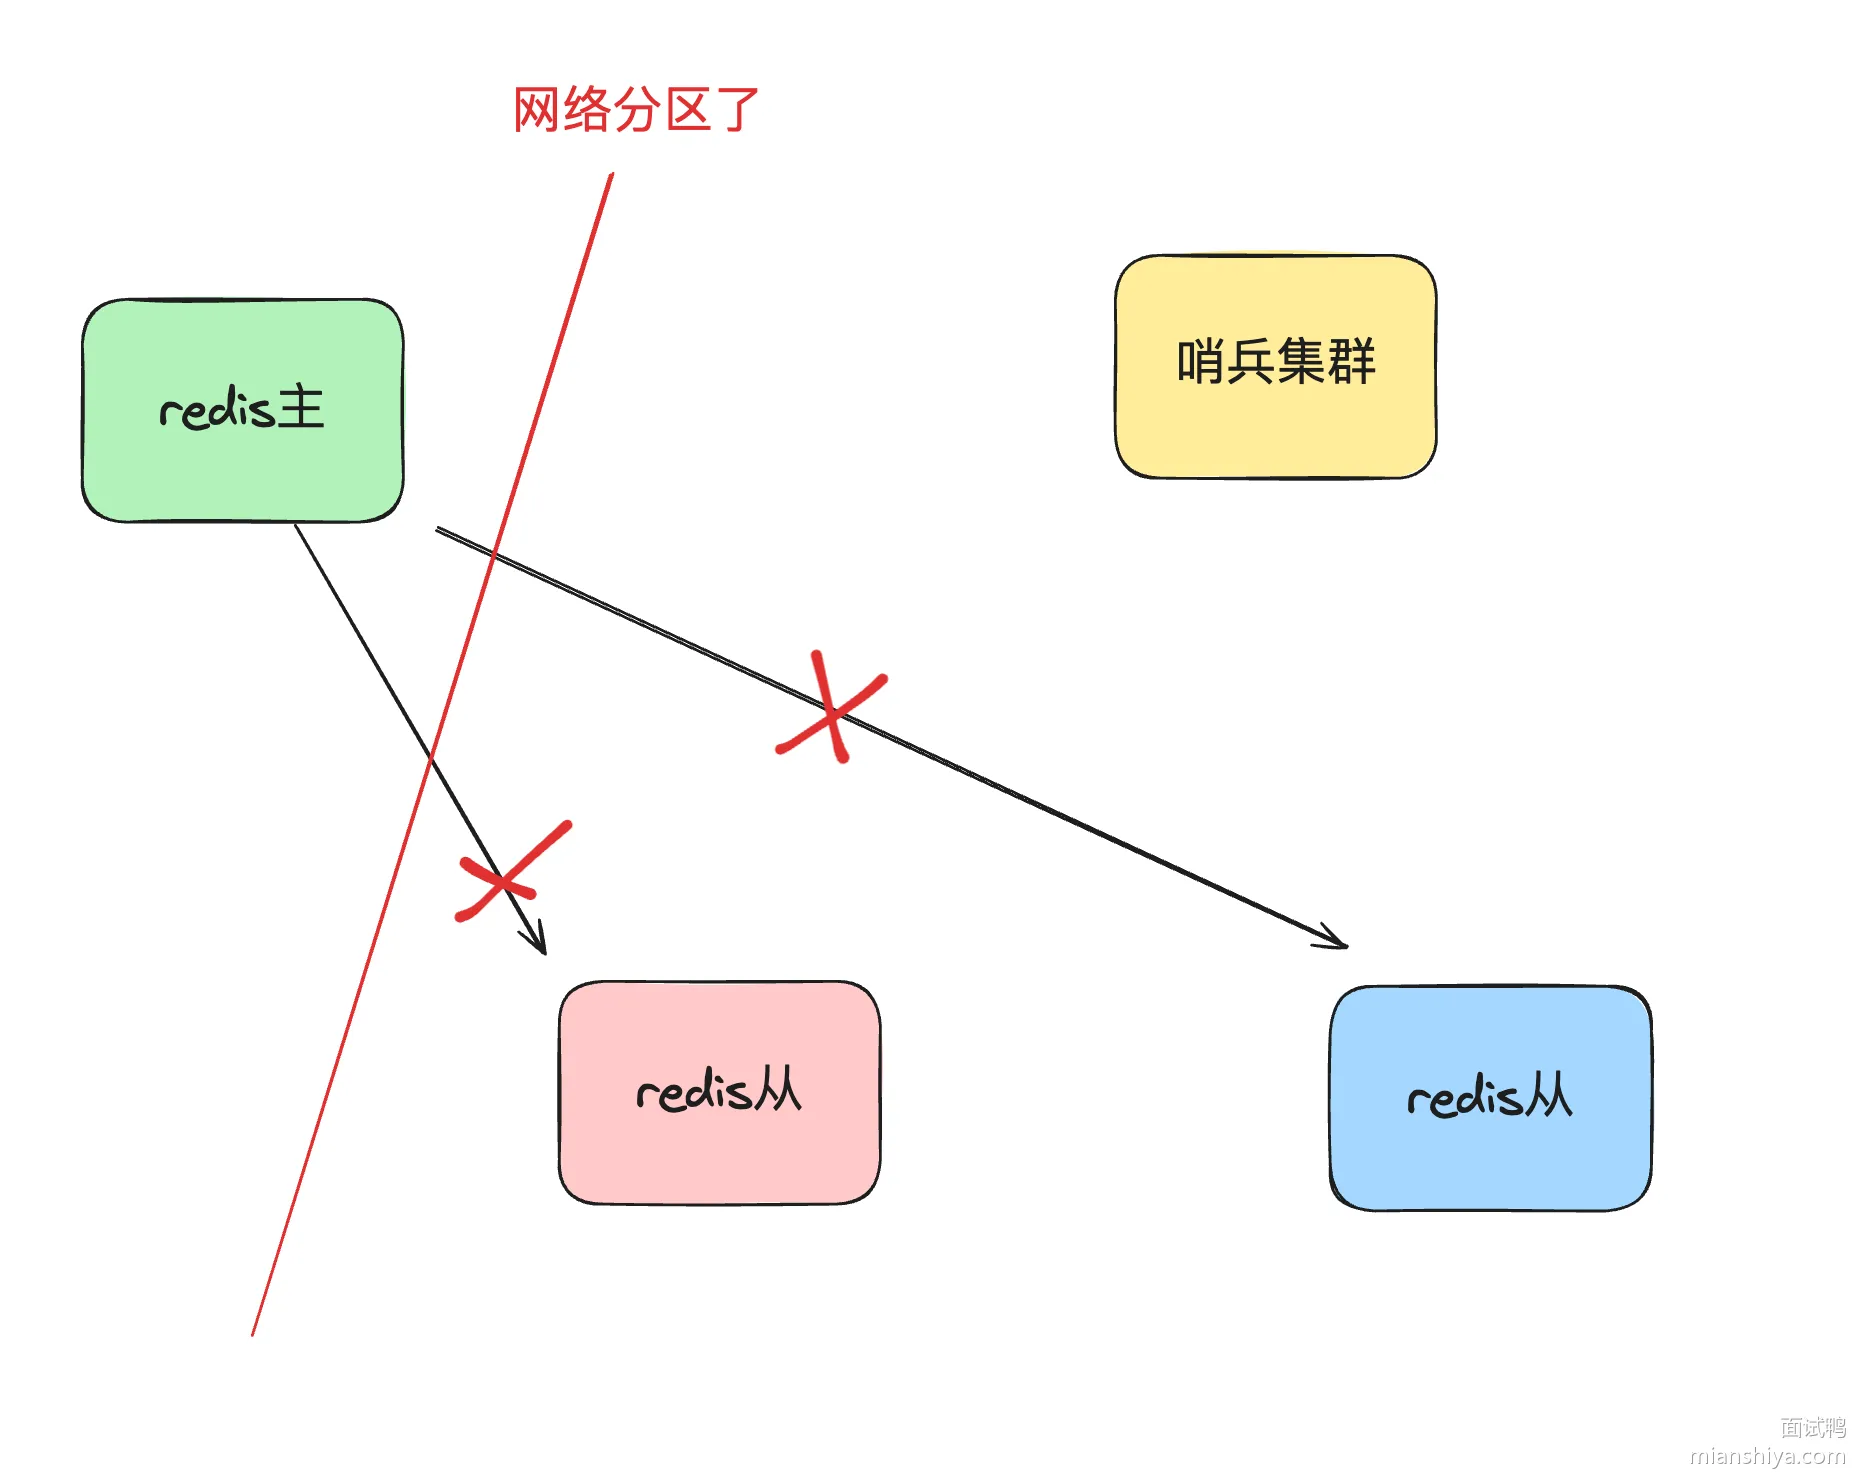
例如发生了网络分区,主节点与哨兵、从节点分区了:
哨兵发现联系不上主节点,于是发起选举,选了新的主节点,此时 Redis 就出现了两个主节点:
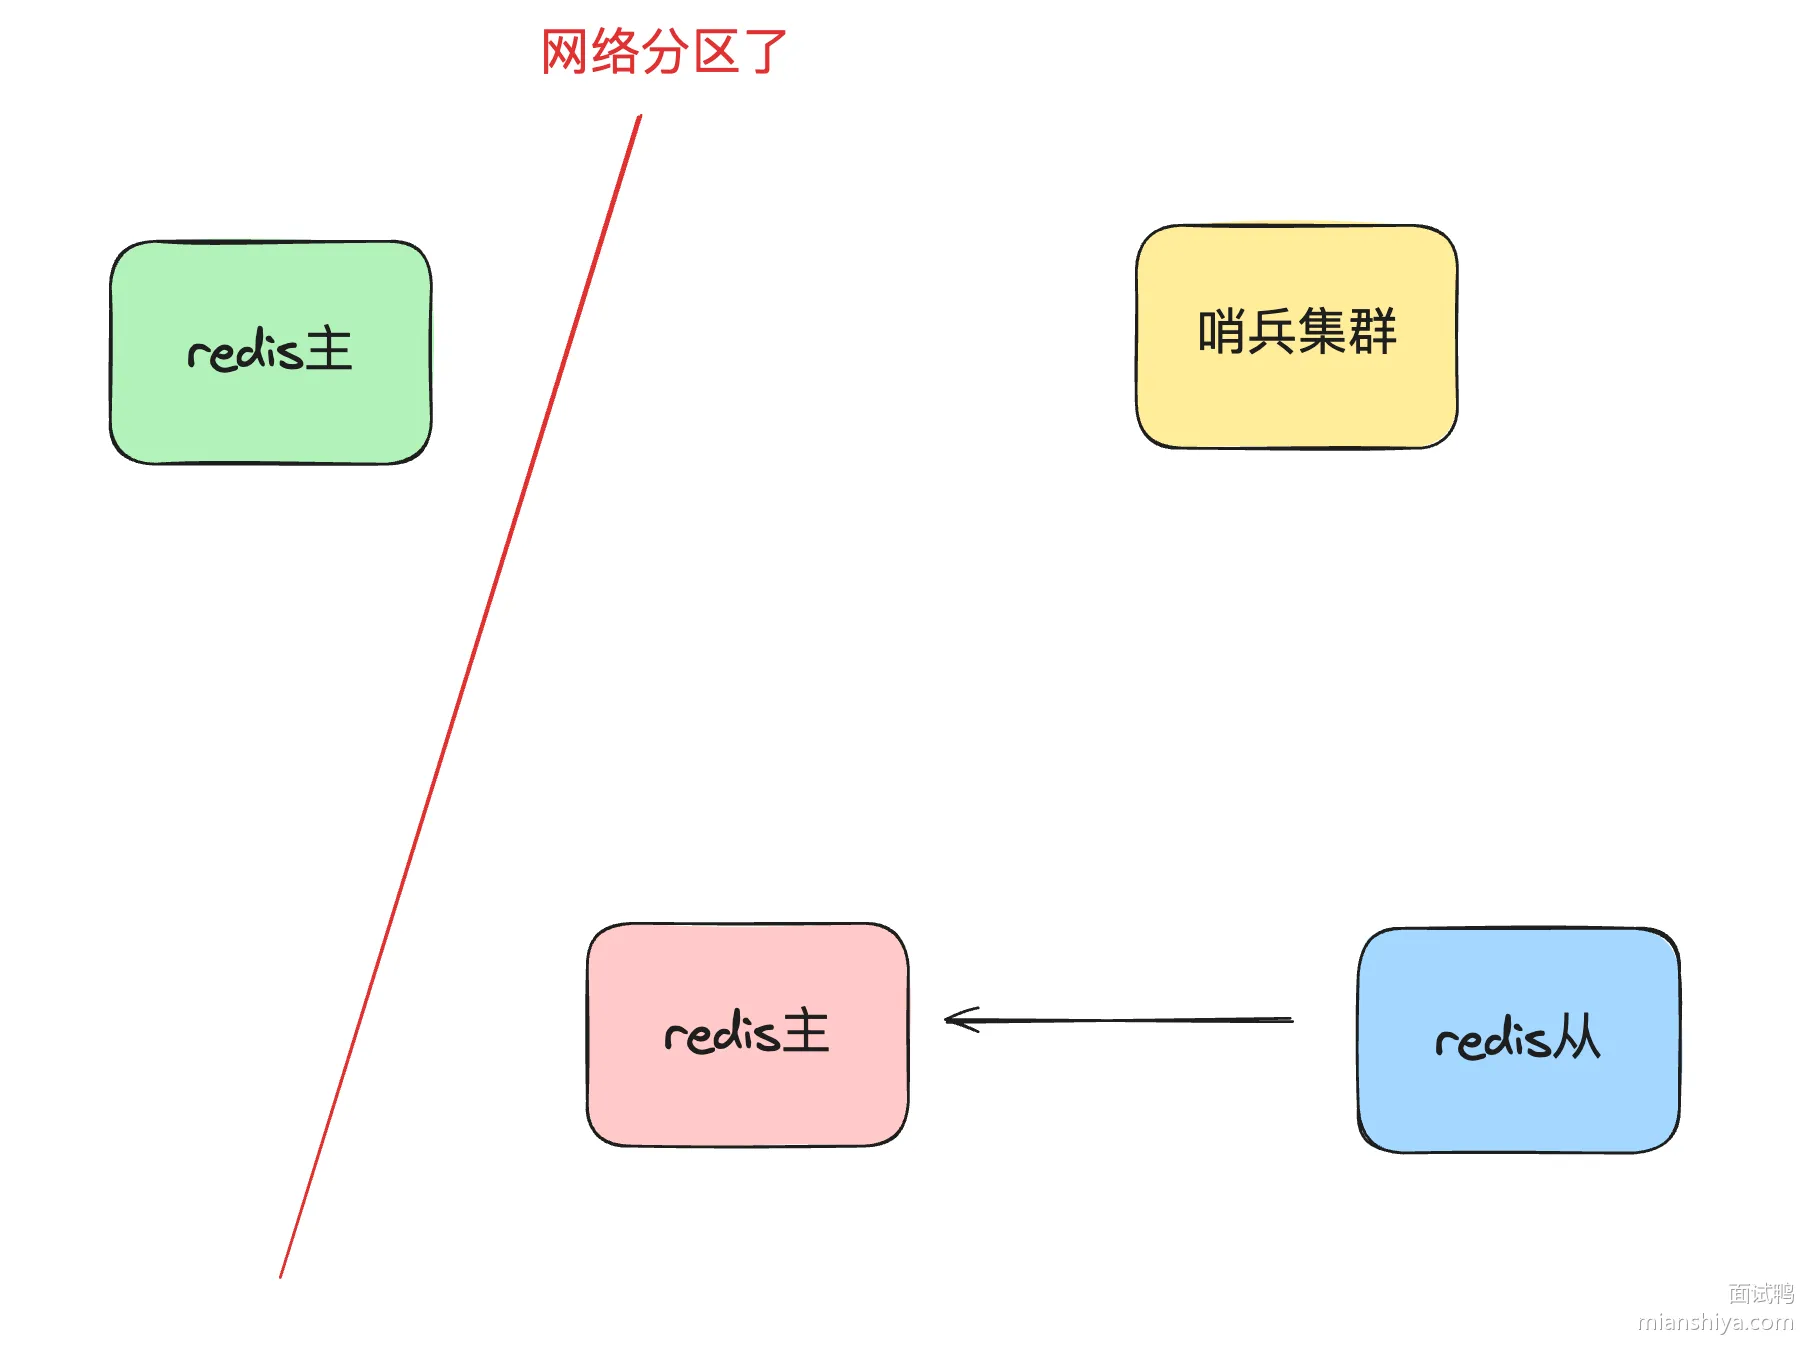
这就发生了脑裂,客户端写数据写哪都会导致数据不一致。
20.2.3. 为什么配置参数也不能完全避免
即使配置了 min-slaves-to-write 和 min-slaves-max-lag,也可能因为脑裂导致数据不一致。
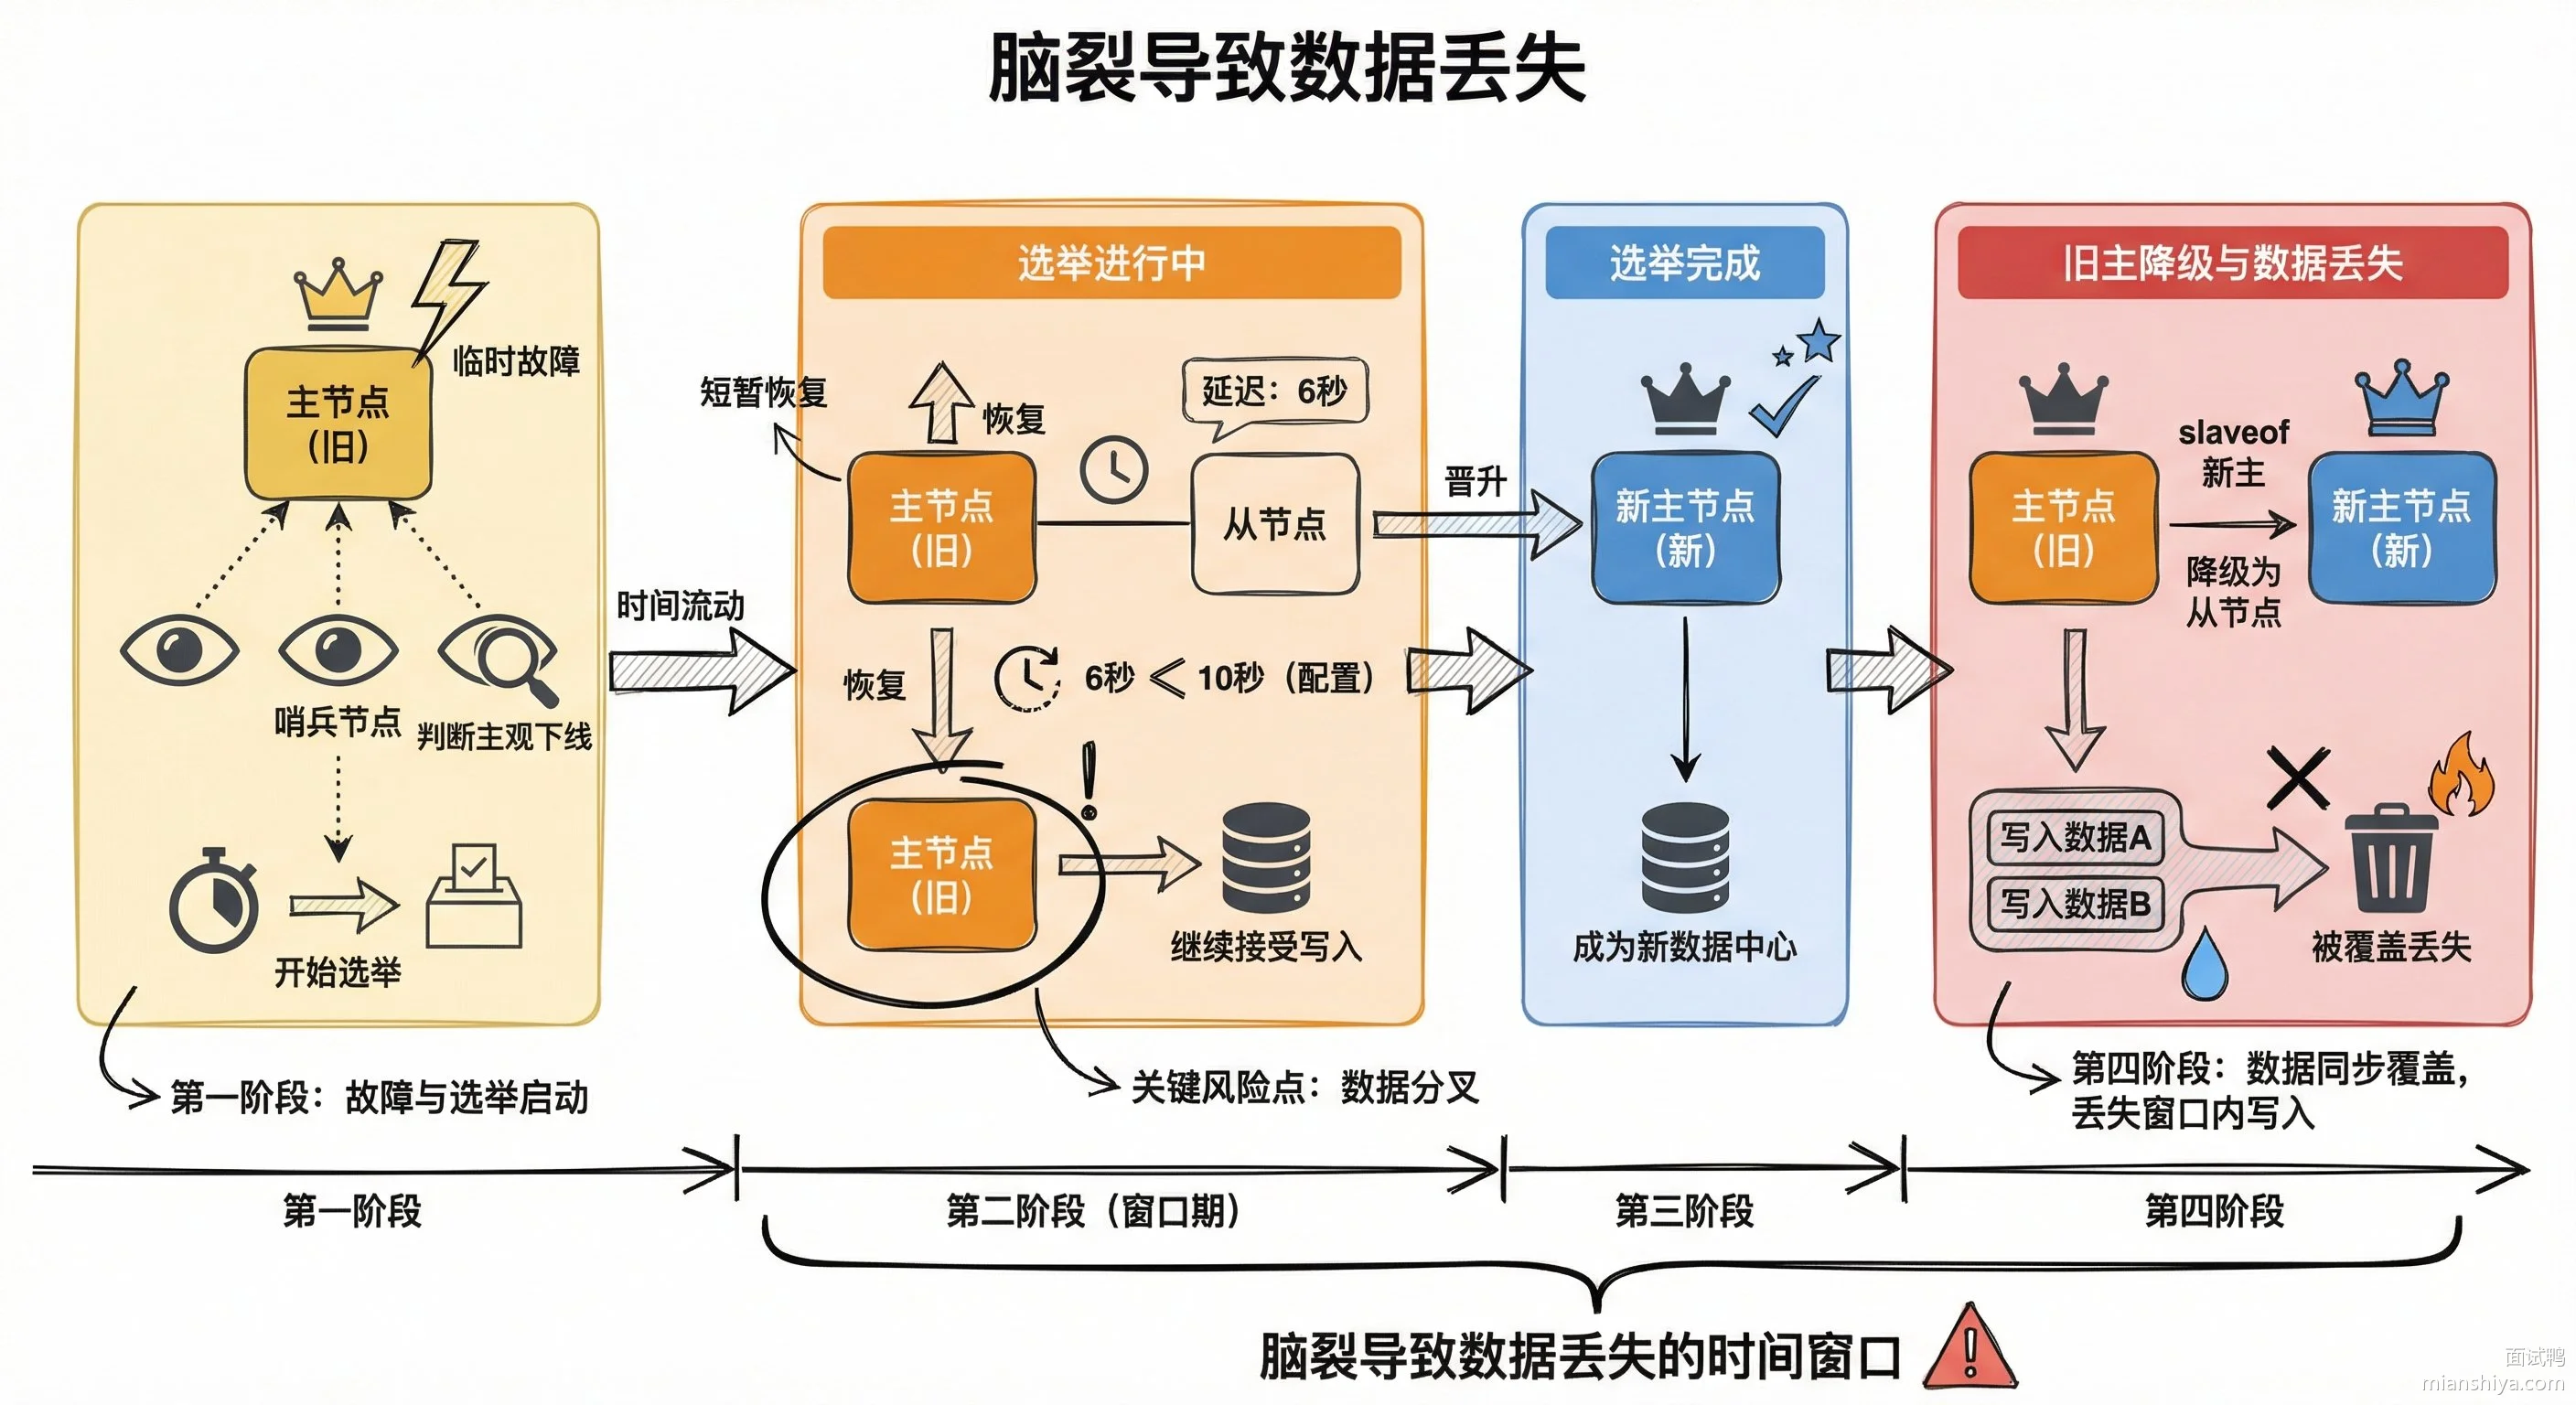
举个例子,假设主节点临时出了问题,哨兵判断它主观下线,开始发起选举。在选举进行的时候,主节点恢复了,它还是跟着很多从节点。假设 min-slaves-max-lag 配置了 10 秒,可能此时从节点和主节点延迟才 6 秒,因此主节点还是可以被写入。
等选举完毕选出新的主节点,旧的主节点被哨兵操作 SLAVEOF 新主,选举时间内写入的数据会被覆盖,就导致了数据丢失。
20.2.4. 生产环境的建议
1)集群部署奇数个节点,比如 3 个或 5 个节点。如果是 5 节点集群,可以设置 min-slaves-to-write=2,min-slaves-max-lag=5
2)合理设置哨兵的 down-after-milliseconds,不要太短。太短会导致网络抖动就触发故障转移,太长又会导致真正故障时恢复慢。一般设置 5-10 秒比较合适
3)客户端做好重试和幂等。既然数据可能丢,业务层就要有兜底方案。写入操作尽量设计成幂等的,丢了重写也不会有问题
4)对于金融级别的场景,要么用 Redis 的 WAIT 命令等待同步复制完成,要么干脆换成支持强一致性的存储,比如 TiKV 或者直接用数据库
20.2.5. 和 ZooKeeper 的对比
ZooKeeper 通过 ZAB 协议保证强一致性,写入操作必须过半数节点确认才算成功,天然就避免了脑裂问题。但代价是写入性能比 Redis 差很多,适合存元数据和配置,不适合高频读写。
Redis 选择的是 AP 路线,优先保证可用性和性能,一致性靠最终一致来兜底。选哪个要看业务场景,缓存场景丢几条数据问题不大,分布式锁场景就得慎重考虑了。
20.3. 常见问题
20.3.1. 如果真的发生了脑裂,网络恢复后怎么处理那些脏数据?
Redis 的处理方式比较暴力,旧主节点会被降级为从节点,执行全量同步或部分同步,期间写入旧主的数据直接被覆盖掉,没有任何冲突检测和合并机制。所以业务层要有兜底,关键数据写 Redis 的同时也要落库,或者用消息队列做异步持久化。网络恢复后可以通过对账脚本把缺失的数据补回来。
20.3.2. min-slaves-to-write 设置成和从节点数量一样会怎么样?
提高了数据安全性,任何一个从节点挂了主节点就拒绝写入,但可用性大打折扣。一般设置成从节点数量的一半多一点就够了,既能防止脑裂,又不会因为个别从节点故障就导致整个集群不可写。比如 3 从节点设置 2,5 从节点设置 3。
20.3.3. 为什么 Redis 不像 ZooKeeper 那样用 Paxos 或 Raft 来保证强一致性?
设计目标不一样。Redis 定位是高性能缓存,每秒几十万 QPS 的场景,如果每次写入都要等多数派确认,延迟会上升 10 倍以上。ZooKeeper 存的是配置和元数据,量小、改得少,强一致带来的开销可以接受。Redis 要是也这么搞,就失去了它最核心的性能优势。
21. Redis 的订阅发布功能是什么?你了解吗?
21.1. 核心要点
Redis 的 Pub/Sub 是一种消息通信机制,用于在不同客户端之间实现消息的实时传递和广播。客户端可以订阅一个或多个频道,当有其他客户端向这些频道发布消息时,所有订阅了该频道的客户端都会立即收到消息。
它的工作流程很简单:
1)发布者通过 PUBLISH 命令往某个频道发消息 2)Redis 找到所有订阅了这个频道的客户端 3)把消息转发给这些客户端
重点是 Redis 不会存储消息,它只是一个"转发通道"。消息发出去之后,如果订阅者不在线,这条消息就永远丢了。
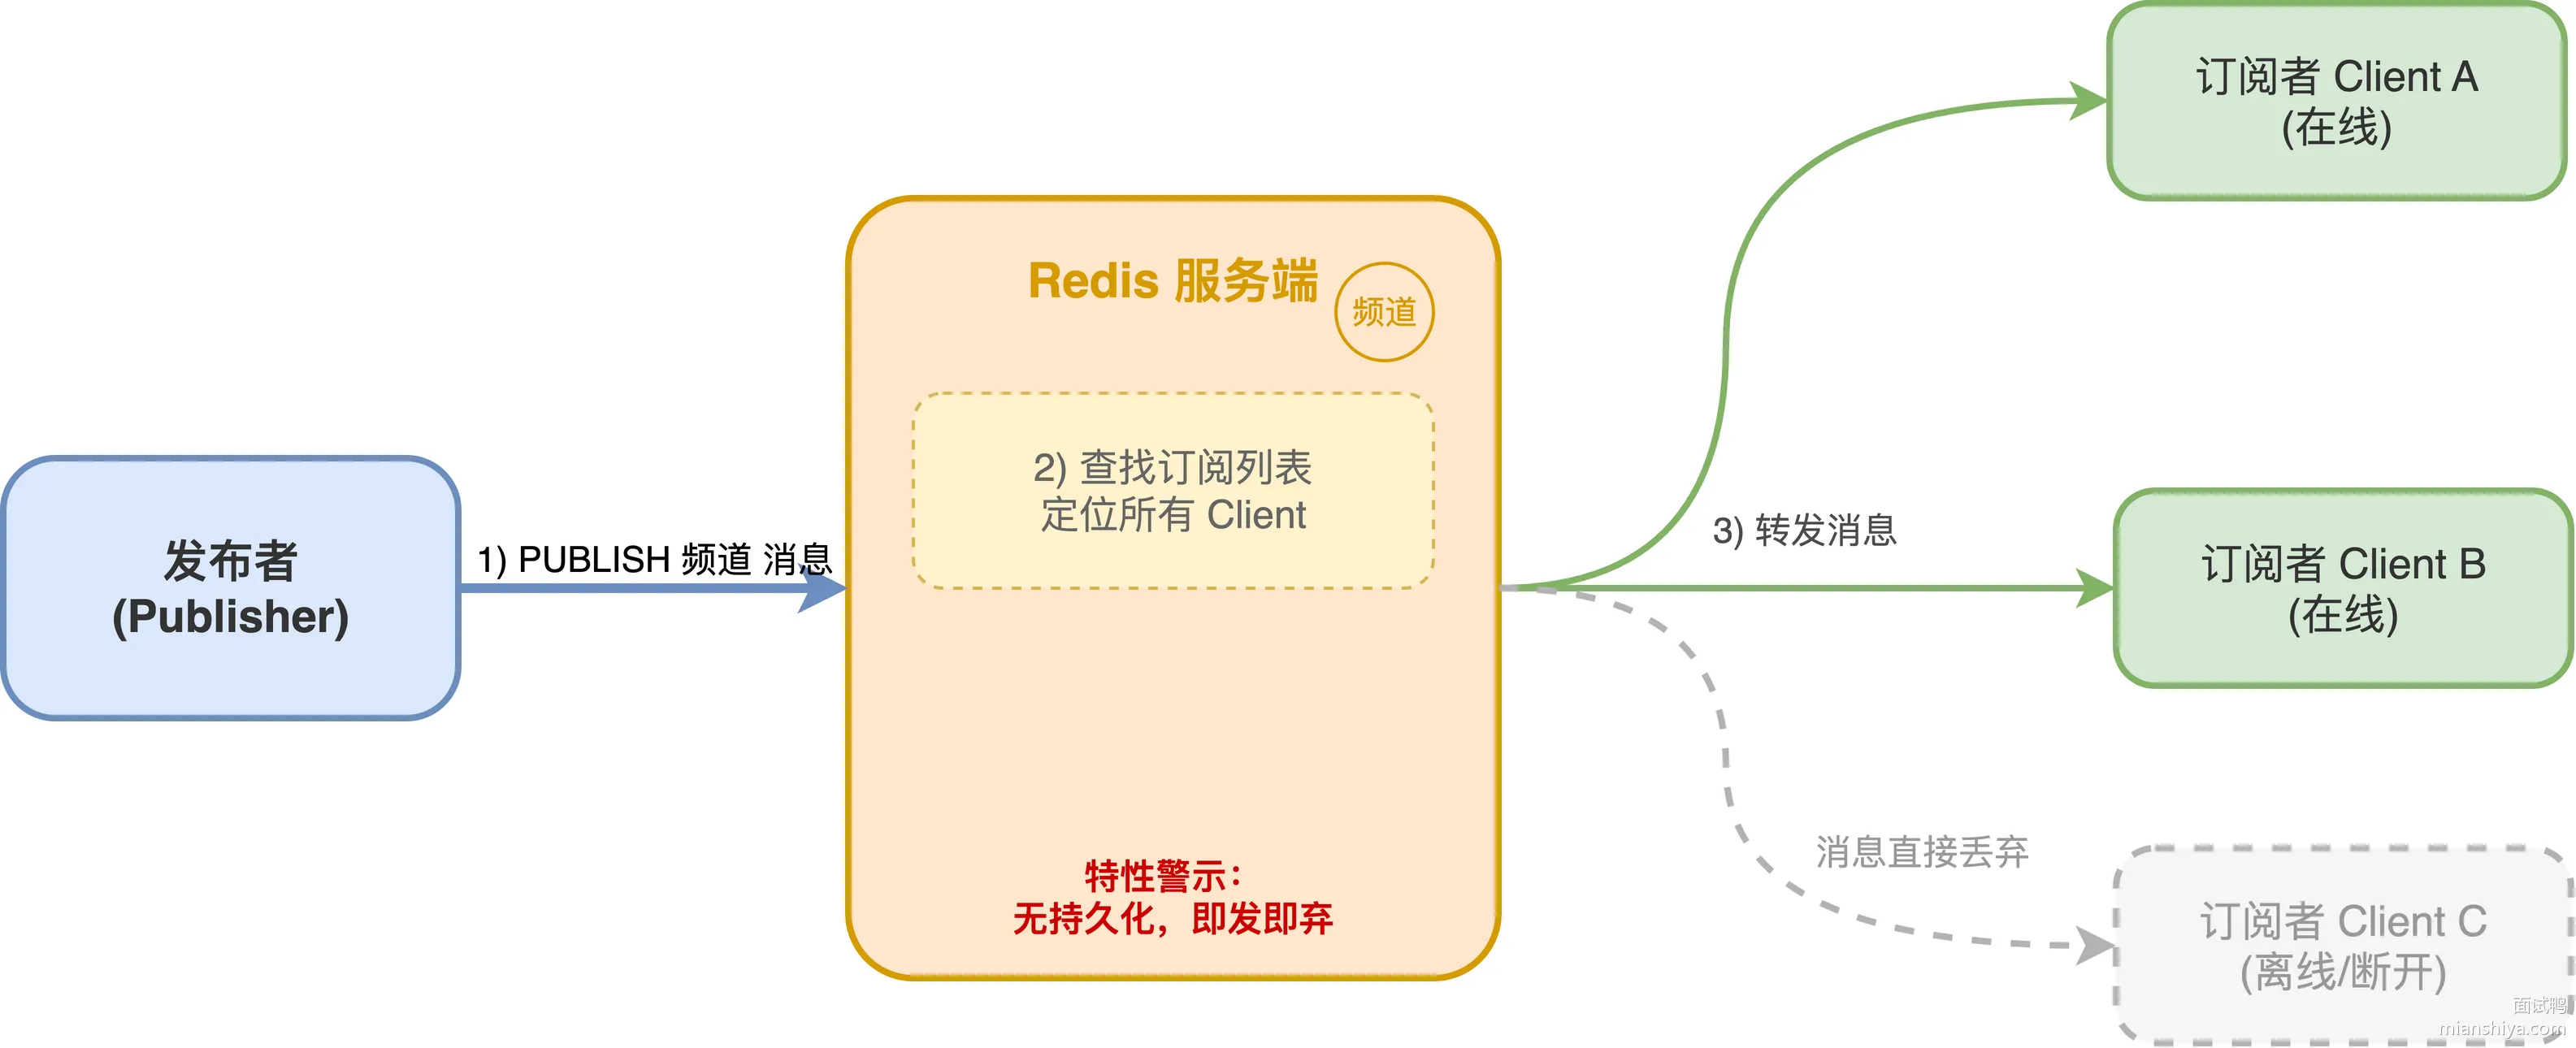
基本命令就 4 个:
- SUBSCRIBE channel:订阅某个频道
- PUBLISH channel message:往频道发消息
- UNSUBSCRIBE channel:取消订阅
- PSUBSCRIBE pattern:模式匹配订阅,比如
mianshiya.*可以订阅所有 mianshiya 开头的频道
21.2. 扩展知识
21.2.1. 发布/订阅模型
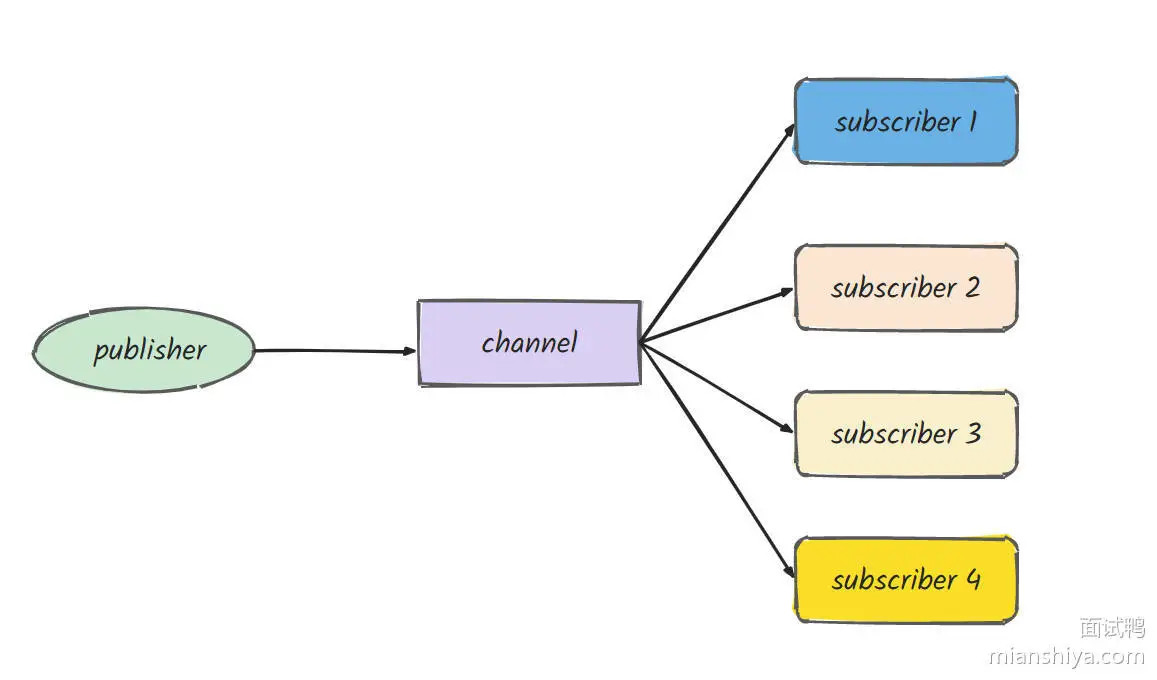
发布/订阅属于消息队列中的一种消息通信模型,生产者发送消息,订阅者接收消息。
如下图所示,发布者向一个或者多个频道发布消息,订阅者可以订阅一个或者多个频道。当发布者发送新消息到对应频道的时候,订阅者可以收到对应的信息。
21.2.2. Redis 的 Pub/Sub 实际演示
订阅对应的频道:
subscribe channel发布发布消息到 Redis 频道:
publish channel message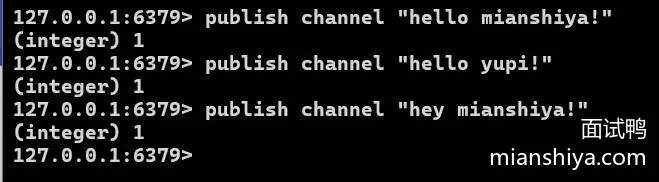
可以看到频道发布的消息都被消费到了:
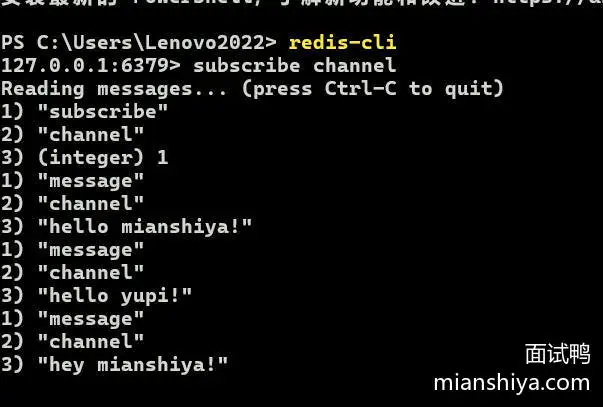
解析下结果:
- subscribe 和 channel 分别表示执行订阅以及订阅的频道
- integer 1 表示订阅成功
- message 表示接收到的消息,后面的 channel 表示订阅频道,再后面就是消息数据
订阅成功之后,客户端会一直保持订阅状态,直到手动取消订阅或连接断开。
它支持消费者阻塞式拉取消息,还提供了模式匹配订阅,消费者可以根据一定的规则订阅多个队列。比如 PSUBSCRIBE mianshiya.*,生产者发布 mianshiya.1、mianshiya.2、mianshiya.3 等队列的消息,消费者都可以接收到。
21.2.3. Redis 的 Pub/Sub 底层实现原理
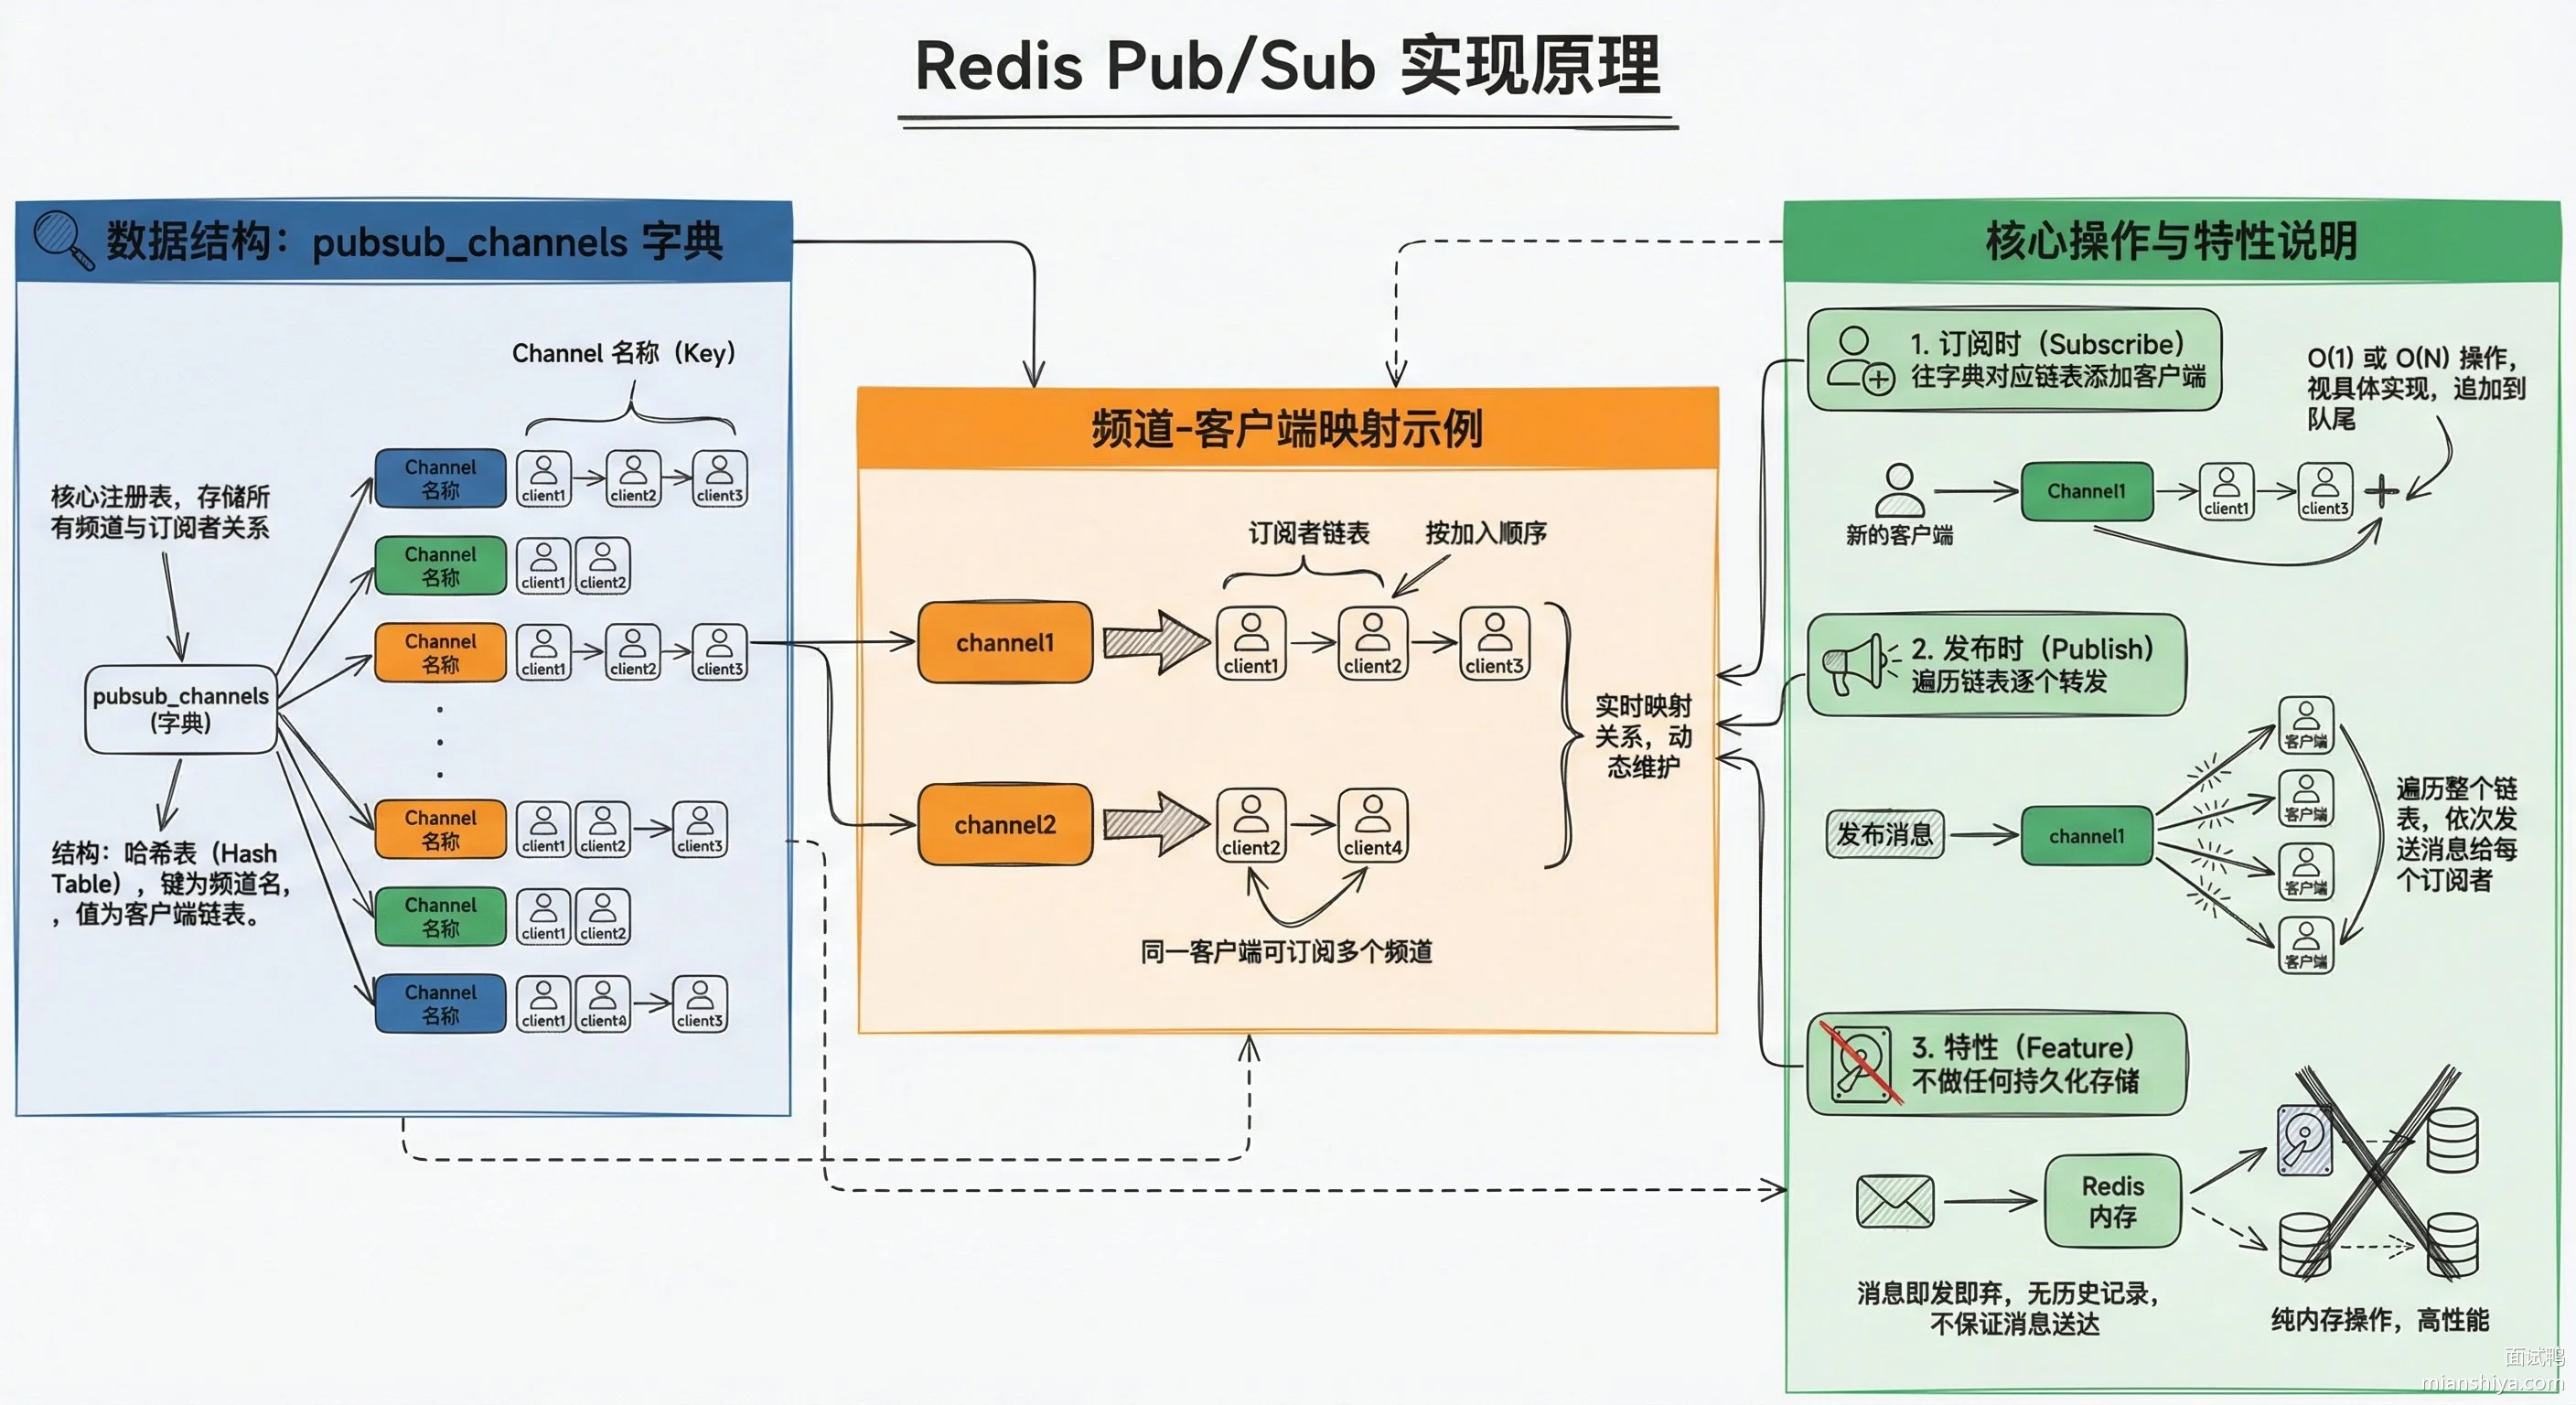
Redis 的 Pub/Sub 实现其实很简单。
消费者订阅队列,实际上就是在 Redis 中保存了一个映射关系,即 队列x -> 消费者1。
如果生产者往队列 x 发送一条消息,Redis 不会做任何的存储动作,而是查找映射关系,然后立马转发给消费者 1。如果找到多个映射关系,那就都转发,所以天然支持多消费者广播。
因此,不论是 RDB 还是 AOF 都不会存储消息。
21.2.4. Redis 的 Pub/Sub 致命缺点:会丢数据
从原理就能看出来,Redis 并不会存储消息。如果生产者发布消息的时候消费者宕机了,当服务恢复时,其间生产者发送的消息就丢了。
不仅是宕机会导致消息丢失,消费者消费过慢也可能导致消息丢失。
在《1. Redis 主从复制的实现原理是什么?》中,提到了 client-output-buffer-limit 参数,默认 pubsub 配置的是 32mb 8mb 60,即缓冲区一旦超过 32 MB 或持续 60s 超过 8M 直接把消费者下线。
Redis 虽然不会存储消息,但是消息会先写入这个缓冲区供消费者拉取消费。如果消费者处理太慢导致缓冲区溢出,那么消费者被强行下线,消息也就丢了。
21.2.5. 和专业消息队列的对比
| 特性 | Redis Pub/Sub | RocketMQ/Kafka |
|---|---|---|
| 消息持久化 | 不支持 | 支持,消息落盘 |
| 消费确认 | 不支持 | 支持 ACK 机制 |
| 消费回溯 | 不支持 | 支持任意位点消费 |
| 消息堆积 | 不支持,缓冲区溢出丢数据 | 支持,磁盘存储 |
| 消费者组 | 不支持 | 支持负载均衡消费 |
| 适用场景 | 实时性要求高、丢几条无所谓 | 可靠性要求高的业务消息 |
21.2.6. 实际应用场景
Redis 的哨兵集群和 Redis 实例通信用的就是 Pub/Sub。
业务上的即时通信场景也可以用,比如聊天室广播、实时通知推送。但因为消息会丢失,大部分正经的业务场景还是会选择 RocketMQ、Kafka 这类专业的消息队列。
21.2.7. Redis 5.0 的 Stream
如果既想用 Redis 又想要消息可靠性,可以看看 Redis 5.0 引入的 Stream。
Stream 是一个真正的消息队列数据结构,支持消息持久化、消费者组、消息确认、消息回溯,功能上已经比较接近 Kafka 了。它解决了 Pub/Sub 消息会丢的问题,但也带来了更多的复杂性。
21.3. 常见问题
21.3.1. Pub/Sub 和 Stream 怎么选?什么场景用哪个?
看你能不能接受丢消息。Pub/Sub 适合实时性要求高但丢几条无所谓的场景,比如实时游戏排行榜广播、监控告警推送、配置变更通知。Stream 适合需要可靠投递的场景,比如订单状态变更、异步任务分发。另外 Pub/Sub 是广播模式,所有订阅者都会收到消息;Stream 支持消费者组,可以做负载均衡,多个消费者分摊消息。
21.3.2. 如果用 Pub/Sub,怎么尽量减少消息丢失?
几个方向可以努力:调大 client-output-buffer-limit 的配置,给消费者更大的缓冲空间;消费者处理逻辑尽量轻,收到消息先丢到本地队列,异步慢慢处理;做好监控,订阅 __keyspace@*__:* 这类系统事件可以感知到客户端被踢的情况。但归根结底,Pub/Sub 的设计就是"尽力而为",真的不能丢消息就别用它。
21.3.3. 你说 Redis 哨兵用的 Pub/Sub,它不怕丢消息吗?
哨兵的场景比较特殊,它用 Pub/Sub 主要是做状态广播和发现,比如"我觉得某个节点挂了"、"我要开始选举了"。这类消息丢几条其实问题不大,因为哨兵会周期性地重复广播自己的状态。而且哨兵之间的关键决策,比如故障转移投票,用的是 Raft 协议的直接通信,不走 Pub/Sub。可以理解成 Pub/Sub 在这里只是个"喇叭",喊一声让大家知道有事发生,具体怎么处理还得走正经流程。
22. Redis 中如何实现分布式锁?
22.1. 核心要点
Redis 实现分布式锁的核心就是 SET key value EX seconds NX 命令配合 Lua 脚本。加锁时用 NX 保证互斥,EX 设置过期防止死锁;解锁时必须用 Lua 脚本先校验再删除,保证原子性。
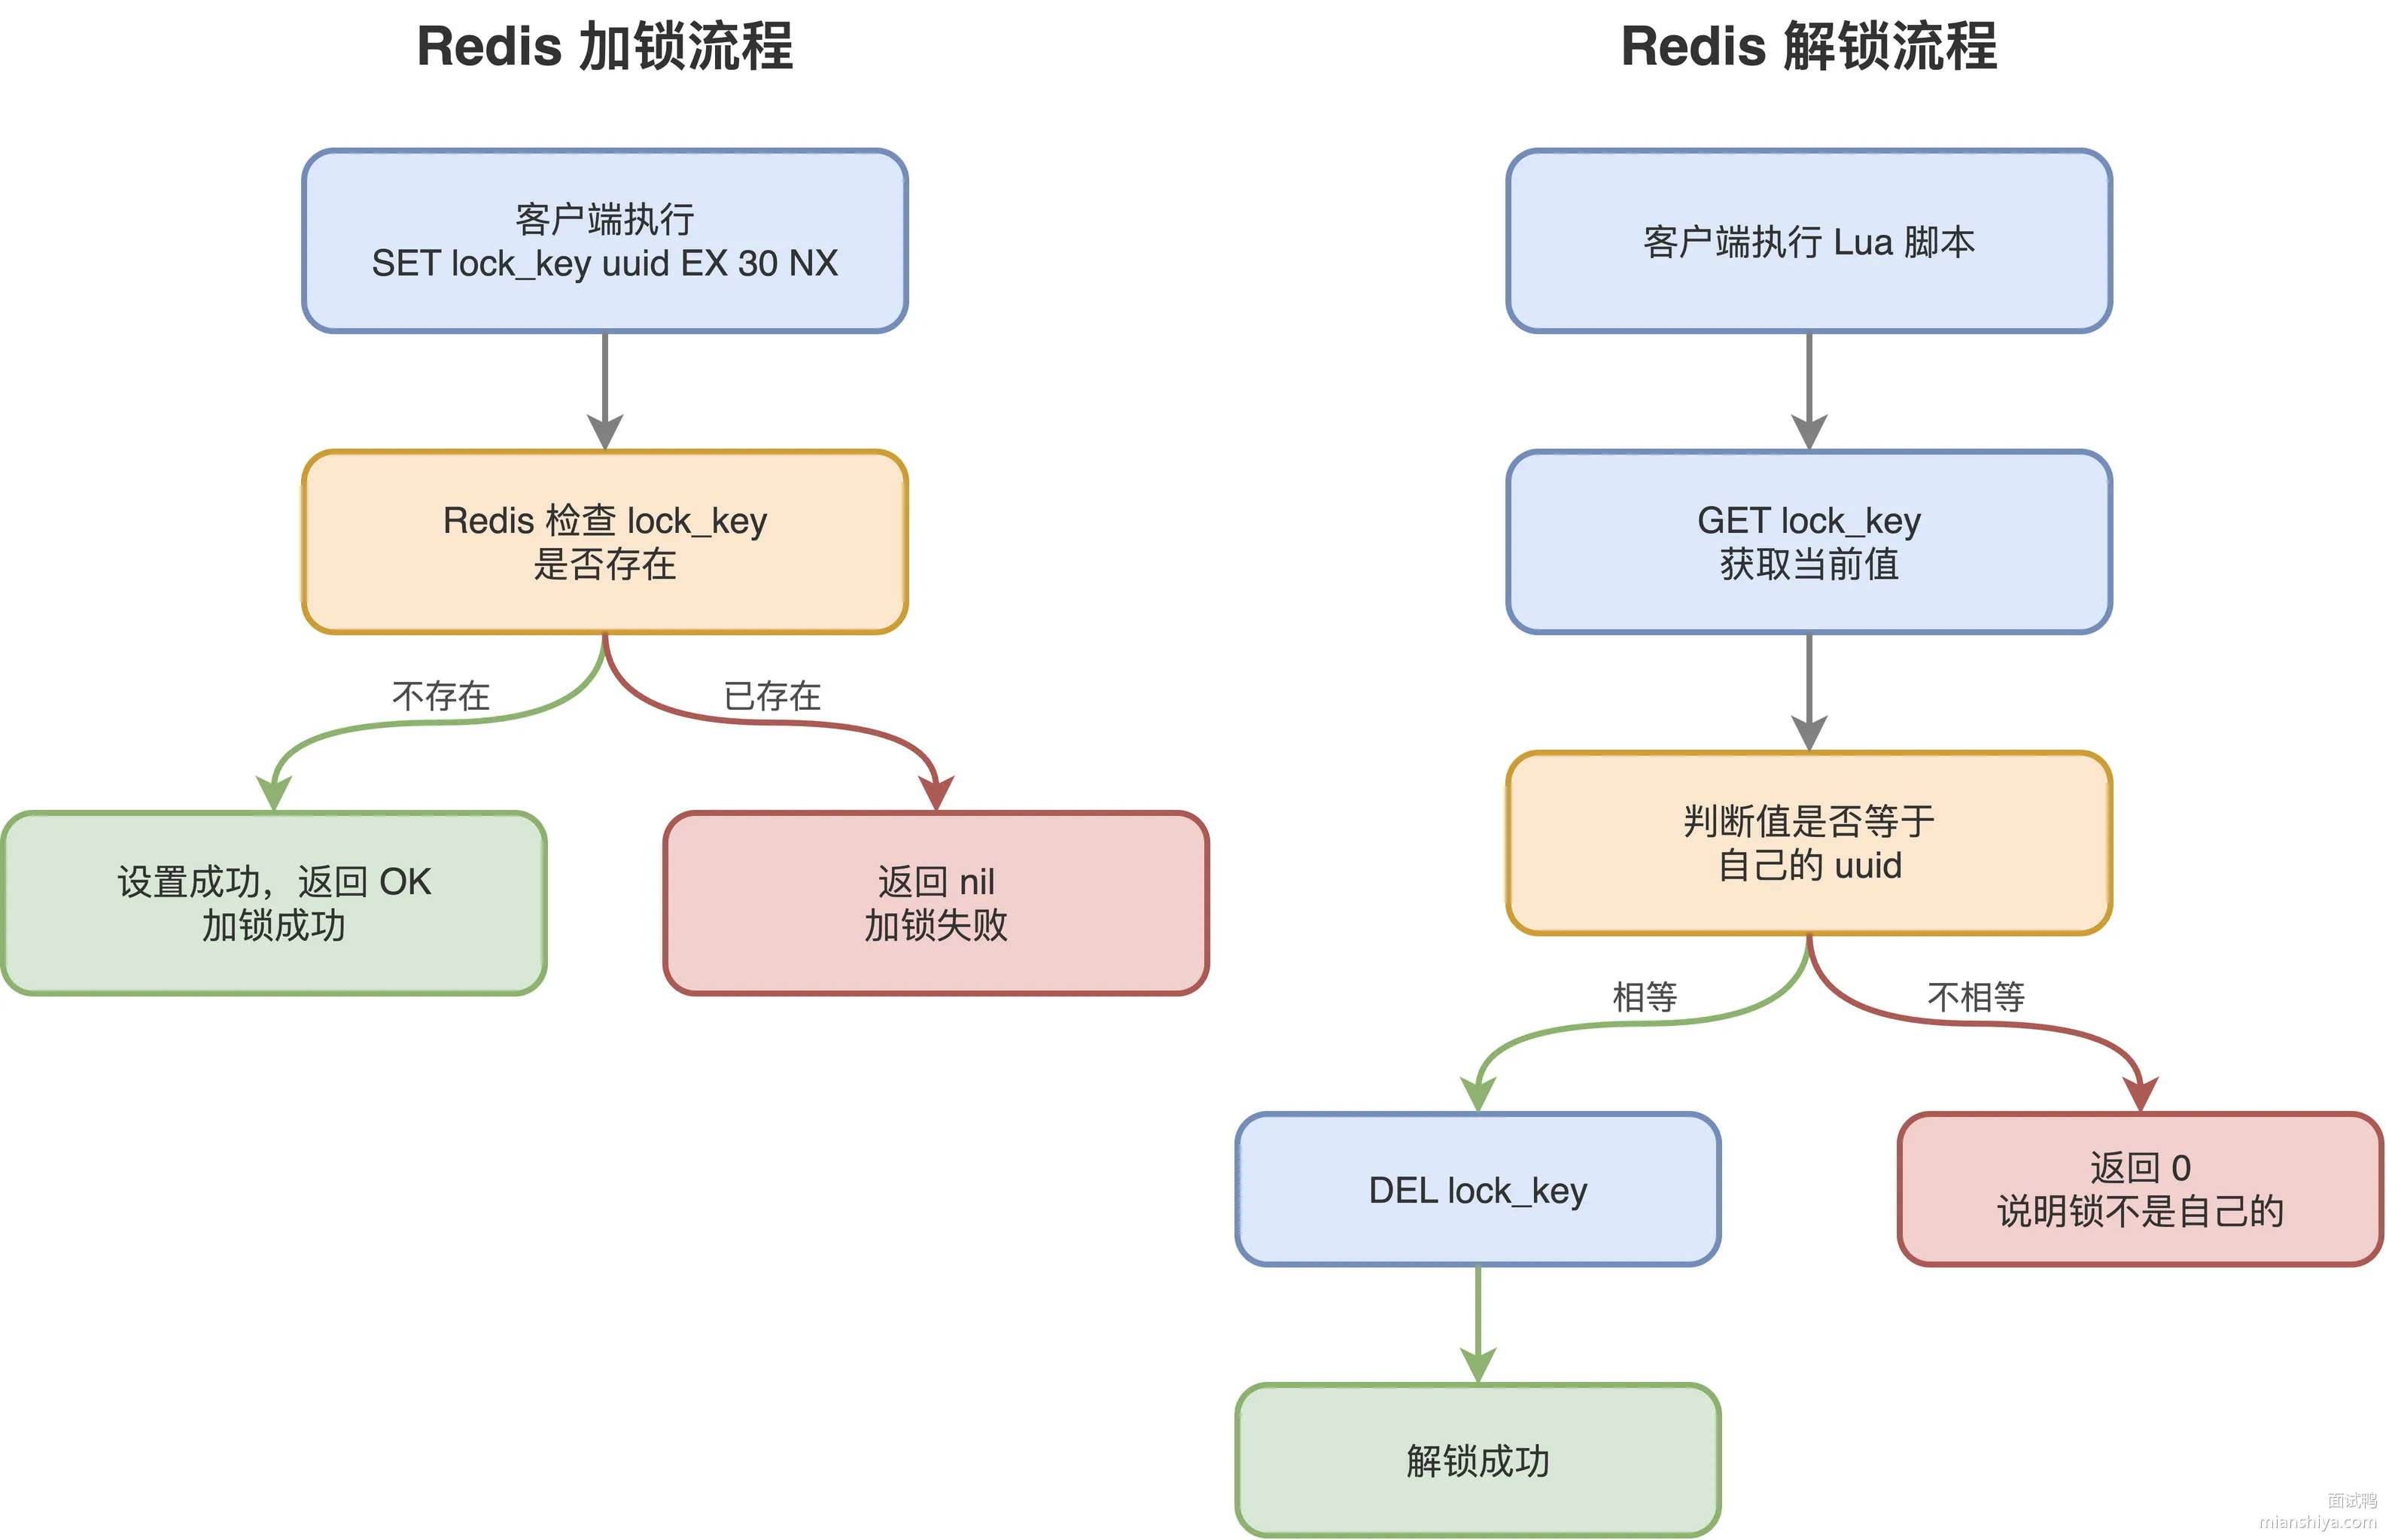
加锁流程: 1)客户端执行 SET lock_key uuid EX 30 NX 2)Redis 检查 lock_key 是否存在 3)不存在则设置成功,返回 OK,加锁成功 4)已存在则返回 nil,加锁失败
解锁流程: 1)客户端执行 Lua 脚本 2)GET lock_key 获取当前值 3)判断值是否等于自己的 uuid 4)相等则 DEL lock_key,解锁成功 5)不相等则返回 0,说明锁不是自己的
加锁命令:
SET lock_key uuid EX 30 NX解锁 Lua 脚本:
if redis.call("GET", KEYS[1]) == ARGV[1]
then
    return redis.call("DEL", KEYS[1])
else
    return 0
end
Java 代码实现:
public class RedisLock {
    private Jedis jedis;
    private String lockKey;
    private String uuid;
    private int expireTime = 30; // 秒

    public boolean tryLock() {
        uuid = UUID.randomUUID().toString();
        String result = jedis.set(lockKey, uuid, SetParams.setParams().nx().ex(expireTime));
        return "OK".equals(result);
    }

    public void unlock() {
        String script = "if redis.call('get', KEYS[1]) == ARGV[1] then " +
                        "return redis.call('del', KEYS[1]) else return 0 end";
        jedis.eval(script, Collections.singletonList(lockKey), Collections.singletonList(uuid));
    }
}
22.2. 扩展知识
22.2.1. 为什么锁必须有过期时间
假设某个服务拿到锁后直接宕机了,没有过期机制的话这把锁就永远卡在那了,其他服务全都干等着,整个业务就卡死了。所以加锁的时候必须带上 EX 或 PX 设置过期时间,相当于给锁上了个"保险"。
在 Redis 2.6.12 之前,SETNX 和 EXPIRE 是两条命令,没法保证原子性。客户端执行完 SETNX 还没来得及 EXPIRE 就挂了,锁照样会卡住。2.6.12 之后 SET 命令支持了 NX、EX、PX 参数,一条命令搞定加锁和设置过期,原子性有保障了。
22.2.2. 为什么解锁要用 Lua 脚本
解锁要先判断锁是不是自己的,再删除。这两步如果分开执行,中间可能被别人插一脚。
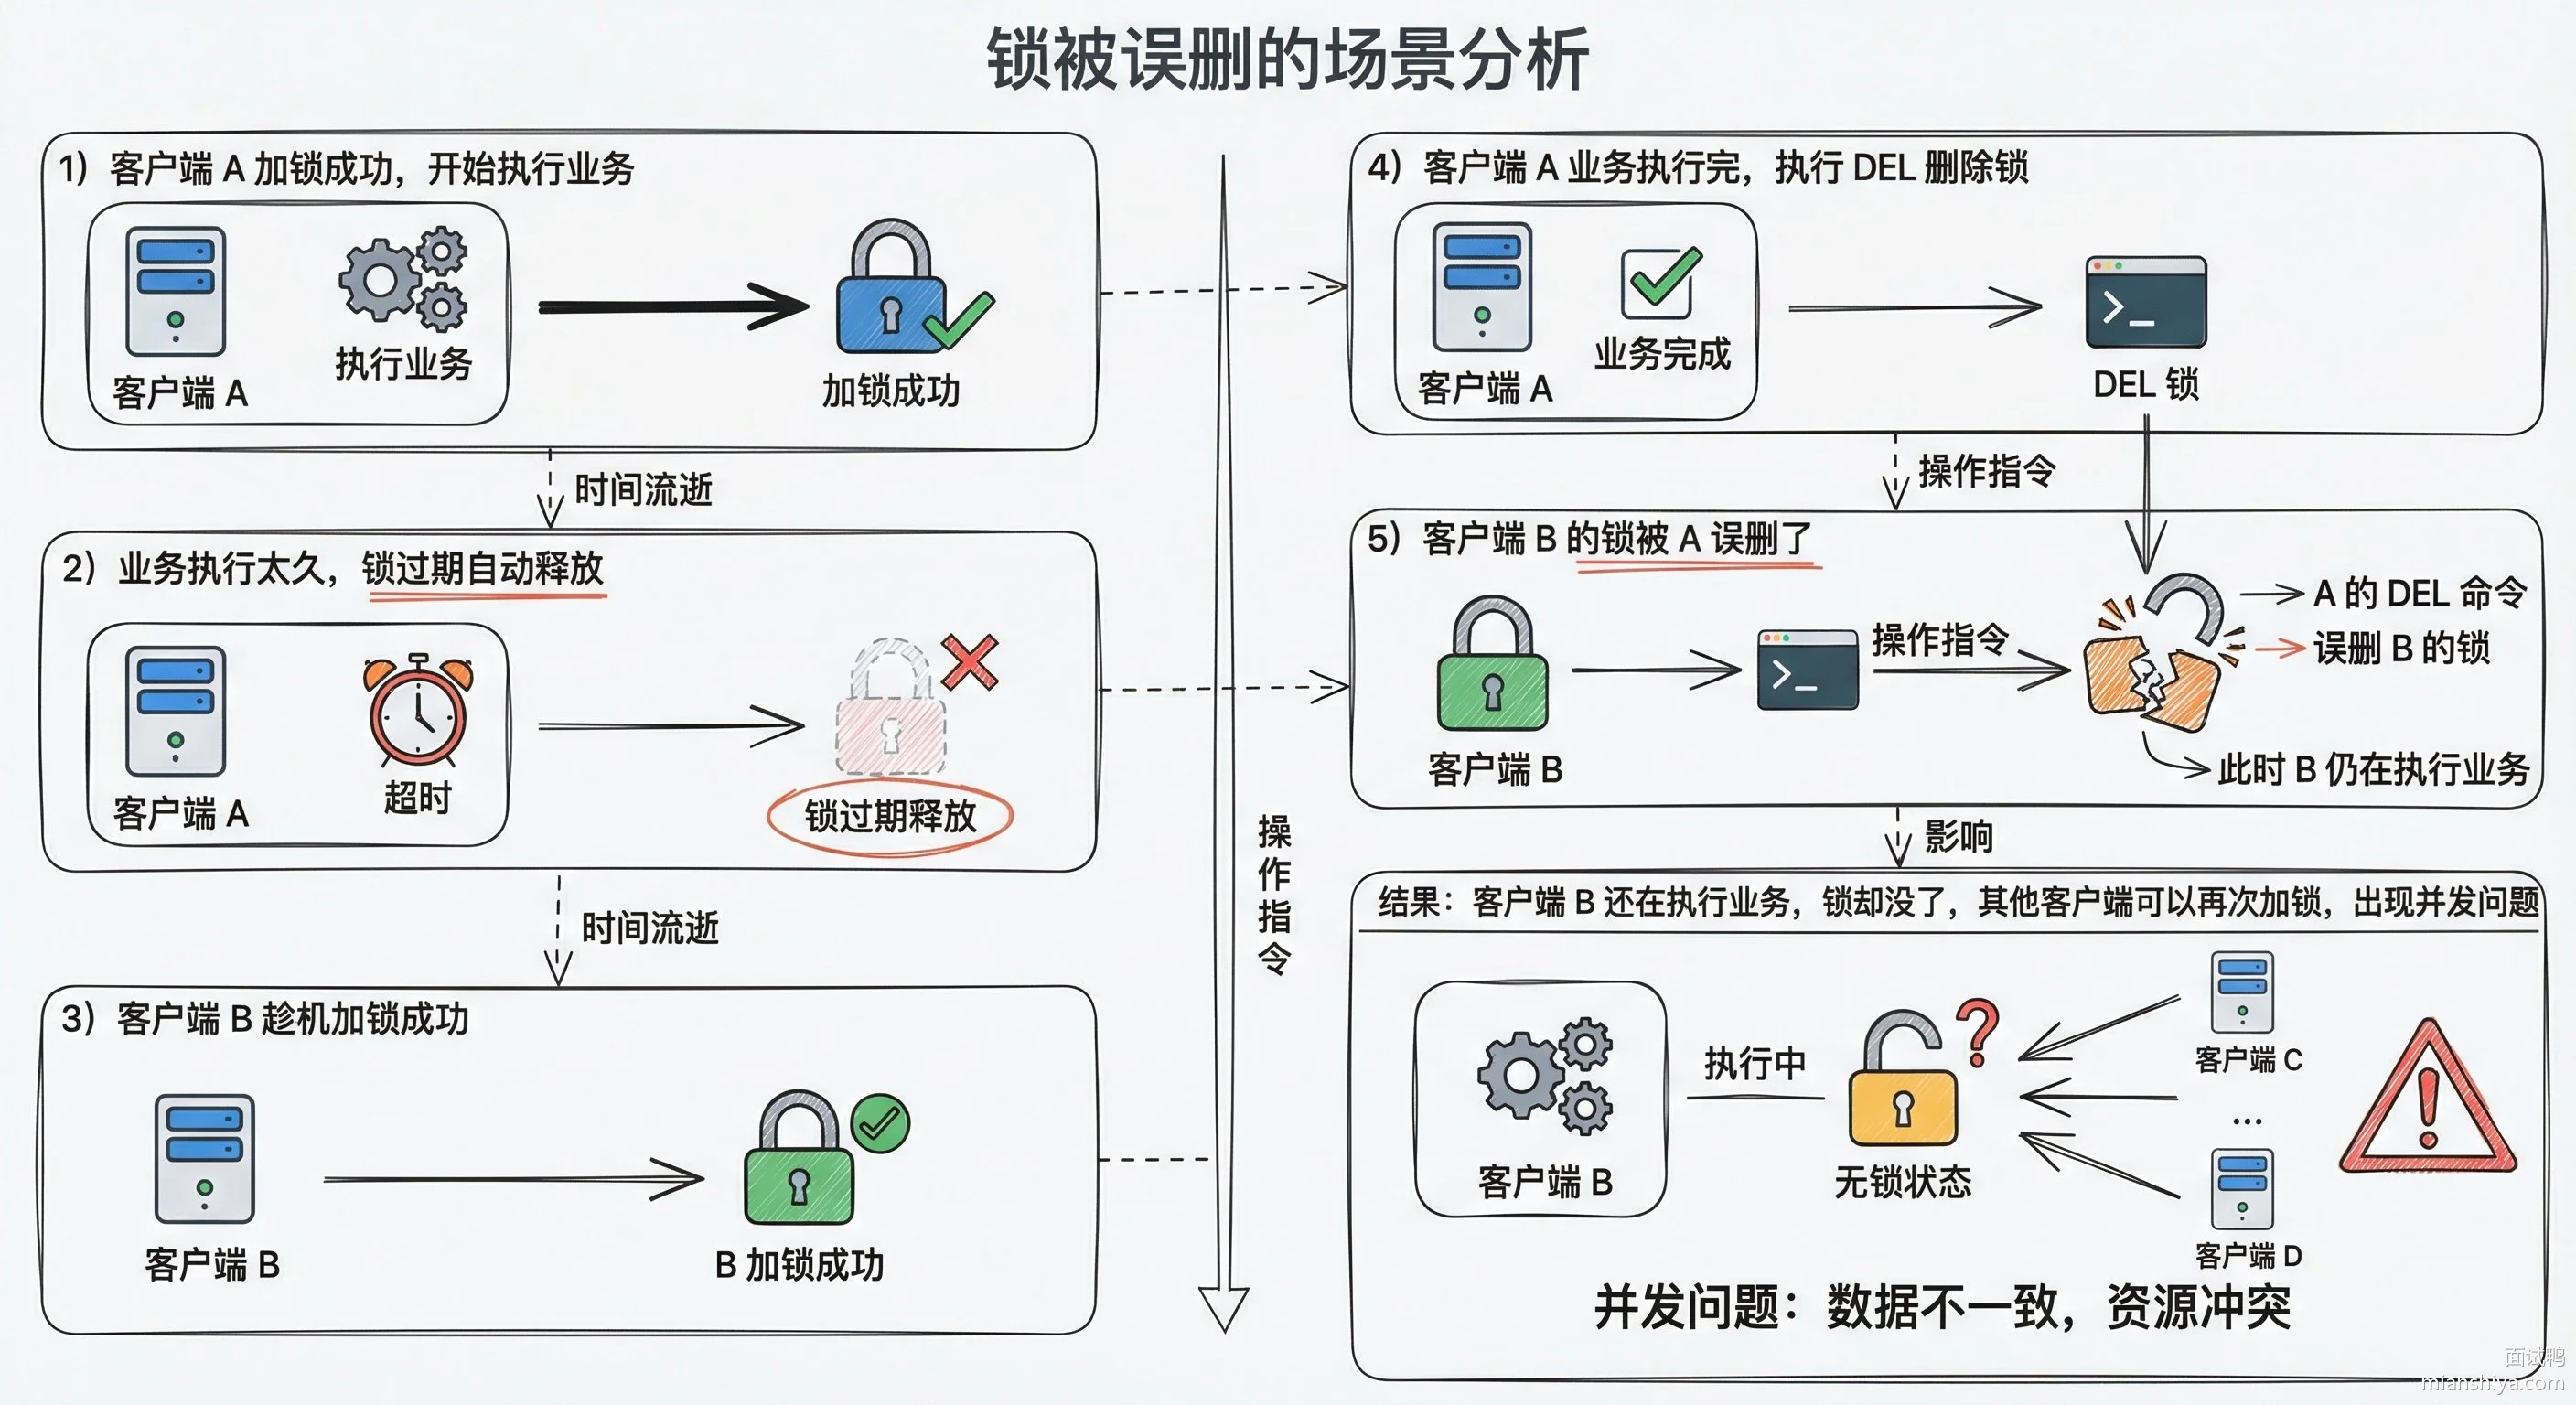
所以每个客户端加锁时要带上唯一标识,比如 UUID。解锁时先 GET 判断值是不是自己的 UUID,是才 DEL。这两步必须用 Lua 脚本包起来,Redis 执行 Lua 脚本是原子的,中间不会被打断。
22.2.3. 单点故障问题
单机 Redis 做分布式锁有个致命问题:Redis 挂了锁就没了。
用主从架构也不保险。客户端在主节点加锁成功,主节点还没把数据同步到从节点就宕机了,从节点晋升为新主节点,这时候锁的数据压根没同步过来。另一个客户端来新主节点加锁,也能成功,两个客户端同时拿到锁,数据就乱了。
针对这个问题,Redis 作者 Antirez 提出了 Redlock 算法。
22.2.4. Redlock 红锁
Redlock 的思路是用多个独立的 Redis 实例,通常部署 5 个。客户端要在大多数实例上加锁成功才算拿到锁。
加锁流程: 1)客户端记录当前时间戳 2)依次向 5 个 Redis 实例发送加锁请求,每个请求设置较短的超时时间,比如 5-50ms 3)统计成功加锁的实例数量,同时计算加锁总耗时 4)如果成功数量 >= 3 个,且总耗时 < 锁的过期时间,加锁成功 5)否则向所有实例发送解锁请求,释放已经加锁的实例
解锁就简单了,直接向所有实例发送 DEL 命令。
Redlock 的问题也不少: 1)部署复杂,要维护 5 个独立 Redis 实例,成本高 2)依赖系统时钟,如果某个节点时钟跳变,锁的有效期计算就不准了 3)高并发场景下要访问多个实例,延迟会变高 4)长时间任务需要续期,多实例续期逻辑更复杂
生产环境如果用 Java,推荐直接用 Redisson 框架,它封装好了分布式锁的各种实现,包括可重入锁、公平锁、读写锁,还有 看门狗机制 自动续期。
- Redis 的 Red Lock 是什么?你了解吗?
- Redis 分布锁注意事项以及其它常见分布式锁的实现
- Redisson 分布式锁的原理
- 53. Redisson 看门狗(watch dog)机制了解吗?
22.3. 常见问题
22.3.1. 锁的过期时间设置多长合适?设短了业务没执行完锁就没了,设长了锁释放太慢,怎么权衡?
一般设置为业务预估执行时间的 2-3 倍,比如业务正常 10 秒,锁就设 30 秒。更优雅的方案是用 Redisson 的看门狗机制,默认 30 秒过期,后台线程每 10 秒检查一次,如果业务还在执行就自动续期,业务结束主动释放锁,锁的持有时间就刚刚好。
22.3.2. 如果 Redis 和客户端之间网络抖动,客户端以为加锁失败了其实成功了,这时候怎么办?
这种情况锁会一直卡在 Redis 里直到过期自动释放。所以过期时间不能设太长,同时客户端加锁失败后最好有重试机制,带上指数退避。如果是关键业务,可以在加锁前先查一下锁的状态,或者记录加锁日志方便排查。
22.3.3. Redisson 的看门狗是怎么实现自动续期的?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
Redisson 加锁时会启动一个后台线程,默认每 10 秒执行一次,检查锁是否还被当前线程持有。如果是,就用 Lua 脚本把锁的过期时间重置为 30 秒。线程释放锁或者客户端宕机后,后台线程停止,锁最终会过期自动释放。
22.3.4. 分布式锁除了 Redis,还有哪些实现方案?各自适合什么场景?
详细解答可以看:分布式锁一般都怎样实现?
常见的还有 ZooKeeper 和数据库。ZooKeeper 用临时顺序节点实现,可靠性比 Redis 高,适合对一致性要求严格的场景,比如分布式任务调度,但性能比 Redis 差不少。数据库可以用唯一索引或者 for update 实现,最简单但性能最差,只适合并发量很低的场景。Redis 性能最好,适合大多数互联网业务。
23. 分布式锁在未完成逻辑前过期怎么办?
23.1. 核心要点
核心解决方案是锁续期,在业务执行过程中定期延长锁的过期时间,确保业务没执行完锁就不会过期。
先说这个问题有多严重。假设客户端 A 拿到锁开始执行业务,业务还没执行完锁就过期了,客户端 B 趁机抢到锁也开始执行,两个客户端同时操作同一份数据,锁的互斥性就废了,数据不一致问题随之而来。
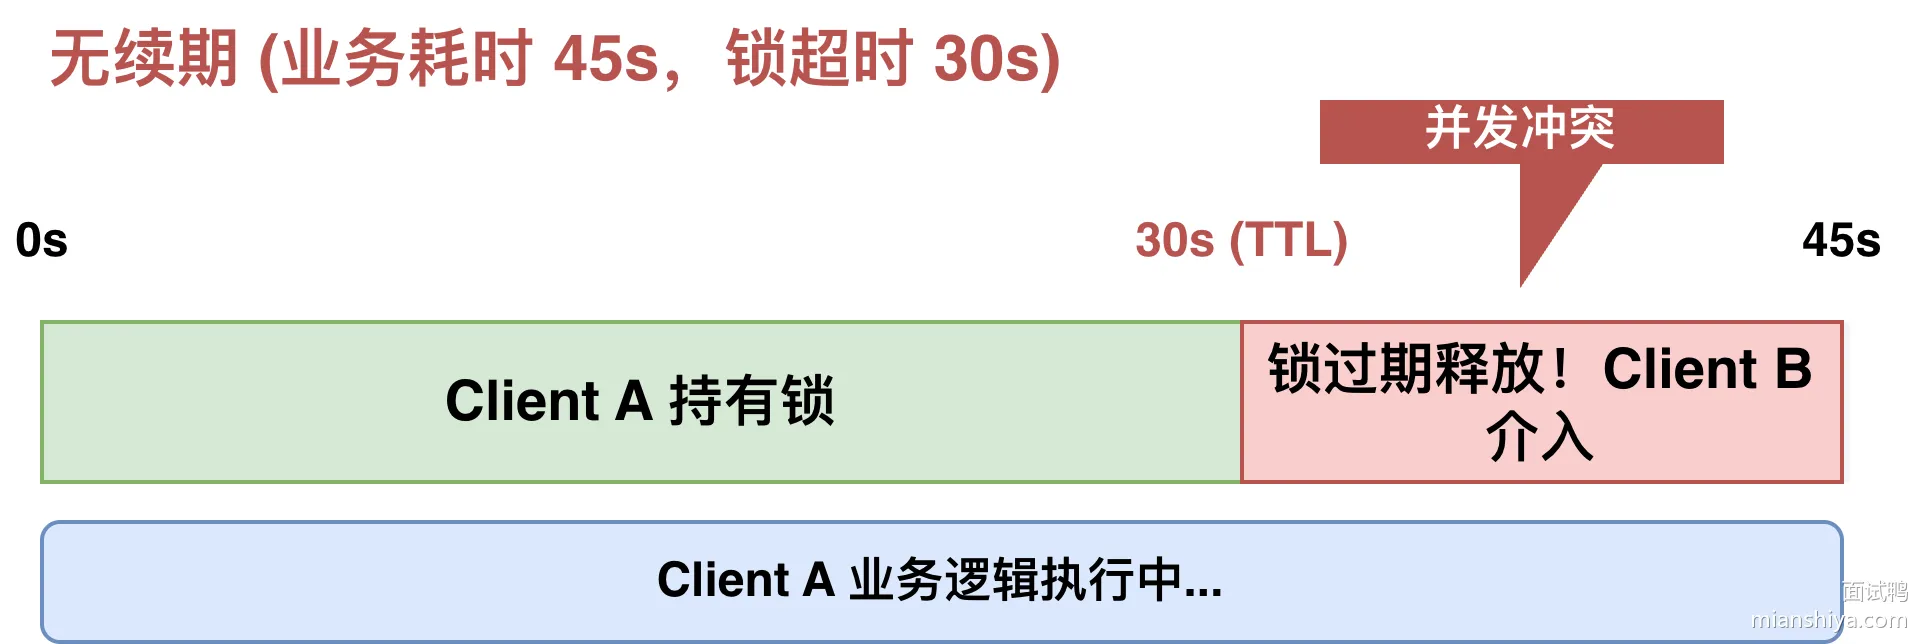
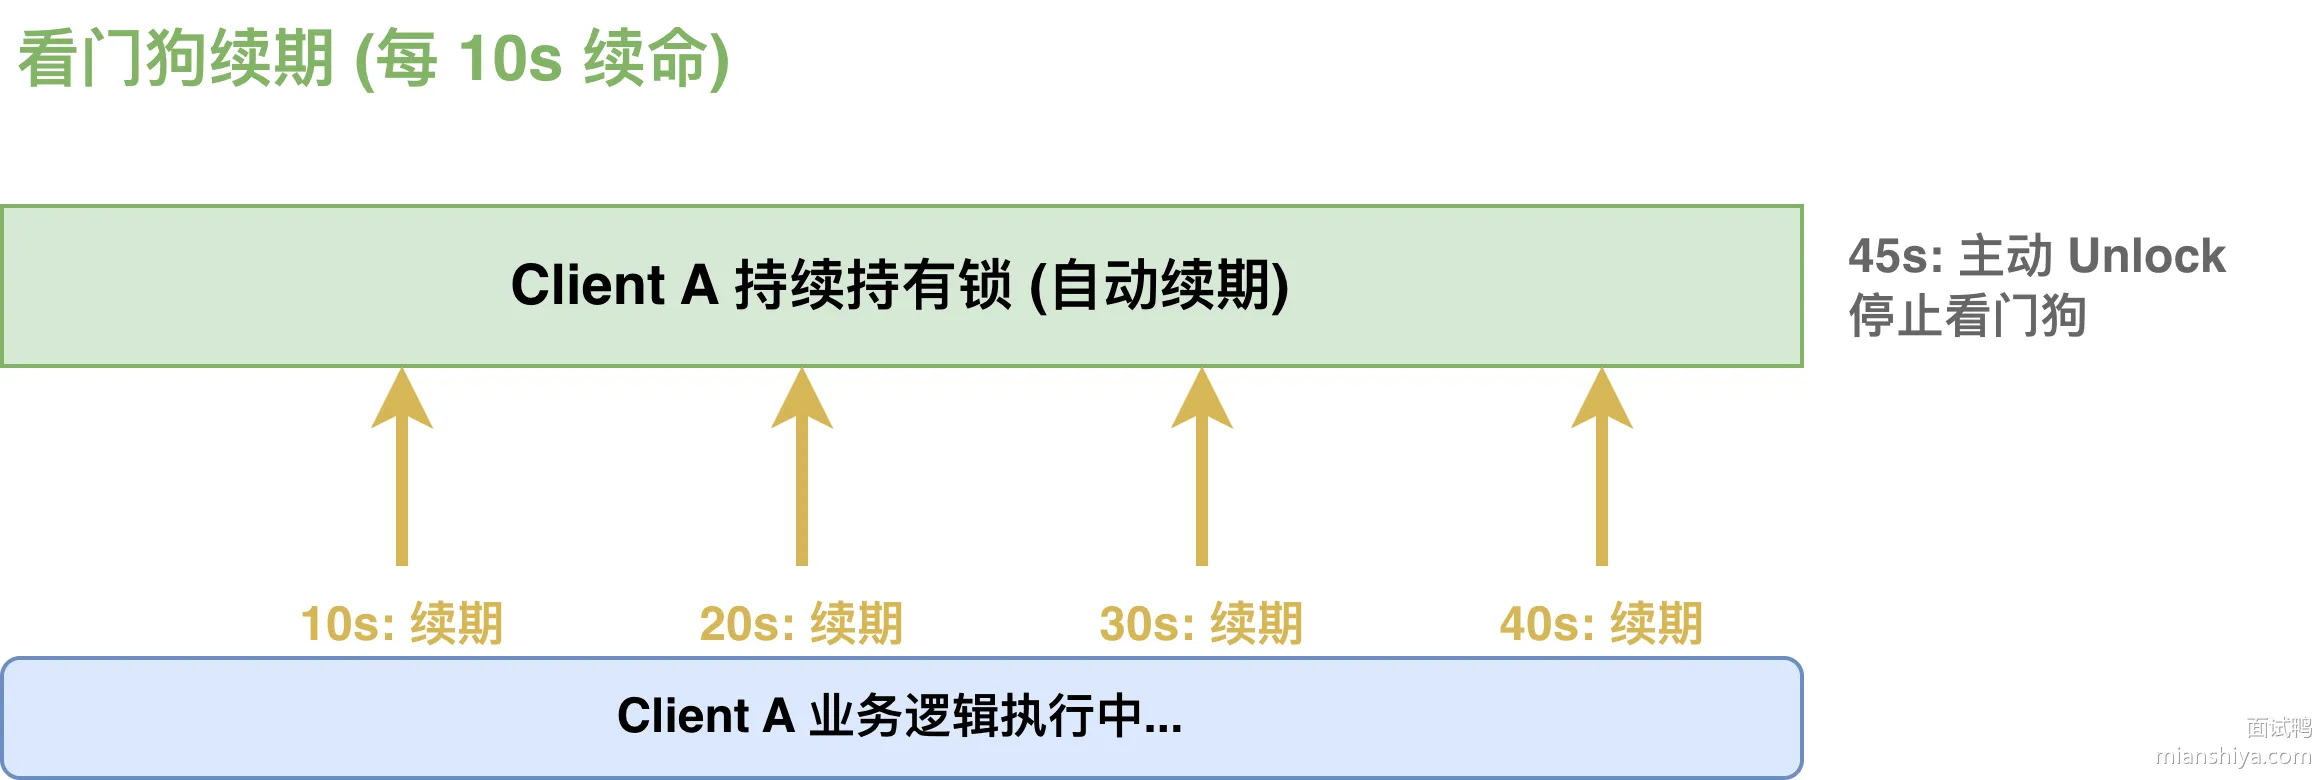
续期的思路很直接:后台起个定时任务,周期性地给锁"续命"。比如锁的过期时间是 30 秒,每隔 10 秒就把过期时间重置为 30 秒,只要业务在跑,锁就不会过期。业务执行完主动释放锁时,把定时任务一并停掉。
23.2. 扩展知识
23.2.1. 看门狗机制
业界管这套续期机制叫看门狗,Redisson 框架就是这么实现的。
Redisson 获取锁时,如果没有指定过期时间,会自动启用看门狗。默认锁的过期时间是 30 秒,看门狗每隔 10 秒检查一次,如果锁还被当前线程持有,就用 Lua 脚本把过期时间重置为 30 秒。
看门狗的底层是基于 Netty 的时间轮实现定时任务,时间轮比普通的 ScheduledThreadPool 更省资源,适合大量定时任务的场景。
Java 代码用 Redisson 实现分布式锁:
RLock lock = redissonClient.getLock("order_lock");
try {
    // 不指定过期时间,自动启用看门狗
    lock.lock();
    // 执行业务逻辑
    processOrder();
} finally {
    lock.unlock();
}
如果手动指定了过期时间,看门狗就不会启动:
// 指定10秒过期,不会自动续期
lock.lock(10, TimeUnit.SECONDS);
23.2.2. Redisson 可重入锁
Redisson 的分布式锁还支持可重入,同一个线程可以多次获取同一把锁而不会死锁。
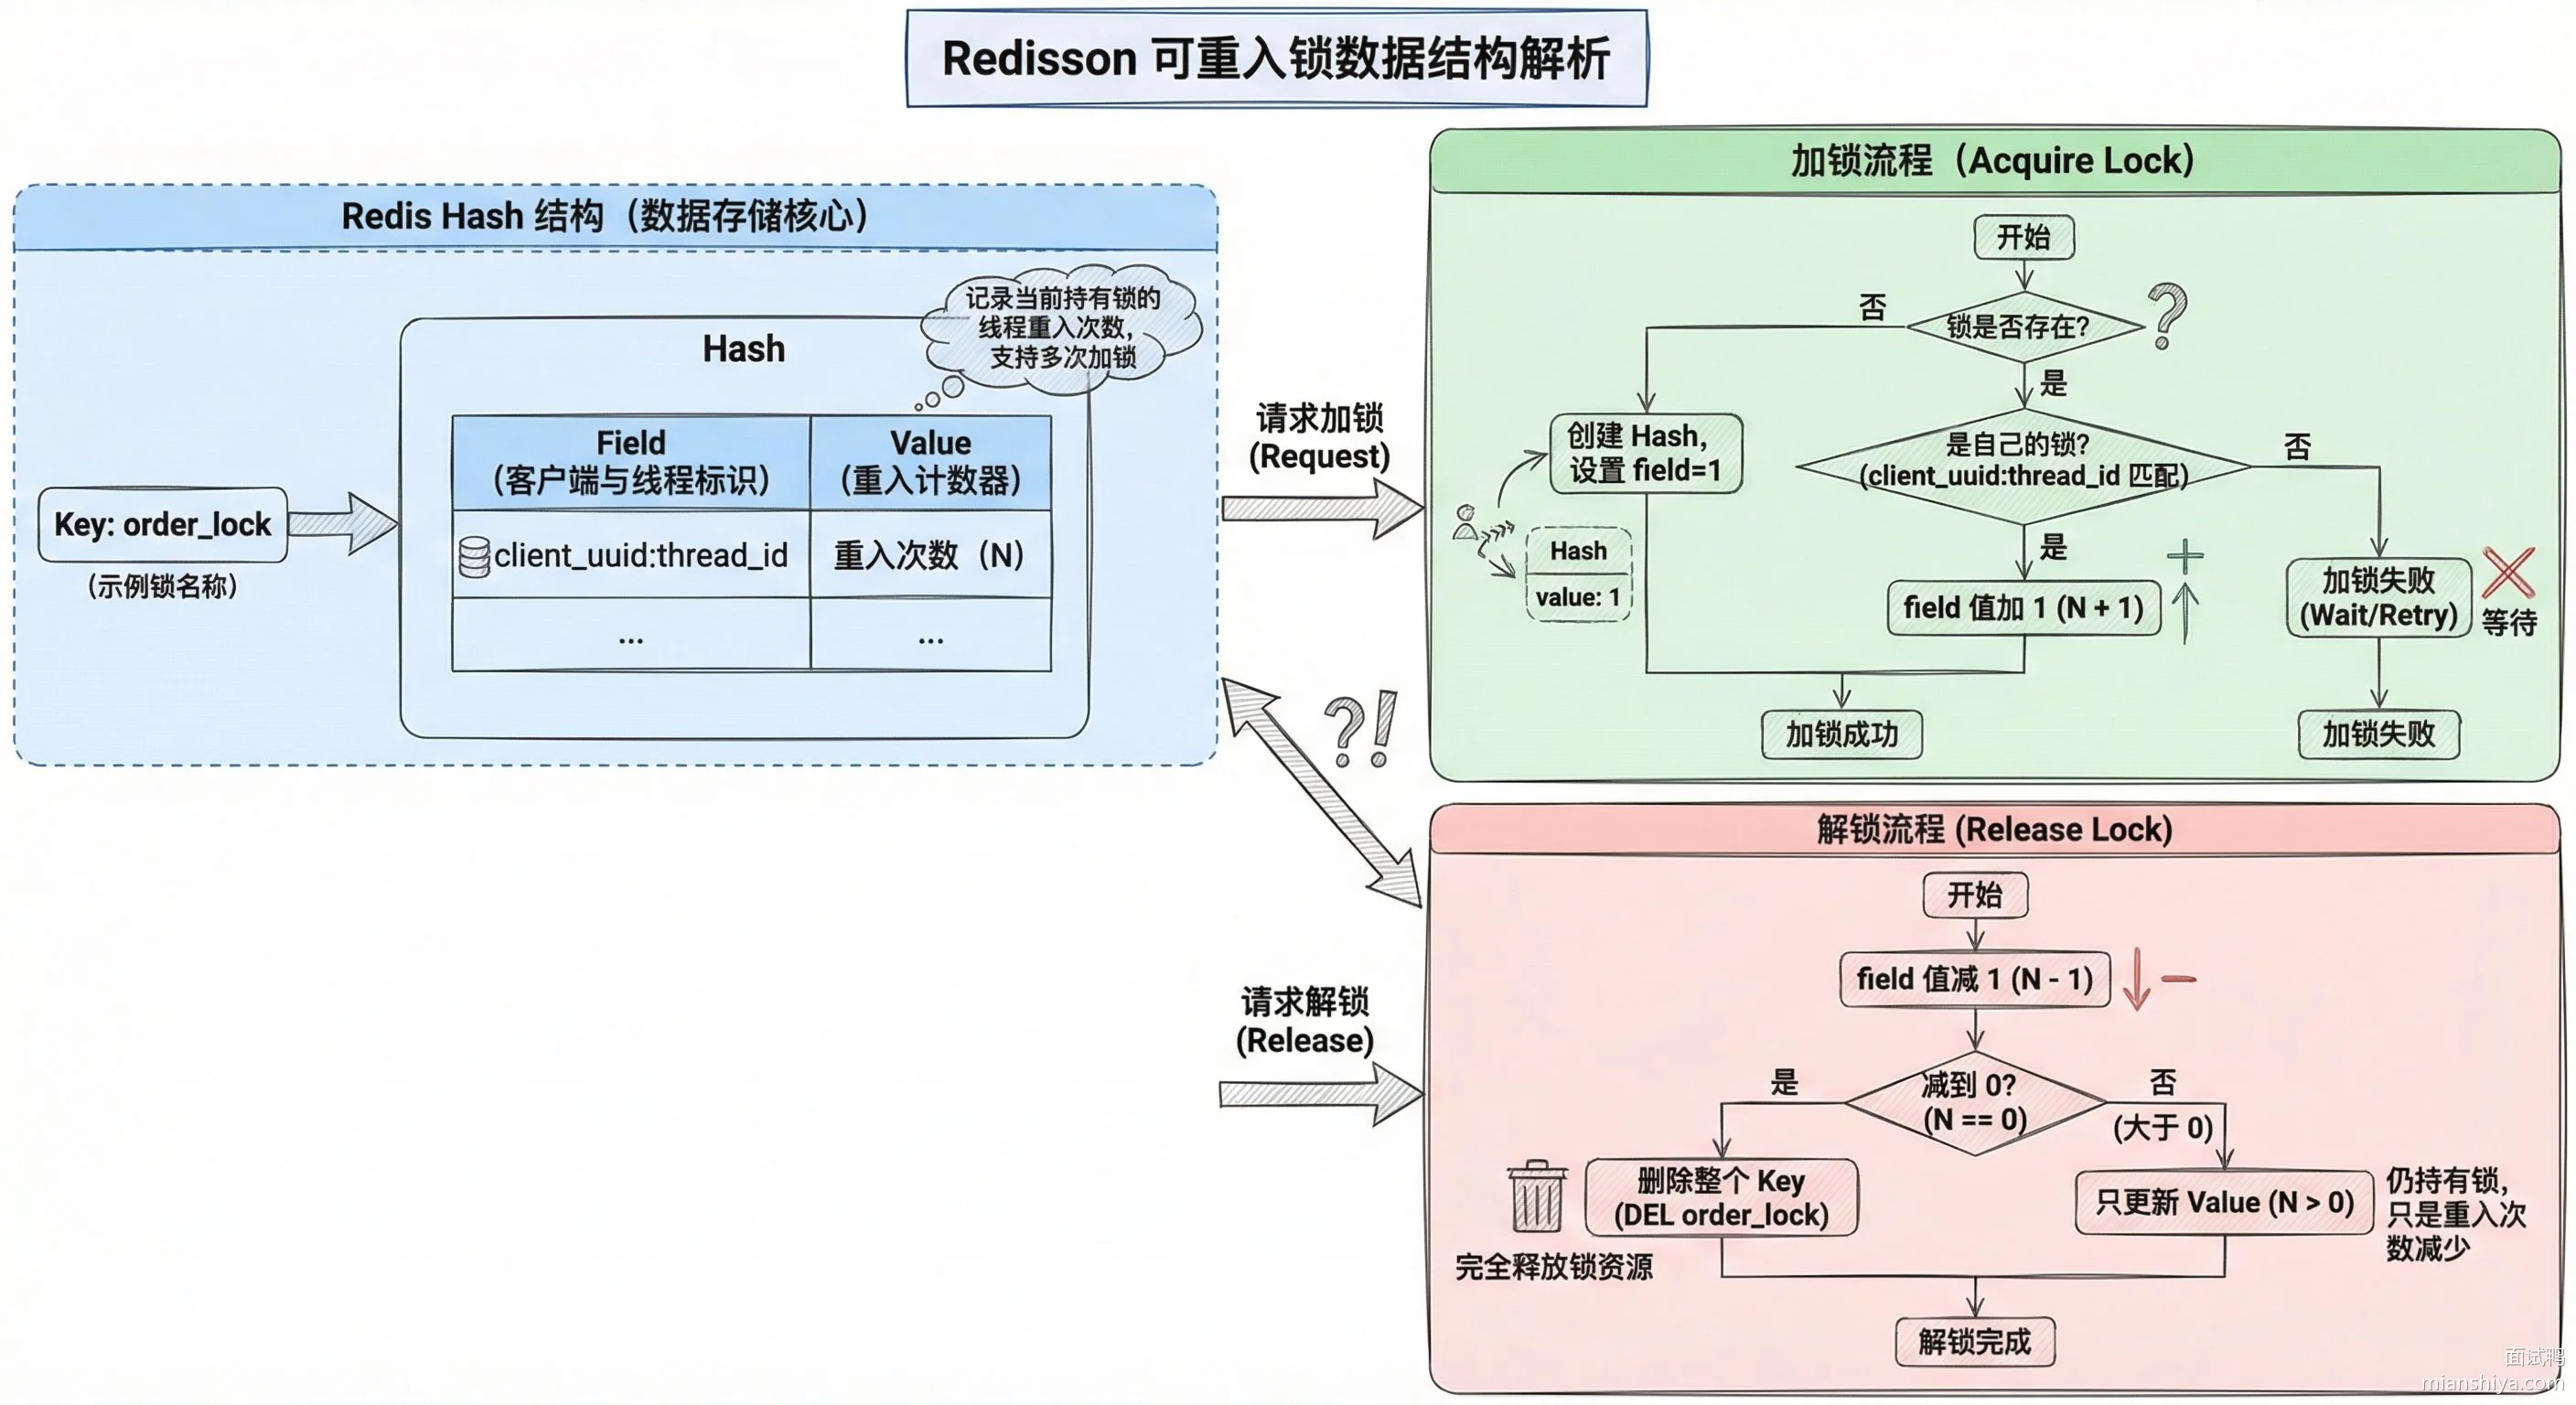
实现原理是用 Redis 的 Hash 结构存储锁信息,key 是锁名,field 是线程标识,value 是重入次数。加锁时先检查锁是否属于当前线程,是的话重入计数加 1;释放锁时计数减 1,减到 0 才真正删除锁。
23.2.3. 看门狗失效的场景
看门狗也不是万能的,有几种情况会失效:
1)客户端宕机,看门狗任务跟着没了,锁到期自动释放,这是正常行为 2)客户端和 Redis 之间网络断了,续期请求发不出去,锁也会过期 3)Redis 节点故障切换,新节点可能没有锁的数据
所以即使有看门狗,业务代码也要做好幂等处理,防止锁意外释放后被重复执行。
23.3. 常见问题
23.3.1. 看门狗续期的间隔是怎么定的?为什么是过期时间的三分之一?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
续期间隔设置为过期时间的 1/3 是为了留足冗余。假设锁 30 秒过期,每 10 秒续期一次,即使某一次续期因为网络抖动慢了几秒,锁也不会过期。如果间隔太长,比如 25 秒续一次,一旦某次续期失败锁就过期了,风险太大。
23.3.2. Redisson 的时间轮和 JDK 的 ScheduledThreadPool 有什么区别?为什么选时间轮?
详细解答可以看:你了解时间轮(Time Wheel)吗?有哪些应用场景?
ScheduledThreadPool 每个任务都要在堆里维护,任务多了插入删除都是 O(log n)。时间轮用数组加链表,任务按触发时间分布在不同的槽里,插入删除都是 O(1)。Redisson 要管理大量锁的续期任务,时间轮性能优势明显。
23.3.3. 如果业务代码出现死循环,看门狗会无限续期吗?锁会一直不释放吗?
对,只要线程还活着、锁还被持有,看门狗就会一直续期。所以业务代码要有超时控制,比如用 Future.get 设置超时,或者在外层加兜底的超时机制。发现执行时间异常长就主动中断线程、释放锁,避免资源被无限占用。
24. Redis 的 Red Lock 是什么?你了解吗?
24.1. 核心要点
Redlock 是 Redis 作者 Antirez 提出的分布式锁算法,专门解决主从架构下锁丢失的问题。
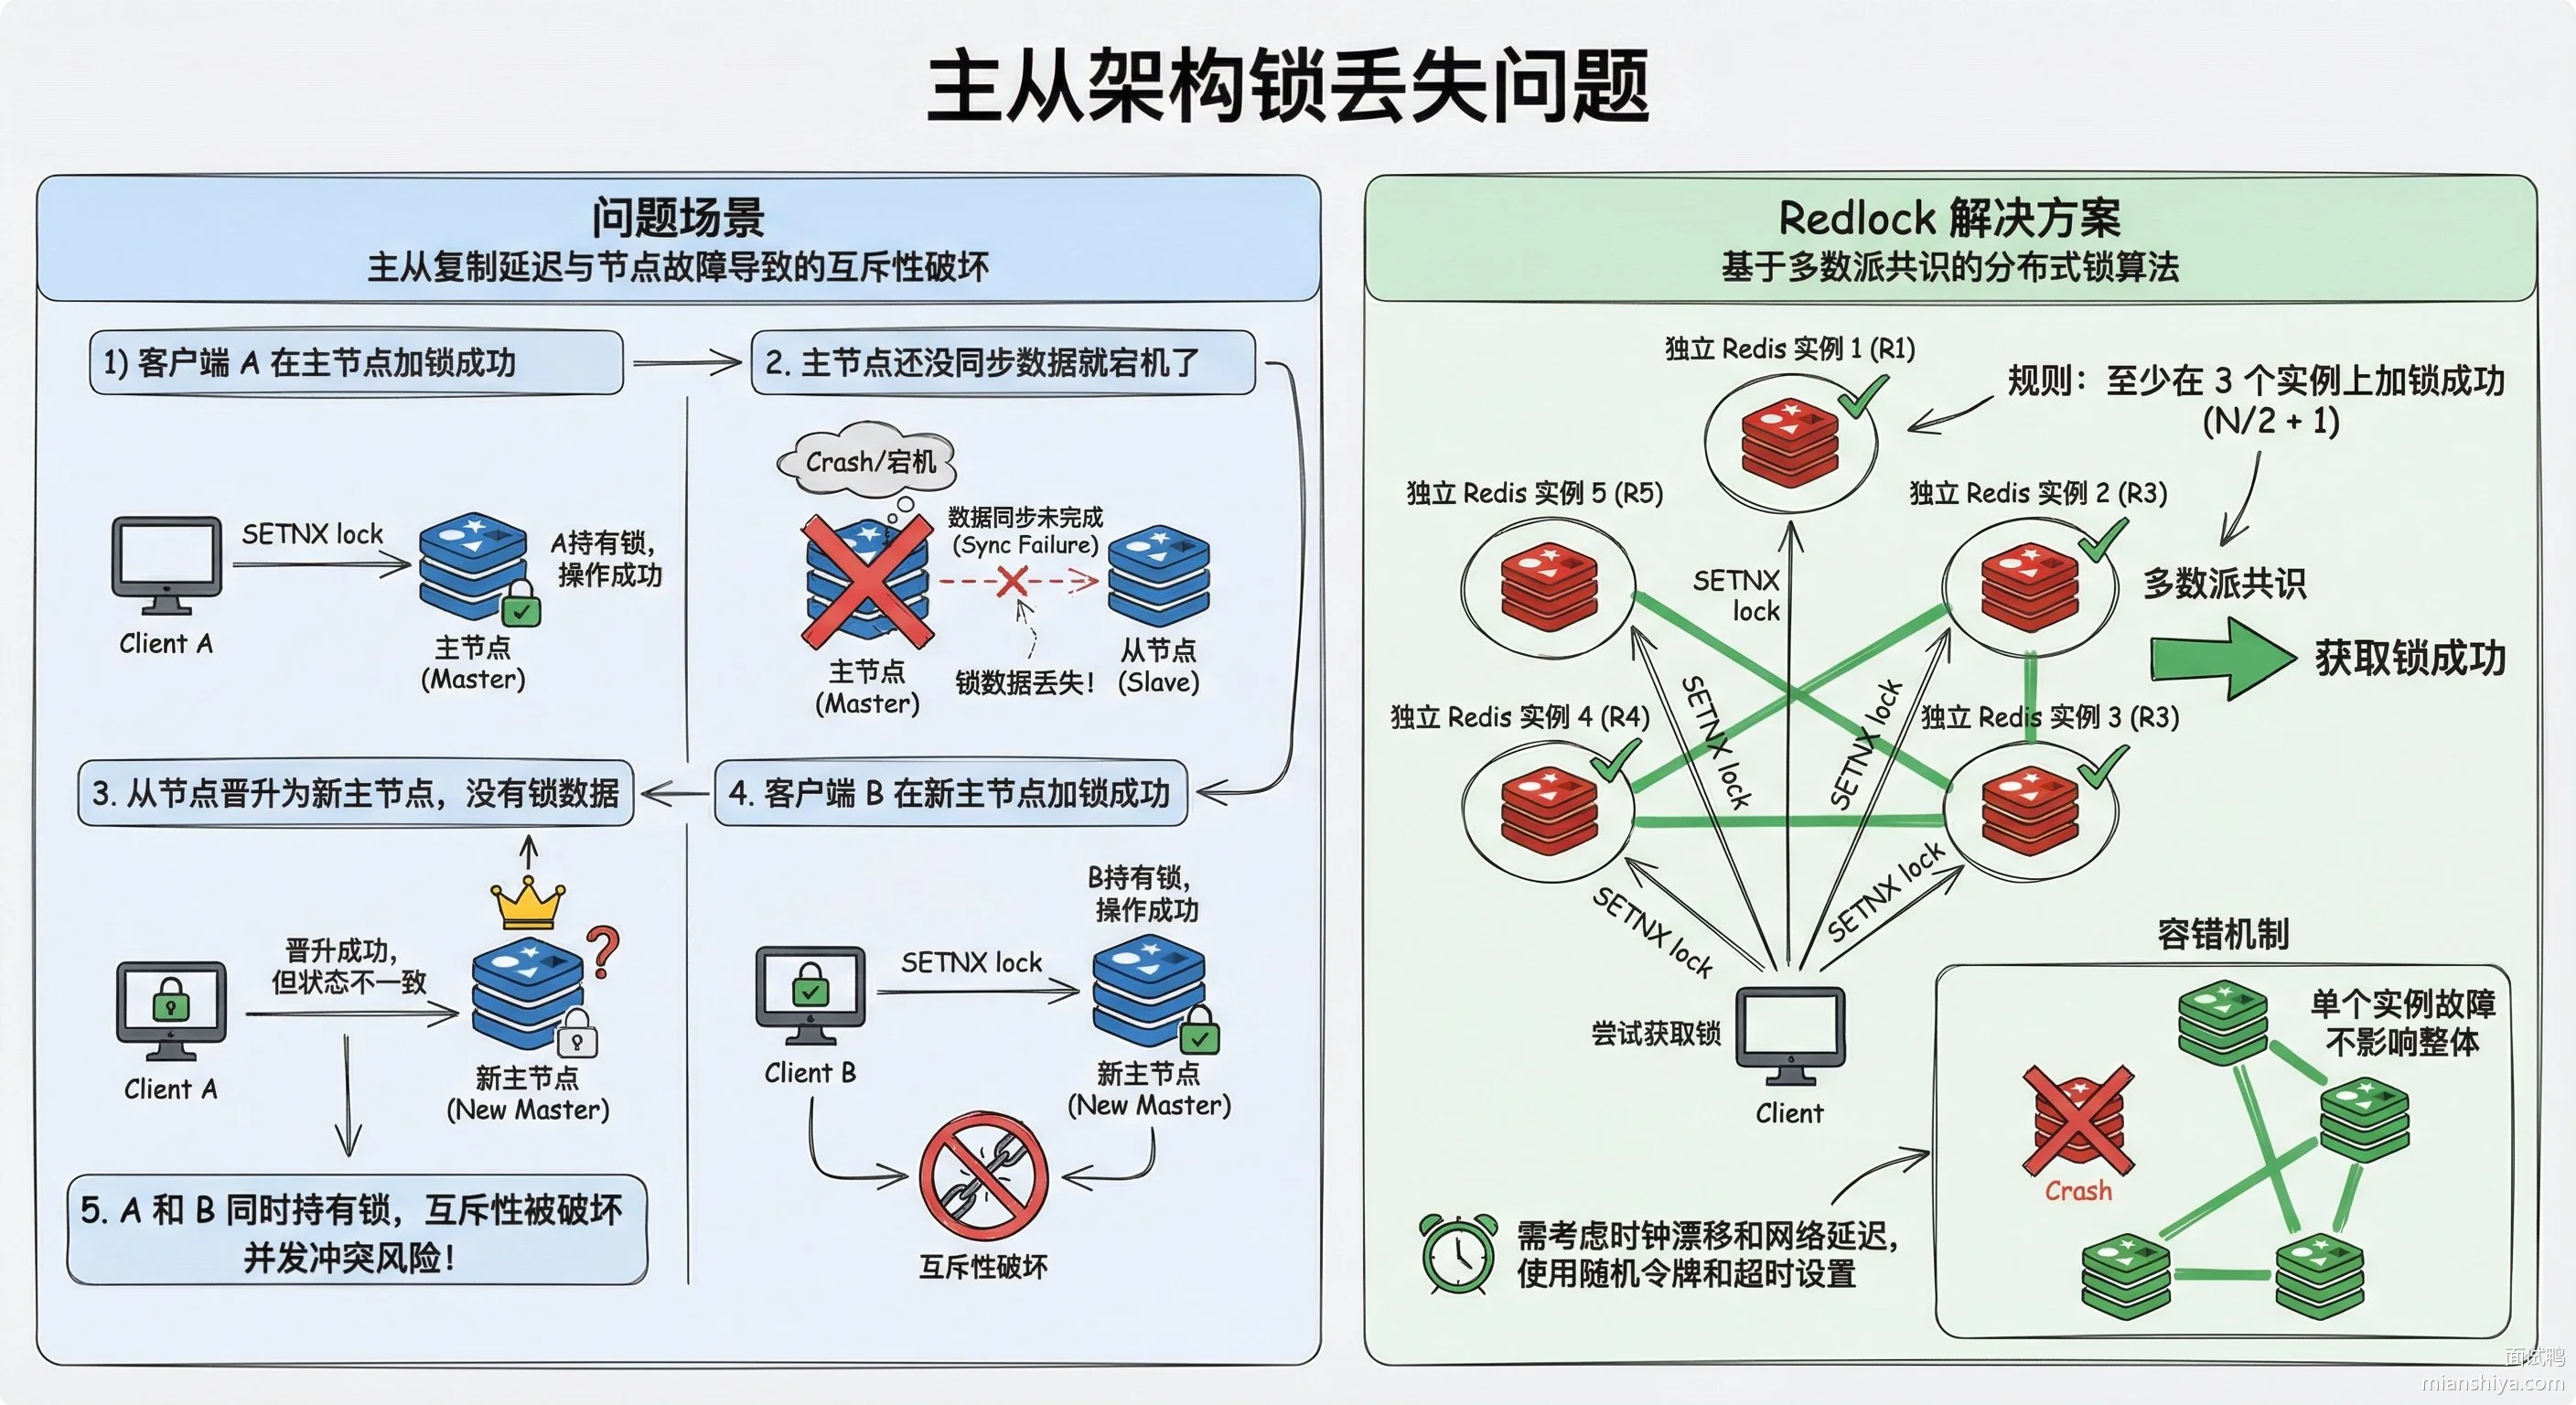
单机 Redis 做分布式锁有单点故障风险。主从架构也不保险:客户端在主节点加锁成功,主节点还没把锁数据同步到从节点就挂了,从节点晋升为新主节点,锁数据压根没同步过来。这时候另一个客户端来加锁,也能成功,两个客户端同时拿到锁,数据就乱了。
Redlock 的思路是用多个独立的 Redis 实例投票,只有拿到大多数节点的锁才算加锁成功。即使部分节点故障,锁的安全性依然有保障。
24.2. 扩展知识
24.2.1. Redlock 实现原理
部署 5 个独立的 Redis 实例,注意是完全独立的,不需要主从复制,不需要哨兵,也不是 Redis Cluster,5 个实例之间没有任何数据同步。
加锁流程:
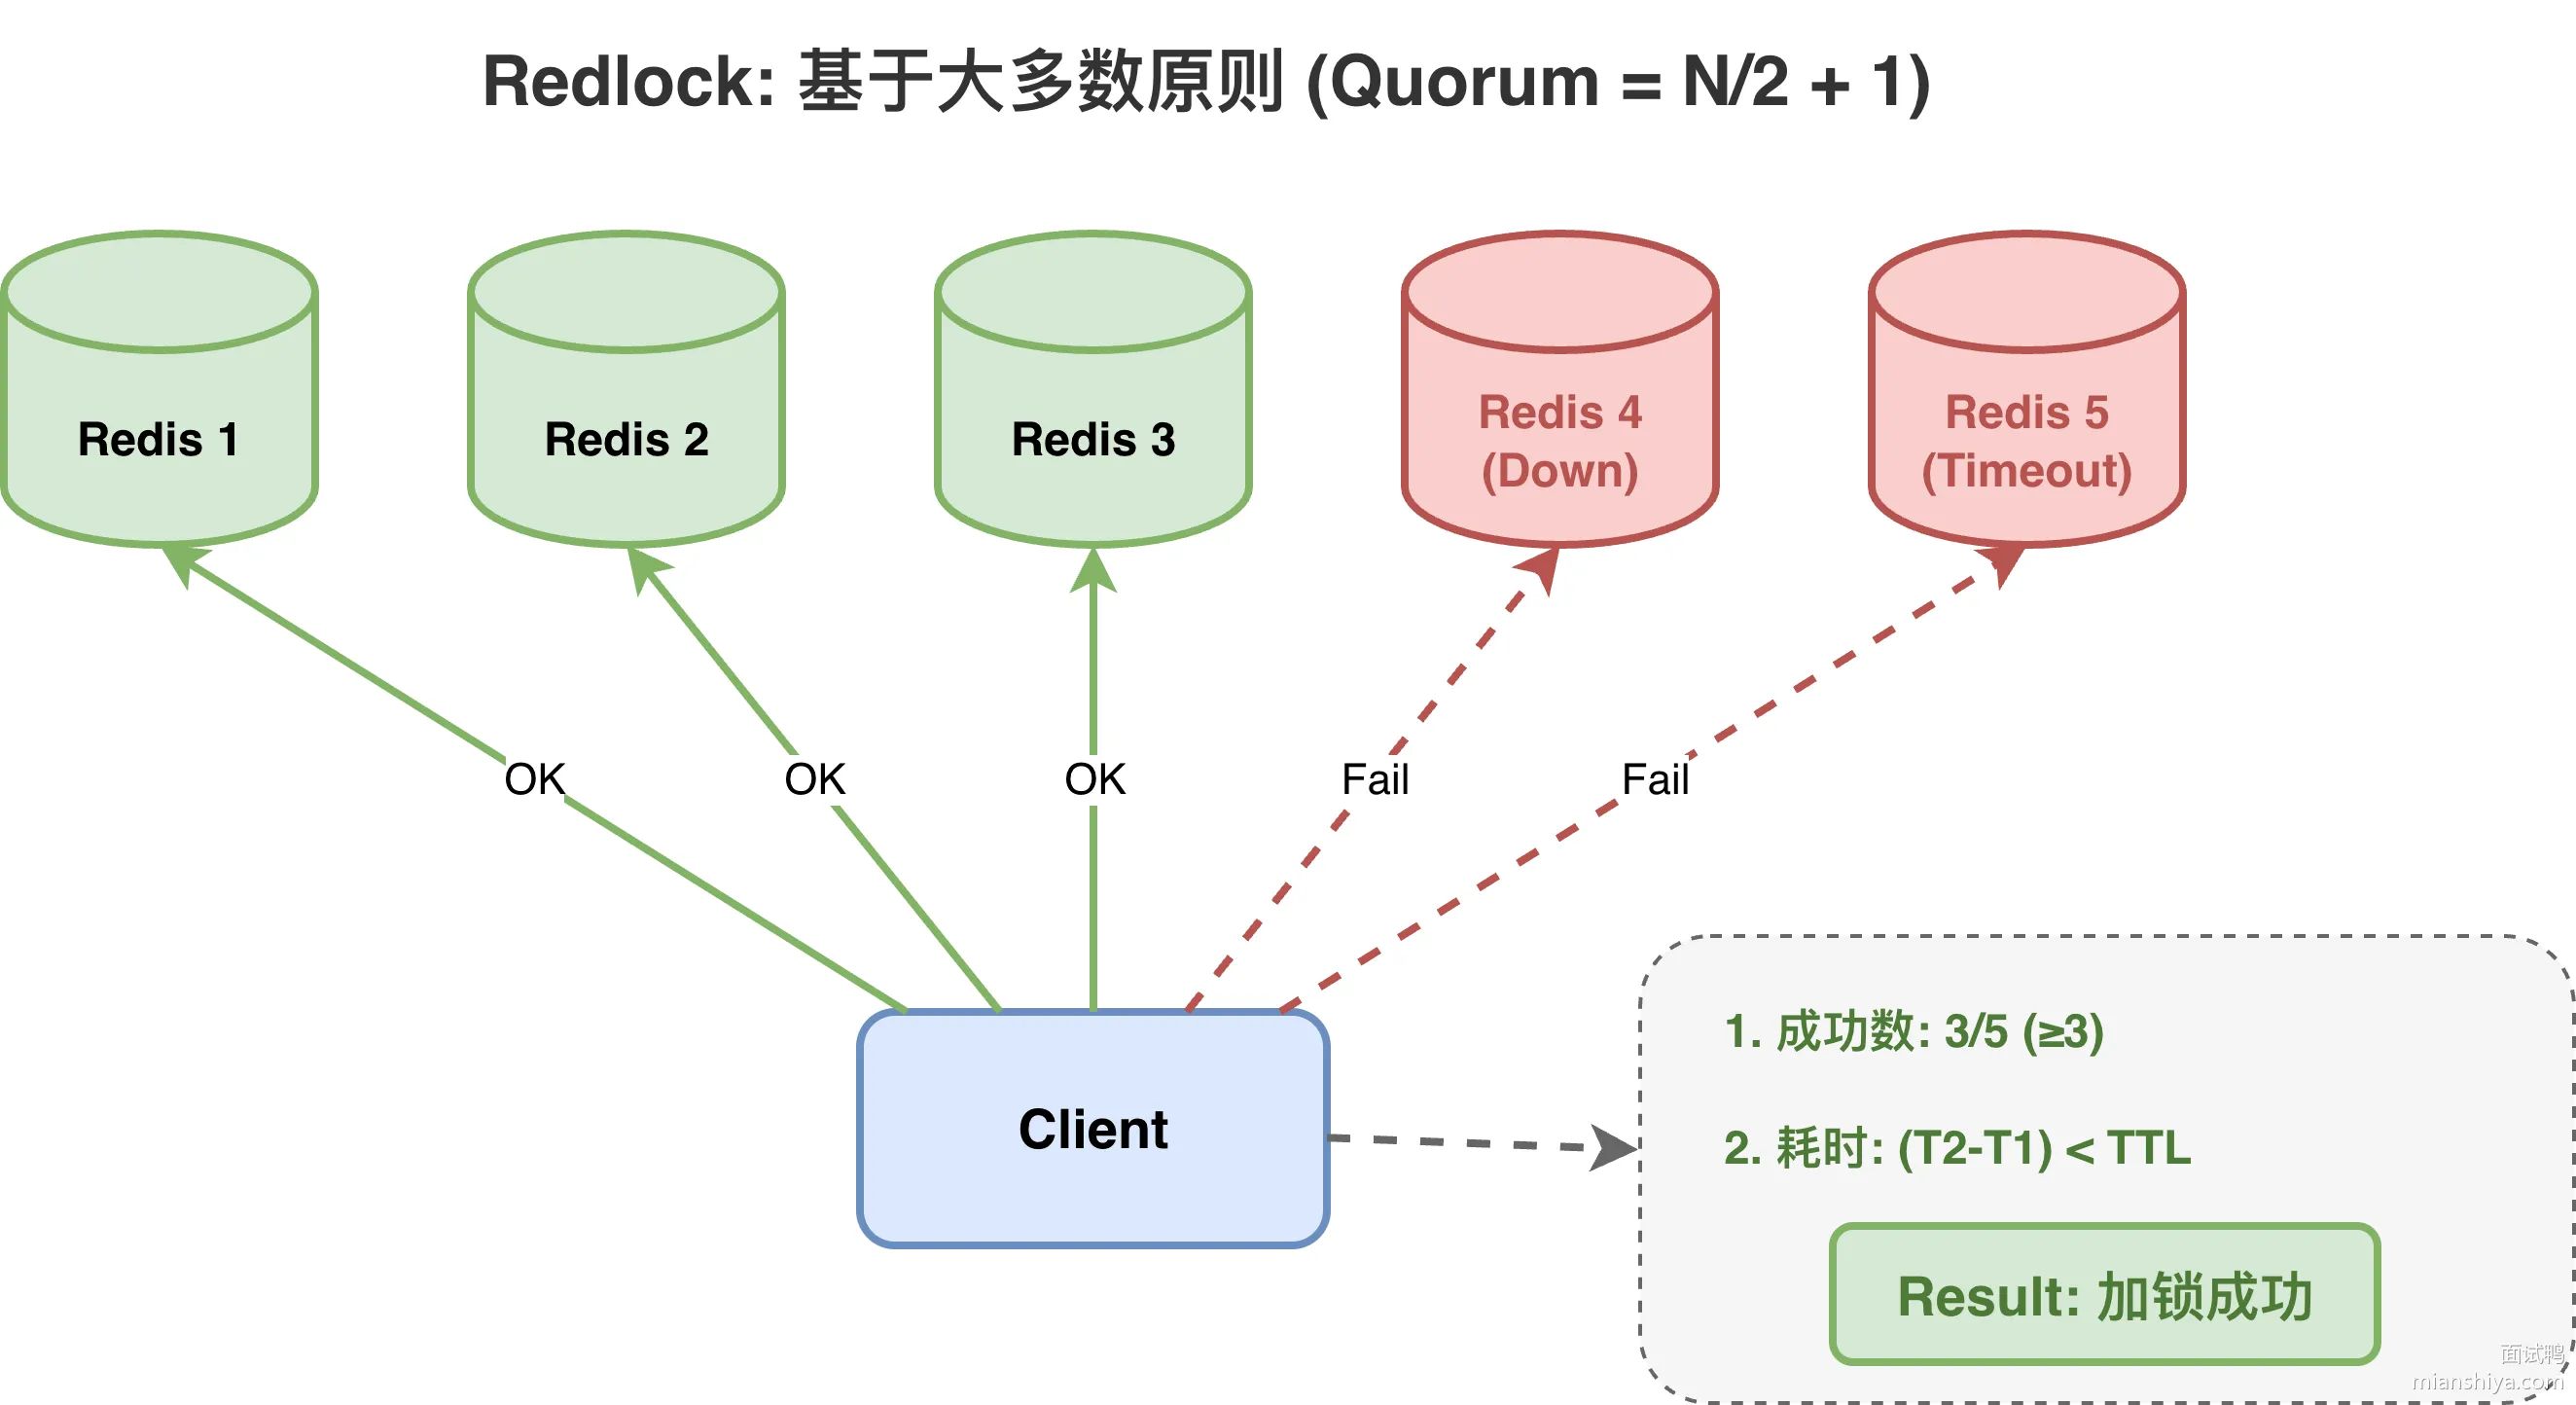
1)客户端记录当前时间戳 t1 2)依次向 5 个 Redis 实例发送 SET lock_key uuid EX 30 NX 命令 3)每个请求设置较短的超时时间,比如 5-50ms,某个实例超时就跳过 4)统计成功加锁的实例数量 5)获取当前时间戳 t2,计算加锁总耗时 t = t2 - t1 6)如果成功数量 >= 3 且 t < 锁的过期时间,加锁成功 7)否则向所有实例发送解锁请求
解锁流程:
向所有 5 个实例发送 DEL 命令,不管之前是否加锁成功
加锁和解锁的命令跟普通 Redis 分布式锁一样,都是 SET EX NX 加锁,Lua 脚本解锁。更详细可看《redis 如何实现分布式锁?》。
为什么要检查加锁耗时?假设锁的过期时间是 30 秒,加锁过程花了 25 秒,那锁实际只剩 5 秒有效期,业务很可能执行不完,这种情况算加锁失败更合理。
24.2.2. Redlock 一定安全吗
不一定。Martin Kleppmann 对 Redlock 提出过质疑,画了这张图:
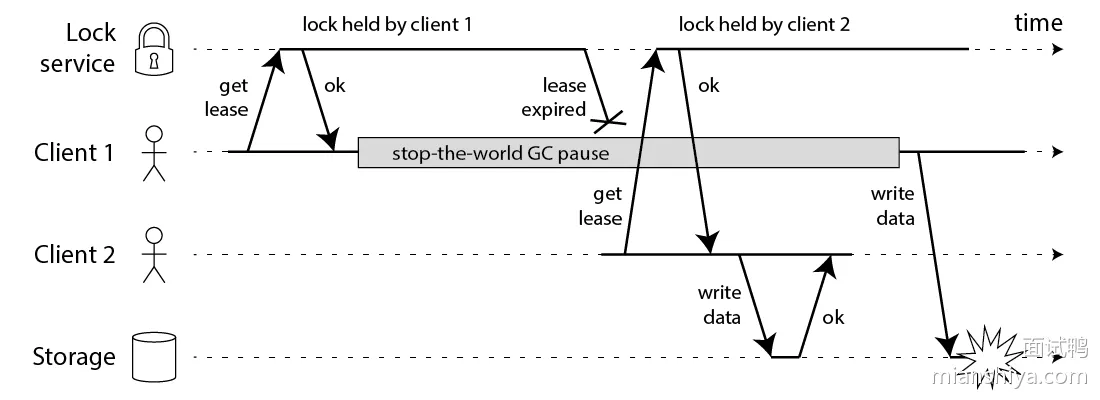
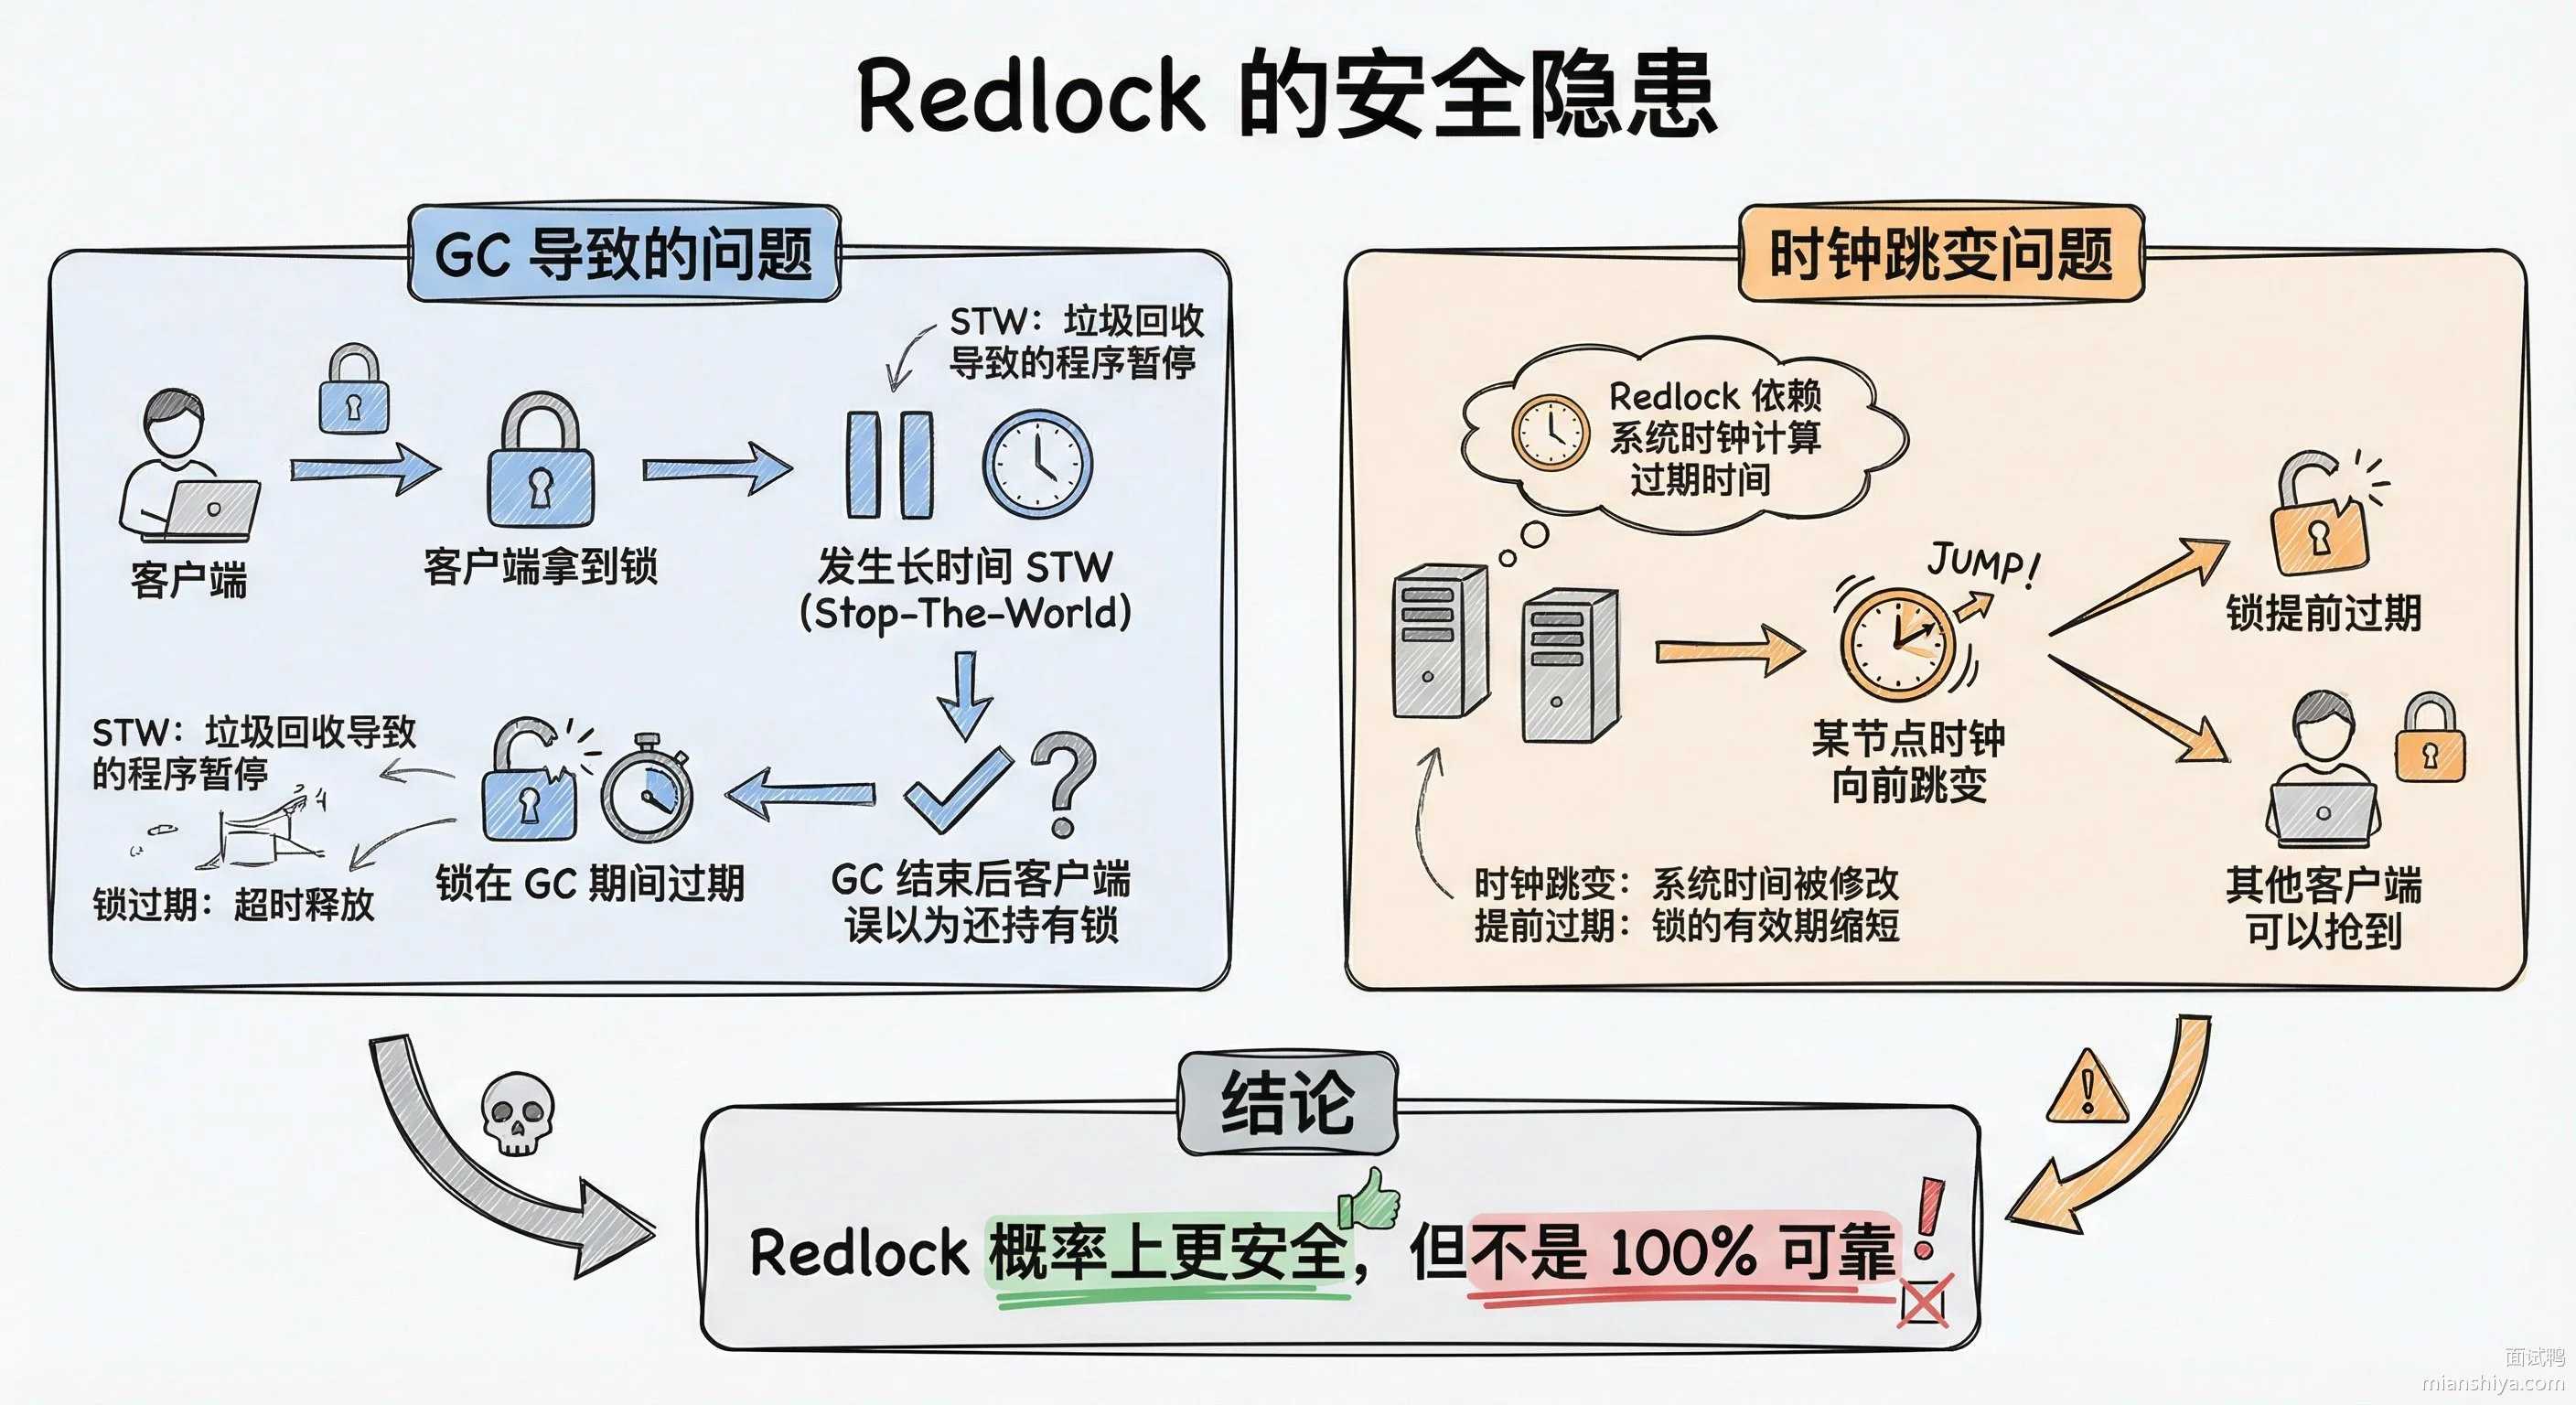
场景是这样的: 1)客户端 1 拿到 Redlock 2)客户端 1 发生长时间 GC,进程被暂停 3)GC 期间锁过期了 4)客户端 2 趁机拿到锁 5)GC 结束,客户端 1 不知道锁已经过期,继续执行业务 6)两个客户端同时操作临界资源
除了 GC,时钟跳变也是隐患。Redlock 依赖各节点的系统时间来计算锁的有效期,如果某个节点的时钟突然往前跳了,锁就会提前过期。
Antirez 回应说可以用 fencing token 机制来解决,但 Redis 本身并不支持 fencing token,需要业务端自己实现。
24.2.3. 生产环境的选择
Redlock 的实现成本不低: 1)需要部署至少 5 个独立实例,资源开销大 2)加锁要依次访问多个节点,延迟比单机高 3)极端情况下还是有问题
所以大多数业务场景还是用主从+哨兵的方案,配合 Redisson 的看门狗续期。只有对锁的可靠性要求极高的场景才考虑 Redlock,比如金融交易、库存扣减。
如果确实需要强一致性的分布式锁,可以考虑 ZooKeeper 或者 etcd,它们基于 Paxos/Raft 共识算法,一致性保证比 Redis 更强。
24.3. 常见问题
24.3.1. Redlock 为什么推荐部署 5 个实例而不是 3 个?
5 个实例允许最多 2 个节点故障还能正常工作,容错能力更强。3 个实例只允许 1 个故障,风险太大。而且 5 个是奇数,投票时不会出现平票的情况。实例数再多性能就太差了,5 个是性能和可靠性的平衡点。
24.3.2. 如果 Redlock 加锁成功了,但执行到一半有个 Redis 实例重启了,会有什么问题?
要看这个实例是否开启了 AOF 持久化。如果没开,重启后锁数据丢失,其他客户端可能在这个实例上加锁成功,配合其他实例可能凑够大多数票。所以用 Redlock 的实例必须开启 AOF 并且设置 fsync=always,保证每次写入都落盘。代价是性能会下降。
24.3.3. Martin Kleppmann 提到的 fencing token 是什么?怎么实现?
fencing token 是一个单调递增的序列号,每次加锁成功时分配一个 token。客户端操作共享资源时带上 token,资源端只接受 token 大于等于上次见过的最大值的请求。这样即使老客户端的锁过期了还在执行,它的 token 比新客户端小,请求会被拒绝。实现需要存储端支持版本比较,比如数据库的乐观锁、ZooKeeper 的版本号。
24.3.4. ZooKeeper 和 Redis 做分布式锁各有什么优劣?
详细解答可以看:如何利用 ZooKeeper 实现分布式锁?
ZooKeeper 用临时顺序节点实现,基于 ZAB 协议保证一致性,可靠性比 Redis 高,客户端宕机会话断开锁自动释放,不需要考虑续期。缺点是性能比 Redis 差一个数量级,QPS 大概几千,Redis 能到十万级。Redis 性能好但一致性弱,适合大多数互联网场景。金融、交易这种对一致性要求极高的场景用 ZooKeeper 更稳。
25. Redis 实现分布式锁时可能遇到的问题有哪些?
25.1. 核心要点
Redis 分布式锁看起来简单,但实际落地坑不少。核心问题集中在以下几个方面:
1)锁过期但业务没跑完:你锁设了 30 秒,结果业务逻辑跑了 35 秒,锁自动释放了,别的线程趁虚而入,数据就乱了。
2)误删别人的锁:A 拿到锁执行超时,锁自动过期;B 拿到新锁;A 执行完去删锁,把 B 的锁给删了。
3)主从同步延迟:主节点刚写入锁就挂了,数据还没同步到从节点,新主上来后锁就丢了,其他客户端照样能加锁成功。
4)单点故障:Redis 单机部署,挂了整个锁服务就瘫痪了。
5)时钟漂移:多节点的系统时间不一致,TTL 判断就不准了,锁可能提前失效或者迟迟不释放。
6)锁不可重入:同一个线程想再次获取同一把锁,直接被拒,递归调用场景下就死锁了。
25.2. 扩展知识
25.2.1. 锁过期与续约机制
锁必须设过期时间,不然客户端崩了锁就永远释放不了。但过期时间设多少是个学问:设太短,业务没跑完锁就没了;设太长,异常情况下锁迟迟不释放,后面的请求全卡着。
Redisson 的看门狗机制是目前比较成熟的方案。默认锁过期时间 30 秒,后台每 10 秒检查一次:业务还在跑就续期到 30 秒,业务结束或线程挂了就停止续约,让锁自然过期。
// Redisson 看门狗自动续约
RLock lock = redisson.getLock("order:lock:12345");
lock.lock(); // 不指定过期时间,默认开启看门狗
try {
    // 业务逻辑
} finally {
    lock.unlock();
}
25.2.2. 误删锁的解决方案
每次加锁带上唯一标识,比如 UUID + 线程 ID,删锁前先校验是不是自己的锁。这个"判断 + 删除"必须是原子操作,用 Lua 脚本搞定:
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
25.2.3. 主从同步问题与 RedLock
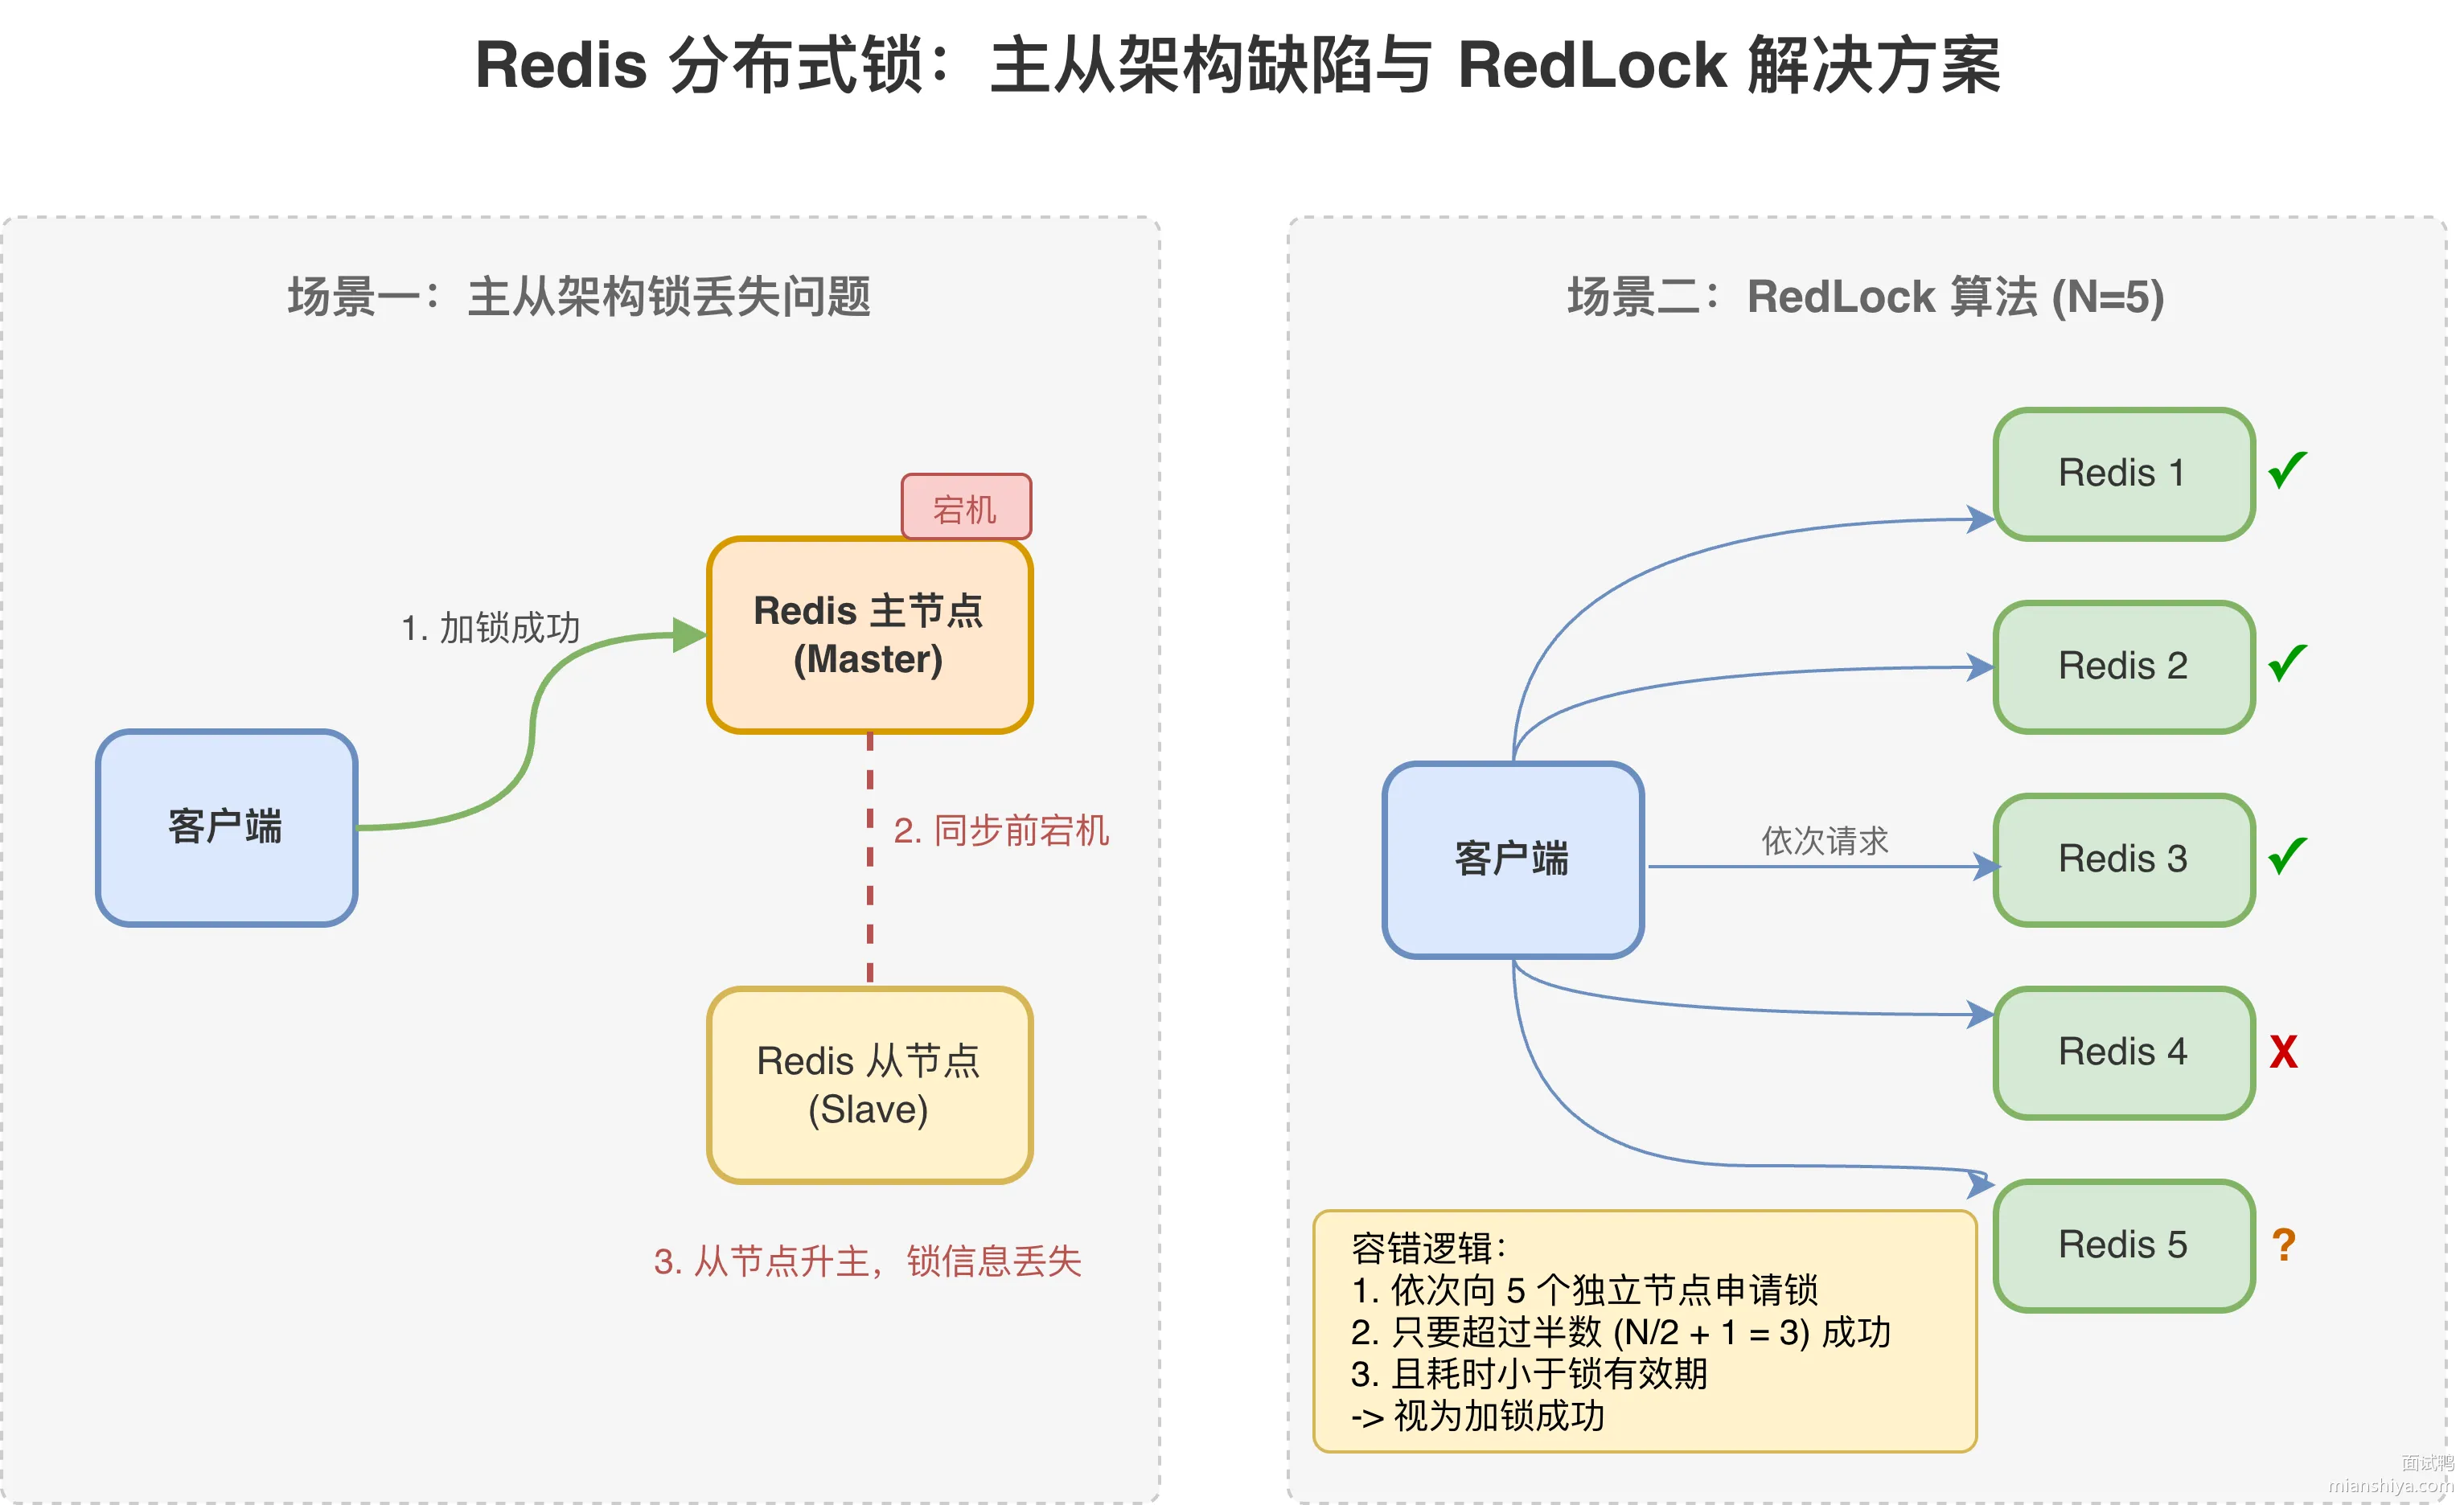
主从架构下,主节点加锁成功后还没来得及同步就挂了,从节点升主后锁就丢了。Redis 作者提出的 RedLock 算法就是解决这个问题的:
部署 N 个独立的 Redis 实例,比如 5 个,加锁时依次向所有实例申请锁。只有超过半数的实例都加锁成功,才算真正拿到锁。这样即使挂了 1-2 个节点,锁的安全性依然有保障。
不过 RedLock 也有争议。Martin Kleppmann 就写文章怼过,说它在网络延迟、进程暂停等极端情况下仍然可能出问题。实际项目中,如果对锁的可靠性要求特别高,可以考虑 ZooKeeper 或 etcd 这种基于共识算法的方案。
25.2.4. 可重入锁实现
同一个线程可能需要多次获取同一把锁,比如递归调用或者嵌套方法。实现思路是用 Hash 结构存储,key 是锁名,field 是客户端标识,value 是重入次数。每次加锁 +1,解锁 -1,减到 0 才真正删除锁。
// Redisson 天然支持可重入
RLock lock = redisson.getLock("reentrant:lock");
lock.lock();
try {
    // 嵌套调用也能再次获取锁
    lock.lock();
    try {
        // 业务逻辑
    } finally {
        lock.unlock();
    }
} finally {
    lock.unlock();
}
25.2.5. 时钟漂移的影响
Redis 用 TTL 判断锁过期,依赖系统时间。如果各节点时钟不同步,可能导致锁提前失效或延迟释放。生产环境务必配置 NTP 服务同步时间,时钟偏差控制在毫秒级。
25.3. 常见问题
25.3.1. RedLock 算法为什么要求超过半数节点加锁成功?少于半数可以吗?
详细解答可以看:Redis 的 Red Lock 是什么?你了解吗?
必须超过半数是为了保证任意时刻最多只有一个客户端持有锁。假设 5 个节点,客户端 A 拿到 3 个节点的锁,客户端 B 最多只能拿到剩下 2 个,拿不到半数以上就加锁失败。如果只要求 2 个节点成功,A 和 B 就可能同时各拿 2 个节点的锁,违背互斥原则。
25.3.2. 看门狗续约机制有什么风险?如果业务代码死循环了怎么办?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
确实是个坑,业务死循环或者卡住,看门狗会一直续约,锁永远不释放。所以在核心业务场景中或者有可能死循环的业务中,不应该完全依赖看门狗,而是通过显式 leaseTime、tryLock 超时以及业务级超时控制,来保证锁最终一定可释放。
25.3.3. Redisson 看门狗的续约间隔和过期时间具体是多少?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
默认锁过期时间是 30 秒,续约间隔是过期时间的三分之一,也就是 10 秒检查一次。如果业务还在执行就续期到 30 秒。这两个值可以通过 Config 配置修改。
26. Redis 中的缓存击穿、缓存穿透和缓存雪崩是什么?
26.1. 核心要点
这三个概念都是缓存失效导致请求打到数据库的场景,区别在于失效的原因和范围不同:
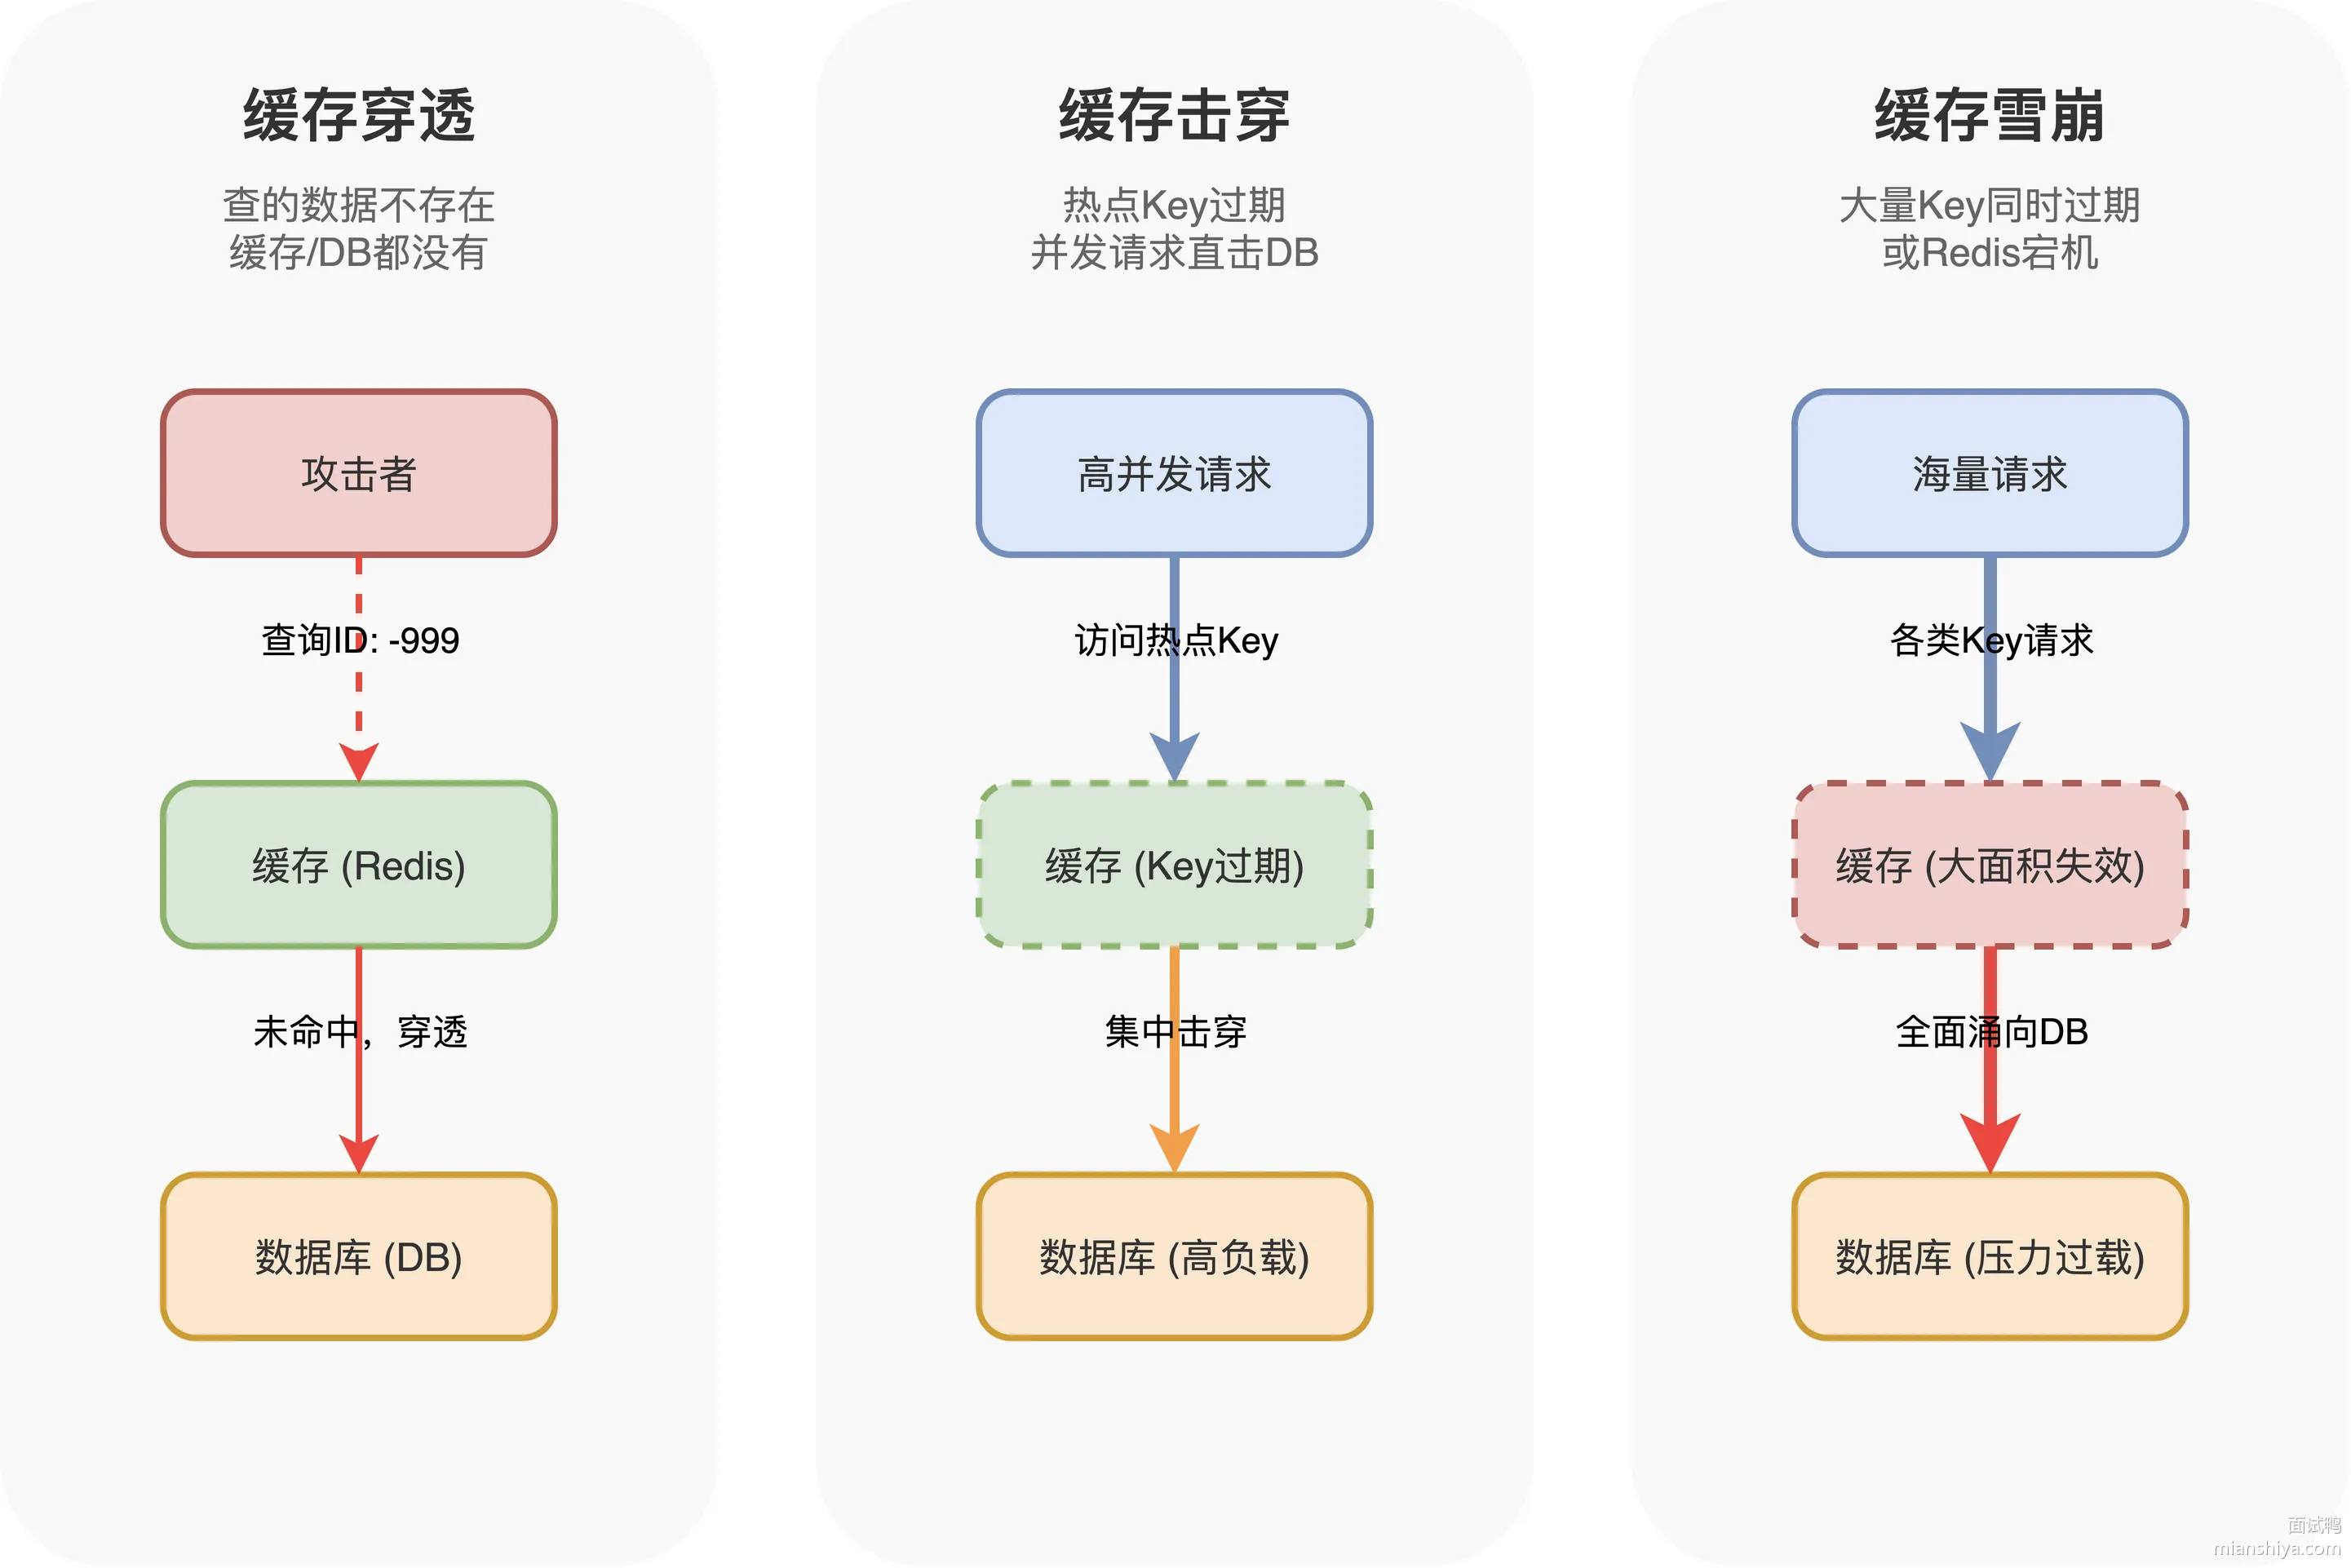
缓存穿透:查的数据压根不存在,缓存里没有,数据库里也没有。攻击者随便编一个不存在的 ID 疯狂请求,每次都穿透到数据库。
缓存击穿:某个热点 key 过期的瞬间,大量请求同时涌进来,全都打到数据库。比如秒杀商品的缓存刚好过期,几万请求一下子砸过去。
缓存雪崩:大批量 key 同时过期,或者 Redis 整个挂了,请求全部涌向数据库。击穿是一个 key,雪崩是一片 key。
解决思路各有侧重:穿透靠布隆过滤器拦截非法请求;击穿靠互斥锁或热点永不过期;雪崩靠过期时间打散和高可用架构。
26.2. 扩展知识
26.2.1. 缓存穿透详解
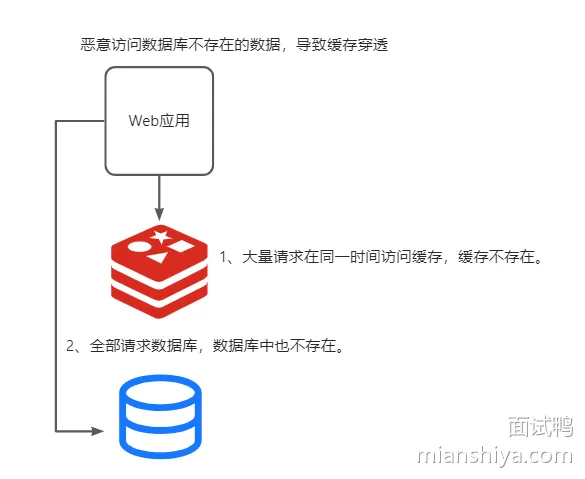
穿透是最危险的,因为它往往是恶意攻击。攻击者构造大量不存在的 key,比如用户 ID 传 -1 或者随机字符串,缓存里肯定没有,数据库查了也是空,每次请求都要走一遍数据库,轻轻松松就把数据库打崩。
防御手段有三层:
1)入口校验:参数合法性检查放在最前面,ID 小于 0 直接拒绝,格式不对直接返回。
2)布隆过滤器:用 Guava 或者 Redis 自带的 RedisBloom 模块,把所有合法 key 预先加载进去。请求来了先问布隆过滤器,说不存在就肯定不存在,直接返回。布隆过滤器可能误判存在,但不会误判不存在。
3)缓存空值:数据库查了确实没有,也往缓存里写一个空标识,过期时间设短点比如 2-5 分钟,防止同一个不存在的 key 反复穿透。
public String getData(String key) {
    String value = redis.get(key);
    if (value != null) {
        return "NULL".equals(value) ? null : value;
    }
    // 布隆过滤器判断
    if (!bloomFilter.mightContain(key)) {
        return null;
    }
    String dbValue = queryDatabase(key);
    if (dbValue == null) {
        // 缓存空值,过期时间 5 分钟
        redis.setex(key, 300, "NULL");
    } else {
        redis.setex(key, 3600, dbValue);
    }
    return dbValue;
}
26.2.2. 缓存击穿详解
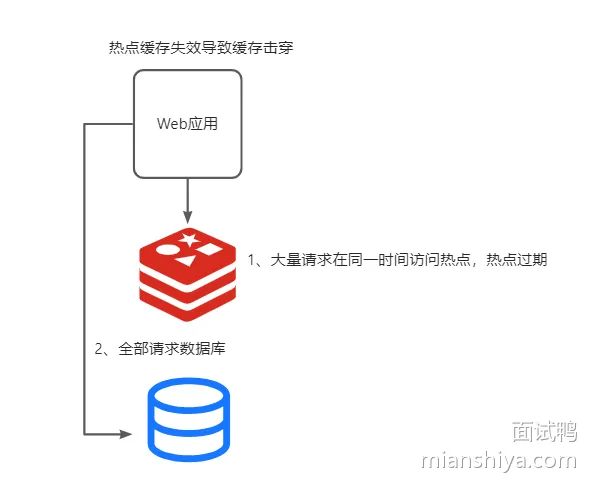
击穿针对的是热点数据。双 11 零点抢 iPhone,这个商品详情缓存了,但刚好在 23:59:59 过期,零点一到几十万请求同时涌过来,缓存没了,全部打数据库,数据库瞬间就炸了。
解决方案主要两种:
1)互斥锁重建缓存:缓存失效时只让一个请求去数据库加载,其他请求等着或者返回旧值。分布式环境用 Redis 的 SETNX 实现分布式锁。
public String getWithMutex(String key) {
    String value = redis.get(key);
    if (value == null) {
        String lockKey = "lock:" + key;
        // 尝试获取锁,设置 3 秒超时防止死锁
        if (redis.setnx(lockKey, "1", 3)) {
            try {
                // 双重检查
                value = redis.get(key);
                if (value == null) {
                    value = queryDatabase(key);
                    redis.setex(key, 3600, value);
                }
            } finally {
                redis.del(lockKey);
            }
        } else {
            // 没拿到锁,睡 50ms 重试
            Thread.sleep(50);
            return getWithMutex(key);
        }
    }
    return value;
}
2)热点数据永不过期:物理上不设过期时间,逻辑上在 value 里存一个过期时间戳。后台起个线程定期检查,快过期了就主动刷新。请求来了发现逻辑过期,也能返回旧数据,不至于卡住。
26.2.3. 缓存雪崩详解
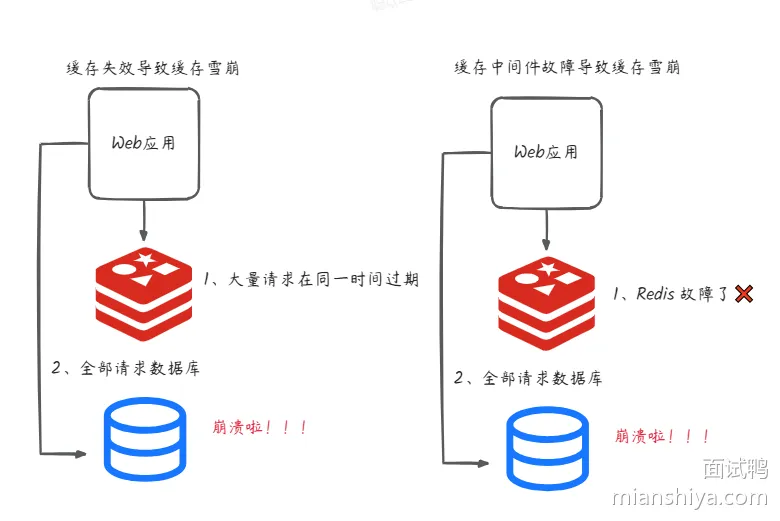
雪崩分两种情况:大量 key 同时过期,或者 Redis 服务整体挂掉。
大量 key 同时过期的场景:系统上线时批量预热缓存,都设了 1 小时过期,1 小时后集体失效,请求蜂拥到数据库。
解决办法是过期时间加随机值,比如基础过期时间 1 小时,再加 0-10 分钟的随机数,把过期时间打散开:
int baseExpire = 3600;
int randomExpire = new Random().nextInt(600);
redis.setex(key, baseExpire + randomExpire, value);
Redis 服务挂掉的场景就更严重了,所有请求都没地方去。这时候需要从架构层面防御:
1)Redis 高可用:主从 + 哨兵,或者 Redis Cluster,挂一个节点不影响整体服务。
2)本地缓存兜底:用 Caffeine 或 Guava Cache 做一层本地缓存,Redis 挂了还能顶一阵。
3)服务熔断降级:用 Sentinel 或 Hystrix,发现数据库压力过大直接熔断,返回默认值或错误提示,保住系统不崩。
4)缓存预热:系统启动或发布后,主动把热点数据加载到缓存,避免冷启动时大量请求穿透。
26.3. 常见问题
26.3.1. 布隆过滤器说不存在就一定不存在,但说存在可能是误判,误判率怎么控制?
误判率和两个参数有关:位数组大小和哈希函数个数。位数组越大、哈希函数越多,误判率越低,但内存占用和计算开销也越高。工程上一般把误判率控制在 1% 以内就够用了。比如 1 亿个元素,用 12 亿 bit 大约 150MB 内存,配 8 个哈希函数,误判率能压到 0.1% 左右。
26.3.2. 用互斥锁解决击穿,没拿到锁的请求是等着还是直接返回?两种策略怎么选?
看业务容忍度。如果业务能接受返回旧数据或空数据,没拿到锁就直接返回,响应快但数据可能不新鲜。如果必须拿到最新数据,就自旋等待,睡个 50-100ms 再重试,但响应时间会拉长。高并发场景下建议第一种,用户体验更好。
26.3.3. 缓存空值会不会把 Redis 内存撑爆?
确实有这个风险,所以空值的过期时间要设得短,2-5 分钟足够。而且要配合布隆过滤器用,布隆过滤器在前面挡掉大部分非法请求,只有极少数漏网的才会缓存空值。双重防护下,空值数量可控。
26.3.4. 热点数据永不过期,那数据更新了怎么办?
详细解答可以看:MySQL 里有 2000w 数据,Redis 中只存 20w 的数据,如何保证 Redis 中的数据都是热点数据?
数据更新时主动删缓存或者更新缓存。删除更简单,下次请求会自动重建。更新的话要注意并发问题,可能出现数据库和缓存不一致。另外后台线程也要定期刷新,防止因为某些原因导致缓存一直是旧数据。
27. Redis 中如何保证缓存与数据库的数据一致性?
27.1. 核心要点
缓存和数据库的双写一致性问题,本质上是分布式系统下两个数据源的同步问题,没有完美方案,只有取舍。
常见的策略有六种,前三种问题比较大,后三种才是实际可用的:
1)先更新缓存,再更新数据库 2)先更新数据库,再更新缓存 3)先删缓存,再更新数据库
以上三种在并发场景下都容易出现数据不一致,不推荐。
4)先更新数据库,再删缓存:实时一致性要求高的场景首选,虽然极端情况下会短暂不一致,但概率很低 5)缓存双删:先删缓存、更新数据库、延迟再删一次,能解决"先删缓存再更新数据库"的并发问题 6)Binlog 异步更新:用 Canal 监听 MySQL Binlog,通过消息队列异步更新缓存,最终一致性最好
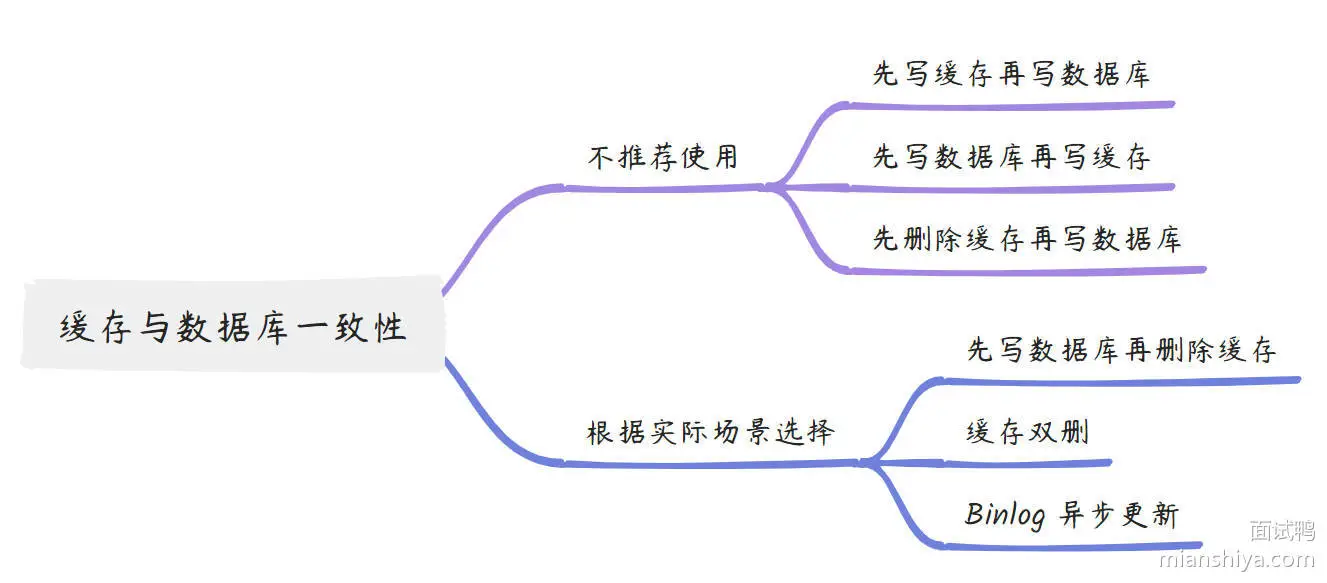
实际项目中怎么选?对实时性要求高就用"先更新数据库再删缓存",对一致性要求高又能接受延迟就用 Binlog 方案。
27.2. 扩展知识
27.2.1. 为什么不推荐更新缓存而是删缓存
更新缓存有两个坑:
1)缓存可能需要复杂计算才能得到最终值,每次更新都算一遍,浪费资源。直接删掉让下次查询时重新计算更划算。
2)并发更新时顺序不可控。A 把数据库改成 10,B 把数据库改成 20,但网络抖动导致 B 的缓存更新先到达,A 的后到达,最后数据库是 20 缓存却是 10。
27.2.2. 先更新缓存,再更新数据库
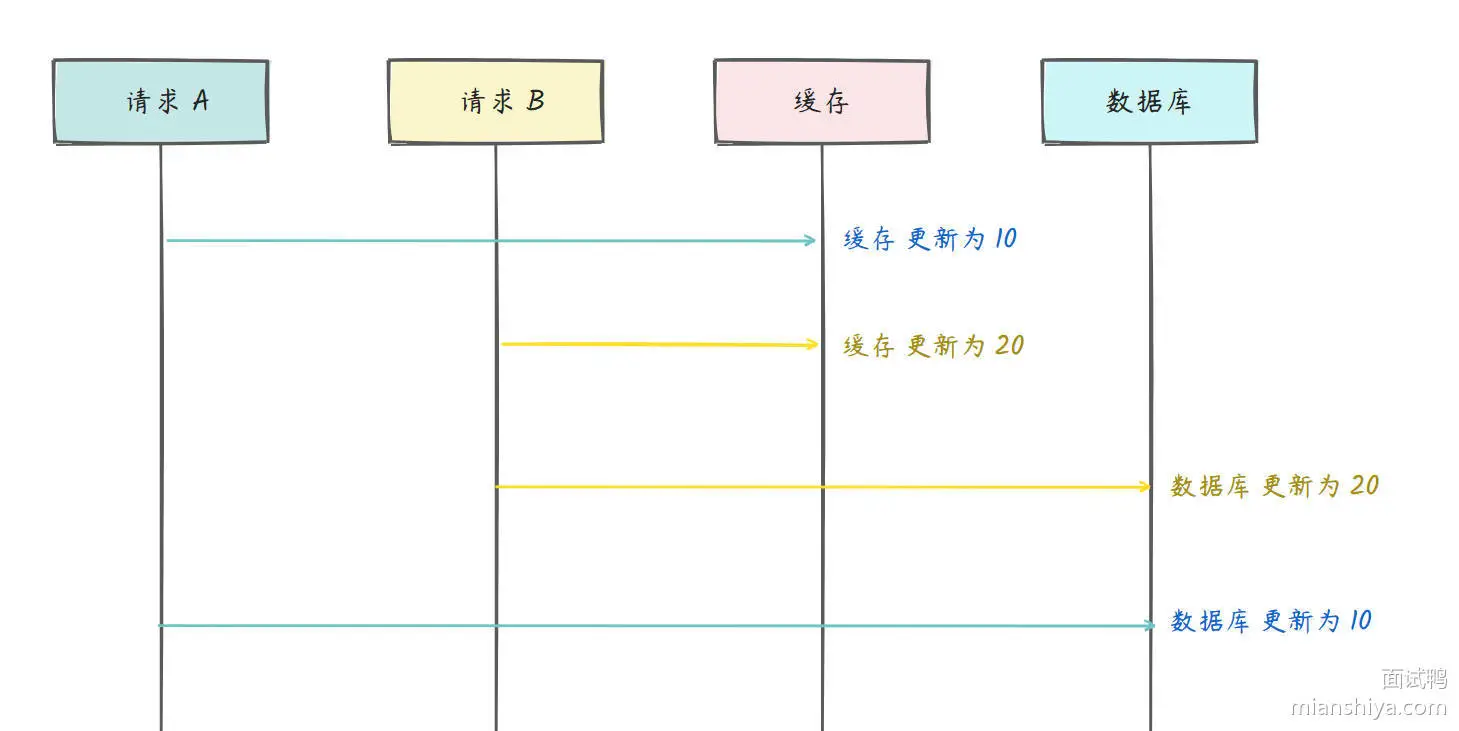
请求 A 把缓存更新成 10,然后请求 B 把缓存更新成 20。由于网络原因,B 的数据库更新先执行,A 的后执行。最终数据库是 10,缓存是 20,不一致。
更严重的是,如果更新完缓存后数据库操作失败了,缓存里是新数据,数据库里是旧数据,事务都没法回滚。
27.2.3. 先写数据库再写缓存的问题
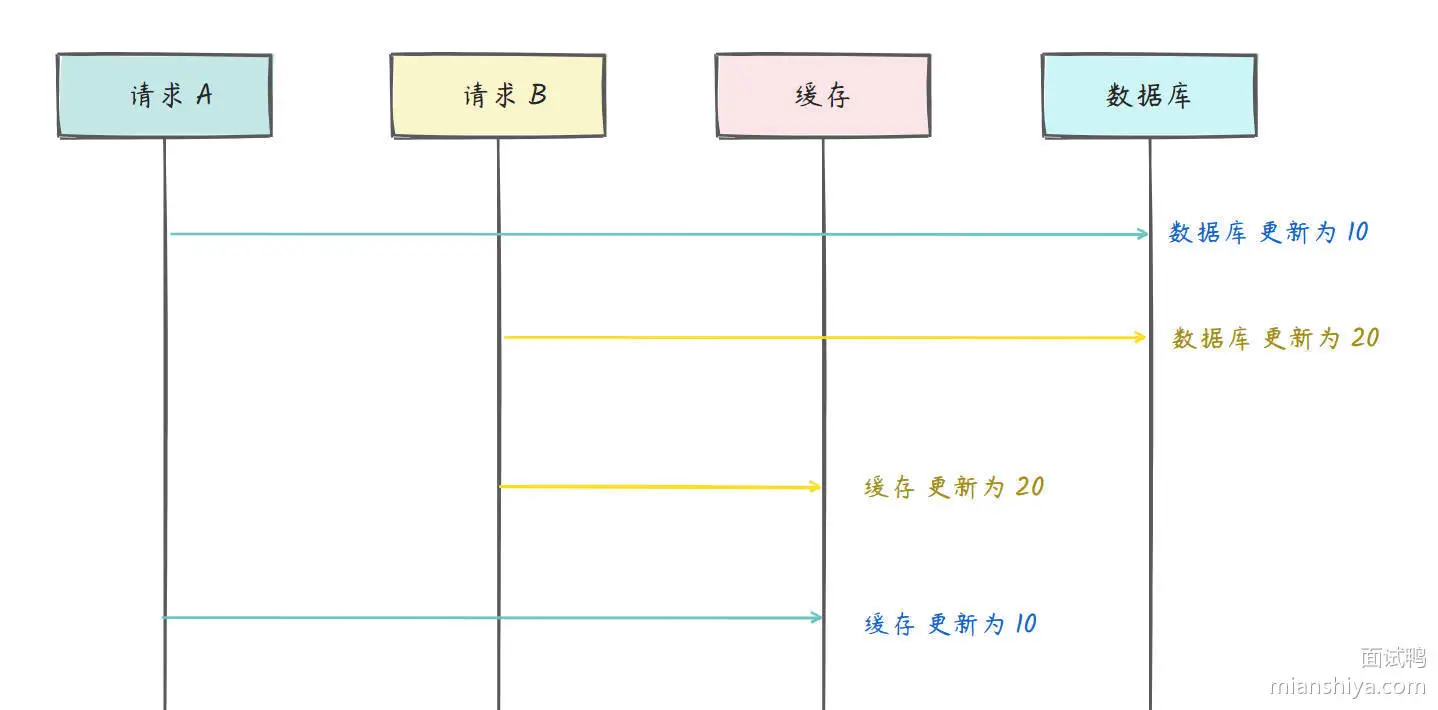
问题和上面一样,并发 + 网络延迟导致顺序错乱。A 先改数据库后改缓存,B 后改数据库先改缓存,最终又是不一致。
27.2.4. 先删缓存再写数据库的问题
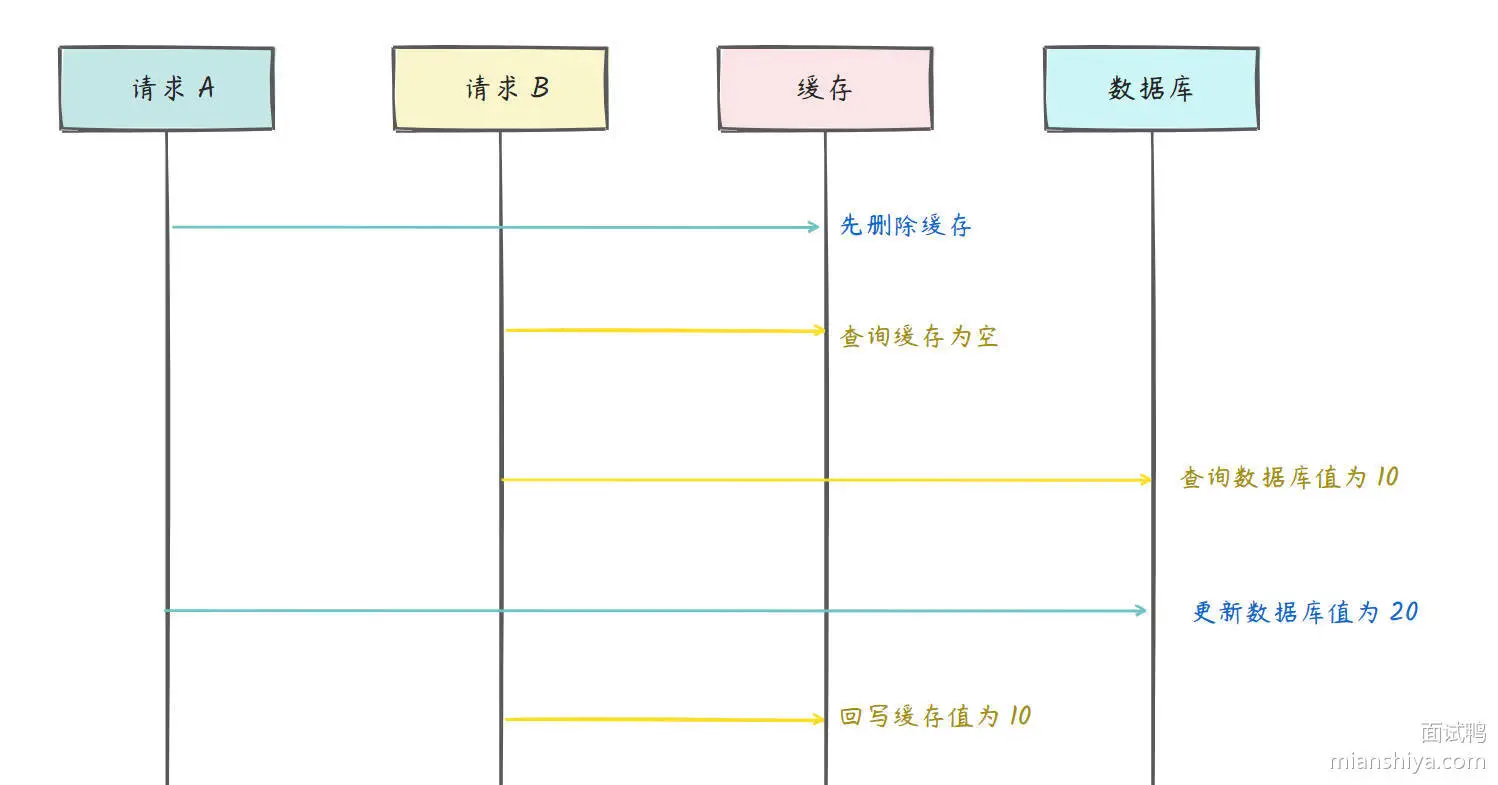
这个场景更常见:
1)请求 A 删了缓存,准备更新数据库 2)请求 B 来查询,发现缓存没了,去数据库查到旧值 10,回写到缓存 3)请求 A 把数据库更新成 20 4)最终数据库是 20,缓存是 10,后续读请求全拿到脏数据
这种情况在读多写少的场景下特别容易出现。
27.2.5. 缓存双删(先删除缓存,再写数据库,然后过一段时间再删除缓存)
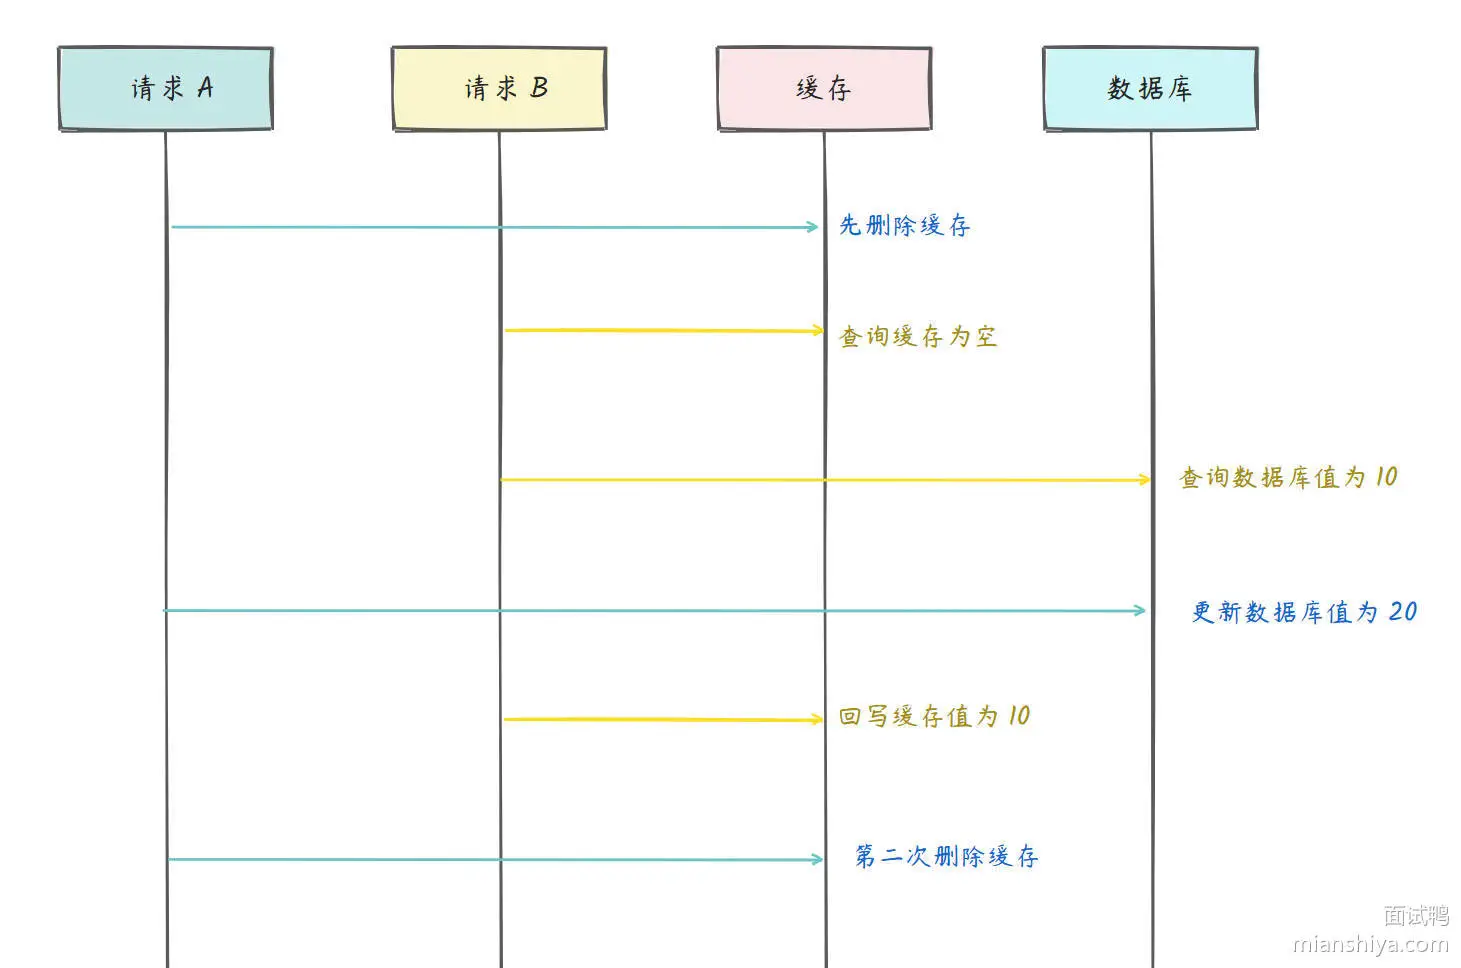
为了解决"先删缓存再更新数据库"的并发问题,在更新数据库后再延迟删一次缓存。即使有请求在中间把旧数据回写了,延迟删除也能把它清掉。
延迟时间一般设成业务读操作的最大耗时再加几百毫秒,比如 1 秒。延迟删除可以用消息队列、定时任务或者 Redisson 的延迟队列实现:
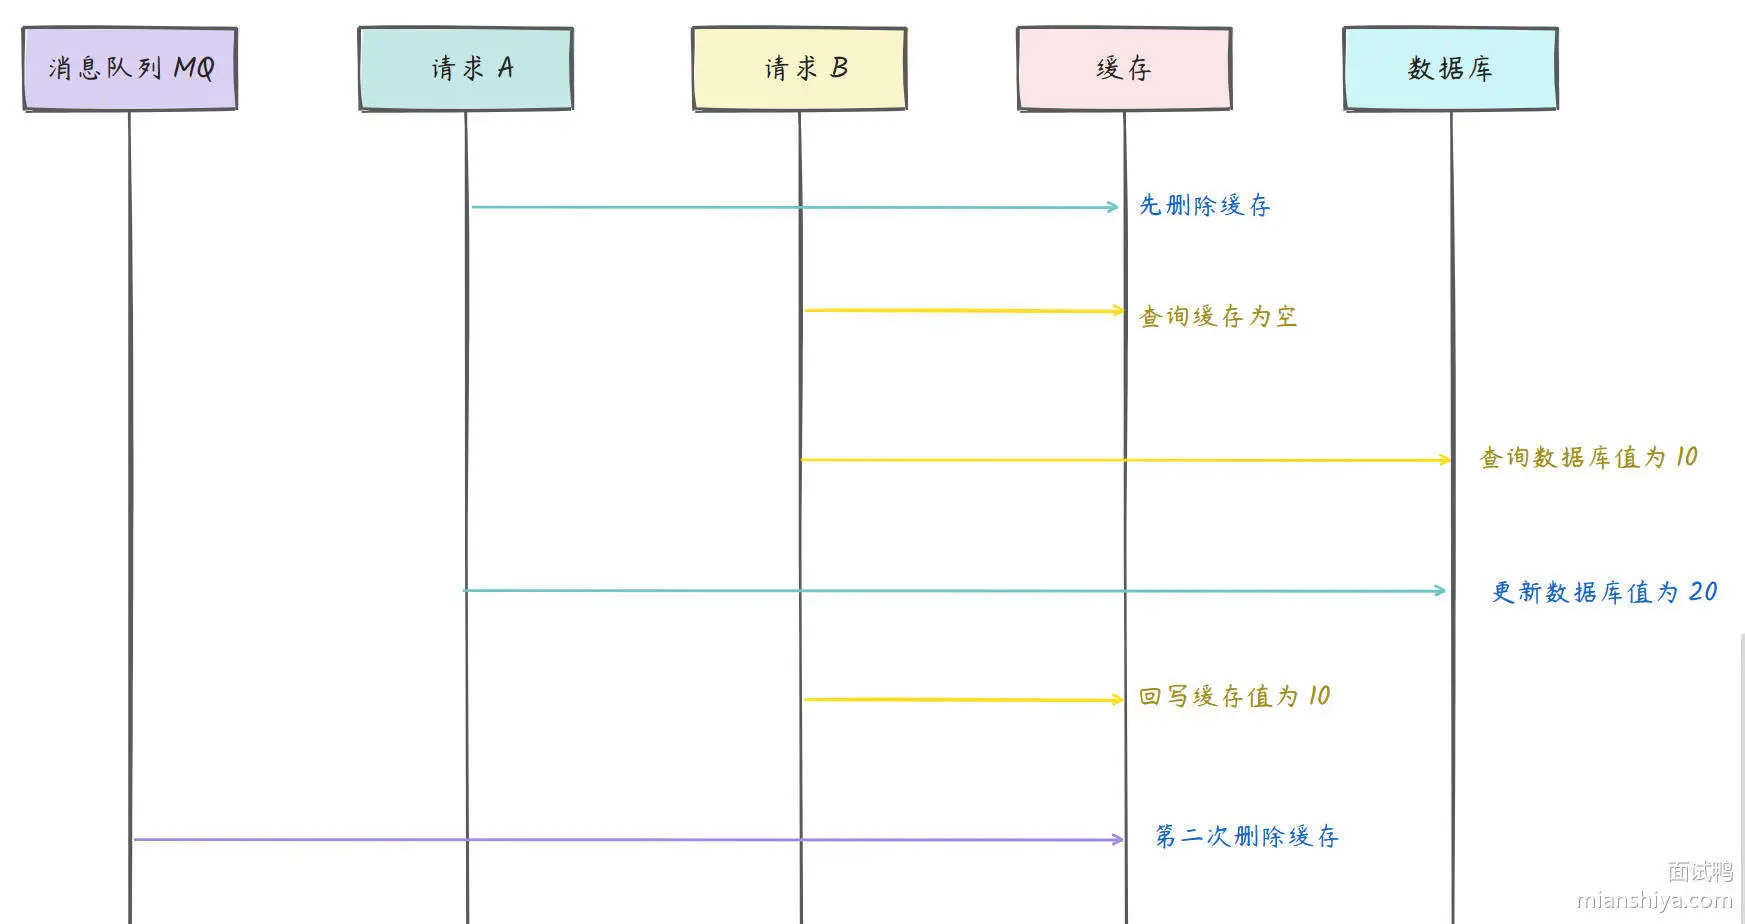
public void updateWithDoubleDelete(String key, Object newValue) {
    // 第一次删除
    redis.del(key);
    // 更新数据库
    database.update(newValue);
    // 延迟删除,发送到消息队列
    delayQueue.send(key, 1000); // 1 秒后删除
}
27.2.6. 先更新数据库再删缓存
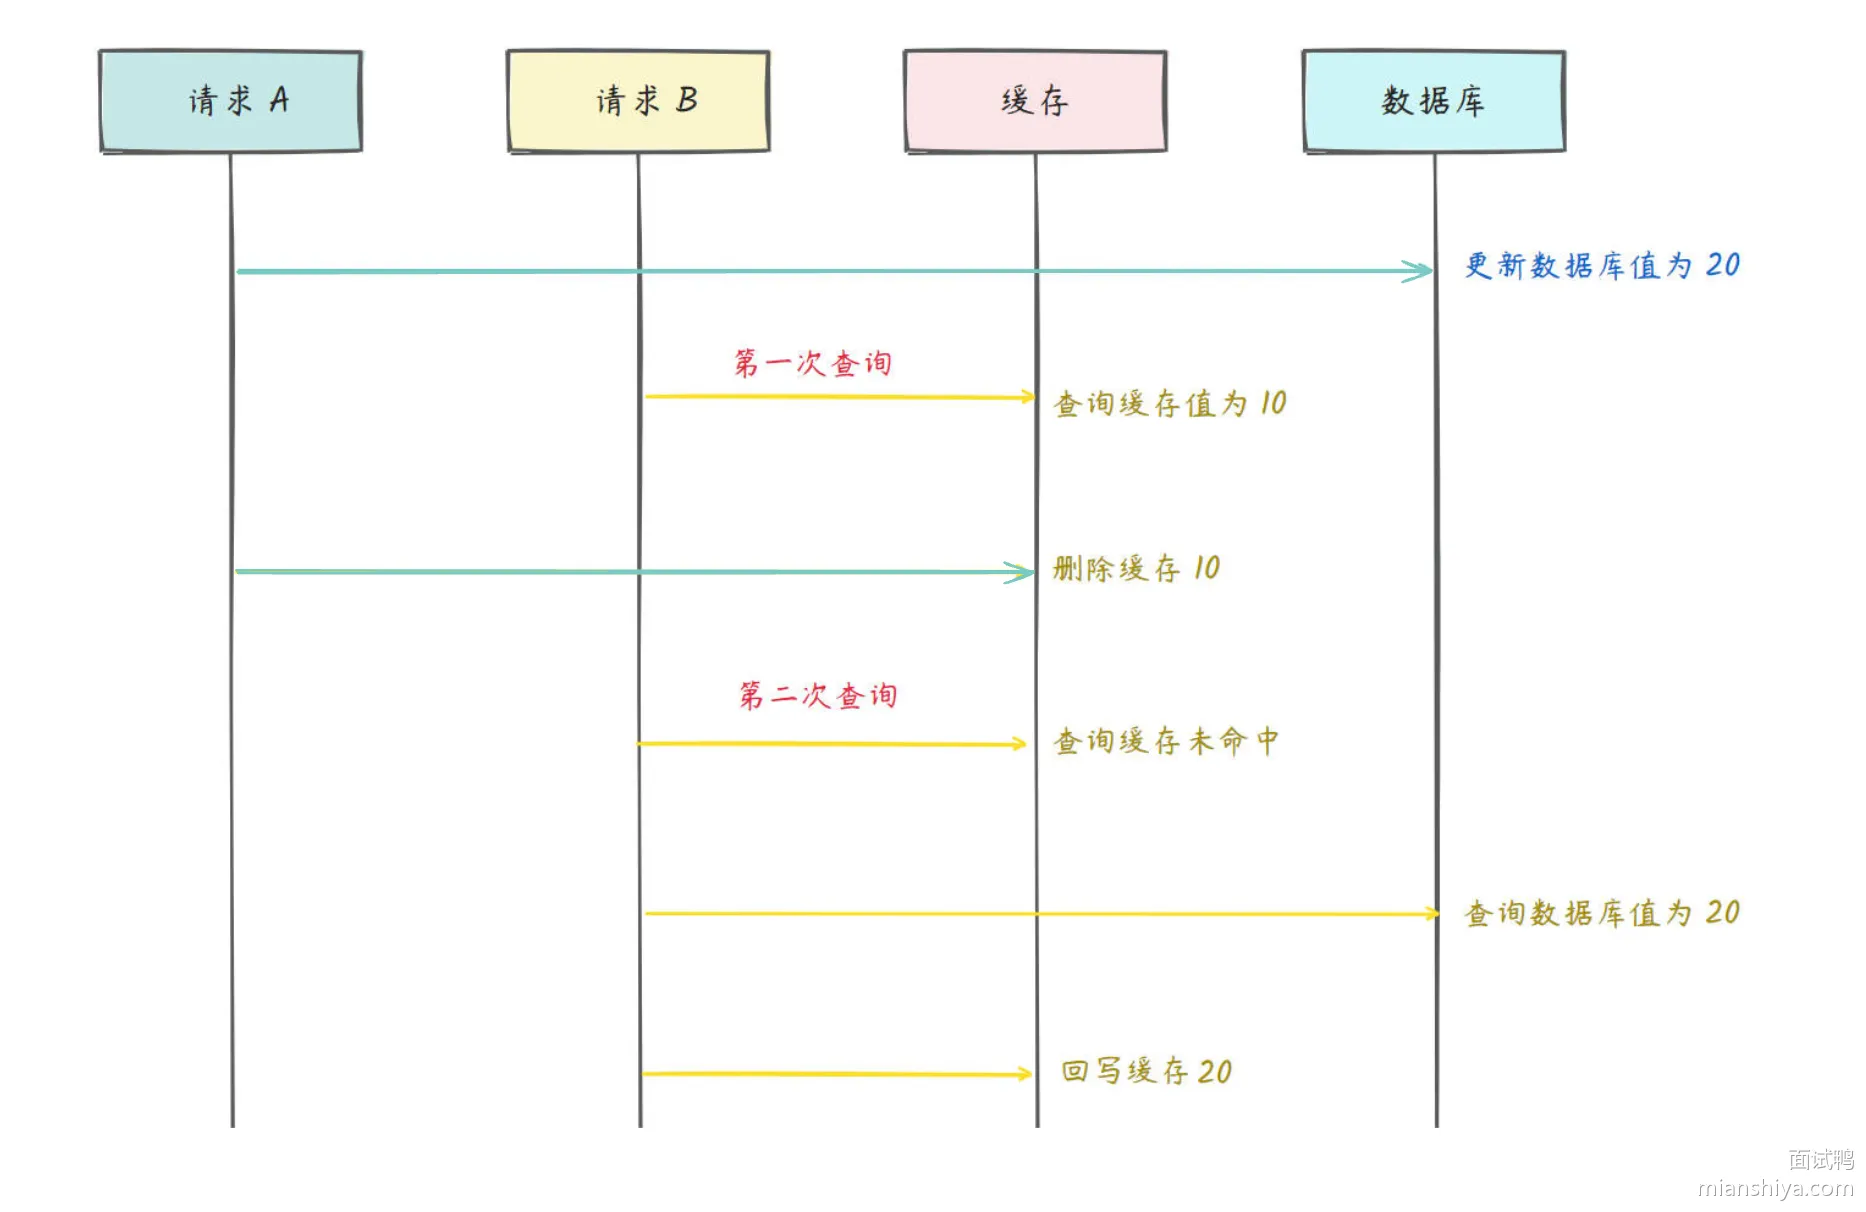
这是目前业界用得最多的方案,也叫 Cache Aside Pattern。先把数据库改了,然后删掉缓存,后续查询会自动从数据库加载最新数据回写缓存。
这个方案也有极端情况会出问题:
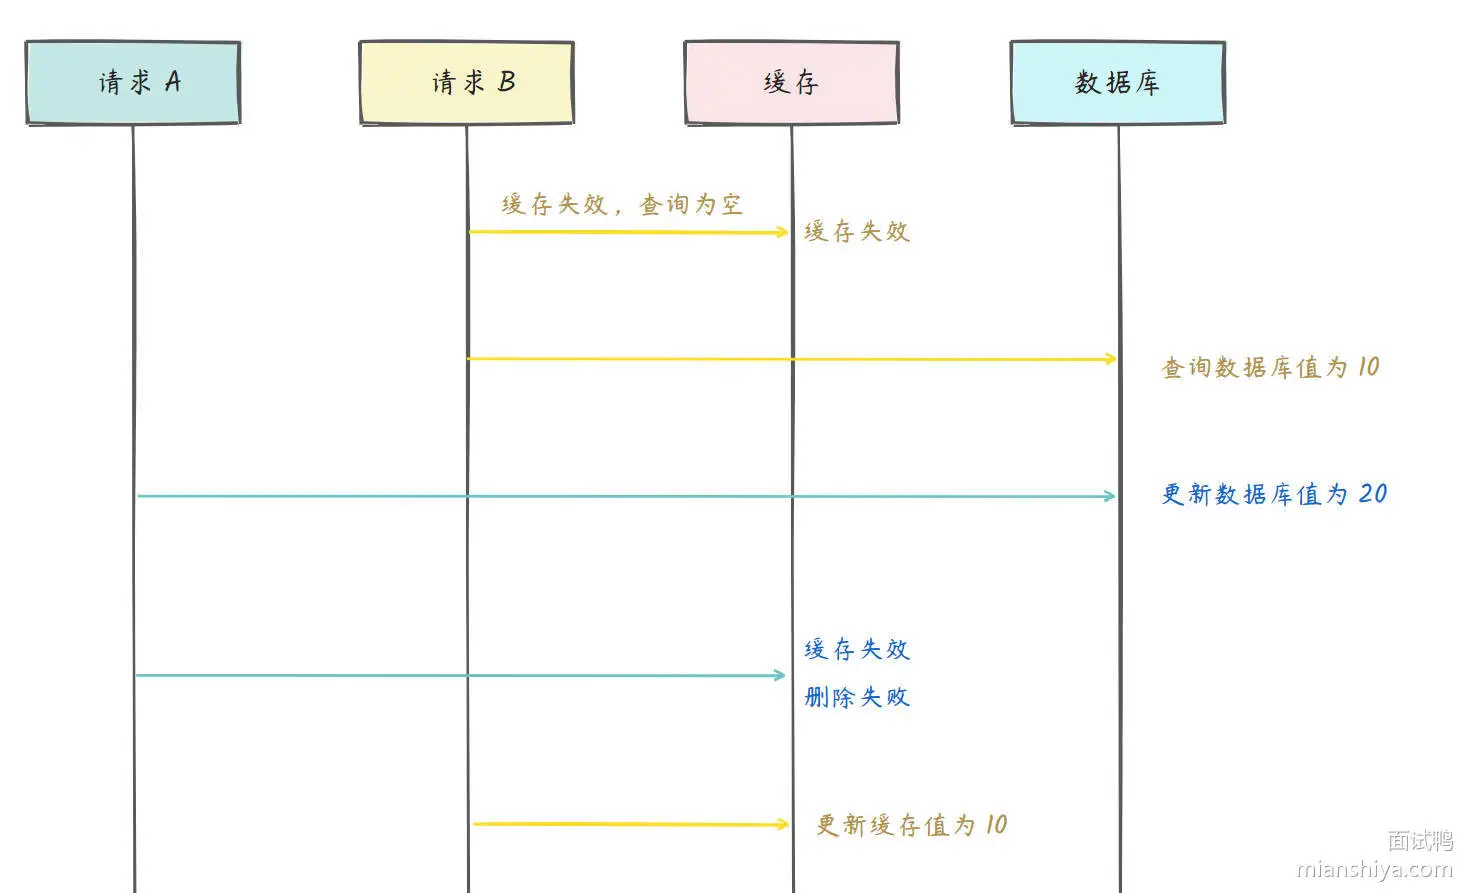
1)缓存刚好过期 2)请求 A 查询,缓存没命中,去数据库读到旧值 3)请求 B 更新数据库,删除缓存 4)请求 A 把旧值回写缓存
但这个场景发生的概率极低,因为它要求写操作在读操作"查数据库"和"写缓存"之间完成,而写数据库通常比回写缓存慢很多。实际业务中几乎不会遇到,所以这个方案是性价比最高的。
27.2.7. 先写数据库,通过 Binlog ,异步更新缓存
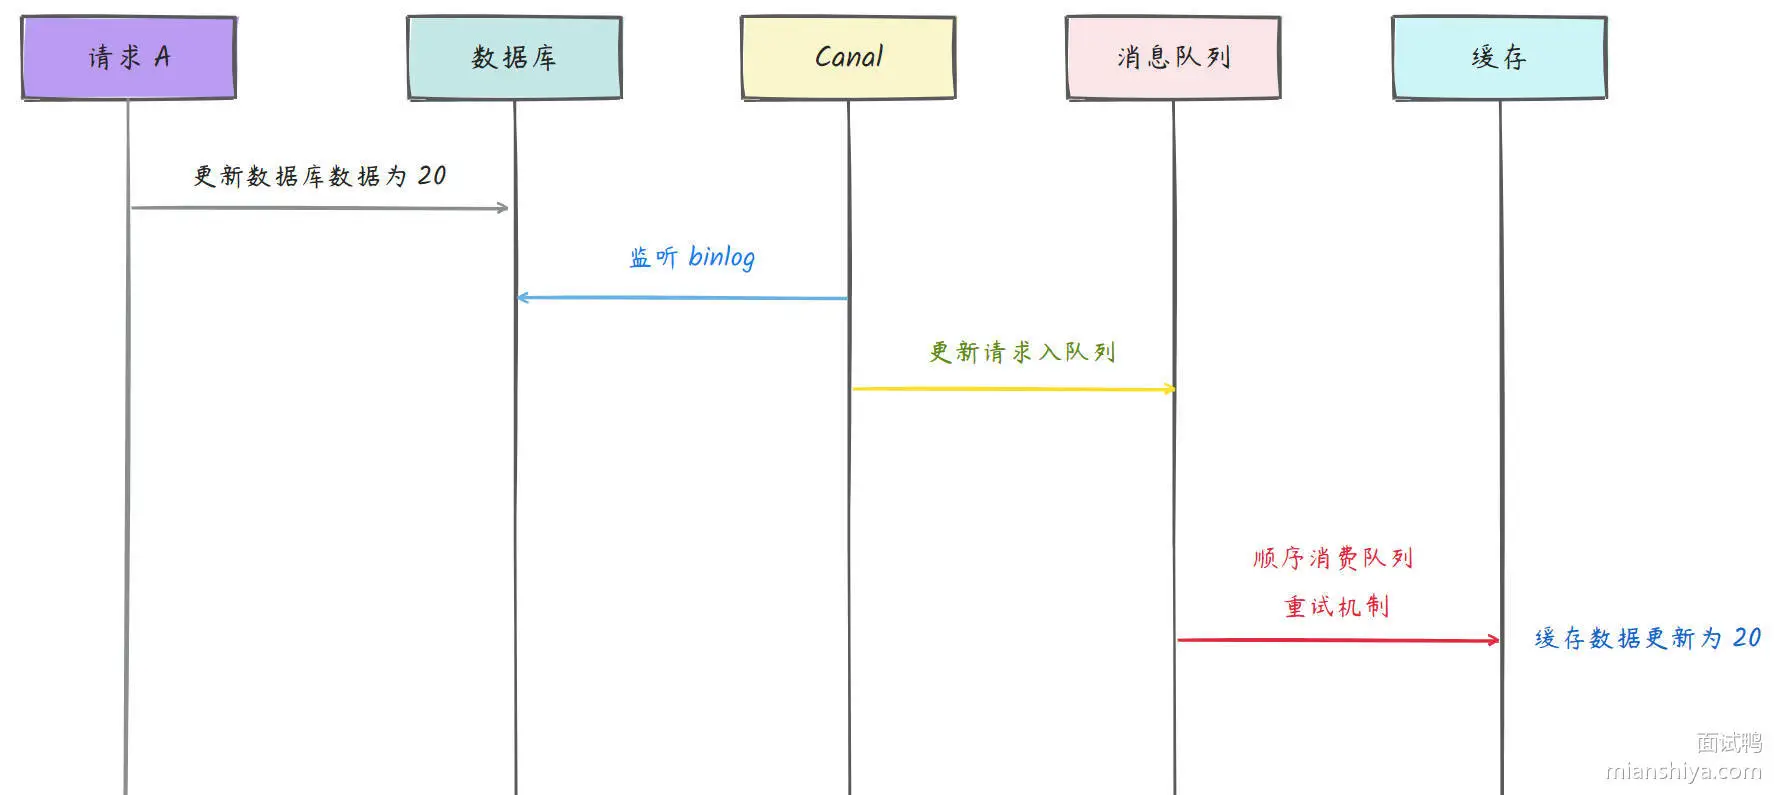
用 Canal 伪装成 MySQL 从节点,订阅主节点的 Binlog,解析出数据变更事件,发到 Kafka 或 RocketMQ,消费者负责更新或删除 Redis 缓存。
这个方案的好处是业务代码完全不用管缓存更新,数据库改了缓存自动跟着变。而且消息队列有重试机制,能保证最终一致性。
要注意的点:
1)消息必须顺序消费,不然先改成 10 后改成 20,但消费顺序反了,缓存就乱了 2)要有幂等处理,同一条消息可能重复投递 3)有一定延迟,一般在百毫秒到秒级
# Canal 配置示例
canal.destinations = example
canal.instance.master.address = 127.0.0.1:3306
canal.mq.topic = cache-sync-topic
canal.mq.partition = 0
27.2.8. 强一致性方案
如果业务就是不能容忍任何不一致,比如金融场景,可以用分布式读写锁。读操作加读锁,写操作加写锁,读读不互斥,读写互斥,写写互斥。
写操作流程:获取写锁 → 更新数据库 → 删除缓存 → 释放写锁
读操作流程:获取读锁 → 查缓存,命中就返回;没命中就查数据库并回写缓存 → 释放读锁
代价是性能下降明显,写操作会阻塞所有读操作,高并发场景下不太适合。
27.3. 常见问题
27.3.1. 删缓存操作失败了怎么办?数据库更新成功了但缓存没删掉
加重试机制。删除失败就把 key 发到消息队列,由消费者异步重试删除,直到成功为止。也可以用本地重试,比如 Spring Retry,设置重试 3 次,每次间隔 100ms。极端情况下还是失败,就报警人工介入。
27.3.2. 为什么说"先更新数据库再删缓存"出问题的概率很低?能量化一下吗?
要出问题需要满足三个条件同时发生:缓存刚好过期、有并发读写请求、写操作在读操作的"查库"和"写缓存"之间完成。写数据库通常要几十毫秒,写缓存只要几毫秒,写操作要在这几毫秒的窗口内完成,概率非常低。而且即使出现了,下次缓存过期后也会自动修复。
27.3.3. Canal 监听 Binlog 方案,如果 Canal 挂了会丢数据吗?
详细解答可以看:什么是 Canal?它有什么作用?请简述它的核心实现原理?
不会丢。Canal 会记录消费位点,重启后从上次的位点继续消费。但会有延迟,挂掉这段时间的数据变更会在重启后补上。如果担心 Canal 单点问题,可以部署 Canal 集群,用 ZooKeeper 做高可用。
28. Redis String 类型的底层实现是什么?(SDS)
28.1. 核心要点
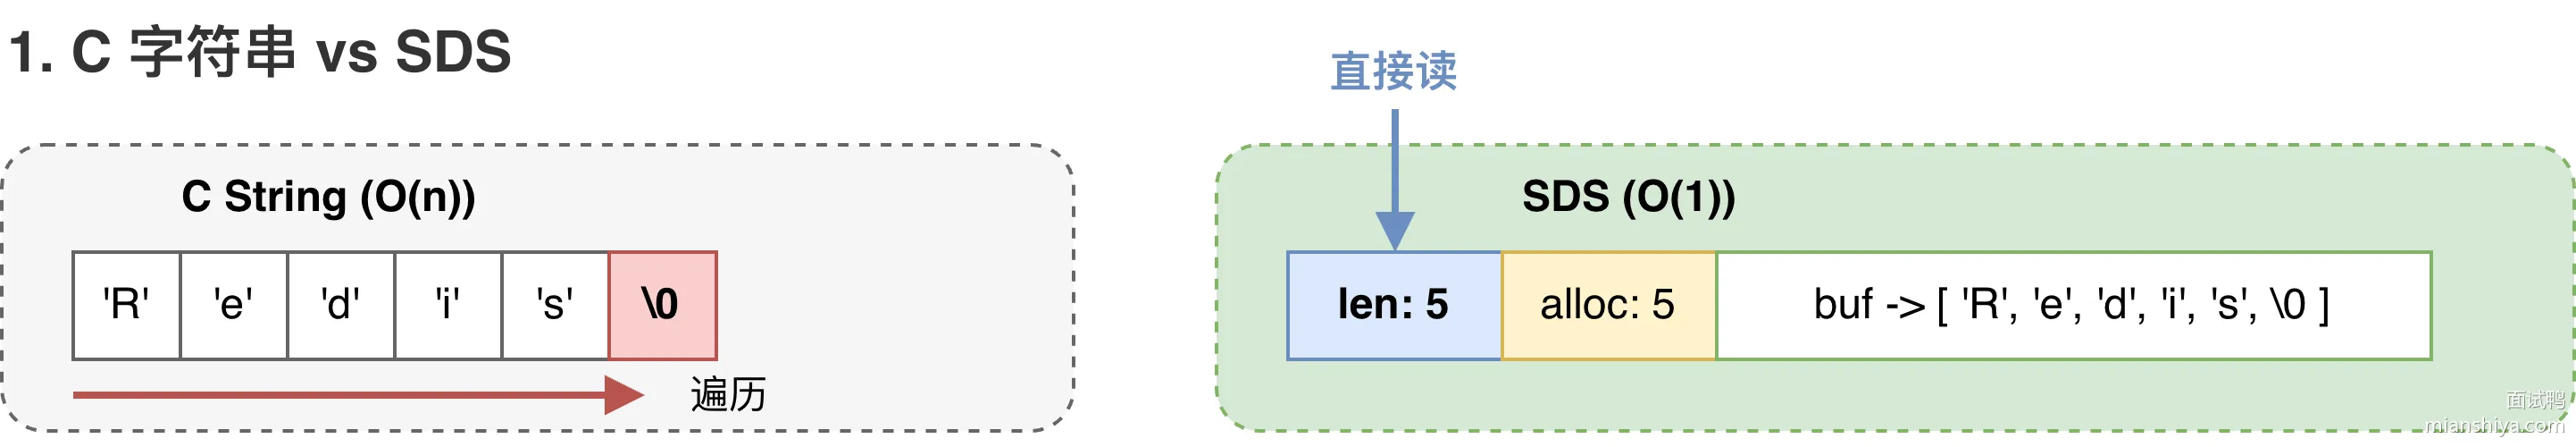
Redis 的 String 底层用的是 SDS,全称 Simple Dynamic String,简单动态字符串。它不是直接用 C 语言原生的 char 数组,因为 C 字符串有几个致命问题:
- 获取长度得遍历一遍,时间复杂度 O(n)
- 遇到 \0 就认为结束了,没法存二进制数据
- 扩容得自己手动搞,一不小心就缓冲区溢出
SDS 的核心设计是在字符数组前面加了个头部结构,记录了当前长度 len 和分配的空间 alloc。这样获取长度直接读 len 字段,O(1) 搞定;判断剩余空间用 alloc - len 就行,扩容前先检查够不够,不够再分配,杜绝溢出;而且不依赖 \0 判断结束,图片、音频这种二进制数据也能存。
SDS 结构包含三个核心字段:len 记录当前字符串长度,alloc 记录分配的总空间,buf 存储实际数据。获取长度时直接返回 len,时间复杂度 O(1)。扩容时先检查 alloc - len 是否足够,不够则重新分配。buf 末尾仍保留 \0,兼容部分 C 函数。
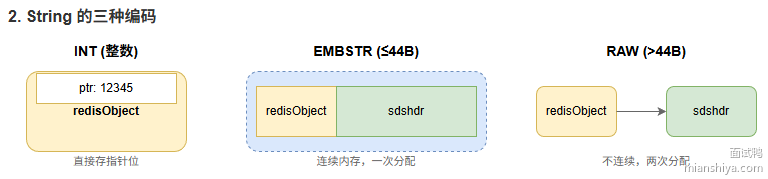
Redis 还根据存储内容做了编码优化:
1)能解析成整数的,直接用 int 编码,把数字存在指针位置,连 SDS 都不用分配
2)44 字节以内的短字符串用 embstr 编码,redisObject 和 SDS 分配在一块连续内存,一次 malloc 搞定
3)超过 44 字节的长字符串用 raw 编码,redisObject 和 SDS 分开存,方便独立扩容
// Jedis 中使用 String 类型
Jedis jedis = new Jedis("localhost", 6379);

// int 编码:存整数
jedis.set("counter", "12345");

// embstr 编码:短字符串
jedis.set("name", "zhangsan");

// raw 编码:长字符串
jedis.set("article", "这是一篇超过44字节的文章内容...");

// 查看编码方式
// DEBUG OBJECT counter  -> encoding:int
// DEBUG OBJECT name     -> encoding:embstr
// DEBUG OBJECT article  -> encoding:raw
28.2. 扩展知识
28.2.1. SDS 的内存预分配策略
SDS 扩容时不是要多少分多少,而是多分一些预留着,减少后续扩容次数:
1)字符串长度小于 1MB 时,扩容后的 alloc 是 len 的 2 倍。比如追加后长度变成 100 字节,那 alloc 就分配 200 字节
2)字符串长度大于等于 1MB 时,每次多分配 1MB。比如追加后长度变成 2MB,那 alloc 就分配 3MB
这个策略在频繁追加内容的场景特别有用,比如日志收集、消息拼接,不用每次都 realloc。
28.2.2. sdshdr 的多版本设计
Redis 3.2 及之后,SDS 不是只有一种结构,而是根据字符串长度选择不同的 sdshdr:
// sdshdr5:长度 0-31 字节,len 只占 5 bit
// sdshdr8:长度 32-255 字节,len 占 1 字节
// sdshdr16:长度 256-65535 字节,len 占 2 字节
// sdshdr32/64:更长的字符串

struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len;        // 1 字节,最大 255
    uint8_t alloc;      // 1 字节
    unsigned char flags;// 1 字节,低 3 位标识类型
    char buf[];
};

struct __attribute__ ((__packed__)) sdshdr32 {
    uint32_t len;       // 4 字节,最大 4GB
    uint32_t alloc;     // 4 字节
    unsigned char flags;// 1 字节
    char buf[];
};
短字符串用 sdshdr8,头部只占 3 字节;长字符串才用 sdshdr32,头部占 9 字节。这样能省不少内存,尤其是 Redis 里大量的短 key。
28.2.3. 三种编码的内存布局对比
| 编码类型 | 触发条件 | 内存分配次数 | 适用场景 |
|---|---|---|---|
| int | 值是 long 范围内的整数 | 0 次 | 计数器、ID |
| embstr | 字符串 ≤44 字节 | 1 次 | 短字符串、缓存 key |
| raw | 字符串 >44 字节 | 2 次 | 长文本、序列化数据 |
embstr 之所以选 44 字节作为分界线,是因为 Redis 的内存分配器 jemalloc 以 64 字节为一个分配单元。redisObject 占 16 字节,sdshdr8 头部占 3 字节,末尾 \0 占 1 字节,加起来 20 字节,剩下正好 44 字节放数据。
redis 3.2 及之后的版本,这个界限是 44,前面版本是 39,详情见:36. Redis 中 EMBSTR 对象的阈值设置为何为 44?其调整历史是什么?
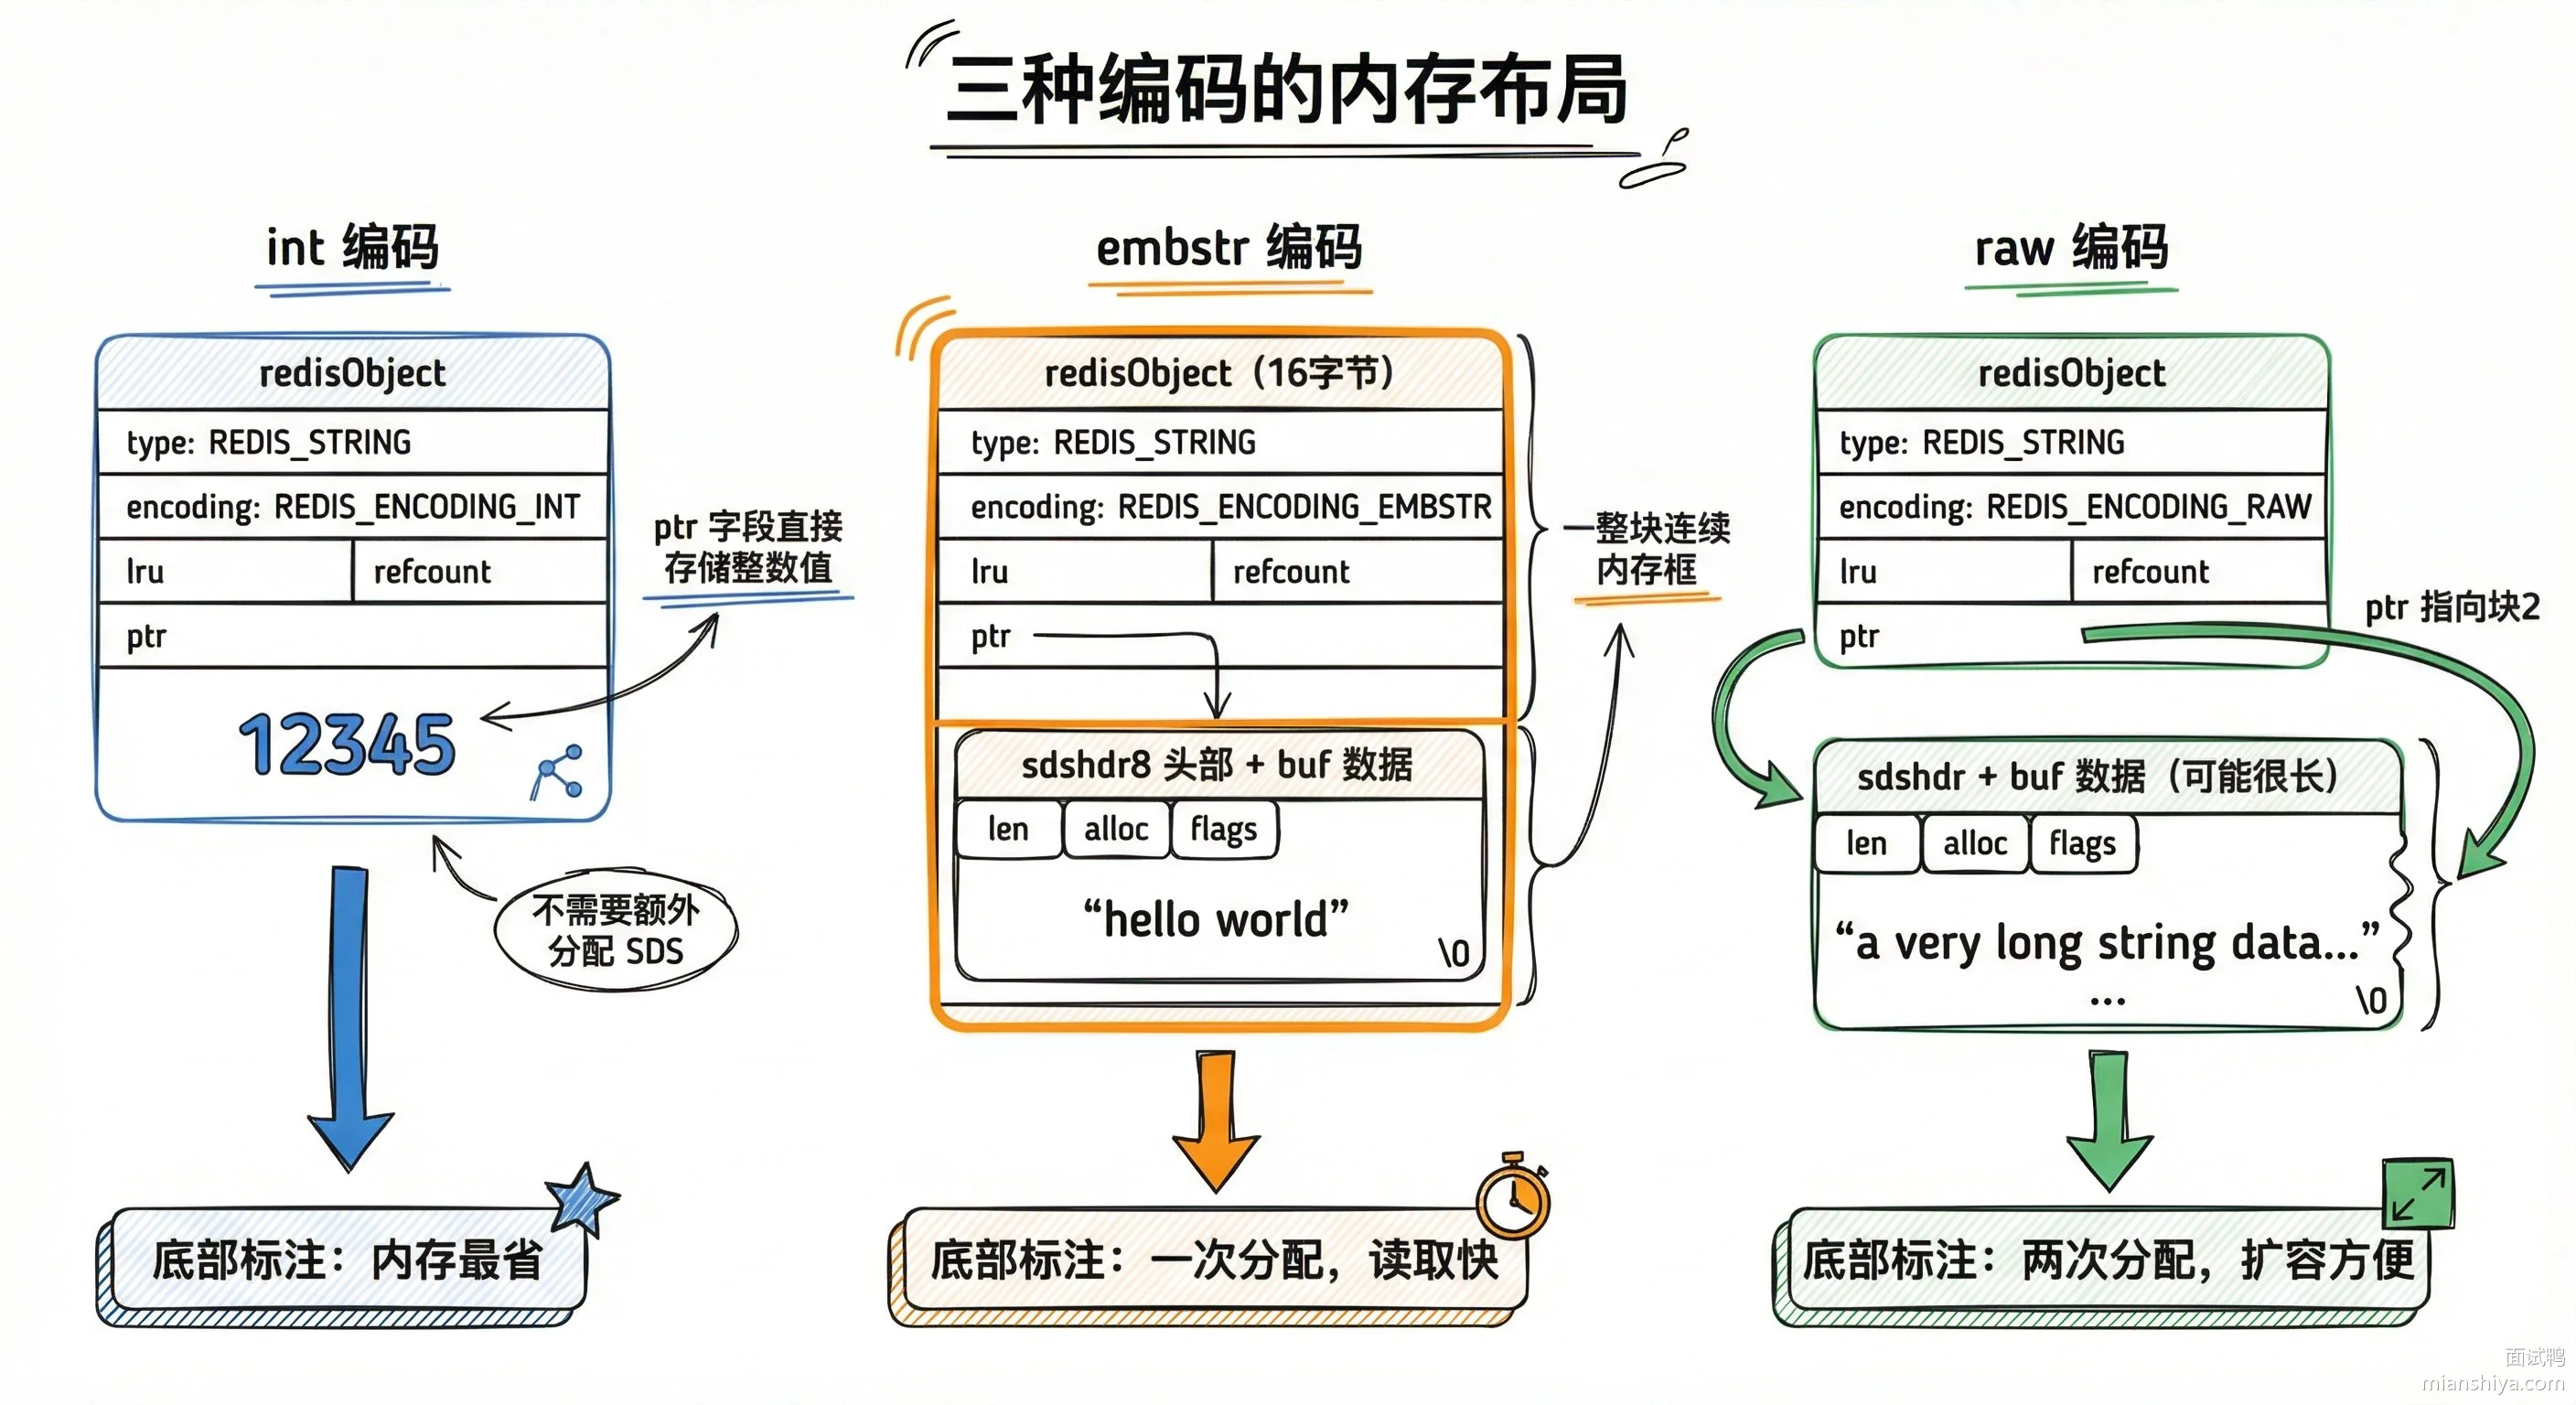
28.2.4. embstr 的只读特性
embstr 编码有个特点:只读。一旦需要修改,Redis 会先把它转成 raw 编码再操作。
127.0.0.1:6379> SET name "hello"
OK
127.0.0.1:6379> DEBUG OBJECT name
Value at:0x7f... encoding:embstr ...

127.0.0.1:6379> APPEND name " world"
(integer) 11
127.0.0.1:6379> DEBUG OBJECT name
Value at:0x7f... encoding:raw ...
原因很简单:embstr 把 redisObject 和 SDS 分配在一块连续内存里,修改内容可能导致 SDS 扩容,扩容就得重新分配整块内存,还不如直接转 raw 来得干净。
28.2.5. 二进制安全的意义
C 字符串用 \0 作为结束符,所以存 "hello\0world" 只能读到 "hello"。SDS 用 len 字段判断长度,buf 里的 \0 就是普通数据,照存不误。
这在实际场景里很重要:
1)存储序列化数据,比如 Protocol Buffers、MessagePack 编码后的二进制
2)存储图片缩略图、小文件
3)存储压缩后的数据,比如 gzip 压缩的内容
28.3. 常见问题
28.3.1. SDS 扩容的时候,为什么小于 1MB 是翻倍,大于 1MB 是加 1MB?
小字符串翻倍扩容是为了减少扩容次数,代价是可能浪费一半空间,但小字符串浪费的绝对值不大。大字符串如果还翻倍,一个 10MB 的字符串扩容后变 20MB,白白浪费 10MB,太亏了。所以大字符串改成固定加 1MB,在扩容次数和空间浪费之间找平衡。
28.3.2. embstr 和 raw 的 44 字节分界线是怎么算出来的?
jemalloc 内存分配器的最小单元是 64 字节。redisObject 结构体占 16 字节,sdshdr8 头部占 3 字节,字符串末尾的 \0 占 1 字节,这些加起来 20 字节。64 - 20 = 44,正好能存 44 字节的字符串内容。超过这个长度就装不下了,只能用 raw 编码分两块内存存。
28.3.3. 为什么 Redis 不直接用 C++ 的 std::string?
Redis 是纯 C 写的,引入 C++ 会增加编译依赖和运行时开销。而且 std::string 的内存分配策略不够灵活,没法针对 Redis 的使用场景做优化,比如预分配策略、多版本 sdshdr 这些。自己实现 SDS 能完全掌控内存布局,针对短字符串、长字符串分别优化。
28.3.4. SDS 末尾为什么还保留 \0?
为了兼容部分 C 标准库函数。有些场景需要把 SDS 的 buf 直接传给 printf、strcmp 这类函数,它们依赖 \0 判断结束。保留 \0 就能直接用,不用再复制一份加结束符。当然 SDS 自己不依赖这个 \0,长度全靠 len 字段。
29. 如何使用 Redis 快速实现排行榜?
29.1. 核心要点
用 Redis 的 Sorted Set 来实现排行榜是最合适的选择。Sorted Set 里每个成员都绑定一个 score 分数,Redis 会按 score 自动排序,而且底层用跳表实现,插入、删除、查排名都是 O(logN),百万级数据也能扛住。
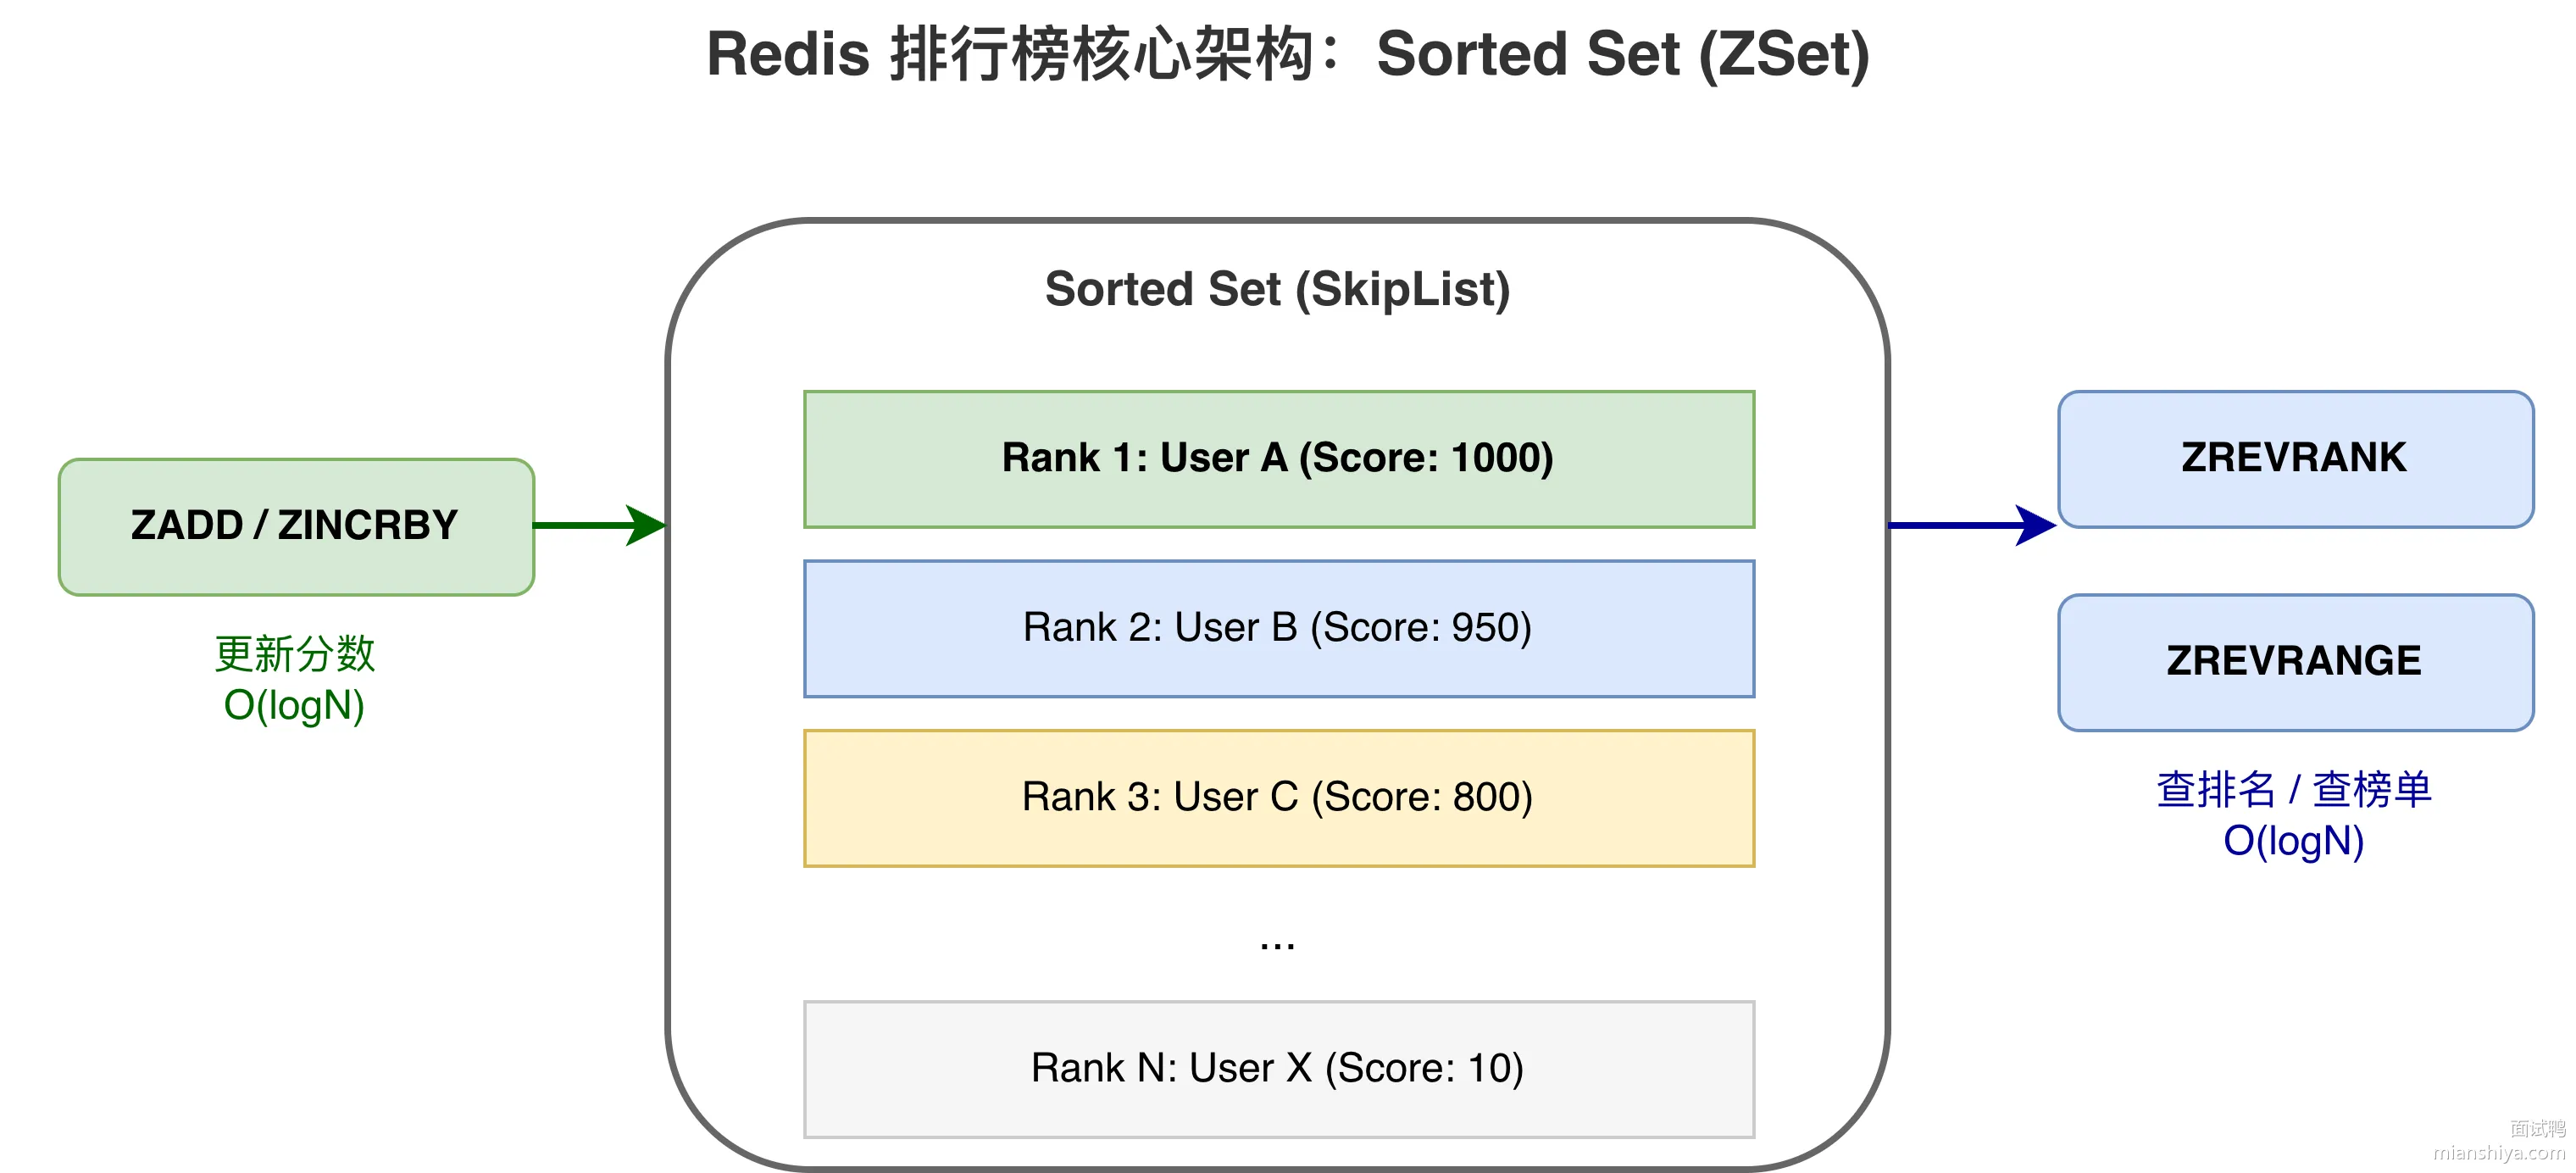
核心操作就这几个命令:
1)ZADD leaderboard 1000 user1 添加用户和分数,用户已存在就更新分数
2)ZREVRANK leaderboard user1 查某个用户排第几名,从 0 开始计数
3)ZREVRANGE leaderboard 0 9 WITHSCORES 取前 10 名,连分数一起返回
4)ZINCRBY leaderboard 500 user1 给用户加分,打游戏升级、签到加积分都用这个
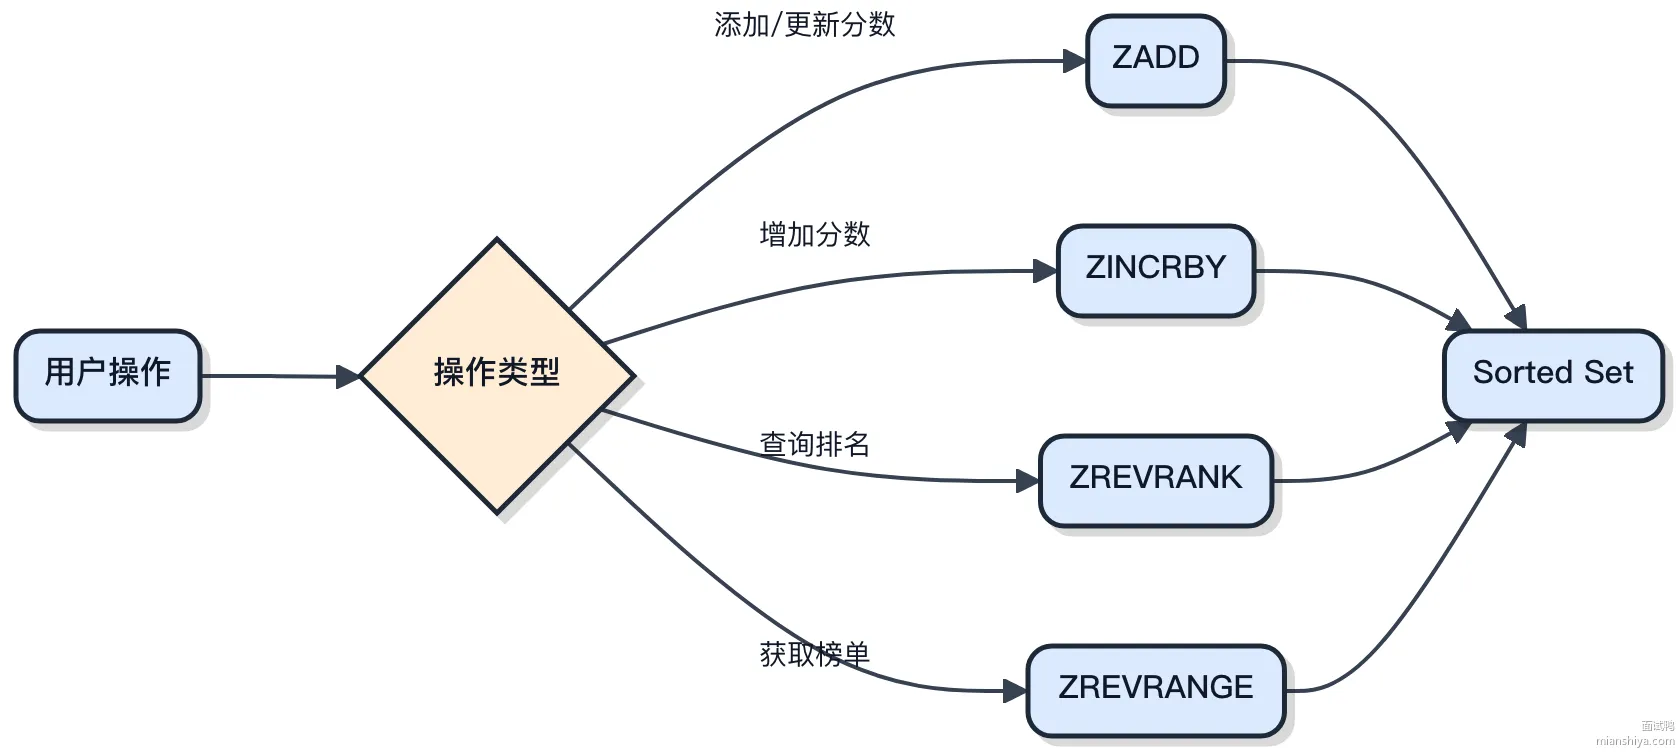
// 游戏排行榜示例
Jedis jedis = new Jedis("localhost", 6379);

// 玩家打完一局,更新分数
jedis.zadd("game:rank:202601", 8500, "player_10086");

// 查自己排第几
Long rank = jedis.zrevrank("game:rank:202601", "player_10086");
System.out.println("当前排名:" + (rank + 1)); // 排名从0开始,+1显示

// 拉取前100名展示
Set<Tuple> top100 = jedis.zrevrangeWithScores("game:rank:202601", 0, 99);
for (Tuple t : top100) {
    System.out.println(t.getElement() + " : " + t.getScore());
}
29.2. 扩展知识
29.2.1. 同分排名问题
Sorted Set 默认 score 相同时按 member 的字典序排,这在排行榜场景会有问题。比如两个玩家都是 1000 分,谁先达到的应该排前面,但 Redis 不管这个。
解决办法是把时间戳编进 score 里:
// 方案一:score = 分数 + (1 - 时间戳/最大时间戳)
// 分数相同时,时间戳小的排前面
long maxTimestamp = 4102444800000L; // 2100年的时间戳
double score = realScore + (1 - System.currentTimeMillis() * 1.0 / maxTimestamp);
jedis.zadd("leaderboard", score, "user1");

// 读取时还原真实分数
long realScore = (long) Math.floor(score);
29.2.2. 大规模排行榜的分片
单个 Sorted Set 存几千万用户没问题,但如果用户量上亿,或者需要支持多个维度的排行榜,就得考虑分片了:
1)按时间分片:每天、每周、每月各一个 key,比如 rank:daily:20260115、rank:weekly:202603
2)按区间分片:分数 0-1000 一个 key,1000-10000 一个 key,查总榜时聚合
3)按用户分片:对用户 ID 取模分到不同 key,适合不关心全局排名只看附近排名的场景
// 按天分片的排行榜
String todayKey = "rank:daily:" + LocalDate.now().format(DateTimeFormatter.BASIC_ISO_DATE);
jedis.zadd(todayKey, score, playerId);
jedis.expire(todayKey, 7 * 24 * 3600); // 保留7天

// 周榜聚合(定时任务)
String weekKey = "rank:weekly:" + getWeekNumber();
Pipeline p = jedis.pipelined();
for (int i = 0; i < 7; i++) {
    String dayKey = "rank:daily:" + LocalDate.now().minusDays(i);
    p.zunionstore(weekKey, new ZParams().aggregate(ZParams.Aggregate.SUM), weekKey, dayKey);
}
p.sync();
29.2.3. 实时排名 vs 附近排名
有些场景不需要展示全局排名,只需要展示"我附近的人",这时候可以优化查询:
// 获取我的排名
Long myRank = jedis.zrevrank("leaderboard", myId);

// 获取我前后各5名的玩家
long start = Math.max(0, myRank - 5);
long end = myRank + 5;
Set<Tuple> nearbyPlayers = jedis.zrevrangeWithScores("leaderboard", start, end);
这种方式不管总榜有多少人,每次只查 11 条数据,性能很稳定。
29.2.4. 排行榜的常用命令对比
| 命令 | 功能 | 时间复杂度 | 使用场景 |
|---|---|---|---|
| ZADD | 添加/更新成员 | O(logN) | 用户得分变化 |
| ZINCRBY | 分数增减 | O(logN) | 增量更新分数 |
| ZREVRANK | 查单个排名 | O(logN) | 展示"我的排名" |
| ZREVRANGE | 区间查询 | O(logN+M) | 榜单分页展示 |
| ZRANGEBYSCORE | 按分数范围查 | O(logN+M) | 查某分数段玩家 |
| ZCARD | 获取总人数 | O(1) | 统计参与人数 |
| ZREM | 删除成员 | O(logN) | 用户注销 |
29.2.5. 持久化和缓存穿透
排行榜数据如果只存 Redis,Redis 挂了数据就没了。生产环境一般是双写:
1)用户得分更新时,先写数据库再写 Redis
2)Redis 挂了重启后,从数据库全量恢复到 Sorted Set
3)也可以用 Redis 的 RDB/AOF 持久化,但恢复时间可能较长
另外要防止缓存穿透:有人恶意查询不存在的用户排名,每次都打到数据库。可以用布隆过滤器先拦一道,或者缓存空结果。
29.3. 常见问题
29.3.1. Sorted Set 底层为什么用跳表而不是红黑树?
详细解答可以看:为什么 Redis Zset 用跳表实现而不是红黑树?B+树?
跳表实现简单,代码量小,Redis 作者 antirez 自己说过选跳表是因为实现起来更直观。从性能上看,跳表的范围查询比红黑树方便,直接沿着底层链表往后遍历就行,不用像红黑树那样中序遍历。另外跳表的平均性能和红黑树差不多,都是 O(logN),但跳表的常数因子在某些场景下更优。
29.3.2. 如果排行榜需要支持实时更新,怎么保证一致性?
用 ZADD 本身就是原子操作,单条更新没问题。如果一次要更新多个用户的分数,可以用 MULTI/EXEC 事务包起来,或者用 Lua 脚本保证原子性。如果是分布式场景,多个服务同时更新同一个用户,可以用 Redis 分布式锁,或者用 ZINCRBY 做增量更新避免覆盖问题。
29.3.3. 排行榜数据量特别大,比如上亿用户,怎么优化?
几个思路。第一是分层,活跃用户放 Redis Sorted Set,不活跃的落到数据库,查询时先查 Redis 没有再查库。第二是分片,按分数区间或者用户 ID hash 分到多个 key,查全局排名时再聚合。
29.3.4. 分数相同怎么处理?比如游戏里先达到的应该排前面
Redis Sorted Set 同分时按 member 字典序排,没法直接按时间排。常用的办法是把时间戳编进 score 里,比如 score 设成"真实分数 + 时间因子",时间因子可以是 1 减去归一化的时间戳,这样同分时先达到的时间因子更大,排名更靠前。读取时把 score 取整还原真实分数。
30. 如何使用 Redis 快速实现布隆过滤器?
30.1. 核心要点
布隆过滤器是一种概率型数据结构,用来判断"某个元素是不是在集合里"。它的特点是:说不在就一定不在,说在则可能误判。用 Redis 实现布隆过滤器主要有两种方式:位图手动实现,或者用官方的 RedisBloom 模块。
位图方式就是用 Redis 的 SETBIT/GETBIT 命令,自己管理哈希函数和位数组。添加元素时,用 k 个哈希函数算出 k 个位置,把这些位置都设成 1;查询时同样算 k 个位置,只要有一个是 0 就说明元素肯定不存在,全是 1 就说明可能存在。
布隆过滤器由一个位数组和 k 个哈希函数组成。添加元素时,通过 k 个哈希函数计算出 k 个位置,将这些位置设为 1。查询时计算同样的 k 个位置,如果全为 1 则可能存在,只要有一个为 0 则一定不存在。误判发生在不同元素的哈希值产生冲突时。
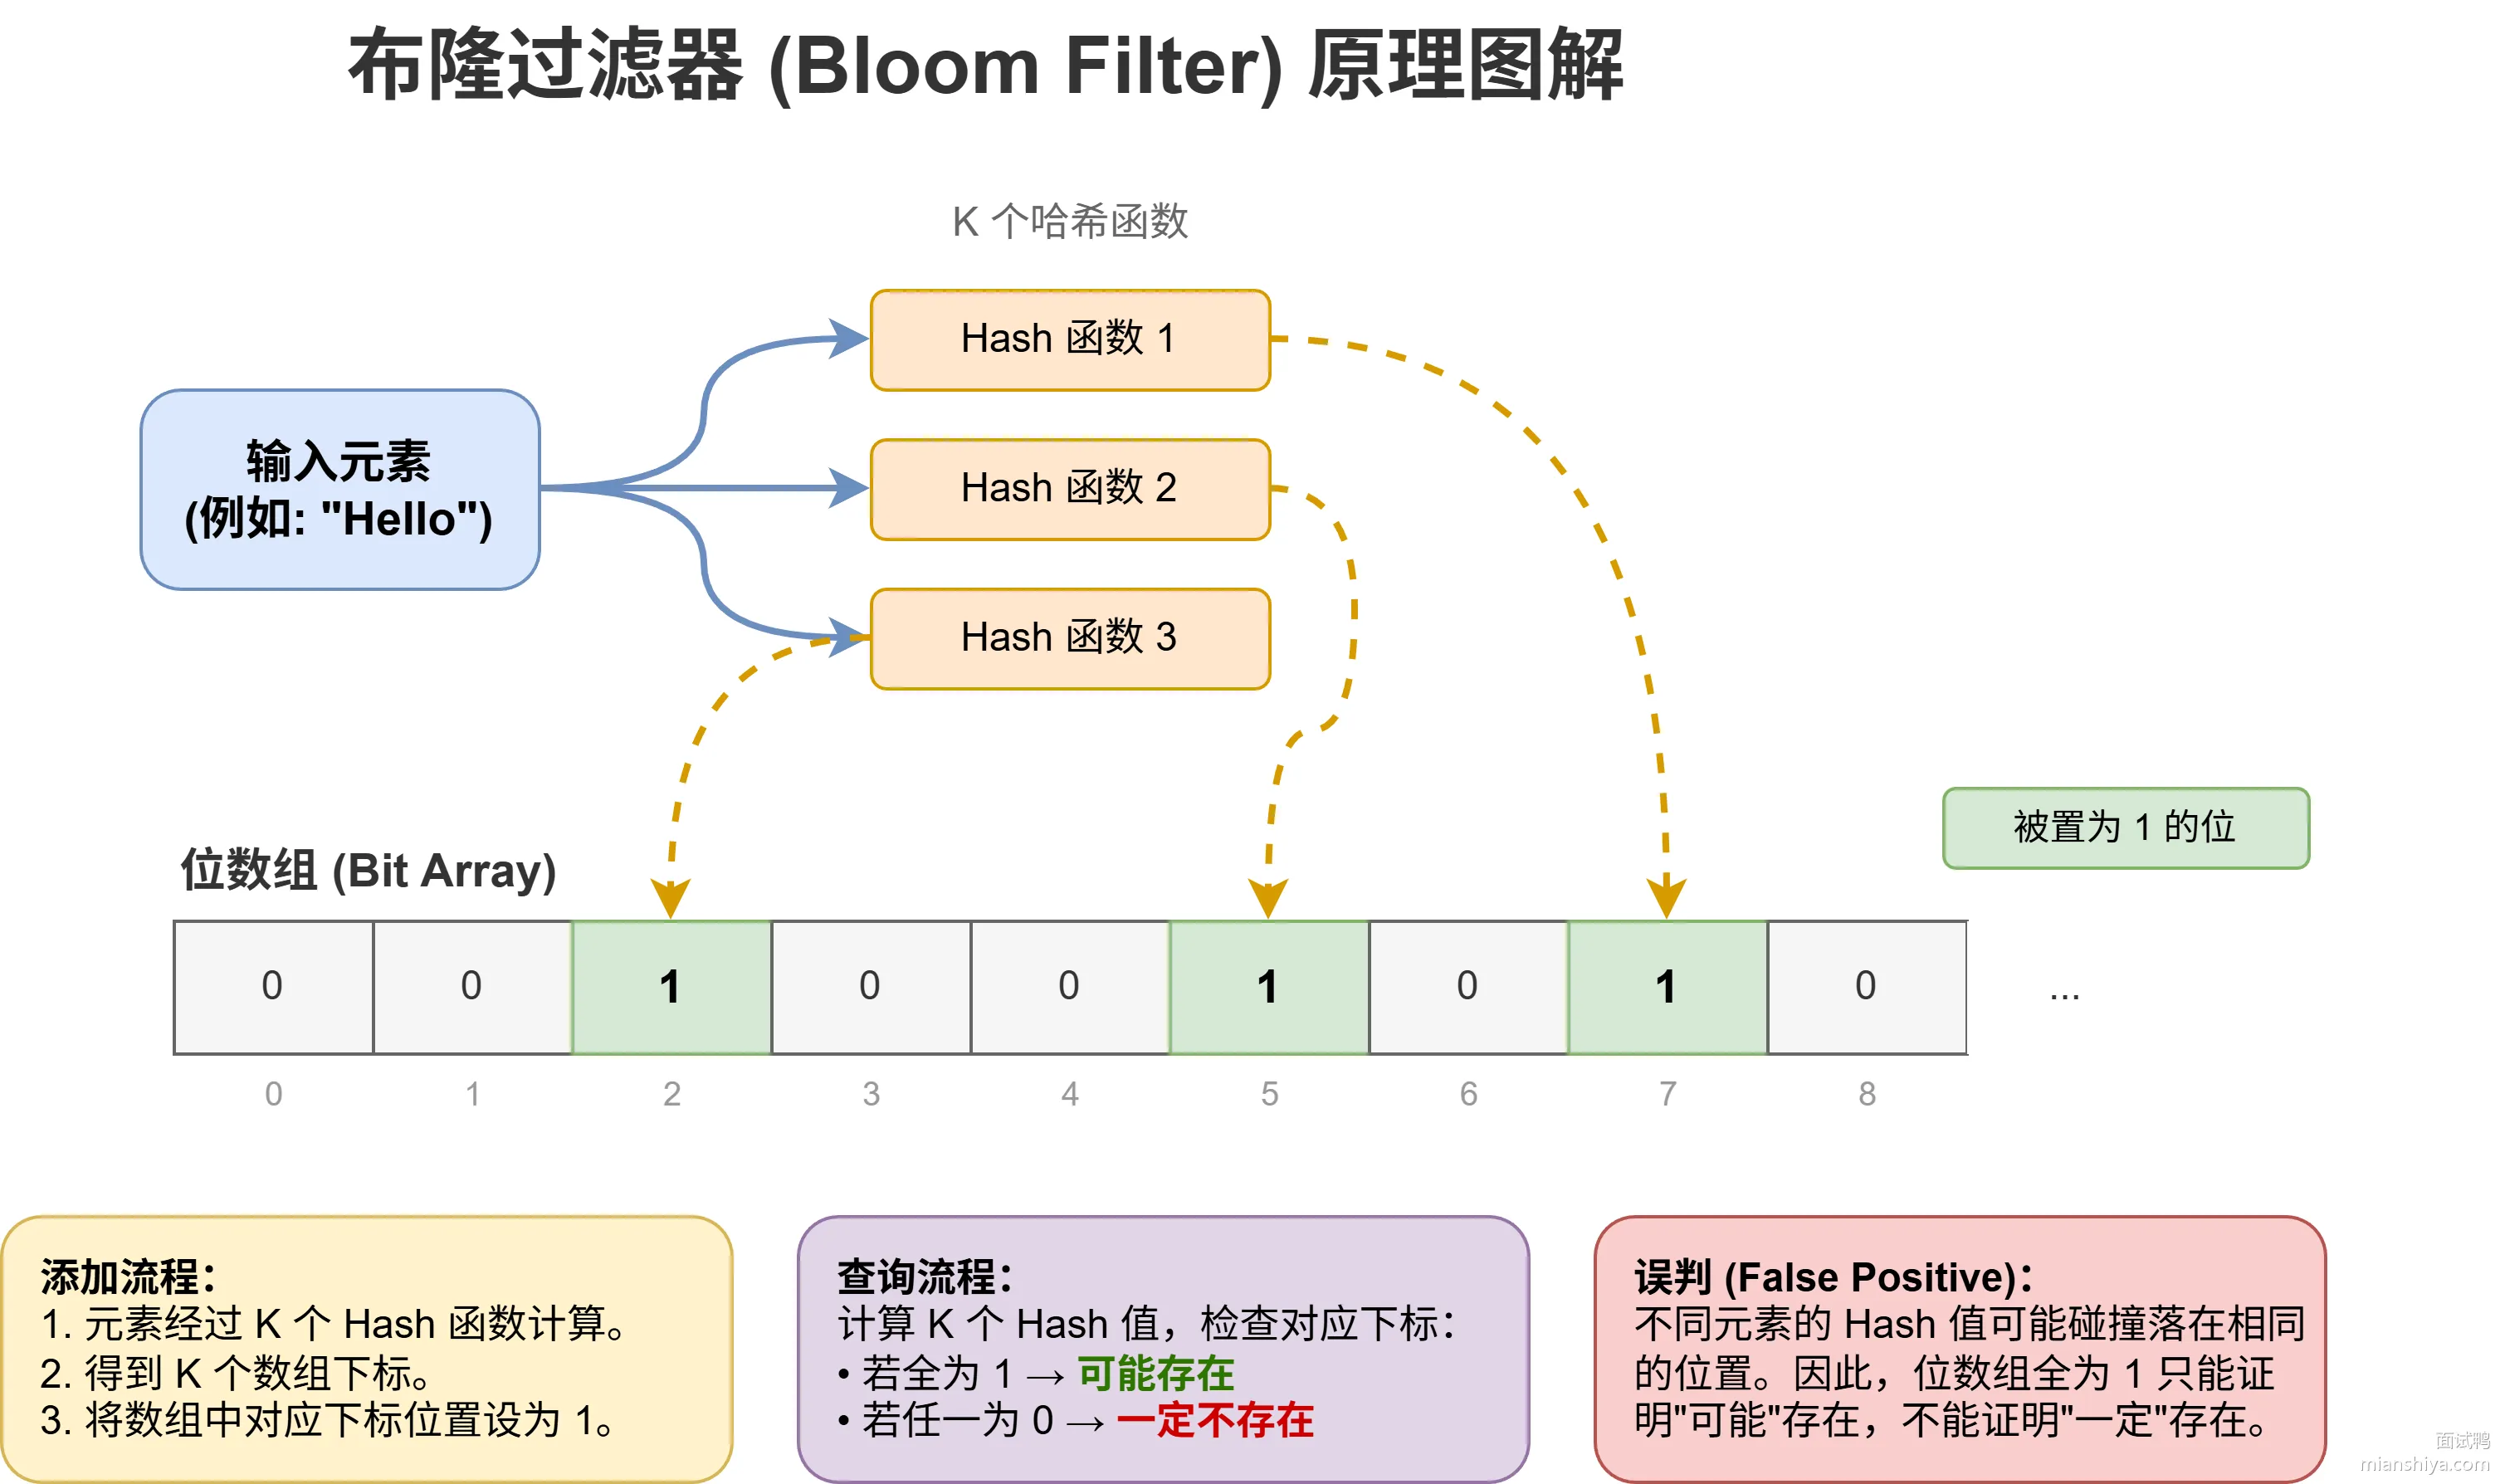
// 用位图手动实现布隆过滤器
public class RedisBloomFilter {
    private static final int BITMAP_SIZE = 1000000;
    private static final int[] SEEDS = {3, 5, 7, 11, 13, 17}; // 6 个哈希种子
    private Jedis jedis;

    public void add(String key, String value) {
        for (int seed : SEEDS) {
            int offset = hash(value, seed) % BITMAP_SIZE;
            jedis.setbit(key, offset, true);
        }
    }

    public boolean mightContain(String key, String value) {
        for (int seed : SEEDS) {
            int offset = hash(value, seed) % BITMAP_SIZE;
            if (!jedis.getbit(key, offset)) {
                return false; // 有一个是 0,肯定不存在
            }
        }
        return true; // 全是 1,可能存在
    }

    private int hash(String value, int seed) {
        int result = 0;
        for (char c : value.toCharArray()) {
            result = seed * result + c;
        }
        return result & Integer.MAX_VALUE;
    }
}
用 RedisBloom 模块更简单,一行命令搞定:
# 创建布隆过滤器,误判率 1%,容量 100 万
BF.RESERVE user_filter 0.01 1000000

# 添加元素
BF.ADD user_filter "user:10086"

# 查询元素
BF.EXISTS user_filter "user:10086"  # 返回 1,可能存在
BF.EXISTS user_filter "user:99999"  # 返回 0,一定不存在
30.2. 扩展知识
30.2.1. 布隆过滤器原理
布隆过滤器由一个位数组和 k 个独立的哈希函数组成。
添加元素时,通过 k 个哈希函数将元素映射到位数组的 k 个位置上,将这些位置设置为 1。
检查元素是否存在时,同样计算 k 个位置,如果所有位置都是 1,则说明元素可能存在;只要有一个位置为 0,就可以确定元素一定不存在。
例如某个 key 通过 hash-1 和 hash-2 两个哈希函数,定位到数组中的值都为 1,则说明它存在。
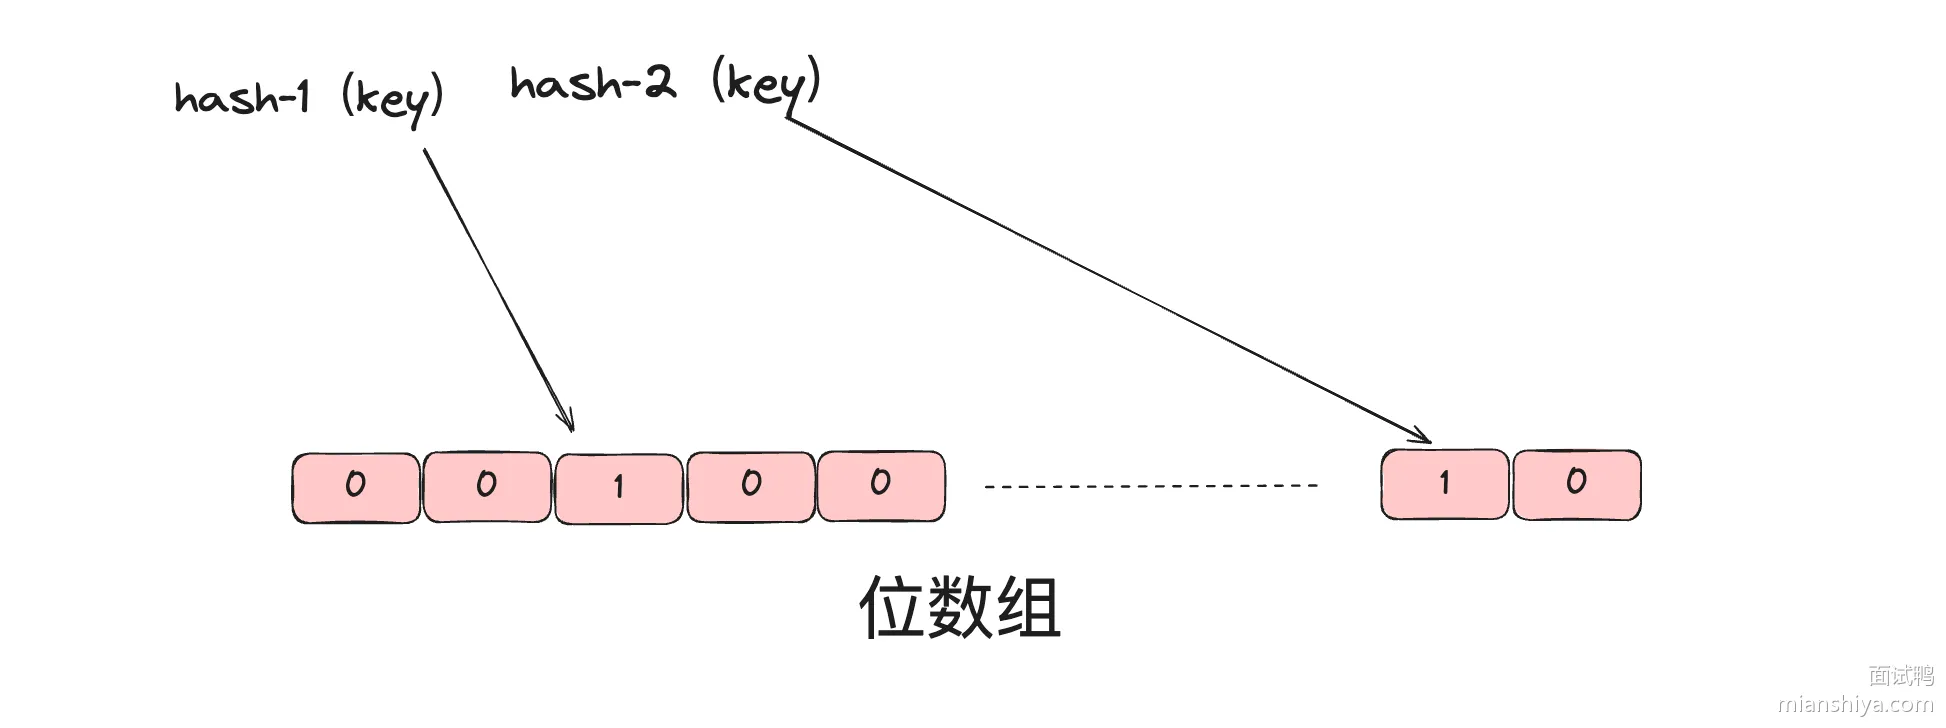
如果布隆过滤器判断一个元素不存在集合中,那么这个元素一定不在集合中,如果判断元素存在集合中则不一定是真的,因为哈希可能会存在冲突。因此布隆过滤器有误判的概率。
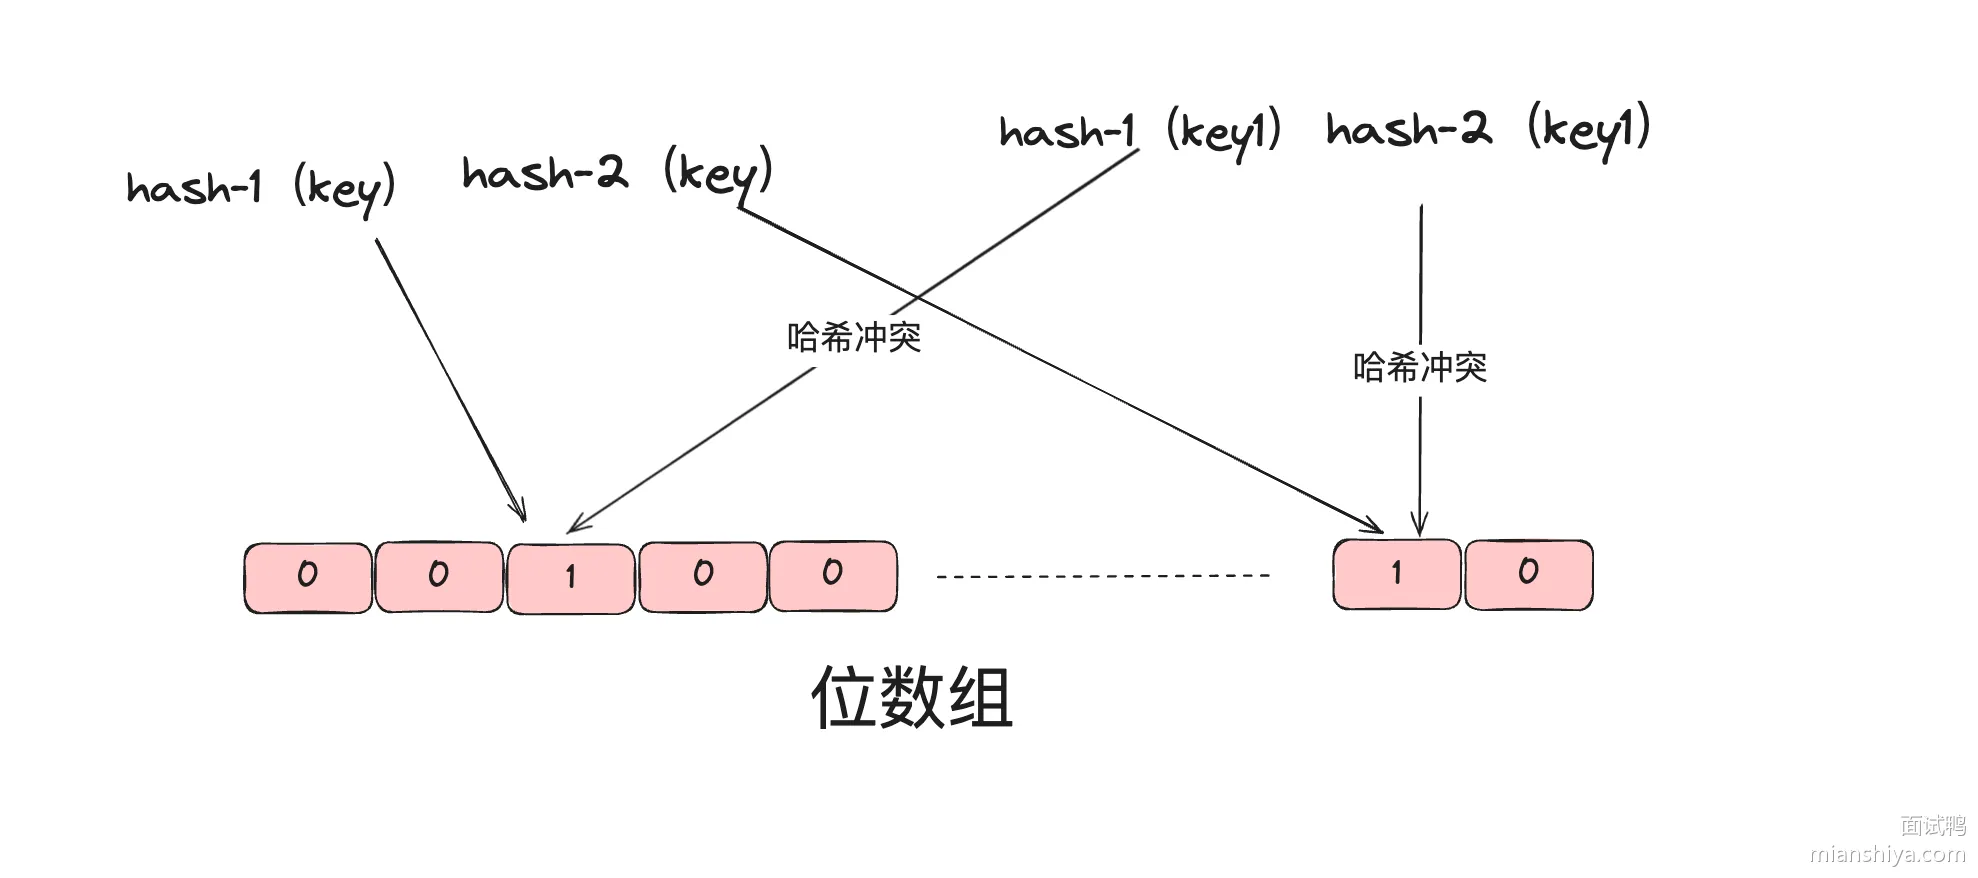
还有一个特点是不支持删除,只能新增。想删除某个元素,只能把整个过滤器重建。
30.2.2. 误判率和参数选择
误判率取决于三个因素:位数组大小 m、哈希函数个数 k、已插入元素数量 n。
理论上的最优哈希函数个数是 k = (m/n) * ln2,大约是 0.7 倍的位数组与元素数量之比。
实际工程中,一般这样估算:
1)要求误判率 1%,每个元素大约需要 10 bit
2)要求误判率 0.1%,每个元素大约需要 15 bit
3)要求误判率 0.01%,每个元素大约需要 20 bit
比如要存 1000 万个元素,误判率控制在 1%,位数组大约需要 1 亿 bit,也就是 12MB 左右。
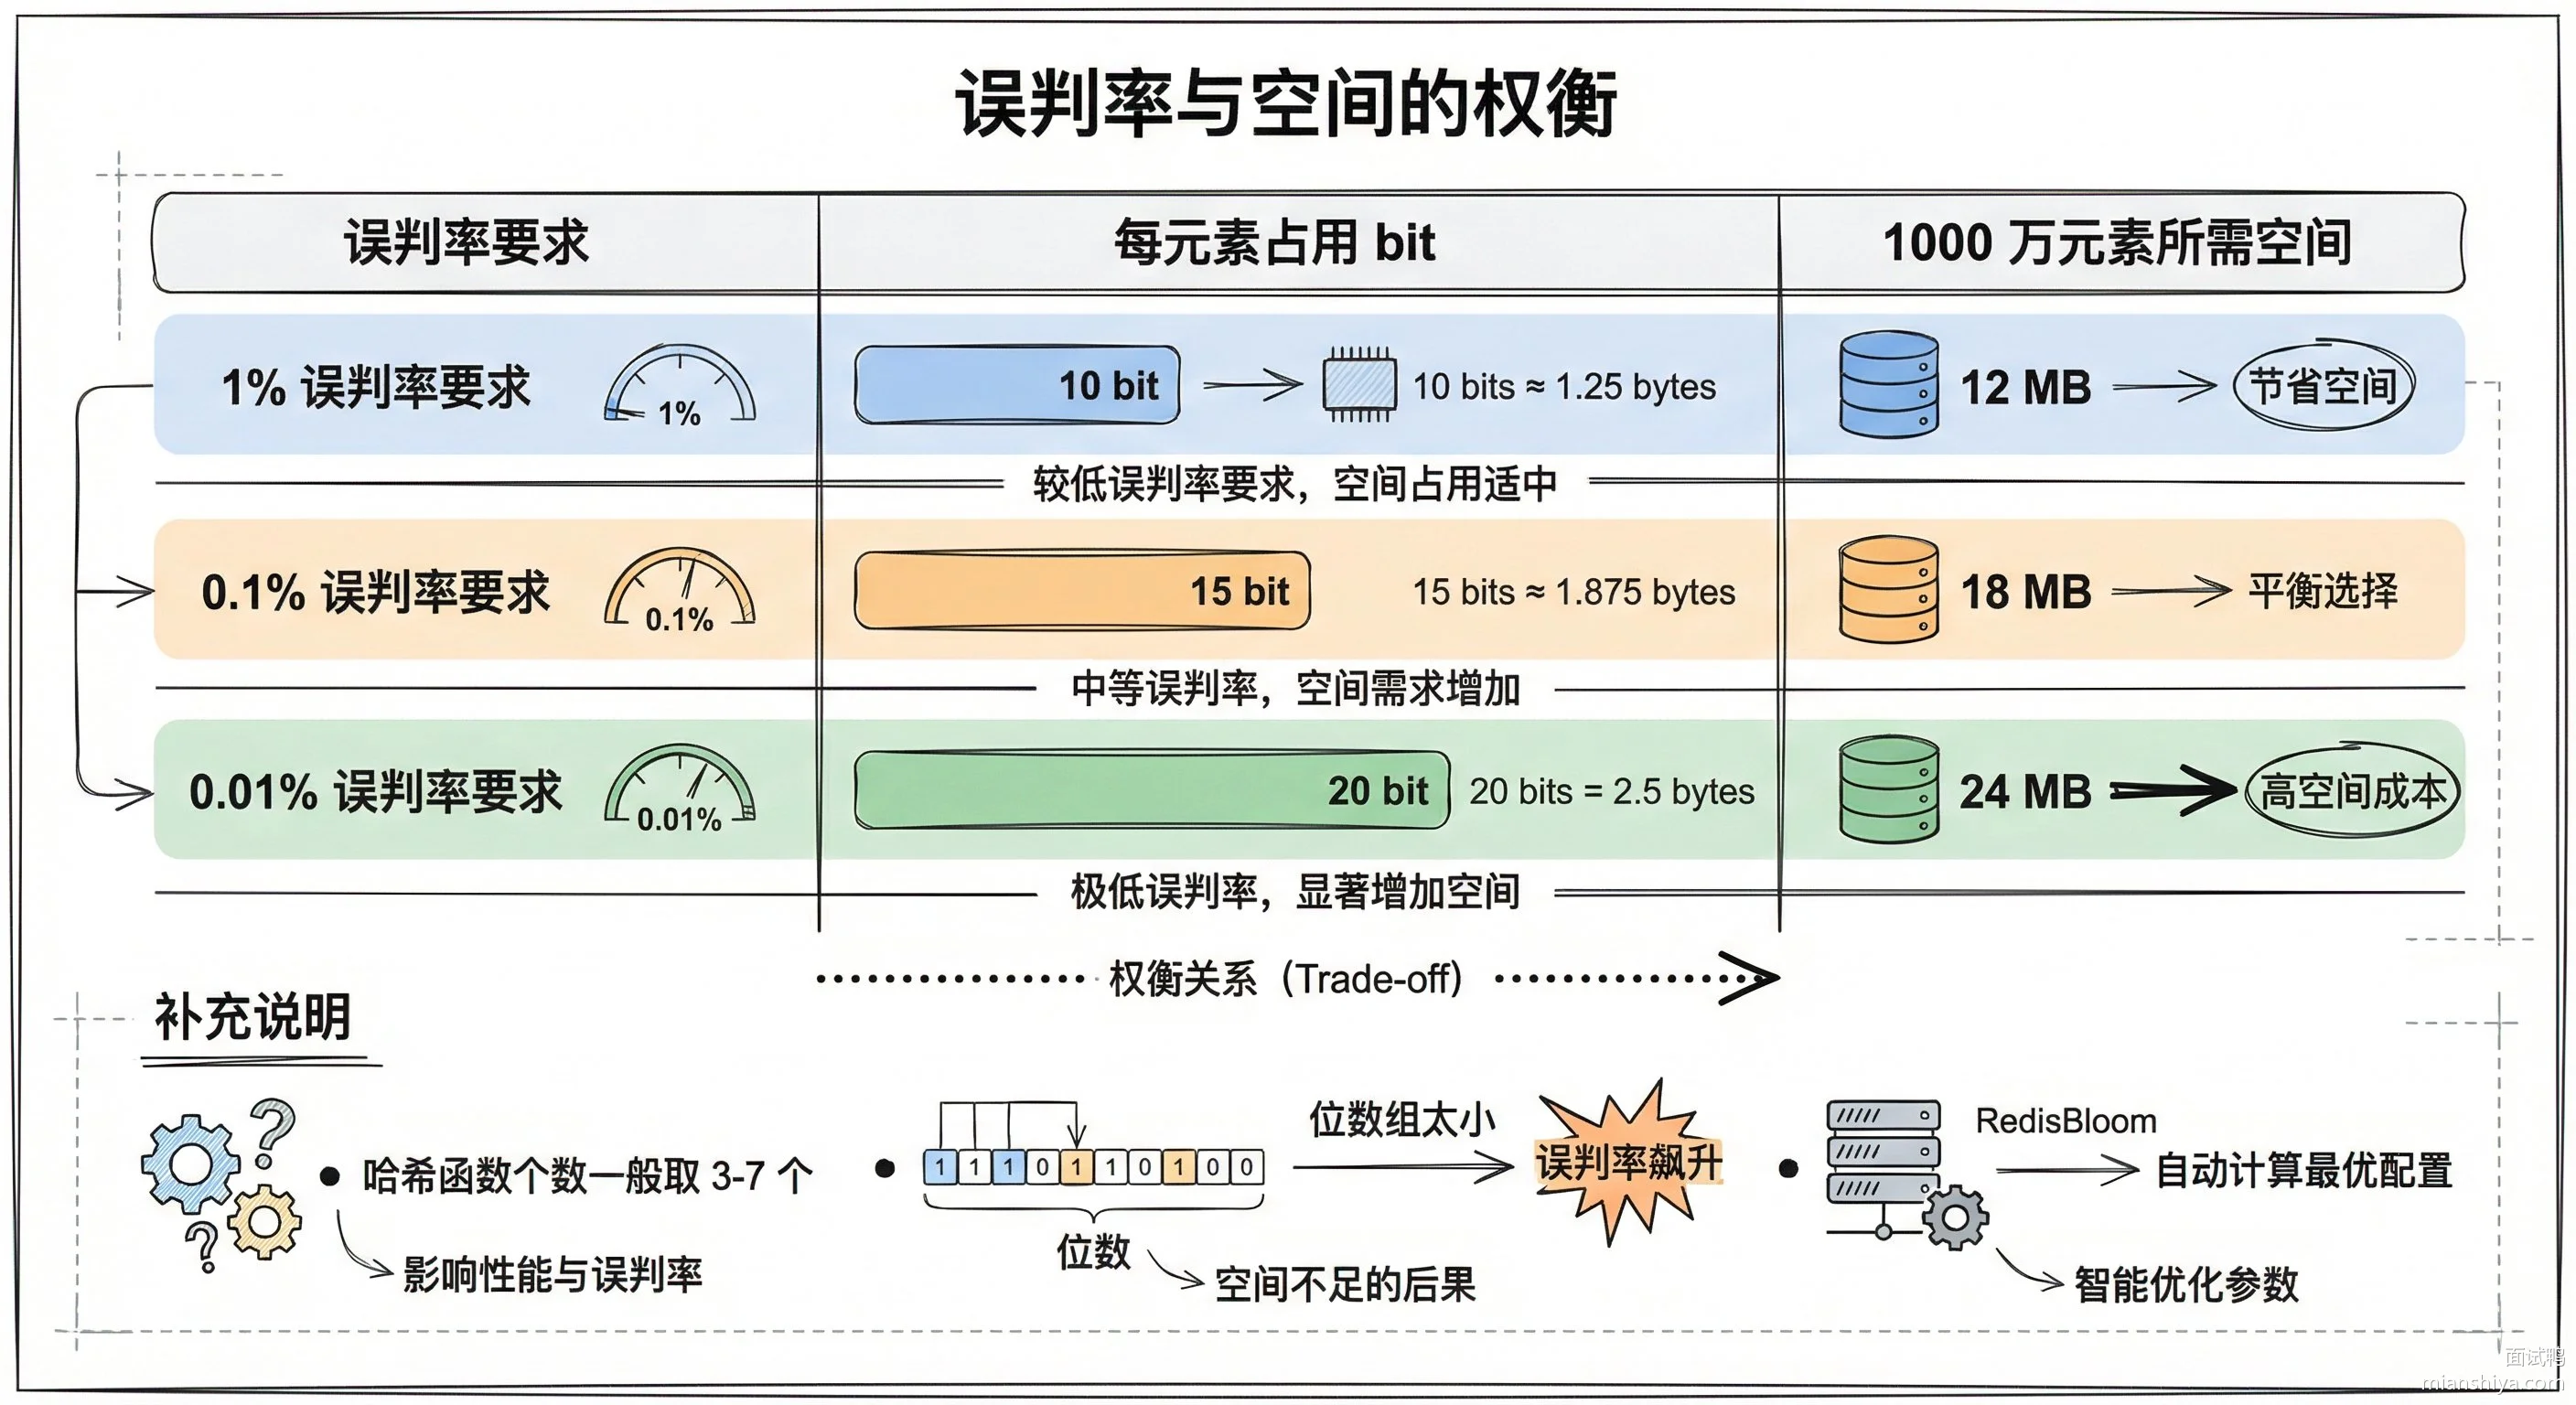
30.2.3. 解决缓存穿透的典型用法
缓存穿透是指查询一个数据库里压根不存在的数据,每次请求都打到数据库。用布隆过滤器可以在缓存层拦截:
public User getUser(Long userId) {
    String key = "user:" + userId;

    // 1. 先查布隆过滤器
    if (!bloomFilter.mightContain("user_bloom", String.valueOf(userId))) {
        return null; // 布隆过滤器说不存在,直接返回
    }

    // 2. 查缓存
    User user = cache.get(key);
    if (user != null) {
        return user;
    }

    // 3. 查数据库
    user = userDao.findById(userId);
    if (user != null) {
        cache.set(key, user);
    }
    return user;
}
这样恶意请求查不存在的用户 ID,在布隆过滤器这一层就被拦住了,不会打到数据库。
30.2.4. RedisBloom 模块详解
RedisBloom 是 Redis Labs 提供的官方模块,内置了最优参数计算,使用起来比手动实现方便很多:
# 创建过滤器时指定误判率和预期容量
BF.RESERVE myfilter 0.001 10000000
# 误判率 0.1%,容量 1000 万

# 批量添加
BF.MADD myfilter item1 item2 item3

# 批量查询
BF.MEXISTS myfilter item1 item2 item3

# 查看过滤器信息
BF.INFO myfilter
如果没提前创建过滤器直接 BF.ADD,RedisBloom 会用默认参数创建一个。默认误判率 0.01,默认容量 100。生产环境建议显式 BF.RESERVE。
Java 中用 Redisson 可以直接操作:
RBloomFilter<String> bloomFilter = redisson.getBloomFilter("user_bloom");
// 初始化,预期插入 5000 万,误判率 3%
bloomFilter.tryInit(50000000L, 0.03);

bloomFilter.add("user:10086");
boolean exists = bloomFilter.contains("user:10086");
30.2.5. 布隆过滤器的适用场景
适合用布隆过滤器的场景有几个共同特点:数据量大、允许小概率误判、只需要判断存在性。
1)爬虫 URL 去重:几亿个 URL 判断有没有爬过,误判了顶多漏爬一个页面
2)垃圾邮件过滤:黑名单地址判断,误判了可能误杀一封正常邮件,但概率可控
3)推荐系统去重:判断用户有没有看过某个内容,误判了顶多少推一条
4)分布式缓存层:HBase、Cassandra 都用布隆过滤器快速判断某个 key 在不在某个 HFile/SSTable 里,减少磁盘 IO
30.2.6. 布隆过滤器的变种
原版布隆过滤器不支持删除,有些场景不太方便。后来出了几个变种:
1)Counting Bloom Filter:每个位置不是 0/1,而是一个计数器,可以删除。代价是空间翻好几倍
2)Cuckoo Filter:支持删除,空间效率和原版差不多,Facebook 在用
3)Scalable Bloom Filter:支持动态扩容,元素超了自动加一层过滤器
RedisBloom 模块里就支持 Cuckoo Filter,用 CF.ADD/CF.EXISTS 操作。
30.3. 常见问题
30.3.1. 布隆过滤器的误判率能不能降到 0?
不能。布隆过滤器的本质是用哈希函数把元素映射到有限的位数组,哈希冲突不可避免。误判率可以通过增大位数组、增加哈希函数来降低,但永远不可能是 0。如果需要精确判断,只能用 Set 这种数据结构,但空间开销会大很多。布隆过滤器的价值就在于用很小的空间代价换取"肯定不存在"的确定性。
30.3.2. 为什么布隆过滤器不支持删除?
因为位数组里的某个位可能是多个元素共同设置的。比如元素 A 和元素 B 的某个哈希值都指向位置 5,删除 A 的时候如果把位置 5 置 0,那查询 B 的时候就会误判为不存在。想支持删除要用 Counting Bloom Filter,把每个位置换成计数器,但空间会膨胀 4-8 倍。
30.3.3. Redis 位图实现布隆过滤器和 RedisBloom 模块有什么区别?
手动用位图实现需要自己选哈希函数、计算位数组大小、写代码逻辑,容易出错。RedisBloom 模块帮你把这些都封装好了,只要指定误判率和容量,它自动算出最优的位数组大小和哈希函数个数。另外 RedisBloom 还支持动态扩容、批量操作,性能也更好。生产环境推荐用 RedisBloom。
30.3.4. 布隆过滤器和 HyperLogLog 有什么区别?
解决的问题不一样。布隆过滤器是判断"某个元素在不在集合里",HyperLogLog 是估算"集合里有多少个不重复元素"。布隆过滤器可以查询单个元素,HyperLogLog 只能给出整体基数估算。另外误差也不一样,布隆过滤器的误判率可以配置到很低,HyperLogLog 的标准误差固定在 0.81% 左右。
31. 如何使用 Redis 统计大量用户唯一访问量(UV)?
31.1. 核心要点
Redis 中的 HyperLogLog 就是干这个的,用极少的内存统计海量数据的去重数量。它是一种基数估算的概率性数据结构,每个 key 固定只占 12 KB 内存,哪怕你往里塞 1 亿个用户 ID,内存占用也不会涨。代价是有 0.81% 左右的误差,不过对于 UV 统计这种场景,差个几百几千完全可以接受。
用 Set 也能做去重统计,但 1000 万用户 ID 光存 Set 就得几百 MB 内存,HyperLogLog 只要 12 KB,差了 4 个数量级。
HyperLogLog 和 Set 的对比:
- Set:精确统计,内存随数据量线性增长,1000 万用户约 400 MB
- HyperLogLog:近似统计,固定 12 KB 内存,误差 0.81%
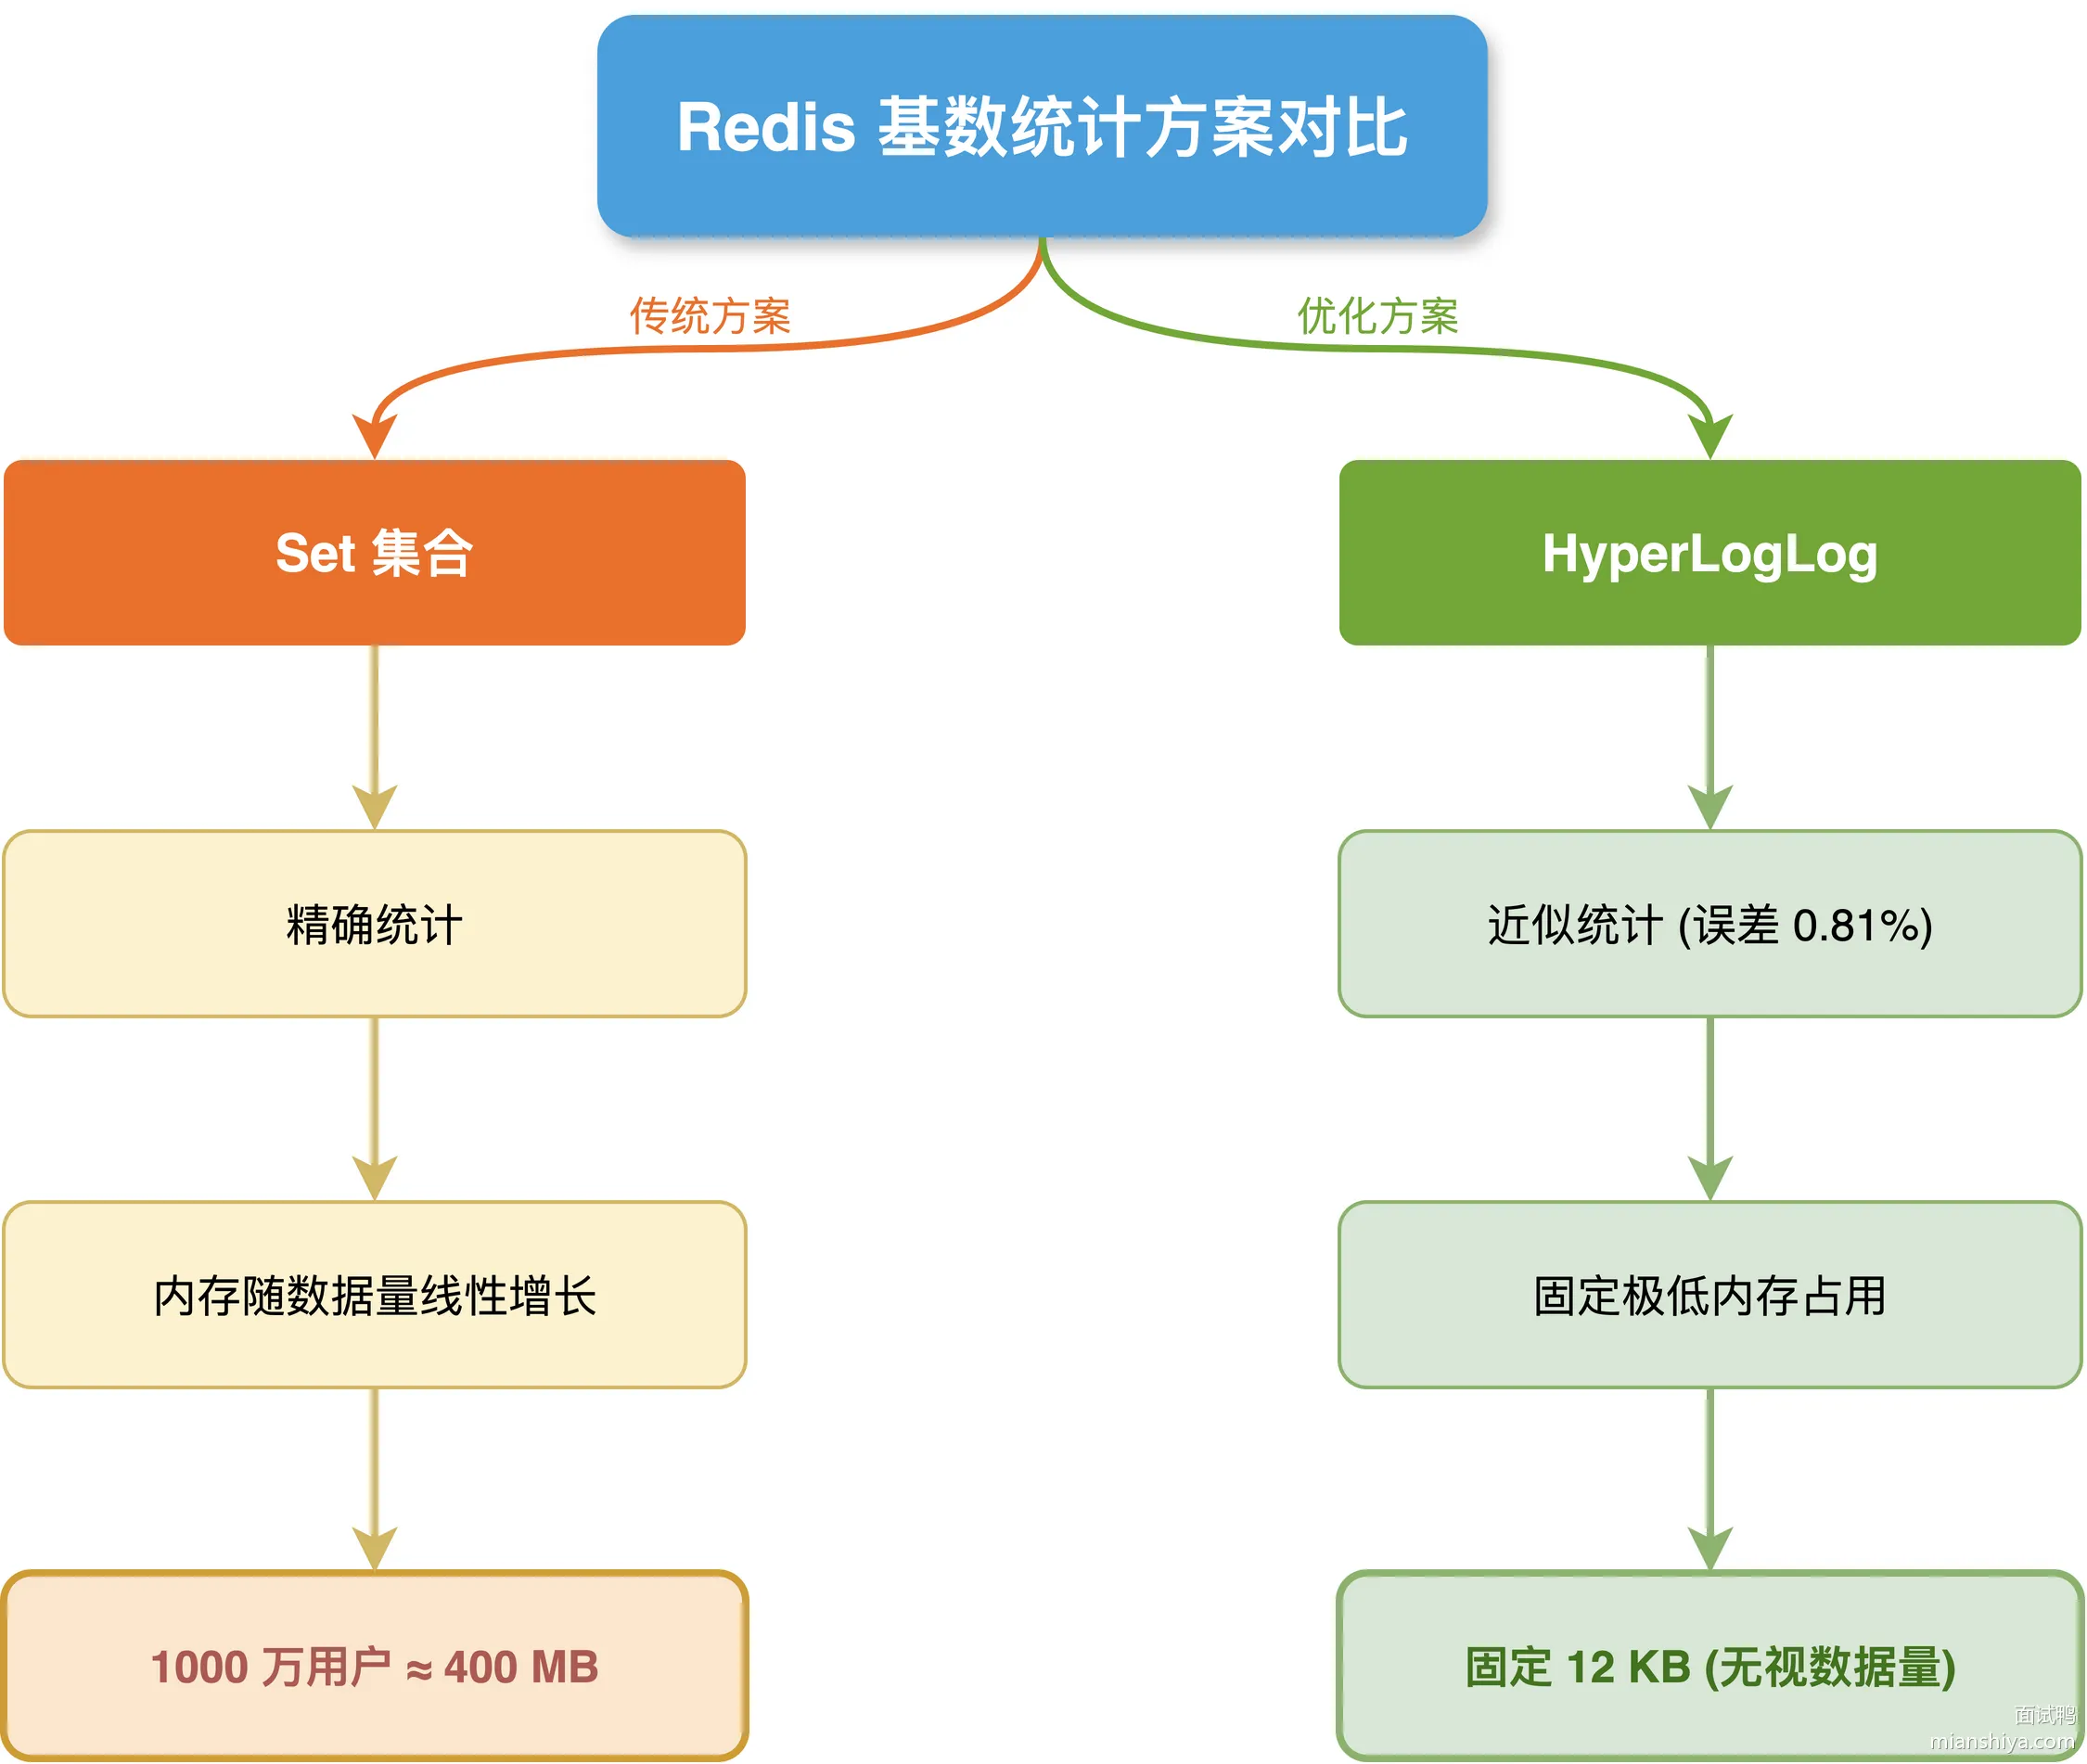
三个核心命令:
1)PFADD key element ... 把用户 ID 加进去
2)PFCOUNT key 拿到去重后的数量
3)PFMERGE destkey sourcekey ... 合并多个 HyperLogLog,比如把每小时的 UV 合并成日 UV
Java 代码示例:
import redis.clients.jedis.Jedis;

public class RedisHyperLogLogUV {

    private static final String UV_KEY = "uv";

    private Jedis jedis;

    public RedisHyperLogLogUV() {
        // 连接到 Redis
        this.jedis = new Jedis("localhost", 6379);
    }

    // 添加用户访问记录
    public void addUserVisit(String userId) {
        jedis.pfadd(UV_KEY, userId);
    }

    // 获取独立用户访问量
    public long getUniqueVisitorCount() {
        return jedis.pfcount(UV_KEY);
    }

    // 关闭连接
    public void close() {
        jedis.close();
    }

    public static void main(String[] args) {
        RedisHyperLogLogUV uvCounter = new RedisHyperLogLogUV();

        // 模拟用户访问
        uvCounter.addUserVisit("user1");
        uvCounter.addUserVisit("user2");
        uvCounter.addUserVisit("user3");
        uvCounter.addUserVisit("user1"); // 重复访问
        uvCounter.addUserVisit("user4");

        // 获取独立用户访问量
        long uniqueVisitors = uvCounter.getUniqueVisitorCount();
        System.out.println("Unique Visitors: " + uniqueVisitors); // 输出: 4

        // 关闭连接
        uvCounter.close();
    }
}
31.2. 扩展知识
31.2.1. HyperLogLog 原理
HyperLogLog 的核心思想挺巧妙的:通过哈希值的前导零长度来估算集合大小。
先把每个元素哈希成一个 64 位的二进制串,然后看这个串从左往右数有多少个连续的 0。直觉上,如果你扔硬币扔出连续 10 个正面,那你大概率已经扔了很多次了。同理,如果哈希值出现了很长的前导零,说明你已经塞了很多元素进去。
但只看一个最大前导零长度,误差会很大。所以 HyperLogLog 把哈希空间切成 16384 个桶,每个元素根据哈希值的前 14 位决定落到哪个桶,剩下的 50 位用来算前导零。每个桶只存一个数字:落到这个桶里的所有元素中,最大的前导零长度是多少。
HyperLogLog 分桶原理:
- 输入元素经过哈希得到 64 位二进制值
- 前 14 位决定落入哪个桶(共 16384 个桶)
- 剩余 50 位计算前导零长度
- 每个桶只存储最大前导零长度
- 最后用调和平均数估算总基数
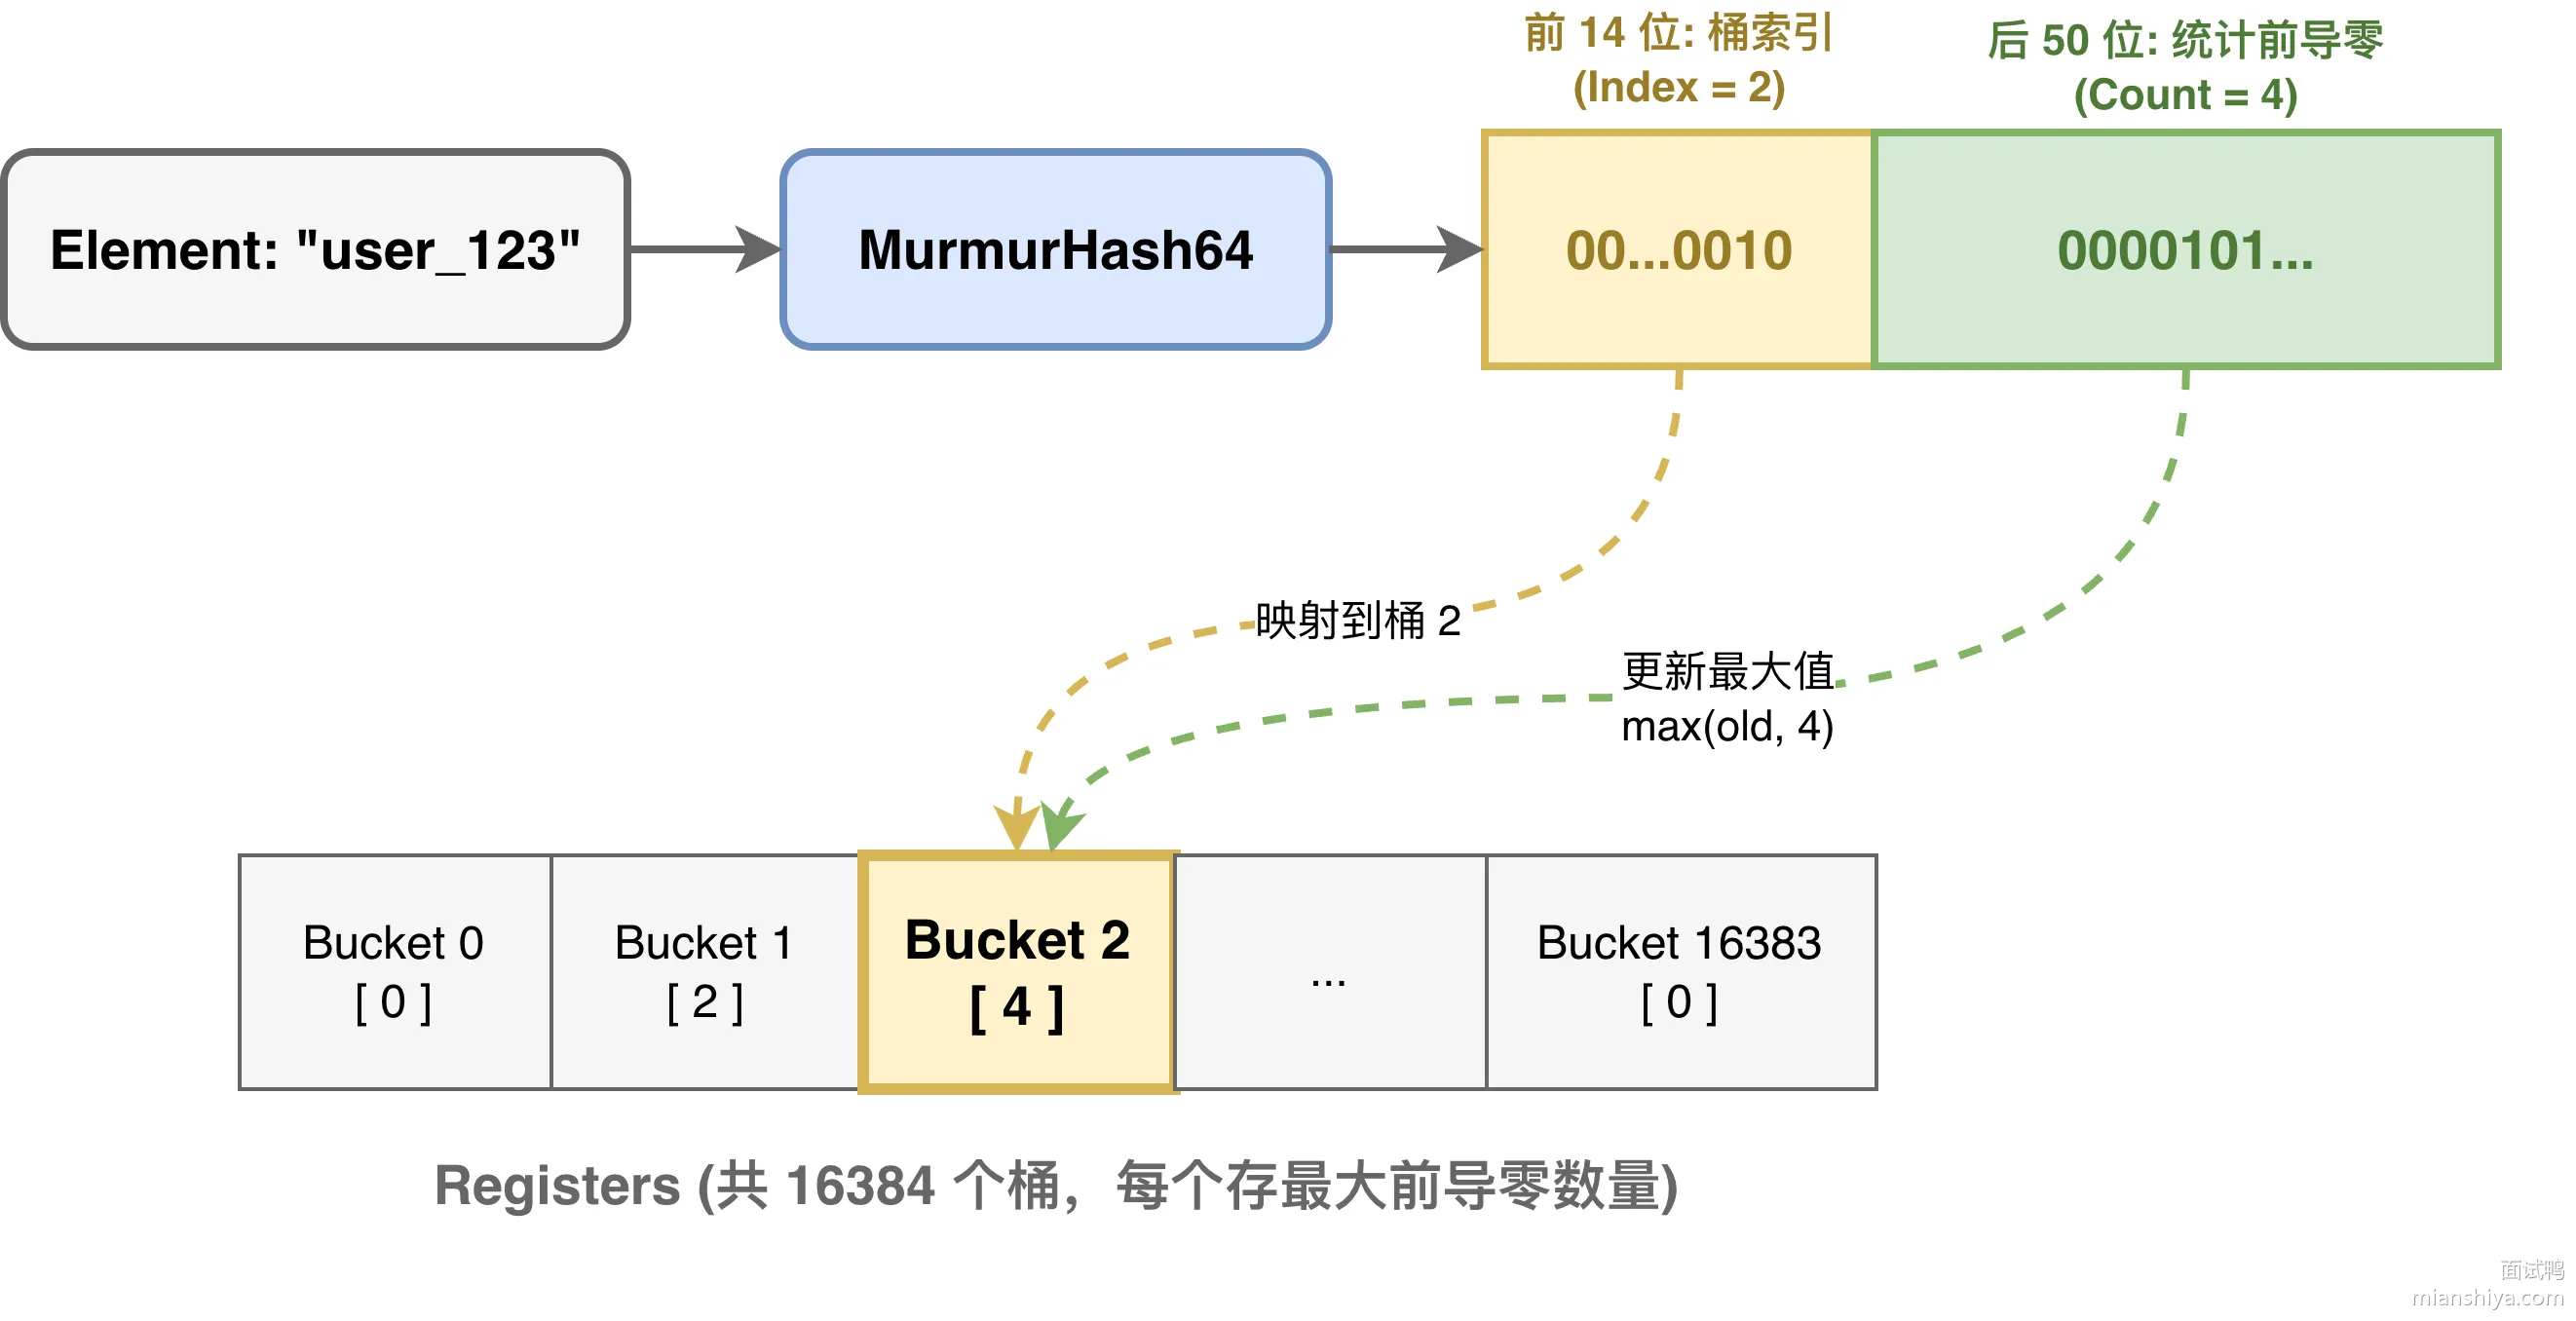
最后用调和平均数把所有桶的数据综合起来,算出一个估算值。用调和平均而不是算术平均,是因为调和平均对极值不敏感,能有效减少个别极端值带来的偏差。
每个桶只需要 6 bit 就能存下前导零长度,16384 个桶一共 16384 × 6 / 8 = 12288 字节,加上一点点元数据,正好约 12 KB。
31.2.2. 实际应用中的选择
UV 统计并不是只有 HyperLogLog 一种方案,得看具体场景:
| 方案 | 内存占用 | 精确度 | 适用场景 |
|---|---|---|---|
| Set | 随数据量线性增长 | 100% 精确 | 小规模、需要精确值、需要查询具体元素 |
| HyperLogLog | 固定 12 KB | 误差 0.81% | 大规模 UV/PV 统计、只关心数量 |
| Bitmap | 1 bit/用户 | 100% 精确 | 用户 ID 是连续数字、需要精确值 |
如果你的用户 ID 是从 1 开始的连续整数,Bitmap 可能更划算。1 亿用户只要 12.5 MB 内存,比 HyperLogLog 大但能精确统计。但如果用户 ID 是 UUID 或者分布很稀疏,Bitmap 就不适合了。
31.2.3. HyperLogLog 的局限性
1)没法删除元素。桶里只存了最大前导零长度,你删一个元素,这个最大值可能还是那个元素贡献的,没法减掉。
2)只能统计数量。你只能知道"大概有多少个不同的用户",但拿不到具体是哪些用户。
3)误差是固定比例。0.81% 的误差率,在 1000 万 UV 的场景下就是 ±8 万的波动,能不能接受得看业务。
如果业务上需要精确值,或者需要支持删除操作,可以考虑用 Redis 的 Set 或者 Bitmap,或者干脆上 ClickHouse、Druid 这类 OLAP 数据库,它们有专门的去重聚合函数。
31.3. 常见问题
31.3.1. HyperLogLog 的误差是怎么算出来的?能不能调整?
误差率由桶的数量决定,公式大概是 1.04 / √m,m 是桶数。Redis 用了 16384 个桶,算出来就是 0.81% 左右。理论上桶数越多误差越小,但内存占用也会变大。Redis 把这个参数写死了,你没法调,因为 12 KB 和 0.81% 的平衡点对大多数场景都够用了。
31.3.2. 如果我要统计每天的 UV,第二天怎么重置?
直接 DEL 掉这个 key 就行,或者用带日期的 key 名,比如 uv:20240115。HyperLogLog 没有 clear 命令,想清空就删 key。用日期做 key 后缀还有个好处:历史数据自动保留,想看哪天的 UV 直接 PFCOUNT 对应 key。
31.3.3. 两个 HyperLogLog 合并后,误差会变大吗?
不会变大。PFMERGE 的原理是取每个桶的最大值,合并后还是 16384 个桶,误差率还是 0.81%。这也是 HyperLogLog 的一个优势:你可以先按小时统计,再合并成天、周、月,误差不会累积。
32. Redis 中的 Geo 数据结构是什么?
32.1. 核心要点
Redis 的 Geo 是专门用来存储和查询地理位置信息的数据结构,从 Redis 3.2 版本开始支持。你可以往里面存经纬度坐标,然后做"附近的人"、"周围 3 公里有哪些门店"这类查询。
底层实现其实是 Sorted Set,每个位置点用 Geohash 算法编码成一个分数,利用有序集合的范围查询能力来实现地理搜索。
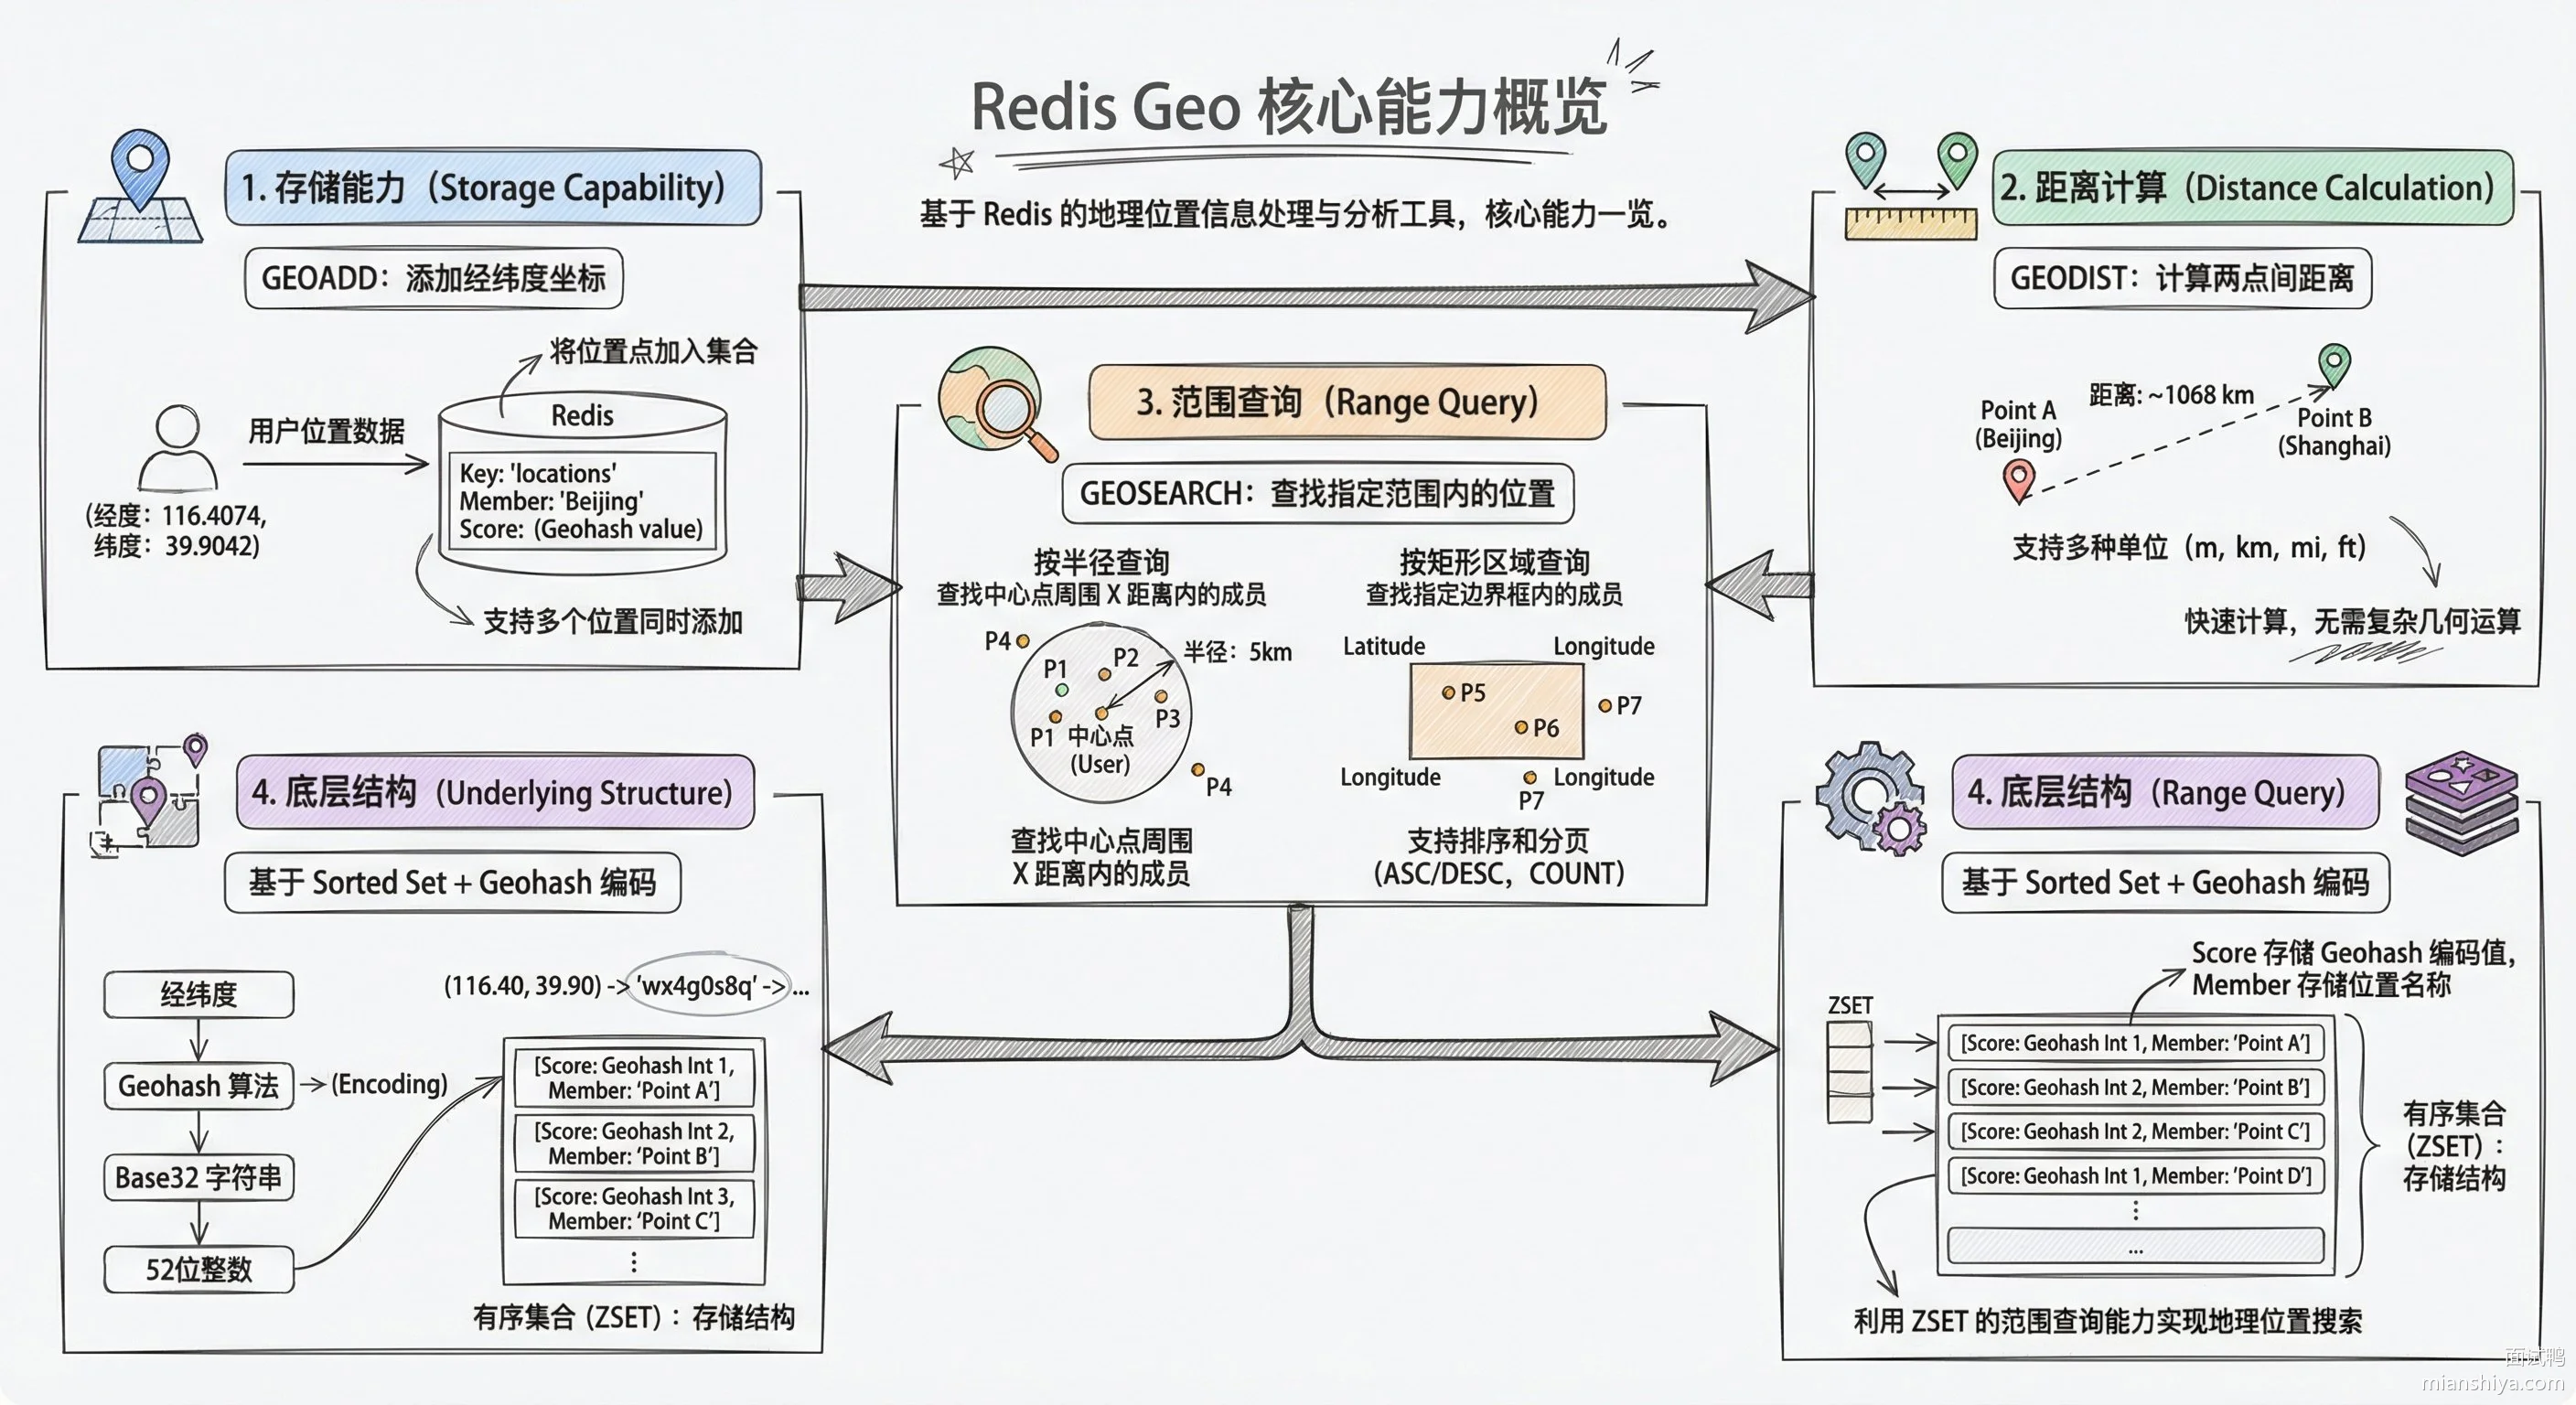
常用命令:
1)GEOADD key longitude latitude member 存入一个位置点
2)GEODIST key member1 member2 km 计算两个位置点之间的距离
3)GEOSEARCH key FROMMEMBER member BYRADIUS 10 km 以某个位置为圆心,搜索 10 公里范围内的点
32.2. 扩展知识
32.2.1. Geohash 编码原理
Geo 能工作的关键在于 Geohash 算法。它能把二维的经纬度坐标压缩成一维的整数,而且有个很好的特性:地理位置越接近的两个点,编码后的值也越接近。
编码过程是这样的:把整个地球看成一个矩形,经度范围 -180 到 180,纬度范围 -90 到 90。每次把矩形切成两半,看目标坐标落在左边还是右边,左边记 0,右边记 1。不断切分,就得到一串二进制数。经度和纬度分别编码后,交叉合并成最终的 Geohash 值。
Redis 里用 52 位的 Geohash 精度,大约能精确到 0.6 米级别,对大多数应用场景够用了。
32.2.2. 为什么用 Sorted Set 做底层
Sorted Set 的 ZRANGEBYSCORE 命令可以高效地取出分数在某个范围内的元素。Geohash 的特性保证了相近的地理位置有相近的分数,所以"找附近 5 公里的点"这种查询,就转化成了"找分数在某个区间内的元素",时间复杂度是 O(log N + M),N 是总元素数,M 是返回结果数。
不过 Geohash 有个边界问题:两个实际上很近的点,如果正好跨了网格边界,编码值可能差很远。Redis 内部处理范围查询时,会同时搜索周围 8 个相邻网格来解决这个问题。
32.2.3. 命令演进
Redis 6.2 之后,GEORADIUS 和 GEORADIUSBYMEMBER 被标记为弃用,推荐用 GEOSEARCH 替代。新命令功能更强,支持圆形和矩形两种搜索范围,用起来也更直观。
# 旧写法
GEORADIUS stores 116.397128 39.916527 5 km WITHDIST COUNT 10

# 新写法
GEOSEARCH stores FROMMEMBER "beijing_hq" BYRADIUS 5 km WITHDIST COUNT 10
如果要把搜索结果存到另一个 key 里,用 GEOSEARCHSTORE。
32.2.4. 典型应用场景
| 场景 | 示例 | 核心操作 |
|---|---|---|
| 附近的人/店 | 微信附近的人、美团外卖商家列表 | GEOSEARCH 范围搜索 |
| 距离计算 | 快递预估送达时间、打车计费 | GEODIST 两点距离 |
| 位置打卡 | 考勤系统、运动轨迹记录 | GEOADD + GEOPOS |
像滴滴、美团这种 LBS 业务,后台存司机/骑手位置时,Redis Geo 就是一个轻量级的选择。当然,如果业务规模上去了,数据量超过几千万级别,可能还是得上 PostGIS 这类专业的地理搜索引擎。
32.2.5. 局限性
1)数据量有上限。因为底层是 Sorted Set,单个 key 存几百万个位置点还行,再多就得分片。
2)只支持地球表面的二维坐标。如果你要算的是室内定位或者三维空间,Geo 就搞不定了。
3)没有原生的轨迹存储能力。要记录用户移动轨迹,得自己用时间戳做 key 或者上 TimeSeries 方案。
32.3. 常见问题
32.3.1. Geohash 精度越高越好吗?
不是。精度越高,编码位数越多,占用空间越大。更关键的是,精度太高反而会影响范围查询的效率。假设你用 60 位精度,两个相距 1 公里的点,Geohash 值可能差好几个数量级,范围查询时要扫描的网格数就变多了。Redis 用 52 位是个平衡点,精确到 0.6 米够用,查询效率也有保证。
32.3.2. Geo 和普通 Sorted Set 在内存占用上有区别吗?
没区别,因为 Geo 底层就是 Sorted Set。一个位置点占用的内存 = member 字符串长度 + 8 字节的分数。所以 member 命名尽量短一点,比如用 ID 而不是完整名称,能省不少内存。
32.3.3. 高并发场景下,大量位置更新会有性能问题吗?
GEOADD 本质是 ZADD,时间复杂度 O(log N)。每秒几万次更新一般没问题,但如果是百万级 QPS,单个 Redis 实例肯定扛不住。常见做法是按城市或区域分片,北京的位置存一个 key,上海的存另一个,写入压力就分散了。读取时根据用户当前位置路由到对应的 key。
33. 你在项目中使用的 Redis 客户端是什么?
33.1. 核心要点
Java 生态里主流的 Redis 客户端就三个:Jedis、Lettuce、Redisson,各有各的定位。
Jedis 是老牌客户端,API 直接对应 Redis 命令,上手快,但它是同步阻塞的,线程也不安全,每个线程得用自己的连接。
Lettuce 是 Spring Boot 2.x 之后的默认客户端,基于 Netty 实现,天生支持异步和响应式编程,一个连接可以被多个线程共享,高并发场景下更省资源。
Redisson 走的是高级封装路线,直接把分布式锁、分布式集合、限流器这些常用组件都包装好了,开箱即用,适合需要这些能力的项目。
三种客户端的定位:
- Jedis:同步阻塞,API 简单直接,线程不安全需要连接池
- Lettuce:异步非阻塞,基于 Netty,线程安全可共享连接
- Redisson:高级封装,提供分布式锁、集合等开箱即用的组件
选型建议:简单业务用 Lettuce 就够了,Spring Boot 默认集成不用额外配置;需要分布式锁、限流这些能力的直接上 Redisson;老项目或者团队熟悉 Jedis 的继续用也没问题,配好连接池一样稳定。
33.2. 扩展知识
33.2.1. Jedis 的连接池问题
Jedis 实例不是线程安全的,多线程共用一个 Jedis 会出各种诡异问题。所以生产环境必须用 JedisPool,每次操作从池子里借一个连接,用完还回去。
JedisPoolConfig config = new JedisPoolConfig();
config.setMaxTotal(100);   // 最大连接数
config.setMaxIdle(20);     // 最大空闲连接
config.setMinIdle(5);      // 最小空闲连接

JedisPool pool = new JedisPool(config, "localhost", 6379);

try (Jedis jedis = pool.getResource()) {
    jedis.set("key", "value");
}
连接池参数要根据实际 QPS 调。如果 maxTotal 设太小,高峰期借不到连接就报错;设太大又浪费资源,Redis 那边连接数也有上限。一般按"并发线程数 × 平均每个请求占用连接时间"来估算。
33.2.2. Lettuce 为什么能共享连接
Lettuce 底层用的是 Netty 的 NIO 模型,一个 TCP 连接上可以跑多个并发请求,靠请求 ID 来匹配响应。所以默认情况下,整个应用只需要一个连接就能撑住很高的并发。
不过有个坑:如果你用了 Redis 的阻塞命令,比如 BLPOP、BRPOP,那就得单独开连接,不然会阻塞住共享连接,把其他请求都卡死。
// Spring Boot 配置 Lettuce 连接池
spring:
  redis:
    lettuce:
      pool:
        max-active: 8
        max-idle: 8
        min-idle: 0
33.2.3. Redisson 的分布式能力
Redisson 最值钱的是它封装好的分布式组件:
| 组件 | 说明 | 典型用途 |
|---|---|---|
| RLock | 可重入分布式锁 | 防止并发修改 |
| RReadWriteLock | 读写锁 | 读多写少场景 |
| RSemaphore | 信号量 | 限制并发数 |
| RRateLimiter | 限流器 | 接口限流 |
| RBloomFilter | 布隆过滤器 | 缓存穿透防护 |
| RDelayedQueue | 延迟队列 | 订单超时、延迟任务 |
Redisson 分布式锁实现流程:
- 客户端执行 Lua 脚本尝试获取锁
- 获取成功则设置锁的过期时间(Redisson 默认自动配置 30s)
- 开启 watchdog 定时续期(若手动配置过期时间,则不会有 watchdog),防止业务没执行完锁就过期
- 业务执行完毕释放锁,删除 key
- 其他等待的客户端重新竞争
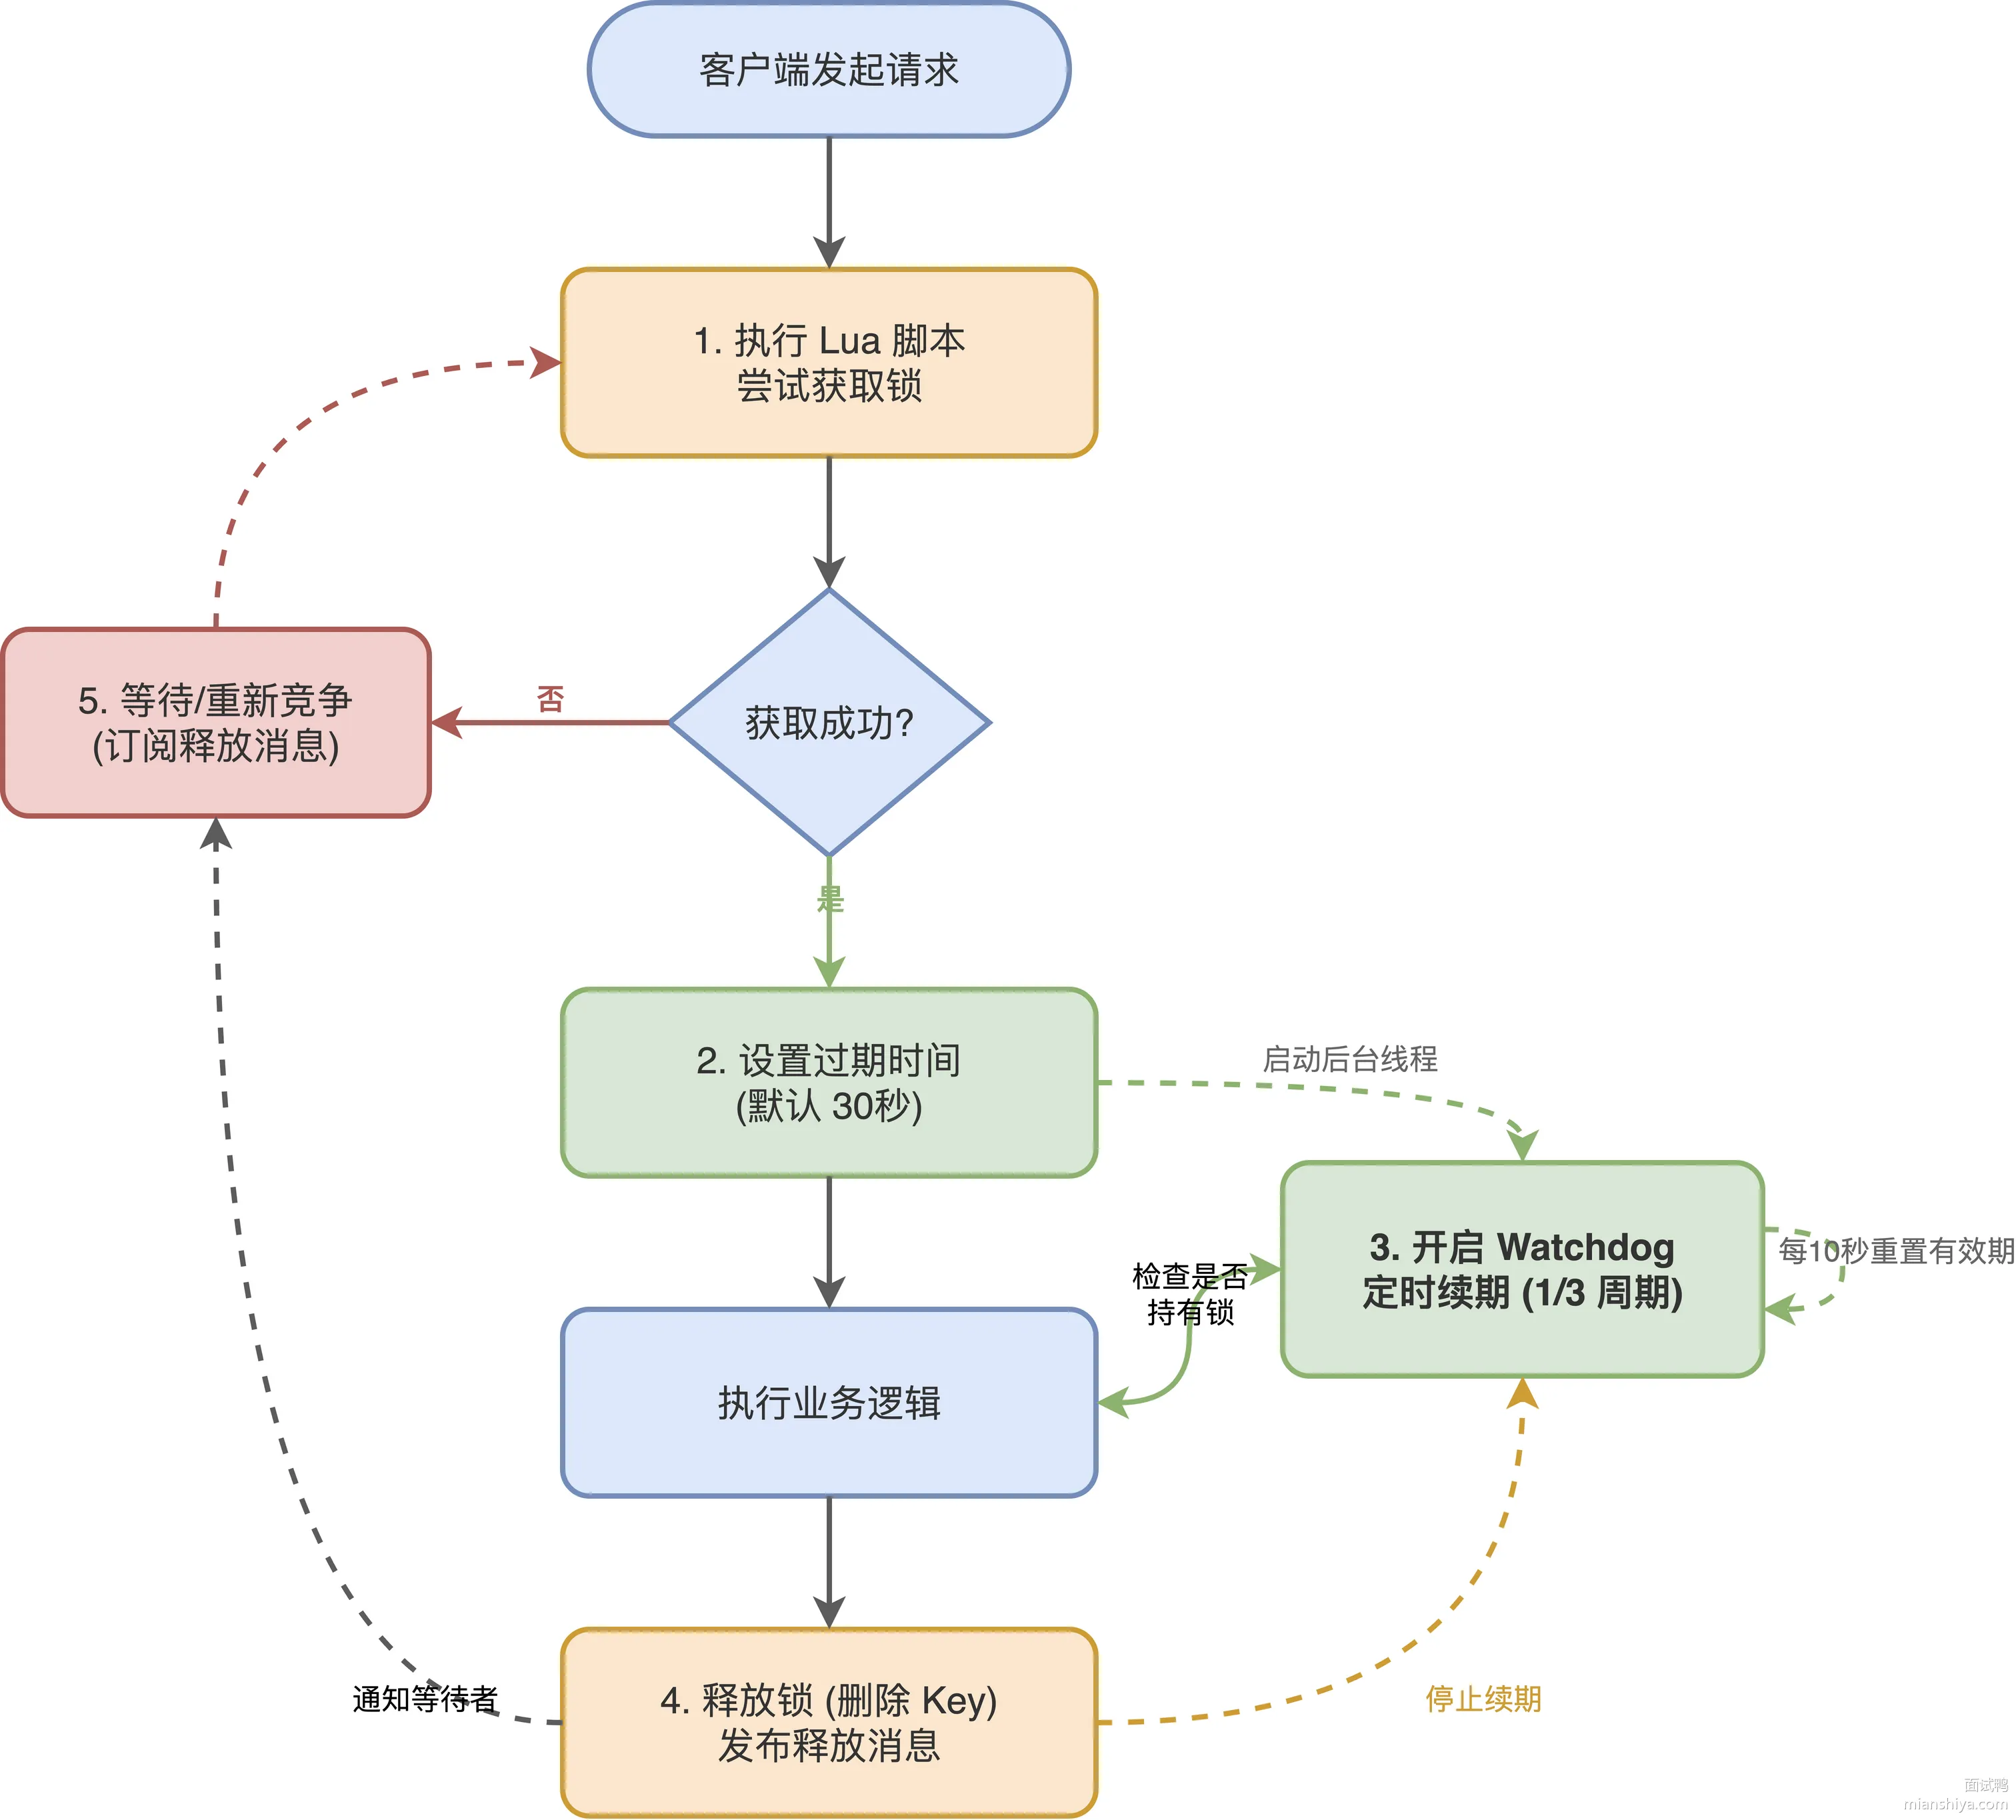
比如分布式锁,Redisson 用 Lua 脚本保证加锁的原子性,还有 watchdog 机制自动续期。你自己用 Jedis 实现的话,得处理锁过期、可重入、主从切换这些细节,很容易踩坑。
RLock lock = redisson.getLock("order:123");
try {
    // 等待 10 秒,锁自动释放时间 30 秒
    if (lock.tryLock(10, 30, TimeUnit.SECONDS)) {
        // 业务逻辑
    }
} finally {
    lock.unlock();
}33.2.4. 三者对比
| 维度 | Jedis | Lettuce | Redisson |
|---|---|---|---|
| 线程安全 | 否,需要连接池 | 是,可共享连接 | 是 |
| 编程模型 | 同步 | 同步/异步/响应式 | 同步/异步 |
| 底层实现 | BIO | Netty NIO | Netty NIO |
| API 风格 | 贴近 Redis 命令 | 贴近 Redis 命令 | 高级抽象封装 |
| 分布式组件 | 无 | 无 | 丰富 |
| Spring Boot 集成 | 需手动配置 | 默认集成 | 需手动配置 |
实际项目中,Lettuce 和 Redisson 可以一起用。日常的 get/set 走 Lettuce,分布式锁、限流走 Redisson。
33.2.5. 版本兼容性
如果你的 Redis 是 6.0 以上版本开了 ACL 认证,注意检查客户端版本。老版本 Jedis 不支持 ACL,只能用传统的 requirepass 认证。Lettuce 5.3+ 和 Redisson 3.13+ 才支持 ACL。
另外 Redis 7.0 引入的一些新特性,比如 Function,也需要客户端版本跟上才能用。
33.3. 常见问题
33.3.1. Jedis 连接池借不到连接会发生什么?
抛 JedisConnectionException,提示 Could not get a resource from the pool。常见原因要么是 maxTotal 设太小了,要么是有地方借了连接没还,造成连接泄漏。排查时先看连接池的活跃连接数,再检查代码有没有 try-finally 保证归还。
33.3.2. Lettuce 单连接模式下,Redis 执行慢查询会影响其他请求吗?
会。虽然 Lettuce 是异步的,但 Redis 服务端是单线程执行命令的。你发了一个 KEYS * 之类的慢查询,服务端卡住的这段时间,所有请求都得排队等。Lettuce 客户端这边能异步发请求,但响应得等 Redis 慢慢处理完才能回来。
33.3.3. Redisson 的 watchdog 机制具体是怎么工作的?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
不手动设置过期时间的话,默认每 10 秒检查一次,如果持有锁的线程还活着,就给锁续期到 30 秒。续期逻辑在客户端跑,如果客户端进程挂了,续期就停了,锁到期自动释放,不会死锁。但如果只是业务线程卡住而进程没挂,watchdog 会一直续期。
34. Redis 字符串类型的最大值大小是多少?
34.1. 核心要点
Redis 字符串的最大容量是 512 MB,这是 Redis 源码里写死的硬限制。
无论是网络传输、内存分配还是字符串操作,大字符串都会增加 Redis 服务器的负载。
且过大的字符串在 GET、SET、APPEND、STRLEN 等操作都会导致性能瓶颈,主从同步也有延迟风险。
所以官方给字符串的大小做了限制,防止单个键值对占用过多的内存,影响整体性能和稳定性。
实际生产中,单个字符串 10KB 以内是比较健康的范围,超过 100KB 就要考虑拆分了。512 MB 只是上限保护,不是让你真用这么大。
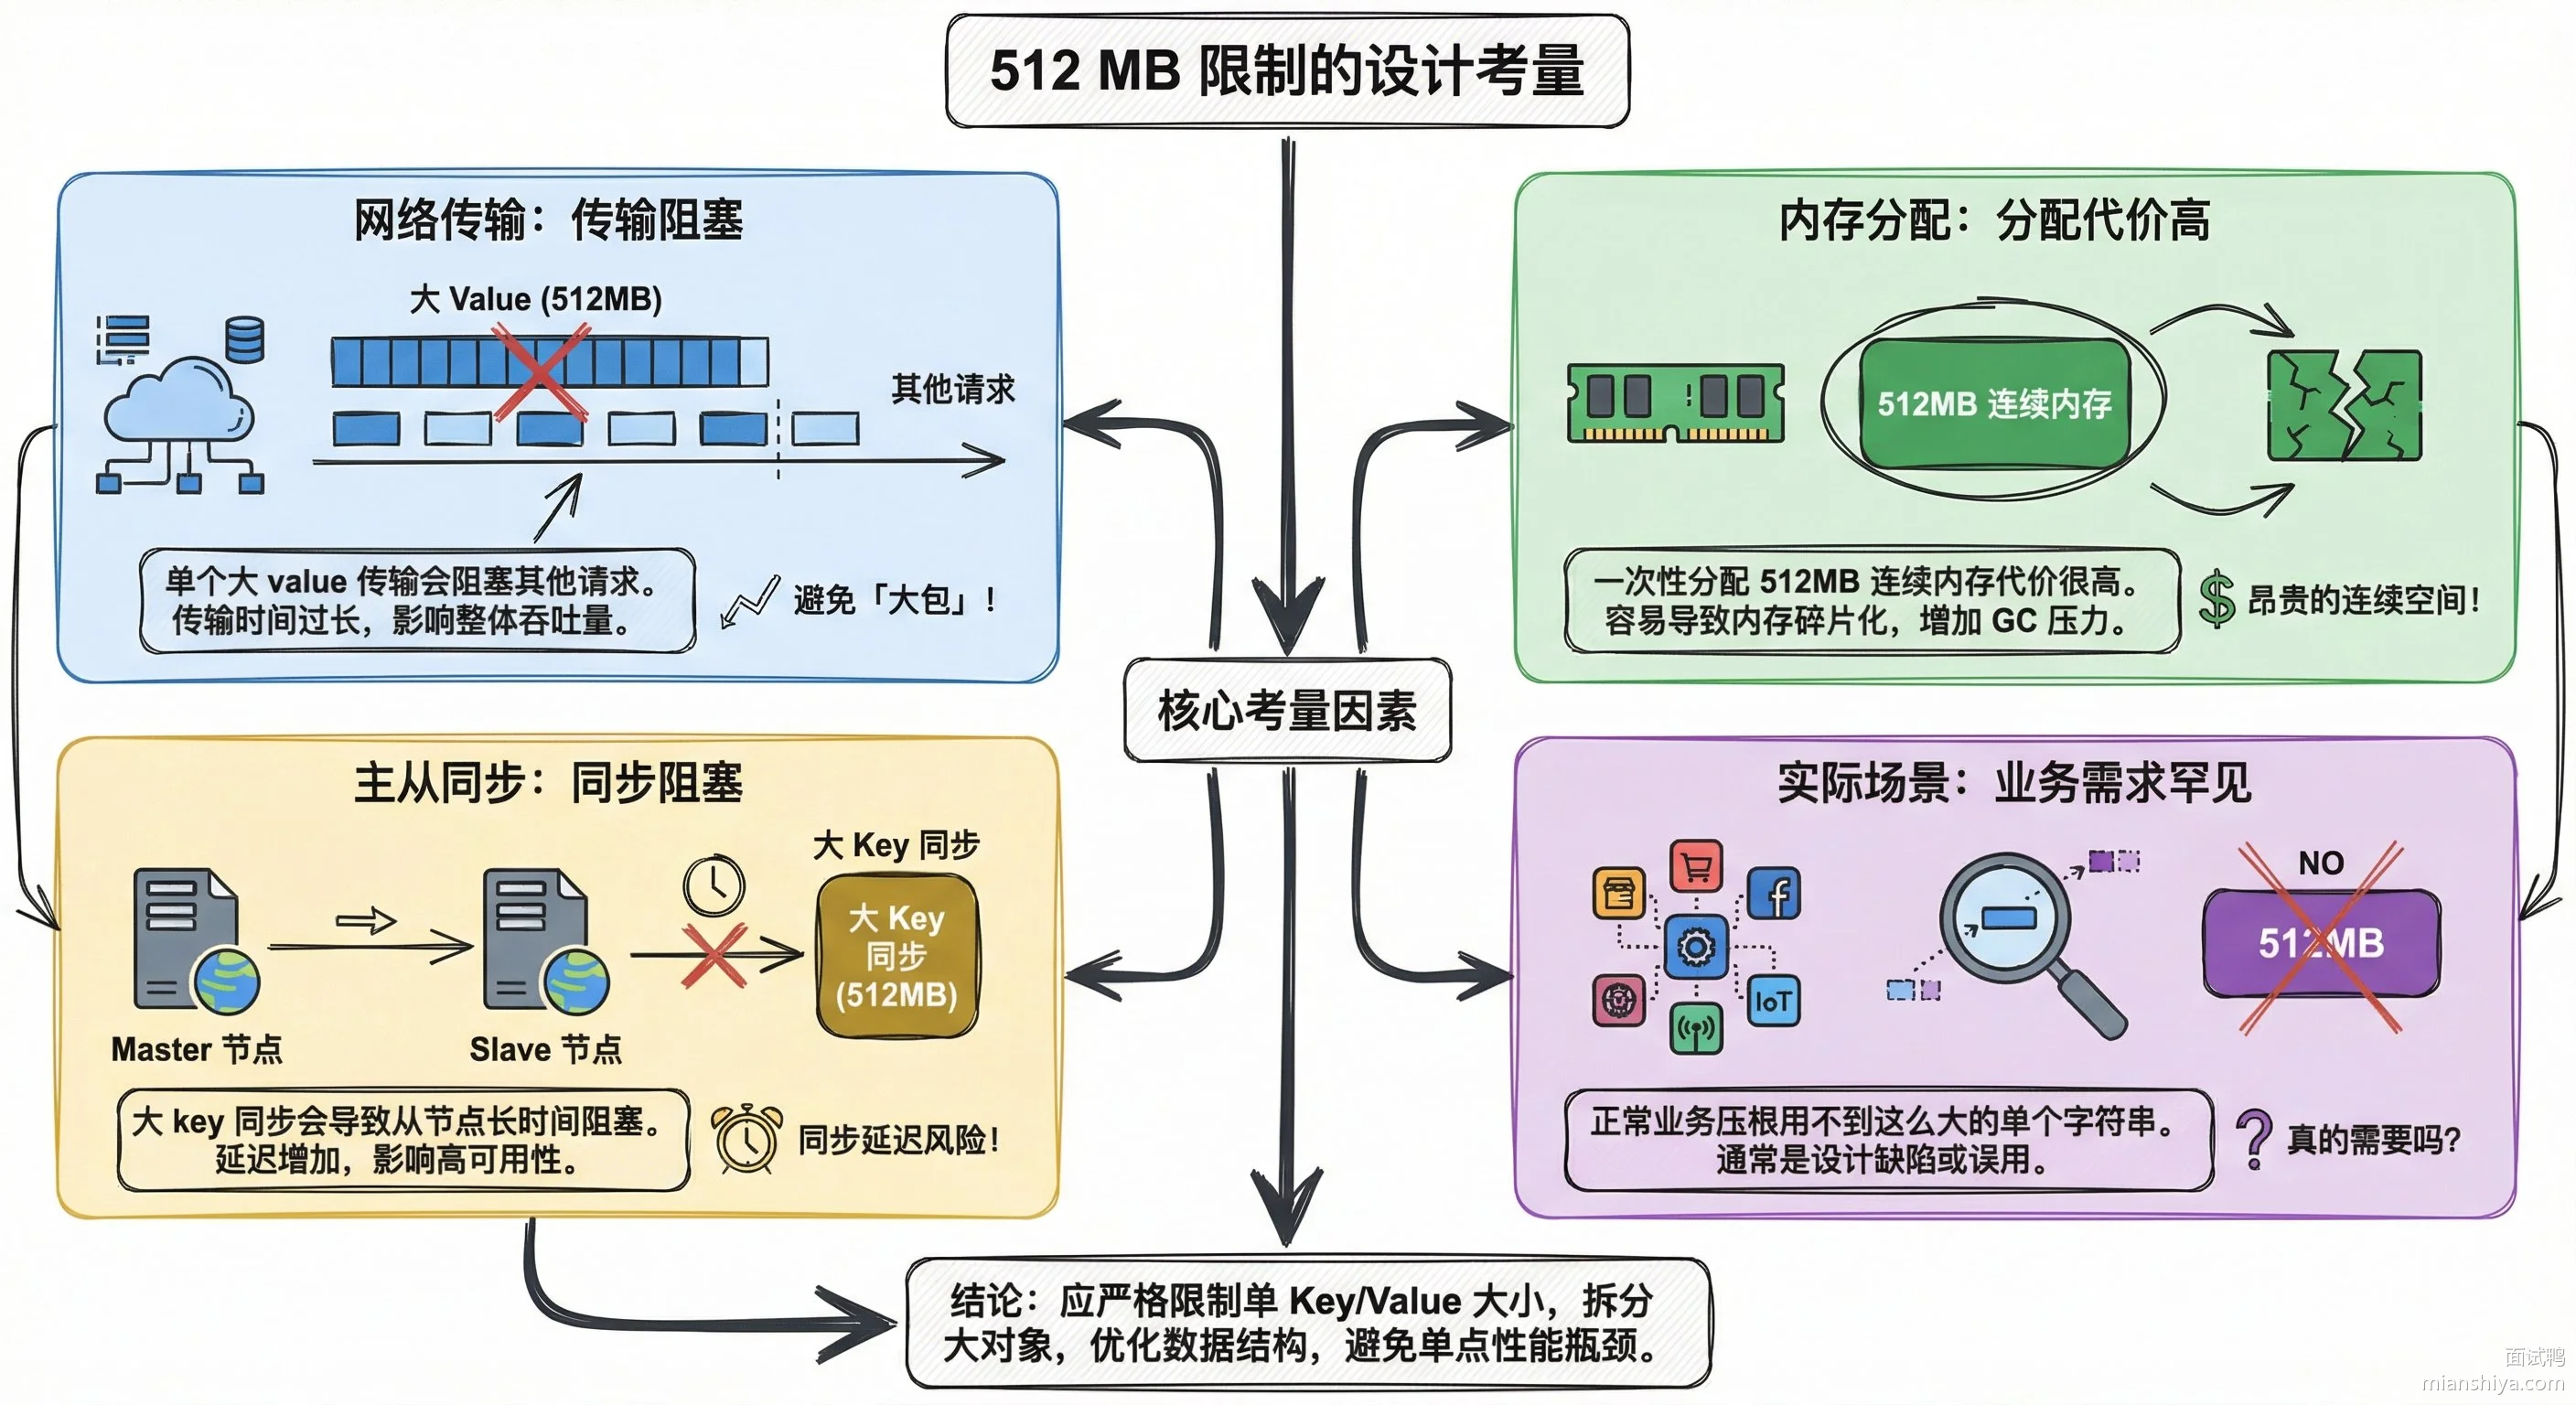
官方文档原文:
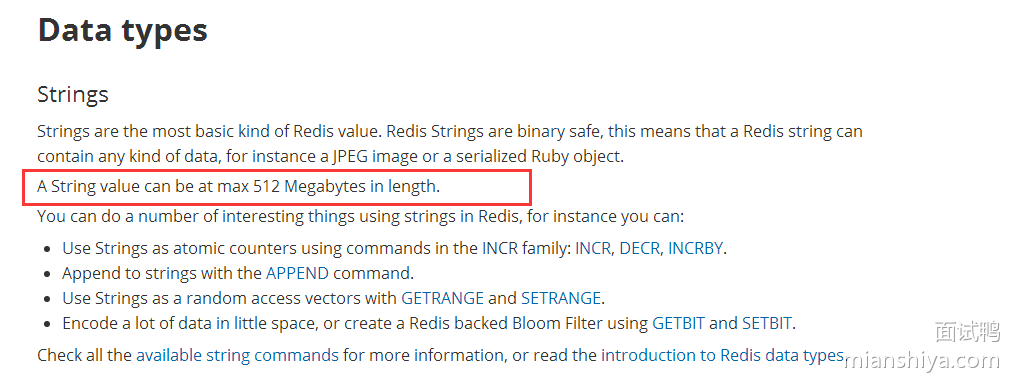
34.2. 扩展知识
34.2.1. 大字符串的性能问题
一个 100MB 的字符串,从写入到读取整条链路都是问题:
1)网络传输:100MB 数据在千兆网卡上要传将近 1 秒,这 1 秒内 Redis 主线程就卡在这一个请求上,其他几万个请求全在排队。
2)内存分配:Redis 用的 jemalloc 对大块内存分配效率不高,而且 100MB 连续内存不好找,容易产生内存碎片。
3)持久化影响:AOF 重写的时候,这 100MB 要完整写一遍;RDB 快照也是,大 key 越多,持久化越慢。
4)主从同步:全量同步的时候,主节点要把这 100MB 发给从节点,从节点加载期间是阻塞的。
5)过期删除:大 key 过期的时候,del 操作是同步的,删 100MB 数据能卡个几百毫秒。
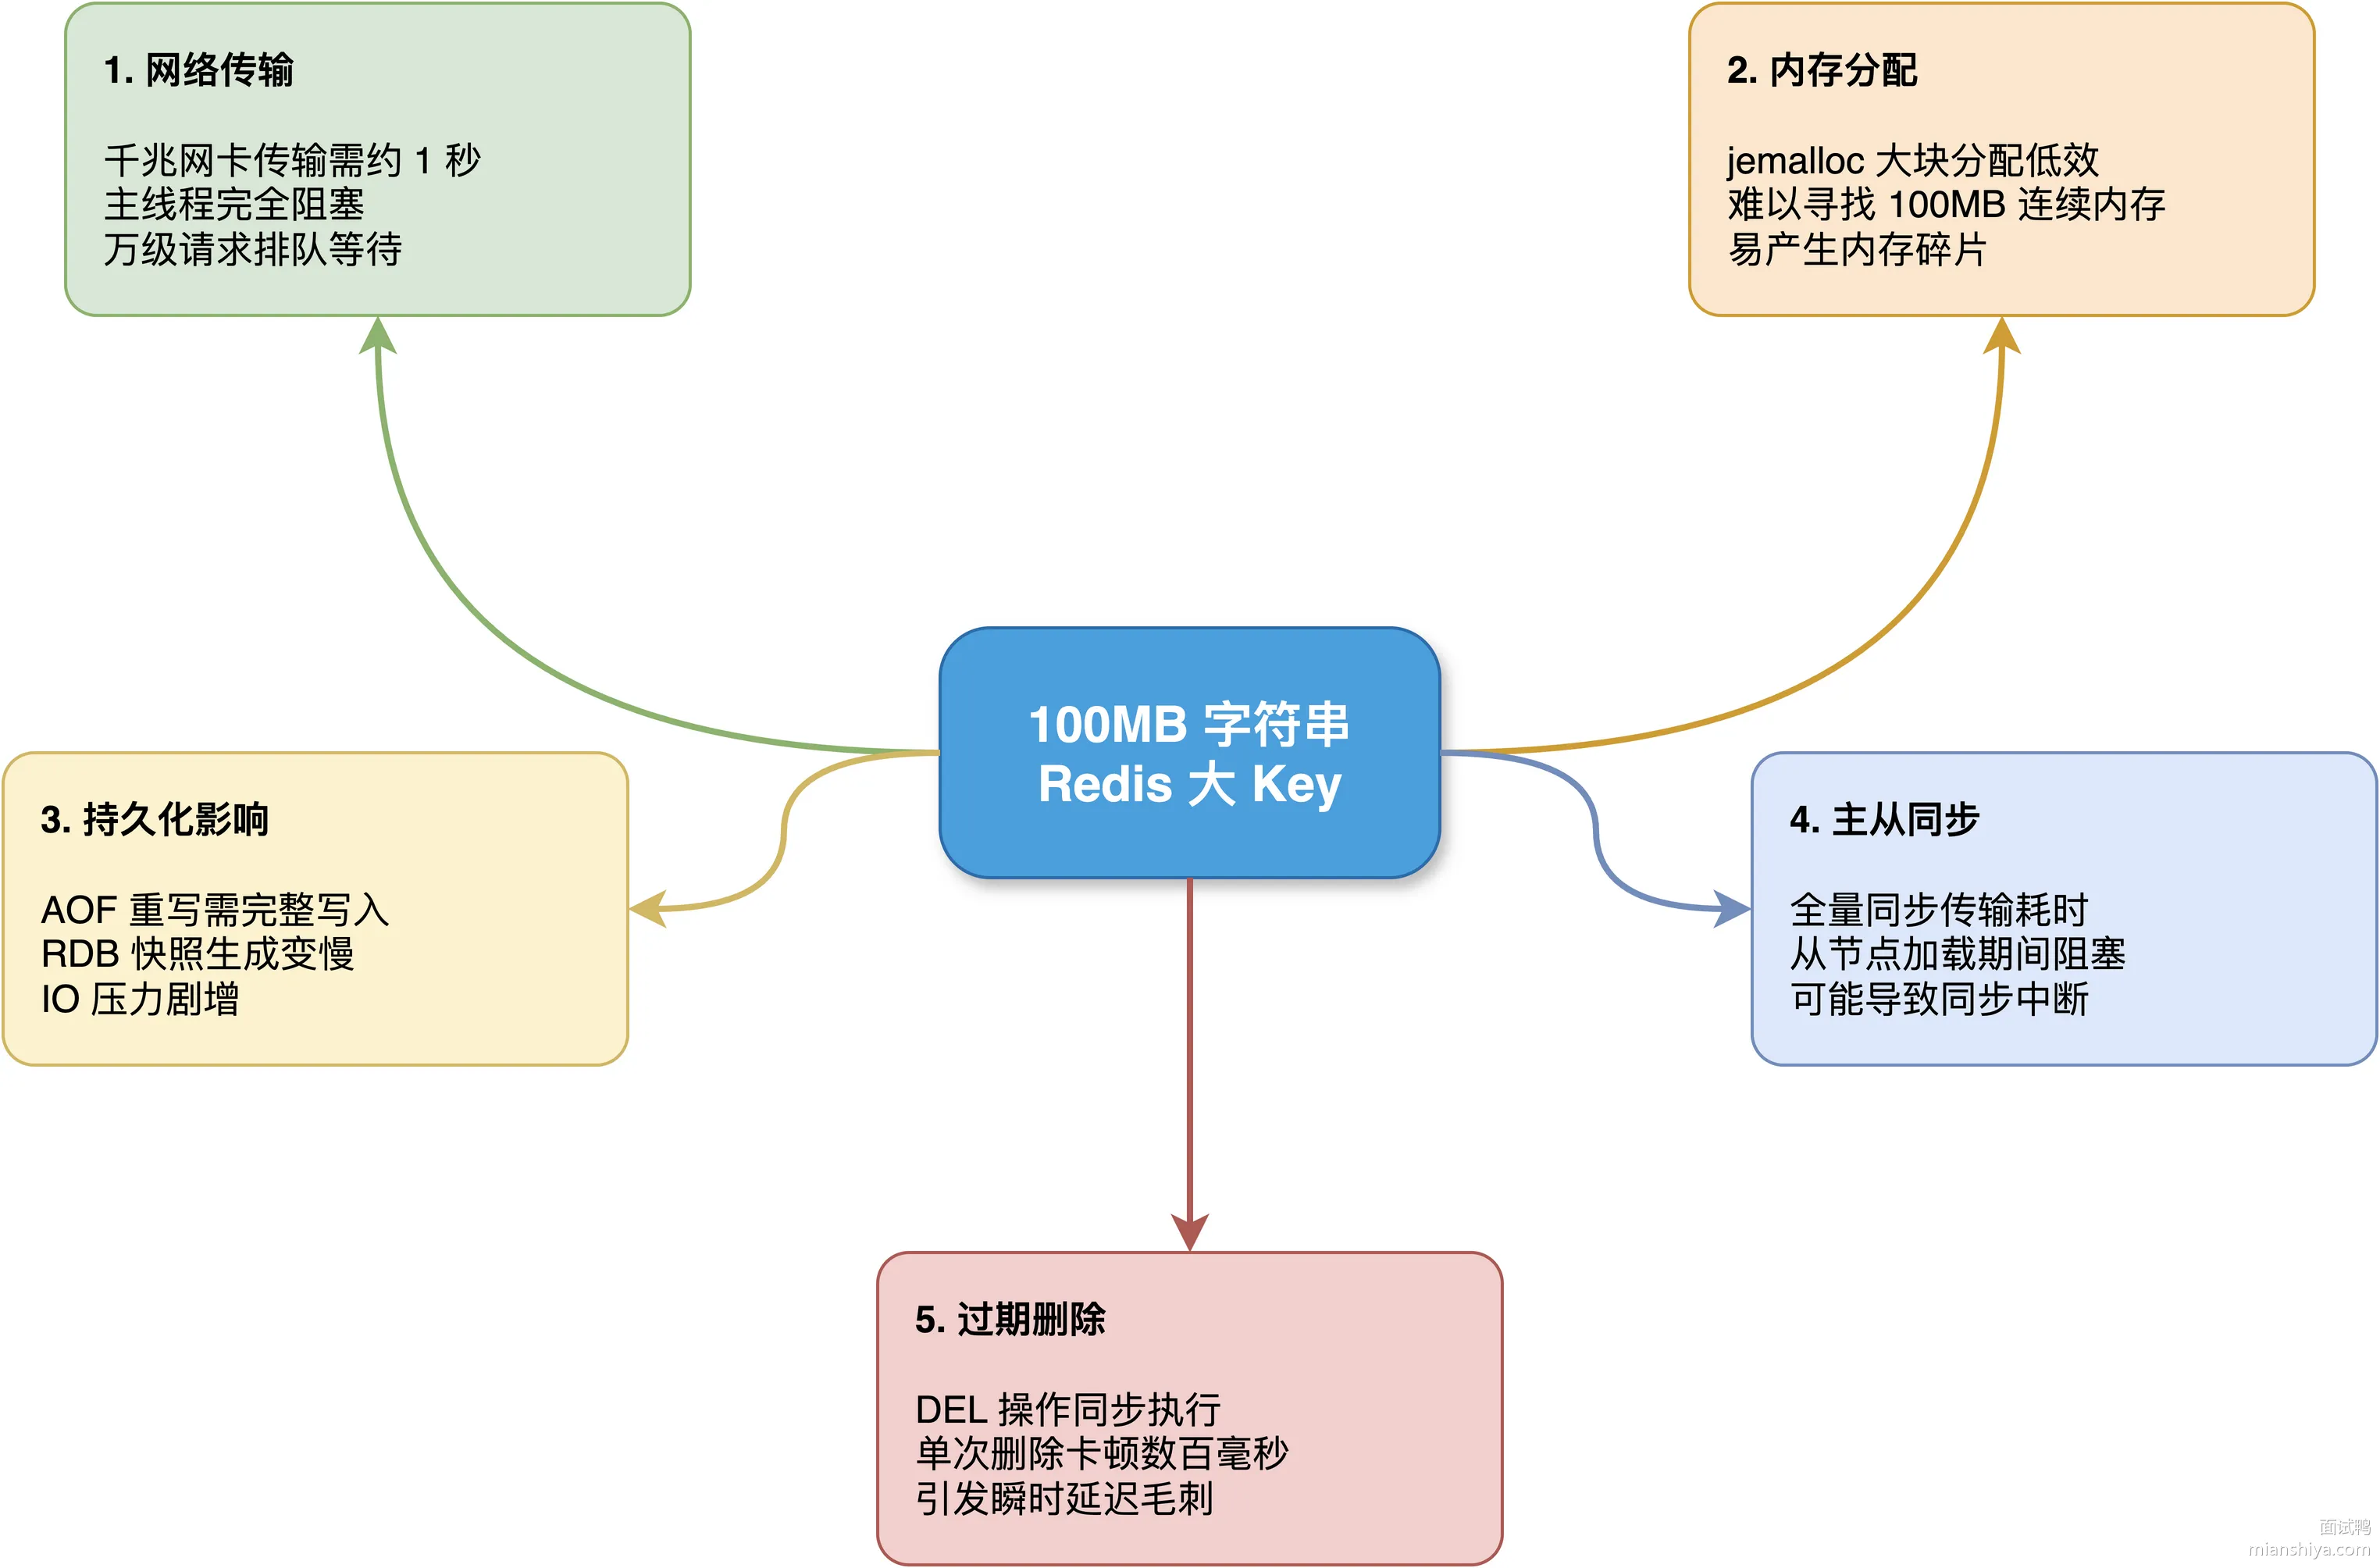
34.2.2. 大字符串的拆分方案
遇到大字符串,拆是唯一的出路:
1)分片存储:把大字符串按固定长度切成多个小字符串,用 key:0、key:1、key:2 这样的命名规则存。读的时候 MGET 一次性拿出来拼接。
public void setBigString(String key, String value, int chunkSize) {
    int chunks = (value.length() + chunkSize - 1) / chunkSize;
    Pipeline pipeline = jedis.pipelined();
    for (int i = 0; i < chunks; i++) {
        int start = i * chunkSize;
        int end = Math.min(start + chunkSize, value.length());
        pipeline.set(key + ":" + i, value.substring(start, end));
    }
    pipeline.set(key + ":chunks", String.valueOf(chunks));
    pipeline.sync();
}

public String getBigString(String key) {
    int chunks = Integer.parseInt(jedis.get(key + ":chunks"));
    List<String> keys = new ArrayList<>();
    for (int i = 0; i < chunks; i++) {
        keys.add(key + ":" + i);
    }
    List<String> values = jedis.mget(keys.toArray(new String[0]));
    return String.join("", values);
}2)压缩存储:如果是文本类数据,用 gzip 或 snappy 压缩后再存,压缩比能到 5-10 倍。
public void setCompressed(String key, String value) {
    byte[] compressed = Snappy.compress(value.getBytes(StandardCharsets.UTF_8));
    jedis.set(key.getBytes(), compressed);
}

public String getCompressed(String key) {
    byte[] compressed = jedis.get(key.getBytes());
    return new String(Snappy.uncompress(compressed), StandardCharsets.UTF_8);
}3)外部存储:真正的大文件,比如图片、文档,根本不该放 Redis。存到 OSS 或者文件系统,Redis 里只存一个 URL 或者文件路径。
34.2.3. 其他数据类型的大小限制
| 数据类型 | 单个元素大小限制 | 元素数量限制 |
|---|---|---|
| String | 512 MB | 1 个值 |
| List | 每个元素 512 MB | 2^32 - 1 个元素 |
| Set | 每个元素 512 MB | 2^32 - 1 个元素 |
| Hash | 每个 field/value 512 MB | 2^32 - 1 个 field |
| Sorted Set | 每个元素 512 MB | 2^32 - 1 个元素 |
这些都是理论上限,实际用的时候单个集合超过 1 万个元素就要警惕了。
34.2.4. 如何发现大 Key
生产环境定期扫描大 key 是必须的:
# Redis 4.0+ 内置的大 key 扫描,采样分析
redis-cli --bigkeys

# 更精确的方式,用 SCAN 遍历 + DEBUG OBJECT
redis-cli SCAN 0 COUNT 1000
redis-cli DEBUG OBJECT your_key

# Redis 4.0+ 可以用 MEMORY USAGE
redis-cli MEMORY USAGE your_key
阿里云、腾讯云这些云厂商的 Redis 服务都有大 key 分析功能,比自己扫方便多了。
34.2.5. 相关题目
34.3. 常见问题
34.3.1. 为什么是 512 MB 而不是 1 GB 或者 256 MB?
512 MB 是个经验值,够大到覆盖 99.99% 的正常使用场景,又不至于让单个 key 大到严重影响性能。早期 Redis 版本这个值更小,后来随着硬件发展调到了 512 MB。这个值在 sds.h 源码里定义的,改起来很简单,但官方认为没必要再大了。
34.3.2. 大 key 删除会阻塞 Redis,有什么办法解决?
详细解答可以看:Redis 中的 Big Key 问题是什么?如何解决?
Redis 4.0 引入了 UNLINK 命令,异步删除。执行 UNLINK 的时候,Redis 只是把 key 从键空间摘掉,实际内存释放交给后台线程慢慢做。对于 List、Set、Hash 这些集合类型,还可以分批删除,比如每次 LPOP 1000 个元素,循环删。开启 lazyfree-lazy-expire 配置,过期 key 也能异步删除。
34.3.3. 我看有些公司用 Redis 存图片,这样做合理吗?
扩展可以看:Redis 通常应用于哪些场景?
绝大多数情况下不合理。图片动辄几百 KB 甚至几 MB,放 Redis 里浪费内存、拖慢性能。正确做法是图片存 OSS 或者 CDN,Redis 里只存图片 URL。除非是特别小的图标,几 KB 的那种,而且访问频率极高,才考虑 Base64 编码后存 Redis,但这种场景很少见。
34.3.4. 512 MB 的限制能突破吗?
源码改一下就能突破,但没意义。真要存这么大的数据,Redis 本身就不是合适的选择。这种场景应该用 HBase、MongoDB 或者干脆用文件存储。Redis 的定位就是快速的内存数据结构服务器,不是大对象存储。
35. Redis 性能瓶颈时如何处理?
35.1. 核心要点
Redis 性能瓶颈的处理核心就是分摊压力,从单机到集群逐级递进。
1)垂直扩容:先看单机资源有没有用满,内存不够就加内存,CPU 频率能提就提。一台 64GB 内存的机器跑 Redis,能撑住大部分中小业务。
2)读写分离:写请求还是走主节点,但把读请求分流到从节点。一主三从的架构,读 QPS 直接翻 3 倍。适合读多写少的场景,比如商品详情页、用户信息查询这种。
3)Redis Cluster 分片:数据量超过单机内 存上限,或者写请求压力太大,就得上分片集群。16384 个槽位分散到多个主节点,写压力也能横向扩展。
4)多级缓存:在应用层加一层本地缓存,Caffeine 或者 Guava Cache 都行,把热点数据兜在本地,压根不走网络。像秒杀场景,库存这种热 key 必须本地缓存顶着。
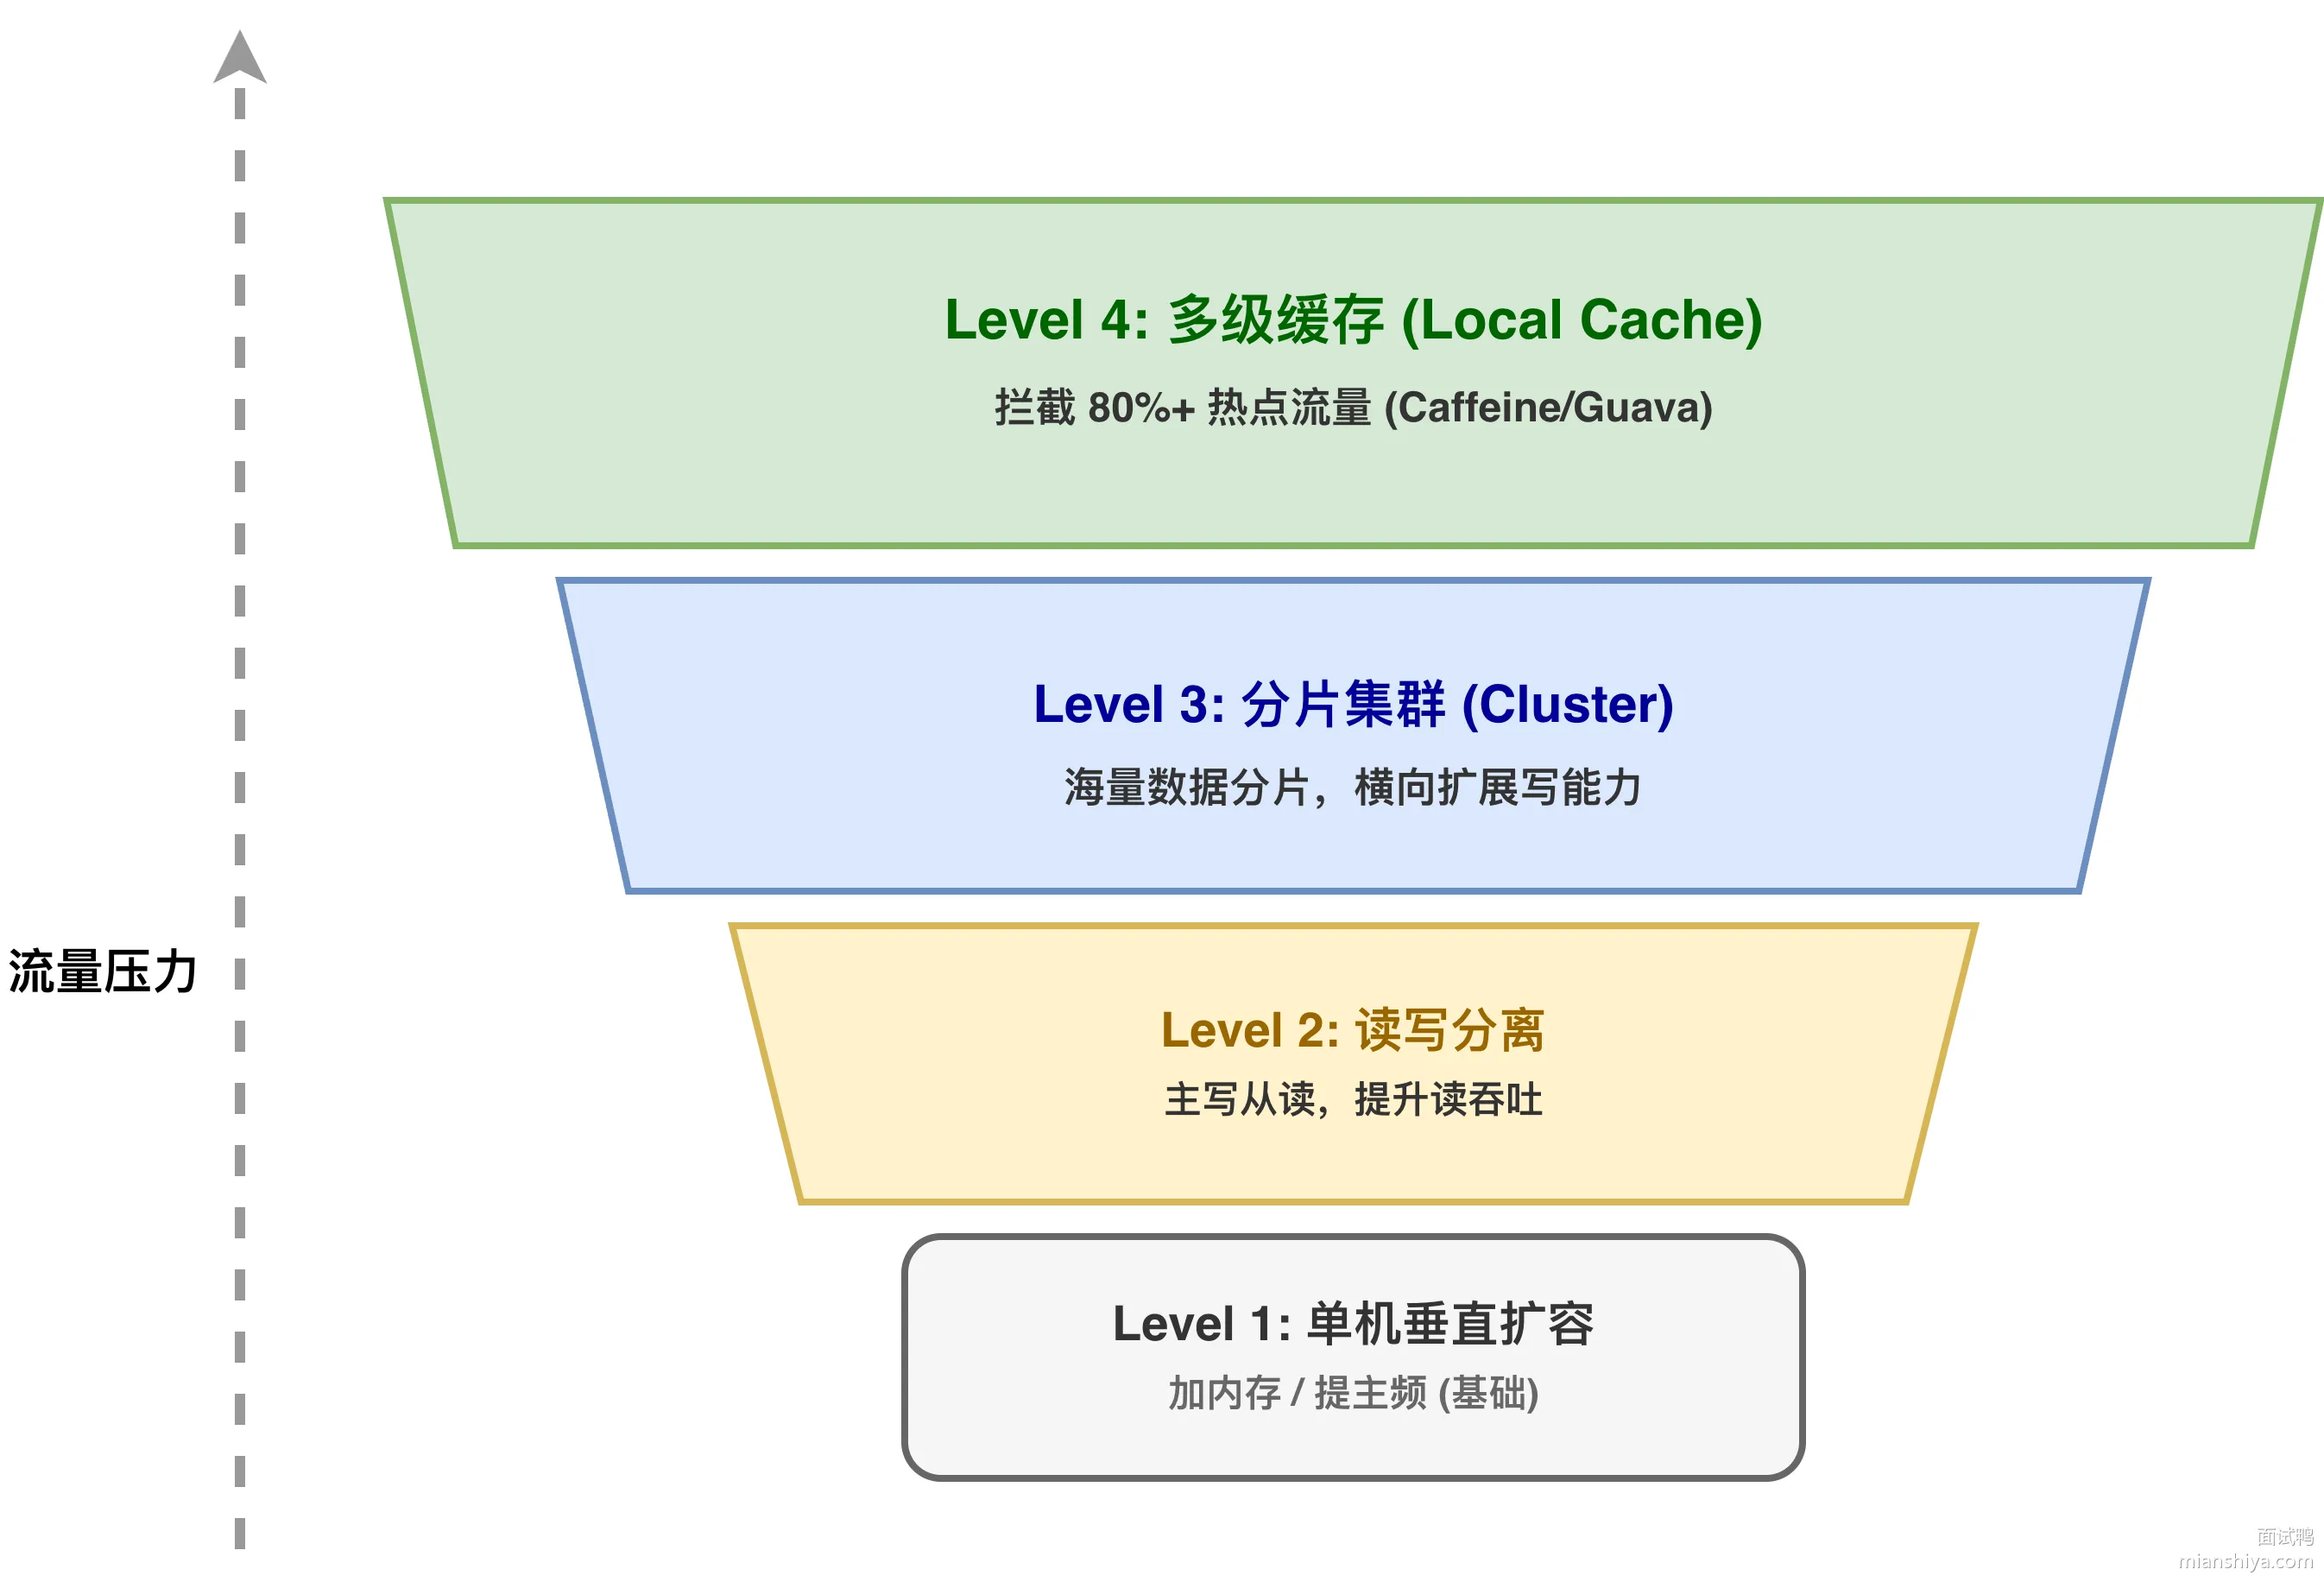
实际项目中,这几种方案往往是组合使用。比如电商大促,既要 Redis Cluster 分片存储,又要本地缓存挡热点,再加上主从读写分离,才能扛住几十万 QPS。
35.2. 扩展知识
35.2.1. 性能瓶颈的定位
处理瓶颈之前,得先知道瓶颈在哪。Redis 自带的监控命令就很好用:
# 查看实时性能指标
redis-cli info stats

# 慢查询日志,超过 10ms 的命令都记下来
config set slowlog-log-slower-than 10000
slowlog get 10

# 内存分析
memory doctor
memory stats
常见的瓶颈点:
1)内存不足:used_memory 超过 maxmemory,开始频繁淘汰数据,响应时间飙升。
2)CPU 打满:大 key 操作或者复杂命令把 CPU 吃满,其他请求只能排队等着。比如对一个百万元素的 Set 执行 SMEMBERS,单次操作就能卡住几秒。
3)网络带宽:单机网卡就那么大吞吐,数据量一大,网络先成瓶颈。
4)持久化阻塞:AOF 重写或者 RDB 快照的时候,fork 子进程会拷贝页表,内存越大 fork 越慢,这段时间主线程是卡死的。32GB 内存的实例,fork 可能要卡个几百毫秒。
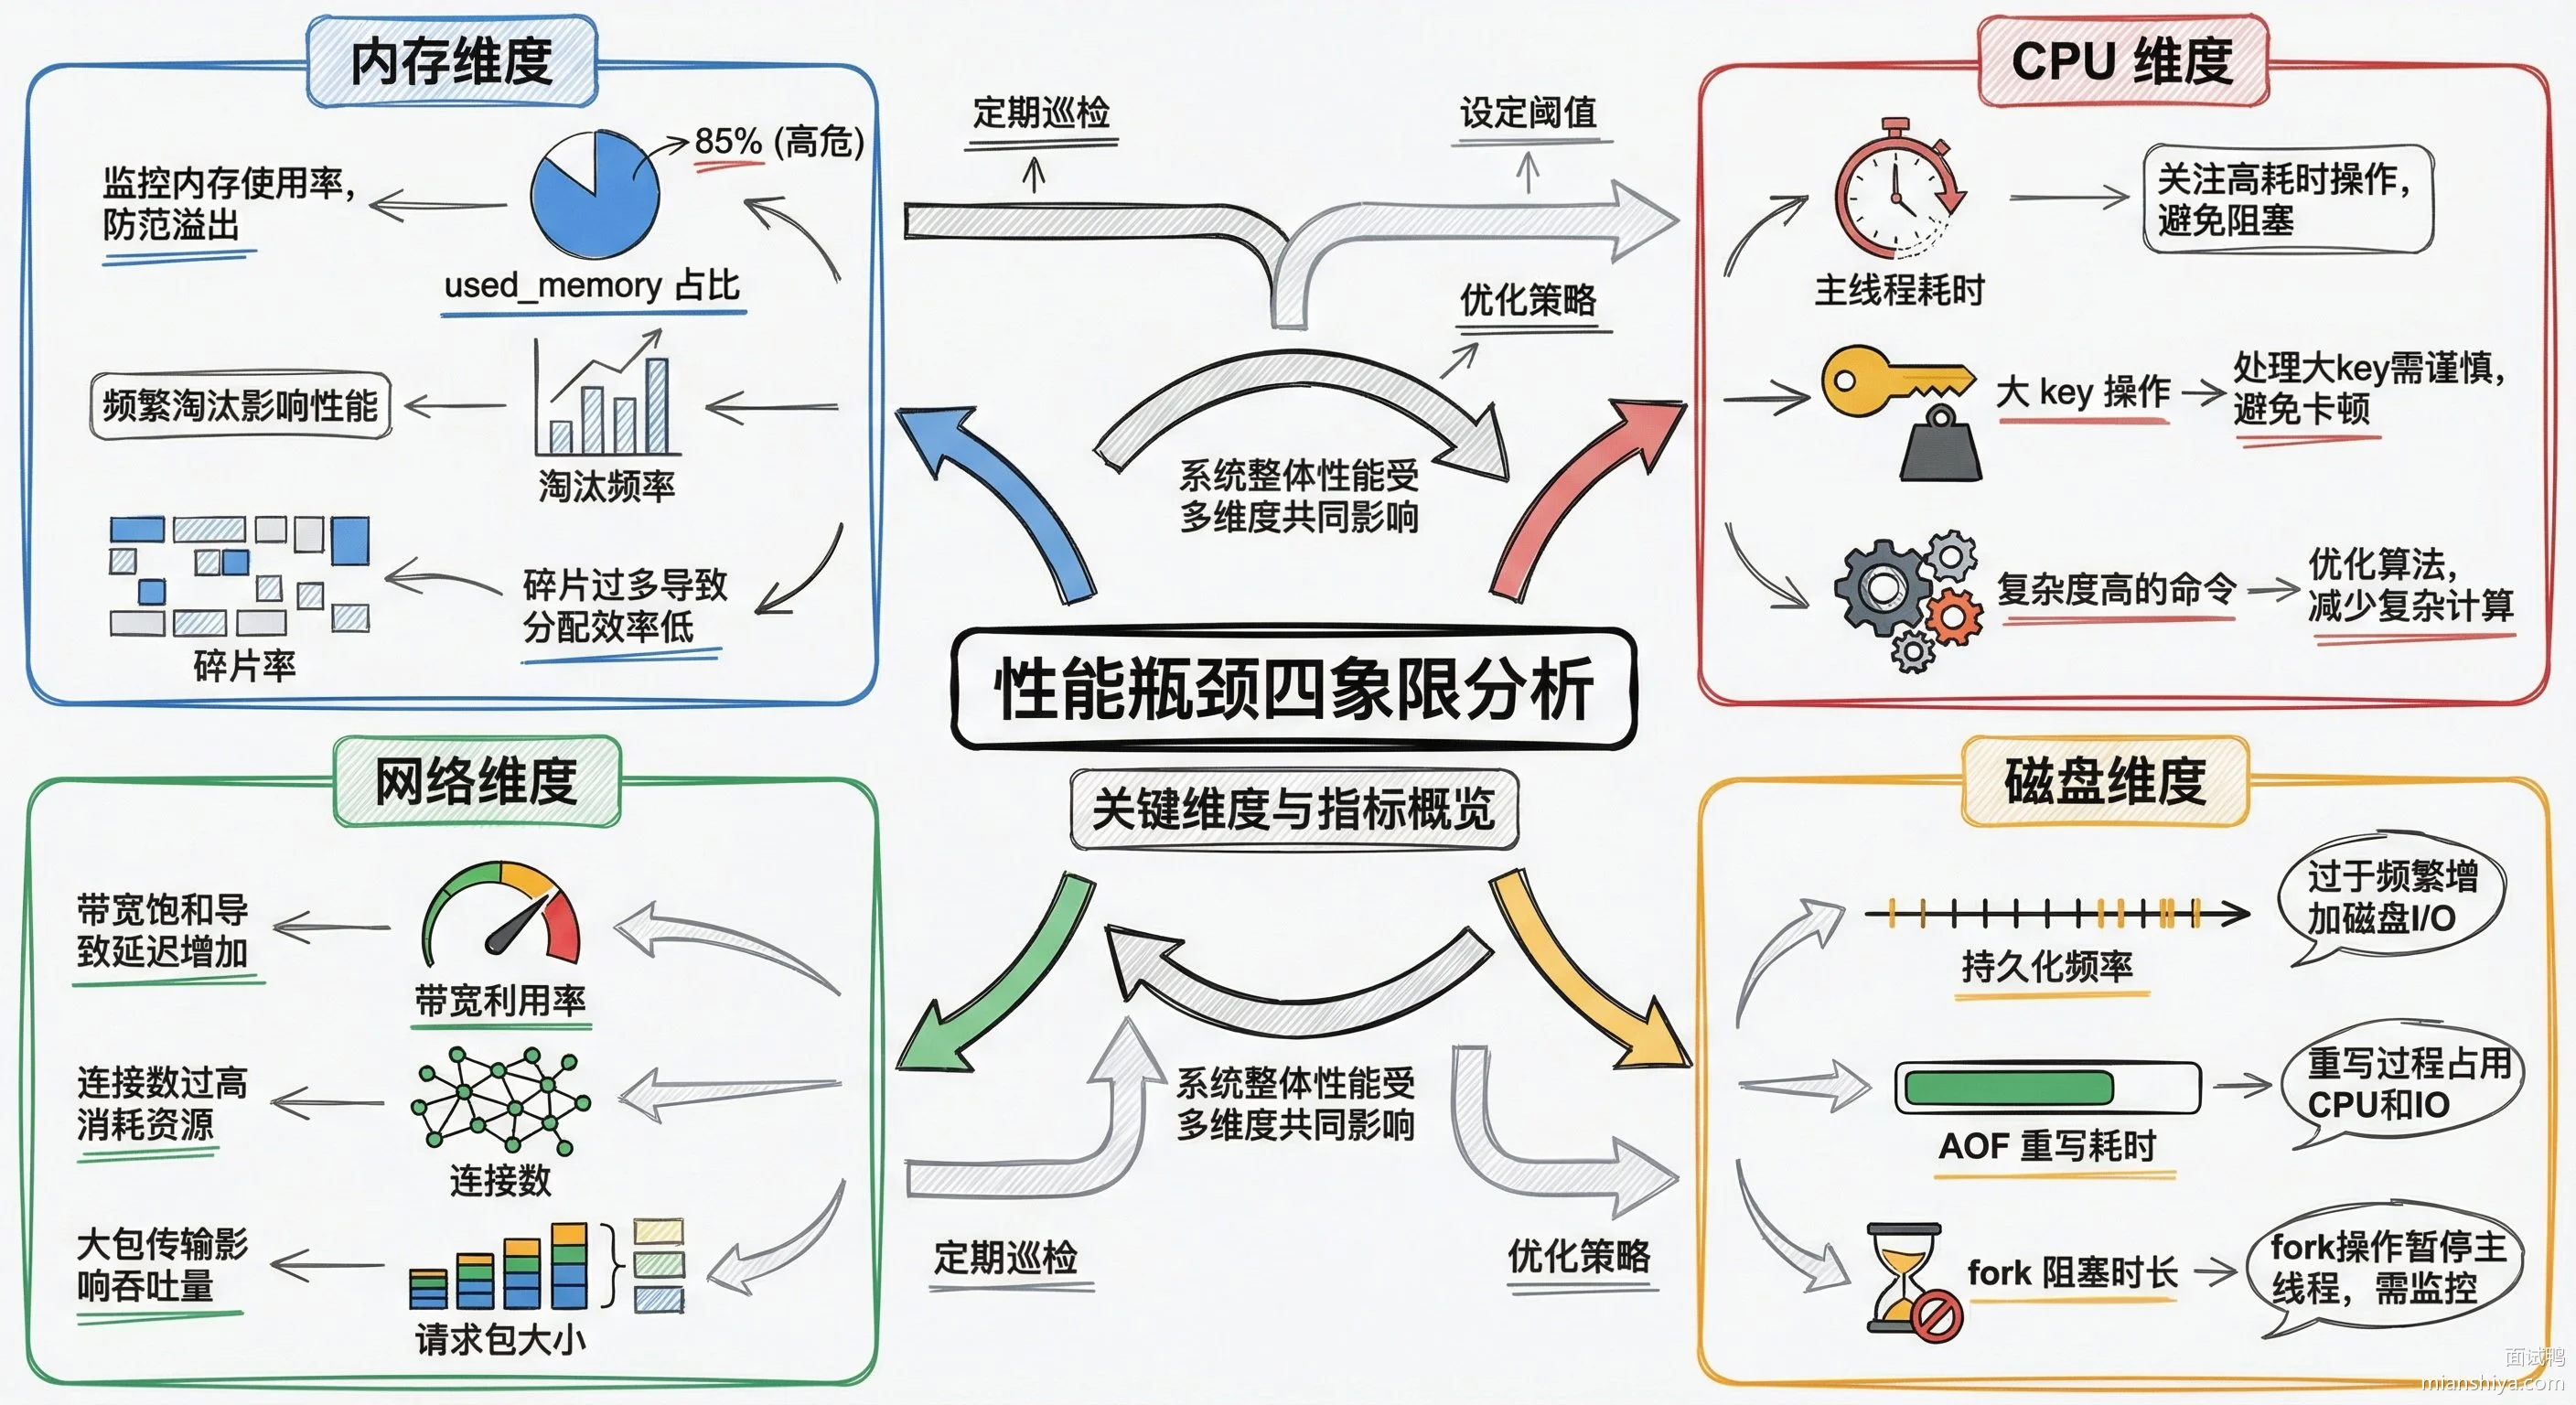
35.2.2. 主从复制和读写分离
通过配置 Redis 主从复制,可以实现读写分离,将写操作交给主节点进行处理,而读操作可以交给从节点,从而减轻主节点的压力。
主从架构的优势在于可以横向扩展读取能力,但是存在主从同步延迟的问题,如果从节点落后较多,可能会出现读取旧数据的情况。
一些优化手段:
1)合理控制从节点数量:一主三从基本够用,从节点太多,主节点同步压力也大。
2)配置 replica-serve-stale-data:设成 no,从节点同步落后时拒绝读请求,避免读到脏数据。
3)监控主从延迟:通过 info replication 看 master_repl_offset 和 slave_repl_offset 的差值,差太多就告警。
35.2.3. Redis 集群
35.2.4. 多级缓存架构
本地缓存 + Redis 的组合,是应对极端流量的标配方案。
@Service
public class ProductService {

    // 本地缓存,最多 1 万条,10 秒过期
    private final Cache<Long, Product> localCache = Caffeine.newBuilder()
            .maximumSize(10_000)
            .expireAfterWrite(10, TimeUnit.SECONDS)
            .build();

    @Autowired
    private RedisTemplate<String, Product> redisTemplate;

    public Product getProduct(Long productId) {
        // 先查本地缓存
        Product product = localCache.getIfPresent(productId);
        if (product != null) {
            return product;
        }

        // 本地没有,查 Redis
        String key = "product:" + productId;
        product = redisTemplate.opsForValue().get(key);
        if (product != null) {
            localCache.put(productId, product);
            return product;
        }

        // Redis 也没有,查数据库
        product = loadFromDB(productId);
        if (product != null) {
            redisTemplate.opsForValue().set(key, product, 1, TimeUnit.HOURS);
            localCache.put(productId, product);
        }
        return product;
    }
}
本地缓存过期时间要短,一般 5-30 秒,避免数据不一致窗口太长。Redis 缓存可以长一点,小时级别都行。
35.3. 常见问题
35.3.1. 本地缓存和 Redis 的数据不一致怎么处理?
本地缓存过期时间设短,控制在秒级别,不一致窗口就很小。如果业务对一致性要求高,可以用 Redis 的发布订阅或者消息队列,数据变更时广播给所有实例清掉本地缓存。像 JetCache 这类框架就内置了这种机制。
35.3.2. Redis Cluster 扩容的时候,怎么保证业务不中断?
Cluster 支持在线扩容,新节点加进来之后,用 reshard 命令把一部分槽位迁移过去。迁移过程中,如果客户端访问到正在迁移的 key,会收到 ASK 重定向,客户端跟着重定向走就行。整个过程对业务透明,不需要停服务。
35.3.3. fork 导致的卡顿怎么优化?
几个方向。一是控制单实例内存大小,不要超过 10GB,内存越小 fork 越快。二是用 Redis 4.0 以后的混合持久化,RDB 做全量,AOF 增量,减少完整 RDB 的频率。三是把持久化放到从节点做,主节点关掉 RDB 和 AOF,让从节点扛这个活。
36. Redis 中 EMBSTR 对象的阈值设置为何为 44?其调整历史是什么?
36.1. 核心要点
44 字节这个阈值是被内存分配器的分配单元给定死的。
Redis 用的是 jemalloc,最小分配单元是 64 字节,超过 64 字节就得分配更大的块,所以 Redis 要把 EMBSTR 编码的字符串塞进 64 字节里。
64 字节怎么分配的:
- redisObject 结构体占 16 字节:type 占 4 位,encoding 占 4 位,lru 占 24 位,refcount 占 32 位,ptr 指针占 64 位,加起来 128 位就是 16 字节。
- sdshdr8 结构体占 3 字节:len 占 1 字节记录已使用长度,alloc 占 1 字节记录分配长度,flags 占 1 字节标记类型。
- 字符串末尾的 '\0' 占 1 字节。
- 剩下的就是 64 - 16 - 3 - 1 = 44 字节,刚好能存 44 个字符。
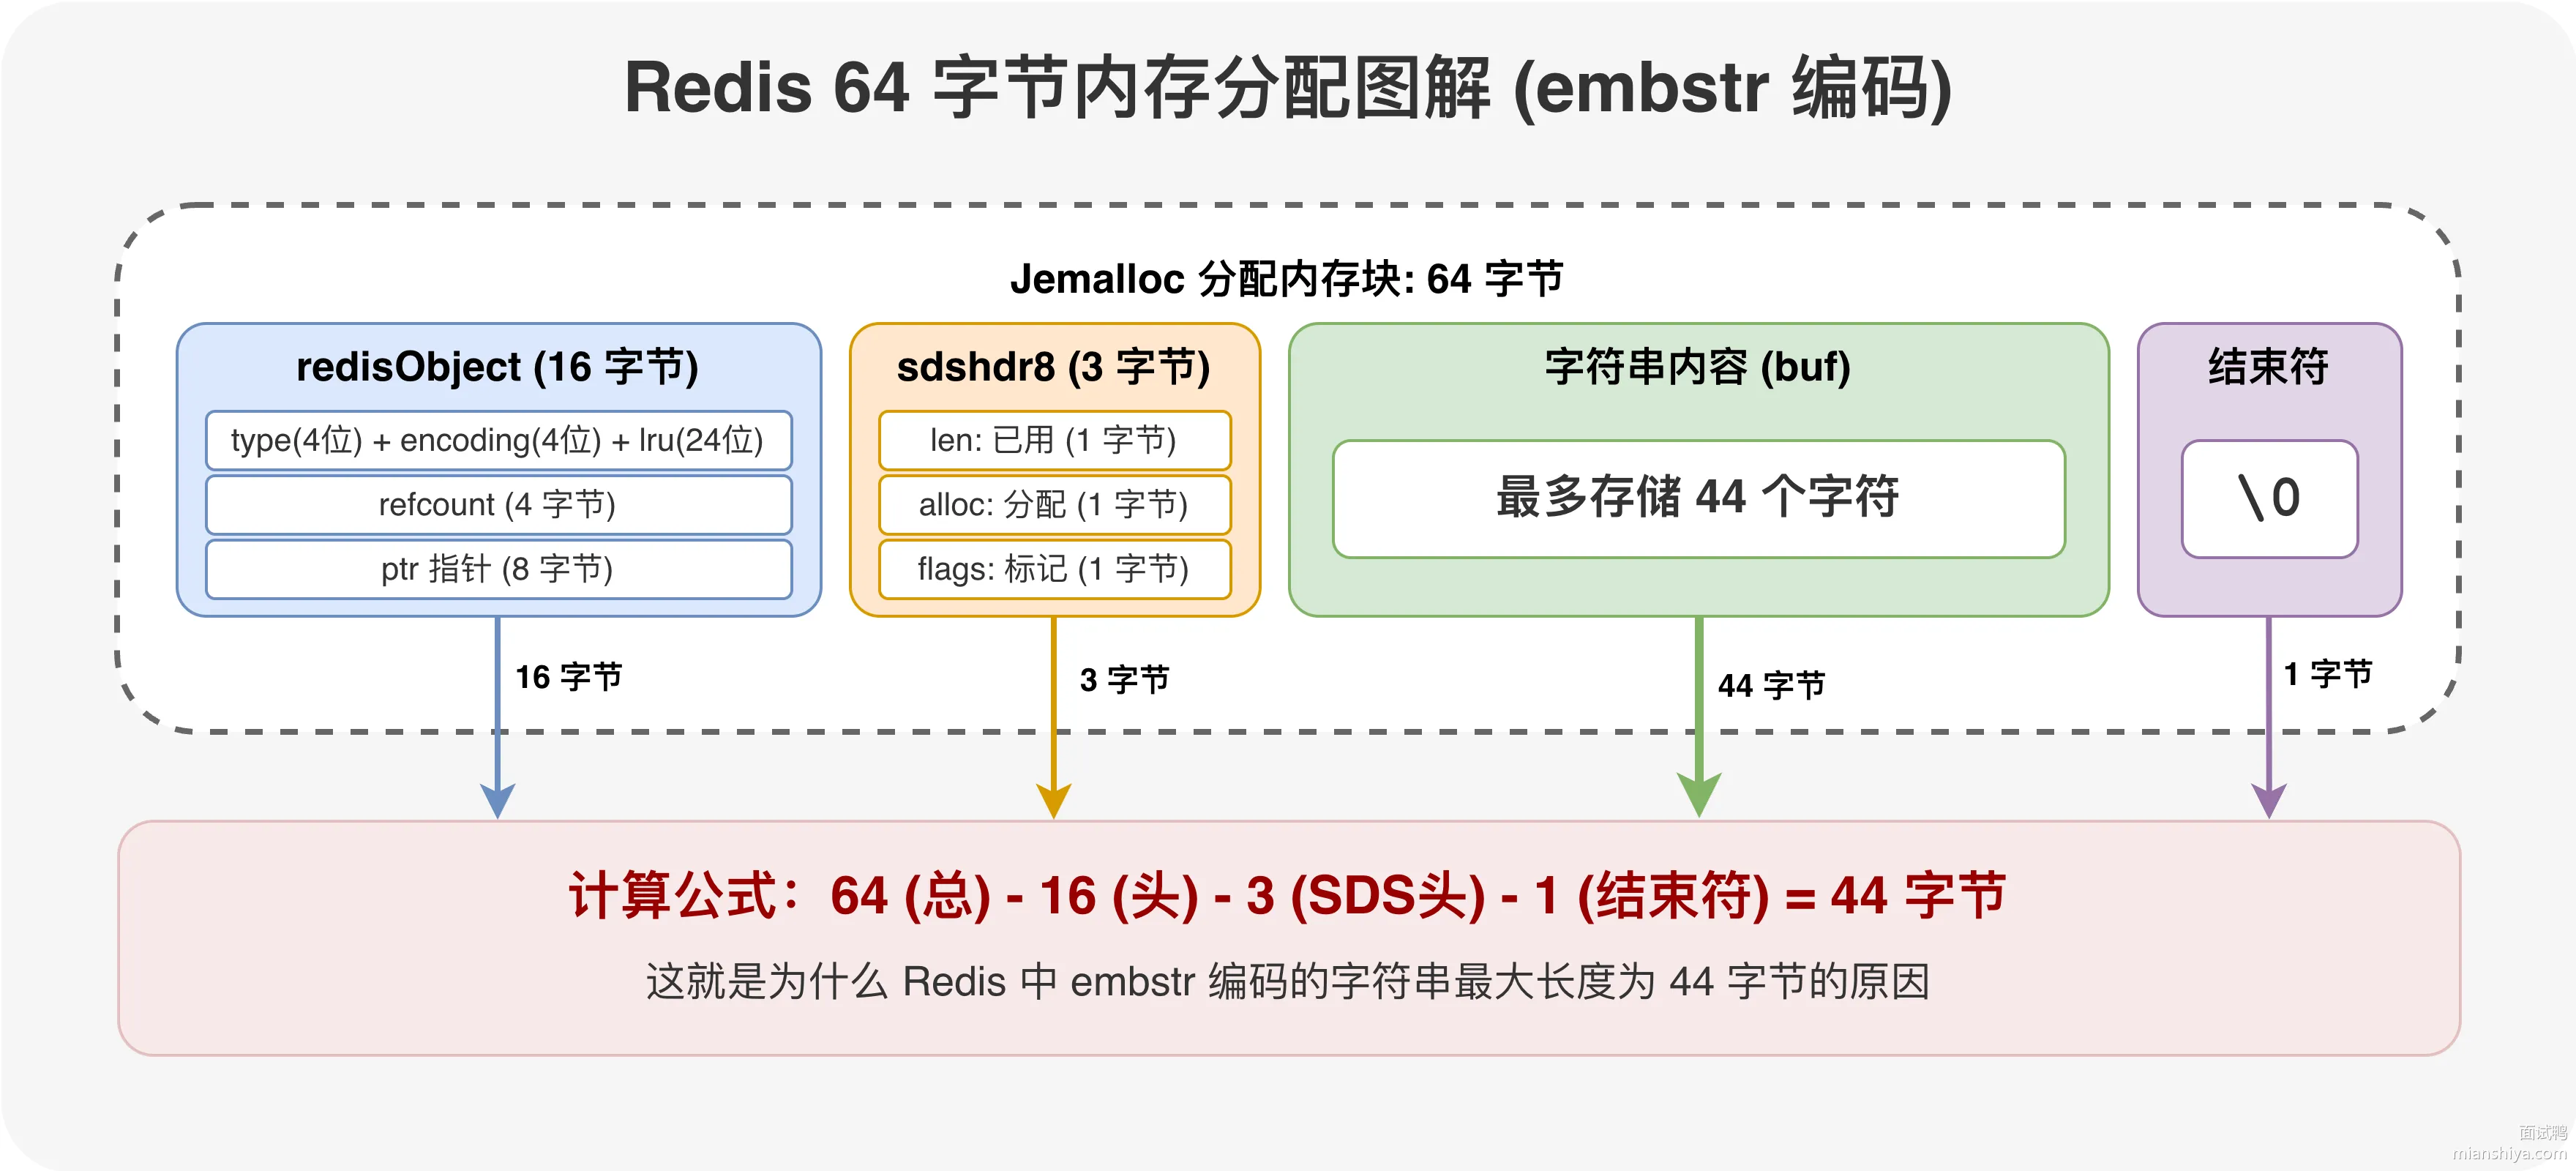
EMBSTR 编码的好处是 redisObject 和 sds 在一块连续内存里,创建和释放都只需要一次内存操作,对 CPU 缓存也更友好。超过 44 字节就得用 RAW 编码,redisObject 和 sds 分开存,ptr 指针指向另一块内存。
// redisObject 结构,占 16 字节
typedef struct redisObject {
    unsigned type:4;        // 4 bits
    unsigned encoding:4;    // 4 bits
    unsigned lru:24;        // 24 bits,LRU 时间或 LFU 计数
    int refcount;           // 32 bits,引用计数
    void *ptr;              // 64 bits,指向实际数据
} robj;

// sdshdr8 结构,占 3 字节
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len;           // 1 byte,已使用长度
    uint8_t alloc;         // 1 byte,分配长度
    unsigned char flags;   // 1 byte,类型标记
    char buf[];            // 柔性数组,实际存数据
};
36.2. 扩展知识
36.2.1. 为什么 3.2 之前阈值是 39
3.2 版本之前,sds 的结构不一样:
// Redis 3.2 之前的 sds 结构
struct sdshdr {
    unsigned int len;      // 4 bytes,已使用长度
    unsigned int free;     // 4 bytes,剩余可用空间
    char buf[];            // 柔性数组
};
老版本的 sdshdr 光头部就占了 8 字节,比新版本的 sdshdr8 多了 5 字节。算下来:64 - 16 - 8 - 1 = 39 字节。
3.2 版本引入了 sdshdr8、sdshdr16、sdshdr32、sdshdr64 四种结构,根据字符串长度选用不同的头部。短字符串用 sdshdr8,头部只要 3 字节,长字符串才用 sdshdr32 或 sdshdr64。这样短字符串能多存 5 个字节的数据。
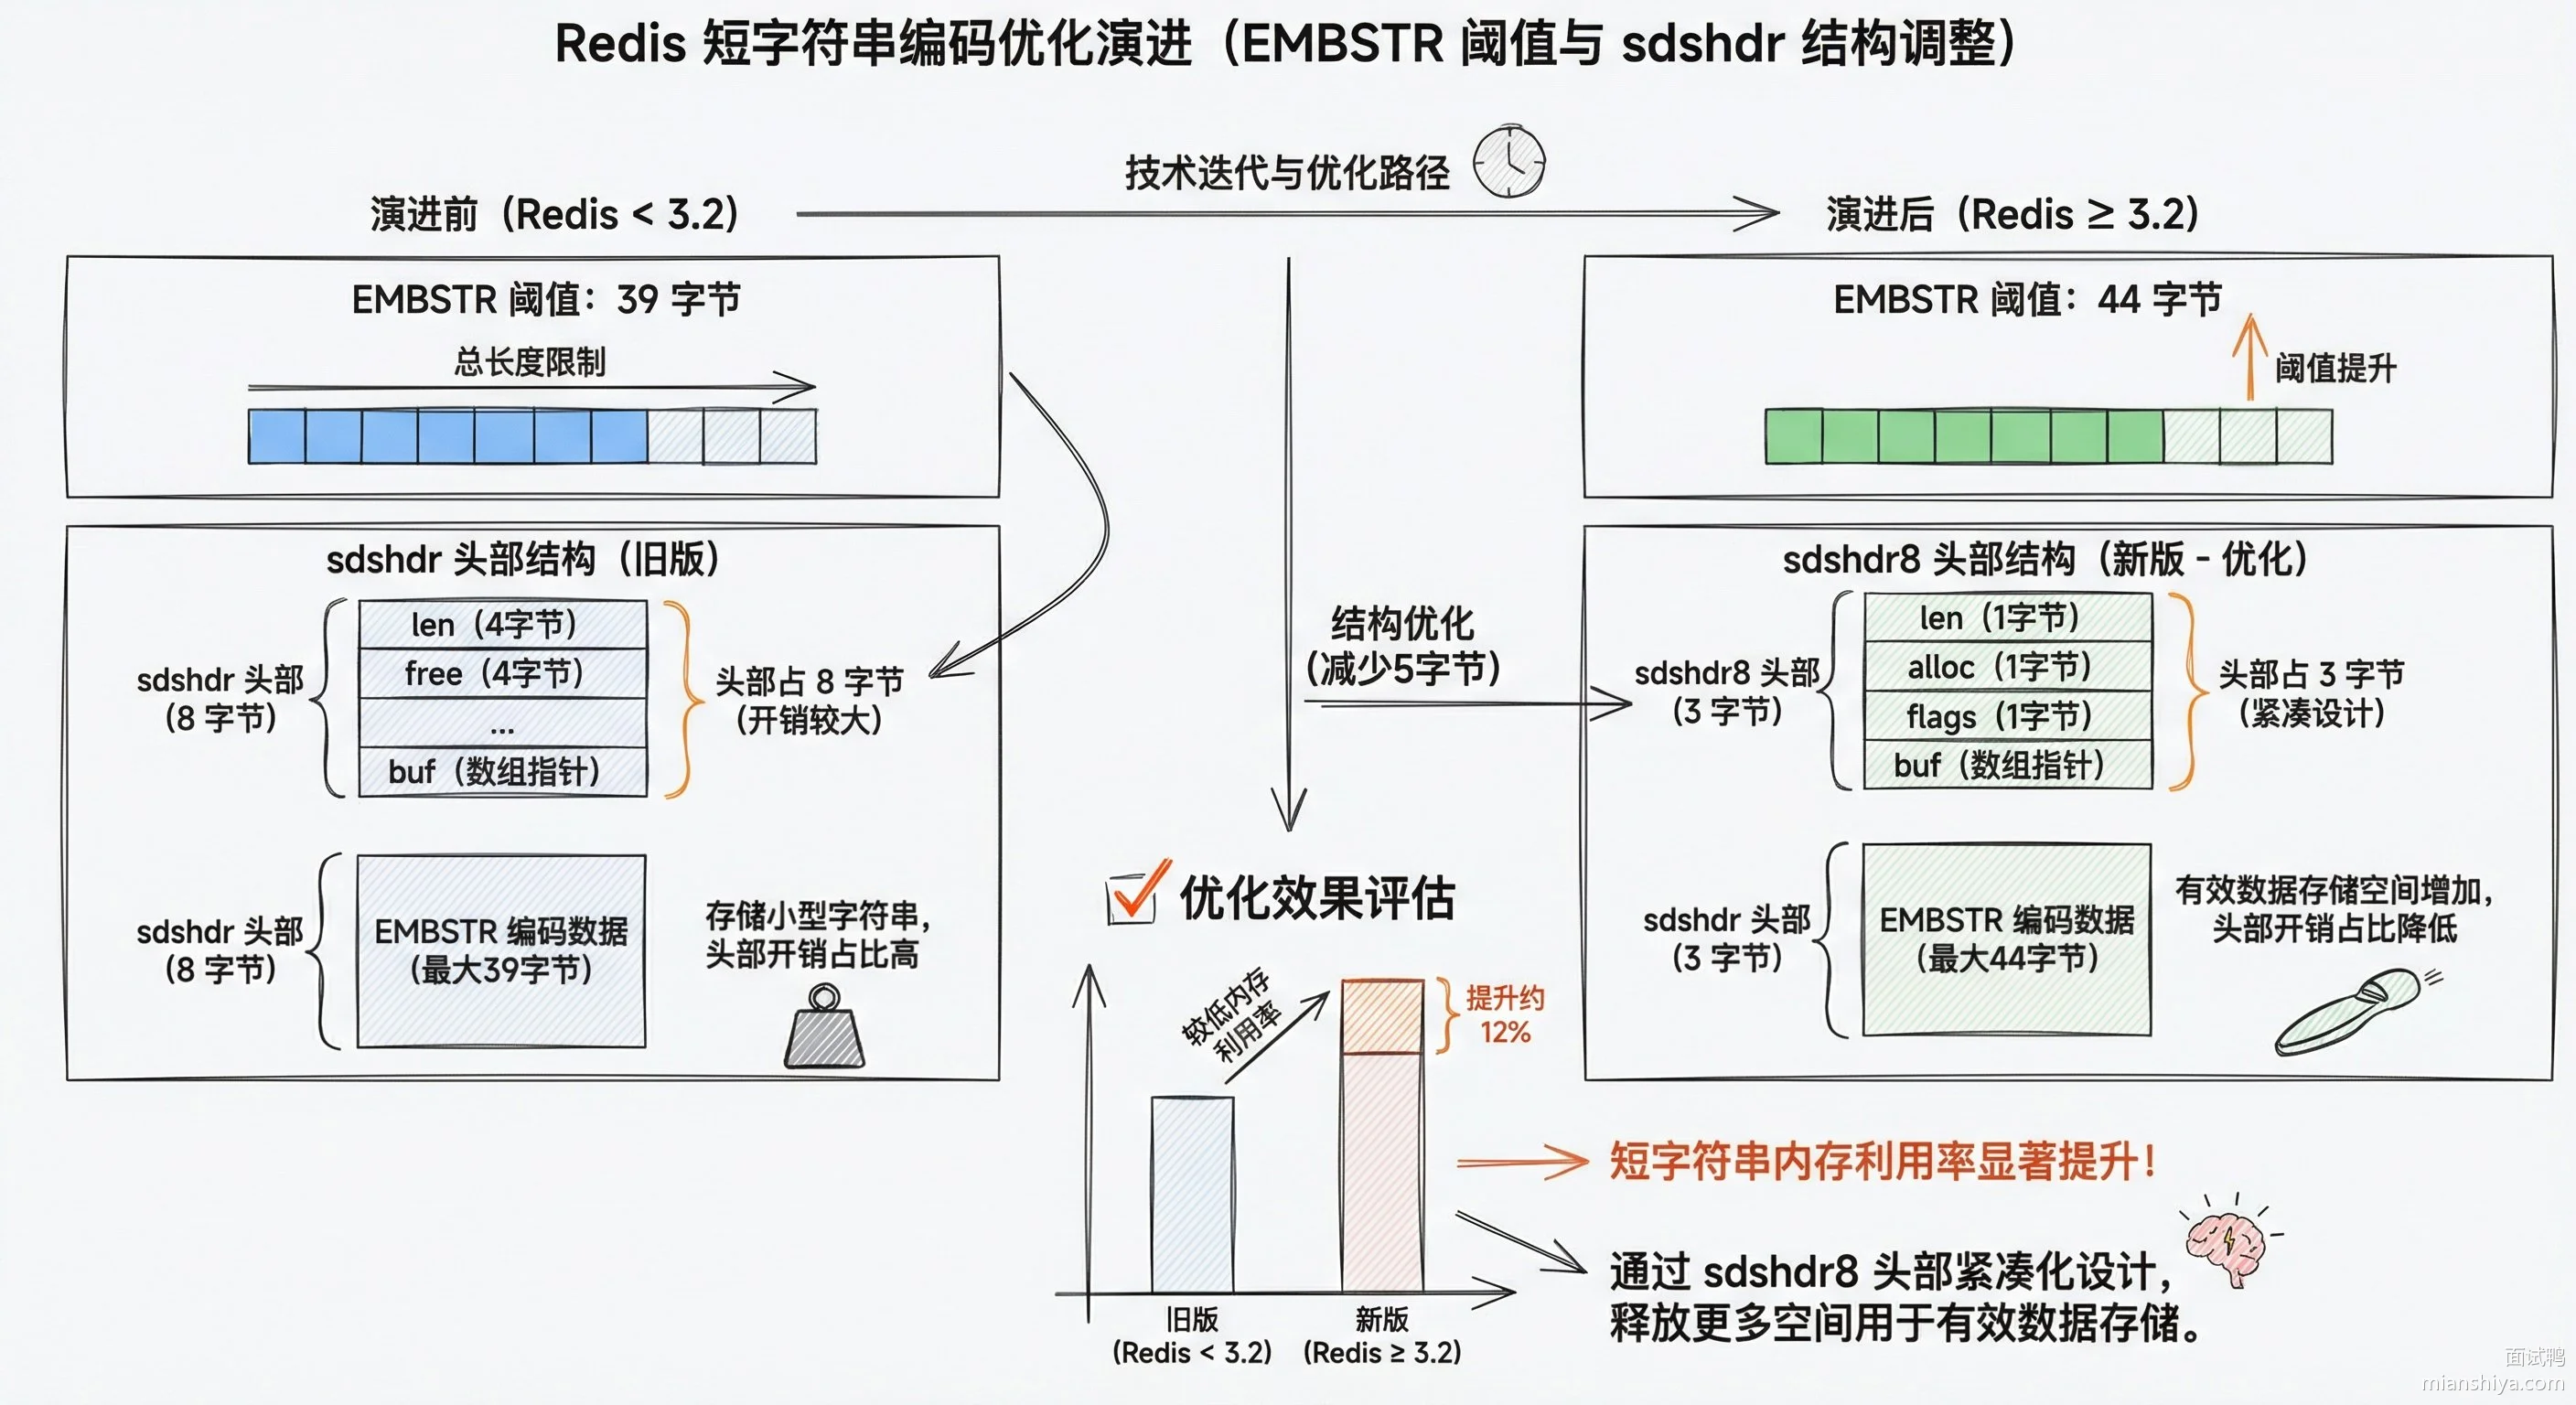
36.2.2. jemalloc 的内存分配策略
jemalloc 的分配策略是按 size class 分级的,常见的 size class:8、16、32、48、64、80、96、128...
64 字节是一个关键分界点。申请 64 字节以内的内存,jemalloc 直接给你一个 64 字节的块;申请 65 字节,就得给 80 字节的块,浪费 15 字节。
Redis 把 EMBSTR 卡在 64 字节,就是为了最大化利用这个最小分配单元,不浪费一个字节。
36.2.3. EMBSTR 和 RAW 的区别
| 特性 | EMBSTR | RAW |
|---|---|---|
| 内存布局 | redisObject 和 sds 连续存储 | redisObject 和 sds 分开存储 |
| 内存分配 | 一次 malloc | 两次 malloc |
| 内存释放 | 一次 free | 两次 free |
| 字符串长度 | ≤44 字节 | >44 字节 |
| 缓存友好性 | 高,数据在一块 | 低,需要跳转指针 |
| 修改操作 | 任何修改都转成 RAW | 可以原地修改 |
EMBSTR 有个特点:只读。只要对 EMBSTR 编码的字符串做任何修改操作,比如 APPEND、SETRANGE,Redis 都会先把它转成 RAW 编码再修改。因为 EMBSTR 的内存是一次性分配的,没法动态扩展。
127.0.0.1:6379> SET name "hello"
OK
127.0.0.1:6379> OBJECT ENCODING name
"embstr"
127.0.0.1:6379> APPEND name " world"
(integer) 11
127.0.0.1:6379> OBJECT ENCODING name
"raw"
36.2.4. 补充:INT 编码
字符串还有一种 INT 编码,当字符串内容是 long 范围内的整数时,直接把整数值存在 ptr 指针里,连 sds 都省了。
127.0.0.1:6379> SET counter 12345
OK
127.0.0.1:6379> OBJECT ENCODING counter
"int"
Redis 还会复用 0-9999 这一万个整数对象,类似 Java 的整数缓存池,进一步节省内存。
36.3. 常见问题
36.3.1. 既然 EMBSTR 是只读的,那为什么不直接用 RAW?
EMBSTR 的优势在于读性能和内存效率。一次内存分配、连续存储意味着 CPU 缓存命中率更高,读取速度更快。绝大多数短字符串在实际业务中都是读多写少的,比如用户昵称、配置项、Token,几乎不会被修改。就算偶尔要改,转一次 RAW 的开销也可以接受。
36.3.2. 如果我存了一个刚好 44 字节的字符串,然后 APPEND 一个字符,会发生什么?
首先 EMBSTR 转成 RAW,分配新的 sds 内存存 45 字节的内容。ptr 指针从指向自己后面变成指向新分配的内存块。原来 64 字节的连续内存会被释放,变成两块独立内存:redisObject 一块,sds 一块。
36.3.3. Redis 7.0 有没有改这个阈值?
没有,还是 44 字节。这个阈值跟 jemalloc 的 64 字节分配单元绑定,除非换内存分配器或者改 redisObject 结构,否则不会变。Redis 7.0 的优化方向主要在多线程 IO 和 Function 这些功能上,底层编码结构没动。
36.3.4. 你说 jemalloc 按 size class 分配,那如果我用的是 glibc malloc 呢?
glibc 的 ptmalloc2 分配策略不一样,小对象分配粒度更细。但 Redis 官方推荐用 jemalloc,编译时默认就是 jemalloc。如果强行换成 glibc malloc,内存碎片会更严重,而且 44 字节这个阈值也不会变,因为它是 Redis 源码里写死的,跟实际用哪个分配器没关系。
37. Redis 中原生批处理命令(MSET、MGET)与 Pipeline 的区别是什么?
37.1. 核心要点
MSET、MGET 是 Redis 内置的原子性批处理命令,一条命令搞定多个 key 的读写;Pipeline 是客户端层面的批量发送机制,把一堆命令打包发出去,让 Redis 挨个执行再一次性返回结果。
两者最大的区别在于原子性和适用范围:
1)MSET/MGET 在 Redis 服务端是单条命令执行,天然原子,中间不会插入其他命令。但只能干"批量读"或"批量写"这一件事,想混着用 SET、INCR、LPUSH 就没戏了。
2)Pipeline 就灵活多了,什么命令都能往里塞,SET、GET、HSET、ZADD 随便组合。但它本质上是多条独立命令,Redis 只是帮你省了网络往返,执行过程中完全可能被其他客户端的命令插队。
3)网络开销上两者都是一次往返,但 MSET/MGET 在服务端只有一次命令解析开销,Pipeline 有 N 次。数据量不大的时候差别可以忽略,几万条命令往上 Pipeline 的解析成本就能感知到了。
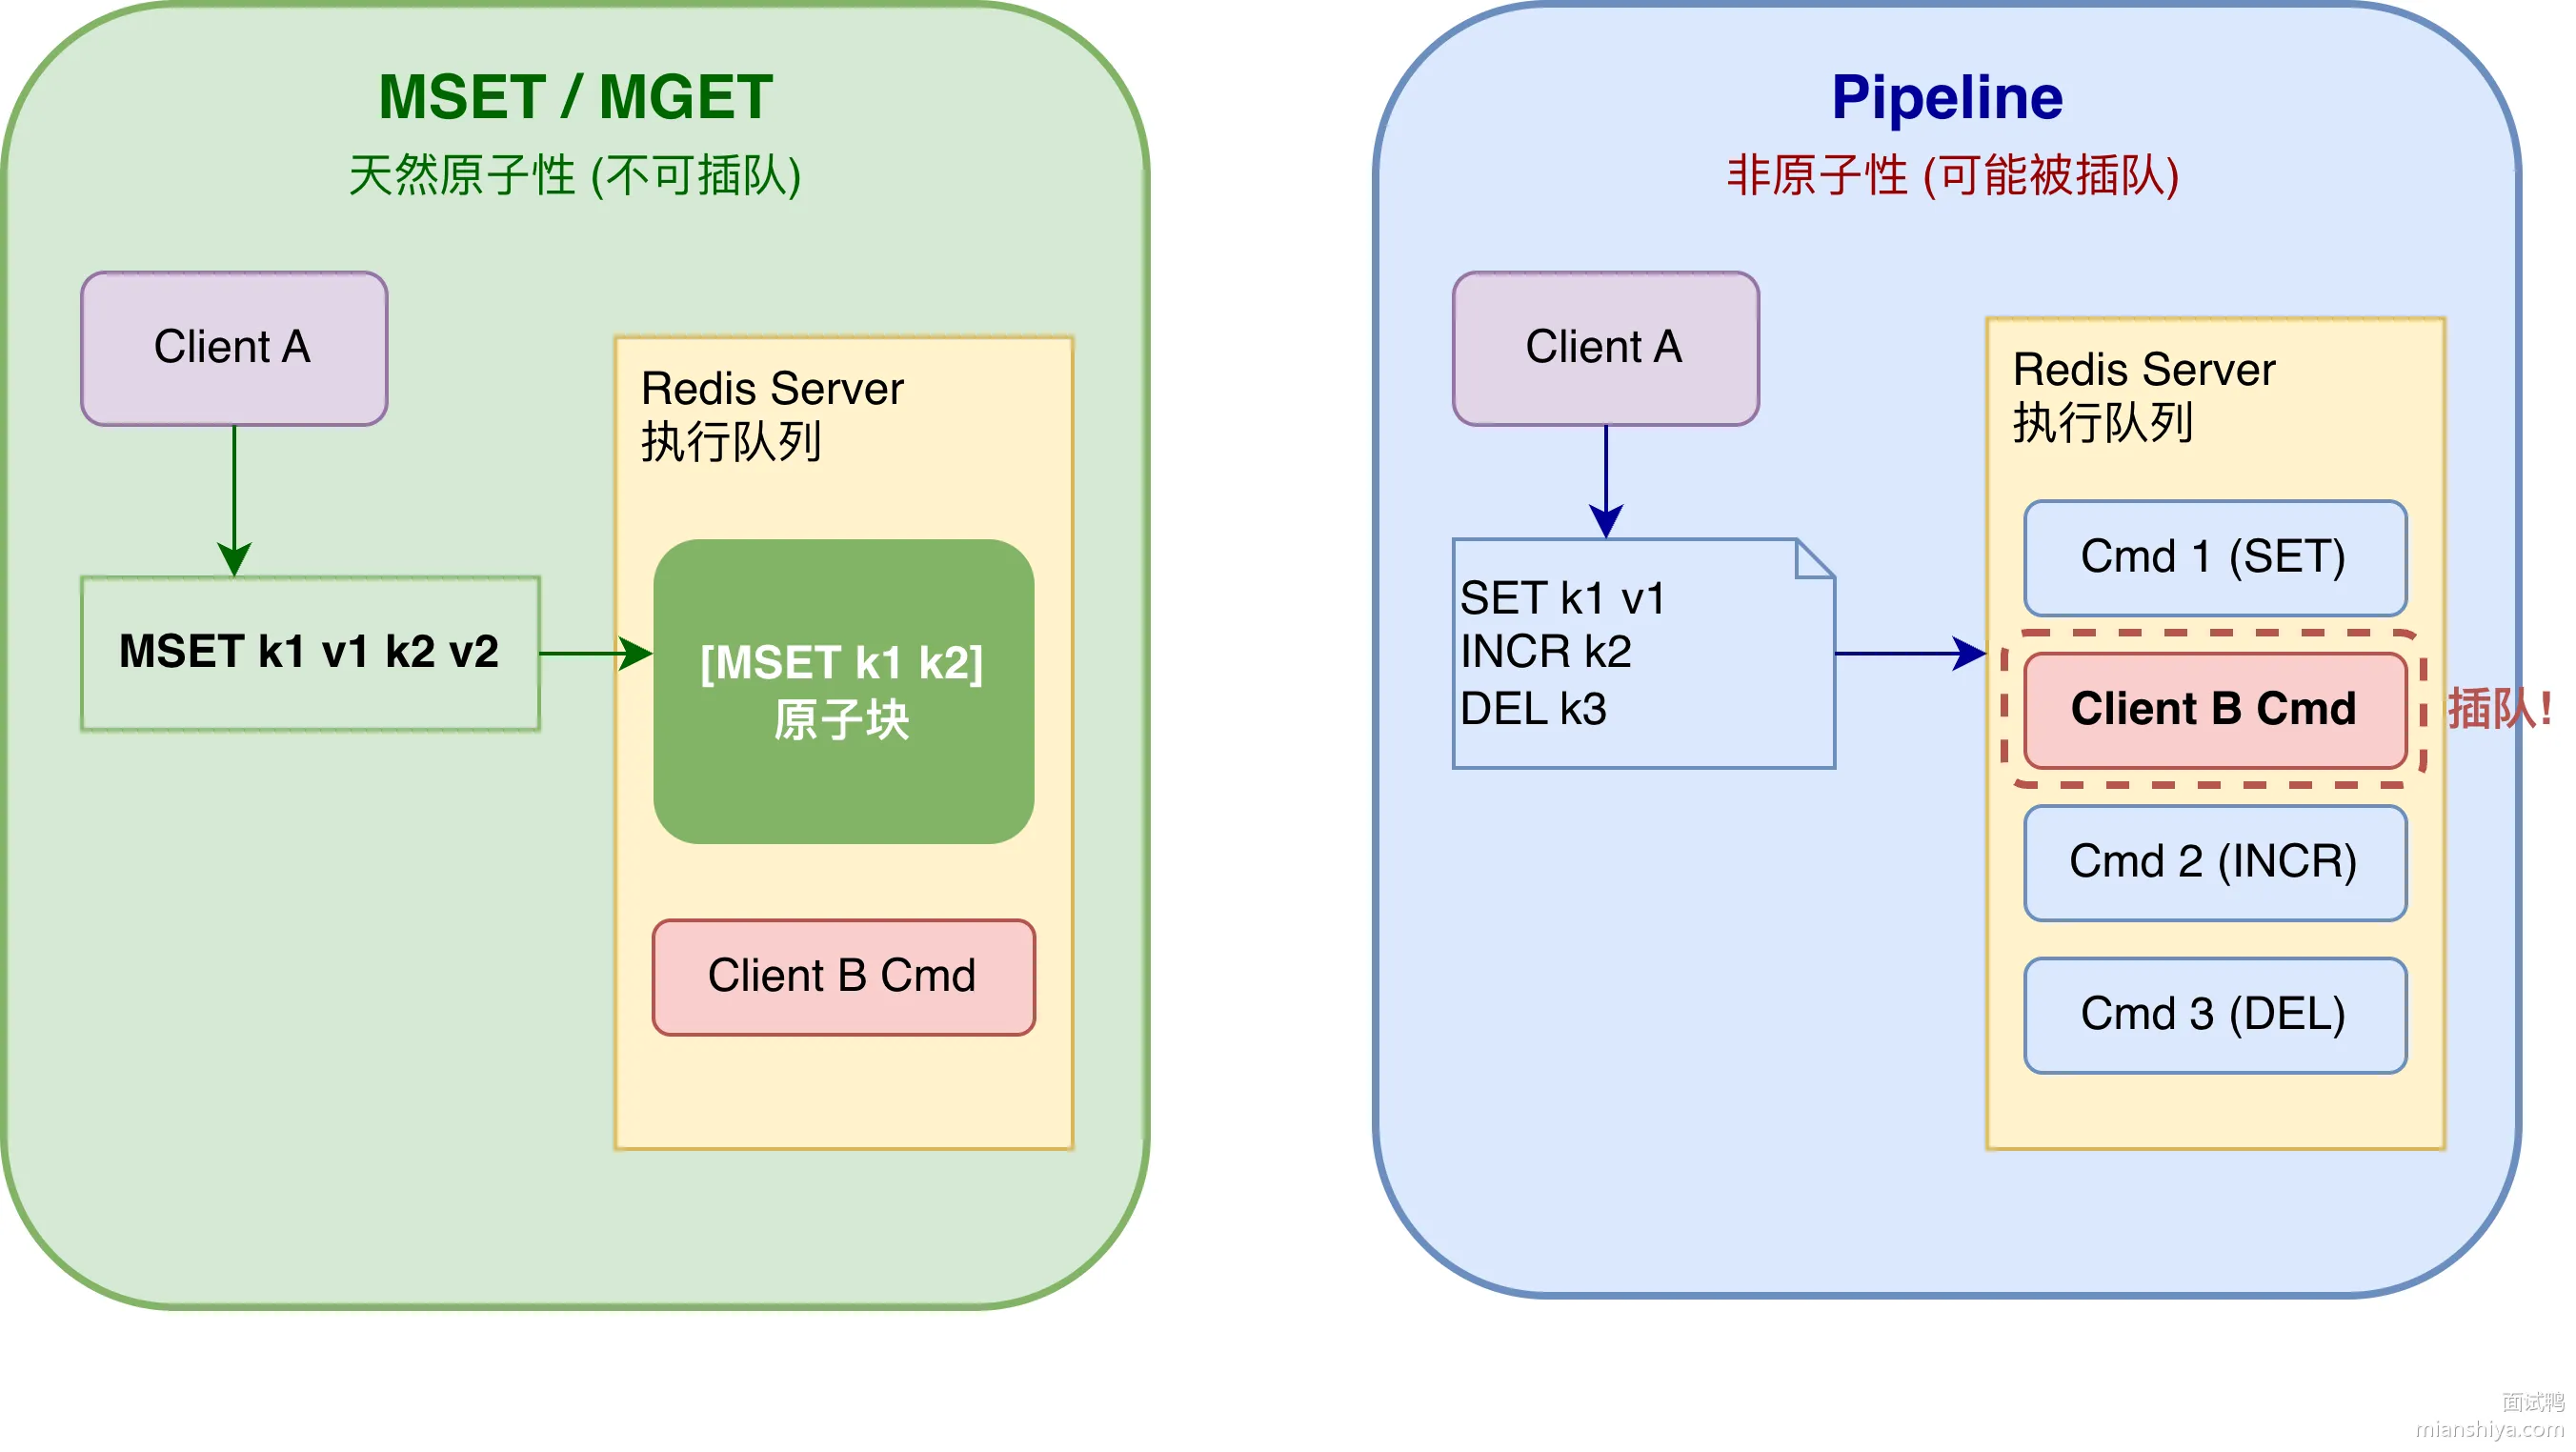
代码上直观感受一下差异:
// MSET 一次写入 3 个 key,原子操作
jedis.mset("user:1:name", "张三", "user:1:age", "25", "user:1:city", "北京");

// Pipeline 批量执行,非原子
Pipeline pipeline = jedis.pipelined();
pipeline.set("user:2:name", "李四");
pipeline.incr("user:2:login_count");
pipeline.zadd("user:2:scores", 88.5, "math");
List<Object> results = pipeline.syncAndReturnAll();
37.2. 扩展知识
37.2.1. 为什么 Pipeline 能提速
没用 Pipeline 之前,客户端发一条命令就得等 Redis 回一条响应,来回一趟网络延迟大概 0.1ms 到 1ms 不等。如果你要执行 1 万条命令,光网络等待时间就可能达到 1 秒以上。
Pipeline 把这 1 万条命令一口气塞进 TCP 缓冲区发出去,Redis 收到后按顺序执行,再把 1 万条响应打包返回。网络往返从 1 万次变成 1 次,吞吐量能翻 5 到 10 倍。
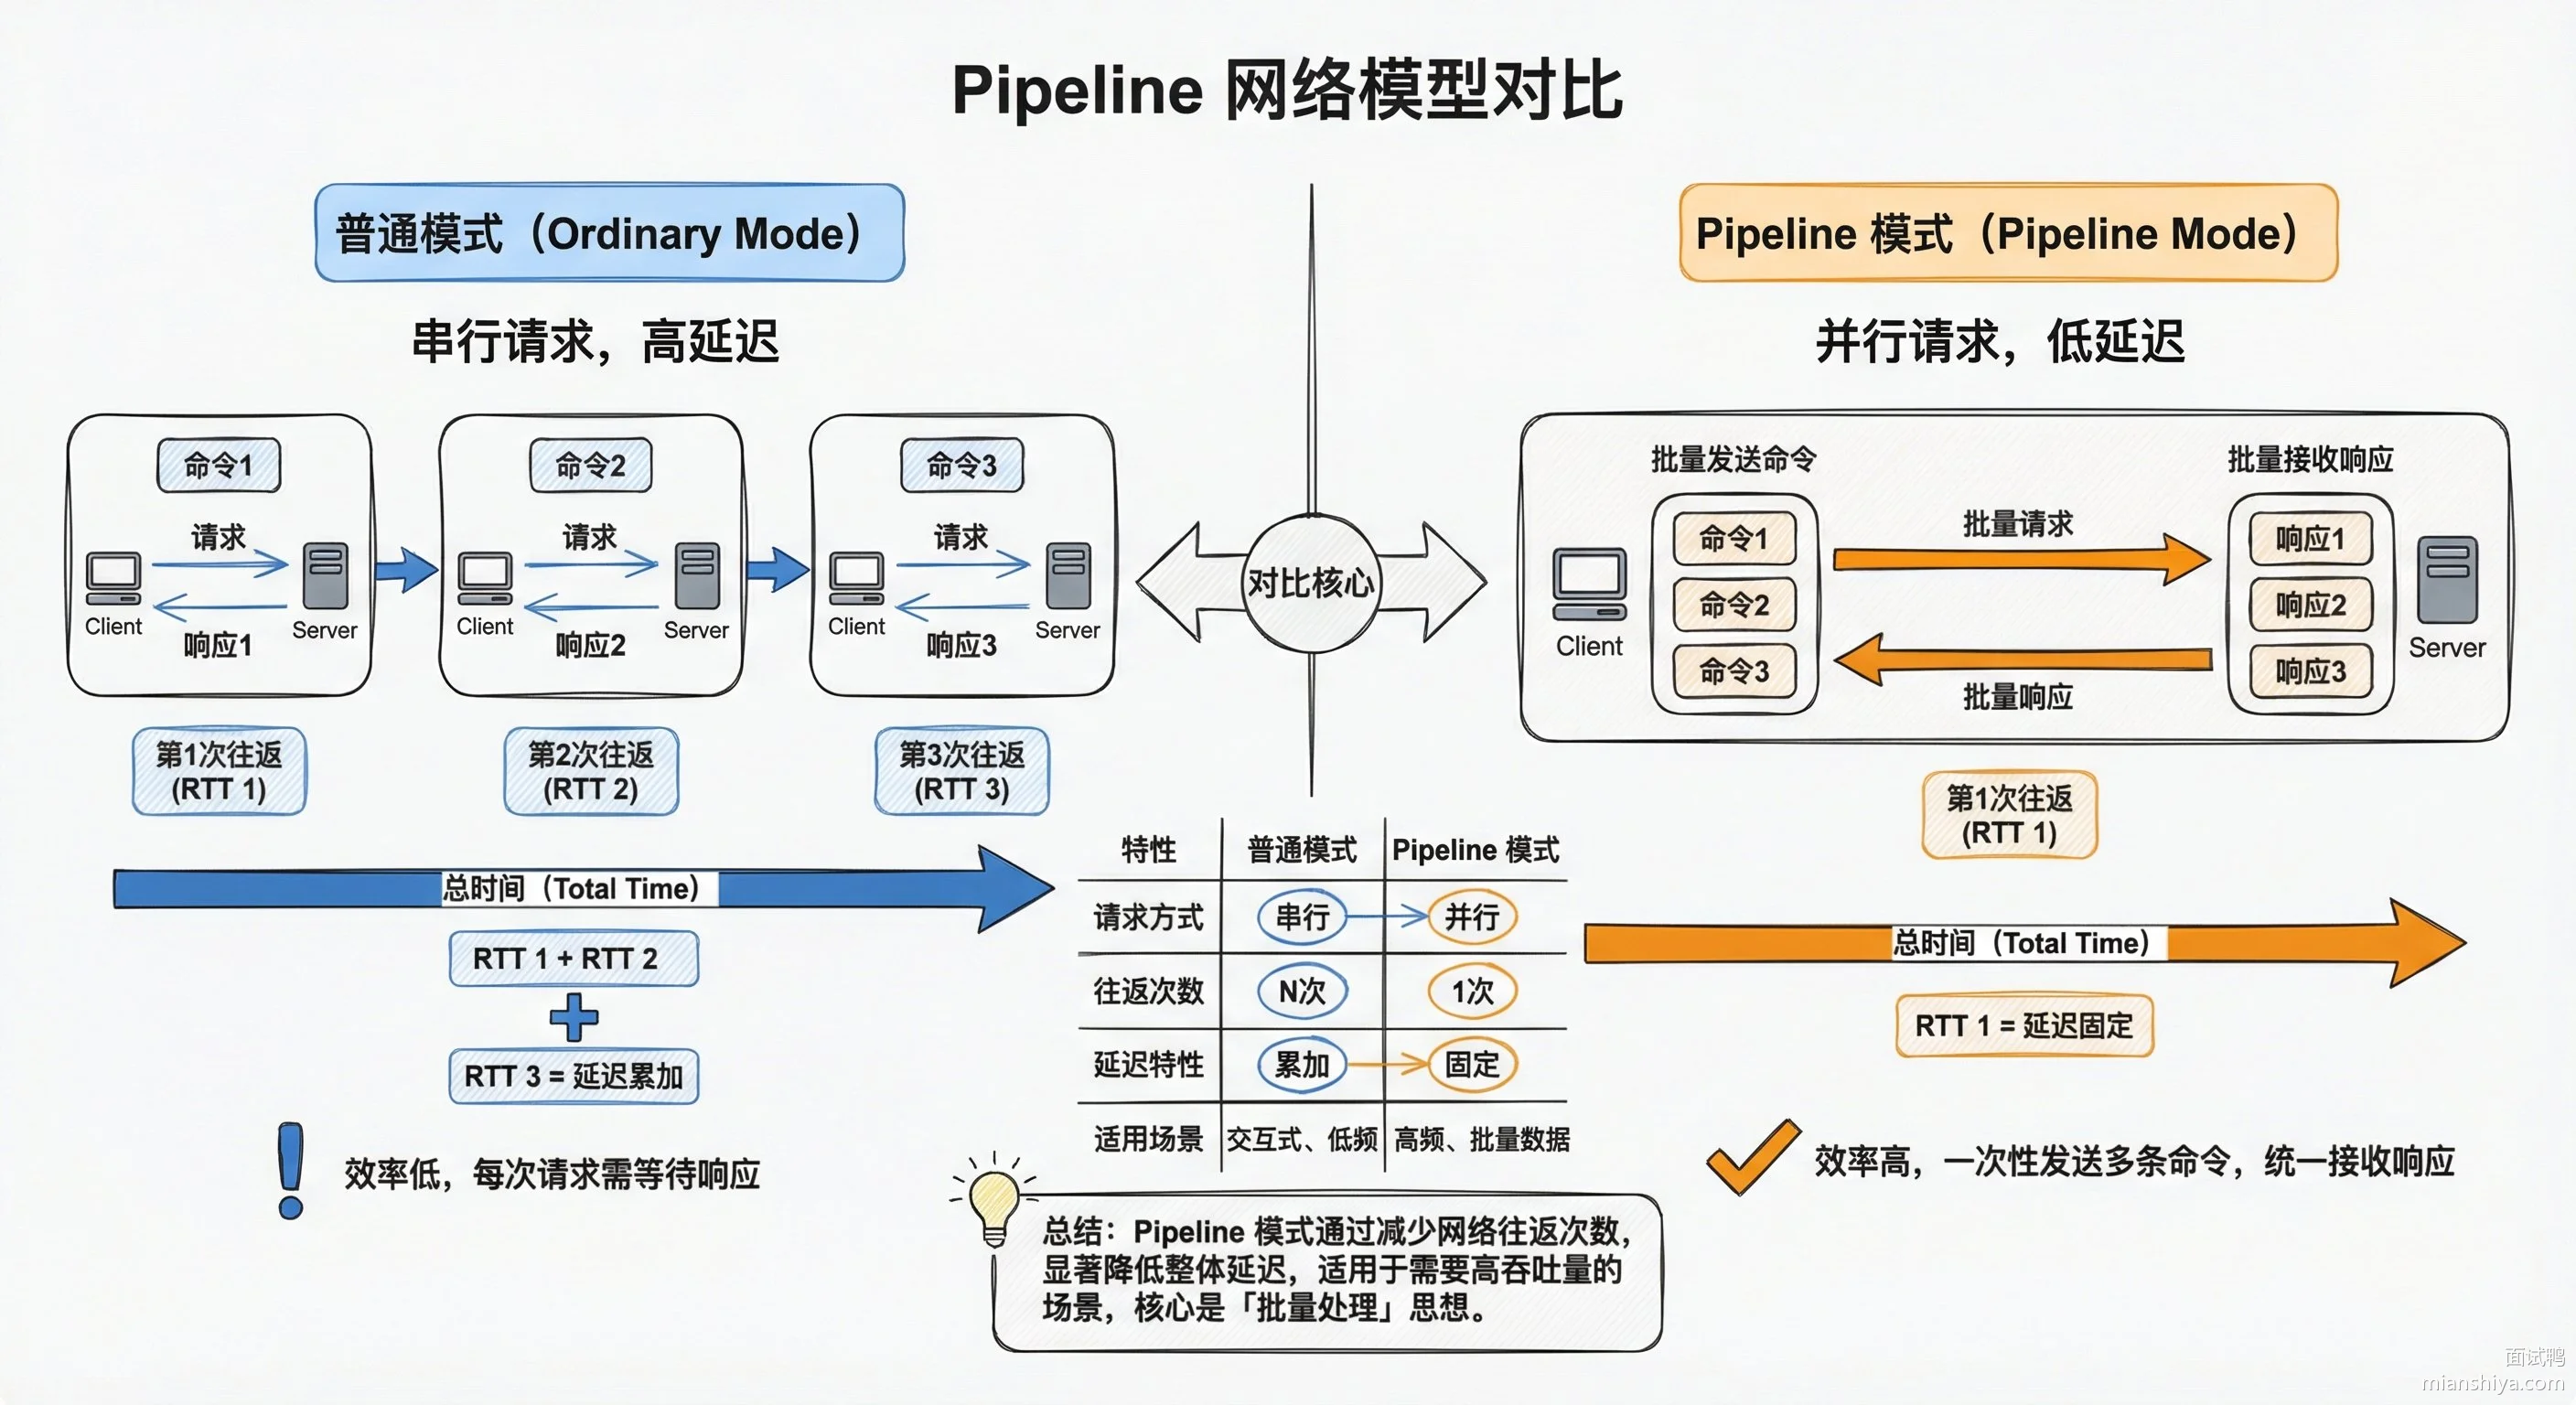
37.2.2. Pipeline 的坑
1)命令数量别太猛。往 Pipeline 里塞 100 万条命令,客户端这边要把请求全攒在内存里,Redis 那边也要把响应全攒着,内存扛不住容易 OOM。一般建议每批控制在 1000 到 10000 条,分批发送。
2)中途出错不会停。Pipeline 里如果第 3 条命令执行失败了,第 4、5、6 条照样继续跑,你得自己从返回值里挑出来哪些成功哪些失败。跟事务的回滚机制完全不同。
3)跨 slot 问题。Redis Cluster 模式下,Pipeline 里的命令如果涉及不同 slot,客户端得自己拆分到对应节点,否则会报 MOVED 错误。Jedis、Lettuce 这些客户端有的支持自动路由,有的不支持,用之前先确认一下。
37.2.3. MSET/MGET 的限制
MSET 和 MGET 在 Cluster 模式下也有 slot 限制,所有 key 必须落在同一个 slot 才行。实际用法上,一般会用 hash tag 来强制路由:
# 用 {user:1} 作为 hash tag,保证这几个 key 落在同一个 slot
MSET {user:1}:name 张三 {user:1}:age 25 {user:1}:city 北京
另外 MSET/MGET 操作的 key 数量也别太多,几百上千个 key 还好,上万个 key 就会阻塞 Redis 主线程,影响其他请求。
37.2.4. 什么时候用哪个
| 场景 | 推荐方案 |
|---|---|
| 批量读写同类型 key,要求原子 | MSET/MGET |
| 混合多种命令,不要求原子 | Pipeline |
| 批量操作 + 部分需要原子 | Pipeline + Lua 脚本组合 |
| Cluster 模式批量操作 | 客户端按 slot 分组 + Pipeline |
37.3. 常见问题
37.3.1. Pipeline 和 Redis 事务有什么区别?什么时候该用事务?
详细解答可以看:Redis 支持事务吗?如何实现?
Pipeline 只是把命令打包发送,执行过程中完全可能被其他客户端的命令插队;事务用 MULTI/EXEC 包裹,保证这批命令连续执行不会被打断。但 Redis 事务不支持回滚,某条命令出错了前面的操作不会撤销。需要"执行过程不被插队"的场景用事务,纯粹想提升吞吐量就用 Pipeline。两者也能组合用,Pipeline 里套 MULTI/EXEC。
37.3.2. Pipeline 打包太多命令会有什么风险?
详细解答可以看:Redis 的 Pipeline 功能是什么?
内存撑爆和网络超时。客户端要把所有命令攒在内存里才能发送,Redis 也要把所有响应攒着才能返回,100 万条命令两边内存都扛不住。另外 TCP 有发送缓冲区大小限制,数据量太大可能触发分包,网络抖动时容易超时。一般控制在每批 1000 到 10000 条比较稳妥。
37.3.3. Cluster 模式下怎么优雅地用 Pipeline?
核心是按 slot 分组。先计算每个 key 的 slot,把同一个 slot 的命令归到一组,每组单独走 Pipeline 发到对应节点。Lettuce 客户端内置了这个逻辑,Jedis 需要自己手动分组或者用 JedisCluster 的批量 API。如果 key 本身有规律,也可以用 hash tag 强制路由到同一个 slot。
38. Redis 主从复制的常见拓扑结构有哪些?
38.1. 核心要点
Redis 主从复制的拓扑结构主要有三种:一主多从、树状级联和主主结构。
1)一主多从
最常见的结构,一个主节点挂多个从节点。写操作全走主节点,读操作分散到各个从节点,实现读写分离。主节点挂了的话,从节点可以顶上来。
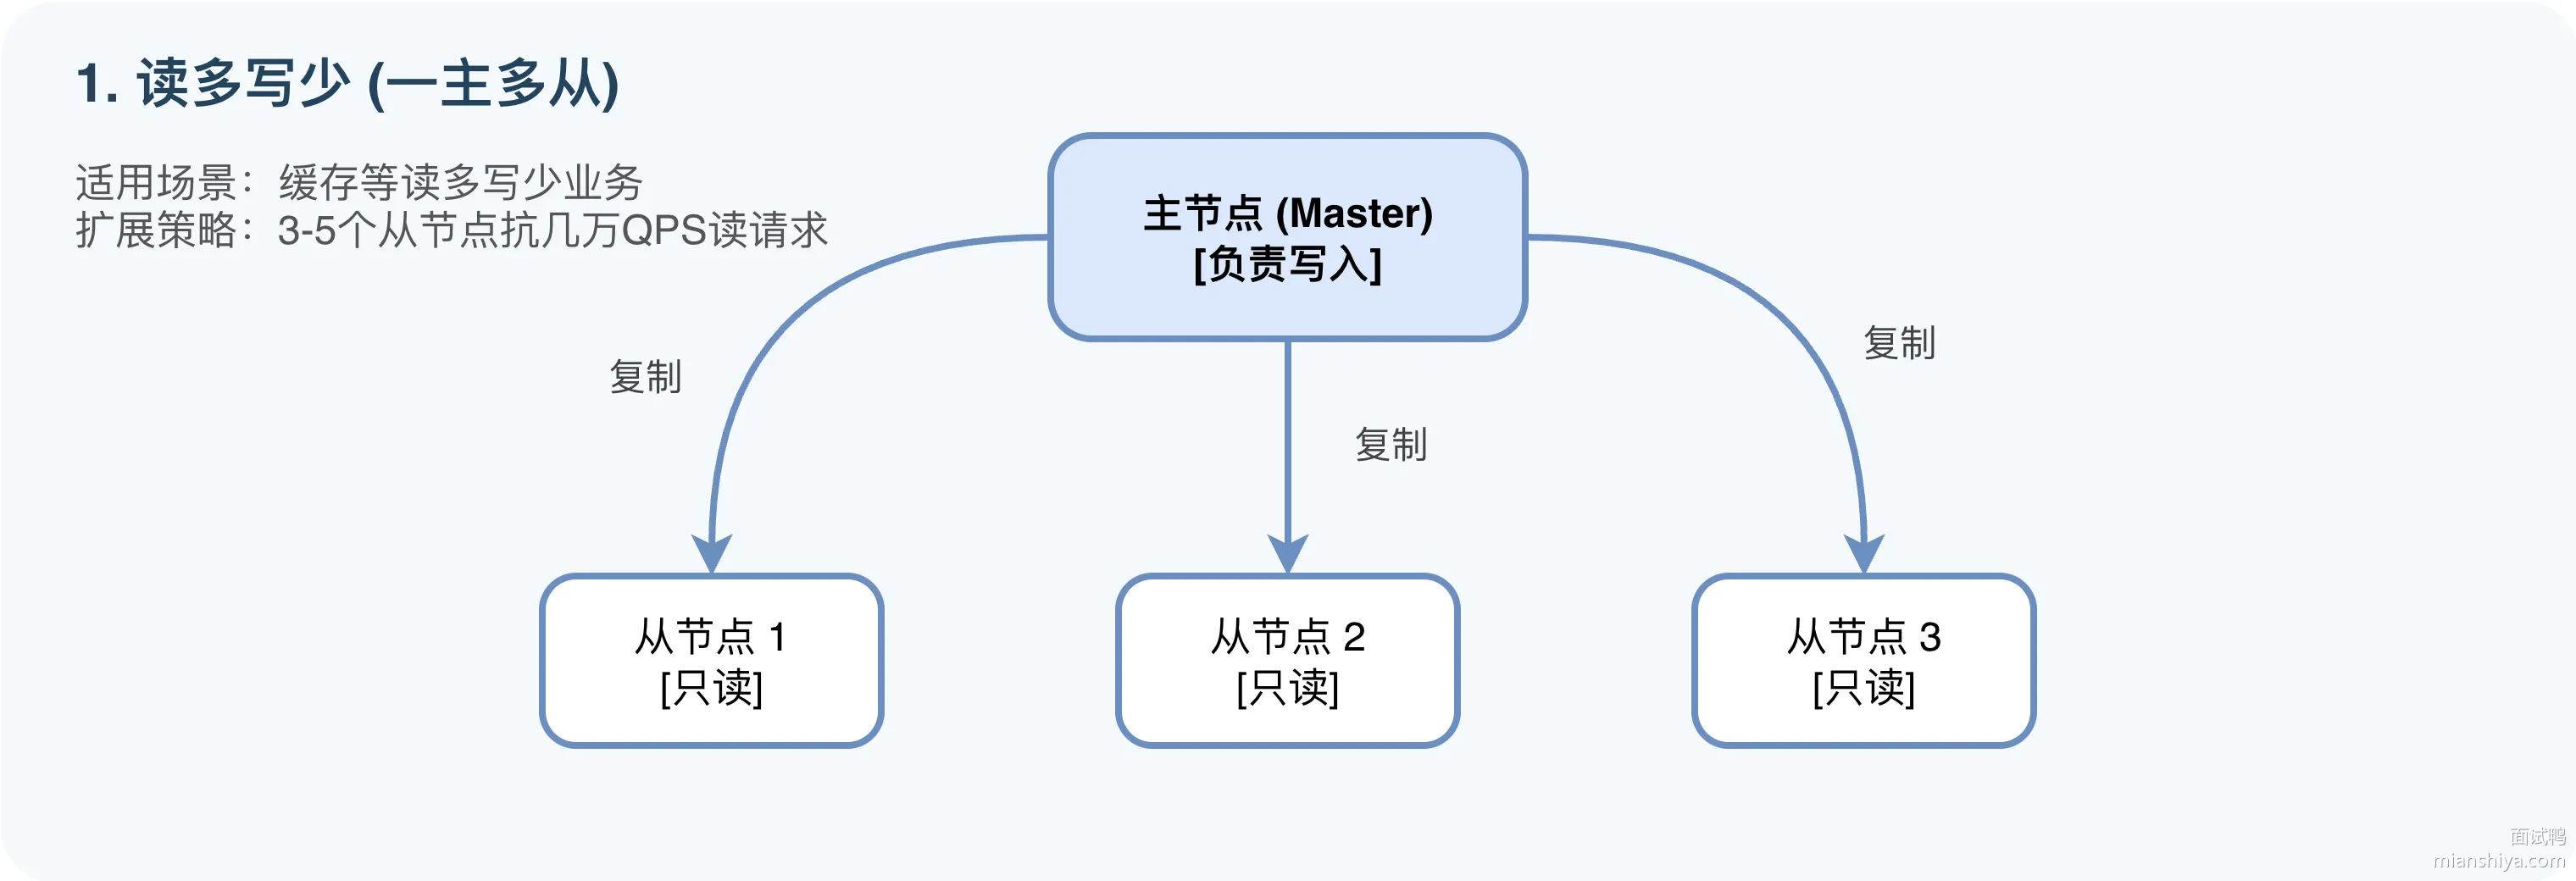
2)树状级联
从节点也能当其他从节点的"主",形成一个层层往下传递的结构。好处是主节点只需要同步给少数几个一级从节点,一级从节点再往下同步,主节点的复制压力小很多。缺点是链路越长,数据延迟越大,最底层从节点拿到最新数据可能慢个几百毫秒。
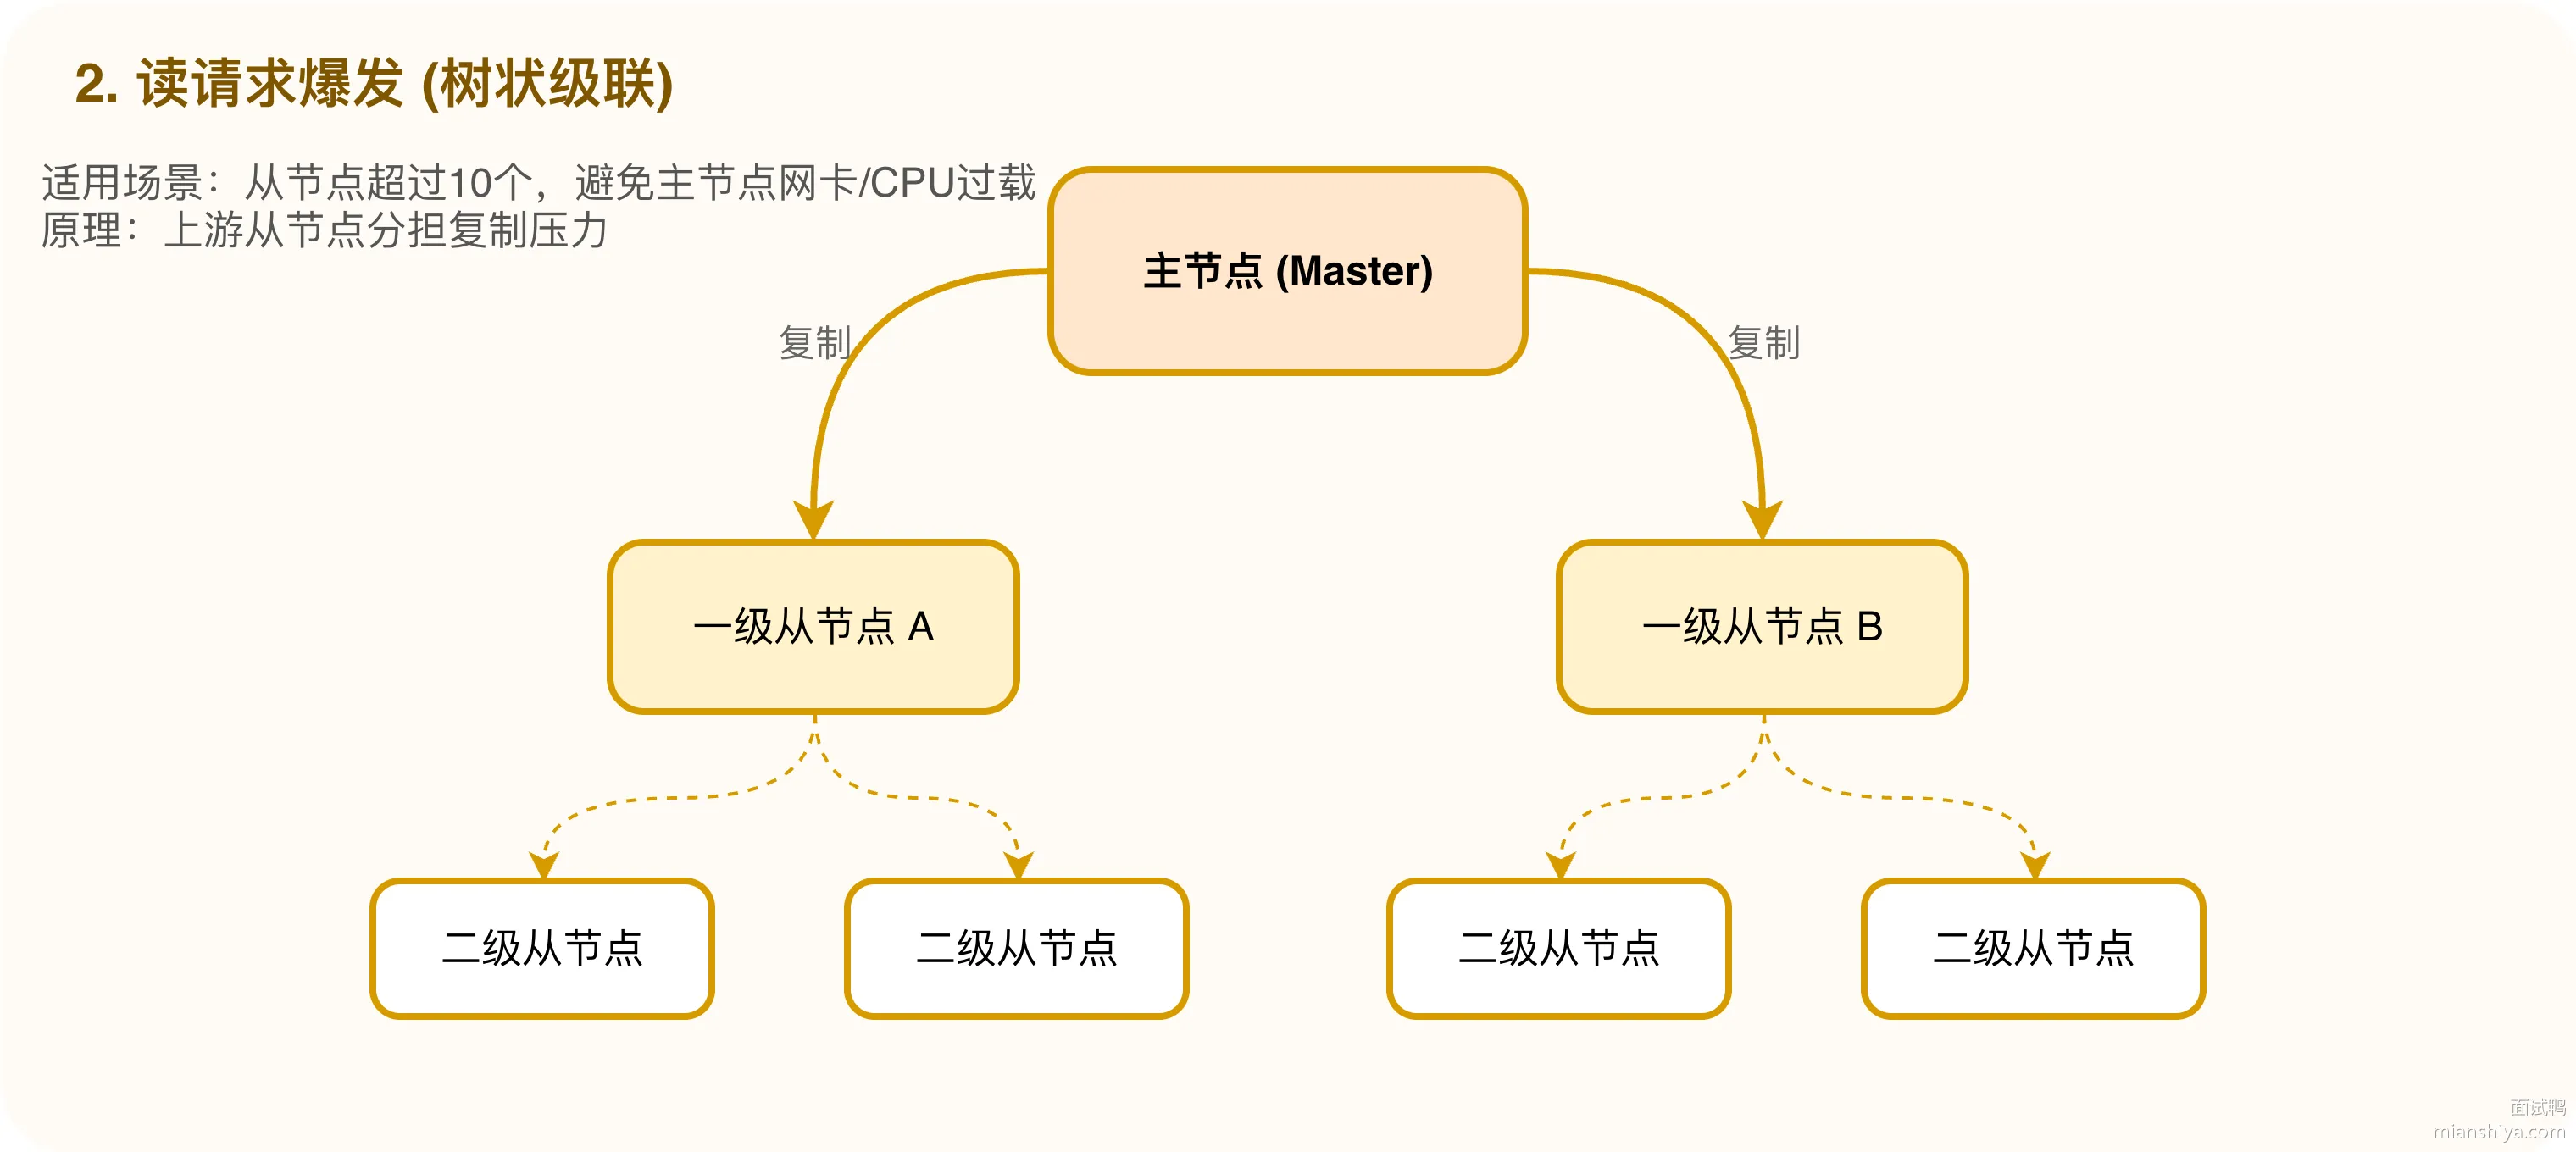
3)主主结构
两个主节点互相同步,写操作可以打到任意一个主节点上。但 Redis 原生不支持主主复制,硬要搞得自己处理数据冲突,两边同时写同一个 key 就炸了。实际生产环境很少用,除非有特殊的多活场景配合业务层面的冲突规避。
38.2. 扩展知识
38.2.1. 不同拓扑结构怎么选
选拓扑结构得看业务特点:
1)读多写少,比如缓存场景,一主多从就够用。从节点数量根据读 QPS 来定,一般 3 到 5 个从节点能扛住几万 QPS 的读请求。
2)从节点数量特别多,比如要挂 10 个以上从节点做读扩展,就考虑树状级联。否则主节点光复制数据就把带宽和 CPU 吃满了,正常写请求反而受影响。
3)多机房容灾,每个机房都要有写能力,这种场景才会考虑主主结构。但要在业务层做好 key 分区,保证同一个 key 只在一个机房写,避免冲突。
38.2.2. 主从复制的数据一致性问题
主从复制是异步的,主节点写完数据立刻返回客户端成功,然后才把数据同步给从节点。这中间有个时间差,从节点读到的可能是旧数据。
极端情况下,主节点刚写完就挂了,数据还没来得及同步到从节点,这部分数据就丢了。如果业务对数据丢失零容忍,得配合 min-slaves-to-write 和 min-slaves-max-lag 参数,让主节点在从节点数量或延迟不达标时拒绝写入。
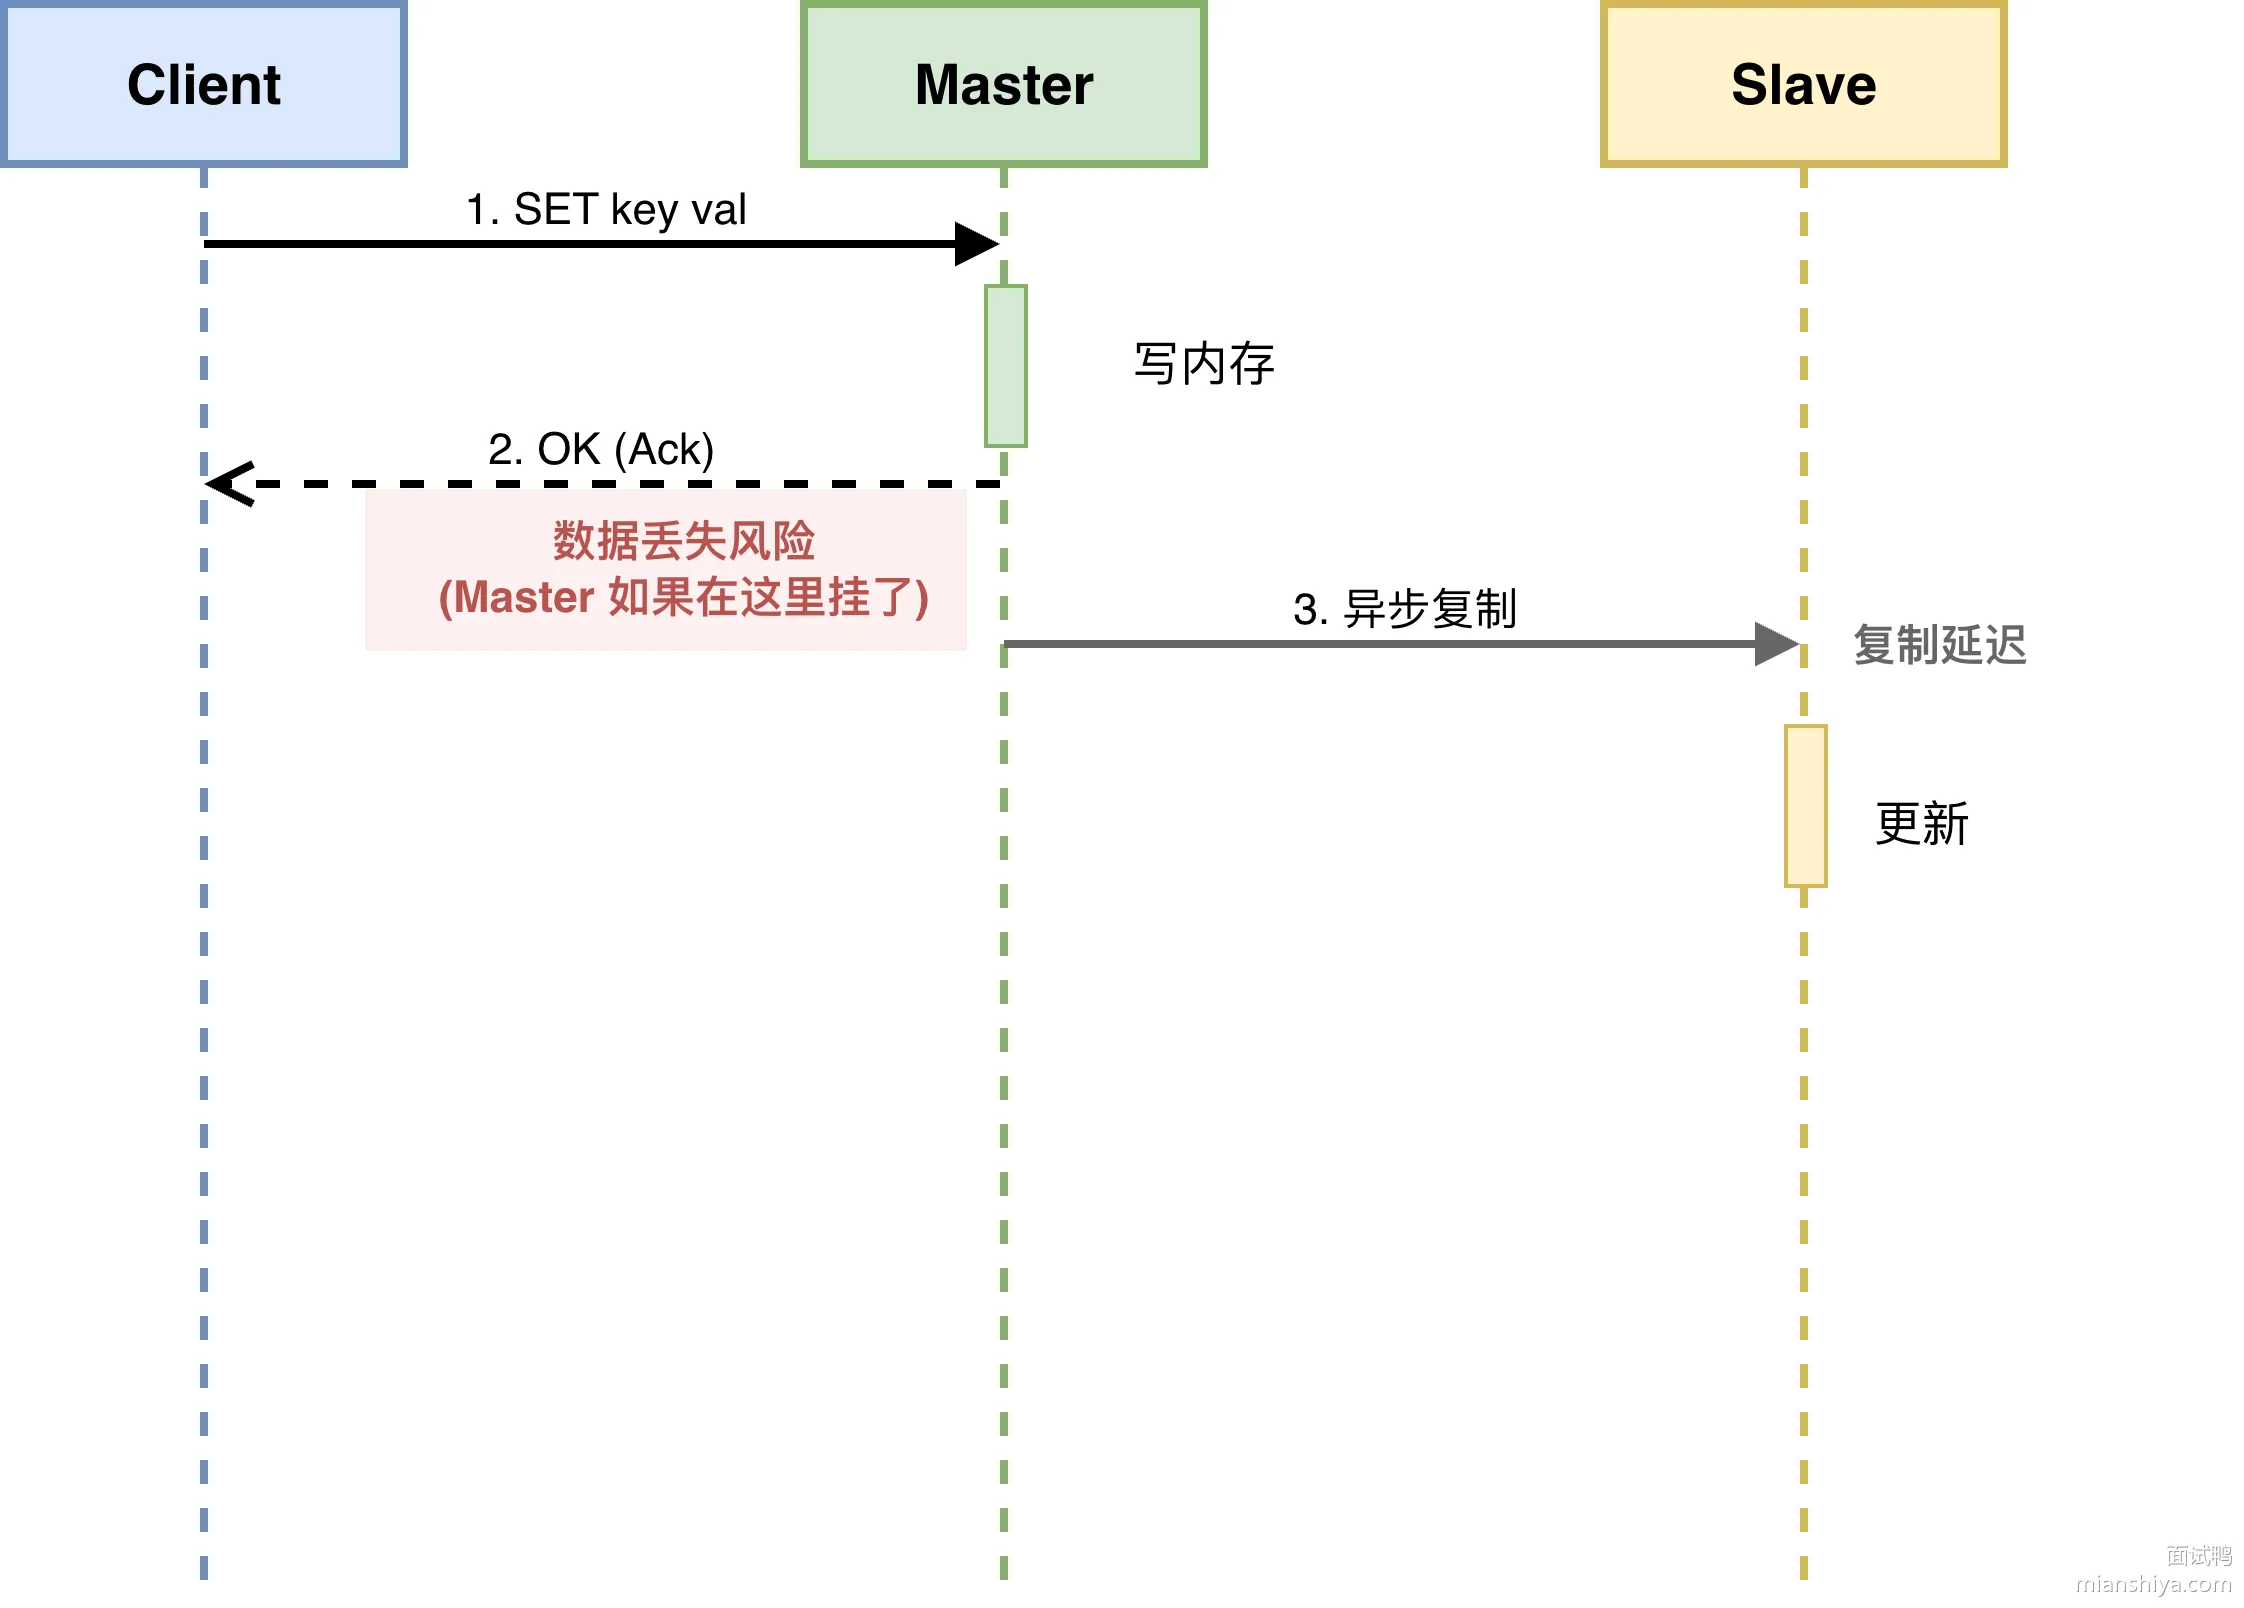
38.2.3. 故障切换怎么搞
单纯的主从结构没有自动故障转移能力,主节点挂了就得人工介入,把某个从节点提升为主节点,再把其他从节点指向新主节点。
生产环境一般会配合哨兵或者 Cluster 模式:
1)哨兵模式下,Sentinel 进程监控主从状态,主节点挂了自动选举新主节点,对客户端透明。
2)Cluster 模式自带主从和故障转移,每个分片都是主从结构,某个分片的主节点挂了自动切换到从节点。
38.2.4. 相关内容
38.3. 常见问题
38.3.1. 一主多从结构下,从节点数量越多越好吗?
不是。从节点数量上去之后,主节点要给每个从节点发送复制数据,网络带宽和 CPU 都会被吃掉一部分。从节点超过 5 个就要考虑树状级联结构,或者直接上 Cluster 模式做分片,把写压力分散到多个主节点上。
38.3.2. 从节点能不能处理写请求?
默认不行,从节点收到写请求会直接报错。可以通过 replica-read-only 配置改成可写,但写到从节点的数据不会同步回主节点,下次全量同步还会被主节点的数据覆盖掉,基本没有实际用途。
38.3.3. 主从复制延迟太大怎么排查?
详细解答可以看:Redis 复制延迟的常见原因有哪些?
先用 INFO replication 看主节点的 master_repl_offset 和从节点的 slave_repl_offset,差值就是延迟的字节数。延迟大一般几个原因:网络带宽不够、从节点机器性能差、主节点写 QPS 太高。还有一种情况是从节点在做 RDB 全量同步或者 AOF 重写,这段时间复制会暂停。
39. Redis List 类型的常见操作命令有哪些?
39.1. 核心要点
Redis List 是一个双端链表结构的字符串列表,支持从两头插入和弹出元素。
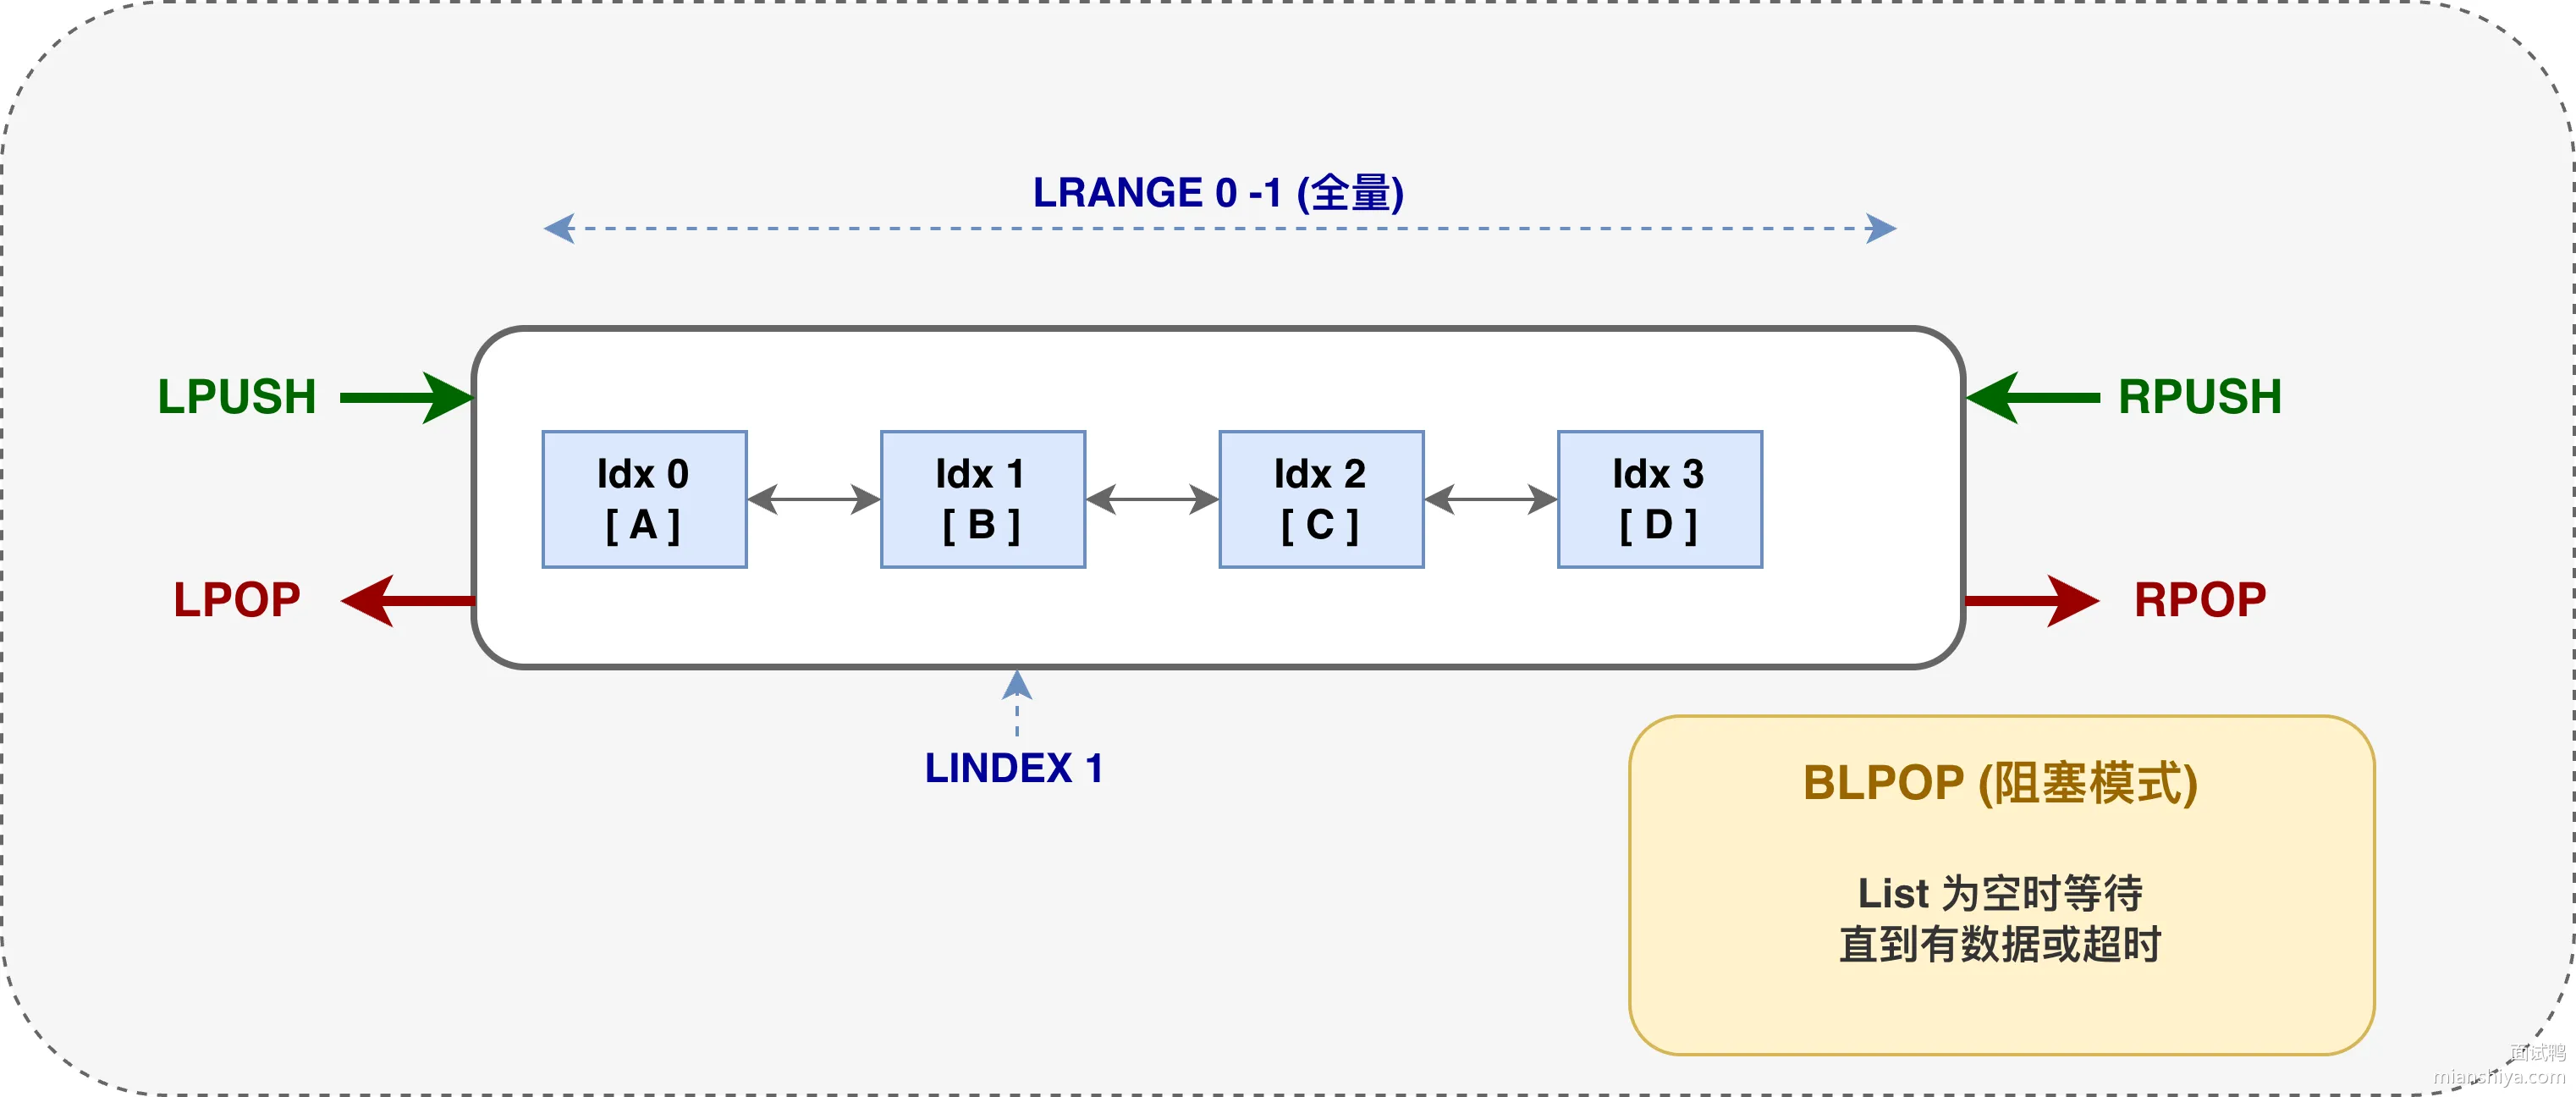
常用命令可以分成写入类、读取类和修改类三组。
写入类命令: 1)LPUSH 从左边塞元素,RPUSH 从右边塞元素,list 不存在会自动创建 2)LPOP 从左边弹出,RPOP 从右边弹出,弹出来的元素会从 list 里删掉 3)BLPOP 和 BRPOP 是阻塞版本,list 空的时候会等着,直到有数据或者超时
读取类命令: 1)LRANGE 按范围取元素,LRANGE key 0 -1 就是取全部 2)LINDEX 按下标取单个元素,下标从 0 开始 3)LLEN 拿 list 长度
修改类命令: 1)LSET 按下标改元素值 2)LREM 删除指定数量的匹配元素 3)LTRIM 只保留指定范围的元素,其他全删掉
代码示例:
# 写入操作
LPUSH mylist a b c     # list 变成 [c, b, a]
RPUSH mylist d e       # list 变成 [c, b, a, d, e]

# 弹出操作
LPOP mylist            # 返回 c,list 变成 [b, a, d, e]
RPOP mylist            # 返回 e,list 变成 [b, a, d]

# 读取操作
LRANGE mylist 0 -1     # 返回 [b, a, d]
LINDEX mylist 1        # 返回 a
LLEN mylist            # 返回 3

# 修改操作
LSET mylist 0 x        # list 变成 [x, a, d]
LREM mylist 1 a        # 删掉第一个 a,list 变成 [x, d]
LTRIM mylist 0 0       # 只保留第一个元素,list 变成 [x]
39.2. 扩展知识
39.2.1. List 的底层实现
Redis 3.2 之前 List 用的是 ziplist 和 linkedlist 两种结构,元素少的时候用 ziplist 省内存,元素多了就转成 linkedlist 方便两端操作。
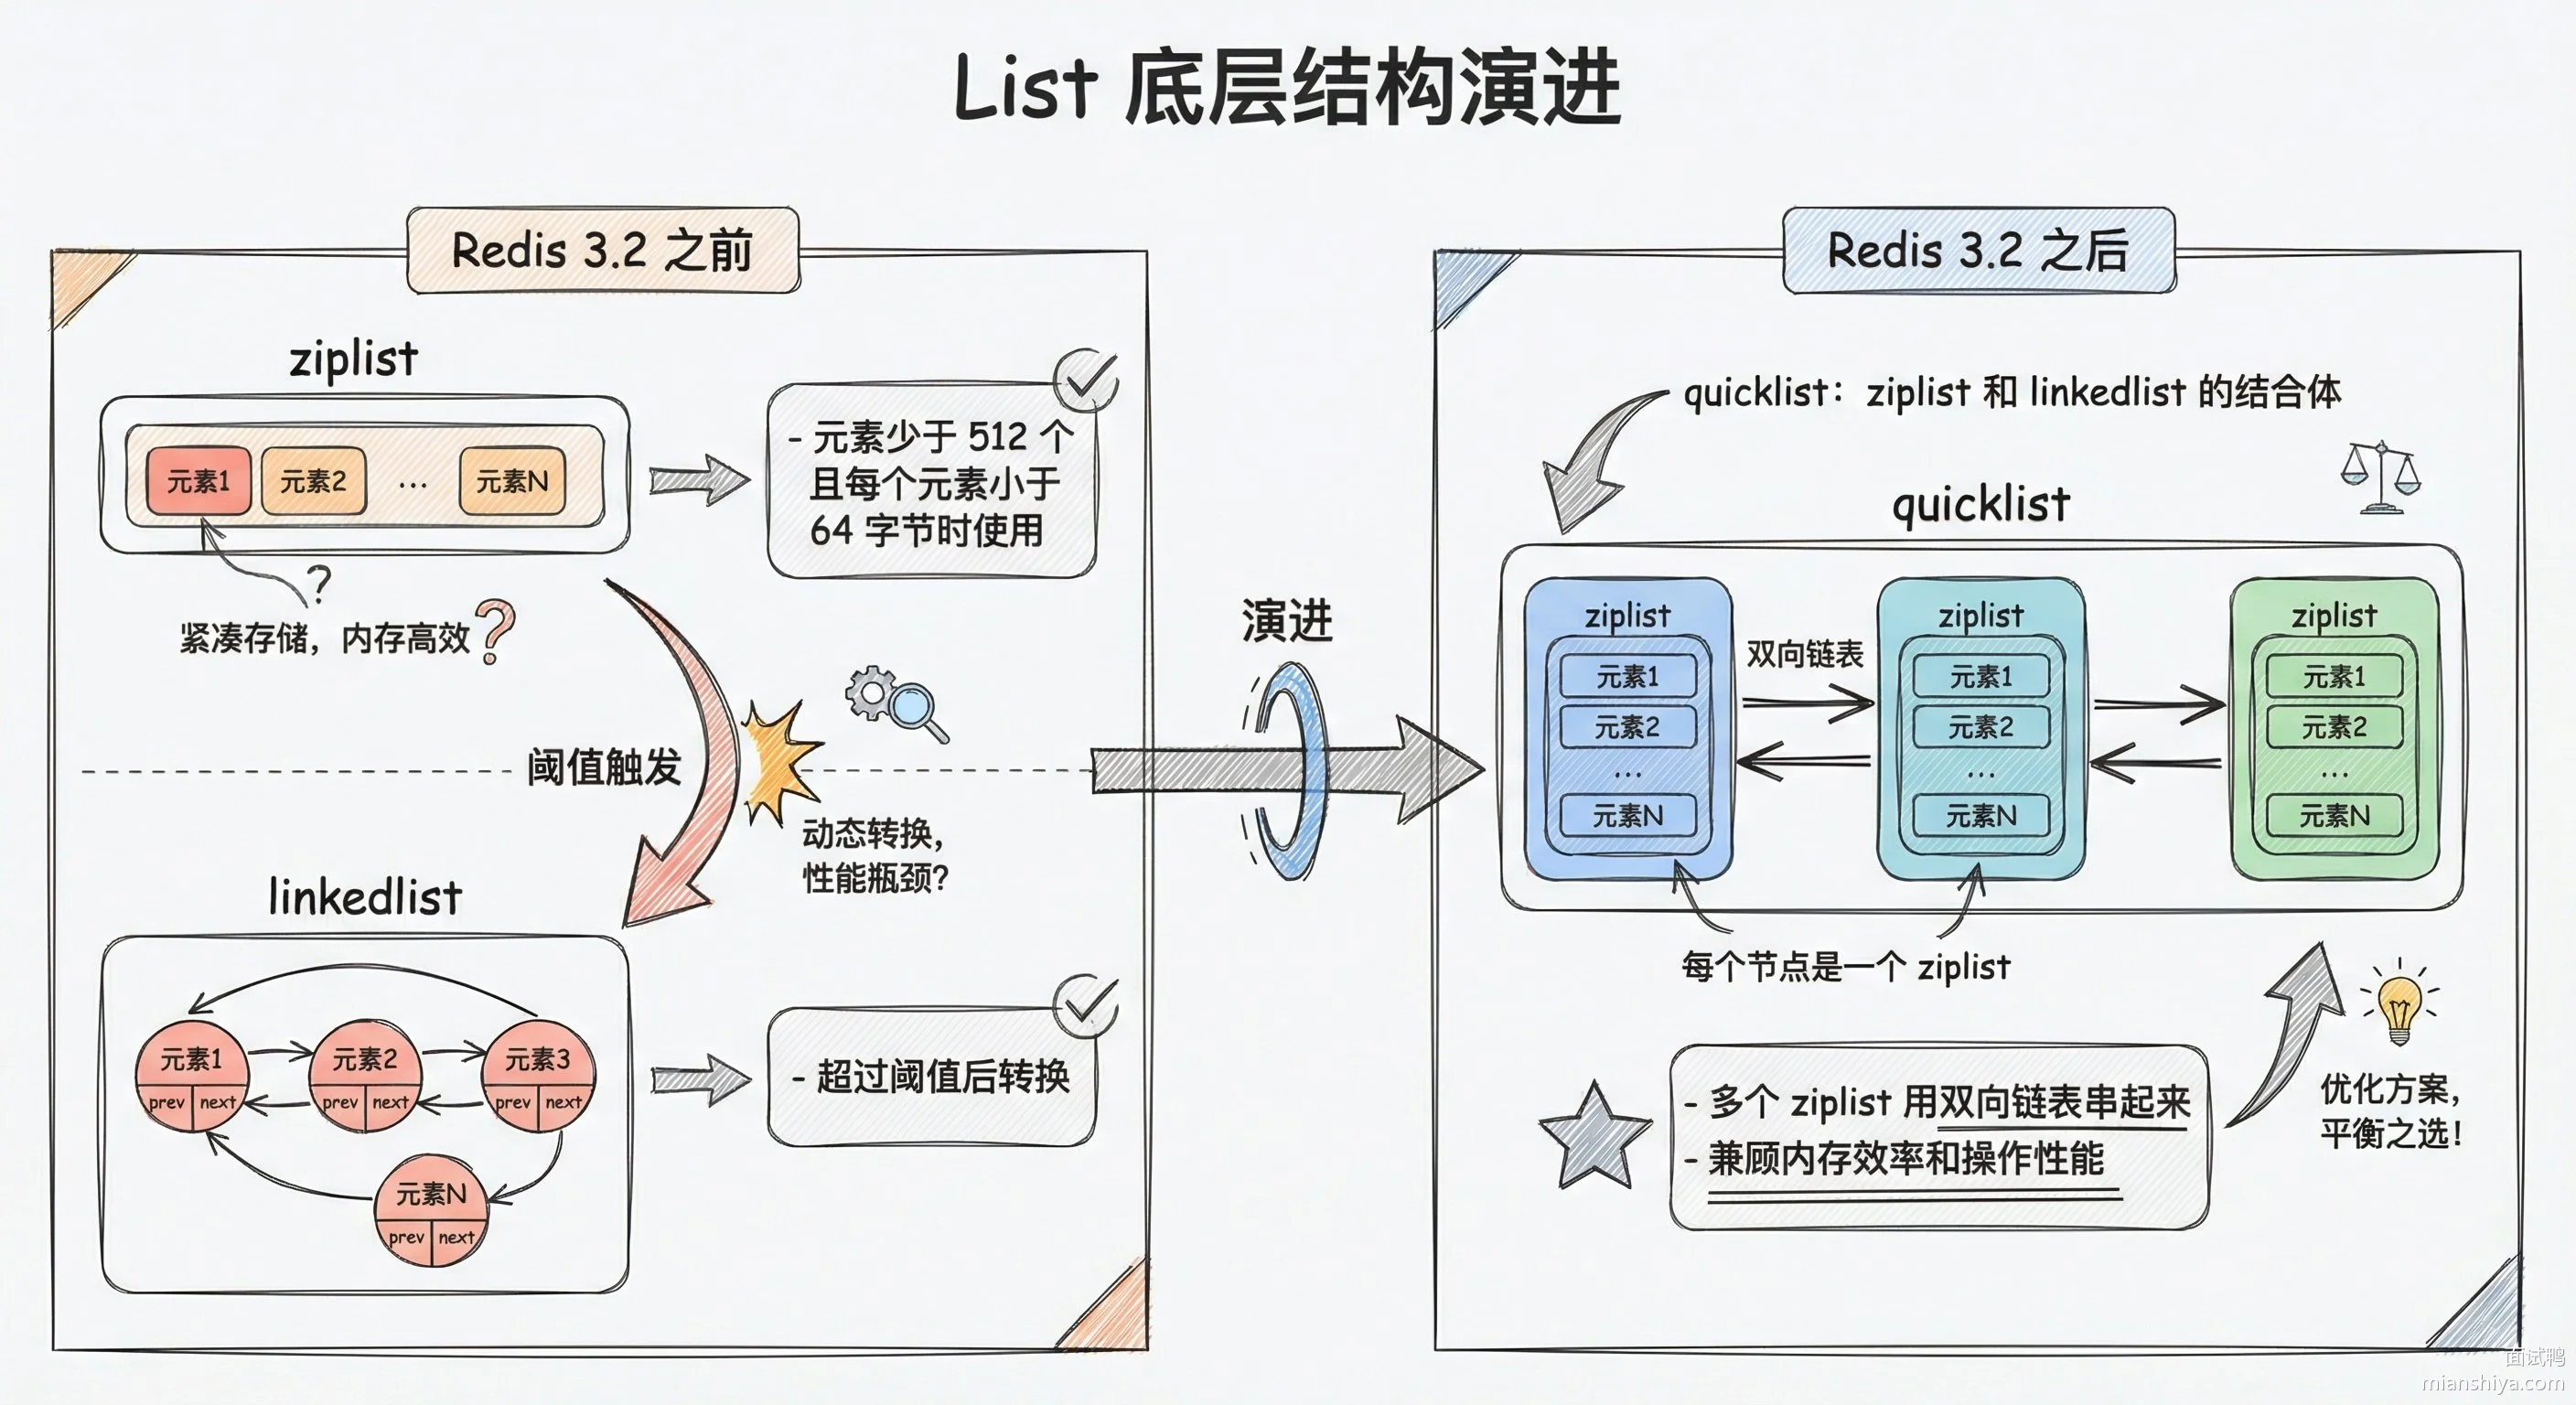
Redis 3.2 之后改成了 quicklist,本质上是把多个小的 ziplist 用双向链表串起来。每个 ziplist 节点控制在一定大小内,既保留了 ziplist 的内存紧凑优势,又能高效地从两端操作。
相关内容:41. Redis 中的 Ziplist 和 Quicklist 数据结构的特点是什么?
39.2.2. List 的典型应用场景
1)消息队列
LPUSH 生产消息,RPOP 消费消息,就是个简单的先进先出队列。如果想让消费者别空转,换成 BRPOP 阻塞等待,list 空的时候消费者会挂起,有消息进来立刻唤醒。
不过 Redis List 做消息队列有个问题:消息弹出去就没了,消费者处理到一半挂掉,消息就丢了。要可靠性得上 Redis Stream 或者专业消息队列。
2)最新动态列表
比如用户的最近 100 条聊天记录、最近 50 条操作日志。每次有新数据 LPUSH 进去,再 LTRIM 保留固定长度,老数据自动淘汰。
LPUSH user:1001:messages "今天天气不错"
LTRIM user:1001:messages 0 99    # 只保留最近 100 条
3)任务队列
后台任务丢进 list,worker 用 BRPOP 阻塞等任务。多个 worker 可以同时 BRPOP 同一个 list,任务会被分配给其中一个 worker,天然实现负载均衡。
39.2.3. 性能注意事项
1)LRANGE 取大范围数据要小心。list 里有 100 万条数据,你来个 LRANGE key 0 -1,Redis 主线程就被卡住了,其他请求全得等着。线上环境一定要限制范围,比如每次最多取 1000 条。
2)LINDEX 和 LSET 按下标操作,时间复杂度是 O(N),下标越大越慢。list 有 10 万条数据,LINDEX key 99999 得从头遍历到尾,性能很差。
3)list 长度要控制住,用 LTRIM 定期裁剪,或者业务上设置 TTL 让整个 key 过期。无限增长的 list 迟早把内存撑爆。
39.3. 常见问题
39.3.1. LPUSH 和 RPUSH 一次可以塞多个元素,顺序是怎么样的?
LPUSH a b c 的结果是 list 变成 [c, b, a],不是 [a, b, c]。因为 LPUSH 是依次往左边塞,先塞 a,再往 a 左边塞 b,最后往 b 左边塞 c。RPUSH 就是正常顺序,RPUSH a b c 结果是 [a, b, c]。
39.3.2. BLPOP 可以同时监听多个 list 吗?
可以。BLPOP list1 list2 list3 0 会按顺序检查这几个 list,哪个先有数据就从哪个弹。注意是按参数顺序检查,不是按数据到达顺序,所以 list1 有数据就永远轮不到 list2。要公平调度得业务层自己轮换顺序。
39.3.3. 用 List 做消息队列和用 Stream 有什么区别?
List 弹出即删除,没有 ACK 机制,消费者挂了消息就丢了;Stream 支持消费者组、消息确认、消息回溯,消费者挂了消息还在,换个消费者可以继续处理。Stream 还支持多消费者组独立消费同一份数据,List 做不到。简单场景用 List,要可靠性上 Stream。
40. 如何在 Redis 中实现队列和栈数据结构?
40.1. 核心要点
用 Redis 的 List 类型就能直接实现队列和栈,核心就是控制从哪边进、从哪边出。
队列是先进先出,用 LPUSH 从左边塞数据,用 RPOP 从右边取数据,先进去的先出来。
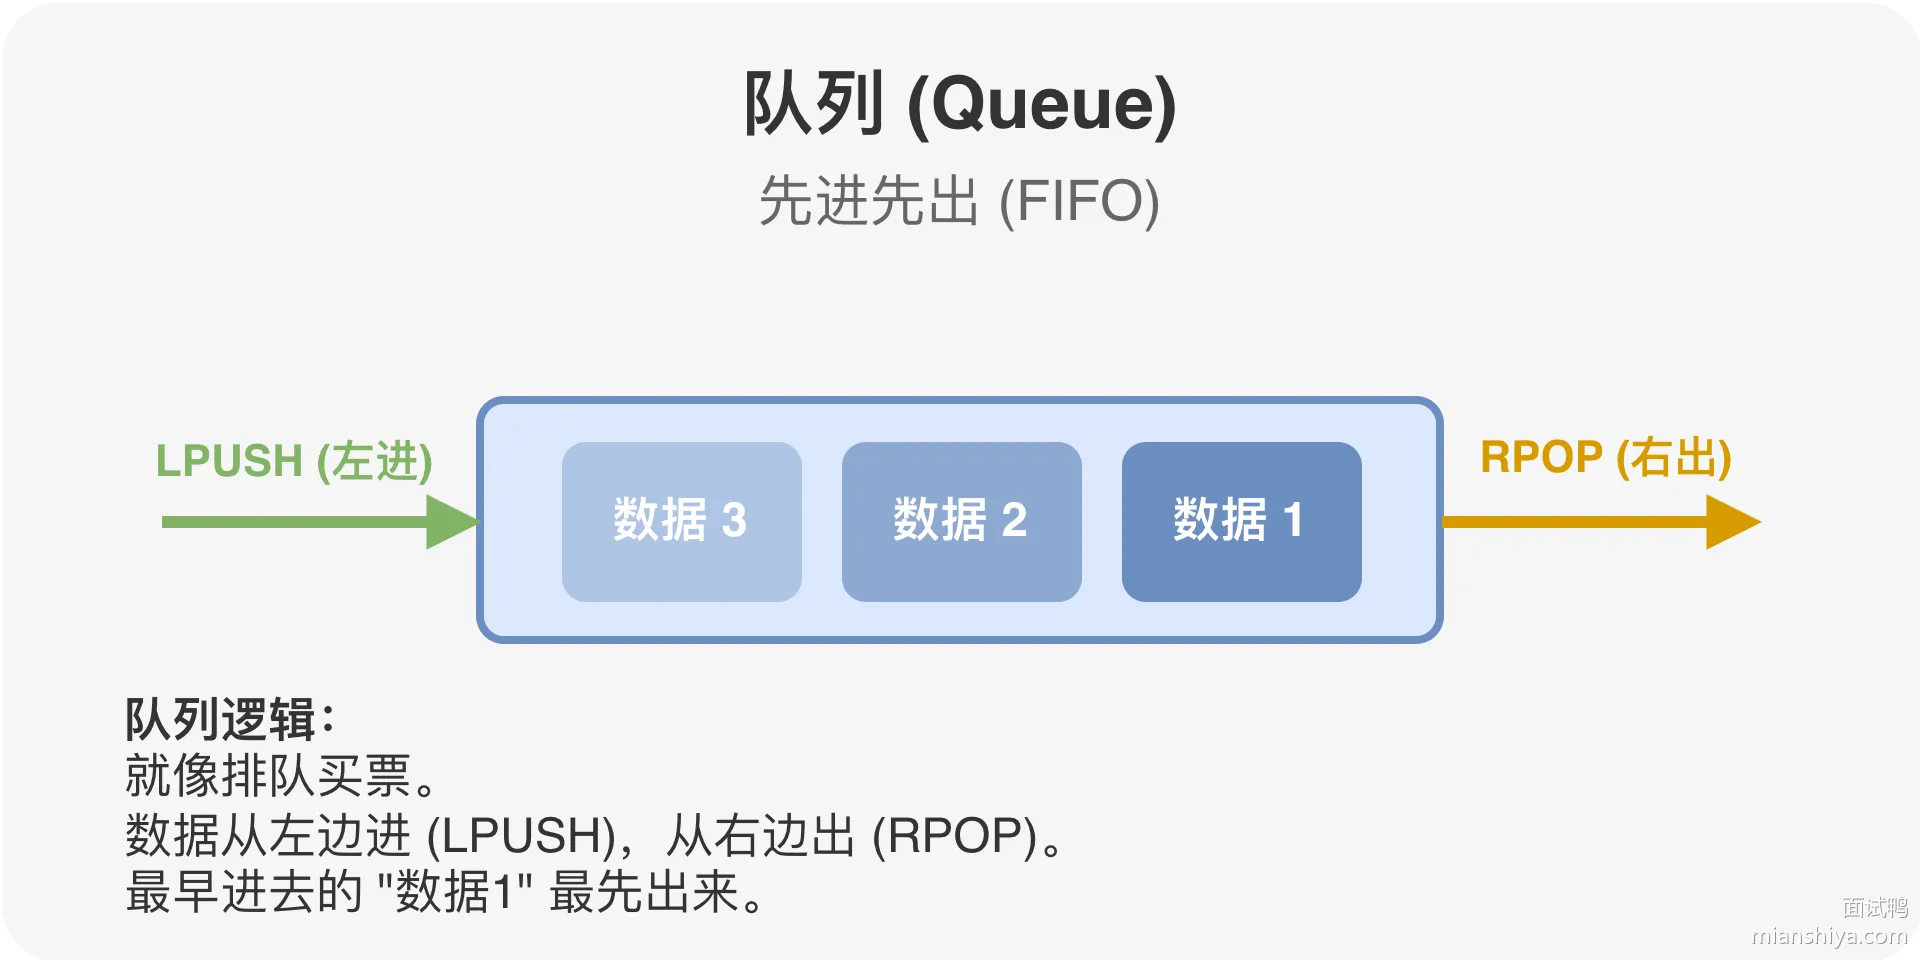
栈是后进先出,LPUSH 从左边塞、LPOP 从左边取,最后塞进去的最先被取出来。
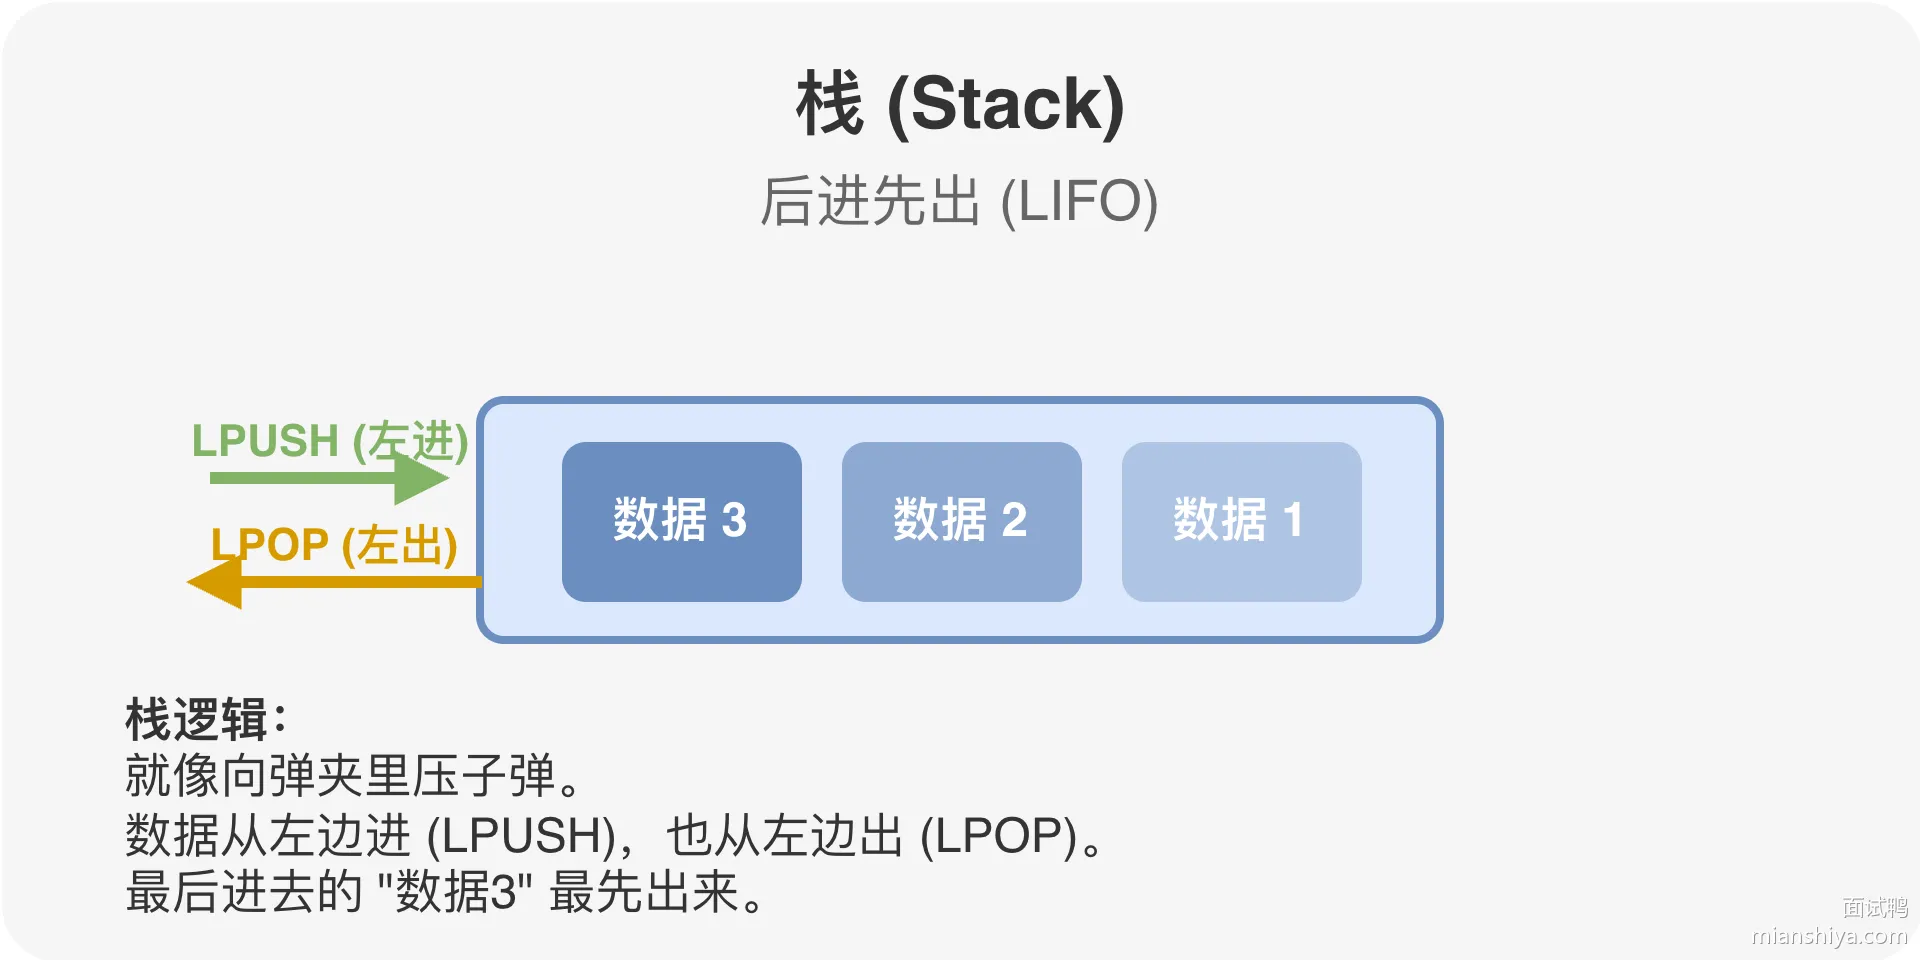
实际操作起来很简单:
# 队列:先进先出
LPUSH myqueue "task1"
LPUSH myqueue "task2"
RPOP myqueue   # 弹出 "task1"

# 栈:后进先出
LPUSH mystack "item1"
LPUSH mystack "item2"
LPOP mystack   # 弹出 "item2"
List 的 LPUSH/RPUSH/LPOP/RPOP 时间复杂度都是 O(1),底层是 quicklist 结构,插入删除非常快,拿来做队列栈再合适不过。
40.2. 扩展知识
40.2.1. 空队列轮询的坑
直接用 RPOP 消费队列有个问题,队列空了就返回 null,业务代码只能死循环去轮询:
while(true) {
    msg = redis.rpop("queue");
    if (msg == null) {
        continue;
    }
    process(msg);
}
队列长时间没消息,这个循环就在那空转,CPU 白白浪费,还疯狂请求 Redis。加个 sleep 呢?消息又有延迟了。
Redis 提供了 BRPOP/BLPOP 这对阻塞命令专门解决这个问题,B 就是 Block 的意思。队列空的时候线程阻塞在那等着,有数据了立马返回,还能设超时时间:
while(true) {
    // 最多等 5 秒,超时返回 null
    msg = redis.brpop("queue", 5);
    if (msg == null) {
        // 超时了,可以干点别的
        continue;
    }
    process(msg);
}
40.2.2. 优先级队列怎么搞
List 只能做普通队列,想要优先级得换 Sorted Set。用 score 表示优先级,分数越小优先级越高:
ZADD priority_queue 1 "low_priority_task"
ZADD priority_queue 0 "high_priority_task"
ZPOPMIN priority_queue  # 弹出 "high_priority_task"
Redis 5.0 加了 ZPOPMIN/ZPOPMAX 命令,专门用来弹出分数最小/最大的元素,实现优先级队列刚刚好。
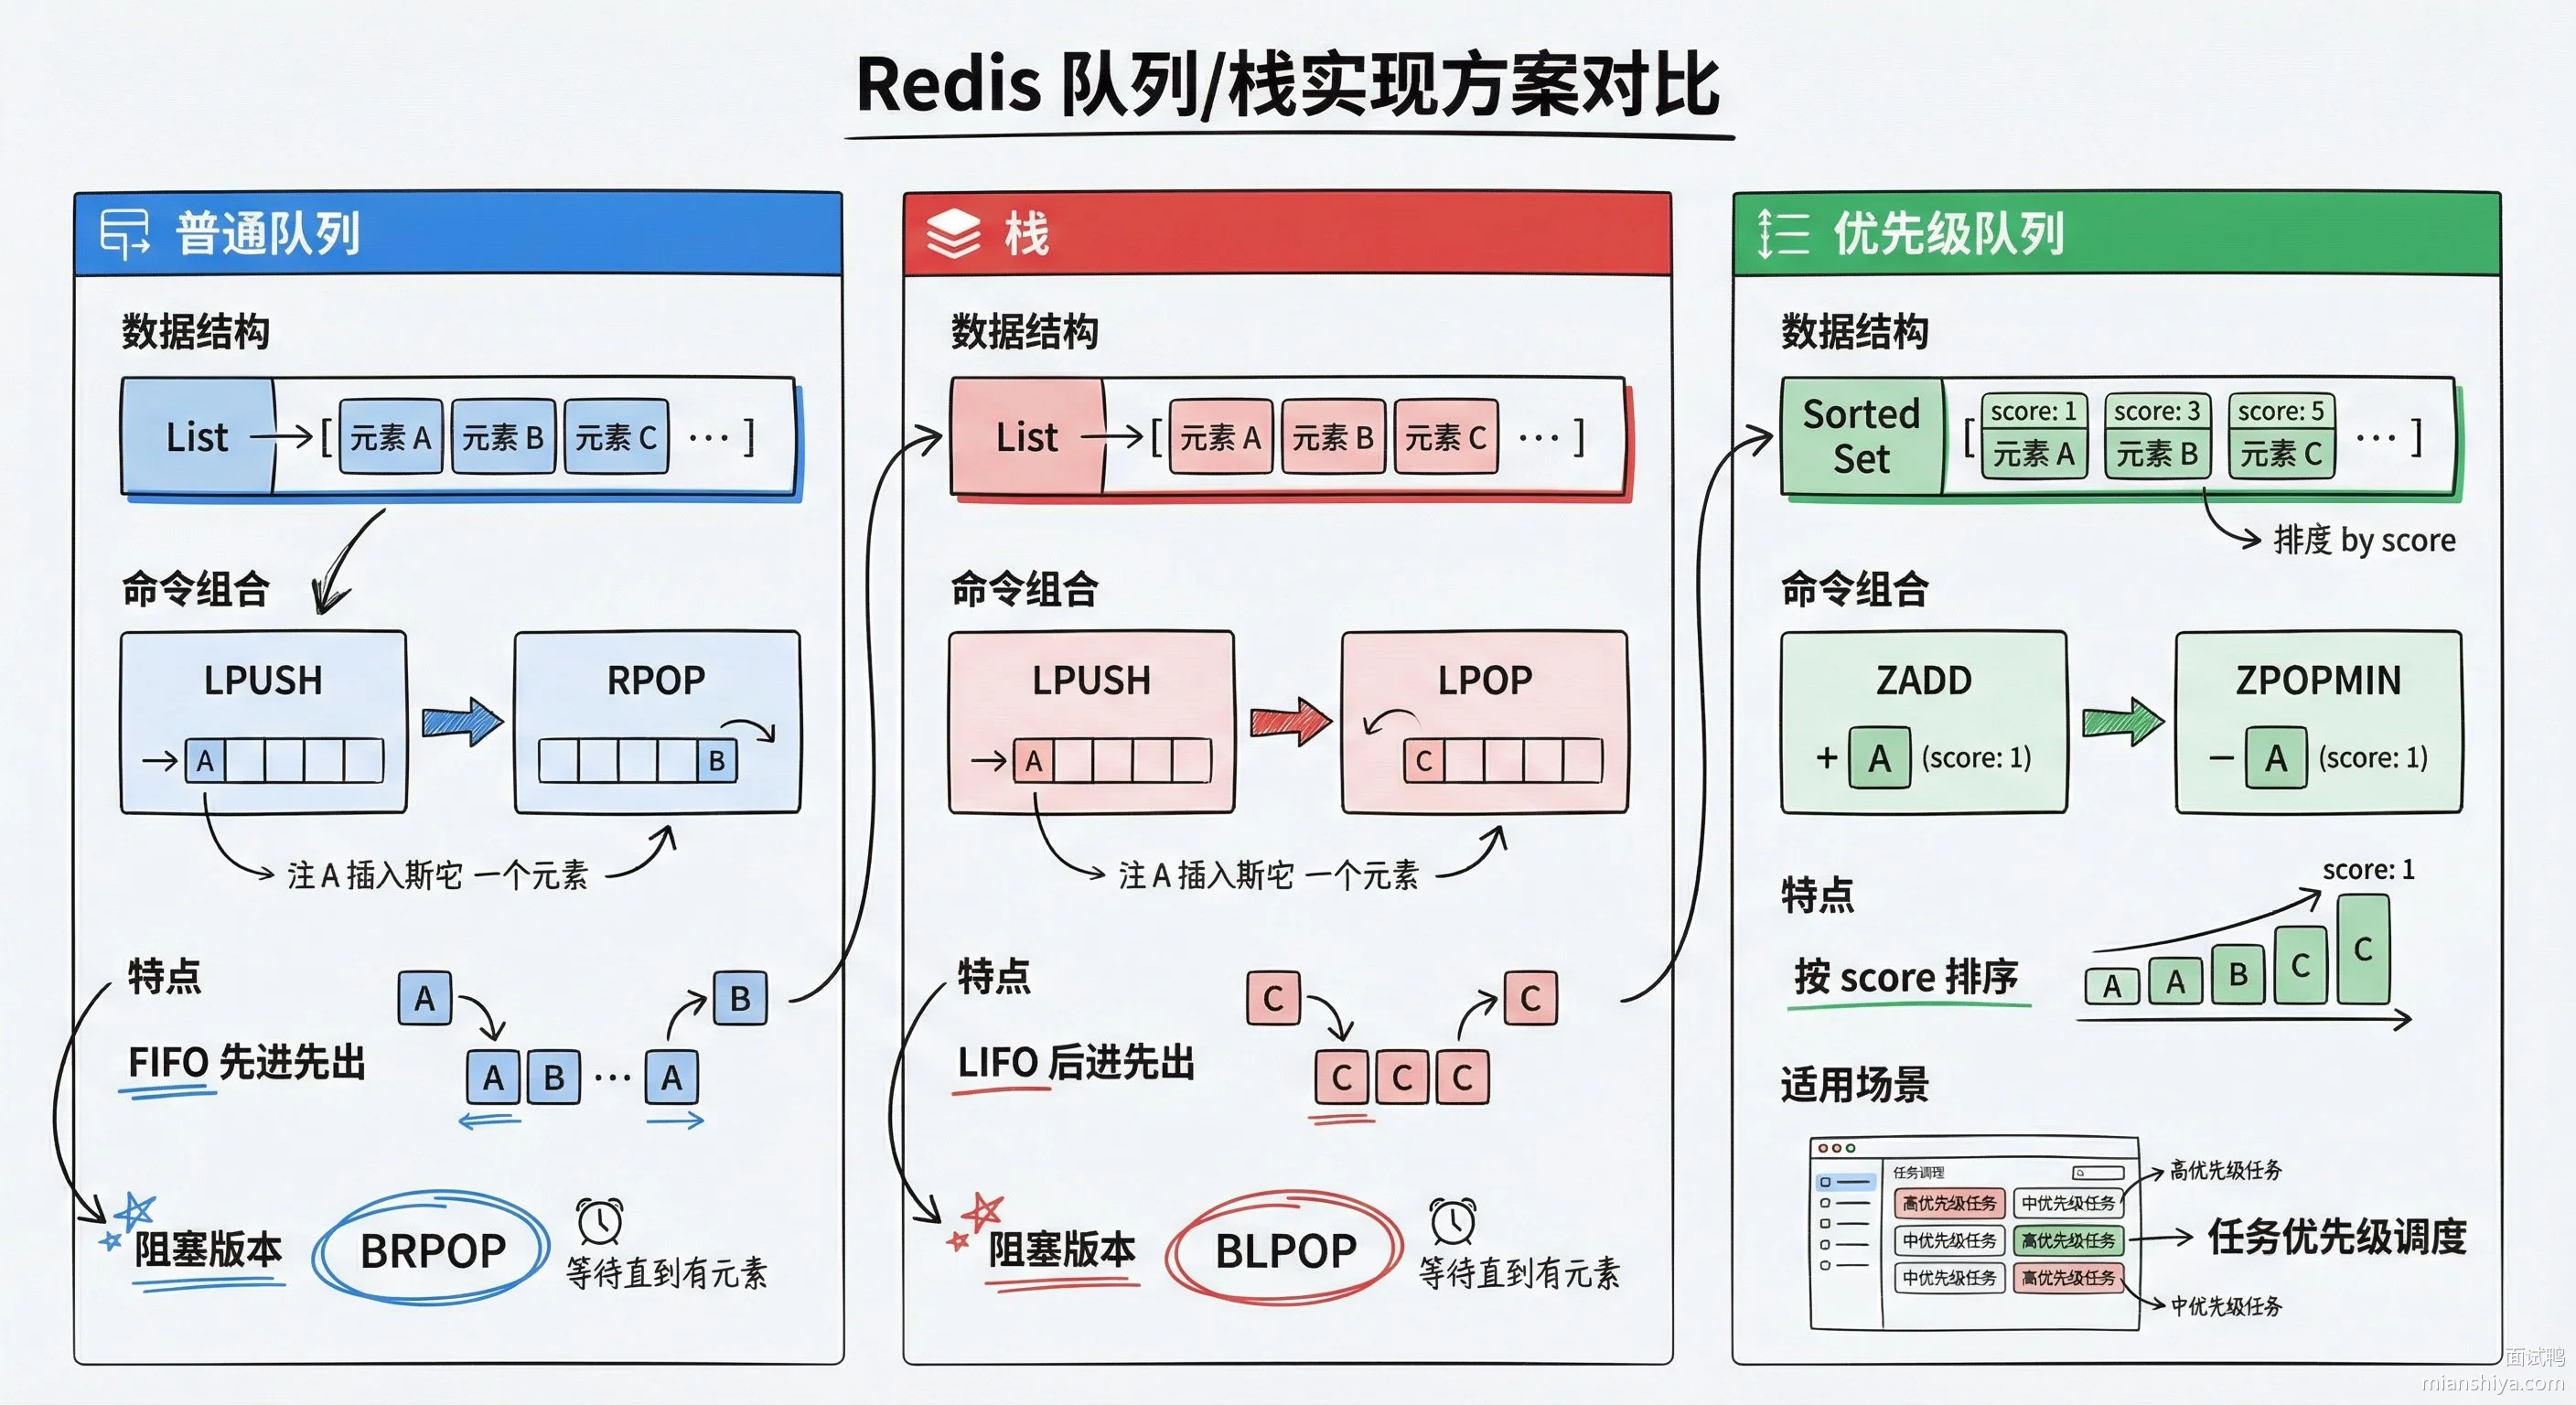
40.2.3. List 做队列的局限性
1)不支持多消费者组。一条消息被一个消费者 POP 走了,别的消费者就拿不到了。想要多个消费者组各自消费同一份数据,List 搞不定
2)没有 ACK 机制。消息被 POP 出去就从 Redis 删了,消费者处理失败消息就丢了。要做可靠消费,得自己加逻辑把消息暂存到另一个 List 里
3)不支持消息回溯。想看看之前消费过的消息?没门,POP 完就没了
这些痛点 Redis 5.0 引入的 Stream 类型都解决了。Stream 支持消费者组、消息确认、消息持久化,功能上接近 Kafka 了。生产环境做消息队列,优先考虑 Stream 或者直接上 RocketMQ、Kafka 这些专业的消息中间件。
40.3. 常见问题
40.3.1. BRPOP 阻塞等待的时候,Redis 连接会不会超时断开?
会的,Redis 客户端连接有个 timeout 配置,默认 0 表示不超时。但实际部署时中间可能有负载均衡器或者防火墙,它们会有自己的空闲连接超时。比如 AWS ELB 默认 60 秒没数据就断连接。解决办法是 BRPOP 的超时时间设短一点,比如 30 秒,超时了重新发起阻塞请求,保持连接活跃。
40.3.2. 用 List 做延迟队列可以吗?
List 本身不支持延迟,但可以配合 Sorted Set 实现。把任务放进 Sorted Set,score 设成执行时间戳,然后起个定时任务用 ZRANGEBYSCORE 捞出到期的任务,再 LPUSH 到 List 里给消费者处理。
40.3.3. LPUSH 和 RPUSH 性能有差别吗?
没差别,都是 O(1)。List 底层是 quicklist,本质上是个双向链表套压缩列表,两头都有指针,从哪边插入都是直接挂上去,不用遍历。
41. Redis 中的 Ziplist 和 Quicklist 数据结构的特点是什么?
41.1. 核心要点
Ziplist 是一块连续内存,把所有元素紧凑地挨在一起存,省内存但不适合存大量数据。
Quicklist 是 Redis 3.2 之后 List 的默认实现,本质是双向链表串起来一堆小的 Ziplist,兼顾了内存效率和操作性能。
Ziplist 的内存布局是这样的:开头有 zlbytes 记录整个压缩列表占多少字节,zltail 记录最后一个节点的偏移量用于快速定位尾部,zllen 记录节点个数,中间是一个个 entry 节点紧密排列,最后用 zlend(0xFF)标记结束。
每个 entry 节点内部又分三部分:pre_entry_length 记录前一个节点的长度用于反向遍历,encoding 记录当前节点的数据类型和长度,content 存实际数据。
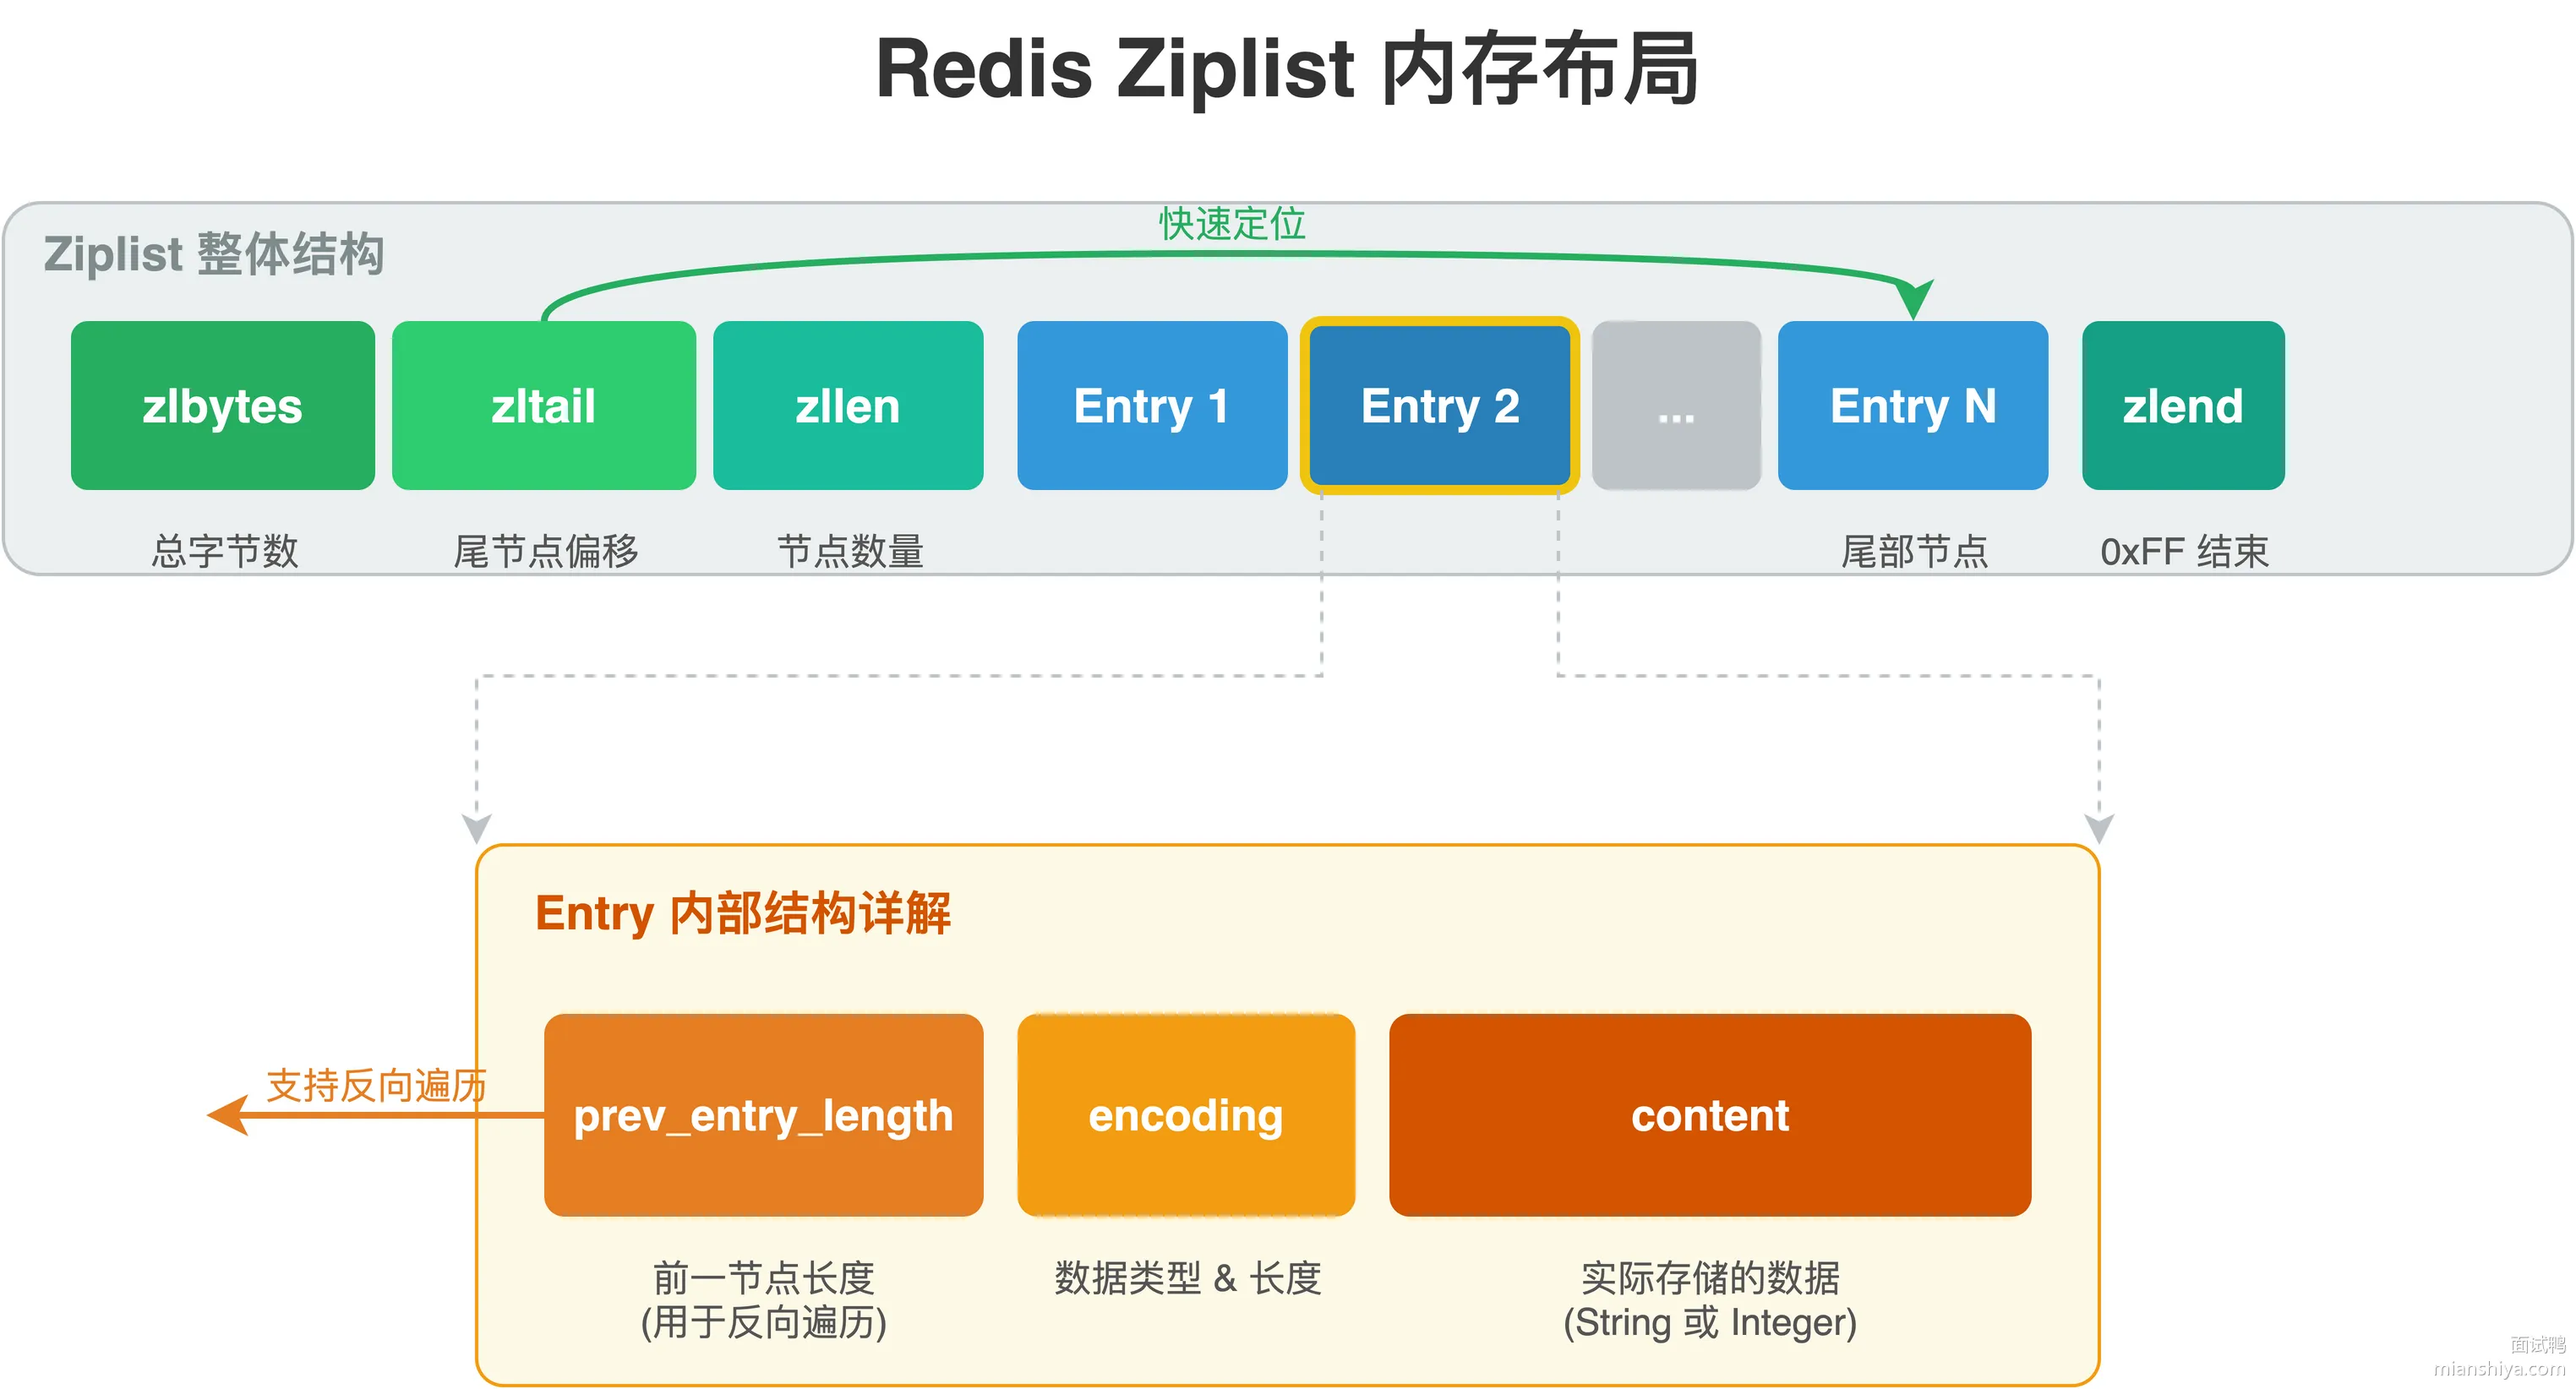
Ziplist 的问题在于,每个 entry 要记录前一个节点的长度。如果前面插入了个大元素,后面那个 entry 的 pre_entry_length 字段就得扩容,它一扩容后面的节点又得跟着变,可能触发连锁更新,极端情况下整条链都得重写一遍。
Quicklist 就是为了解决这个问题,把一大串数据拆成多个小 Ziplist,每个 Ziplist 控制在一定大小内,连锁更新最多影响一小块,不会波及整个列表。
41.2. 扩展知识
41.2.1. Ziplist 在 Redis 里的应用
早期(3.2 之前) Redis 用 Ziplist 来存小规模的 List 和 Hash:
1)List 在元素个数小于 512 个、且每个元素小于 64 字节时,底层用 Ziplist
2)Hash 在键值对数量小于 512 对、且每个 key 和 value 都小于 64 字节时,底层也用 Ziplist
这两个阈值可以通过配置调整:
list-max-ziplist-entries 512
list-max-ziplist-value 64
hash-max-ziplist-entries 512
hash-max-ziplist-value 64
超过阈值就升级成更复杂的数据结构,List 升级成 LinkedList,Hash 升级成 hashtable。
41.2.2. Quicklist 的设计细节
Quicklist 是个双向链表,每个链表节点里装的不是单个元素,而是一整个 Ziplist。这样链表操作是 O(1) 的,同时每个节点内部还享受 Ziplist 的内存紧凑优势。
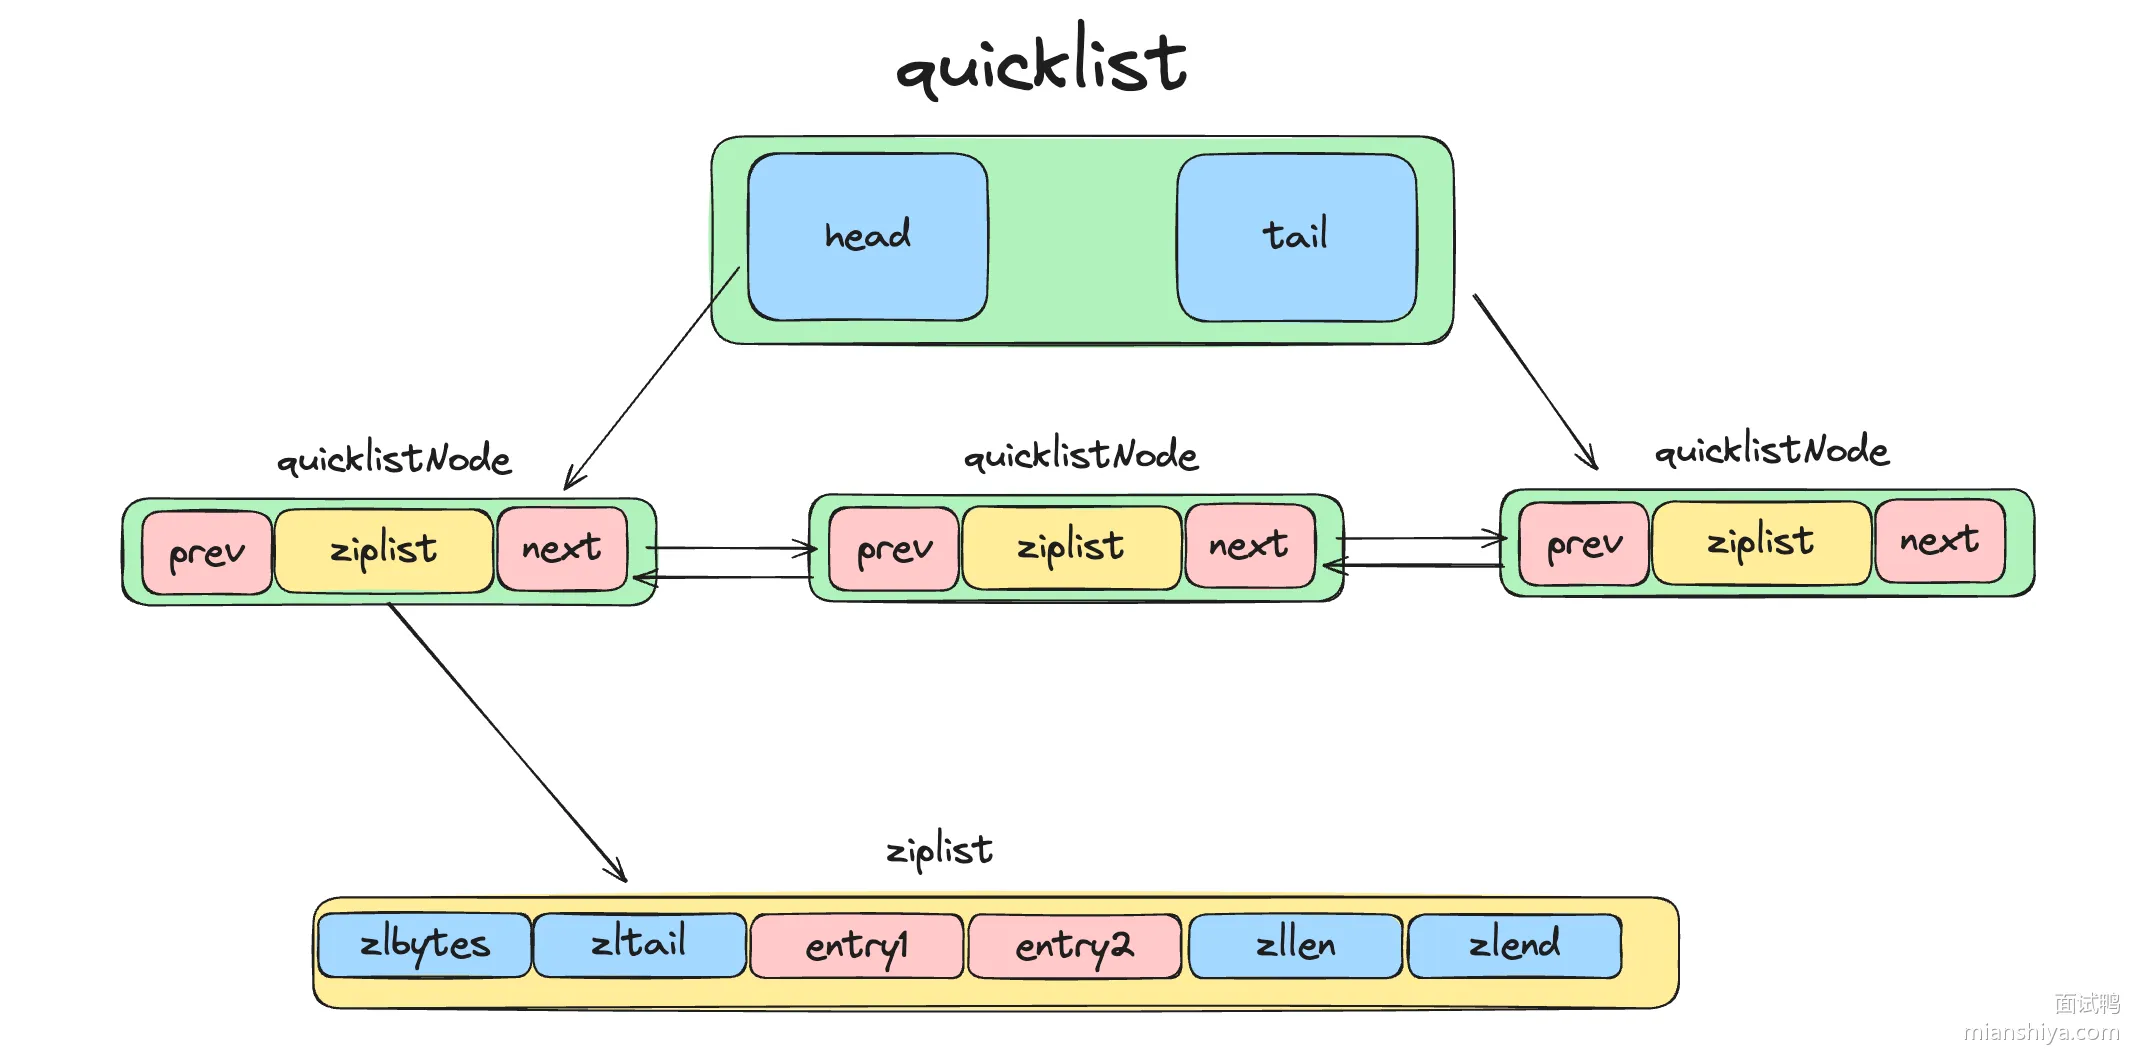
Redis 还支持对 Quicklist 中间节点的 Ziplist 做 LZF 压缩。因为队列两头访问频繁、中间很少碰,把中间的节点压缩掉能再省一波内存。
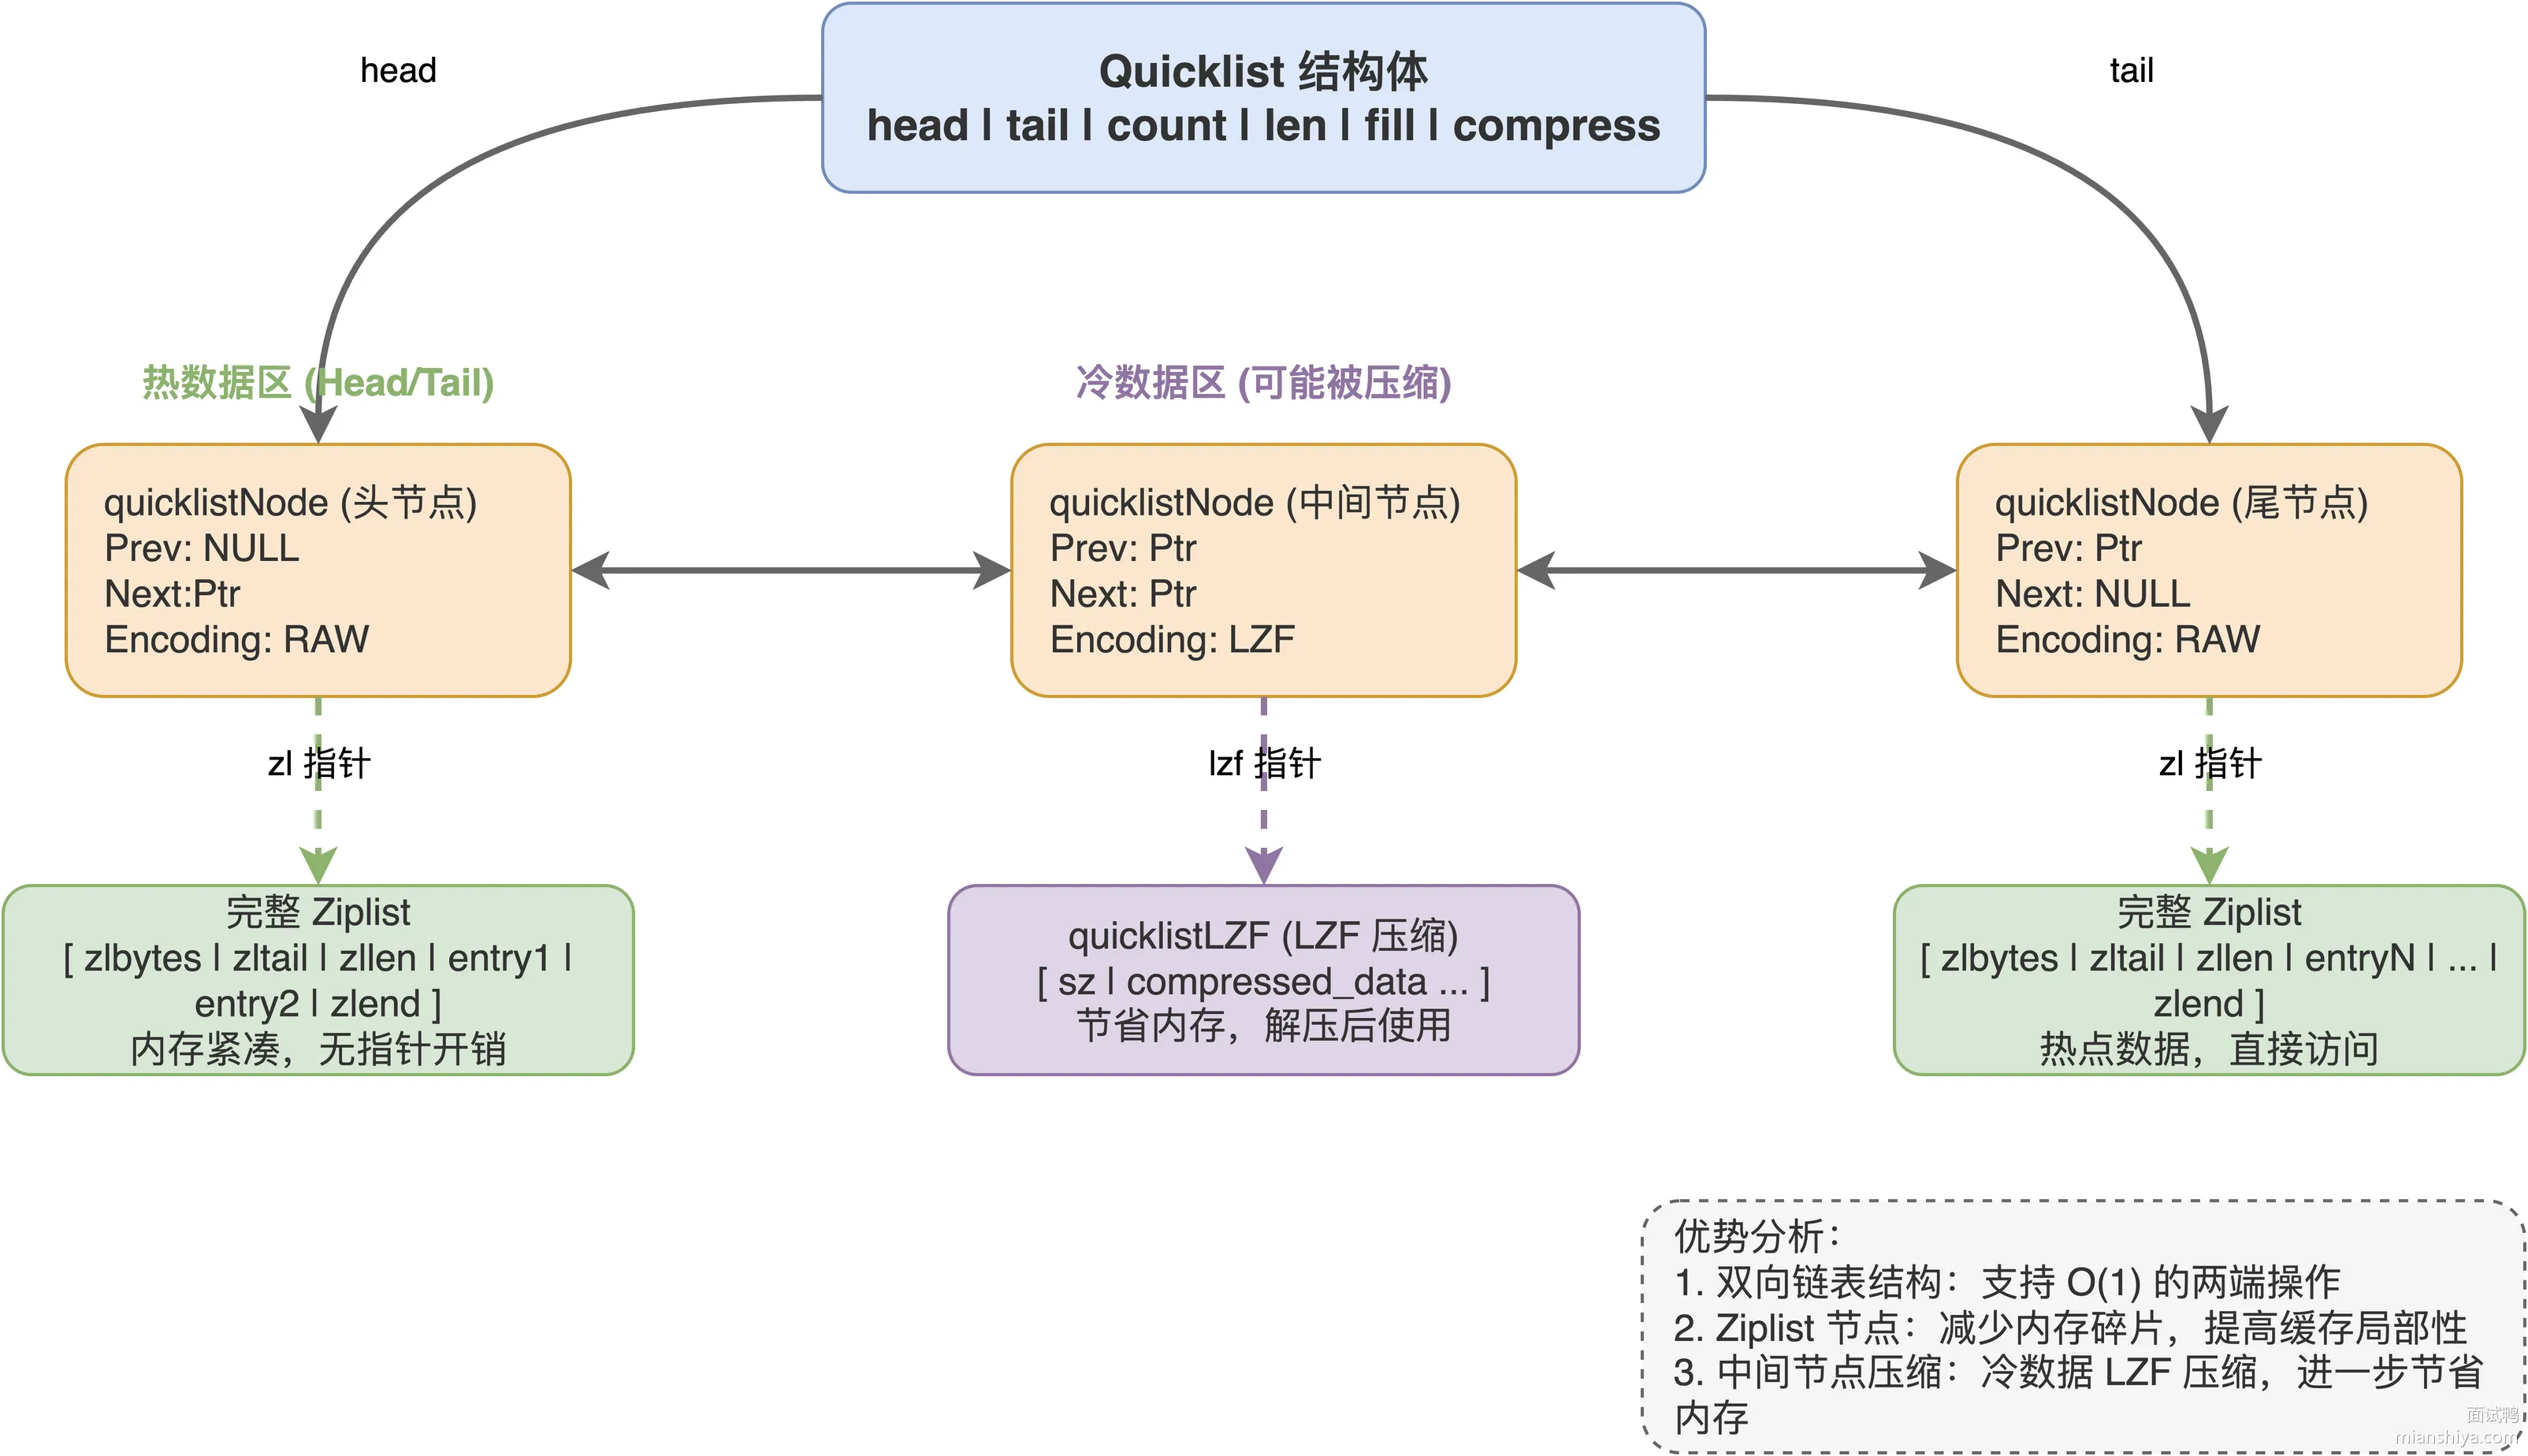
控制 Quicklist 行为的配置有两个:
list-max-ziplist-size -2
list-compress-depth 0
list-max-ziplist-size 控制每个节点内 Ziplist 的大小:
- 正数表示最多存多少个元素
- -1 表示最大 4KB
- -2 表示最大 8KB(默认值)
- -3/-4/-5 分别对应 16KB/32KB/64KB
list-compress-depth 控制两端多少个节点不压缩。0 表示都不压缩,1 表示两端各留 1 个不压缩、中间全压缩。
41.2.3. Redis 7.0 的 Listpack
Redis 7.0 引入了 Listpack 来替代 Ziplist。Listpack 最大的改进是每个节点不再记录前一个节点的长度,而是记录自己的长度,彻底干掉了连锁更新问题。
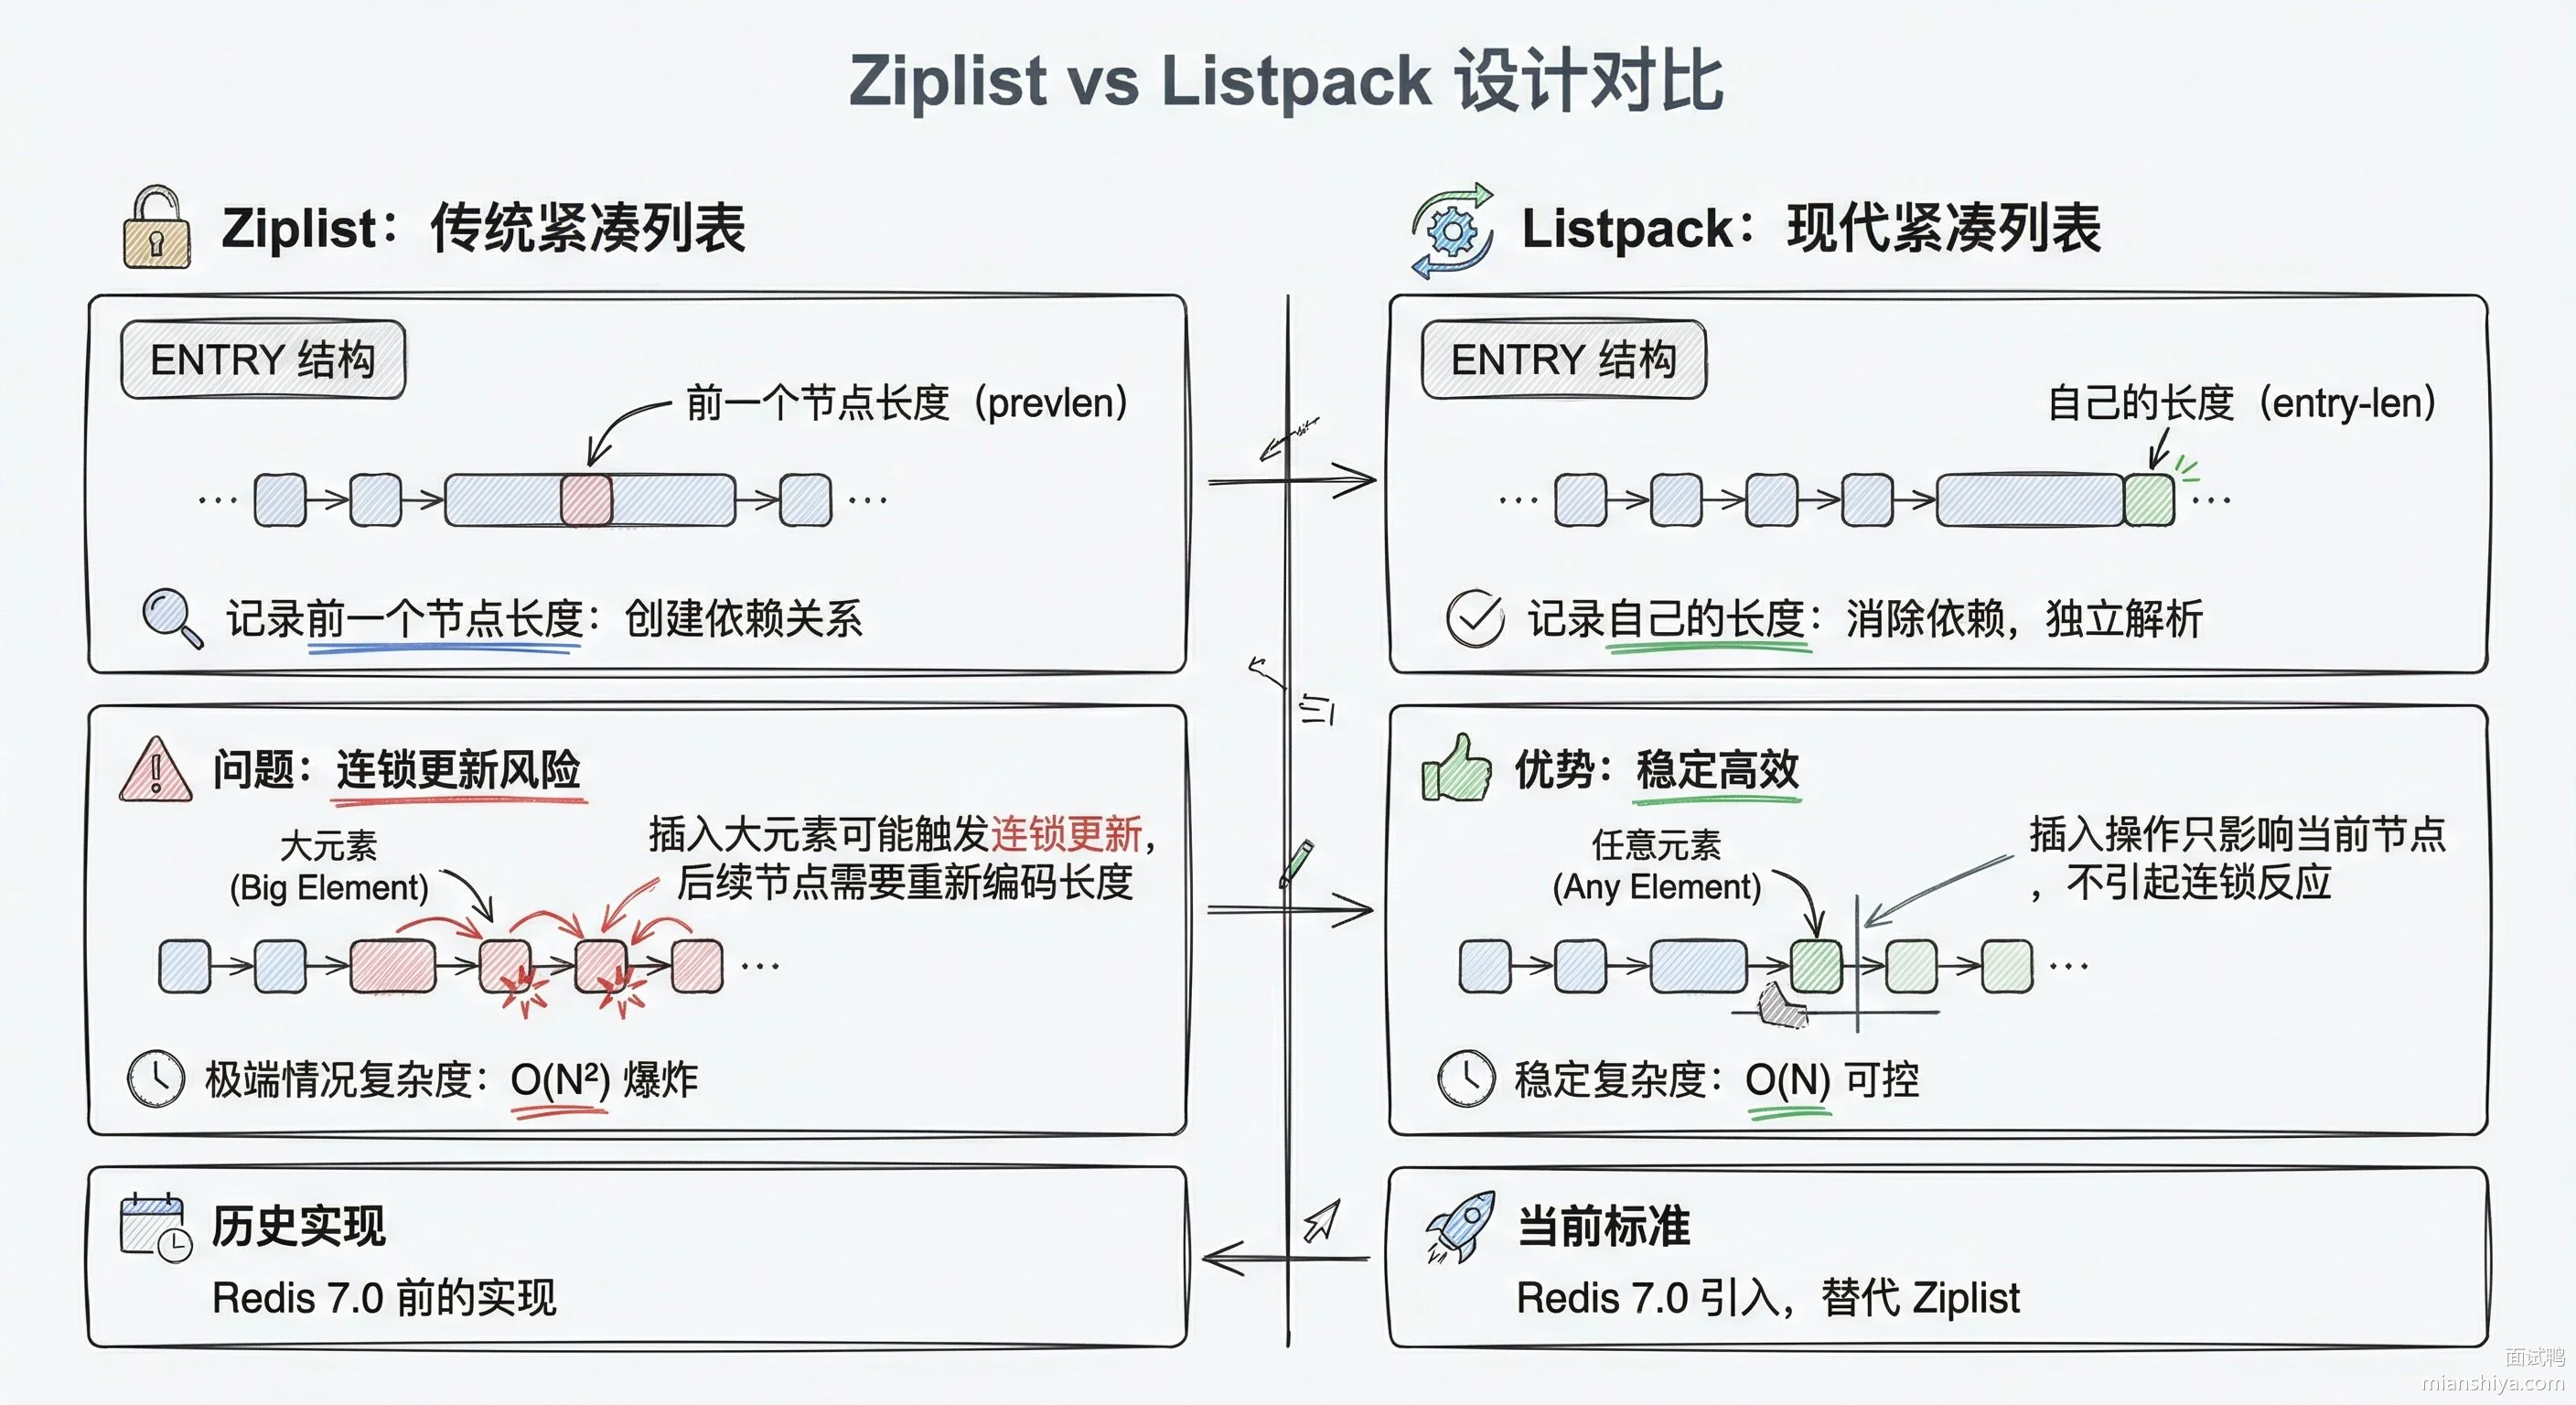
现在 Hash、Set、Sorted Set 在小数据量时都用 Listpack 了,Quicklist 里面装的也从 Ziplist 换成了 Listpack。
41.2.4. 为什么不直接用链表
普通双向链表每个节点除了数据还得存两个指针,64 位系统上一个指针 8 字节,两个就是 16 字节。如果存的数据本身才几个字节,指针开销反而比数据还大,内存利用率很低。
Redis 是内存数据库,对内存敏感度极高。一个有 10 万个小元素的 List,用纯链表光指针就要吃掉 1.6MB,用 Quicklist 能省掉大半。
41.3. 常见问题
41.3.1. ziplist 的连锁更新具体是怎么发生的?
ziplist 每个节点用 1 到 5 字节记录前一个节点的长度。如果前一个节点长度小于 254 字节,用 1 字节记;否则用 5 字节。假设连续多个节点长度都在 250-253 字节之间,某次插入导致第一个节点长度变成 254,后面节点的 prevlen 就得从 1 字节扩到 5 字节,接着又导致下一个节点长度增加,连锁反应一路传下去。
41.3.2. Quicklist 中间节点压缩用的什么算法?
用的 LZF 算法,特点是压缩和解压速度都很快,压缩比中等。Redis 选它是因为中间节点虽然访问少但也不是完全不访问,一旦要访问得快速解压出来,LZF 的解压速度比 zlib、snappy 都快,适合这种场景。
41.3.3. Ziplist 查找某个元素的时间复杂度是多少?
O(N),得从头挨个遍历。Ziplist 本质就是个紧凑数组,没有索引结构,想找某个元素只能顺着 entry 一个个跳过去比对。所以 Ziplist 只适合存少量数据,数据多了查找性能就扛不住了。
42. Redis 复制延迟的常见原因有哪些?
42.1. 核心要点
Redis 主从复制会有延迟,从节点的数据比主节点慢一拍。在读写分离场景下,刚写进去的数据去从节点查可能查不到,这就是复制延迟带来的问题。
常见原因有 5 个:
1)网络问题。带宽不够或者网络抖动,主节点发出去的数据从节点收不到或者收得慢。不过内网环境一般不会有这问题
2)主节点负载太高。大量写操作涌进来,主节点一边处理客户端请求一边给从节点发数据,忙不过来就顾不上复制了
3)复制缓冲区溢出。主节点把写命令暂存在 repl_backlog 里等着发给从节点,从节点处理慢、写入又猛,缓冲区就爆了,从节点只能触发全量复制,延迟直接拉满
4)主节点在做持久化。生成 RDB 快照或者 AOF 重写都是 CPU 和磁盘的大活,这期间复制请求就排队等着
5)从节点配置太差。从节点得接收、解析、写入主节点发来的数据,机器性能跟不上处理速度就慢
42.2. 扩展知识
42.2.1. 复制积压缓冲区原理
主从复制分两种模式:全量复制和增量复制。增量复制依赖一个叫 repl_backlog 的环形缓冲区,主节点把写命令写进去,从节点记住自己同步到哪个位置,下次断开重连就从那个位置继续拉。
问题在于这个缓冲区是环形的,大小固定。如果从节点断线时间太长,它上次同步的位置已经被新数据覆盖了,就只能触发全量复制。全量复制意味着主节点要生成 RDB、传输整个数据集、从节点清空自己再加载,这一套下来延迟能到分钟级。
缓冲区大小通过 repl-backlog-size 配置,默认 1MB,生产环境建议调大:
repl-backlog-size 256mb怎么估算合适的大小?看主节点每秒写入多少数据,乘以你能容忍的最大断线时间。比如每秒写入 2MB,允许断线 2 分钟,那至少要 2MB × 120s = 240MB。
42.2.2. 复制延迟的监控
用 INFO replication 命令可以看从节点的复制状态:
redis-cli INFO replication重点关注这几个指标:
1)master_repl_offset 和 slave_repl_offset 的差值,差值越大说明延迟越严重
2)master_link_down_since_seconds,如果不是 0 说明主从连接断了
3)slave_read_repl_offset,从节点已经读到的复制偏移量
可以写个脚本定时采集主从节点的 offset 差值,超过阈值就告警。比如差值超过 10MB 或者持续 30 秒差值在增长,就说明复制跟不上了。
42.2.3. 延迟优化手段
从根源上说,复制延迟的本质是主节点产生数据的速度超过了从节点消费的速度。优化方向:
1)减少主节点写入压力。大批量写入拆成小批次,避免一次性灌入太多数据
2)调大复制缓冲区。repl-backlog-size 和 client-output-buffer-limit slave 都要调
3)从节点和主节点同机房部署。跨机房网络延迟动辄几十毫秒,能同机房就同机房
4)不要在主节点做持久化。让从节点来承担 RDB/AOF 的活,主节点关掉 save 配置
5)升级从节点配置。特别是磁盘,用 SSD 替换 HDD,IO 能力能差 10 倍
6)控制从节点数量。一个主节点别挂太多从节点,从节点多了可以用级联复制,让从节点再挂从节点
42.2.4. 相关题目
42.3. 常见问题
42.3.1. 读写分离场景下,怎么保证读到的数据是最新的?
几种方案。第一种是关键业务强制读主库,比如刚下完单立马查订单详情,这种直接走主库。第二种是写入后带上版本号或时间戳,读的时候比对版本,发现从库数据旧就降级读主库。第三种是用 WAIT 命令,写入后阻塞等至少一个从节点同步完成再返回,但这会牺牲写入性能。
42.3.2. 从节点能不能承担写请求?
默认不行,从节点是 read-only 的,写请求直接报错。可以改配置 replica-read-only no 允许写,但写进去的数据会被下一次主节点同步覆盖掉,没有实际意义。唯一的用途是临时调试或者做一些不需要持久化的本地计算。
42.3.3. 主节点挂了,从节点的复制积压缓冲区还有用吗?
没用了,积压缓冲区是主节点维护的。主节点挂了如果用哨兵自动故障转移,新主节点会有自己的积压缓冲区,其他从节点得重新建立复制关系,可能触发全量复制。Redis 的复制是以主节点为中心的,主节点一换整个复制链路都要重建。
43. Redis 事务与关系型数据库事务的主要区别是什么?
43.1. 核心要点
Redis 事务和关系型数据库事务压根就不是一回事。关系型数据库讲究 ACID,而 Redis 的事务只能算是批量执行命令的机制,连回滚都没有。
先看关系型数据库事务的 ACID:
1)原子性:事务里的操作要么全成功,要么全失败回滚,不存在中间状态
2)一致性:事务执行完数据库还是保持一致的,不会出现数据错乱
3)隔离性:多个事务并发执行互不干扰,还能设置不同隔离级别
4)持久性:事务一旦提交,数据就永久保存了,断电也丢不了
再看 Redis 事务对 ACID 的支持情况:
1)原子性:Redis 事务只保证命令连续执行,中间不被打断。但如果某条命令执行失败,后面的命令照样跑,已执行的也不会回滚
2)一致性:没有回滚机制就没法保证一致性,中间出错数据就乱了
3)隔离性:Redis 是单线程执行命令的,事务执行期间别的命令插不进来,天然串行化。但没有隔离级别可选,就这一种模式
4)持久性:取决于 RDB 或 AOF 的配置,理论上还是可能丢数据的
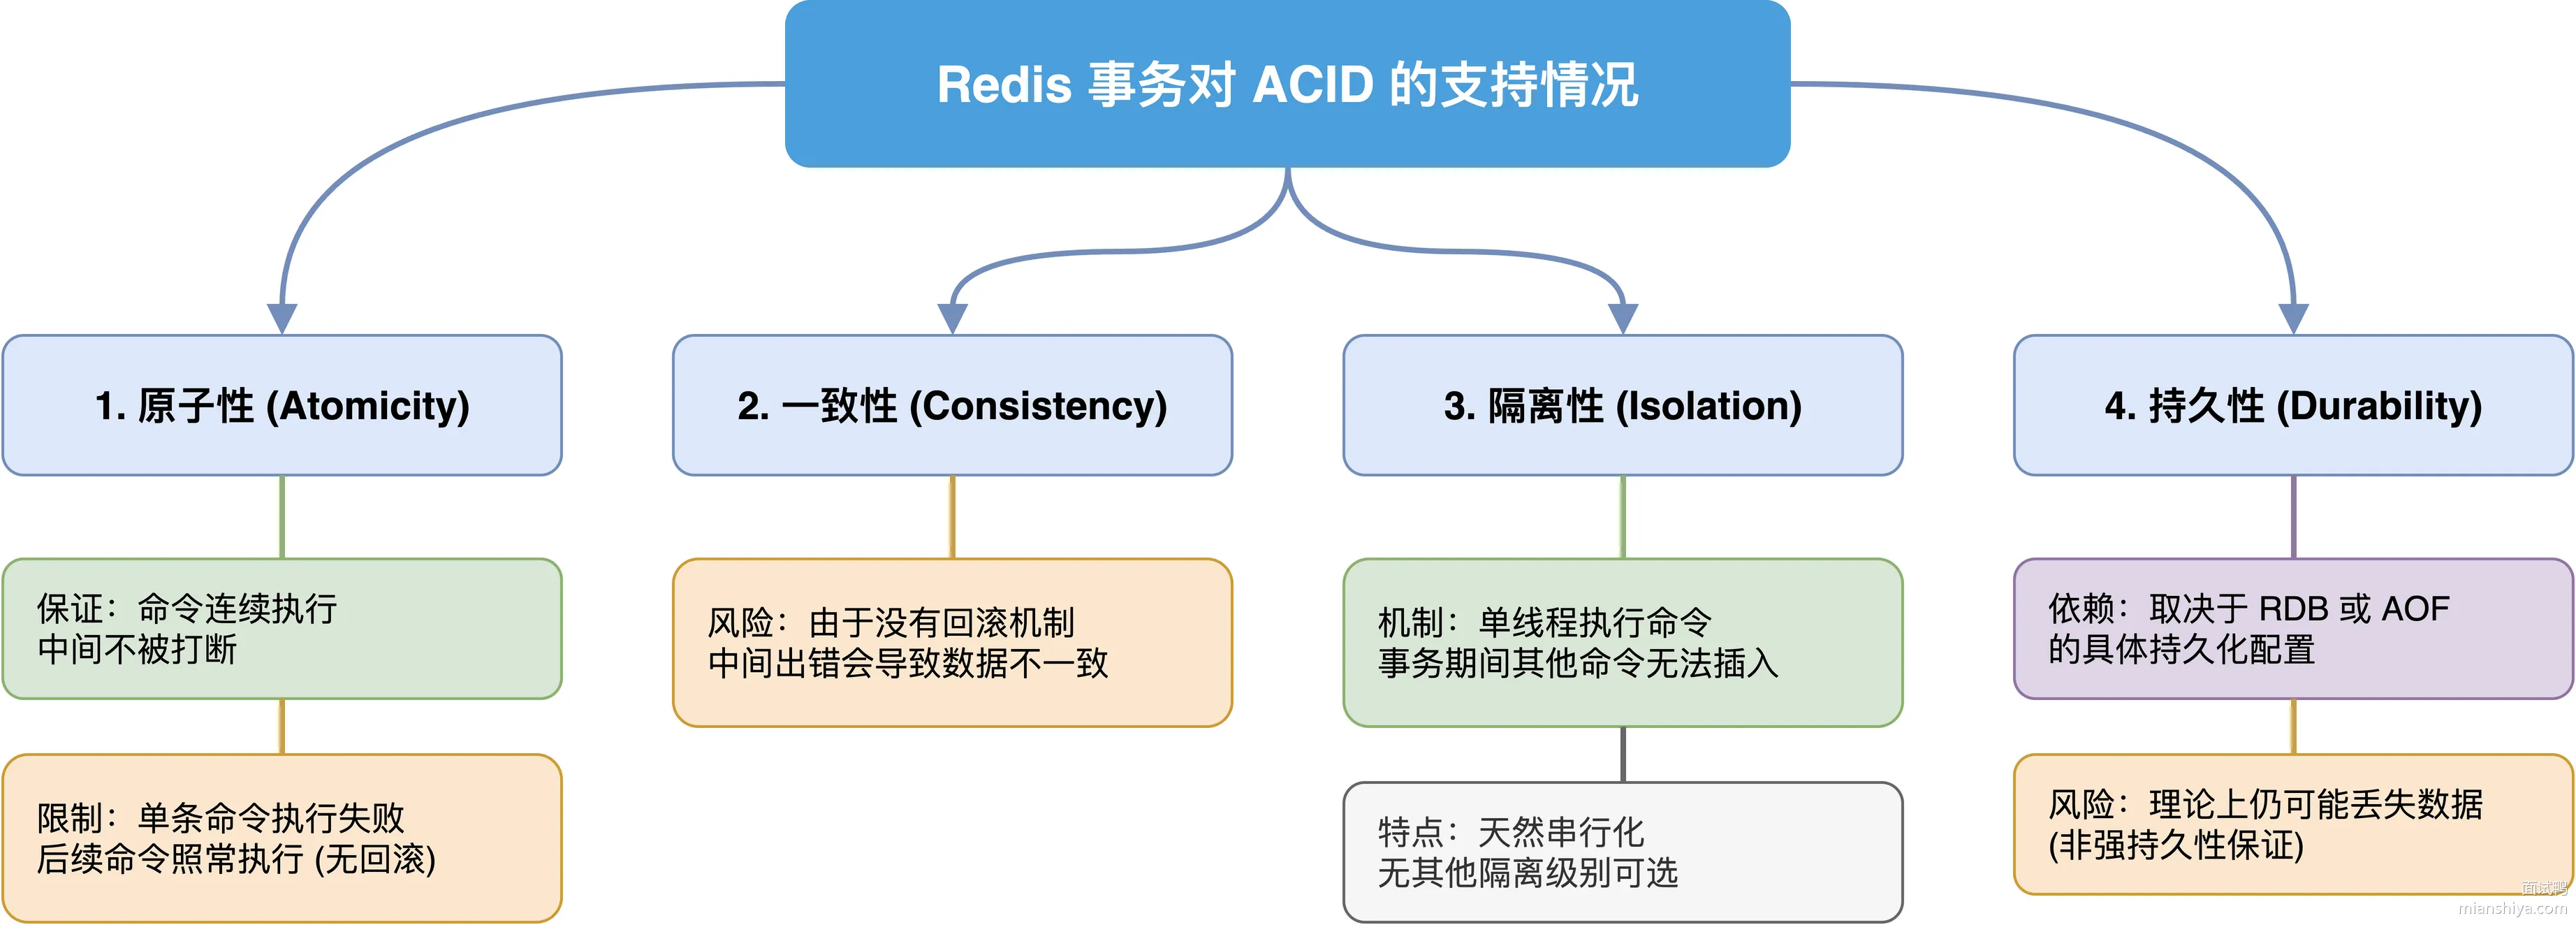
43.2. 扩展知识
43.2.1. Redis 事务的工作机制
Redis 事务靠 MULTI、EXEC、DISCARD、WATCH 这四个命令撑起来。
MULTI 开启事务后,后续发的命令都不会立即执行,而是先进入一个队列里排队。等执行 EXEC 的时候,队列里的命令才会一口气跑完,中间不会被其他客户端的命令插队。
DISCARD 用来放弃事务,清空队列里的命令。
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> SET user:1:name "zhangsan"
QUEUED
127.0.0.1:6379> SET user:1:age 25
QUEUED
127.0.0.1:6379> EXEC
1) OK
2) OK
43.2.2. 为什么 Redis 不支持回滚
Redis 作者 antirez 在官方文档里解释过这个设计决策:
1)Redis 命令出错只有两种情况:语法错误在入队时就能发现,类型错误说明是程序 bug。这两种情况都不应该出现在生产环境
2)不支持回滚让 Redis 保持简单高效。如果要实现回滚,就得记录 undo log,内存开销和代码复杂度都会上去
3)Redis 定位是高性能缓存,不是关系型数据库,没必要搞那么复杂
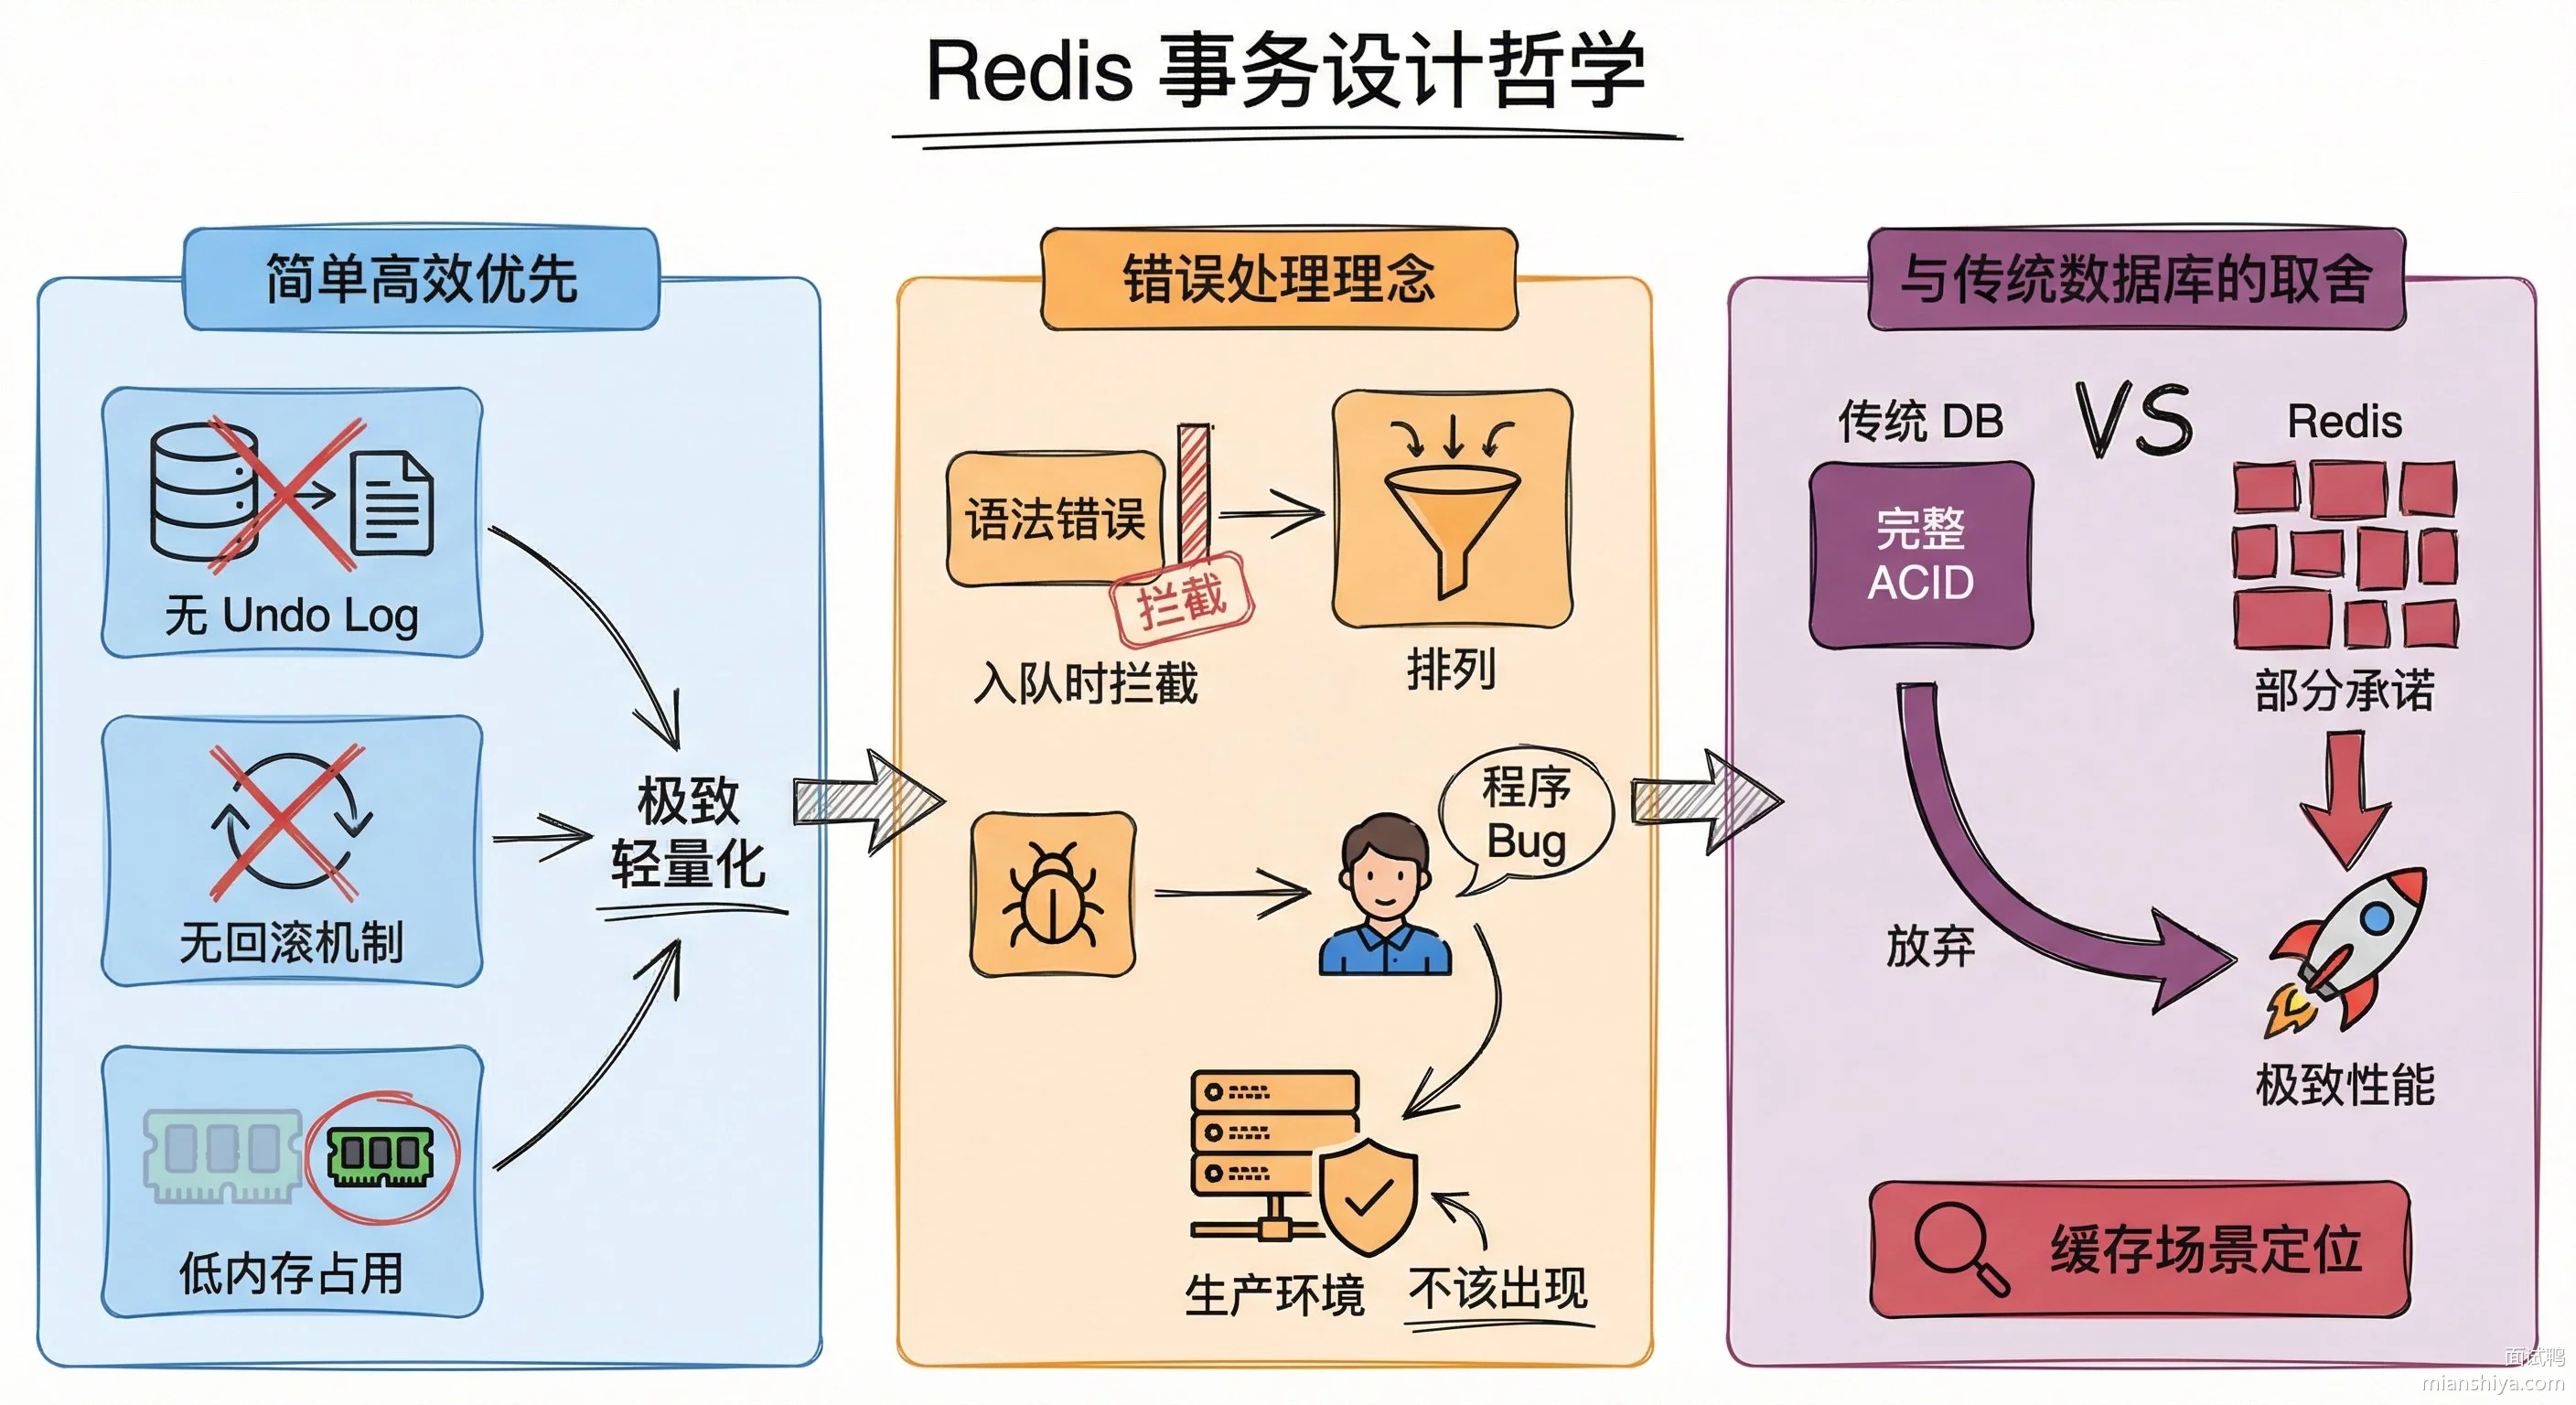
43.2.3. WATCH 实现乐观锁
WATCH 命令能监控一个或多个 key,如果在 EXEC 执行前这些 key 被别的客户端改了,整个事务就会被打断,EXEC 返回 nil。
这就是典型的乐观锁思路:先不加锁,提交时再检查有没有冲突。
127.0.0.1:6379> WATCH balance
OK
127.0.0.1:6379> GET balance
"100"
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> DECRBY balance 50
QUEUED
127.0.0.1:6379> EXEC
# 如果 balance 在 WATCH 后被其他客户端修改了,这里返回 nil
实际业务中,比如扣库存的场景,用 WATCH 配合重试逻辑就能实现 CAS 操作。
43.2.4. 需要强事务怎么办
如果业务确实需要回滚和强一致性,有几个方案:
1)用 Lua 脚本。Lua 脚本在 Redis 里是原子执行的,可以在脚本里自己实现补偿逻辑
2)业务层做补偿。把操作拆成多个步骤,失败了自己写代码把数据改回去
3)换数据库。真需要 ACID 就别硬用 Redis,老老实实用 MySQL、PostgreSQL
43.3. 常见问题
43.3.1. Redis 事务中某条命令执行失败了,后面的命令还会执行吗?
详细解答可以看:Redis 支持事务吗?如何实现?
会继续执行。Redis 事务不支持回滚,失败的命令就当没执行成功,后面的命令照常跑。比如对字符串执行 INCR 会报类型错误,但后面的 SET 命令还是会成功。
43.3.2. WATCH 监控的 key 在事务执行过程中被改了怎么办?
详细解答可以看:Redis 支持事务吗?如何实现?
WATCH 只检查 EXEC 执行前的状态。如果在 MULTI 之前 key 被改了,EXEC 会返回 nil,事务不执行。如果是在 EXEC 执行过程中被改的,那没办法检测,因为这时候事务已经在跑了。
43.3.3. Lua 脚本和 MULTI/EXEC 事务有什么区别?
详细解答可以看:Redis 的 Lua 脚本功能是什么?如何使用?
Lua 脚本更强大。事务只是把命令打包执行,脚本可以写逻辑判断和循环。脚本里能根据前一条命令的结果决定后面怎么做,事务做不到这点。性能上脚本也更好,只需要一次网络往返。
43.3.4. Redis 7.0 引入的 Redis Functions 和 Lua 脚本有什么区别?
Functions 是脚本的升级版。脚本每次执行都要传完整代码,Functions 可以预先加载到 Redis 里,调用时只传函数名和参数。Functions 还支持持久化,重启后不用重新加载。另外 Functions 有更好的集群支持,脚本在集群模式下有些坑。
44. Redis Cluster 模式与 Sentinel 模式的区别是什么?
44.1. 核心要点
一句话说清楚:Sentinel 只管故障转移,Cluster 既管故障转移又管数据分片。
Sentinel 是哨兵模式,专门盯着主从复制架构里的主节点。主节点挂了,哨兵会把某个从节点提升为新主节点,保证服务不中断。但数据还是全量存在每个节点上,没法水平扩展。
Cluster 是官方的集群方案,把数据自动打散到多个节点上存储,每个节点只存一部分数据。同时 Cluster 内置了类似哨兵的故障检测和自动故障转移机制,某个主节点挂了,它的从节点会自动顶上,不需要额外部署哨兵。
选型建议:
1)数据量不大,单机能扛住,只是想要高可用,用主从 + Sentinel。架构简单,运维成本低
2)数据量大,单机内存不够用,或者写入压力太大需要分散,用 Cluster。能水平扩展,加节点就能扩容
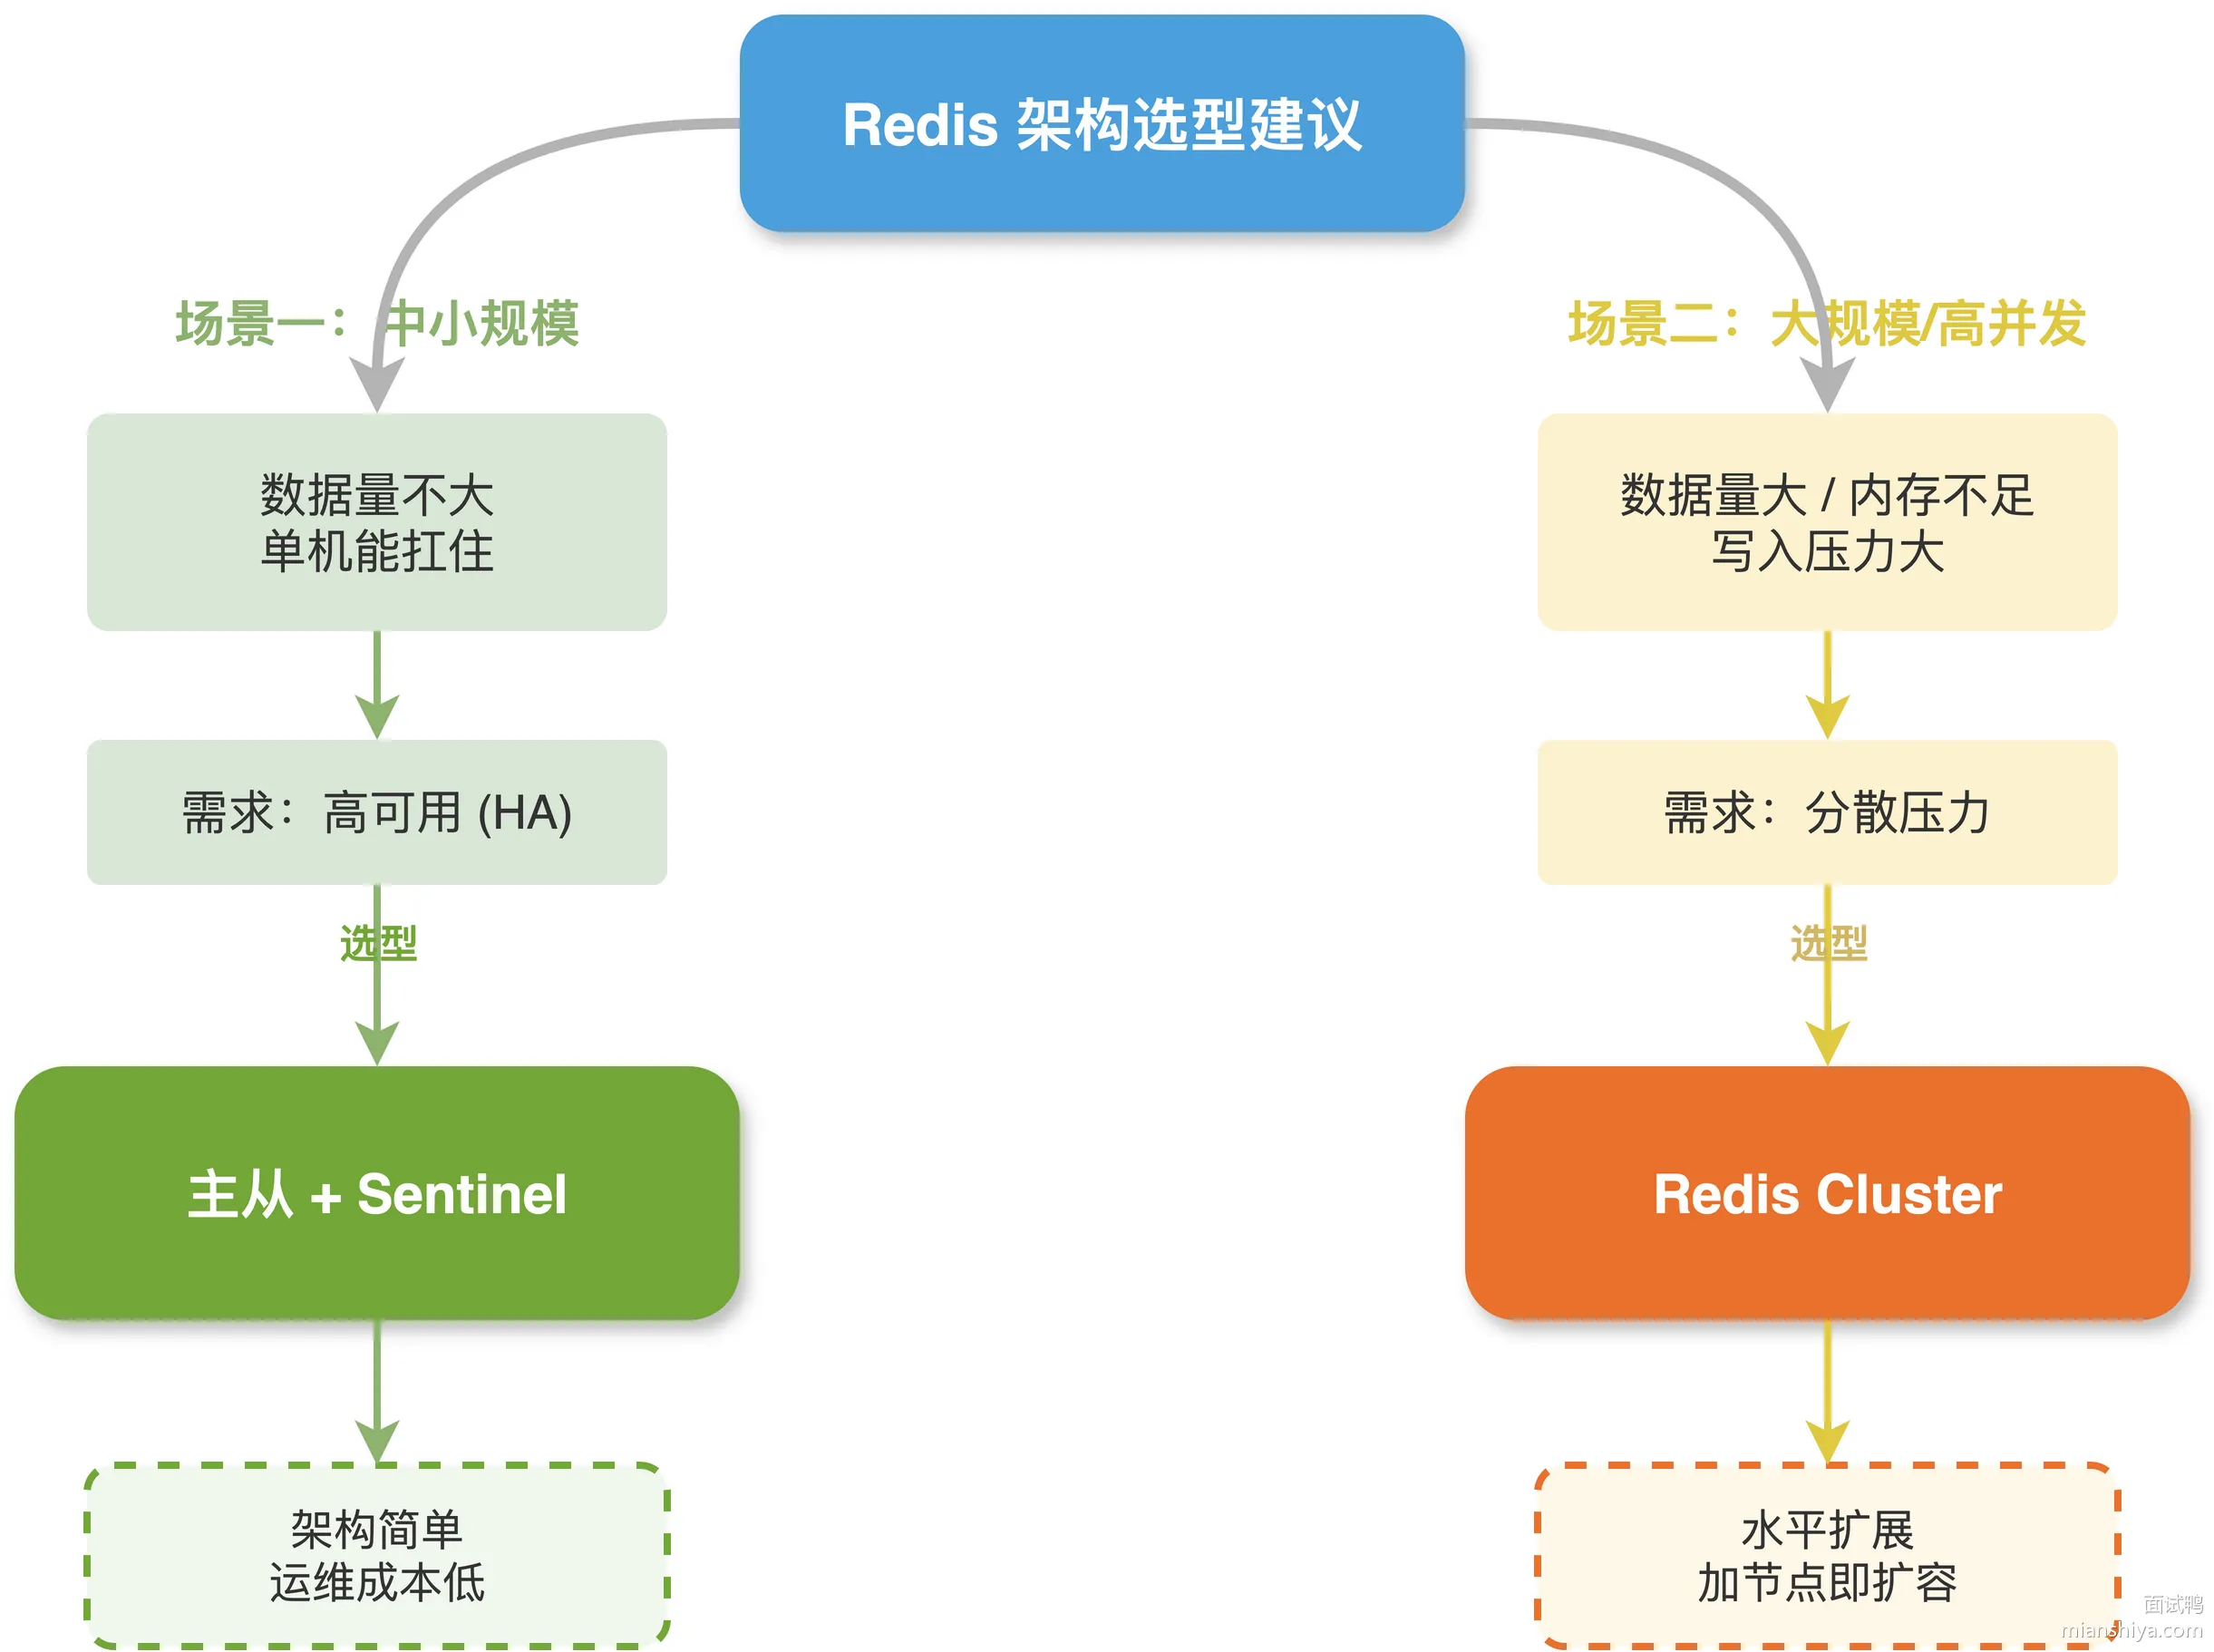
44.2. 扩展知识
44.2.1. Sentinel 的工作原理
Sentinel 本质上是一组独立的监控进程,一般部署 3 个或 5 个,它们干三件事:
1)监控:每个 Sentinel 每秒给主从节点发 PING,检测是否存活
2)通知:主节点状态变化时,Sentinel 通过发布订阅机制通知客户端
3)故障转移:主节点挂了,Sentinel 们投票选出新主节点
Sentinel 判断主节点挂了需要达成共识。先是单个 Sentinel 主观认为下线,然后询问其他 Sentinel,超过 quorum 数量的 Sentinel 都认为挂了,才会触发故障转移。这能防止网络抖动导致的误判。
44.2.2. Cluster 的数据分片
Cluster 用哈希槽来分片,一共 16384 个槽,每个主节点负责一部分槽。key 通过 CRC16 算法算出哈希值,再对 16384 取模,落到对应的槽上。
slot = CRC16(key) % 16384比如 3 主 3 从的集群,槽的分配可能是:
| 节点 | 槽范围 |
|---|---|
| Master 1 | 0-5460 |
| Master 2 | 5461-10922 |
| Master 3 | 10923-16383 |
客户端第一次访问时会拉取槽和节点的映射关系缓存到本地,后续直接算出 key 在哪个节点,直连过去。如果算错了,节点会返回 MOVED 重定向,告诉客户端正确的节点地址。
44.2.3. Cluster 的故障转移
Cluster 里每个节点都会互相发 PING 探测存活状态,采用 Gossip 协议传播集群信息。
某个节点检测到另一个节点 PING 不通,会把它标记为 PFAIL。当集群里超过半数的主节点都认为某节点 PFAIL,就升级为 FAIL,触发故障转移。
故障转移流程:
1)挂掉的主节点的从节点们发起选举
2)其他主节点投票,得票超过半数的从节点当选新主节点
3)新主节点广播自己的身份,接管原来的哈希槽
整个过程全自动,不需要人工介入,也不需要额外的哨兵进程。
44.2.4. 两种模式的局限性
Sentinel 的问题:
1)不能分片,数据量受单机内存限制。比如服务器 64G 内存,Redis 最多也就用到 50G 左右
2)写入只能走主节点,写压力大的场景扛不住
Cluster 的问题:
1)不支持跨槽的事务和 Lua 脚本。比如 MGET 的 key 落在不同节点上会报错,得用 hash tag 把相关 key 强制分到同一个槽
2)运维复杂度更高。扩缩容要做槽迁移,虽然 Redis 7.0 改进了不少,但还是比主从架构麻烦
3)客户端要支持 Cluster 协议。老版本的客户端可能不支持,需要升级
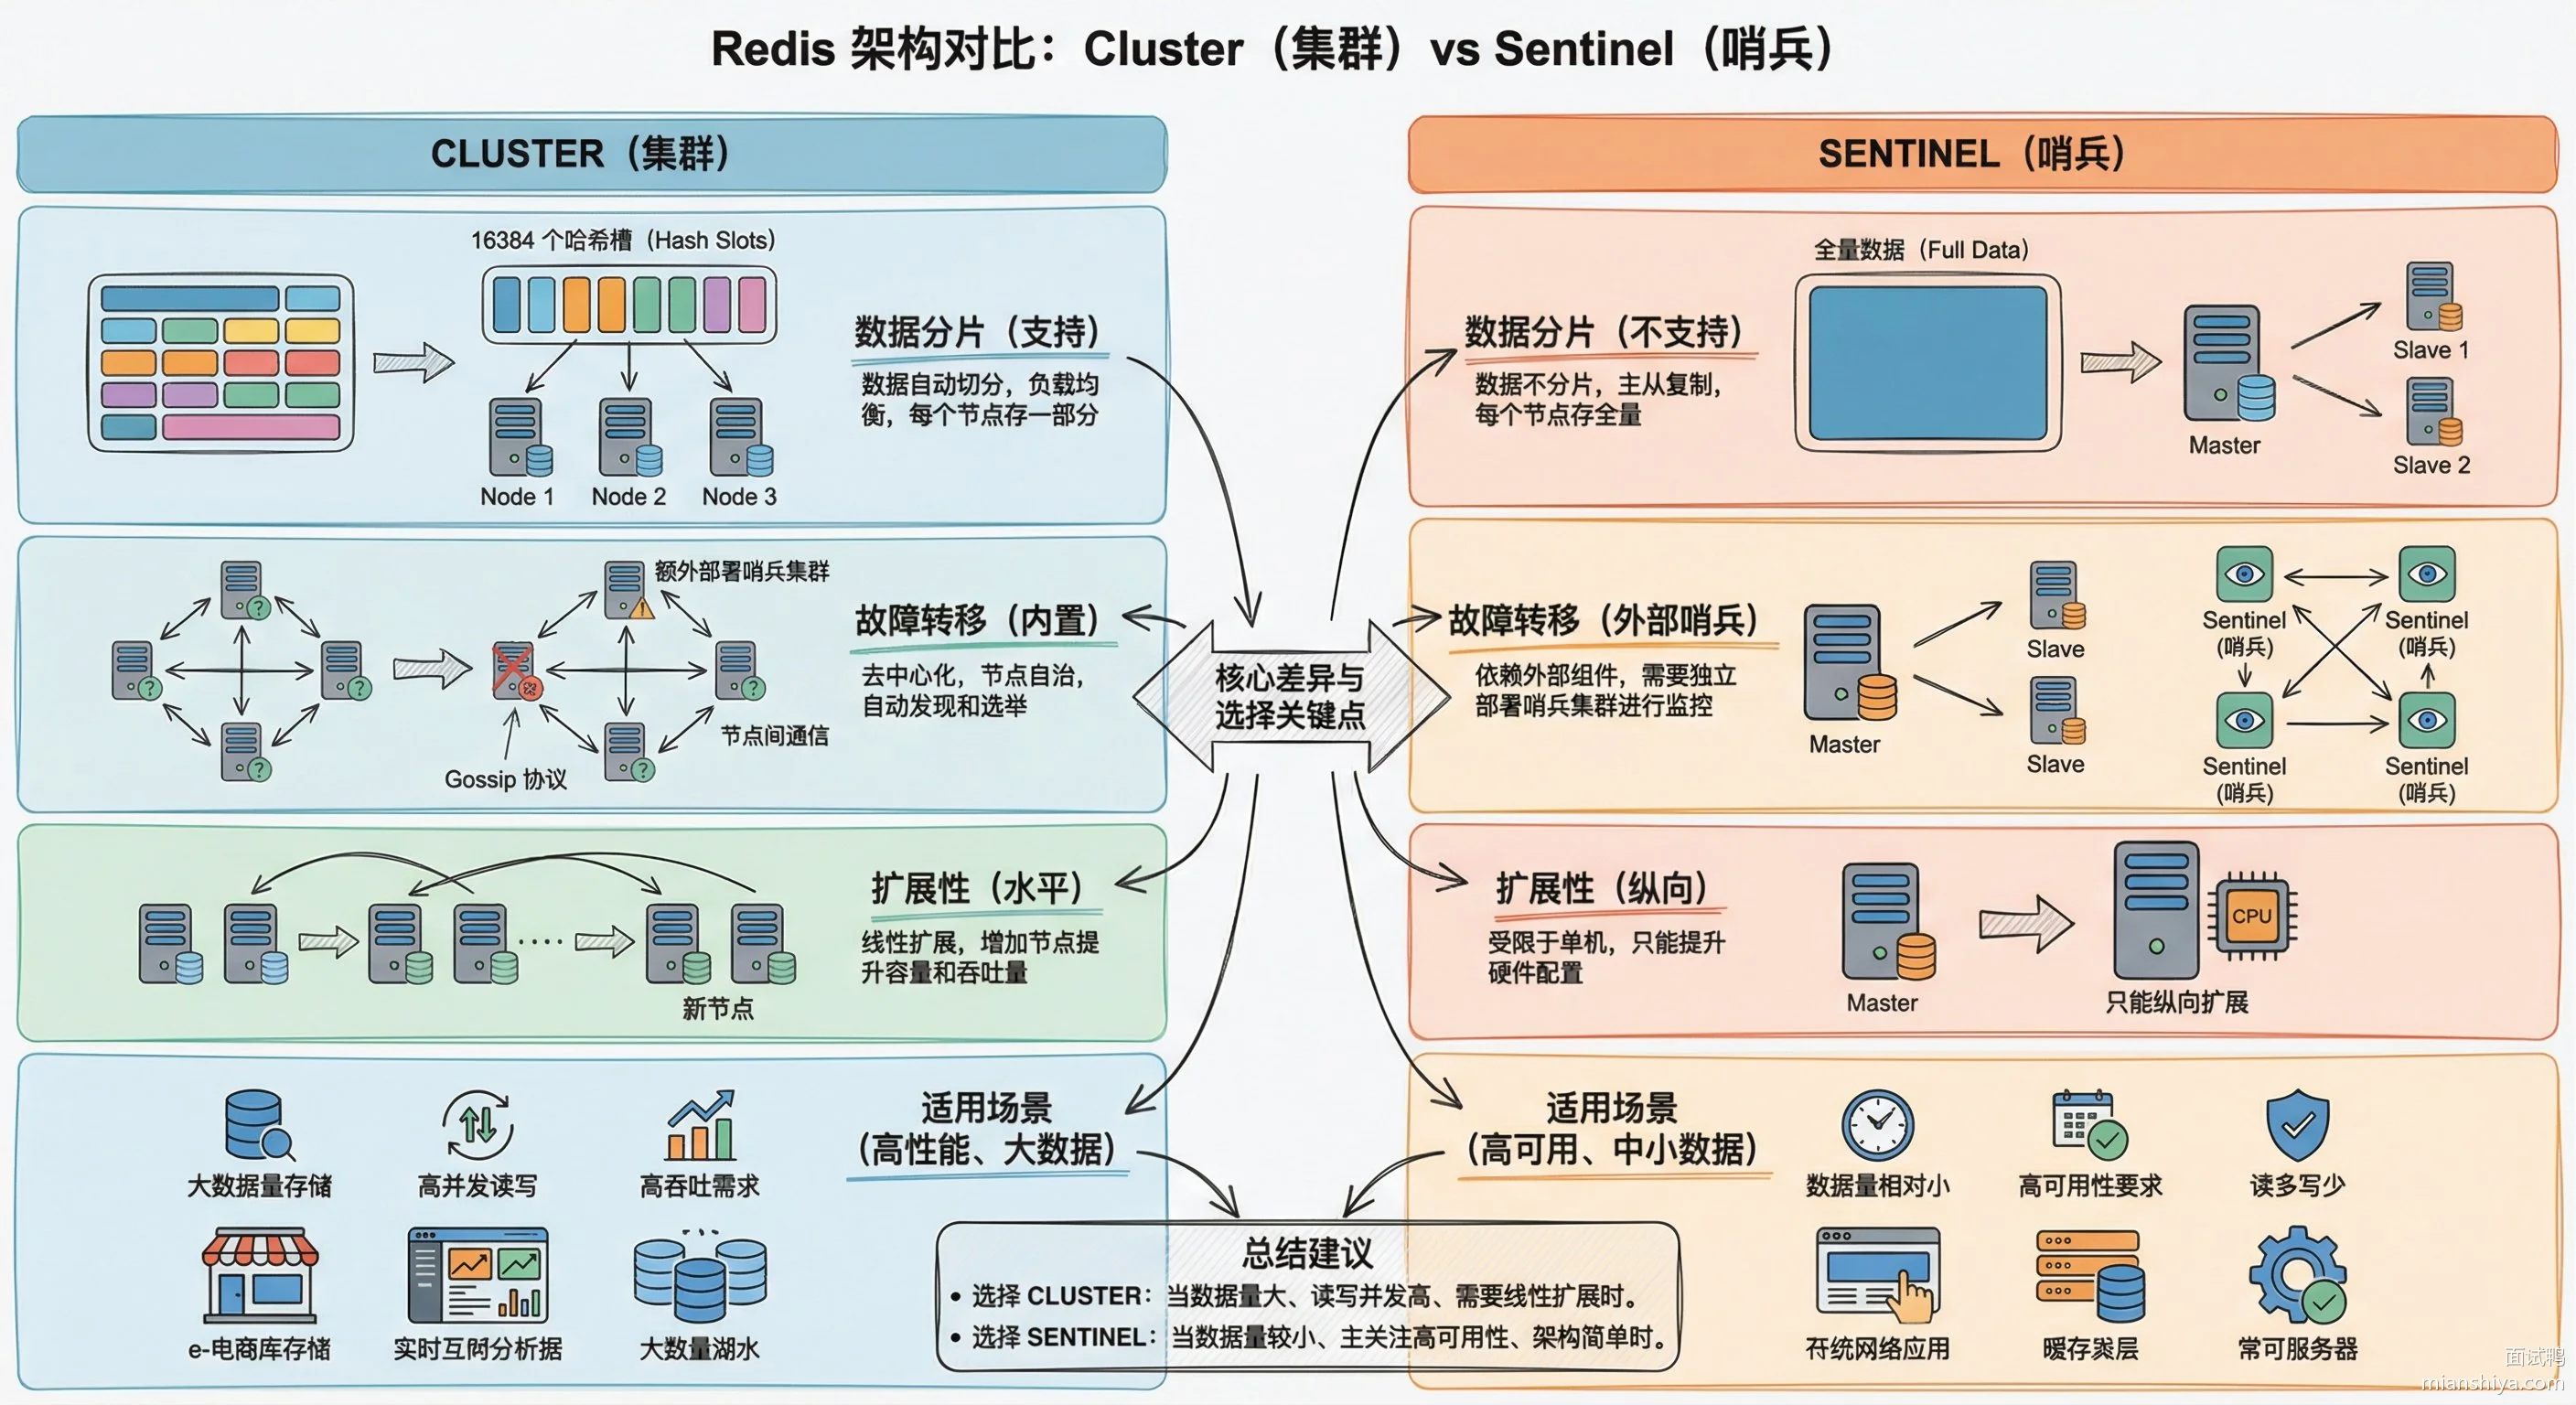
44.3. 常见问题
44.3.1. Cluster 模式下,客户端怎么知道 key 在哪个节点上?
详细解答可以看:在 Redis 集群中,如何根据键定位到对应的节点?
客户端第一次连接集群时会执行 CLUSTER SLOTS 命令拉取槽和节点的映射关系,缓存到本地。后续每次操作,客户端本地算 CRC16(key) % 16384 得到槽号,查缓存找到对应节点直连。如果节点返回 MOVED 错误说明缓存过期了,客户端更新缓存再重试。
44.3.2. Sentinel 集群为什么要部署奇数个节点?
故障转移需要超过半数的 Sentinel 同意才能执行。部署偶数个的话,比如 4 个,需要 3 个同意;部署 3 个也是需要 2 个同意。4 个和 3 个的容错能力一样,都只能挂 1 个,但 4 个多占资源。所以一般部署 3 个或 5 个。
44.3.3. Cluster 模式下扩容怎么做?数据怎么迁移?
先把新节点加入集群,然后用 redis-cli --cluster reshard 命令把部分槽从现有节点迁移到新节点。迁移过程中数据不会丢,Redis 会先把源节点的槽数据同步到目标节点,同步完成后再切换槽的归属。迁移期间如果有请求打到正在迁移的槽,会收到 ASK 重定向。
44.3.4. 能不能在 Cluster 模式下再套一层 Sentinel?
没必要,Cluster 内置了故障检测和自动故障转移机制,每个主节点都有从节点做备份。主节点挂了,从节点会自动提升为主节点,功能和 Sentinel 重叠。硬要加反而会增加复杂度,还可能出现两边同时触发故障转移导致冲突。
45. Redis 的 ListPack 数据结构是什么?
45.1. 核心要点
ListPack 是 Redis 6.0 引入的一种紧凑型序列化数据结构,专门用来替代 ziplist。它把数据直接按字节序列存储,不走 Redis 常规的对象模型,内存占用极低。
Redis 7.0 开始,List、Hash、ZSet 在数据量小的时候底层都改用 ListPack 了,彻底把 ziplist 换掉了。
ListPack 的结构很简单:
1)header 占 6 字节,前 4 字节存总长度,后 2 字节存元素个数
2)中间是一个个 element 紧挨着排列
3)末尾一个 0xFF 字节标识结束
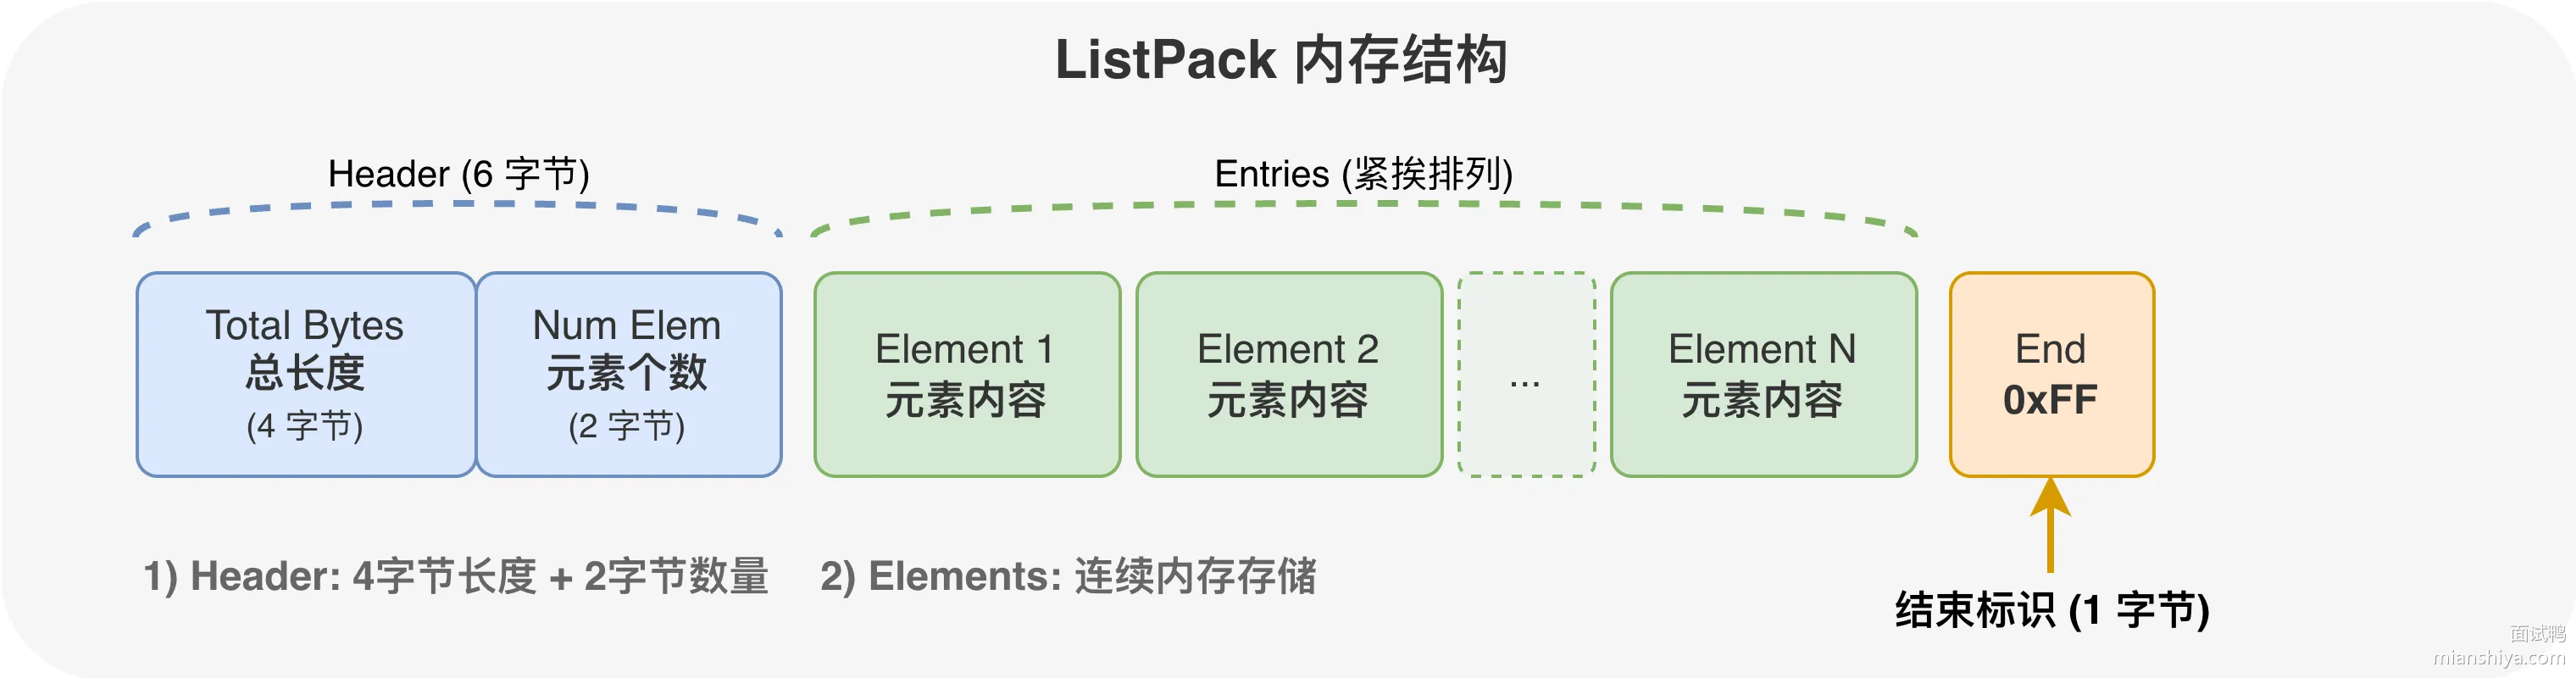
每个 element 内部又分三部分:encoding-type 标记编码方式、element-data 存实际数据、element-tot-len 记录前两部分的总长度。
45.2. 扩展知识
45.2.1. 为什么要用 ListPack 替换 ziplist
Redis 作者在 ListPack 的设计文档里提到,他发现了一个 bug 怀疑跟 ziplist 的连锁更新有关,于是干脆重新设计了 ListPack。
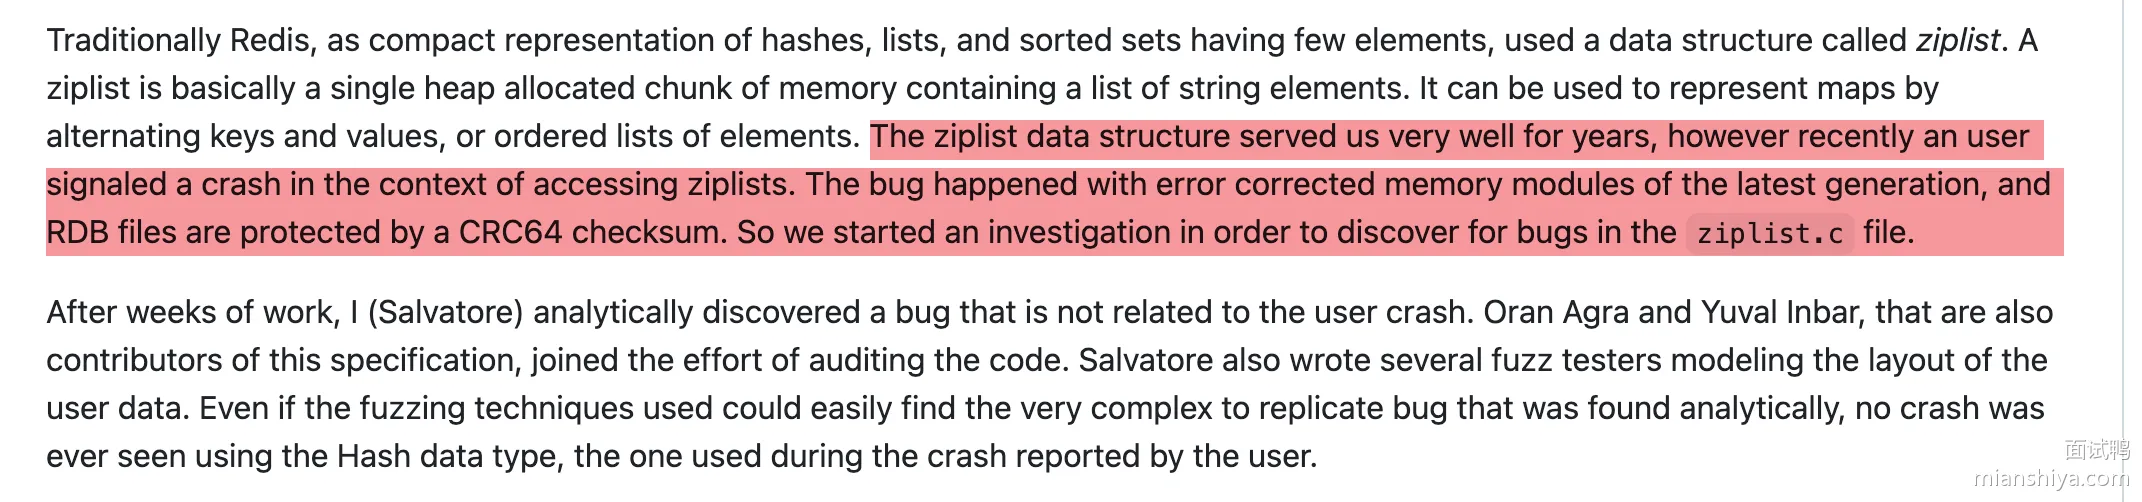
ziplist 的问题出在它的 entry 结构上。每个 entry 会记录前一个 entry 的长度,用来支持从后往前遍历。这个长度字段是变长的:前一个 entry 小于 254 字节时占 1 字节,大于等于 254 字节时占 5 字节。
假设现在有一串 entry,每个都刚好 253 字节。如果在最前面插入一个 260 字节的新 entry,第二个 entry 记录前一个长度的字段就得从 1 字节扩到 5 字节,这个 entry 变大了,可能导致第三个 entry 也得扩...一路传下去就是连锁更新。最坏情况下时间复杂度是 O(N²)。
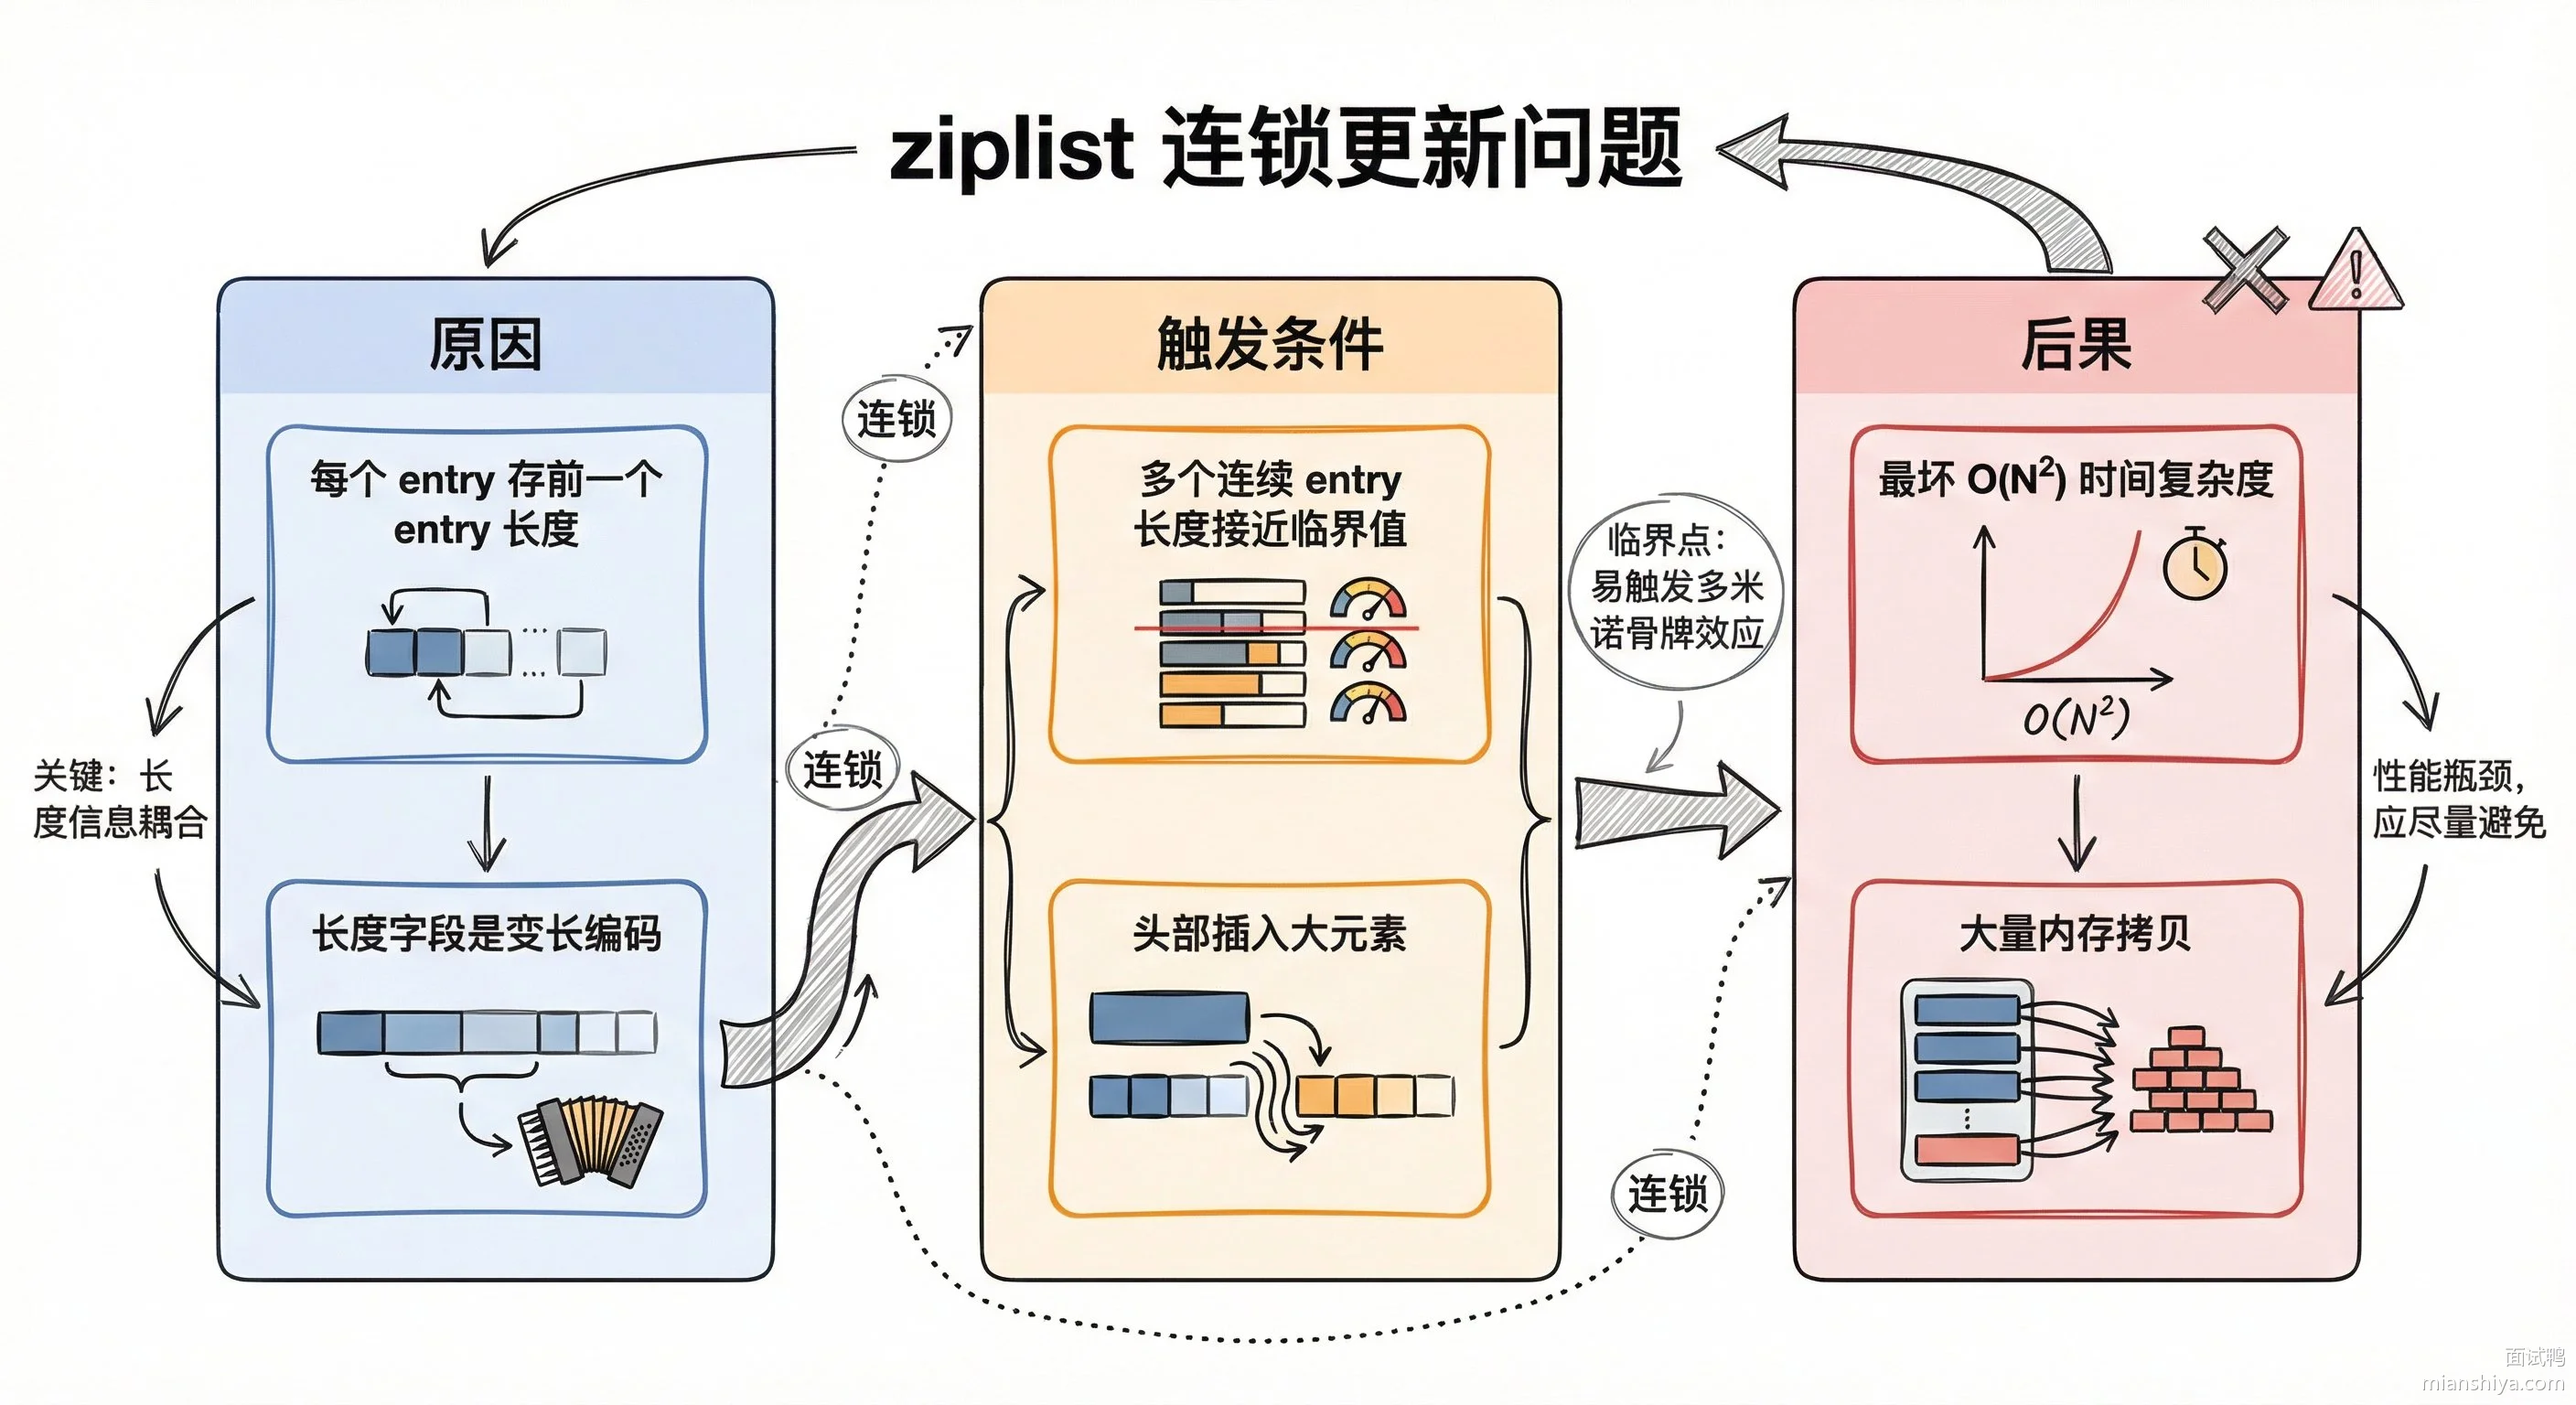
45.2.2. ListPack 怎么解决连锁更新
ListPack 的核心改进:每个 element 只记录自己的长度,不记录前一个的长度。
element 的内部结构:
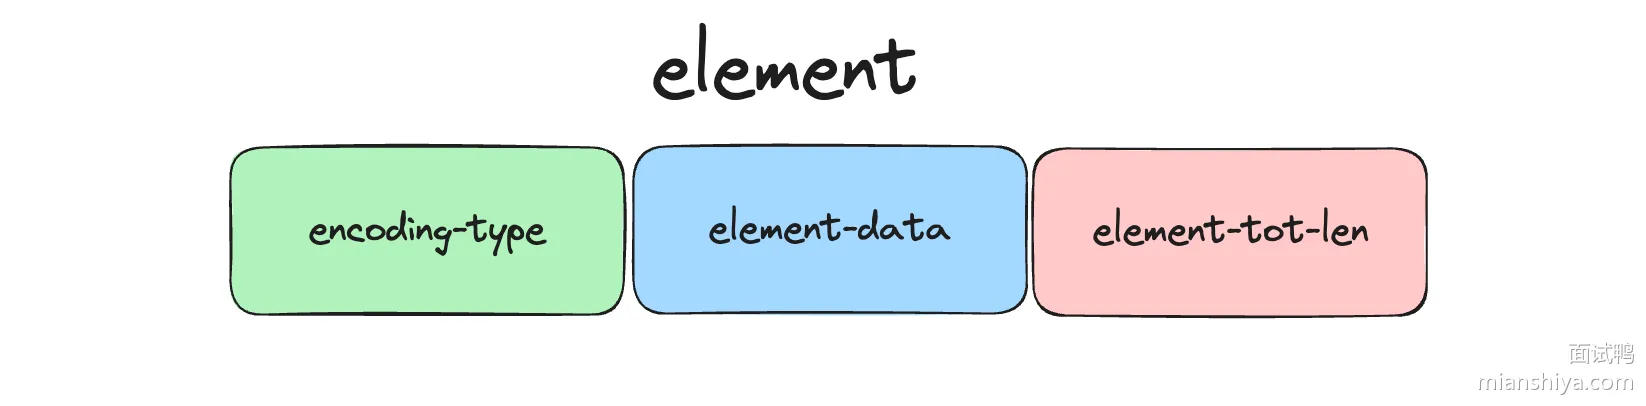
1)encoding-type:标记编码类型,整数还是字符串,以及具体的编码方式
2)element-data:实际数据
3)element-tot-len:encoding-type + element-data 的总长度
关键在于 element-tot-len 放在元素末尾,而且只记录自己的长度。往前遍历的时候,先读 element-tot-len 就能算出这个元素的起始位置,跳到前一个元素。
这样一来,修改任何元素都只影响自己,不会波及后面的元素,连锁更新问题就不存在了。
45.2.3. 编码方式
ListPack 用多种编码方式来压缩数据:
1)7 位无符号整数:0-127 的整数只占 1 字节
2)13 位有符号整数:-4096 到 4095 占 2 字节
3)16/24/32/64 位整数:根据数值范围选择合适的编码
4)字符串:短字符串用 6 位长度前缀,长字符串用 12 位或 32 位
这种变长编码让 ListPack 在存储小整数和短字符串时特别省内存。比如存 100 个用户 ID,如果 ID 都在 0-127 范围内,每个只占 2 字节。
45.2.4. 和 ziplist 的性能对比
| 维度 | ziplist | ListPack |
|---|---|---|
| 连锁更新 | 存在,最坏 O(N²) | 不存在 |
| 内存占用 | 略小 | 略大一点点 |
| 遍历方向 | 双向 | 双向 |
| 插入复杂度 | 平均 O(N),最坏 O(N²) | O(N) |
| 实现复杂度 | 较复杂 | 更简单 |
ListPack 内存占用比 ziplist 稍大一点,因为每个元素都要存自己的长度。但这点开销换来了稳定的 O(N) 插入性能,很值。
45.2.5. 什么时候会用到 ListPack
Redis 7.0 之后,这些数据类型在元素数量少、单个元素小的时候会用 ListPack:
1)Hash:field 数量小于 hash-max-listpack-entries 且每个 value 小于 hash-max-listpack-value
2)ZSet:元素数量小于 zset-max-listpack-entries 且每个元素小于 zset-max-listpack-value
3)List:在 quicklist 的每个节点内部用 ListPack 存储
默认配置下,hash-max-listpack-entries 是 512,hash-max-listpack-value 是 64 字节。数据量超过阈值后会自动转成 hashtable 或 skiplist。
45.3. 常见问题
45.3.1. ListPack 怎么支持从后往前遍历?
靠每个元素末尾的 element-tot-len 字段。从 ListPack 末尾的 0xFF 往前找,先读到最后一个元素的 element-tot-len,往前跳相应字节数就到了这个元素的开头。再往前一字节是上一个元素的 element-tot-len,以此类推。
45.3.2. ListPack 的 element-tot-len 本身也是变长的,怎么知道它占几个字节?
element-tot-len 用的是类似 UTF-8 的变长编码。每个字节的最高位是标志位,1 表示还有后续字节,0 表示结束。从后往前读,一直读到最高位是 0 的字节为止。这样不管 element-tot-len 占几个字节都能正确解析。
45.3.3. Hash 类型什么时候从 ListPack 转成 hashtable?
两个条件满足任意一个就转:field 数量超过 hash-max-listpack-entries,或者任意一个 field 或 value 的长度超过 hash-max-listpack-value。默认分别是 512 和 64 字节。一旦转成 hashtable 就不会再转回去了,即使后来删掉一些 field。
45.3.4. 为什么 Redis 不直接用 hashtable,非要搞这些紧凑结构?
内存成本。Redis 的 hashtable 每个 entry 要存 key、value 的指针,再加上 dictEntry 结构体本身,一个 entry 至少 24 字节的元数据开销。存 100 个只有几字节的小 field,用 hashtable 元数据比数据还大。ListPack 把数据紧挨着存,几乎没有额外开销,内存省好几倍。
46. Redis 中的内存碎片化是什么?如何进行优化?
46.1. 核心要点
内存碎片化就是内存里出现很多小块空间被闲置,没法被有效利用的现象。
Redis 默认用 jemalloc 做内存分配器,它是按固定大小来分配内存的。比如你实际只需要 8KB,分配器却给了 12KB,多出来的 4KB 就浪费了,这就是内存碎片。
而且频繁创建、删除大量数据的时候,内存块的大小和位置会变得不连续,碎片就越来越多。
可以通过 INFO memory 命令查看内存碎片率:
# Memory
used_memory:1000000       # 实际申请的内存空间
used_memory_rss:1200000   # 操作系统视角下 Redis 占用的物理内存,含碎片
mem_fragmentation_ratio:1.20
1)used_memory 是 Redis 真正用到的内存 2)used_memory_rss 是操作系统看到的 Redis 占用总量,包含碎片 3)mem_fragmentation_ratio = used_memory_rss / used_memory,大于 1 就说明有碎片
碎片率在 1.0 到 1.5 之间算正常,超过 1.5 就该考虑清理了。如果小于 1 问题更严重,说明 Redis 内存不够用,已经在用 swap 了,性能会断崖式下跌。
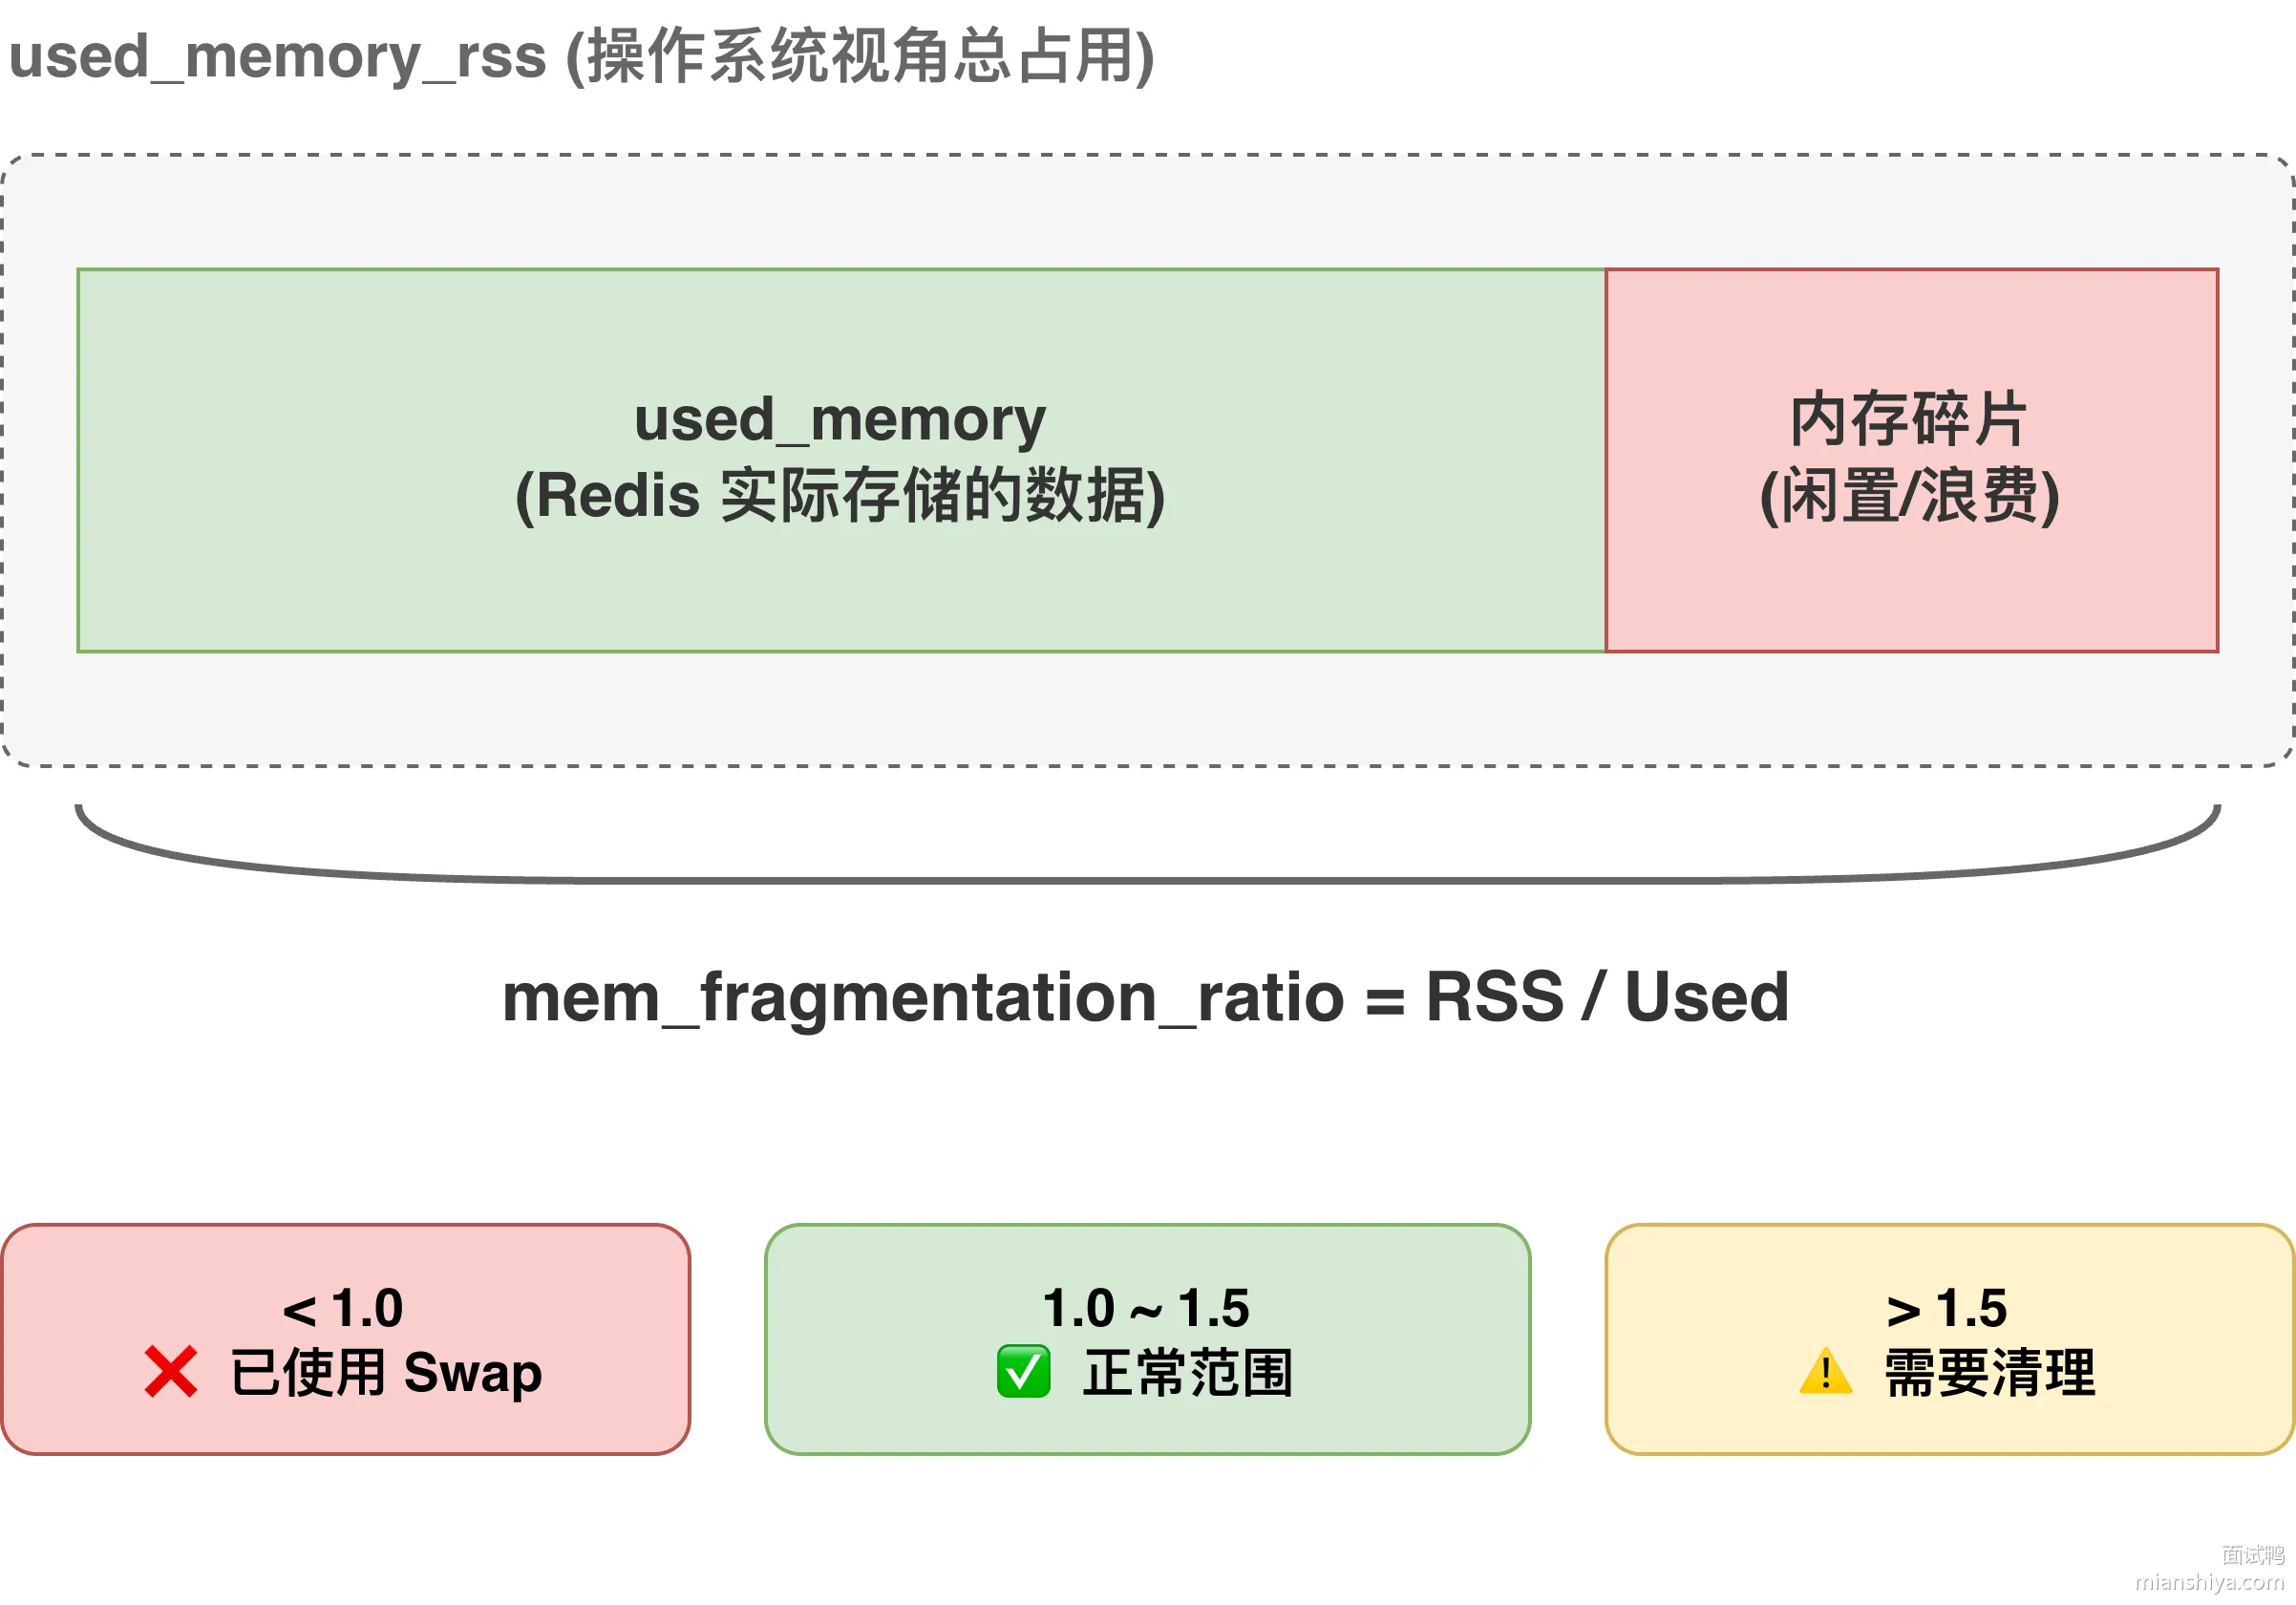
46.2. 扩展知识
46.2.1. 内存碎片产生的根本原因
jemalloc 把内存划分成不同大小的"块"来管理,比如 8 字节、16 字节、32 字节...一直到更大的块。当你申请内存时,它会找一个最接近但不小于你需求的块分给你。
举个例子,你申请 20 字节,jemalloc 会给你 32 字节的块,那 12 字节就浪费了。Redis 里存的 key-value 大小不一,这种"凑整"导致的浪费累积起来就很可观。
更麻烦的是删除操作。假设连续分配了 A、B、C 三块内存,删掉 B 之后中间就空出来一块。如果后面要申请的内存比这块大,这块空间就用不上,只能干放着。频繁增删数据会让内存像蜂窝一样千疮百孔。
46.2.2. 碎片整理的几种方案
1)重启 Redis
最简单粗暴的办法。重启后内存重新分配,碎片自然就没了。但代价是服务中断,如果没有集群或者主从切换机制,这个方案基本不可行。
2)使用 activedefrag 自动碎片整理
Redis 4.0 引入了这个功能,可以在运行时自动整理碎片,不用重启。核心配置项:
# 开启自动碎片整理
activedefrag yes

# 碎片占用的字节数超过 100MB 时才开始整理
active-defrag-ignore-bytes 100mb

# 碎片率达到多少百分比才触发
active-defrag-threshold-lower 10
active-defrag-threshold-upper 100

# CPU 使用率控制,避免整理影响正常请求
active-defrag-cycle-min 1
active-defrag-cycle-max 25
整理过程是增量式的,每次只处理一小部分,通过 active-defrag-cycle-min 和 active-defrag-cycle-max 控制每个周期花多少 CPU 时间来做整理,不会一下子把 CPU 打满。
3)手动执行 MEMORY PURGE
Redis 4.0 也加了这个命令,可以手动触发内存回收。但要注意,这个命令会阻塞主线程,数据量大的时候可能卡住好几秒,生产环境慎用。
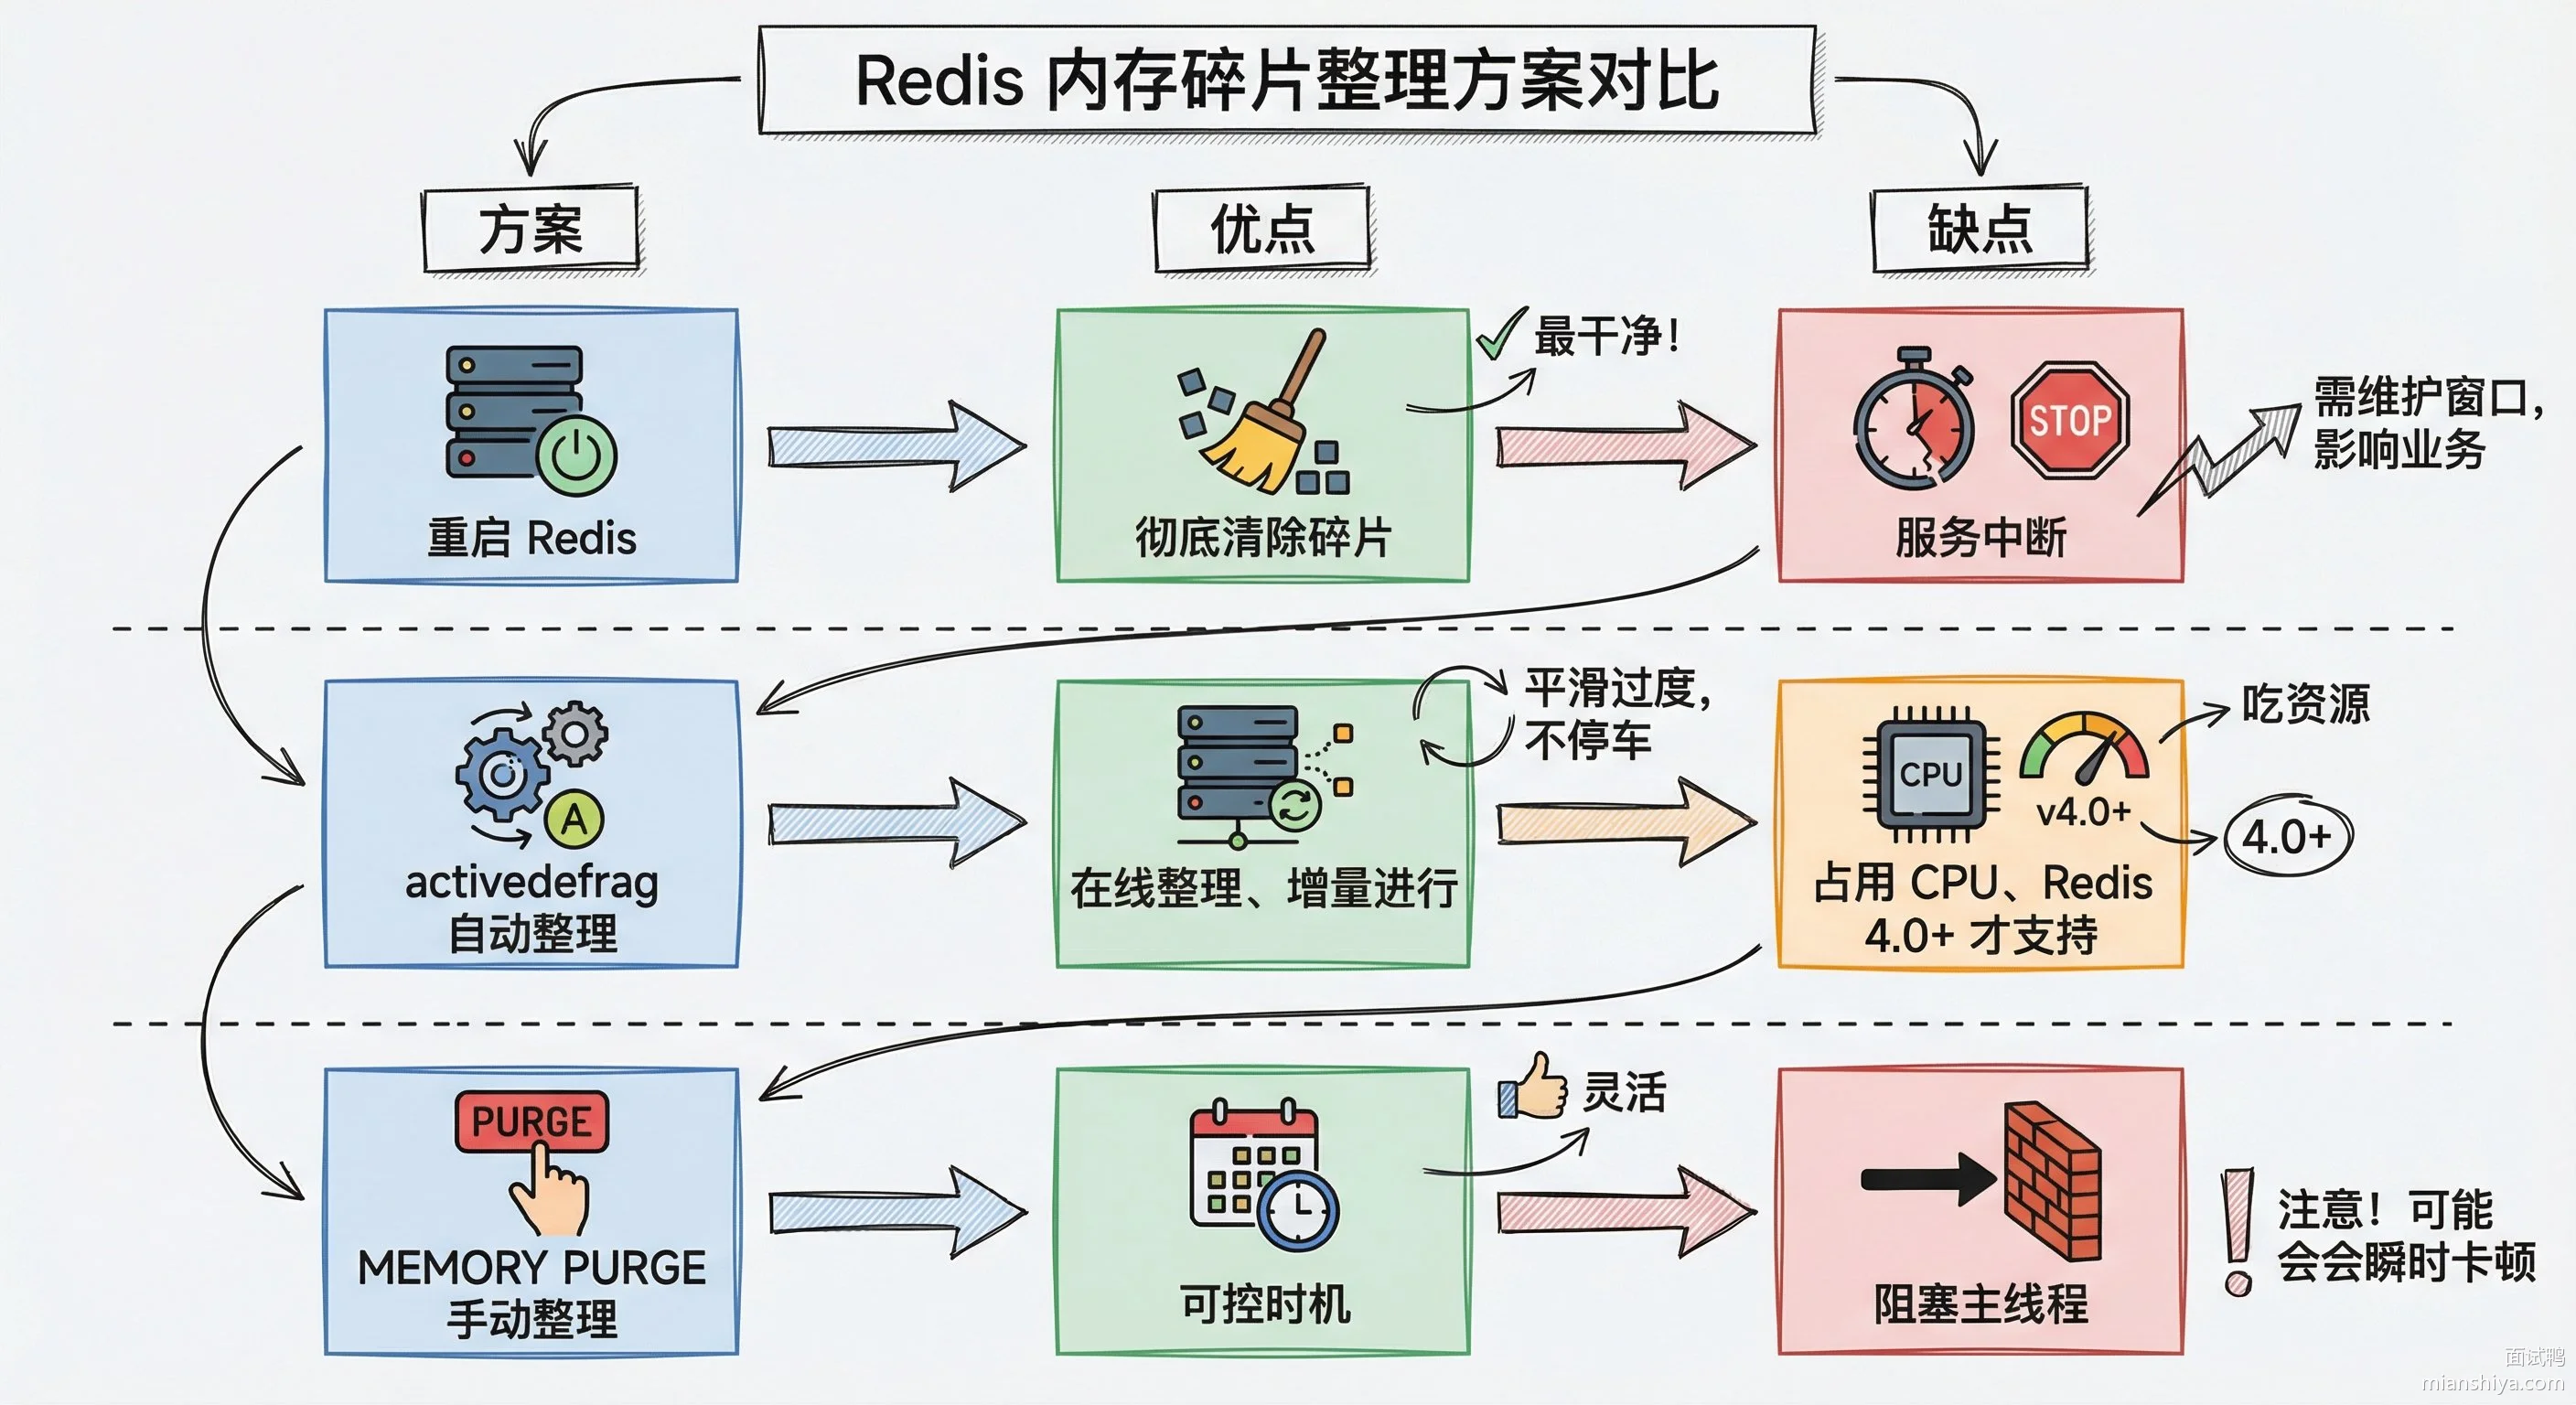
46.2.3. 预防碎片的最佳实践
1)尽量让 key 的大小固定或相近,避免大小差异悬殊的 key 混在一起
2)批量删除大量 key 的时候用 UNLINK 代替 DEL,UNLINK 是异步删除,对内存布局的冲击小一些
3)如果业务允许,可以给 key 设置过期时间让 Redis 自己清理,比集中大批量删除温和
4)Redis 7.0 把 ziplist 换成了 listpack,内存利用率更高,能从源头减少碎片
46.3. 常见问题
46.3.1. jemalloc 和 tcmalloc、glibc malloc 比起来有什么优势?
jemalloc 在多线程环境下碎片率更低,它用 arena 机制让不同线程在不同的内存区域分配,减少锁竞争。tcmalloc 是 Google 出的,侧重分配速度,但碎片控制不如 jemalloc。glibc 的 ptmalloc 是默认的,但在高并发场景下碎片和锁竞争都比较严重。Redis 虽然主线程是单线程,但后台有 IO 线程和持久化线程,jemalloc 综合表现最好。
46.3.2. activedefrag 开着会不会影响 Redis 性能?
会有一定影响,但可控。整理过程会占用 CPU,通过 active-defrag-cycle-max 可以限制最多占用 25% 的 CPU 周期。而且整理是渐进式的,不会一次性处理完所有碎片。建议在业务低峰期开启,或者把 cycle-max 调低一点。如果碎片率不高,比如低于 1.5,其实没必要开。
46.3.3. 碎片率小于 1 说明用了 swap,这时候应该怎么处理?
这是紧急情况,说明物理内存已经不够了。Redis 用了 swap 之后性能会暴跌,响应时间可能从微秒级变成毫秒级甚至秒级。首先要扩容内存或者加机器分担压力,然后检查是不是有 big key 占用太多内存,用 redis-cli --bigkeys 扫一遍。还要看看是不是 maxmemory 没配或者配太大了,让 Redis 以为可以无限用内存。
47. Redis 的虚拟内存(VM)机制是什么?
47.1. 核心要点
Redis VM 机制是 Redis 早期版本用来扩展内存容量的方案,内存不够的时候把冷数据挪到磁盘上,热数据留在内存里。这样 Redis 就能处理比物理内存更多的数据。
但这玩意在 Redis 2.4 之后就被砍掉了。原因很简单:Redis 是内存数据库,核心卖点就是快,一旦数据要从磁盘读,延迟直接从微秒级涨到毫秒级,高并发场景根本扛不住。
现在 Redis 推荐用内存淘汰策略来管理内存,而不是靠磁盘来兜底。
详细的内存淘汰策略可以看《redis 的内存淘汰策略有哪些?》。
Redis 放弃 VM 的原因:
1)性能拖后腿:Redis 设计初衷就是高性能内存数据库,频繁磁盘 IO 跟这个目标背道而驰
2)架构复杂:VM 机制要维护冷热数据分离、页面交换等逻辑,代码复杂度高,出问题难排查
3)硬件便宜了:现在服务器动不动就 256GB、512GB 内存,内存价格也降了很多,没必要靠磁盘来省钱
47.2. 扩展知识
47.2.1. VM 的工作原理
VM 机制的核心思路是把数据分成固定大小的页面,然后根据访问频率决定哪些留内存、哪些扔磁盘。
1)分页管理:Redis 把数据切成多个页面,每个页面默认 4KB。页面是数据交换的最小单位。
2)LRU 追踪:Redis 维护一个 LRU 列表,记录每个数据最近一次被访问的时间。访问越少的数据越靠后,越容易被换出去。
3)换出流程:当内存不够用的时候,Redis 从 LRU 列表尾部找出最冷的数据页,写到磁盘的交换文件里,然后释放内存。
4)换入流程:如果客户端要访问的数据在磁盘上,Redis 要先把对应的页面读回内存,这时候就会有明显的延迟。
47.2.2. 为什么不能用操作系统的 swap 替代
有人可能想,既然 Redis 自己的 VM 被砍了,那让操作系统的 swap 来兜底不行吗?
不行,而且更糟糕。操作系统的 swap 是以物理页为单位交换的,它不知道 Redis 的数据结构,可能把一个完整的对象拆到不同页里,读的时候要换入好几个页,效率更低。而且 swap 是全局的,Redis 跟别的进程共享,控制不了。
Redis 自己做 VM 至少还能按自己的数据结构来分页,控制换入换出的粒度。但即便这样性能也不行,所以最后还是砍了。
47.2.3. 现代 Redis 的内存管理思路
VM 被砍之后,Redis 转向了几个方向来解决内存不够的问题:
1)内存淘汰策略:配置 maxmemory 和淘汰策略,内存到上限就自动删掉一些 key,比如 LRU、LFU、TTL 淘汰等
2)集群分片:用 Redis Cluster 把数据分散到多个节点,横向扩展容量
3)冷热分离架构:业务层面做分离,热数据放 Redis,冷数据放 MySQL 或者对象存储,需要的时候再加载
47.3. 常见问题
47.3.1. Redis 的 VM 机制跟操作系统虚拟内存有什么区别?
操作系统虚拟内存是透明的,进程感知不到,由内核自动管理页面换入换出。Redis VM 是应用层实现的,Redis 自己决定哪些数据换出去、什么时候换。Redis VM 能根据数据的访问模式做更精准的冷热判断,但实现复杂,而且最终还是躲不开磁盘 IO 的性能瓶颈。
47.3.2. 现在 Redis 7.0 有什么新的内存优化手段?
Redis 7.0 把底层数据结构 ziplist 换成了 listpack,内存利用率更高,碎片更少。还有 Function 机制替代 Lua 脚本,减少脚本加载的内存开销。另外 7.0 对 AOF 做了优化,支持多 part 文件,重写的时候内存峰值更低。
47.3.3. 如果非要在内存不够的情况下保证数据不丢,有什么办法?
一是开启 RDB 或 AOF 持久化,数据至少在磁盘上有一份。二是用 Redis Cluster 或者主从复制,把数据分散到多台机器。三是业务层面做降级,非核心数据存到别的地方,Redis 只存最关键的。最不推荐的是让系统 swap,那样 Redis 基本就废了。
48. 在 Redis 集群中,如何根据键定位到对应的节点?
48.1. 核心要点
Redis Cluster 把数据分布到 16384 个哈希槽里,每个 key 通过 CRC16 算法算出哈希值,再对 16384 取模,得到槽位编号。每个节点负责一部分槽位,知道 key 落在哪个槽,就知道数据在哪个节点上。
公式很简单:slot = CRC16(key) % 16384
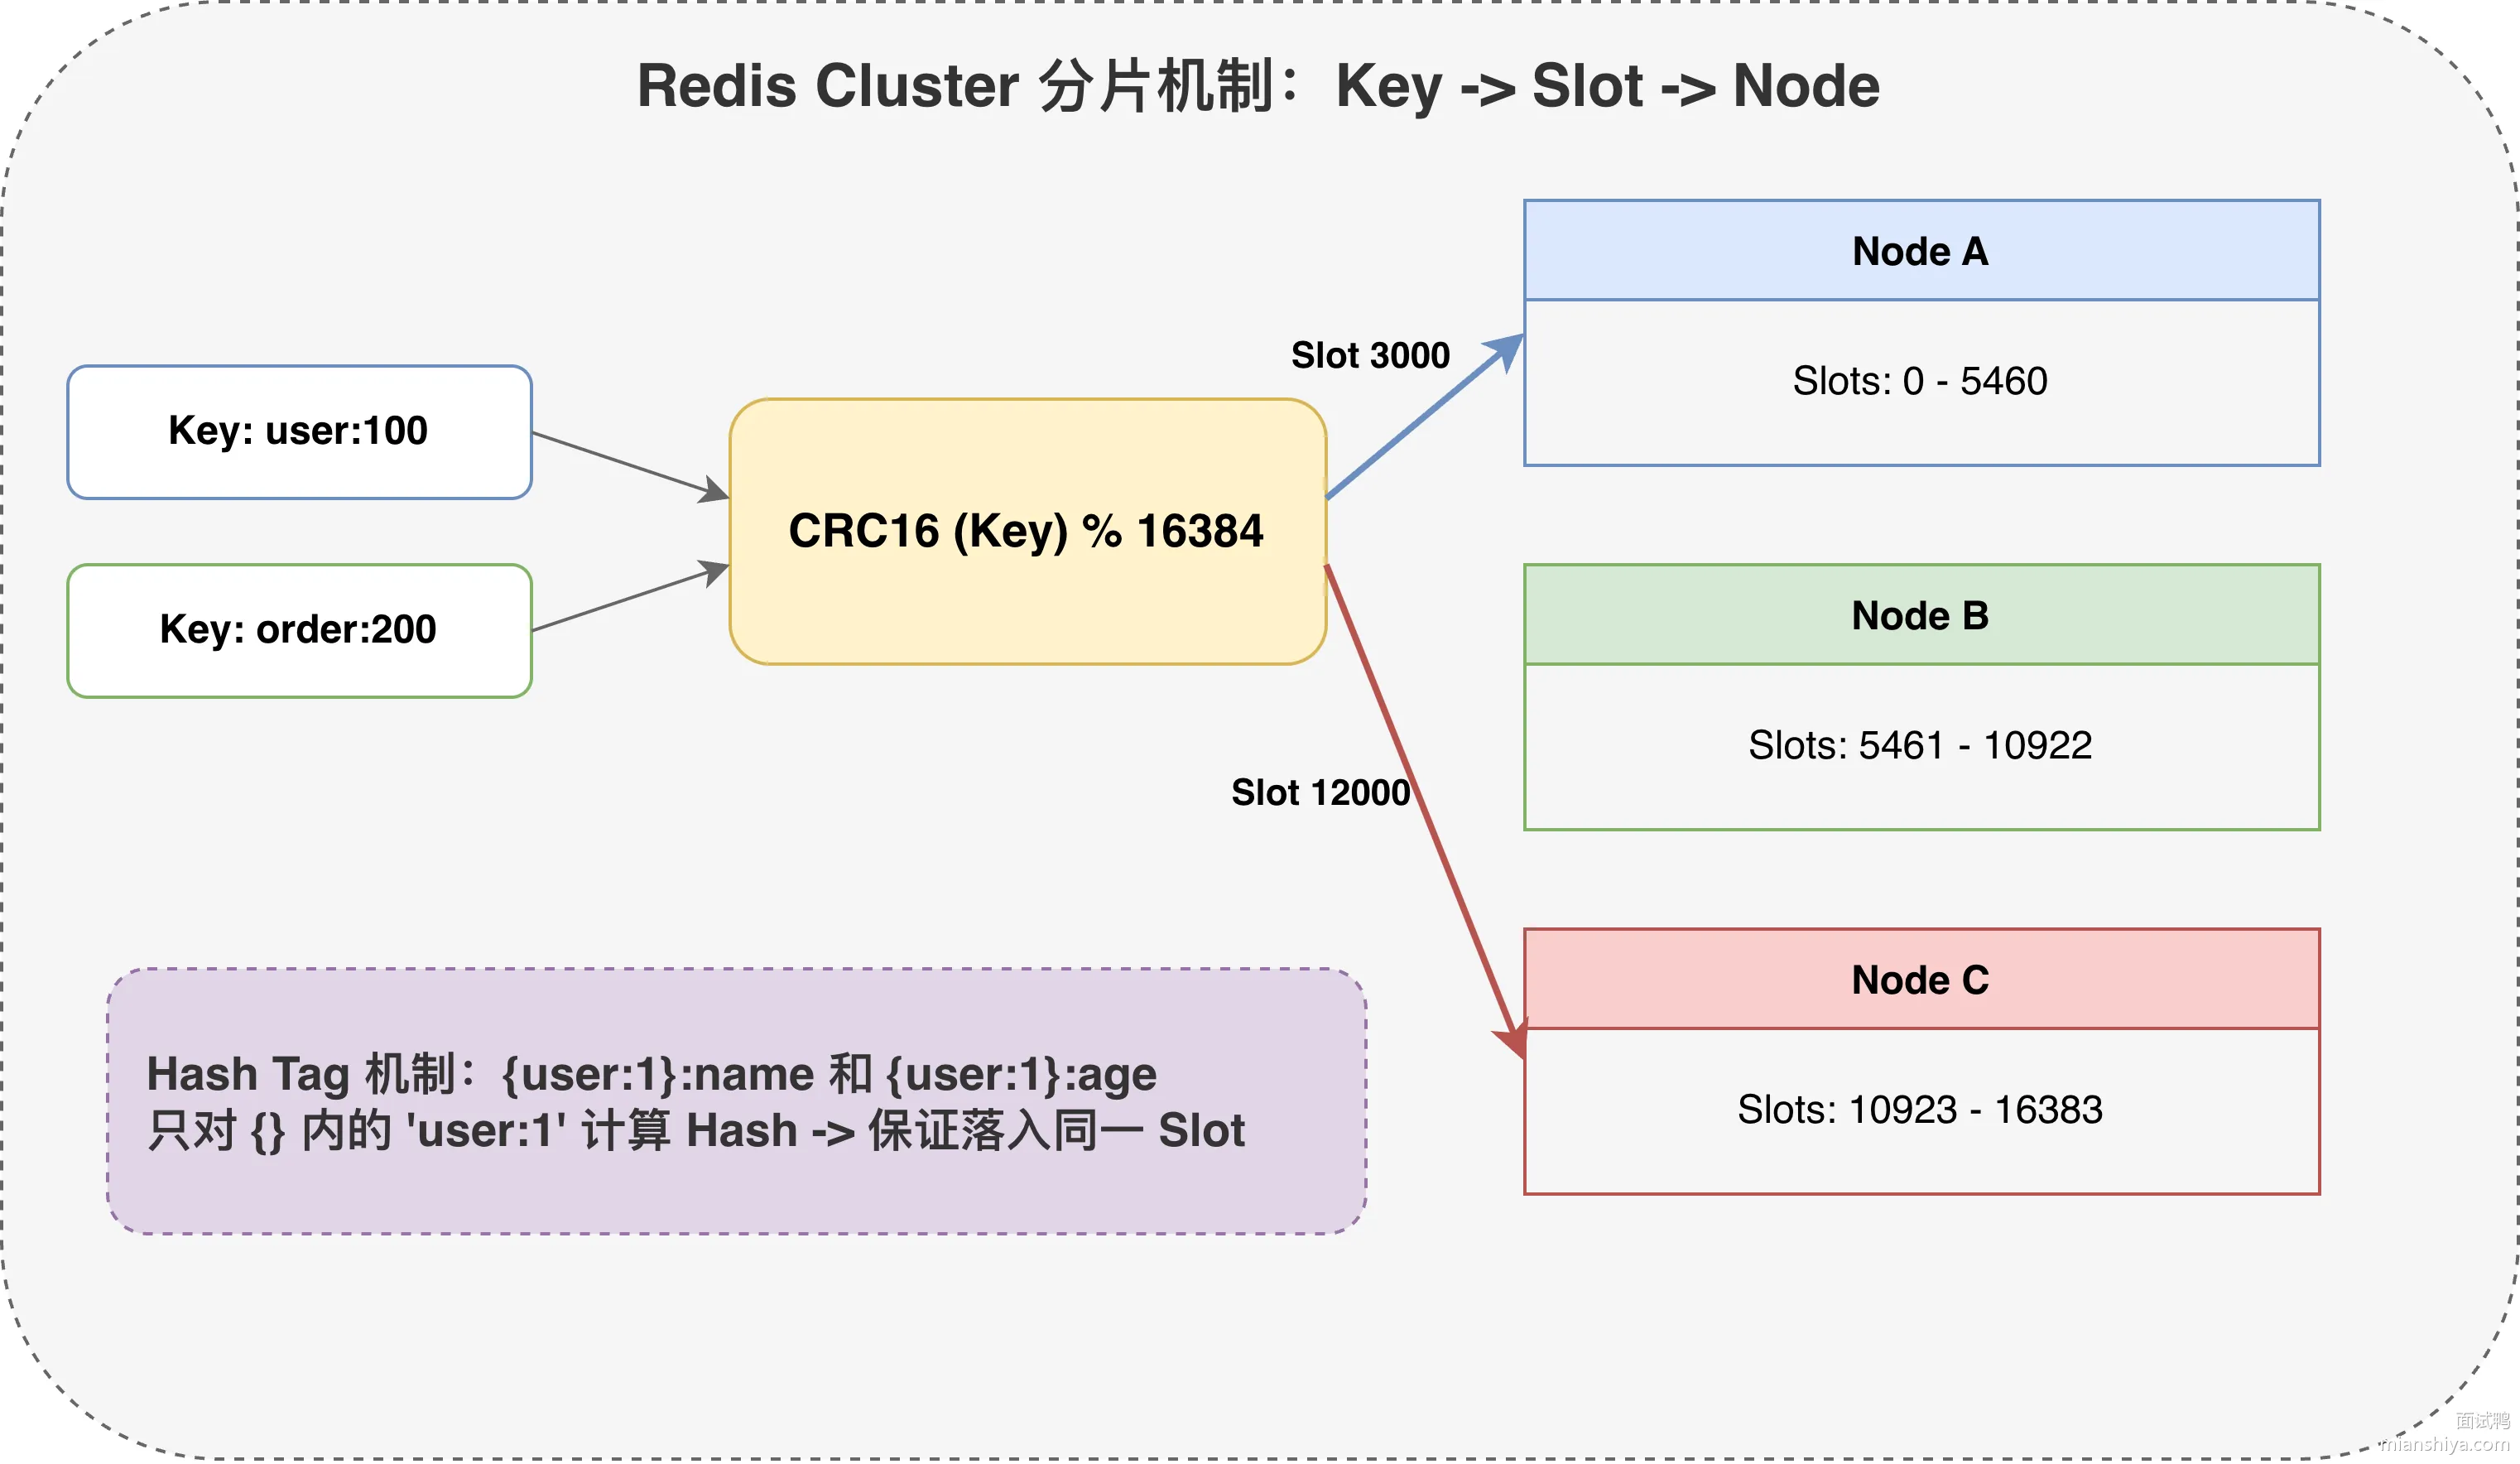
48.2. 扩展知识
48.2.1. 集群节点怎么知道彼此的槽位
每个节点启动的时候只知道自己负责哪些槽,不知道别的节点的情况。节点之间通过 Gossip 协议互相交换信息,用 PING 命令发送自己的状态,用 PONG 响应对方。
几轮通信下来,每个节点都有了完整的槽位映射表,知道哪个槽归谁管。这种去中心化的设计让集群不依赖中心节点,任何一个节点挂了也不影响其他节点之间的通信。
48.2.2. 客户端怎么找到正确的节点
客户端访问 Redis Cluster 的时候,可以连到集群里的任意一个节点,不用关心数据具体在哪。
1)客户端本地用 CRC16 算出 key 对应的槽位
2)客户端启动时会从集群拉取一份槽位到节点的映射关系,缓存在本地,大部分情况下能直接命中正确的节点
3)如果连的节点上没这个数据,节点会返回重定向指令告诉客户端该去找谁
重定向指令有两种:
1)MOVED slot ip:port:表示这个槽已经永久迁移到另一个节点了,客户端要更新本地缓存,以后直接访问新节点
2)ASK slot ip:port:表示这个槽正在迁移中,数据可能在源节点也可能在目标节点,这次临时去目标节点问一下,但不用更新本地缓存
下图演示 MOVED 情况:
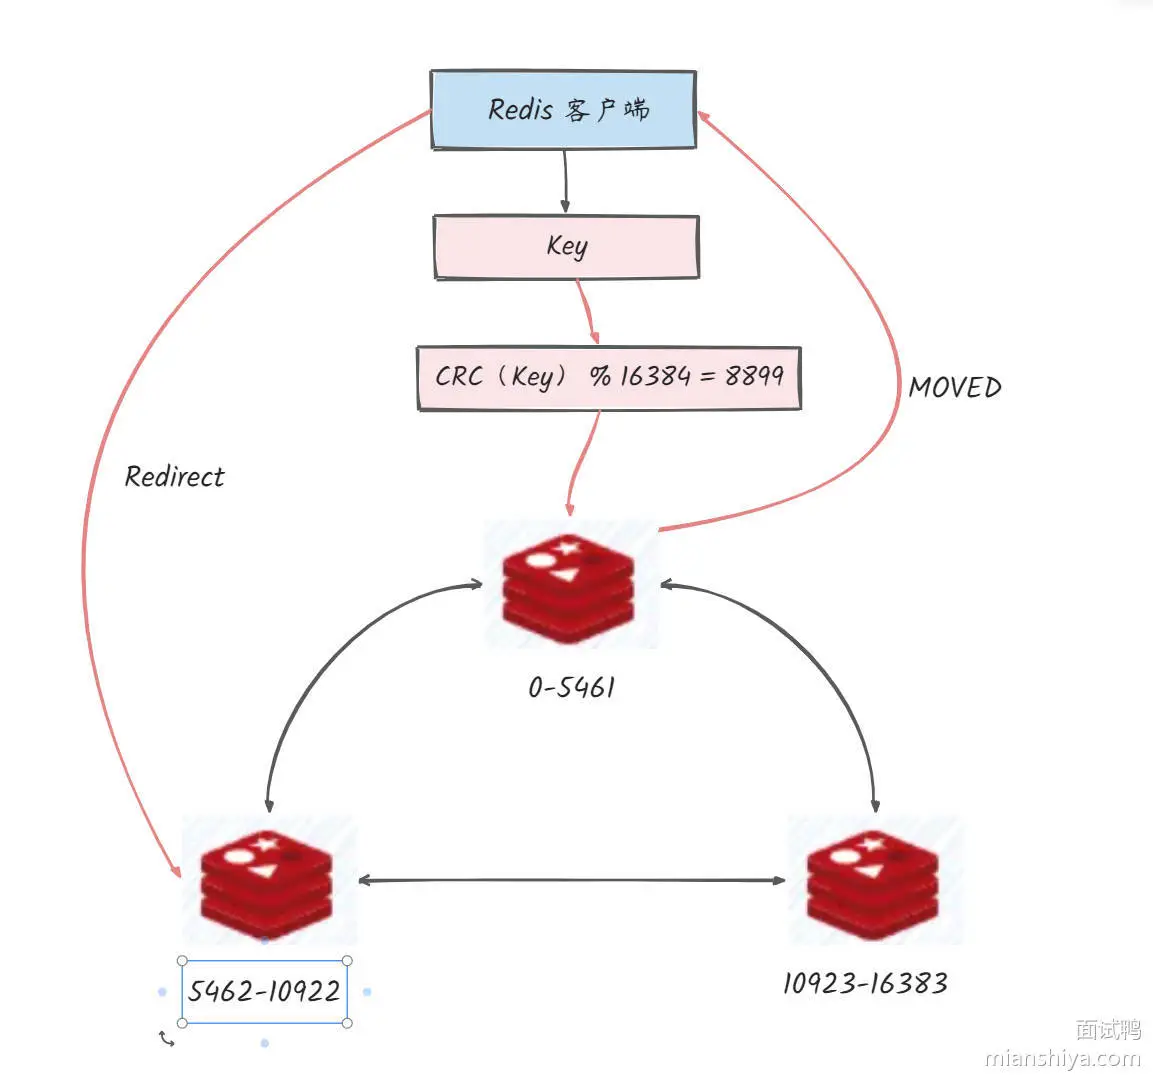
Redis 集群更详细的介绍,可以查看《2. Redis 集群的实现原理是什么?》
48.2.3. ASK 重定向的细节
槽迁移过程中,数据可能一半在源节点一半在目标节点。客户端收到 ASK 重定向后,要先给目标节点发一个 ASKING 命令,然后再发实际的请求。
为啥要多发一个 ASKING?因为迁移还没完成,目标节点理论上还没正式接管这个槽。ASKING 相当于一个临时授权,告诉目标节点"虽然你还没完全拥有这个槽,但这个请求你先帮忙处理一下"。
不发 ASKING 直接请求,目标节点可能会拒绝,因为它觉得自己还不该管这个槽。
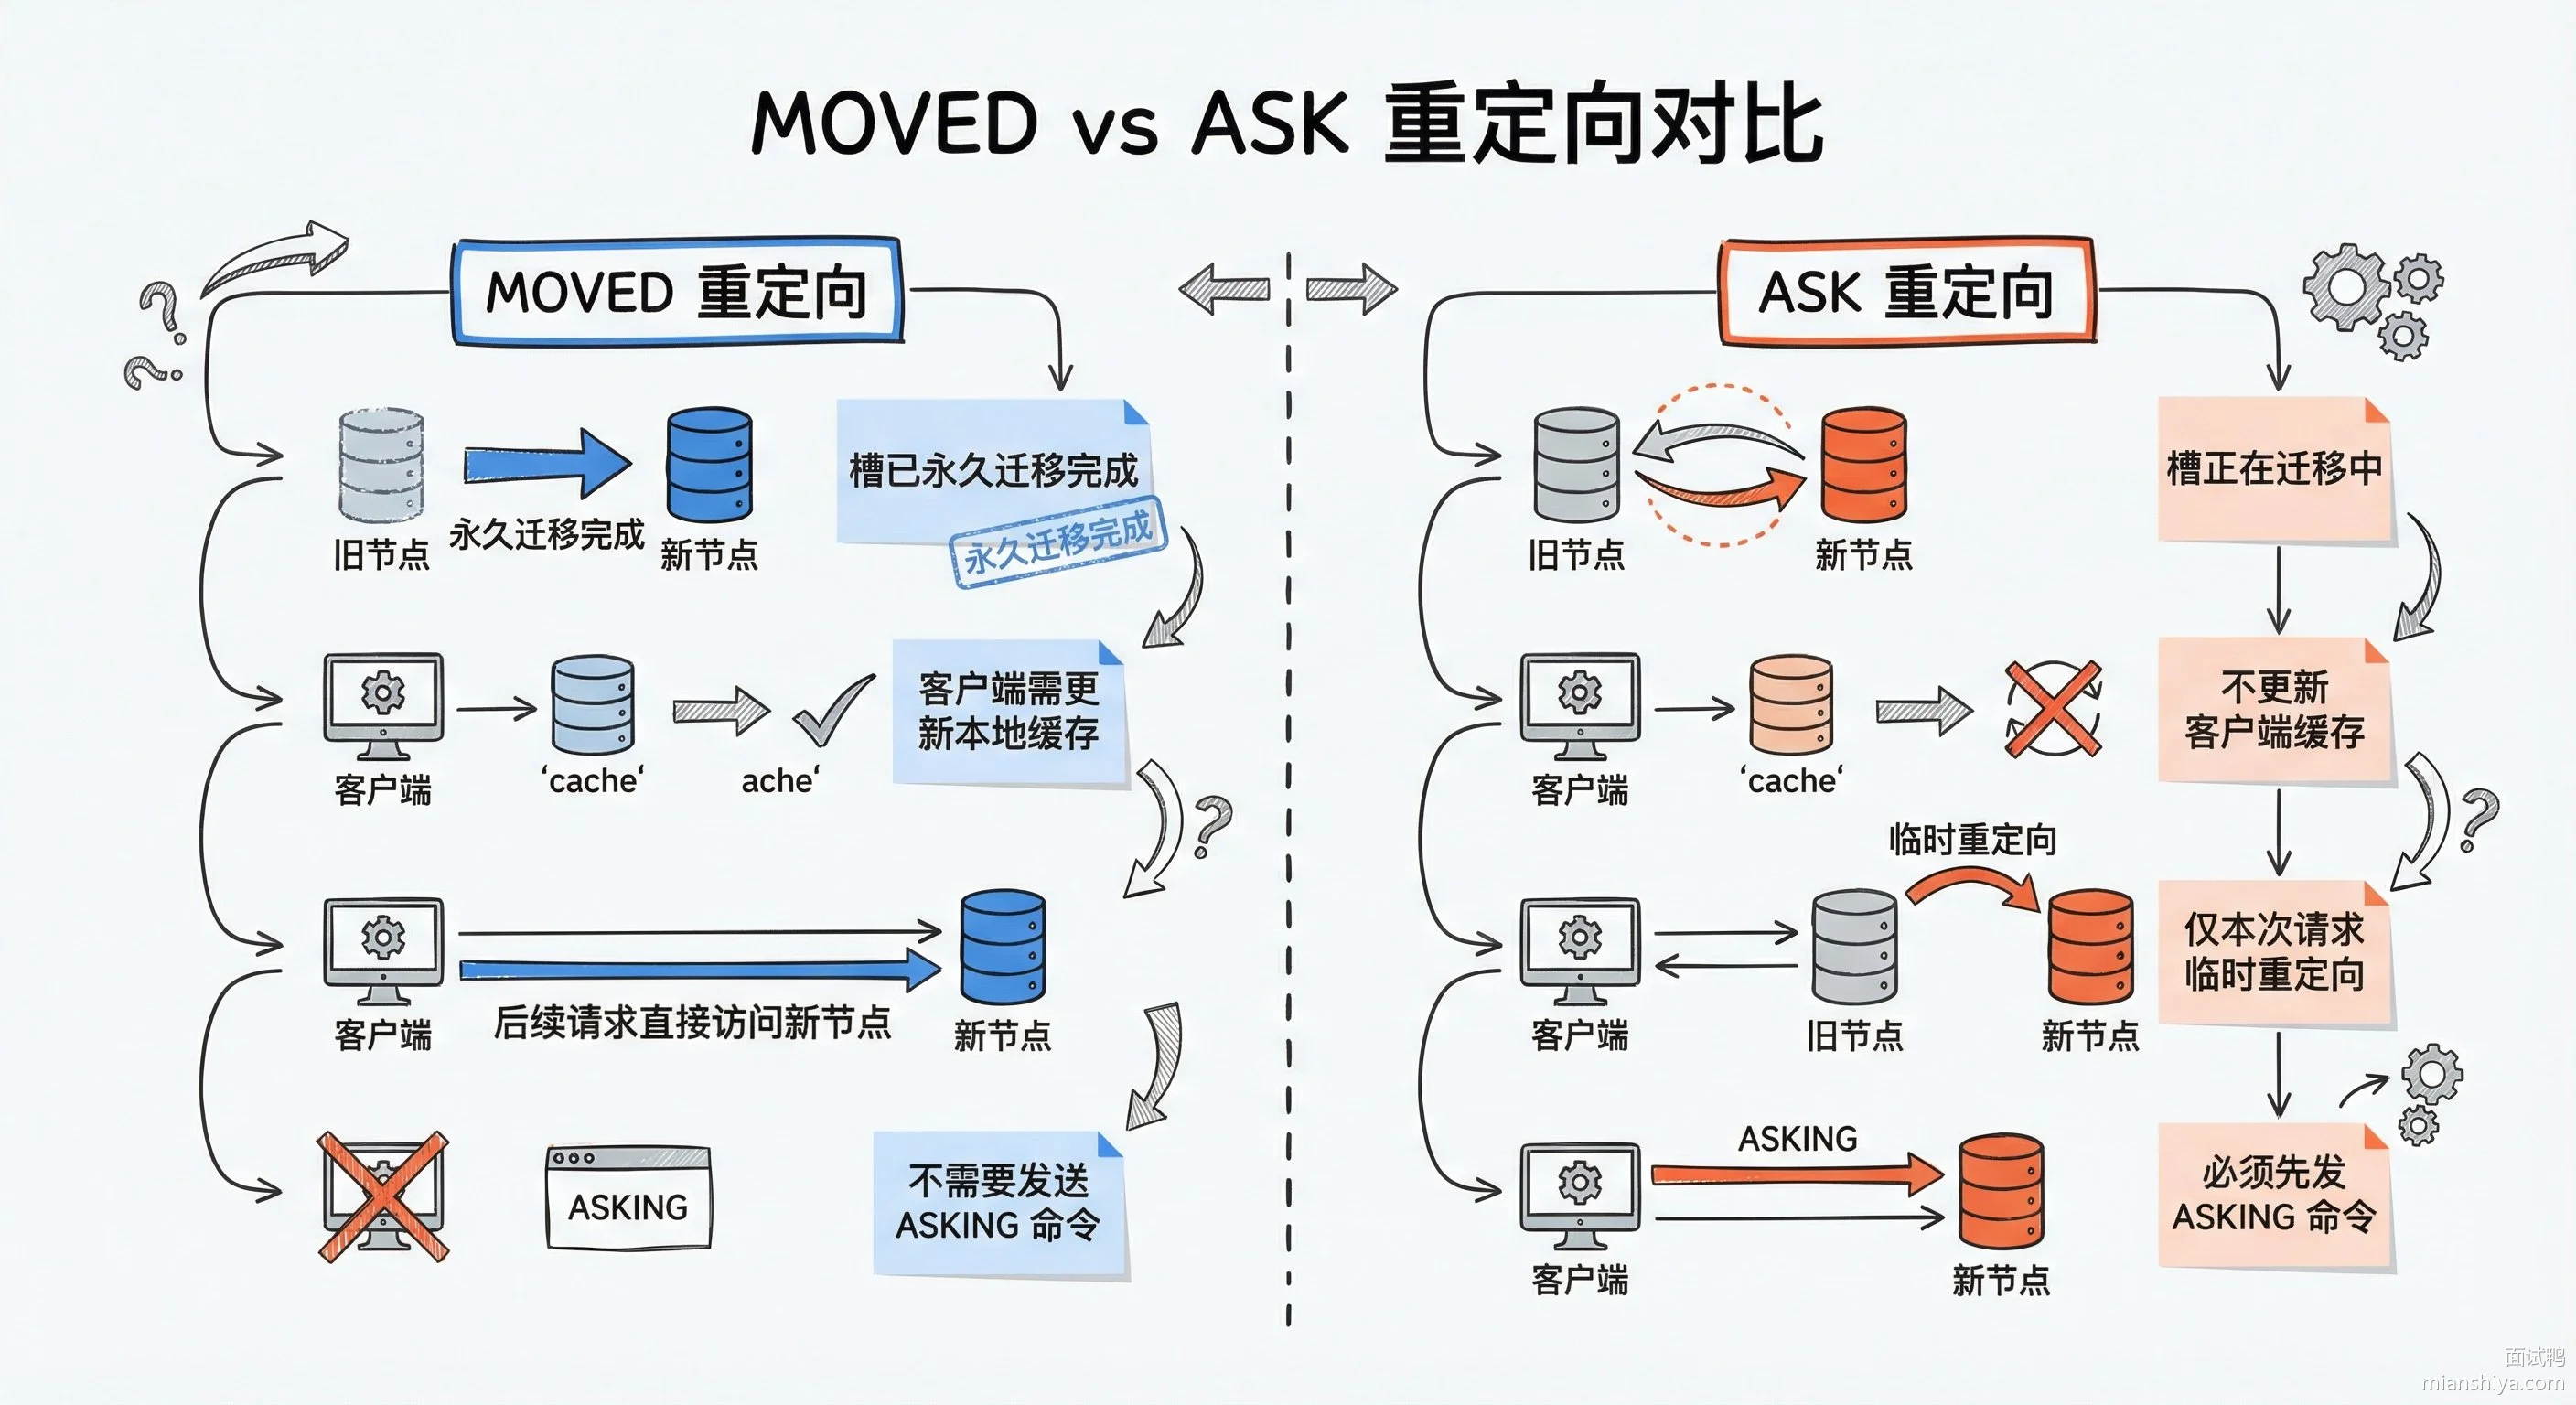
48.2.4. 哈希标签让多个 key 落在同一个槽
有时候想让几个 key 一定在同一个节点上,比如要对它们做事务或者 Lua 脚本操作。Redis 提供了哈希标签机制:如果 key 里有大括号 {},只对括号里的内容做哈希。
比如 user:{1001}:name 和 user:{1001}:age,虽然是两个不同的 key,但因为 {1001} 部分相同,它们一定落在同一个槽里,也就一定在同一个节点上。
这样就能对这两个 key 执行 MGET、事务、Lua 脚本这些需要在同一个节点执行的操作了。
48.3. 常见问题
48.3.1. 为什么 Redis Cluster 选择 16384 个槽,不是 65536 或者其他数字?
主要是考虑心跳包大小。节点之间用 Gossip 协议通信,每次心跳都要带上自己负责的槽位信息,用 bitmap 表示。16384 个槽只需要 2KB,65536 个槽就要 8KB。对于一个可能有几百个节点的集群,每秒几次心跳,带宽消耗差距很大。16384 对于大多数场景够用了,一个集群一般不会超过 1000 个节点,平均每个节点也有十几个槽。
48.3.2. 客户端怎么知道去哪个节点拿数据,每次都要问集群吗?
不用每次问。客户端启动时会用 CLUSTER SLOTS 或 CLUSTER NODES 命令拉一份完整的槽位映射,缓存在本地。后面每次请求,客户端本地算出槽位,直接连对应的节点。只有收到 MOVED 重定向才更新缓存。像 Jedis、Lettuce 这些主流客户端都是这么实现的,叫 Smart Client 模式。
48.3.3. 如果集群正在扩容,一个槽的数据迁移到一半,这时候来了个写请求怎么处理?
写请求会先到源节点。如果 key 还在源节点,直接写。如果 key 已经迁到目标节点了,源节点返回 ASK 重定向,客户端去目标节点写。迁移过程中,源节点对这个槽的新 key 写入会被拒绝,必须去目标节点写。这样保证迁移完成后数据都在目标节点上,不会出现新数据写到源节点的情况。
49. Redis 源码中有哪些巧妙的设计,举几个典型的例子?
49.1. 核心要点
Redis 能做到单机 10 万+ QPS,靠的就是源码里一堆精心打磨的细节。最典型的设计有这几个:SDS 字符串、压缩列表 ziplist、渐进式 rehash、共享对象池、惰性删除+定期删除。
49.1.1. SDS 字符串
C 语言原生字符串有几个硬伤:获取长度要 O(n) 遍历、拼接容易溢出、不能存二进制数据。Redis 搞了个 SDS 结构,直接把长度和剩余空间记在头部:
struct sdshdr {
    int len;      // 已用长度
    int free;     // 剩余空间
    char buf[];   // 实际数据
};
好处很直接:
1)取长度 O(1),不用遍历 2)追加字符串时先检查 free 够不够,不够就扩容,杜绝溢出 3)不依赖 \0 判断结尾,二进制数据随便存 4)字符串缩短后空间不立刻释放,留着下次用,减少内存分配次数
49.1.2. 压缩列表 ziplist(Redis 7.0 后 ziplist 已被 listpack 替代)
当 List 或 Hash 里元素少、每个元素又短的时候,Redis 不用链表,用一整块连续内存把数据挤在一起。每个节点前面记着前一个节点的长度,往前往后遍历都很快,还省掉了指针的开销。
比如一个 Hash 里存 3 个 field,如果用普通哈希表,光指针就得吃掉几十字节;用 ziplist 可能总共才 50 字节。元素一多或者单个元素超过 64 字节,Redis 会自动转成标准结构,性能和空间两头兼顾。
49.1.3. 渐进式 rehash
哈希表扩容是个大活儿,一次性搬几百万个 key 能把主线程卡死。Redis 的做法是准备两张表 ht[0] 和 ht[1],扩容时新数据往 ht[1] 写,同时每次增删改查顺手搬几个旧节点过去。等 ht[0] 清空了,指针一换就完事。整个过程分摊到日常操作里,用户几乎感知不到。
49.1.4. 共享对象池
0 到 9999 这一万个整数在业务里出现频率极高,Redis 启动时就把它们全部预创建好放在池子里。后续用到直接拿引用,不用反复 malloc/free。一个计数器加 1、减 1,底层压根不涉及内存分配。
49.1.5. 过期键处理
Redis 没有专门的线程去扫过期键,而是两招组合拳:
1)惰性删除:访问某个 key 时顺手检查,过期了就删 2)定期删除:每 100ms 随机抽 20 个设置了过期时间的 key,删掉其中已过期的,如果过期比例超过 25% 就再来一轮
这样既不会漏删,也不会因为全量扫描拖慢响应。
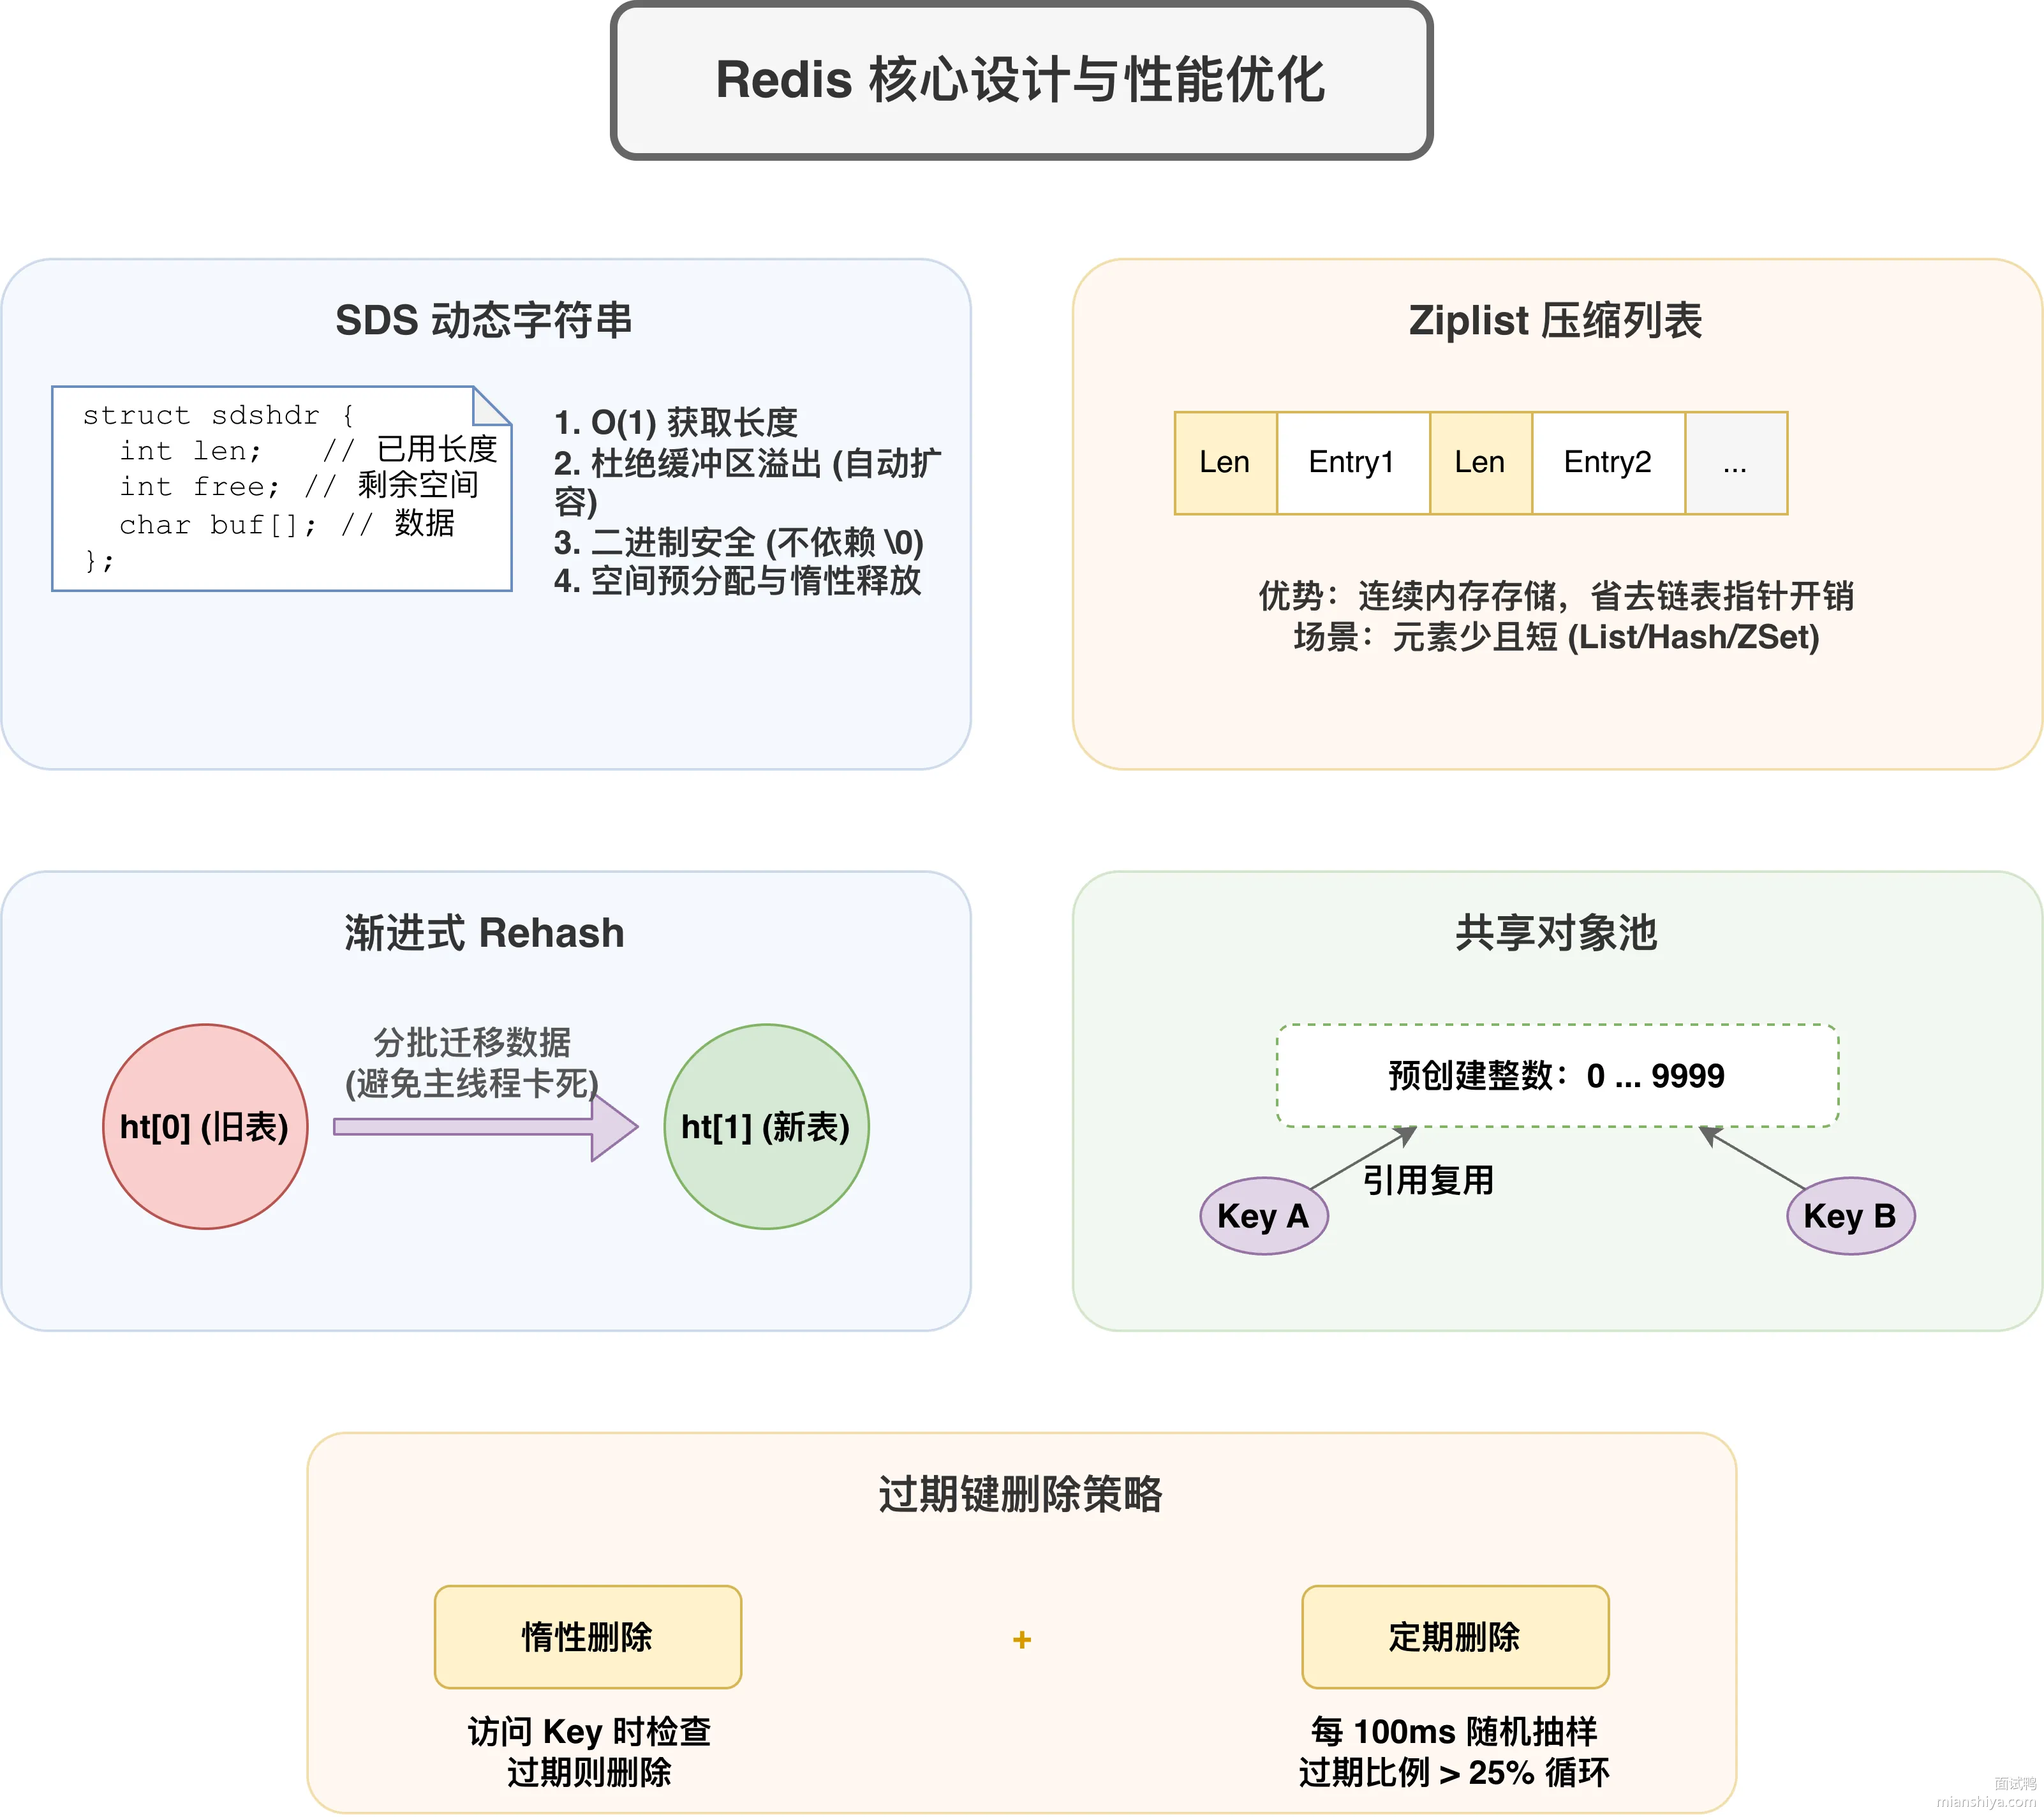
49.2. 扩展知识
49.2.1. AOF 重写机制
AOF 文件记录的是写命令流水,时间一长文件会膨胀。比如一个 key 被 SET 了 100 次,文件里就有 100 条命令,但恢复时只需要最后一条的值。
AOF 重写就是 fork 一个子进程,根据当前内存快照生成最精简的命令集。重写期间主进程照常干活,新的写操作同时追加到旧 AOF 和一个重写缓冲区。等子进程写完,主进程把缓冲区的增量命令追加到新文件,然后原子地替换旧文件。
整个过程对外无感知,文件大小能压缩 90% 以上。
49.2.2. listpack 替代 ziplist
Redis 7.0 之后,ziplist 被 listpack 全面替代。原因是 ziplist 有个连锁更新的问题:中间某个节点长度变了,后面所有节点的 prevlen 字段可能都要改,最坏情况下一次插入要更新整条链。
listpack 的节点只记录自己的长度,不记前一个节点的信息,彻底干掉了连锁更新。内存布局更简单,解析也更快。
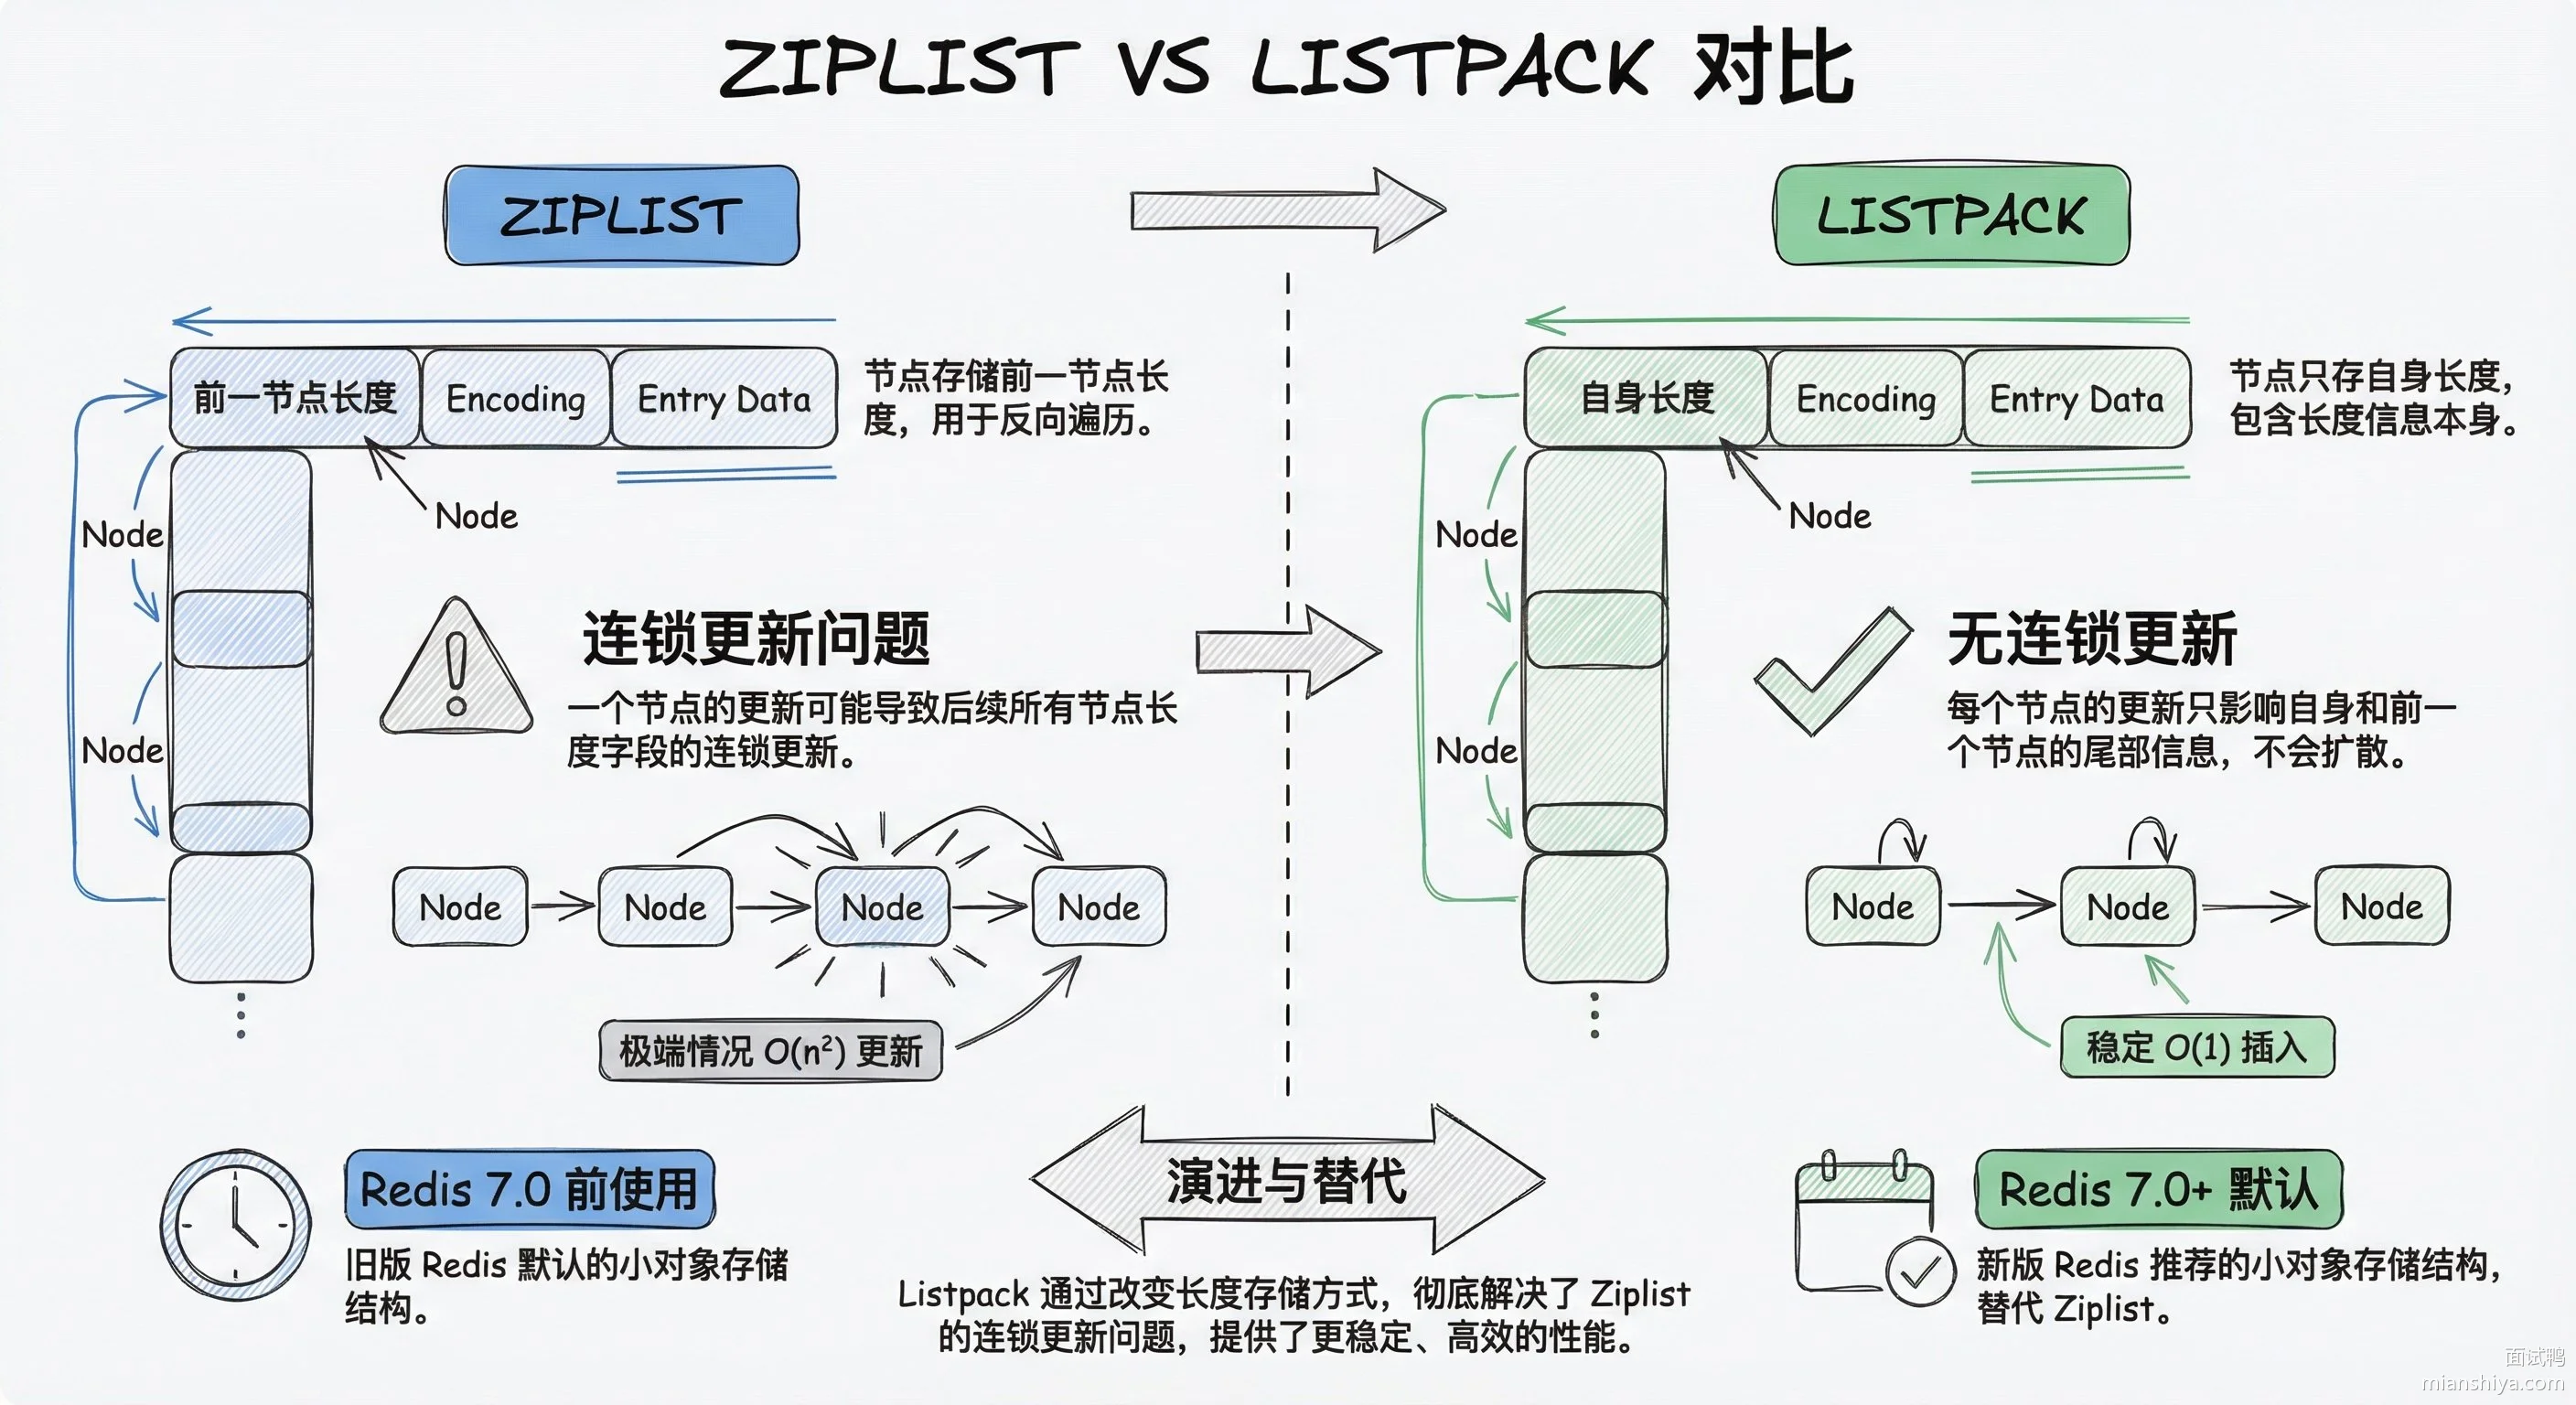
49.2.3. 内存编码的自动升级
Redis 的每种数据类型背后都有多种编码实现,会根据数据规模自动切换:
| 数据类型 | 小数据编码 | 大数据编码 | 切换阈值 |
|---|---|---|---|
| String | int/embstr | raw | 44 字节 |
| List | quicklist | quicklist | ~ |
| Hash | listpack | hashtable | 512 个 field |
| Set | intset/listpack | hashtable | 512 个元素 |
| ZSet | listpack | skiplist+hashtable | 128 个元素 |
阈值可以通过配置调整,比如 hash-max-listpack-entries 和 hash-max-listpack-value。
49.2.4. 相关链接
49.3. 常见问题
49.3.1. SDS 扩容的时候,新容量是怎么算的?
分两种情况。如果扩容后长度小于 1MB,直接翻倍,比如原来 10 字节扩到 20 字节;如果超过 1MB,每次只多加 1MB。这样小字符串扩容快、大字符串不浪费内存。
49.3.2. 渐进式 rehash 期间,读操作怎么处理?
先查 ht[0],没找到再查 ht[1]。写操作只往 ht[1] 写,不会再往旧表塞数据。所以整个 rehash 期间读写都正常,只是查询可能要查两张表。
49.3.3. ziplist 的连锁更新具体是怎么发生的?
ziplist 每个节点用 1 到 5 字节记录前一个节点的长度。如果前一个节点长度小于 254 字节,用 1 字节记;否则用 5 字节。假设连续多个节点长度都在 250-253 字节之间,某次插入导致第一个节点长度变成 254,后面节点的 prevlen 就得从 1 字节扩到 5 字节,接着又导致下一个节点长度增加,连锁反应一路传下去。
49.3.4. 共享对象池为什么只缓存 0 到 9999,不缓存更多?
缓存的整数越多,启动时占用的内存越大,而且命中率不一定高。0-9999 覆盖了绝大多数业务场景里的计数器、标志位、小 ID,再往上就是长尾了,投入产出不划算。可以通过 REDIS_SHARED_INTEGERS 编译参数调整,但一般没必要。
50. 说说 Redisson 分布式锁的原理?
50.1. 核心要点
Redisson 分布式锁的核心就是用 Redis 的 Hash 结构 + Lua 脚本保证原子性,再加上一个后台线程做自动续期。
50.1.1. 加锁流程
加锁时 Redisson 执行一段 Lua 脚本,逻辑分三步:
1)锁不存在,直接创建 Hash 结构,field 是线程标识,value 设为 1,然后设置过期时间,加锁成功 2)锁存在且 field 匹配当前线程,说明是重入,value 加 1,刷新过期时间,加锁成功 3)锁存在但 field 不匹配,说明被别人占着,返回锁的剩余存活时间,加锁失败
用 Hash 而不是 String 的好处是天然支持可重入,同一个线程多次加锁只需要累加计数。
50.1.2. 自动续期
加锁成功后(不手动设置过期时间),Redisson 会启动一个后台定时任务,默认每隔 10 秒把锁的过期时间重置为 30 秒。只要业务线程还活着、还持有锁,这个续期任务就会一直跑。业务执行完调用 unlock 或者线程挂了,续期任务才停止,锁自然过期。
这套机制叫 Watch Dog,解决了"业务还没跑完锁就过期"的难问题。
50.1.3. 解锁流程
解锁同样是一段 Lua 脚本:
1)锁不存在或者 field 不匹配当前线程,直接返回,防止误删别人的锁 2)field 匹配,计数减 1。如果减完还大于 0,说明还有重入没退出,刷新过期时间 3)计数减到 0,删除 key,同时 publish 一条消息通知其他等待的线程
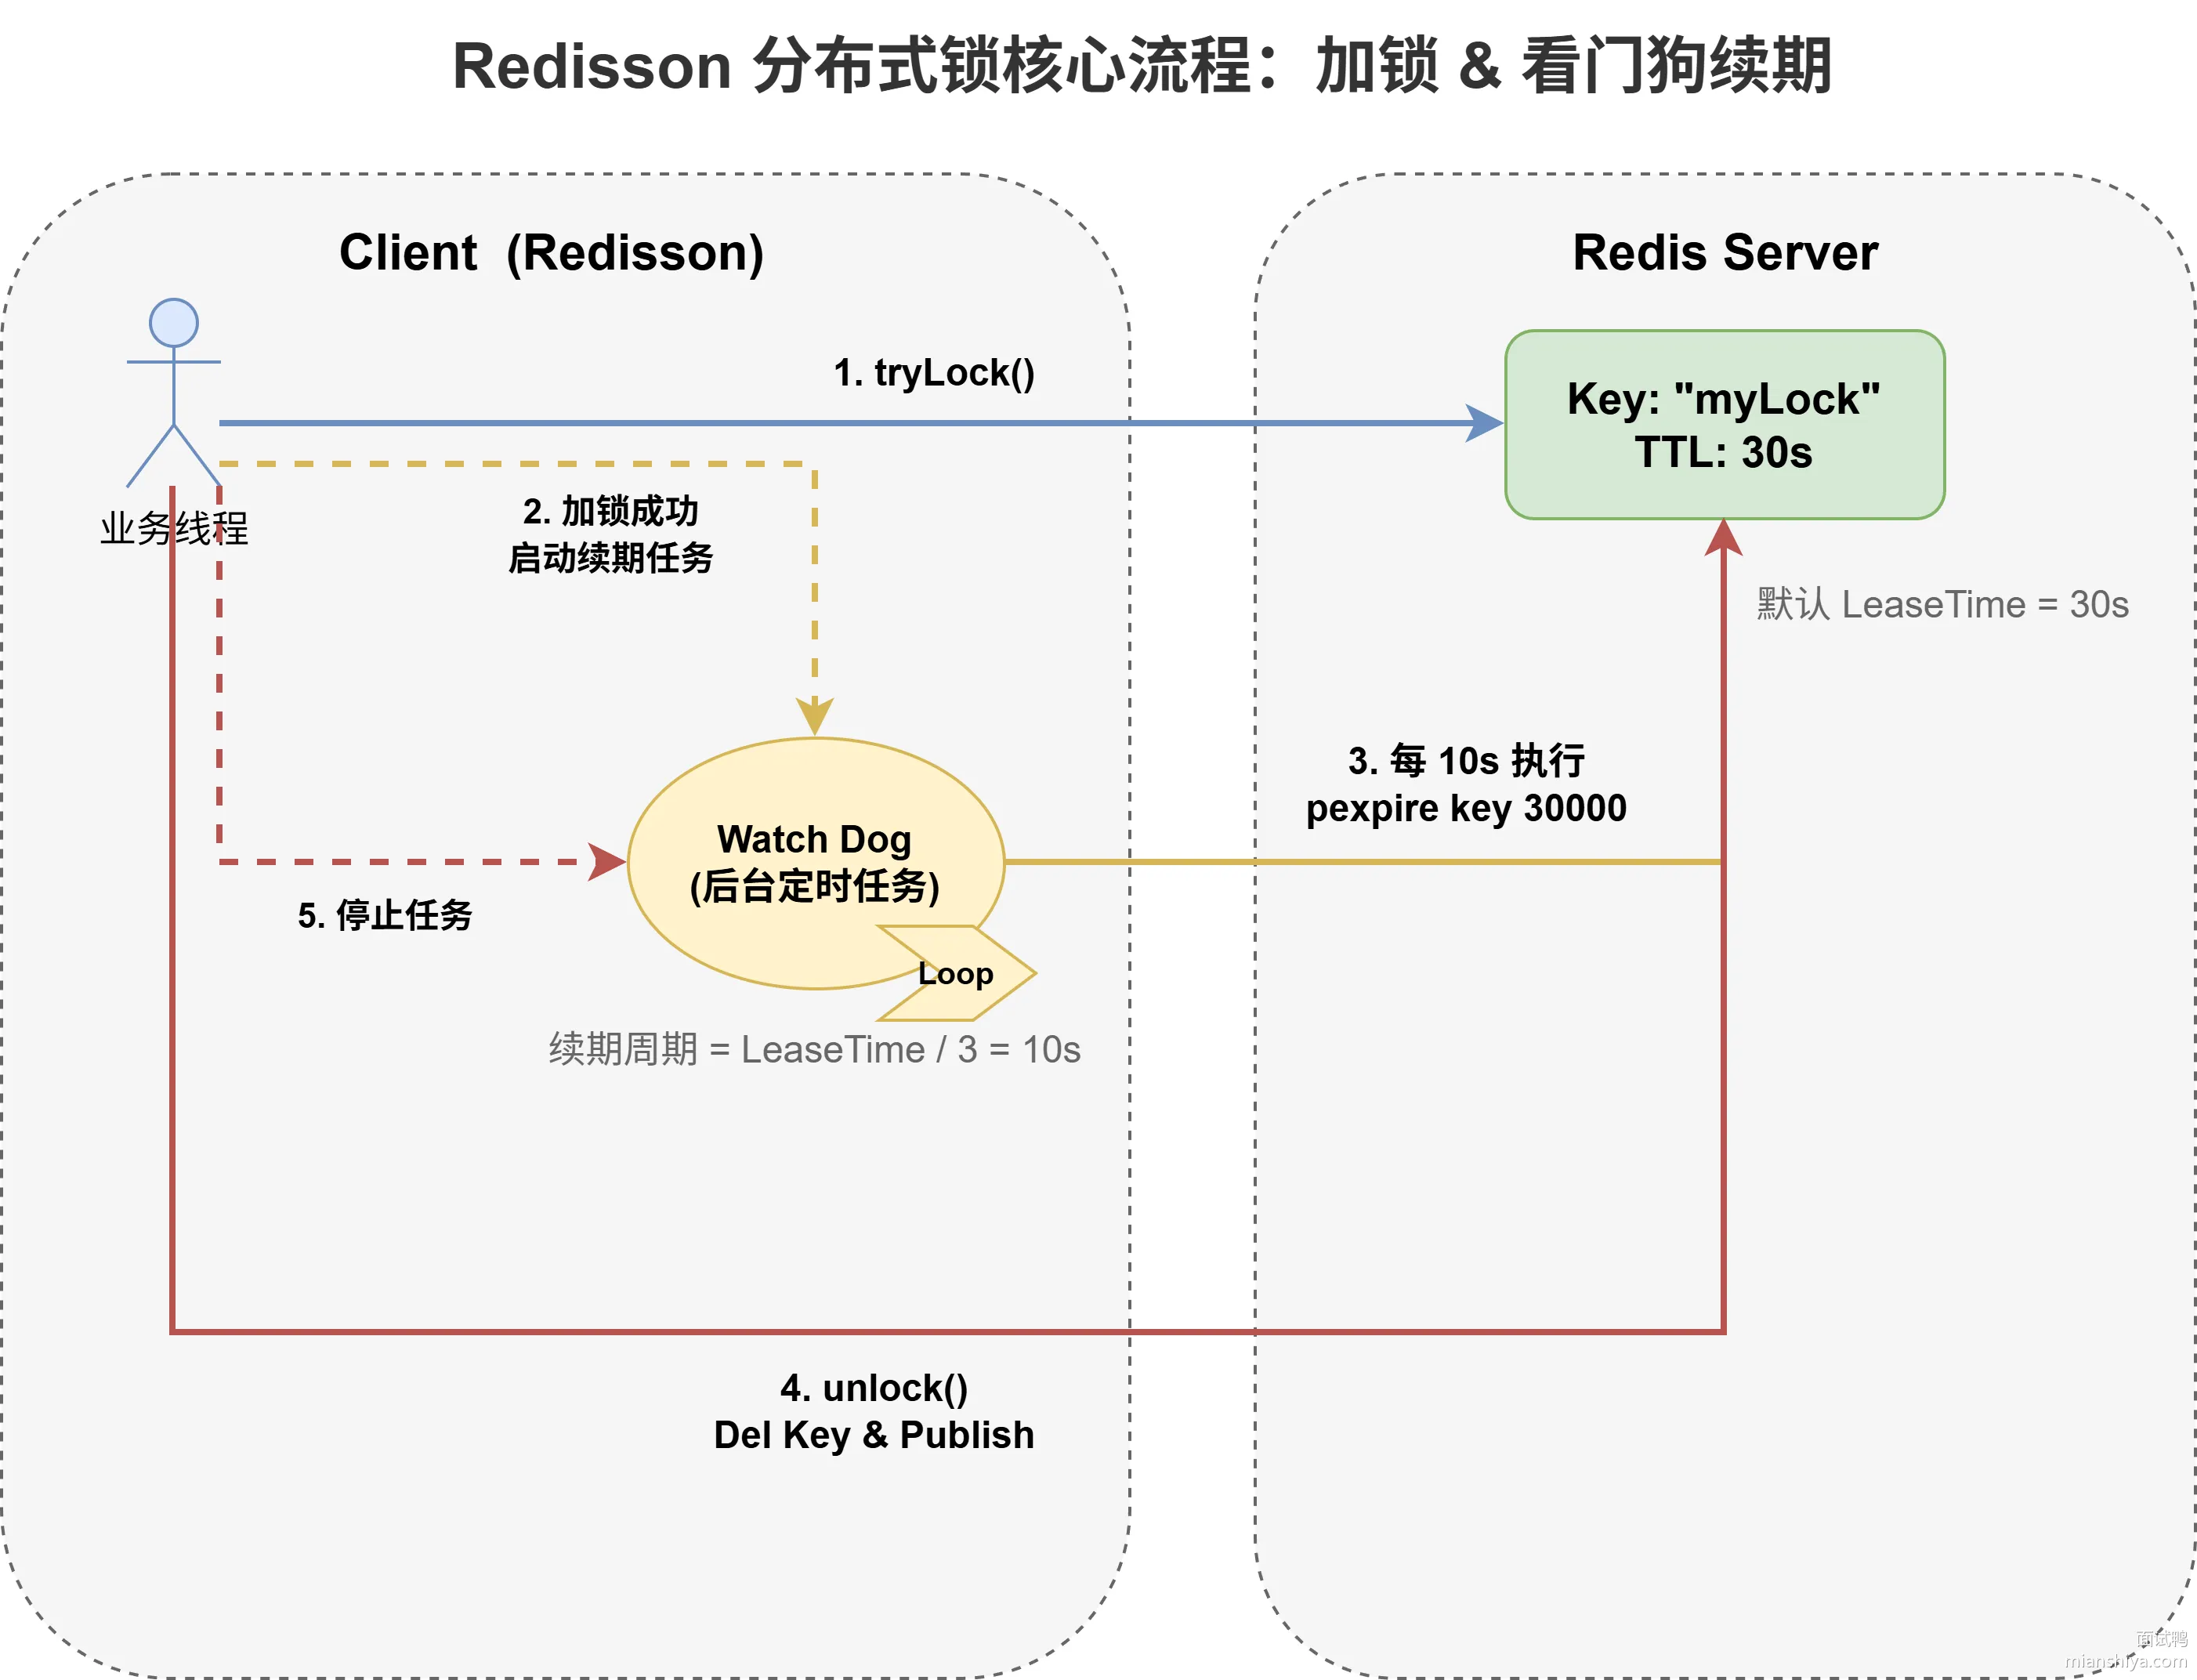
50.2. 扩展知识
50.2.1. Lua 脚本源码解析
加锁的核心代码:
<T> RFuture<T> tryLockInnerAsync(long waitTime, long leaseTime, TimeUnit unit, long threadId, RedisStrictCommand<T> command) {
    return commandExecutor.syncedEval(getRawName(), LongCodec.INSTANCE, command,
            "if ((redis.call('exists', KEYS[1]) == 0) " +
                        "or (redis.call('hexists', KEYS[1], ARGV[2]) == 1)) then " +
                    "redis.call('hincrby', KEYS[1], ARGV[2], 1); " +
                    "redis.call('pexpire', KEYS[1], ARGV[1]); " +
                    "return nil; " +
                "end; " +
                "return redis.call('pttl', KEYS[1]);",
            Collections.singletonList(getRawName()), unit.toMillis(leaseTime), getLockName(threadId));
}
这里 KEYS[1] 是锁的名称,ARGV[1] 是过期时间毫秒数,ARGV[2] 是线程唯一标识。hincrby 命令在 key 不存在时会自动创建 Hash 并设置初始值。
解锁的核心代码:
protected RFuture<Boolean> unlockInnerAsync(long threadId) {
    return evalWriteAsync(getRawName(), LongCodec.INSTANCE, RedisCommands.EVAL_BOOLEAN,
          "if (redis.call('hexists', KEYS[1], ARGV[3]) == 0) then " +
                    "return nil;" +
                "end; " +
                "local counter = redis.call('hincrby', KEYS[1], ARGV[3], -1); " +
                "if (counter > 0) then " +
                    "redis.call('pexpire', KEYS[1], ARGV[2]); " +
                    "return 0; " +
                "else " +
                    "redis.call('del', KEYS[1]); " +
                    "redis.call('publish', KEYS[2], ARGV[1]); " +
                    "return 1; " +
                "end; " +
                "return nil;",
            Arrays.asList(getRawName(), getChannelName()), LockPubSub.UNLOCK_MESSAGE, internalLockLeaseTime, getLockName(threadId));
}
publish 发消息到 channel,让订阅的线程知道锁释放了,可以来抢了。
50.2.2. Redisson 支持的锁类型
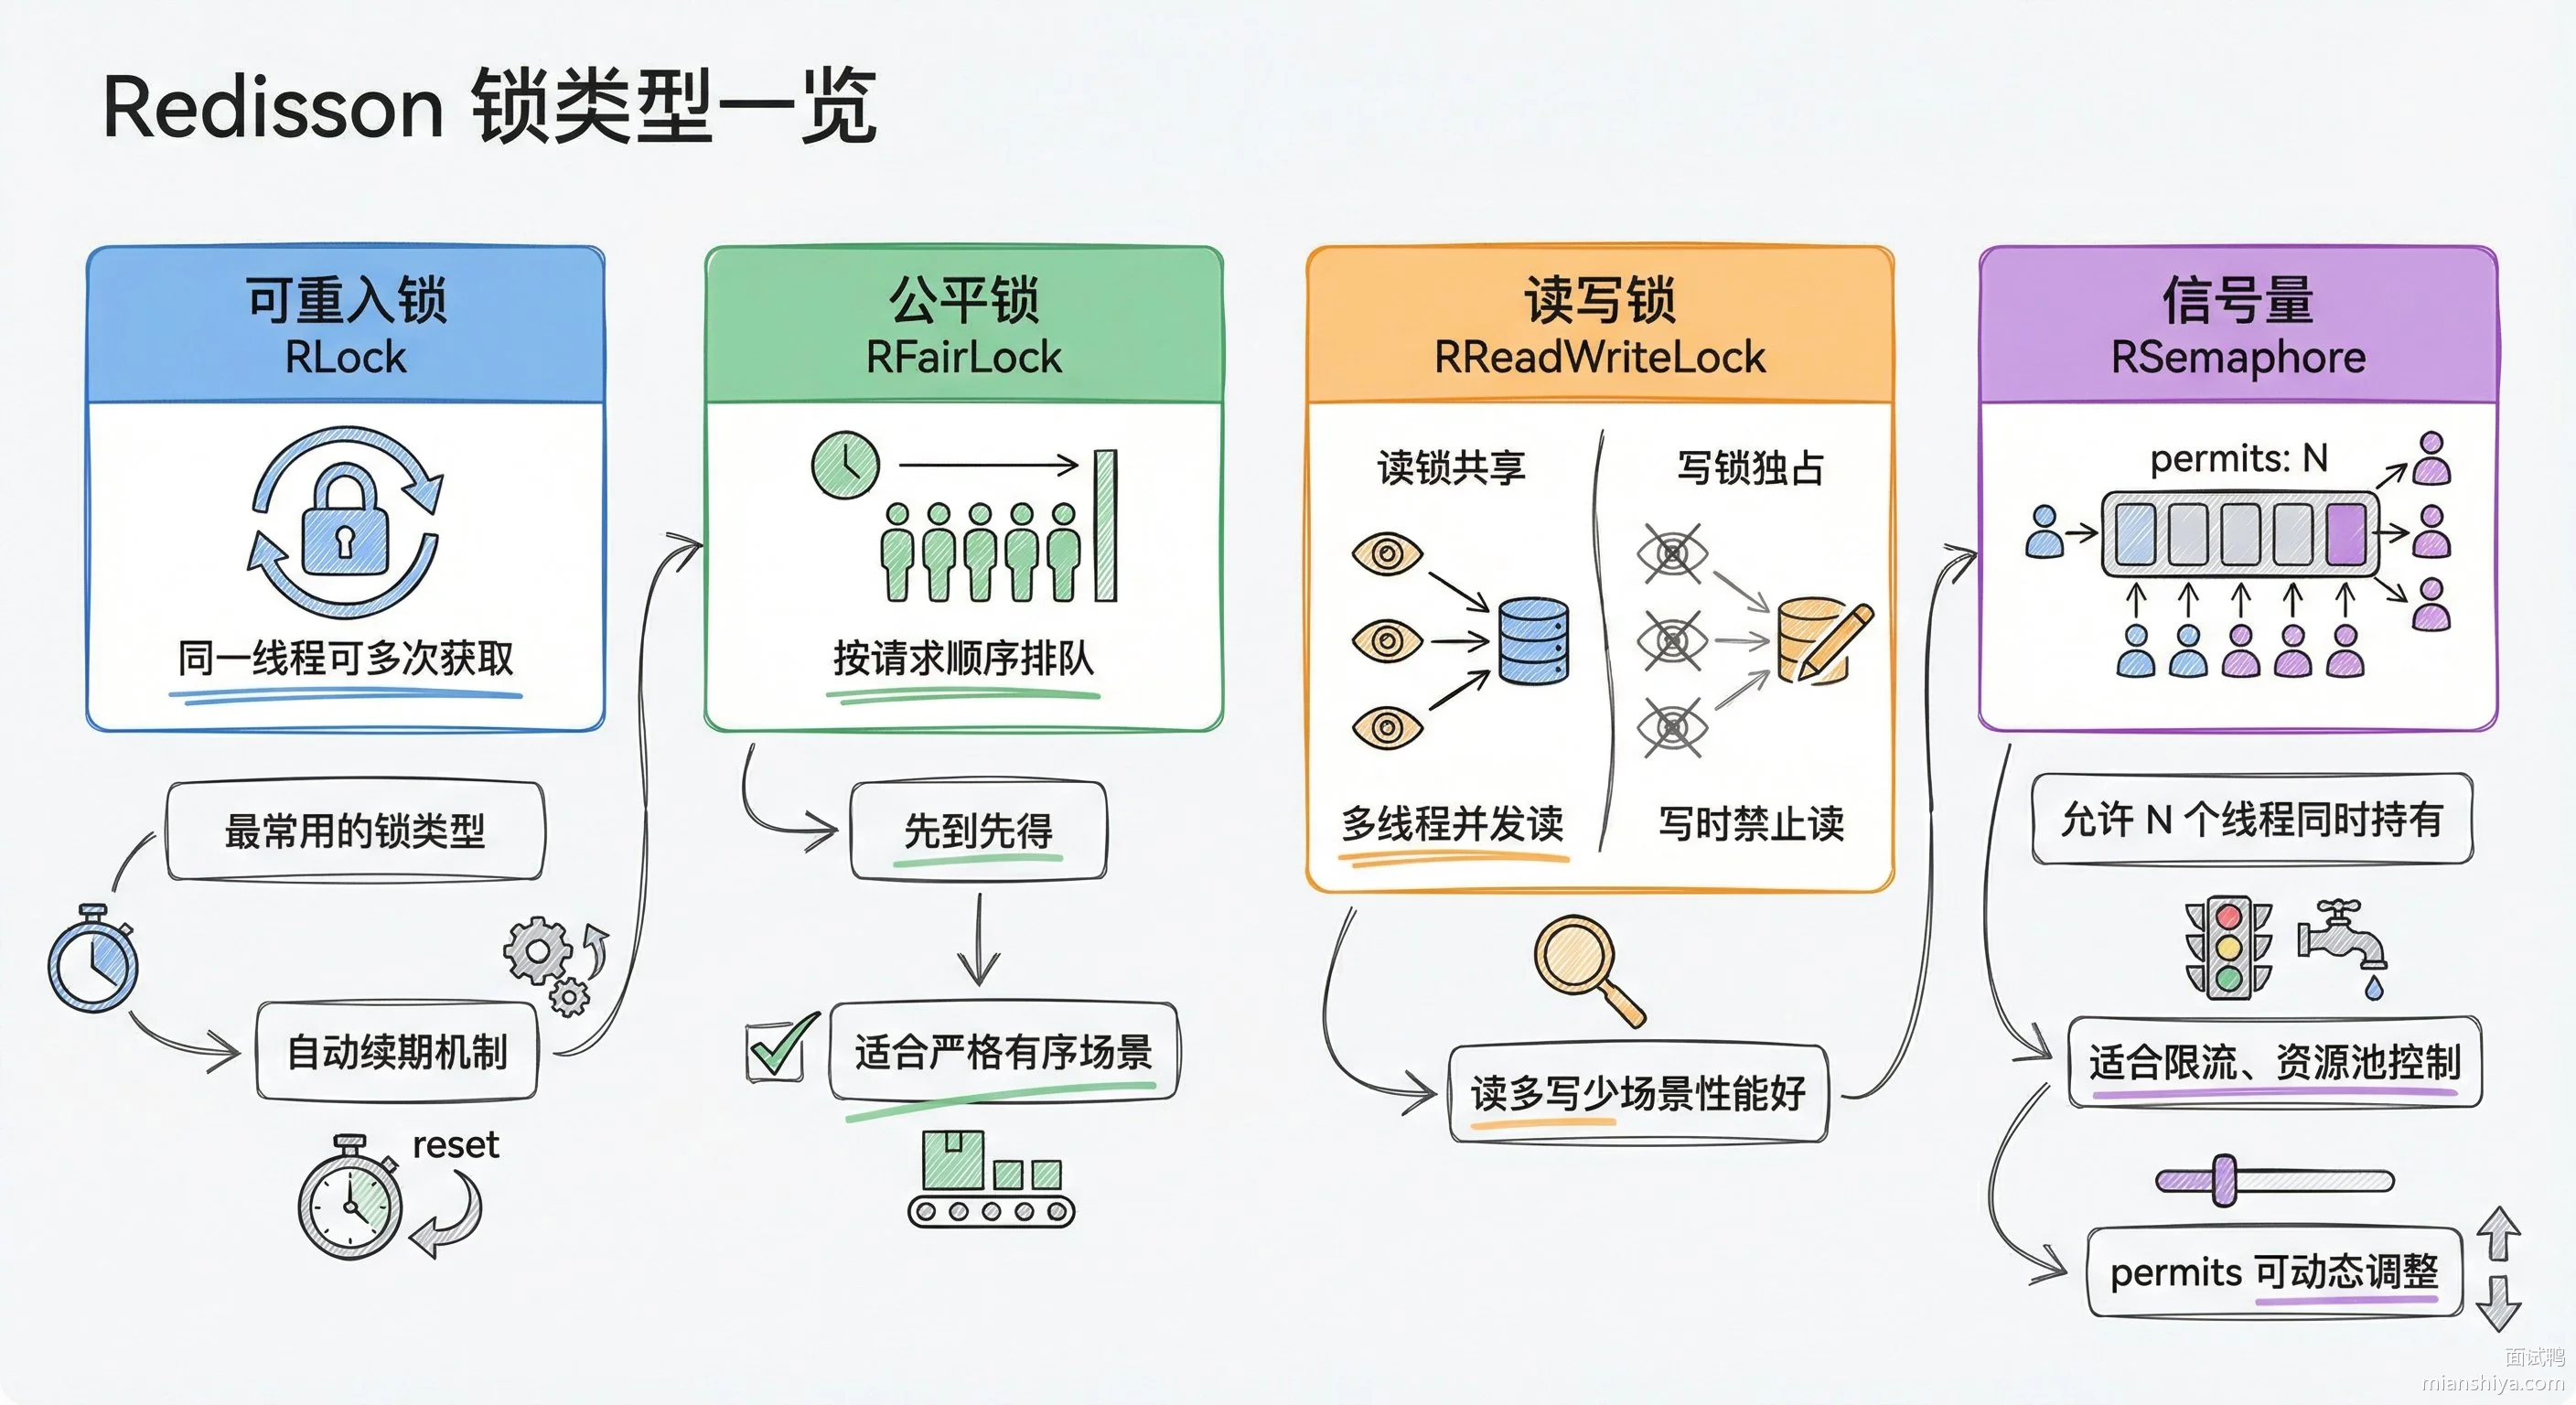
50.2.3. 主从架构下的锁安全问题
Redis 主从复制是异步的,存在一个隐患:客户端在 master 上加锁成功,master 还没来得及把数据同步给 slave 就挂了,slave 提升为新 master 后锁就丢了,另一个客户端又能加锁成功,两个客户端同时持有锁。
为了解决这个问题,Redis 作者提出了 RedLock 算法:部署 5 个独立的 Redis 实例,客户端依次向每个实例加锁,只有超过半数加锁成功且总耗时没超过锁的过期时间,才算加锁成功。
Redisson 提供了 RedissonRedLock 实现,但实际上这个方案争议很大,Martin Kleppmann 写过文章质疑它的正确性。大多数业务场景下,单实例 + Watch Dog 已经够用;对一致性要求极高的场景,建议用 ZooKeeper 或 etcd。
50.2.4. 相关链接
50.3. 常见问题
50.3.1. Watch Dog 续期的时间间隔和锁过期时间是怎么配的?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
默认锁过期时间 30 秒,续期间隔是过期时间的三分之一,也就是 10 秒。每 10 秒把锁重置为 30 秒,保证业务还在跑的时候锁不会过期。这两个参数可以通过 Config.setLockWatchdogTimeout() 调整。
50.3.2. 如果业务线程卡死了,锁会一直续期吗?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
不会。续期任务和业务线程是绑定的,本质上是把任务挂在 Netty 的 eventLoop 上。如果业务线程所在的 JVM 进程挂了,续期任务自然也没了,锁就会在 30 秒后自动过期。但如果只是业务逻辑死循环,进程还活着,续期任务确实会一直跑,锁不会释放。所以业务代码里最好用 try-finally 保证 unlock,或者用 tryLock 带超时。
50.3.3. Redisson 加锁失败后是怎么等待的?
详细解答可以看:Redisson 看门狗(watch dog)机制了解吗?
加锁失败时 Lua 脚本会返回锁的剩余存活时间,客户端订阅一个 channel 等待解锁消息。等收到消息或者等待超时,再重新尝试加锁。这比纯轮询效率高,减少了无效的 Redis 请求。
50.3.4. RedLock 为什么要 5 个实例,3 个行不行?
3 个也行,只要是奇数就行,核心是超过半数成功。5 个的好处是容错性更强,挂 2 个还能正常工作。3 个的话挂 1 个就只剩 2 个,刚好过半,再挂一个就不可用了。实例数越多容错越好,但加锁延迟也越高,5 个是个平衡点。
51. Redis Zset 的实现原理是什么?
51.1. 核心要点
ZSet 的底层是跳表 + 哈希表双结构配合。跳表按 score 排序,支持 O(log N) 的插入、删除和范围查询;哈希表存 member 到 score 的映射,支持 O(1) 的单点查分。
为什么要两个结构?各取所长:
1)通过 member 查 score,比如 ZSCORE key member,走哈希表,O(1) 搞定
2)按 score 范围查 member,比如 ZRANGEBYSCORE key 0 100,走跳表,O(log N + M)
3)插入和删除同时更新两个结构,跳表部分 O(log N),哈希表部分 O(1),整体 O(log N)
如果只用跳表,按 member 查 score 就得遍历,复杂度退化到 O(N)。如果只用哈希表,范围查询没法搞。两个结构各管各的,互补短板。
当元素少的时候,ZSet 会用 listpack 来存,省内存。触发条件是元素个数不超过 128 且每个元素长度不超过 64 字节,任意一个条件破了就自动升级成跳表+哈希表。这俩阈值可以通过 zset-max-listpack-entries 和 zset-max-listpack-value 配置。
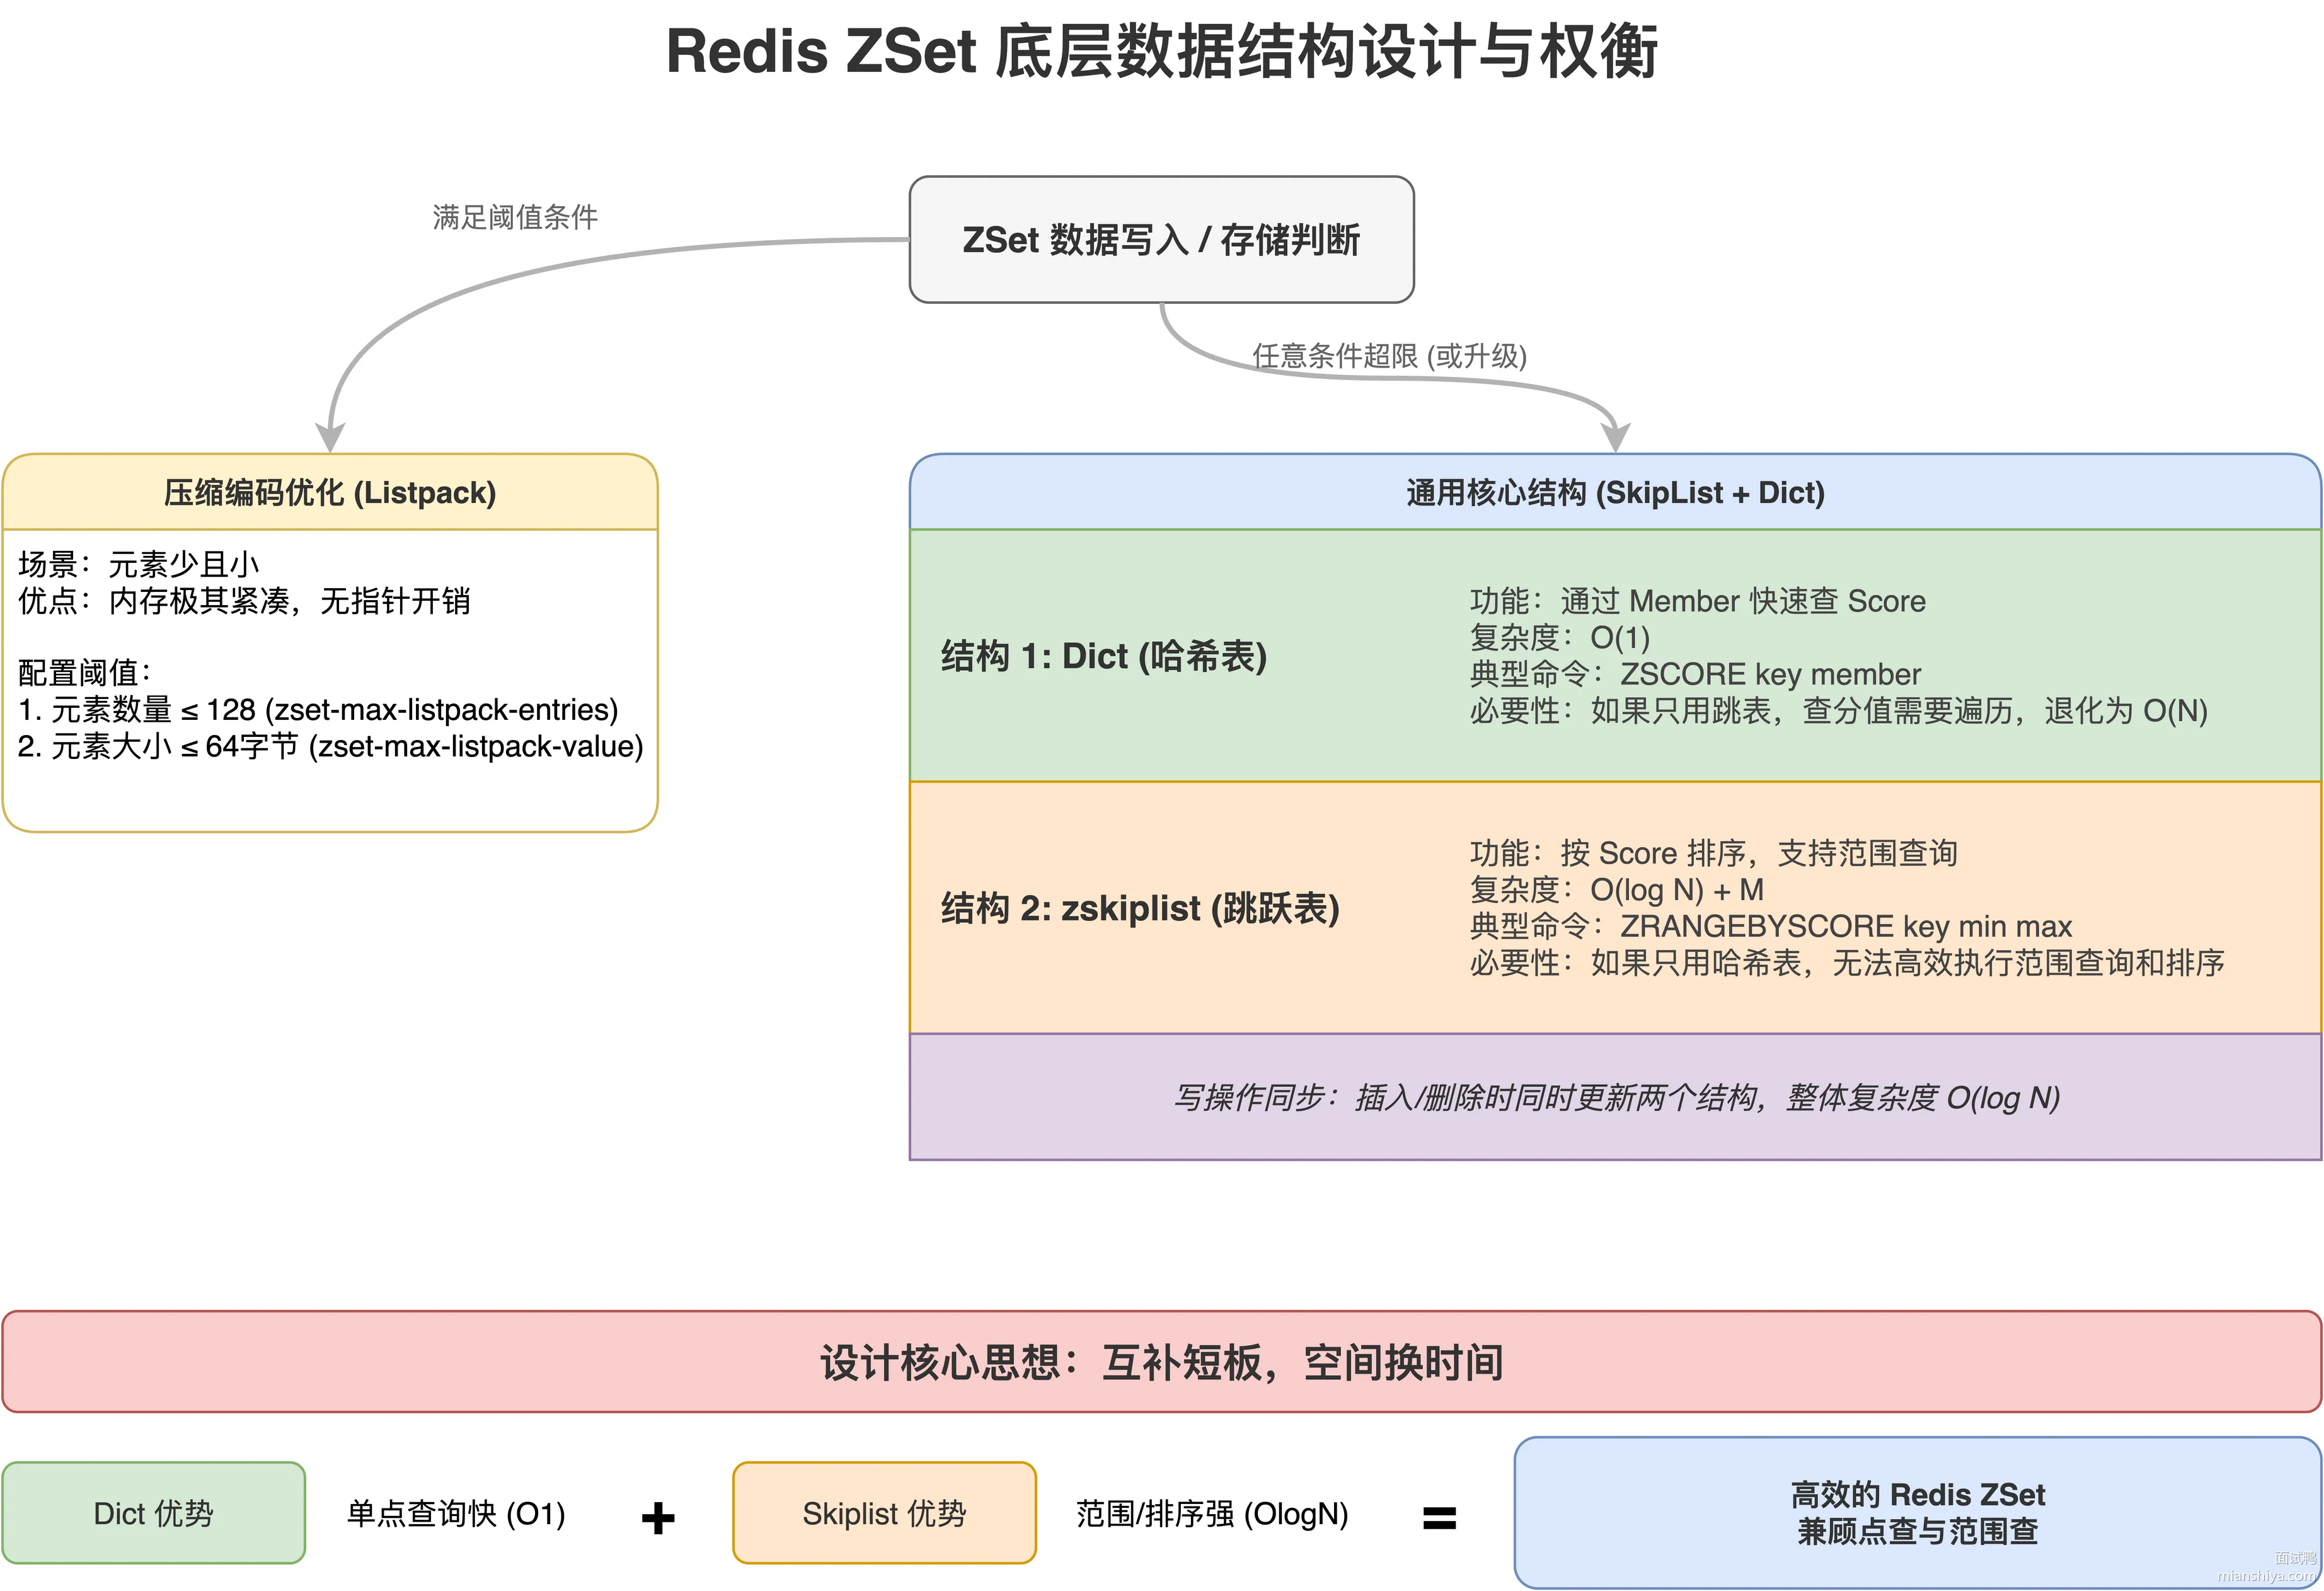
51.2. 扩展知识
51.2.1. 跳表结构详解
跳表本质上是一个多层链表。最底层是完整的有序链表,往上每一层都是下一层的"快速通道",节点按一定概率被提升到上层。查找时从最高层开始,能跳就跳,跳不动就下沉,类似二分查找的思路。
Redis 的跳表实现有几个特点:
1)最高 32 层,每个节点有 1/4 概率升到上一层
2)支持双向遍历,每个节点有 backward 指针指向前一个节点
3)支持重复 score,同 score 的 member 按字典序排列
typedef struct zskiplistNode {
    sds ele;                         // member
    double score;                    // 分数
    struct zskiplistNode *backward;  // 后退指针
    struct zskiplistLevel {
        struct zskiplistNode *forward;  // 前进指针
        unsigned long span;             // 跨度,用于计算排名
    } level[];
} zskiplistNode;
span 字段很精妙,记录的是当前节点到下一个节点之间跨越了多少个元素。累加一路上的 span 就能算出元素的排名,ZRANK 命令就是这么实现的,不用真的去数。
举个查找例子,比如现有跳表结构如下, 然后需要查找数据 60 :
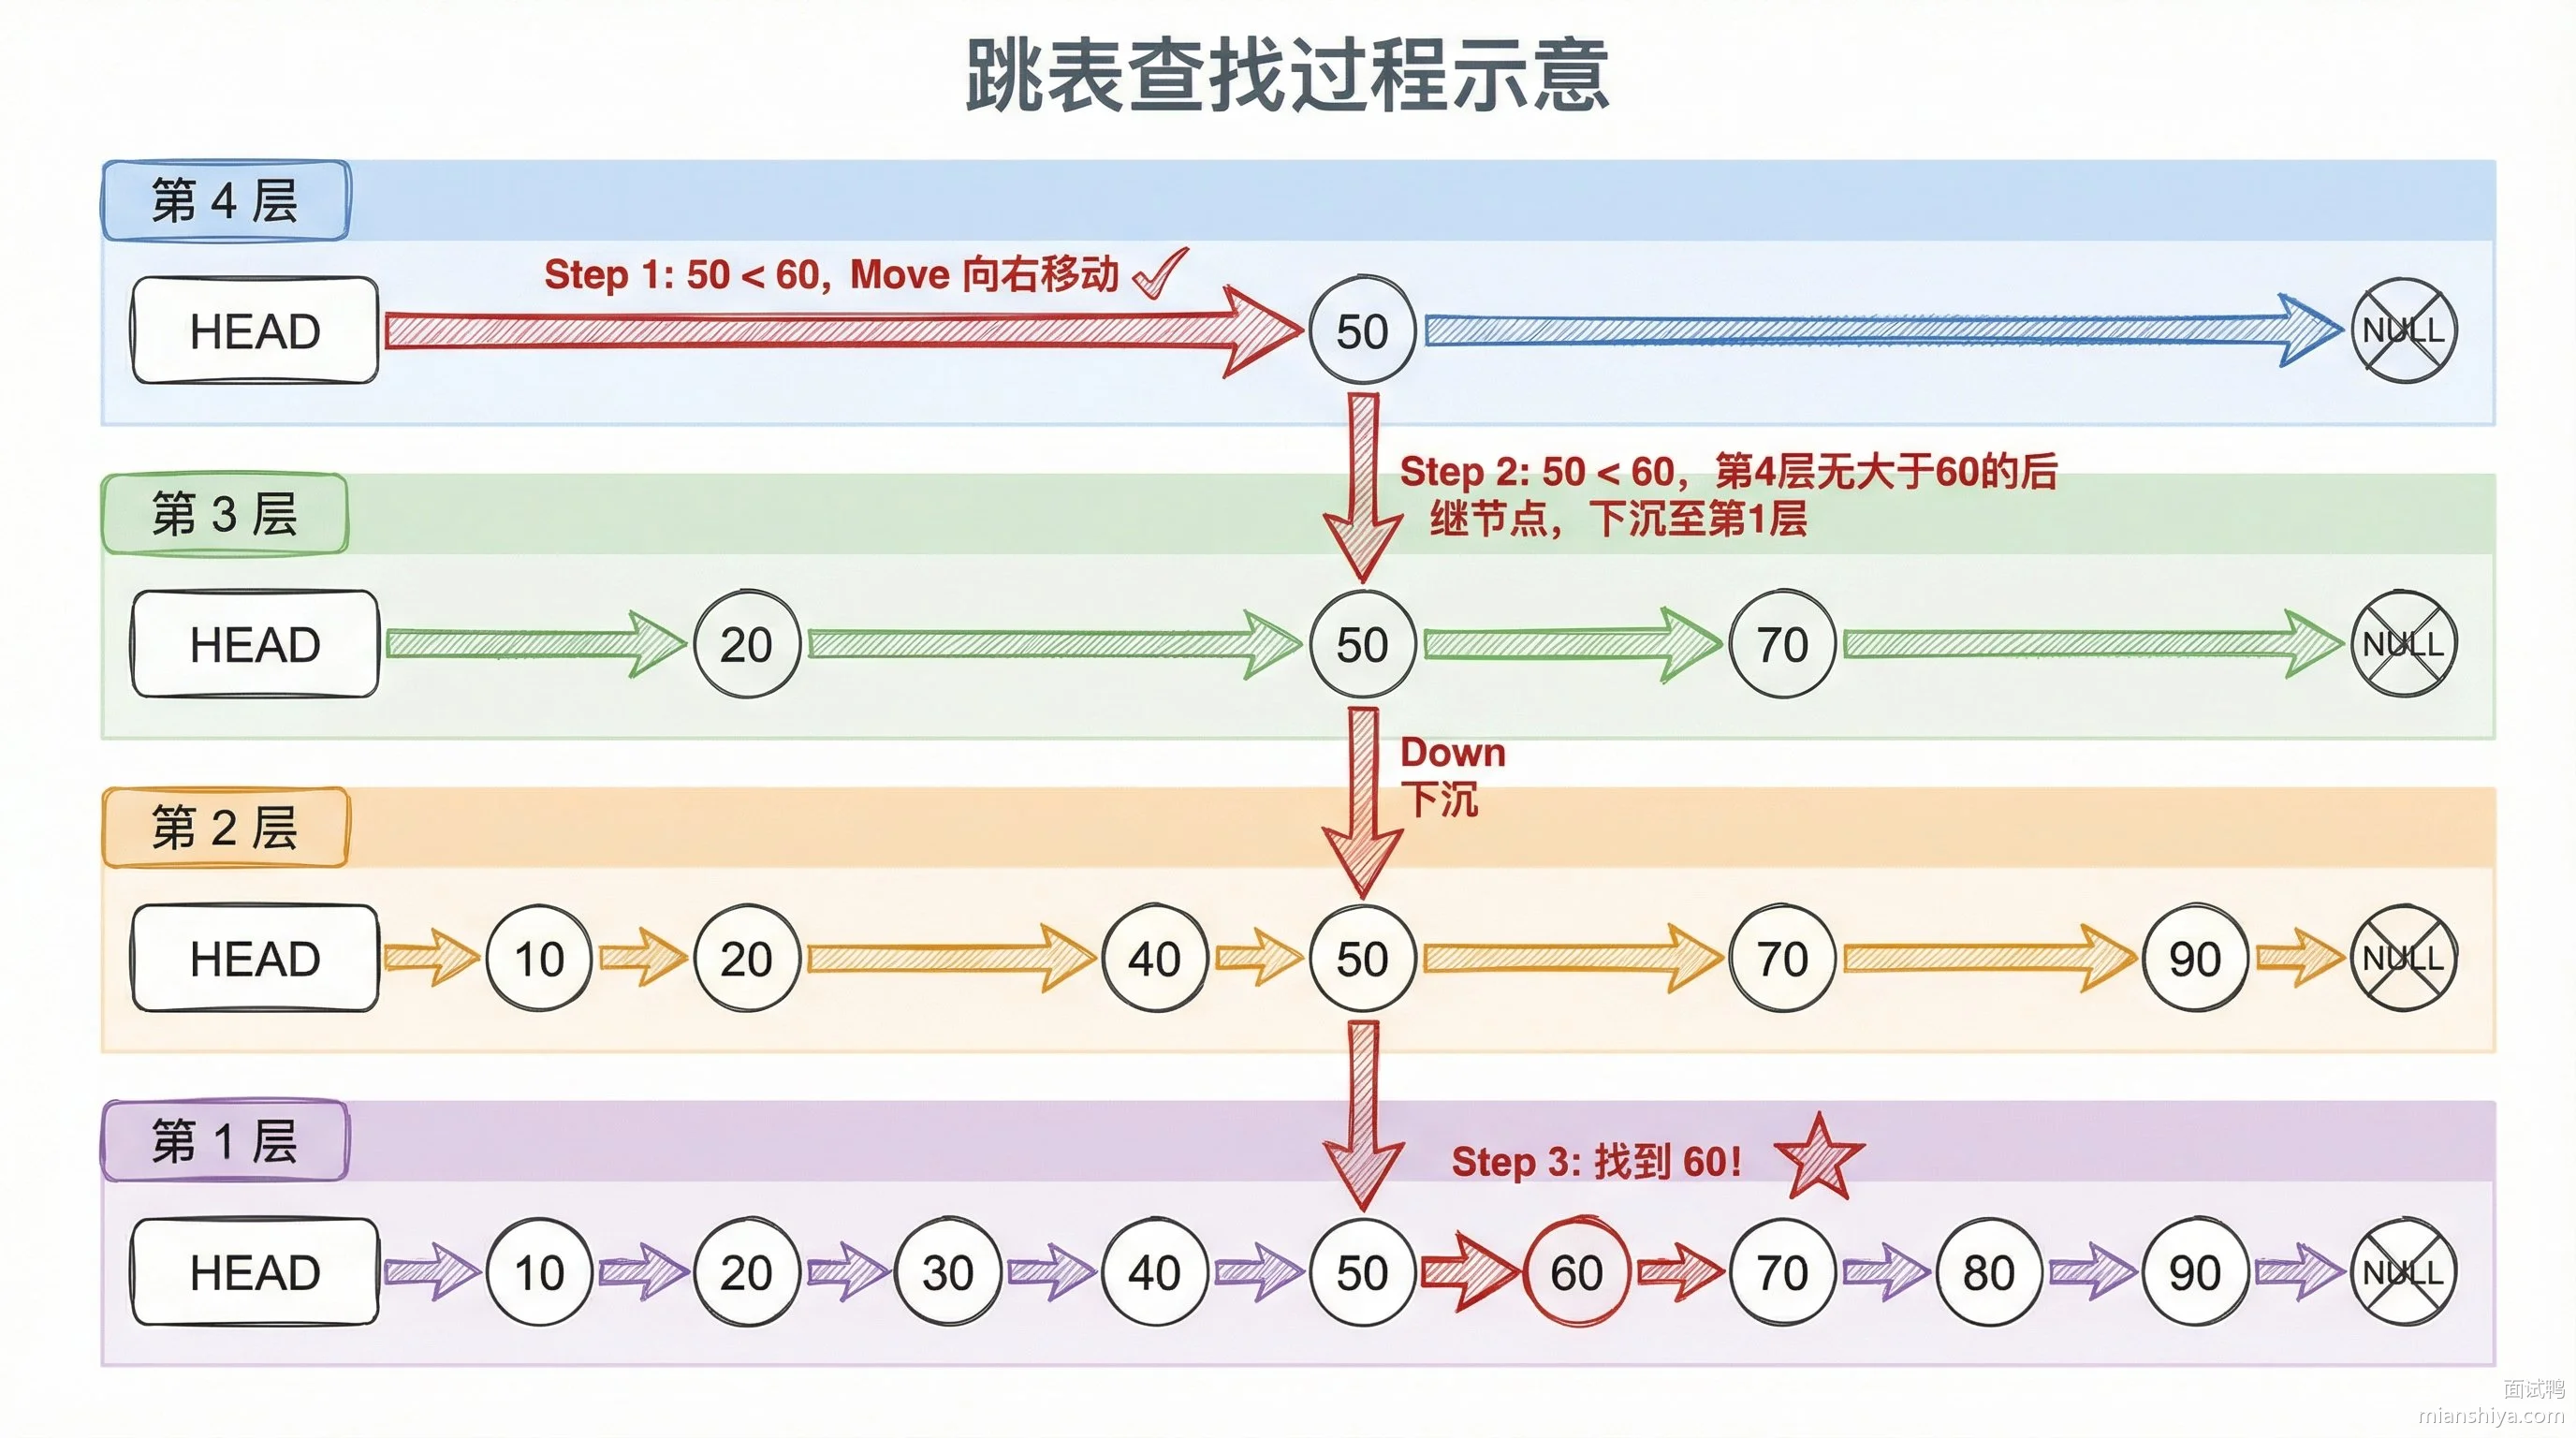
51.2.2. 为什么用跳表不用红黑树
Redis 作者 antirez 解释过这个选择:
1)跳表实现简单,代码量大概是红黑树的一半,好写好调试
2)范围查询天然友好,跳表本身就是有序链表,找到起点后顺着往后遍历就行;红黑树要中序遍历,没那么直观
3)插入删除只需要修改局部指针,不用像红黑树那样可能触发多次旋转
性能上两者差不多,都是 O(log N),但跳表的常数因子更小,缓存局部性也更好。
51.2.3. ZSet 常用命令的复杂度
| 命令 | 复杂度 | 说明 |
|---|---|---|
| ZADD | O(log N) | 跳表插入 + 哈希表更新 |
| ZREM | O(log N) | 跳表删除 + 哈希表删除 |
| ZSCORE | O(1) | 直接查哈希表 |
| ZRANK | O(log N) | 跳表查找 + span 累加 |
| ZRANGE | O(log N + M) | 定位 + 遍历 M 个元素 |
| ZRANGEBYSCORE | O(log N + M) | 同上 |
| ZCARD | O(1) | 直接返回长度字段 |
51.2.4. 典型应用场景
1)排行榜:游戏积分榜、文章热度榜,member 是用户/文章 ID,score 是分数/热度值。ZREVRANGE 取 Top N,ZRANK 查排名
2)延迟队列:member 是任务 ID,score 是执行时间戳。定时用 ZRANGEBYSCORE 取出到期任务处理
3)滑动窗口限流:member 是请求标识,score 是请求时间戳。每次请求先删除窗口外的旧记录,再统计窗口内的请求数
51.2.5. 相关链接
51.3. 常见问题
51.3.1. 跳表的层高是怎么决定的?
详细解答可以看:Redis 中跳表的实现原理是什么?
随机决定的。每个新节点创建时,先给它 1 层,然后以 25% 的概率决定要不要再升一层,升了就继续以 25% 概率判断下一层,直到不升为止或者到达最高层 32 层。这样平均下来每个节点大概 1.33 层,整体结构比较均衡。
51.3.2. 两个 member 的 score 相同怎么排?
按 member 的字典序排。Redis 内部比较时先比 score,score 相等再用 sdscmp 比较 member 字符串。所以 ZSet 的排序是稳定且确定的,不会出现同 score 的元素顺序不一致的情况。
51.3.3. ZRANK 是怎么算出排名的?
详细解答可以看:如何使用 Redis 快速实现排行榜?
靠跳表节点里的 span 字段。查找目标节点时,每往前跳一步就把 span 累加起来,最后累加值就是排名。不用真的从头数到尾,复杂度还是 O(log N)。
51.3.4. ZSet 能不能只用哈希表实现?
不能高效实现范围查询。哈希表只能做点查,ZRANGEBYSCORE 这种按 score 区间取数据的操作,哈希表只能遍历所有元素挨个比较,复杂度 O(N)。跳表天然有序,定位到区间起点后顺着链表往后取就行,复杂度 O(log N + M)。
52. 为什么 Redis Zset 用跳表实现而不是红黑树?B+树?
52.1. 核心要点
Redis 的 Zset 底层选择跳表主要有三个原因:实现简单、范围查询高效、结构灵活可调。
52.1.1. 为什么不用红黑树?
1)实现简单
跳表就是多层链表,通过概率算法动态生成索引层级,没有左旋右旋那套东西,代码写起来清爽很多。红黑树要维护平衡,插入删除都得搞旋转,代码量和理解成本都高不少。Redis 作者 antirez 自己也说过,跳表简单到他收到一个补丁就能快速实现 ZRANK 的 O(logN) 查询,改动量很小。
2)范围查询高效
Zset 最常用的操作就是 ZRANGE、ZREVRANGE 这类范围查询。跳表通过 O(logN) 定位到起点后,直接沿着底层链表往后遍历就行,缓存局部性很好。红黑树从结构上就不支持这种操作,要做范围查询得中序遍历,跳来跳去的效率差远了。
3)结构灵活
跳表的层数是动态的,节点要升几层完全靠概率决定,数据量大就多几层,数据量小就少几层,自动适应。红黑树的结构是定死的,没法调整。
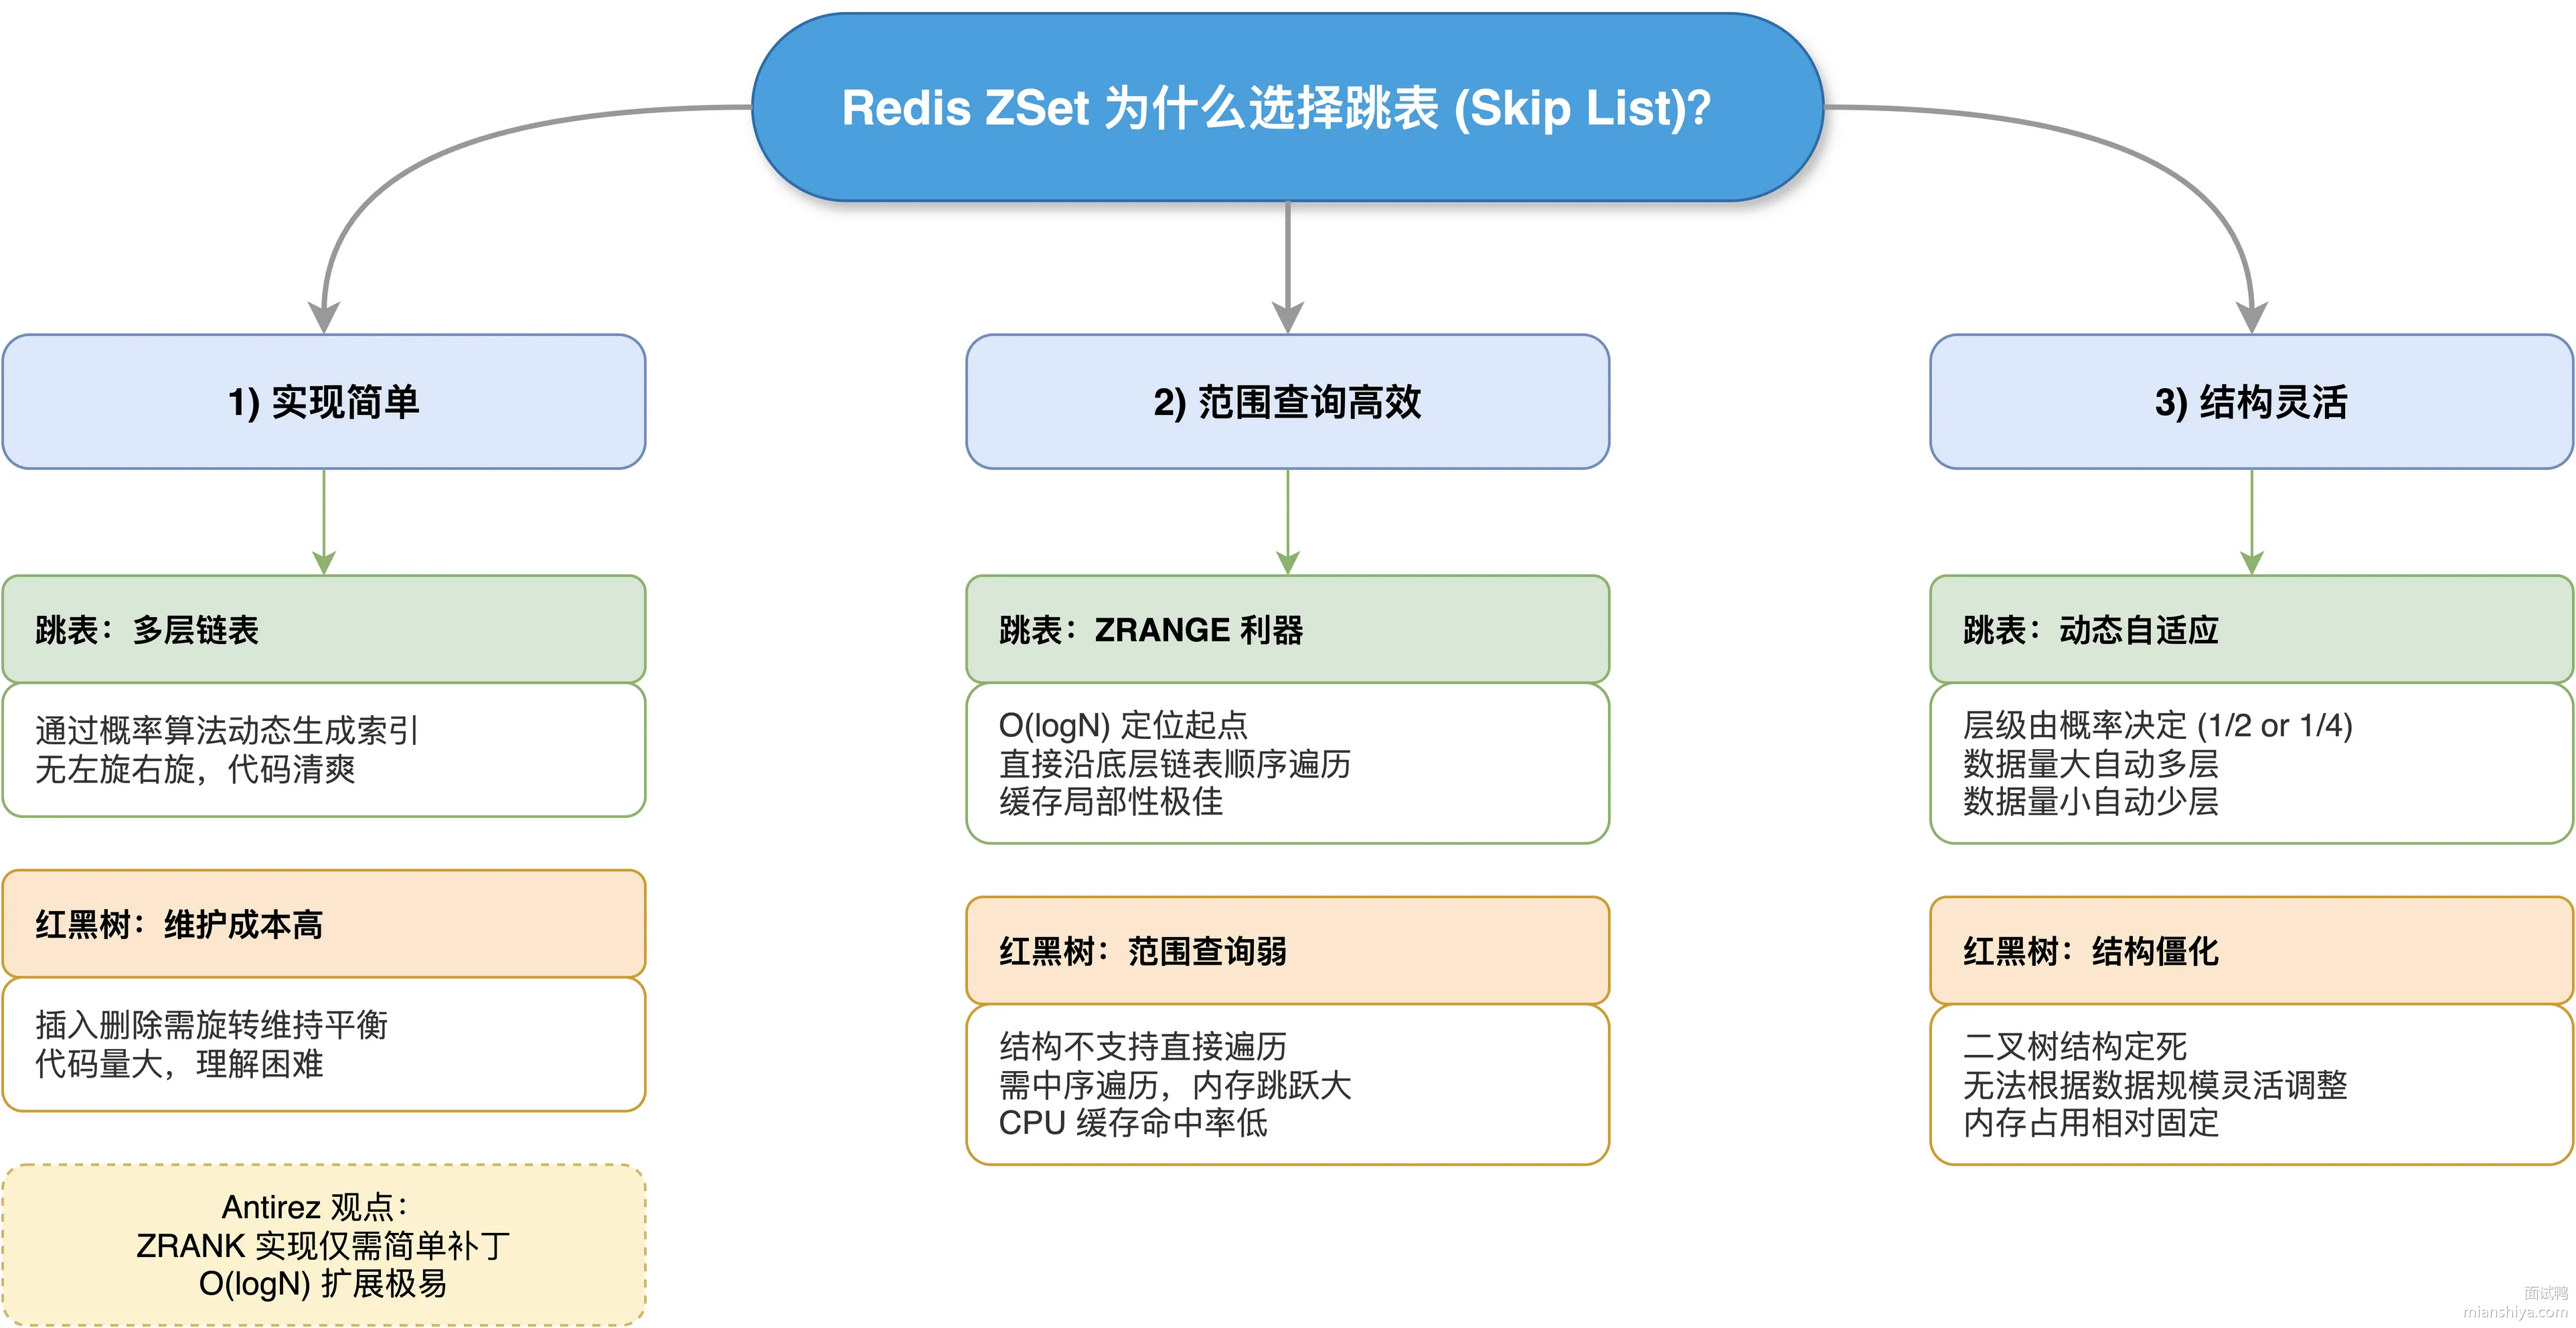
52.1.2. 为什么不用 B+ 树?
B+ 树是为磁盘设计的,放内存里反而不划算:
1)实现复杂度高。B+ 树插入和删除要处理节点分裂、合并、重新平衡,代码复杂度远高于跳表。跳表的插入删除本质就是链表操作 + 随机层数,非常简单。
2)B+ 树真正的优势在于减少磁盘 IO。B+ 树高扇出是为了让树更矮、减少磁盘寻道次数,非叶子节点只存索引能让内存放下更多索引信息,适合 MySQL 这种海量数据存磁盘的场景。Redis 数据全在内存,用不上这个优势。
52.2. 扩展知识
52.2.1. 跳表的核心原理
跳表本质上是一个带多级索引的有序链表。最底层是完整的有序链表,往上每一层都是下一层的"快速通道",通过跳过一些节点来加速查找。
查找过程从最高层开始,能往右走就往右走,走不动了就往下降一层继续。
举个查找例子,比如现有跳表结构如下, 然后需要查找数据 60 :
整个过程跳过了大量节点,时间复杂度 O(logN)。
52.2.2. Redis 跳表的实现细节
Redis 的跳表实现有几个特点值得注意:
1)层数上限是 32 层,足够支撑 2^32 个元素了
2)每个节点升层的概率是 1/4,不是教科书里常见的 1/2。这样索引更稀疏,内存占用更小,Redis 团队实测下来性能也够用
3)底层链表是双向的,有个 backward 指针指向前一个节点。这是为了支持 ZREVRANGE 反向遍历,单向链表做不到
4)每个节点除了存 score 和 member,还存了一个 span 字段记录跨度,用来快速计算排名。比如 ZRANK 命令就是靠累加路径上的 span 值实现 O(logN) 查询的
Redis 7.0 最多 32 层,足够支撑 2^64 个元素了。Redis 5.0 之前是 64 层,后来发现 32 层完全够用就改了。
52.2.3. redis 作者对 zset 用跳表实现的原因解释
Is there any particular reason you chose skip list instead of btrees except for simplicity? Skip lists consume more memory in pointers and are generally slower than btrees because of poor memory locality so traversing them means lots of cache misses.
之前有人询问作者 antirez,不用 b 树而用跳表来实现 zset 除了简单之外还有什么特别原因吗?跳表在指针上比 b 树消耗的更多的内存,并且通常因为内存局部性差,可能有大量缓存未命中索引而访问起来比 b 树慢。
作者 antirez 回复如下:
There are a few reasons:
- They are not very memory intensive. It's up to you basically. Changing parameters about the probability of a node to have a given number of levels will make then less memory intensive than btrees.
- A sorted set is often target of many ZRANGE or ZREVRANGE operations, that is, traversing the skip list as a linked list. With this operation the cache locality of skip lists is at least as good as with other kind of balanced trees.
- They are simpler to implement, debug, and so forth. For instance thanks to the skip list simplicity I received a patch (already in Redis master) with augmented skip lists implementing ZRANK in O(log(N)). It required little changes to the code.
以下是翻译内容:
有以下几个原因:
1)它们对内存的占用不是很大。这基本上取决于你的设置。通过调整节点拥有特定层数的概率参数,可以使跳表比 B 树更少占用内存。
2)排序集合经常会被用于许多 ZRANGE 或 ZREVRANGE 操作,也就是以链表的方式遍历跳表。在这种操作中,跳表的缓存局部性至少与其他类型的平衡树一样好。
3)跳表实现起来更简单,调试等操作也更方便。例如,由于跳表的简单性,我收到了一个补丁(已经在 Redis 的主分支中实现),它使用增强的跳表在 O(log(N)) 的时间复杂度内实现了 ZRANK。这只需要对代码进行很少的修改。
52.2.4. 其他
- 7. Redis 中跳表的实现原理是什么?
- 为什么 JDK 1.8 对 HashMap 进行了红黑树的改动?
- 说说平衡树的基本实现,与红黑树的区别是什么?
52.3. 常见问题
52.3.1. Zset 底层只用了跳表吗?什么时候用的是别的结构?
详细解答可以看:Redis Zset 的实现原理是什么?
数据量小的时候用的是 ziplist(Redis 7.0 之后换成了 listpack)。具体阈值是元素个数不超过 zset-max-ziplist-entries(默认 128)且每个元素大小不超过 zset-max-ziplist-value(默认 64 字节)。超过这个阈值才会转成跳表。ziplist 是紧凑的连续内存结构,小数据量下内存利用率高,遍历也快,没必要上跳表那套索引结构。
52.3.2. 跳表的层数是怎么决定的?为什么 Redis 选择 1/4 的概率而不是 1/2?
详细解答可以看:Redis 中跳表的实现原理是什么?
每个节点插入时通过随机函数决定层数,从 1 层开始,每次有 p 的概率升一层,直到不升为止或者达到最大层数。教科书一般用 p=1/2,这样平均每 2 个节点有 1 个升到第二层,每 4 个有 1 个升到第三层。Redis 用 p=1/4 意味着索引更稀疏,第二层大约每 4 个节点才有一个。好处是省内存,代价是查找路径稍微长一点,但 Redis 实测下来这个 trade-off 划算。
52.3.3. ConcurrentSkipListMap 也是用跳表实现的,它和 Redis 跳表有什么区别?
详细解答可以看:Redis 中跳表的实现原理是什么?
ConcurrentSkipListMap 是 Java 并发包里的数据结构,主要区别在于它要处理多线程并发问题,用了大量 CAS 操作来保证线程安全。Redis 是单线程模型处理命令,跳表实现不用考虑并发,代码简单很多。另外 ConcurrentSkipListMap 只能按 key 排序,Redis 的跳表是按 score 排序,还额外维护了 span 字段用来算排名。
53. Redisson 看门狗(watch dog)机制了解吗?
53.1. 核心要点
Redisson 的看门狗就是用来解决分布式锁续期问题的。场景很常见:业务逻辑还没执行完,锁的超时时间先到了,锁被自动释放,别的线程就能抢到锁,两个线程同时操作临界资源,数据就乱了。
看门狗的原理很简单:不设置 leaseTime 的时候,Redisson 会启动一个定时任务,默认每 10 秒往 Redis 发一次请求,把锁的过期时间重置为 30 秒。只要业务还在跑,锁就一直续着。
释放锁的时候,看门狗定时任务会被取消。如果客户端直接宕机了,定时任务自然也就没了,不会再续期,等 30 秒超时一到锁自动释放,不会死锁。
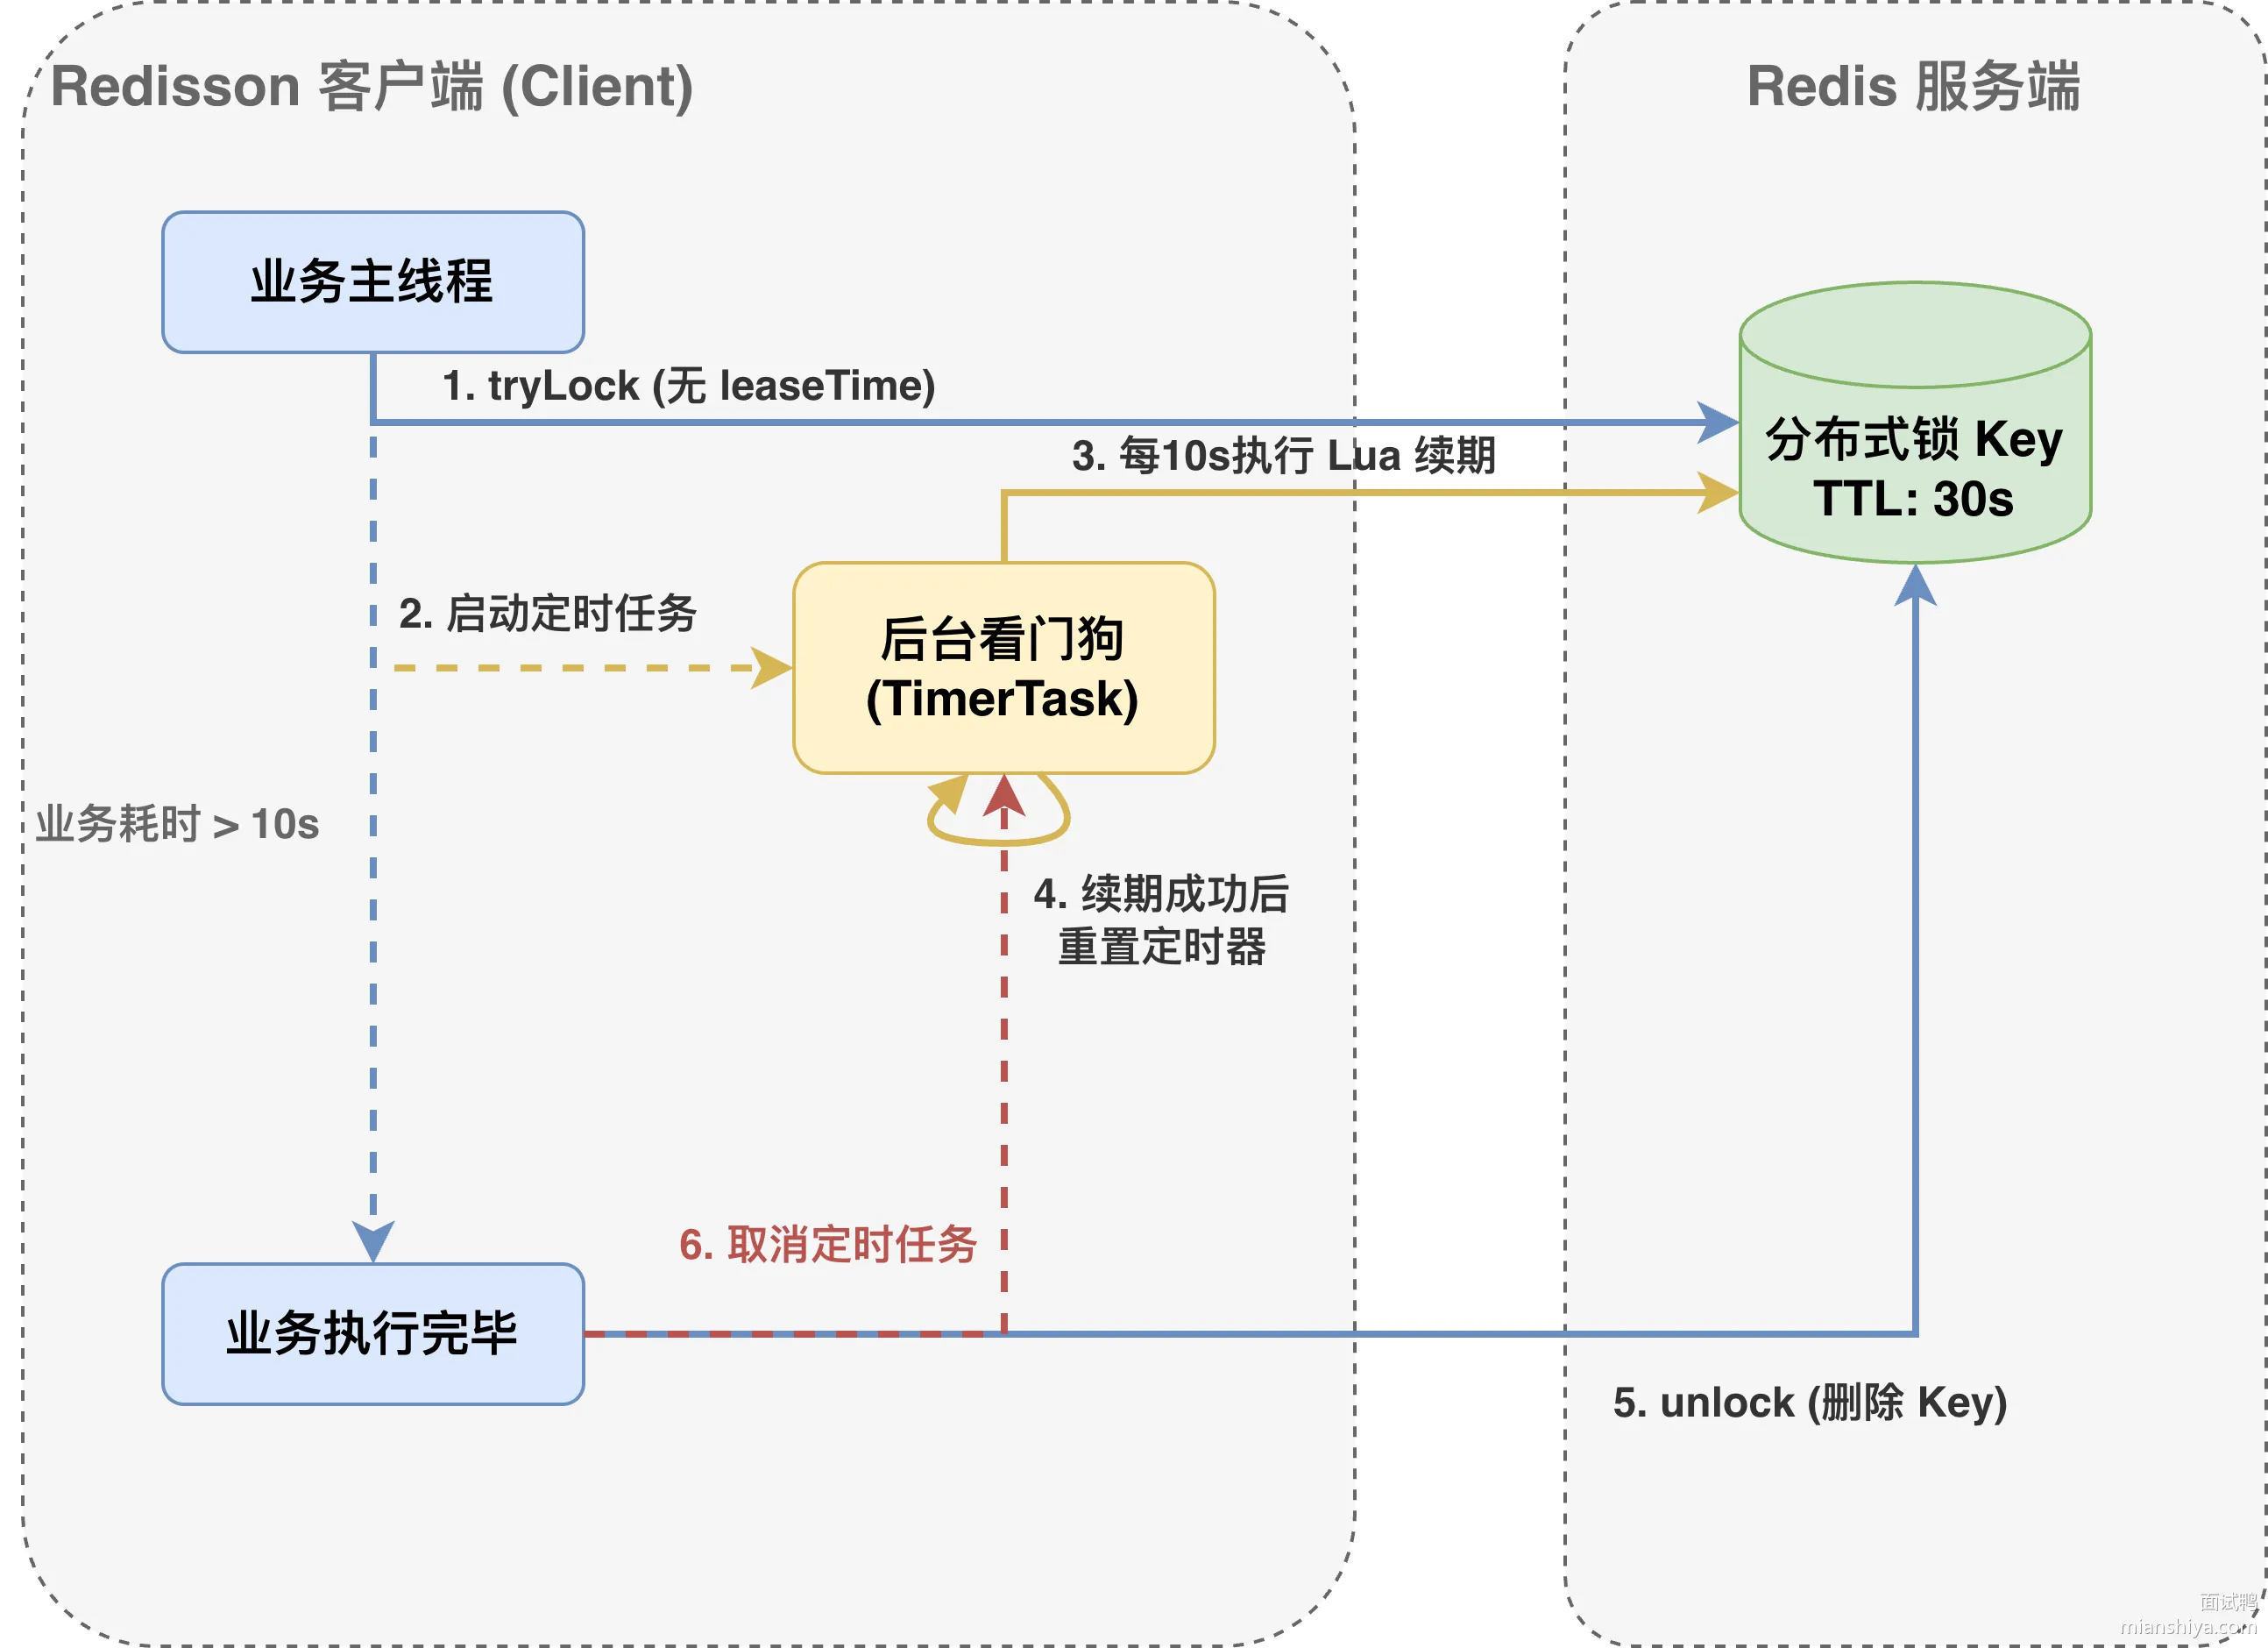
53.2. 扩展知识
53.2.1. 看门狗的核心源码分析
续期机制主要涉及两个方法:scheduleExpirationRenewal 负责在获取锁后启动续期任务,renewExpiration 负责定期刷新过期时间。
53.2.2. scheduleExpirationRenewal 方法
这个方法在客户端拿到锁之后被调用,干的事情就是把当前锁注册到续期 map 里,然后启动定时任务。
1)先创建一个 ExpirationEntry 对象来存锁的过期信息
2)用 putIfAbsent 往 EXPIRATION_RENEWAL_MAP 里塞。如果已经有了说明别的线程正在续期这把锁,那就把当前线程 ID 加进去就行
3)如果是第一次创建这个条目,调用 renewExpiration() 启动定时任务
4)如果当前线程被中断了,调用 cancelExpirationRenewal(threadId) 取消续期
53.2.3. renewExpiration 方法
这个方法才是真正干活的。它通过 Netty 的时间轮创建一个定时任务,每隔 internalLockLeaseTime / 3 毫秒执行一次。默认 leaseTime 是 30 秒,所以默认每 10 秒续一次。
定时任务执行的时候:
1)先从 map 里重新拿一次 ExpirationEntry,拿不到就说明锁已经释放了,直接返回
2)检查里面有没有线程 ID,没有说明没人持有锁,直接返回
3)调用 renewExpirationAsync(threadId) 异步续期
4)续期成功就重新调度自己,相当于递归续下去;续期失败就取消续期,清掉 map 里的条目
中文注释版源码如下:
// 续期锁的过期时间
private void renewExpiration() {
    // 从过期续期映射中获取锁的过期条目
    ExpirationEntry ee = EXPIRATION_RENEWAL_MAP.get(getEntryName());
    if (ee == null) {
        return; // 如果找不到条目,说明没有锁需要续期
    }

    // 创建一个定时任务,用于定期续期锁的过期时间
    Timeout task = commandExecutor.getServiceManager().newTimeout(new TimerTask() {
        @Override
        public void run(Timeout timeout) throws Exception {
            // 重新获取过期条目
            ExpirationEntry ent = EXPIRATION_RENEWAL_MAP.get(getEntryName());
            if (ent == null) {
                return; // 如果条目已被移除,结束任务
            }
            // 获取持有锁的线程 ID
            Long threadId = ent.getFirstThreadId();
            if (threadId == null) {
                return; // 如果没有线程 ID,说明没有线程持有该锁,结束任务
            }

            // 异步续期锁的过期时间
            CompletionStage<Boolean> future = renewExpirationAsync(threadId);
            future.whenComplete((res, e) -> {
                if (e != null) {
                    // 如果续期过程中发生错误,记录日志并移除续期条目
                    log.error("Can't update lock {} expiration", getRawName(), e);
                    EXPIRATION_RENEWAL_MAP.remove(getEntryName());
                    return;
                }

                if (res) {
                    // 如果续期成功,重新调度续期任务
                    renewExpiration();
                } else {
                    // 如果续期失败,取消续期操作
                    cancelExpirationRenewal(null);
                }
            });
        }
    }, internalLockLeaseTime / 3, TimeUnit.MILLISECONDS); // 定时任务每 internalLockLeaseTime / 3 毫秒执行一次

    // 设置定时任务到过期条目中
    ee.setTimeout(task);
}

// 启动续期操作,首次获取锁时会调用此方法
protected void scheduleExpirationRenewal(long threadId) {
    // 创建新的过期条目
    ExpirationEntry entry = new ExpirationEntry();
    // 尝试将新的条目加入到续期映射中
    ExpirationEntry oldEntry = EXPIRATION_RENEWAL_MAP.putIfAbsent(getEntryName(), entry);
    if (oldEntry != null) {
        // 如果条目已存在,说明已有其他线程在续期,添加当前线程 ID 到条目中
        oldEntry.addThreadId(threadId);
    } else {
        // 如果是首次添加,开始进行续期操作
        entry.addThreadId(threadId);
        try {
            // 启动锁过期续期任务
            renewExpiration();
        } finally {
            // 如果当前线程被中断,取消续期操作
            if (Thread.currentThread().isInterrupted()) {
                cancelExpirationRenewal(threadId);
            }
        }
    }
}
实际续期用的是 Lua 脚本,在 renewExpirationAsync 方法里,先检查锁是不是自己的,是的话就用 pexpire 续期 30 秒:
// 异步续期锁的过期时间
protected CompletionStage<Boolean> renewExpirationAsync(long threadId) {
    // 执行 Redis Lua 脚本进行锁的过期时间续期
    return commandExecutor.syncedEval(getRawName(), LongCodec.INSTANCE, RedisCommands.EVAL_BOOLEAN,
            // Lua 脚本,检查锁的持有者并延长过期时间
            "if (redis.call('hexists', KEYS[1], ARGV[2]) == 1) then " +
                    "redis.call('pexpire', KEYS[1], ARGV[1]); " +
                    "return 1; " +
                    "end; " +
                    "return 0;",
            // 锁的名称,传入 Redis 脚本
            Collections.singletonList(getRawName()),
            // 续期时间(单位:毫秒)和当前线程 ID
            internalLockLeaseTime, getLockName(threadId));
}
53.2.4. 释放锁时取消续期
调用 unlock 的时候会触发 cancelExpirationRenewal,把定时任务取消掉,从 map 里移除条目:
// 取消锁的续期操作
protected void cancelExpirationRenewal(Long threadId, Boolean unlockResult) {
    // 获取锁的过期续期条目
    ExpirationEntry task = EXPIRATION_RENEWAL_MAP.get(getEntryName());
    if (task == null) {
        return; // 如果找不到过期条目,退出方法
    }

    // 如果提供了线程 ID,移除该线程 ID
    if (threadId != null) {
        task.removeThreadId(threadId);
    }

    // 如果没有线程 ID 或没有线程持有该锁,取消续期任务
    if (threadId == null || task.hasNoThreads()) {
        Timeout timeout = task.getTimeout();
        if (timeout != null) {
            timeout.cancel(); // 取消定时续期任务
        }
        EXPIRATION_RENEWAL_MAP.remove(getEntryName()); // 移除过期条目
    }
}
有个细节值得注意:在 unlockAsync0 里,即使解锁过程抛异常了,cancelExpirationRenewal 也会被调用。这样设计是为了防止出现异常后续期任务还在跑,导致锁被无限续期的问题。
53.2.5. 只有不设置过期时间才会续期
不是所有 Redisson 分布式锁都会触发看门狗机制。只有不设置 leaseTime 的时候才会自动续期。
看 tryLock 方法的实现,里面会判断 leaseTime:如果传了 leaseTime,就用用户指定的超时时间,不启动看门狗;如果没传,就用默认的 30 秒,同时启动看门狗续期。
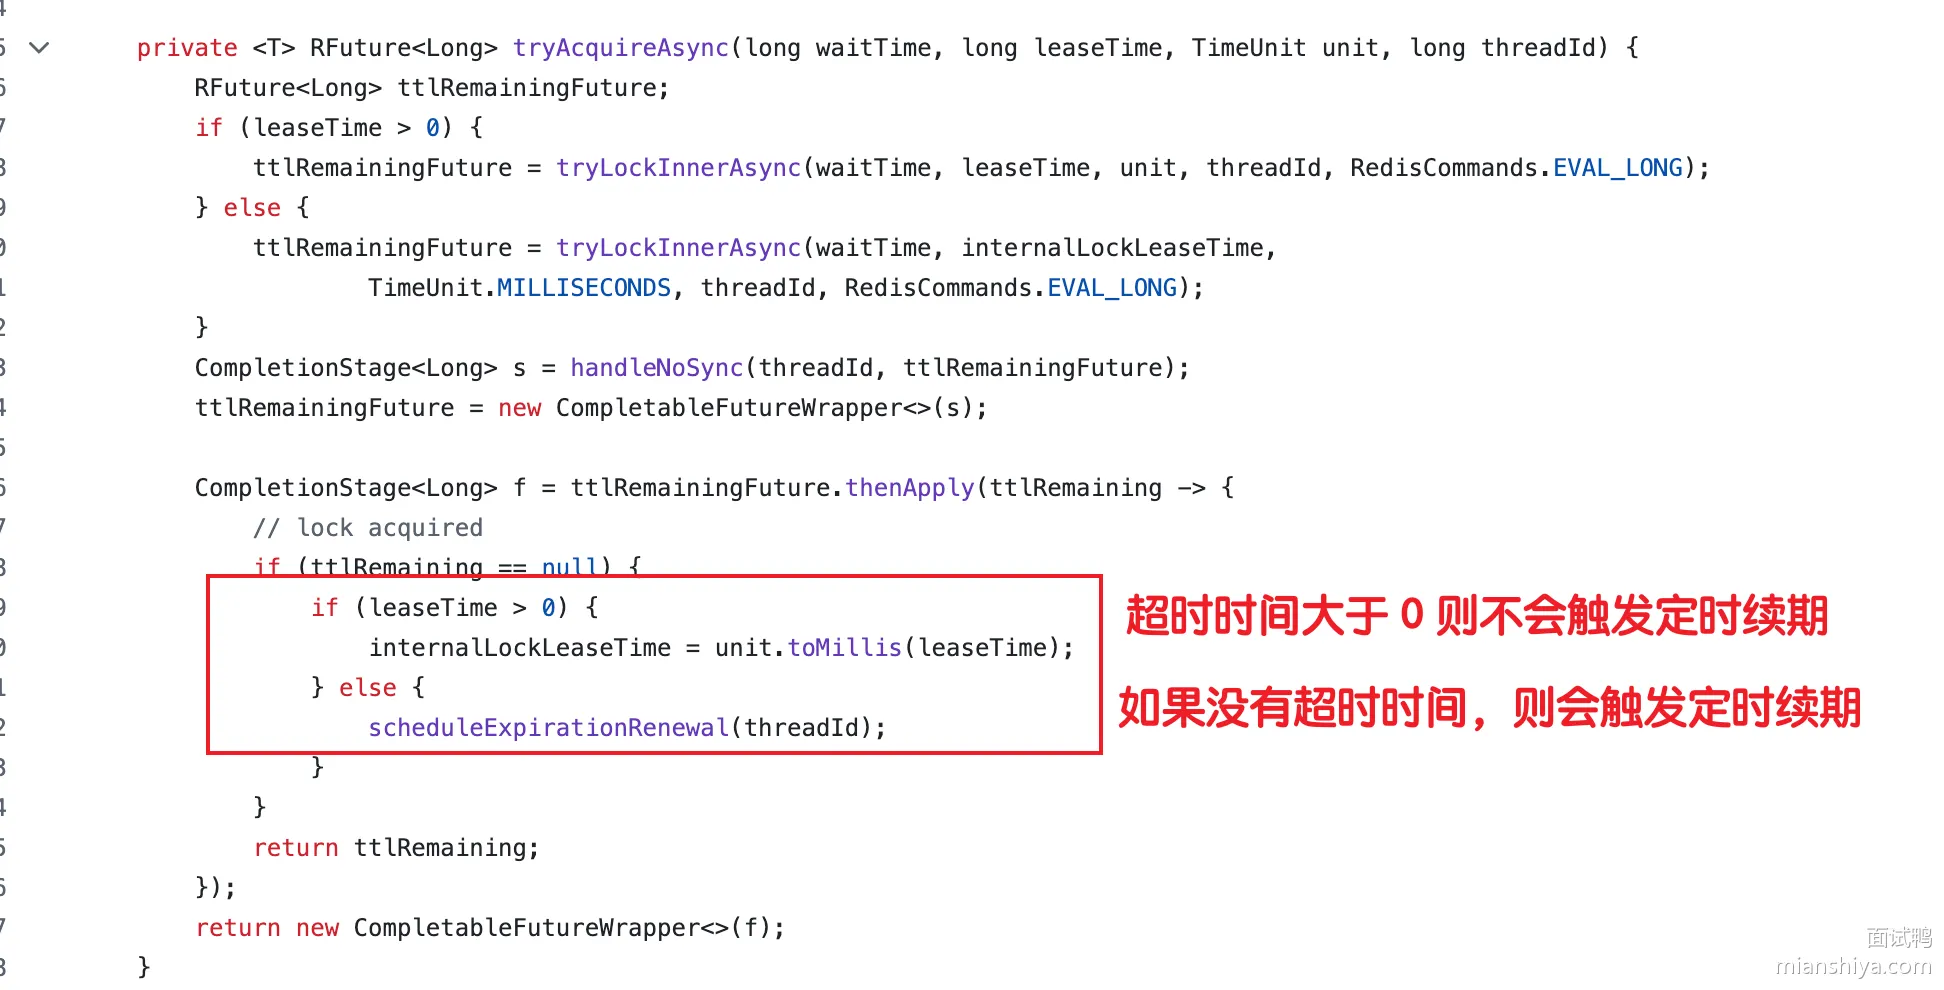
53.2.6. 客户端宕机怎么办?
续期是靠定时任务实现的,客户端一宕机,定时任务就没了,不会再续期。按默认配置每 10 秒续期 30 秒来算,最多等 30 秒锁就自动释放了,集群里其他客户端就能拿到锁,业务不会被阻塞。
如果觉得 30 秒太长,有两个办法:
1)紧急情况直接去 Redis 里删掉对应的 key,锁立刻释放
2)通过 lockWatchdogTimeout 参数调整超时时间:
Config config = new Config();
config.useSingleServer()
      .setAddress("redis://127.0.0.1:6379")
      .setConnectionPoolSize(10);

// 设置 Redisson 锁的看门狗超时时间为 15 秒
config.setLockWatchdogTimeout(15000);  // 时间单位:毫秒

RedissonClient redisson = Redisson.create(config);
53.3. 常见问题
53.3.1. 如果 Redis 和客户端之间网络闪断了几秒,续期请求没发出去,锁会不会被释放?
不会立刻释放。续期间隔是 10 秒,锁的过期时间是 30 秒,只要网络在 20 秒内恢复,下一次续期请求发出去就能续上。但如果网络断的时间超过了锁的剩余过期时间,锁就会被释放,其他客户端可以抢到。这时候原来的客户端如果还在执行业务逻辑,就会出现两个客户端同时操作临界资源的问题,所以分布式锁不是万能的,关键业务还得考虑幂等和数据校验。
53.3.2. 为什么续期间隔是过期时间的三分之一,不是二分之一或者更短?
三分之一是个经验值,在续期频率和网络开销之间取了个平衡。太短的话续期请求太频繁,对 Redis 压力大;太长的话容错空间小,一次续期失败锁就可能过期。设成三分之一的话,一次续期失败还有两次机会,留出了足够的容错窗口。
53.3.3. 看门狗续期用的是什么定时器?为什么不用 ScheduledExecutorService?
用的是 Netty 的 HashedWheelTimer 时间轮。时间轮的优势是在大量定时任务的场景下性能更好,添加和取消任务都是 O(1) 的。Redisson 本身底层通信就依赖 Netty,直接复用 Netty 的时间轮也避免了引入额外的线程池。ScheduledExecutorService 在任务量大的时候性能会差一些,不太适合这种高并发场景。
53.3.4. 如果业务代码里 try-finally 没写好,unlock 没调用,看门狗会一直续期下去吗?
会的,这是个典型的锁泄露问题。只要客户端进程还活着,看门狗就会一直续期,锁永远不会释放。所以用 Redisson 分布式锁一定要保证 unlock 在 finally 块里调用,或者用 try-with-resources 写法。如果实在担心,可以主动设置 leaseTime,放弃看门狗机制,让锁到点自动释放。
54. ZADD/ZINCRBY/ZREVRANK 等