732. 让你设计一个 RPC 框架,怎么设计?
核心要点
RPC 框架核心就这么几点:
- 动态代理,屏蔽底层调用细节
- 序列化,网络数据传输需要扁平的二进制数据
- 协议,规定好协议格式才能正确解析数据
- 网络传输,I/O 模型相关,一般用 Netty 作为底层通信框架
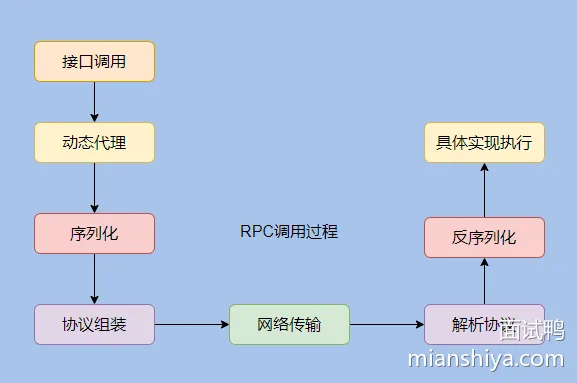
以上是 RPC 框架的基础能力。
生产级别的框架还需要注册中心做服务发现,还得提供路由分组、负载均衡、异常重试、限流熔断等能力。
说到这就可以停一下,等对方继续深挖,见招拆招。
扩展知识
下面我们来深入剖析下 RPC,从根上理解它。
RPC 全称是 Remote Procedure Call ,即远程过程调用,其对应的是我们的本地调用。
远程其实指的就是需要网络通信,可以理解为调用远程机器上的方法。
那可能有人说:我用 HTTP 调用不就是远程调用了,那不也叫 RPC 了?
不是的,RPC 的目的是:让我们调用远程方法像调用本地方法一样无差别。
来看下代码就很清晰,比如本来没有拆分服务都是本地调用的时候方法是这样写的:
public String getSth(String str) {
     return yesService.get(str);
}
如果 yesSerivce 被拆分出去,此时需要远程调用了,如果用 HTTP 方式,可能就是:
public String getSth(String str) {
    RequestParam param = new RequestParam();
    ......
    return HttpClient.get(url, param,.....);
}
此时需要关心远程服务的地址,还需要组装请求等等,而如果采用 RPC 调用那就是:
    public String getSth(String str) {
        // 看起来和之前调用没差?哈哈没唬你,
        // 具体的实现已经搬到另一个服务上了,这里只有接口。
        // 看完下面就知道了。
         return yesService.get(str);
    }
所以说 RPC 其实就是用来屏蔽远程调用网络相关的细节,使得远程调用和本地调用使用一致,让开发的效率更高。
在了解了 RPC 的作用之后,我们来看看 RPC 调用需要经历哪些步骤。
RPC 调用基本流程
按上面的例子来说,yesService 服务实现被移到了远程服务上,本地没有具体的实现只有一个接口。
那这时候我们需要调用 yesService.get(str) ,该怎么办呢?
我们所要做的就是把传入的参数和调用的接口全限定名通过网络通信告知到远程服务那里。
然后远程服务接收到参数和接口全限定名就能选中具体的实现并进行调用。
业务处理完之后再通过网络返回结果,这就搞定了!
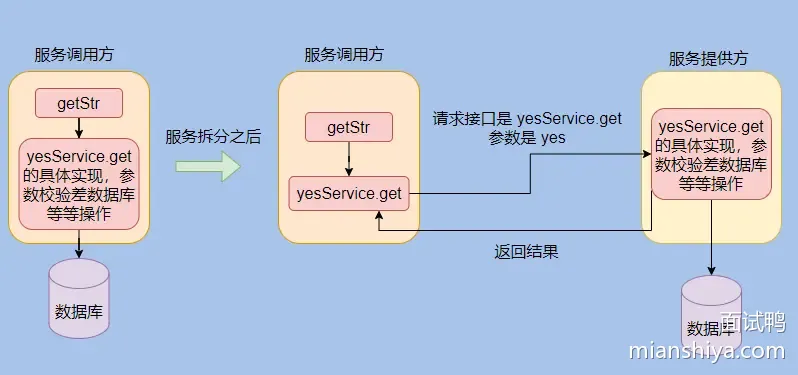
上面的操作这些就是由yesService.get(str) 触发的。
不过我们知道 yesService 就是一个接口,没有实现的,所以这些操作是怎么来的?
是通过动态代理来的。
RPC 会给接口生成一个代理类,所以我们调用这个接口实际调用的是动态生成的代理类,由代理类来触发远程调用,这样我们调用远程接口就无感知了。
动态代理想必大家都比较熟悉,最常见的就是 Spring 的 AOP 了,涉及的有 JDK 动态代理和 cglib。
在 Dubbo 中用的是 Javassist,至于为什么用这个其实梁飞大佬已经写了博客说明了。
他当时对比了 JDK 自带的、ASM、CGLIB(基于ASM包装)、Javassist。
经过测试最终选用了 Javassist。
梁飞:最终决定使用JAVAASSIST的字节码生成代理方式。 虽然ASM稍快,但并没有快一个数量级,而JAVAASSIST的字节码生成方式比ASM方便,JAVAASSIST只需用字符串拼接出Java源码,便可生成相应字节码,而ASM需要手工写字节码。
可以看到选择一个框架的时候性能是一方面,易用性也很关键。
说回 RPC 。
现在我们知道动态代理屏蔽了 RPC 调用的细节,使得用户无感知的调用远程服务,那调用的细节有哪些呢?
序列化
像我们的请求参数都是对象,有时候是定义的 DTO ,有时候是 Map ,这些对象是无法直接在网络中传输的。
你可以理解为对象是“立体”的,而网络传输的数据是“扁平”的,最终需要转化成“扁平”的二进制数据在网络中传输。
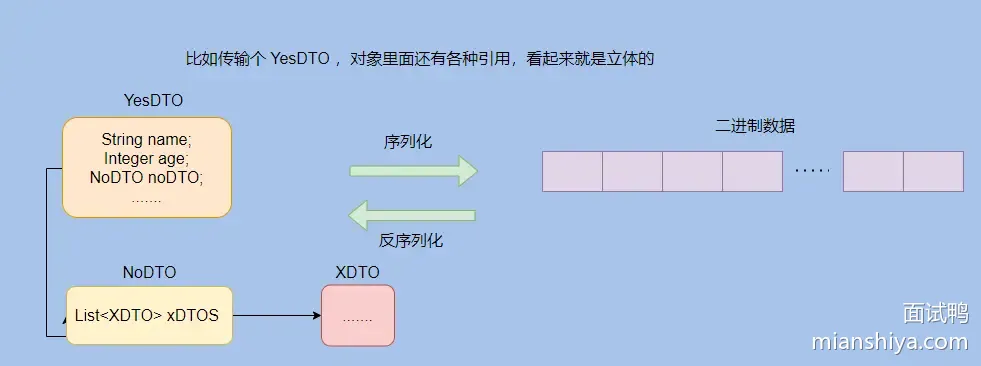
你想想,各对象分配在内存不同位置,各种引用,这看起来是不是有种立体的感觉?最终都是要变成一段01组成的数字传输给对方,这种就01组成的数字看起来是不是很“扁平”?
把对象转化成二进制数据的过程称为序列化,把二进制数据转化成对象的过程称为反序列化。
当然如何选择序列化格式也很重要。
比如采用二进制的序列化格式数据更加紧凑,采用 JSON 等文本型序列化格式可读性更佳,排查问题比较方便。
还有很多序列化选择,一般需要综合考虑通用性、性能、可读性和兼容性。
具体本文就不分析了,之后再专门写一篇分析各种序列化协议的。
RPC 协议
刚才也提到了只有二进制数据才能在网络中传输,那一堆二进制在底层看来是连起来的,它可不会管你哪些数据是哪个请求的,那接收方得知道呀,不然就不能顺利的把二进制数据还原成对应的一个个请求了。
于是就需要定义一个协议,来约定一些规范,制定一些边界使得二进制数据可以被还原。
比如下面一串数字按照不同位数来识别得到的结果是不同的。
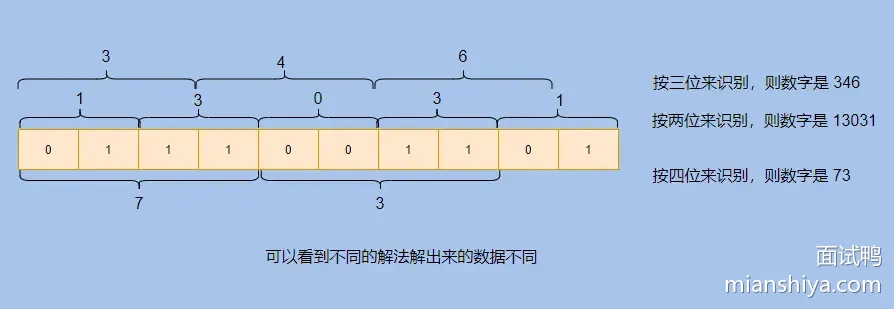
所以协议其实就定义了到底如何构造和解析这些二进制数据。
我们的参数肯定比上面的复杂,因为参数值长度是不定的,而且协议常常伴随着升级而扩展,毕竟有时候需要加一些新特性,那么协议就得变了。
一般 RPC 协议都是采用协议头+协议体的方式。
协议头放一些元数据,包括:魔法位、协议的版本、消息的类型、序列化方式、整体长度、头长度、扩展位等。
协议体就是放请求的数据了。
通过魔法位可以得知这是不是咱们约定的协议,比如魔法位固定叫 233 ,一看我们就知道这是 233 协议。
然后协议的版本是为了之后协议的升级。
从整体长度和头长度我们就能知道这个请求到底有多少位,前面多少位是头,剩下的都是协议体,这样就能识别出来,扩展位就是留着日后扩展备用。
贴一下 Dubbo 协议:
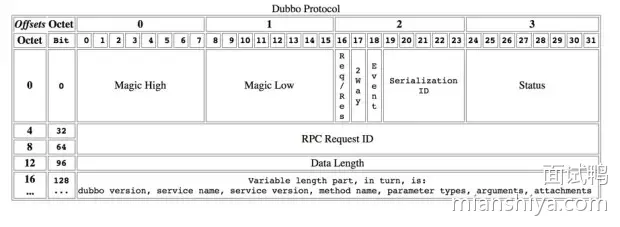
可以看到有 Magic 位,请求 ID, 数据长度等等。
网络传输
组装好数据就等着发送了,这时候就涉及网络传输了。
网络通信那就离不开网络 IO 模型了。
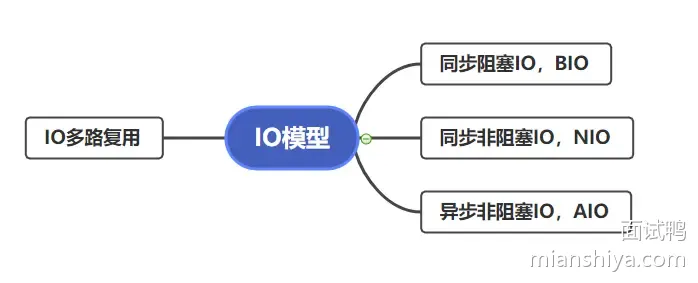
网络 IO 分为这四种模型,具体以后单独写文章分析,这篇就不展开了。
一般而言我们用的都是 IO 多路复用,因为大部分 RPC 调用场景都是高并发调用,IO 复用可以利用较少的线程 hold 住很多请求。
一般 RPC 框架会使用已经造好的轮子来作为底层通信框架。
例如 Java 语言的都会用 Netty ,人家已经封装的很好了,也做了很多优化,拿来即用,便捷高效。
小结
RPC 通信的基础流程已经讲完了,回顾下之前的图:
响应返回就没画了,反正就是倒着来。
我再用一段话来总结一下:
服务调用方,面向接口编程,利用动态代理屏蔽底层调用细节将请求参数、接口等数据组合起来并通过序列化转化为二进制数据,再通过 RPC 协议的封装利用网络传输到服务提供方。
服务提供方根据约定的协议解析出请求数据,然后反序列化得到参数,找到具体调用的接口,然后执行具体实现,再返回结果。
这里面还有很多细节。
比如请求都是异步的,所以每个请求会有唯一 ID,返回结果会带上对应的 ID, 这样调用方就能通过 ID 找到对应的请求塞入相应的结果。
有人会问为什么要异步,那是为了提高吞吐。
当然还有很多细节,会在之后剖析 Dubbo 的时候提到,结合实际中间件体会才会更深。
真正工业级别的 RPC
以上提到的只是 RPC 的基础流程,这对于工业级别的使用是远远不够的。
生产环境中的服务提供者都是集群部署的,所以有多个提供者,而且还会随着大促等流量情况动态增减机器。
因此需要注册中心,作为服务的发现。
调用者可以通过注册中心得知服务提供者们的 IP 地址等元信息,进行调用。
调用者也能通过注册中心得知服务提供者下线。
还需要有路由分组策略,调用者根据下发的路由信息选择对应的服务提供者,能实现分组调用、灰度发布、流量隔离等功能。
还需要有负载均衡策略,一般经过路由过滤之后还是有多个服务提供者可以选择,通过负载均衡策略来达到流量均衡。
当然还需要有异常重试,毕竟网络是不稳定的,而且有时候某个服务提供者也可能出点问题,所以一次调用出错进行重试,减少业务的损耗。
还需要限流熔断,限流是因为服务提供者不知道会接入多少调用者,也不清楚每个调用者的调用量,所以需要衡量一下自身服务的承受值来进行限流,防止服务崩溃。
而熔断是为了防止下游服务故障导致自身服务调用超时阻塞堆积而崩溃,特别是调用链很长的那种,影响很大,比如A=>B=>C=>D=>E,然后 E 出了故障,你看ABCD四个服务就傻等着,慢慢的资源就占满了就崩了,全崩。
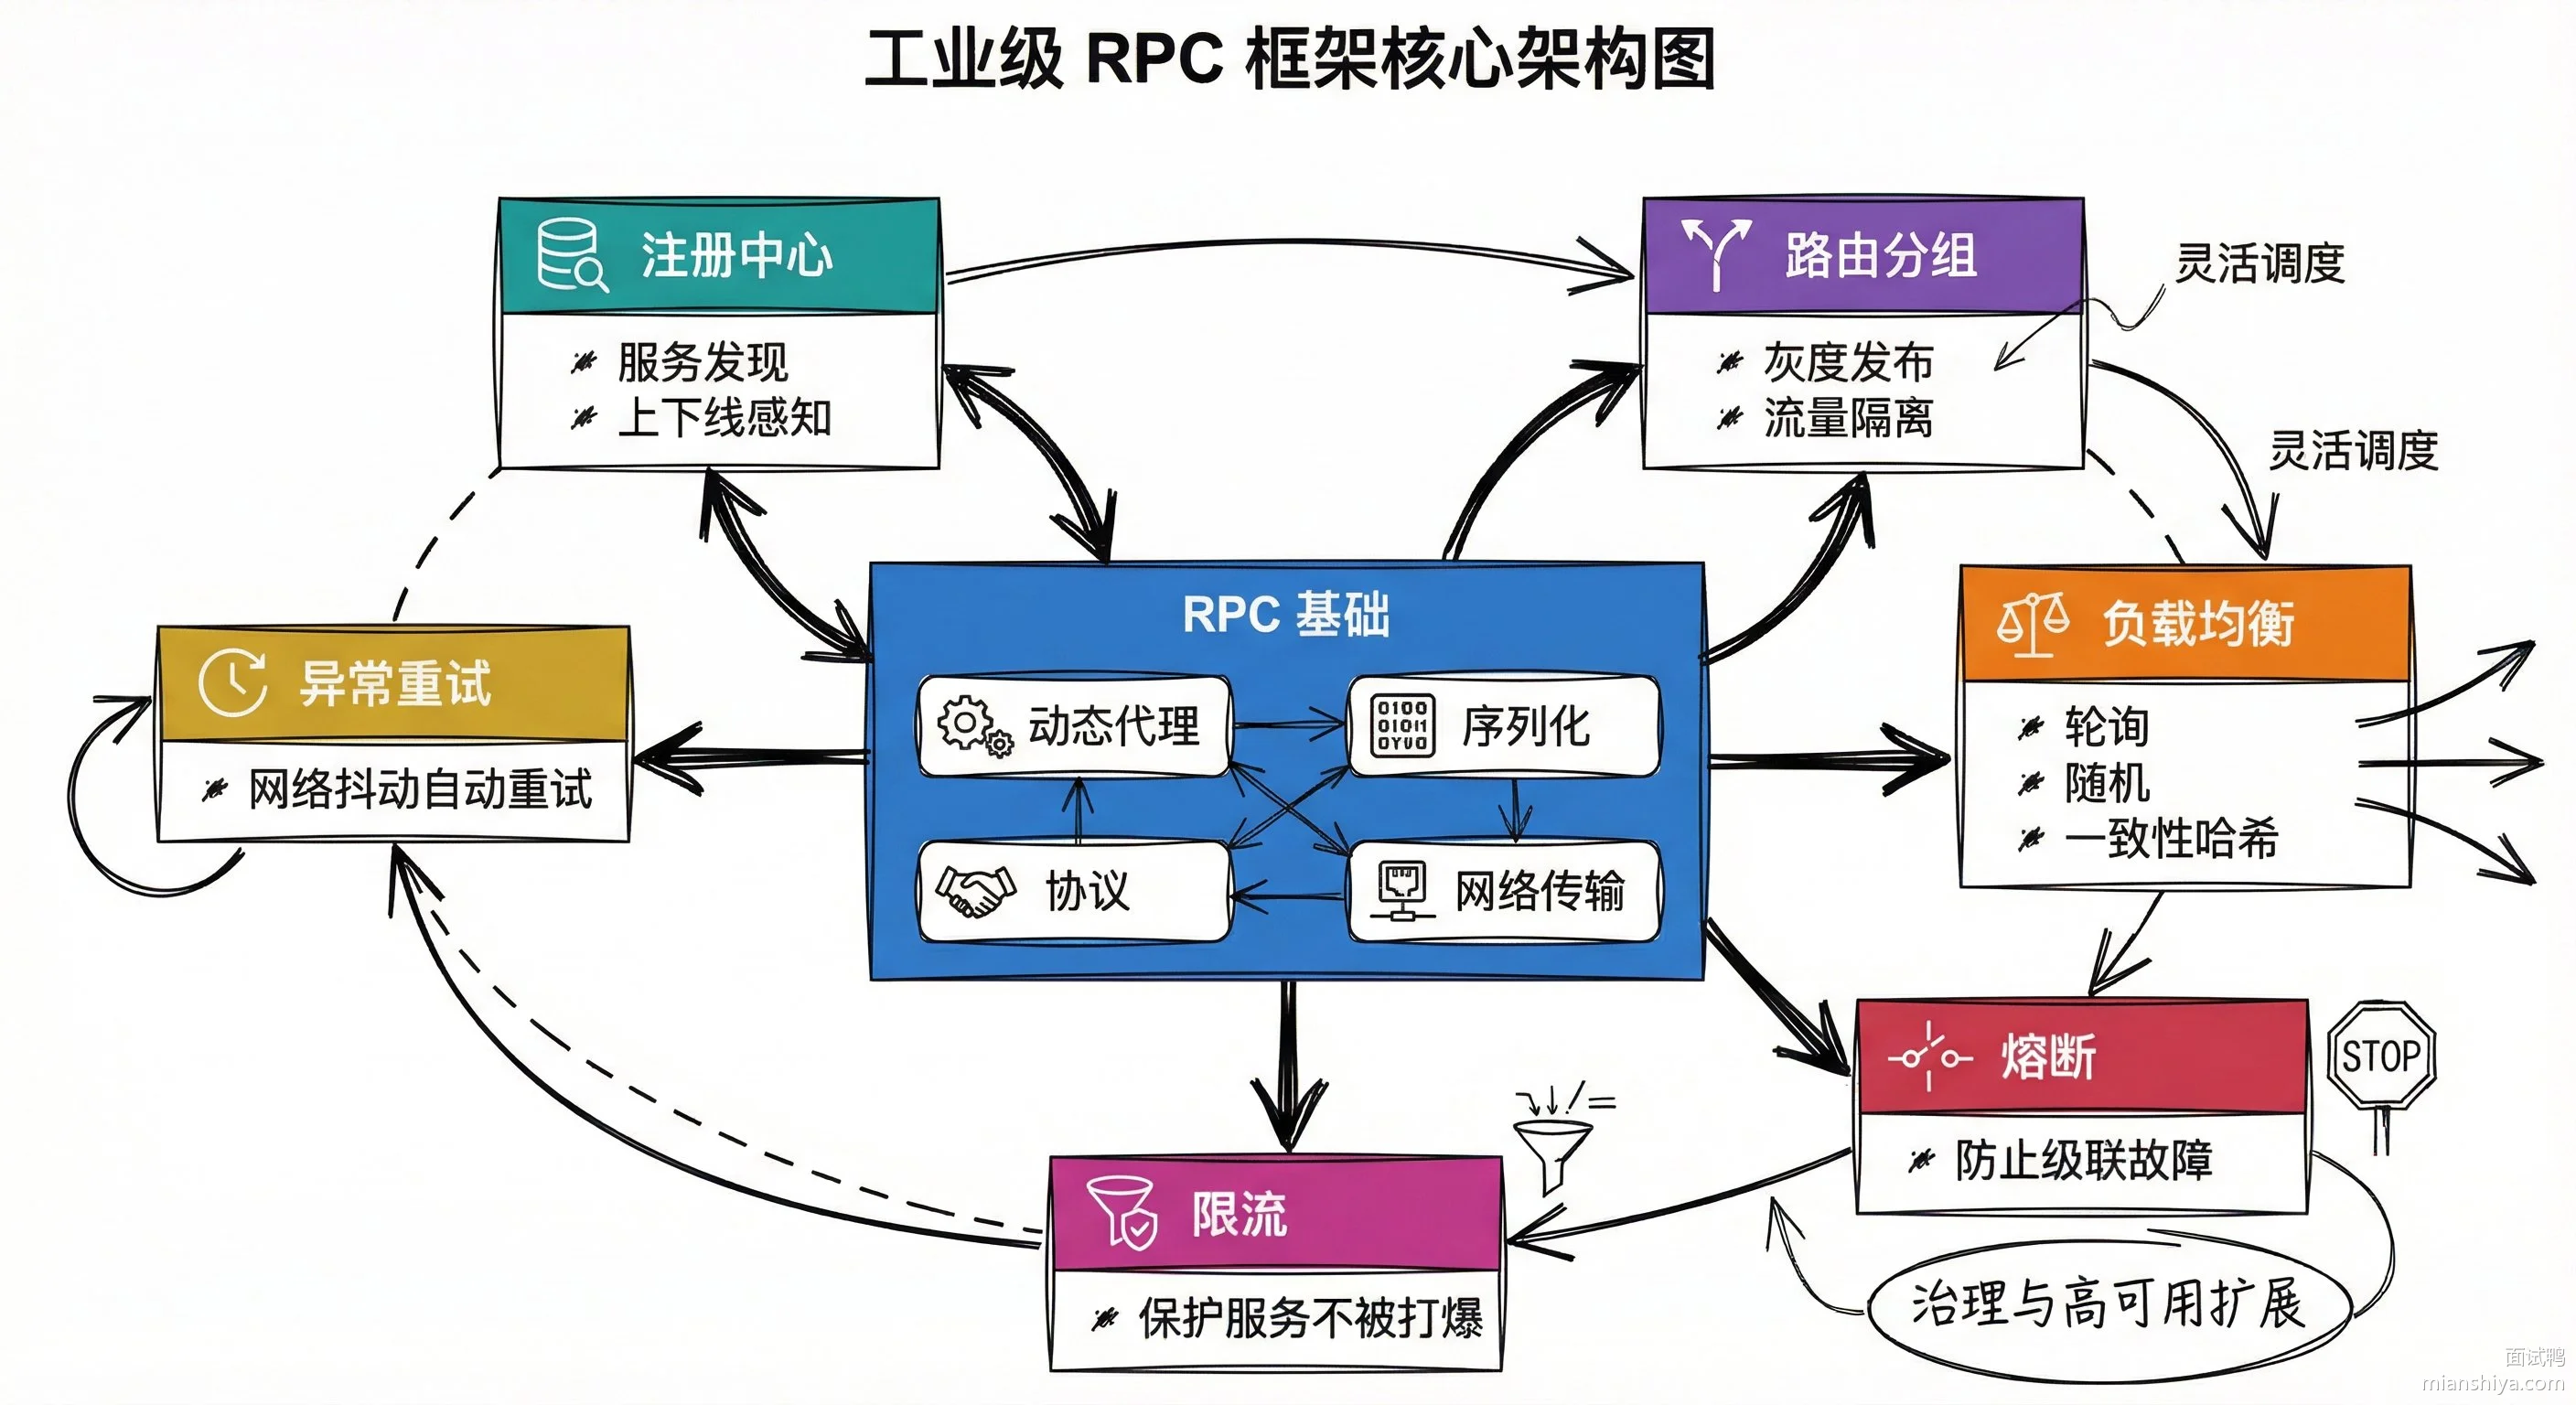
大致就是以上提到的几点,不过还能细化,比如负载均衡的各种策略、限流到底是限制总流量还是根据每个调用者指定限流量,还是上自适应限流等等。
常见问题
Dubbo 和 gRPC 有什么区别?
回答:主要区别在协议和生态。Dubbo 用的是私有协议,序列化默认 Hessian2,gRPC 用的是 HTTP/2 协议加 Protobuf 序列化。gRPC 天然支持多语言因为 Protobuf 本身就是跨语言的,Dubbo 最早只支持 Java 后来才慢慢支持其他语言。性能上 gRPC 稍强一些,但 Dubbo 在服务治理能力上更完善,路由、负载均衡、服务降级这些开箱即用。选型主要看团队技术栈和服务治理需求。
RPC 调用超时了怎么排查?
回答:先看超时发生在哪个阶段。调用方超时可能是网络问题、服务端处理慢或者线程池打满了。服务端处理慢就看业务逻辑有没有慢 SQL、外部依赖调用耗时。线程池打满看监控,Dubbo 默认 200 个线程,并发高了不够用。网络问题抓包看有没有丢包重传。还有一个坑是服务端 Full GC,STW 期间请求堆积全超时,看 GC 日志就知道了。
服务提供者上下线时怎么做到调用方无感知?
回答:注册中心推送变更是有延迟的,老版本 Dubbo 靠心跳检测,间隔 60 秒,最坏情况下线后 60 秒内还会有请求打过去。Dubbo 2.7 之后支持优雅停机,下线前先从注册中心注销,等待一段时间让调用方感知,再处理完已有请求才真正停掉。调用方这边要配合做异常重试,某个提供者调不通就换一个。
负载均衡策略怎么选?
回答:看场景。随机和轮询是最简单的,机器配置差不多就够用了。如果机器配置差异大用加权轮询,权重根据机器配置设。最少活跃数适合处理耗时差异大的场景,让处理快的机器多接请求。一致性哈希适合有状态的场景,同一个请求总是打到同一台机器,比如带本地缓存的服务。
4680. 如何设计一个秒杀功能?
核心要点
对方针对这个问题不指望候选人可以系统地回答出完且可落地的方案。只是想考察候选人是否拥有高并发大流量场景下的处理思路或者说能考虑到的一些关键点。
针对秒杀场景,我们需要先和对方说出以下几个需要解决的问题点:
- 瞬时流量的承接
- 防止超卖
- 预防黑产
- 避免对正常服务的影响
- 兜底方案
然后可以从前后端两个视角向对方阐述整体的设计点:
首先是前端:
- 利用 CDN 缓存静态资源(秒杀页面的 HTML、CSS、JS 等),减轻服务器的压力
- 客户端限流,在前端随机限流,降低请求量
- 按钮防抖,防止用户重复多次点击发出大量请求
其次是后端:
- Nginx(或其他接入层)做统一接入,负载均衡与流量过滤、限流
- 业务端限流,可以自定义实现本地 guava 限流或利用 sentinel 等
- 服务拆分,将秒杀功能拆分为独立的服务,避免对现有服务产生影响
- 秒杀数据的拆分和缓存,缓存可以使用分布式缓存或本地缓存方案,且需要缓存预热
- 精准地库存扣减,防止超卖发生
- 风控识别黑产,进行流量防控且需要动态黑名单机制
- 验证码、答题等手段预防脚本刷单
- 幂等操作,防止重复下单
- 业务手段降低并发量,例如通过预约、预售。
- 兜底方案,如果服务压力过大或者代码有漏洞,那么关闭秒杀直接返回秒杀结束,降低服务压力及时止损。
详细分析
瞬时流量的承接
一般情况下,秒杀的流量特性就是持续性短和大。
流量集中在活动即将开始的时候,会有很多用户开始持续性地刷新页面。前端资源的访问也需要损耗大量的资源,因此需要利用 CDN 缓存秒杀页面的一些静态资源,将这部分压力给到 CDN 厂商。
并且静态资源放在 CDN 厂商那之后,地理位置也距离用户更近,用户访问也就更快,体验上也更好!
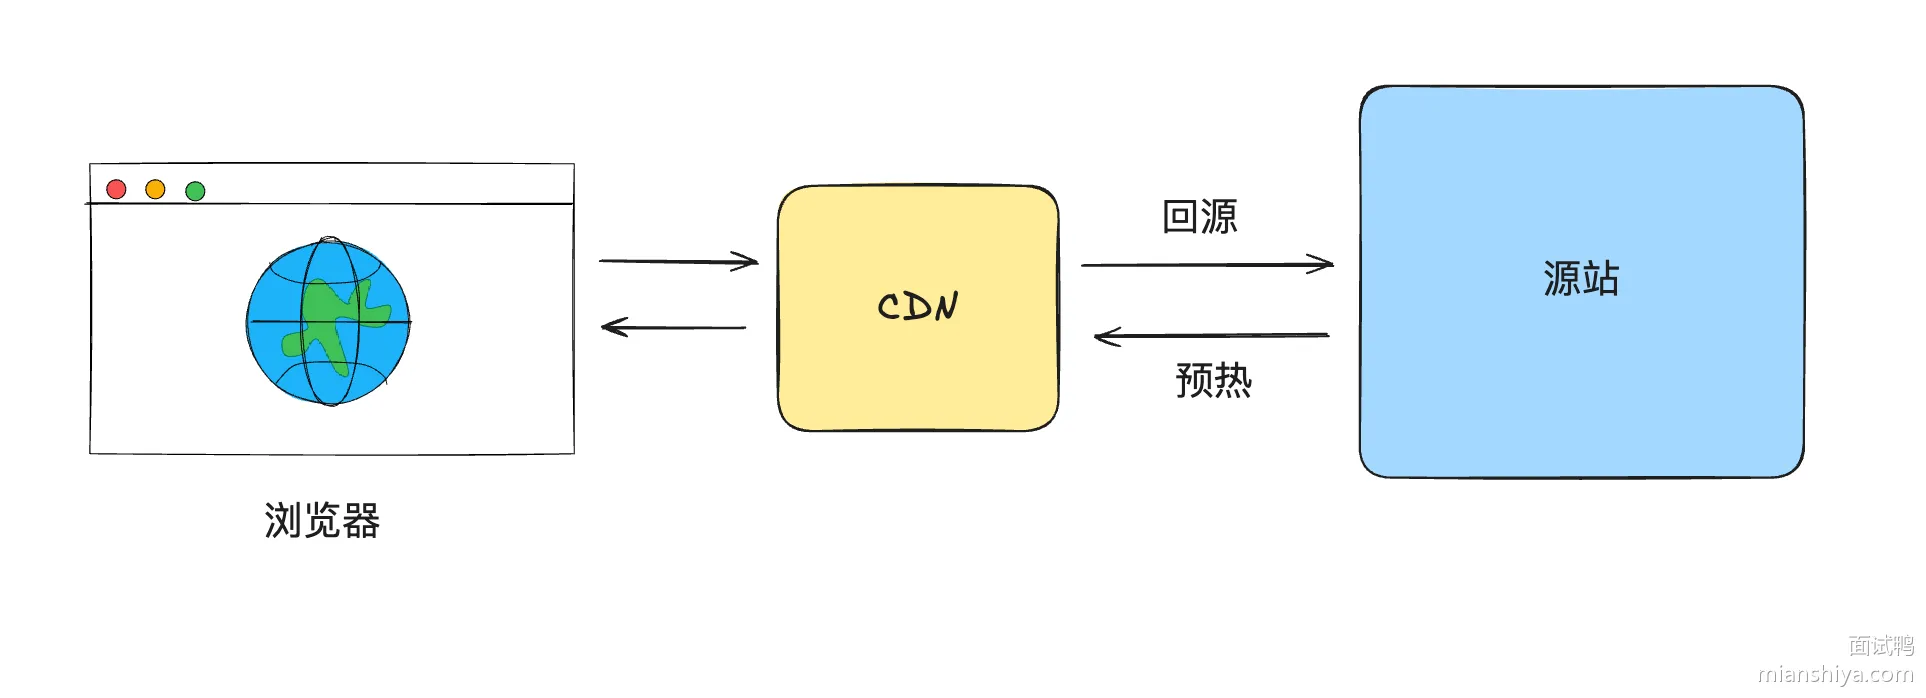
秒杀页面可手动推给 CDN 预热。
秒杀流量还有个特点,就是大部分请求实际都是无效的,因为秒杀的商品库存往往都是个位数,而抢购的用户是其成千上万倍。
假设有 100 万的请求来抢购一台 iPhone,那么需要放这 100 万请求直接打到后端服务吗?显然不需要。
针对这个情况,我们就需要层层过滤请求。
例如前面提到的客户端限流,即在前端随机限流,降低请求量。说的更直白一些即部分用户点击抢购按钮,但是请求都发不到后端,直接前端代码返回秒杀结束。(如果预测量是在太大,可以这样操作,毕竟也是随机的)
如果前端请求发出来了,那么可以利用 nginx 统一接入,针对更大的流量可以在 nginx 前面再加 lvs。
lvs 四层转发请求打到多台 nginx 上, nginx 再负载均衡到多台后端服务,且 nginx 有限流功能,例如 ip 限流,还可以配置黑名单等等,其实已经可以拦截大量请求流量。
请求到达后端服务之前还可以再进行限流,比如使用 sentinel 再拦截一道。
最终请求打到后端服务,涉及到一些读取数据和写数据的操作。如果量级不大且数据库配置高,理论上可以用数据库来承接(数据库层面也是有优化的,后面介绍)。
这时候也可以利用缓存来承接读写,可以用本地缓存或分布式缓存,如 Redis。
最终一个相对而言比较完整的请求链路如下:
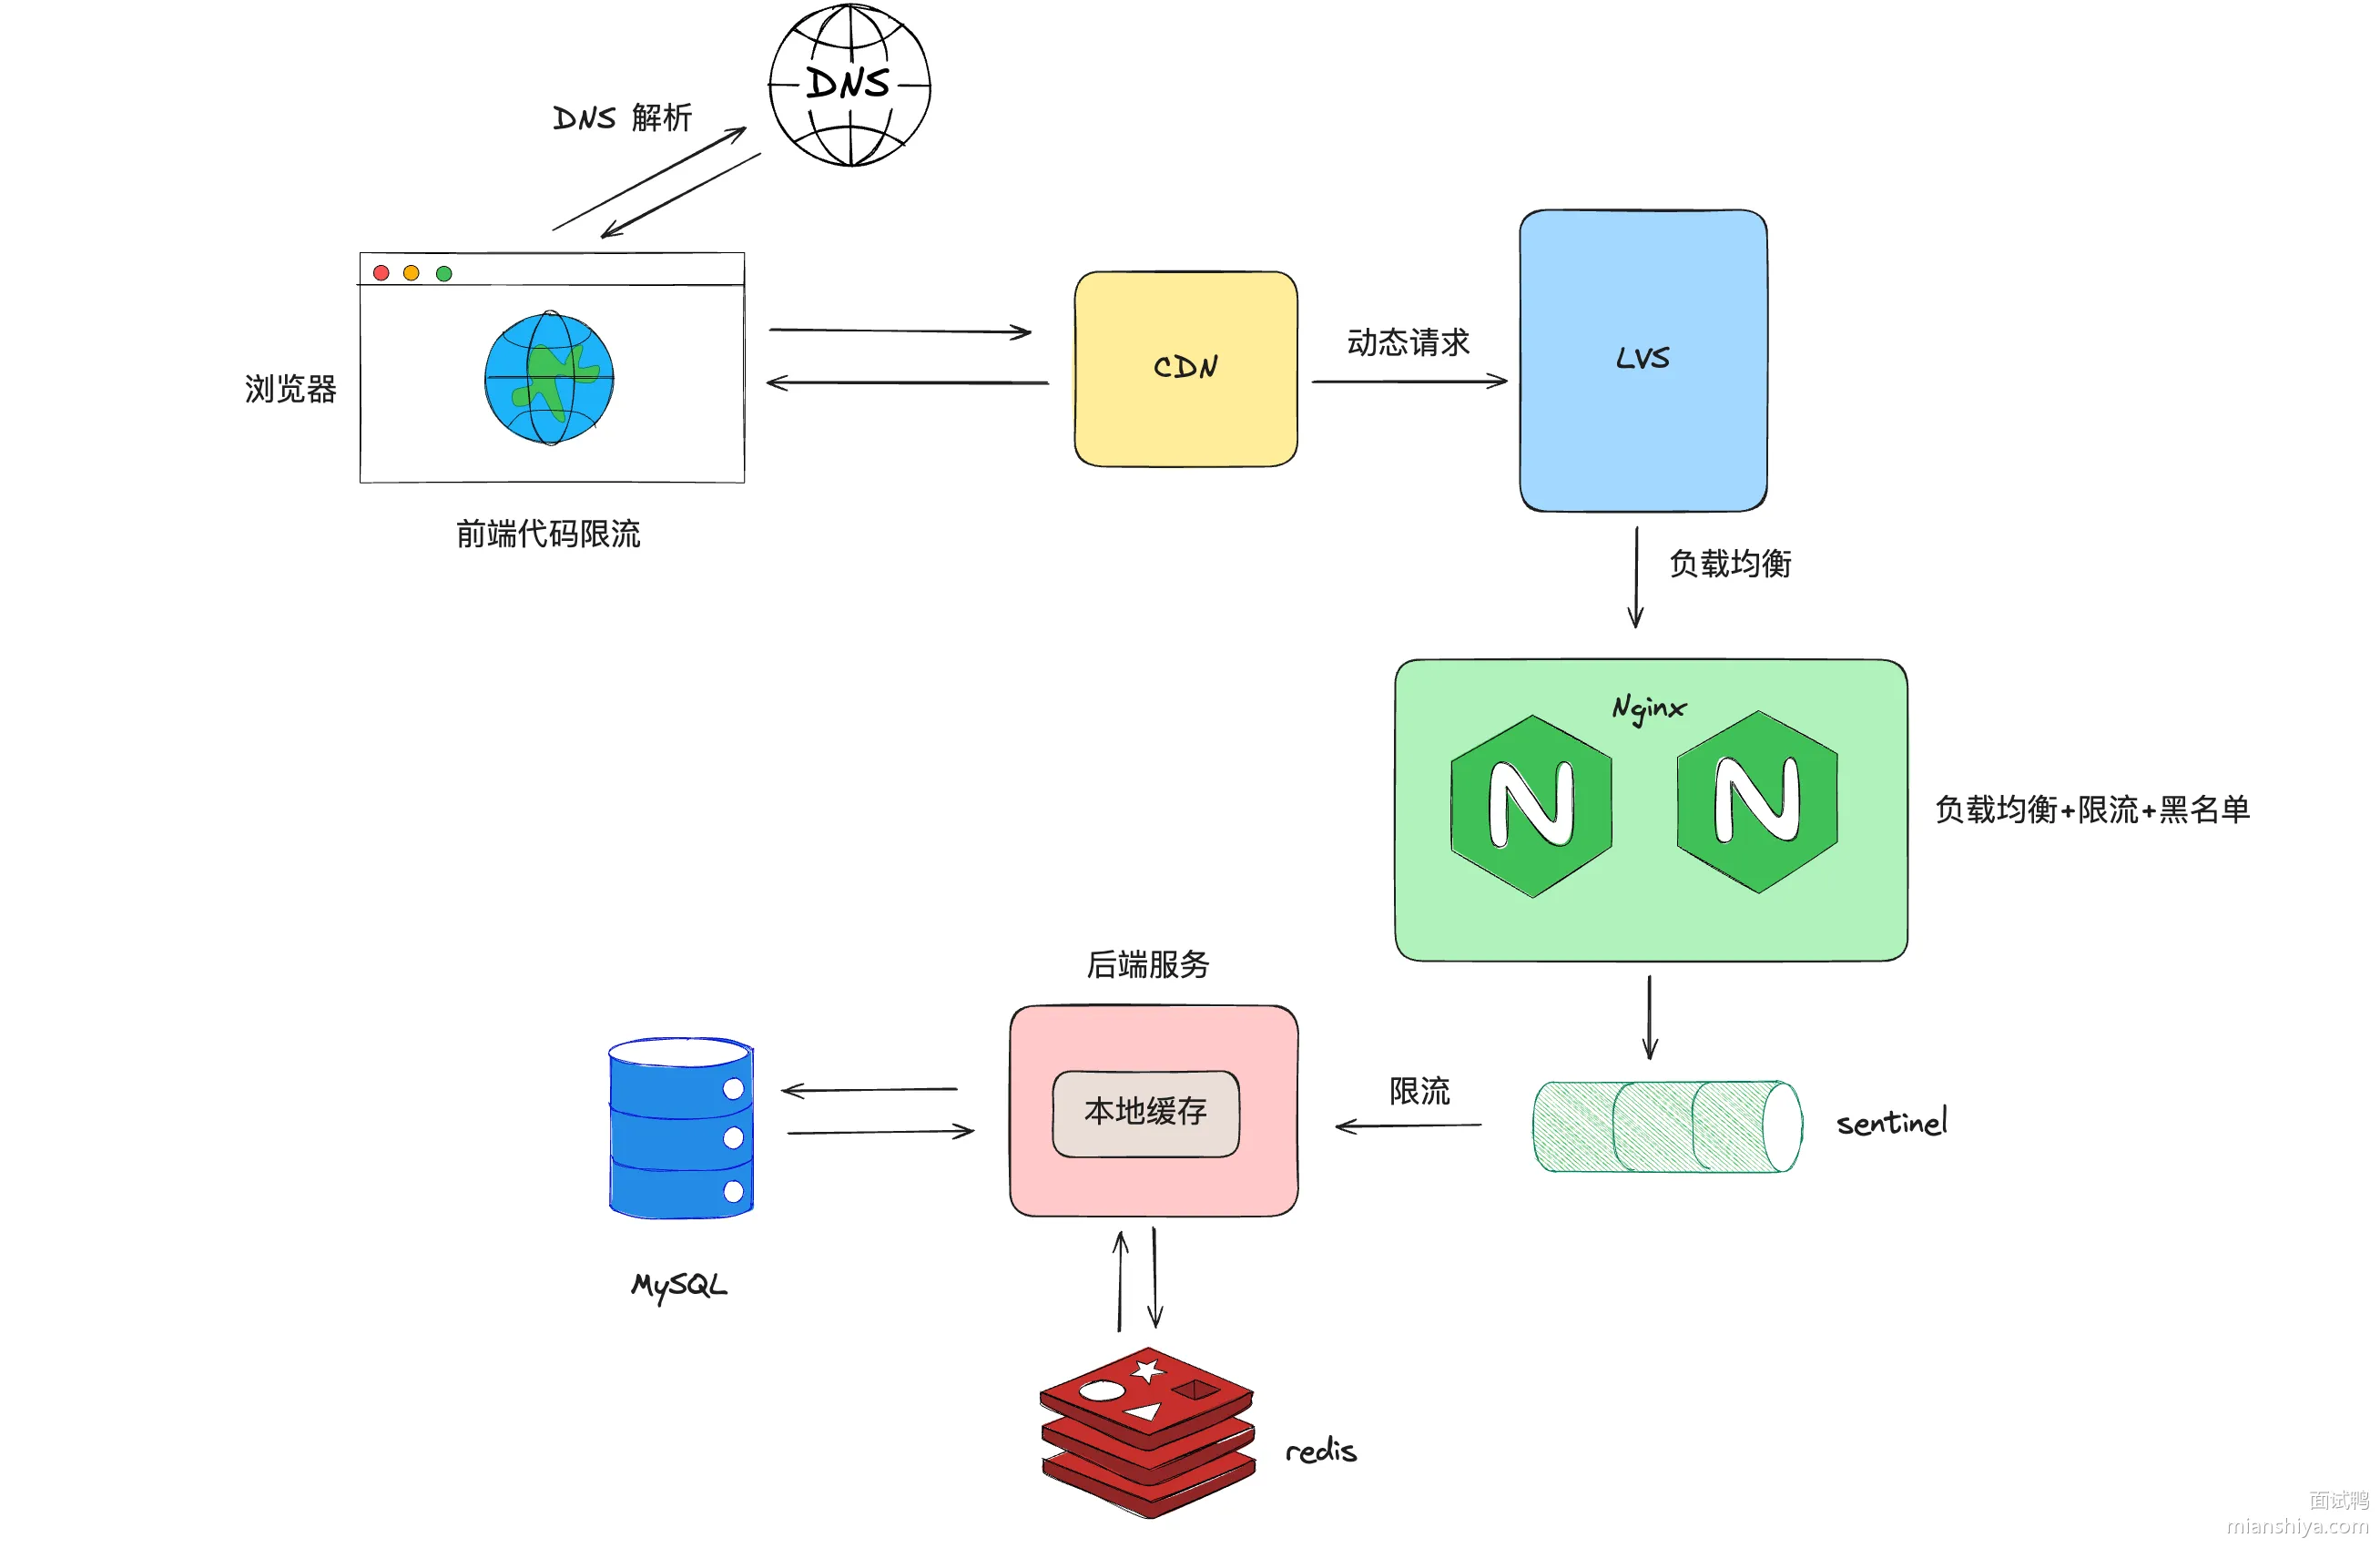
我把 DNS 解析也加上了,因为对一些大公司而言,DNS 其实也是一个分流的手段。
在量级没这么大的情况下,实际上的秒杀架构不需要如上图所示,例如不需要引入 lvs、本地缓存之类的。
库存扣减设计
先看一下正常扣减库存的思路:
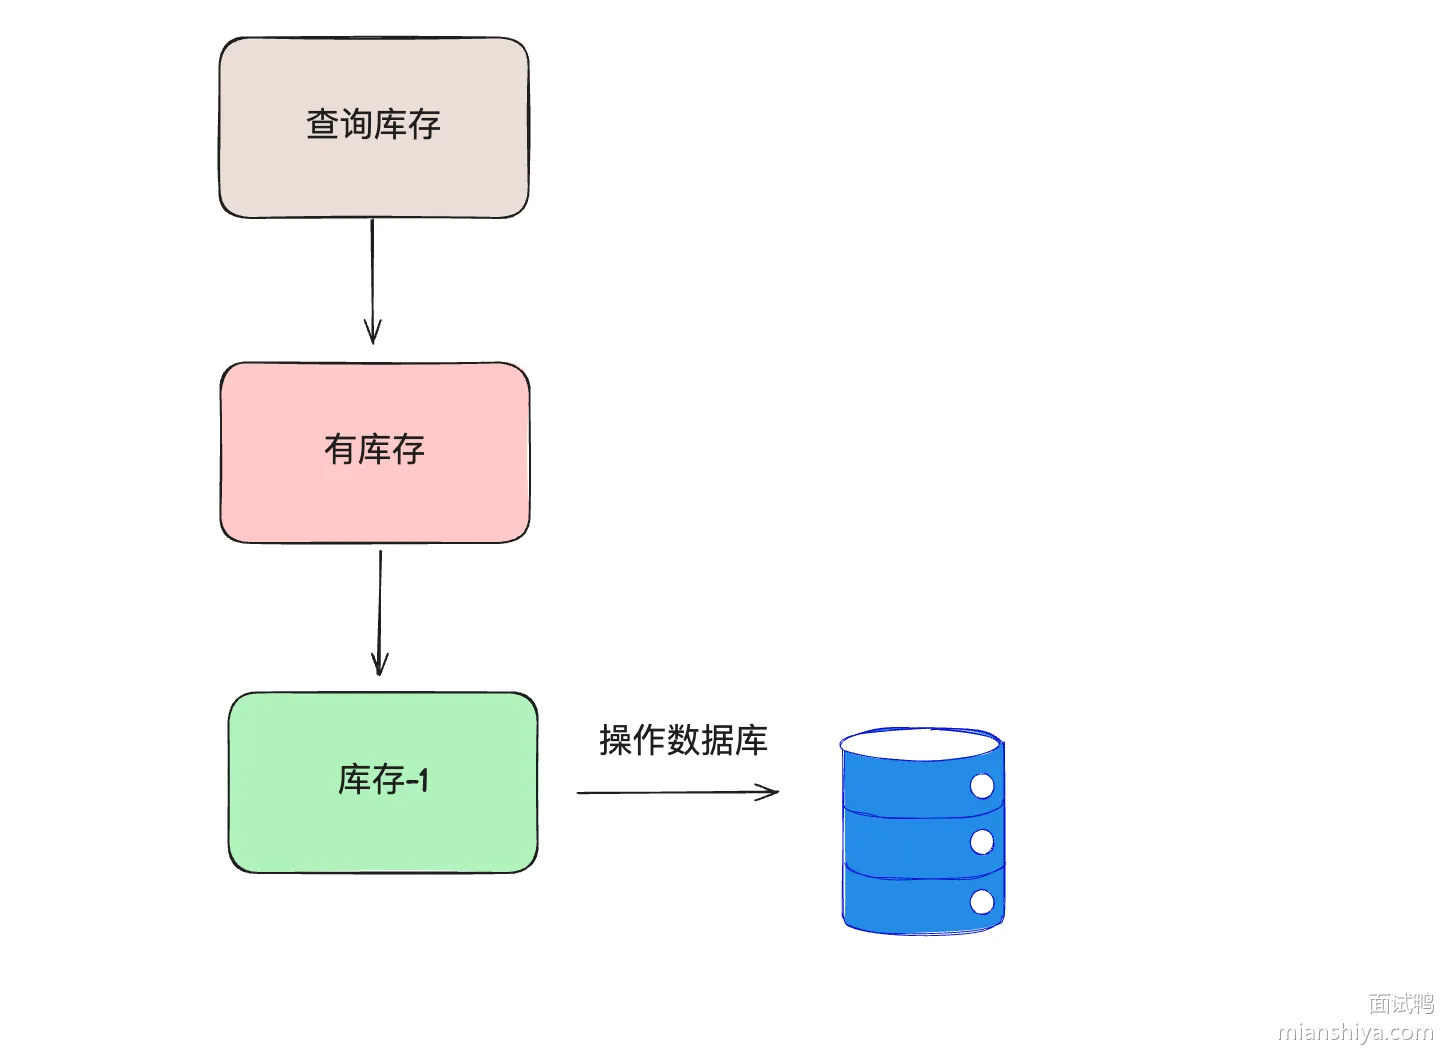
这样的设计会有什么问题?并发问题,导致超卖。
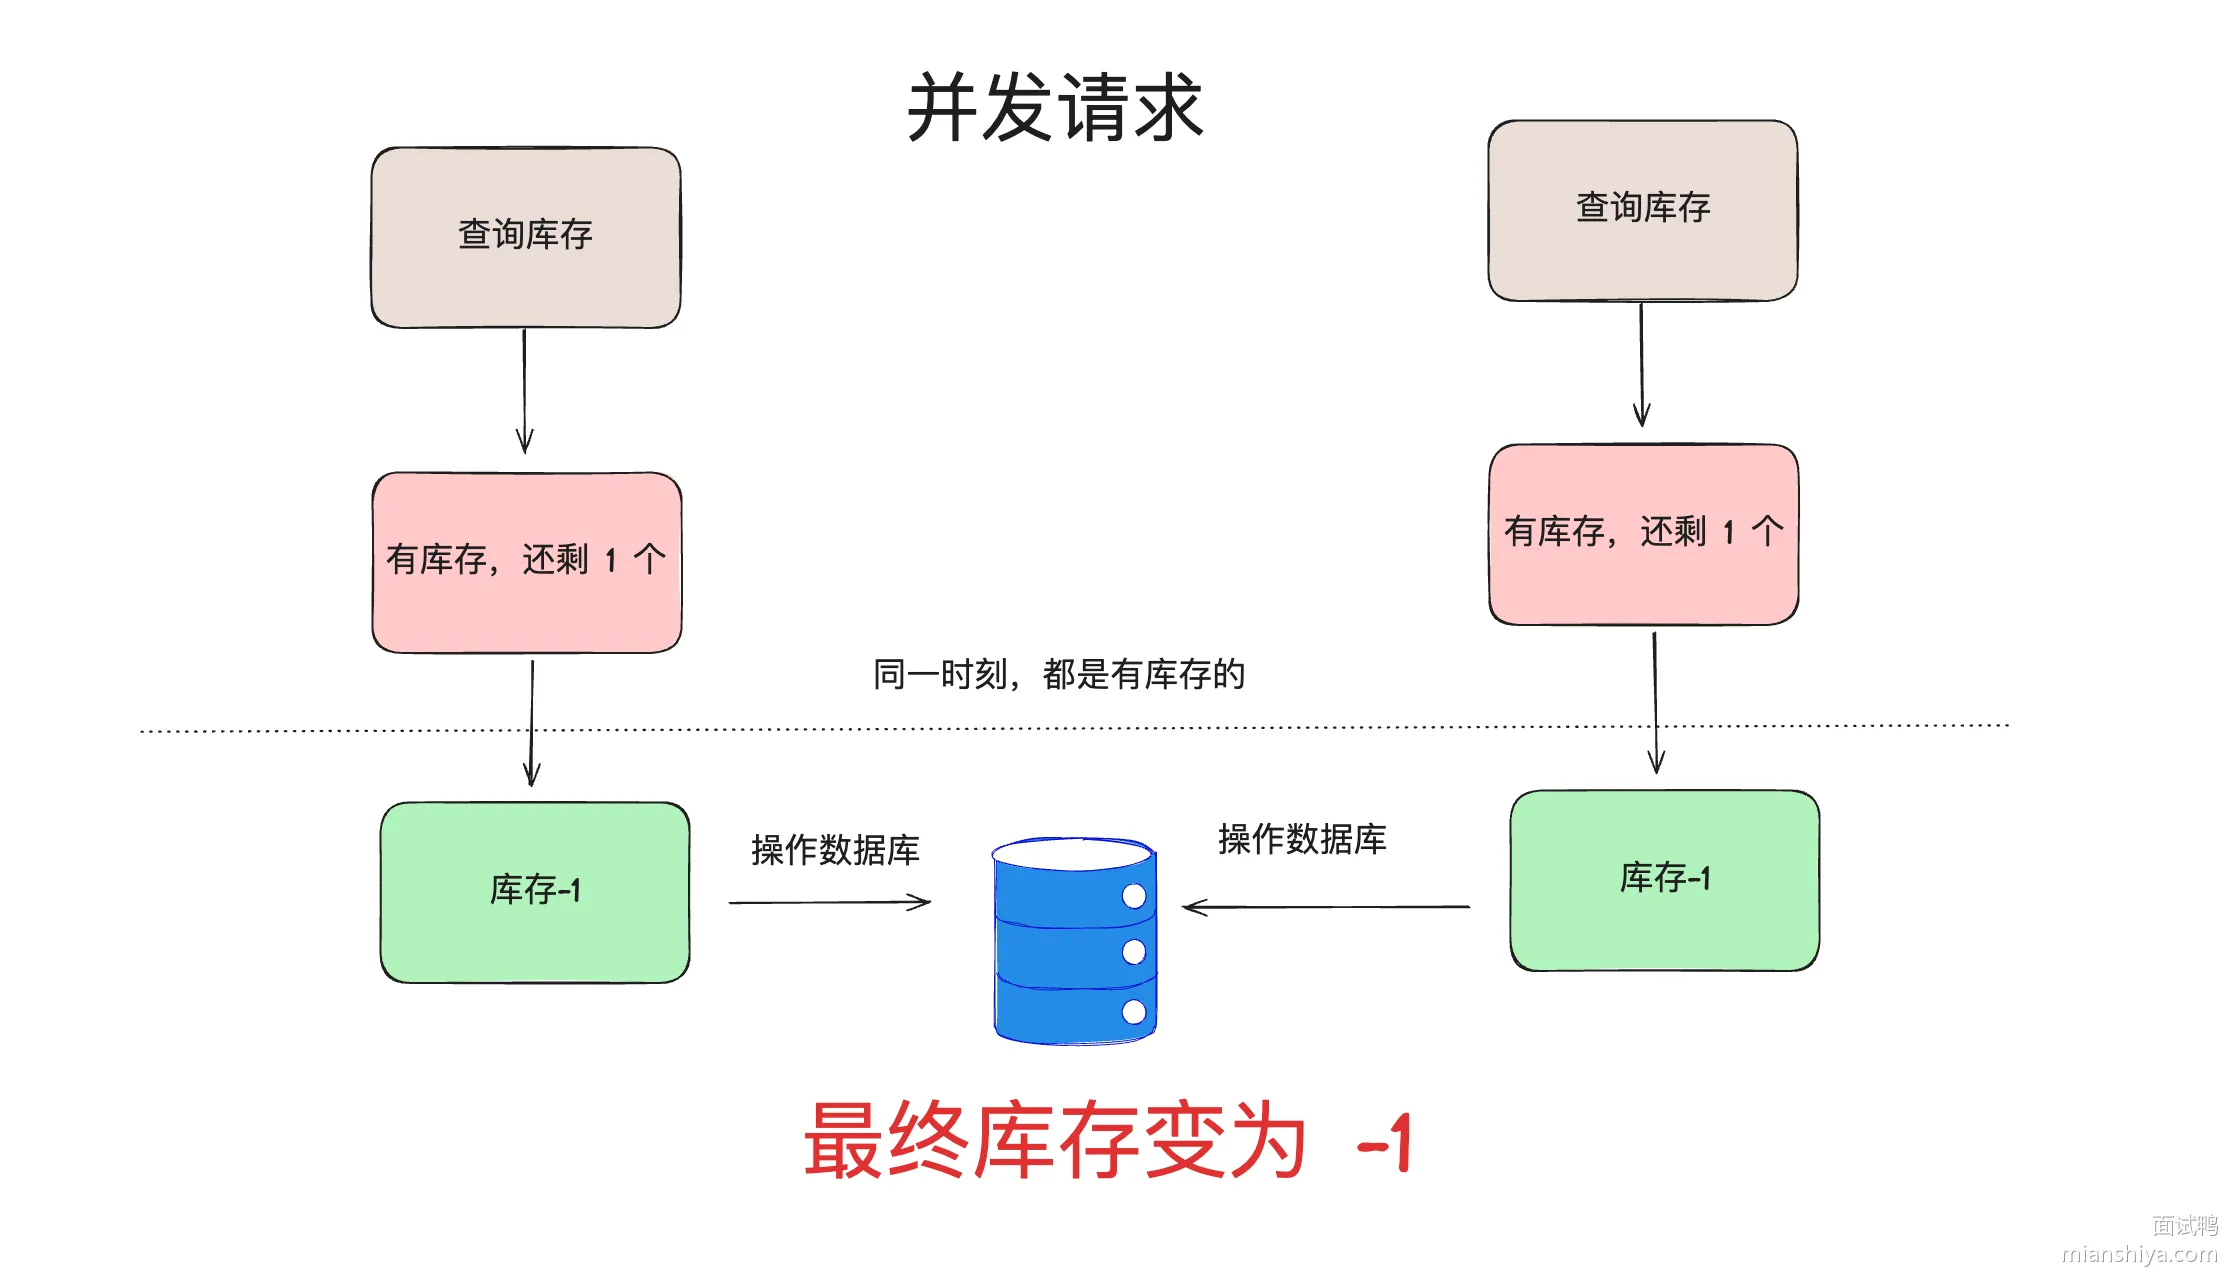
此时可以加锁,比如利用数据库的锁,针对这个场景数据库常用的是乐观锁。
update inventory set available_inventory = available_inventory - 1
where sku_id = 1 and available_inventory > 0;
数据库热点行问题解决方案
如果使用这个语句,在高并发场景下,实际上就会产生热点行问题。
我之前公司基于数据库扣减方案,压测单台机子下单链路的并发只能达到 70。单个扣减库存的接口并发只有 200 就把数据库 CPU 压满了。(各公司实际内部业务不同,仅供参考)
数据库补丁优化
我们当时数据库用的是阿里云的 RDS,实际上有一个可落地的优化方案:Inventory hint + Returning。
如果你公司本身用的就是阿里云的 RDS,这个改造成本就很低,仅需在 SQL 上填写一些 hint 即可。
在 SQL 表名前加 /*+ COMMIT_ON_SUCCESS ROLLBACK_ON_FAIL TARGET_AFFECT_ROW(1)*/
update /*+ COMMIT_ON_SUCCESS ROLLBACK_ON_FAIL
  TARGET_AFFECT_ROW(1)*/ inventory
 set available_inventory = available_inventory - 1
where sku_id = 1 and available_inventory > 0;
Inventory hint 原理简单介绍:
- COMMIT_ON_SUCCESS:当前语句执行成功就提交事务上下文。
- ROLLBACK_ON_FAIL:当前语句执行失败就回滚事务上下文。
- TARGET_AFFECT_ROW(NUMBER):如果当前语句影响行数是指定的就成功,否则语句失败。
设置了这几个 hint 后,当前的语句会按照主键(或唯一键)分组,将相同行的请求修改分为一组,分组后仅组内第一条 SQL 需要抢锁,后续的都不需要申请锁,减少申请锁的流程。
然后组内第一条 SQL 已经遍历 B+树查询到数据了,后续组内库存扣减直接改即可,不用再次查询。且组内 SQL 都修改完之后,仅需一次分组提交事务即可。
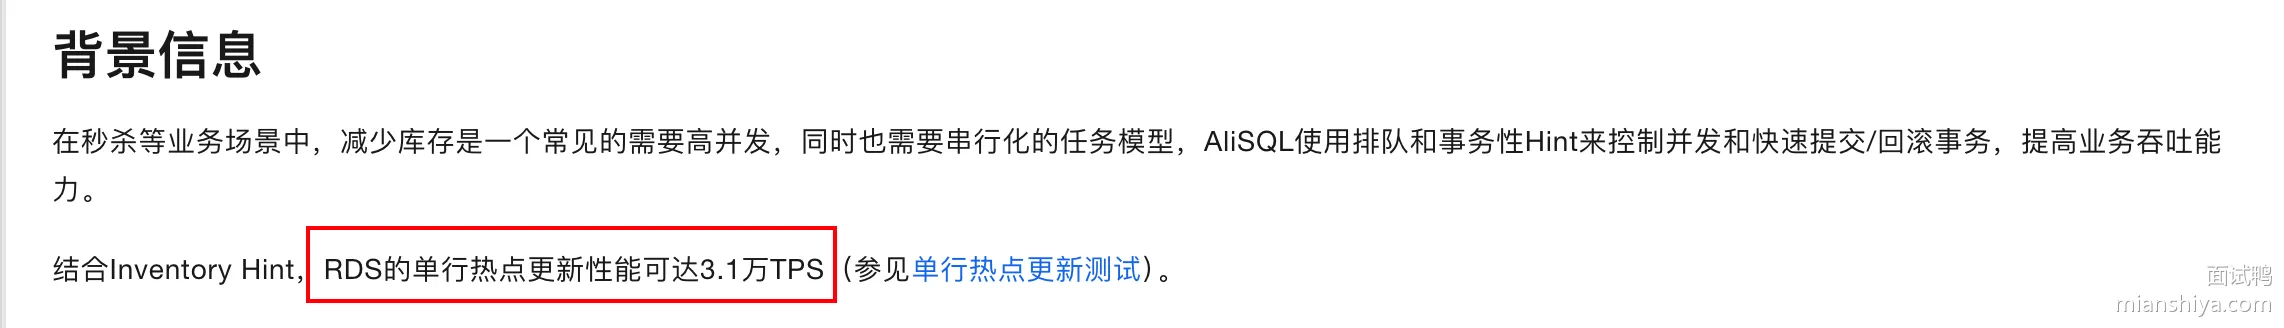
根据阿里云介绍,结合 Inventory hint 单行 TPS 可达 3.1w:
还可以配合 Returning 使用:
CALL dbms_trans.returning("*", "update /*+ COMMIT_ON_SUCCESS ROLLBACK_ON_FAIL
  TARGET_AFFECT_ROW(1)*/ inventory
 set available_inventory = available_inventory - 1
where sku_id = 1 and available_inventory > 0;");
正常情况下,如果我们 update 扣减了一次库存之后,如果想得知最新的库存,那么需要再执行一次 select 操作,而 Returning 可以直接返回实时的库存,减少一次查询。
利用 Returning,我们可以得知实时的库存,发现没库存后,可以直接设置一个标志位,表明秒杀已经结束,快速 fail 请求,降低服务的压力。
还有一个 Statement queue 我之前没用到,关于这几个 hint 的详情,可以查看这个介绍链接
库存拆分
除了数据库补丁优化,从业务角度,我们可以将库存进行拆分。
上面举例是 1 个库存,但有时候的秒杀的库存会更多,例如 1000 个库存,此时就可以将这 1000 个库存拆分成 100 个小库存,每个小库存内有 10 个库存。
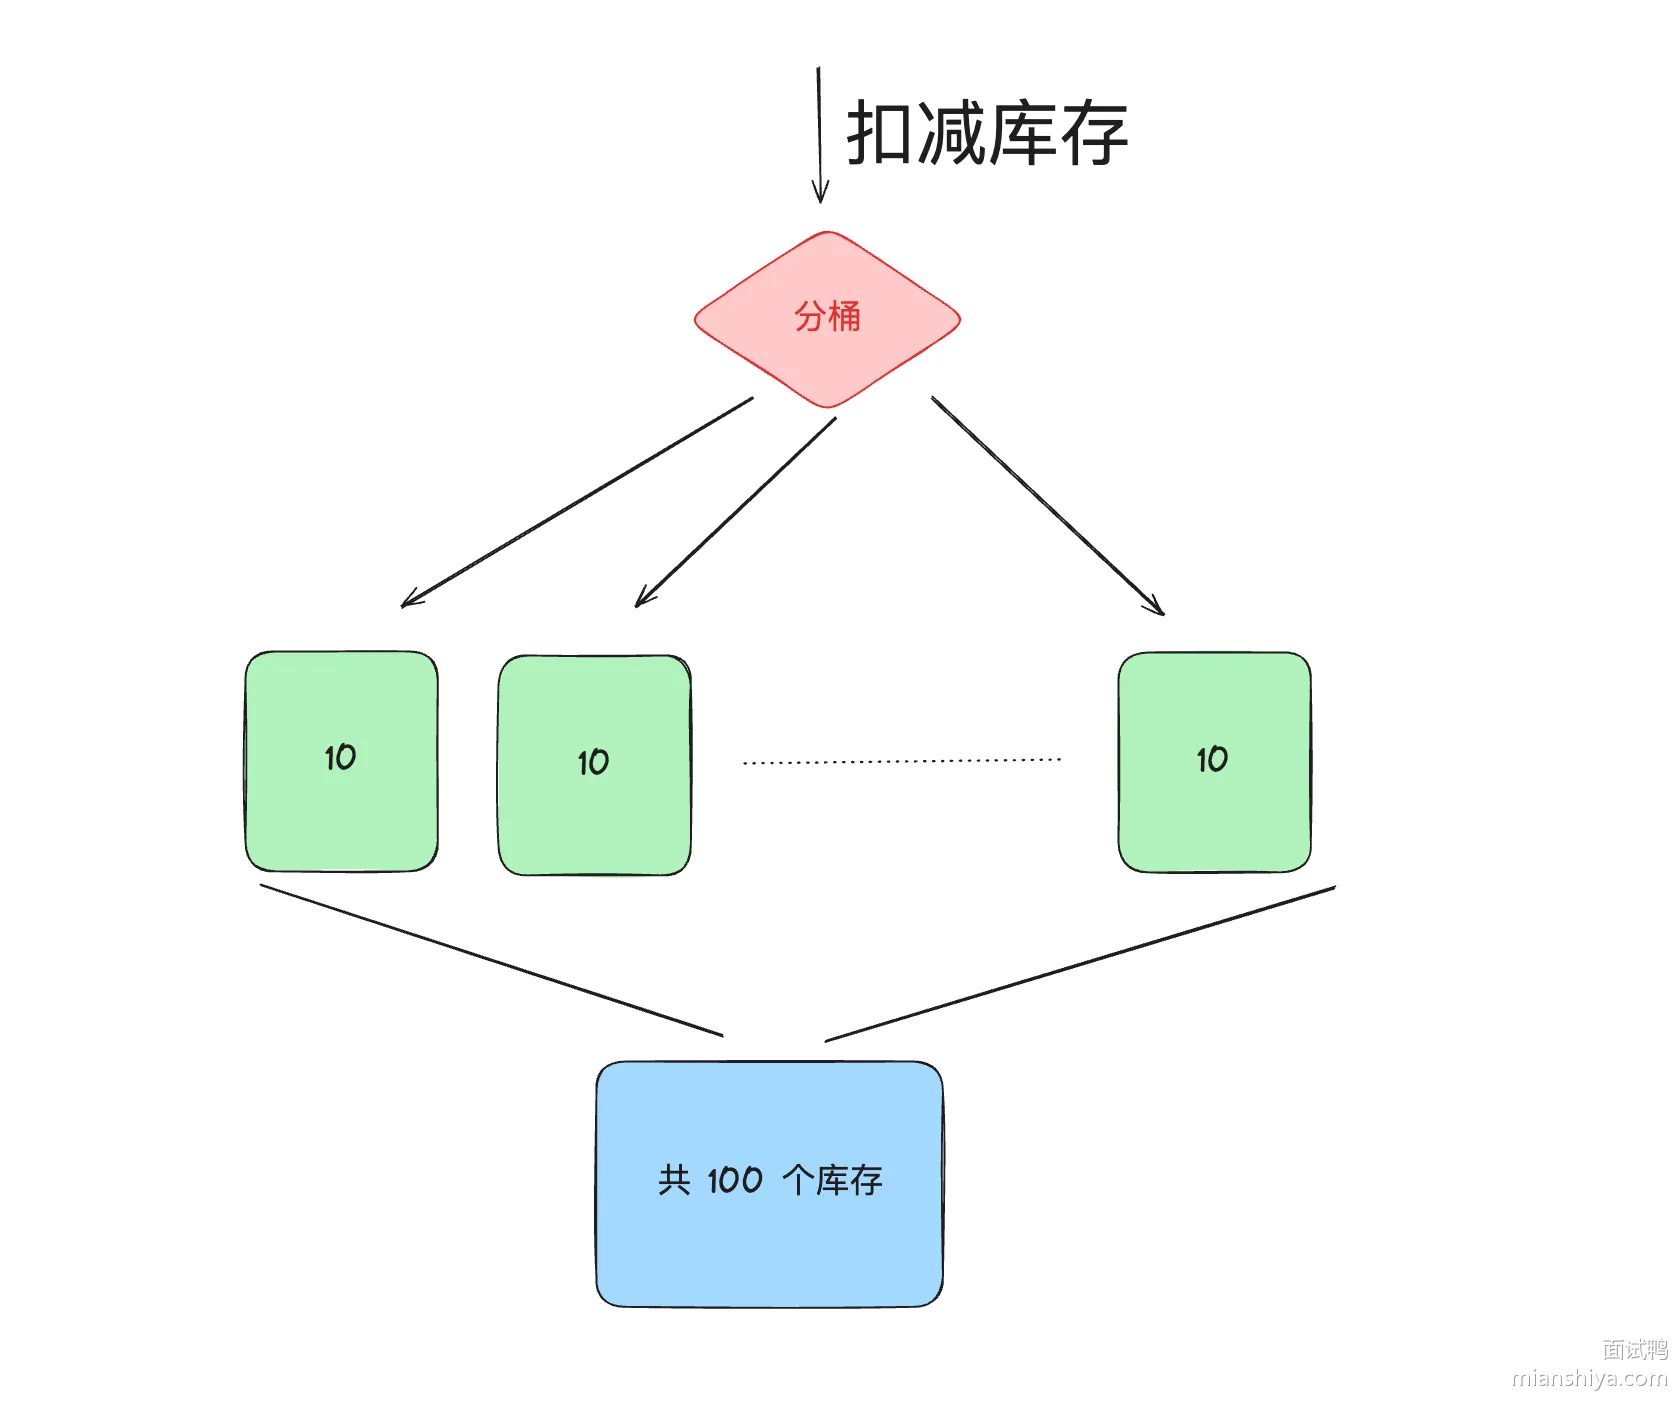
这样其实就是人为的把热点行拆分了,可以把小库存分散到不同的表或者库中,等于将并发度提升了 10 倍。
看起来挺简单,实际对于整个库存扣减流程的改造还是挺大的,例如分桶的库存调配、创建库存时分桶的库存分配、表的映射、库的映射等等。
插入库存扣减流水
既然直接 update 有热点行问题,那么就将 update 改为 insert 。
实际上用户的购买从更新库存变成插入流水,然后异步定时将流水库存同步到剩余库存中。
这个手段确实避免了热点行的问题,但插入数据不好控制总的数据量,容易导致超卖。
可以跟对方提一下这个方案,跟他说清这个方案是有超卖的问题。表明你知道这个思路,也知道这个方案的缺点。
这个思路实际上在非限制库存的热点行场景可以使用。
缓存
利用缓存来承接热点数据是很多人都熟知的方案,例如使用 Redis。
可以将库存提前同步到 Redis 中,然后利用 redis + lua 脚本控制库存的扣减。
lua 脚本的内容实际上很简单,我用文字来描述一下:
- 根据商品 key 获取库存
- 如果有则库存-1,返回新库存
- 如果没库存,则返回没库存
redis + lua 可以保证操作的原子性,且性能足够优秀,因此是一个非常高效的库存扣减方案。
然后 redis 扣减完毕之后,可以发送一个异步消息(消息队列削峰填谷),后端服务异步消费把数据库中的库存给扣了,实现最终一致性。
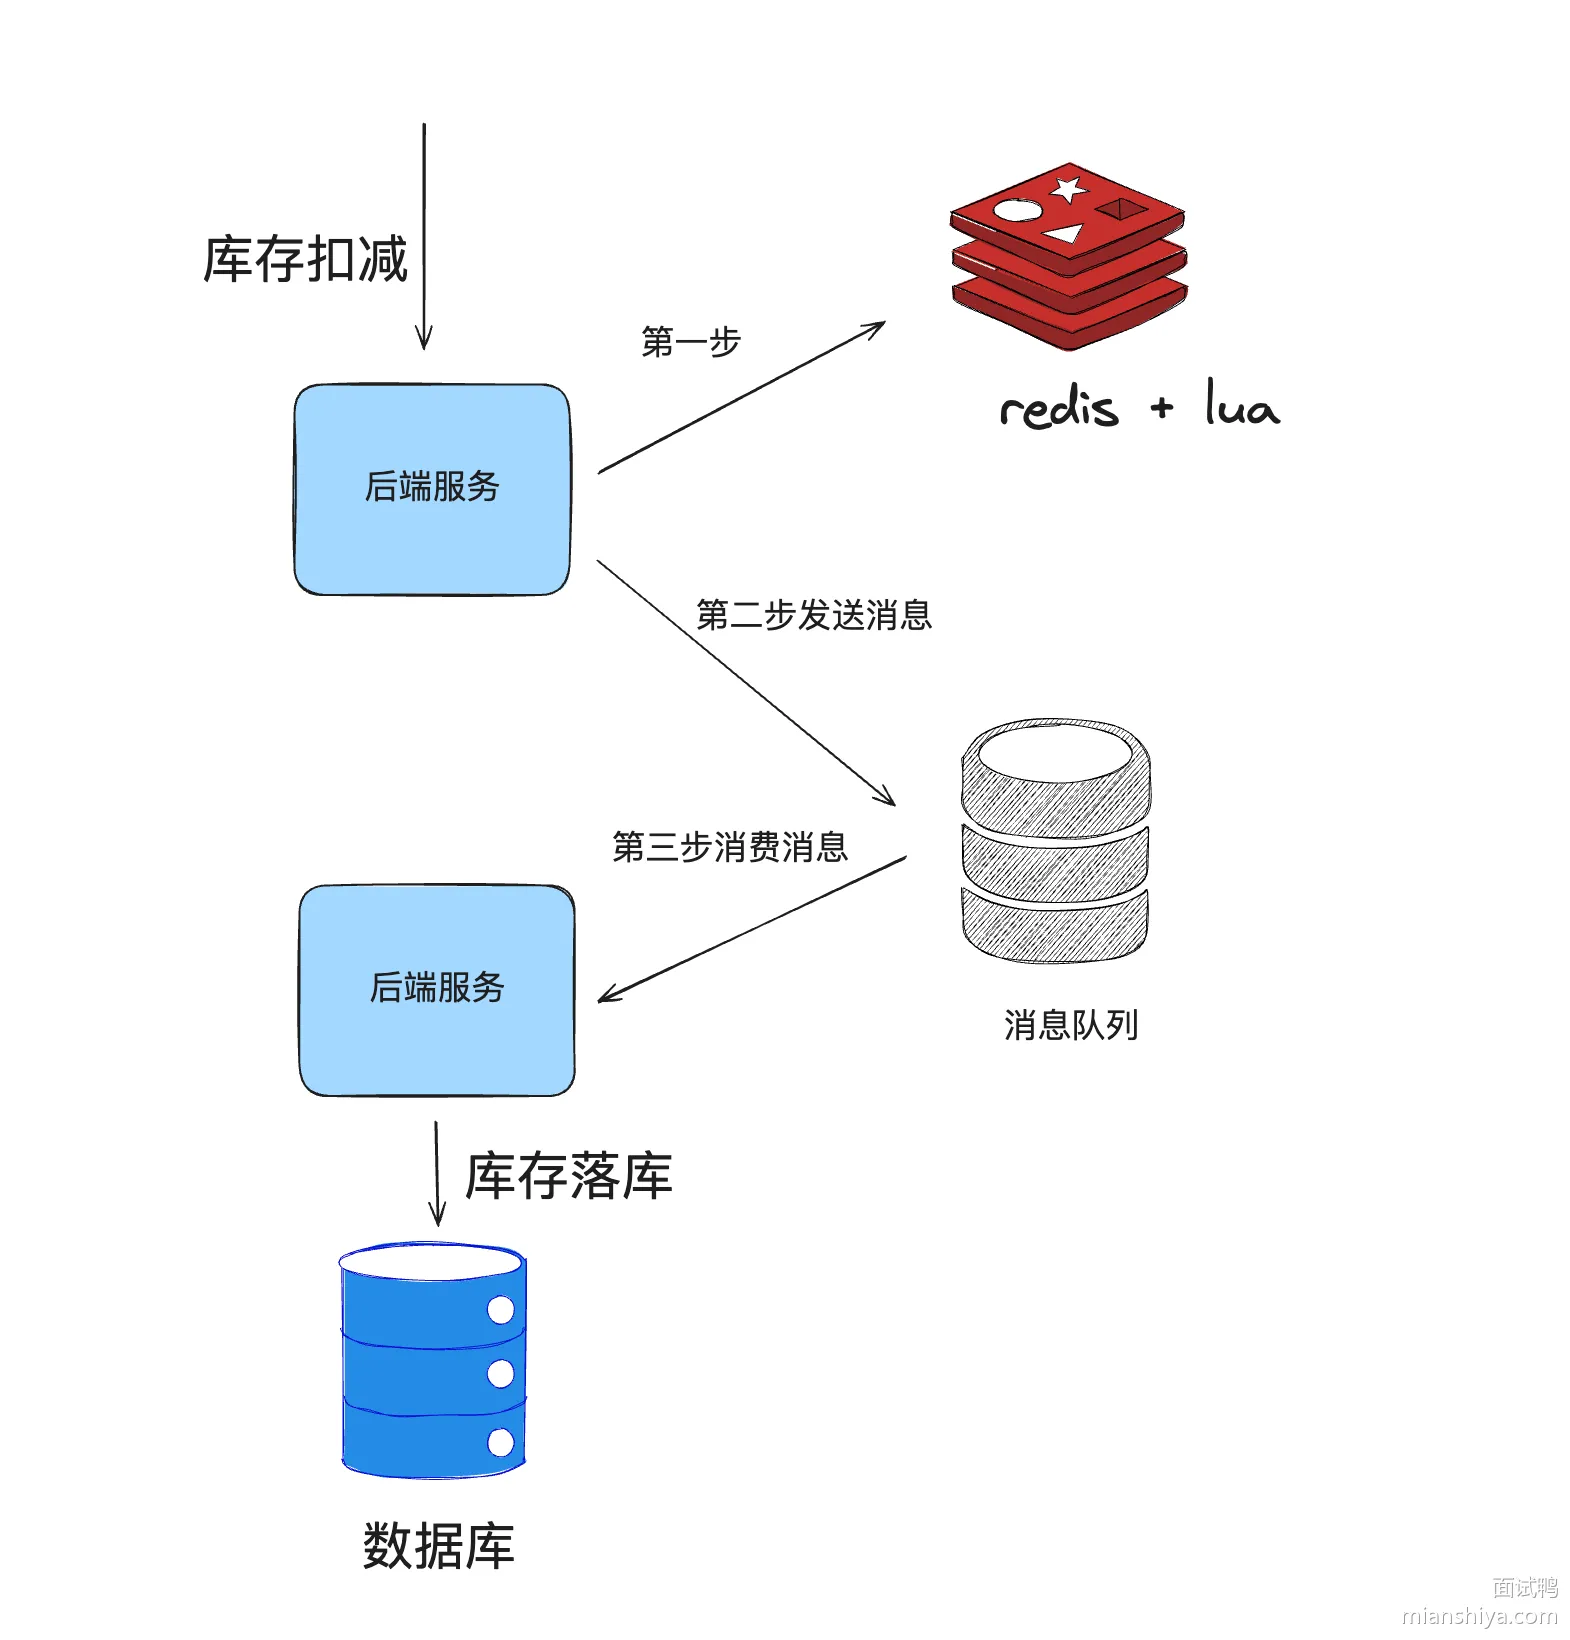
看到这肯定有同学会问:“redis 操作成功后,mq发送失败怎么办?”
因此,我们还需要一个准实时对账机制,lua 脚本内不仅要扣减库存,还需要利用 zset 增加流水,score 设置为时间。定时拉取一段时间流水记录比对数据库的库存是否一致,如果不一致则补偿。
至于本地缓存,理论上性能更高,但是方案设计上会更复杂,因为库存被分配到多个应用中。需要在秒杀预热的时候,给后端服务预分配好库存,然后应用各自承接库存扣减,也需要做好对账,防止意外的发生。
预防黑产
大一点的公司都会有风控机制,借助一些算法对用户的来源、行为数据等等进行分析,如果发现不法分子,则将其加入到黑名单中。
脚本抢购实际上可以用验证码、答题等机制拦截,并且这种机制也可以打散用户的请求,降低瞬时流量高峰。
幂等设计
可以看这题:如何避免用户重复下单(多次下单未支付,占用库存)
业务手段
预约
例如 Nike 设计就是抢购,预约有一个比较长的时间段,例如 15 分钟。然后预约通过后等待最终抽签结果即可。
这样的设计通过一段时间的预约,可减少瞬时的压力,再异步通过后台实现抽签来间接解决秒杀的问题。
预售
例如现在的电商活动都搞定金预售。
通过下定让用户感觉这个商品已经到手了,不需要再等到双十一或者 618 零点准时抢购,均摊了请求,减少准点抢购的压力。
避免对正常服务的影响
大部分公司秒杀都是和正常服务糅合在一起的,没有做区分。
如果成本允许,且为了避免对正常业务产生影响,则可以将秒杀单独剥离出一套,独立域名、独立服务器部署等。
不过这样实现起来其实很麻烦,最终的数据还是需要同步的正常服务中的,成本比较大。
兜底方案
或许在真正的业务中,很少有人会做兜底方案,都仅考虑正向业务,但是兜底确实很重要!
所以在业务上的设计我们要尽量考虑异常极端情况,设计一个简单的兜底也比没兜底好。
那就得疯狂兜底!向对方展示出你的方案面面俱到!
针对秒杀,其实最简单的方案就是加个开关:关闭秒杀,直接返回秒杀结束。
这个兜底是为了避免极端情况发生,严重影响正常业务的进行或产生资损。
因为秒杀对用户而言本身是一个可以接受失败的场景,没抢到很正常。只要用户来参加我们的活动,营销目的也达到了,所以在严重影响正常业务进行或者发现代码出现漏洞,被人薅羊毛的情况下,关闭秒杀是最好的选择!
常见问题
Redis + Lua 扣减库存成功但 MQ 发送失败了怎么处理?
回答:核心靠对账机制。Lua 脚本里除了扣库存,还要用 zset 记录扣减流水,score 存时间戳。后台跑个定时任务拉最近一段时间的流水,跟数据库库存比对,发现不一致就走补偿逻辑把数据库扣了。对账周期一般设几秒到几十秒,取决于业务对一致性的容忍度。
库存拆分之后,某个分桶的库存卖完了但其他分桶还有库存怎么办?
回答:两种处理方式。一种是路由层做感知,发现当前分桶没库存了就重新路由到其他分桶。另一种是后台跑个再平衡任务,监控各分桶库存,发现不均衡就做库存调拨。第一种响应快但路由逻辑复杂,第二种简单但有时间差。可以两种结合,优先路由切换,兜底靠再平衡。
如果秒杀流量把 Redis 也打挂了怎么办?
回答:首先 Redis 要做好集群部署和限流保护,巨大流量单机肯定扛不住。如果真挂了,降级策略是切到本地缓存或者直接走兜底开关返回秒杀结束。本地缓存要提前预热好,切换逻辑要配置化可以秒级生效。
秒杀场景下数据库乐观锁和悲观锁该怎么选?
回答:秒杀场景基本都用乐观锁。悲观锁是先锁再操作,高并发下大量请求排队等锁,吞吐量上不去。乐观锁是直接更新带条件判断,失败了快速返回。秒杀本来成功率就低,大部分请求注定失败,用乐观锁让它们快速失败快速返回才是正解。
724. 让你设计一个消息队列,怎么设计?
核心要点
设计类题目要先从大局上讲出核心要点,然后等对方深挖。
1)先明确消息中间件的几个重要角色:生产者、消费者、Broker、注册中心。
2)消息中间件数据流转过程:生产者生成消息发送至 Broker,Broker 暂存消息,消费者再从 Broker 拉取消息进行消费。注册中心负责服务发现,包括 Broker、生产者、消费者的注册和下线,服务的高可用离不开它。
3)通信层面:各模块通信可以基于 Netty 自定义协议来实现。注册中心可以用 ZooKeeper、Consul、Nacos 这些现成的,也可以像 RocketMQ 一样自己实现轻量的 NameServer。
4)考虑扩容和性能,采用分布式架构:
- 像 Kafka 一样采取分区理念,一个 Topic 分成多个 Partition
- 为保证数据可靠性采取多副本存储,Leader 和 Follower 机制,根据性能和可靠性权衡提供异步和同步刷盘
- 利用选举算法保证 Leader 挂了之后 Follower 能顶上
- 用本地文件系统存储消息,采用顺序写提高性能
- 根据场景使用内存映射、零拷贝进一步提升性能,还可以像 Kafka 那样用批处理思想提高整体吞吐
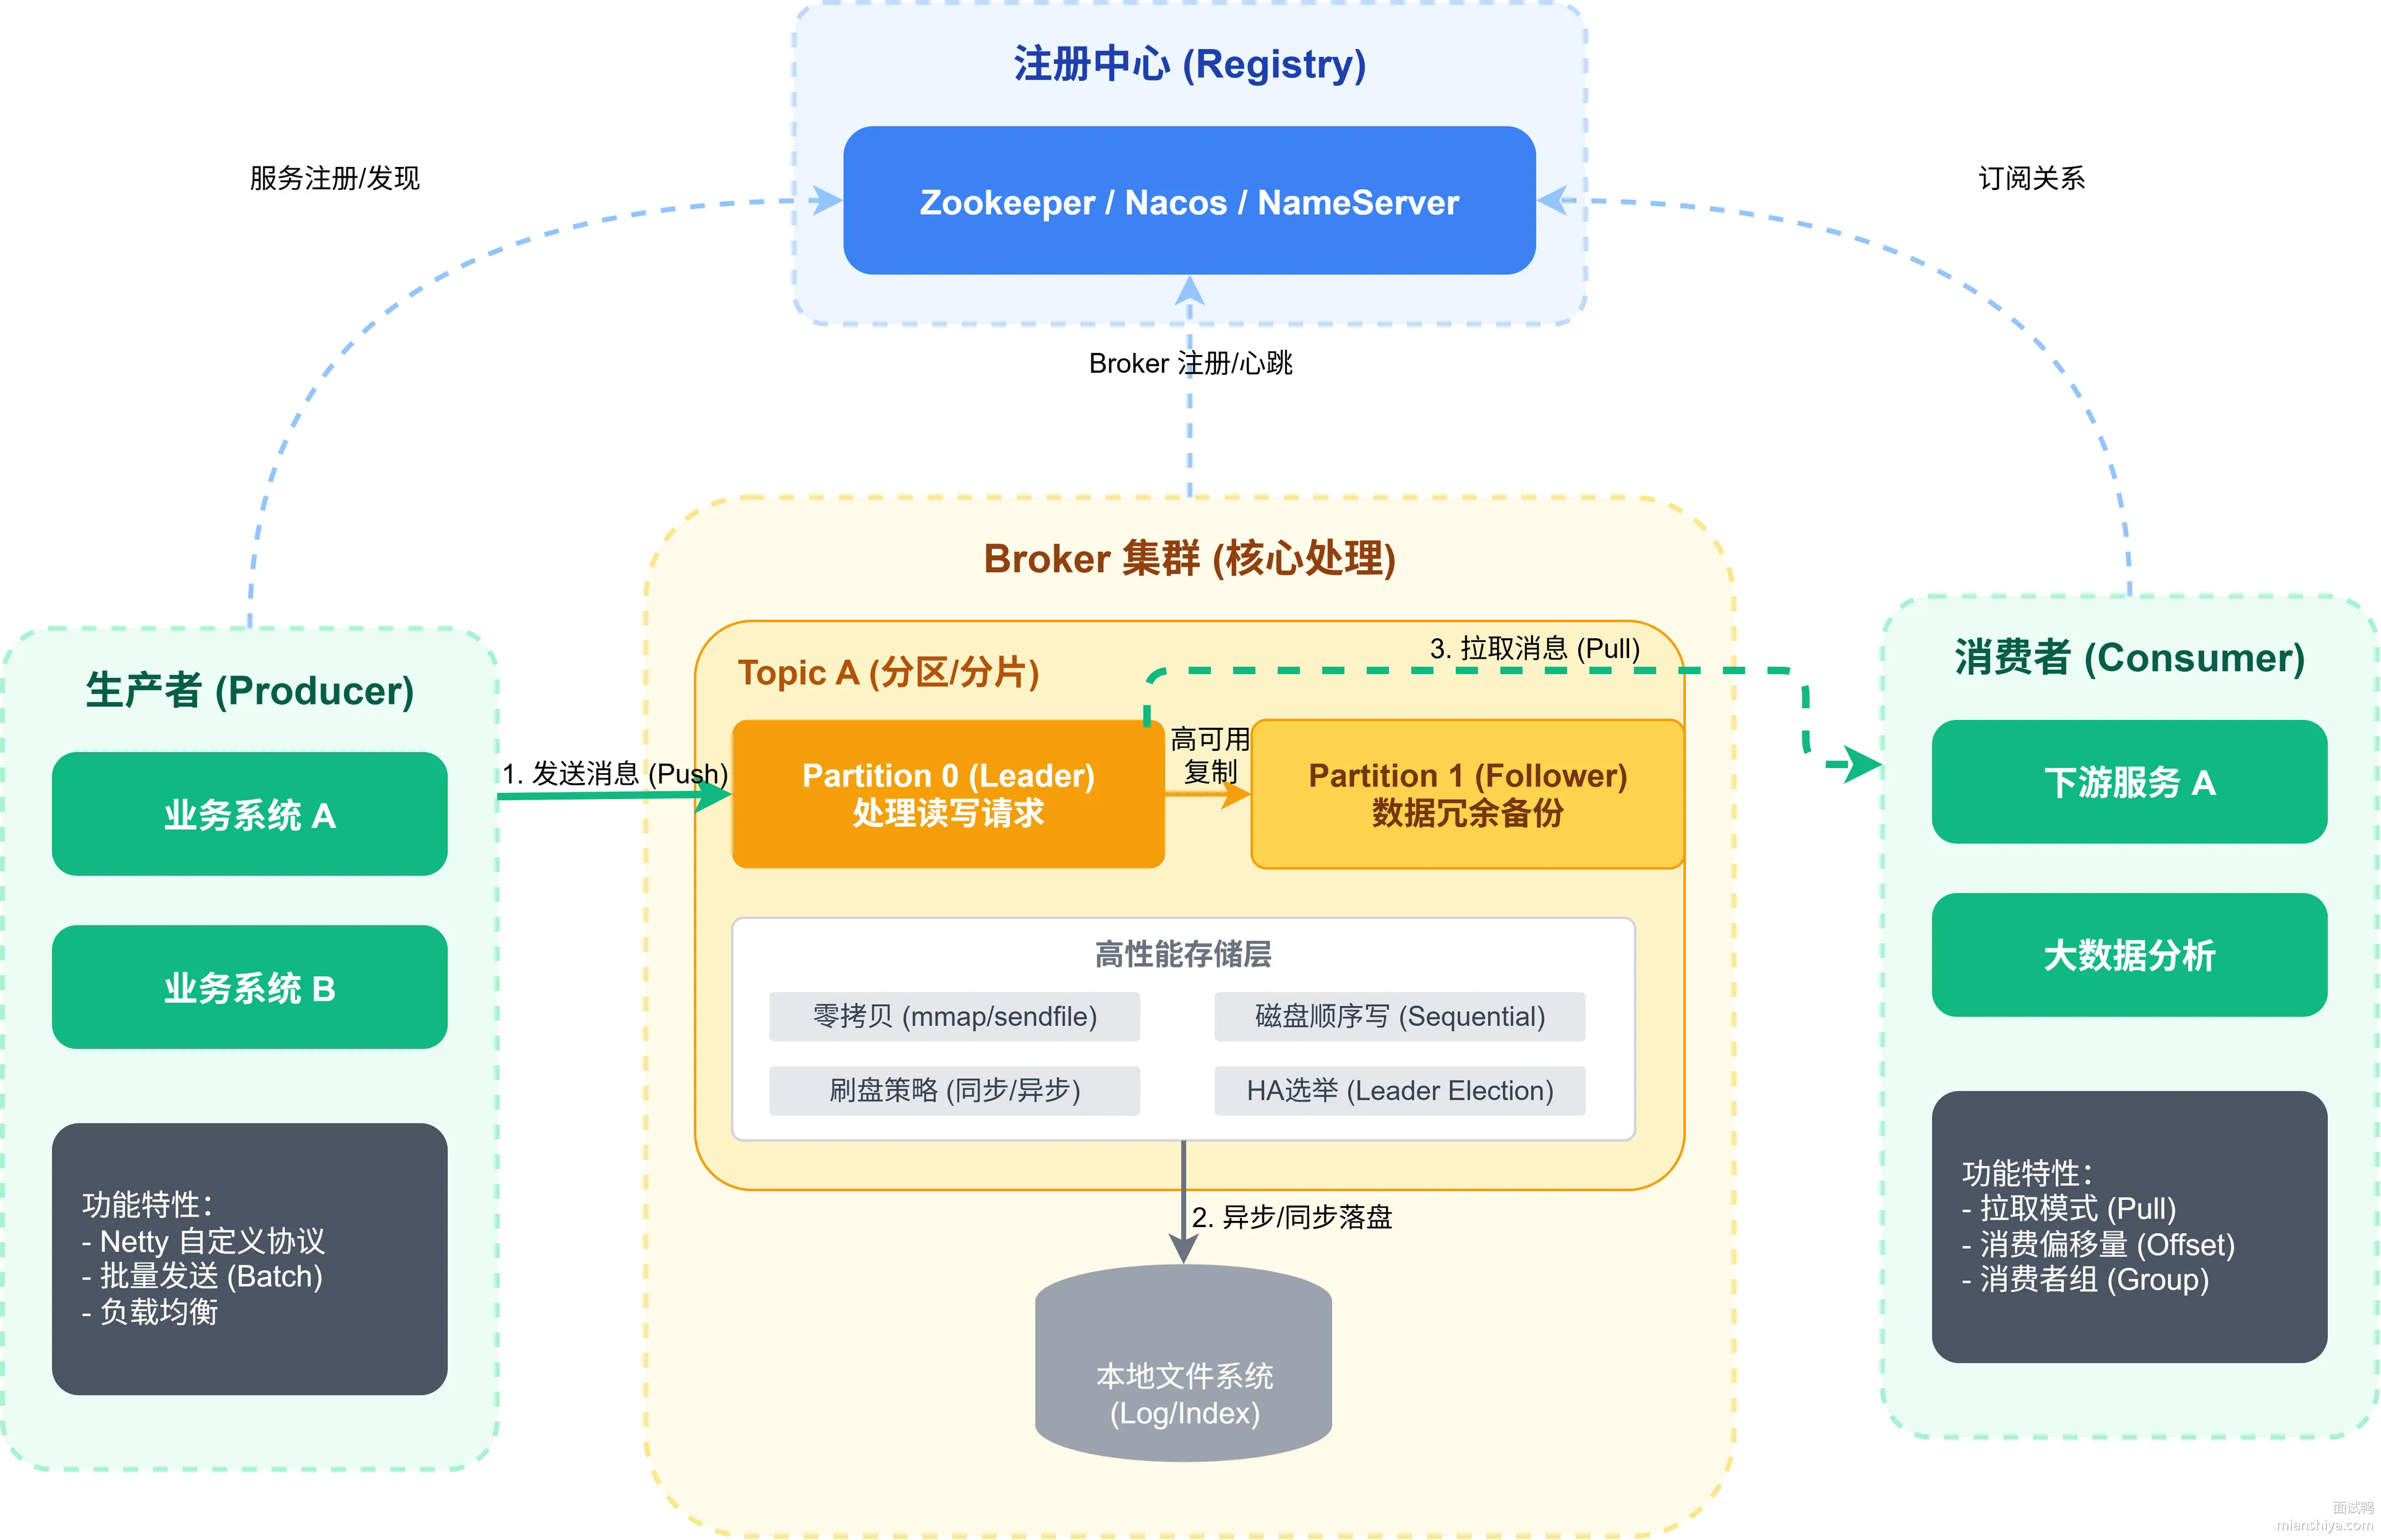
说到这些要点基本就差不多了。
有一点要注意:说各设计要点时要留机会给对方插话,让对方有参与感,感觉是在他的引导下设计逐步完善的。让沟通成为一场技术交流。
扩展知识
消息队列解决什么问题
消息队列核心解决三个问题:异步、解耦、削峰。
拿电商下单场景来说,用户下单后要扣库存、发优惠券、发短信通知、更新积分,如果同步调用,响应时间是各个服务耗时之和,用户等得不耐烦。
引入消息队列后,下单服务只管把消息丢到队列里就返回,后续那些服务各自消费处理,响应时间直接从 500ms 降到 50ms。
解耦方面,原来订单服务要直接调用库存、积分、短信这些服务,耦合严重,任何一个服务挂了或者改接口都得跟着改。
引入消息队列后,订单服务只管发消息,压根不用关心谁来消费。
削峰方面,秒杀场景每秒 10 万请求打过来,数据库直接扛不住。
消息队列顶在前面,把请求攒在队列里,后端服务按自己能力慢慢消费,比如每秒处理 2000 个,系统稳稳的。
存储设计
存储是消息队列的核心,直接决定了性能和可靠性。
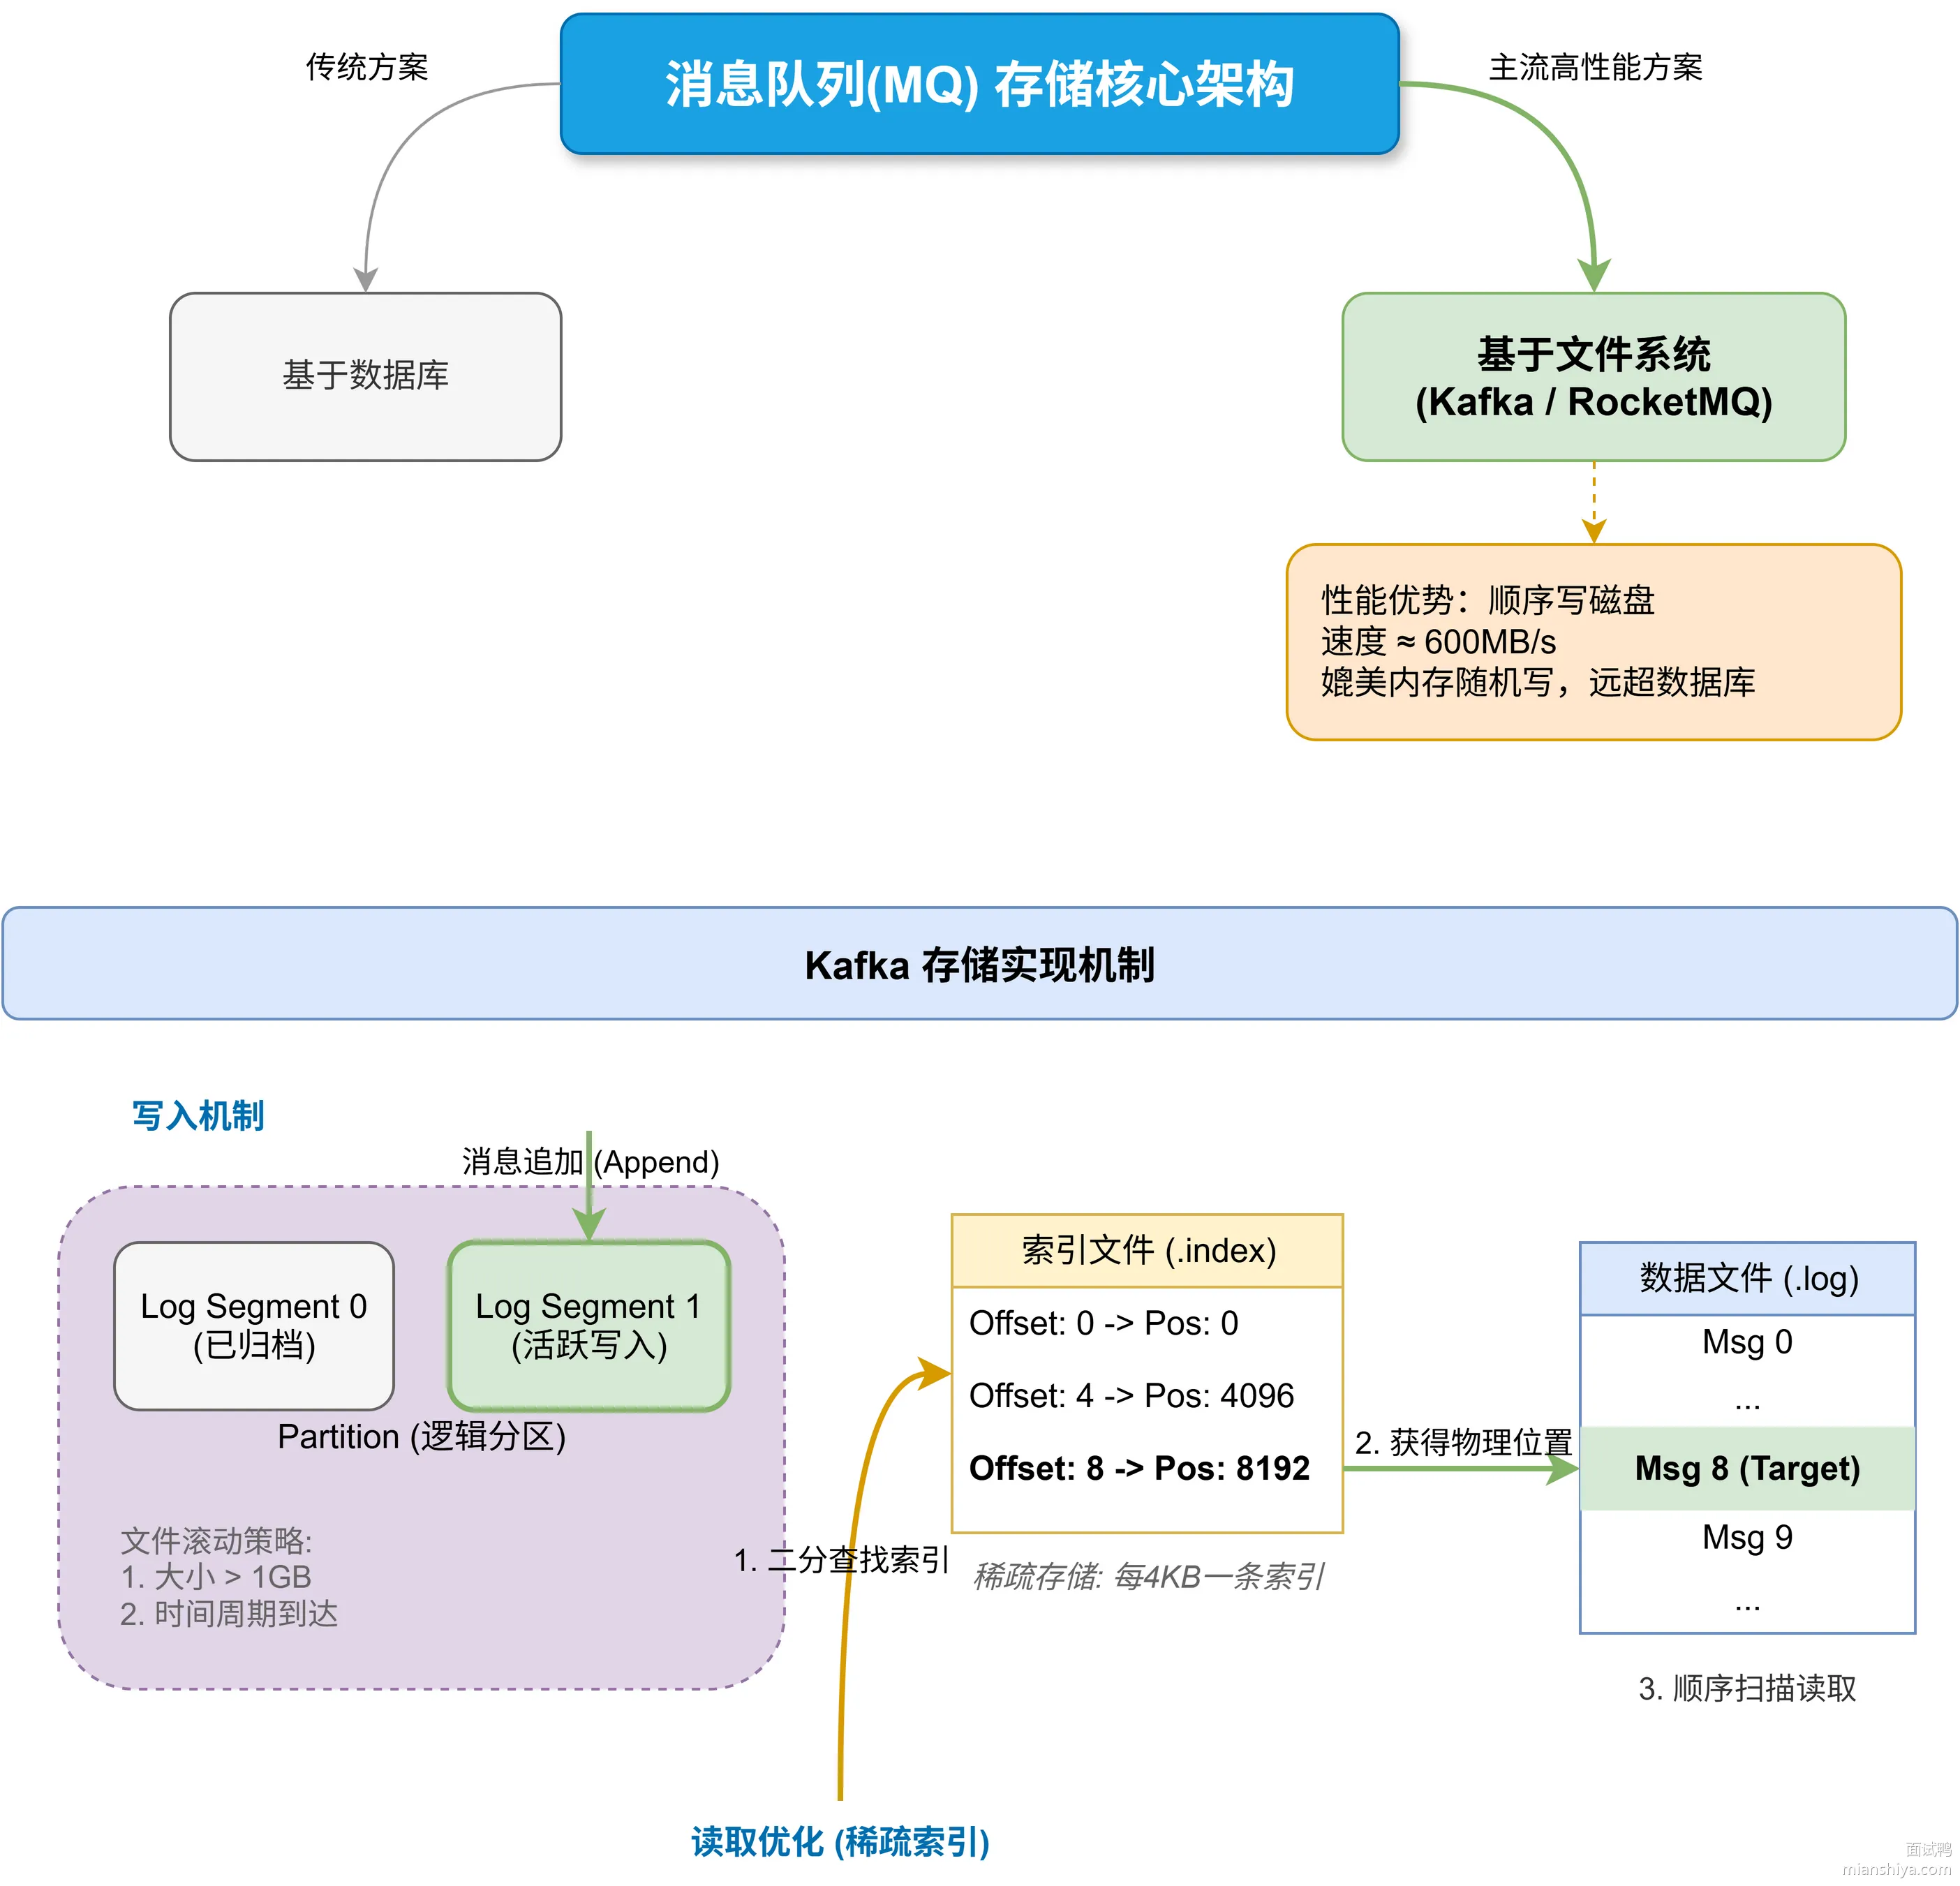
主流方案有两种:基于文件系统和基于数据库。Kafka、RocketMQ 都选了文件系统,原因很简单,顺序写磁盘的性能能到 600MB/s,跟内存随机写差不多快,比数据库高出一个数量级。
具体实现上,Kafka 把每个 Partition 的消息写到一个 log 文件里,文件按大小或时间滚动,比如超过 1GB 就新建一个文件。消息追加写入,天然有序,消费的时候根据 offset 定位到具体位置顺序读取。
为了加速读取,还会维护索引文件。Kafka 的索引是稀疏的,每隔 4KB 记录一个 offset 到物理位置的映射,查找时先二分查索引,再顺序扫描,平衡了索引大小和查询效率。
高可用设计
单点故障是分布式系统的大忌,消息队列通过副本机制来保证高可用。
Kafka 的做法是每个 Partition 有一个 Leader 和多个 Follower。生产者只跟 Leader 打交道,Follower 从 Leader 同步数据。Leader 挂了,从 ISR 列表里选一个 Follower 提升为新 Leader,整个过程对生产者和消费者透明。
ISR 是 In-Sync Replicas 的缩写,代表跟 Leader 数据同步没掉队的副本集合。如果某个 Follower 同步太慢,会被踢出 ISR。选举新 Leader 只从 ISR 里选,保证新 Leader 的数据是最新的。
刷盘策略也影响可靠性。同步刷盘是消息写到磁盘才返回成功,可靠但慢;异步刷盘是写到 PageCache 就返回,性能高但机器宕机会丢数据。RocketMQ 默认异步刷盘,Kafka 默认也是异步,实际生产中根据业务对数据丢失的容忍度来选。
消费模型
消费模型主要有两种:推模式和拉模式。
推模式是 Broker 主动把消息推给消费者,实时性好,但消费者处理不过来的时候容易被压垮。RabbitMQ 默认用推模式。
拉模式是消费者主动去 Broker 拉消息,消费者可以控制消费速度,不会被撑爆,但实时性差一些,消费者得不停地轮询。Kafka 用的是拉模式。
Kafka 的拉模式做了优化,支持长轮询。消费者发起拉取请求时可以设置等待时间,如果没有新消息,Broker 会 hold 住请求直到有消息或者超时,避免了空轮询浪费资源。
顺序性保证
很多业务场景需要保证消息顺序,比如订单状态变更,创建、支付、发货、完成这几条消息顺序乱了业务就出问题。
全局有序代价太大,Kafka 只保证单个 Partition 内有序。生产者发消息时指定同一个 Key,Kafka 根据 Key 做 hash 路由到同一个 Partition,消费者单线程消费这个 Partition,顺序就能保证。
如果消费端要多线程提高吞吐,可以在消费者内部再根据 Key 路由到不同的队列,每个队列单线程处理,在业务层面保证同一个 Key 的消息顺序消费。
事务消息
分布式场景经常需要保证本地事务和消息发送的一致性。比如下单时要扣库存、发消息通知,两个操作要么都成功要么都失败。
RocketMQ 的事务消息解决了这个问题。流程是:先发半消息到 Broker,这时候消费者看不到;然后执行本地事务;根据本地事务结果提交或回滚消息。如果 Broker 一直没收到确认,会回查生产者,生产者检查本地事务状态后再返回提交或回滚。
Kafka 0.11 版本也引入了事务支持,但用法不太一样,主要用在流处理场景的 exactly-once 语义。
常见问题
消息队列怎么保证消息不丢失?
回答:要从三个环节考虑。生产端要开启确认机制,Kafka 设置 acks=all,消息写入所有 ISR 副本才算成功。Broker 端要开启持久化,同步刷盘最可靠,异步刷盘配合多副本也能接受。消费端要关闭自动提交,处理完消息再手动提交 offset,避免消息没处理完就标记已消费。
消息积压了几百万条怎么处理?
回答:先定位积压原因,是消费者处理太慢还是消费者挂了。如果是处理慢,临时扩容消费者实例数量,但要注意 Kafka 里消费者数量不能超过 Partition 数量,超过了也没用。如果 Partition 数量不够,紧急情况下可以新建一个 Topic,Partition 数量开大,用一个临时消费者把老 Topic 的消息倒腾到新 Topic,再用更多消费者并行消费。
怎么保证消息不重复消费?
回答:消息队列只能保证 at least once,不重复得靠消费端自己做幂等。常见方案:业务上用唯一 ID 做去重,比如订单号;数据库层面用唯一索引兜底;Redis 里记录已处理的消息 ID,处理前先查一下。
Kafka 的零拷贝是怎么实现的?
回答:Kafka 用 sendfile 系统调用实现零拷贝。传统方式是数据从磁盘读到内核缓冲区,拷贝到用户空间,再拷贝回内核的 socket 缓冲区,最后发出去,来回 4 次拷贝 4 次上下文切换。sendfile 直接在内核里把数据从文件描述符传到 socket 描述符,省掉用户空间那一趟,变成 2 次拷贝 2 次上下文切换,性能提升明显。
1140. 消息队列设计成推消息还是拉消息?推拉模式的优缺点?
核心要点
推模式(Push):消息队列(Broker)将消息主动推送给消费者,适合实时性要求高、消费者能够及时处理消息的场景。
- 优点:实时性好,消息可立即送达消费者。
- 缺点:难以控制消费速度,容易导致消费者过载,尤其是在高并发时。
拉模式(Pull):消费者主动从消息队列(Broker)中拉取消息,适合消费能力有限、需要根据自身处理能力调控速率的场景。
- 优点:消费者可以根据自身负载决定拉取频率,避免过载;更适合批量处理。
- 缺点:可能会导致消息延迟,实时性不如推模式,尤其是拉取频率较低时。
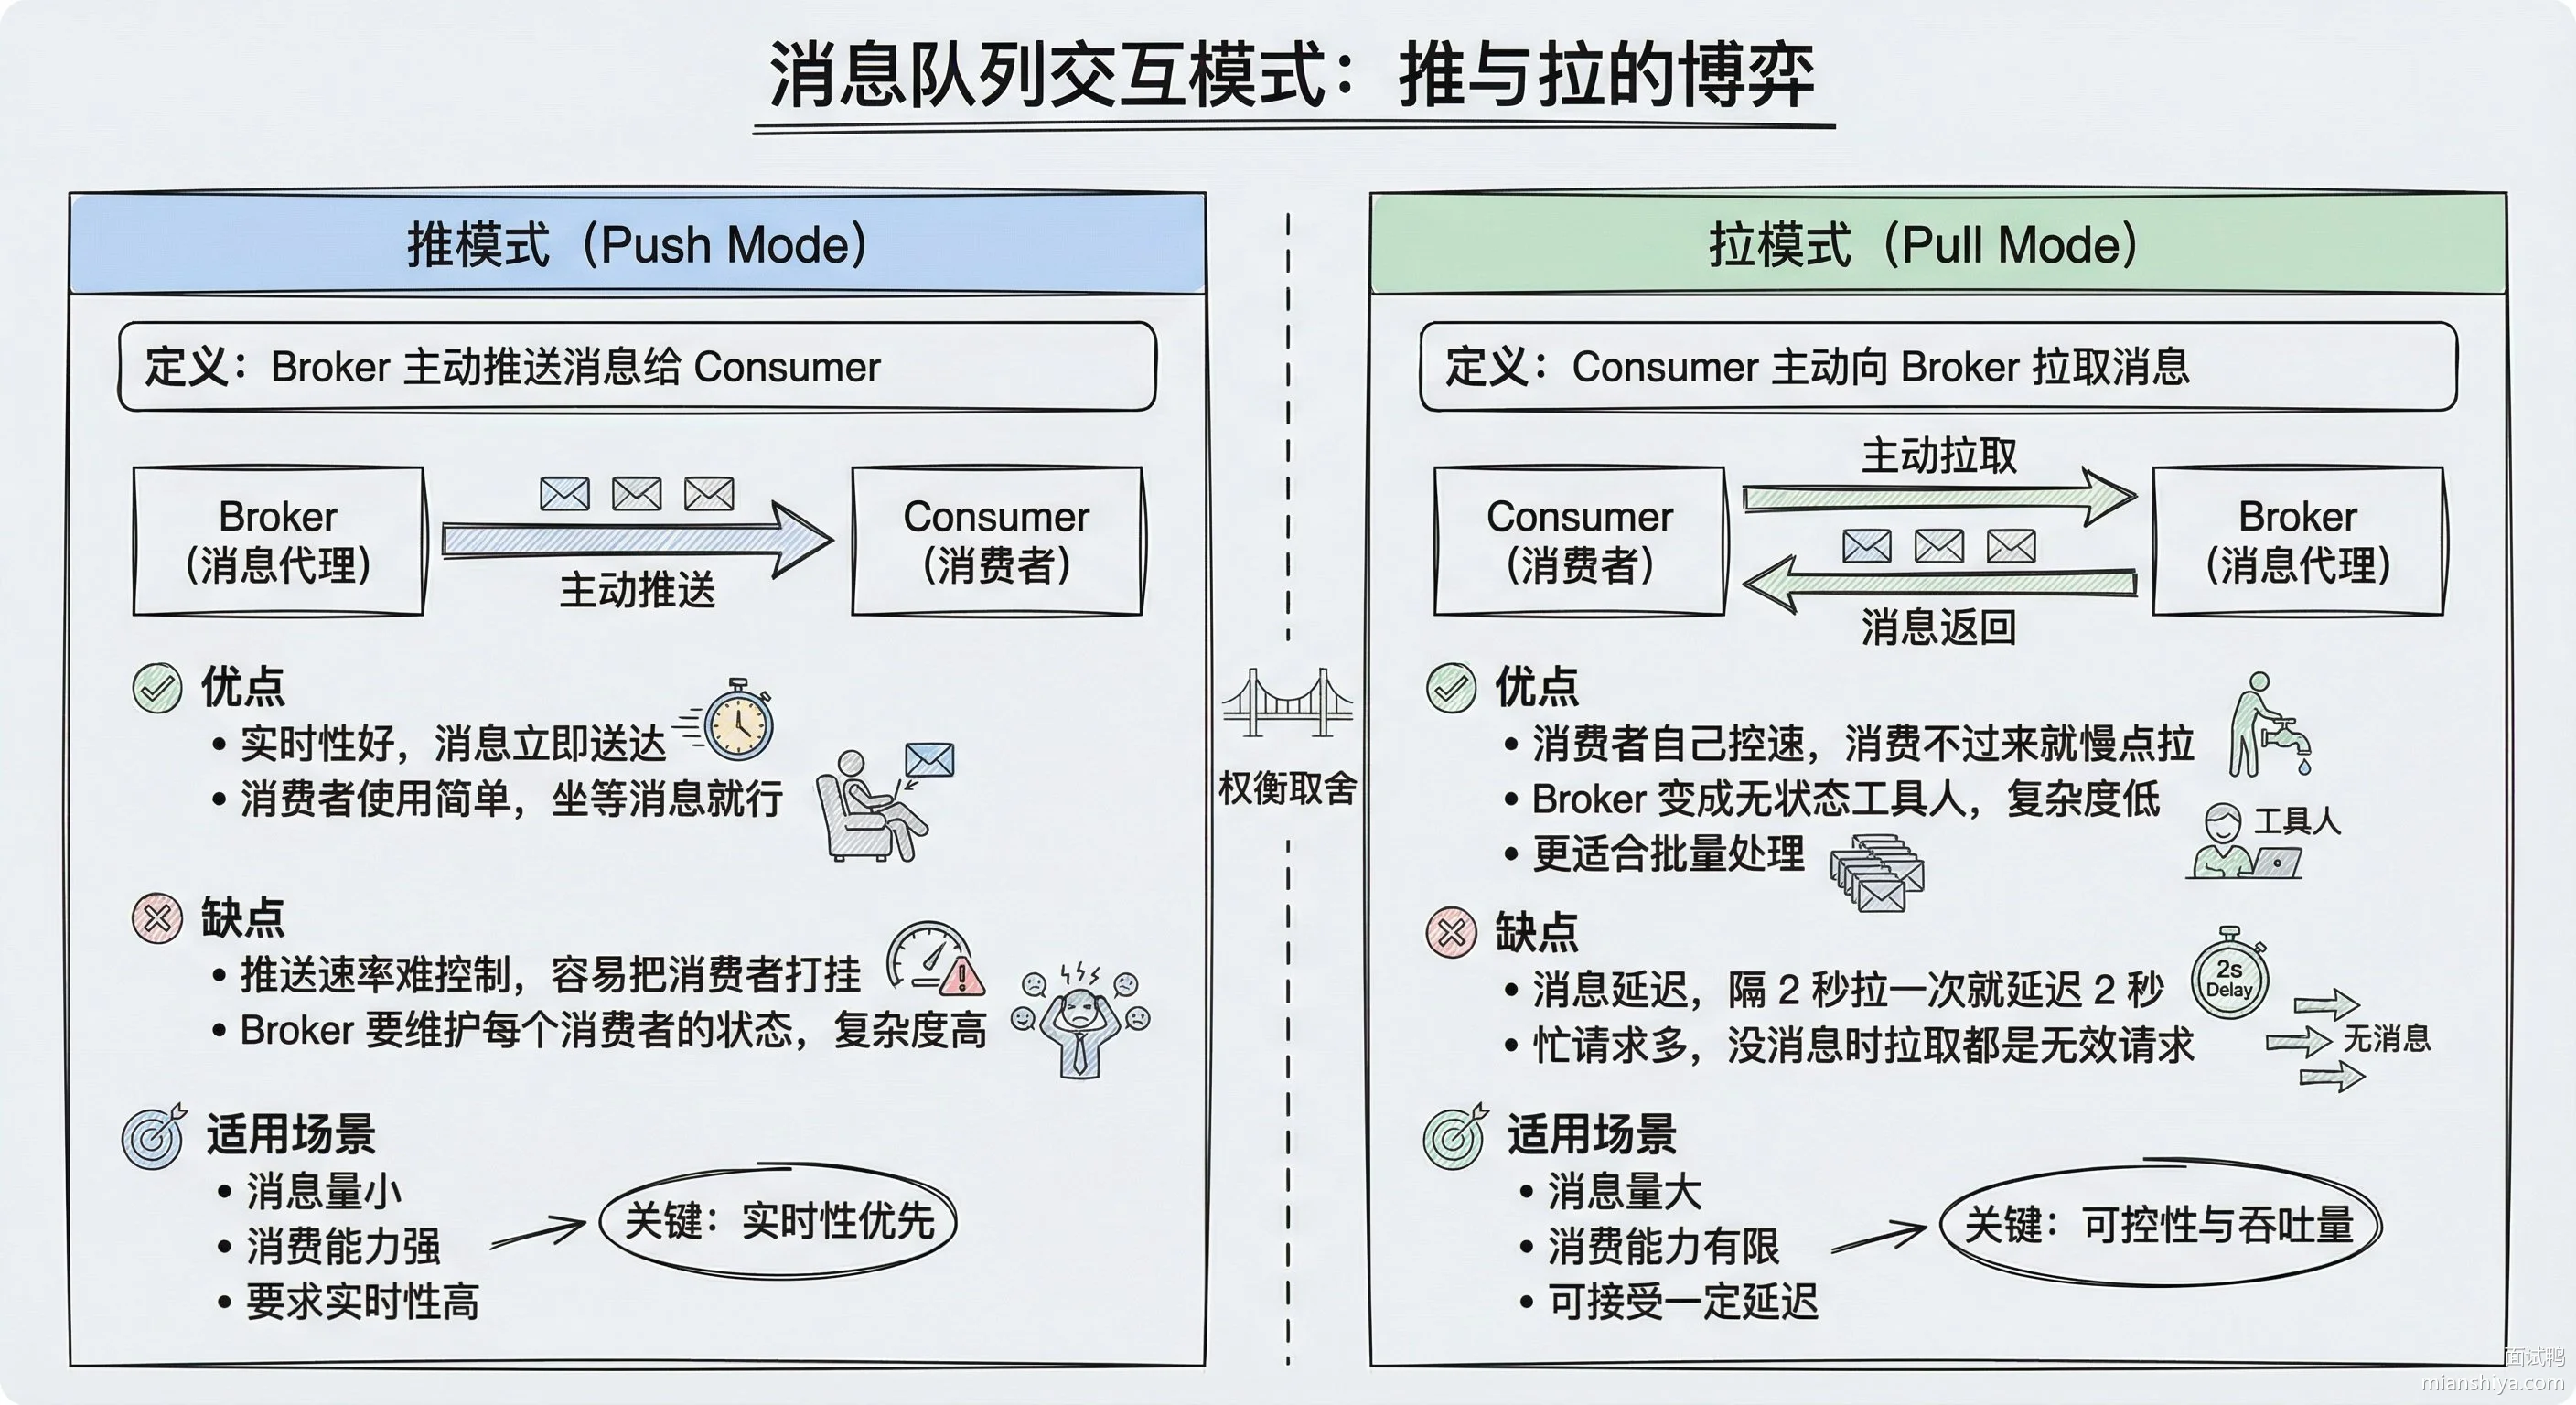
主流的消息队列像 RocketMQ、Kafka 都选择了拉模式,但不是纯粹的拉,底层用了长轮询来弥补拉模式实时性差的问题。
长轮询的做法是:消费者去拉消息时,如果有消息 Broker 立马返回,如果没有消息就 hold 住这个请求别断开连接,等消息来了再返回。这样既保证了实时性,又避免了频繁的无效请求。默认等待时间一般是 30 秒,超时后消费者再发起下一次请求。
RocketMQ 的 PushConsumer 看起来是推,其实底层还是拉,只是框架帮你封装了自动拉取的逻辑,对业务代码来说就像是推的一样。
扩展知识
推拉模式
首先明确一下推拉模式到底是在讨论消息队列的哪一个步骤,一般而言我们在谈论推拉模式的时候指的是 Comsumer 和 Broker 之间的交互。
默认的认为 Producer 与 Broker 之间就是推的方式,即 Producer 将消息推送给 Broker,而不是 Broker 主动去拉取消息。
想象一下,如果需要 Broker 去拉取消息,那么 Producer 就必须在本地通过日志的形式保存消息来等待 Broker 的拉取,如果有很多生产者的话,那么消息的可靠性不仅仅靠 Broker 自身,还需要靠成百上千的 Producer。
Broker 还能靠多副本等机制来保证消息的存储可靠,而成百上千的 Producer 可靠性就有点难办了,所以默认的 Producer 都是推消息给 Broker。
所以说有些情况分布式好,而有些时候还是集中管理好。
推模式
推模式指的是消息从 Broker 推向 Consumer,即 Consumer 被动的接收消息,由 Broker 来主导消息的发送。
推模式有什么好处:
- 消息实时性高,Broker 接受完消息之后可以立马推送给 Consumer。
- 对于消费者使用来说更简单,简单啊就等着,反正有消息来了就会推过来。
推模式有什么缺点?
推送速率难以适应消费速率,推模式的目标就是以最快的速度推送消息,当生产者往 Broker 发送消息的速率大于消费者消费消息的速率时,随着时间的增长消费者那边可能就“爆仓”了,因为根本消费不过来啊。当推送速率过快就像 DDos 攻击一样消费者就傻了。
并且不同的消费者的消费速率还不一样,身为 Broker 很难平衡每个消费者的推送速率,如果要实现自适应的推送速率那就需要在推送的时候消费者告诉 Broker ,我不行了你推慢点吧,然后 Broker 需要维护每个消费者的状态进行推送速率的变更。
这其实就增加了 Broker 自身的复杂度。
所以说推模式难以根据消费者的状态控制推送速率,适用于消息量不大、消费能力强要求实时性高的情况下。
拉模式
拉模式指的是 Consumer 主动向 Broker 请求拉取消息,即 Broker 被动的发送消息给 Consumer。
我们来想一下拉模式有什么好处?
拉模式主动权就在消费者身上了,消费者可以根据自身的情况来发起拉取消息的请求。假设当前消费者觉得自己消费不过来了,它可以根据一定的策略停止拉取,或者间隔拉取都行。
拉模式下 Broker 就相对轻松了,它只管存生产者发来的消息,至于消费的时候自然由消费者主动发起,来一个请求就给它消息呗,从哪开始拿消息,拿多少消费者都告诉它,它就是一个没有感情的工具人,消费者要是没来取也不关它的事。
拉模式可以更合适的进行消息的批量发送,基于推模式可以来一个消息就推送,也可以缓存一些消息之后再推送,但是推送的时候其实不知道消费者到底能不能一次性处理这么多消息。而拉模式就更加合理,它可以参考消费者请求的信息来决定缓存多少消息之后批量发送。
拉模式有什么缺点?
消息延迟,毕竟是消费者去拉取消息,但是消费者怎么知道消息到了呢?所以它只能不断地拉取,但是又不能很频繁地请求,太频繁了就变成消费者在攻击 Broker 了。因此需要降低请求的频率,比如隔个2 秒请求一次,你看着消息就很有可能延迟 2 秒了。
消息忙请求,忙请求就是比如消息隔了几个小时才有,那么在几个小时之内消费者的请求都是无效的,在做无用功。
到底是推还是拉
可以看到推模式和拉模式各有优缺点,到底该如何选择呢?
RocketMQ 和 Kafka 都选择了拉模式,当然业界也有基于推模式的消息队列如 ActiveMQ。
我个人觉得拉模式更加的合适,因为现在的消息队列都有持久化消息的需求,也就是说本身它就有个存储功能,它的使命就是接受消息,保存好消息使得消费者可以消费消息即可。
而消费者各种各样,身为 Broker 不应该有依赖于消费者的倾向,我已经为你保存好消息了,你要就来拿好了。
虽说一般而言 Broker 不会成为瓶颈,因为消费端有业务消耗比较慢,但是 Broker 毕竟是一个中心点,能轻量就尽量轻量。
那么竟然 RocketMQ 和 Kafka 都选择了拉模式,它们就不怕拉模式的缺点么? 怕,所以它们操作了一波,减轻了拉模式的缺点。
即
长轮询
RocketMQ 和 Kafka 都是利用“长轮询”来实现拉模式。所谓的“长轮询”具体的做法都是通过消费者去 Broker 拉取消息时,当有消息的情况下 Broker 会直接返回消息,如果没有消息都会采取延迟处理的策略,即保持连接,暂时 hold 主请求,然后在对应队列或者分区有新消息到来的时候都会提醒消息来了,通过之前 hold 主的请求及时返回消息,保证消息的及时性。
一句话说就是消费者和 Broker 相互配合,拉取消息请求不满足条件的时候 hold 住请求,避免了多次频繁的拉取动作,当消息一到就返回消息。
扩展阅读:RocketMQ 中的长轮询
RocketMQ 中的 PushConsumer 其实是披着拉模式的方法,只是看起来像推模式而已。
因为 RocketMQ 在被背后偷偷的帮我们去 Broker 请求数据了。
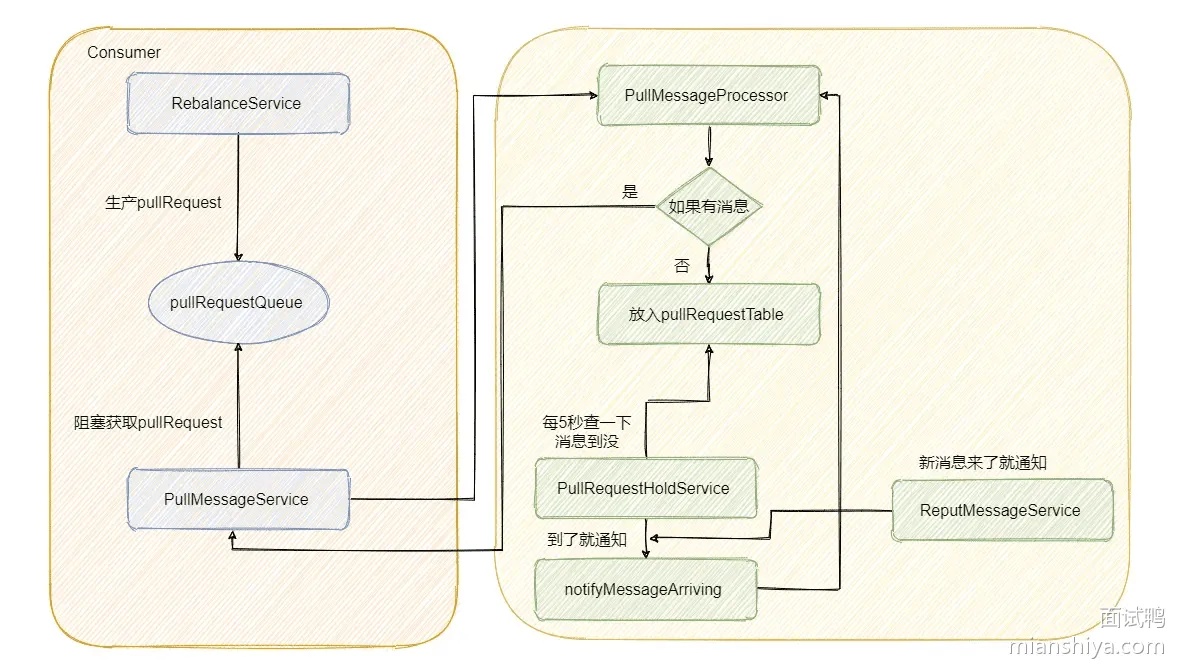
后台会有个 RebalanceService 线程,这个线程会根据 topic 的队列数量和当前消费组的消费者个数做负载均衡,每个队列产生的 pullRequest 放入阻塞队列 pullRequestQueue 中。然后又有个 PullMessageService 线程不断的从阻塞队列 pullRequestQueue 中获取 pullRequest,然后通过网络请求 broker,这样实现的准实时拉取消息。
这一部分代码我不截了,就是这么个事儿,稍后会用图来展示。
然后 Broker 的 PullMessageProcessor 里面的 processRequest 方法是用来处理拉消息请求的,有消息就直接返回,如果没有消息怎么办呢?我们来看一下代码。
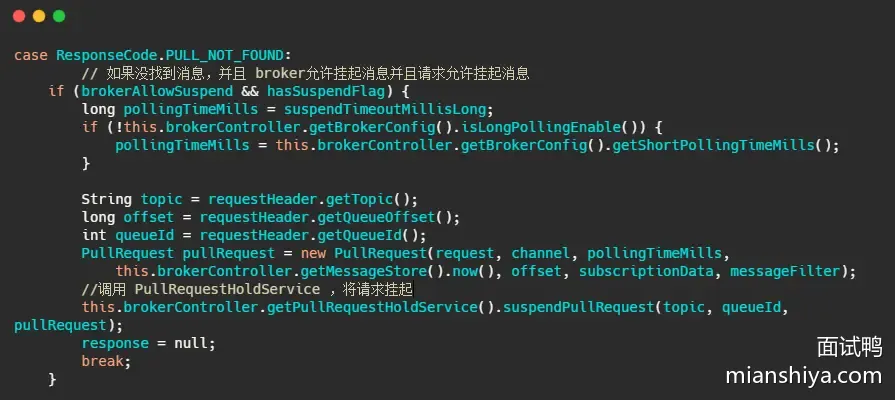
我们再来看下 suspendPullRequest 方法做了什么。
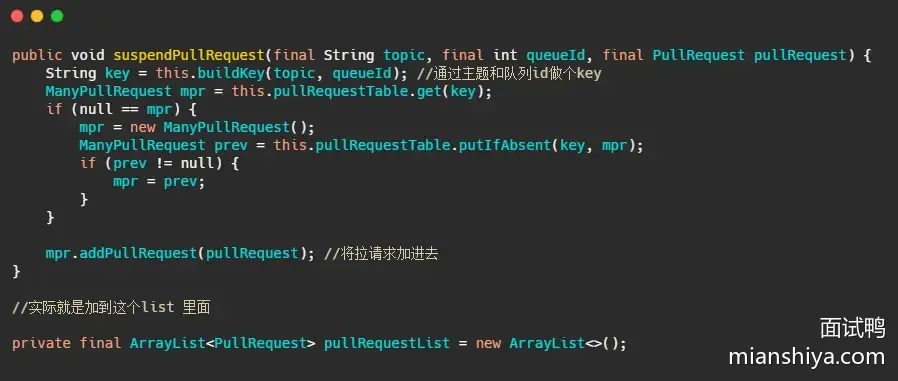
而 PullRequestHoldService 这个线程会每 5 秒从 pullRequestTable 取PullRequest请求,然后看看待拉取消息请求的偏移量是否小于当前消费队列最大偏移量,如果条件成立则说明有新消息了,则会调用 notifyMessageArriving ,最终调用 PullMessageProcessor 的 executeRequestWhenWakeup() 方法重新尝试处理这个消息的请求,也就是再来一次,整个长轮询的时间默认 30 秒。
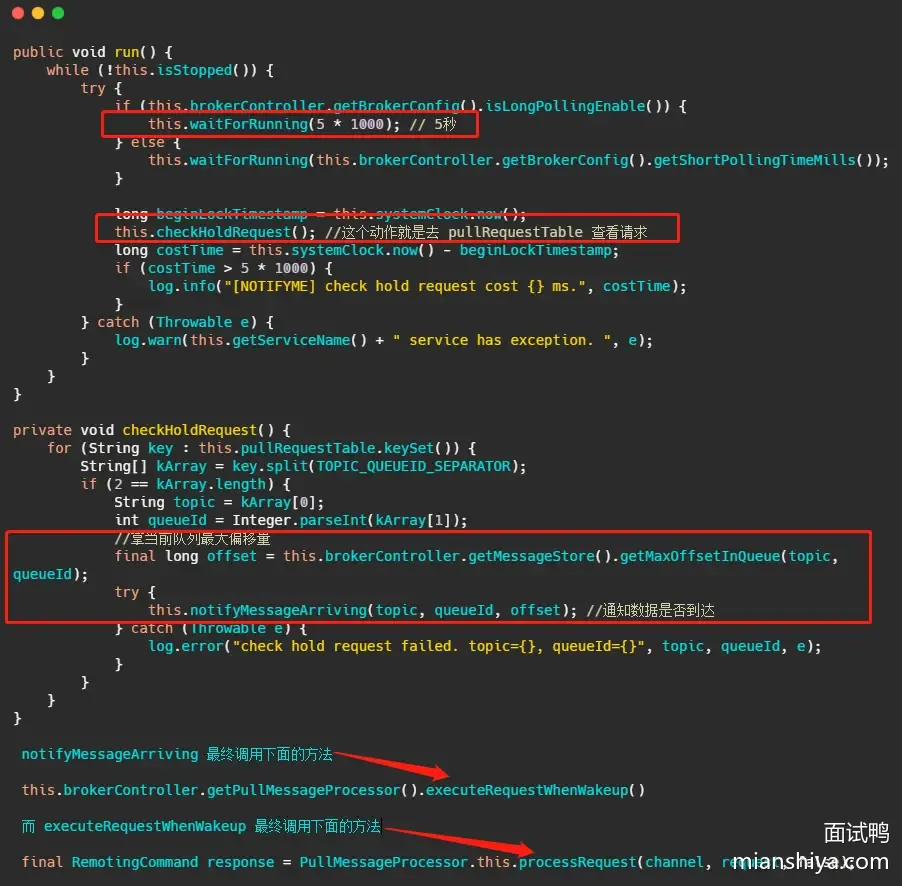
简单的说就是 5 秒会检查一次消息时候到了,如果到了则调用 processRequest 再处理一次。这好像不太实时啊? 5秒?
别急,还有个 ReputMessageService 线程,这个线程用来不断地从 commitLog 中解析数据并分发请求,构建出 ConsumeQueue 和 IndexFile 两种类型的数据,并且也会有唤醒请求的操作,来弥补每 5s 一次这么慢的延迟
代码我就不截了,就是消息写入并且会调用 pullRequestHoldService#notifyMessageArriving。
最后我再来画个图,描述一下整个流程。
扩展阅读:Kafka 中的长轮询
像 Kafka 在拉请求中有参数,可以使得消费者请求在 “长轮询” 中阻塞等待。
简单的说就是消费者去 Broker 拉消息,定义了一个超时时间,也就是说消费者去请求消息,如果有的话马上返回消息,如果没有的话消费者等着直到超时,然后再次发起拉消息请求。
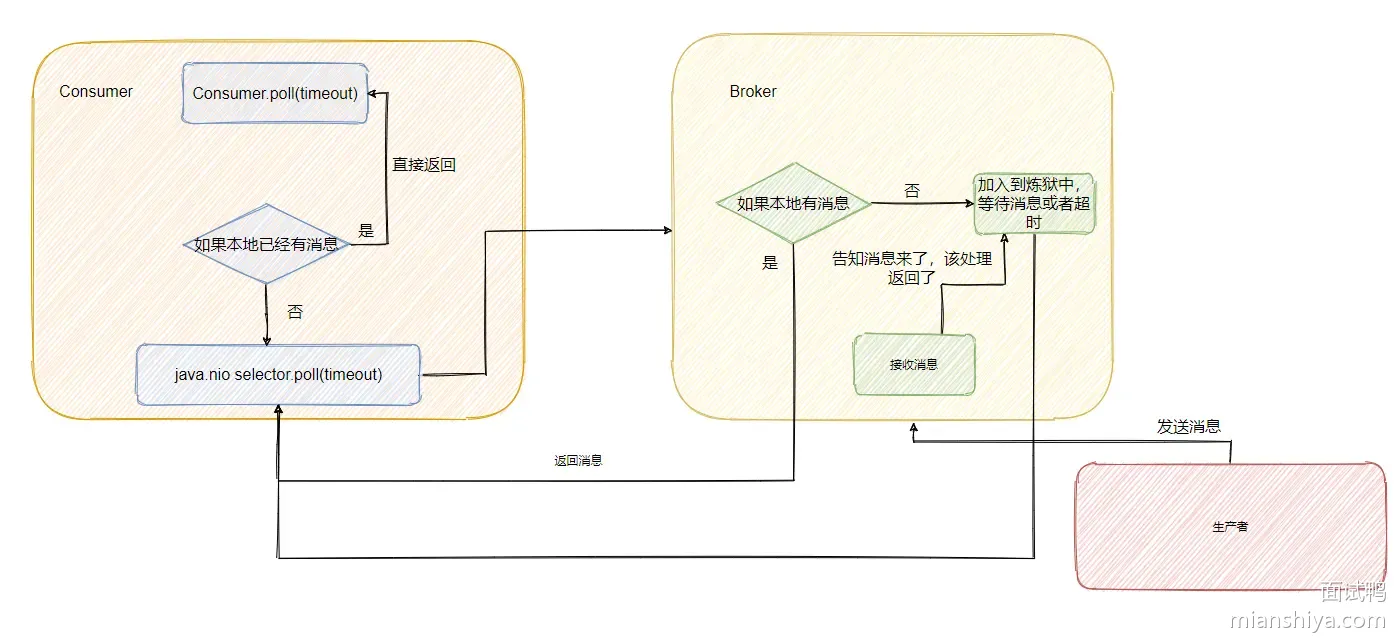
并且 Broker 也得配合,如果消费者请求过来,有消息肯定马上返回,没有消息那就建立一个延迟操作,等条件满足了再返回。
我们来简单的看一下源码,为了突出重点,我会删减一些代码。
先来看消费者端的代码。
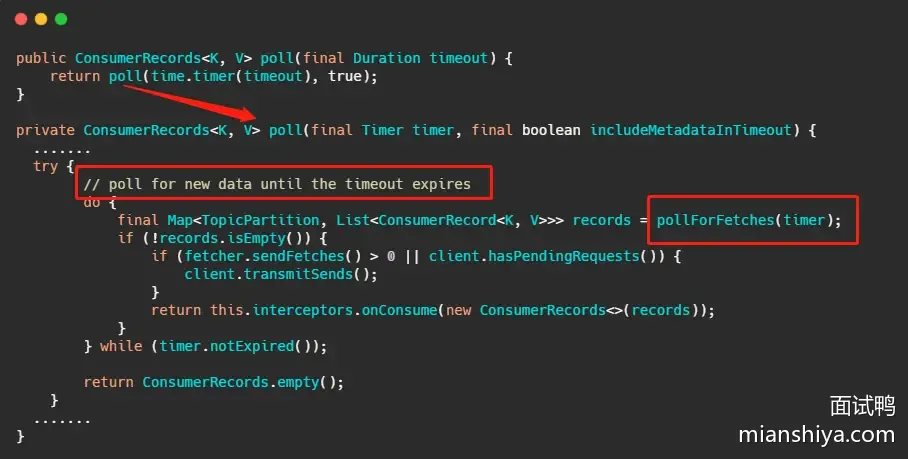
上面那个 poll 接口想必大家都很熟悉,其实从注解直接就知道了确实是等待数据的到来或者超时,我们再简单的往下看。
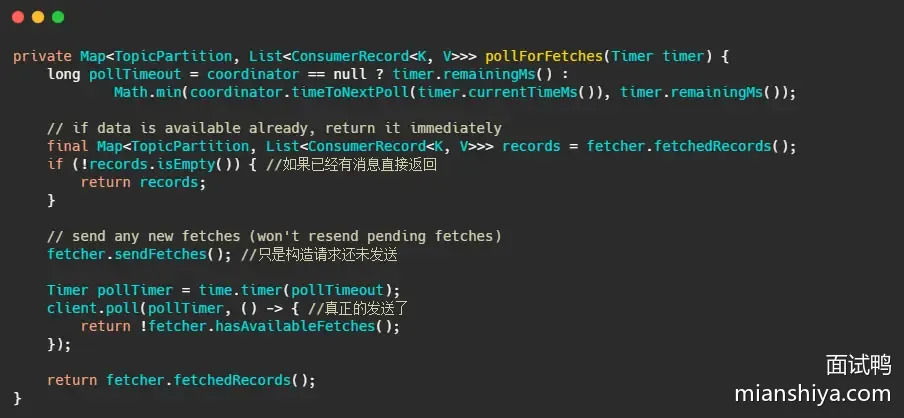
我们再来看下最终 client.poll 调用的是什么。
最后调用的就是 Kafka 包装过的 selector,而最终会调用 Java nio 的 select(timeout)。
现在消费者端的代码已经清晰了,我们再来看看 Broker 如何做的。
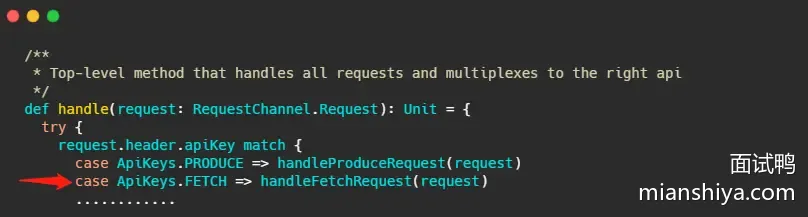
Broker 处理所有请求的入口其实我在之前的文章介绍过,就在 KafkaApis.scala 文件的 handle 方法下,这次的主角就是 handleFetchRequest 。
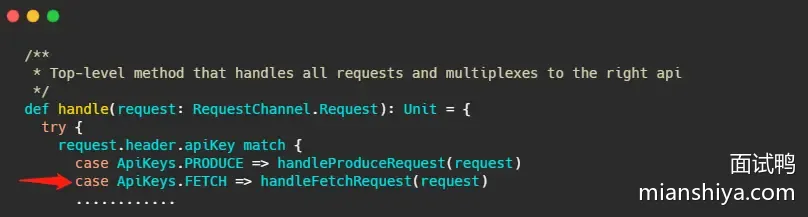
这个方法进来,我截取最重要的部分。
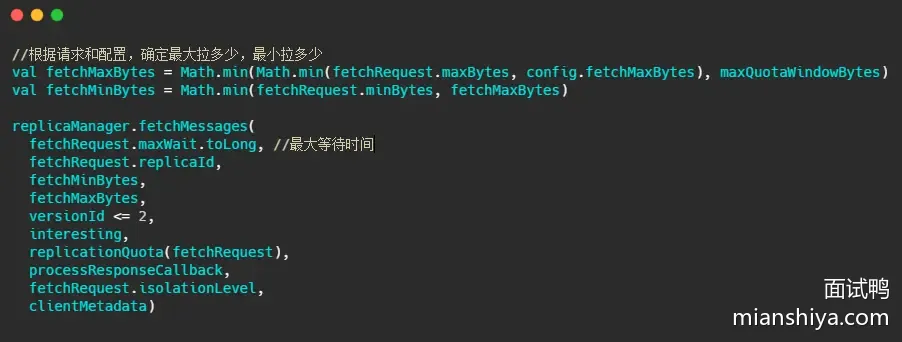
下面的图片就是 fetchMessages 方法内部实现,源码给的注释已经很清晰了,大家放大图片看下即可。
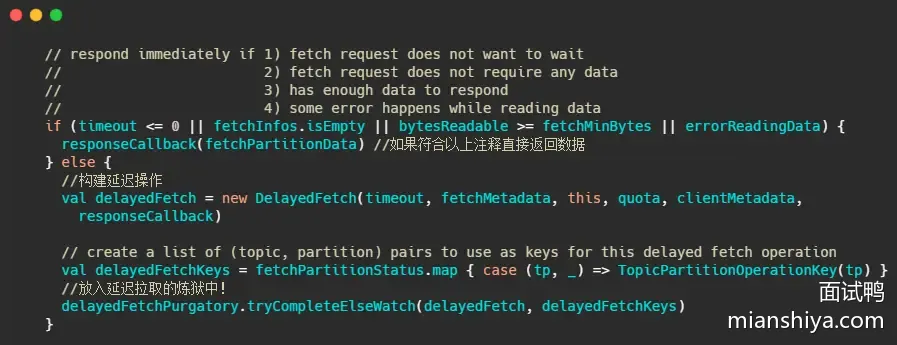
这个炼狱名字取得很有趣,简单的说就是利用我之前文章提到的时间轮,来执行定时任务,例如这里是delayedFetchPurgatory,专门用来处理延迟拉取操作。
我们先简单想一下,这个延迟操作都需要实现哪些方法,首先构建的延迟操作需要有检查机制,来查看消息是否已经到了,然后呢还得有个消息到了之后该执行的方法,还需要有执行完毕之后该干啥的方法,当然还得有个超时之后得干啥的方法。
这几个方法其实对应的就是代码里的 DelayedFetch ,这个类继承了 DelayedOperation 内部有:
- isCompleted 检查条件是否满足的方法
- tryComplete 条件满足之后执行的方法
- onComplete 执行完毕之后调用的方法
- onExpiration 过期之后需要执行的方法
判断是否过期就是由时间轮来推动判断的,但是总不能等过期的时候再去看消息到了没吧?
这里 Kafka 和 RocketMQ 的机制一样,也会在消息写入的时候提醒这些延迟请求消息来了,具体代码我不贴了, 在 ReplicaManager#appendRecords 方法内部再深入个两方法可以看到。
不过虽说代码不贴,图还是要画一下的。
常见问题
如果用的是拉模式,消费者挂了一段时间再重启,会不会丢消息?
回答:不会丢。拉模式下消息都存在 Broker 里,消费者会维护自己的消费位移,记录消费到哪了。重启后从上次的位移继续拉就行,只要消息还没过期或被删除,就能拉到。这也是拉模式的一个好处,消费者的状态和 Broker 解耦了。
长轮询的请求一直 hold 住不会有问题吗?比如 Broker 挂了怎么办?
回答:会有问题,所以一般都设置了超时时间,RocketMQ 默认 30 秒,Kafka 可以自己配置。超时后连接会断开,消费者重新发起请求。如果 Broker 挂了,消费者会感知到连接断开,然后去连其他的 Broker 节点。所以 Broker 要做集群部署,一个节点挂了还有其他节点顶上。
为什么 Kafka 和 RocketMQ 都选择拉模式,推模式真的不行吗?
回答:不是不行,是拉模式更适合消息队列这种场景。消息队列本身就有持久化需求,它的使命就是接收消息、保存消息,让消费者可以消费。消费者各种各样,有快有慢,Broker 不应该依赖消费者的状态,我已经帮你存好消息了,你要就来拿。推模式把 Broker 搞复杂了,要维护每个消费者的状态和推送速率,吃力不讨好。
长轮询和 WebSocket 有什么区别?
回答:长轮询还是基于 HTTP 请求的,只是服务端收到请求后不立即响应,而是等有数据了再响应。响应完成后连接就断了,客户端要再发一个新请求。WebSocket 是在 HTTP 握手后升级成独立的协议,建立一个长连接,服务端可以主动推消息给客户端,不需要客户端反复发请求。WebSocket 更适合实时聊天、推送这种场景,长轮询更适合消息队列这种拉取场景。
740. 让你设计一个短链系统,怎么设计?
核心要点
先说一下回答思路:1)简单描述下短链原理 2)后端设计 3)补充跳转设计 一个小小短链其实融合了很多知识点,能较为全面的考察一个候选人的综合实力。
原理:
短链系统核心就三件事:生成短链、存储映射关系、重定向跳转。
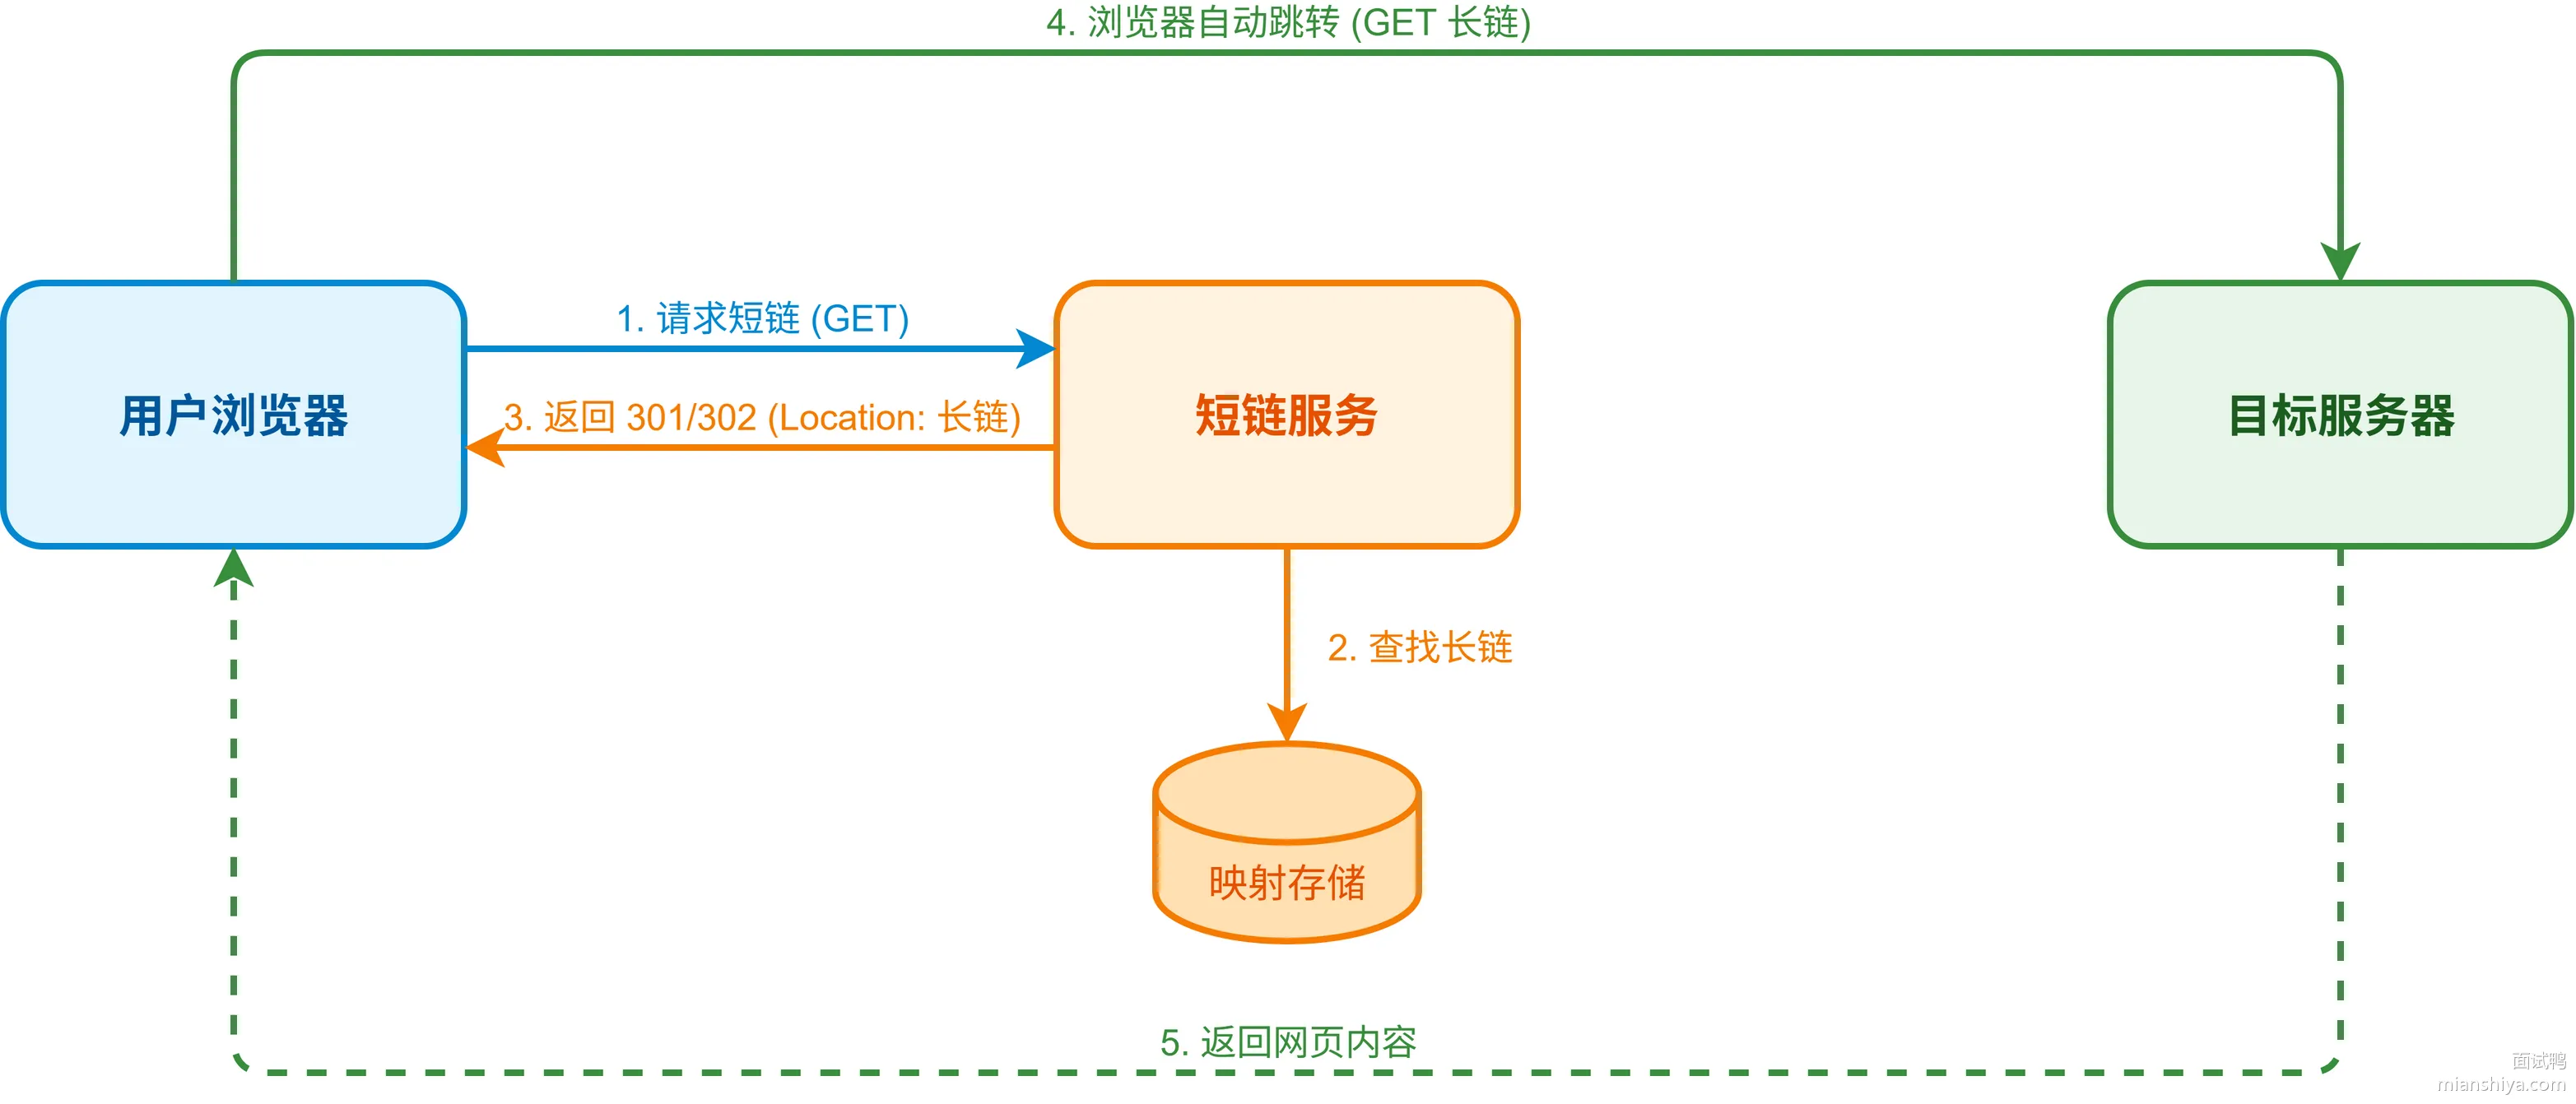
用户在浏览器输入短链后,请求打到短链服务,短链服务根据 URL 找到对应的长链,返回重定向响应,浏览器自动跳转到真正的地址。
后端设计:
后端的主要功能是存储短链和长链的对应关系,并且能快速通过短链找到长链。
首先需要先生成短链,假设短链的域名是 dl.x
常见有两种方案:
1)可以通过数据库自增 id 作为短链,往数据库插入一条长链,对应就会得到一个 id
| id | url |
|---|---|
| 1 | https://www.code-nav.cn/course/1790274408835506178 |
| 2 | https://www.code-nav.cn/course/1789189862986850306 |
如果用户访问了 dl.x/1 ,解析得到 1,通过主键就能定位到数据库记录,得到长链 https://www.code-nav.cn/course/1790274408835506178 。
这个方式很简单,通过主键查询也很快。
如果对方问这样的方式有什么缺点,你再说:一旦短链量变多,自增 id 会变成很大,比如 9999999999999999,这样短链也不短了,而且数字有规律性,容易被人遍历出来。
没问就不用说。
2)哈希算法
可以通过 hash 算法将长链进行 hash 计算,得到固定的长度,比如通过 md5 计算可以得到固定的 128bit 数据,还有别的哈希函数,比如 MurMurHash,它既可以生成 128 bit 也可以生成 32bit,不过 32 bit 相比 128 bit 生成速度更慢,且 hash 碰撞的概率更高。
这里再提一嘴 MurMurHash 128bit 版本的速度是 md5 的十倍。
还有 crc32 ,得到的就是 32 位的哈希值,运算速度和 md5 差不多。
因此我们可以将长链通过 hash 得到固定的位数,我找了个网上的 MurmurHash2 例子,我们来看下
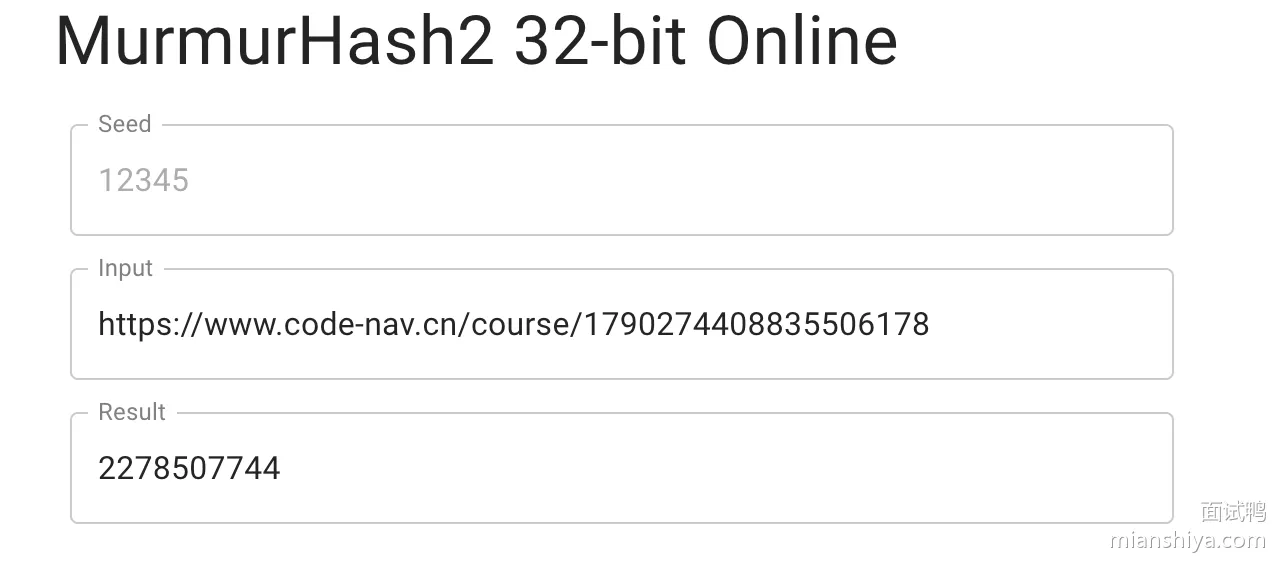
可以看到这么长的一个 url,直接变成了 2278507744,因此短链就是 dl.x/2278507744
但是这好像比我们平时在短信中看到的短链还长了一些,还能再缩短吗?
当然是可以的,还可以利用进制转化进一步缩短长度!
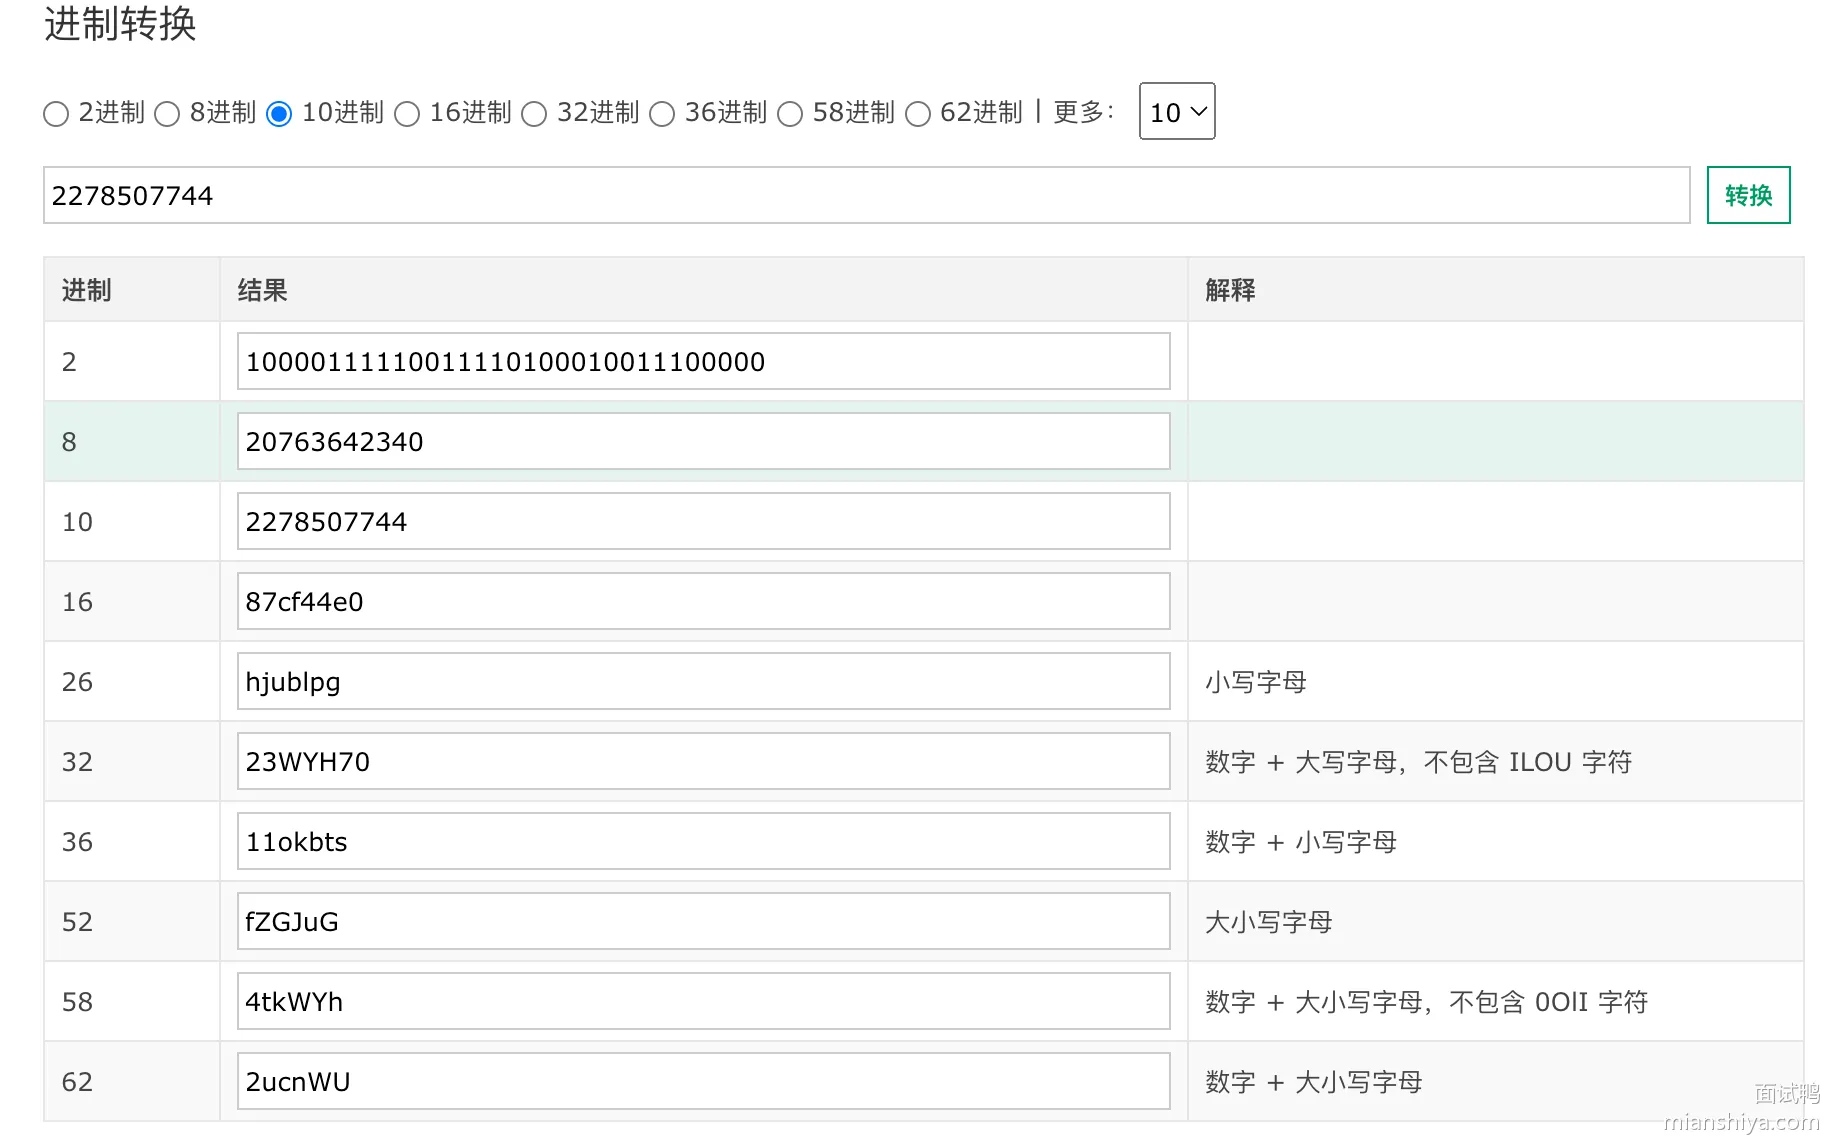
比如我们取 62 位的,最终的短链就是 dl.x/2ucnWU,这样看着是不是感觉就对了?同理上面的自增 id 也可以通过进制转化进一步缩短。
最终的数据库表结构的设计如下:
字段:
- id:主键
- short_url:短链
- long_url:原始长 URL
- user_id:用户 ID(如果需要关联用户)
- created_at:创建时间
- updated_at:更新时间
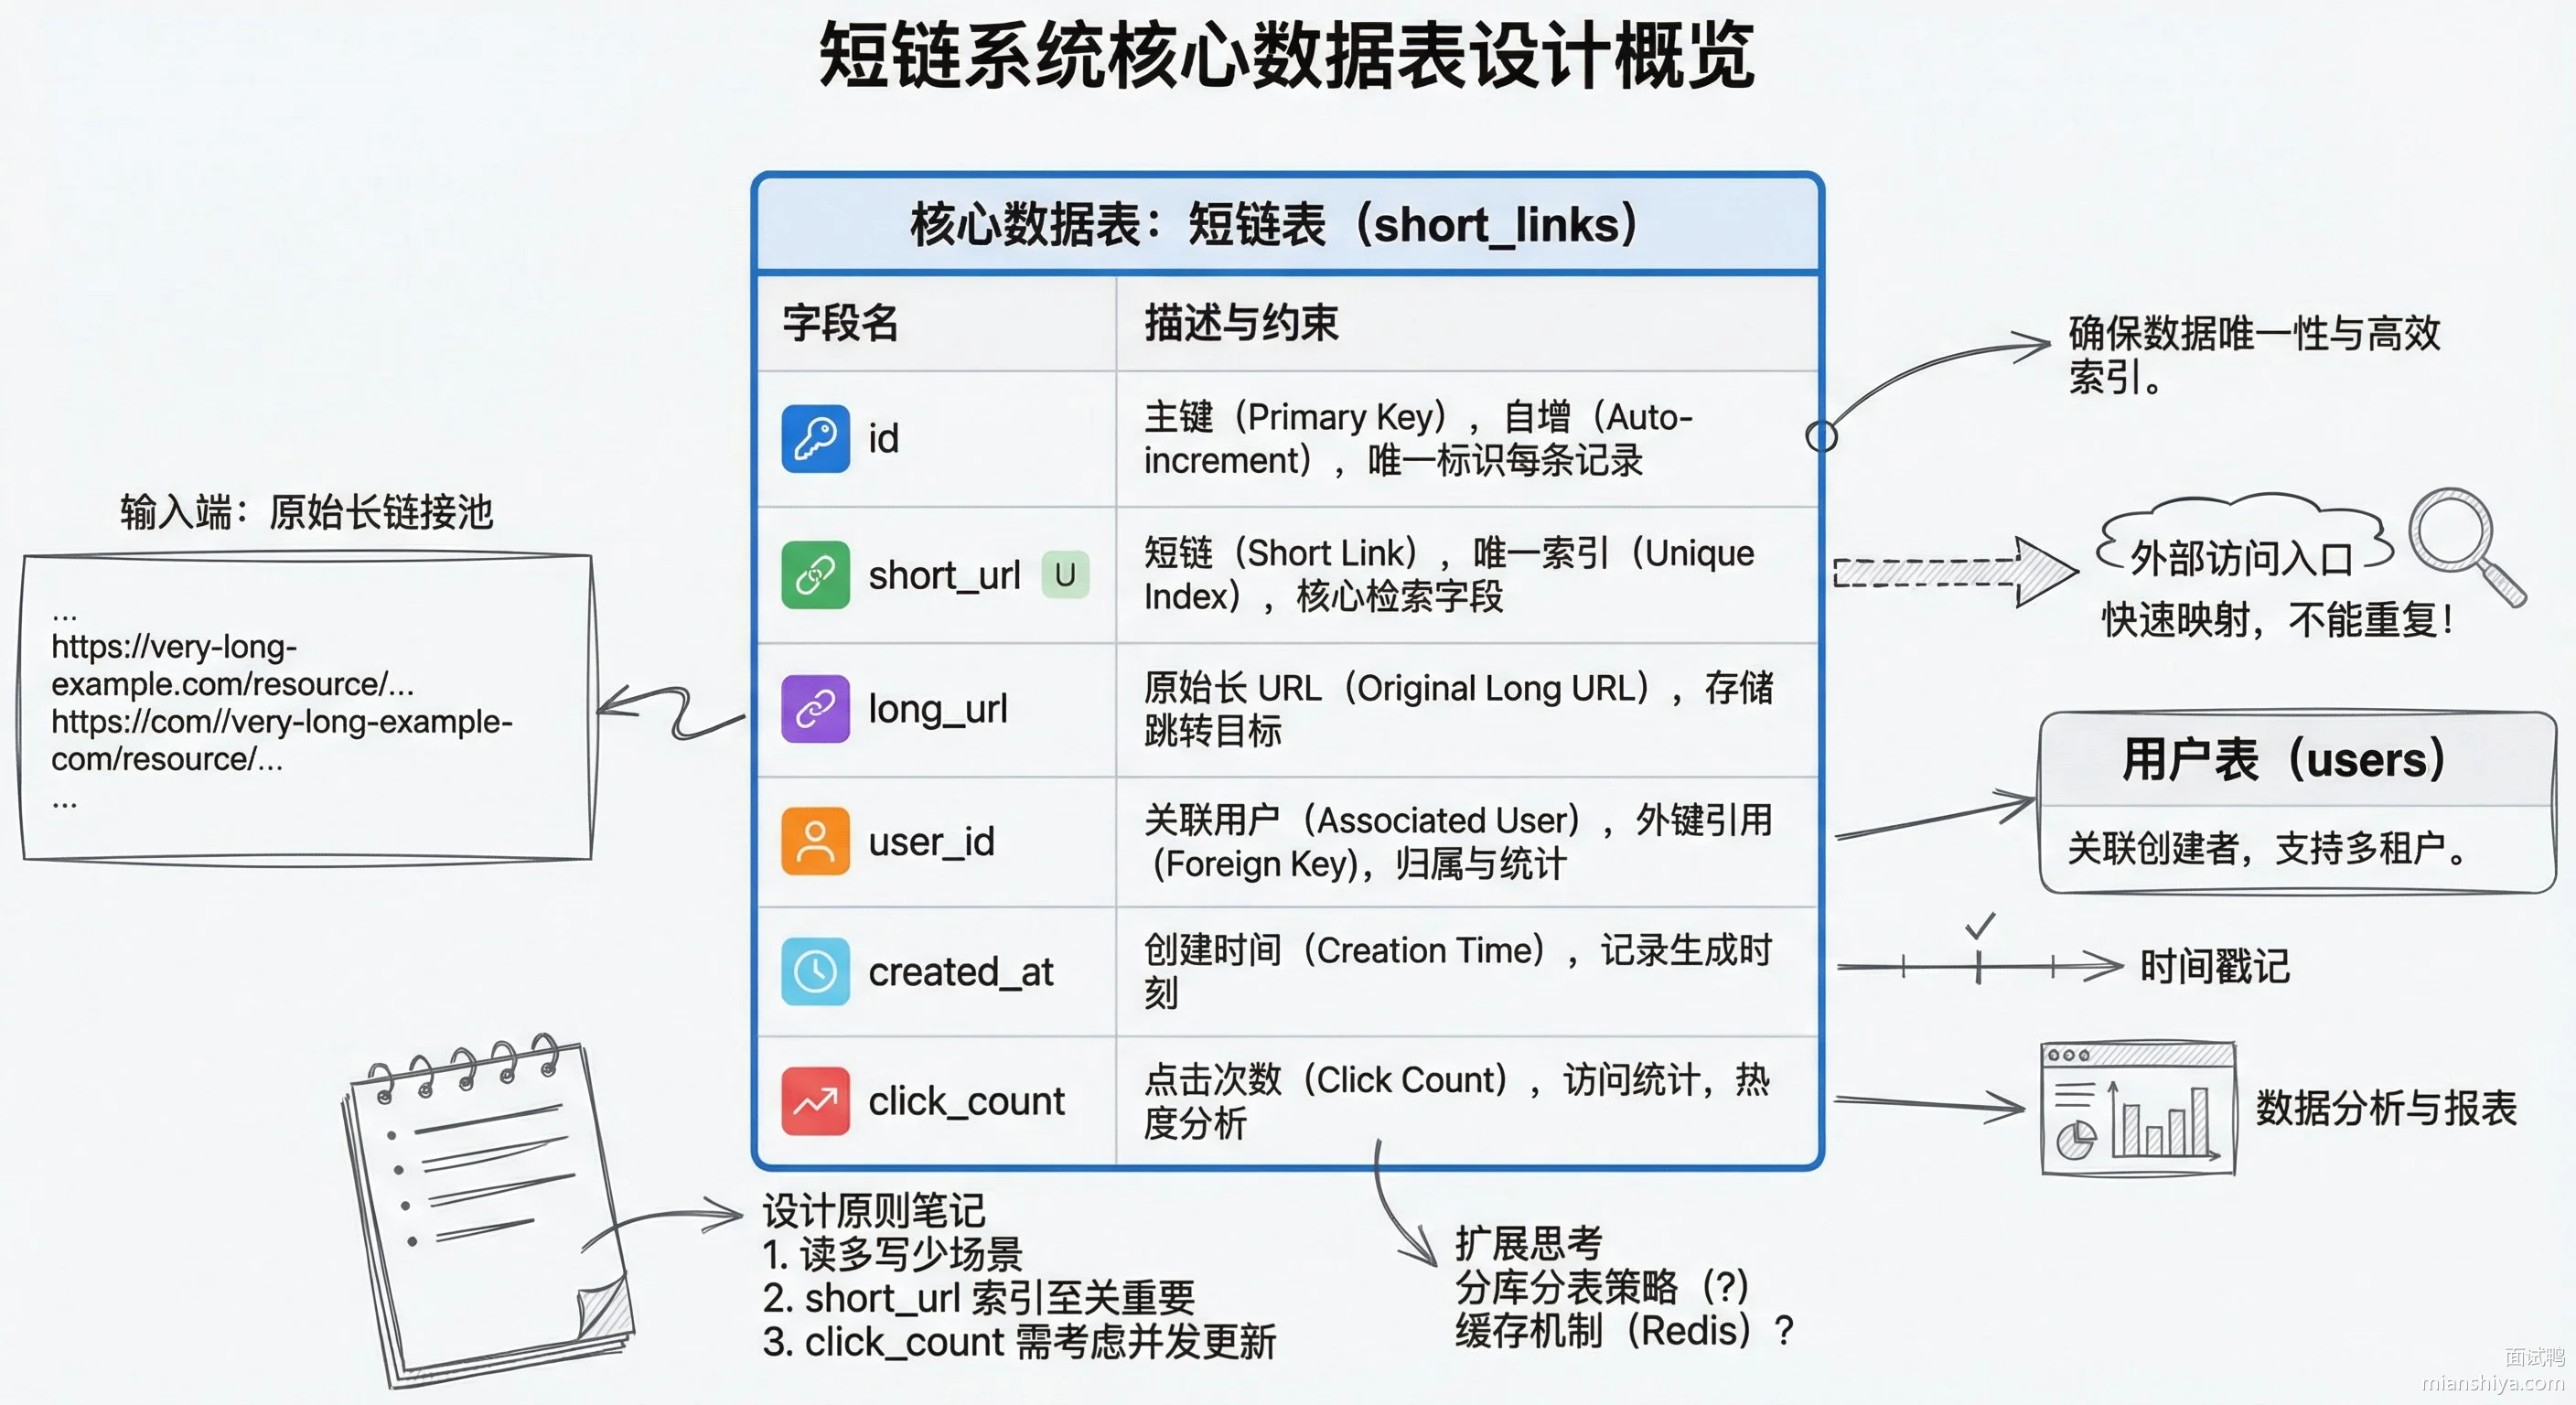
short_url 字段必须建索引,因为最常见的查询就是根据短链找长链。如果用哈希方案,还得建唯一索引防止哈希冲突导致的重复。
跳转设计:
我们已经了解到通过短链得到长链的过程,那么浏览器具体是如何在输入短链后自动跳到长链地址的呢?
答案就是重定向。这里就需要涉及到 HTTP 的知识点,服务器返回 301 或者 302 状态码,然后在 location 上写上长链的地址,浏览器就会自动识别动作,进行跳转。
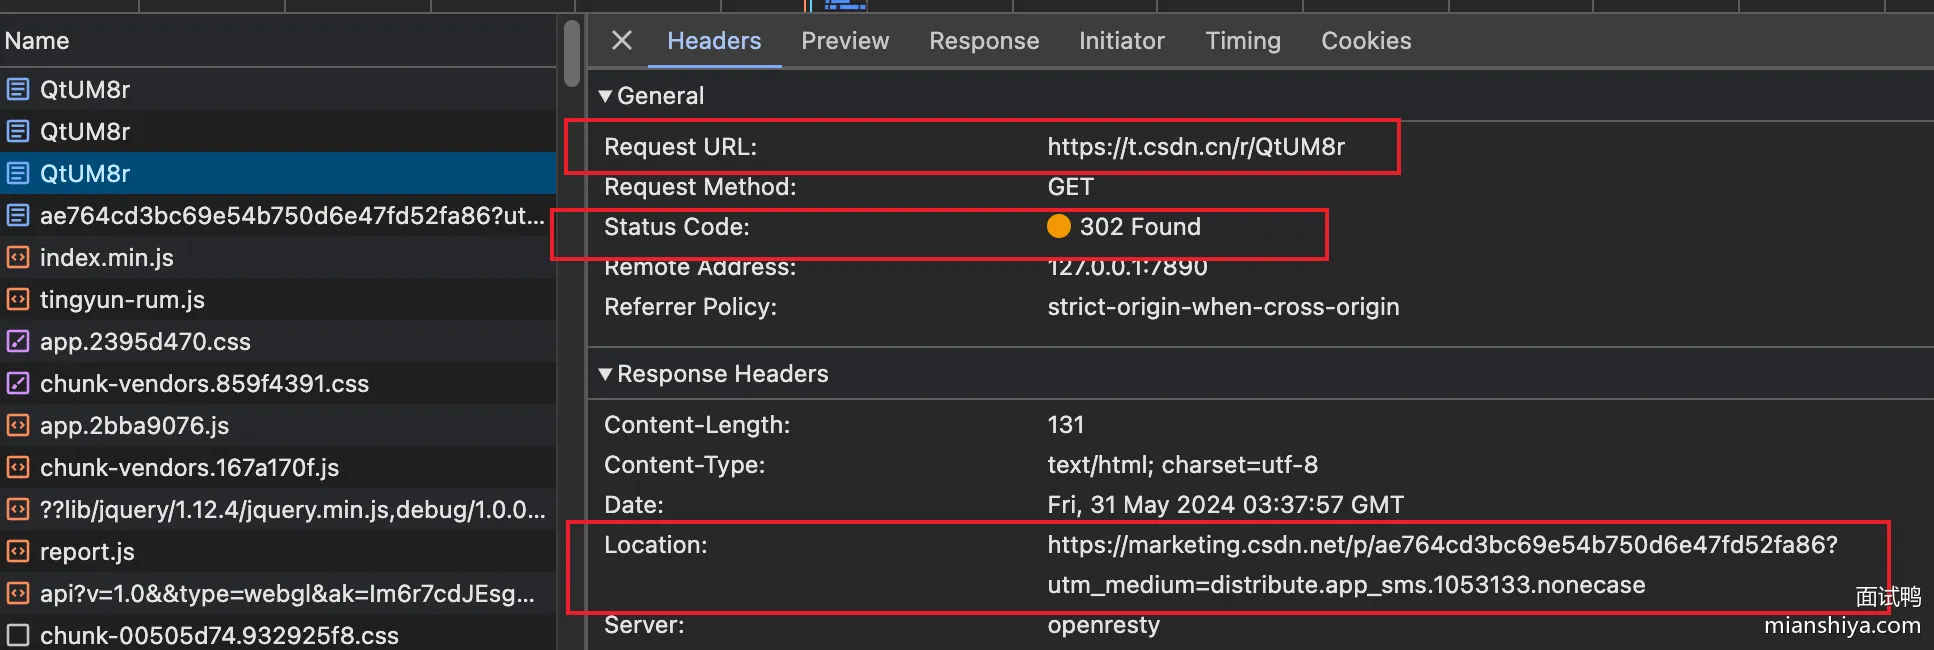
这两个状态码还是有区别的:
1)301 表示永久重定向,即浏览器会默认缓存这次跳转的信息,下次用户在浏览器访问这个短链,浏览器不需要请求短链服务,会自动跳转到长链地址。
2)302 表示临时重定向,即浏览器不会缓存这次跳转信息,用户每次访问这个短链,都需要请求短链服务得到长链。
区别就是 301 可以降低短链服务器压力,因为后续用户访问都不需要请求短链后端服务,而 302 则需要每次访问,但是这样一来可以统计短链访问次数,做一些分析。
扩展知识
为什么需要短链
短链主要用在短信场景,短信按字数收费,超过一定字数费用翻倍,长 URL 直接塞进去不划算。
社交媒体平台对字数也有限制,一个长 URL 占掉大半篇幅。二维码场景也需要短链,URL 太长生成的码密密麻麻,扫码识别率下降。
哈希冲突怎么处理
哈希算法有碰撞概率,不同的长链可能算出一样的短链。解决方案是把 short_url 设为唯一索引,插入时如果报唯一键冲突,就在长链后面拼个随机数重新哈希,直到不冲突为止。MurmurHash 32bit,32位哈希空间是2^32,根据生日悖论,当数据量达到约 2^16(65536)条时,碰撞概率约为50%。所以数据量大了碰撞不可避免。
分库分表方案
数据量到千万级单表就撑不住了,需要分库分表。如果用自增 ID 方案,分表后各表的自增 ID 会重复,得引入全局发号器,比如雪花算法生成全局唯一 ID。
分表键用短链,因为查询都是根据短链来的。分 16 张表的话,对短链做 hash 取模路由到对应的表。写入时先拿全局 ID,转成短链,根据短链路由到对应表插入。
分库分表架构:
- 客户端请求创建短链
- 短链服务从发号器获取全局唯一 ID
- ID 转换成 62 进制短链
- 根据短链 hash 取模路由到对应分表
- 写入分表
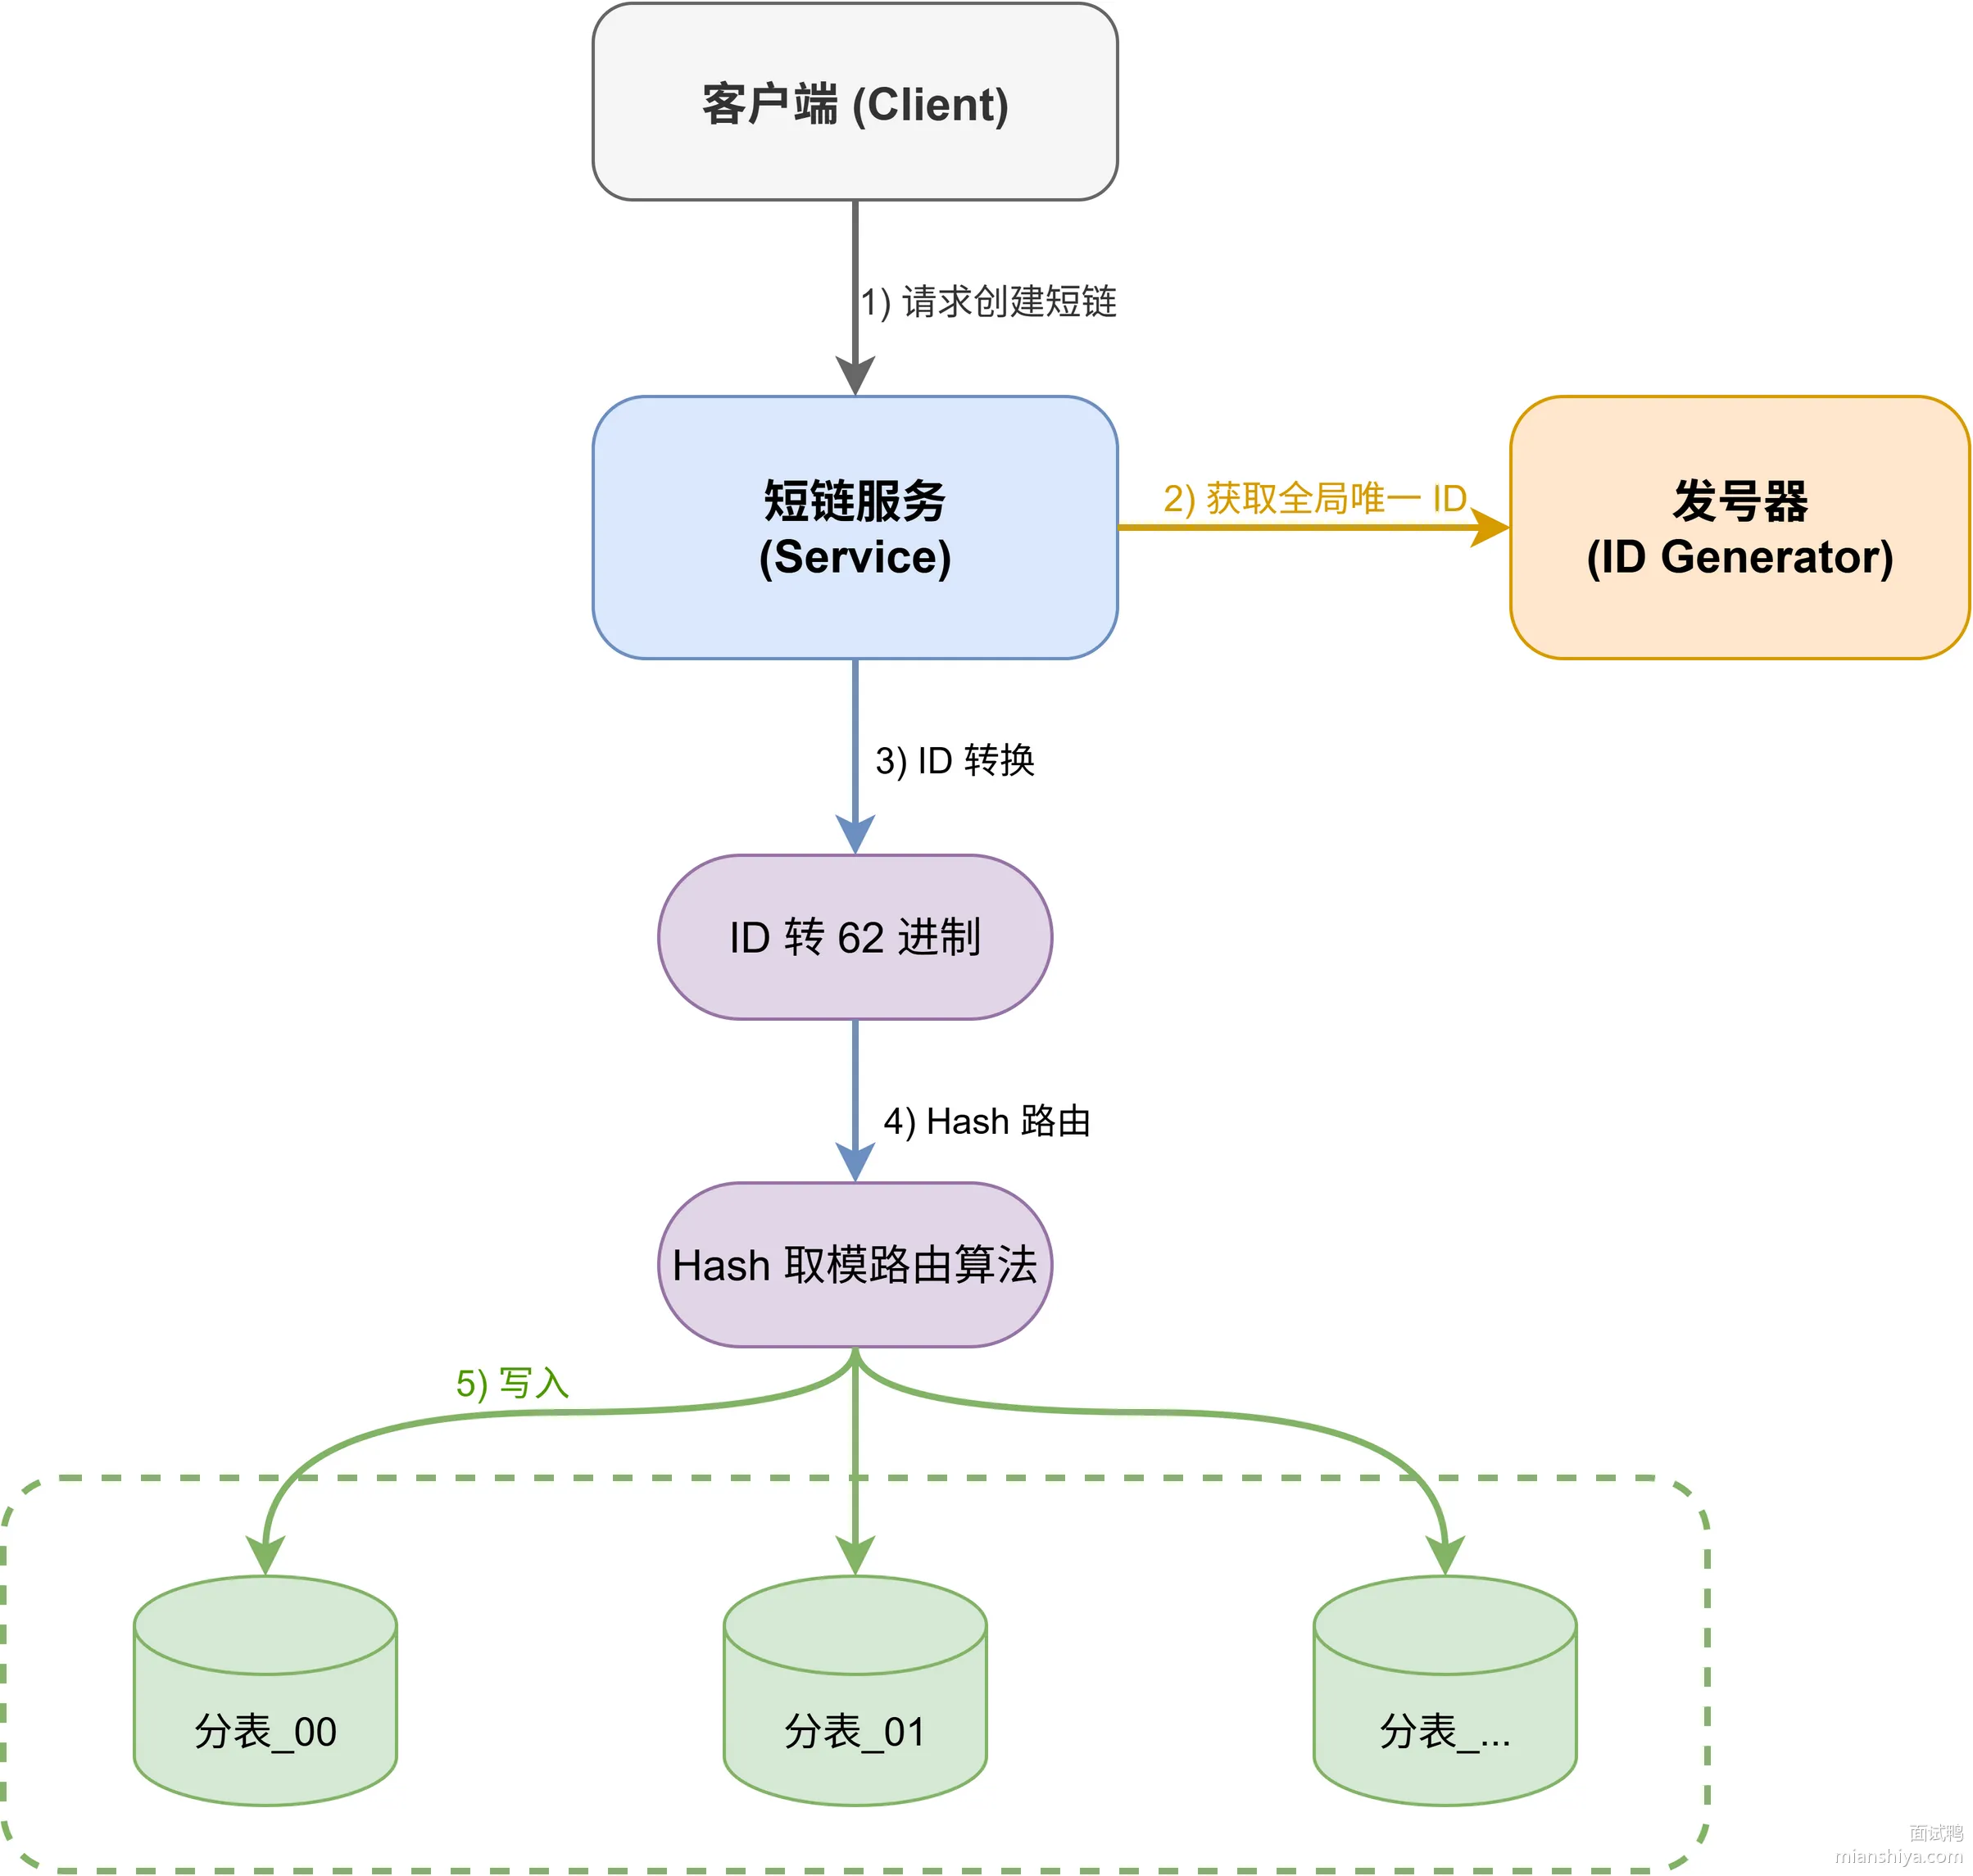
缓存优化
热点短链直接缓存到 Redis,比如双十一给几百万用户推短信,这个短链肯定是热点,全放数据库扛不住。缓存策略可以用旁路缓存,先查 Redis,没有再查数据库然后回写 Redis。过期时间根据活动周期设,活动结束就让它自然过期。
还有一个细节,短链一旦创建就不会变,天然适合缓存,不用担心缓存一致性问题。
安全考虑
自增 ID 方案有个问题,短链是连续的,别人可以遍历 dl.x/1、dl.x/2、dl.x/3 把你的短链全爬出来。解决方案:一是用哈希方案,短链没有规律;二是自增 ID 混入随机因子,比如 ID 异或一个固定的随机数再转 62 进制。
还要防止恶意创建短链,可以限制单 IP 创建频率,或者加验证码。
常见问题
62 进制是怎么来的?
回答:62 进制用 0-9、a-z、A-Z 这 62 个字符表示数字,正好是 URL 安全字符。10 进制的 2278507744 转成 62 进制只需要 6 位,缩短了不少。转换方法就是不断除以 62 取余数,余数映射到字符表。如果想更短还可以用 64 进制,加上 - 和 _ 两个字符,不过有些场景这俩字符会有问题。
高并发下怎么保证短链不重复?
回答:用唯一索引兜底是最稳的,数据库层面保证唯一性。如果用自增 ID 方案,发号器用 Redis incr 或者数据库序列都行,天然不会重复。如果用哈希方案,唯一索引冲突了就重试,大不了多试几次,概率很低的。分布式场景下用雪花算法生成全局唯一 ID,时间戳加机器 ID 加序列号,不同机器生成的 ID 不会撞。
短链服务挂了怎么办?
回答:服务层面做高可用,多实例部署加负载均衡。数据库层面主从复制,主库挂了从库顶上。Redis 也得做主从或者集群,单点挂了不能影响服务。还有一点,301 跳转的话浏览器有缓存,服务挂了老用户还能用,只是新用户和新创建短链受影响。
怎么统计短链的访问情况?
回答:302 跳转的话每次请求都过短链服务,在服务里埋点就行。统计维度一般有 PV、UV、地域分布、设备类型、访问时间分布这些。数据量大的话用 Kafka 异步写入,落到 ClickHouse 这类分析型数据库做聚合。实时大屏展示可以用 Flink 做实时统计。
826. 让你实现一个分布式单例对象,如何实现?
核心要点
普通单例是进程内唯一,分布式单例要解决的是跨进程唯一,不管部署了多少台机器、多少个服务实例,全局只有这一个对象。
实现思路分两步:
- 一是用分布式锁控制创建过程,保证同一时刻只有一个进程能创建
- 二是把对象存到外部存储,让所有进程都能访问到。
创建流程是这样的:
- 多个进程同时尝试获取分布式锁,只有一个能抢到
- 抢到锁的进程先检查外部存储里有没有这个对象,没有就创建并序列化存进去,有就直接跳过。
- 最后释放锁,其他进程抢到锁后发现对象已存在,也直接跳过。
用 Redis 实现的核心代码:
public class DistributedSingleton<T> {
    private final RedissonClient redisson;
    private final String lockKey;
    private final String dataKey;
    private final Supplier<T> creator;
    private final Class<T> clazz;

    public T getInstance() {
        // 先尝试直接读,大部分情况不需要抢锁
        String data = redisson.getBucket(dataKey).get();
        if (data != null) {
            return JSON.parseObject(data, clazz);
        }

        // 没有才去抢锁创建
        RLock lock = redisson.getLock(lockKey);
        try {
            lock.lock();
            // 双重检查
            data = redisson.getBucket(dataKey).get();
            if (data != null) {
                return JSON.parseObject(data, clazz);
            }
            // 创建并存储
            T instance = creator.get();
            redisson.getBucket(dataKey).set(JSON.toJSONString(instance));
            return instance;
        } finally {
            lock.unlock();
        }
    }
}
修改对象的逻辑类似,也是抢锁、读取、修改、写回、释放锁,保证同一时刻只有一个进程在改。
扩展知识
ZooKeeper 实现方案
ZooKeeper 天然适合做分布式协调,实现分布式单例可以利用它的临时节点和 watch 机制。
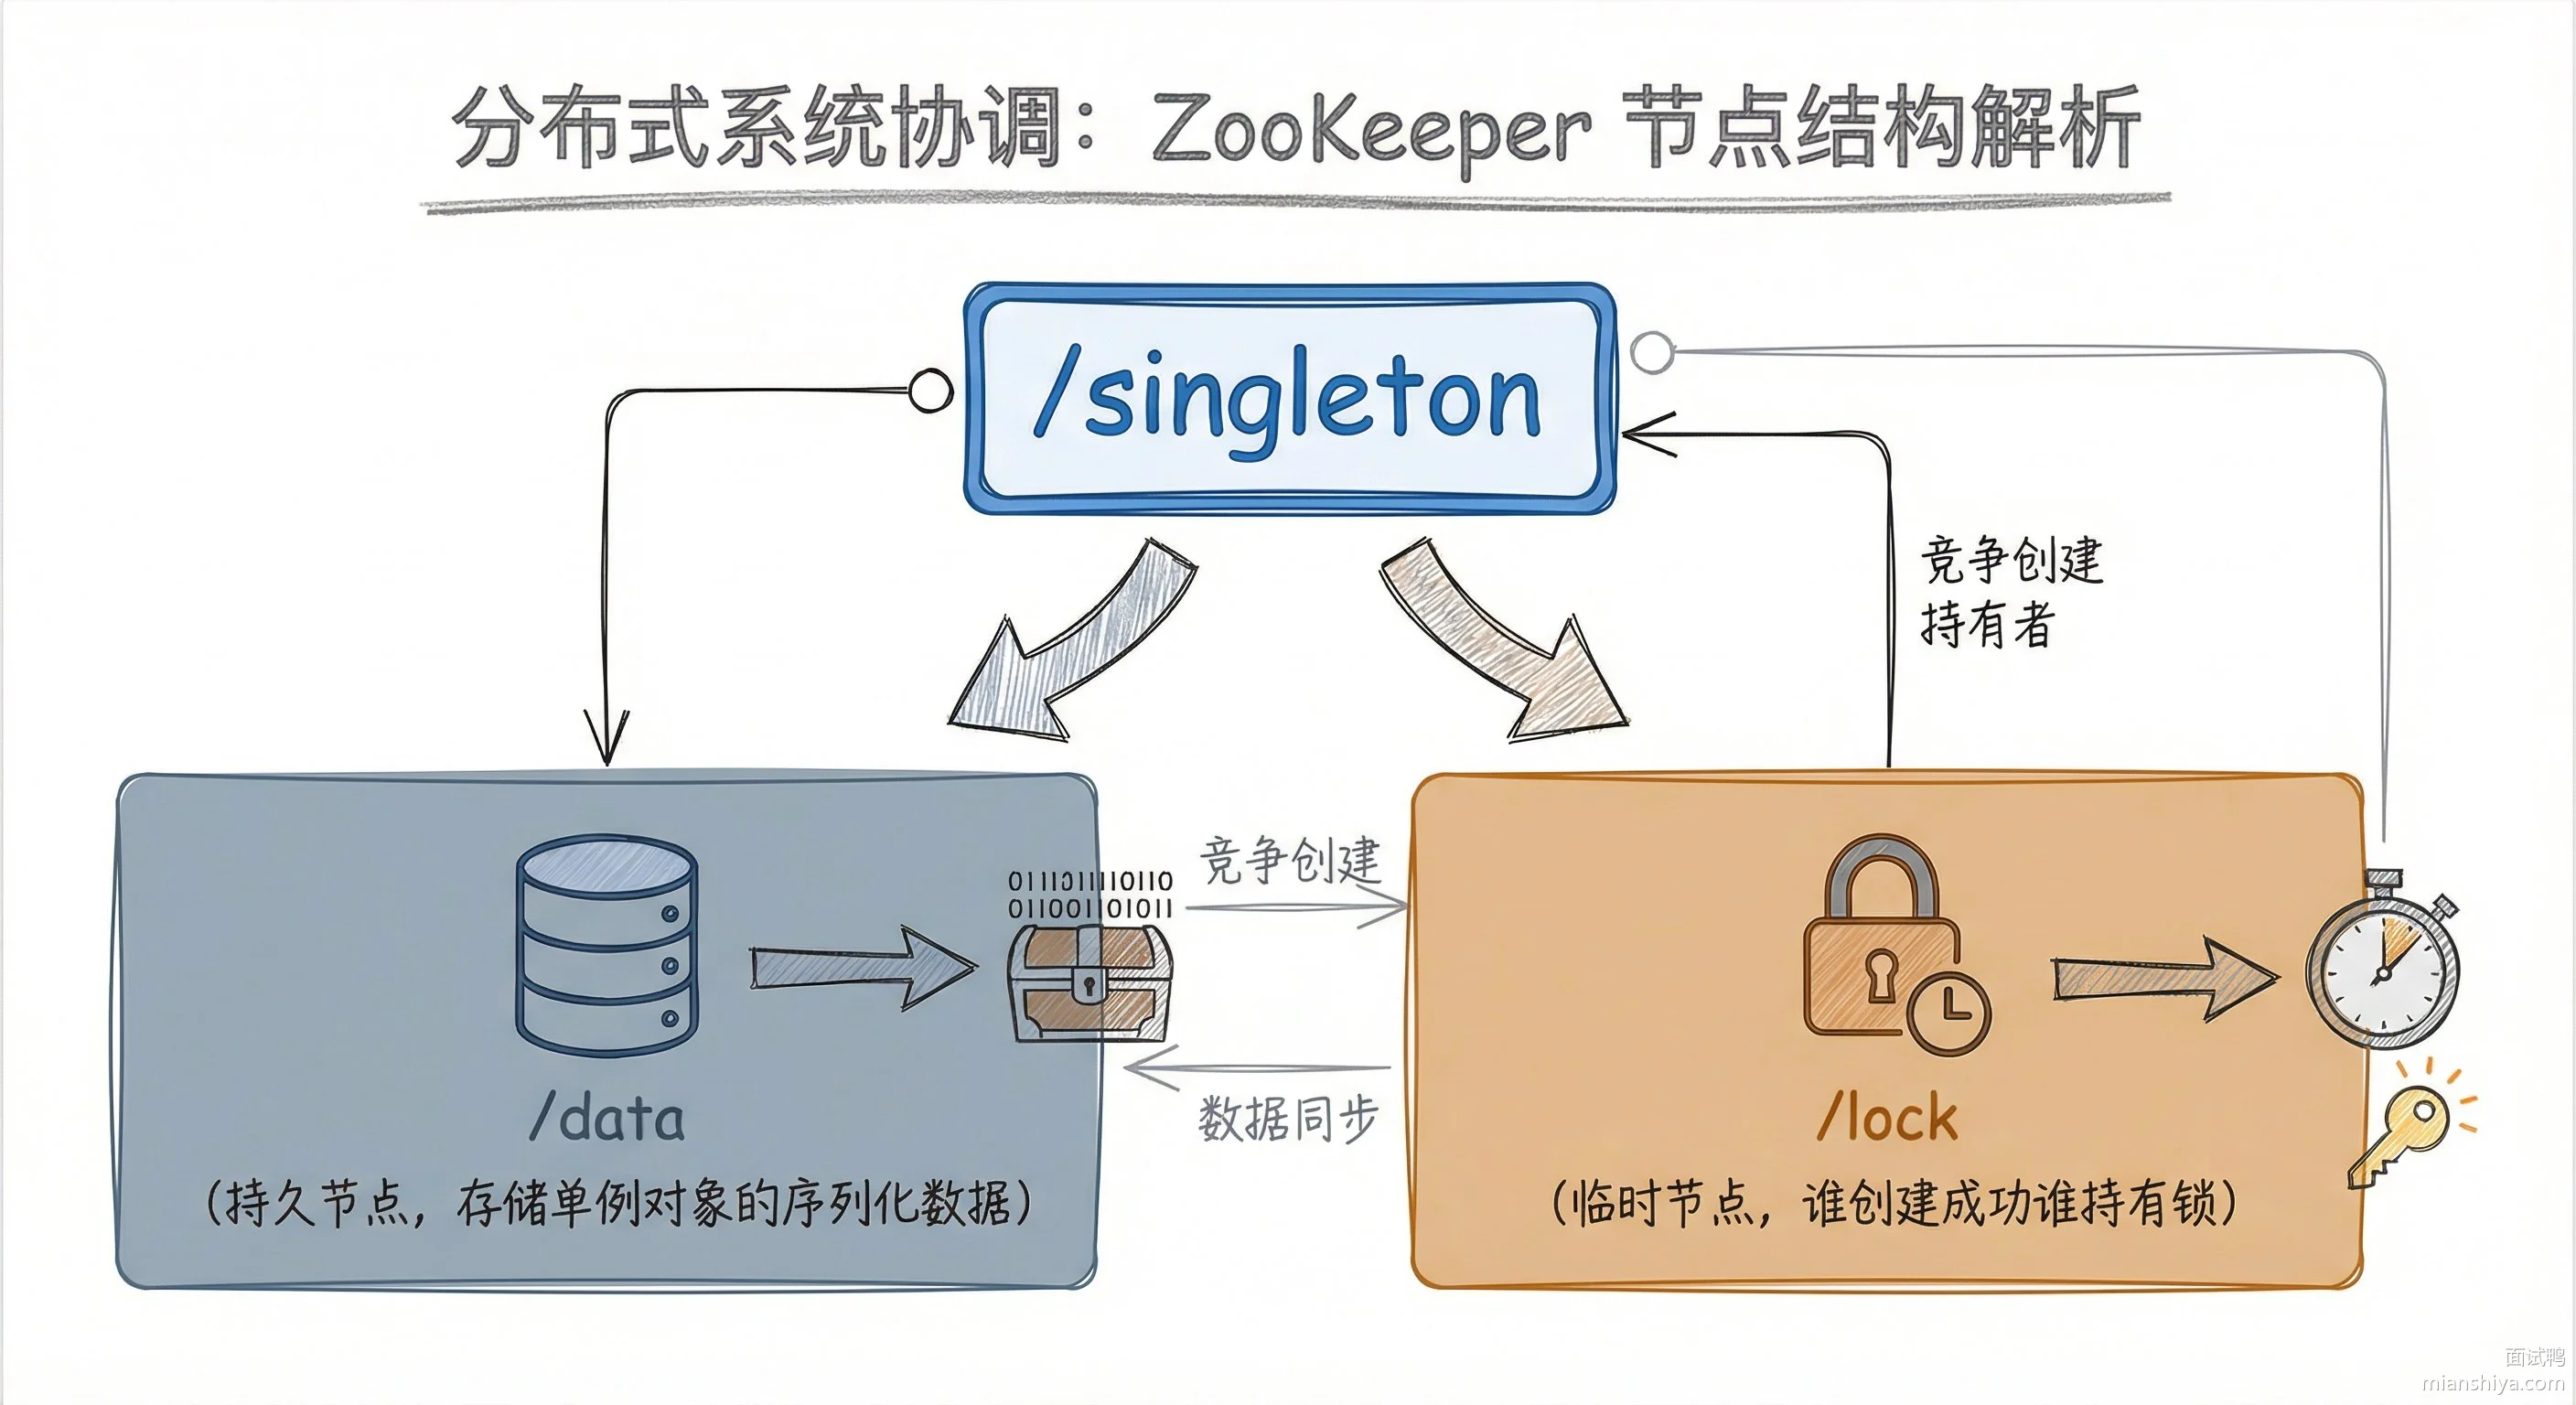
实现逻辑:
1)所有进程尝试在 /singleton/lock 路径创建临时节点,只有一个能成功,成功的就是拿到锁的
2)拿到锁的进程检查 /singleton/data 节点是否存在,不存在就创建单例对象并写入
3)其他进程通过 watch 监听 /singleton/lock,一旦持有者下线或主动删除节点,就会收到通知
4)临时节点的好处是进程崩溃后节点自动删除,不会出现死锁
public T getOrCreate() throws Exception {
    // 尝试创建临时节点获取锁
    try {
        curator.create()
            .withMode(CreateMode.EPHEMERAL)
            .forPath("/singleton/lock");

        // 拿到锁,检查数据节点
        if (curator.checkExists().forPath("/singleton/data") == null) {
            T instance = creator.get();
            curator.create()
                .creatingParentsIfNeeded()
                .forPath("/singleton/data", serialize(instance));
        }
    } catch (NodeExistsException e) {
        // 锁被别人持有,等待
    } finally {
        curator.delete().forPath("/singleton/lock");
    }

    // 读取数据
    byte[] data = curator.getData().forPath("/singleton/data");
    return deserialize(data);
}
Redis vs ZooKeeper 对比
| 维度 | Redis | ZooKeeper |
|---|---|---|
| 性能 | 更高,单机 10 万+ QPS | 较低,写操作需要过半节点确认 |
| 一致性 | 主从异步复制,极端情况可能丢数据 | 强一致性,ZAB 协议保证 |
| 锁释放 | 需要设置过期时间或手动释放 | 临时节点自动释放,更安全 |
| 运维复杂度 | 低,大部分公司都有现成集群 | 高,需要单独维护 ZK 集群 |
| 适用场景 | 对性能要求高,能容忍极端情况的不一致 | 对一致性要求严格的金融级场景 |
容易踩的坑
1)双重检查不能少:抢到锁之后必须再查一次对象是否存在,因为可能另一个进程刚创建完释放锁,你才抢到。
2)锁的过期时间:Redis 分布式锁必须设置过期时间,防止进程崩溃后锁一直不释放。但过期时间设短了,业务还没执行完锁就过期了,又会有并发问题。Redisson 的看门狗机制可以自动续期,推荐用现成的库。
3)序列化一致性:所有进程必须用同一套序列化方案,不然 A 进程用 JSON 写入,B 进程用 Hessian 读取就炸了。
4)缓存一致性:如果本地也缓存了一份单例对象,修改的时候要考虑如何通知其他进程刷新本地缓存。可以用 Redis 的 Pub/Sub 做广播通知。
真的需要分布式单例吗
很多时候分布式单例不是最优解。
比如配置信息,与其做成分布式单例,不如用配置中心 Nacos、Apollo 来管理。比如全局计数器,与其用分布式单例,不如直接用 Redis 的原子操作。
常见问题
如果 Redis 主从切换的瞬间,两个进程都认为自己拿到了锁怎么办?
回答:这是 Redis 异步复制的固有问题。进程 A 在主节点拿到锁,主节点还没来得及同步给从节点就挂了,从节点升为主节点后,进程 B 又拿到了同一把锁。对一致性要求高的场景,要么用 RedLock 算法在多个独立的 Redis 实例上加锁,要么干脆换 ZooKeeper。RedLock 要求过半节点加锁成功才算拿到锁,代价是性能下降和运维复杂度上升。
分布式单例的修改操作很频繁,每次都要抢锁性能扛不住怎么办?
回答:可以引入租约机制。某个进程抢到锁后不立刻释放,而是持有一段时间的独占写权限,这段时间内所有修改请求都路由到这个进程。租约到期或者进程主动放弃,其他进程才能竞争。这样就把频繁的分布式锁竞争变成了偶尔一次的租约续期,ZooKeeper 的 Leader 选举就是这个思路。
本地也缓存了单例对象,怎么保证和外部存储的一致性?
回答:严格一致性的话,每次读都从外部存储拉最新的,但这样性能太差。一般会用最终一致性,修改的时候通过 Redis Pub/Sub 或者消息队列广播一条失效通知,其他进程收到后清掉本地缓存,下次访问时重新从外部存储加载。如果通知丢了,可以给本地缓存加一个 TTL 兜底,比如 10 秒过期强制刷新一次。
958. 分布式锁一般都怎样实现?
核心要点
分布式锁用于多个应用实例之间互斥访问共享资源,单机锁搞不定跨进程的问题,必须依赖外部组件。
业界主流方案是 Redis。
Redis 实现分布式锁的核心是 SETNX 命令,SET if Not eXists,只有 key 不存在时才能设置成功。加锁成功返回 OK,失败返回 nil。
- 加锁:
SET lockKey lockValue NX PX 30000,NX 保证互斥,PX 30000 设置 30 秒过期时间,防止客户端挂了锁永远不释放。 - 释放锁:必须用 Lua 脚本保证原子性,先判断 value 是不是自己的,是才删除。不能直接 DEL,否则可能把别人的锁删掉。
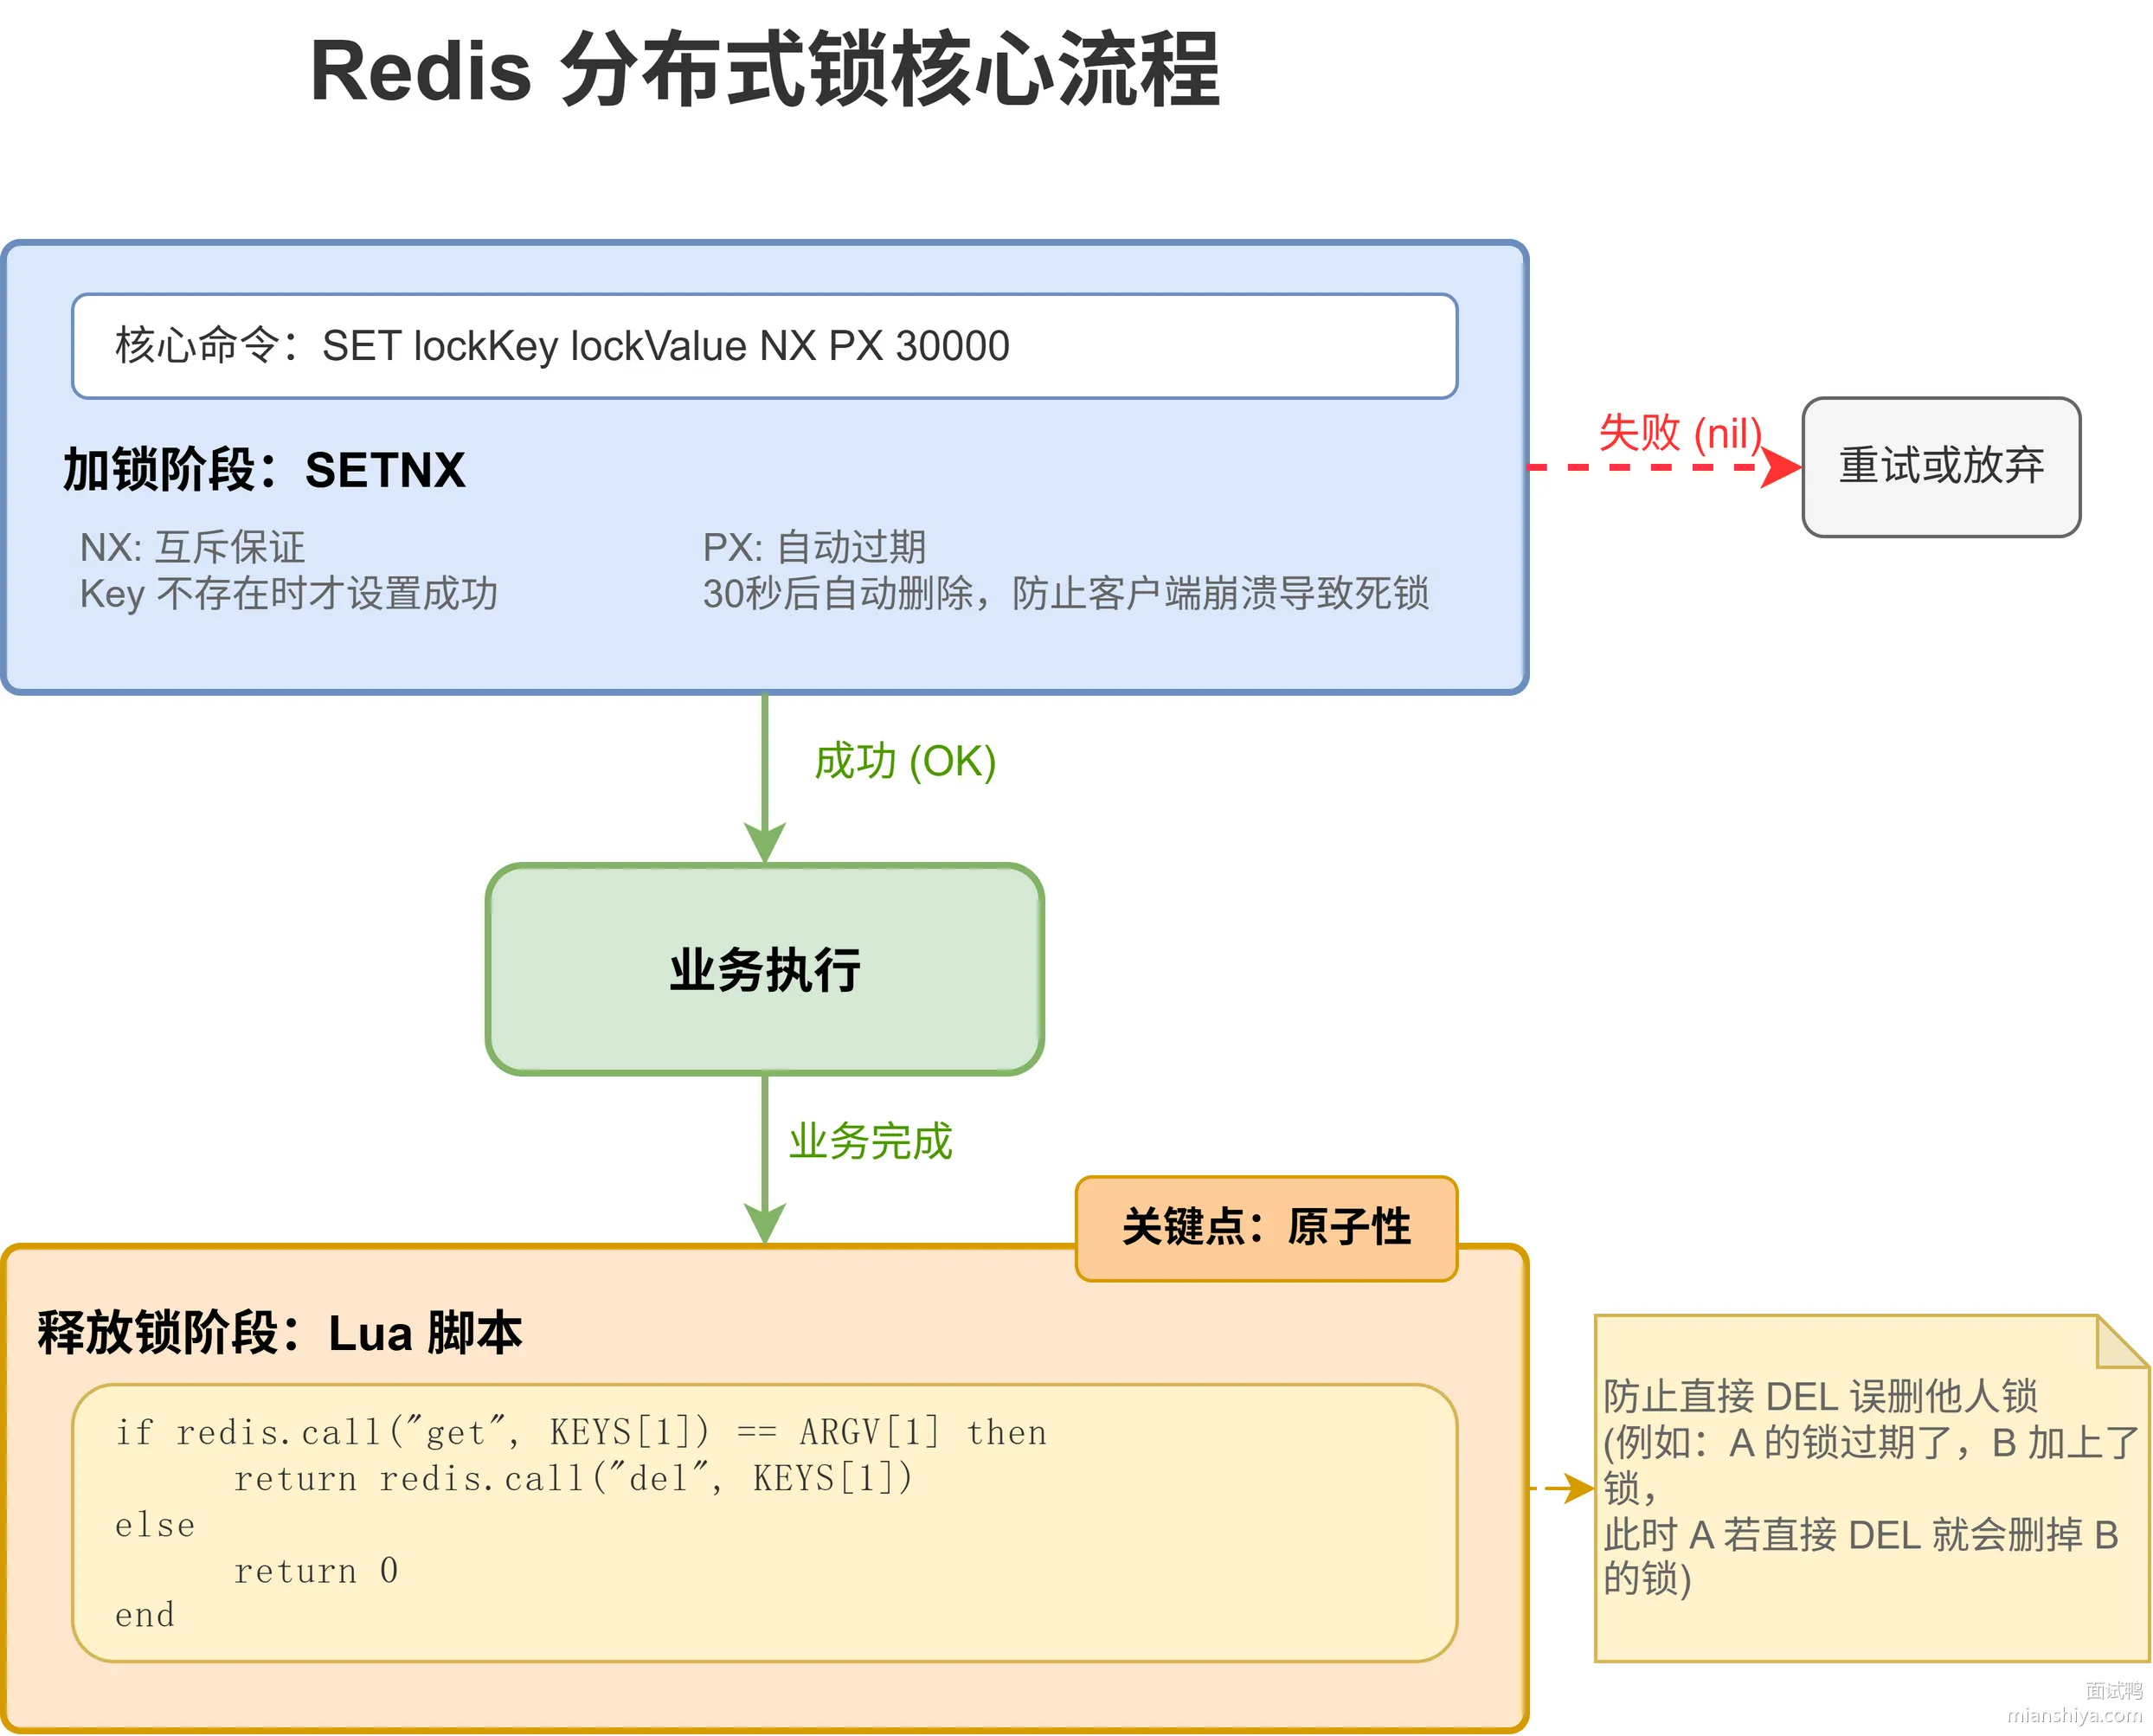
代码示例:
public class RedisDistributedLock {
    private Jedis jedis;
    private String lockKey;
    private String lockValue;
    private int lockTimeout;

    public RedisDistributedLock(Jedis jedis, String lockKey, int lockTimeout) {
        this.jedis = jedis;
        this.lockKey = lockKey;
        this.lockTimeout = lockTimeout;
        // UUID 保证 lockValue 唯一,防止误删别人的锁
        this.lockValue = UUID.randomUUID().toString();
    }

    public boolean acquireLock() {
        String result = jedis.set(lockKey, lockValue, "NX", "PX", lockTimeout);
        return "OK".equals(result);
    }

    public boolean releaseLock() {
        // Lua 脚本保证 check-and-delete 原子性
        String script =
            "if redis.call('get', KEYS[1]) == ARGV[1] then " +
            "return redis.call('del', KEYS[1]) " +
            "else return 0 end";
        Object result = jedis.eval(script,
            Collections.singletonList(lockKey),
            Collections.singletonList(lockValue));
        return Long.valueOf(1).equals(result);
    }
}
除此之外,也可以用 ZooKeeper 实现分布式锁。
主要用的是它的临时有序节点。
多个客户端在同一个目录下创建临时有序节点,序号最小的那个拿到锁。临时节点保证客户端挂了自动释放,有序节点保证公平排队。
扩展知识
Redis 分布式锁的坑
锁过期了业务还没执行完
锁设了 30 秒超时,但业务逻辑跑了 40 秒,锁提前释放了,别的客户端进来了,数据就乱了。
解决方案是看门狗机制,后台起个定时线程,每隔 10 秒检查一下锁还在不在,在就续期到 30 秒。
Redisson 开箱即用,只要你获取锁时不指定超时时间,它就自动开启看门狗:
RLock lock = redisson.getLock("myLock");
lock.lock(); // 不指定超时,自动续期
try {
    // 业务逻辑
} finally {
    lock.unlock();
}
注意:如果你手动指定了超时时间 lock.lock(30, TimeUnit.SECONDS),看门狗就不会启动,锁到期就释放。
主从切换导致锁丢失
Redis 主从架构下,客户端在 master 加锁成功,但锁数据还没同步到 slave,master 挂了,slave 升级为 master,新 master 上压根没这把锁,别的客户端就能再次加锁成功,两个客户端同时持有锁。
这就是 Redis 作者提出 RedLock 的原因。
RedLock 的思路是多个独立的 Redis 节点(没有哨兵和 slave 了)一起投票,超过半数加锁成功才算成功。
比如现在有 5 个 Redis 节点(官方推荐至少 5 个),客户端获取当前时间 T1,然后依次利用 SETNX 对 5 个 Redis 节点加锁,如果成功 3 个及以上(大多数),再次获取当前时间 T2,如果 T2-T1 小于锁的超时时间,则加锁成功,反之则失败。
如果加锁失败则向全部节点调用释放锁的操作。
RedLock 的问题:
- 成本高,得部署 5 个独立 Redis 实例,不能是主从
- 时钟漂移问题,某个节点系统时间突然往前跳,锁提前过期
- GC 问题,客户端拿到锁后发生长时间 Full GC,醒来时锁早过期了,别的客户端已经拿到锁在干活了
Martin Kleppmann 写过一篇文章专门怼 RedLock,核心观点是分布式系统不能依赖时间假设,RedLock 的安全性证明不成立。
Redis 作者 antirez 也回应了,两边吵得挺热闹。实际工程中,大多数场景用单节点 Redis + Redisson 就够了。
ZooKeeper 分布式锁细节
ZooKeeper 用临时有序节点实现分布式锁:
- 客户端在 /locks 目录下创建临时有序节点,比如 /locks/lock-0000000001
- 获取 /locks 下所有子节点,判断自己是不是序号最小的
- 如果是最小的,拿到锁;如果不是,监听比自己小一号的节点
- 等前一个节点被删除,自己就变成最小的,拿到锁
这种设计避免了惊群效应,每个客户端只监听前一个节点,不会所有客户端同时被唤醒。
临时节点的特性:客户端和 ZooKeeper 之间维护一个 session,session 超时节点自动删除。
就算客户端进程挂了,锁也会自动释放,不用担心死锁。
Curator 提供了 InterProcessMutex 封装好了这些细节:
InterProcessMutex lock = new InterProcessMutex(client, "/locks/myLock");
try {
    if (lock.acquire(10, TimeUnit.SECONDS)) {
        // 拿到锁,执行业务
    }
} finally {
    lock.release();
}
Redis vs ZooKeeper 怎么选?
| 维度 | Redis | ZooKeeper |
|---|---|---|
| 性能 | 高,10 万+ QPS | 一般,写操作走 leader |
| 可靠性 | 主从异步复制,可能丢锁 | ZAB 协议,强一致 |
| 实现复杂度 | Redisson 封装完善 | Curator 封装完善 |
| 运维成本 | 低,本身就用 Redis | 需要额外部署 ZK 集群 |
| 适用场景 | 允许极端情况下重复加锁 | 对一致性要求极高 |
实际选型:如果系统本身已经用了 ZooKeeper 做注册中心,用 ZK 做分布式锁成本不大。如果只有 Redis,且业务能容忍极端情况下的锁失效,就用 Redis + Redisson。
数据库实现分布式锁
其实数据库也能实现分布式锁,用 SELECT ... FOR UPDATE 或者 unique key 插入竞争。
但性能太差,几百 QPS 就撑不住了,一般不推荐。除非你的场景并发量很低,又不想引入额外组件。
常见问题
Redisson 的看门狗是怎么实现的?续期失败了怎么办?
回答:Redisson 用 Netty 的 HashedWheelTimer 做定时任务,默认锁超时 30 秒,每 10 秒续期一次,把过期时间重置为 30 秒。续期操作也是 Lua 脚本保证原子性,先 check 锁是不是自己的,是才 PEXPIRE 续期。如果续期失败,比如网络抖动导致 Redis 不可达,HashedWheelTimer 会不断重试。但如果客户端进程挂了,定时任务也就没了,锁自然超时释放,不会死锁。
为什么释放锁要用 Lua 脚本?直接 GET 再 DEL 不行吗?
回答:GET 和 DEL 是两条命令,中间有时间窗口。假设客户端 A 的锁过期了,客户端 B 拿到了锁,这时候 A 的 GET 发现 value 是自己的老值,但执行 DEL 的时候其实删的是 B 的锁。Lua 脚本在 Redis 里是原子执行的,check 和 delete 绑在一起,不会被打断。
ZooKeeper 的临时节点有什么坑?
回答:session 超时时间设得不合理容易出问题。如果网络抖动导致 ZK 认为客户端挂了,临时节点被删掉,锁就释放了,但客户端其实还在执行业务。Curator 默认 session 超时是 60 秒,可以根据业务场景调整。另一个坑是惊群效应,老版本实现是所有客户端监听同一个父节点,锁释放时所有人都被唤醒争抢,现在用有序节点 + 监听前一个节点的方式解决了。
分布式锁能保证幂等吗?
回答:锁只保证同一时刻只有一个客户端执行,不保证执行成功。如果客户端拿到锁后执行到一半挂了,下一个客户端拿到锁重新执行,数据可能不对。幂等要业务层自己保证,比如用唯一 ID 做去重,或者用数据库乐观锁兜底。分布式锁和幂等是两个独立的问题,锁解决互斥,幂等解决重复执行。
970. 如果让你统计每个接口每分钟调用次数怎么统计?
核心要点
统计接口调用次数的方案得看精度要求和系统规模。小系统追求简单可以用内存计数,大系统要求准确就得上日志采集 + ES 或者 MQ + 时序数据库。
最简单的方案是内存计数:
- ConcurrentHashMap 存每个接口的调用次数,key是方法名,value 为 AtomicInteger 类型,记录调用次数
- 用 AOP 切面拦截所有接口调用,每次调用就把对应接口的计数器加 1。
- 定时任务每 60 秒把数据捞出来落库或上报,然后清空 Map 重新开始计。
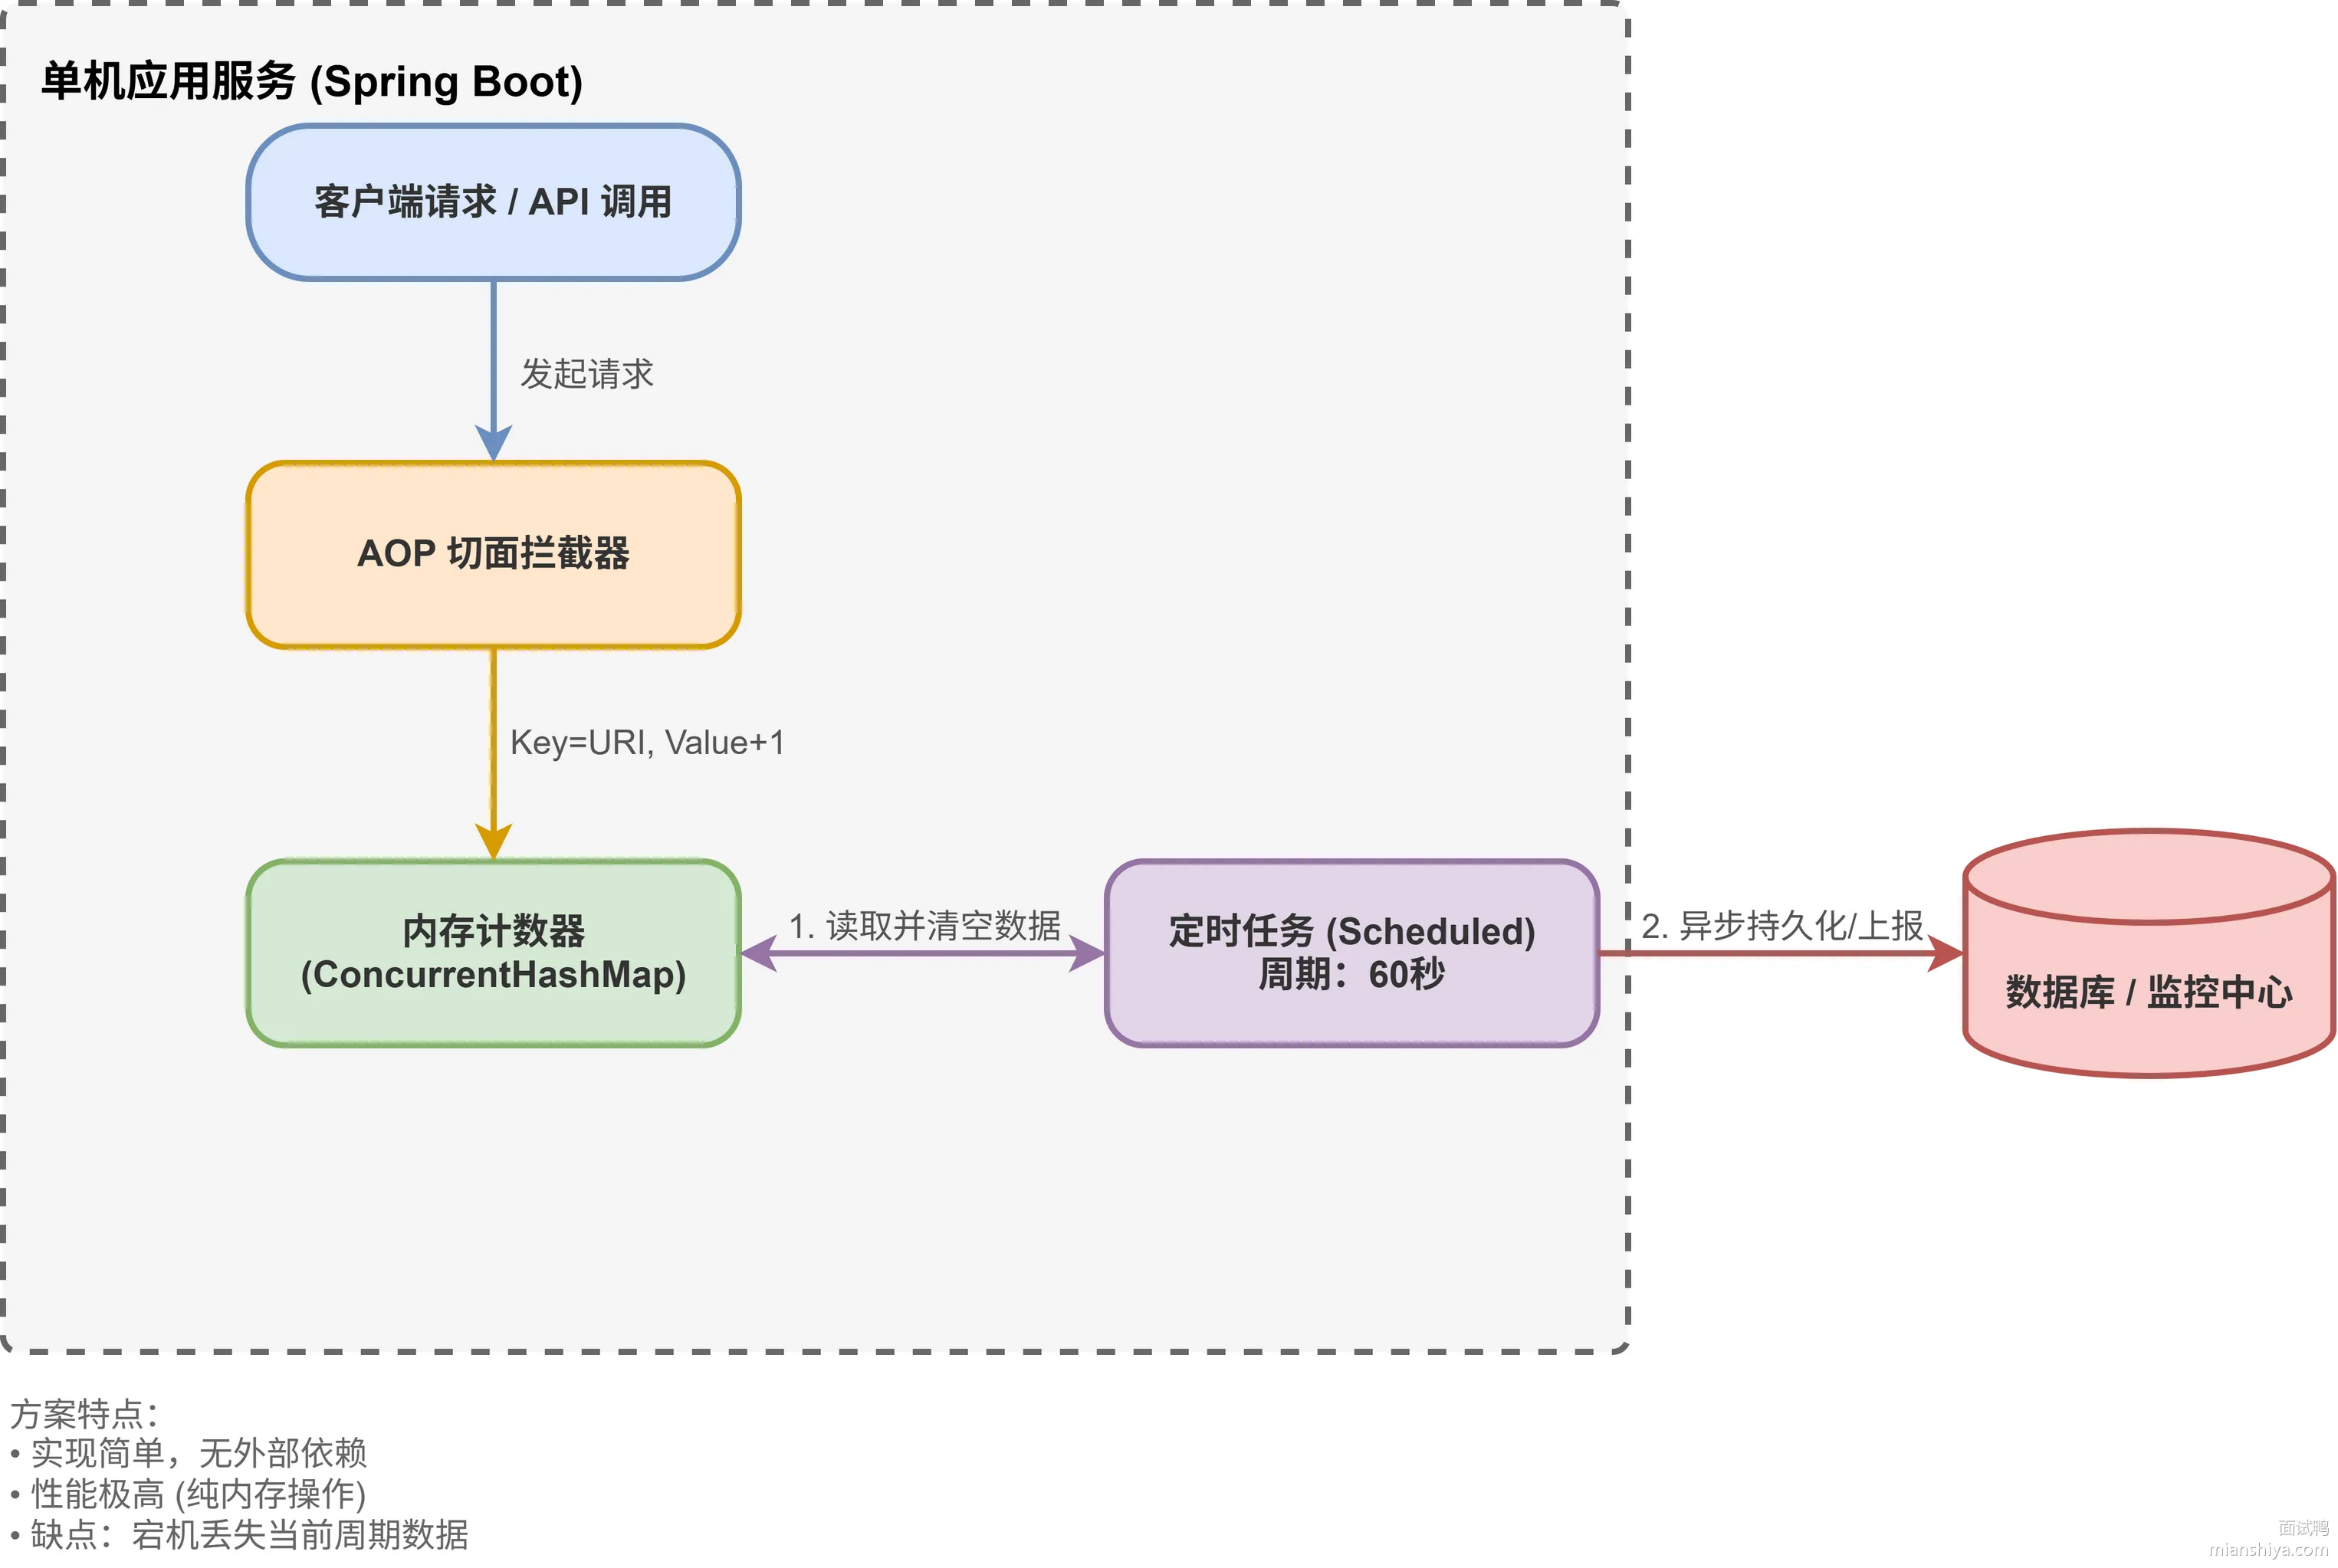
代码示例:
@Aspect
@Component
public class ApiCallAspect {
    // 接口名 -> 调用次数
    private ConcurrentHashMap<String, AtomicInteger> apiCallCounts = new ConcurrentHashMap<>();

    @Before("execution(* com.example.controller.*.*(..))")
    public void recordApiCall(JoinPoint joinPoint) {
        String methodName = joinPoint.getSignature().getName();
        // computeIfAbsent 保证并发安全,AtomicInteger 保证累加原子性
        apiCallCounts.computeIfAbsent(methodName, k -> new AtomicInteger(0)).incrementAndGet();
    }

    public ConcurrentHashMap<String, AtomicInteger> getAndReset() {
        ConcurrentHashMap<String, AtomicInteger> snapshot = new ConcurrentHashMap<>(apiCallCounts);
        apiCallCounts.clear();
        return snapshot;
    }
}

@Scheduled(fixedRate = 60000)
public void reportApiCallCounts() {
    ConcurrentHashMap<String, AtomicInteger> counts = apiCallAspect.getAndReset();
    counts.forEach((api, count) -> {
        // 落库或上报监控系统
        metricsService.report(api, count.get());
    });
}
内存计数方案的问题:
- 精度不准,定时任务执行和 Map 清空之间有时间窗口,统计的不是严格的 60 秒
- 宕机就丢数据,内存里的东西没落地就没了
- 多实例部署时每台机器各统计各的,还得汇总
还可以采用日志记录实现接口的统计。每次接口调用都用日志记录:接口名、时间戳等信息。
利用日志采集工具将日志统一发送并存储至 es 中(或者其他 NoSQL 中),利用 es 即可统计每分钟每个接口的调用量。
也可以利用 MQ,每次接口调用时都将接口名、时间戳封装发送消息,消费端可以将这些信息存储至 NoSQL 中,最终进行统计分析。
因为存储了时间戳,所以接口的调用次数是准确的。
扩展知识
生产环境怎么做?
真正的生产系统一般用日志采集 + 分析引擎的架构。
每次接口调用打一条结构化日志,日志里带上接口名、调用时间、响应时间、状态码这些字段。
日志采集器把日志发到 Kafka,下游消费写入 Elasticsearch 或 ClickHouse,最后用 Kibana 或 Grafana 做可视化。
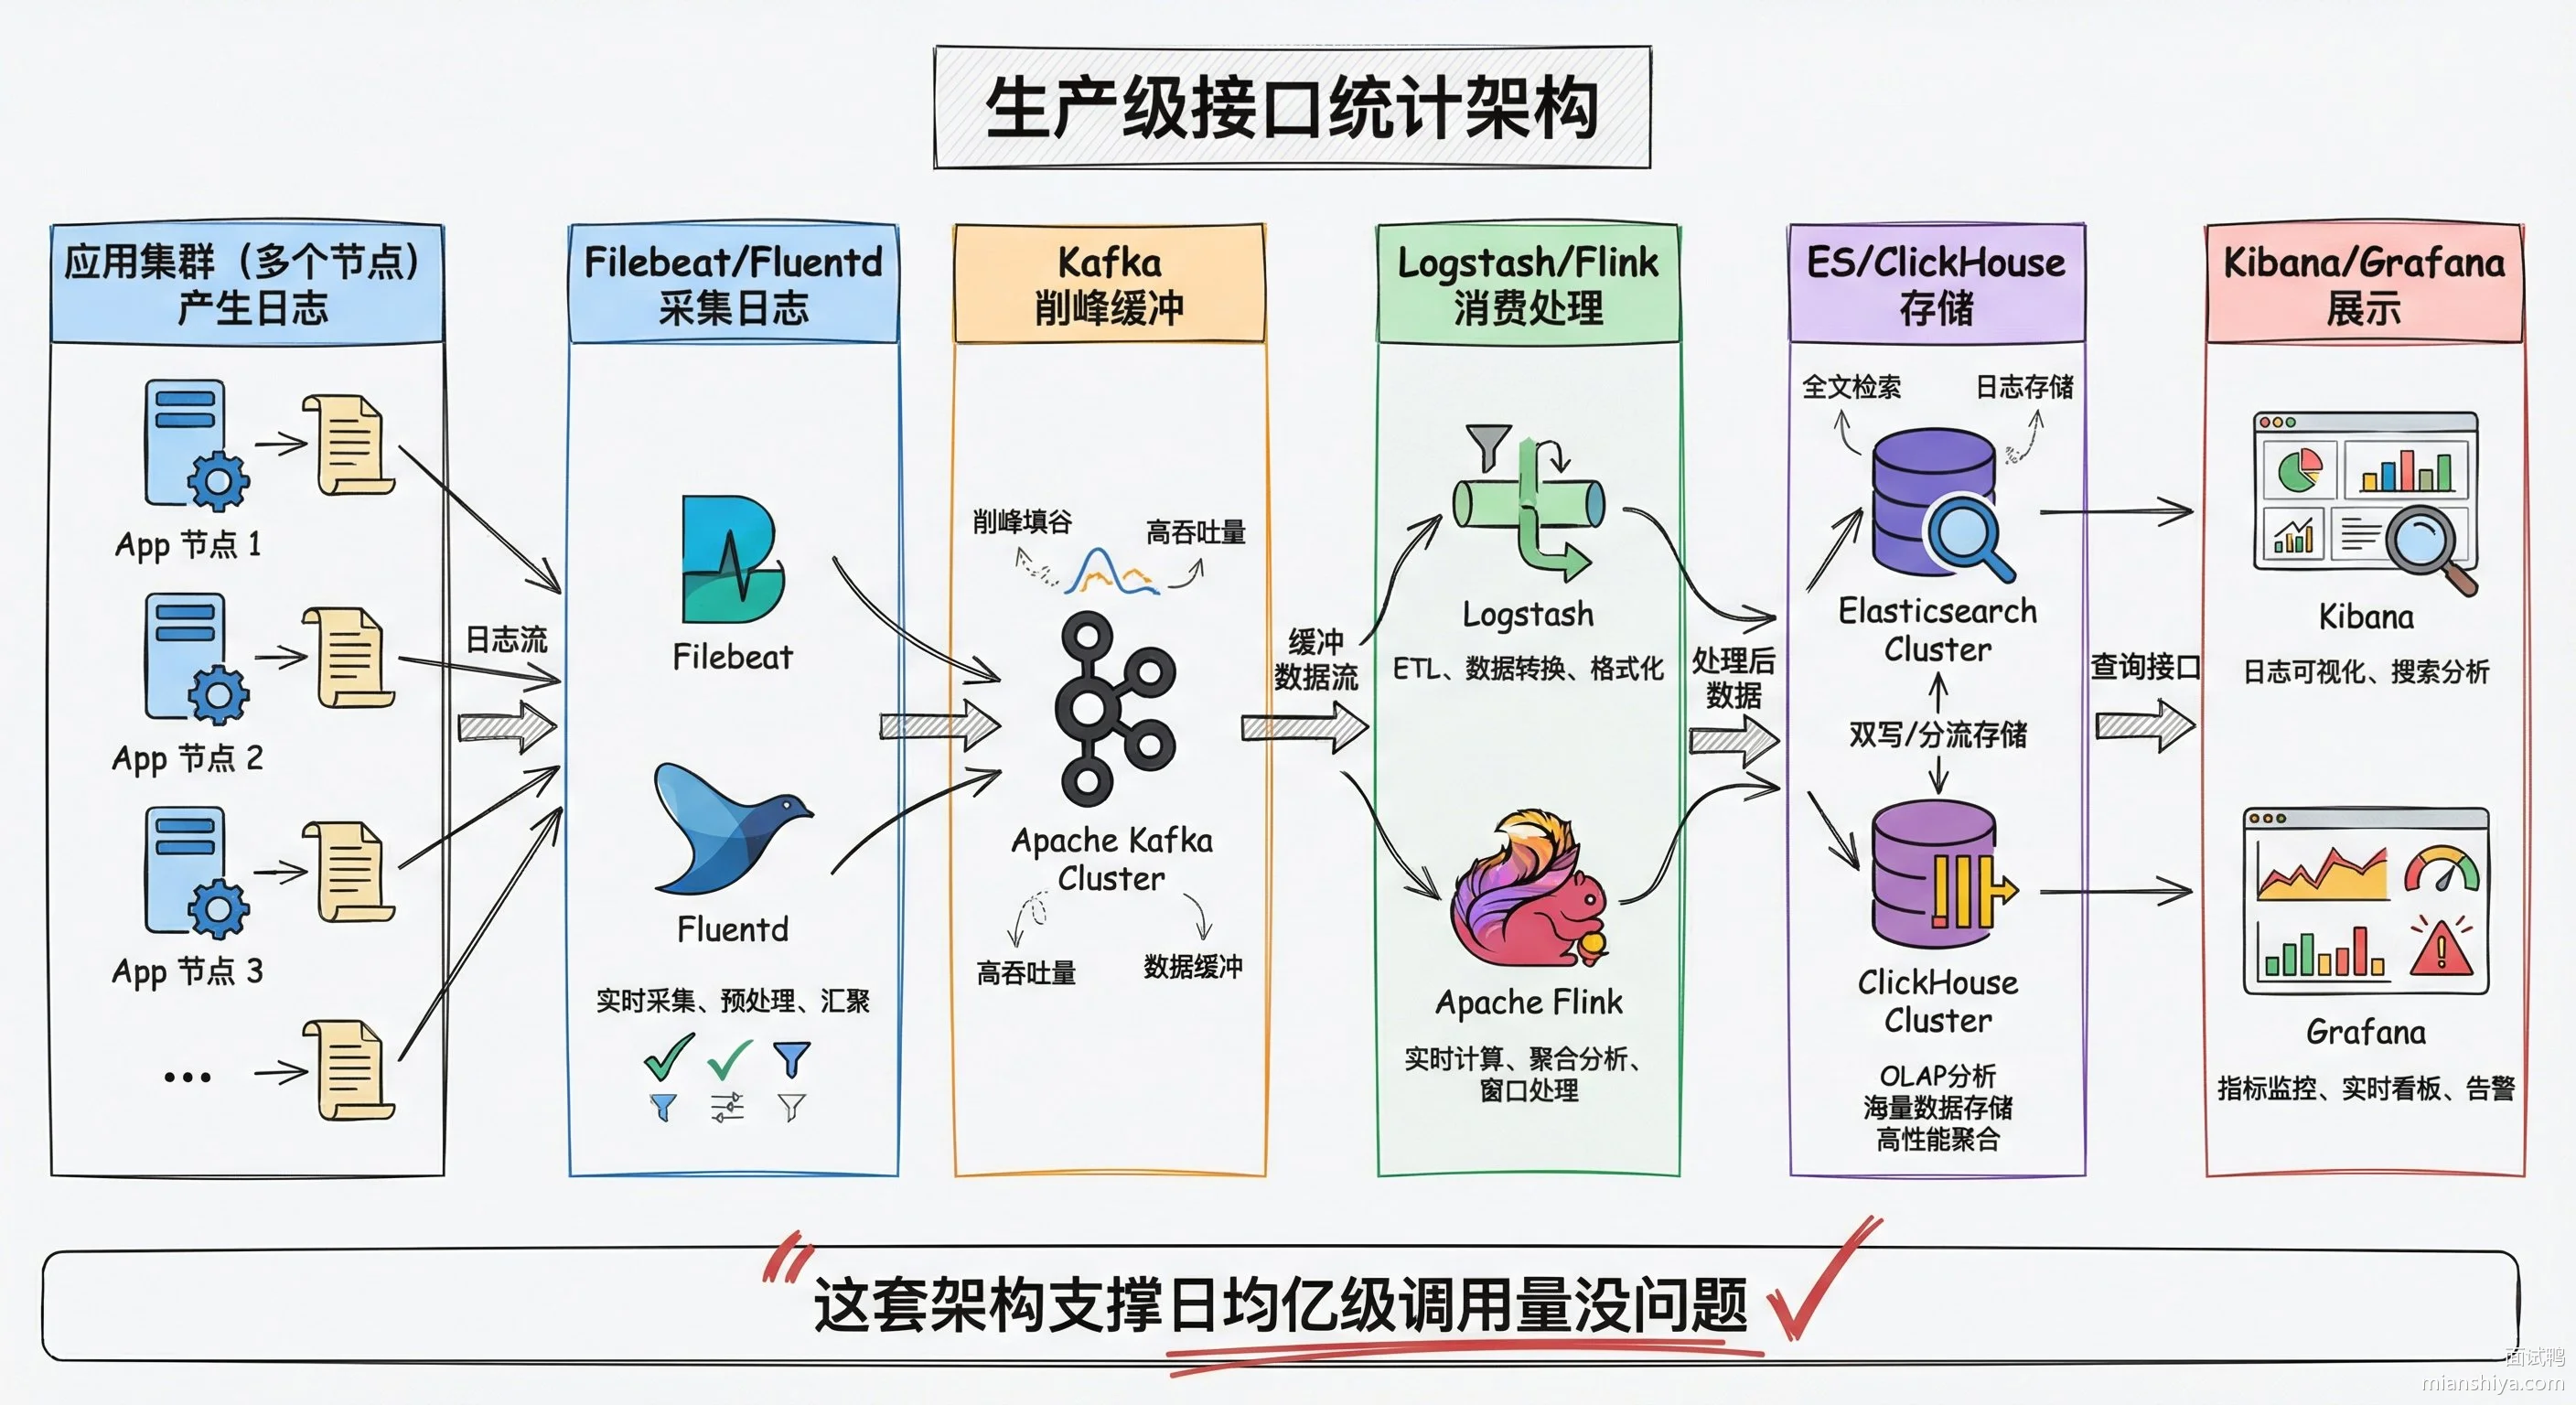
这套架构的优势:
- 精度高,每条日志带时间戳,统计哪个分钟的数据完全精确
- 数据不丢,日志落盘 + Kafka 持久化 + ES 多副本,三重保险
- 多维分析,想统计什么都行,按接口、按机器、按时间段随便切
Elasticsearch 做统计的查询示例:
{
  "size": 0,
  "query": {
    "range": {
      "timestamp": {
        "gte": "now-1m",
        "lte": "now"
      }
    }
  },
  "aggs": {
    "by_api": {
      "terms": {
        "field": "api_name.keyword",
        "size": 100
      }
    }
  }
}
用 Redis 做实时计数
如果只是想要一个轻量级的实时计数,Redis 是个好选择。用 INCR 命令原子递增,key 设计成 api:count:{接口名}:{分钟时间戳} 这种格式,天然就是按分钟分桶了。
public void recordApiCall(String apiName) {
    // 当前分钟的时间戳,精确到分钟
    long minute = System.currentTimeMillis() / 60000;
    String key = String.format("api:count:%s:%d", apiName, minute);
    redisTemplate.opsForValue().increment(key);
    // 设置 2 小时过期,过期数据自动清理
    redisTemplate.expire(key, 2, TimeUnit.HOURS);
}
查某个接口过去一分钟的调用量:
public Long getApiCount(String apiName) {
    long minute = System.currentTimeMillis() / 60000 - 1; // 上一分钟
    String key = String.format("api:count:%s:%d", apiName, minute);
    return redisTemplate.opsForValue().get(key);
}
Redis 方案的好处是实时性高,INCR 是 O(1) 操作,几乎不影响接口性能。缺点是历史数据查询不方便,想看一周前某天的调用量就麻烦了。
Micrometer + Prometheus 方案
Spring Boot 项目还可以用 Micrometer 埋点 + Prometheus 采集 + Grafana 展示。
Micrometer 是 Spring Boot 2.0 开始内置的监控门面,跟 SLF4J 一个思路,屏蔽底层监控系统的差异。
@RestController
public class UserController {
    private final Counter apiCounter;

    public UserController(MeterRegistry registry) {
        this.apiCounter = Counter.builder("api.call.count")
            .tag("api", "getUser")
            .register(registry);
    }

    @GetMapping("/user/{id}")
    public User getUser(@PathVariable Long id) {
        apiCounter.increment();
        return userService.getById(id);
    }
}
更省事的做法是用 @Timed 注解,自动统计调用次数和响应时间:
@Timed(value = "api.call", extraTags = {"api", "getUser"})
@GetMapping("/user/{id}")
public User getUser(@PathVariable Long id) {
    return userService.getById(id);
}
Prometheus 每 15 秒拉一次数据,自动计算每分钟的调用量。PromQL 查询:
rate(api_call_count_total{api="getUser"}[1m]) * 60滑动窗口计数
如果对精度要求高,可以用滑动窗口算法。把一分钟切成 60 个桶,每个桶存 1 秒钟的计数。查询时把 60 个桶的数据加起来就是过去一分钟的调用量。
public class SlidingWindowCounter {
    private AtomicLongArray buckets = new AtomicLongArray(60);
    private AtomicLong lastSecond = new AtomicLong(0);

    public void increment() {
        long currentSecond = System.currentTimeMillis() / 1000;
        int index = (int) (currentSecond % 60);

        // 检查是否需要重置桶
        long lastSec = lastSecond.get();
        if (currentSecond - lastSec >= 60) {
            // 超过一分钟没更新,全部清零
            for (int i = 0; i < 60; i++) {
                buckets.set(i, 0);
            }
        } else if (currentSecond > lastSec) {
            // 清零中间跳过的桶
            for (long s = lastSec + 1; s <= currentSecond; s++) {
                buckets.set((int) (s % 60), 0);
            }
        }

        buckets.incrementAndGet(index);
        lastSecond.set(currentSecond);
    }

    public long getCount() {
        long sum = 0;
        for (int i = 0; i < 60; i++) {
            sum += buckets.get(i);
        }
        return sum;
    }
}
滑动窗口方案精度最高,任何时刻查询都是严格的过去 60 秒数据,不会因为定时任务的执行时机导致统计偏差。
常见问题
高并发场景下内存计数有什么性能问题?
回答:ConcurrentHashMap 在高并发写入同一个 key 的时候会有竞争。AtomicInteger 底层用 CAS 自旋,冲突严重时 CPU 空转浪费资源。可以用 LongAdder 替代 AtomicInteger,LongAdder 内部维护一个 Cell 数组,把竞争分散到多个槽位,最后统计时把所有 Cell 加起来。Doug Lea 在 JDK8 专门为这种高频计数场景设计的,比 AtomicLong 快几十倍。
多实例部署怎么汇总统计数据?
回答:两种方案。一种是各实例统计完往同一个 Redis 里写,用 INCRBY 累加,查询时直接读 Redis。另一种是各实例各自上报到监控系统,监控系统做聚合。Prometheus 就是这种模式,每个实例暴露 /metrics 接口,Prometheus 挨个拉数据,查询时用 sum by 聚合。第二种方案更灵活,能按实例维度下钻分析。
统计数据怎么做持久化?重启后历史数据还能查吗?
回答:内存计数方案不行,重启就没了。生产环境一般定时把统计结果写入时序数据库,比如 InfluxDB、TimescaleDB、TDengine 这些,专门针对时间序列数据优化过,压缩比高,查询快。或者写入 ES,好处是能和业务日志放一起分析。历史数据查询就从这些存储里捞,不依赖应用内存。
如果接口数量特别多,内存会不会撑爆?
回答:一个接口名字符串加一个 AtomicInteger,撑死几百字节。就算有 1 万个接口也就几 MB,不是问题。真正要担心的是日志方案,每次调用都打日志,日均 10 亿调用就是 10 亿条日志,ES 存储成本不低。可以考虑采样,不用每条都记,随机采 1% 或 10%,统计时乘个系数,误差在可接受范围内,成本降一个数量级。
1042. 让你设计一个文件上传系统,怎么设计?
核心要点
关于文件上传系统有几个最主要的核心点需要解决:
- 如何支持超大文件上传
- 避免重复文件存储,节省空间
- 限流问题
大文件分片上传的核心流程:
- 前端把文件切成固定大小的分片,比如每片 2MB
- 计算整个文件的 MD5 摘要,作为文件唯一标识(MD5/SHA 等哈希算法本身支持流式计算,每次喂入一块数据更新内部状态,最后输出摘要)
- 先问后端这个摘要存不存在,存在就秒传成功
- 不存在则逐片上传,每片带上序号和文件标识
- 后端收到分片后存储,并在 Redis 记录上传进度
- 所有分片传完后,后端合并文件或直接分片存储
具体来说:
1)分片上传解决大文件问题。一个 10GB 的视频,直接传后端内存肯定扛不住,切成 5000 个 2MB 的小块,后端收一块存一块,内存占用就那么点。网络断了也不怕,断点续传从上次的分片继续就行。
2)哈希去重解决重复存储问题。用 MD5 或 SHA-256 算文件摘要,两个文件摘要一样就认为是同一份。上传前先把摘要传给后端查一下,库里有就直接返回成功,这就是秒传的原理。
3)多维度限流保护后端。单文件大小上限、每日上传次数、上传频率、同时上传人数,这几个维度都要卡住,不然几个人同时传大文件,后端直接被打爆。
扩展知识
分片存储的两种策略
分片传上来之后,存储有两种玩法:
第一种是合并存储,所有分片传完后拼成一个完整文件。好处是后续读取简单,坏处是合并本身要时间和临时空间,10GB 的文件合并一次可能要几十秒。
第二种是分片存储,分片直接存着不合并。下载的时候按序把分片流式输出给前端,前端自己拼。好处是上传完就完了,没有合并开销;坏处是读取逻辑复杂,还要维护分片元数据。
实际生产中,小文件走合并,大文件走分片存储比较合理。
阿里云 OSS、七牛云这些对象存储服务,底层都是分片存储的思路。
断点续传的实现细节
断点续传的关键是记录上传进度。用 Redis 存每个分片的上传状态:
key: upload:{userId}:{fileMd5}
value: {
    "filename": "大文件.mp4",
    "totalChunks": 5000,
    "uploadedChunks": [0, 1, 2, ..., 1234],
    "expireAt": 1704067200
}
前端每次上传前先查一下这个 key,拿到已上传的分片列表,跳过这些分片继续传。
这个 key 要设过期时间,比如 24 小时,用户传了一半不传了,过期后自动清理分片文件。
清理逻辑可以用 Redis 的 key 过期通知,监听到过期事件后,异步删除对应的分片文件。
秒传的安全隐患
秒传虽然省空间省带宽,但有个安全问题:MD5 碰撞。
两个不同的文件,MD5 有可能一样,概率虽然极低但不是零。
更严重的是,有人故意构造 MD5 碰撞来搞事情。比如我上传一个正常文件,算出 MD5,然后构造一个带病毒的文件,让它的 MD5 跟正常文件一样。别人下载的时候拿到的就是病毒文件。
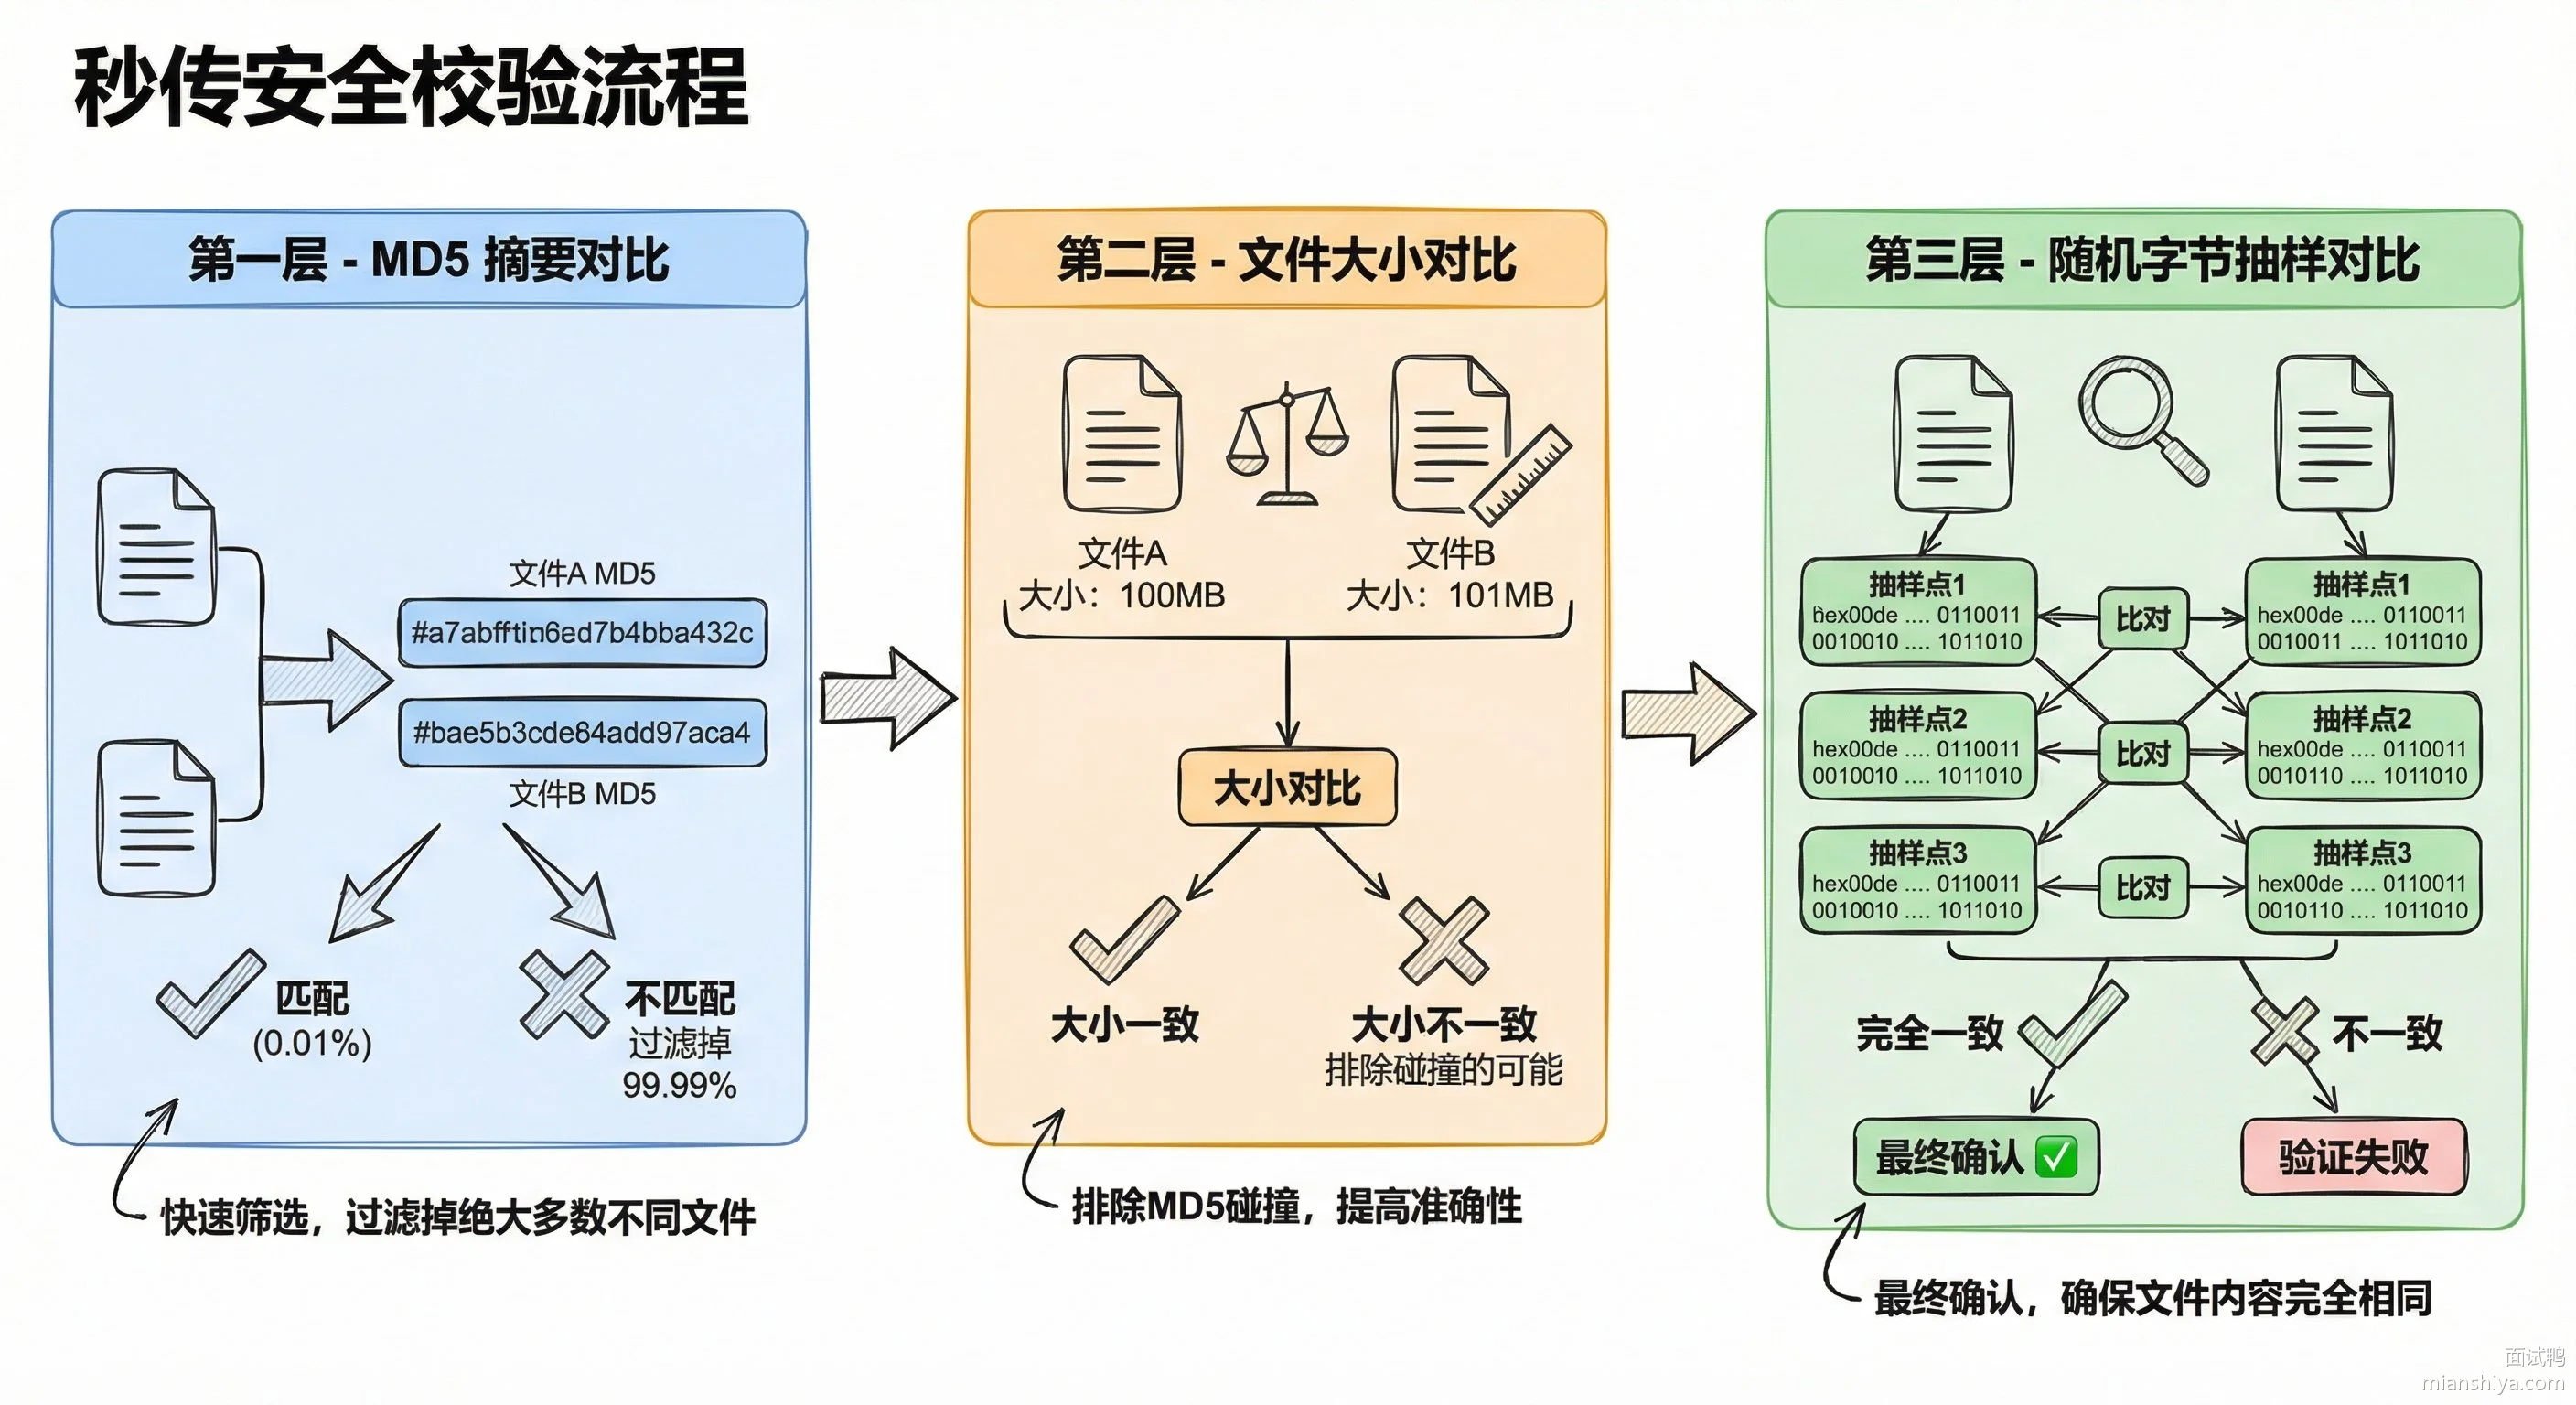
解决方案:
- 用更安全的哈希算法,比如 SHA-256,碰撞难度指数级上升
- 摘要相同时,再对比文件大小,大小不一样肯定不是同一个文件
- 关键文件再抽几个字节对比一下内容
存储选型对比
| 方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 本地磁盘 | 单机小系统 | 简单直接、无网络开销 | 单点故障、扩容麻烦 |
| NFS/NAS | 多机共享 | 多机可访问、运维简单 | 性能瓶颈、带宽占用高 |
| 分布式文件系统 | 海量存储 | 高可用、自动扩容 | 运维复杂、学习成本高 |
| 对象存储 | 通用场景 | 弹性扩容、CDN 加速 | 按量计费、可能成本高 |
小公司直接用阿里云 OSS 或腾讯云 COS,省心省力。大厂自建的话,FastDFS、MinIO、SeaweedFS 都是不错的选择,MinIO 兼容 S3 协议,迁移方便。
限流的多层防护
文件上传的限流要分层做:
网关层用 Nginx 做第一道防线,限制请求体大小、连接数、上传速率:
client_max_body_size 100m;
limit_conn_zone $binary_remote_addr zone=upload_conn:10m;
limit_conn upload_conn 5;  # 单IP最多5个并发上传
limit_rate 1m; # 限速1MB/s应用层用令牌桶或漏桶算法做精细控制。比如用 Guava 的 RateLimiter,限制每秒处理 100 个分片上传请求:
RateLimiter rateLimiter = RateLimiter.create(100);

public void uploadChunk(ChunkRequest request) {
    if (!rateLimiter.tryAcquire(1, TimeUnit.SECONDS)) {
        throw new TooManyRequestsException("上传太频繁,请稍后再试");
    }
    // 处理上传逻辑
}业务层做用户维度的限制,比如普通用户每天最多上传 10 个文件、总量不超过 1GB,VIP 用户放宽限制。这些规则存 Redis,方便动态调整。
常见问题
如果用户上传到一半断网了,重新上传怎么知道从哪个分片继续?
回答:前端上传前先请求一个"查询已上传分片"的接口,带上文件的 MD5。后端从 Redis 查这个文件的上传记录,返回已经成功上传的分片序号列表。前端拿到列表后,只上传缺失的分片就行。这个 Redis key 要设过期时间,用户长时间不传就自动清理掉,释放存储空间。
秒传这个功能,用户 A 上传了一个私密文件,用户 B 能通过秒传拿到吗?
回答:不能,秒传只是存储层面的去重,不是访问权限的共享。用户 B 秒传成功后,数据库里会给他创建一条新的文件记录,指向同一个物理文件,但权限是独立的。用户 A 删除文件只是删他自己的记录,物理文件要等所有引用都删了才会真正删除,这就是引用计数的思路。
分片上传的分片大小设多少合适?有什么讲究?
回答:一般设 2MB 到 5MB 比较合理。太小了分片数量多,HTTP 请求开销大,元数据存储也费空间;太大了单个请求时间长,失败重传代价高,对弱网环境不友好。还要考虑后端的接收 buffer 大小和超时配置,分片大小不能超过这些限制。实际项目里可以做成可配置的,让运维根据网络环境调整。
如果存储服务挂了,正在上传的文件怎么办?
回答:分片上传天然就有一定的容错能力。每个分片上传成功才会更新 Redis 进度,存储挂了分片写入失败,进度不更新,用户重试会从失败的分片继续。关键是存储层要做好多副本或纠删码,单节点挂了数据不丢。如果用对象存储服务,这些高可用能力都是现成的,不用自己操心。
1086. 让你设计一个分布式 ID 发号器,怎么设计?
核心要点
分布式 ID 发号器要解决的核心问题就是:在多机器、多进程环境下生成全局唯一且趋势递增的 ID。
常见的实现方案有两类:
- 雪花算法
- 数据库号段模式
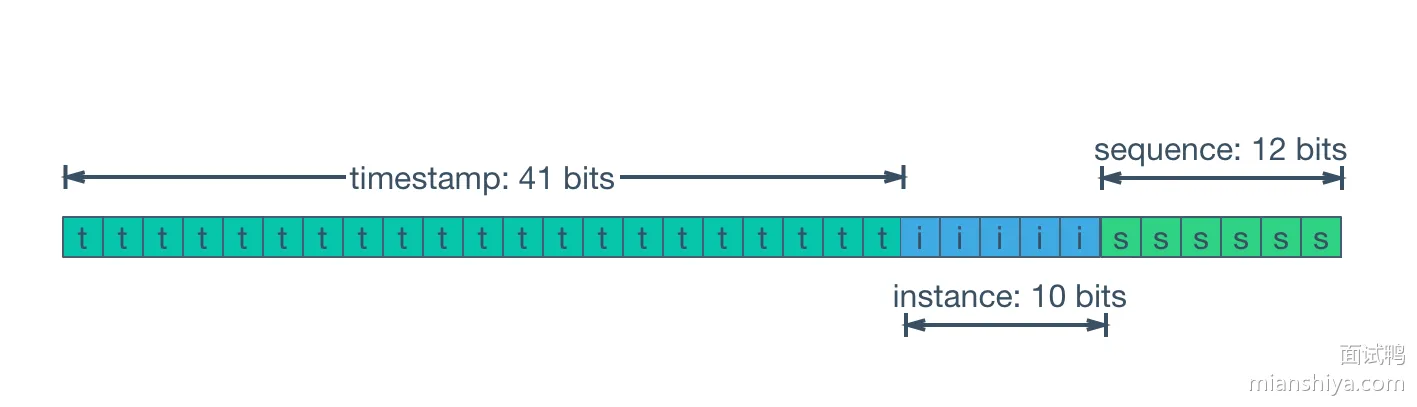
雪花算法的 64 位结构:
- 最高位固定为 0,表示正数
- 接下来 41 位是时间戳,精确到毫秒,可以用 69 年
- 中间 10 位是机器 ID,可以部署 1024 台机器
- 最后 12 位是序列号,同一毫秒内单机可产生 4096 个 ID
雪花算法是本地生成,不依赖外部存储,性能极高。单机每秒能产生几百万个 ID,适合高并发场景。缺点是依赖机器时钟,时钟回拨会导致 ID 重复。
数据库号段模式是预先从数据库批量取一段 ID 缓存在本地,用完再取下一段。
美团的 Leaf、滴滴的 TinyID 都是这个思路。好处是 ID 完全有序,坏处是依赖数据库,数据库挂了就没法发号(当然,数据库挂了整个系统其实全完了)。
扩展知识
基于数据库号段模式实现方案详解
对 MySQL 来说,分布式 ID 直接利用自增 id 即可实现。
REPLACE INTO table(bizTag) VALUES ('order');
select last_insert_id();
将 bizTag 设为唯一索引,可以填写业务值(也可以不同业务多张表)。
REPLACE INTO 执行后自增 ID 会 + 1,通过 last_insert_id 即可获得自增的 ID 。
优点:简单、利用数据库就能实现,且 ID 有序。
缺点:性能不足。
也可以利用
- auto_increment_increment
- auto_increment_offset
实现横向扩展。
比如现在有两台数据库,auto_increment_increment 都设置为 2,即步长是 2。
- 第一台数据库表 auto_increment_offset 设置为 1
- 第二台数据库表 auto_increment_offset 设置为 2
这样一来,第一台的 ID 增长值就是 1、3、5、7、9....,第二台的 ID 增加值就是 2、4、6、8、10....
这样也能保证全局唯一性,多加几台机器弥补性能问题,只要指定好每个表的步长和初始值即可。
不过单调递增特性没了,且加机器的成本不低,动态扩容很不方便。
这里我们可以思考下,每次操作数据库就拿一个 ID ,我们如果一次性拿 1000 个,那不就大大减少操作数据库的次数了吗?性能不就上去了吗?
重新设计下表,主要字段如下:
- bizTag: 业务标识
- maxId: 目前已经分配的最大 ID
- step: 步长,可以设置为 1000 那么每次就是拿 1000 ,设置成 1w 就是拿 1w 个
每次来获取 ID 的 SQL 如下:
UPDATE table SET maxId = max_id + step WHERE bizTag = xxx
SELECT maxId, step FROM table WHERE biz_tag = xxx
假设 step 是 1000,执行完 SQL 拿到 max_id 是 5000,那这台机器就可以发 4001 到 5000 这一千个 ID,用完再去取下一批。
这就是号段模式的核心:批量思想,一次从数据库取一批 ID 缓存到本地,避免每次都访问数据库。
到这里可能对方会追问,假设业务并发量很高,此时业务方一批 ID 刚好用完后,来获取下一批 ID ,因为当前数据库压力大,很可能就会产生性能抖动,即卡了一下才拿到 ID,从监控上看就是产生毛刺。
这样怎么处理?
其实这就是考察你是否有预处理思想,如果你看过很多开源组件就会发现预处理的场景很多,例如 RocketMQ commitlog 文件的分配就是预处理,即当前 commitlog 文件用完之前,就会有后台线程预先创建后面要用的文件,就是为了防止创建的那一刻的性能抖动。
同理,这个场景我们也可以使用预处理思想。
美团 Leaf 用双 Buffer 解决这个问题:
双 Buffer 工作流程:
- 发号服务维护两个号段 buffer,比如 buffer1 和 buffer2
- 业务请求从 buffer1 取号
- 当 buffer1 使用量超过 20%,后台线程异步加载下一批号段到 buffer2
- buffer1 用完后切换到 buffer2 继续发号
- buffer2 使用超过 20% 时,又去预加载到 buffer1
- 两个 buffer 交替使用,业务永远不会等待数据库
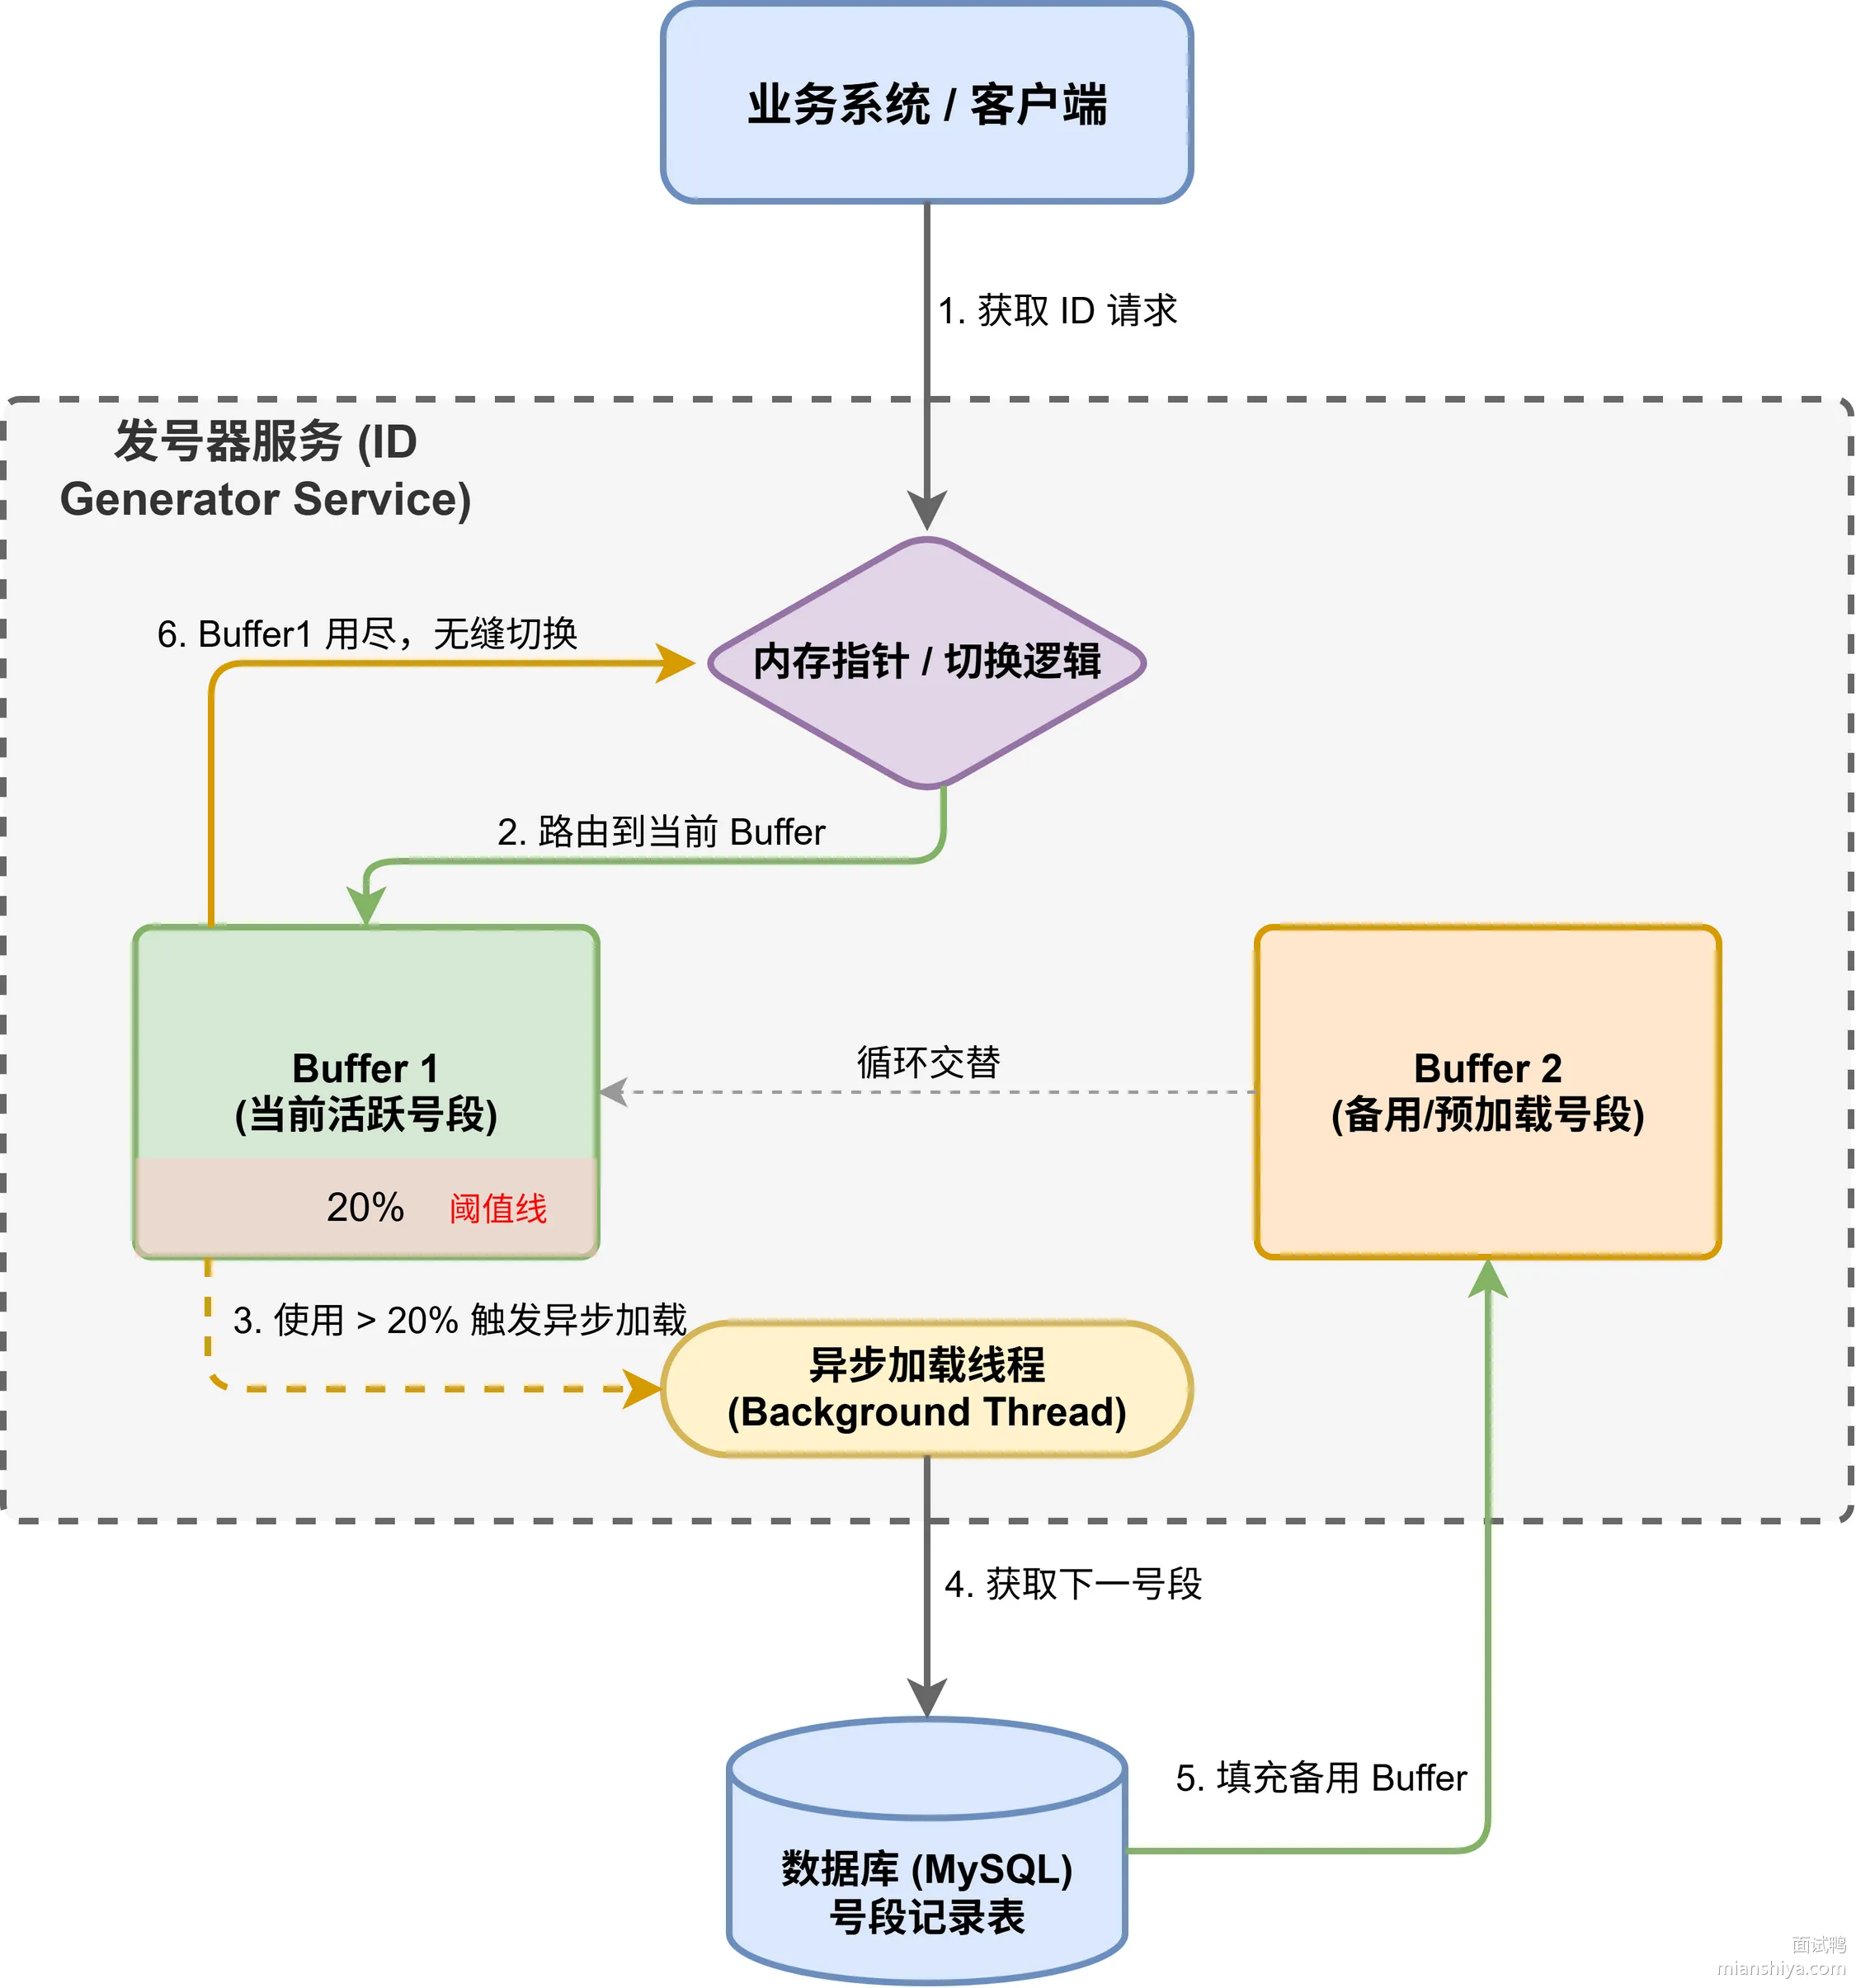
ID 安全性问题
数据库号段模式生成的 ID 是严格连续的,这会暴露业务信息。竞争对手早上下一单拿到订单号 10001,晚上下一单拿到 10500,一减就知道你今天卖了 499 单。
解决方案:
1)最后几位加随机数:比如 ID 后两位用随机数填充,10001 变成 1000137,外人看不出规律
2)ID 加密:用 AES 或自定义算法把 ID 加密后再给外部,内部存储还是用原始 ID
3)混合 UUID:对外展示的 ID 用 UUID,内部用自增 ID,两者做映射
订单号、文章 ID 这种对外暴露的标识,一定要考虑安全性,不然容易被爬虫按序遍历。
UUID 为什么不适合做数据库主键
很多人第一反应是用 UUID,本地就能生成,简单得很。
但 UUID 做数据库主键问题很大:
- 太长了,36 个字符,存储空间是 bigint 的好几倍,索引也更占空间
- 完全无序,插入时会导致 B+ 树频繁分裂,页分裂会产生大量随机 IO,写入性能能差一个数量级
- 可读性差,排查问题时看着一堆乱码很头疼
所以 UUID 只适合做业务上的唯一标识,比如文件名、幂等 key 这种,不适合做数据库主键。
雪花算法的机器 ID 分配
雪花算法的机器 ID 怎么保证不重复是个实际问题。容器化部署后机器都是动态扩缩容的,写死配置文件肯定不行。
常见的动态分配方案:
1)Redis 自增:服务启动时调用 INCR machine_id_counter,拿到的值就是机器 ID。Redis 单线程执行,天然保证不重复。
2)ZooKeeper 顺序节点:启动时创建临时顺序节点 /snowflake/machine_,ZK 返回的节点序号就是机器 ID。服务挂了节点自动删除,不会占用 ID。
3)数据库自增表:和 Redis 思路一样,但需要处理数据库挂掉的情况。
美团 Leaf 用的是 ZooKeeper 方案,Hutool 工具类默认用 MAC 地址和进程 ID 算一个 hash 值,小项目够用了。
时钟回拨的应对策略
雪花算法最怕时钟回拨。NTP 时间同步、服务器运维调整时间、虚拟机休眠恢复,都可能导致时钟往回跳。
常见解决策略:
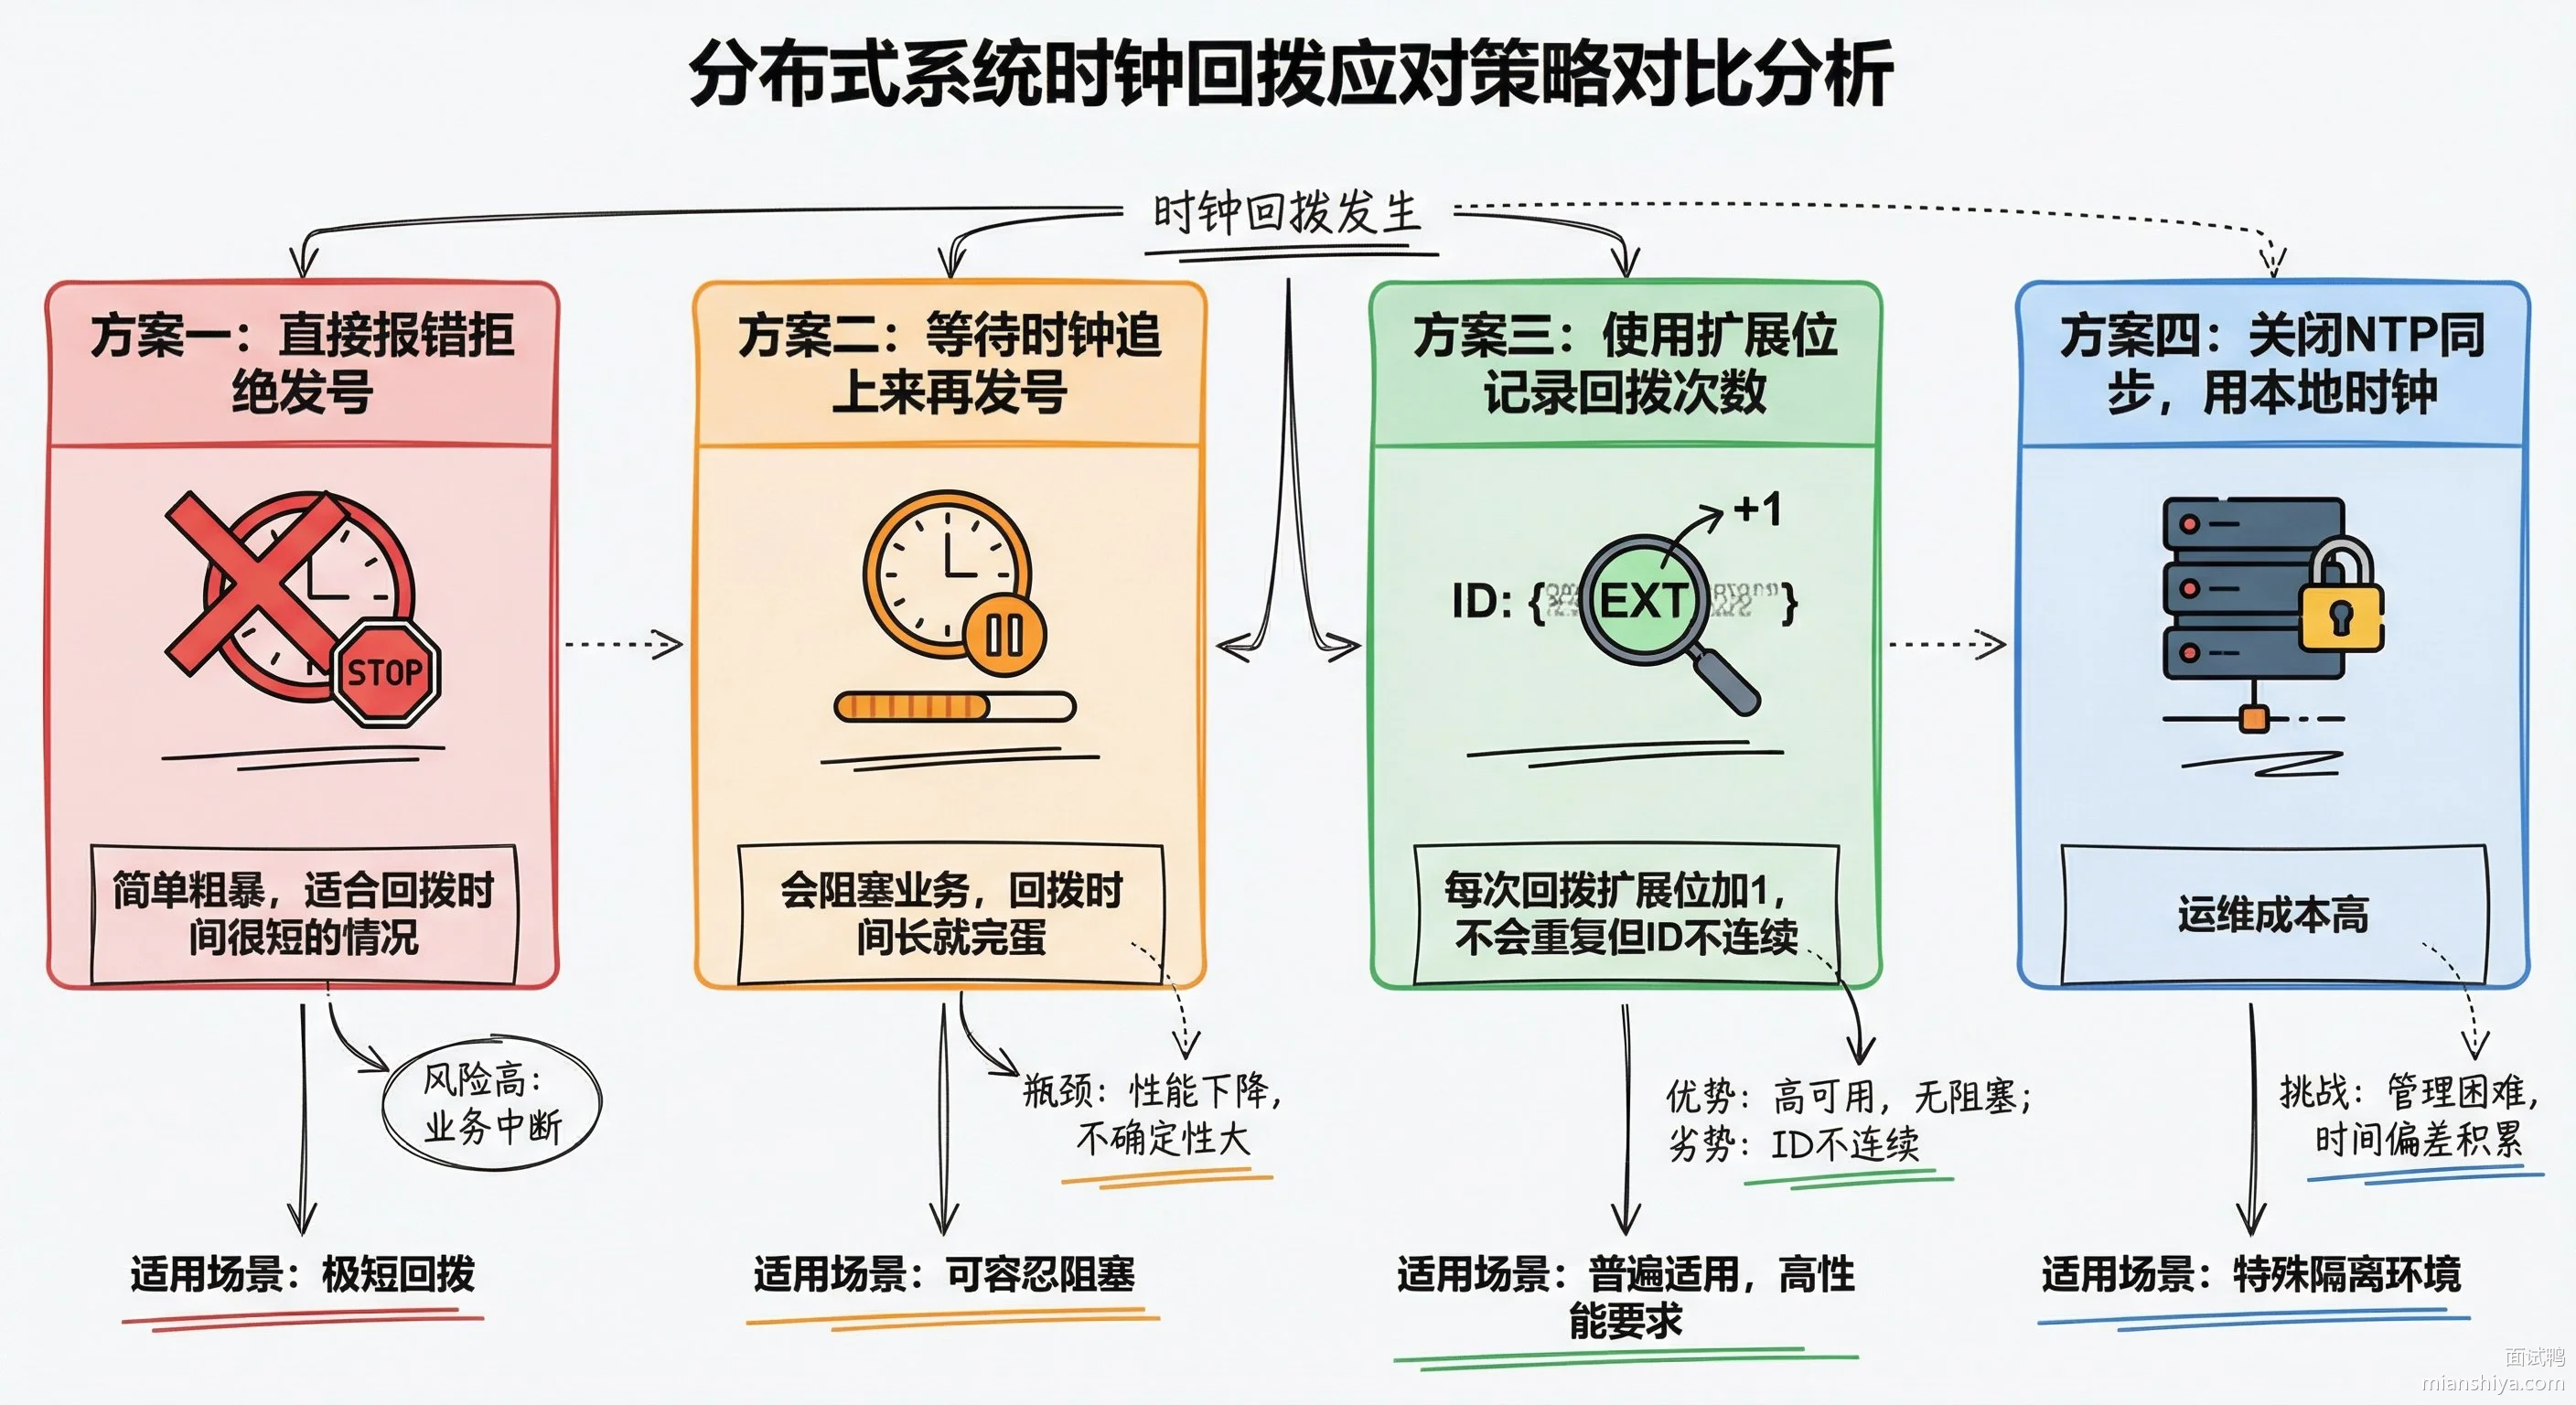
实际生产中,百度 UidGenerator 的做法比较聪明:在启动时获取时间戳,后续用单调递增的计数器模拟"时间流逝",跟当前时间完全解耦。
从根本上规避了时钟回拨问题。
各方案对比
| 方案 | 性能 | 有序性 | 依赖 | 适用场景 |
|---|---|---|---|---|
| UUID | 极高 | 无序 | 无 | 幂等 key、文件名 |
| 雪花算法 | 极高 | 趋势递增 | 时钟 | 高并发分布式系统 |
| 数据库自增 | 低 | 严格递增 | 数据库 | 单机小系统 |
| 数据库号段 | 高 | 趋势递增 | 数据库 | 通用分布式系统 |
| Redis INCR | 高 | 严格递增 | Redis | 中等并发场景 |
大厂一般雪花算法和号段模式都用,根据业务场景选择。对 ID 连续性要求高的用号段模式,纯粹追求性能的用雪花算法。
常见问题
雪花算法的机器 ID 如果用完了怎么办?10 位只能表示 1024 台机器
回答:实际上 1024 台机器同时发号的场景很少见。如果真不够用,可以从序列号那 12 位借几位过来,比如机器 ID 用 13 位就能表示 8192 台机器,代价是单机每毫秒的发号量从 4096 降到 512。另一个思路是机器 ID 做动态回收,服务下线后把 ID 还回去,新服务上线复用这个 ID。
数据库号段模式,数据库挂了怎么办?
回答:本地缓存还有没用完的号段,短时间能扛住。关键是 step 要设大一点,比如设成 QPS 峰值的 600 倍,至少有 10 分钟缓冲。数据库本身要做主从高可用,主库挂了切从库。切换后要注意 max_id 可能因为复制延迟变小了,发号服务要记录上次取到的 max_id,发现变小就再执行一次 update 把它追上来。
雪花算法生成的 ID,能反推出生成时间吗?
回答:能,把 ID 右移 22 位就得到时间戳部分,加上起始时间戳就是生成时间。这也是个安全隐患,别人拿到你的订单 ID 就能知道下单时间,甚至能推算出你的业务量级。如果介意可以对时间戳部分做一些混淆,比如异或一个固定值。
如果让你设计,你会选哪个方案?
回答:看业务场景。如果是纯后端系统、对性能要求极高、能接受少量 ID 浪费,我选雪花算法,本地生成没有网络开销,抗住几百万 QPS 不是问题。如果 ID 要对外暴露、需要严格递增、对安全性有要求,我选号段模式加上 ID 混淆,美团 Leaf 这套方案很成熟,直接拿来用就行。
1190. 什么是限流?限流算法有哪些?怎么实现的?
核心要点
限流就是限制到达系统的并发请求数,让系统只处理能力范围内的请求,超出的直接拒绝或排队。
本质上是在用户体验和系统稳定性之间做权衡。
常见的限流算法有四种:计数器、滑动窗口、漏桶、令牌桶。
四种限流算法的核心思想:
- 计数器:维护一个计数器,请求来了加一,窗口结束后计数重置为零,超过阈值就拒绝
- 滑动窗口:记录时间窗口内每个请求的时间点,统计窗口内请求数是否超限
- 漏桶:请求先进桶排队,服务端定速从桶里取请求处理,桶满则拒绝
- 令牌桶:定速往桶里放令牌,请求来了先拿令牌,拿到才能通过,拿不到就拒绝
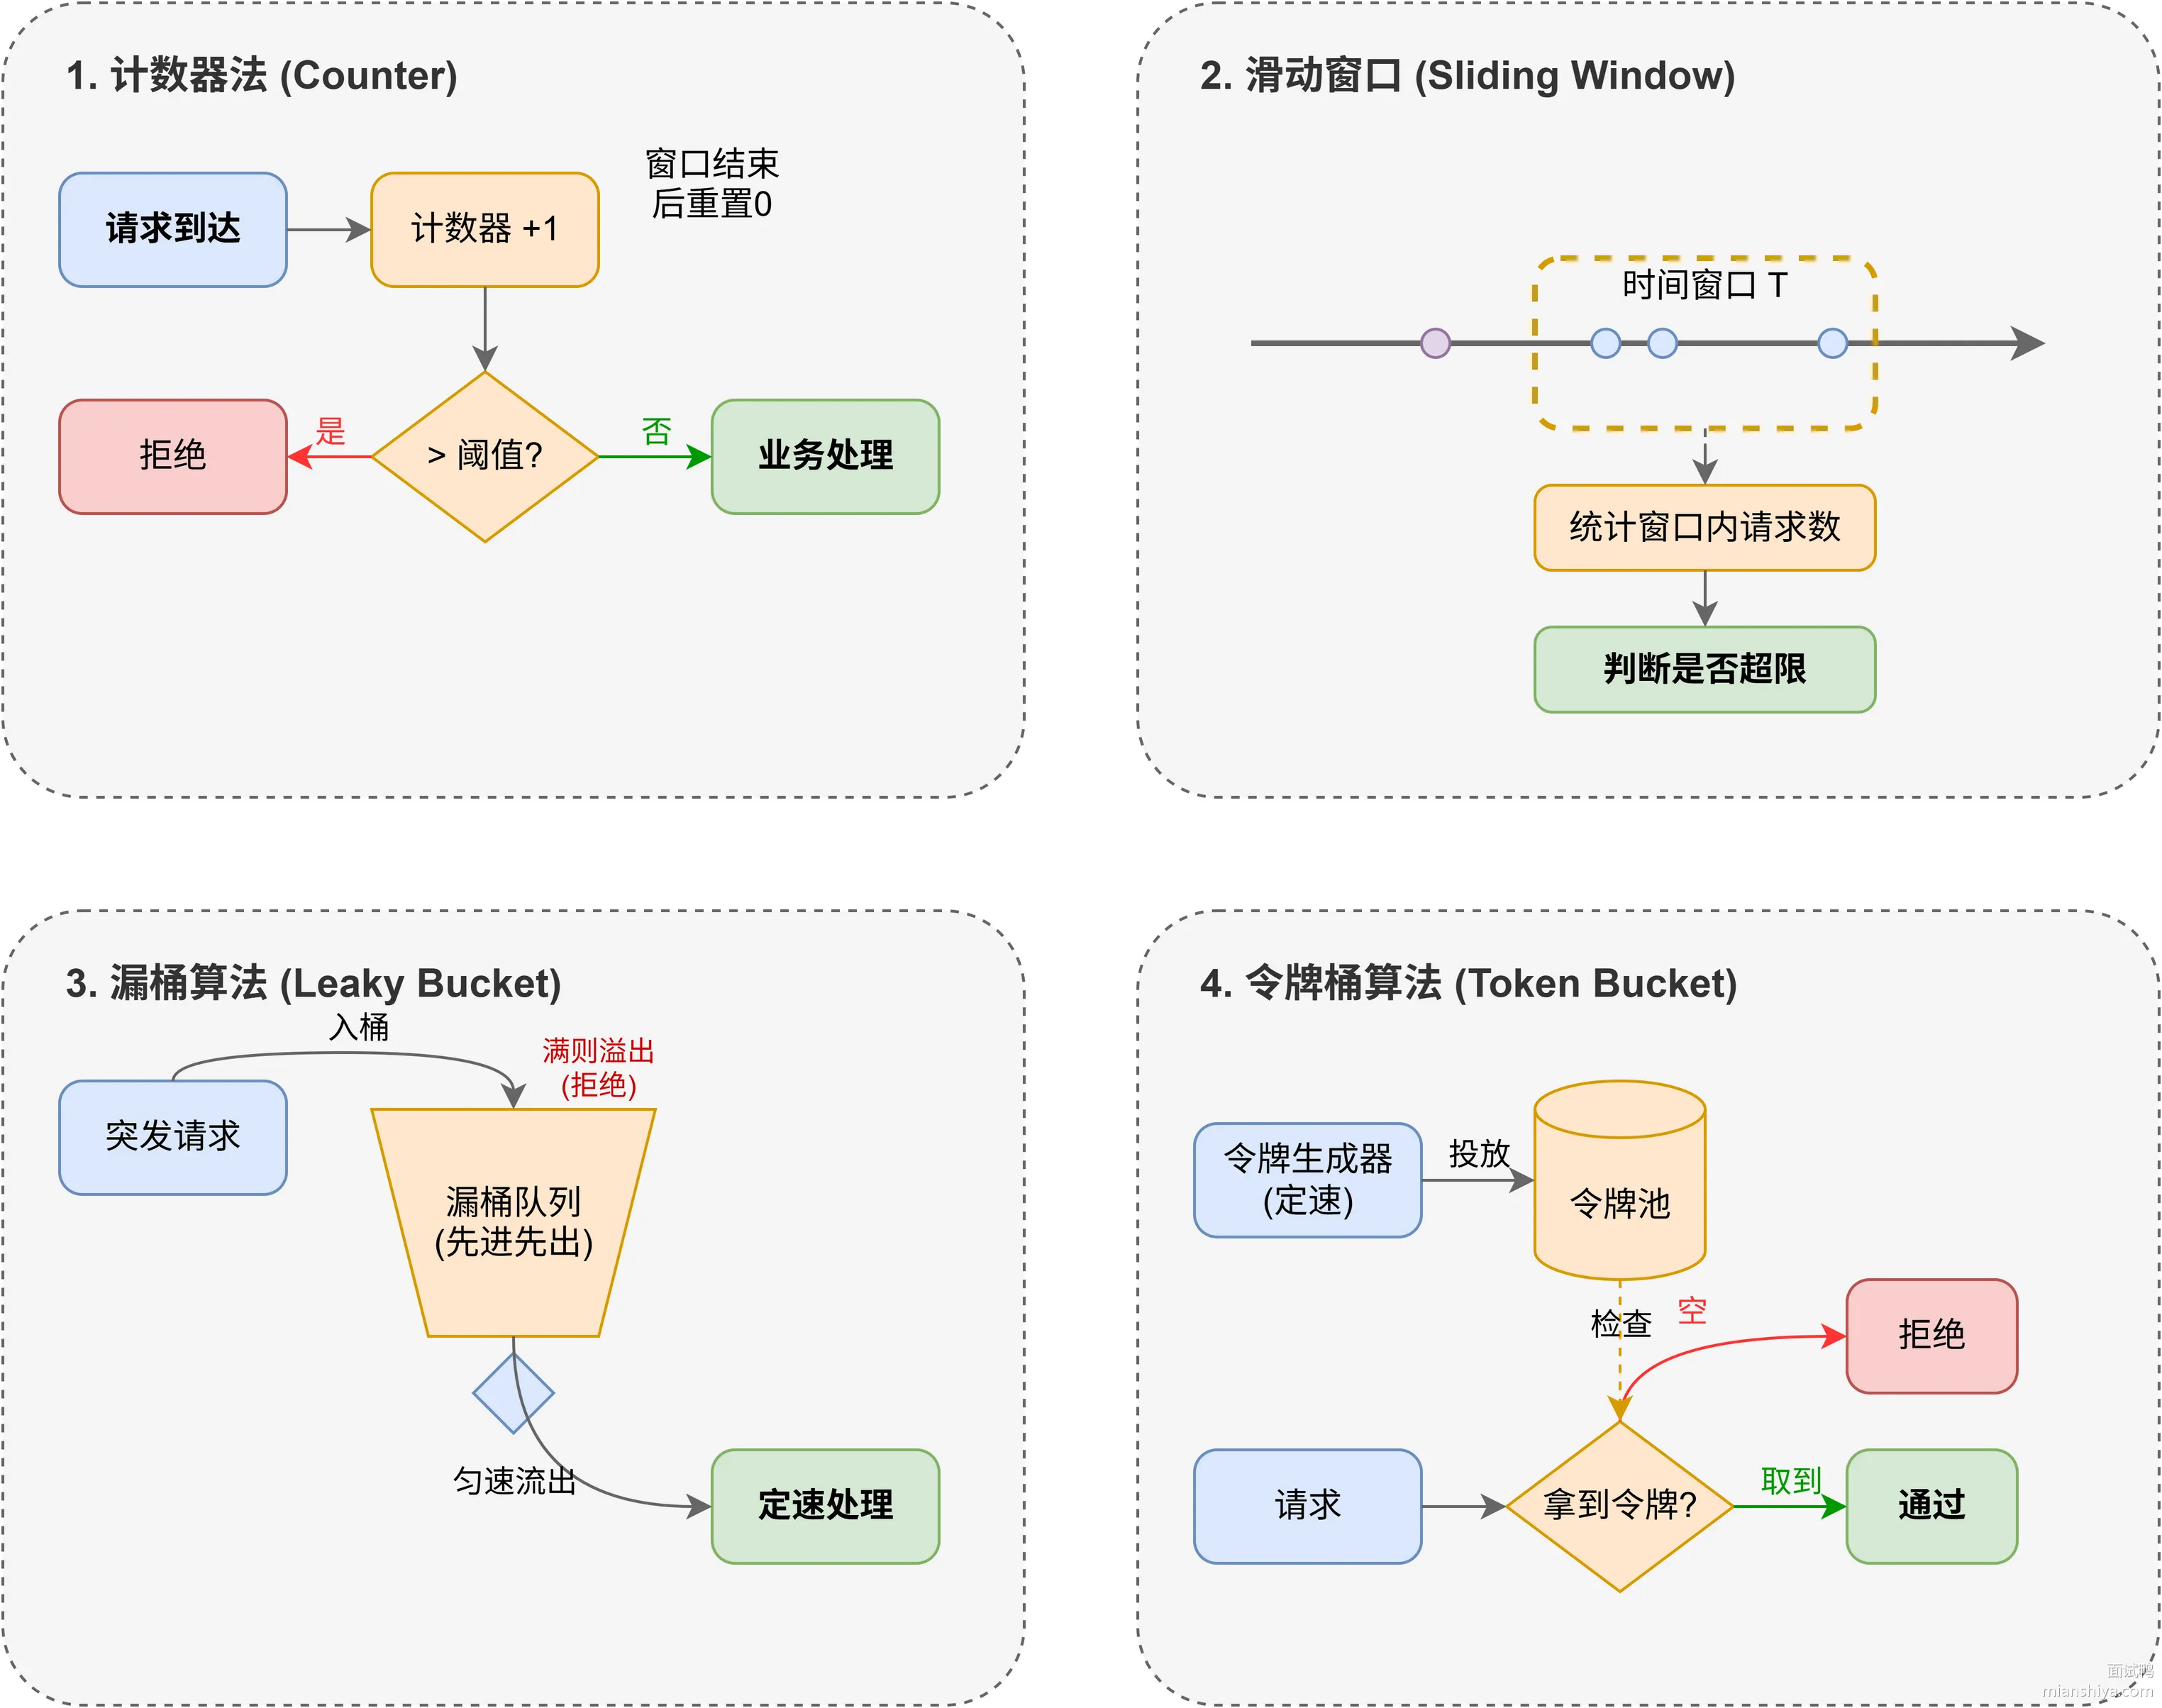
计数器最简单,Java 里用 AtomicInteger 就能实现单机限流,放 Redis 里就是分布式限流。缺点是无法应对突发流量,1 万个请求一瞬间涌进来,计数器还没超限但系统已经被打爆了。
滑动窗口解决了固定窗口的临界问题,能保证任意时间窗口内请求数不超限。代价是要记录每个请求的时间戳,内存占用比较大。
漏桶的特点是宽进严出,不管请求来得多猛,出去的速度是恒定的。优点是流量极其平滑,缺点是没法应对突发流量,明明系统有余力也只能慢慢处理。
令牌桶是定速往桶里放令牌,桶里有令牌就能处理请求。突发流量来了,桶里攒了 100 个令牌,这 100 个请求可以瞬间通过,比漏桶更灵活。Guava 的 RateLimiter 就是令牌桶实现的。
扩展知识
限流是什么?
首先来解释下什么是限流?
在日常生活中限流很常见,例如去有些景区玩,每天售卖的门票数是有限的,例如 2000 张,即每天最多只有 2000 个人能进去游玩。
那在我们工程上限流是什么呢?限制的是 「流」,在不同场景下「流」的定义不同,可以是每秒请求数、每秒事务处理数、网络流量等等。
而通常我们说的限流指代的是 限制到达系统的并发请求数,使得系统能够正常的处理 部分 用户的请求,来保证系统的稳定性。
限流不可避免的会造成用户的请求变慢或者被拒的情况,从而会影响用户体验。
因此限流是需要在用户体验和系统稳定性之间做平衡的,即我们常说的 trade off。
对了,限流也称流控(流量控制)。
为什么要限流?
前面,我们提到限流是为了保证系统的稳定性。
日常的业务上有类似秒杀活动、双十一大促或者突发新闻等场景,用户的流量突增,后端服务的处理能力是有限的,如果不能处理好突发流量,后端服务很容易就被打垮。
亦或是爬虫等不正常流量,我们对外暴露的服务都要以最大恶意去防备调用者。
我们不清楚调用者会如何调用我们的服务,假设某个调用者开几十个线程一天二十四小时疯狂调用你的服务,如果不做啥处理咱服务也算完了,更胜的还有DDos攻击。
还有对于很多第三方开放平台来说,不仅仅要防备不正常流量,还要保证资源的公平利用,一些接口都免费给你用了,资源都不可能一直都被你占着吧,别人也得调的。
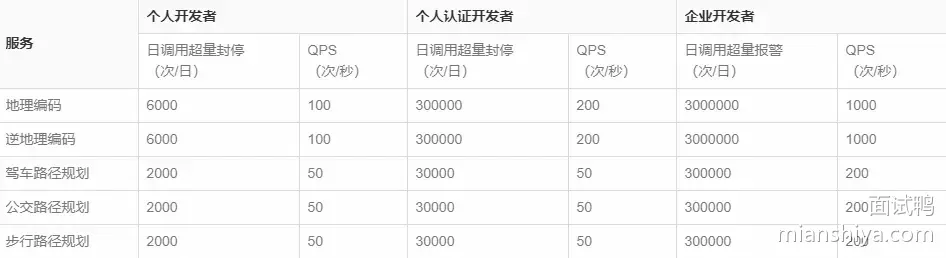
当然加钱的话好商量。
小结一下
限流的本质是因为后端处理能力有限,需要截掉超过处理能力之外的请求,亦或是为了均衡客户端对服务端资源的公平调用,防止一些客户端饿死。
计数限流
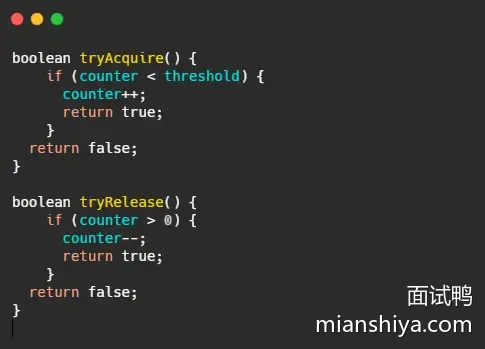
最简单的限流算法就是计数限流了。
例如系统能同时处理 100 个请求,保存一个计数器,处理了一个请求,计数器就加一,一个请求处理完毕之后计数器减一。
每次请求来的时候看看计数器的值,如果超过阈值就拒绝。
非常简单粗暴,计数器的值要是存内存中就算单机限流算法。
如果放在第三方存储里,例如 Redis 中,集群机器访问就算分布式限流算法。
优点就是:简单粗暴,单机在 Java 中可用 Atomic 等原子类、分布式就 Redis incr。
缺点就是:假设我们允许的阈值是1万,此时计数器的值为 0, 当 1 万个请求在前 1 秒内一股脑儿的都涌进来,这突发的流量可是顶不住的。
缓缓地增加流量处理和一下子涌入对于程序来说是不一样的。
而且一般的限流都是为了限制在指定时间间隔内的访问量,因此还有个算法叫固定窗口。
固定窗口限流
它相比于计数限流主要是多了个时间窗口的概念,计数器每过一个时间窗口就重置。 规则如下:
- 请求次数小于阈值,允许访问并且计数器 +1;
- 请求次数大于阈值,拒绝访问;
- 这个时间窗口过了之后,计数器清零;
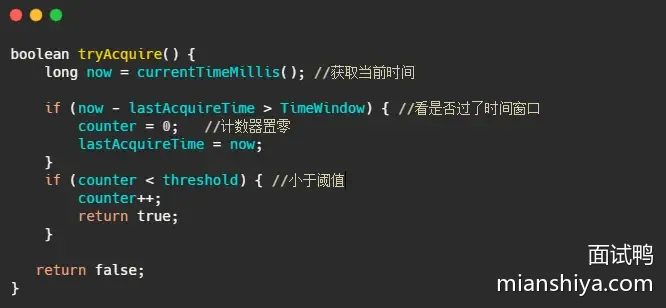
看起来好像很完美,实际上还是有缺陷的。
固定窗口临界问题
假设系统每秒允许 100 个请求,假设第一个时间窗口是 0-1s,在第 0.55s 处一下次涌入 100 个请求,过了 1 秒的时间窗口后计数清零,此时在 1.05 s 的时候又一下次涌入100个请求。
虽然窗口内的计数没超过阈值,但是全局来看在 0.55s-1.05s 这 0.5 秒内涌入了 200 个请求,这其实对于阈值是 100/s 的系统来说是无法接受的。
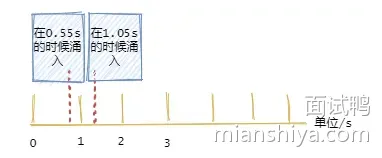
为了解决这个问题引入了滑动窗口限流。
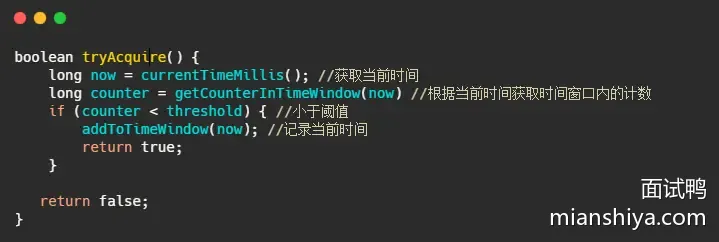
滑动窗口限流
滑动窗口限流解决固定窗口临界值的问题,可以保证在任意时间窗口内都不会超过阈值。
相对于固定窗口,滑动窗口除了需要引入计数器之外还需要记录时间窗口内每个请求到达的时间点,因此对内存的占用会比较多。
规则如下,假设时间窗口为 1 秒:
- 记录每次请求的时间
- 统计每次请求的时间 至 往前推1秒这个时间窗口内请求数,并且 1 秒前的数据可以删除。
- 统计的请求数小于阈值就记录这个请求的时间,并允许通过,反之拒绝。
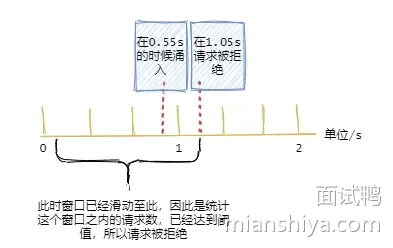
但是滑动窗口和固定窗口都无法解决短时间之内集中流量的突击。
我们所想的限流场景是:
每秒限制 100 个请求。希望请求每 10ms 来一个,这样我们的流量处理就很平滑,但是真实场景很难控制请求的频率,因此可能存在 5ms 内就打满了阈值的情况。
当然对于这种情况还是有变型处理的,例如设置多条限流规则。不仅限制每秒 100 个请求,再设置每 10ms 不超过 2 个。
再多说一句,这个滑动窗口可与TCP的滑动窗口不一样。
TCP的滑动窗口是接收方告知发送方自己能接多少“货”,然后发送方控制发送的速率。
接下来再说说漏桶,它可以解决时间窗口类的痛点,使得流量更加平滑。
漏桶算法
如下图所示,水滴持续滴入漏桶中,底部定速流出。
如果水滴滴入的速率大于流出的速率,当存水超过桶的大小的时候就会溢出。
规则如下:
- 请求来了放入桶中
- 桶内请求量满了拒绝请求
- 服务定速从桶内拿请求处理
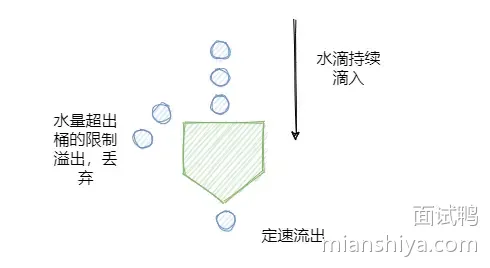
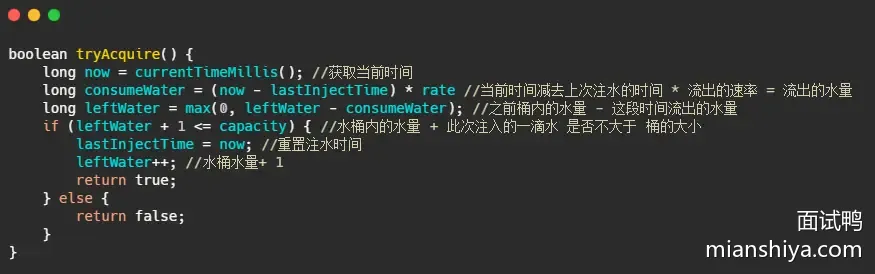
可以看到水滴对应的就是请求。
它的特点就是宽进严出,无论请求多少,请求的速率有多大,都按照固定的速率流出,对应的就是服务按照固定的速率处理请求。
看到这想到啥,是不是和消息队列思想有点像,削峰填谷。
一般而言漏桶也是由队列来实现的,处理不过来的请求就排队,队列满了就开始拒绝请求。
看到这又想到啥,线程池不就是这样实现的嘛?
经过漏桶这么一过滤,请求就能平滑的流出,看起来很像很挺完美的?实际上它的优点也即缺点。
面对突发请求,服务的处理速度和平时是一样的,这其实不是我们想要的。
在面对突发流量我们希望在系统平稳的同时,提升用户体验即能更快的处理请求,而不是和正常流量一样,循规蹈矩的处理(看看,之前滑动窗口说流量不够平滑,现在太平滑了又不行,难搞啊)。
而令牌桶在应对突击流量的时候,可以更加的“激进”。
令牌桶算法
令牌桶其实和漏桶的原理类似,只不过漏桶是定速地流出,而令牌桶是定速地往桶里塞入令牌,然后请求只有拿到了令牌才能通过,之后再被服务器处理。
当然令牌桶的大小也是有限制的,假设桶里的令牌满了之后,定速生成的令牌会丢弃。
规则:
- 定速的往桶内放入令牌
- 令牌数量超过桶的限制,丢弃
- 请求来了先向桶内索要令牌,索要成功则通过被处理,反之拒绝
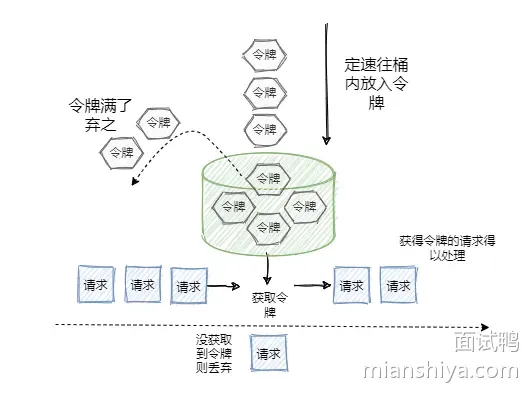
看到这又想到什么?Semaphore 信号量啊,信号量可控制某个资源被同时访问的个数,其实和咱们拿令牌思想一样,一个是拿信号量,一个是拿令牌。
只不过信号量用完了返还,而咱们令牌用了不归还,因为令牌会定时再填充。
再来看看令牌桶的伪代码实现,可以看出和漏桶的区别就在于一个是加法,一个是减法。
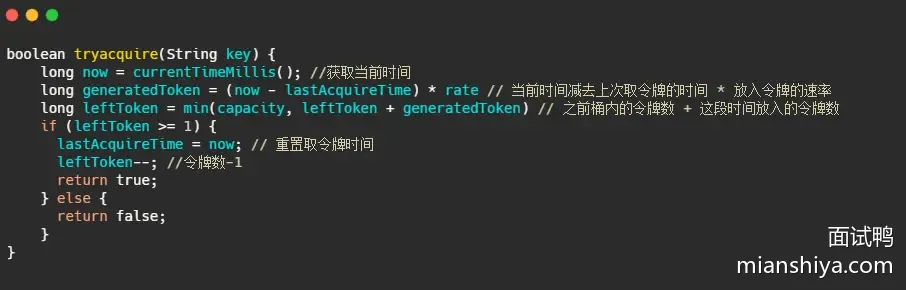
可以看出令牌桶在应对突发流量的时候,桶内假如有 100 个令牌,那么这 100 个令牌可以马上被取走,而不像漏桶那样匀速的消费。所以在应对突发流量的时候令牌桶表现的更佳。
小结令牌桶算法的优点
1)平滑的流量控制:令牌桶算法能够平滑处理请求流量,避免了突发流量对系统造成的冲击。
2)突发流量处理:由于桶的容量可以缓冲突发流量,系统可以在短时间内处理更多的请求,而不会立即拒绝。
令牌桶算法使用时的注意点
1)桶容量的配置:
- 如果桶的容量设置过小,可能会导致系统频繁地拒绝请求,从而影响用户体验。
- 如果桶的容量设置过大,可能会导致系统在短时间内处理过多的请求,从而增加系统负担。
2)令牌生成速率:
- 令牌生成速率需要根据实际需求进行调整。如果速率设置过低,可能无法满足用户的请求;如果速率设置过高,可能会导致系统负担过重。
限流算法小结
上面所述的算法其实只是这些算法最粗略的实现和最本质的思想,在工程上其实还是有很多变型的。
从上面看来好像漏桶和令牌桶比时间窗口算法好多了,那时间窗口算法有什么用?
并不是的,虽然漏桶和令牌桶对比时间窗口对流量的整形效果更佳,流量更加得平滑,但是也有各自的缺点(上面已经提到了一部分)。
拿令牌桶来说,假设你没预热,那是不是上线时候桶里没令牌?没令牌请求过来不就直接拒了么?
这就误杀了,明明系统没啥负载现在。
再比如说请求的访问其实是随机的,假设令牌桶每20ms放入一个令牌,桶内初始没令牌,这请求就刚好在第一个20ms内有两个请求,再过20ms里面没请求,其实从40ms来看只有2个请求,应该都放行的,而有一个请求就直接被拒了。
这就有可能造成很多请求的误杀,但是如果看监控曲线的话,好像流量很平滑,峰值也控制的很好。
再拿漏桶来说,漏桶中请求是暂时存在桶内的,这其实不符合互联网业务低延迟的要求。
所以漏桶和令牌桶其实比较适合阻塞式限流场景,即没令牌我就等着,这样就不会误杀了,而漏桶本就是等着,比较适合后台任务类的限流。
而基于时间窗口的限流比较适合对时间敏感的场景,请求过不了您就快点儿告诉我,等的花儿都谢了。
单机限流和分布式限流
本质上单机限流和分布式限流的区别其实就在于 “阈值” 存放的位置。
单机限流就上面所说的算法直接在单台服务器上实现就好了,而往往我们的服务是集群部署的。
因此需要多台机器协同提供限流功能。
像上述的计数器或者时间窗口的算法,可以将计数器存放至 Redis 等分布式 K-V 存储中。
例如滑动窗口的每个请求的时间记录可以利用 Redis 的 zset 存储,利用ZREMRANGEBYSCORE 删除时间窗口之外的数据,再用 ZCARD计数。
像令牌桶也可以将令牌数量放到 Redis 中。
不过这样的方式等于每一个请求我们都需要去Redis判断一下能不能通过,在性能上有一定的损耗。
所以有个优化点就是 「批量获取」,每次取令牌不是一个一取,而是取一批,不够了再去取一批,这样可以减少对 Redis 的请求。
不过要注意一点,批量获取会导致一定范围内的限流误差。比如你取了 10 个此时不用,等下一秒再用,那同一时刻集群机器总处理量可能会超过阈值。
其实「批量」这个优化点太常见了,不论是 MySQL 的批量刷盘,还是 Kafka 消息的批量发送还是分布式 ID 的高性能发号,都包含了「批量」的思想。
当然,分布式限流还有一种思想是平分,假设之前单机限流 500,现在集群部署了 5 台,那就让每台继续限流 500 呗,即在总的入口做总的限流限制,然后每台机子再自己实现限流。
限流的难点
可以看到,每个限流都有个阈值,这个阈值如何定是个难点。
定大了服务器可能顶不住,定小了就“误杀”了,没有资源利用最大化,对用户体验不好。
我能想到的就是限流上线之后先预估个大概的阈值,然后不执行真正的限流操作,而是采取日志记录方式,对日志进行分析查看限流的效果,然后调整阈值,推算出集群总的处理能力,和每台机子的处理能力(方便扩缩容)。
然后将线上的流量进行重放,测试真正的限流效果,最终阈值确定,然后上线。
我之前还看过一篇耗子叔的文章,讲述了在自动化伸缩的情况下,我们要动态地调整限流的阈值很难。
于是基于TCP拥塞控制的思想,根据请求响应在一个时间段的响应时间P90或者P99值来确定此时服务器的健康状况,来进行动态限流。在他的 Ease Gateway 产品中实现了这套算法,有兴趣的同学可以自行搜索。
其实真实的业务场景很复杂,需要限流的条件和资源很多,每个资源限流要求还不一样。
限流组件
一般而言,我们不需要自己实现限流算法来达到限流的目的,不管是接入层限流还是细粒度的接口限流,都有现成的轮子使用,其实现也是用了上述我们所说的限流算法。
比如Google Guava 提供的限流工具类 RateLimiter,是基于令牌桶实现的,并且扩展了算法,支持预热功能。
阿里开源的限流框架 Sentinel 中的匀速排队限流策略,就采用了漏桶算法。
Nginx 中的限流模块 limit_req_zone,采用了漏桶算法,还有 OpenResty 中的 resty.limit.req库等等。
具体的使用还是很简单的,有兴趣的同学可以自行搜索,对内部实现感兴趣的同学可以下个源码看看,学习下生产级别的限流是如何实现的。
常见问题
令牌桶算法,系统刚启动的时候桶里没令牌,请求不是直接被拒了吗?
回答:取决于使用方式。Guava RateLimiter 的 acquire() 是阻塞的,不会拒绝请求。如果用 tryAcquire() 且需要避免冷启动失败,可以在启动时预填充令牌,或设置宽限期不做限流。注意:SmoothWarmingUp 模式虽然启动时令牌满,但其目的是让预热期限流更严格(保护系统),不是解决冷启动被拒的问题。
滑动窗口要记录每个请求的时间戳,请求量大了内存扛不住怎么办?
回答:可以做近似处理。把时间窗口切成若干个小格子,比如 1 秒切成 10 个 100ms 的格子,每个格子只记录请求数而不是每个请求的时间戳。滑动的时候丢弃过期的格子,加上新格子。这样内存占用是固定的,只跟格子数量有关,跟请求量无关。精度会有一点损失,但大多数场景够用了。
限流和熔断有什么区别?
回答:限流是主动控制流入量,不管下游状态如何,超过阈值就拒绝。熔断是被动保护机制,发现下游服务出问题了,比如超时率或错误率超过阈值,就暂时停止调用下游,快速失败。打个比方,限流像门口保安,人太多就不让进了。熔断像电路保险丝,下游短路了就自动断开,防止把自己也烧了。两者经常配合使用,Sentinel 里都有。
如果限流组件本身挂了怎么办?
回答:要看限流是用来保护自己还是保护下游。如果是保护自己,限流组件挂了可以降级为不限流,让请求直接通过,至少业务还能跑。如果是保护下游,比如调用第三方接口有频率限制,限流组件挂了就要降级为全部拒绝,宁可业务不可用也不能把下游打挂导致被封禁。具体策略要看业务场景,关键是提前想好降级方案并做好监控告警。
4945. 即时通讯项目中怎么实现历史消息的下拉分页加载?
核心要点
下拉分页加载本质上是增量加载,每次下拉请求一小部分新数据追加到已有列表里,形成无限滚动的效果。
核心实现方案是游标分页,而不是传统的基于页码或偏移量的分页。
传统分页的问题在于数据会变。
用户在聊天室里持续收到新消息,如果按偏移量分页,第一页查了第 1-5 条,正准备查第二页的第 6-10 条
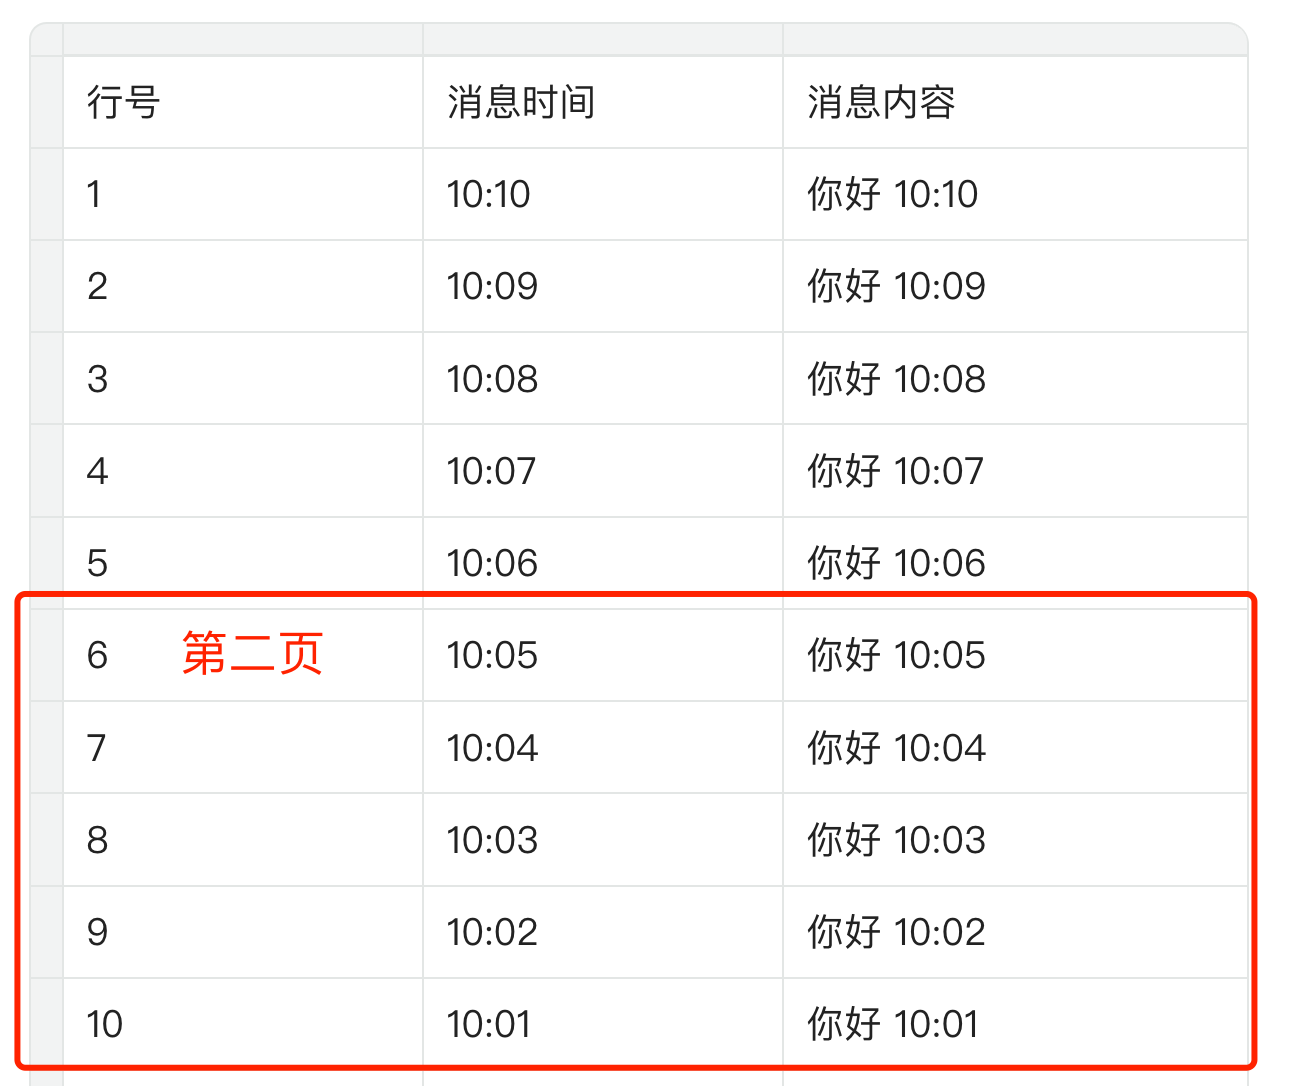
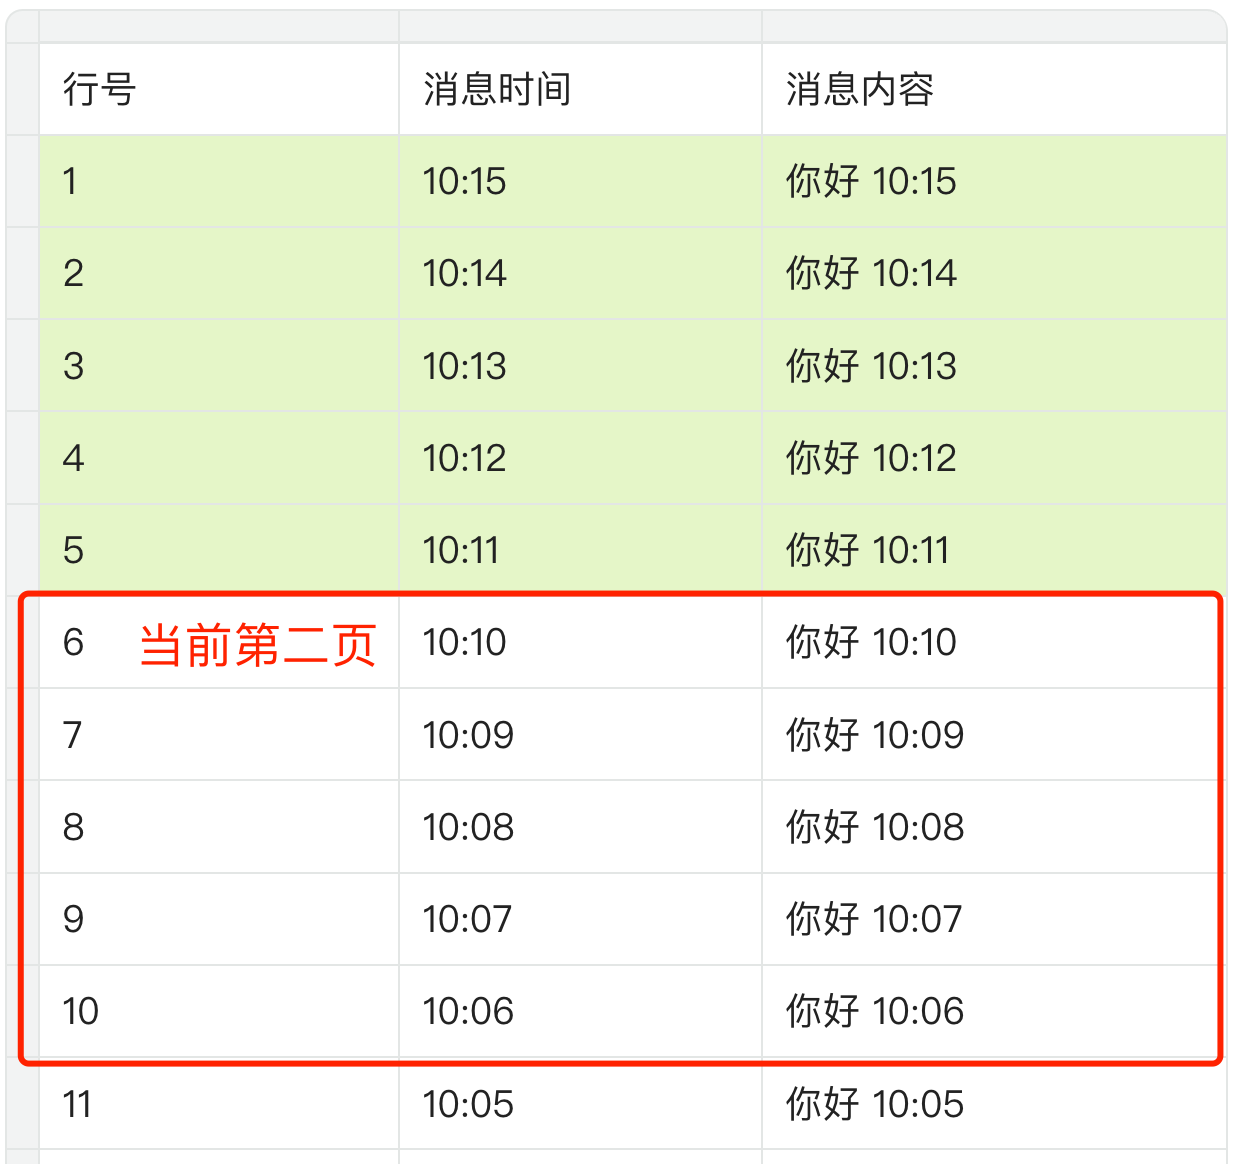
结果这时候来了 5 条新消息,原来的第 6-10 条变成了第 11-15 条,你再用 limit 5, 5 查出来的还是之前的第 1-5 条,数据就重复了。
新消息插入后,偏移量指向的数据就变了:
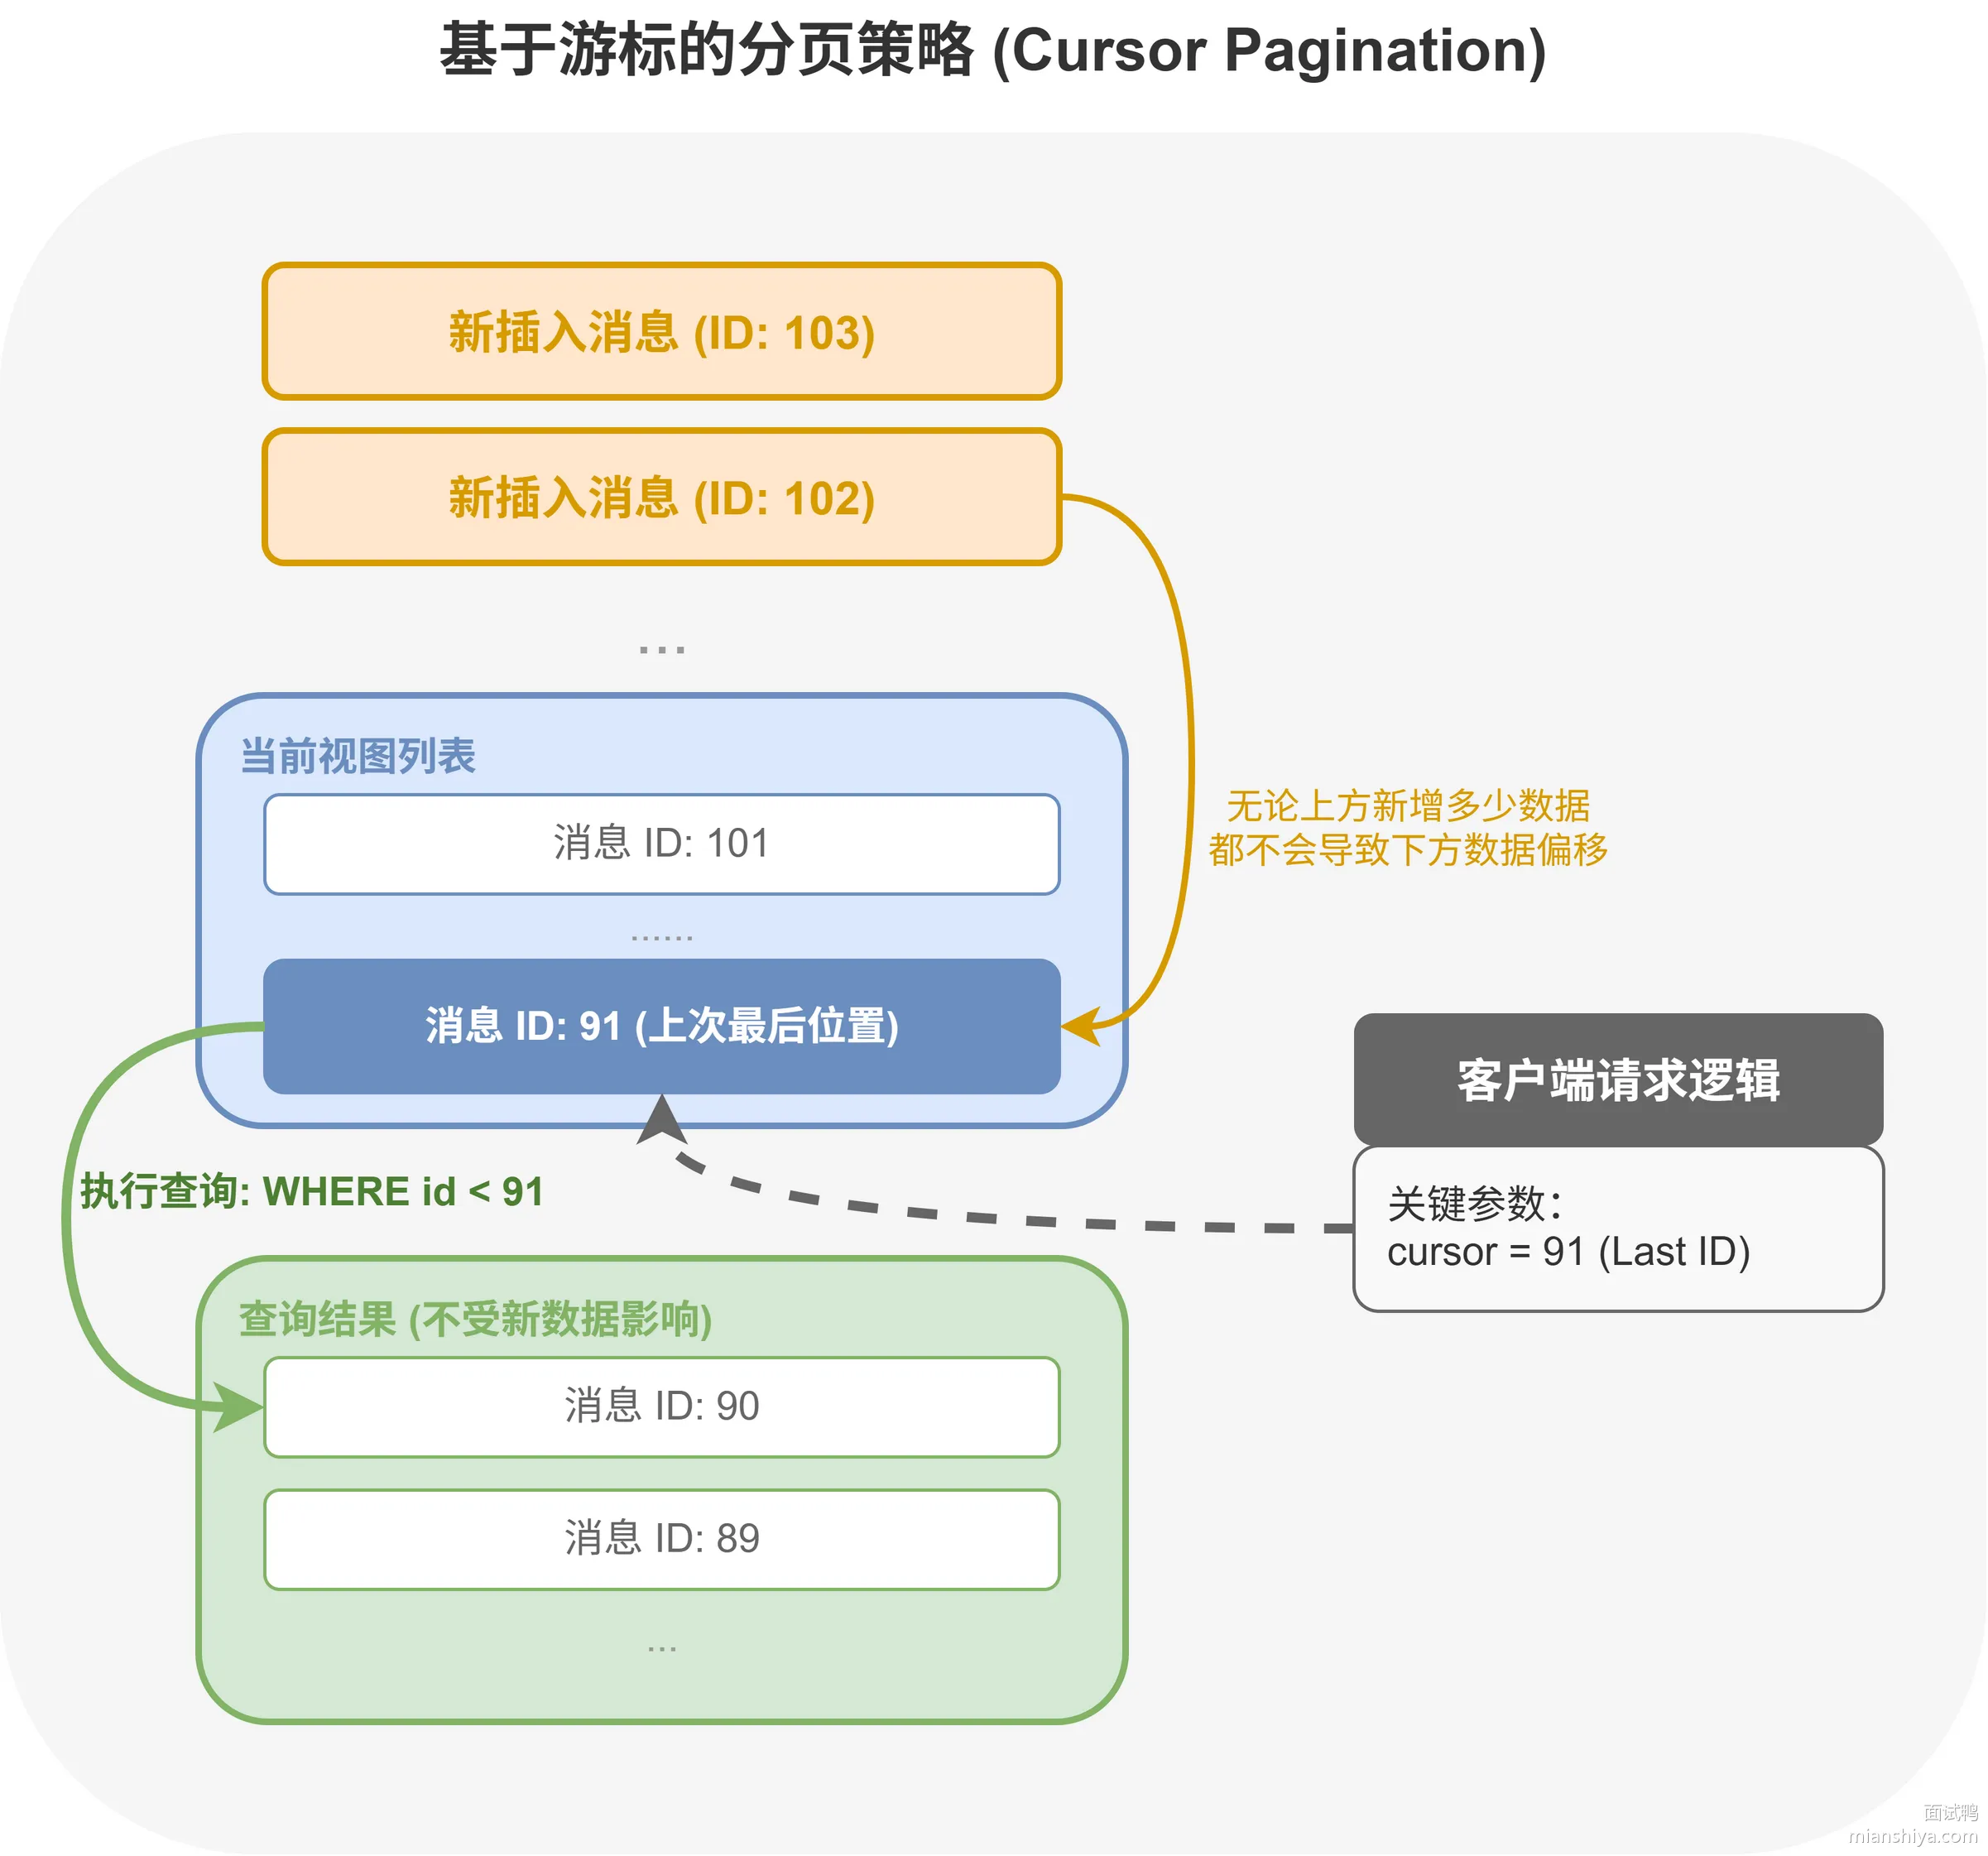
游标分页的做法是用一个游标值来跟踪位置,不依赖偏移量。
一般选消息的自增 ID 或时间戳作为游标,每次查完把最后一条记录的 ID 返回给前端。
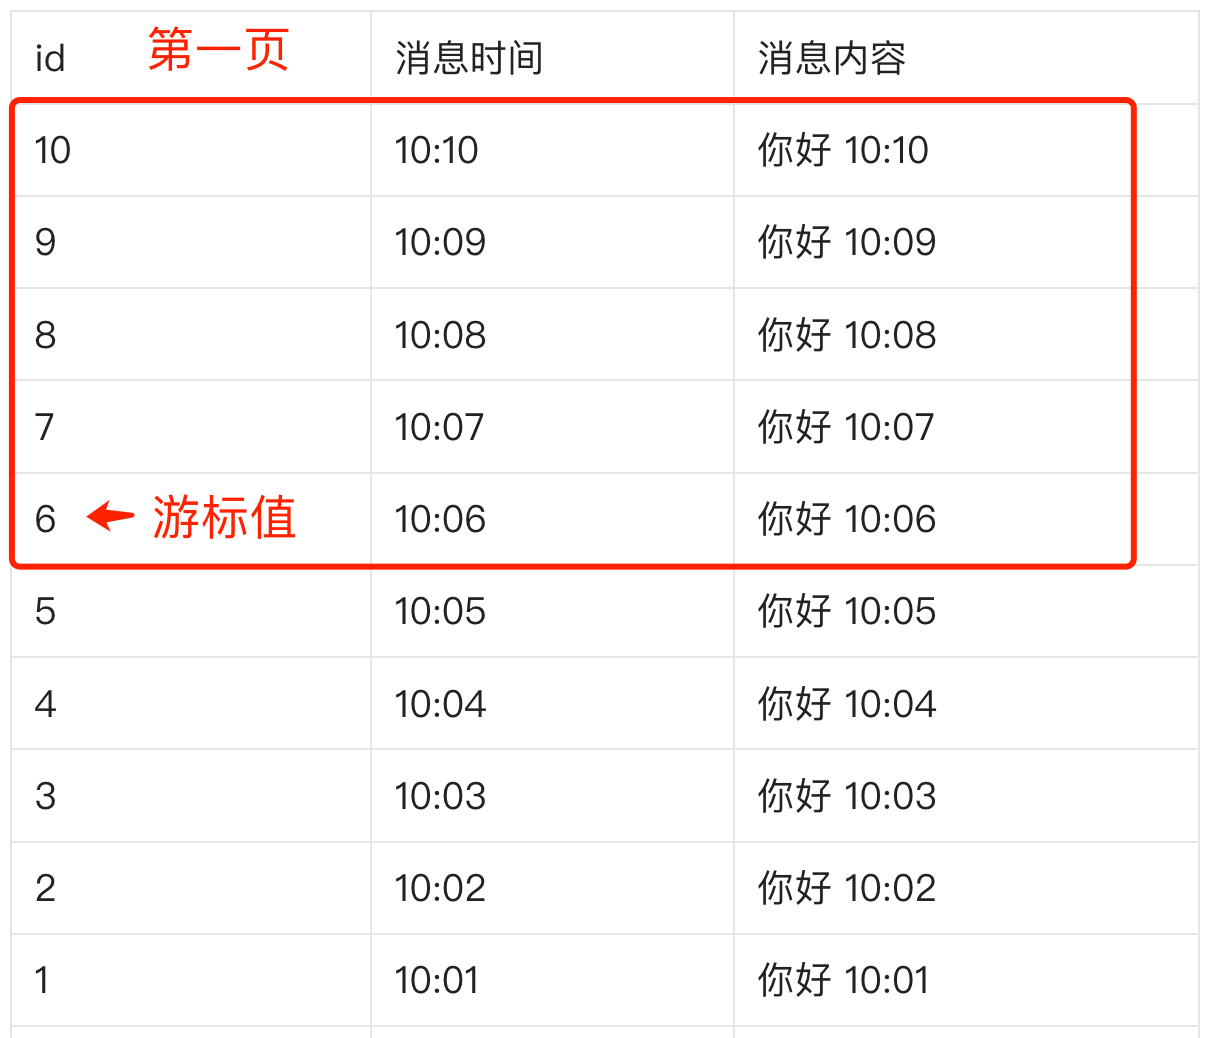
下次前端带着这个游标值来请求,后端查 ID 小于游标值的数据:
SELECT * FROM messages
WHERE id < :cursorId
ORDER BY id DESC
LIMIT 5;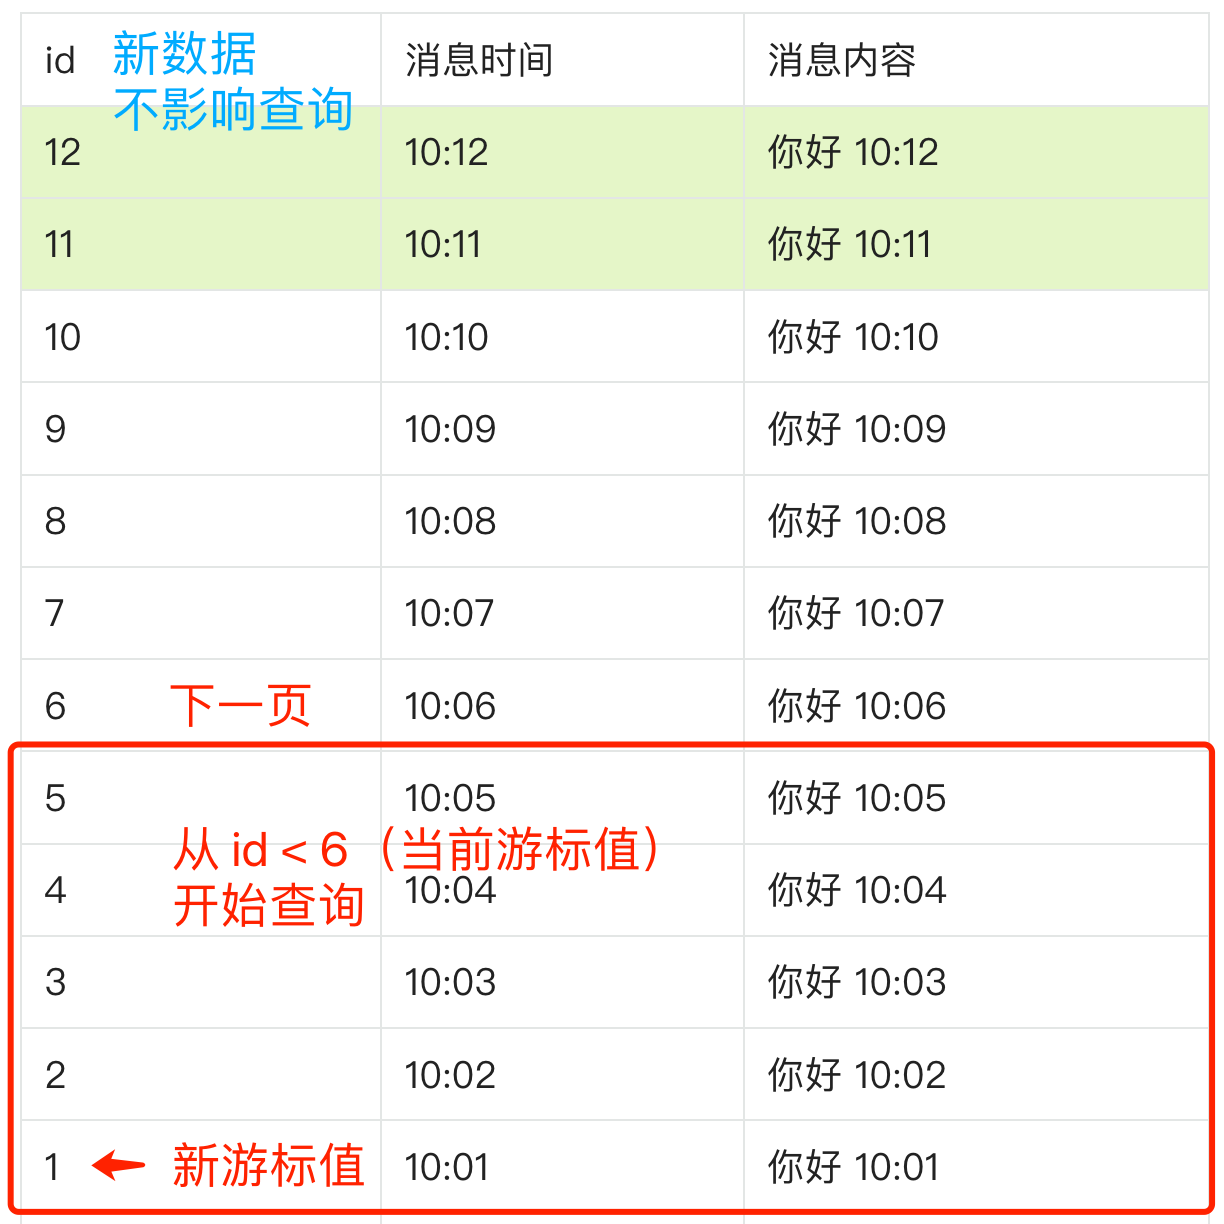
这样不管中间插入了多少新消息,查询都是从上次的位置往前翻,不会受新数据影响。
扩展知识
游标分页的性能优势
游标分页除了解决数据一致性问题,性能也比传统分页好得多。
传统偏移分页 limit 10000, 10 要先扫描跳过前 10000 条记录,偏移量越大越慢。
游标分页直接用 where id < xxx 走索引定位,不用扫描前面的记录,不管翻到第几页性能都差不多。
游标字段的选择
游标字段需要满足几个条件:
- 唯一性,不然定位会出问题
- 排序稳定,字段值不能变来变去
- 有索引,保证查询效率
- 不频繁更新,减少定位漂移
IM 系统里消息 ID 是最常用的游标,自增、唯一、有主键索引。
时间戳也能用,但要注意精度问题,秒级时间戳在高并发下可能重复,同一秒内的多条消息就分不清先后了。
更稳妥的方案是时间戳 + ID 复合游标,时间戳相同的情况下用 ID 兜底:
SELECT * FROM messages
WHERE (timestamp < :cursorTimestamp OR (timestamp = :cursorTimestamp AND id < :cursorId))
ORDER BY timestamp DESC, id DESC
LIMIT 10;
游标分页的适用场景
游标分页特别适合这几类场景:
- 数据持续增长,像 IM 消息、社交动态、日志流,新数据一直在插入
- 大数据量翻页,数据量上百万千万级别,传统分页深页查询会很慢
- 数据迁移同步,按游标批量拉取数据做增量同步
但游标分页有个局限:不支持直接跳页。用户想直接跳到第 100 页,游标分页做不到,只能一页一页翻过去。
所以如果业务上需要跳页能力,还得用传统分页,不过一般 IM 场景下拉加载不需要跳页。
前端配合实现
后端返回数据的时候,除了消息列表,还要带上下一页的游标值和是否还有更多数据的标识:
{
  "messages": [...],
  "nextCursor": "1234567890",
  "hasMore": true
}
前端拿到 hasMore 为 false 就知道到底了,不用再发请求。下拉触发时带上 nextCursor 请求下一页,拿到数据追加到列表头部。
常见问题
如果用户在翻看历史消息的过程中,有消息被删除了,游标分页会有问题吗?
回答:如果删除的是游标指向的那条记录,下次查询 where id < xxx 还是能正常工作,因为查的是小于某个值的数据,这条数据存不存在不影响。如果删除的是还没查到的历史数据,那条数据自然就不会出现在后续结果里,也没问题。游标分页的特点就是往一个方向遍历,删除操作不会导致数据重复,最多是某条数据用户看不到了。
高并发场景下时间戳精度不够导致重复,除了复合游标还有什么解决办法?
回答:可以用更高精度的时间戳,比如毫秒级甚至微秒级。MySQL 的 datetime 支持到微秒,timestamp 也行。另一个思路是用分布式 ID 生成器,像雪花算法生成的 ID 本身就包含时间戳信息,而且全局唯一递增,直接用这个 ID 做游标就行,不用再考虑时间戳精度问题。
游标分页怎么实现向上翻页,比如用户想看更新的消息?
回答:把查询条件反过来就行。向下翻历史是 where id < cursor,向上翻新消息就是 where id > cursor,排序方向也反过来 ORDER BY id ASC。前端记录两个游标,一个是当前最旧消息的 ID 用于下拉加载历史,一个是当前最新消息的 ID 用于上拉加载新消息。
如果要支持按关键词搜索历史消息,还能用游标分页吗?
回答:可以用,但游标字段的选择要考虑搜索场景。单纯用 ID 做游标没问题,搜索条件加上 where content like '%xxx%' 和 id < cursor 组合就行。性能上要注意给搜索字段建全文索引或者用 Elasticsearch,不然 like 模糊匹配会很慢。如果搜索结果要按相关度排序,那游标分页就不太合适了,因为相关度是动态计算的,没法用一个固定字段做游标。
11716. 现在有 40 亿个 QQ 号,给你 1G 的内存,如何实现去重?
核心要点
如果直接存储 40 亿个 int 值,那么需要 40亿 * 4字节 / 1024³ ≈14.90 GiB,很明显内存不够。更不用说用 HashMap 来存储实现去重了。
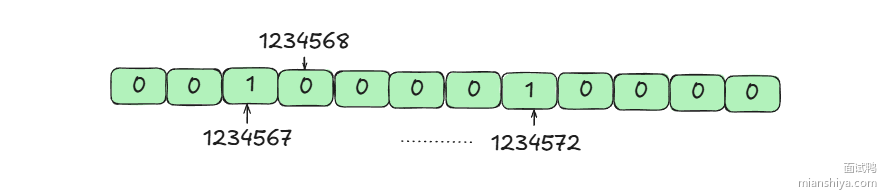
因此需要一个更直接、精确且省内存的方式,就是位图(Bitmap)。
40 亿个 QQ 号,每个 QQ 号用1个二进制位标记是否存在(存在标1,不存在标0)。
QQ 号最大是 10 位整数,理论最大值是 43亿,这样存储下来总内存仅需约 500MB(43亿位≈500MB),远小于 1G 限制。
具体步骤:
- 初始化一个足够大的位图,4 300 000 000 bits ≈ 4 300 000 000/8 bytes ≈ 537 500 000 B ≈ 513 MB
- 遍历所有 QQ 号,将每个号码对应的位标记为1(重复号码会被自动覆盖),比如我的 QQ 是1234567,那么这个数组的第 1234567 位置设置成 1 即可。
- 遍历位图,收集所有标记为 1 的位的位置,即对应的 QQ号,这就是去重的结果。
扩展知识
如果 QQ 号超过 42 亿怎么办
QQ 号理论上最大到 2^32-1 约 42 亿,刚好用一个位图能覆盖。
但如果数据范围更大比如 100 亿,单个位图放不下就得分桶处理:
- 用取模或者范围划分把数据分成多个桶,比如 3 个桶各负责 0-33 亿、33-66 亿、66-100 亿
- 每个桶单独维护一个位图,桶内的数据要减去偏移量才能映射到 0 开始的下标
- 去重结果就是把各个桶的位图结果合并起来
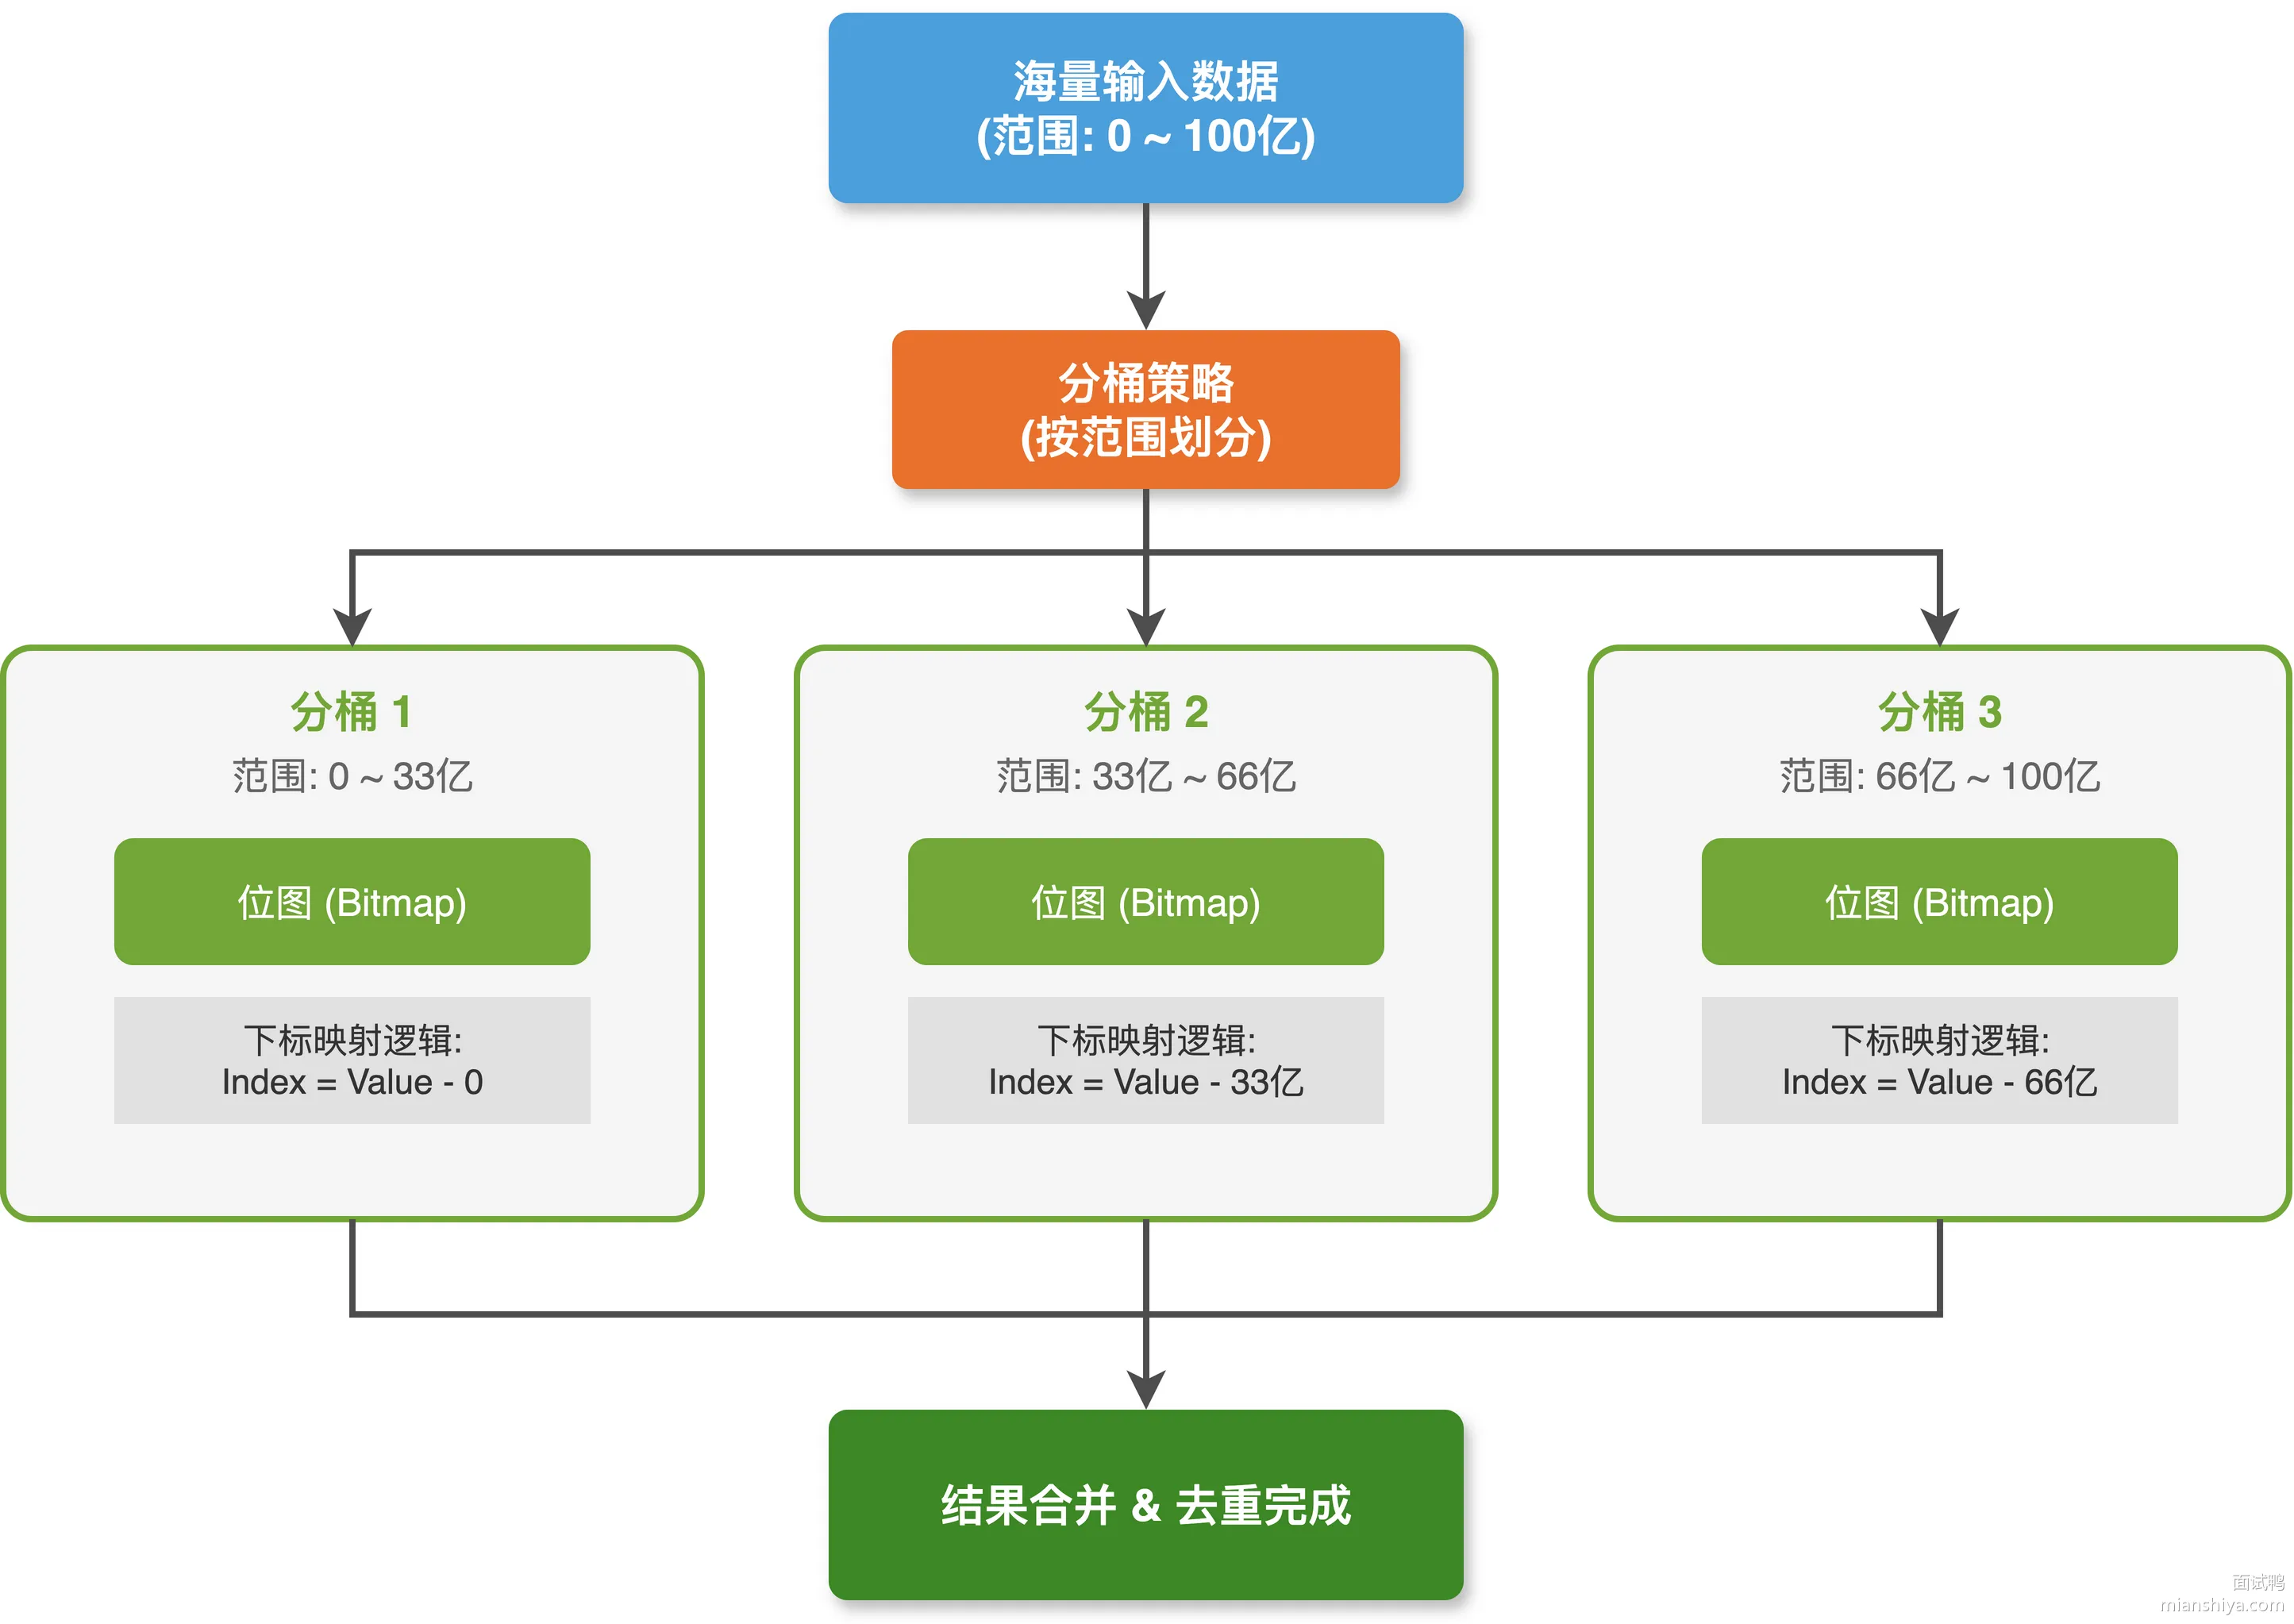
这种分治思想在大数据场景非常常见,MapReduce 的 Map 阶段就是干这个事的。
位图 vs 布隆过滤器
位图是精确去重,一个数存在就是存在,不存在就是不存在,没有误判。代价是需要覆盖整个数据范围,42 亿个可能的 QQ 号就要 500MB,不管实际有多少个。
布隆过滤器是概率型数据结构,用多个哈希函数把数据映射到位图的多个位置。它可以用更小的空间判断数据"可能存在"或"一定不存在",但会有一定的误判率。
适合对精确度要求不高但内存极度敏感的场景,比如爬虫 URL 去重、缓存穿透防护。
这道题要求的是精确去重,所以只能用位图。
如果对方问能不能用布隆过滤器,要明确回答:布隆过滤器有误判,会把不存在的数据误判为存在,不适合精确去重场景。
相关题目
- 如何使用 Redis 快速实现布隆过滤器?
- 手写一个 bitmap
常见问题
位图只能处理非负整数,如果数据是字符串或者有负数怎么办?
回答:字符串要先哈希成整数再用位图,但哈希有冲突问题,不同字符串可能映射到同一个位置导致误判,所以字符串去重一般不用位图。负数的话可以加一个偏移量把它平移到非负区间,比如数据范围是 -10 亿到 10 亿,就统一加 10 亿变成 0 到 20 亿再用位图。
如果 40 亿个 QQ 号存在磁盘上,内存一次放不下怎么读取?
回答:流式读取就行。开一个 BufferedReader 或者用 NIO 的 Channel,一行一行读或者一批一批读,每读到一个 QQ 号就往位图里设置一下。位图本身 500MB 是常驻内存的,但数据文件可以流式处理不用全加载进来。Java 里 Files.lines() 返回的 Stream 就是懒加载的,内存友好。
这个方案在分布式环境下怎么做?
回答:可以把位图放到 Redis 里用 SETBIT 命令操作,多台机器共享同一个位图。或者每台机器维护自己的本地位图,最后做一次 OR 运算合并。如果数据量再大,可以按 QQ 号范围分片,每个分片独立处理,类似 MapReduce 的思路。
69. 如何设计一个点赞系统?
核心要点
点赞系统的核心挑战在于高并发写入和数据一致性的平衡。
抖音、微博这种日活过亿的 App,热门内容一秒钟能涌进几万个点赞请求,直接怼数据库铁定崩。
所以设计思路就是:缓存抗流量、异步削峰、批量落库。
整体架构分三层:
1)接入层:用户点赞请求先打到 Redis,用 INCR 原子操作累加点赞数,用 SET 记录用户是否点过赞,响应时间控制在 10ms 以内
2)异步层:消息队列把点赞事件投递给消费者,Kafka 或 RocketMQ 都行,吞吐量轻松扛住每秒 10 万级消息
3)存储层:消费者批量聚合一段时间窗口内的点赞数据,比如每 5 秒或累积 1000 条就批量写入 MySQL
库表设计上,核心就两张表:
-- 点赞记录表,记录谁给哪个内容点了赞
CREATE TABLE like_record (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id BIGINT NOT NULL,
    item_id BIGINT NOT NULL,
    liked_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    UNIQUE KEY unique_user_item (user_id, item_id)
) ENGINE=InnoDB;

-- 点赞计数表,存每个内容的总点赞数
CREATE TABLE like_count (
    item_id BIGINT PRIMARY KEY,
    like_count BIGINT DEFAULT 0
) ENGINE=InnoDB;
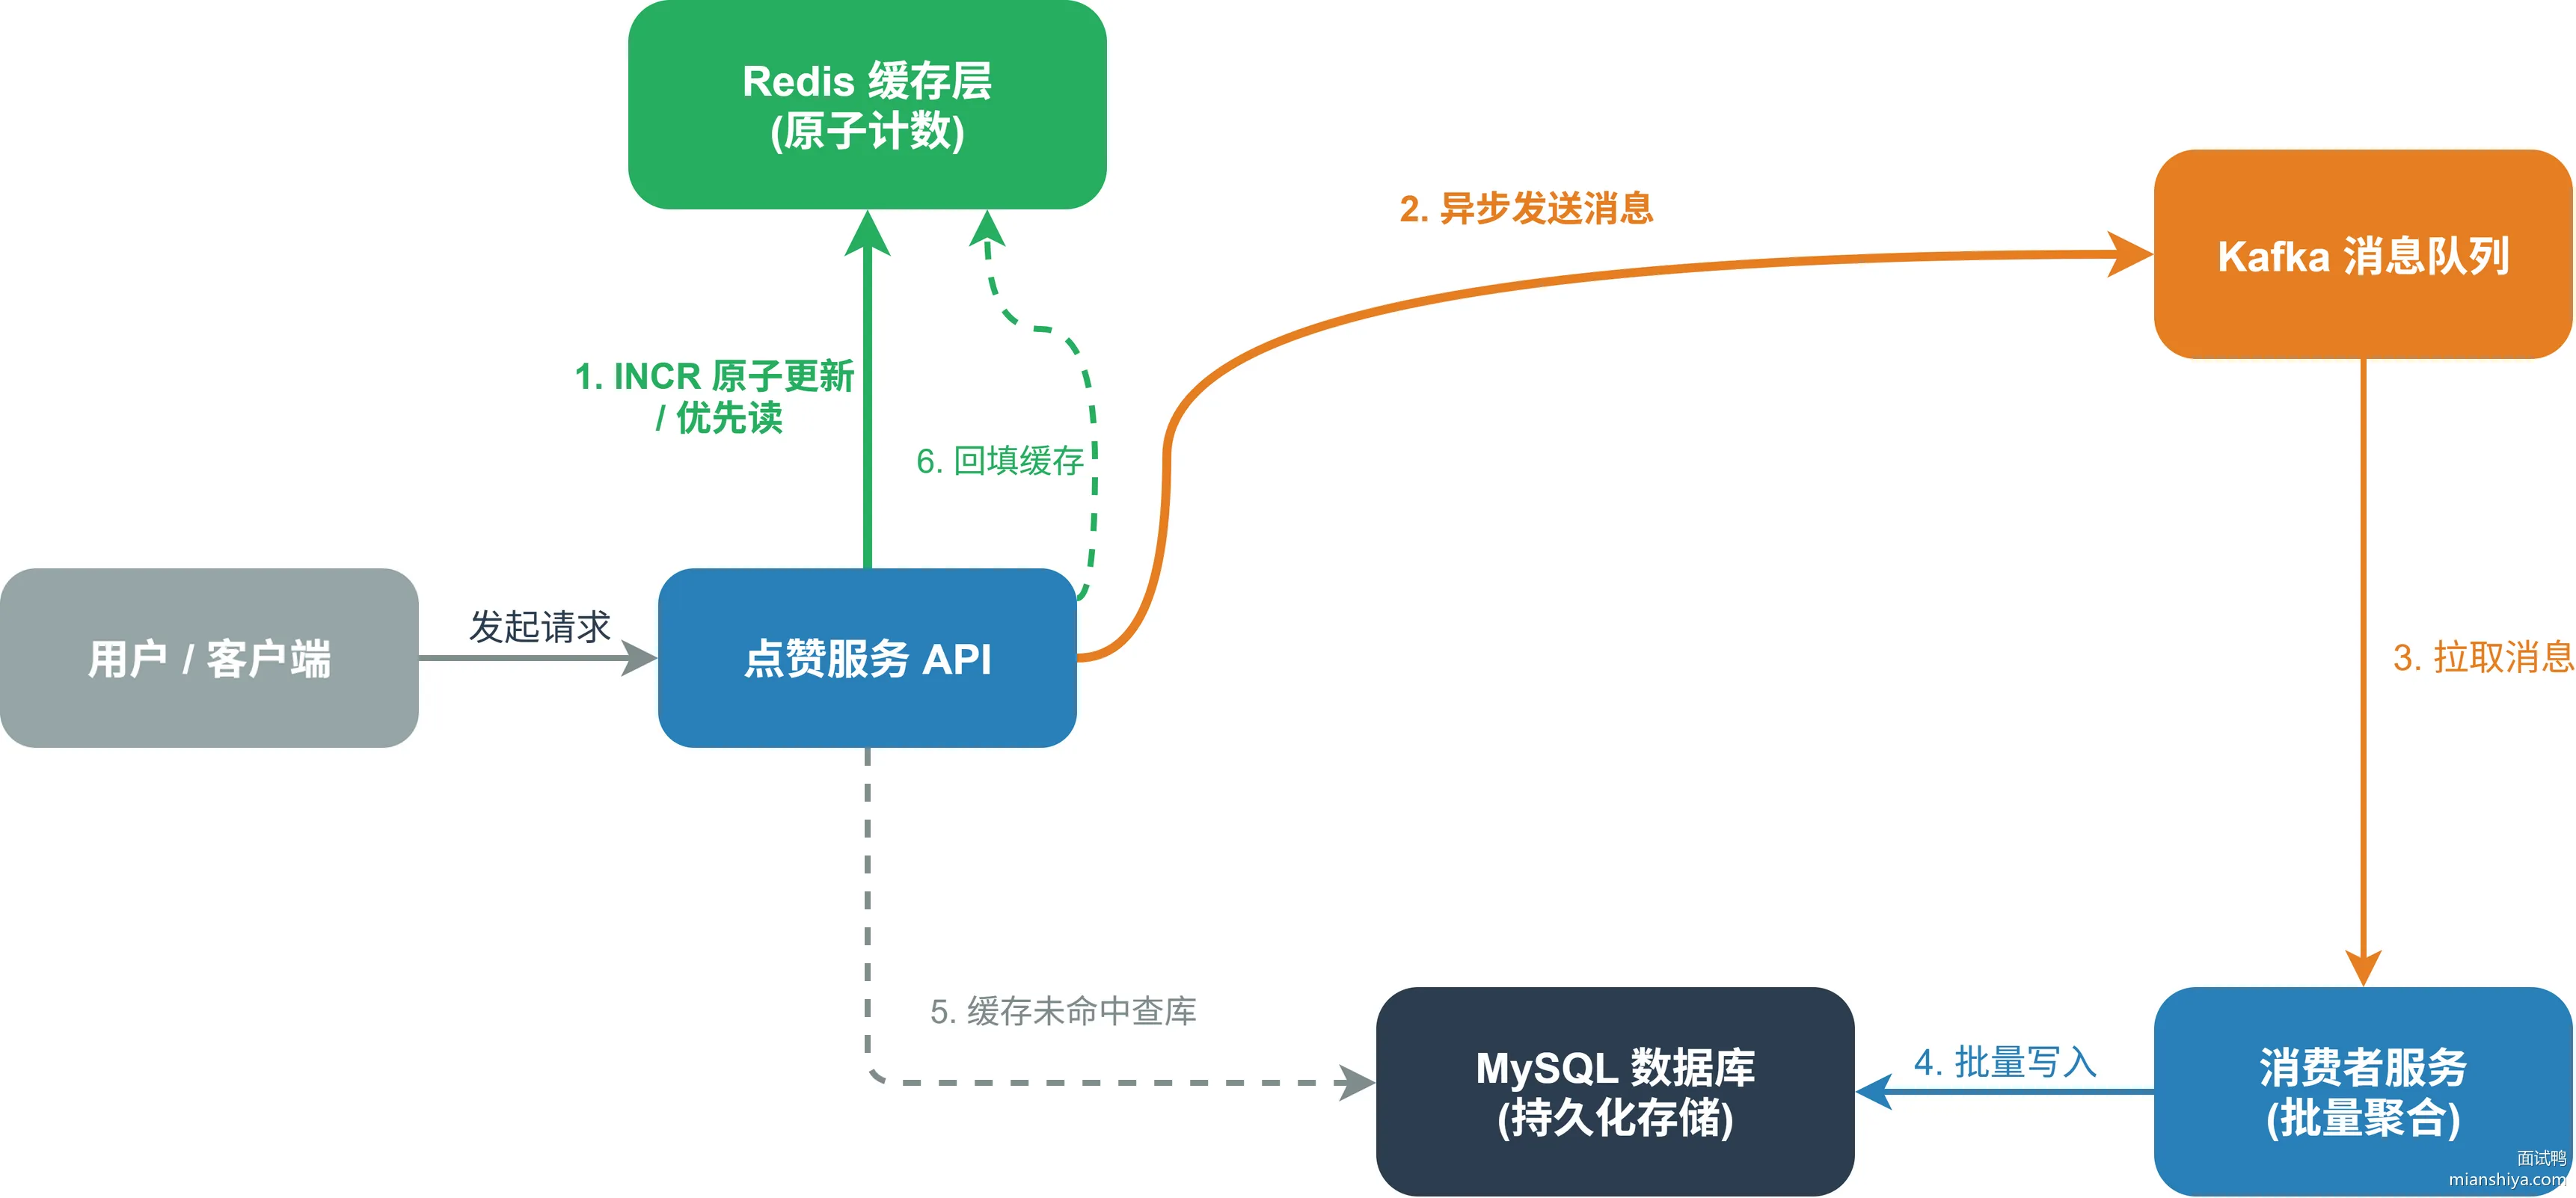
用户点赞请求先到 Redis 缓存层,Redis 用 INCR 原子操作更新点赞数,同时发消息到 Kafka 消息队列。
消费者从 Kafka 拉取消息,批量聚合后写入 MySQL 数据库。
读取点赞数时优先读 Redis,缓存未命中再查 MySQL 并回填缓存。
扩展知识
为什么不能直接写数据库
早期很多小系统确实是直接写 MySQL 的,用户点一下就 UPDATE like_count SET like_count = like_count + 1。
问题是 MySQL 单机 TPS 也就几千,热门内容一秒钟几万个点赞请求,数据库连接池直接打满,整个服务跟着挂。
更麻烦的是行锁竞争,所有请求都在抢同一行数据的锁,锁等待超时一堆。
所以业界通用做法是把写压力转移到 Redis 上。
Redis 单机能扛 10 万+ QPS,而且 INCR 是原子操作,不存在并发问题。
缓存和数据库的一致性怎么保证
既然用了缓存就得面对一致性问题。
点赞场景对一致性要求没那么高,用户晚几秒看到最新点赞数完全可以接受,所以一般采用最终一致性方案。
具体做法是:Redis 里的点赞数是实时的,MySQL 里的数据通过定时任务或消息队列异步同步。
如果 Redis 挂了,从 MySQL 加载数据重建缓存。
有个细节要注意:取消点赞的时候不能简单用 DECR,因为如果消息丢了或者重复消费,点赞数可能变成负数。
稳妥的做法是用 Redis 的 SET 数据结构存点赞用户集合,点赞就 SADD,取消就 SREM,点赞数用 SCARD 获取。
分库分表策略
数据量上亿之后单表肯定扛不住,得分库分表。
点赞记录表按 item_id 取模分表比较合适,这样查某个内容的所有点赞记录只需要查一张表。
如果按 user_id 分,查某个内容的点赞数就得扫所有分表,效率太低。
点赞计数表数据量相对小,可以不分表,或者按 item_id 范围分表。
防刷策略
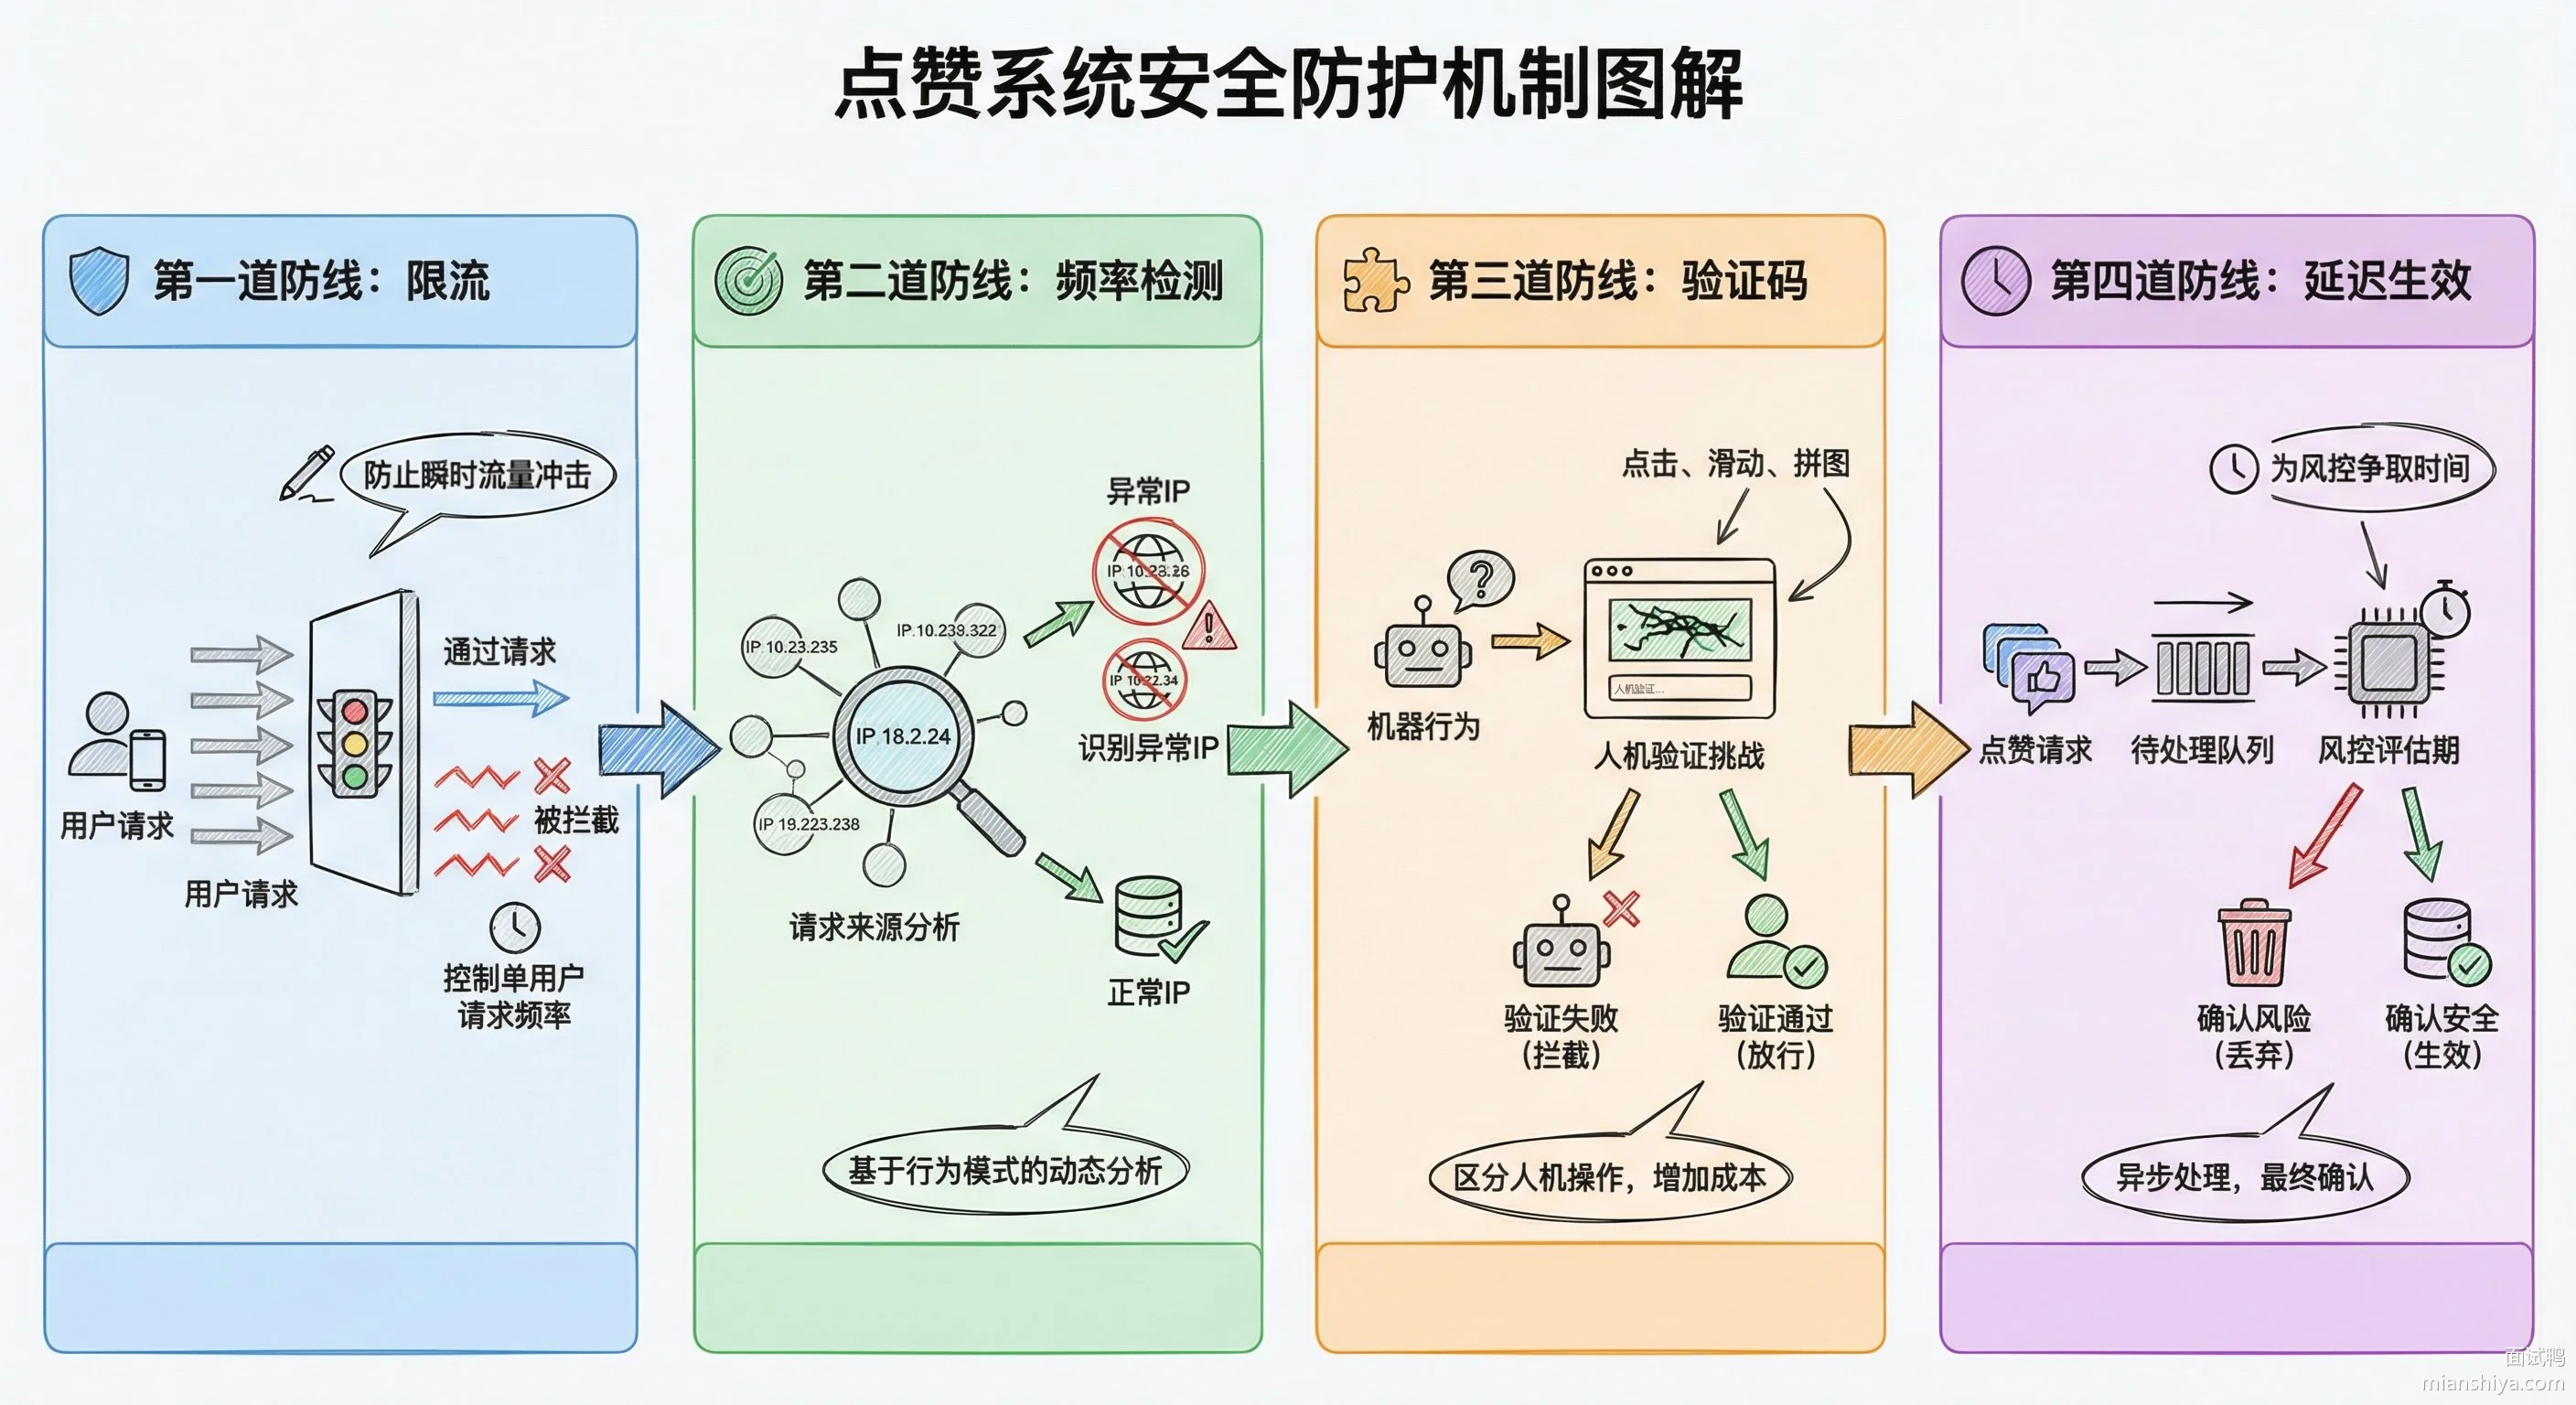
点赞系统必须防刷,不然竞争对手雇一堆水军把你服务器刷挂。常见手段:
1)限流:单用户每秒最多点赞 5 次,用 Redis 的滑动窗口或令牌桶实现
2)频率检测:同一个 IP 短时间内给同一个内容点赞超过阈值,直接拉黑
3)验证码:异常行为触发验证码校验
4)延迟生效:点赞数不实时展示,延迟几分钟,给风控系统留出识别时间
大厂的实际做法
微博的点赞数存在 Redis Cluster 里,分片存储,每个热门微博的点赞数据分散在多个 Redis 节点上。
还有一些大厂的做法是在 Redis 前面再加一层本地缓存,热门视频的点赞数直接缓存在应用服务器的内存里,用 Guava Cache 或 Caffeine。本地缓存的过期时间设短一点,比如 1 秒,这样既能抗住瞬时流量,数据也不会太旧。
常见问题
如果 Redis 和 MySQL 的点赞数不一致了,怎么修复?
回答:先搞清楚以谁为准。一般来说 MySQL 是最终的数据源,Redis 只是缓存。修复的时候跑个定时任务,从 MySQL 读取正确的点赞数,覆盖写到 Redis 里。如果 MySQL 数据也有问题,就得从点赞记录表重新 COUNT 聚合。线上修复的时候要注意限流,不能一下子把数据库打爆。
用户重复点击点赞按钮,怎么保证幂等?
回答:在 Redis 里用 SET 结构存用户点赞集合,key 是 item_id,value 是点过赞的 user_id 集合。每次点赞先 SISMEMBER 判断用户是否已经点过,点过就直接返回成功,没点过才 SADD 并发消息。数据库层面靠 user_id 和 item_id 的唯一索引兜底,重复插入会报错。
点赞数量特别大的热门内容,Redis 单 key 会不会有瓶颈?
回答:会的。Redis 单 key 的 QPS 上限大概在几万,热门内容可能一秒几十万请求。解决办法是拆 key,把一个点赞计数拆成多个子 key,比如 like_count:item_123:0 到 like_count:item_123:9,请求随机打到某个子 key 上,读的时候把所有子 key 的值加起来。这就是所谓的热点 key 打散。
消息队列消费失败了,点赞数据会丢吗?
回答:不会丢,因为 Redis 里已经记录了。消费失败的消息会进死信队列,后面人工或定时任务重新处理。就算死信也没处理,数据还在 Redis 里,定时任务对账的时候会把 Redis 和 MySQL 的数据同步一致。最坏情况是 Redis 也挂了且没持久化,那就得从点赞记录表重新聚合计数。