1. 基础语法
1.1. 条件查询
1.1.1. 运算符
运算符是 SQL 中用于在条件查询中进行条件判断的特殊符号,比如 =、 !=、<、> 等。通过使用不同的运算符,我们可以在查询语句中设定多样化的条件,从而根据数据的不同属性进行灵活的筛选和过滤。
假设你是一名招聘官,而数据表中的数据就像是你面试的候选人。不同的运算符就像是你设定的不同面试条件,例如你可以使用 "!=" 运算符来筛选出不符合某个条件的候选人,使用 ">" 运算符来筛选出成绩优秀的候选人,使用 "BETWEEN" 运算符来筛选出年龄在某个范围内的候选人。
示例
让我们来看一个具体的SQL代码和结果示例,假设有一张名为 employees 的数据表,它存储了员工信息,包括员工姓名(name)、年龄(age)、工资(salary)等:
数据表 employees:
| name | age | salary |
|---|---|---|
| 小明 | 25 | 5000 |
| 小红 | 30 | 6000 |
| 小李 | 28 | 5500 |
| 小张 | 22 | 4500 |
现在,我们使用不同的运算符来进行条件查询:
1)使用 "!=" 运算符筛选出 name 不是 '小张' 的员工:
-- SQL查询语句
select name, age, salary from employees where name != '小张';
查询结果:
| name | age | salary |
|---|---|---|
| 小明 | 25 | 5000 |
| 小红 | 30 | 6000 |
| 小李 | 28 | 5500 |
2)使用 ">" 运算符筛选出工资高于 5500 的员工:
-- SQL查询语句
select name, age, salary from employees where salary > 5500;
查询结果:
| name | age | salary |
|---|---|---|
| 小红 | 30 | 6000 |
3)使用 "BETWEEN" 运算符筛选出年龄在 25 到 30 之间的员工:
-- SQL查询语句
select name, age, salary from employees where age between 25 and 30;
查询结果:
| name | age | salary |
|---|---|---|
| 小明 | 25 | 5000 |
| 小红 | 30 | 6000 |
| 小李 | 28 | 5500 |
通过上述 SQL 查询语句,我们可以根据不同的运算符进行条件查询,得到了符合不同条件的员工信息。
1.1.2. 空值
在数据库中,有时候数据表的某些字段可能没有值,即为空值(NULL)。
空值表示该字段的值是未知的、不存在的或者没有被填写的。在SQL查询中,我们可以使用 "IS NULL" 和 "IS NOT NULL" 来判断字段是否为空值或非空值。
空值的应用场景:假设你是一名考试老师,而数据表中的数据就像是你学生们的考试成绩。当某个学生没有参加考试或者成绩尚未出来时,他的考试成绩就是空值。你可以使用 "IS NULL" 来找出没有参加考试的学生,使用 "IS NOT NULL" 来找出已经有成绩的学生。
示例
假设有一张名为 employees 的数据表,它存储了员工信息,包括员工姓名(name)、年龄(age)、入职日期(hire_date)等:
数据表 employees :
| name | age | hire_date |
|---|---|---|
| 小明 | 25 | 2020-01-01 |
| 小红 | 30 | 2020-02-15 |
| 小李 | 28 | NULL |
| 小张 | NULL | 2020-03-20 |
现在,我们使用 "IS NULL" 来查询出入职日期未填写的员工:
-- SQL查询语句
select name, age from employees where hire_date is null;
查询结果:
| name | age |
|---|---|
| 小李 | 28 |
1.1.3. 模糊查询
模糊查询是一种特殊的条件查询,它允许我们根据模式匹配来查找符合特定条件的数据,可以使用 LIKE 关键字实现模糊查询。
在 LIKE 模糊查询中,我们使用通配符来代表零个或多个字符,从而能够快速地找到匹配的数据。
有如下 2 种通配符:
- 百分号(%):表示任意长度的任意字符序列。
- 下划线(_):表示任意单个字符。
模糊查询的应用场景:假设你是一名侦探,你需要根据目标人物的一部分线索信息来找到匹配的目标,比如你可以根据目标的名字中包含的关键字或字符来查找。
示例
假设有一张名为employees的数据表,它存储了员工信息,包括员工姓名(name)、年龄(age)、职位(position)等:
数据表employees:
| name | age | position |
|---|---|---|
| 张三 | 25 | 软件工程师 |
| 李四 | 30 | 数据分析师 |
| 王五 | 28 | 产品经理 |
| 小明 | 22 | 软件测试工程师 |
现在,我们使用 LIKE 模糊查询来找出姓名(name)中包含关键字 "张" 的员工信息:
-- SQL查询语句
select name, age, position from employees where name like '%张%';
查询结果:
| name | age | position |
|---|---|---|
| 张三 | 25 | 软件工程师 |
还可以使用模糊查询匹配开头和结尾:
-- 只查询以 "张" 开头的数据行
select name, age, position from employees where name like '张%';

-- 只查询以 "张" 结尾的数据行
select name, age, position from employees where name like '%张';
同理,可以使用 not like 来查询不包含某关键字的信息。
1.1.4. 逻辑运算
逻辑运算是一种在条件查询中使用的运算符,它允许我们结合多个条件来过滤出符合特定条件的数据。
在逻辑运算中,常用的运算符有:
- AND:表示逻辑与,要求同时满足多个条件,才返回 true。
- OR:表示逻辑或,要求满足其中任意一个条件,就返回 true。
- NOT:表示逻辑非,用于否定一个条件(本来是 true,用了 not 后转为 false)
示例
假设有一张名为employees的数据表,它存储了员工信息,包括员工姓名(name)、年龄(age)、工资(salary)等:
数据表employees:
| name | age | salary |
|---|---|---|
| 张三 | 25 | 10000 |
| 李四 | 30 | 12000 |
| 李五 | 28 | 15000 |
| 小明 | 22 | 8000 |
现在,我们使用逻辑运算来找出姓名中包含关键字 "李" 且 年龄小于 30 岁的员工信息:
-- SQL查询语句
select name, age, salary from employees where name like '%李%' and age < 30;
查询结果:
| name | age | salary |
|---|---|---|
| 李五 | 28 | 15000 |
上述查询语句中,我们使用 and 逻辑与运算得到了符合要求的员工信息。
1.2. 去重
在数据表中,可能存在重复的数据记录,但如果我们想要过滤掉重复的记录,只保留不同的记录,就要使用 SQL 的去重功能。
在 SQL 中,我们可以使用 DISTINCT 关键字来实现去重操作。
举个应用场景:假设你是班长,要统计班级中有哪些不同的学生,而不关心他们重复出现的次数,就可以使用去重。
示例
假设有一张名为students的数据表,它存储了学生信息,包括学生姓名(name)、班级ID(class_id)、考试编号(exam_num)、成绩(score)等:
数据表students:
| name | class_id | exam_num | score |
|---|---|---|---|
| 张三 | 1 | 1 | 90 |
| 李四 | 2 | 2 | 85 |
| 王五 | 1 | 1 | 92 |
| 李四 | 2 | 3 | 88 |
现在,我们使用DISTINCT关键字来找出不同的班级 ID:
-- SQL 查询语句
select distinct class_id from students;
查询结果:
| class_id |
|---|
| 1 |
| 2 |
除了按照单字段去重外,DISTINCT 关键字还支持根据多个字段的组合来进行去重操作,确保多个字段的组合是唯一的。
示例语法如下:
distinct 字段1, 字段2, 字段3, ...1.3. 排序
在查询数据时,我们有时希望对结果按照某个字段的值进行排序,以便更好地查看数据。
在 SQL 中,我们可以使用 ORDER BY 关键字来实现排序操作。ORDER BY 后面跟上需要排序的字段,可以选择升序(ASC)或降序(DESC)排列。
示例
假设有一张名为 students 的数据表,它存储了学生信息,包括学生姓名(name)、年龄(age)和成绩(score)等:
数据表 students :
| name | age | score |
|---|---|---|
| 张三 | 18 | 90 |
| 李四 | 20 | 85 |
| 王五 | 19 | 92 |
| 赵六 | 20 | 88 |
现在,我们使用ORDER BY关键字来对学生表进行排序:
-- SQL 查询语句 1
select name, age from students order by age asc;

-- SQL 查询语句 2
select name, score from students order by score desc;
查询语句 1 结果,按照年龄升序(从小到大):
| name | age |
|---|---|
| 张三 | 18 |
| 王五 | 19 |
| 李四 | 20 |
| 赵六 | 20 |
查询语句 2 结果,按照分数降序(从大到小):
| name | score |
|---|---|
| 王五 | 92 |
| 张三 | 90 |
| 赵六 | 88 |
| 李四 | 85 |
在排序的基础上,我们还可以根据多个字段的值进行排序。当第一个字段的值相同时,再按照第二个字段的值进行排序,以此类推。
示例语法如下:
order by 字段1 [升序/降序], 字段2 [升序/降序], ...1.4. 截断和偏移
我们先用一个比喻来引出截断和偏移的概念。
假设你有一张待办事项清单,上面有很多任务。当你每次只想查看其中的几个任务时,会怎么办呢?
1)你可以使用手指挡住不需要看的部分(即截断)
2)根据任务的编号,直接翻到需要查看的位置(即偏移)
在 SQL 中,我们使用 LIMIT 关键字来实现数据的截断和偏移。
截断和偏移的一个典型的应用场景是分页,即网站内容很多时,用户可以根据页号每次只看部分数据。
示例
假设有一张名为 tasks 的数据表,它存储了待办事项信息,包括任务名称(task_name)和截止日期(due_date)等。
数据表tasks:
| task_name | due_date |
|---|---|
| 完成报告 | 2023-08-05 |
| 预约医生 | 2023-08-08 |
| 购买礼物 | 2023-08-10 |
| 安排旅行 | 2023-08-15 |
现在,我们使用LIMIT关键字来进行分页查询:
-- LIMIT 后只跟一个整数,表示要截断的数据条数(一次获取几条)
select task_name, due_date from tasks limit 2;

-- LIMIT 后跟 2 个整数,依次表示从第几条数据开始、一次获取几条
select task_name, due_date from tasks limit 2, 2;
查询语句 1 结果,只获取了 2 条数据:
| task_name | due_date |
|---|---|
| 完成报告 | 2023-08-05 |
| 预约医生 | 2023-08-08 |
查询语句 2 结果,从下标为 2(第 3 条)数据的位置开始获取 2 条数据:
| task_name | due_date |
|---|---|
| 购买礼物 | 2023-08-10 |
| 安排旅行 | 2023-08-15 |
通过上述 SQL 查询语句,我们分别选取了待办事项表中的前两个任务和从第三个任务开始的两个任务,实现了数据的截断和偏移。
1.5. 条件分支
条件分支 case when 是 SQL 中用于根据条件进行分支处理的语法。它类似于其他编程语言中的 if else 条件判断语句,允许我们根据不同的条件选择不同的结果返回。
使用 case when 可以在查询结果中根据特定的条件动态生成新的列或对现有的列进行转换。
举个例子:假设你是一位餐厅的服务员,客人点了不同的菜品,而你需要根据客人点的菜来确定服务的方式。如果客人点了鱼,你会用餐具和服务方式适合吃鱼的方式来招待他们;如果客人点了牛排,你会用适合牛排的餐具和服务方式。case when 就像你根据客人点的菜品来选择不同服务方式的过程。
示例
假设有一个学生表 student,包含以下字段:name(姓名)、age(年龄)。数据如下:
| name | age |
|---|---|
| 小明 | 18 |
| 鸡哥 | 25 |
| 李华 | 30 |
| 王五 | 40 |
使用条件分支 case when ,根据 name 来判断学生是否会说 RAP,并起别名为 can_rap。
示例 SQL 如下:
SELECT
  name,
  CASE WHEN (name = '鸡哥') THEN '会' ELSE '不会' END AS can_rap
FROM
  student;
查询结果:
| name | can_rap |
|---|---|
| 小明 | 不会 |
| 鸡哥 | 会 |
| 李华 | 不会 |
| 王五 | 不会 |
case when 支持同时指定多个分支,示例语法如下:
CASE WHEN (条件1) THEN 结果1
	   WHEN (条件2) THEN 结果2
	   ...
	   ELSE 其他结果 END
2. 函数
2.1. 时间函数
在 SQL 中,时间函数是用于处理日期和时间的特殊函数。它们允许我们在查询中操作和处理日期、时间、日期时间数据,从而使得在数据库中进行时间相关的操作变得更加方便和灵活。
常用的时间函数有:
- DATE:获取当前日期
- DATETIME:获取当前日期时间
- TIME:获取当前时间
示例
假设有一个订单表 orders,包含以下字段:order_id(订单号)、order_date(下单日期)、order_time(下单时间)。数据如下:
| order_id | order_date | order_time |
|---|---|---|
| 1 | 2023-08-01 | 12:30:45 |
| 2 | 2023-08-01 | 14:20:10 |
| 3 | 2023-08-02 | 09:15:00 |
| 4 | 2023-08-02 | 18:05:30 |
使用时间函数获取当前日期、当前日期时间和当前时间:
-- 获取当前日期
SELECT DATE() AS current_date;

-- 获取当前日期时间
SELECT DATETIME() AS current_datetime;

-- 获取当前时间
SELECT TIME() AS current_time;
查询结果:
为了方便对比,放到同一个表格
| current_date | current_datetime | current_time |
|---|---|---|
| 2023-08-01 | 2023-08-01 14:30:00 | 14:30:00 |
注意,这里的日期、日期时间和时间将根据当前的系统时间来生成,实际运行结果可能会因为当前时间而不同。
还有很多时间函数,比如计算两个日期的相差天数、获取当前日期对应的毫秒数等,实际运用时自行查阅即可,此处不做赘述。
2.2. 字符串处理
在 SQL 中,字符串处理是一类用于处理文本数据的函数。它们允许我们对字符串进行各种操作,如转换大小写、计算字符串长度以及搜索和替换子字符串等。字符串处理函数可以帮助我们在数据库中对字符串进行加工和转换,从而满足不同的需求。
示例
假设有一个员工表 employees,包含以下字段:id(员工编号)、name(员工姓名)。数据如下:
| id | name |
|---|---|
| 1 | 小明 |
| 2 | 热dog |
| 3 | Fish摸摸 |
| 4 | 鸡哥 |
1)使用字符串处理函数 UPPER 将姓名转换为大写:
-- 将姓名转换为大写
SELECT name, UPPER(name) AS upper_name
FROM employees;
查询结果:
| name | upper_name |
|---|---|
| 小明 | 小明 |
| 热dog | 热DOG |
| Fish摸摸 | FISH摸摸 |
| 鸡哥 | 鸡哥 |
2)使用字符串处理函数 LENGTH 计算姓名长度:
-- 计算姓名长度
SELECT name, LENGTH(name) AS name_length
FROM employees;
查询结果:
| name | name_length |
|---|---|
| 小明 | 2 |
| 热dog | 4 |
| Fish摸摸 | 6 |
| 鸡哥 | 2 |
3)使用字符串处理函数 LOWER 将姓名转换为小写:
-- 将姓名转换为小写并进行条件筛选
SELECT name, LOWER(name) AS lower_name
FROM employees;
查询结果:
| name | lower_name |
|---|---|
| 小明 | 小明 |
| 热dog | 热dog |
| Fish摸摸 | fish摸摸 |
| 鸡哥 | 鸡哥 |
2.3. 聚合函数
在 SQL 中,聚合函数是一类用于对数据集进行 汇总计算 的特殊函数。它们可以对一组数据执行诸如计数、求和、平均值、最大值和最小值等操作。聚合函数通常在 SELECT 语句中配合 GROUP BY 子句使用,用于对分组后的数据进行汇总分析。
常见的聚合函数包括:
- COUNT:计算指定列的行数或非空值的数量。
- SUM:计算指定列的数值之和。
- AVG:计算指定列的数值平均值。
- MAX:找出指定列的最大值。
- MIN:找出指定列的最小值。
示例
假设有一个订单表 orders,包含以下字段:order_id(订单号)、customer_id(客户编号)、amount(订单金额)。数据如下:
| order_id | customer_id | amount |
|---|---|---|
| 1 | A001 | 100 |
| 2 | A002 | 200 |
| 3 | A001 | 150 |
| 4 | A003 | 50 |
1)使用聚合函数 COUNT 计算订单表中的总订单数:
SELECT COUNT(*) AS order_num
FROM orders;
查询结果:
| order_num |
|---|
| 4 |
2)使用聚合函数 COUNT(DISTINCT 列名) 计算订单表中不同客户的数量:
SELECT COUNT(DISTINCT customer_id) AS customer_num
FROM orders;
查询结果:
| customer_num |
|---|
| 3 |
3)使用聚合函数 SUM 计算总订单金额:
SELECT SUM(amount) AS total_amount
FROM orders;
查询结果:
| total_amount |
|---|
| 500 |
3. 分组聚合
3.1. 单字段分组
在 SQL 中,分组聚合是一种对数据进行分类并对每个分类进行聚合计算的操作。它允许我们按照指定的列或字段对数据进行分组,然后对每个分组应用聚合函数,如 COUNT、SUM、AVG 等,以获得分组后的汇总结果。
举个例子:某个学校可以按照班级将学生分组,并对每个班级进行统计。查看每个班级有多少学生、每个班级的平均成绩。这样我们就能够对学校各班的学生情况有一个整体的了解,而不是单纯看个别学生的信息。
在 SQL 中,通常使用 GROUP BY 关键字对数据进行分组。
示例
假设有一个订单表 orders,包含以下字段:order_id(订单号)、customer_id(客户编号)、amount(订单金额)。数据如下:
| order_id | customer_id | amount |
|---|---|---|
| 1 | A001 | 100 |
| 2 | A002 | 200 |
| 3 | A001 | 150 |
| 4 | A003 | 50 |
1)使用分组聚合查询中每个客户的编号:
SELECT customer_id
FROM orders
GROUP BY customer_id;
查询结果:
| customer_id |
|---|
| A001 |
| A002 |
| A003 |
2)使用分组聚合查询每个客户的下单数:
SELECT customer_id, COUNT(order_id) AS order_num
FROM orders
GROUP BY customer_id;
查询结果:
| customer_id | order_num |
|---|---|
| A001 | 2 |
| A002 | 1 |
| A003 | 1 |
3.2. 多字段分组
有时,单字段分组并不能满足我们的需求,比如想统计学校里每个班级参加每场考试的学生情况,这时就可以使用多字段分组。
多字段分组和单字段分组的实现方式几乎一致,使用 GROUP BY 语法即可。
示例
假设有一个订单表 orders,包含以下字段:order_id(订单号)、product_id(商品编号)、customer_id(客户编号)、amount(订单金额)。
数据如下:
| order_id | product_id | customer_id | amount |
|---|---|---|---|
| 1 | 1 | A001 | 100 |
| 2 | 1 | A002 | 200 |
| 3 | 1 | A001 | 150 |
| 4 | 1 | A003 | 50 |
| 5 | 2 | A001 | 50 |
要查询使用多字段分组查询表中 每个客户 购买的 每种商品 的总金额,相当于按照客户编号和商品编号分组:
-- 查询每个用户购买的每种商品的总金额,按照客户编号和商品编号分组
SELECT customer_id, product_id, SUM(amount) AS total_amount
FROM orders
GROUP BY customer_id, product_id;
查询结果:
| customer_id | product_id | total_amount |
|---|---|---|
| A001 | 1 | 250 |
| A001 | 2 | 50 |
| A002 | 1 | 200 |
| A003 | 1 | 50 |
3.3. having 子句
在 SQL 中,HAVING 子句用于在分组聚合后对分组进行过滤。它允许我们对分组后的结果进行条件筛选,只保留满足特定条件的分组。
HAVING 子句与条件查询 WHERE 子句的区别在于,WHERE 子句用于在 分组之前 进行过滤,而 HAVING 子句用于在 分组之后 进行过滤。
示例
假设有一个订单表 orders,包含以下字段:order_id(订单号)、customer_id(客户编号)、amount(订单金额)。数据如下:
| order_id | customer_id | amount |
|---|---|---|
| 1 | A001 | 100 |
| 2 | A002 | 200 |
| 3 | A001 | 150 |
| 4 | A003 | 50 |
1)使用 HAVING 子句查询订单数超过 1 的客户:
SELECT customer_id, COUNT(order_id) AS order_num
FROM orders
GROUP BY customer_id
HAVING COUNT(order_id) > 1;
查询结果:
| customer_id | order_num |
|---|---|
| A001 | 2 |
2)使用 HAVING 子句查询订单总金额超过 100 的客户:
-- 查询订单总金额超过100的客户
SELECT customer_id, SUM(amount) AS total_amount
FROM orders
GROUP BY customer_id
HAVING SUM(amount) > 100;
查询结果:
| customer_id | total_amount |
|---|---|
| A001 | 250 |
| A002 | 200 |
4. 查询进阶
4.1. 关联查询
4.1.1. cross join
在之前的教程中,我们所有的查询操作都是在单个数据表中进行的。但有时,我们可能希望在单张表的基础上,获取更多额外数据,比如获取学生表中学生所属的班级信息等。这时,就需要使用关联查询。
在 SQL 中,关联查询是一种用于联合多个数据表中的数据的查询方式。
其中,CROSS JOIN 是一种简单的关联查询,不需要任何条件来匹配行,它直接将左表的 每一行 与右表的 每一行 进行组合,返回的结果是两个表的笛卡尔积。
示例
假设有一个员工表 employees,包含以下字段:emp_id(员工编号)、emp_name(员工姓名)、department(所属部门)、salary(工资)。数据如下:
| emp_id | emp_name | department | salary |
|---|---|---|---|
| 1 | 小明 | 技术部 | 5000 |
| 2 | 鸡哥 | 财务部 | 6000 |
| 3 | 李华 | 销售部 | 4500 |
假设还有一个部门表 departments,包含以下字段:department(部门名称)、manager(部门经理)、location(所在地)。数据如下:
| department | manager | location |
|---|---|---|
| 技术部 | 张三 | 上海 |
| 财务部 | 李四 | 北京 |
| 销售部 | 王五 | 广州 |
使用 CROSS JOIN 进行关联查询,将员工表和部门表的所有行组合在一起,获取员工姓名、工资、部门名称和部门经理,示例 SQL 代码如下:
SELECT e.emp_name, e.salary, d.department, d.manager
FROM employees e
CROSS JOIN departments d;
上面的 SQL 还可以简化为:
SELECT e.emp_name, e.salary, d.department, d.manager
FROM employees e, departments d;
通过逗号分隔表名,隐式地实现了笛卡尔积,是 SQL 早期的写法,功能上与 CROSS JOIN 完全相同。
注意,在多表关联查询的 SQL 中,我们最好在选择字段时指定字段所属表的名称(比如 e.emp_name),还可以通过给表起别名(比如 employees e)来简化 SQL 语句。
查询结果:
| emp_name | salary | department | manager |
|---|---|---|---|
| 小明 | 5000 | 技术部 | 张三 |
| 小明 | 5000 | 财务部 | 李四 |
| 小明 | 5000 | 销售部 | 王五 |
| 鸡哥 | 6000 | 技术部 | 张三 |
| 鸡哥 | 6000 | 财务部 | 李四 |
| 鸡哥 | 6000 | 销售部 | 王五 |
| 李华 | 4500 | 技术部 | 张三 |
| 李华 | 4500 | 财务部 | 李四 |
| 李华 | 4500 | 销售部 | 王五 |
4.1.2. inner join
在 SQL 中,INNER JOIN 是一种常见的关联查询方式,它根据两个表之间的关联条件,将满足条件的行组合在一起。
注意,INNER JOIN 只返回两个表中满足关联条件的交集部分,即在两个表中都存在的匹配行。
示例
假设有一个员工表 employees,包含以下字段:emp_id(员工编号)、emp_name(员工姓名)、department(所属部门)、salary(工资)。数据如下:
| emp_id | emp_name | department | salary |
|---|---|---|---|
| 1 | 小明 | 技术部 | 5000 |
| 2 | 鸡哥 | 财务部 | 6000 |
| 3 | 李华 | 销售部 | 4500 |
假设还有一个部门表 departments,包含以下字段:department(部门名称)、manager(部门经理)、location(所在地)。数据如下:
| department | manager | location |
|---|---|---|
| 技术部 | 张三 | 上海 |
| 财务部 | 李四 | 北京 |
| 销售部 | 王五 | 广州 |
| 摸鱼部 | 赵二 | 吐鲁番 |
使用 INNER JOIN 进行关联查询,根据员工表和部门表之间的公共字段 部门名称(department) 进行匹配,将员工的姓名、工资以及所属部门和部门经理组合在一起:
SELECT e.emp_name, e.salary, e.department, d.manager
FROM employees e
JOIN departments d ON e.department = d.department;
查询结果如下:
| emp_name | salary | department | manager |
|---|---|---|---|
| 小明 | 5000 | 技术部 | 张三 |
| 鸡哥 | 6000 | 财务部 | 李四 |
| 李华 | 4500 | 销售部 | 王五 |
我们会发现,使用 INNER_JOIN 后,只有两个表之间存在对应关系的数据才会被放到查询结果中。
4.1.3. outer join
在 SQL 中,OUTER JOIN 是一种关联查询方式,它根据指定的关联条件,将两个表中满足条件的行组合在一起,并 包含没有匹配的行 。
在 OUTER JOIN 中,包括 LEFT OUTER JOIN 和 RIGHT OUTER JOIN 两种类型,它们分别表示查询左表和右表的所有行(即使没有被匹配),再加上满足条件的交集部分。
示例
假设有一个员工表 employees,包含以下字段:emp_id(员工编号)、emp_name(员工姓名)、department(所属部门)、salary(工资)。数据如下:
| emp_id | emp_name | department | salary |
|---|---|---|---|
| 1 | 小明 | 技术部 | 5000 |
| 2 | 鸡哥 | 财务部 | 6000 |
| 3 | 李华 | 销售部 | 4500 |
假设还有一个部门表 departments,包含以下字段:department(部门名称)、manager(部门经理)、location(所在地)。数据如下:
| department | manager | location |
|---|---|---|
| 技术部 | 张三 | 上海 |
| 财务部 | 李四 | 北京 |
| 人事部 | 王五 | 广州 |
| 摸鱼部 | 赵二 | 吐鲁番 |
使用 LEFT JOIN 进行关联查询,根据员工表和部门表之间的部门名称进行匹配,将员工的姓名、工资以及所属部门和部门经理组合在一起,并包含所有员工的信息:
SELECT e.emp_name, e.salary, e.department, d.manager
FROM employees e
LEFT JOIN departments d ON e.department = d.department;
查询结果:
| emp_name | salary | department | manager |
|---|---|---|---|
| 小明 | 5000 | 技术部 | 张三 |
| 鸡哥 | 6000 | 财务部 | 李四 |
| 李华 | 4500 | 销售部 | NULL |
关注下表格的最后一条数据,李华所属的销售部并没有在部门表中,但仍然返回在了结果集中,manager 为 NULL。
有些数据库并不支持 RIGHT JOIN 语法,那么如何实现 RIGHT JOIN 呢?
其实只需要把主表(from 后面的表)和关联表(LEFT JOIN 后面的表)顺序进行调换即可!
4.2. 子查询
子查询是指在一个查询语句内部 嵌套 另一个完整的查询语句,内层查询被称为子查询。子查询可以用于获取更复杂的查询结果或者用于过滤数据。
当执行包含子查询的查询语句时,数据库引擎会首先执行子查询,然后将其结果作为条件或数据源来执行外层查询。
打个比方,子查询就像是在一个盒子中的盒子,外层查询是大盒子,内层查询是小盒子。执行查询时,我们首先打开小盒子获取结果,然后将小盒子的结果放到大盒子中继续处理。
示例
假设我们有以下两个数据表:orders 和 customers,分别包含订单信息和客户信息。
orders 表:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
customers 表:
| customer_id | name | city |
|---|---|---|
| 101 | Alice | New York |
| 102 | Bob | Los Angeles |
| 103 | Charlie | Chicago |
现在,我们希望查询出有订单总金额 > 200 的客户的姓名和城市信息,示例 SQL 如下:
-- 主查询
SELECT name, city
FROM customers
WHERE customer_id IN (
    -- 子查询
    SELECT DISTINCT customer_id
    FROM orders
    WHERE total_amount > 200
);
在上述 SQL 中,先通过子查询从订单表中过滤查询出了符合条件的客户 id,然后再根据客户 id 到客户信息表中查询客户信息,这样可以少查询很多客户信息数据。
上述语句的查询结果:
| name | city |
|---|---|
| Bob | Los Angeles |
| Charlie | Chicago |
4.2.1. exists
之前的教程讲到,子查询是一种强大的查询工具,它可以嵌套在主查询中,帮助我们进行更复杂的条件过滤和数据检索。
其中,子查询中的一种特殊类型是 "exists" 子查询,用于检查主查询的结果集是否存在满足条件的记录,它返回布尔值(True 或 False),而不返回实际的数据。
示例
假设我们有以下两个数据表:orders 和 customers,分别包含订单信息和客户信息。
orders 表:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
customers 表:
| customer_id | name | city |
|---|---|---|
| 101 | Alice | New York |
| 102 | Bob | Los Angeles |
| 103 | Charlie | Chicago |
| 104 | 赵二 | China |
现在,我们希望查询出 存在订单的 客户姓名和订单金额。
使用 exists 子查询的方式,SQL 代码如下:
-- 主查询
SELECT name, total_amount
FROM customers
WHERE EXISTS (
    -- 子查询
    SELECT 1
    FROM orders
    WHERE orders.customer_id = customers.customer_id
);
上述语句中,先遍历客户信息表的每一行,获取到客户编号;然后执行子查询,从订单表中查找该客户编号是否存在,如果存在则返回结果。
查询结果如下:
| name | total_amount |
|---|---|
| Alice | 200 |
| Bob | 350 |
| Charlie | 500 |
和 exists 相对的是 not exists,用于查找不满足存在条件的记录。
4.3. 组合查询
在 SQL 中,组合查询是一种将多个 SELECT 查询结果合并在一起的查询操作。
包括两种常见的组合查询操作:UNION 和 UNION ALL。
- UNION 操作:它用于将两个或多个查询的结果集合并, 并去除重复的行 。即如果两个查询的结果有相同的行,则只保留一行。
- UNION ALL 操作:它也用于将两个或多个查询的结果集合并, 但不去除重复的行 。即如果两个查询的结果有相同的行,则全部保留。
示例
假设我们有以下两个数据表:table1 和 table2,分别包含不同部门的员工信息。
table1 表:
| emp_id | name | age | department |
|---|---|---|---|
| 101 | Alice | 25 | HR |
| 102 | Bob | 28 | Finance |
| 103 | Charlie | 22 | IT |
table2 表:
| emp_id | name | age | department |
|---|---|---|---|
| 101 | Alice | 25 | HR |
| 201 | David | 27 | Finance |
| 202 | Eve | 24 | HR |
| 203 | Frank | 26 | IT |
现在,我们想要合并这两张表的数据,分别执行 UNION 操作和 UNION ALL 操作。
UNION 操作:
SELECT name, age, department
FROM table1
UNION
SELECT name, age, department
FROM table2;
UNION 操作的结果,去除了重复的行(名称为 Alice):
| name | age | department |
|---|---|---|
| Alice | 25 | HR |
| Bob | 28 | Finance |
| Charlie | 22 | IT |
| David | 27 | Finance |
| Eve | 24 | HR |
| Frank | 26 | IT |
UNION ALL 操作:
-- UNION ALL操作
SELECT name, age, department
FROM table1
UNION ALL
SELECT name, age, department
FROM table2;
结果如下,保留了重复的行:
| name | age | department |
|---|---|---|
| Alice | 25 | HR |
| Bob | 28 | Finance |
| Charlie | 22 | IT |
| Alice | 25 | HR |
| David | 27 | Finance |
| Eve | 24 | HR |
| Frank | 26 | IT |
4.4. 开窗函数
4.4.1. sum over
在 SQL 中,开窗函数是一种强大的查询工具,它允许我们在查询中进行对分组数据进行计算、 同时保留原始行的详细信息 。
开窗函数可以与聚合函数(如 SUM、AVG、COUNT 等)结合使用,但与普通聚合函数不同,开窗函数不会导致结果集的行数减少。
打个比方,可以将开窗函数想象成一种 "透视镜",它能够将我们聚焦在某个特定的分组,同时还能看到整体的全景。
本节我们先讲第一个开窗函数:sum over。
该函数用法为:
SUM(计算字段名) OVER (PARTITION BY 分组字段名)示例
假设我们有订单表 orders,表格数据如下:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
现在,我们希望计算每个客户的订单总金额,并显示每个订单的详细信息。
示例 SQL 如下:
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount,
    SUM(total_amount) OVER (PARTITION BY customer_id) AS customer_total_amount
FROM
    orders;
查询结果:
| order_id | customer_id | order_date | total_amount | customer_total_amount |
|---|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 | 320 |
| 3 | 101 | 2023-01-10 | 120 | 320 |
| 2 | 102 | 2023-01-05 | 350 | 350 |
| 4 | 103 | 2023-01-15 | 500 | 500 |
在上面的示例中,我们使用开窗函数 SUM 来计算每个客户的订单总金额(customer_total_amount),并使用 PARTITION BY 子句按照customer_id 进行分组。从前两行可以看到,开窗函数保留了原始订单的详细信息,同时计算了每个客户的订单总金额。
4.4.2. sum over order by
之前的教程中,我们讲到了 sum over 开窗函数,并且用它实现了分组统计。
本节教程我们将学习 sum over 函数的另一种用法:sum over order by,可以实现同组内数据的 累加求和 。
示例用法如下:
SUM(计算字段名) OVER (PARTITION BY 分组字段名 ORDER BY 排序字段 排序规则)举一个应用场景:老师在每个班级里依次点名,每点到一个学生,老师都会记录当前已点到的学生们的分数总和。
示例
假设我们有订单表 orders,表格数据如下:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
现在,我们希望计算每个客户的历史订单累计金额,并显示每个订单的详细信息。
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount,
    SUM(total_amount) OVER (PARTITION BY customer_id ORDER BY order_date ASC) AS cumulative_total_amount
FROM
    orders;
结果将是:
| order_id | customer_id | order_date | total_amount | cumulative_total_amount |
|---|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 | 200 |
| 3 | 101 | 2023-01-10 | 120 | 320 |
| 2 | 102 | 2023-01-05 | 350 | 350 |
| 4 | 103 | 2023-01-15 | 500 | 500 |
在上面的示例中,我们使用开窗函数 SUM 来计算每个客户的历史订单累计金额(cumulative_total_amount),并使用 PARTITION BY 子句按照 customer_id 进行分组,并使用 ORDER BY 子句按照 order_date 进行排序。从结果的前两行可以看到,开窗函数保留了原始订单的详细信息,同时计算了每个客户的历史订单累计金额;相比于只用 sum over,同组内的累加列名称
4.4.3. rank
本节我们来学习一个新的开窗函数 Rank。
Rank 开窗函数是 SQL 中一种用于对查询结果集中的行进行 排名 的开窗函数。它可以根据指定的列或表达式对结果集中的行进行排序,并为每一行分配一个排名。在排名过程中,相同的值将被赋予相同的排名,而不同的值将被赋予不同的排名。
当存在并列(相同排序值)时,Rank 会跳过后续排名,并保留相同的排名。
Rank 开窗函数的常见用法是在查询结果中查找前几名(Top N)或排名最高的行。
Rank 开窗函数的语法如下:
RANK() OVER (
  PARTITION BY 列名1, 列名2, ... -- 可选,用于指定分组列
  ORDER BY 列名3 [ASC|DESC], 列名4 [ASC|DESC], ... -- 用于指定排序列及排序方式
) AS rank_column其中,PARTITION BY 子句可选,用于指定分组列,将结果集按照指定列进行分组;ORDER BY 子句用于指定排序列及排序方式,决定了计算 Rank 时的排序规则。AS rank_column 用于指定生成的 Rank 排名列的别名。
示例
假设我们有订单表 orders,表格数据如下:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
现在,我们希望为每个客户的订单按照订单金额降序排名,并显示每个订单的详细信息。
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount,
    RANK() OVER (PARTITION BY customer_id ORDER BY total_amount DESC) AS customer_rank
FROM
    orders;
查询结果:
| order_id | customer_id | order_date | total_amount | customer_rank |
|---|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 | 1 |
| 3 | 101 | 2023-01-10 | 120 | 2 |
| 2 | 102 | 2023-01-05 | 350 | 1 |
| 4 | 103 | 2023-01-15 | 500 | 1 |
在上面的示例中,我们使用开窗函数 RANK 来为每个客户的订单按照订单金额降序排名(customer_rank),并使用 PARTITION BY 子句按照 customer_id 进行分组,并使用 ORDER BY 子句按照 total_amount 从大到小进行排序。
可以看到,开窗函数保留了原始订单的详细信息,同时计算了每个客户的订单金额排名。
4.4.4. row_number
Row_Number 开窗函数是 SQL 中的一种用于为查询结果集中的每一行 分配唯一连续排名 的开窗函数。
它与之前讲到的 Rank 函数,Row_Number 函数为每一行都分配一个唯一的整数值,不管是否存在并列(相同排序值)的情况。每一行都有一个唯一的行号,从 1 开始连续递增。
Row_Number 开窗函数的语法如下(几乎和 Rank 函数一模一样):
ROW_NUMBER() OVER (
  PARTITION BY column1, column2, ... -- 可选,用于指定分组列
  ORDER BY column3 [ASC|DESC], column4 [ASC|DESC], ... -- 用于指定排序列及排序方式
) AS row_number_column其中,PARTITION BY子句可选,用于指定分组列,将结果集按照指定列进行分组。ORDER BY 子句用于指定排序列及排序方式,决定了计算 Row_Number 时的排序规则。AS row_number_column 用于指定生成的行号列的别名。
示例
假设我们有订单表 orders,表格数据如下:
| order_id | customer_id | order_date | total_amount |
|---|---|---|---|
| 1 | 101 | 2023-01-01 | 200 |
| 2 | 102 | 2023-01-05 | 350 |
| 3 | 101 | 2023-01-10 | 120 |
| 4 | 103 | 2023-01-15 | 500 |
现在,我们希望为每个客户的订单按照订单金额降序排列,并且分配一个 row_number 编号,示例 SQL 语句如下:
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount,
    ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY total_amount DESC) AS row_number
FROM
    orders;
结果将是:
| order_id | customer_id | order_date | total_amount | row_number |
|---|---|---|---|---|
| 4 | 103 | 2023-01-15 | 500 | 1 |
| 2 | 102 | 2023-01-05 | 350 | 1 |
| 1 | 101 | 2023-01-01 | 200 | 1 |
| 3 | 101 | 2023-01-10 | 120 | 2 |
在上面的示例中,我们使用开窗函数 ROW_NUMBER 为每个客户的订单按照订单金额降序排列,并为每个订单分配了一个编号(row_number),并使用 PARTITION BY 子句按照 customer_id 进行分组,并使用 ORDER BY 子句按照 total_amount 进行排序。
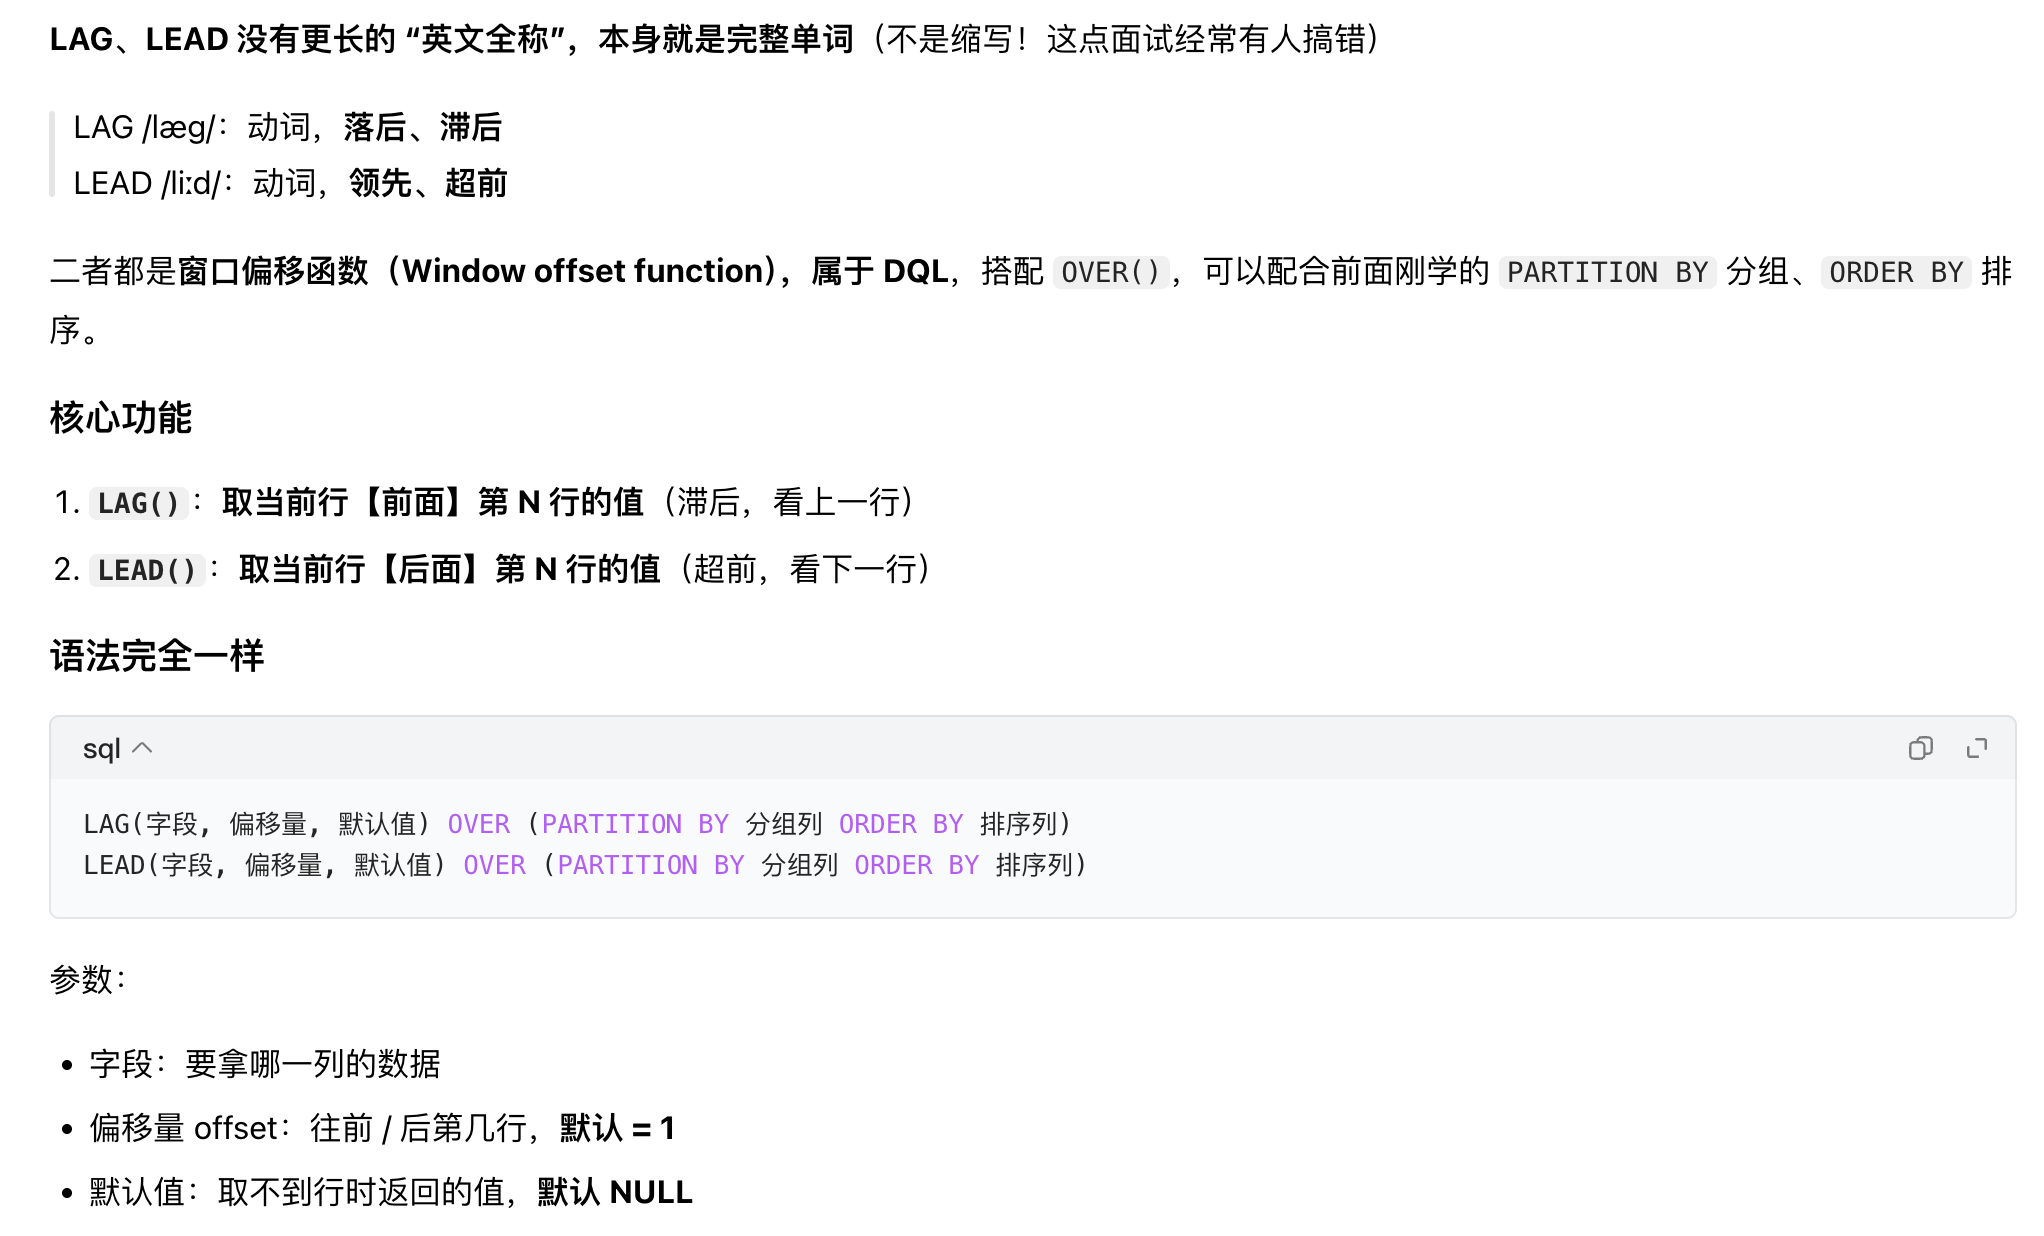
4.4.5. lag / lead
开窗函数 Lag 和 Lead 的作用是获取在当前行之前或之后的行的值,这两个函数通常在需要比较相邻行数据或进行时间序列分析时非常有用。
1)Lag 函数
Lag 函数用于获取 当前行之前 的某一列的值。它可以帮助我们查看上一行的数据。
Lag 函数的语法如下:
LAG(column_name, offset, default_value) OVER (PARTITION BY partition_column ORDER BY sort_column)参数解释:
column_name:要获取值的列名。offset:表示要向上偏移的行数。例如,offset为1表示获取上一行的值,offset为2表示获取上两行的值,以此类推。default_value:可选参数,用于指定当没有前一行时的默认值。PARTITION BY和ORDER BY子句可选,用于分组和排序数据。
2)Lead 函数
Lead 函数用于获取 当前行之后 的某一列的值。它可以帮助我们查看下一行的数据。
Lead 函数的语法如下:
LEAD(column_name, offset, default_value) OVER (PARTITION BY partition_column ORDER BY sort_column)参数解释:
column_name:要获取值的列名。offset:表示要向下偏移的行数。例如,offset为1表示获取下一行的值,offset为2表示获取下两行的值,以此类推。default_value:可选参数,用于指定当没有后一行时的默认值。PARTITION BY和ORDER BY子句可选,用于分组和排序数据。
示例
以下是一个示例,假设我们有一个学生成绩表scores,其中包含学生的成绩和考试日期:
| student_id | exam_date | score |
|---|---|---|
| 101 | 2023-01-01 | 85 |
| 101 | 2023-01-05 | 78 |
| 101 | 2023-01-10 | 92 |
| 101 | 2023-01-15 | 80 |
现在我们想要查询每个学生的考试日期和上一次考试的成绩,以及下一次考试的成绩,示例 SQL 如下:
SELECT
    student_id,
    exam_date,
    score,
    LAG(score, 1, NULL) OVER (PARTITION BY student_id ORDER BY exam_date) AS previous_score,
    LEAD(score, 1, NULL) OVER (PARTITION BY student_id ORDER BY exam_date) AS next_score
FROM
    scores;
结果将是:
| student_id | exam_date | score | previous_score | next_score |
|---|---|---|---|---|
| 101 | 2023-01-01 | 85 | NULL | 78 |
| 101 | 2023-01-05 | 78 | 85 | 92 |
| 101 | 2023-01-10 | 92 | 78 | 80 |
| 101 | 2023-01-15 | 80 | 92 | NULL |
在上面的示例中,我们使用 Lag 函数获取每个学生的上一次考试成绩(previous_score),使用 Lead 函数获取每个学生的下一次考试成绩(next_score)。如果没有上一次或下一次考试,对应的列将显示为 NULL。
5. 截图
5.1. DDL/DML/DQL/DCL/TCL
5.2. lag/lead