多级指针
2026-09-02
// 声明一个变量
var a int = 10

// 声明一个指针变量
var p *int

// 初始化指针,指向变量 a 的地址
p = &a

// 访问指针对应的变量值
fmt.Println(*p) // 输出 10

// 通过指针修改变量值
*p = 20
fmt.Println(a) // 输出 20var abcc **int = &abc
fmt.Println(abcc) // 0x10df06fc6050
fmt.Println(*abcc) // 0x10df06fd60e8
fmt.Println(**abcc) // 20cors
2026-09-19
报错这个,说明可能服务器和nginx重复配置了 CORS 请求头,要删除其中一个
Access to fetch at 'https://fly.a.com/a-cloudagent-api/acp/stream' from origin 'https://a-cloudagent.pages.a.com' has been blocked by CORS policy: The 'Access-Control-Allow-Origin' header contains multiple values '*, *', but only one is allowed. Have the server send the header with a valid value.类型断言
2026-09-02
类型断言用于将接口类型的值转换为具体类型的值。如果你有一个接口类型的变量,可以使用类型断言来提取其动态类型和值。
// <目标类型的值>,<布尔参数> := <表达式>.( 目标类型 )

var x interface{} = 10
y := x.(int)  // 将 x 断言为 int 类型

y, ok := x.(int)
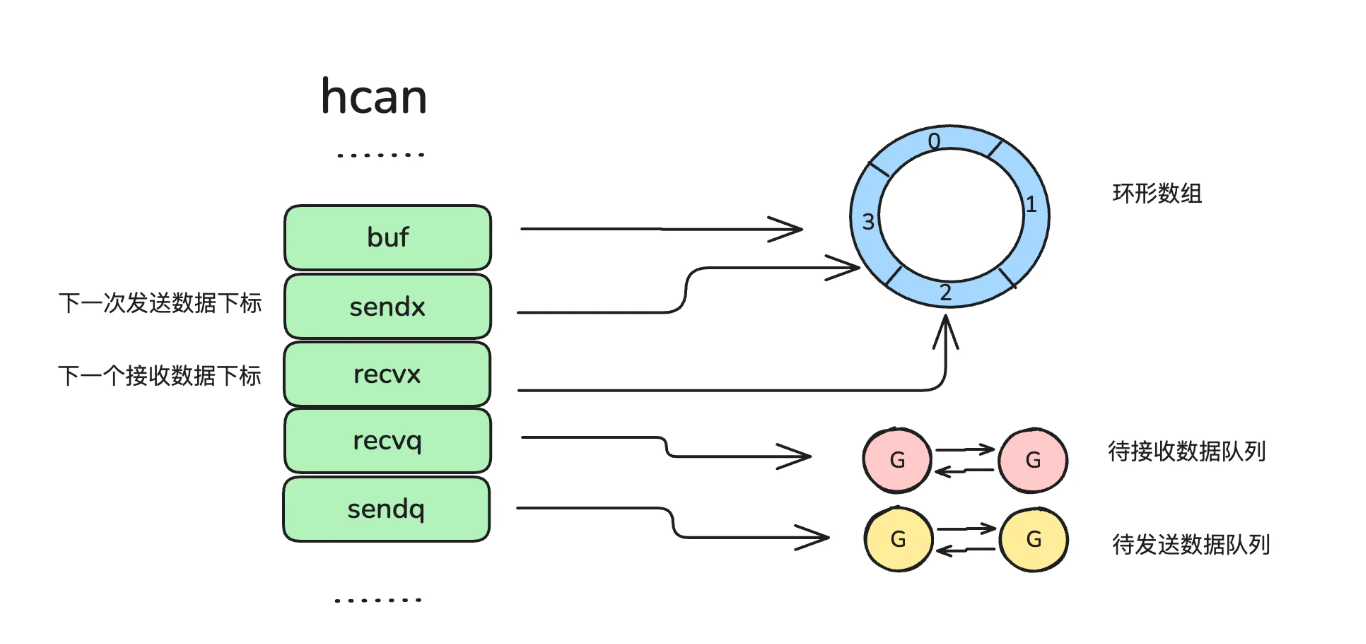
Go 语言向 channel 发送数据的过程是怎样的?
2026-09-02
从源码来看,总结过程如下:
- 检查 channel 状态:如果 channel 为 nil 或已关闭,立即返回错误。
- mutex 加锁:确保对 channel 状态的修改是线程安全的。
- 寻找接收方:如果有等待队列 recvq 中有的接收方,直接将数据发送给接收方并唤醒它。
- 写入缓冲区:如果没有等待的接收方,且缓冲区未满,则将数据写入缓冲区,即 sendx 位置,并更新它。
- 阻塞等待:如果缓冲区已满,则当前 Goroutine 将被阻塞,将其加入到 sendq 队列中,直到有接收方接收数据。
channel
2026-09-02
很多人第一次学习 channel,会把它理解成“线程安全队列”。这个说法能帮助入门,却不够完整。
队列主要解决“数据放在哪里”;channel 同时解决了两件事:
- 通信:把一个值从发送方交给接收方;
- 同步:条件不满足时挂起 goroutine,条件满足后再唤醒它。
docker 日志
2026-09-02
- 最省事,绕过 compose 直接问 Docker(容器名固定是 bump-go)
docker logs -f bump-go- 用 compose,必须带 -f
cd packages/bump-go/deploy
docker compose -f docker-compose.prod.yml logs -f- 看有哪些 compose 项目在跑
docker compose lsLinux 查看 CPU、内存、磁盘、负载常用命令
2026-09-02
一、CPU
top(综合实时监控,最常用)
top- 整体负载:
load average: 1.2, 0.8, 0.5→ 分别是 1 分钟、5 分钟、15 分钟系统负载 %Cpu(s):CPU 占用明细,us用户态、sy内核态、id空闲、wa等待 IO- 交互键:
P按 CPU 使用率排序,M按内存排序,1展开多核,q退出
htop(top 增强版,需要安装)
htop彩色界面、支持鼠标、操作更直观。
lscpu 查看 CPU 硬件信息(静态)
lscpu看核数、线程数、CPU 型号、架构:
CPU(s):总逻辑核数Core(s) per socket:每个插槽的物理核数Socket(s):CPU 插槽颗数
mpstat 看 CPU 细分使用率
mpstat -P ALL 1每 1 秒输出所有 CPU 核心的占用情况。
二、内存
free 查看内存
free -h-h = human readable,人类可读单位(G/M)。
              total        used        free      shared  buff/cache   available
Mem:           15Gi       2.3Gi       8.0Gi       230Mi       5.1Gi        12Gi
Swap:          15Gi          0B        15Gi
available 才是真正可分配给程序的内存,不要只看 free(free 没算上可回收的 buff/cache)。
vmstat 虚拟内存、IO、CPU 综合
vmstat 1每秒刷新;si、so 是 swap 换入换出,持续不为 0 说明内存不足。
三、磁盘
df 磁盘分区整体使用率
df -hdu 查看目录占用大小
du -sh *        # 当前目录下各个子目录大小
du -sh /data    # 看指定目录
-s 汇总,-h 人类可读。
iostat 磁盘 IO 性能
iostat -x 1看磁盘读写、%util 磁盘繁忙度,定位 IO 瓶颈。
lsblk 块设备(硬盘分区结构)
lsblk看硬盘、分区、挂载点,不看使用率。
四、系统整体负载
uptime
# 14:35:22 up 12 days,  4:12,  2 users,  load average: 0.31, 0.42, 0.38
五、进程资源
ps aux --sort=-%mem    # 按内存排序看进程
ps aux --sort=-%cpu    # 按 CPU 排序
六、网络(顺带常用)
ss -tulnp        # 现代替代 netstat,推荐
netstat -tulnp
七、速查表
| 目的 | 命令 |
|---|---|
| 实时整体监控 CPU / 内存 / 进程 | top / htop |
| 看内存总量与空闲 | free -h |
| CPU 硬件规格 | lscpu |
| 磁盘分区使用率 | df -h |
| 目录文件占用大小 | du -sh * |
| 磁盘 IO 性能 | iostat -x 1 |
| 虚拟内存 / swap 状态 | vmstat 1 |
| 简单系统负载 | uptime |
八、小提示
很多最小化系统没有 htop / iostat,需要安装:
# centos
yum install htop sysstat
# ubuntu/debian
apt install htop sysstat
sysstat 包提供:mpstat、iostat、vmstat。
Linux 进程相关高频命令
2026-09-02
面试常考:ps、top、htop、pstree、pgrep、pidof、kill、killall、nice、renice。
一、ps 查看进程快照(静态,一瞬间状态)
ps = process status,输出瞬间进程信息,不会实时刷新。
ps aux      # BSD 风格:a 所有用户进程,u 显示用户/CPU/内存,x 无终端后台进程
ps -ef      # System-V 风格:-e 全部进程,-f 完整格式(PPID 父 PID、CMD 命令)
ps aux 列含义:
| 列 | 说明 |
|---|---|
USER | 进程所属用户 |
PID | 进程 ID(重点) |
%CPU | CPU 占用百分比 |
%MEM | 内存占用百分比 |
VSZ | 虚拟内存 |
RSS | 实际物理内存 |
TTY | 终端,? 代表后台守护进程 |
STAT | 进程状态 |
START | 启动时间 |
TIME | 累计 CPU 时间 |
COMMAND | 启动命令 |
STAT 进程状态字母(面试考点)
R:Running 运行中S:Sleep 可中断休眠(等待事件,大部分进程是 S)D:不可中断休眠(IO 阻塞,磁盘忙,不能被信号打断)Z:Zombie 僵尸进程,子进程退出但父进程没回收T:Stopped 停止 / 暂停
二、top 实时进程监控(动态刷新,默认 3 秒)
top交互快捷键(运行 top 之后按):P 按 CPU 排序,M 按内存排序,q 退出,k 输入 PID 杀死进程,1 展开多核。
升级版 htop,界面更友好,需 yum / apt 安装。top 头部显示系统负载、总任务数、CPU、内存与 swap 使用。
三、pstree 进程树
以树状显示父子进程关系:
pstree        # 树状
pstree -p     # 显示 PID
pstree -up    # 显示 PID + 用户
四、根据程序名查 PID:pgrep / pidof
pgrep nginx         # 输出 nginx 所有 pid
pgrep -l nginx      # -l 同时输出 PID + 进程名
pgrep -u root sshd  # 指定用户 root 的 sshd 进程
pidof nginx # 精确完整程序名,返回全部 pid区别:pgrep 支持部分名字模糊匹配;pidof 需要完整程序名。
五、进程信号 kill、killall、pkill
kill 不是"杀死",而是发送信号给进程。
| 信号编号 | 名称 | 作用 |
|---|---|---|
1 | SIGHUP | 重新加载配置,平滑重启 |
2 | SIGINT | Ctrl+C,中断 |
9 | SIGKILL | 强制杀死,不能被忽略 / 捕获,暴力杀进程 |
15 | SIGTERM | 默认信号,优雅终止,进程可做清理工作(kill 不加 -NUM 默认 15) |
kill 1234          # 默认发 15(SIGTERM),优雅结束
kill -15 1234
kill -9 1234       # 强制杀死,万不得已才用,资源可能泄漏

pkill nginx        # 按名字发 15 信号
pkill -9 nginx     # 强制杀掉所有 nginx 进程
killall nginx
pkill 是模糊匹配,名字相似的进程会被误杀,优先 pgrep 先确认再 kill。
六、进程优先级 nice / renice
nice:启动进程时设置优先级,范围-20 ~ 19- 数值越小,优先级越高;只有 root 才能设置负数
- 默认
nice=0
nice -n 5 ./test.sh       # 启动时 nice 值设 5,优先级变低
renice -n -5 -p 1234      # 修改已运行进程 pid=1234 的 nice 为 -5,调高优先级
七、前后台作业 jobs、bg、fg、&、Ctrl+Z
sleep 100 &   # & 放到后台运行
jobs          # 查看后台作业列表(Ctrl+Z 暂停当前进程并放入后台停止状态)
bg %1         # 把后台 1 号暂停作业,继续后台运行
fg %1         # 把后台作业拉回前台
八、面试高频考点汇总
- 僵尸进程 Z:子进程结束,父进程没有
wait/waitpid回收子进程退出状态;孤儿进程:父进程挂掉,子进程被 systemd 收养。 kill -15和kill -9区别:-15 SIGTERM:优雅退出,进程可捕获信号,关闭文件、清理资源;-9 SIGKILL:内核直接销毁进程,进程无法拦截,不做清理,慎用。
- D 状态不可中断睡眠:IO 阻塞、磁盘问题,
kill -9也杀不掉,只能等 IO 完成或重启机器。 ps aux是静态快照,top是动态实时。
九、高频面试题示例
Q:怎么查看系统有没有 nginx 进程?
ps aux | grep nginx
pgrep -l nginx
pidof nginx
Q:怎么强制杀掉所有 java 进程?
pkill -9 java
# 稳妥做法先看 pid
pgrep java
kill -9 pid
Q:怎么看父子进程关系?
pstree -p,或者 ps -ef 看 PPID 字段。
十、坑提醒
ps aux | grep xxx会出现 grep 自身那条进程,是正常现象。- 不要一上来就
kill -9,优先用默认的 15 信号。
Docker 常用命令
2026-09-02
一、信息查看
docker --version
docker -v          # 查看版本
docker info        # 查看 docker 详细信息
docker 命令 --help  # 查看帮助
二、镜像 image
docker search nginx        # 搜索镜像
docker pull nginx          # 拉取镜像,不加 tag 默认 latest
docker pull nginx:1.27

docker images              # 列出本地镜像
docker images -a           # 显示全部(含中间镜像)

docker rmi 镜像id           # 删除镜像
docker rmi -f 镜像id        # 强制删除
docker image prune -a      # 批量删除无用镜像

docker save -o nginx.tar nginx:1.27   # 导出镜像
docker load -i nginx.tar              # 导入镜像

docker build -t myapp:v1 .            # 构建镜像(Dockerfile)
docker build --no-cache -t myapp:v1 . # 不使用缓存构建
三、容器 container
# 创建并启动容器
# -d 后台运行;-p 宿主机端口:容器端口;--name 容器名
docker run -d -p 8080:80 --name mynginx nginx

# 交互式启动,进入容器
docker run -it --name test ubuntu /bin/bash

docker ps        # 列出运行中容器
docker ps -a     # 列出所有(包括停止的)

docker start 容器id/名字
docker stop 容器id/名字
docker restart 容器id/名字
docker kill 容器id          # 强制杀死容器

docker rm 容器id            # 删除容器(必须先 stop)
docker rm -f 容器id         # 强制删除正在运行的容器
docker container prune      # 清理所有停止的容器
进入正在运行的容器:
docker exec -it mynginx /bin/bash
docker exec -it myalpine sh      # alpine 镜像没有 bash,用 sh
容器日志:
docker logs 容器id
docker logs -f --tail 100 mynginx    # -f 实时跟踪;--tail 只看最后 n 行
文件拷贝(宿主机 ↔ 容器):
docker cp ./test.txt mynginx:/tmp/        # 宿主机 → 容器
docker cp mynginx:/tmp/test.txt ./        # 容器 → 宿主机
四、数据卷 volume(持久化)
docker volume create myvol       # 创建卷
docker volume ls                 # 列出卷
docker volume inspect myvol      # 查看卷详情
docker volume prune              # 删除未使用卷

docker run -d -v myvol:/usr/share/nginx/html nginx   # 使用卷启动容器
docker run -d -v /host/path:/container/path nginx    # 挂载宿主机目录(绑定挂载)
五、网络 network
docker network ls                  # 查看网络
docker network create mynet        # 创建自定义网络
docker network connect mynet 容器名  # 将容器加入网络
docker network rm mynet            # 删除网络
docker network prune
六、docker-compose(多容器编排)
需要安装 docker-compose:
docker-compose up            # 前台启动
docker-compose up -d         # 后台启动
docker-compose stop          # 停止,不删除容器
docker-compose down          # 停止并删除容器、网络
docker-compose down -v       # down 同时删除数据卷
docker-compose logs -f       # 查看日志
docker-compose up -d --build # 重新构建镜像再启动
七、系统清理(非常常用)
# 一键清理:停止的容器、无用镜像、无用网络,不删 volume
docker system prune

# 全部清理(含未使用的数据卷,谨慎)
docker system prune -a --volumes
八、高频组合速查
docker rm -f $(docker ps -aq)      # 删除所有容器
docker rmi -f $(docker images -q)  # 删除所有镜像
Shell 字符串拼接、截取
2026-09-02
bash shell,所有示例可直接复制到终端运行。
一、字符串拼接
Shell 拼接不需要运算符,直接把变量放一起即可。
a="hello"
b="world"

c="$a$b"          # 直接写在一起(最常用)→ helloworld
c="$a $b"         # 中间加空格/分隔符 → hello world
c="prefix_${a}_suffix"   # 变量和字面量混合 → prefix_hello_suffix

str="abc"
str+="123"        # += 追加(bash 4+ 支持)→ abc123
建议变量使用 ${var} 大括号形式,避免和后面字符混淆。
二、字符串截取(参数扩展 ${})
格式:${变量:起始位置:长度},下标从 0 开始;起始为负数表示从尾部倒数,负数前面要加空格 ${str: -N}。
str="abcdefg"

echo ${str:0:3}    # abc   从 0 开始取 3 个字符
echo ${str:2:2}    # cd    下标 2 开始取 2 个
echo ${str:3}      # defg  从下标 3 取到结尾
echo ${str: -2}    # fg    取最后 2 个字符(冒号后面有空格!)
echo ${str: -4:3}  # def   倒数第 4 位,取 3 个
三、模式匹配截取(按字符/后缀删除,非常高频)
| 语法 | 作用 |
|---|---|
${str#pattern} | 从开头,删除最短匹配 |
${str##pattern} | 从开头,删除最长匹配 |
${str%pattern} | 从结尾,删除最短匹配 |
${str%%pattern} | 从结尾,删除最长匹配 |
file="app.tar.gz"

echo ${file#*.}     # tar.gz  删除第一个 . 以及前面内容
echo ${file##*.}    # gz      获取文件后缀
echo ${file%.*}     # app.tar 删除最后一个 . 后面内容
echo ${file%%.*}    # app     删除全部 . 后面内容

url="/home/abc/test.txt"
echo ${url##*/}     # test.txt  取文件名(去掉路径)
echo ${url%/*}      # /home/abc 取目录(去掉文件名)
四、字符串常用辅助
获取长度 ${#var}
s="123456"
echo ${#s}   # 6
字符串替换
str="aa bb cc bb"

echo ${str/bb/XX}    # aa XX cc bb   替换第一个匹配
echo ${str//bb/XX}   # aa XX cc XX   全部替换
echo ${str/#aa/>>}   # >> bb cc bb   只替换开头
echo ${str/%bb/<<}   # aa bb cc <<   只替换结尾
空值默认值
echo ${var:-"default"} # 变量为空则使用默认值五、完整小例子汇总
#!/bin/bash

name="Shell"
ver="5.0"

info="${name}_${ver}"
echo $info

text="hello_shell_demo.txt"
echo "长度: ${#text}"
echo "前5字符: ${text:0:5}"
echo "最后4字符: ${text: -4}"
echo "后缀: ${text##*.}"
echo "去掉后缀: ${text%.*}"
echo "替换hello→hi: ${text/hello/hi}"
六、坑点提醒
${str:-2}❌ 错误;倒数必须加空格${str: -2}✅- 双引号包裹变量
"$str",防止空格、特殊字符出问题 ###是删开头;%%%删结尾,不要记反- 模式里
*代表任意字符
Shell for 循环
2026-09-02
bash 中 for 有三种常用写法:遍历列表、C 语言风格 for、遍历命令输出。
一、for in 遍历列表(最常用)
for 变量 in 列表
do
    # 循环体
done
示例 1:直接枚举值
#!/bin/bash
for i in apple banana orange
do
  echo "水果: $i"
done
示例 2:数字序列 {start..end}
for i in {1..5};    do echo $i; done   # 1~5
for i in {5..1};    do echo $i; done   # 倒序 5~1
for i in {1..10..2};do echo $i; done   # 步长 2(bash 4+,{start..end..step})
示例 3:遍历文件
for f in *.txt
do
  echo "文件:$f"
done
示例 4:遍历变量 / 命令输出
str="a b c d"
for item in $str
do
  echo $item
done

# 遍历 ls 输出(不推荐直接 ls,仅演示)
for file in $(ls)
do
  echo $file
done
坑:文件名带空格时 $(ls) 会出错;处理文件优先用 glob *.txt,不要解析 ls 输出。
二、C 语言风格 for (( ))
适合数字循环,双括号,下标、判断、自增,仅 bash 支持,sh 不支持。
for ((初始化; 条件; 迭代))
do
  command
donefor ((i=1; i<=10; i++)); do echo $i; done # 1 到 10
for ((i=10; i>0; i--)); do echo $i; done # 倒序
for ((i=0; i<=20; i+=3));do echo $i; done # 步长 3三、遍历命令输出(while read,处理带空格行,重要)
for 按空格分割;读取文件每一行要用 while read,不要用 for。
while read -r line
do
  echo "行内容:$line"
done < test.txt
对比:
for i in $(cat test.txt):按空白分割,一行有空格会拆成多个变量,不适合读行while read -r line:按换行分割,正确处理每行,生产常用
四、break / continue
break:跳出整个循环continue:跳过本次,进入下一轮循环
for ((i=1;i<=10;i++))
do
  if [ $i -eq 3 ];then
    continue
  fi
  if [ $i -eq 7 ];then
    break
  fi
  echo $i
done
# 输出:1 2 4 5 6
五、一行简写(分号分隔 do done)
for i in {1..3}; do echo $i; done
for ((i=1;i<=5;i++)); do echo $i; done
六、常见坑总结
for (( ))是 bash 语法,sh script.sh会报错,要用bash script.sh{1..10}不能放变量:a=10; for i in {1..$a}❌ 不生效;变量数字循环用for (( ))- 处理带空格文件名不要用
$(ls),用通配符 glob - 读取文本行优先
while read -r,不要for in $(cat file)
七、小练习
# 打印 1-20 偶数
for ((i=2;i<=20;i+=2));do echo $i;done
Shell 条件判断
2026-09-02
Shell 条件主要:if、test、[ ]、[[ ]]、case。
[ ]就是test命令,POSIX 标准,括号两边必须空格[[ ]]是 bash 增强语法,支持正则、&&、||、通配符,不用转义,推荐脚本使用
一、if 基础语法
if 条件; then
  # 成立执行
elif 条件2; then
  # 条件2 成立
else
  # 都不成立
fia=10
if [[ $a -gt 5 ]]; then echo "大于5"; fi二、数字比较(整数,不能用于字符串)
只能用 -eq -ne -gt -ge -lt -le,不要在 [ ] 里面用 > <。
| 运算符 | 含义 |
|---|---|
-eq | 等于 equal |
-ne | 不等于 not equal |
-gt | 大于 greater than |
-ge | 大于等于 greater equal |
-lt | 小于 less than |
-le | 小于等于 less equal |
x=8
if [[ $x -eq 8 ]]; then echo "等于8"; fi
if [[ $x -gt 3 ]];  then echo "大于3"; fi
if [[ $x -lt 10 ]]; then echo "小于10"; fi坑:if [ $x > 5 ] 在单中括号里 > 会被当做重定向!要用 [[ $x > 5 ]] 或者 (( x > 5 ))。
(( )) 数学条件(bash)
双括号可以直接写数学表达式,写 > < ==:
if (( x > 5 )); then
  echo "x大于5"
fi
三、字符串判断
| 条件 | 说明 |
|---|---|
[[ $str == "abc" ]] | 字符串相等 |
[[ $str != "abc" ]] | 不相等 |
[[ -z $str ]] | 字符串为空 zero,长度 0 |
[[ -n $str ]] | 字符串非空 not zero,有内容 |
[[ $str =~ ^a.*b$ ]] | 正则匹配(仅 [[ ]] 支持) |
name="shell"
if [[ $name == "shell" ]]; then echo "相等"; fi

str=""
if [[ -z $str ]]; then echo "字符串为空"; fi

s="hello123"
if [[ $s =~ ^hello ]]; then echo "以hello开头"; fi注意:== 在 [[ ]] 里支持通配符:[[ $str == he* ]]。
四、文件测试条件(高频)
| 条件 | 作用 |
|---|---|
-e file | 文件是否存在 exist |
-f file | 存在并且是普通文件 file |
-d file | 存在并且是目录 directory |
-r file | 可读 read |
-w file | 可写 write |
-x file | 可执行 execute |
-s file | 文件大小 > 0,非空文件 |
f="./test.txt"
if [[ -f $f ]];    then echo "普通文件存在"; fi
if [[ -d "./dir" ]];then echo "是目录"; fi
五、多条件 与 / 或
在 [[ ]] 内部:&& 逻辑与(同时成立),|| 逻辑或(一个成立即可)。
a=6
if [[ $a -gt 2 && $a -lt 10 ]]; then echo "2<a<10"; fi
if [[ $a -lt 3 || $a -gt 8 ]];  then echo "小于3或者大于8"; fi
单中括号 [ ] 里面不能直接写 && ||,要用 -a -o(不推荐,优先用 [[ ]]):
if [ $a -gt 2 -a $a -lt 10 ]; then echo "ok"; fi六、case 多分支匹配
适合字符串多值判断,支持通配符 *:
#!/bin/bash
opt="b"
case $opt in
  a)
    echo "选项a"
    ;;
  b)
    echo "选项b"
    ;;
  c|d) # c 或者 d
    echo "c或d"
    ;;
  *) # 默认,其他所有情况
    echo "其他输入"
    ;;
esac
七、常见坑汇总
[ ]括号内侧必须有空格:[$a -gt 1]❌;[ $a -gt 1 ]✅- 数字比较用
-eq/-gt;字符串用==!=,不要混用 [ ]内部不能直接用&&||><,改用[[ ]]- 判断空字符串建议
[[ -z "$var" ]],变量加引号防止变量为空时语法报错 {1..$n}不能展开变量;数字循环用for (( ))(( ))只做整数运算,不支持小数
八、综合小示例(字符串 + 循环 + 条件)
#!/bin/bash
str="hello.txt"

# 判断后缀
if [[ ${str##*.} == "txt" ]]; then
  echo "是txt文件"
fi

# 循环 + 条件
for ((i=1;i<=10;i++))
do
  if (( i % 2 == 0 )); then
    echo "$i 是偶数"
  fi
done
题目:获取根分区 / 的磁盘使用率纯数字
2026-09-02
目标:拿到类似 78,而不是 78%。
df / 直接输出根分区信息,示例输出:
Filesystem     1K-blocks     Used Available Use% Mounted on
/dev/sda1 209715200 45234120 154321000 22% /字段:$1 文件系统 | $2 总 | $3 已用 | $4 可用 | $5 使用率(22%)| $6 挂载点
选项拆解
✅ A
df / | grep / | awk '{ print $5 }' | sed 's/%//g'df /:输出根分区磁盘信息grep /:过滤出包含/的那一行(过滤掉表头标题行,表头里没有/)awk '{print $5}':取出第 5 列,得到22%sed 's/%//g':替换,把百分号%删除,输出纯数字22
输出结果是纯数字,符合题目要求。
❌ B df -h | grep / | awk '{ print $5 }'
-h 人类可读格式,能拿到 22%,结果带百分号 %,不是纯数字,不符合需求。
❌ C df / | awk '{ print $5 }' | cut -d'%' -f1
df / 的输出第一行是表头,没有被过滤。awk 会先打印表头的第 5 列(字符串 Use%),cut 之后变成 Use,输出脏数据。缺 grep 过滤有效数据行。
❌ D df / | grep / | awk '{ print $4 }'
$4 是可用空间(Available),不是使用率。
补充实操小知识点
sed 's/要替换/替换成/g':sed 's/%//g'把文本中所有%替换为空,等价于删掉百分号。cut -d'%' -f1:以%作为分隔符,取第 1 段。awk中$数字代表第几列,默认按空白分割。
小优化:实际工作可以省略 grep,awk 自身可以做匹配,不用管道给 grep:
df / | awk '/\//{print $5}' | sed 's/%//'
# 或者更直观地跳表头
df / | awk 'NR>1{print $5}' | sed 's/%//'
# 一步到位(去掉百分号,GNU df 支持)
df --output=pcent / | tr -d ' %'
坑点总结
- 要过滤掉表头行,不然会读到标题
- 题目要纯数字,必须去掉百分号
% - 分清字段:
$5= 使用率,不要和可用空间$4搞混
sed & awk 核心速记
2026-09-02
- sed:流编辑器,擅长行处理、替换、删除、输出行;面向行
- awk:文本分析语言,擅长列分割、统计、计算;面向字段(列)
一、sed 命令
sed [选项] '脚本' 文件名
# 管道用法:command | sed '脚本'
常用选项:
| 选项 | 说明 |
|---|---|
-n | 只输出匹配行,取消默认打印全部行 |
-i | 直接修改源文件(危险!测试不要直接 -i) |
-e | 多个编辑命令 |
1. s 替换(最常用)
# s/原字符串/新字符串/标记
# g = global 全局替换;不加 g 只替换每行第一个匹配
sed 's/old/new/g' test.txt

# 删除百分号,面试原题:s/%//g
echo "88%" | sed 's/%//g'    # 输出 88

# 只替换每行第一个 old
sed 's/old/new/' test.txt

# -n + p:只打印被替换的行
sed -n 's/old/new/p' test.txt
2. d 删除行
sed '2d' file        # 删除第 2 行
sed '1,3d' file      # 删除 1-3 行
sed '/error/d' file  # 删除包含 error 的行
3. p 打印行(配合 -n)
sed -n '2p' file        # 打印第 2 行
sed -n '/root/p' file   # 打印包含 root 的行
坑:不加 -n 会打印全部行 + 重复打印匹配行。
4. 地址范围
1,10:1 到 10 行/pattern/:匹配正则的行
面试原题片段:sed 's/%//g' 去掉百分号。
二、awk 命令
awk 把每行按空白分割为字段:$1 $2 $3 ... $0
$0代表整行全部内容$1第 1 列,$5第 5 列(df命令取使用率就是$5)NF内置变量:当前行一共有多少列NR内置变量:行号
awk [选项] '条件{动作}' 文件
# 管道:cat xxx | awk '{}'
基础示例
df / | awk '{print $5}'        # 打印第 5 列(df 那道题)
awk '{print $1,$3}' /etc/passwd # 打印第 1、3 列
awk '{print $0}' test.txt       # 打印整行
条件过滤
awk '/root/{print $1}' /etc/passwd   # 匹配包含 root 的行,打印第 1 列
awk '$3>100{print $0}' file          # 条件判断:第 3 列大于 100
内置变量高频
| 变量 | 含义 |
|---|---|
$0 | 完整一行文本 |
$1,$2... | 第 1、2…列 |
NF | 这一行总列数;$NF = 最后一列 |
NR | 当前行号 |
awk '{print $NF}' test.txt     # 打印每行最后一列
awk '{print NR,$0}' test.txt   # 打印行号 + 内容
-F 指定分隔符(非常高频)
默认按空格分割;-F 修改分隔符。
awk -F: '{print $1}' /etc/passwd   # 冒号分割,取第 1 列用户名
echo "78%" | awk -F% '{print $1}'  # 以 % 做分隔符
面试题 C 选项:cut -d'%' -f1 和 awk -F% '{print $1}' 效果等价。
awk BEGIN / END
BEGIN{}:处理文件之前执行 1 次END{}:全部行处理结束后执行 1 次,适合统计求和
awk 'BEGIN{sum=0} {sum+=$2} END{print sum}' test.txt三、sed vs awk 怎么选(面试必背)
- sed:擅长行层面
- 替换字符串、删除某些行、抽取某些行
- 不擅长多列处理、数学计算
- awk:擅长列、统计计算
- 按列提取、条件判断、求和、统计
- 单纯全局字符串替换也能做,但不如 sed 方便
等价功能对比:去掉字符串百分号 78% → 78
echo "78%" | sed 's/%//g'          # sed
echo "78%" | awk -F% '{print $1}'  # awk
四、经典管道组合(刷题原题)
df / | grep / | awk '{print $5}' | sed 's/%//g'
# 1. df 输出磁盘
# 2. grep 过滤有效行,去掉表头
# 3. awk $5 取出使用率字段 "22%"
# 4. sed 删掉百分号得到纯数字
五、cut 顺带对比(容易一起考)
cut:简单按分隔符切分文本,功能比 awk 弱。
cut -d'%' -f1 # -d 分隔符,-f 取第几段cut 只适合简单分割;awk 支持任意空白、正则、计算,更强大。
六、面试坑点
- sed 不加
-n,print/p动作会输出全部行;修改源文件用-i,测试千万不要直接上-i - awk
$NF是最后一列,很多人记不住 df输出有表头,如果不过滤表头,awk 会拿到脏数据- sed 替换标记
g代表全局;不写g只替换每行第一个匹配
七、练习题(手敲巩固)
# 1. 把文本所有 hello 替换成 hi
sed 's/hello/hi/g' test.txt

# 2. 打印 /etc/passwd 所有用户名(冒号分隔第 1 列)
awk -F: '{print $1}' /etc/passwd

# 3. 打印文件每行的最后一列
awk '{print $NF}' test.txt
grep 命令详解
2026-09-02
grep = Global Regular Expression Print,全局正则打印;作用:文本按模式匹配,打印匹配的行。
grep [选项] "匹配模式" 文件名
# 管道用法
cat file.txt | grep "关键词"
一、高频选项(面试必背)
| 选项 | 全称 | 功能 |
|---|---|---|
-i | --ignore-case | 忽略大小写匹配 |
-n | --line-number | 输出匹配行的行号 |
-v | --invert-match | 反向匹配,输出不匹配的行(非常高频) |
-c | --count | 只输出匹配到的行数,不输出内容 |
-o | --only-matching | 只打印匹配到的字符串本身,不打印整行 |
-r / -R | --recursive | 递归遍历目录下所有文件搜索;-R 跟随软链接 |
-l | --files-with-matches | 只输出匹配的文件名,不输出行内容 |
-L | --files-without-match | 输出不匹配的文件名 |
-E | --extended-regexp | 开启扩展正则,等价于 egrep,不用转义 ()+ |
-F | --fixed-strings | 把模式当做普通字符串,不解析正则,等价于 fgrep |
二、简单示例
grep "error" app.log        # 在文件中搜索 error
grep -i "error" app.log     # 忽略大小写找 error / Error / ERROR
grep -n "error" app.log     # 显示匹配行 + 行号
grep -v "error" app.log     # 反向:输出不含 error 的所有行
grep -c "error" app.log     # 统计包含 error 一共有多少行
grep -o "2026-[0-9]*" app.log   # 只打印匹配到的关键词文本,不是整行
grep -r "timeout" /var/log/    # 递归整个目录搜索关键词
grep -l "Exception" /var/log/*.log   # 只打印哪些文件包含关键词
三、正则使用
基础正则(默认 grep)
^行开头;$行结尾.任意单个字符;*前面字符 0 次或多次[]字符集合
grep "^root" /etc/passwd      # 以 root 开头的行
grep "bash$" /etc/passwd      # 以 bash 结尾的行
grep "root\|ftp" /etc/passwd  # 基础正则的 | 需要反斜杠转义
扩展正则 -E(推荐,不用大量转义)
grep -E "root|ftp" /etc/passwd   # -E 支持 | () + ?,不用转义

# 匹配 ip 简单示例
grep -E "[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}" access.log
旧写法 egrep "root|ftp" 等价于 grep -E "root|ftp"。
四、面试经典坑 1:ps aux | grep nginx
ps aux | grep nginx会多出来一条 grep nginx 自身进程。解决方法:
反向过滤掉 grep 自己
bashps aux | grep nginx | grep -v "grep"优先使用
pgrep(专门查进程)bashpgrep -l nginx
五、面试经典坑 2:grep 匹配空行
grep "^$" file.txt      # 找出所有空行
grep -v "^$" file.txt   # 找出非空行
六、结合管道的综合示例(真实工作场景)
# 1. 日志找 error,显示行号,忽略大小写
grep -ni "error" app.log

# 2. 过滤注释行(#开头)和空行,看配置文件有效内容
grep -v "^#" nginx.conf | grep -v "^$"

# 3. 统计访问日志中 404 出现多少次
grep -c " 404 " access.log

# 4. 只提取日志里面所有 IP 地址(-o 只输出匹配内容)
grep -oE "[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}" access.log
七、grep / egrep / fgrep 区别
- grep:基础正则;
|+( )需要加反斜杠转义 - egrep =
grep -E:扩展正则,|+()不用转义,写正则更舒服 - fgrep =
grep -F:完全关闭正则,全部字符当普通字面字符串;搜索含.*$特殊符号的文本非常好用,不会被解析成正则
八、面试题速问速答
- 怎么查看配置文件去掉注释和空行?
grep -v "^#" nginx.conf | grep -v "^$" - 递归查找目录下哪个文件包含字符串"warning"?
grep -rl "warning" /var/log - 找出文件中不包含"success"的行?
grep -v "success" test.txt ps aux | grep redis为什么会出现 grep 进程? 管道右边 grep 也是一个正在运行进程,会匹配 "redis" 字符串;用grep -v grep过滤,或者用pgrep。
九、补充小对比
- grep:行过滤,输出满足条件的整行
- awk:列处理,切割字段计算
- sed:行修改替换删除
skopeo 查询 TCR 镜像元信息
2026-09-02
容器镜像仓库是腾讯云 TCR(*.tencentcloudcr.com)。
一、登录
# TCR 域名,用户名 = 腾讯云账号 ID,密码 = TCR 访问凭证(不是腾讯云网页密码)
skopeo login tcr-xxxx.tencentcloudcr.com --username 100xxxxxx --password "TCR生成的访问密码"
登录之后即可直接 inspect。
二、查询远端镜像元信息(已 login)
skopeo inspect docker://tcr-xxx.tencentcloudcr.com/myns/demo:v1三、只提取镜像构建创建时间(配合 jq)
skopeo inspect docker://tcr-xxx.tencentcloudcr.com/myns/demo:v1 | jq -r '.Created'四、列出仓库全部 tag
skopeo list-tags docker://tcr-xxx.tencentcloudcr.com/myns/demo五、输出原始 manifest 调试
skopeo inspect --raw docker://tcr-xxx.tencentcloudcr.com/myns/demo:v1dig 命令
2026-09-02
dig +short image.uwayfly.comdig:DNS lookup 命令,查询域名 DNS 记录+short:精简输出参数,只返回解析结果(IP/CNAME),去掉一大段冗余 DNS 报文image.uwayfly.com:要查询的目标域名
作用
快速查出 image.uwayfly.com 这个域名解析到哪个 IP 地址,适合脚本里直接取 IP 使用。
迁移mysql数据
2026-09-02
一、在 ECS 上查看表
一行搞定全部表行数(不进交互):
mysql -u root -p -e "
SELECT table_name, table_rows FROM information_schema.tables
WHERE table_schema='koa_blog';"
二、在 ECS 上导出
cd ~
# 关键参数:--single-transaction 不锁表;--default-character-set 防中文乱码
mysqldump -u root -p \
  --single-transaction \
  --default-character-set=utf8mb4 \
  --databases koa_blog \
  > koa_blog_$(date +%Y%m%d).sql

# 压缩(体积能小 5-10 倍,传输快)
gzip koa_blog_$(date +%Y%m%d).sql
ls -lh koa_blog_*.sql.gz
补充说明:
- 用
--databases koa_blog会在 SQL 里自动带上CREATE DATABASE IF NOT EXISTS+USE,新机器上不用手建库 - 只要数据不要建表语句:加
--no-create-info;只要结构不要数据:加--no-data login_record如果很大只想留近期数据:mysqldump ... koa_blog login_record --where="event_at > '2026-01-01'"
三、传到 CVM
方式 A:本机中转(网络能连上两边就用这个)
# 本机执行
scp root@<ECS_IP>:~/koa_blog_20260826.sql.gz .
scp koa_blog_20260826.sql.gz root@<CVM_IP>:~/
方式 B:ECS 直传 CVM(更快,少一跳)
# 在 ECS 上执行
scp koa_blog_20260826.sql.gz root@<CVM_IP>:~/
四、在 CVM 上导入
# 1. 确认 MySQL 已装并运行
systemctl status mysqld    # 或 mysql,看发行版
mysql --version

# 2. 解压
gunzip koa_blog_20260826.sql.gz

# 3. 导入
mysql -u root -p < koa_blog_20260826.sql

# 4. 校验:表数量 + 行数要和 ECS 一致
mysql -u root -p -e "
SELECT table_name, table_rows FROM information_schema.tables
WHERE table_schema='koa_blog';"
五、对比大小
information_schema.tables.table_rows 对 InnoDB 是估算值,来自 B+ 树随机采样,误差常见 ±10%~50%,小表还经常显示 0。
两边都跑这条,再比
mysql -u root -p koa_blog -e "
SELECT 'article'      AS tbl, COUNT(*) AS cnt FROM article
UNION ALL SELECT 'comment',      COUNT(*) FROM comment
UNION ALL SELECT 'image',        COUNT(*) FROM image
UNION ALL SELECT 'login_record', COUNT(*) FROM login_record
UNION ALL SELECT 'message',      COUNT(*) FROM message
UNION ALL SELECT 'tag',          COUNT(*) FROM tag
UNION ALL SELECT 'type',         COUNT(*) FROM type
UNION ALL SELECT 'user',         COUNT(*) FROM user;"
如何在Nginx中实现请求的重定向?请举例说明
2026-09-02
在Nginx中实现请求的重定向,可以使用 rewrite、return 和 proxy_pass 指令来完成。这里我举个简单的例子:假设你要把所有访问 http://example.com/old-path 的请求重定向到 http://example.com/new-path。
你可以在你的 Nginx 配置文件中添加如下内容:
server {
    listen 80;
    server_name example.com;

    location /old-path {
        rewrite ^/old-path$ /new-path permanent;
    }

    location /new-path {
        # 处理新的路径,如需要可以进一步配置
    }
}
这段配置实现了以下几点:
- 监听域名
example.com的 80 端口。 - 当请求路径是
/old-path时,使用rewrite指令将其永久重定向(状态码301)到/new-path。 /new-path可以继续由 Nginx 处理,或者进一步配置。
扩展知识
return指令: 你还可以使用return指令来实现重定向,它是更简单、直接的方法。比如说:
location /old-path {
    return 301 /new-path;
}
这种方式效果和上面的 rewrite 是一样的,使用 301 表示永久重定向。
- 临时重定向:
有时候,我们需要临时重定向(状态码302),可以通过把重定向的状态码改成 302 实现:
location /old-path {
    return 302 /new-path;
}proxy_pass指令:
如果你想把请求重定向到另一个服务器而不仅仅是同一个站点内部的不同路径,可以使用 proxy_pass 指令:
location /old-path {
    proxy_pass http://other-server.com/new-path;
}- 全局配置重定向:
在有些情况下,你可能需要对整个站点应用重定向规则,可以在 server 块中使用:
server {
    listen 80;
    server_name example.com;

    if ($host = "old-domain.com") {
        return 301 http://new-domain.com$request_uri;
    }
}
这个配置会把 old-domain.com 访问请求重定向到 new-domain.com,并保留请求路径和查询参数。
- 条件重定向:
在 Nginx 中,你也可以根据条件来进行重定向,比如说根据 User-Agent:
if ($http_user_agent ~* "Mobile") {
    return 302 /mobile-version;
}
以上配置会把移动设备的用户重定向到 /mobile-version 路径。
统计 nginx 日志
2026-09-02
# 统计访问 Nginx 的客户端 IP,按访问次数从高到低,取前 N 个 IP
awk '{print $1}' /var/log/nginx/access.log | sort | uniq -c | sort -nr | head -n10

# 统计请求的 URL 路径,按访问次数从高到低,取 TOP N 访问接口 / 页面
awk '{print $7}' /var/log/nginx/access.log | sort | uniq -c | sort -nr | head -n10
DAO
2026-09-02
DAO = Data Access Object(数据访问对象)
一句话:把「操作数据库/缓存的代码」从「业务逻辑」里单独抽出来一层,这一层就叫 DAO。
ORM
2026-09-02
- 数据库里一张表 = 程序里一个结构体;
- 表里一行记录 = 一个结构体实例;
- 操作数据库 = 直接操作结构体。
docker-compose-dev 重启
2026-08-04
&& 在 YAML > 折叠里被丢了换行,sh 解析失败。改用列表形式: 试一下:
cd /Users/guowangyang/Documents/github/imooc-manus/mooc-manus

# 停掉旧容器
docker-compose -f docker-compose.yml down

# 用 dev compose 启动(代码热更新模式)
docker-compose -f docker-compose-dev.yml up -d
启动后 docker logs -f manus-api 应该能看到 [DEV] syncing deps... → uv run uvicorn ... --reload 输出。以后改代码只需要 docker-compose -f docker-compose-dev.yml restart manus-api,uvicorn 的 --reload 会自动检测变更并热重启(很多情况下连 restart 都不需要)。+
docker-compose-dev.yml
2026-08-04
完全正确!这就是开发模式的标准做法。volume mount 以后改代码只需要 docker-compose restart 就行。
帮你看下怎么写: 给你写完整的开发版 compose,挂载代码 + 自动 uv sync + 热重载: 好了。首次启动 + 以后改代码 只用一条命令:
# 首次:用 dev compose 启动
cd /Users/guowangyang/Documents/github/imooc-manus/mooc-manus
docker-compose -f docker-compose-dev.yml up -d

# 改代码后:只需重启(uvicorn --reload 会自动检测变更,大多数情况连重启都不需要)
docker-compose -f docker-compose-dev.yml restart manus-api关键优化:
./api:/app— 代码 volume mount,host 改了容器立刻生效--reload— uvicorn 自动检测文件变更热重载sh -c "uv sync && uv run uvicorn ..."— 启动时自动装依赖
改代码后验证日志(清爽版,只有你的业务日志):
docker logs -f manus-api 2>&1 | grep -vE "uvicorn\.(access|error)"现在 print() 被我加在 main.py 里了,启动时能看到详细的生命周期输出。改完代码重启就行,再也不需要 docker-compose build 了。
只看 docker 中的名称和状态
2026-08-04
docker ps --format "table {{.Names}}\t{{.Status}}"colima stop 卡住
2026-08-04
colima stop 卡住原因
stopping colima 一直不动,就是vz虚拟机僵尸卡死,这是M系列mac上colima的经典问题。
vz驱动的虚拟机有时候正常关机流程卡死,
colima stop命令就会无限等待虚拟机响应,但虚拟机内部已经挂掉,永远不会返回。
解决,不要等它自己结束
直接新开一个终端tab,不要在卡住的窗口死等。
1、杀掉卡住的colima进程
pkill -9 colima
pkill -9 lima
pkill -9 vz
-9强制杀死,不等优雅退出。原来卡住的那个终端会直接终止。
2、销毁坏掉的实例(必须做,否则下次start还报错)
colima delete3、重新启动(给一组实用参数,分配CPU内存)
M系列推荐:4核,8G内存,使用vz
colima start --vm-type vz --cpu 4 --memory 8为什么会频繁卡住?
- Mac睡眠唤醒:mac休眠之后,vz虚拟机内部进程容易崩掉,外部进程残留,之后stop/start全部卡死。这是vz虚拟化框架本身的bug。
- 直接关闭终端、强制重启mac,没有正常
colima stop,虚拟机状态损坏。 - colima版本旧,升级到最新版可以缓解:
brew update && brew upgrade colima日常使用避坑小习惯
- Mac准备睡眠前,最好执行
colima stop,再合上盖子,减少僵尸状态。 - 一旦发现stop卡住,不要等待,直接
pkill -9杀进程,再delete重建。 - 如果频繁复现,可以换成qemu驱动,稳定性更高,性能稍微差一点:
colima delete
colima start --vm-type qemu --cpu 4 --memory 8
永久保存配置,不用每次敲参数
colima template edit写入下面内容:
vmType: vz
cpu: 4
memory: 8
保存退出,以后直接 colima start 就自动用这套配置。
小提醒:
colima delete会删掉本地docker镜像和容器,如果有重要镜像,先docker save导出备份。
uv 开发项目
2026-08-04
两个新问题,都是常见踩坑:
VIRTUAL_ENV环境变量还残留着(指向之前根目录的.venv),uv 在警告from app.infrastructure.logging import setup_logging报No module named 'app'——直接python app/main.py跑不了一个 package,得用python -m app.main
解决办法
问题 1:ModuleNotFoundError: No module named 'app'
api/app/ 是个 package(有 __init__.py),里面用 from app.xxx import yyy。直接 python app/main.py 跑时,app 不在 sys.path 上,所以 import app 失败。
必须用 python -m app.main(module 方式跑),这样 Python 会把当前目录加进 sys.path。
问题 2:VIRTUAL_ENV 警告
之前 source .venv/bin/activate 留下的环境变量 VIRTUAL_ENV 还指向根目录那个无效的 .venv,uv 每次都警告。deactivate 只是反激活,新开一个 shell 标签最干净;或者 unset VIRTUAL_ENV 临时清掉。
跑起来的正确命令
# 进入 api 目录
cd /Users/guowangyang/Documents/github/imooc-manus/mooc-manus/api

# 1. 同步依赖(第一次或者 uv.lock 更新后)
uv sync

# 2. 跑 main.py(注意是 -m app.main,不是 app/main.py)
unset VIRTUAL_ENV
uv run python -m app.main
FastAPI 项目其实有更标准的跑法(带热重载、生产级 uvicorn):
cd /Users/guowangyang/Documents/github/imooc-manus/mooc-manus/api

# 开发:自动重载
uv run uvicorn app.main:app --reload --host 0.0.0.0 --port 8000

# 生产:不重载
uv run uvicorn app.main:app --host 0.0.0.0 --port 8000 --workers 1
sandbox/ 同理:cd sandbox && uv run uvicorn app.main:app --reload --host 0.0.0.0 --port 8001
为什么 python -m app.main 才对
| 写法 | 含义 | sys.path 是? | import app 能否找到 |
|---|---|---|---|
python app/main.py | 把 app/main.py 当脚本 | /Users/.../api/app/ 的父目录 | ❌ api/ 不在 path,找不到 app package |
python -m app.main | 把 app.main 当模块 | 当前目录(api/) | ✅ api/ 在 path,app package 可找到 |
一劳永逸清掉 VIRTUAL_ENV 警告
在 ~/.zshrc 末尾加一行,让任何新 shell 都不带这个变量:
echo 'unset VIRTUAL_ENV' >> ~/.zshrc或者更直接:把根目录那个无效的 .venv 删掉(uv 警告消失,因为没东西可警告了):
cd /Users/guowangyang/Documents/github/imooc-manus
rm -rf .venv
source ~/.zshrc 之后新开标签就干净了。
chrome cdp
2026-08-04
关键错误在第一行:
DevTools remote debugging requires a non-default data directory. Specify this using --user-data-dir.Chrome 现在要求远程调试必须指定一个非默认的用户数据目录。虽然 Chrome 窗口打开了,但 9222 端口实际上没启动,所以 Python 连不上。
正确命令
先完全退出 Chrome(Cmd+Q),然后:
/Applications/Google\ Chrome.app/Contents/MacOS/Google\ Chrome \
  --remote-debugging-port=9222 \
  --user-data-dir=/tmp/chrome-debug-profile
/tmp/chrome-debug-profile 是一个临时目录,Chrome 会在那里创建新的用户配置,不会影响你正常使用的 Chrome 配置。
启动后可以验证端口是否就绪:
curl http://localhost:9222/json/version返回 JSON 数据说明 CDP 已启动,然后再运行你的 Python 脚本:
python mas-study/10-6_使用Playwright简化CDP连接.pypython mcp server
2026-08-04
这个不是代码问题,是使用方式问题。
原因
你这个脚本是 MCP Server(不是普通脚本),它通过 stdio 协议等待 MCP 客户端(如 Claude Desktop / Cursor / MCP Inspector)发来的 JSON-RPC 消息。
但你直接 python 运行它,然后在终端手敲 1+1\n —— MCP Server 把 1+1\n 当成 JSON-RPC 消息解析,解析失败就报 Invalid JSON 错。
stdin 里期望的是这种格式的 JSON:
{"jsonrpc":"2.0","id":1,"method":"initialize","params":{...}}不是普通算术表达式。
正确使用方式(3 选 1)
方式 1:MCP Inspector(最常用测试工具)
npx @modelcontextprotocol/inspector python mas-study/6_6_mcp-server-demo.py会自动打开浏览器界面,能可视化调用 calculator 工具。
方式 2:MCP CLI(mcp 1.0+ 才有)
mcp dev mas-study/6_6_mcp-server-demo.py方式 3:接到 Claude Desktop / Cursor 在 MCP 客户端配置里加:
{
  "mcpServers": {
    "demo": {
      "command": "python",
      "args": ["/Users/guowangyang/Documents/github/imooc-manus/mas-study/6_6_mcp-server-demo.py"]
    }
  }
}
然后在客户端对话里说"计算 1+1"即可。
简单记:MCP Server 脚本不能直接 python 跑测试,必须配 MCP 客户端或 Inspector。
所有 fastapi 都有 docs 目录吗,发布后也有吗,正式环境也有吗
2026-08-04
默认都有,但正式环境通常建议关闭。
FastAPI 自带的两套文档
FastAPI 启动就自动生成,无需额外配置:
| 路径 | 风格 | 底层 |
|---|---|---|
/docs | Swagger UI(可交互测试) | OpenAPI |
/redoc | ReDoc(纯阅读,更美观) | OpenAPI |
只要是 app = FastAPI() 创建的实例,这两个路径就自动存在。
如何关闭
正式环境不应该暴露这些:
# 方式 1:创建时关闭
app = FastAPI(docs_url=None, redoc_url=None)

# 方式 2:通过环境变量控制
import os
is_prod = os.getenv("ENV") == "production"
app = FastAPI(
    docs_url=None if is_prod else "/docs",
    redoc_url=None if is_prod else "/redoc",
)
为什么正式环境要关
- 安全:暴露了所有接口的请求/响应结构,给攻击者提供信息
- 性能:Swagger UI 静态资源约 1MB+,浪费带宽
- (可选)OpenAPI JSON 也要关:
openapi_url=None禁用/openapi.json,因为 Swagger 和 ReDoc 都依赖这个 JSON
app = FastAPI(
    docs_url=None,      # 关 Swagger
    redoc_url=None,     # 关 ReDoc
    openapi_url=None,   # 关 OpenAPI schema JSON
)
简单记:开发/测试环境留 /docs 方便调试,正式上线关掉。
Pydantic
2026-08-04
这个脚本展示了一个很巧妙的组合用法:用 Pydantic 的类型定义自动生成 Tool 的 JSON Schema,再用同一份 Pydantic 解析模型返回的 JSON。核心是"一份类型,两处复用"。
脚本逐行解读
1. 定义数据结构(Pydantic Model)
class UserInfo(BaseModel):
    """传递用户的信息进行数据提取&处理,涵盖name、age、email"""
    name: str = Field(..., description="用户名字")
    age: int = Field(..., gt=0, description="用户年龄,必须是正整数")
    email: EmailStr = Field(..., description="用户的电子邮件")
这里的 BaseModel 做了三件事:
| 用途 | 产出 | 示例 |
|---|---|---|
| 类型声明 | Python 类型提示 | name: str → name 必须是字符串 |
| 约束定义 | 字段校验规则 | gt=0 → age 必须 > 0;EmailStr → 必须是合法邮箱格式 |
| 文档生成 | JSON Schema | 自动生成结构化的参数描述 |
调用 UserInfo.model_json_schema() 会生成:
{
  "type": "object",
  "properties": {
    "name": { "type": "string", "description": "用户名字" },
    "age":  { "type": "integer", "description": "用户年龄,必须是正整数", "exclusiveMinimum": 0 },
    "email": { "type": "string", "format": "email", "description": "用户的电子邮件" }
  },
  "required": ["name", "age", "email"]
}
这就是 Pydantic 的核心价值:不需要手写 JSON Schema,类型定义即文档。
2. 把 Schema 喂给 LLM 作为 Tool
tools=[{
    "type": "function",
    "function": {
        "name": UserInfo.__name__,          # → "UserInfo"
        "description": UserInfo.__doc__,     # → "传递用户的信息进行数据提取&处理..."
        "parameters": UserInfo.model_json_schema(),  # → 上面的 JSON Schema
    }
}],
LLM 收到的 tool 定义就是:
- 函数名:
UserInfo - 用途描述:提取用户信息
- 参数格式:需要
name、age、email,格式分别是什么
LLM 会根据这段 Schema 自动从用户输入中提取对应的结构化数据。
3. LLM 返回的 JSON → Pydantic 解析
用户输入: "我叫泽辉呀,今年18岁,我的联系方式是zehuiya@163.com"
                              ↓
LLM 推理:需要一个 name、一个 age、一个 email → 提取 →
                              ↓
Tool Call 返回: {"name": "泽辉呀", "age": 18, "email": "zehuiya@163.com"}
                              ↓
UserInfo.model_validate_json(这个 JSON)
model_validate_json 做的事情:
- 解析 JSON → Python dict
- 校验
name是字符串?✓ →age > 0?✓ →email格式合法?✓ - 返回 一个
UserInfo对象,可以.name.age.email直接访问
4. 为什么这个组合这么强大?
          ┌─────────────────────┐
          │   Pydantic Model    │
          │   UserInfo          │
          │   - name: str       │
          │   - age: int>0      │
          │   - email: EmailStr │
          └─────────┬───────────┘
                    │
        ┌───────────┴───────────┐
        │                       │
    model_json_schema()    model_validate_json()
        │                       │
        ▼                       ▼
  给 LLM 的 Tool 定义      解析 LLM 返回的 JSON
  (告诉 LLM 要什么格式)     (校验 + 转成 Python 对象)
一份 Pydantic 定义,同时充当"给 LLM 的格式说明书"和"返回值的数据校验器"。
5. 一个比喻
可以把这个过程理解为填表:
BaseModel= 你设计了一张表格模板(有"姓名"、"年龄"、"邮箱"三个格子)model_json_schema()= 把空表格拍照发给 LLM,说"请按这个格式填"- LLM = 从短信文本里提取信息,填到表格里
model_validate_json()= 检查填好的表格是否合法(年龄不能是负数、邮箱不能乱写)- 最后你拿到一个
UserInfo对象 = 一份检查通过的表格
完整数据流
"我叫泽辉呀,今年18岁,我的联系方式是zehuiya@163.com"
                              │
                     TokenHub (deepseek-v4-pro)
                              │
              {"tool_calls":[{
                "function":{
                  "arguments": '{"name":"泽辉呀","age":18,"email":"zehuiya@163.com"}'
                }
              }]}
                              │
              UserInfo.model_validate_json(...)
                              │
                    ┌─────────┴─────────┐
                    │ UserInfo 对象       │
                    │ .name  = "泽辉呀"   │
                    │ .age   = 18         │
                    │ .email = "zehuiya..."│
                    └─────────────────────┘
如果 LLM 返回了不合法的数据(比如 {"name": "泽辉呀", "age": -5, "email": "不是邮箱"}),model_validate_json 会直接抛异常,省去你手写校验逻辑。
docker 的 env 不一样
2026-08-04
根因找到了:.env 里的数据库地址写错了
你的 docker-compose.yml 里 PostgreSQL 容器叫 manus-postgres,Redis 叫 manus-redis,但 .env 文件里用的还是 localhost。在 Docker 网络里,localhost 指的是容器自己,不是宿主机也不是其他容器。
需要改 .env 文件,把主机名从 localhost 改成 Docker 容器名: 问题很明确了,改 mooc-manus/.env 里的两行: 改好了。核心改动:
localhost:5432→manus-postgres:5432REDIS_HOST=localhost→REDIS_HOST=manus-redis
Docker 网络里各容器之间用容器名互相访问,localhost 只能访问自己。现在重新启动:
docker-compose down
docker-compose up
manus-api 就能连上 Postgres 和 Redis 了。
为什么有的有build,有的没有build
2026-08-04
很简单,区分就是"自己的代码 vs 别人做好的服务":
有 build 的(你的代码,需要自己构建):
| 服务 | 构建来源 |
|---|---|
manus-sandbox | ./sandbox/Dockerfile |
manus-api | ./api/Dockerfile |
manus-ui | ./ui/Dockerfile |
这三个是你项目的业务代码,别人不可能有,只能从你本地的 Dockerfile 编译出来。
没 build 的(现成镜像,直接下载):
| 服务 | 镜像 |
|---|---|
manus-redis | redis:7-alpine |
manus-postgres | postgres:16-alpine |
manus-nginx | nginx:alpine |
这三个是 Redis、PostgreSQL、Nginx,都是开源基础设施,Docker Hub 上有官方打包好的镜像,直接 pull 下来就能用,不需要自己写 Dockerfile。
所以 manus-sandbox 的问题就在于:它既有 build(自己的代码)又写了 image: manus-sandbox,Docker 看到 image 就先去网上搜,当然搜不到。
docker-compose up --build 是不是全都构建了
2026-08-04
对,docker-compose up --build 会把所有有 build 配置的服务都重新构建一遍(你这个项目里就是 manus-sandbox + manus-api + manus-ui 三个一起搞),比较慢。
只构建那个报错的服务就行:
# 先单独构建 sandbox
docker-compose build manus-sandbox

# 再正常启动
docker-compose up
这样只动 manus-sandbox,manus-api 和 manus-ui 不动(除非你改了它们的代码,那也顺手加进 build 命令里)。
开发环境可以用吗
2026-08-04
你说得对,我之前说的方案同样适用于开发环境。核心问题很简单:
你的 docker-compose.yml 里 manus-sandbox 写了一个本地才有的镜像名 image: manus-sandbox,Docker 傻傻地跑去 Docker Hub 上找,当然找不到,就一直重试卡住了。
开发环境直接用这个命令就够了:
docker-compose up --build加 --build 就是告诉 Docker:"别去网上找了,用我本地的 Dockerfile 自己构建"。每次改了代码重新构建时也用这个,开发日常就用它。
或者更简单,把 docker-compose.yml 第 47 行删掉,以后都不用加 --build:
  manus-sandbox:
    build:
      context: ./sandbox
      dockerfile: Dockerfile
    # 删掉这行 → image: manus-sandbox
    container_name: manus-sandbox
删了 image 之后,docker-compose up 会自动识别"哦这是本地构建的",直接走 Dockerfile,不会再联网找了。
manus-sandbox 报错
2026-08-04
诊断
报错的核心原因是:docker-compose.yml 第 47 行给 manus-sandbox 服务指定了 image: manus-sandbox,Docker Compose 试图从 Docker Hub 拉取这个镜像,但该镜像不存在于任何远程仓库。
  manus-sandbox:
    build:
      context: ./sandbox
      dockerfile: Dockerfile
    image: manus-sandbox   # ← 这行导致 Docker 去远程仓库拉取
虽然同时配置了 build 和 image,但在没有本地缓存时,Docker Compose 会优先尝试 pull,失败后无限重试。
解决方案
有三种方式,任选其一:
方案 1(推荐):运行时加 --build 参数
docker-compose up --build这会强制 Docker Compose 先本地构建,不尝试从远程 pull。
方案 2:删除 image 行
把 manus-sandbox 的 image: manus-sandbox 删掉,Docker Compose 会自动用目录名生成镜像名,不会尝试远程 pull:
  manus-sandbox:
    build:
      context: ./sandbox
      dockerfile: Dockerfile
    # image: manus-sandbox   ← 删除这行
    container_name: manus-sandbox
方案 3:先 build 再 up
docker-compose build manus-sandbox
docker-compose up
为什么其他服务没问题
redis:7-alpine、postgres:16-alpine、nginx:alpine、python:3.12-slim— 这些都是 Docker Hub 上的官方镜像,可以直接 pullmanus-api和manus-ui只有build没有image,所以不会尝试远程 pull- 只有
manus-sandbox同时有build+image,触发了 pull 行为
磁盘占用
2026-08-04
我用了以下命令来逐步排查磁盘占用:

1. 整体磁盘状态
df -h /Users/guowangyang看出 888 Gi / 926 Gi 已用,仅剩 1.1 Gi。
2. 项目目录总大小
du -sh .项目总共 2.2 GB,不算最大但内部有浪费。
3. 子目录分拆(找大文件夹)
du -sh */ | sort -hr发现 api/ 1.8 GB、ui/ 318 MB、docker/ 48 MB。
4. 继续下钻
du -sh api/*   # 发现 api/.venv 1.8 GB
du -sh ui/*    # 发现 ui/node_modules 316 MB
定位 api/.venv 是项目内最大头。
5. 系统缓存(真正的大肥肉)
du -sh ~/Library/Caches/* | sort -hr输出:
| 缓存 | 大小 |
|---|---|
| Yarn | 13 GB 🔴 |
| 微信开发者工具 | 3.2 GB |
| Chrome | 2.8 GB |
| pnpm | 2.2 GB |
| Playwright | 1.8 GB |
| pip | 1.3 GB |
| ... | ... |
6. 模拟器大件
du -sh ~/Library/Developer/CoreSimulator   # 6.8 GB iOS 模拟器
du -sh ~/Library/Developer/Xcode/DerivedData  # 172 MB
总结:核心排查思路
df -h           → 看到磁盘快满了
du -sh */       → 一级级找大目录
du -sh ~/Library/Caches/*  → 系统缓存是宝藏(35+ GB 可清)
最大的浪费不在项目里(2.2 GB),而是系统缓存:Yarn 13 GB + iOS 模拟器 6.8 GB + 其他缓存 15 GB,加起来超过 35 GB。清掉这些立刻能释放大量空间。
docker 数据库与本机数据库
2026-08-03
是的,两个不同的数据库:
| 之前连的(有数据) | 现在连的(空的) | |
|---|---|---|
| 地址 | host.docker.internal:5432 | llmops-db:5432 |
| 在哪 | Mac 本机 PostgreSQL | Docker 容器 PostgreSQL |
| 密码 | postgres | llmops123456 |
数据没丢,只是还在你 Mac 的 PostgreSQL 里。要切回去:
# 改回 Mac 本地 PostgreSQL
sed -i '' 's|postgresql://postgres:x@llmops-db|postgresql://postgres:x@host.docker.internal|g' /Users/ygw/Downloads/imooc-llmops/api/.env

# 重启
docker-compose down && docker-compose up
不过建议保留 Docker 里的 PostgreSQL(数据更独立,不污染 Mac),下次可以直接把 Mac 上的数据迁移过来。你想用哪个?
docker celery 启动
2026-08-03
找到问题了。两个容器都跑了 Flask 而不是 Celery——entrypoint.sh 覆盖了 compose 的 command。
关键修复:加了 entrypoint: [""] 覆盖 Dockerfile 里的 entrypoint.sh,让 compose 的 command 真正生效。
# 停掉旧的
docker-compose down

# 因为用了新名字,旧容器也手动删
docker rm -f llmops-api llmops-celery 2>/dev/null

# 重启
cd /Users/guowangyang/Downloads/imooc-llmops
docker-compose up
这次 llmops-celery-dev 终端的输出应该显示 celery worker 而不是 Serving Flask app,然后前端那个 0% 进度条就会开始动了。
docker ps 命令
2026-08-03
API 已经正常了(HTTP 200),但文件处理没走是因为 Celery worker 没起来。日志里全是 llmops-api 没有 llmops-celery 的输出。
排查一下:
# 1. 看哪些容器在跑
docker ps

# 2. 如果 celery 没在跑,看它的报错
docker-compose logs celery
终端跑这两条,把输出贴给我。如果 docker ps 里只看到 llmops-api 一个容器,那就是 Celery 连不上 Redis(.env 里 REDIS_HOST=host.docker.internal 在 compose 的 bridge 网络下不生效)。
如果是这个原因,把 .env 里的 REDIS_HOST 改回 localhost,然后用 network_mode: host 模式跑——让容器直接用你的 Mac 网络栈。
docker 开发
2026-08-03
下面是有问题的,flask 开发可以,但是都没有启动 celery
Docker 开发和线上都能用,而且开发用 Docker 恰恰能避免你之前遇到的"3.13 装不上"问题。
开发 vs 生产,区别就一个地
开发环境:代码在本地改了要立刻生效(不能每次都重新 docker build)
生产环境:打一次包,复制到 N 台机器,稳稳跑不坏
开发怎么玩
方式一:只把依赖放 Docker,代码挂载本地(推荐)
# Dockerfile 里只装依赖
cat > Dockerfile.dev << 'EOF'
FROM python:3.10-slim-bookworm
WORKDIR /app
COPY requirements.txt .
RUN pip install -r requirements.txt
CMD ["flask", "run", "--host=0.0.0.0", "--port=5001", "--debug"]
EOF

# 启动:把本地代码"挂"进容器,改代码立刻生效
docker run -v $(pwd):/app -p 5001:5001 --env-file .env my-dev
你改本地代码 → Flask --debug 模式自动重载 → 容器马上生效
跟不用 Docker 的开发体验一模一样,但 Python 版本/依赖永远对的方式二:docker-compose(一站式)
# docker-compose.yml
version: '3'
services:
  api:
    build: .
    ports: ['5001:5001']
    volumes: ['./api:/app/api']    # ← 这行是关键:本地改,容器变
    env_file: './api/.env'
  db:
    image: postgres:15
    environment:
      POSTGRES_DB: llmops
      POSTGRES_PASSWORD: postgres
  redis:
image: redis:7docker-compose up # 一行命令:API + 数据库 + Redis 全部起来一图说明
┌─────────────────────────────────────────────┐
│ 不用 Docker 开发                              │
│  brew install python@3.10                    │
│  brew install postgres redis                 │
│  pip install -r requirements.txt  ← 3.13冲突 │
│  配数据库...配Redis...                       │
│  同事:怎么我跑不起来?                        │
└─────────────────────────────────────────────┘

┌─────────────────────────────────────────────┐
│ 用 Docker 开发                                │
│  docker-compose up                           │
│  Python 3.10 ✓  依赖 ✓  DB ✓  Redis ✓        │
│  同事拉代码 → docker-compose up → 五个服务全好 │
└─────────────────────────────────────────────┘
Docker 不是"只能上线用",是"开发就帮你把环境搭好,上线时原样推到服务器"。你之前 3.13 冲突的痛苦,Docker 一把解决。
docker build
2026-08-03
对,用大白话解释一下。
两行命令的含义
第一行:docker build -t llmops-api -f api/Dockerfile api/
| 部分 | 含义 |
|---|---|
docker build | "给我造一个集装箱" |
-t llmops-api | "贴个标签叫 llmops-api"(后面用这个名启动它) |
-f api/Dockerfile | "按这张说明书造"(Dockerfile = 制作步骤说明书) |
api/ | "材料在这个目录里找" |
这步做的事:把你项目里的 Python 代码 + 所有依赖(你刚才冲突的那个 requirements.txt 里 579 个包)打包成一个"自带运行环境的镜像",不依赖你本机装了什么 Python 版本。
本质:把 "项目代码 + Python 3.10 + 579 个 pip 包" 捏成一个可移动的、可复制的、在任何机器上都能跑的"盒子"。
第二行:docker run -p 5001:5001 llmops-api
| 部分 | 含义 |
|---|---|
docker run | "启动这个盒子" |
-p 5001:5001 | "你把盒子的 5001 端口映射到我这台电脑的 5001 端口" |
llmops-api | "用刚才贴了标签的那个盒子" |
结果:你访问 http://localhost:5001 就访问到 Docker 里面跑的后台服务了。
所以你的问题:"是不是所有的后台服务都可以用 Docker 包装?"
是的,完全可以。 而且这正是 Docker 设计的初衷。
用 Docker 之前 vs 之后
❌ 之前(你现在的痛点):
  本机装 Python 3.13 → pip install 报冲突 → 降版本 → 冲突...
  换台机器又是同样的噩梦
  老板:"在我电脑上怎么跑不起来"

✅ 之后(用 Docker):
  打一次包,所有地方都能跑
  你 Mac 上能跑 → CI 机器上能跑 → 服务器上也能跑
  一模一样的 Python、一模一样的依赖、一模一样的环境
你这个项目的 Dockerfile 里做了什么
看你的 api/Dockerfile(我刚才读过的那个文件),它做的就三件事:
# 1. 拿一个"干净 Python 3.10"做底
FROM python:3.10-slim-bookworm

# 2. 把 requirements.txt 里的 579 个包装进去(用 3.10,绝不会冲突!)
COPY requirements.txt .
RUN pip install --prefix=/pkg -r requirements.txt

# 3. 把你的代码拷进去
COPY . /app/api

# 4. 告诉你"启动命令"
ENTRYPOINT ["/bin/bash", "/entrypoint.sh"]
这就是你刚才 Python 3.13 冲突的完美解决方案——Docker 里面永远跑的是 Python 3.10,跟你本机用 3.12 还是 3.13 没关系。
甚至更简单的玩法:干掉本地 Python 环境
如果所有后台服务都用 Docker,你本机甚至不需要装 Python:
| 需要做的事 | 不用装 | 直接跑的命令 |
|---|---|---|
| 装 Python 3.10 | 不需要 brew install python@3.10 | 已经在 Docker 里了 |
| 装 pip 依赖 | 不需要 pip install -r requirements.txt | Dockerfile 自动装 |
| 管理多个 Python 版本 | 不需要 venv/pyenv | 每个 Docker 自己带着 |
简单类比
Docker = 真正的"打包带走"
传统方式 = 带着配方去别人厨房做饭(锅碗瓢盆都可能不一样)

Docker 不管你厨房里有没有 3.13 还是 3.10,
它自带整个厨房(Python 3.10 + 579 个包 + 你的代码)。
唯一需要装的只有 Docker 本身(brew install --cask docker),然后就能用 docker build + docker run 跑任何后台服务了。
dotenv.load_dotenv 默认不会覆盖系统环境变量
2026-08-03
load_dotenv(override=True) 只改当前 Python 进程内的 os.environ 字典,不会:
- 写你 shell 的
.zshrc/.bash_profile - 影响系统级环境变量
- 影响其他终端窗口/进程
- 进程退出后残留任何东西
本质就是把 .env 文件里的 key=value 读到 Python 内存里,override=True 只是说"如果内存里已经有了同名 key,用文件里的值覆盖它"。Flask 停掉就全没了。
你现在 shell 里 echo $COS_SECRET_ID 应该还是旧的那个,但 Flask 进程内部会因为 override=True 用到 .env 里的新密钥。两者互不干扰。
Git 仓库大小命令
2026-08-03
# Git 对象大小
git count-objects -vH

# 目录磁盘占用
du -sh .          # 项目总大小
du -sh .git       # Git 仓库大小
du -sh api ui docker   # 各子目录大小
postgresql 相关命令
2026-08-03
1. 诊断阶段
# 检查 PostgreSQL 版本
pg_config --version

# 检查服务状态和数据库列表
brew services list | grep postgresql
pg_isready
psql -l
2. 修复阶段
# 创建 postgres 角色
psql -d postgres -c "CREATE ROLE postgres WITH LOGIN SUPERUSER PASSWORD 'postgres';"

# 将 llmops 数据库归属给 postgres
psql -d postgres -c "ALTER DATABASE llmops OWNER TO postgres;"
3. 迁移修复阶段
# 查看数据库现有表
psql -U postgres -d llmops -c "\dt"

# 查看可用迁移文件
ls api/internal/migration/versions/

# 清除过期的迁移版本记录
psql -U postgres -d llmops -c "DELETE FROM alembic_version;"

# 重建数据库(因为 app 表已存在导致迁移冲突)
psql -U postgres -d postgres -c "DROP DATABASE llmops;"
psql -U postgres -d postgres -c "CREATE DATABASE llmops OWNER postgres;"

# 安装 uuid-ossp 扩展
psql -U postgres -d llmops -c "CREATE EXTENSION IF NOT EXISTS \"uuid-ossp\";"

# 执行数据库迁移
cd api && source .venv/bin/activate
flask --app app.http.app db upgrade
4. 验证阶段
# 确认所有表已创建
psql -U postgres -d llmops -c "\dt"
最终结果:15 个迁移全部执行成功,26 张表创建完毕。
whistle 配置
2026-08-03
为什么其他前端项目这样配置
127.0.0.1:443 https://h5-test.igame.qq.com,就能通过https://h5-test.igame.qq.com进行访问
很好的问题!两个写法都是 whistle 的 host 拦截语法,等价:
| 写法 | 含义 |
|---|---|
www.test.com 127.0.0.1:8080 | 访问 www.test.com → 打本地 8080 |
127.0.0.1:8080 www.test.com | 同样效果(whistle 智能识别方向) |
核心原理
[Chrome 浏览器]
    │ 1. 你输入 https://h5-test-1006.igame.qq.com
    │ 2. Chrome 把请求发给代理 127.0.0.1:8899(whistle 监听的端口)
    ▼
[whistle]
    │ 3. 看 Host header = h5-test-1006.igame.qq.com
    │ 4. 匹配规则:127.0.0.1:1006  https://h5-test-1006.igame.qq.com
    │ 5. 识别出右值就是要拦截的域名
    │ 6. 把请求转发到 127.0.0.1:1006(你本地的 vite 端口)
    ▼
[本地 Vite 服务 127.0.0.1:1006] 收到请求,返回页面
你之前失败的原因
你的规则 127.0.0.1:5173 http://llmops.uwayfly.com/ 写法是对的,但Chrome 没配 whistle 代理:
[Chrome] 输入 http://llmops.uwayfly.com
    │ 浏览器发现没走代理
    │ 直接查系统 DNS → llmops.uwayfly.com 不存在
    ▼
ENOTFOUND  ← 你截图那个错
whistle 完全没机会接管。
腾讯同事的项目能 work 是因为
- 域名真实存在:
h5-test-1006.igame.qq.com是腾讯内网 DNS 能解析的域名(公司 DNS 有记录或走公网 DNS 都能查到 IP) - 浏览器配了 whistle 代理:公司内网开发标配,所有 HTTP/HTTPS 都过
127.0.0.1:8899 - whistle 拿到请求后改 host 头:让请求实际打本地 vite,但浏览器地址栏还显示
h5-test-1006.igame.qq.com,所以 cookie / CORS / 端口都对得上
你的 llmops.uwayfly.com 为什么失败
| 场景 | 原因 |
|---|---|
h5-test-1006.igame.qq.com | 公网/公司 DNS 能查到 IP → 浏览器连得上 whistle → whistle 改 host |
llmops.uwayfly.com | 私有不存在的域名 → 系统 DNS 查不到 → 浏览器连 whistle 之前就死 |
三个方案按推荐度排序
方案 1:直接用 localhost(最简单,强烈推荐)
访问 http://localhost:5173不用 whistle、不用 hosts、不用配代理。所有 cookie/同源问题 vite proxy 解决。
方案 2:本地 hosts(要保域名但不想折腾)
echo "127.0.0.1 llmops.uwayfly.com" | sudo tee -a /etc/hosts
# 访问:http://llmops.uwayfly.com:5173(必须带端口)
DNS 解析层解决,不用 whistle。
方案 3:whistle 接管(公司多环境才需要)
- 启动:
w2 start - Chrome 配 SwitchyOmega 代理
127.0.0.1:8899 - 规则:
http://llmops.uwayfly.com 127.0.0.1:5173 - 访问:
http://llmops.uwayfly.com(不带端口)
只有多环境代理 + HTTPS 抓包 + 注入 mock这种复杂场景才需要。个人项目用方案 1 或 2 足够了。
SIMD
2026-08-03
全称:Single Instruction, Multiple Data 中文:单指令,多数据流
音标:/sɪmd/,业内两种读法:
- 连读:西姆德(工程圈常用)
- 逐字母:S-I-M-D
直白解释
一条 CPU 指令,同时操作多个数据,实现并行计算。
普通标量运算(SISD):
c1 = a1 * b1
c2 = a2 * b2
c3 = a3 * b3
c4 = a4 * b4
→ 需要4条乘法指令
SIMD 并行运算:
[c1,c2,c3,c4] = [a1,a2,a3,a4] * [b1,b2,b3,b4]
→ 只用 **1条指令** 一次性算出4组乘法
x86 / ARM 常见 SIMD 指令集
- x86 CPU:SSE、AVX2、AVX-512
- ARM(苹果M系列、手机CPU):NEON、SVE
和你刚才的 SimSIMD 关联
SimSIMD = Similarity + SIMD 专门手写优化 SIMD 指令,加速向量相似度(余弦、L2距离)计算, 所以做 Embedding、向量检索速度远超普通 NumPy。
通俗场景举例
图片像素处理、音频信号、AI向量、游戏图形渲染,大量连续数组计算都会疯狂依赖 SIMD。
对比容易混淆概念
| 缩写 | 全称 | 通俗理解 |
|---|---|---|
| SISD | 单指令单数据 | 普通串行计算 |
| SIMD | 单指令多数据 | CPU内部向量并行(同一核内) |
| MIMD | 多指令多数据 | 多核CPU、多进程并行 |
小补充:GPU 本质就是大规模 SIMD 集群。
集市兑换后页面空白的修复
2026-07-28
虚拟滚动的核心思路
集市列表如果一次渲染 50 张卡片,每张卡片都在内存里,会很卡。所以用了 VirtualScrollHelper 做"虚拟滚动"——ScrollView 里只创建你能看到的几行卡片,其他位置只是空的。
它的工作原理是:
ScrollView 滚动 → 派发 'scrolling' 事件 → VirtualScrollHelper._onScrolling 回调
                → 读 ScrollView.offset.y(你滚到了哪里)
                → 计算"当前可视区域应该显示第几行到第几行"
                → 只渲染这几行 / 回收其他行
问题出在哪里
兑换后,数据变了,要重新渲染列表。 流程是:
Step 1:进入 _applyBazaarData
用户当时滚到了 offset=500(列表中间),代码在入口把 500 记下来:
scrollOffset = getScrollOffset() → { x:0, y:500 } // 记下"用户在500位置"Step 2:_updateLifeGameTabVisibility 调 _relayoutScroll。里面有一行:
scrollToTop(0) // ScrollView 内部 offset 变成 0 了Step 3:进入 _fillContent({ savedScrollOffset: {x:0, y:500} })
代码做了什么:
- 销毁所有旧卡片节点
- 重新算 content 高度(setContentSize)
- 调 VirtualScrollHelper.reload(...)
- 调 scrollToOffset(0, 500, 0)
问题在第 3 和第 4 的顺序上。
旧代码顺序:先 reload,再 scrollToOffset
reload 内部(VirtualScrollHelper.reload line 79-92):
_recycleAll()               // 回收所有节点
_renderedStartRow = -1      // 重置已渲染行范围
_renderedEndRow = -1
_lastCheckY = -1
_updateVisibleRange()       // ★ 关键:这时 ScrollView.offset 是 0(前面被 scrollToTop 过了)
_updateVisibleRange 读 ScrollView.getScrollOffset().y = 0,然后算:
offsetY=0 → visibleTop=0, visibleBottom=viewportH
         → startRow=0, endRow=BUFFER+可视行数
         → 只渲染第 0~N 行(顶部几行)
然后 scrollToOffset(0, 500, 0) 把 ScrollView 移到底部。
但是!scrollToOffset(offset, 0) 第三个参数是 0,表示"立即设值,不带动画"。Cocos 引擎在这种情况下不会派发 scrolling 事件(因为没有"滚动过程")。
所以 VirtualScrollHelper 的 _onScrolling 回调永远不会被触发,它仍然认为可视区在顶部,不会去创建中部/底部的卡片节点。
结果:ScrollView 物理上移到底部了,但 content 里只有顶部几行有卡片节点,中部和底部什么都没有 → 你看到的就是整片空白。
[ScrollView 视口显示区域]     [content 实际内容]
┌─────────────────┐         ┌─────────────────┐
│                 │         │ 卡片1 ✓ (已渲染) │ ← 你滚到底部了,
│   空白空白空白   │         │ 卡片2 ✓ (已渲染) │   视口对着这里
│   空白空白空白   │ ←视口→  │ 卡片3 ✗ (未渲染) │   但卡片3-9没
│   空白空白空白   │         │ 卡片4 ✗ (未渲染) │   被虚拟滚动创建
│                 │         │ ...              │
└─────────────────┘         └─────────────────┘
修复后顺序:先 scrollToOffset,再 reload
把 scrollToOffset 提前到 reload 之前:
新流程:
setContentSize(新contentH)      // content 尺寸先设好,maxOffset 也更新了
scrollToOffset(0, 500, 0)      // ScrollView 移到500位置(立即设值)
_virtualScroll.reload(...)     // reload 内部 _updateVisibleRange 读到的 offset=500
_updateVisibleRange 读 ScrollView.getScrollOffset().y = 500,然后算:
offsetY=500 → visibleTop=500, visibleBottom=500+viewportH
         → startRow=行500~行500+viewportH
         → 渲染可视区域内的所有卡片 ✓
[ScrollView 视口显示区域] [content 实际内容]
┌─────────────────┐ ┌─────────────────┐
│ │ │ 卡片1 ✓ (已渲染) │
│ │ │ 卡片2 ✓ (已渲染) │
│ 卡片3 正常显示 │ ←视口→ │ 卡片3 ✓ (已渲染) │ ← 三行都渲染了
│ 卡片4 正常显示 │ │ 卡片4 ✓ (已渲染) │
│ 卡片5 正常显示 │ │ 卡片5 ✓ (已渲染) │
└─────────────────┘ └─────────────────┘一句话总结:虚拟滚动靠"当前 ScrollView offset 是多少"来决定渲染哪些卡片。旧代码是"先渲染再移动视口",移动视口又不派发事件,虚拟滚动不知道视口变了。新代码是"先把视口移到位,再渲染",渲染时就能正确找到当前可见范围。
为什么切 tab(savedOffset=null)不影响:切 tab 后视口本来就在顶部(offset=0),先 reload 用 0 算还是先 scrollToTop 再 reload 结果一样——0 就是首屏。
下蛋动画修复
2026-07-28
核心链路:LayEggDialog 的"出场"和"退场"
弹窗生命周期分两段:出场(show) 和 退场(hide)。
退场(hide)做了什么
用户点屏幕关闭弹窗,hide 依次做这些事:
_stopIdleAnim()— 停止蛋的循环动画,复位位置和缩放_shakeEgg()— 蛋左右晃动 0.15s("摇一摇")_popEgg()— 蛋快速放大 10% 再缩小("蓄力")_flyEggToBasketAfterShake()— 蛋飞入篮子(抛物线动画),最后 reset 蛋节点位置/缩放/active=falseAnimationHelper.popOut(cardNode, 0.2)— 卡片缩小退出AnimationHelper.fadeOut(root, 0.15)— 根节点淡出- finally →
root.active = false、_visible = false
关键:第 5 步 popOut(cardNode)
// AnimationHelper.popOut 简化版:
node.setScale(0.8, 0.8, 1);        // ← 卡缩到 0.8
opacity.opacity = 0;                 // ← 卡透明度设 0(完全透明)
tween → scale 0.8→drop + opacity 0→0(维持透明)退场动画结束时的状态:card 的 UIOpacity.opacity = 0,scale = 0.8。
出场(show)的飞入路径 _showWithFly
修复前的代码做了这些:
1. root.active = true                                   弹窗根节点激活
2. fadeIn(root, 0.15)                                   根节点淡入 opacity 0→255
3. card.setScale(1, 1, 1)                               ← 只恢复了 scale
4. egg 从底部飞到中央 scale 0.3→1.0                      蛋飞到位
5. rewardPop(cardNode, 0.35)                            ← 卡片弹出动画
6. 显示标题/数量/提示
7. openingEggPop                                        蛋回弹 1→1.10→1
问题就出在第 5 步 rewardPop:
// AnimationHelper.rewardPop 简化版:
node.setScale(0.6, 0.6, 1);        // ← 卡瞬间缩到 0.6!
opacity.opacity = 0;                 // ← 透明度归 0
tween → scale 0.6→1, opacity 0→255  // ← 再慢慢涨回来
此时蛋已经在第 4 步飞到中央、scale=1。Card 是蛋的父节点,rewardPop 把 card 缩到 0.6 → 蛋也瞬间缩到 0.6,然后 tween 回 1。视觉上就是:
蛋飞到位(1.0) → 突然缩成小蛋(0.6) → 慢慢涨大(1.0) → 再弹跳(1.10)
这就是你看到的"从小到大→换蛋"。
修复过程(为什么中间踩了坑)
第一轮修复(错):把 CDN 加载改成同步等待
以为是 CDN 图加载慢导致。正确的做法是等图加载完再显示。但这不是根因,反而因为 Promise 包装的问题导致第二次蛋不显示。已回退。
第二轮修复(对一半):移除 rewardPop
把第 5 步 rewardPop(cardNode) 删掉,换成了只淡入标题/数量/提示文字:
5. title.active=true + fadeIn(title, 0.25)
6. countLabel.active=true
7. hintLabel.active=true + fadeIn(hint, 0.25)
8. openingEggPop
蛋飞到位后不再被 card 缩放,画面连续一致 ✓。
但漏了一个关键点:rewardPop 不仅做缩放动画,它还顺带重置了 card 的 opacity 0→255。删掉 rewardPop 后,第 3 步只恢复了 scale=1,忘了恢复 opacity。
而 card 的 opacity 在退场时被 popOut 设成了 0:
上一次退场 → popOut(card) → card opacity = 0
这一次出场 → setScale(1,1,1) → scale 恢复了
               但 opacity 还是 0!→ card 完全透明不可见
第三轮修复(完整):加上 card 的 fadeIn
if (this.cardNode) {
    this.cardNode.setScale(1, 1, 1);
    AnimationHelper.fadeIn(this.cardNode, 0.15);  // ← 把 popOut 留下的 opacity=0 拉回 255
}
一个直观的对照表
| 步骤 | 退场时留下的状态 | 出场时 rewardPop 做的 | 出场时我修复后做的 |
|---|---|---|---|
| card scale | 0.8(popOut) | setScale(0.6)→1 ← 导致蛋缩小 | setScale(1) ✓ 蛋不再缩 |
| card opacity | 0(popOut) | 0→255 ✓ 恢复可见 | |
| 蛋位置 | eggInitLocal(中央) | 不动(无入场) | setPosition(0,-350)→飞入 |
| 蛋 scale | 1(restore 里重置) | 不动 | 0.3→1.0 |
最终效果:蛋从底部飞到中央(0.3→1.0),card 正常可见,标题/数量淡入,蛋回弹——一个个蛋从头飞到位,过程中不会突然缩回去。
press-ui 组件库同步 demo 改为“推”模式
2026-07-28
- 一次执行,全部同步 — 不用每个 demo 仓库各自跑一次
- 源文件单一 — 不再需要每个 demo 维护 src/press-ui/ 副本
- 按需处理差异 — 通过 config 区分 uni-app/pure/Vue2/Vue3 的不同处理逻辑
- 可加 watch — 在主仓库用 gulp.watch,改一个文件自动推到所有目标
- 精简 demo 仓库 — demo 仓库只需保留自己特有的配置和页面,不再需要 src/press-ui/ 大目录
ins 浏览器无法跳转XX
2026-07-26
AI 的建议,ins 浏览器无法跳转。
d2c 的 rem 和项目里的是否冲突
2026-07-22
(function (win, doc) {
  if (!win.addEventListener) return;
  var html = document.documentElement;

  function setFont() {
    var cliWidth = html.clientWidth;
    var clientHeight = html.clientHeight;
    var base = Math.min(clientHeight, cliWidth);
    html.style.fontSize = 100 * (base / 750) + 'px';
  }
  win.addEventListener('resize', setFont, false);
  setFont();
})(window, document);不冲突,两者正好配合。你的 rem 脚本做的是运行时缩放,d2c-utils 做的是设计稿到 rem 的静态换算。
你的 rem 脚本
1rem = 100 × (屏幕宽 / 750) px| 屏幕宽度 | 1rem 等于 |
|---|---|
| 750px | 100px |
| 375px | 50px |
d2c-utils 的 role
d2c-utils 把设计稿 px 静态换算成 rem 值,运行时由你的脚本决定 1rem 的实际像素。
验证当前代码,全部正确
// 375px 屏幕:1rem = 50px → 7.5 × 50 = 375px ✅
// 750px 屏幕:1rem = 100px → 7.5 × 100 = 750px ✅
.page-container { width: 7.5rem; }

// 任意屏幕等比例缩放 ✅
.back-icon { width: 0.4rem; } // 20px @375 / 40px @750换算公式:Figma px × 2 ÷ 100 = rem,与你脚本中的 100 * (base / 750) 完全对得上:
375px 屏幕:fontSize = 100 × 375/750 = 50  →  375px = 7.5rem
750px 屏幕:fontSize = 100 × 750/750 = 100 →  750px = 7.5rem
如果用 d2c-utils 原生 rem
它通过 { mode: 'rem', designWidth: 750 } 控制。关键是 designWidth 要和你脚本的基准(750)一致。当前手动换算已经和你的 rem 脚本完美匹配,直接用即可。
碰一碰
2026-07-21
现在我对四个项目都有了清晰的理解。让我制定方案并实施。 好的,基于调研结果:
关键发现:t-comm 中已经有 src/bluetooth-bump/ 模块(蓝牙底层),但缺少业务编排层(状态机 + API 调用 + 缓存管理)。我需要新增一个 src/bump-service/ 模块来封装通用的碰一碰业务逻辑。
让我先读一下 t-comm 中已有的 bluetooth-bump 模块,了解其暴露的接口: 现在我清楚了全貌。让我看一下 step-tree-server 的结构,然后开始实施: 现在我有了完整的上下文。让我开始实施三个部分。
1. 先在 t-comm 中新增 bump-service 模块
2. 在 step-tree-server 后端新增 bump 接口
3. 在 step-tree-client 中集成碰一碰
现在创建 step-tree-client 的碰一碰模块:
现在更新 step-tree-client 的配置文件:
最后安装后端缺少的 uuid 依赖: npm 安装失败,用 pnpm 试试: 安装成功。看起来 uuid v14 自带类型定义,@types/uuid 已经不需要了但也无害。
现在让我总结一下整体架构和使用方式:
总结
我已经完成了碰一碰核心逻辑的沉淀和跨项目复用,整体架构如下:
分层架构
┌─────────────────────────────────────────────────────────────────┐
│                    业务层(step-tree-client)                      │
│   BumpService.ts + BumpPage.ts + bump.api.ts                    │
│   负责:UI / 框架适配(oops) / 业务定制                            │
└─────────────────────────┬───────────────────────────────────────┘
                          │ 依赖
┌─────────────────────────┴───────────────────────────────────────┐
│                   @tencent/t-comm(通用库)                        │
│                                                                   │
│  ┌─────────────────────┐  ┌──────────────────────┐              │
│  │  bluetooth-bump     │  │  bump-service (NEW)  │              │
│  │  ─────────────────  │  │  ──────────────────  │              │
│  │  纯蓝牙层:          │  │  业务编排层:          │              │
│  │  广播/扫描/RSSI判定  │  │  状态机/API/缓存/刷新 │              │
│  │  去重/跨平台兼容     │  │  BumpApiAdapter 注入  │              │
│  └─────────────────────┘  └──────────────────────┘              │
└─────────────────────────────────────────────────────────────────┘
                          │ 调用
┌─────────────────────────┴───────────────────────────────────────┐
│                   后端(step-tree-server)                         │
│   /api/bump/start  → 生成 tempId                                │
│   /api/bump/peer/:tempId → 查对端信息                             │
│   /api/bump/report → 撮合(双方都上报才 matched)                  │
│   /api/bump/reward → 领取奖励(加粮食)                            │
└─────────────────────────────────────────────────────────────────┘
新增文件清单
| 项目 | 文件 | 说明 |
|---|---|---|
| t-comm | src/bump-service/types.ts | 通用类型 + 适配器接口 |
| t-comm | src/bump-service/bump-service.ts | 核心编排类(状态机/API/缓存) |
| t-comm | src/bump-service/index.ts | 模块导出入口 |
| t-comm | src/index.ts | 注册新模块 |
| step-tree-server | src/app/models/bump-session.ts | Sequelize 数据模型 |
| step-tree-server | src/app/services/bump.service.ts | 业务逻辑(撮合/奖励) |
| step-tree-server | src/app/api/bump.ts | Koa 路由 |
| step-tree-server | src/core/init.ts | 路由注册(修改) |
| step-tree-client | assets/scripts/module/bump/bump.api.ts | API 调用 |
| step-tree-client | assets/scripts/module/bump/BumpService.ts | 业务服务(集成 t-comm) |
| step-tree-client | assets/scripts/module/bump/BumpPage.ts | 碰一碰页面 UI |
| step-tree-client | assets/scripts/config/EventName.ts | 新增事件(修改) |
| step-tree-client | assets/scripts/config/UIConfig.ts | 新增 UIID(修改) |
复用指南
任何新小程序要接入碰一碰,只需要:
- 后端提供 4 个接口:
bumpStart、getPeerByTempId、bumpReport、bumpReward - 前端安装
@tencent/t-comm,然后:tsimport { BluetoothBump, BumpService } from '@tencent/t-comm'; // 实现 BumpApiAdapter(对接你自己的后端) const api: BumpApiAdapter = { bumpStart: (req) => myHttp.post('/bump/start', req), bumpReport: (req) => myHttp.post('/bump/report', req), bumpReward: (req) => myHttp.post('/bump/reward', req), getPeerByTempId: (req) => myHttp.get(`/bump/peer/${req.temp_id}`), }; // 创建 BumpService const bumpService = new BumpService({ api }); const tempId = await bumpService.start({ actId: 'xxx' }); // 创建 BluetoothBump(蓝牙层) const bt = new BluetoothBump({ onBump: (deviceId, rssi, dev, peerTempId) => { bumpService.bumpPeer(peerTempId, rssi); }, }); await bt.start();
bundle 注意
2026-07-20
本地 bundle 可能存在的坑 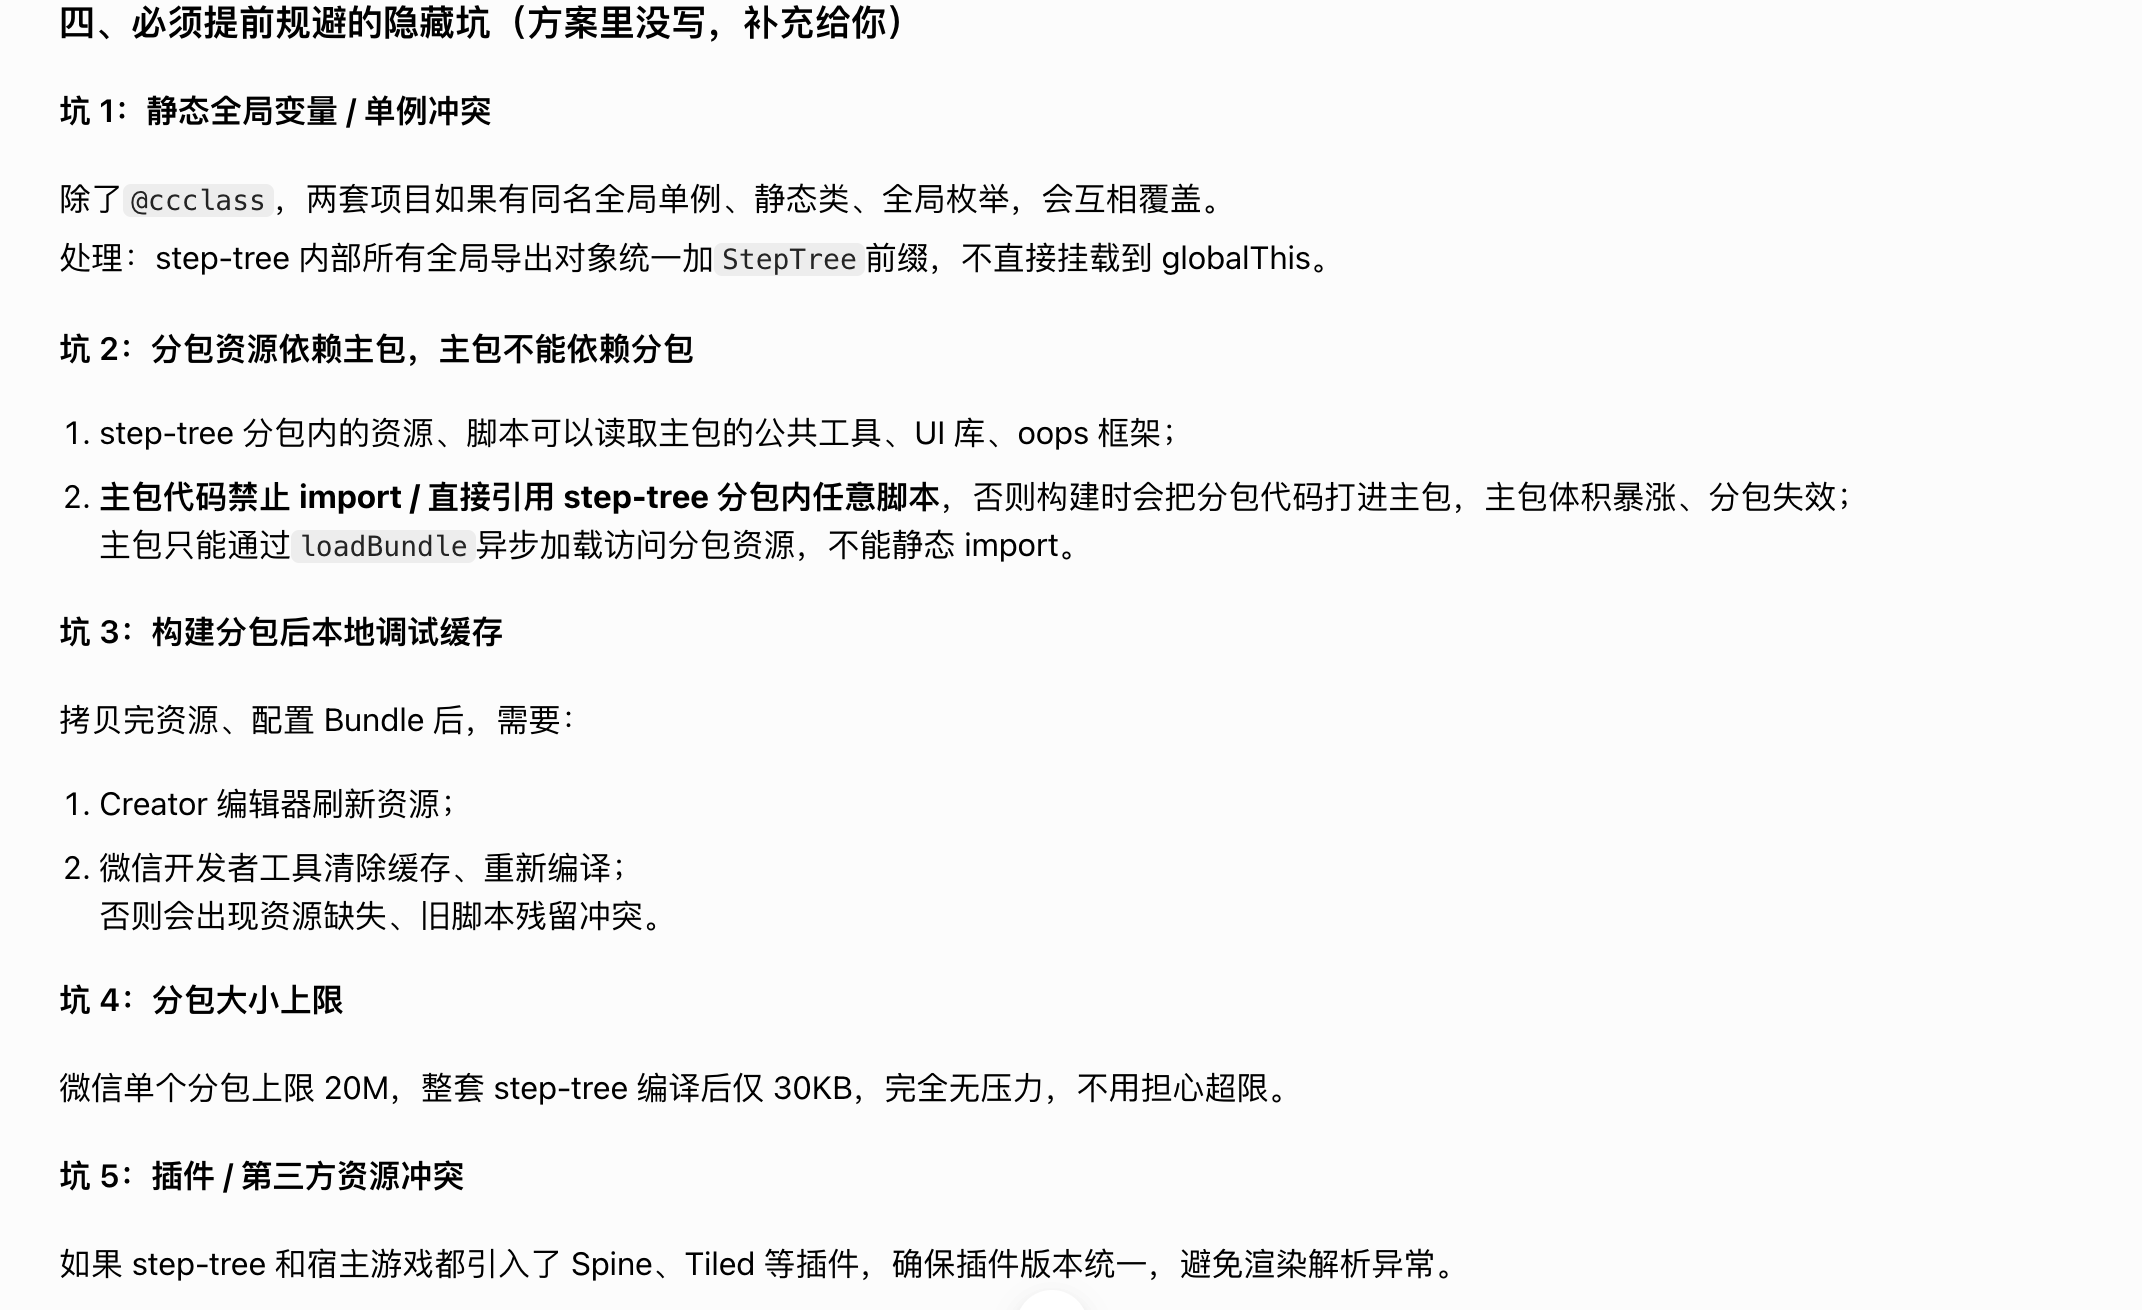
Cocos Bundle 超通俗完整讲解
2026-07-20
Cocos Bundle 超通俗完整讲解,分三层:本质、两种形态、用途、和普通文件夹/远程包/分包的区别
一、Bundle 最核心一句话定义
Bundle = 一套独立打包、可单独异步加载的「资源+脚本+索引清单」合集 Creator 里任意文件夹,右键「配置为Bundle」后,引擎会给它生成一套独立管理体系: 自带 catalog.json(资源索引表)、bundle.json(分包配置),可以不和主包一起初始化,想用的时候再下载/加载,用完还能卸载释放内存。
底层设计目的
微信小游戏主包有 4M强制上限,所有资源、脚本、场景全塞主包很容易超限; Bundle 就是用来拆分资源,实现懒加载、按需下载的官方解决方案。
二、Bundle 的两大形态(完全区分开,你前面踩坑根源就在分不清)
形态1:本地 Bundle(Subpackage 子包,你现在这套可行方案)
就是同一个AppID项目内,标记为Bundle的文件夹,构建后输出到 subpackages/xxx,属于当前小游戏本地内置分包
- 存放位置:打包后和主包一起上传微信后台,存在用户本地;
- 加载时机:启动游戏只加载4M主包,用户点击对应按钮,才会从本地磁盘读取这个分包;
- 环境:和主包共用同一套引擎、同一个运行上下文,脚本、组件、全局变量互通;
- 限制:只能当前小游戏自己用,别的AppID小游戏完全读不到;
- 你的场景优势:step-tree做成本地Bundle,不会出现
Cannot read push of null空指针报错。
形态2:远程 Bundle(你之前踩坑失败的方案)
把标记为Bundle的文件夹,单独导出上传到外网HTTPS服务器,跨AppID远程下载
- 存放位置:公网CDN/云服务器,不在小游戏本地;
- 加载时机:点击按钮后,实时发起网络请求下载整套资源;
- 环境:两套不同AppID小游戏,运行环境隔离;
- 宿主B的全局对象、管理器、脚本上下文 和 远程A的Bundle完全隔离;
- 自定义业务组件、TS脚本跨环境加载会出现大量空对象、组件丢失、生命周期异常;
- 适用范围:只适合纯图片、音效、静态配置表,不适合带完整游戏逻辑的脚本场景。
三、Bundle 和普通文件夹有什么本质区别?
普通文件夹(没配置Bundle)
- 构建时全部打进主包,游戏启动强制加载,占用主包4M体积;
- 没有独立索引,无法单独卸载,资源会永久占用内存;
- 不能单独异步加载,打开游戏一次性全加载完。
配置为Bundle的文件夹
- 构建时剥离出主包,单独打包成分包/远程包,启动不加载;
- 内置独立资源清单
catalog.json,引擎能精准查找里面的场景、预制、贴图; - 支持生命周期:
loadBundle加载 → 使用 →assetManager.removeBundle彻底卸载,释放全部内存; - 支持分包懒加载,解决微信4M主包限制。
举个生活化例子:
- 整个游戏 = 一栋房子(主包)
- 普通文件夹 = 家具,装修房子时全部搬进屋内,房子变大、交房变慢(启动卡顿、主包超限)
- Bundle文件夹 = 独立储物间(子包),交房时只给你钥匙,你要用储物间东西时再单独开门取用,不用不占房子空间。
四、Bundle 内部包含什么东西?
任意Bundle文件夹内,你可以放:
- 场景
.scene、预制体.prefab - 贴图、Spine动画、音效、字体、json配置
- TypeScript/JS业务脚本、自定义组件(@ccclass) 构建打包后引擎自动生成2个核心文件:
bundle.json:记录分包名称、类型、依赖、加载配置;catalog.json:资源索引表,记录每一张图、每一个脚本的路径、MD5哈希、类型,引擎靠它快速查找资源。
五、三种Bundle相关功能区分(你截图里三个按钮)
构建发布 → 勾选配置主包为远程包 把整个项目所有资源+引擎代码打包成一套超大远程主包,壳子小游戏远程加载整套游戏; 缺点:体积巨大、跨AppID带脚本必崩。
项目 → 构建Bundle 单独导出某一个标记好的Bundle文件夹,只有该分包资源,不带引擎,上传服务器做远程资源包; 适合共享纯素材,不适合完整子玩法。
资源右键 → 配置为Bundle + 构建发布(不勾选远程) 生成本地Subpackage子包,同AppID懒加载,就是你现在采用的最优方案。
六、结合你的业务场景极简总结
- Bundle 本质:可独立按需加载、单独卸载的资源分包单元,用来拆分主包体积;
- 本地Bundle(同AppID子包):脚本互通、无兼容报错,适合把step-tree作为内置子玩法;
- 远程Bundle(跨AppID):环境隔离,业务脚本会大量崩溃,不适合你的带完整逻辑小游戏;
- 普通文件夹=启动强制加载,Bundle=想用再加载,这是最核心的功能差异。
ChatRecord 全新架构
2026-07-18
全新三层架构
根因(这次真正的 bug)
uni.connectSocket({ url }) // ❌ 不传回调 → uni-app 返回 Promise → task.onOpen 不存在uni-app 规则:异步 API 传了 success/fail/complete 任一回调 → 返回原生返回值(SocketTask);不传 → 返回 Promise。之前重写时把 success 删了导致 regression。
uni.connectSocket({ url, success: () => {}, fail }) // ✅ 返回 SocketTask,task.onOpen 可用三层设计
| 层 | 类 | 职责 |
|---|---|---|
| 编排层 | TencentASRAdapter | start/stop/权限,generation 轮次隔离,识别文本缓存 |
| 传输层 | AsrSocket | 封装 H5 WebSocket / 小程序 SocketTask 差异,connect() 返回 Promise,send() 自动区分格式,close() 幂等 |
| 采集层 | AudioCapturer | 封装 H5 AudioContext / 小程序 RecorderManager,统一吐 ArrayBuffer PCM 帧 |
关键设计点
- 传输层修复 socket ——
success: () => {}拿到真正的 SocketTask - generation 轮次隔离 —— 每次 start
generation += 1,所有异步回调(onMessage / onFrame / connect 后续)都校验this.generation !== gen直接丢弃,杜绝跨轮污染 teardown()统一清理 —— start 先 teardown 上轮,stop 后台延迟 2s teardown- stop 立即 emit —— 带一路缓存的
lastText(VAD 模式 slice_type 0/1/2 持续更新),不卡 UI - 每层单一职责 —— socket 坏了只看 AsrSocket,录音坏了只看 AudioCapturer,编排逻辑只看 Adapter
三层解耦后,以后任何一端出问题都能精准定位,不用再全文件翻。
引导蒙层错位定位与修复
2026-07-17
根因分析
这次的 bug 触发链(与上次"集市页错位"不是同一个原因):
- STEP_EARN_FOOD 启动 → highlight 赚鹅粮入口
- 用户点 赚鹅粮 →
TaskListModal打开 →TaskPanelOpened触发 →_businessEventFired = true - 用户点"玩更多游戏" →
_handleGameTimeTask→ 检查授权 → 弹GameDataAuthDialog - 用户确认授权 →
_batchGrantAndGoHome触发:- 关
GameDataAuthDialog(不派发 GuideReturnedHome) - 关
TaskListModal→ 派发 GuideReturnedHome ← 关键! - 开
ReceiveTipDialog
- 关
_onReturnedHome触发 → 上次加的守卫_businessEventFired已为 true → 通过 → 双信号齐 → 推进- STEP_CLAIM_PRIZE(空)→ STEP_TAP 启动
- 但用户实际停留在
ReceiveTipDialog上 → STEP_TAP 高亮错位渲染
上次修复的守卫只防了"businessEvent 之前到达的残留信号",没防住"业务事件之后、目标弹窗关闭但其它弹窗还在"的场景。
彻底修复方案 — Baseline 守卫
核心思路:在 STEP 启动时记录 baseline(所有 active 的全屏弹窗 UIID 集合),只有当 baseline 之后新打开的弹窗全部关闭 时,GuideReturnedHome 才算"真的回到主页"。
变更(5 个文件 + 1 新文件 + 1 测试文件)
| 文件 | 变更 |
|---|---|
guideReturnHomeGuard.ts (new) | 纯函数模块,captureActiveFullScreenUIs / findFullScreenUIsOpenedAfterBaseline,deps 注入便于单测 |
CoachmarkRenderer.ts | 加 _baselineUIs 字段;_onReturnedHome 加 baseline 守卫(守卫 2,与原有 businessEvent 守卫 1 互补) |
TaskListModal.ts | hide() 派发从 tween.start() 后移到 .call() 中(让派发时 node.active=false) |
BumpPage.ts | 同上 |
ReceiveTipDialog.ts | hide() 新增派发(让"最终关闭"也能触发推进,STEP_EARN_FOOD 不卡住) |
GameDataAuthDialog.ts | hide() 新增派发(与 TaskListModal 对称) |
guide-return-home-guard.test.ts (new) | 10 个新测试,覆盖守卫 + bug 场景回归 |
验证
- ✅
pnpm test:unit:36 files / 255 tests 全过(新增 10) - ✅
pnpm build:mp:成功,src/bundle.js ≈ 900KB(远低于 4MB 约束) - ✅
read_lints:0 新增 error(pre-existing 3 errors / 32 warnings 不变)
关键设计
- pure function + deps 注入:
captureActiveFullScreenUIs(getActiveUIs)接受查询函数作参数,测试无需 mock 全局 - 双守卫互补:守卫 1 防"businessEvent 之前残留",守卫 2 防"业务事件之后新开弹窗未关闭"
- 派发时序统一在 tween
.call()中:让派发时node.active=false,getActiveUIs返回准确列表 - ReceiveTipDialog/GameDataAuthDialog 对称派发:让"最终关闭"也能触发推进,避免 STEP_EARN_FOOD 卡住
批量上报方案
2026-07-13
我先看下当前上报的实现,理解现在的调用链路和请求格式。 现在我理解了架构:CommReportItem.list 本来就支持批量(数组),但 Reporter.commReport 每次只塞一条。设计一个批量方案:
方案:Reporter 层加一个 flush 队列
- 每次
commReport把单条 push 到_pendingList - 用
microtask + 定时 flush(比如 200ms 或达到阈值批量发一次) - 一次 HTTP 请求把多条塞到
list数组 - 保持外部 API 不变(ReportService 语义方法零改动)
我先看下 GalileoReporter 和 ReportContext,确认改动范围。 架构清晰。现在实施批量:改造 Reporter.commReport 内部为「入队 + 延迟 flush」,一次 HTTP 请求把队列里所有 item 塞进 CommReportItem.list。
设计要点:
- 入队:
commReport()把单条 record 推入_pendingList(含 secondChannel/eventId/eventContent 等) - 批量阈值:达到
MAX_BATCH_SIZE = 20立即 flush;否则FLUSH_INTERVAL_MS = 500后自动 flush - flush:一次
commReportRequest({ app_name, list: [...] }),list是数组 - Galileo:每条依旧单独 report(Galileo 是单条协议,跟批量无关)
- 兼容:外部 API 完全不变,
ReportService零改动 - 可关:
FLUSH_INTERVAL_MS = 0时立即发(保留原行为兜底) 好,方案清晰。现在改造Reporter.ts加批量缓冲: 只需要清理两个未使用的 import(我用了_getTraceId里的secondChannel但没用ReportSecondChannel枚举;REPORT_GAME_ID之前就注释掉了)。下划线命名 warning 是既有风格(原代码_getTraceId就带下划线,全项目一致),忽略。 0 error 了。剩下的 warning:
- 下划线命名(
_pendingList/_flushTimer/_scheduleFlush/_flushNow/_getTraceId)— 全项目风格如此(原文件里_getTraceId就带下划线),保持一致 _getTraceId内部.slice(-4)缩进 — 原代码就是这样,未动- 两个 hint 是 IDE 语言服务的旧缓存,实际 ESLint 已 0 unused-vars error
跑单测和构建验证一下: 130/130 pass。
改造完成
核心思路:改造 Reporter.ts 内部为「入队 + 延迟 flush」,外部 API 完全不变。
变更文件:assets/scripts/core/report/Reporter.ts
行为:
commReport()不再立即发 HTTP,而是把单条 list item 推入_pendingList- 阈值
MAX_BATCH_SIZE = 20或超时FLUSH_INTERVAL_MS = 500ms自动 flush - flush 时一次 HTTP 请求把队列所有 item 塞进
CommReportItem.list数组(接口本来就支持数组) - Galileo 上报保持原有单条协议(跟 CommReport 批量无关)
- 新增公开方法
Reporter.flush(),可在页面关闭/切换时兜底调用
关键设计:
- 定时器"首次到达触发排定,后续入队不重排"(防止高频事件让定时器无限延后,最坏 500ms 一定发)
- 达到 20 条立即发(防止一次请求过大)
- 队列先取走再置空
this._pendingList = [],避免下一次 push 与 in-flight 请求混淆 - 业务侧
ReportService零改动,100+ 调用点无感
验证:
pnpm test:unit130/130 pass- read_lints 0 error(剩余 warning 全部与本次改动无关,是全项目
_xxx命名风格惯例)
预期效果(对照截图):截图里几十条 CommReport?tstamp=xxx 请求会合并成每 500ms 一次或每 20 条一次的批量请求,请求数量降至 1/20,请求 payload 从 list: [1条] 变为 list: [N条]。
_broadcastSwitchGen 的设计思想是什么
2026-07-13
The user is asking about the design philosophy behind _broadcastSwitchGen. Let me explain it clearly.
_broadcastSwitchGen is a generation counter used as a "stale callback guard" pattern. It's a common pattern in async UI code to prevent old async callbacks (from setTimeout, tween, or fetch) from writing to a node that has since been hidden or re-entered.
Let me walk through the full design:
Problem: When BumpSelectPage.show() is called, it kicks off an async flow (_refreshBroadcast) that:
- Does
await queryBumpNotifications()(network delay) - After network returns, schedules
setTimeout(3s)for carousel rotation - Inside setTimeout, runs a
tween(0.18s)fade-out - Inside tween callback, renders next item and schedules next cycle
If the user closes the page (hide()) during any of these async gaps, the stale callbacks will fire on a hidden/destroyed node, causing:
- Attempts to render text on a destroyed Broadcast node
- Setting bc.active = true on a hidden page
- Scheduling more timeouts that will never be cleaned up
- Does
Solution: Every time a new "refresh session" starts (show() or hide()), increment gen. All async callbacks store a snapshot of gen at creation time, and before doing anything, they check if their stored gen still matches the current gen. If not, they return immediately.
The key insight that makes it elegant:
show()→_refreshBroadcast()takesmyGensnapshot → only one incrementhide()→_stopBroadcastCarousel()increments gen → all pending callbacks from the previous show() session will fail their gen check and bail out- Inside carousel cycle,
_scheduleNextTickpassesgento every recursive tick, so even a deeply nested setTimeout→tween chain can tell if it's stale
The earlier bug was that _refreshBroadcast was effectively incrementing gen twice (once at ++gen entry, once inside _stopBroadcastCarousel()), making myGen always one behind and causing the guard to falsely reject valid results.
Let me explain this clearly to the user. _broadcastSwitchGen 是一个代次号(generation counter),解决的是典型的"异步回调在页面已销毁/重入后复活"问题。
要解决的问题
_refreshBroadcast 里有一串跨越多个时间维度的异步链:
show()                 ← 时刻 A
  _refreshBroadcast()
    await queryBumpNotifications()   ← 网络延迟 200ms
    setTimeout(3s)                   ← 宏任务
      tween 0.18s fade-out           ← 帧循环
        .call() 回调                  ← 帧循环
          渲染下一条
          setTimeout(3s)             ← 又排一个宏任务
            tween fade-out
              ...
如果用户在 3s 轮播定时器还没到 时就关了页面(hide()),那些排好队的 setTimeout、tween.call() 仍然会在未来触发,对着一个已销毁的节点做 _renderBroadcastAt、bc.active = true。
解决方案
给整个"播报刷新会话"发一个代次号,所有异步回调在动手之前先验代次号:
show() →
  gen = 1                            ← 当前会话 = 第 1 代
  _refreshBroadcast(myGen=1)
    await queryBump 完成 (gen 仍是 1 → 继续)
    setTimeout(3s, gen=1)
    tween.fadeOut → .call(gen=1)     ← 这里 gen=1,继续
    setTimeout(3s, gen=1)

  用户 hide() →
    _stopBroadcastCarousel()
      clearTimeout()
      gen = 2                        ← 代次号失效!

  残留的 setTimeout(3s, gen=1) 触发 →
    if (gen=1 !== _broadcastSwitchGen=2) return;  ← 早退!
关键规则
| 触发者 | 行为 | gen 变化 |
|---|---|---|
_refreshBroadcast 入口 | gen+1,用 myGen 快照往下传 | 每次 show 让 gen 前进 1 |
_stopBroadcastCarousel(hide()) | clearTimeout + gen+1 | 让所有「上一代」的回调全部失效 |
_scheduleNextTick(gen) | 把 gen 透传给下一层 setTimeout / tween.call() | 不改变,只是每一轮回调都带着自己的"出生代" |
这样即使最末端的 _onFadeOutComplete(在 tween.call 回调里再 _renderBroadcastAt + _scheduleNextTick),也能用最初 show() 那次的 gen 判断自己是否已过时。
前面那个 bug 是怎么来的
_refreshBroadcast 原本同时做了两件事:
- 入口
++gen拿到myGen("新一回刷新开始了") - 又调了
_stopBroadcastCarousel()("清理旧轮播")
而 _stopBroadcastCarousel 内部也 ++gen。结果 myGen 恒等于 1,但实际 gen 已被推到 2,所有校验都失败。这就是为什么"有数据但页面没展示"。
新手引导中点击喂食无反应
2026-07-11
问题定位 Bug 位置:assets/scripts/module/guide/view/renderer/CoachmarkRenderer.ts:213-214 // a) 转发点击到目标节点(业务 Button 触发,跳页 / 喂食 / 弹窗) try { target.emit(Node.EventType.TOUCH_END); target.emit('click'); } catch (e) { oops.log.error('[CoachmarkRenderer] 转发点击失败', e); } target 是从 GuideAnchorRegistry 取的锚点节点,对喂食按钮来说就是 feed(父节点)。Coachmark 合成点击事件时只 emit 在父节点 feed 上。 根因 MainHomeBuilder.ts 给三个底部按钮都用了「父节点做视觉 + 子节点 HitArea 做点击区」模式: feedHit.on(Node.EventType.TOUCH_END, () => callbacks.onFeed()); MainHomeBuilder._bindPressScale(feedHit, feed);
// 引导锚点:喂食按钮(STEP_FEED) GuideAnchorRegistry.ins.register('home.feed-button', feed);
- feedHit(子节点,228×280 扩大点击区)注册了 TOUCH_END 监听 → 真正调 callbacks.onFeed() → GooseHomeApp.handleFeed()
- feed(父节点,可见切图)注册了引导锚点 home.feed-button Cocos 的 node.emit() 不会向子节点冒泡——只在当前节点触发。所以合成点击发到 feed(父)上,feedHit(子)的 TOUCH_END 监听永远收不到,callbacks.onFeed() 永远不跑 → handleFeed() 不跑 → 没有 PetFedEnd 事件 → 引导卡在等 PetFedEnd + GuideReturnedHome 双信号(30s 兜底才推进)。 影响范围 |引导步|锚点|实际监听节点|受影响?| |-|-|-|-| |STEP_FEED (喂食)|feed|feedHit 子节点|✅ 是| |STEP_EARN_FOOD (赚鹅粮)|earn|earnHit 子节点|✅ 是| |STEP_COLLECT (集市)|market|marketHit 子节点|✅ 是| |STEP_TAP (碰一碰)|wrap|wrap 自身|❌ 否(监听和锚点同节点)|
修复方案 推荐方案 A:递归 emit(修 CoachmarkRenderer) CoachmarkRenderer._onTargetClicked 改为递归遍历 target 的所有后代节点都 emit 一次。这样:
- 父节点和子节点各自注册了监听都能触发
- 业务侧无需改任何东西,三个按钮一次性修好
- 防止以后再加新按钮又踩同样的坑 assets/scripts/module/guide/view/renderer/CoachmarkRenderer.ts:213 改造为: const forwardClick = (node: Node): void => { node.emit(Node.EventType.TOUCH_END); node.emit('click'); for (const child of node.children) { forwardClick(child); } }; forwardClick(target); 其他备选:
- B:把 MainHomeBuilder 三个按钮的 on(TOUCH_END, ...) 监听搬到父节点(feed/earn/market),但父节点 UITransform 尺寸是 148×80,触摸区会变小,违反当前「扩大点击区」的设计意图。
- C:把 GuideAnchorRegistry.register 三个锚点都改为子节点 feedHit/earnHit/marketHit,但 circle 镂空会按子节点尺寸 228×280 渲染,视觉圈放大可能与设计稿偏离。 要直接修 A 方案吗?我会把 forwardClick 抽成模块内私有方法,3 行代码改动,跑下 read_lints 验收。
泛化事件 是啥意思
2026-07-11
简单说:GuideReturnedHome 这个事件名太通用了——Bazaar、TaskListModal、BumpPage、LayEggDialog 四个不同页面的 hide() 都派发同一个 EventName.GuideReturnedHome。所以 CoachmarkRenderer 订阅时收不到"这是谁派发的"信息,无法区分来源。 就是同一个事件名被多个不同的界面/场景共用派发,"谁的返回"分不清。
Bazaar.hide()           ──→ dispatch(GuideReturnedHome)
TaskListModal.hide()    ──→ dispatch(GuideReturnedHome)
LayEggDialog.hide()     ──→ dispatch(GuideReturnedHome)
BumpPage.hide() ──→ dispatch(GuideReturnedHome)四个不同的页面关闭,派发的是同一个 EventName.GuideReturnedHome。CoachmarkRenderer 订阅这个事件时,收到的只是一个匿名信号——不知道是谁关的、什么时候关的、是为当前引导步关的还是为上一步关的。
非泛化(好的设计)应该是:
Bazaar.hide()     ──→ dispatch(BazaarClosed)        ← 事件名带身份
LayEggDialog.hide() ──→ dispatch(LayEggClosed)       ← 可以区分来源
这样 renderer 能精准知道"这是集市关了"而不是"某个页面关了",就不会把上一步 LayEggDialog 关闭的信号误收成当前步"集市返回主页"。
为什么设计成泛化? 因为所有页面关闭时 CoachmarkRenderer 需要的行为是一样的——"用户回到主页了,推进到下一段"。但这个设计假设"renderer 启动后收到的第一个 GuideReturnedHome 一定是当前步触发的",而实际上上一步残留/延迟的 GuideReturnedHome 会被提前订阅收走,就产生了 bug。
我们的修复就是加一个"因果顺序"守卫来弥补事件缺乏来源标识的问题:businessEvent(如 BazaarOpened)之前收到的 GuideReturnedHome 不可能是当前步的,忽略。
泛化事件导致的新手引导蒙层错位
2026-07-11
    const seg = this._seg;
    // GuideReturnedHome 是泛化事件(Bazaar / TaskListModal / BumpPage / LayEggDialog
    // 关闭时都会派发)。本段在 _start 阶段就提前订阅它(防止 businessEvent 之后目标
    // 页面自动关闭时信号丢失)。但由此带来一个陷阱:上一段(如 STEP_FEED 的 LayEggDialog
    // 关闭)延迟 / 残留派发的 GuideReturnedHome 会被本段提前收到。
    //
    // 逻辑约束:GuideReturnedHome(用户操作完目标页面「回到主页」)必然发生在 businessEvent
    // (目标页面「打开」,如 BazaarOpened)之后——先打开集市才谈得上关闭集市。因此若本段
    // 要求 businessEvent 但它尚未到达,这次 GuideReturnedHome 一定是上一步 / 其它页面的
    // 残留信号,与本段无关,必须忽略。
    //
    // 若不忽略:残留信号会把 _returnedHomeFired 提前置 true,用户一触发 businessEvent
    // (点开集市)双信号立即到齐 → 本段提前推进 → 下一段高亮(STEP_EARN_FOOD 的
    // home.task-entry)错位渲染到用户当前仍停留的集市页上(左下角空白处冒出高亮圈)。
    if (seg?.completeOn.businessEvent && !this._businessEventFired) {
      oops.log.logBusiness('[CoachmarkRenderer] 忽略 businessEvent 之前到达的 GuideReturnedHome(残留信号)');
      return;
    }
签到领取奖励收口
2026-07-11
我先把 _checkAndClaimLoginTask 现状和 TaskService.autoSignInAndClaimIfNeeded 的返回值搞清楚,再给方案。 我看清楚了核心问题:
- Bug 现状:
_checkAndClaimLoginTask里list = await TaskService.ins.fetchTaskList()拿到列表后没有 claimable → 直接返回 null,从来不会调dailySignIn()。这跟autoSignInAndClaimIfNeeded是同一件事,只是缺了「没 claimable 就调签到再拉再领」这半段。 - 冲突现状:
Game._installDailySignInWatcher已经在登录时自动跑autoSignInAndClaimIfNeeded(我这轮加的),而 GuidePage_checkAndClaimLoginTask又自己写了一套简化版签到领取——两套并跑,还可能互相踩:GuidePage 用getList() 快照 → 找 day1 → claim时,登录侧的autoSignInAndClaim可能已经在 round1 领了同一档。 - 需求:引导时 + 平常都要弹「今日登录鹅鹅 收获鹅粮 +Ng」的 cutscene;平常那次要能开关。
优雅方案
核心思路:把「签到+领取」这份业务逻辑彻底收口到 TaskService.autoSignInAndClaimIfNeeded(返回本次领到的总金额),任何调用方都只负责「拿金额 → 决定要不要弹 cutscene」,不再自己找 cell / 调 claim / 调 sign。
具体:
1. TaskService.autoSignInAndClaimIfNeeded 返回 { claimedAmount: number; claimedTaskIds: string[] }
_claimAllClaimableLoginCells内部把cell.amount累加返回_runAutoSignInAndClaim累加 round1+round2 的 amount- 短时间去重 promise 复用同一结果
2. 新增独立组件 LoginBonusCutscene(assets/scripts/module/task/view/LoginBonusCutscene.ts)
- 直接复用
CutsceneRenderer+STEP_FEEDcutscene① 的 seg 配置(title/subtitle/iconAmount/duration/showBackground) - 静态
LoginBonusCutscene.show(amount: number): Promise<void>:找到 root layer → 挂一个盖满屏的 stage node → 渲染 CutsceneRenderer → 完成时清理 - 用 UIID 注册太重(只是一个 3s 的 cutscene 无交互层),走
oops.gui.layer.top直接挂节点更轻
3. 收口触发点:TaskService 内部弹(业务规则集中)
autoSignInAndClaimIfNeeded(opts?: { showBonusCutscene?: boolean })领完有金额 → 调LoginBonusCutscene.show(amount)- Game 登录 watcher 调
autoSignInAndClaimIfNeeded({ showBonusCutscene: true })(默认可关) - 需要"关掉平常弹"时改成
{ showBonusCutscene: false }即可,一处开关
4. GuidePage _checkAndClaimLoginTask 简化
- 从"自己找 day1 → claim"改成
const { claimedAmount } = await TaskService.ins.autoSignInAndClaimIfNeeded({ showBonusCutscene: false }) - 关键:Guide 场景要求 cutscene 内嵌在 guide stage(跟其他 step 连续播放),所以 Guide 传
showBonusCutscene: false阻止 TaskService 弹独立 cutscene,然后自己把claimedAmount注入 seg.iconAmount → 沿用 guide 的CutsceneRenderer.build(this._stage, seg, done)播放 - amount=0 时跳过 cutscene①,逻辑不变
- 修掉原 bug:现在没 claimable 也会走签到再领,Day1 补签也能领到
5. 冲突保护
autoSignInAndClaimIfNeeded本身有_autoClaimPending去重,Guide 触发时如果登录 watcher 已经在跑,会 await 同一 Promise,共享同一份claimedAmount结果- 但 Guide 想吞掉 TaskService 侧的弹窗,所以选项要传
showBonusCutscene: false——这里有个坑:登录 watcher 先跑showBonusCutscene: true→ 已在弹 → Guide 又调时复用同一 Promise 就没法关。解决:把去重 promise 拆成"业务 promise(领取结果)" + "弹窗触发(副作用)"两段,showBonusCutscene只影响副作用;Guide 侧调用时如果发现已经在跑,多设个"抑制标记"让当前尚未完成的那次跳过弹窗,或者更简单——Guide 启动前先 dispose 掉已挂的 LoginBonusCutscene 节点(Guide 有自己的清屏逻辑_stage.removeAllChildren,若把 cutscene 挂在 Guide 会用到的 stage 层就自然被清)
6. 关平常那次的开关放哪
env.ts里加SHOW_LOGIN_BONUS_CUTSCENE: true(后续要关时改一处)- 或者
Game._installDailySignInWatcher里显式传,先默认 true,产品要下线时改成 false 即可
要不要我按这个思路直接开写?主要是 4 步:
- 改
autoSignInAndClaimIfNeeded返回{ claimedAmount, claimedTaskIds } - 新建
LoginBonusCutscene.ts(复用 CutsceneRenderer + STEP_FEED seg 配置) - 改
Game._installDailySignInWatcher传showBonusCutscene: true - 改 GuidePage
_checkAndClaimLoginTask→ 委托给autoSignInAndClaimIfNeeded({ showBonusCutscene: false }),修 Bug + 消除重复代码
有一点想确认:LoginBonusCutscene 展示时用户如果正在别的 UI 上(比如已经开了 TaskListModal),是盖上面还是排队? 我倾向"直接盖 top layer",因为它只有 3s + 点击关闭,无交互冲突。你决定即可。
上面图里的 fire-and-forget 啥意思
2026-07-11
"Fire-and-forget" 是一种异步调用模式,意思是发射后不管——调用一个异步操作后不 await 它的结果,让它在后台自行完成,主流程不等待也不处理返回值。
在代码里通常表现为:
// fire-and-forget:用 void 表达"我知道这是 Promise 但故意不等"
void TaskService.ins.fetchTaskList();
void ResManager.preloadGroupWhenIdle(PreloadGroup.AuthBoot, { initialDelayMs: 0 });
对比正常 await:
// 阻塞等待结果
await TaskService.ins.fetchTaskList();适用场景:预热/预加载、日志上报、缓存刷新等——这些操作的结果不影响当前主流程,失败了也无所谓(内部自行兜底),所以不需要阻塞等待。
在本项目里你之前也用过这个模式,比如 GooseHomeApp._afterGuide 末尾的 void TaskService.ins.fetchTaskList() 就是典型的 fire-and-forget 预热。
不加闭包,我就得新加个变量吗
2026-07-11
先说结论:
不加自执行闭包(IIFE),不用新增全局变量,但必须多一个局部临时变量;而且会破坏「原子上锁」,存在并发竞态漏洞,不推荐。
1. 先看不加闭包的等价写法(多一个局部临时变量)
let globalConfig: GooseRainbowConfig | null | undefined;
let fetchPromise: Promise<GooseRainbowConfig | null> | undefined;

export async function getGooseRainbowConfig(): Promise<GooseRainbowConfig | null> {
    if (globalConfig !== undefined) return globalConfig;
    if (fetchPromise !== undefined) return fetchPromise;

    // 这里多了个局部临时变量 task,替代闭包
    const task = async () => {
        try {
            const cfg = await getRainbowConfig<GooseRainbowConfig>({
                provider_name: 'frontconfig',
                path: isTestEnv() ? 'goose_game_test' : 'goose_game',
            });
            globalConfig = cfg ?? null;
            return globalConfig;
        } catch (err) {
            fetchPromise = undefined;
            throw err;
        }
    };
    // 调用拿到 Promise 实例再赋值
    fetchPromise = task();
    return fetchPromise;
}- 没有新增全局变量,只多了函数内局部变量
task; - 逻辑和 IIFE 完全等价,功能一模一样;
2. 关键坑:这种写法有并发竞态bug(重点)
IIFE 是一行原子同步赋值:
fetchPromise = (async () => { ... })();执行顺序:同步创建Promise → 立刻赋值给fetchPromise,中间没有空隙。
分开写 const task = ...; fetchPromise = task(); 看似一样,但极端并发场景有漏洞:
- 请求A走到
const task = async ()=>{}; - JS事件循环切走,请求B同时进入函数,同样走完
const task; - A 执行
fetchPromise = task(); - B 再执行
fetchPromise = task();
最终会生成两个独立Promise、发起两次重复接口请求,失去合并请求的作用。
IIFE 一行赋值杜绝了这个时间空隙,是原子操作。
3. 有没有办法不加闭包、不加临时变量?
做不到。 原因:代码里有 await,await 只能写在 async 函数内部。 你只有两个选择:
- IIFE 自执行闭包:无临时变量,原子上锁,无并发漏洞;
- 单独定义 async 函数:需要局部临时变量,存在竞态风险。
4. 补充:为什么不能直接写?
下面这种直接赋值语法直接报错,JS/TS 不允许:
// 语法错误:await 不能直接写在普通代码块,只能在async函数内
fetchPromise = await getRainbowConfig(...)
极简总结
- 不加闭包,不需要新增全局变量,但必须加一个函数内局部临时变量;
- 拆分写法存在并发重复请求漏洞,IIFE 自执行是更安全、简洁的方案;
- 核心约束:有
await就必须包裹在async函数里,绕不开一层函数封装。
单例缓存+请求合并方案
2026-07-11
整体思路方向正确:用全局变量缓存配置、用 pending 函数锁并发请求,避免同一时刻多次重复拉取接口,但存在几处逻辑缺陷、边界bug、写法不规范,下面逐条拆解。
一、现有代码存在的问题
1. pending 赋值逻辑有竞态风险(严重)
if (pendingGetGooseRainbowConfig) return await pendingGetGooseRainbowConfig();
pendingGetGooseRainbowConfig = async () => { ... }
return await pendingGetGooseRainbowConfig();
并发场景时序问题:
- 同时两个请求进入函数,
globalConfig为空、pendingGetGooseRainbowConfig初始undefined - A线程判断 pending 不存在,走到赋值行之前让出事件循环
- B线程同样判断 pending 不存在,也进入赋值逻辑
- 最终会创建两个独立请求函数、发起两次接口调用,失去请求合并作用
根源:先判断、后赋值,中间有空隙,没有原子锁。
2. pending 变量永久残留,失败不会清空
如果 getRainbowConfig 接口抛异常(网络错误、500等):
globalConfig不会赋值pendingGetGooseRainbowConfig永远指向这个失败的 Promise 函数- 后续所有调用
getGooseRainbowConfig()都会一直复用失败请求,永久拿不到配置,不会重试。
3. 类型与空值逻辑瑕疵
globalConfig声明未初始化,默认undefined,判断if (globalConfig)没问题,但语义不清晰;cfg ?? null:如果接口返回合法配置对象直接赋值,返回 null 缓存 null,本身没问题,但要确认业务是否允许永久缓存 null。
4. 写法冗余
pendingGetGooseRainbowConfig 存一个 () => Promise 包装函数没必要,直接存 Promise 对象更简洁。
二、修复后的标准实现(请求合并+失败自动释放锁)
type GooseRainbowConfig = any;
declare function isTestEnv(): boolean;
declare function getRainbowConfig<T>(opts: any): Promise<T | null>;

// 全局缓存配置
let globalConfig: GooseRainbowConfig | null | undefined;
// 直接缓存Promise,代替包装函数,解决竞态
let fetchPromise: Promise<GooseRainbowConfig | null> | undefined;

export async function getGooseRainbowConfig(): Promise<GooseRainbowConfig | null> {
    // 1. 已有缓存直接返回
    if (globalConfig !== undefined) {
        return globalConfig;
    }

    // 2. 已有正在请求的Promise,复用,合并请求
    if (fetchPromise) {
        return fetchPromise;
    }

    // 3. 首次发起请求,原子赋值Promise,杜绝并发重复请求
    fetchPromise = (async () => {
        try {
            const cfg = await getRainbowConfig<GooseRainbowConfig>({
                provider_name: 'frontconfig',
                path: isTestEnv() ? 'goose_game_test' : 'goose_game',
            });
            // 成功写入缓存
            globalConfig = cfg ?? null;
            return globalConfig;
        } catch (err) {
            // 请求失败,清空Promise锁,允许下次重新拉取
            fetchPromise = undefined;
            throw err; // 抛出异常让上层自行处理失败逻辑
        }
    })();

    return fetchPromise;
}
三、关键优化点说明
解决竞态并发 先把
fetchPromise立即赋值,所有并发进来的请求都会复用同一个 Promise,只会发起一次接口。失败自动释放锁 接口报错时
fetchPromise = undefined,下次调用会重新发起请求,不会卡死永久失败。缓存区分「未请求」和「请求过无配置」
globalConfig === undefined:还没拉取过配置globalConfig === null:拉取过,但配置为空,永久缓存不再请求
精简存储结构 不再存
()=>Promise包装函数,直接存 Promise 实例,减少一层调用。
四、拓展补充(可选需求)
场景1:需要主动刷新配置(新增刷新函数)
export function clearGooseRainbowConfigCache() {
    globalConfig = undefined;
    fetchPromise = undefined;
}

// 使用:更新配置后手动清缓存重新拉取
// await clearGooseRainbowConfigCache();
// const newCfg = await getGooseRainbowConfig();
场景2:不希望缓存 null,失败后每次都重试
删除 globalConfig = cfg ?? null,仅成功返回配置时赋值 globalConfig = cfg,失败不写缓存。
五、总结原代码对错结论
- 核心思路缓存+合并并发请求是正确的;
- 原生代码有两个致命缺陷:
- 并发下会重复发起请求(竞态漏洞)
- 接口报错后永久卡死,无法重试;
- 建议替换为上面直接缓存 Promise 的标准实现。
装扮选中态的数据源
2026-07-10
完整梳理:装扮选中态的数据源
当前架构
后端权威(PetService.getFirstPet().equipment)
    ↓ getCostumeSpineSkinFromPet() 解析
    ↓ CostumeSkinService.syncSavedKey() 对齐本地
本地缓存(localStorage 'costume:current-skin')
    ↓ CostumeSkinService.ins.savedKey
    ↓ SKIN_TO_CARD[savedKey]
CostumePage.selectedKey(UI 选中态)
问题根源
| 时机 | selectedKey 取值方式 | 问题 |
|---|---|---|
| 类属性初始化 (line 126) | SKIN_TO_CARD[CostumeSkinService.ins.savedKey] | 读 localStorage 缓存,可能是旧值 |
| show() (line 164/171) | syncFromBackend() 里再从后端 PetInfo 纠正 | 但这里依赖 PetService.getFirstPet() 内存缓存——如果用户在别处(如首页)换了装扮但没刷 PetInfo,依然是旧的 |
| 保存后退出再进 | hide() → discardPreview()(只回退 previewKey);再次 show() → syncFromBackend() 走内存里的 PetInfo | PetInfo 在 onSave() 末尾 refresh() 了,所以再进来时后端数据是新的 ✓ |
核心隐患:selectedKey 作为属性初始化表达式只在组件 addComponent 时执行一次(等同 constructor),之后 show() 虽然会 syncFromBackend(),但如果页面第一次已经 buildAll() 过(initialized=true),且 syncFromBackend() 判断 key 没变就不重建——导致只在 PetInfo 刷新且 spineSkin 确实变了的时候才会纠正 UI。
场景复现:
- 首次进装扮页 → 选中 xiha → 保存成功 → spine 变 xiha
- 退出 → 首页 spine 也变 xiha(CostumeChanged 事件 + PetInfoLoaded)✓
- 不关小游戏,再次进装扮页 →
show()→syncFromBackend()→getCostumeSpineSkinFromPet()返回 xiha →SKIN_TO_CARD[xiha]='skin-xiha' - 但
selectedKey已在上一次 show() 里被设成'skin-xiha'(保存时没更新 selectedKey 到最新) - ❌ 如果上一次保存后又预览了别的卡片没保存,那
selectedKey停留在那张预览卡!
用户:选 bee → selectedKey='skin-bee' → 保存成功 → commitPreview → selectedKey 仍 = 'skin-bee' ✓
用户:再选 xiha 预览(不保存) → selectedKey='skin-xiha'
用户:退出 → discardPreview(previewKey→bee) → 但 selectedKey 没重置!
用户:再进 → syncFromBackend() → getCostumeSpineSkinFromPet()=bee → SKIN_TO_CARD='skin-bee'
        → selectedKey('skin-xiha') !== 'skin-bee' → 走 setSelected('skin-bee') → 纠正 ✓
实际上 syncFromBackend() 能纠正。但存在一个边界:如果 PetInfo.refresh() 失败了(line 772 catch 只打日志不 rethrow),内存里的 PetInfo 不变 → syncFromBackend 取不到最新 → 不会纠正。
方案:全部从后端唯一真实源驱动
改动点:在 show() 中强制从后端 refresh PetInfo,确保 selectedKey 总是后端权威值。
现在改造 show() 方法,让每次打开装扮页先从后端 refresh PetInfo,再用后端权威值驱动 selectedKey: 现在还要修 hide():离开时除了 discardPreview(),也要把 selectedKey 重置到后端保存值,这样下次进来即使 _refreshAndSync 还没返回,selectedKey 也不会停留在上次预览的卡: 唯一新引入的是 line 192 方法名前缀下划线 warning。其余都是已有的 pre-existing issues(cc 模块解析、命名规范等)。让我修一下方法名:
0 新增错误。剩余都是 pre-existing 问题。
完整梳理总结
改造前的数据流(有隐患)
┌─────────────────────────────────────────────────────────────┐
│  CostumePage.selectedKey 初始化                              │
│    = SKIN_TO_CARD[localStorage 缓存]  ← 可能过时!           │
│                                                              │
│  show() → syncFromBackend()                                  │
│    = getCostumeSpineSkinFromPet()  ← 用 PetInfo 内存缓存     │
│    → 如果内存也过时(refresh 失败 / 跨端操作),就不纠正       │
│                                                              │
│  hide() → 只 discardPreview()                                │
│    → selectedKey 停留在上次预览的卡!                          │
└─────────────────────────────────────────────────────────────┘
改造后的数据流(后端唯一真实源)
┌─────────────────────────────────────────────────────────────┐
│  show()                                                      │
│    1. syncFromBackend()         ← 快速用内存缓存纠正(零延迟)│
│    2. refreshAndSyncFromBackend()  ← 异步拉后端最新 PetInfo   │
│       ↓ await PetService.ins.refresh()                       │
│       ↓ syncFromBackend()       ← 后端权威值覆盖 selectedKey │
│                                                              │
│  hide()                                                      │
│    1. discardPreview()          ← previewKey → savedKey      │
│    2. selectedKey = SKIN_TO_CARD[savedKey]  ← 重置选中态     │
│                                              不残留预览卡     │
│                                                              │
│  数据优先级:后端 PetInfo > localStorage > 默认 luofu         │
└─────────────────────────────────────────────────────────────┘
改动文件
| 文件 | 改动 |
|---|---|
CostumePage.ts show() | 新增 void this.refreshAndSyncFromBackend() 异步拉后端 |
CostumePage.ts refreshAndSyncFromBackend() | 新增方法:refresh → syncFromBackend |
CostumePage.ts hide() | 新增 selectedKey = SKIN_TO_CARD[savedKey] 重置选中 |
CostumePage.ts onPhoto() | 上一轮改的:subText 用 savedKey 名称 |
场景验证
| 场景 | 行为 |
|---|---|
| 保存 xiha → 退出 → 再进 | hide 重置 selectedKey→xiha;show syncFromBackend 确认 xiha ✓ |
| 预览 bee 不保存 → 退出 → 再进 | hide 重置到 savedKey(xiha);refresh 后端确认 xiha ✓ |
| 跨端在其他端换成 bee → 进装扮页 | syncFromBackend 先用旧内存(xiha);refresh 后拿到 bee → 纠正 ✓ |
| 保存失败(Equip 报错) | commitPreview 不执行、PetInfo 不变;hide 重置到旧 savedKey ✓ |
| refresh 网络异常 | catch 打日志 return;fallback 用内存缓存(最后一次成功的 PetInfo)✓ |
多么简单的登录流程
2026-07-09
iphone uuid
2026-07-08
- 00008120-000E2D9E2662601E
- 00008030-001239581A29802E
versionCode 计算公式
2026-07-08
versionCode = X * 10000 + Y * 100 + Z
蓝牙数据传输
2026-07-08
好的,采用方案 A:Android 端在广播时把 payload 塞进 manufacturerData(真正的 advertising packet 字段),iOS Central 端从 advertisData 解析兜底。
我先精确定位需要改的代码。 [读取文件中] [读取文件中] 代码结构很清楚了。方案 A 的改造点如下:
改动方案
改点 1:wx-adapter.ts startAdvertising 和 updateAdvertisedValue
在 advertiseRequest 里加上 manufacturerData 字段。微信 Android 会把它塞进 advertising packet 的 Manufacturer Specific Data AD Type(0xFF),iOS Central 端在 advertisData 里能读到。
- 使用一个虚构的
manufacturerId(16-bit LE),我们用0xFEED(跟 serviceUuid 前缀一致,方便识别) manufacturerSpecificData就是 payload 的 UTF-8 字节
改点 2:utils.ts parsePayload
在 advertisData 解析步骤中,先剥掉可能的 AD Type 头(length + type + manufacturerId(2字节 LE) + payload),再尝试解析 UTF-8 payload。
我也顺便把当前有污染的 iOS 日志 2L48QG_------ 那种"petId 全是-"的无效数据在 parsePayload 中直接过滤掉(现在 parseBumpName 会返回 { petId: '------' },然后走到 BumpService 里才判掉,日志里刷屏的 "对端 petId 无效" 都是这里来的)。
先开工: [读取文件中] 先加个常量,再改 3 个文件:
1. constants.ts 新增 BUMP_MANUFACTURER_ID
[编辑文件中]
2. wx-adapter.ts 广播时加 manufacturerData
[编辑文件中]
3. utils.ts parsePayload 增强 —— 从 advertisData 里剥出 manufacturer data payload
微信 iOS onBluetoothDeviceFound 回调中的 advertisData 就是厂商自定义数据段的 raw bytes(不含 length/type 头),格式是:[manufacturerId LE 2 bytes][payload...]。所以我们要跳过前 2 字节,尝试解析剩余部分。
同时也补一层"扫全 buffer 查找 payload 分隔符"的兜底,最大化健壮性。 [编辑文件中] [编辑文件中] 现在把 arrayBufferToUtf8 加个 offset 参数: [编辑文件中]
4. 顺手治一下"petId 全是 -" 的脏数据 —— parseBumpName 里增加 petId 格式校验
这样 iOS 上扫到BUMP_2L48QG_------ 直接返回 null(不认这个设备),彻底不再刷"对端 petId 无效,跳过昵称查询"日志: [编辑文件中]
5. 检查 lint 无误
[代码检查中] ✅ 无 lint 错误。
📋 改动总结
| 文件 | 变更 |
|---|---|
constants.ts | 新增 BUMP_MANUFACTURER_ID = 0xFEED |
wx-adapter.ts | startAdvertising / updateAdvertisedValue 首选 advertiseRequest 增加 manufacturerData 字段(4 层 fallback:全字段 → 对象 serviceData → 无 serviceData → 无 mfr → 裸跑) |
utils.ts | parsePayload 从 advertisData 兜底解析时先剥掉 2 字节 manufacturerId 再按 UTF-8 解析;parseBumpName 增加 petId 格式校验(过滤 ------ 之类脏数据);arrayBufferToUtf8 支持 offset |
🔍 预期效果
再次两台机器互扫 iOS 日志应该会看到:
parsePayload {"deviceId":"97EBF6DC-...","name":"","RSSI":-40,
             "advertisData":"<ArrayBuffer: byteLength=??>",...}
[bump] 雷达上发现鹅 tempId=EKTJ0S petId=3gme3wdjj4ab9 rssi=-40  ✅
[bump] 获取对端昵称成功 peerTempId=EKTJ0S nick=xxx- iOS 端读到 Android 广播的
advertisData(原来一直是空/没打印,现在 Android 会主动写入) - 剥掉前 2 字节 manufacturerId 后剩下
EKTJ0S|3gme3wdjj4ab9 parsePayloadString解析成功 → 首次实现 Android→iOS 单向识别 ✅
而 iOS 端扫到的 2L48QG_------(他人干扰)会被 parseBumpName 直接判空,不再刷屏日志。
⚠️ 已知风险与降级
- 若微信基础库版本较低不支持
manufacturerData,startAdvertising会fail,我们的 4 层 fallback 会自动降级到"仅deviceName+serviceUuids"(也就是改动前的行为),不会影响原来 Android↔Android / iOS↔iOS 的正常路径。 - iOS Peripheral 端调
startAdvertising时传manufacturerData会不会被拒不确定,若被拒也会自动 fallback。安全。
为什么BUMP_QK9 这个会被截断,谁做的,哪里做的
2026-07-08
这是一个很好的问题。BUMP_QK94FKJJD1I_00myi68uwr1er 被截断为 QK9 是 iOS 系统行为,不是代码做的。
原因分析
1. iOS BLE 广播包的 localName 长度限制
iOS 系统在 BLE 广播包(Advertising Packet)中,localName(AD Type 0x09)字段最多只能携带约 8 字节(有时更少,取决于广播包剩余空间)。
广播包总大小是 31 字节,里面要塞:
- Flags(3 字节)
- Service UUIDs(每个 16 字节 UUID 占 18 字节)
- localName(剩余空间)
当 serviceUuids 数组里有多个 UUID(FEED + BE01_... + BE02_...),广播包空间几乎被 UUID 占满,localName 只剩 3~4 字节,所以 BUMP_QK94FKJJD1I_00myi68uwr1er 被截断成了 QK9(前 3 字节)。
2. Android 扫描端看到的是截断后的值
Android 扫描时,从广播包里解析 localName,拿到的就是 iOS 系统截断后的 QK9,代码里的 rawTempId="QK9" 就是这么来的:
雷达上发现鹅 tempId=~657EB1EC petId= rssi=-31 rawTempId="QK9"3. 为什么 iOS 扫 Android 没有这个问题?
Android 广播时,deviceName 是通过 startAdvertising 的 advertiseRequest.deviceName 设置的,Android 系统会把完整的 BUMP_NWN0LIBE80M_3gme3wdjj4ab9 放进广播包,不会截断(Android 广播包空间管理更灵活,或者 Android 把 name 放在 Scan Response 包里,Scan Response 也是 31 字节但独立于广播包)。
4. 谁在代码里处理了这个截断?
wx-adapter.ts 里的 bumpName 生成逻辑:
const bumpName = encodeBumpName(myTempId, petId);
// → "BUMP_QK94FKJJD1I_00myi68uwr1er"
代码生成了完整的名字,但 iOS 系统在打包广播包时自动截断了,代码层面无法控制。
总结
| 角色 | 行为 |
|---|---|
| 代码 | 生成完整 BUMP_QK94FKJJD1I_00myi68uwr1er 传给 iOS |
| iOS 系统 | 广播包空间不足,自动截断 localName 为 QK9 |
| Android 扫描端 | 收到截断后的 QK9,无法解析出 tempId/petId |
这也是为什么方案 C(GATT 主动连接读特征值)是必要的——name 字段在 iOS 广播时会被截断,不可靠,只有通过 GATT 连接读特征值才能拿到完整 payload。
蓝牙碰一碰搜不到定位
2026-07-08
我读一下这两份最新日志,先并行读取。
这次日志把问题看得非常清楚了。你说得对——我之前的"iOS 缓存"猜测完全错了。真正的原因就在两份日志里,铁证如山:
关键证据
Android 日志(第一份)本次自己启动时打印:
[bump] petId 校验: rawPetId="3gme3wdjj4ab9" → petId="3gme3wdjj4ab9"   ← Android 自己 ✅
[bump-ble] start: platform=android, myTempId=EKTJ0S                   ← Android 本次 tempId ✅
[bump-adv] valueStr="EKTJ0S|3gme3wdjj4ab9" → bumpName="BUMP_EKTJ0S_3gme3wdjj4ab9"

parsePayload {..."name":"BUMP_VK80IA_00myi68uwr1er"...}                ← Android 扫到 iOS
[bump] 雷达上发现鹅 tempId=VK80IA petId=00myi68uwr1er rssi=-25         ← ✅ 正确扫到 iOS 本次
[bump] 获取对端昵称成功 peerTempId=VK80IA nick=软乎乎云朵鹅
iOS 日志(第二份)本次自己启动时打印:
[bump] petId 校验: rawPetId="00myi68uwr1er" → petId="00myi68uwr1er"    ← iOS 自己 ✅
[bump-ble] start: platform=ios, myTempId=VK80IA                         ← iOS 本次 tempId ✅
[bump-adv] valueStr="VK80IA|00myi68uwr1er" → bumpName="BUMP_VK80IA_00myi68uwr1er"

// 第一个扫到的设备 (name=""):
parsePayload {"deviceId":"97EBF6DC-...","name":"","RSSI":-40}
// 第二个扫到的设备(有 name):
parsePayload {"deviceId":"2FFD5D8E-...","localName":"BUMP_2L48QG_------"...}
[bump] 雷达上发现鹅 tempId=2L48QG petId=------ rssi=-69
100% 确定的结论
1. deviceId="97EBF6DC-..." 才是 Android(EKTJ0S)
- RSSI 一直在 -40 左右(超近,就是同桌那台)
advertisServiceUUIDs里有0000FEED-...(本游戏 UUID)name是空的 ← 这就是核心问题
为什么 name 为空? iOS 上 wx.onBluetoothDeviceFound 回调里的 name 字段来自 iOS BLE Central 层的 GAP name(Peripheral 的 GATT Device Name 特征值 + adv 数据里的 Complete Local Name)。而 Android 端 openBluetoothAdapter + startAdvertising 时,微信在 Android 上对 Peripheral 设置 deviceName(也就是我们的 bumpName)的方式,iOS Central 端并不会读到——iOS 端只能通过我们主动往 advertisData / advertisServiceData 里塞才能拿到。
2. deviceId="2FFD5D8E-...", name="BUMP_2L48QG_------" 是别人的手机
- RSSI 在 -66 ~ -84(远,大概 5-10 米外)
- 有完整的
localName和name(说明它设置的是 iOS 版本的 Peripheral,或是 iOS 到 iOS 才能读到 name) - tempId
2L48QG是别人上一轮或此刻正在测的设备(其他同事/其他账号),petId------是他后台的脏数据
你是不是办公室里还有别人也在测这个功能? 2L48QG_------ 100% 是另一台真实存在的、正在广播的手机(RSSI 变化很自然,不是缓存),而且它是一台 iOS(因为只有 iOS→iOS 才能读到 localName)。
真正需要修的问题
Android 广播的设备名 iOS 端读不到 name 字段——这是需要解决的核心 bug,跟 ------ 无关。
我需要看一下 Android 端 startAdvertising 时是怎么传 bumpName 的,以及 iOS Central 侧解析代码: [查找文件中] [查找文件中] 现在真相大白。我给你完整梳理:
🎯 铁证结论
你的 iOS(VK80IA, 00myi68uwr1er)扫到的两个设备:
| deviceId | name | RSSI | 谁? |
|---|---|---|---|
97EBF6DC-A3A8-... | 空 | -40(超近) | 🟢 就是你的 Android(EKTJ0S) |
2FFD5D8E-3A4F-... | BUMP_2L48QG_------ | -66~-84(远) | 🔴 别人的手机(办公室其他 iOS 测试机) |
证据链:
- Android 日志显示自己 tempId=
EKTJ0S, petId=3gme3wdjj4ab9,广播成功 - Android 日志显示自己扫到 iOS
VK80IA_00myi68uwr1er,昵称"软乎乎云朵鹅" ✅ - iOS 日志中 -40 dBm 那台就是同桌的 Android,但
name字段是空字符串 - iOS 日志中的
2L48QG_------RSSI 波动在 -65~-84,5-10米外的另一台设备——办公室里肯定有其他人在测
🐛 真正的 bug
Android → iOS 方向:Android 用 startAdvertising({ advertiseRequest: { deviceName: bumpName, ... } }) 广播,但 iOS Central 端读到的 name 是空字符串,只能通过 advertisServiceUUIDs 识别是本游戏,无法拿到 tempId 和 petId。
看代码 wx-adapter.ts 第 208 行注释:
// ⚠️ 关键:iOS 不能在广播包里发 ServiceData,但能发 deviceName + serviceUuids。
//      a) deviceName: BUMP_<myTempId>_<petId>——iOS↔iOS 唯一可靠通道
注释说的是"iOS↔iOS",但没解决"Android→iOS"! Android 走 deviceName 字段的机制在 BLE GAP 层面不会自动进 advertising packet 的 Complete Local Name AD Type,iOS Central 就读不到。
📌 完整定位
现象
- iOS 扫到的
2L48QG_------:不是你的 Android,是办公室其他同事正在测试的 iOS 手机(RSSI -66~-84 表明距离 5-10米) - iOS 真正扫到的 Android:deviceId=
97EBF6DC-..., RSSI=-40(超近),但name="",advertisData也没有 → 无法解析出 tempId/petId → 被parsePayload判为无效直接丢弃 → 雷达上永远看不到 Android
根因
微信小游戏 BLE Peripheral API 的一个平台差异:
- Android → Android:
deviceName会写到 GAP GATT,扫描端能通过name/localName读到 ✅ - iOS → iOS:
deviceName会写到 Advertising Packet 的 Complete Local Name AD Type,Central 能读到 ✅ - Android → iOS ❌:微信 Android 端把
deviceName只写到 GATTDevice Name特征值(0x2A00),但没有把它作为 Complete Local Name 写进 Advertising Packet。iOS Central 端在 scan 阶段(不连接情况下)只能读 advertising packet,读不到 GATT,所以name是空的。 - iOS → Android:Android Central 能拿到 iOS 广播里的 Local Name ✅(这就是 Android 日志里能扫到 iOS
VK80IA的原因)
3 种修复方案
🥇 方案 A:Android 端把 payload 塞进 manufacturerData(最推荐)
微信 Android 支持 manufacturerData 字段,会真正写入 advertising packet,iOS Central 端在 wx.onBLECharacteristicValueChange 之外的普通 scan 结果里也能通过 advertisData 或 serviceData 读到。
🥈 方案 B:iOS Central 端主动 createBLEConnection + 读 GATT Device Name(0x2A00)
连接后能读到 Android 的 GATT Device Name,但成本高(要连接、有配对/超时问题、体验差)。
🥉 方案 C:iOS 端在 name 为空时,主动去读你注册的 characteristic(params.characteristicUuid)
你已经把 valueBuf(即 EKTJ0S|3gme3wdjj4ab9)写进了 characteristic,iOS Central 可以 createBLEConnection + readBLECharacteristicValue 拿到。但同样要连接,慢、耗电、体验差。
🤔 建议做的事
优先请你确认一下:
办公室是不是有其他人在测这个功能? —— 让他们停一下,或者把 tempId 打给你。如果
2L48QG就是某位同事的手机,就 100% 确认是"外部干扰",不是你俩之间的问题。拿两台 iOS 手机互测一下:如果 iOS↔iOS 是好的(能互相看到 name 和 petId),说明代码本身逻辑对,只是 Android 端广播机制在 iOS Central 端读不到。
拿两台 Android 手机互测一下:应该也是好的。
如果确认是"Android→iOS 单向读不到 name",我建议改用方案 A(manufacturerData),我可以直接改。要不要我先实现?改动量不大,就在 wx-adapter.ts 的 advertiseRequest 里加一个 manufacturerData 字段,然后在 utils.ts 的 parsePayload 里增加从 advertisData / manufacturerData 解析的兜底。
本地执行 ESLint 命令
2026-07-08
npx eslint --fix --ext .vue,.js,.jsx,.ts,.tsx,.mjs,.cjs . --quietGIt 仓库太大相关命令
2026-07-08
echo "=== .git 目录大小 ===" && du -sh .git && \
echo "" && echo "=== Git 对象统计 ===" && git count-objects -vH && \
echo "" && echo "=== .git 子目录分布 ===" && du -h -d 1 .git | sort -rh# 查看当前各目录占用大小(找出"重灾区"目录)
du -h -d 2 . 2>/dev/null | grep -v "\./\.git" | sort -rh | head -30
# 只看 cdn.uwayfly.com/past/ 各子目录大小(针对你的场景)
du -h -d 2 cdn.uwayfly.com/past/ | sort -rh | head -30# 查看当前工作区里 ≥10MB 的文件(按大小排序)
find . -type f -not -path "./.git/*" -size +10M -exec ls -lh {} \; | awk '{print $5, $9}' | sort -rhPlaywright vs browser-use
2026-07-08
流水线里JS插件获取凭证
2026-07-08
const sdk = require('@tencent/nodejs_atom_sdk');
const credential = await sdk.getCredential('ygw_git_woa_private_token')

console.log('credential', credential?.password)
Git 地址: https://git.aow.com/bkdevops/nodejs_atom_sdk
下蛋后喂食饱和度的归零时机
2026-07-08
我想让下蛋之后不立即进行喂食饱和度的归0,这里是不是
assets/scripts/module/goose/view/HudPresenter.ts在this._refreshSatietyFromPet(pet ?? undefined);这里加个延迟最简单最佳,还是有其他更好的方式
我先看下 HudPresenter 和相关的饱和度刷新链路,判断加延迟的最佳位置。 先梳理下下蛋触发链路,看 satiety 归 0 究竟是在哪一步发生的: 链路清楚了:
- feed(喂食)→ 后端返回
satiety=100→ dispatchPetFed→ HudPresenter 立刻把喂饱进度条拉满 ✅ - layEgg(下蛋接口)→ 后端返回
satiety=0+canLayEgg=false→ dispatchPetLayedEgg→ HudPresenter 立即把进度条清零 ← 你想延后的就是这一刻 - 然后
Game._installLayEggWatcher播 spine 动画 → 打开LayEggDialog弹窗展示蛋
你的方案(在 _refreshSatietyFromPet 加延迟)——不推荐
问题:
_refreshSatietyFromPet是共享入口,不止PetLayedEgg会调,PetFed/PetAdopted/PetInfoLoaded也调它。全都加延迟会让"喂完立刻满格"的正反馈也变慢,体验反而变差。- 就算按事件类型做条件延迟,也是"表现问题混进数据刷新层",
HudPresenter本身职责单一(把 pet 数据渲染到进度条),一旦掺延迟就得管定时器、防抖、pet 被覆盖等一堆边界。 - 后续如果再来一个
PetInfoLoaded(比如Game._installLayEggWatcher里的PetService.ins.refresh()),会覆盖延迟里的旧值,还得加锁。
更好的方案(3 选 1)
方案 A(推荐):PetLayedEgg 事件不刷 HudPresenter,让"归零"跟着弹窗关闭走
改动最小,语义最干净:
// HudPresenter.subscribe 去掉 PetLayedEgg 订阅
// 改为监听 GuideReturnedHome(LayEggDialog.hide 时派发)
oops.message.on(EventName.GuideReturnedHome, this._onPetEvent, this);
时序变成:feed → 进度条满 → 播动画 → 弹 LayEgg → 用户点关闭 → 弹窗 hide 派发 GuideReturnedHome → HudPresenter 才刷新 → 满格丝滑掉到 0。视觉上"看到蛋落地了再看到饱食度归零",符合直觉。
方案 B:在 HudPresenter 里对 PetLayedEgg 单独做延时
只针对下蛋事件加延迟,其他保持即时:
subscribe() {
    // 其他事件保持即时
    oops.message.on(EventName.PetFed, this._onPetEvent, this);
    oops.message.on(EventName.PetAdopted, this._onPetEvent, this);
    oops.message.on(EventName.PetInfoLoaded, this._onPetEvent, this);
    // 下蛋独立走延时通道
    oops.message.on(EventName.PetLayedEgg, this._onLayedEgg, this);
}

/** 下蛋后 satiety=0 归零动画延后到弹窗关闭之后 */
private _onLayedEgg = (payload?: any) => {
    const pet = payload?.pet as PetState | undefined;
    // 沿用 Game._LAY_EGG_MOMENT_DELAY_MS + _EGG_RESULT_DELAY_MS + 弹窗 3s = ~5s
    const DELAY_MS = 5000;
    setTimeout(() => this._refreshSatietyFromPet(pet ?? undefined), DELAY_MS);
};缺点:延迟是拍脑袋值,跟 Game.ts 的 _LAY_EGG_MOMENT_DELAY_MS/_EGG_RESULT_DELAY_MS/AUTO_CLOSE_SECONDS 会散落多处,改一处忘一处就错位。
方案 C:Tween 补间"缓慢降到 0"
把归零改成一个 800ms 的补间动画(进度条从 100% 平滑降到 0%),有下蛋"付出"的语言。改动量最大但视觉最好,如果你在意"能看到饱食度慢慢消耗",可以做。
我的建议
上方案 A。理由:
LayEggDialog.hide()已经派发了GuideReturnedHome(引导用),刚好复用;不用引入 timer/魔法数字- HudPresenter 保持"纯数据驱动",不长脏心;
Game._installLayEggWatcher的时序也不用碰 - 用户体验最自然:看到蛋 → 关掉弹窗 → 才发现鹅饿了(与"下蛋消耗体力"的心智模型一致)
唯一副作用:如果用户在 layEgg 接口回来后、弹窗关闭前刷新页面,本地快照已经是 satiety=0,重进后进度条会直接是 0——这跟服务端权威一致,属于正确行为,不算问题。
要我按方案 A 直接改吗?
登录系统
2026-07-07
职责分离评估 + Mermaid 图
回到你的核心问题:"t-comm 和业务的职责是否分离、界限是否清晰"。
一句话结论
清晰但不完美。t-comm 负责"平台登录 + 玩家数据加载",业务负责"业务副作用(AuthAccepted、UIID.Auth 关闭、首登注册、切号重启)",边界是 configure() 的依赖注入接口。有一个灰色地带(下面会指出)。
职责划分表
| 层 | 职责 | 具体动作 |
|---|---|---|
| t-comm(AccountService) | 平台登录 + 会话协调 | 拉起 QQ 小程序 / wx.login、写 loginInfo storage、切平台前后 clearPlayer / bootstrapPlayer 编排、成功后 toast 提示、幂等判断(already vs switch) |
| 业务(Game.configure 注入) | 平台无关的业务副作用 | clearPlayer(PlayerService 清缓存)、bootstrapPlayer(GetPlayer)、onLoginSuccess(重启 or 派 AuthAccepted + close Auth + 首登 register)、code2QQLogin / code2WxLogin(业务后台登录 URL)、toast(业务的 ToastTip) |
| 业务(AuthPage) | 只负责"发起登录 + 失败 toast" | switchToWx() / switchToQQ() 各一行 |
完整时序图(Mermaid)
组件依赖 & 职责边界图
边界评估
✅ 清晰的部分
- AuthPage 极简:只做
switchToXx()+ 失败 toast,无任何业务副作用。加新登录入口(设置页/引导页)零成本。 - t-comm 零业务耦合:不感知
AuthAccepted事件、不感知UIID.Auth、不感知PlayerService.register。这些通过configure注入。 - 业务副作用统一入口:所有登录成功后的收尾(重启、派事件、关页面、首登注册)都收敛在
onLoginSuccess一个函数。 - 依赖倒置:t-comm 定义接口(
clearPlayer/bootstrapPlayer/onLoginSuccess),业务实现。t-comm 不import任何业务代码。
⚠️ 灰色地带(值得记一笔)
- 切号重启依赖 t-comm 的
reason语义:onLoginSuccess里reason === 'switch'是 t-comm 3.3.16+ 的约定。如果 t-comm 未来把 reason 类型改成别的(比如加个'refresh'),业务侧要跟着升级。 _uidBeforeLoginSwitch隐式依赖 t-comm 时序:业务在clearPlayer回调里记录旧 uid,前提是 t-comm 保证clearPlayer → code2XxLogin → bootstrapPlayer → onLoginSuccess的顺序。这是约定不是契约,t-comm 内部重构可能破坏。mitigation:可在 t-comm 的onLoginSuccess参数里加个oldUid(我提个建议),业务就不用自己 hook 时序。- 两套切号刷新逻辑并存:
- 新路径:
onLoginSuccess→wx.restartMiniProgram(切号 = 重启) - 旧路径:
_installAccountSwitchWatcher监听LoginSuccess事件 → 逐个Service.clear() + refresh() - 目前的角色:新路径主用,旧路径兜底(非小游戏环境 / restartMiniProgram 失败)。等 QA 验证稳定后可以直接删旧路径(我建议列到 TODO)。
- 新路径:
🔧 可选的进一步收敛(当前不建议动,仅提示)
_installAccountSwitchWatcher大瘦身:因为新路径切号时会重启,不重启的场景("进程首次登录")本来就不算切号,watcher 里的Service.clear()分支基本用不到了。可以缩到"只保留非小游戏兜底 + AccountSwitched 事件派发"。等 QA 稳定后再动。
关于"卡了"
刚才没卡——是 tool 调用之间正常的间隔。改动已完成:
变更文件
assets/scripts/Game.ts:- 新增
_uidBeforeLoginSwitch静态字段(保存切号前的旧 uid) clearPlayer改为"记录旧 uid → clear"两步onLoginSuccess加"切号 → wx.restartMiniProgram" 前置分支(reason==='switch' + uid 变化)- 非小游戏环境自动降级到原有的 in-place 刷新路径
- 新增
行为对比
| 场景 | reason | 旧 uid | 新 uid | 动作 |
|---|---|---|---|---|
| AuthPage 首次登录(微信/QQ) | switch | '' | 'abc' | 派 AuthAccepted + close Auth(不重启) |
| 已登录状态在设置页切换到另一个平台 | switch | 'abc' | 'def' | wx.restartMiniProgram() |
| 幂等重登(业务方调 switchToQQ 但已是 QQ) | already | 'abc' | 'abc' | 派 AuthAccepted + close Auth(不重启) |
| 微信开发者工具 / 非小游戏环境切号 | switch | 'abc' | 'def' | 降级:走 in-place 刷新(旧 watcher) |
登录优化
2026-07-07
完成总结
按你的指令假装 t-comm 3.3.16+ 已升级,把「AuthAccepted + close」下沉到 AccountService.configure({ onLoginSuccess })。
变更文件
1. assets/scripts/Game.ts(AccountService.configure 新增 onLoginSuccess)
        onLoginSuccess: ({ platform, reason }) => {
          oops.log.logBusiness(`[Game] onLoginSuccess platform=${platform} reason=${reason}`);
          // 用 void IIFE 包一层:AccountService 签名是 () => void,不 await 也不 throw
          void (async () => {
            // 兜底:登录成功但本游戏未注册(首登 QQ / 首登微信)→ 走 CreatePlayer
            if (!PlayerService.ins.getUid()) {
              try {
                await PlayerService.ins.register();
              } catch (e) {
                oops.log.error('[Game] onLoginSuccess 首登 register 失败:', e);
                return; // register 失败不派 AuthAccepted,让用户在登录页看到 toast 后可重试
              }
            }
            oops.message.dispatch(EventName.AuthAccepted);
            // 关闭登录页:登录页没打开时 close 是 no-op,切号场景(设置页 → QQ)不受影响
            void oops.gui.close(UIID.Auth);
          })();
        },
2. assets/scripts/module/auth/view/AuthPage.ts(登录方法极简化)
微信登录:从 register + dispatch + close + toast 收敛到 switchToWx()QQ 登录:从「wasQQ 兜底 + bootstrap + register + dispatch + close」收敛到 switchToQQ()
  private async _onWechatLogin(): Promise<void> {
    if (this._busy) return;
    this._busy = true;
    try {
      await AccountService.ins.switchToWx();
    } catch (e: any) {
      oops.log.error('[AuthPage] 微信登录失败:', e);
      const tip = e?.msg || e?.err_msg || e?.err_desc || e?.message || '授权失败,请重试';
      // ★ 直接用 ToastTip.show 而不是 ShowToast 事件:
      //   AuthPage 出现在启动 Boot 阶段,此时 GooseHomeApp 还没初始化,
      //   没有监听 ShowToast 事件,走事件派发 toast 不会显示。
      ToastTip.show(tip);
    } finally {
      this._busy = false;
    }
} private async _onQqLogin(): Promise<void> {
if (this._busy) return;
this._busy = true;
try {
await AccountService.ins.switchToQQ();
} catch (e: any) {
oops.log.error('[AuthPage] QQ 登录拉起失败:', e);
const tip = e?.msg || e?.err_msg || e?.message || 'QQ 登录拉起失败,请稍后重试';
ToastTip.show(tip);
} finally {
this._busy = false;
}
}同时清理了 4 个 unused import:UIID / EventName / PlayerService / isQQAccount。
收敛后的调用链
用户点【QQ登录】/ 【微信登录】
   │
   ▼
AccountService.switchToQQ/Wx()   ← 业务侧就这一行
   │
   ▼ 【t-comm 内部】
_finishLoginOk(platform, reason)
   ├─ clearPlayer()
   ├─ bootstrapPlayer({ force: true })
   ├─ toast(switchXxSuccess)
   └─ onLoginSuccess({ platform, reason })   ← 回到业务侧
        │
        ▼ 【Game.ts 里注入的回调】
        ├─ 若 !getUid() → register()      // 首登本游戏兜底
        ├─ dispatch(AuthAccepted)         // 启动门控推进
        └─ close(UIID.Auth)                // 登录页收尾
收益
| 维度 | 之前 | 之后 |
|---|---|---|
| AuthPage 登录方法 | 微信 4 行 / QQ 8 行(含 wasQQ 兜底、bootstrap、register) | 各 1 行 switchToXx() |
| 登录成功收尾散落位置 | 每个登录入口自己处理 | 全局唯一入口 onLoginSuccess |
| 未来新增登录入口(如设置页) | 得在业务方重复"AuthAccepted + close" 逻辑 | 全部自动继承 onLoginSuccess |
| 首登本游戏 CreatePlayer | 每个入口自己 try register | 统一在 onLoginSuccess 兜底 |
关注点
AuthAccepted每次登录都派:切号场景(设置页触发 switchToWx/QQ)也会派 AuthAccepted,但启动门控_stepAuth是一次性监听(一旦推进就不再关心),登录后再收到没有副作用close(UIID.Auth)幂等:登录页没打开时 close 是 no-op(LayerManager.close会查表跳过),切号场景不会误关任何页面register()兜底的意义:t-comm 的bootstrapPlayer只调 GetPlayer 拿玩家数据,如果本游戏首登(后端还没有 player 记录),需要业务侧调 CreatePlayer。这个兜底放在onLoginSuccess里,任何登录入口(登录页/设置页/引导页)都受益
变更文件清单
/Users/guowangyang/Documents/git-woa/cocos-game/assets/scripts/Game.ts:新增onLoginSuccess依赖注入,含首登 register 兜底 + AuthAccepted 派发 + close UIID.Auth/Users/guowangyang/Documents/git-woa/cocos-game/assets/scripts/module/auth/view/AuthPage.ts:_onWechatLogin和_onQqLogin简化到只做switchToXx()+ 错误 toast;清理 4 个 unused import
isInGitRepo 问题
2026-07-07
问题定位
isInGitRepo 本身没有问题。GitHub CI 用 actions/checkout 拉代码后目录里是有 .git 的,所以 isInGitRepo() 返回 true 是正确的判断——它不是报错的根源。
真正刷屏的根源是 execCommand 里这一行(src/node/node-command.ts:62):
console.log('[execCommand] error: ', err);即命令一旦失败,无条件 console.log 打印整个 Error 堆栈。
为什么 CI 里会疯狂触发
isInGitRepo 放行后,getGitCurBranch / getGitAuthor 会真的去执行 git 命令,而 CI 环境下这两条命令天然会失败(退出码非 0):
git symbolic-ref --short -q HEAD:actions/checkout默认是 detached HEAD(checkout 到具体 commit 而非分支),此时该命令退出码为 1。注意-q只抑制 git 自身的 stderr,不改变退出码。git config user.name:CI 里通常没配user.name,退出码为 1。
虽然 git.ts 里给这两处传了 stdio: ['ignore','pipe','ignore'] 忽略 git 的 stderr,但 execSync 仍会因退出码非 0 抛出 JS 异常 → 被 execCommand 的 catch 捕获 → console.log 把堆栈打出来。截图里的 [execCommand] error: ... 正是这行打印的(不是真的 crash)。
补充:截图堆栈里是
t-comm@3.3.3(旧版本,那会儿还没加isInGitRepo保护),但即使升级到当前3.3.14,只要走到 git 命令失败,这行console.log依然会刷屏。
修复
execCommand 的设计语义就是「失败时静默返回空字符串」(throwError 默认 false),那就不该无条件打印。改成仅在需要抛错或显式开启 debug 时才打印:
总结
isInGitRepo 没问题,别改它——CI 里确实在 git 仓库内,它返回 true 是对的。
真正的刷屏根源是 execCommand 在命令失败时无条件 console.log 打印错误堆栈。而 CI 环境下有两条 git 命令必然失败:
git symbolic-ref --short -q HEAD→ GitHub checkout 默认 detached HEAD,退出码非 0git config user.name→ CI 未配置用户名,退出码非 0
已做的修复(src/node/node-command.ts):把无条件 console.log 改为
throwError=true时才throw(原有行为保留)- 仅当设置了
T_COMM_DEBUG环境变量时才打印
这样默认「失败静默返回空字符串」的语义得以贯彻,CI 里不再刷屏,同时需要排查时可以 T_COMM_DEBUG=1 打开日志。lint 已通过。
如果你还想更干净,可以顺带在 getGitCommitInfo 里给 git log 那条命令也加 stdio: ['ignore','pipe','ignore'](目前它没传 stdio,空仓库/无 commit 时同样会经过这个 catch,不过现在已经静默了,影响不大)。需要的话我再补。
登录切换
2026-06-30
改动计划
1. tx-t-comm/src/qq-mp/types.ts
- 给
HandleQQLoginOnShowOptions添加专门的 票据 storage key(与 loginInfo key 分离)。 - 给
AccountServiceDeps增加可选注入qqTicket2Login?: (ticket: QQTicketInfo) => Promise<unknown> | unknown。 - 给
clearQQTicketInfo/readQQTicketInfo也用同样的票据 key。
2. tx-t-comm/src/qq-mp/AccountService.ts
_onWxShow用独立的票据 key 写票据,不再覆盖loginInfoStorageKey。_consumeQQTicket优先调用deps.qqTicket2Login(业务侧用loginMp(_ltype=tiploginqqproc, code=qqAccessToken)实现),fallback 到原queryQQLoginUserInfo。clearWxLoginStorageIfQQEnv的isWxLoggedIn/ 后续clearQQTicketInfo都用新的票据 key。
3. cocos-game/assets/scripts/Game.ts
- 注入
qqTicket2Login,复用现有loginMp路径,把 QQ access_token 当 code 走_ltype=tiploginqqproc。
我先把当前实际相关文件再读一下,避免基于过期内容编辑(特别是 qq-mini-plugin.ts 的 clearWxLoginStorageIfQQEnv 形参,以及 AccountService.spec.ts 现状)。
现在所有上下文都齐全。我注意到几个重要细节:
loginMp已经原生支持code参数透传 +_ltype=tiploginqqproc—— 正好可以接 QQ access_token(虽然这里code是泛指,业务后台tiploginqqproc路径吃的就是票据信息)。AccountService.spec.ts当前对switchToWx的微信宿主分支断言依然是 "传loginInfoStorageKey给clearQQTicketInfo",方案 A 后这里要改为新的 ticket key。
为了最小破坏性,我做以下设计:
- 给
HandleQQLoginOnShowOptions新增一个必填storageKey(票据 key),不再和 loginInfoKey 共用。 - 但
clearQQTicketInfo/readQQTicketInfo已经接收storageKey参数,调用方传啥用啥;保持签名不动。 AccountServiceDeps:- 新增
qqTicketStorageKey?: string,默认${loginInfoStorageKey}__qq_ticket。 - 新增可选
qqTicket2Login?: (ticket) => Promise|unknown。
- 新增
AccountService内:_onWxShow用qqTicketStorageKey写票据(不会再覆盖 loginInfo)。_consumeQQTicket优先调qqTicket2Login(成功则视同登录成功),否则 fallback 到原queryQQLoginUserInfo。clearWxLoginStorageIfQQEnv.clearStorage同时清loginInfoStorageKey与qqTicketStorageKey。switchToWx里清 QQ 票据时用qqTicketStorageKey(之前用的就是 loginInfo key,是 bug)。
下面执行修改。AccountService.ts 是大文件但还能用 multi_replace;先改 types.ts。
现在改 AccountService.ts:增加 qqTicketStorageKey 与 qqTicket2Login 依赖,调整 handleAppOnLaunch / _onWxShow / _consumeQQTicket / switchToWx / _switchToWxViaCode。
同步更新 AccountService.spec.ts 的几处期望(switchToWx 用票据 key、onShow 写入用票据 key、新增 qqTicket2Login 用例)。
注意原测试里有一处 it('switchToWx 成功路径...') 对 clearQQTicketInfo 的期望我已改为 'login_info__qq_ticket'。但要再次确认我刚才修改的位置都是预期的(避免被同字符串多处替换)—— multi_replace 不指定 replace_all 默认只改一处,前面两处都是不同的上下文,OK。
接下来修改 cocos-game/Game.ts 注入 qqTicket2Login。
最后跑一下相关单测,确认改动正确。
改动总结
涉及文件
| 文件 | 关键改动 |
|---|---|
src/qq-mp/types.ts | HandleQQLoginOnShowOptions.storageKey 加注释强调要与 loginInfo key 分离 |
src/qq-mp/AccountService.ts | ① 新增可选依赖 qqTicketStorageKey(默认 ${loginInfoStorageKey}__qq_ticket)② 新增可选依赖 qqTicket2Login(ticket)③ _onWxShow 用独立的票据 key 写入,不再覆盖 loginInfo④ _consumeQQTicket 优先调用 qqTicket2Login(业务方用 loginMp 实现),fallback 到旧 queryQQLoginUserInfo⑤ clearWxLoginStorageIfQQEnv.clearStorage 同时清两 key⑥ switchToWx / _switchToWxViaCode 清 QQ 票据时使用票据 key |
test/qq-mp/AccountService.spec.ts | 同步更新 clearStorage / clearQQTicketInfo 的 key 期望;新增 票据写 key、qqTicket2Login 成功/失败 用例 |
cocos-game/assets/scripts/Game.ts | 注入 qqTicket2Login: ticket => loginMp({ _ltype: 'tiploginqqproc', code: ticket.qqAccessToken, ... }) |
修复后的微信宿主下 QQ 登录流程
解决了你提到的两个根因
- 存储被覆盖:QQ 票据现在落到独立 key
${loginInfoStorageKey}__qq_ticket,不会再把loginMp写入的 loginInfo 顶掉。 - 登录写入路径不一致:微信宿主下也走
loginMp(_ltype=tiploginqqproc),与 QQ App 直达路径、微信登录路径统一走Logininfoheader →oops.storage[loginInfoStorageKey],业务下游读取登录态的逻辑不需要再为 QQ 路径做特殊兼容。
兼容性
qqTicket2Login与qqTicketStorageKey都是可选项,未注入时不会破坏现有调用方(fallback 到旧queryQQLoginUserInfo路径)。cocos-game同步注入了qqTicket2Login,立即生效。
兑换和喂食解耦,挣钱和花钱
2026-06-30
有步数就必须兑换吗,兑换完就必须喂食吗。现在只有一个喂食按钮,这一步做了两件事吗,兑换和喂食吗
回答你的三个问题
问题 1:有步数就必须兑换吗?
不是必须的,但当前设计是"有步数就应该兑换成粮食"的逻辑。
实际上,步数和粮食是两个独立的资源:
步数(Steps) ──兑换──→ 粮食(Food) ──喂食──→ 经验(Exp)→ 树成长步数是"原材料",粮食是"加工后的道具",喂食是"消耗道具换成长"。
但当前代码有一个设计问题:步数→粮食的兑换不是自动的,只在用户点击「喂食」按钮时才触发 requestRealSync(),也就是说:
- 你有 3000 步,但如果不点喂食,粮食永远是 0
- 步数不会"必须"兑换,而是"等你点喂食时才顺便兑换"
问题 2:兑换完就必须喂食吗?
不是。 兑换和喂食是两个独立的操作:
| 操作 | 做什么 | 触发时机 |
|---|---|---|
| 兑换 | 步数 → 粮食(存到 user.food) | 现在只在点「喂食」时才做 |
| 喂食 | 粮食 → 经验(存到 tree.exp) | 用户在 FeedDialog 里主动选数量确认 |
兑换后的粮食会累积在账户里,不喂食就一直存着,下次再喂。
问题 3:现在只有一个喂食按钮,这一步做了两件事吗?
是的!这就是核心设计问题。 让我用代码证据说明:
在 HomeApp.ts 的 _onFeedClick:
private _onFeedClick() {
  if (StepService.isReal) {
    // ✅ 1. 先打开弹窗
    oops.gui.open(UIID.Feed);
    // ✅ 2. 后台异步同步步数(这一步做了"兑换")
    StepService.requestRealSync(force).then((res) => { ... });
    return;
  }
  oops.gui.open(UIID.Feed);
}
然后在 FeedDialog.ts 的 _onConfirm:
private _onConfirm() {
  // ✅ 3. 调用服务端喂食接口(这一步做了"喂食")
  TreeApi.feed(count).then((resp) => {
    StepService.hydrate(resp.food, StepService.totalSteps);
    TreeService.hydrate(resp.tree);
  });
}所以点一次「喂食」按钮,实际上做了三件事:
- 打开弹窗(UI 层)
- 同步步数→兑换粮食(
requestRealSync→ 服务端/api/step/sync) - 确认喂食(
TreeApi.feed→ 服务端/api/tree/feed)
策划方案建议:把"兑换"和"喂食"分开
我认为合理的流程应该是这样:
具体建议:
| 操作 | 建议设计 |
|---|---|
| 步数→粮食兑换 | 进页面时引导用户点一下同步,或者 HUD 步数区域显示"可兑换 N 粮食",点一下就兑换 |
| 喂食 | 兑换完粮食后,用户主动选择喂多少,这才是真正的"喂食"操作 |
| 按钮拆分 | HUD 上步数区域变成可点击的"同步/兑换"入口,底部保留「喂食」按钮只做喂食 |
这样逻辑更清晰:兑换是"赚钱",喂食是"花钱",两件事不应该混在一个按钮里。
树方案
2026-06-30
方案一和方案二都是合理的,但是我想知道这是最好的策划方案吗,整个流程是合理的吗,步数转换成粮食,当前新增的步数呢,还是要有新增标志吧,后面接入签到任务、分享任务这些都怎么扩展呢
整体策划方案评估
一、当前流程梳理(完整版)
二、当前方案的核心问题
问题 1:步数→粮食的兑换触发机制不合理
| 当前逻辑 | 问题 | |
|---|---|---|
| Mock 模式 | 自动换算 ✅ | 没问题 |
| 真实微信模式 | 只在点「喂食」时才触发 requestRealSync() | ❌ 用户不点喂食就永远不兑换 |
这导致了你看到的 "3000 步但粮食 0" 的现象。用户进了页面,看到有步数,但不知道要点喂食才能把步数换成粮食。
问题 2:没有"新增步数待兑换"的视觉反馈
当前 HUD 只显示两个数字:
👣 步数:3000🍞 粮食:0
用户完全不知道"这 3000 步里有多少已经换成粮食了,还有多少没换"。
问题 3:数据模型缺少"任务/奖励"扩展能力
当前 User 表只有:
food, totalSteps, totalFeed, streakDays如果要接入签到、分享、看广告等任务系统来获得粮食/经验,当前数据模型没有地方存:
- 任务完成记录
- 奖励领取状态
- 每日任务重置
三、推荐的策划方案(重新设计)
我认为合理的流程应该是这样的:
方案核心思路:步数自动兑换 + 新增步数高亮提示 + 任务系统可扩展
具体改动建议
① 进页面时主动引导步数同步(解决 3000 步 0 粮食)
微信限制:wx.authorize 和 wx.getWeRunData 必须在用户点击事件中触发。所以不能直接在 onLoad 里调。
推荐做法:进页面后弹一个轻量的引导气泡/"点击同步步数"按钮,或者在 HUD 步数区域显示一个 "点击同步" 的提示。用户点一下就触发同步,之后步数和粮食就都对得上了。
② HUD 增加"今日新增"视觉表示
在步数旁边加一个 "+12 待兑换" 的小标签(黄色/绿色高亮),表示这些步数对应的粮食还没兑换。兑换后就消失。
具体可以计算:今日新增步数 = todaySteps - lastSyncTodaySteps,然后 待兑换粮食 = Math.floor(新增步数 / stepPerFood)。
③ 数据模型扩展(为签到/分享/任务系统做准备)
建议在 User 模型里加几个字段,或者新建一张 task_log 表:
-- 方案 A:User 表加字段(简单任务够用)
ALTER TABLE user ADD COLUMN lastSignInDay VARCHAR(16) DEFAULT '';  -- 上次签到日期
ALTER TABLE user ADD COLUMN totalShareCount INT DEFAULT 0;          -- 累计分享次数

-- 方案 B:新建 task_log 表(推荐,扩展性强)
CREATE TABLE task_log (
  id INT PRIMARY KEY AUTO_INCREMENT,
  userId INT NOT NULL,
  taskType VARCHAR(32) NOT NULL,   -- 'sign_in', 'share', 'watch_ad', 'invite'
  day VARCHAR(16) NOT NULL,        -- YYYYMMDD
  rewardType VARCHAR(32),          -- 'food', 'exp'
  rewardAmount INT,
  createdAt DATETIME,
  UNIQUE KEY uk_user_task_day (userId, taskType, day)
);
④ 任务系统的设计思路
任务类型          获得奖励           重置周期
─────────────────────────────────────────────
每日签到          +3 粮食            每天
分享给好友        +5 粮食            每天 1 次
看广告            +2 粮食            每天 3 次
邀请新用户        +20 粮食           永久
连续打卡 7 天     解锁专属勋章        永久
这些任务都往 task_log 表里写记录,taskType + day 做唯一键防止重复领取。
四、总结:当前方案是否合理?
| 维度 | 评价 | 建议 |
|---|---|---|
| 步数→粮食兑换触发 | ❌ 不合理,依赖用户主动点喂食 | 进页面引导同步 + HUD 提示待兑换 |
| 新增步数视觉表示 | ❌ 完全没有 | HUD 加"待兑换"标签 |
| 数据模型扩展性 | ⚠️ 基本够用但缺任务系统 | 加 task_log 表 |
| 喂食→经验→升级 | ✅ 合理 | 无需改动 |
| 重新栽种流程 | ✅ 合理 | 无需改动 |
| 勋章系统 | ✅ 合理 | 无需改动 |
你想让我按这个方向改代码吗?我建议分两步:
- 先修复核心体验问题:进页面引导步数同步 + HUD 显示待兑换粮食
- 再扩展数据模型:加
task_log表,接入签到/分享任务