Java 基础
1. 什么是 Java 的多态特性?
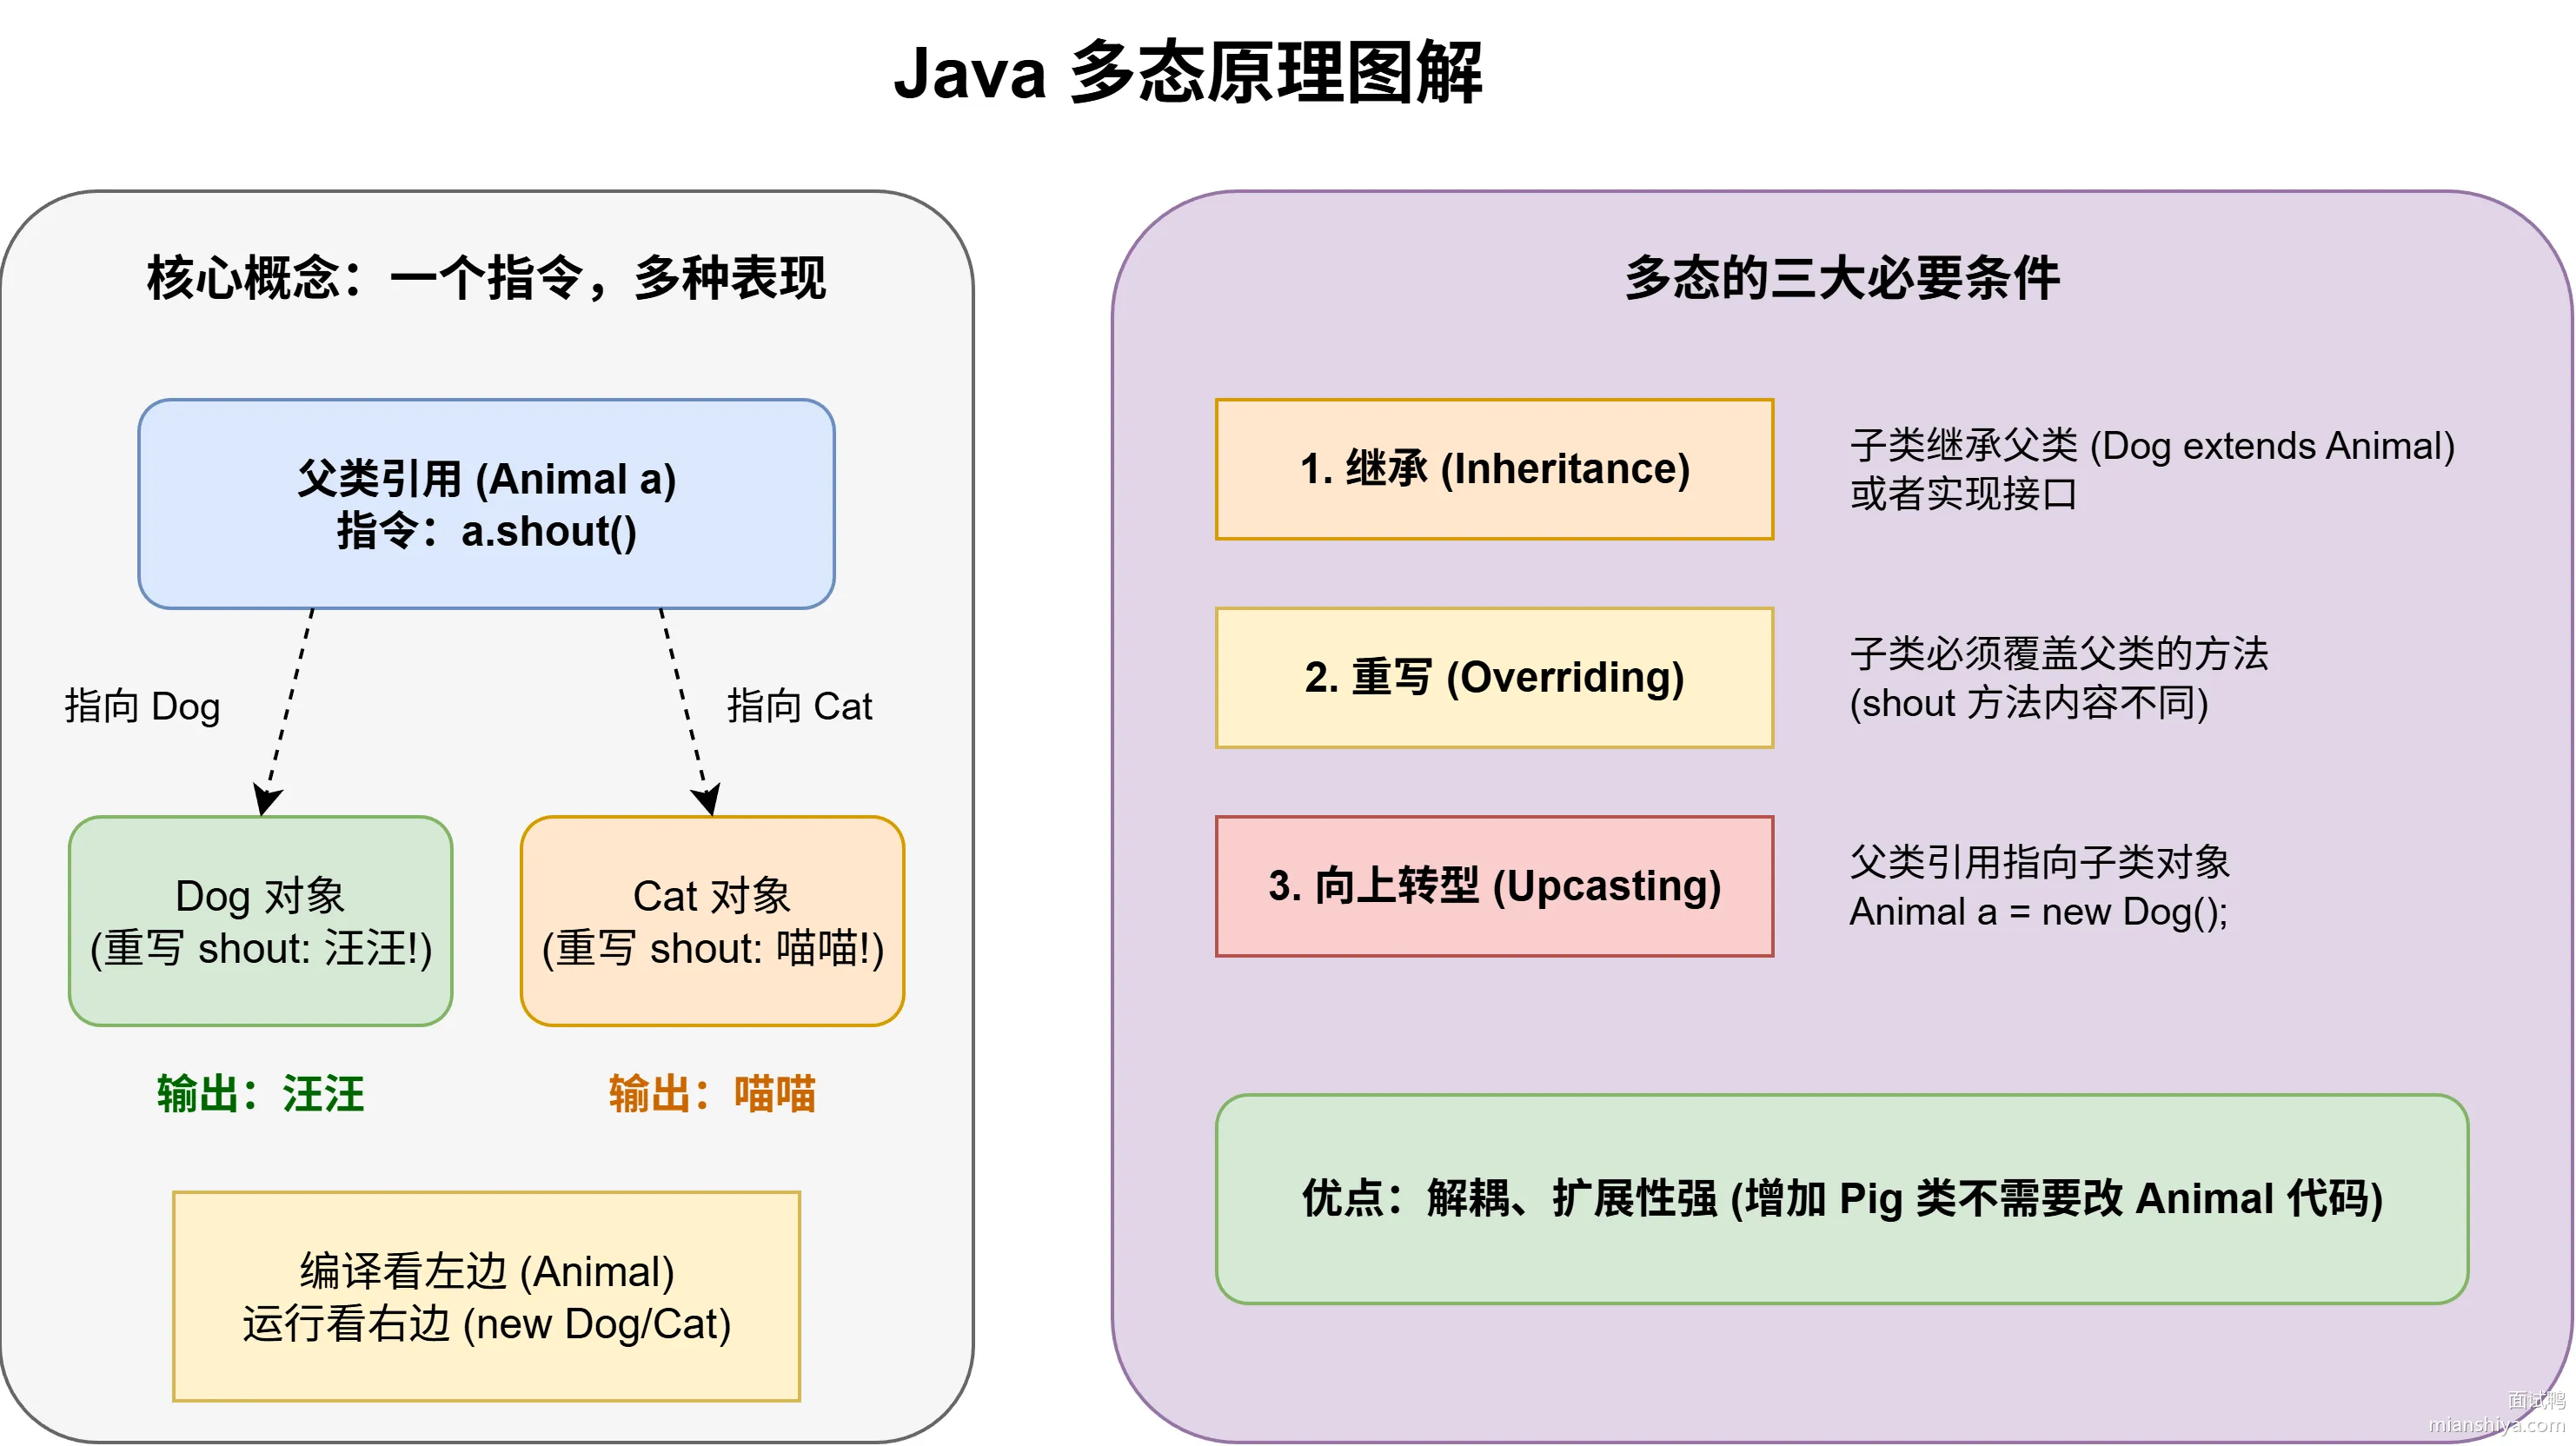
简单说就一句话:父类引用指向子类对象,调用同一个方法时,会执行子类自己的实现。
八个字总结:一个指令,多种表现。
Animal dog = new Dog();     // 父类引用指向子类对象
Animal cat = new Cat();
dog.shout();   // 输出:汪汪   → 运行时才知道调用 Dog 的 shout()
cat.shout();   // 输出:喵喵   → 运行时才知道调用 Cat 的 shout()
底层原理一句话记住:编译看左边 Animal,运行看右边实际对象类型,底层是通过虚方法表 vtable 动态绑定找到真正要执行的方法。
多态的三个必要条件:
1)要有继承或实现关系,子类继承父类或类实现接口 2)子类要重写 override 父类的方法 3)父类引用指向子类对象,也叫向上转型
多态的作用:
1)解耦:调用方只依赖抽象父类或接口,不依赖具体实现 2)可扩展:新增一个子类,完全不需要改原有代码
比如上面的示例代码,如果以后加了个猪,只需要写个 Pig 类继承 Animal 就行了,原来的代码一行都不用改,直接就能兼容。这就叫对扩展开放,对修改关闭。
1.1. 编译时多态 vs 运行时多态
重载是编译时多态,也叫静态绑定。编译器在编译阶段就根据参数列表确定调用哪个方法。
重写是运行时多态,也叫动态绑定。编译时只知道是父类类型,运行时根据实际对象类型去调用对应的方法。这也是面向对象多态特性的核心实现机制。
1.2. 常见问题
1.2.1. 重写的时候,子类方法可以抛出和父类不同的异常吗?具体有什么限制?
回答:可以,但有限制。如果父类方法声明了 throws 某个异常,子类可以不抛出任何异常,也可以抛出父类异常的子类,但不能抛出比父类更宽泛的异常或者新的受检异常。比如父类抛 IOException,子类可以抛 FileNotFoundException,因为它是 IOException 的子类;但不能抛 Exception,因为它比 IOException 更宽泛。RuntimeException 不受这个限制,随便抛。
1.2.2. 为什么静态方法不能被重写?
回答:因为重写是运行时多态的体现,依赖于对象实例。静态方法属于类,不属于实例,调用的时候是根据引用类型来决定调用哪个方法,不是根据实际对象类型。子类定义同名静态方法只是把父类的方法隐藏了,不是重写。你用父类引用调用,还是调父类的静态方法;用子类引用调用,才调子类的。
1.2.3. 能举个实际开发中重载和重写配合使用的例子吗?
回答:比如日志框架 SLF4J 的 Logger 接口。info、debug、error 这些方法都重载了多个版本,可以传一个参数、两个参数、带异常参数等,这是重载。同时不同的日志实现比如 Logback、Log4j2 都实现了这个接口,提供自己的具体实现,这是重写。业务代码只依赖 Logger 接口,运行时根据配置注入不同的实现,这就是重载和重写配合使用的典型场景。
1.2.4. 方法重载时,如果传入 null 会调用哪个方法?
回答:编译器会选择最具体的那个方法。比如有 print(Object obj) 和 print(String str) 两个重载方法,传 null 会调用 print(String str),因为 String 比 Object 更具体。但如果有 print(String str) 和 print(Integer num) 两个,传 null 就会编译报错,因为两个类型是平级的,编译器无法决定调用哪个,必须强转明确类型。
1.2.5. 重载和重写的核心区别是什么?
详细解答可以看:Java 方法重载和方法重写之间的区别是什么?
回答:重载发生在同一个类里,方法名相同但参数不同,编译期就定死了调用哪个方法;重写发生在父子类之间,方法签名完全一样,运行期才根据对象的实际类型决定调用哪个版本。一个是编译期绑定,一个是运行期绑定,这是本质区别。
1.2.6. 为什么 Java 不支持返回值类型不同的方法重载?
回答:因为编译器没法仅凭返回值类型来判断该调哪个方法。比如你写 obj.display(),不接收返回值,编译器完全不知道你想调返回 int 的还是返回 String 的。参数列表是调用时必须提供的,所以能用来区分;返回值是调用后才产生的,没法作为区分依据。
1.2.7. 多态场景下,子类的成员变量会被父类引用访问到吗?
回答:访问不到。多态只对方法有效,对成员变量不起作用。通过父类引用访问成员变量,拿到的永远是父类定义的那个变量,跟实际对象类型没关系。这叫变量的静态绑定,编译期就确定了。
1.2.8. 静态方法能被重写吗?
回答:不能。静态方法属于类本身,不属于对象实例,所以不参与多态。如果子类定义了一个和父类签名一样的静态方法,这叫方法隐藏 method hiding,不是重写。通过父类引用调用静态方法,永远执行的是父类的版本,跟实际对象是什么类型没关系。
2. Java 中的参数传递是按值还是按引用?
2.1. 核心要点
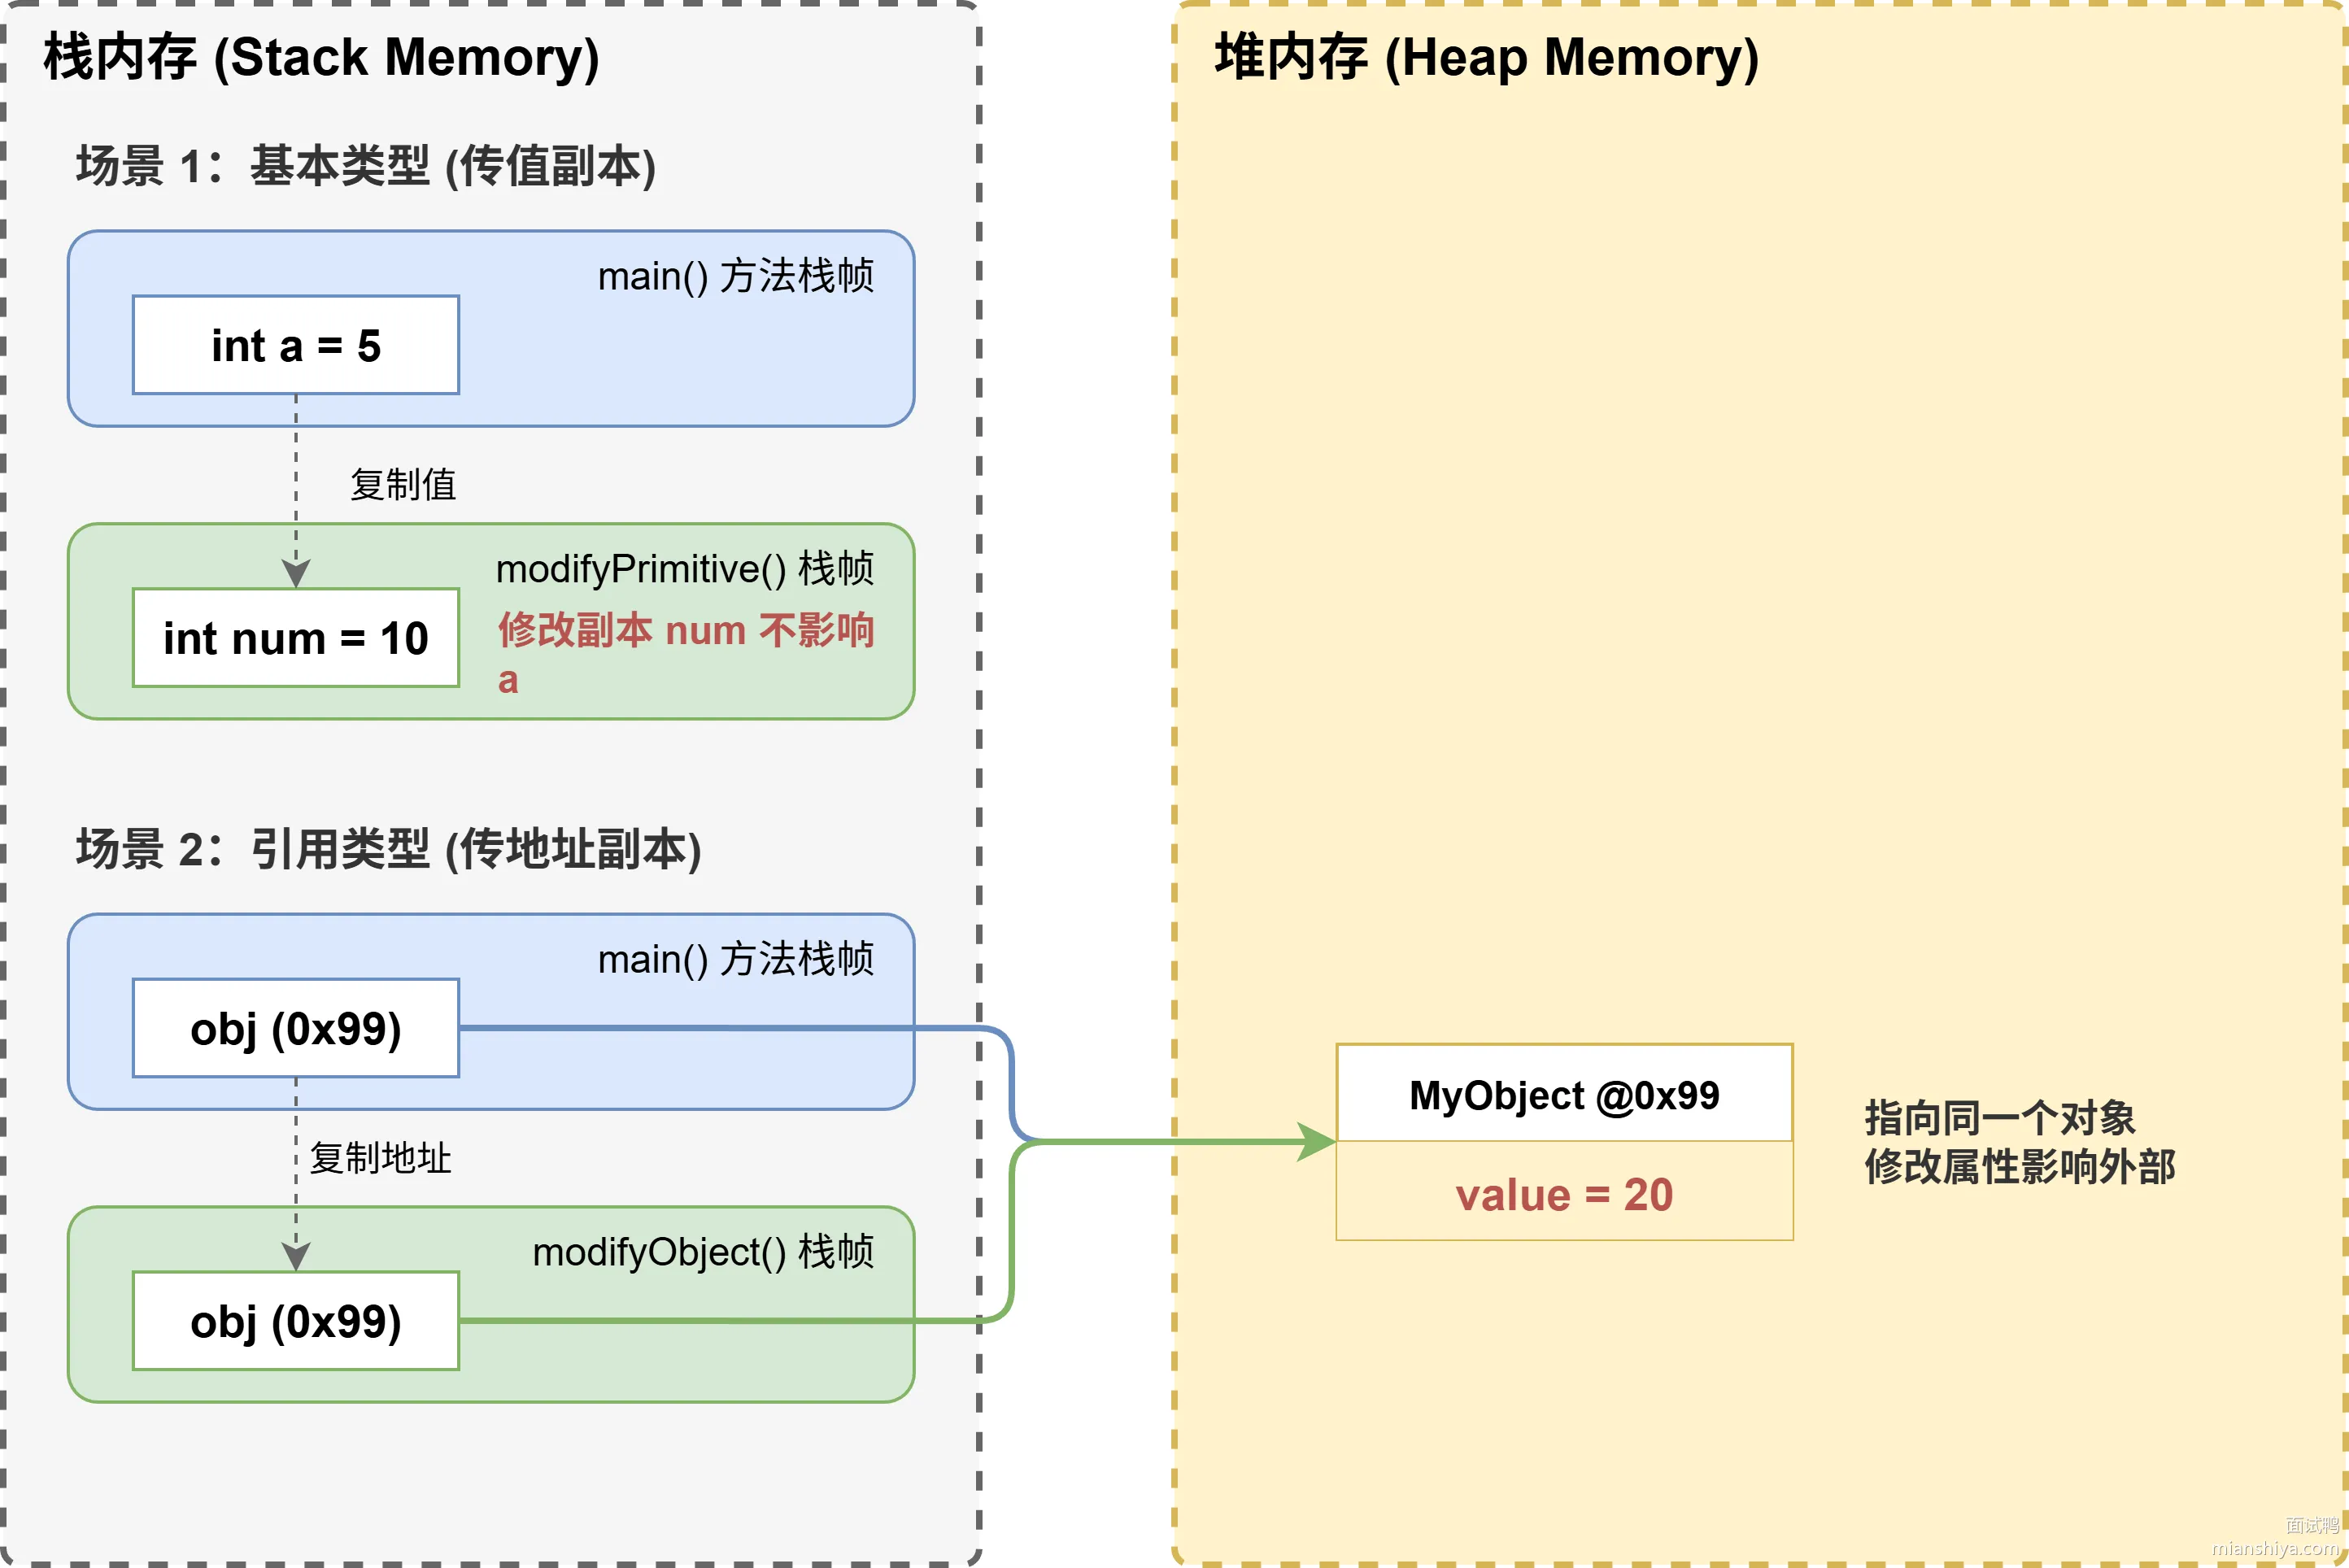
在 Java 中,参数传递只有按值传递,不论是基本类型还是引用类型。
1)基本数据类型如 int、char、boolean 等:传递的是值的副本,也就是基本类型的数值本身。对方法参数的任何修改都不会影响原始变量。
2)引用数据类型如对象引用:传递的是引用的副本,也就是对象引用的内存地址。方法内可以通过引用修改对象的属性,但不能改变引用本身,使其指向另一个对象。
2.2. 扩展知识
2.2.1. 基本类型与引用类型的区别
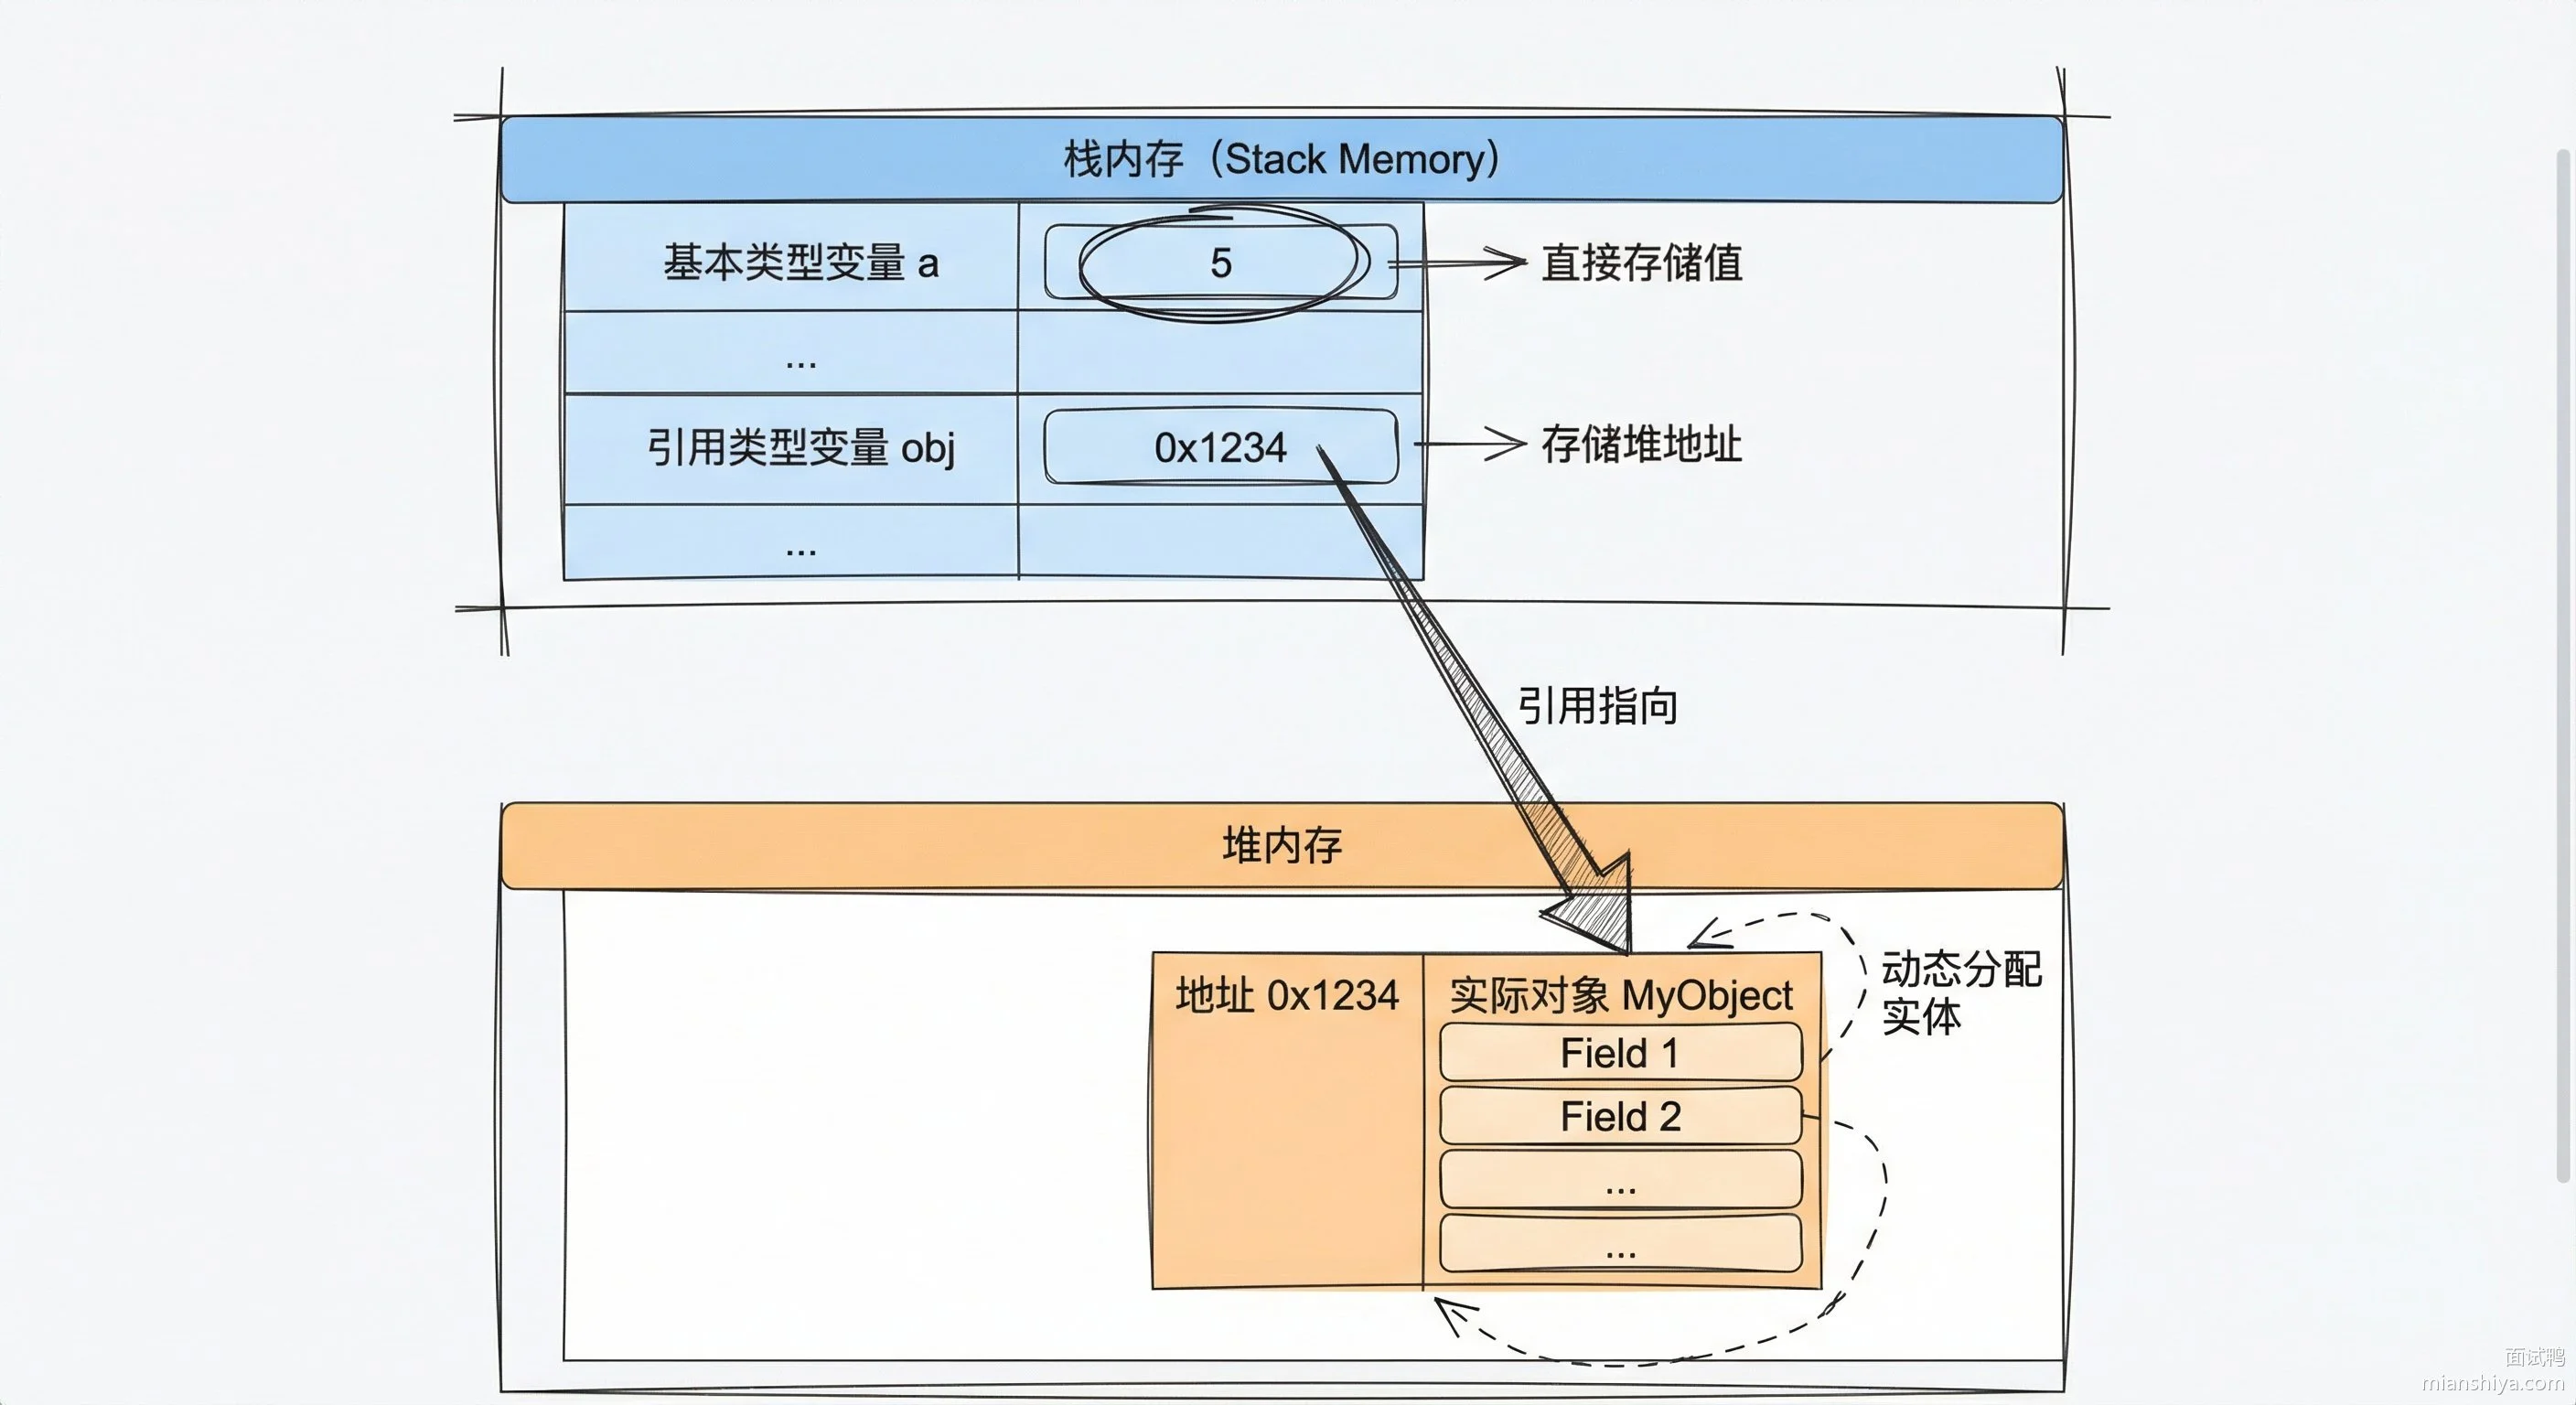
基本类型包括 int、float、double、char、boolean 等,存储在栈内存中。方法中对基本类型参数的操作只会影响传递的副本,原始变量的值不受影响。
引用类型包括所有的对象和数组,引用类型的变量存储的是对象在堆内存中的地址。当引用类型作为参数传递时,传递的是这个地址的副本。所以方法内的修改可以影响到传入的对象的内容,但不会影响对象引用本身的地址。
2.2.2. 示例代码分析
public class ParameterPassing {
    public static void main(String[] args) {
        int a = 5;
        modifyPrimitive(a);
        System.out.println("After modifyPrimitive: " + a); // 输出: 5

        MyObject obj = new MyObject();
        obj.value = 10;
        modifyObject(obj);
        System.out.println("After modifyObject: " + obj.value); // 输出: 20

        resetReference(obj);
        System.out.println("After resetReference: " + obj.value); // 输出: 20
    }

    public static void modifyPrimitive(int num) {
        num = 10; // 仅仅修改了副本,不影响原始变量
    }

    public static void modifyObject(MyObject obj) {
        obj.value = 20; // 修改了对象的属性,会影响原始对象
    }

    public static void resetReference(MyObject obj) {
        obj = new MyObject(); // 修改的是引用的副本,不影响原始对象
        obj.value = 30;
    }
}

class MyObject {
    int value;
}
modifyPrimitive 方法中,num 是基本类型的副本,所以对它的修改不影响原始变量 a。
modifyObject 方法中,obj 是引用类型的副本,但这个副本仍指向原始对象,所以修改 value 属性会影响原始对象。
resetReference 方法中,obj 被重新赋值为一个新对象,这个变化只影响副本,不影响原始引用。
2.2.3. 不可变类
关于引用的回答后,面试官可能会接着问不可变类。不可变类在多线程环境中不需要额外的同步控制,因为它们的状态一旦创建就不能改变。
更多可看:什么是 Java 中的不可变类?
2.3. 常见问题
2.3.1. String 作为参数传递后在方法里修改了,为什么原来的变量没变?
回答:String 是不可变类,方法里对 String 做任何拼接或替换操作,实际上是创建了一个新的 String 对象,然后让方法内的局部引用指向这个新对象。原来的引用还是指向老对象,压根没动过。这不是传引用还是传值的问题,而是 String 本身的不可变性决定的。
2.3.2. 如果我想让方法修改后的值影响到外面的变量,有什么办法?
回答:几种常见做法:
1)用返回值把修改后的结果返回去,调用方接收一下 2)把要修改的值包在一个对象里,传对象进去改属性 3)用数组包一层,比如 int[] holder = {5},方法里改 holder[0]
核心思路就是绕开直接改引用这条路走不通的问题。
2.3.3. 为什么 Java 设计成只有值传递,不像 C++ 那样支持引用传递?
回答:Java 从设计之初就追求简洁和安全。引用传递会让代码行为变得不可预测,调用一个方法可能悄悄把你的变量指向了别的地方,排查 bug 很头疼。Java 选择值传递可以让程序员明确知道:传进去的引用本身不会被改掉,最多改对象的内容。这样代码更好理解,也更好维护。
2.3.4. 那 swap 函数在 Java 里能实现吗?交换两个变量的值
回答:直接交换两个基本类型变量或者两个引用变量,做不到。因为传进去的都是副本,方法里怎么换都影响不了外面。但如果是交换对象里面的属性,比如 obj1.value 和 obj2.value 互换,这个可以做到。或者把两个值装进数组,传数组进去在方法里交换数组元素,也能达到效果。
3. 为什么 Java 不支持多重继承?
3.1. 核心要点
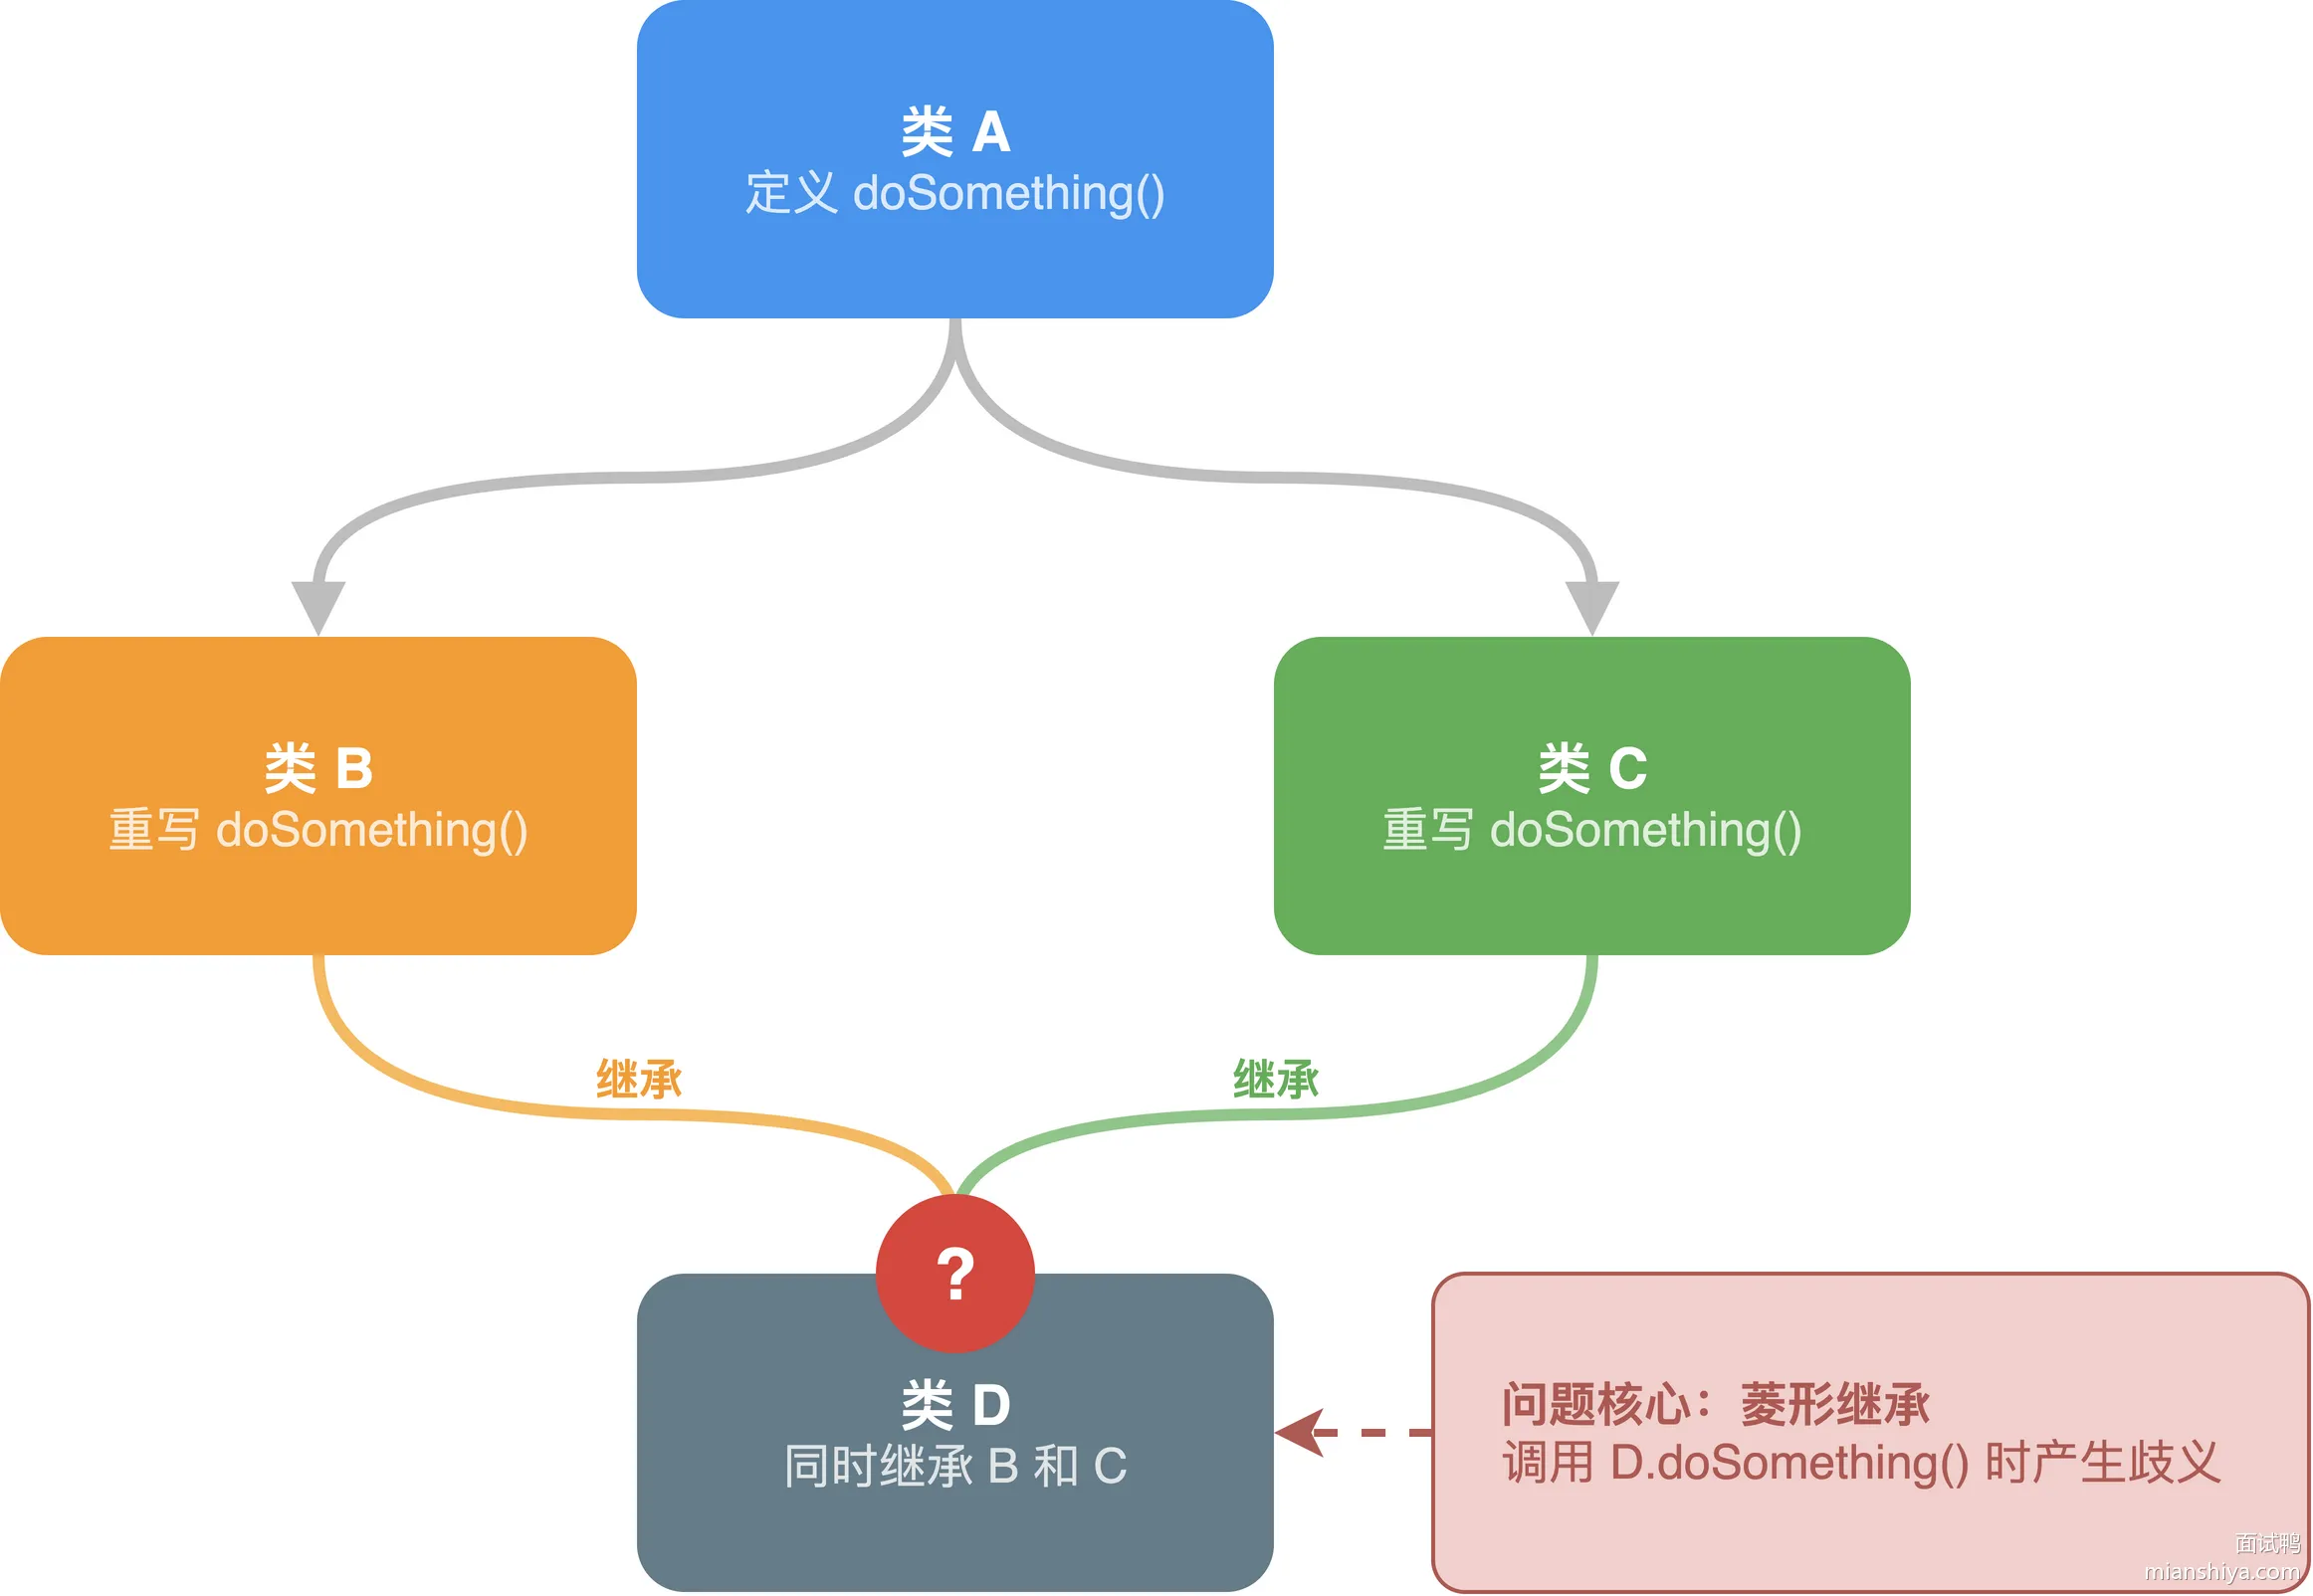
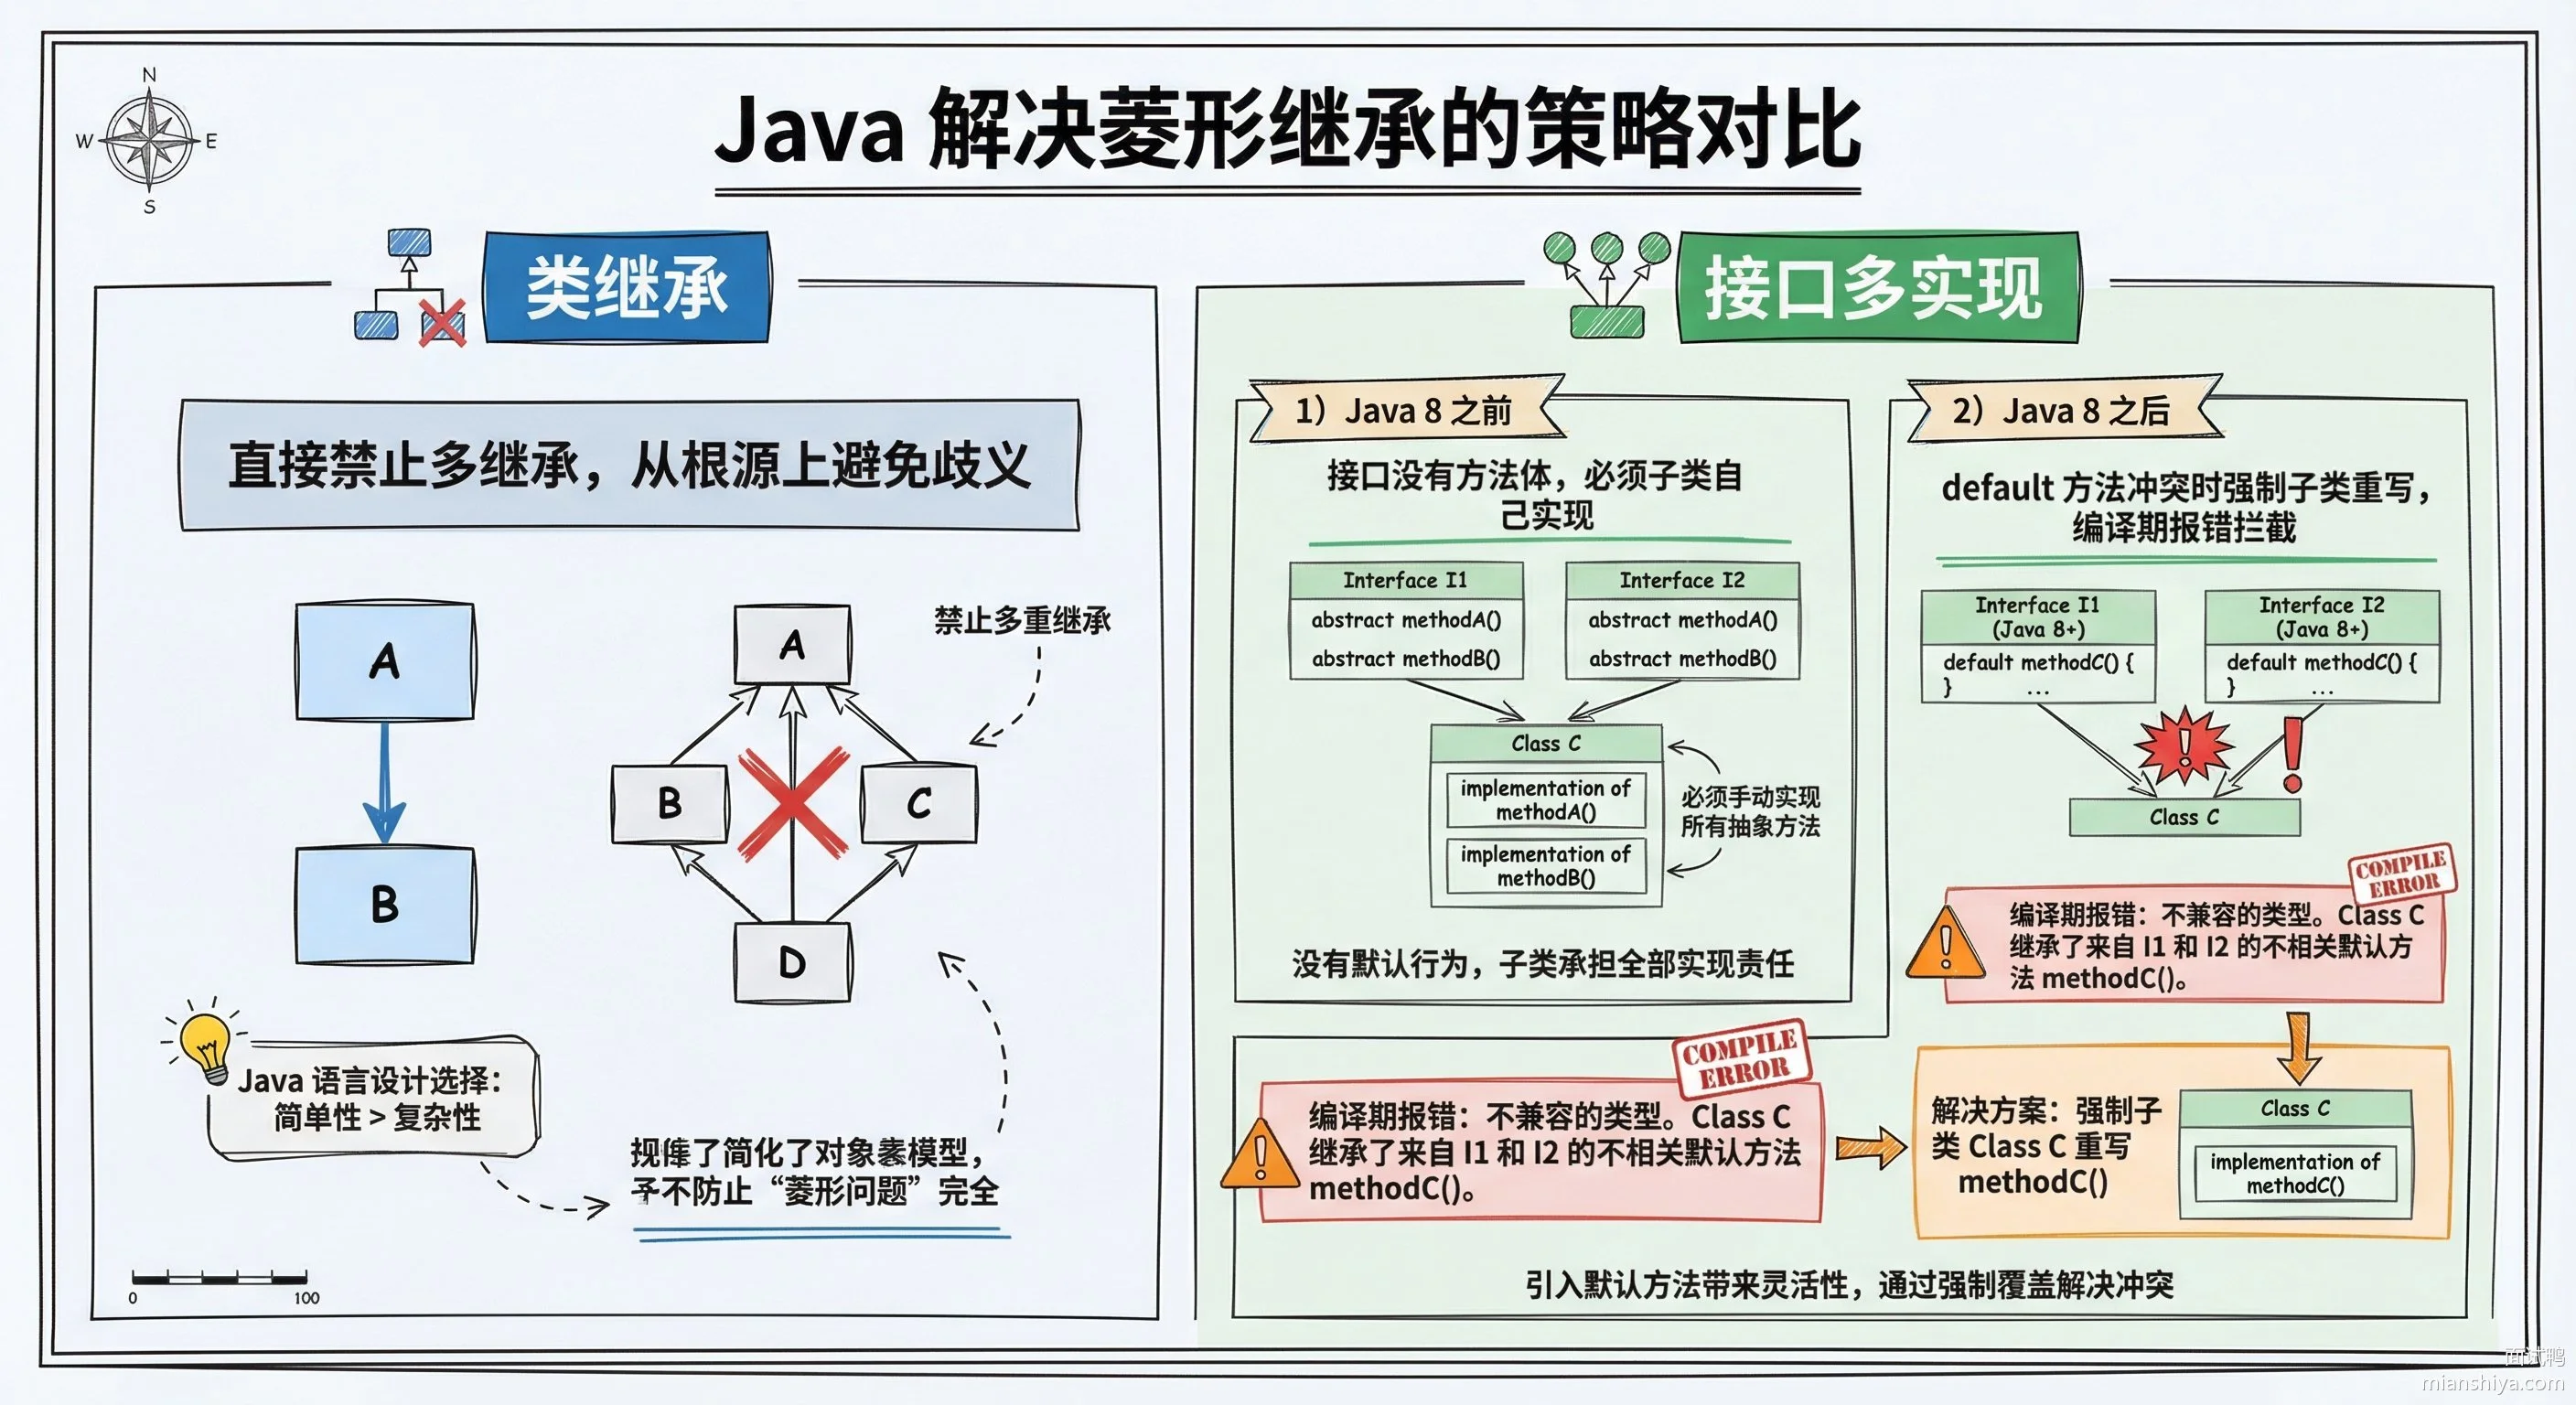
Java 不支持多继承,核心原因是菱形继承问题。Java 之父 James Gosling 吸取了 C++ 多继承带来的坑,直接在语言层面把这条路堵死了。
什么是菱形继承?假设有这样一个继承结构:类 A 有一个方法 doSomething(),B 和 C 都继承了 A 并各自重写了这个方法,然后 D 同时继承 B 和 C。问题来了:当你调用 D.doSomething() 时,到底该执行 B 的版本还是 C 的版本?编译器没法替你做决定,这就产生了歧义。
用伪代码说明一下这个问题:
// 假设 Java 支持多继承
class A {
    void doSomething() { System.out.println("A"); }
}

class B extends A {
    void doSomething() { System.out.println("B"); }
}

class C extends A {
    void doSomething() { System.out.println("C"); }
}

// 这行代码在 Java 中是非法的
class D extends B, C {
    // 调用 doSomething() 时,该用 B 的还是 C 的?
}
C++ 允许多继承,但程序员得自己处理这种歧义,一不小心就是运行时的诡异 bug。Java 索性一刀切,禁止类的多继承,用接口的多实现来满足"一个类具有多种行为"的需求。
3.2. 扩展知识
3.2.1. 为什么接口可以多实现
接口多实现能行,关键在于 Java 8 之前接口压根没有方法体,只有方法签名。不管你实现多少个接口,最终都得在子类里自己写实现逻辑,自然不存在"该调谁"的歧义。
interface Flyable {
    void fly();
}

interface Swimmable {
    void swim();
}

// 多实现没问题,因为必须自己提供实现
class Duck implements Flyable, Swimmable {
    @Override
    public void fly() { System.out.println("扑腾扑腾飞"); }

    @Override
    public void swim() { System.out.println("划水划水"); }
}
3.2.2. Java 8 默认方法带来的新问题
Java 8 引入了 default 方法,接口终于能有方法体了。这一下,菱形继承的幽灵又出现了:
interface A {
    default void doSomething() { System.out.println("A"); }
}

interface B extends A {
    default void doSomething() { System.out.println("B"); }
}

interface C extends A {
    default void doSomething() { System.out.println("C"); }
}

// 编译报错!
class D implements B, C {
    // 不重写 doSomething() 编译器直接拒绝
}
Java 的解决方案很直接:碰到这种冲突,强制要求子类重写,编译期就报错,逼你做出选择。如果你想用某个父接口的实现,可以用 接口名.super.方法名() 显式指定:
class D implements B, C {
    @Override
    public void doSomething() {
        B.super.doSomething(); // 明确用 B 的版本
    }
}
3.2.3. 和 C++ 多继承的对比
C++ 确实支持多继承,但代价是需要程序员自己处理歧义。C++ 提供了虚继承来缓解菱形继承问题,但这玩意儿理解成本高,还容易出错。
| 特性 | Java | C++ |
|---|---|---|
| 类多继承 | 不支持 | 支持 |
| 接口/抽象类多实现 | 支持 | 支持 |
| 菱形问题处理 | 编译期禁止或强制重写 | 虚继承,运行时开销 |
| 学习成本 | 低 | 高 |
Java 这种设计哲学很明确:宁可限制灵活性,也要保证代码的可预测性和可维护性。
3.3. 常见问题
3.3.1. 如果我就是需要一个类同时具有多个父类的功能,Java 里怎么实现?
回答:一般有三种方案。第一种是接口多实现加组合,把需要复用的逻辑封装成独立的类,通过组合持有这些类的实例,再在接口方法里委托调用。第二种是用抽象类做中间层,把公共逻辑放在抽象类里,子类继承抽象类同时实现多个接口。第三种是 Java 8 之后直接用接口的 default 方法,把默认实现写在接口里,但得注意处理好冲突。
3.3.2. 接口的 default 方法和抽象类的普通方法有什么区别?
回答:最大的区别是状态。抽象类可以有实例变量,方法能读写这些状态;接口的 default 方法只能访问接口里定义的常量和其他方法,没法维护状态。另外抽象类是单继承的,而接口可以多实现。所以需要共享状态的公共逻辑放抽象类,纯行为契约的默认实现放接口 default 方法。
3.3.3. Kotlin 和 Scala 这些 JVM 语言是怎么处理多继承的?
回答:它们都用 Trait 或类似机制。Scala 的 Trait 可以有具体实现和状态,碰到冲突时按线性化顺序解析,最后混入的 Trait 优先。Kotlin 的接口也支持默认实现,冲突处理和 Java 8 类似,强制要求显式重写。本质上都是在编译期把歧义解决掉,不把问题留到运行时。
4. 什么是 Java 内部类?它有什么作用?
4.1. 核心要点
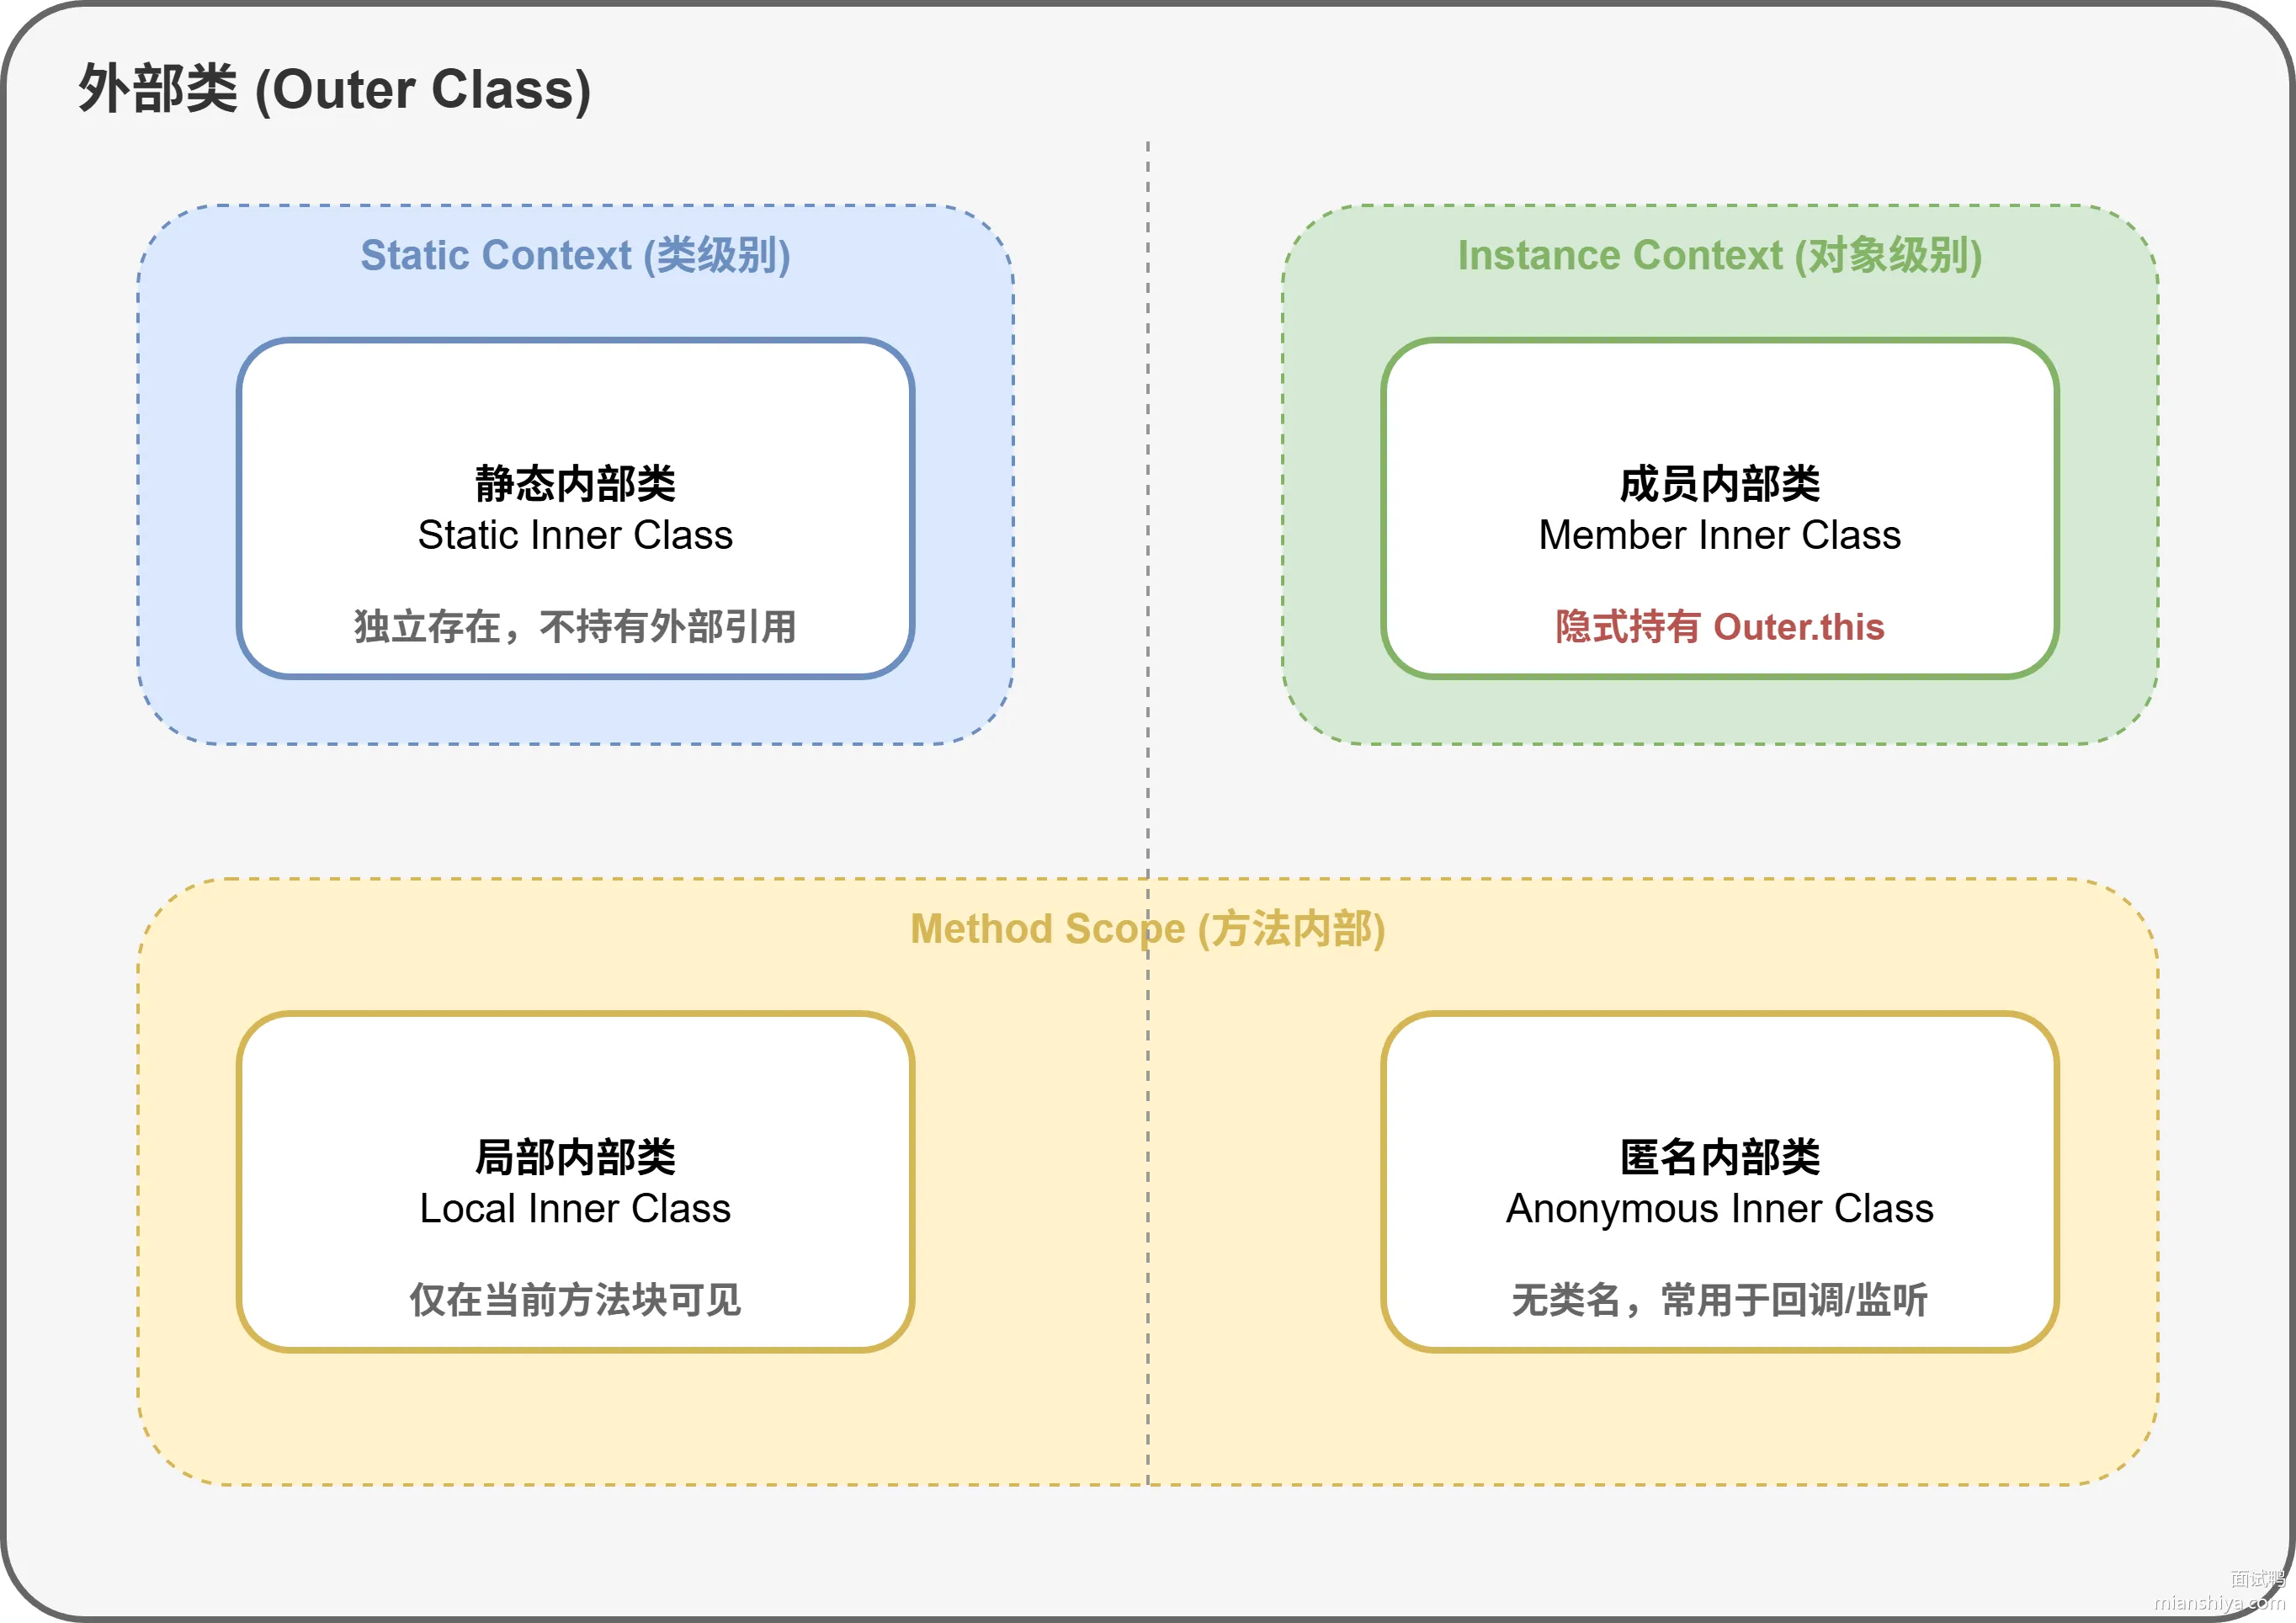
Java 内部类就是定义在另一个类里面的类,分为成员内部类、静态内部类、局部内部类和匿名内部类四种。内部类最大的特点是能直接访问外部类的成员,包括私有成员。
内部类的作用主要有这几点:
1)把逻辑相关的类放在一起,提高内聚性,外面用不到的类就不用暴露出去
2)内部类可以直接拿到外部类的成员变量和方法,操作起来很方便
3)对于只在一个地方用的小类,用内部类能减少冗余代码
4)匿名内部类在事件监听、回调这些场景用得非常多,比如 Android 的点击事件、Swing 的按钮监听,写起来很简洁
4.2. 扩展知识
4.2.1. 四种内部类的区别和用法
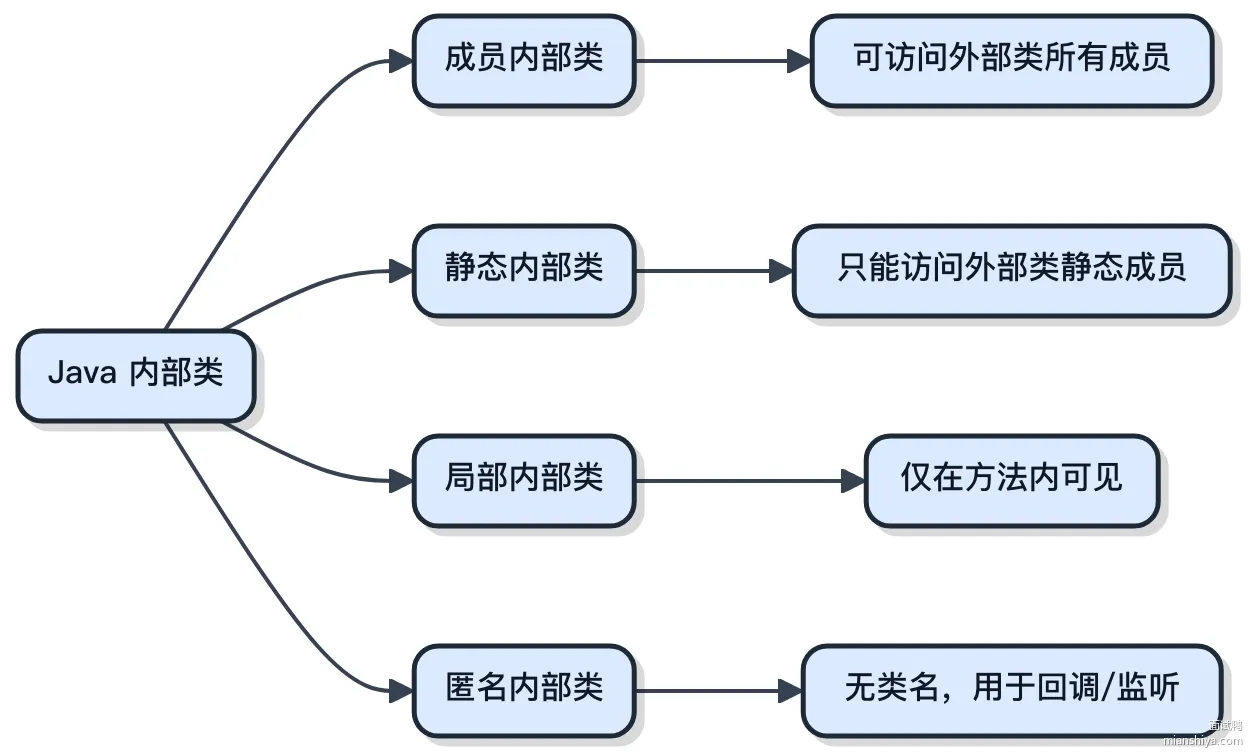
1)成员内部类,定义在类里面但不带 static 修饰,可以访问外部类的所有成员,包括 private 的。每个成员内部类实例都隐式持有一个外部类实例的引用。
public class OuterClass {
    private String outerField = "Outer Field";

    class InnerClass {
        void display() {
            System.out.println("Outer Field: " + outerField);
        }
    }

    public void createInner() {
        InnerClass inner = new InnerClass();
        inner.display();
    }
}
2)静态内部类,用 static 修饰,只能访问外部类的静态成员。它本质上就是个顶级类,可以独立于外部类使用,主要用来表明类结构和命名空间。像 HashMap 里的 Node、Entry 就是典型的静态内部类。
public class OuterClass {
    private static String staticOuterField = "Static Outer Field";

    static class StaticInnerClass {
        void display() {
            System.out.println("Static Outer Field: " + staticOuterField);
        }
    }

    public static void createStaticInner() {
        StaticInnerClass staticInner = new StaticInnerClass();
        staticInner.display();
    }
}
3)局部内部类,定义在方法里面,只在这个方法内可见。它可以访问外部类的成员,也能访问方法中的局部变量,但这个局部变量必须是 final 或者 effectively final 的。实际开发中用得比较少。
public class OuterClass {
    void outerMethod() {
        final String localVar = "Local Variable";

        class LocalInnerClass {
            void display() {
                System.out.println("Local Variable: " + localVar);
            }
        }

        LocalInnerClass localInner = new LocalInnerClass();
        localInner.display();
    }
}
4)匿名内部类,没有类名,在创建对象的时候直接定义。用得最多的场景就是实现接口或继承抽象类,比如各种回调、监听器。
public class OuterClass {
    interface Greeting {
        void greet();
    }

    public void sayHello() {
        Greeting greeting = new Greeting() {
            @Override
            public void greet() {
                System.out.println("Hello, World!");
            }
        };
        greeting.greet();
    }
}
4.2.2. 内部类的底层实现
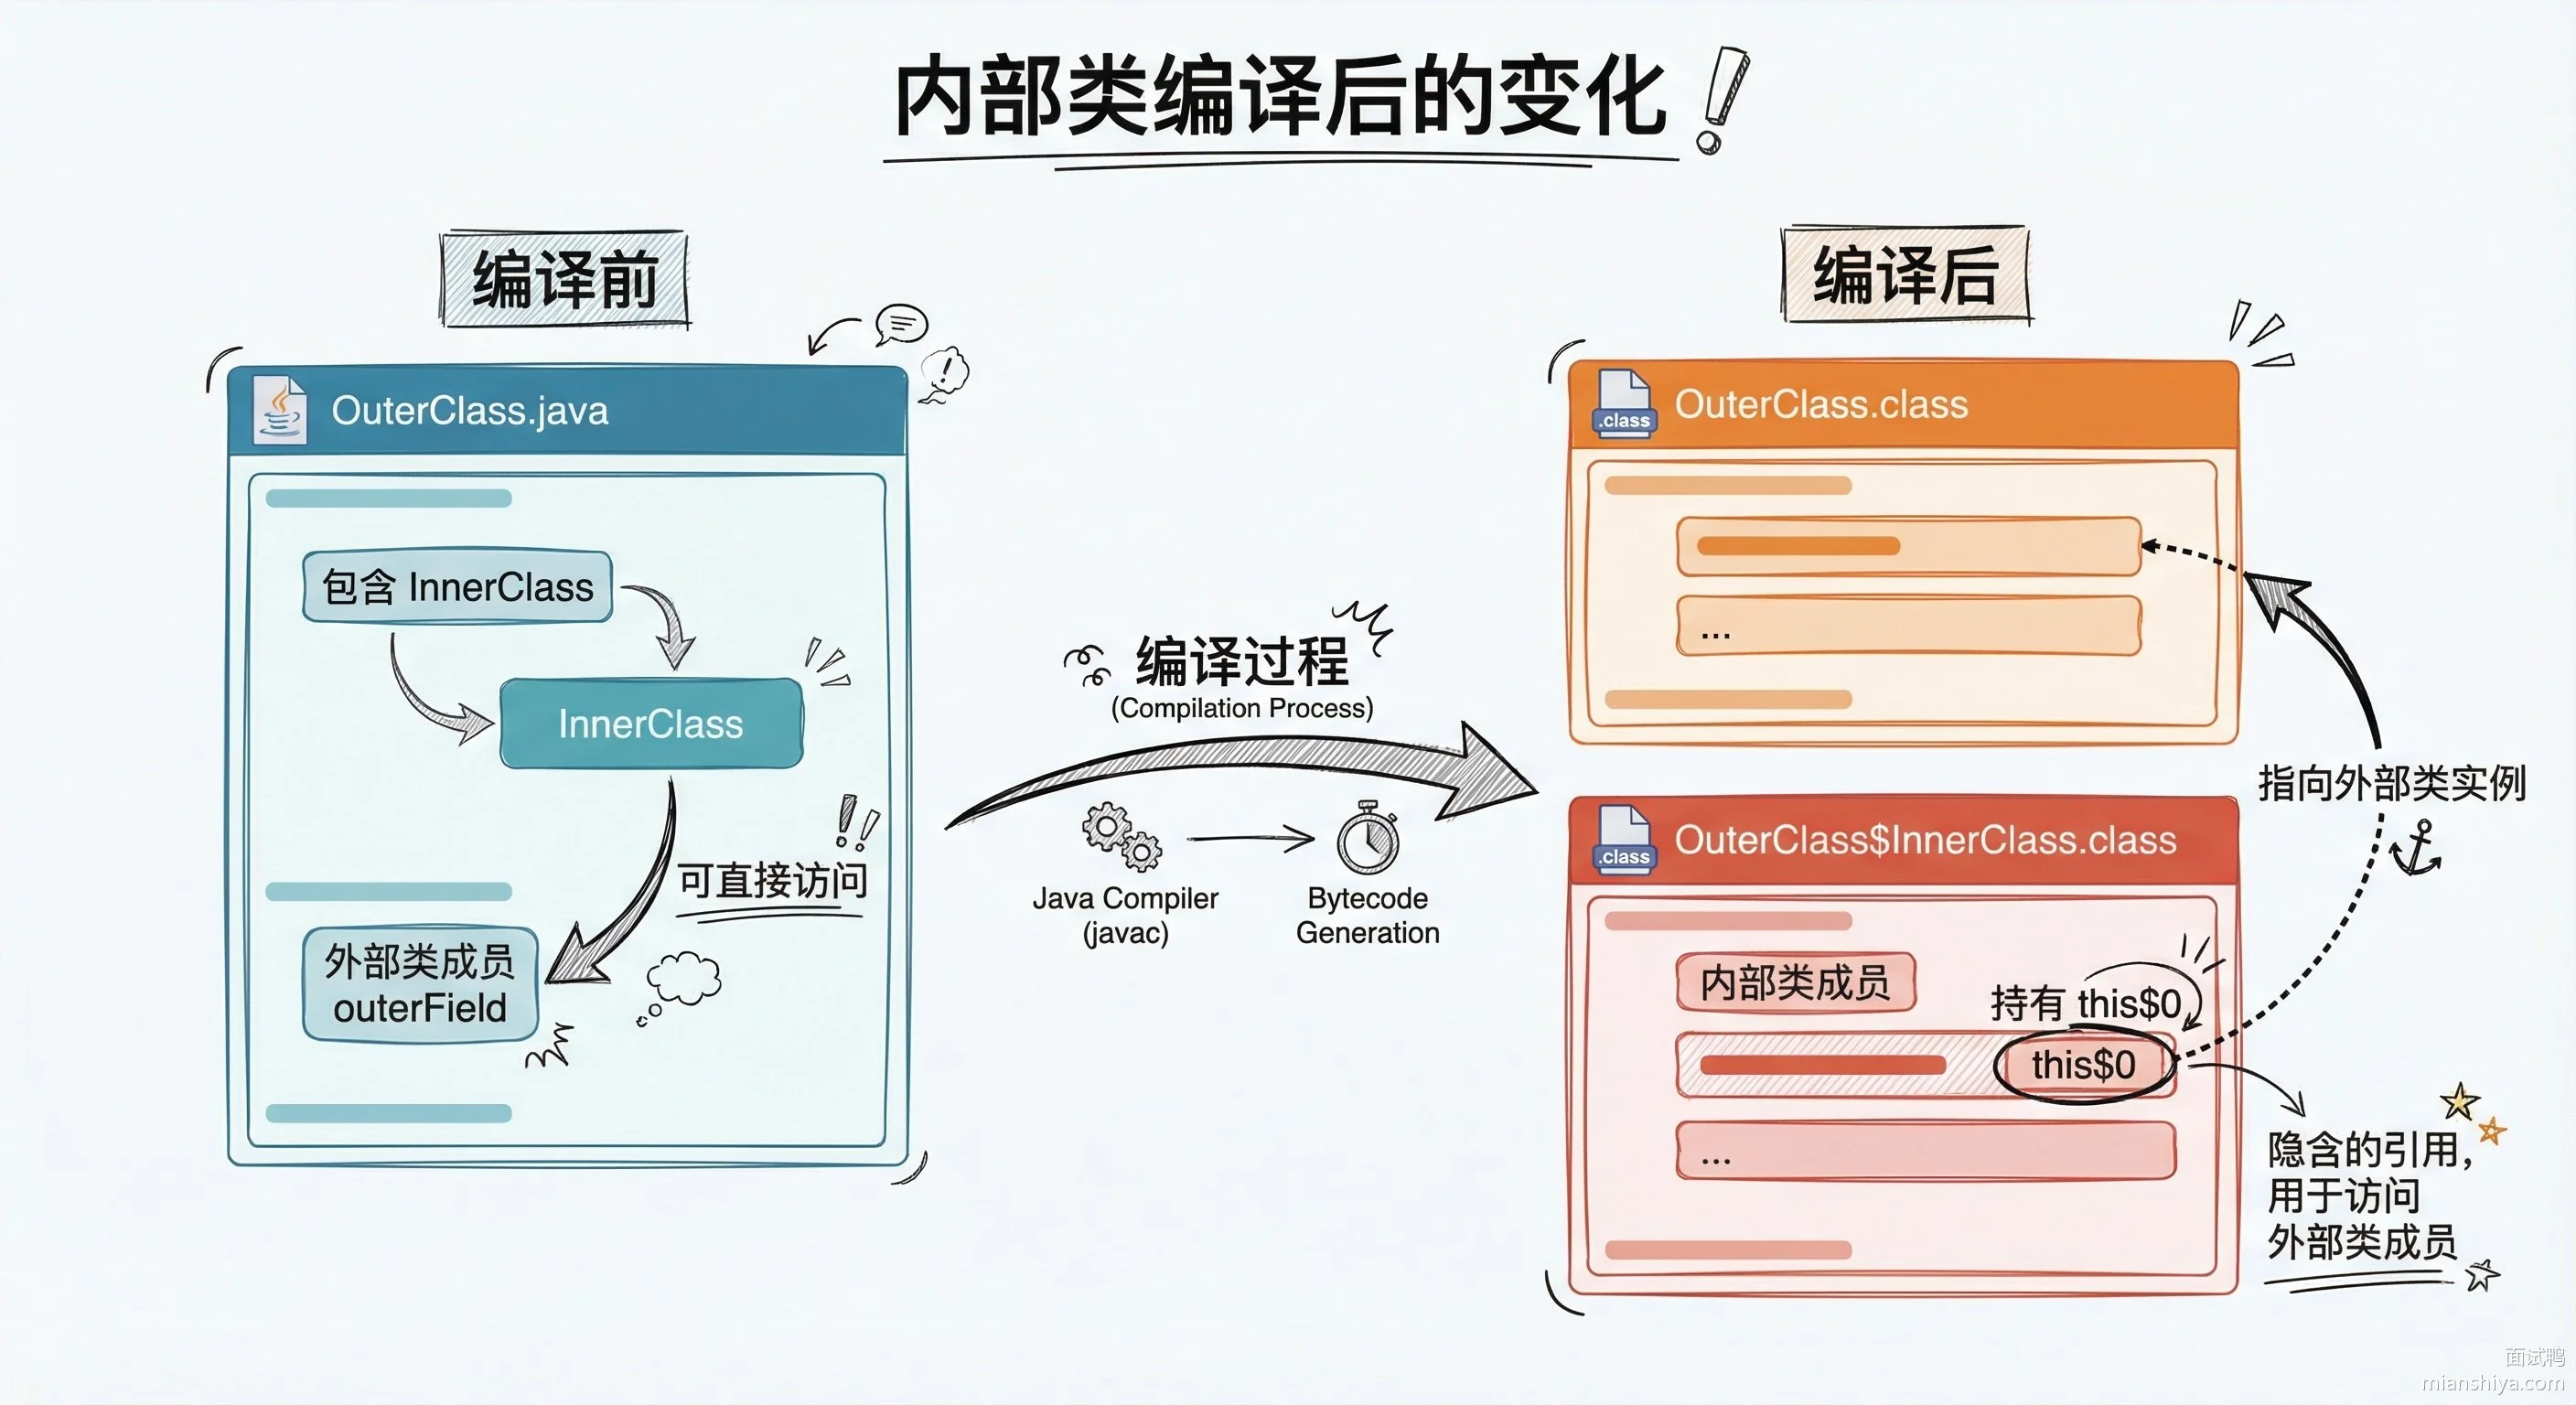
内部类其实是编译层面的概念,有点像语法糖。经过编译器处理之后,内部类会被提升为独立的顶级类,和外部类没什么两样,所以在 JVM 层面是没有内部类这个概念的。
编译后会生成类似 OuterClass$InnerClass.class 这样的文件名,成员内部类的构造方法会被编译器自动加一个外部类实例的参数,用来维护对外部类的引用。
4.2.3. 成员内部类 vs 静态内部类怎么选
如果内部类需要访问外部类的实例成员,就用成员内部类;如果不需要,优先用静态内部类。原因很简单,成员内部类会隐式持有外部类的引用,可能导致外部类无法被 GC 回收,造成内存泄漏。Android 开发里的 Handler 内存泄漏就是典型案例。
4.2.4. Lambda 表达式对匿名内部类的影响
Java 8 引入 Lambda 之后,很多原本要用匿名内部类的场景都可以用 Lambda 替代了,代码更简洁。不过 Lambda 只能用于函数式接口,也就是只有一个抽象方法的接口。
// 匿名内部类写法
Runnable r1 = new Runnable() {
    @Override
    public void run() {
        System.out.println("Hello");
    }
};

// Lambda 写法
Runnable r2 = () -> System.out.println("Hello");
4.3. 常见问题
4.3.1. 成员内部类为什么能访问外部类的私有成员?编译器是怎么处理的?
回答:编译器会在外部类里自动生成一个包级私有的静态方法,比如 access$000,用来返回私有字段的值。内部类访问外部类私有成员的时候,实际上是调用这个生成的方法,绕过了 Java 的访问控制。这也是为什么说内部类是编译器层面的语法糖。
4.3.2. 匿名内部类访问局部变量为什么必须是 final 的?
回答:局部变量存在栈上,方法执行完就没了,但匿名内部类的实例可能还活着。为了保证一致性,编译器会把这个局部变量的值拷贝一份给内部类。如果允许修改,内部类和外部方法看到的值就可能不一样,所以干脆强制 final,不让改。Java 8 之后放宽了,只要是 effectively final 就行,也就是虽然没写 final 但实际上没改过。
4.3.3. 静态内部类能不能访问外部类的实例变量?如果想访问怎么办?
回答:直接访问不行,因为静态内部类不持有外部类的引用。如果非要访问,可以通过构造方法或者 setter 把外部类实例传进去,然后通过这个实例去访问。
4.3.4. 内部类在实际项目中有哪些典型应用场景?
回答:最常见的就是集合框架里的迭代器,比如 ArrayList 的 Itr 就是成员内部类,能直接访问外部类的 elementData 数组。还有 Builder 模式,通常把 Builder 定义成静态内部类,像 Guava 的 ImmutableList.Builder 、OkHttp 的 Request.Builder、Lombok 的 @Builder 生成的代码都是这种套路。另外就是各种回调和事件监听,用匿名内部类或者 Lambda 来实现。
5. Java 中 String、StringBuffer 和 StringBuilder 的区别是什么?
5.1. 核心要点
三者都用来处理字符串,核心区别在于可变性和线程安全。
String 是不可变的,底层的 char 数组被 final 修饰,一旦创建就定死在那了。每次拼接、替换都会生成新对象,原来那个不会变。
StringBuffer 和 StringBuilder 都是可变的,底层用一个可扩容的数组存字符。区别在于 StringBuffer 的方法都加了 synchronized,是线程安全的;StringBuilder 没加锁,单线程下性能更好。
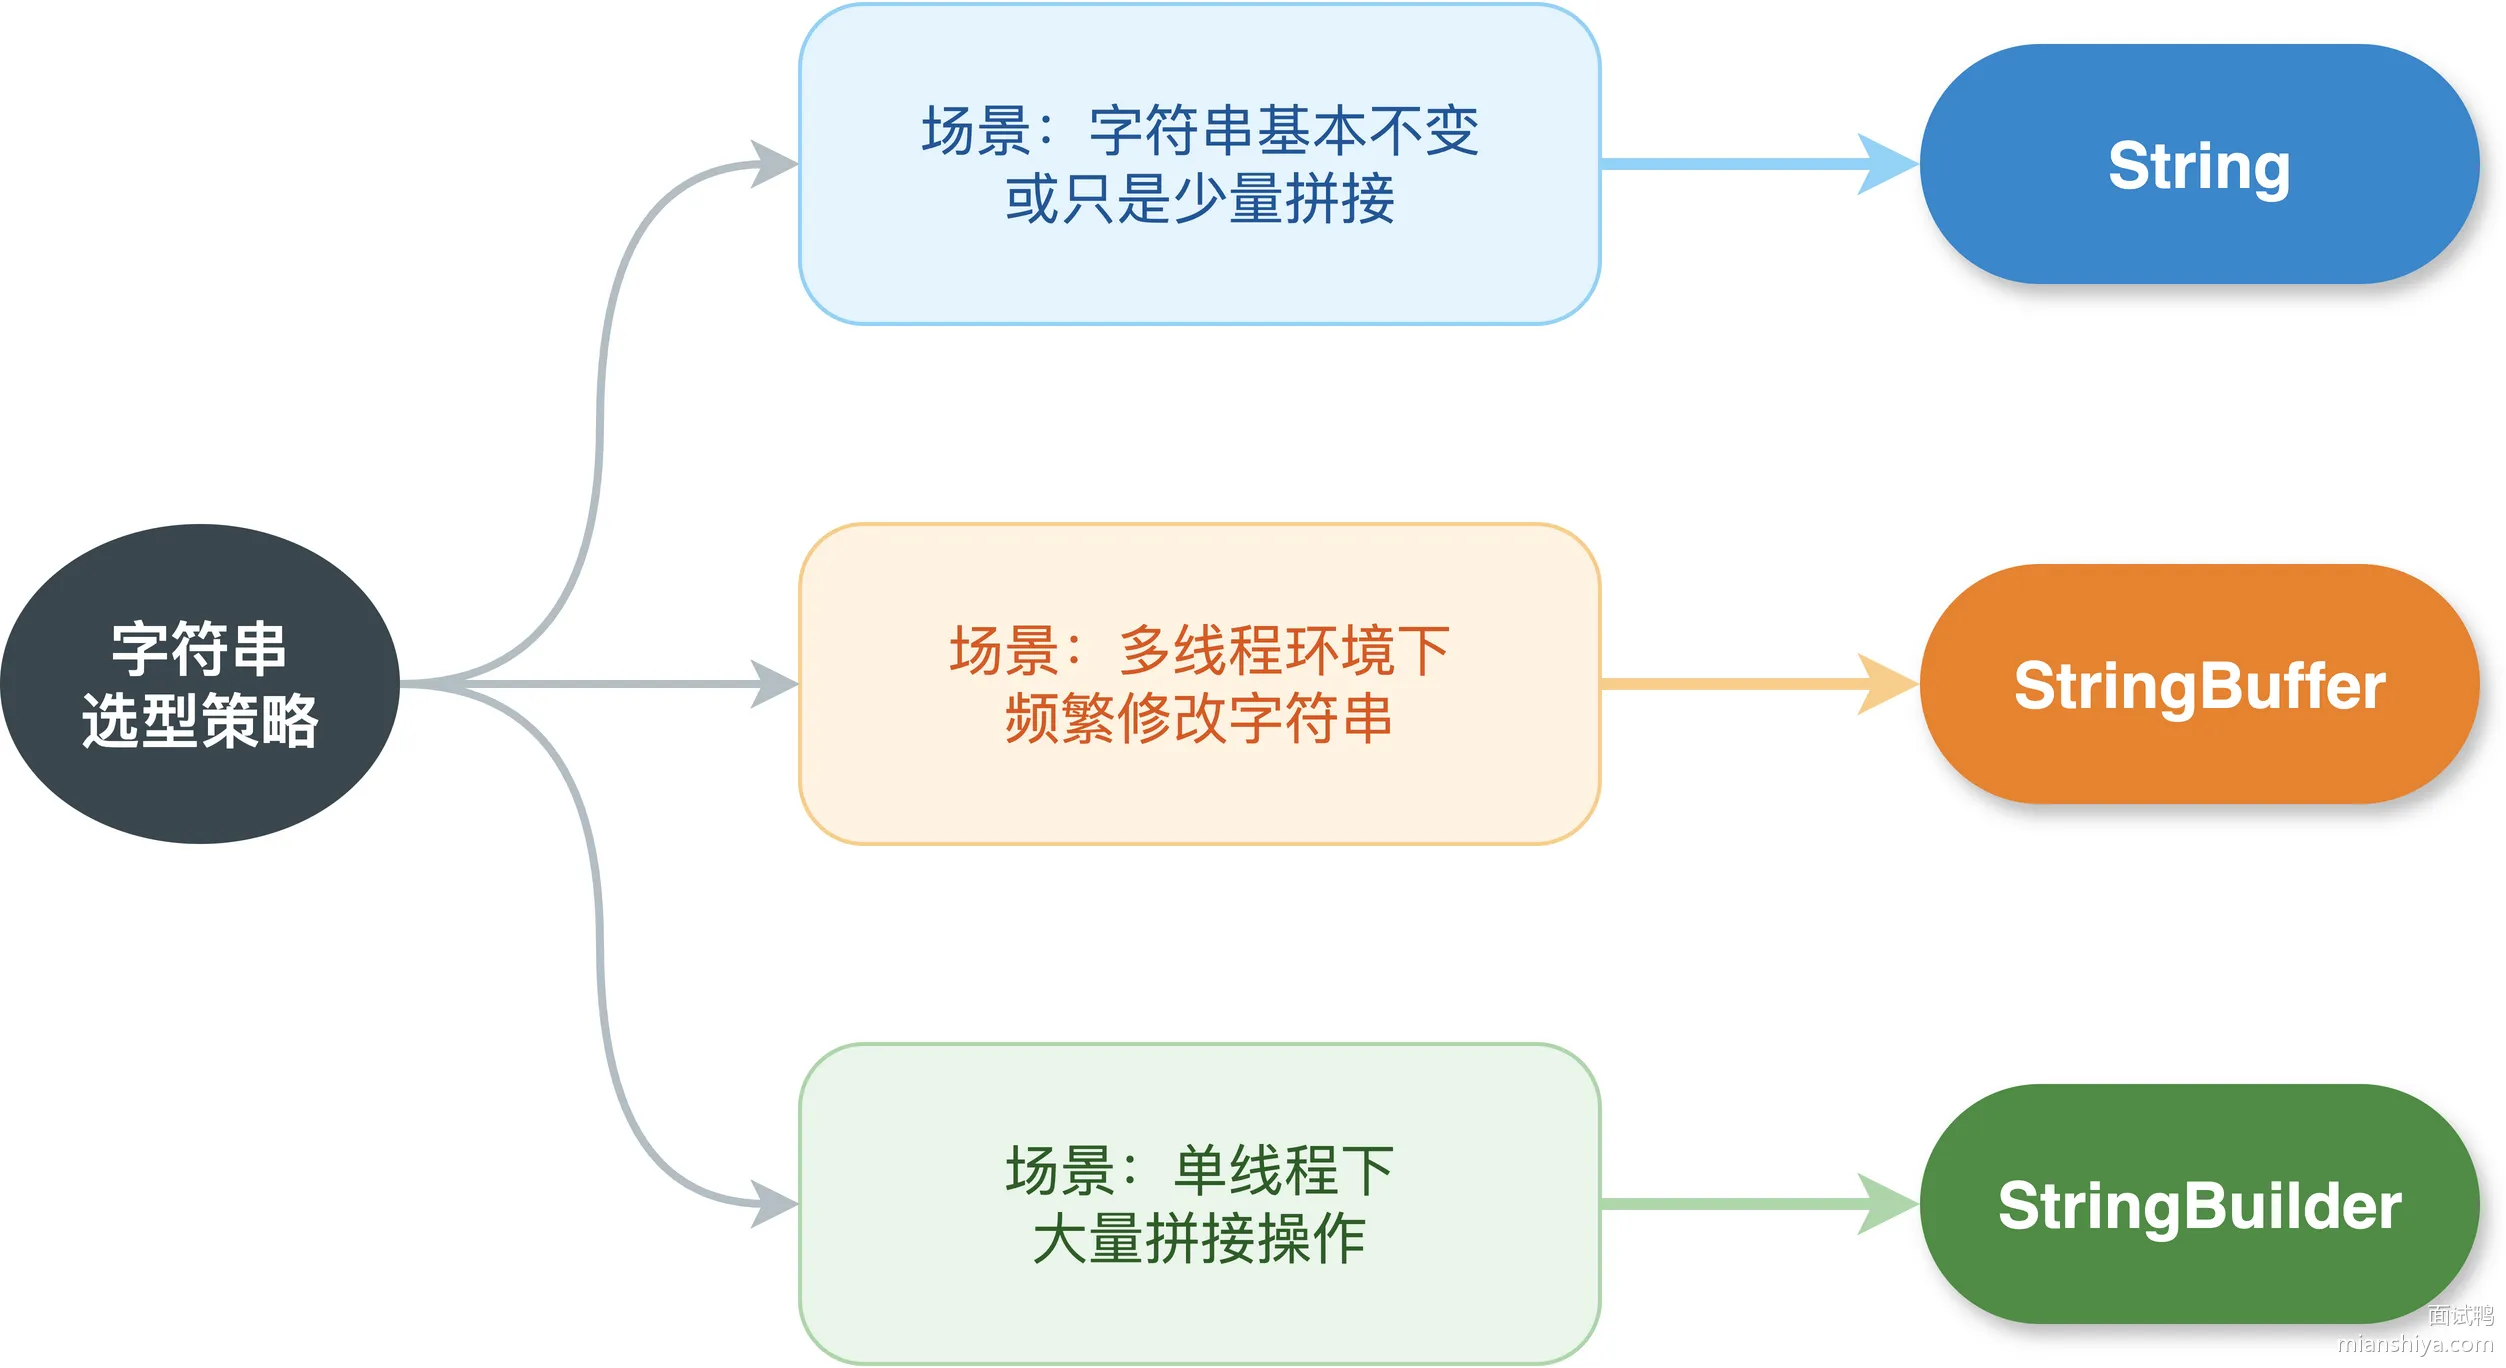
实际选型很简单: 1)字符串基本不变,或者只是少量拼接,直接用 String 2)多线程环境下要频繁修改字符串,用 StringBuffer 3)单线程下大量拼接操作,用 StringBuilder
举个典型场景,在循环里拼接 SQL 语句,如果用 String,10000 次循环就会创建 10000 个临时对象,GC 压力很大。换成 StringBuilder,始终操作同一个对象,只在容量不够时才扩容一次。
// 反面教材:循环中用 String 拼接
String sql = "";
for (int i = 0; i < 10000; i++) {
    sql += "value" + i + ",";  // 每次都创建新对象
}

// 正确做法:用 StringBuilder
StringBuilder sb = new StringBuilder(100000);  // 预估容量
for (int i = 0; i < 10000; i++) {
    sb.append("value").append(i).append(",");
}
5.2. 扩展知识
5.2.1. 为什么 String 要设计成不可变
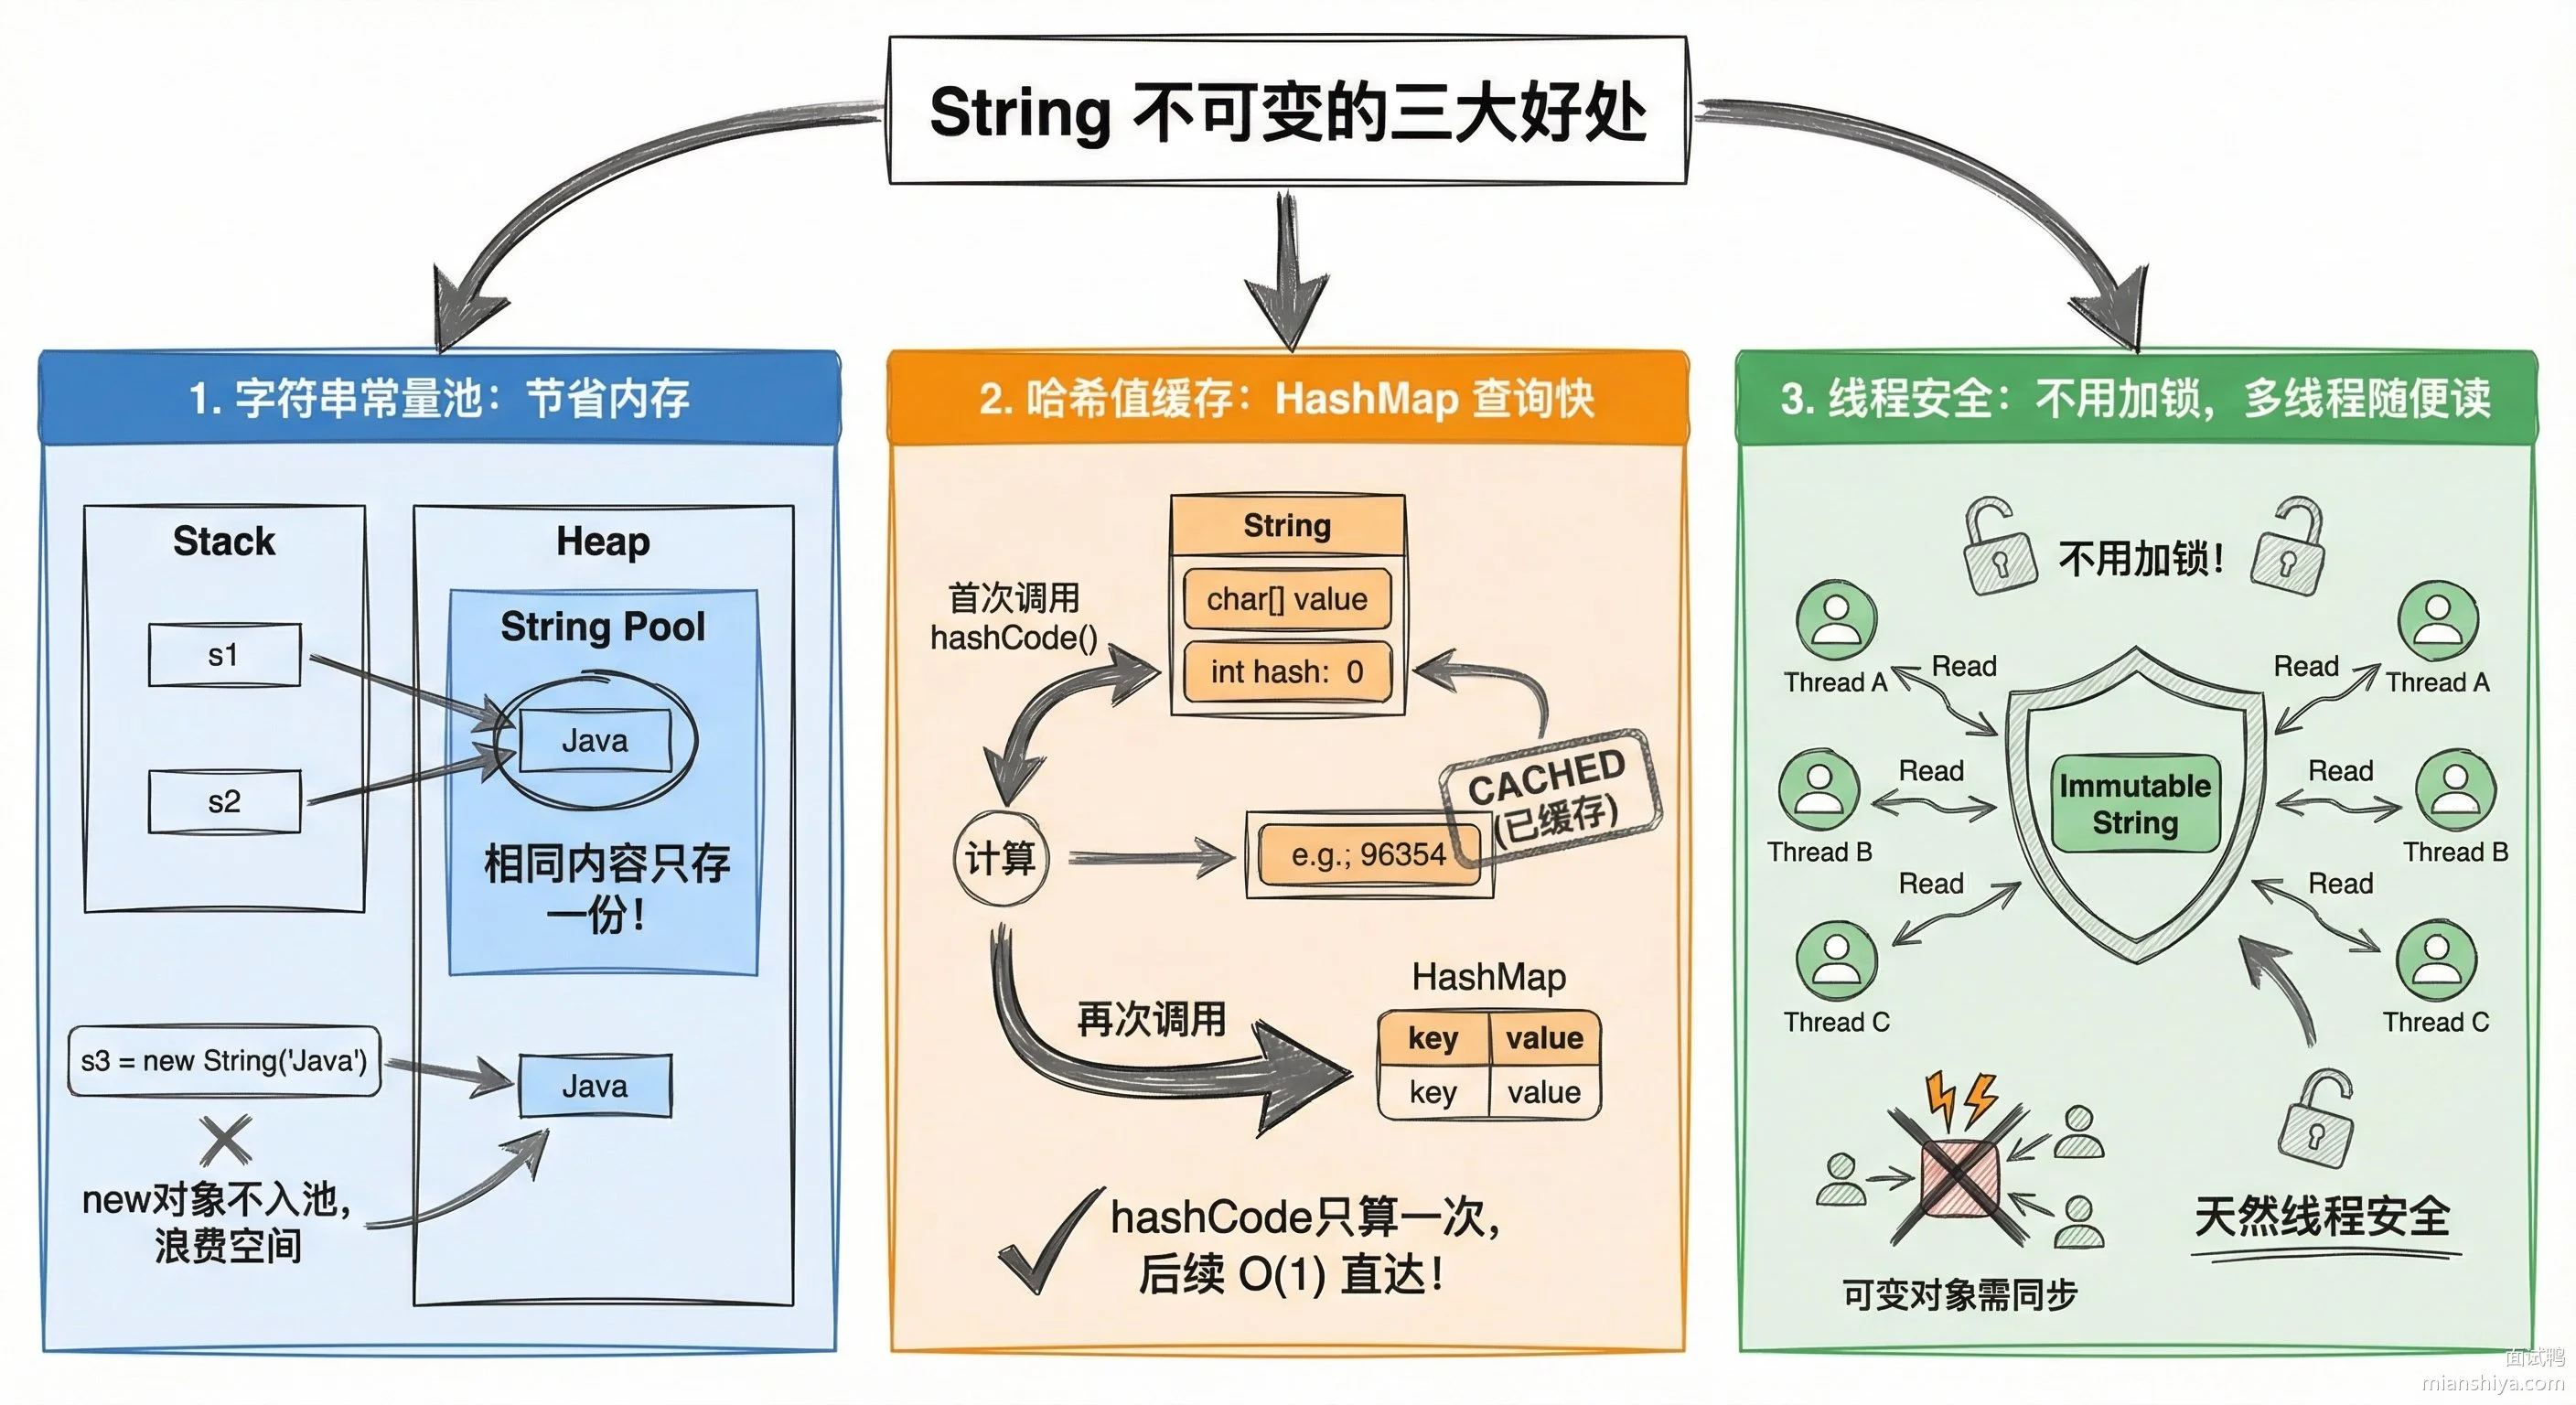
String 不可变不是拍脑袋决定的,背后有几个重要考量:
1)字符串常量池能生效。JVM 在堆里专门开辟了一块区域存字符串常量,相同内容的字符串只存一份。如果 String 可变,你改了一个引用指向的内容,其他引用也跟着变了,这就乱套了。
2)哈希值可以缓存。String 的 hashCode 算一次就存起来了,后面再调直接返回。HashMap 拿 String 做 key 的时候效率很高,不用每次都重新算。
3)天然线程安全。不可变对象压根不需要同步,多个线程随便读,不会有并发问题。
5.2.2. StringBuilder 底层实现
StringBuilder 继承自 AbstractStringBuilder,核心就是一个 char 数组加一个 count 变量记录实际字符数。
abstract class AbstractStringBuilder {
    char[] value;  // JDK 9 之前
    int count;     // 实际字符数量
}
append 操作先检查容量够不够,不够就扩容,然后把新内容拷贝到数组末尾,更新 count。整个过程没有创建新对象,都是在原数组上操作。
扩容策略是原容量乘 2 再加 2。假设当前容量是 16,扩容后就是 34。如果还不够,就直接扩到需要的大小。扩容要创建新数组、拷贝旧数据,开销不小,所以创建 StringBuilder 时最好预估一下最终长度,用带参构造函数指定初始容量。
5.2.3. JDK 9 的重大变化
JDK 9 把 String、StringBuilder、StringBuffer 底层的 char 数组全换成了 byte 数组,同时加了一个 coder 字段标记编码方式。
// JDK 9+ 的 String
public final class String {
    private final byte[] value;
    private final byte coder;  // 0=LATIN1, 1=UTF16
}
为什么要改?因为大部分字符串其实都是英文、数字这些 Latin-1 字符,一个字符只要 1 个字节就够了。以前用 char 数组,每个字符固定占 2 字节,纯英文字符串直接浪费一半内存。改成 byte 数组后,Latin-1 字符串内存占用直接砍半。
这个优化叫 Compact Strings,对内存敏感的应用来说提升明显,特别是要处理海量字符串的场景。
5.2.4. 编译器的字符串拼接优化
Java 编译器会把简单的字符串拼接优化成 StringBuilder。比如下面的代码:
String s = "a" + "b" + "c";编译器直接在编译期把它算成 "abc",运行时就是一个常量。
但如果拼接里有变量:
String s = a + b + c;编译器会把它变成:
String s = new StringBuilder().append(a).append(b).append(c).toString();不过要注意,这个优化在循环里不太行。每次循环都会 new 一个 StringBuilder,跟你手动写 String 拼接差不多。所以循环里的字符串拼接,还是得自己在循环外创建 StringBuilder。
JDK 9 引入了 Indify String Concatenation,用 invokedynamic 指令来处理字符串拼接,性能比以前的 StringBuilder 方式更好,而且给了 JVM 更多优化空间。
5.3. 常见问题
5.3.1. 你说 StringBuilder 扩容是原容量乘 2 加 2,为什么要加 2?
详细解答可以看:Java 的 StringBuilder 是怎么实现的?
回答:加 2 主要是为了处理边界情况。如果当前容量是 0,乘 2 还是 0,加 2 之后至少有 2 个位置。另外加 2 也能让小容量的 StringBuilder 扩容时多一点缓冲,减少频繁扩容的次数。
5.3.2. StringBuffer 的 synchronized 加在哪了?整个方法都加还是只锁关键代码?
回答:直接加在方法上,整个方法都是同步的。append、insert、delete 这些修改方法全都是 synchronized 修饰的。这种粗粒度的锁确实简单,但也意味着同一时刻只有一个线程能操作这个 StringBuffer,并发高的时候性能会比较差。
5.3.3. String 的 intern 方法是干什么的?什么场景下会用?
回答:intern 会把字符串放进常量池,如果池里已经有相同内容的字符串,就返回池里那个的引用。用在需要大量比较字符串的场景,比如 JSON 解析时字段名会反复出现,intern 之后可以直接用 == 比较,比 equals 快。不过要小心,滥用 intern 会把常量池撑爆,JDK 7 之前常量池在永久代,空间有限,容易 OOM。
5.3.4. 多线程环境下一定要用 StringBuffer 吗?有没有其他方案?
回答:不一定。如果每个线程都有自己的 StringBuilder 实例,压根不存在共享,用 StringBuilder 就行。只有多个线程要操作同一个可变字符串对象时才需要同步。另一个方案是用 ThreadLocal 包一层 StringBuilder,每个线程用自己的实例,既避免了同步开销,又不用担心线程安全问题。
6. Java 的 StringBuilder 是怎么实现的?
6.1. 核心要点
StringBuilder 底层就是一个可扩容的字符数组加一个 count 变量。
核心数据结构很简单,继承自 AbstractStringBuilder:
abstract class AbstractStringBuilder {
    char[] value;  // 存字符的数组,JDK 9 之后改成了 byte[]
    int count;     // 实际存了多少个字符
}
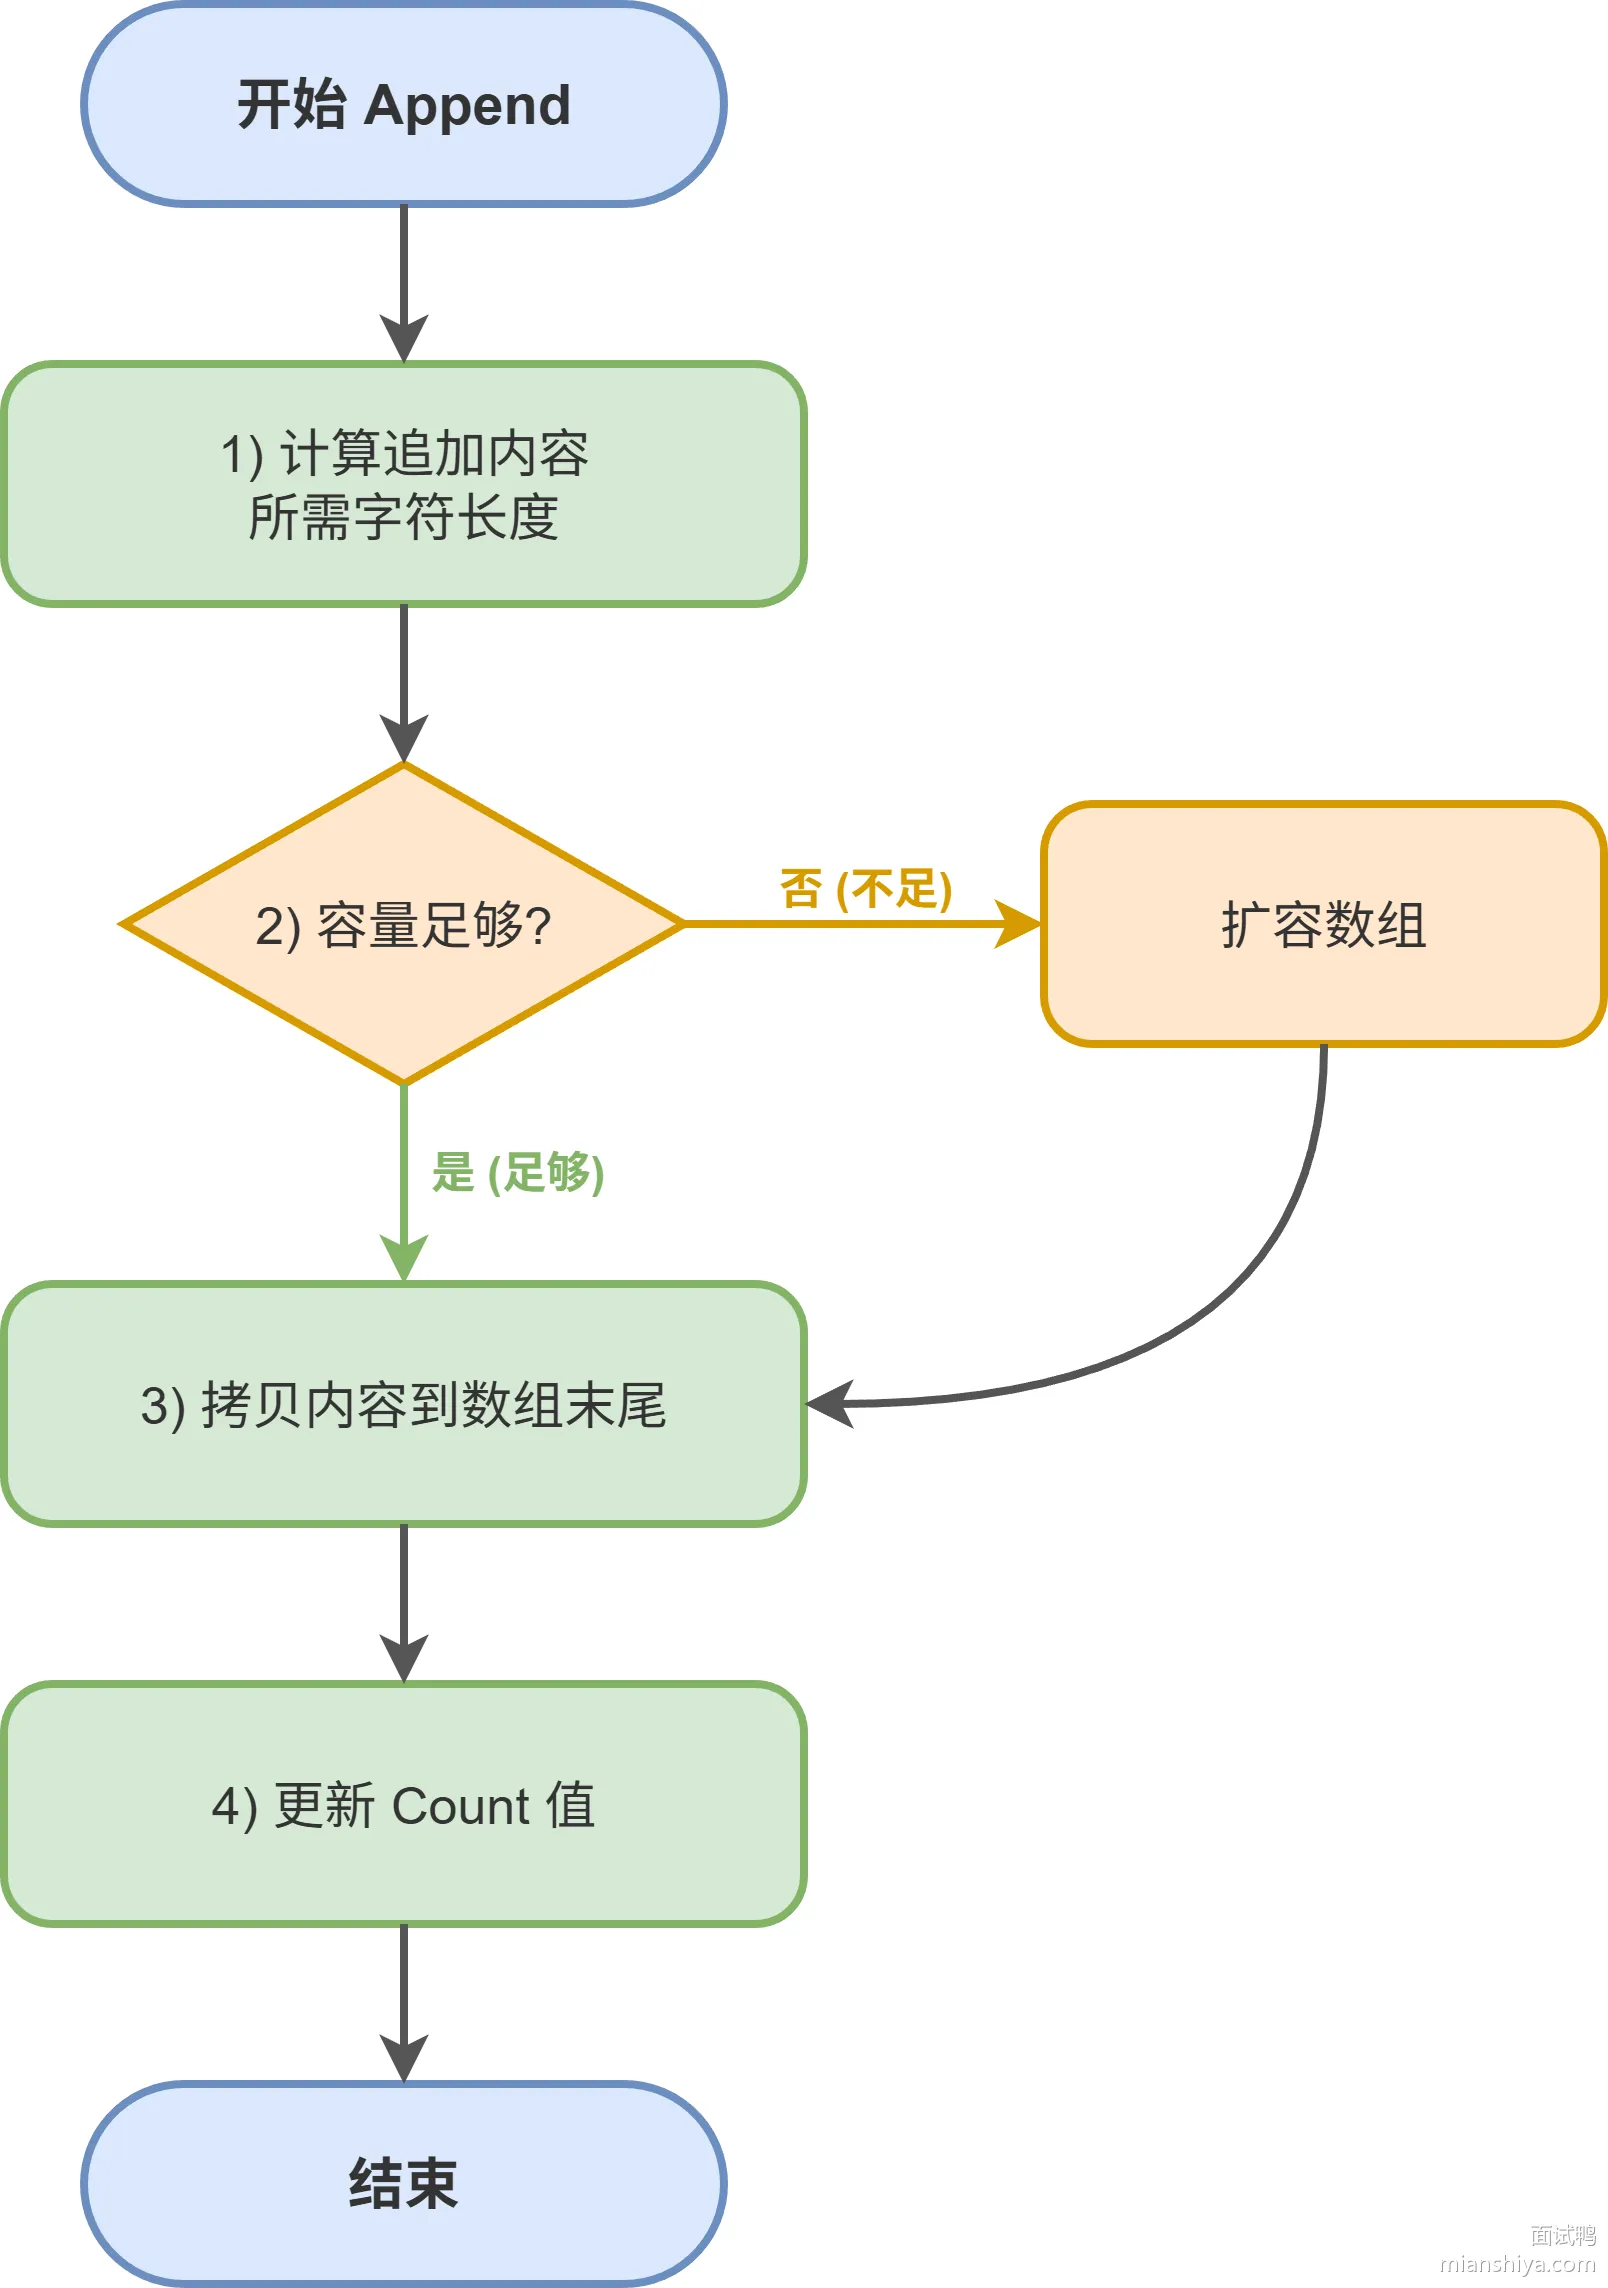
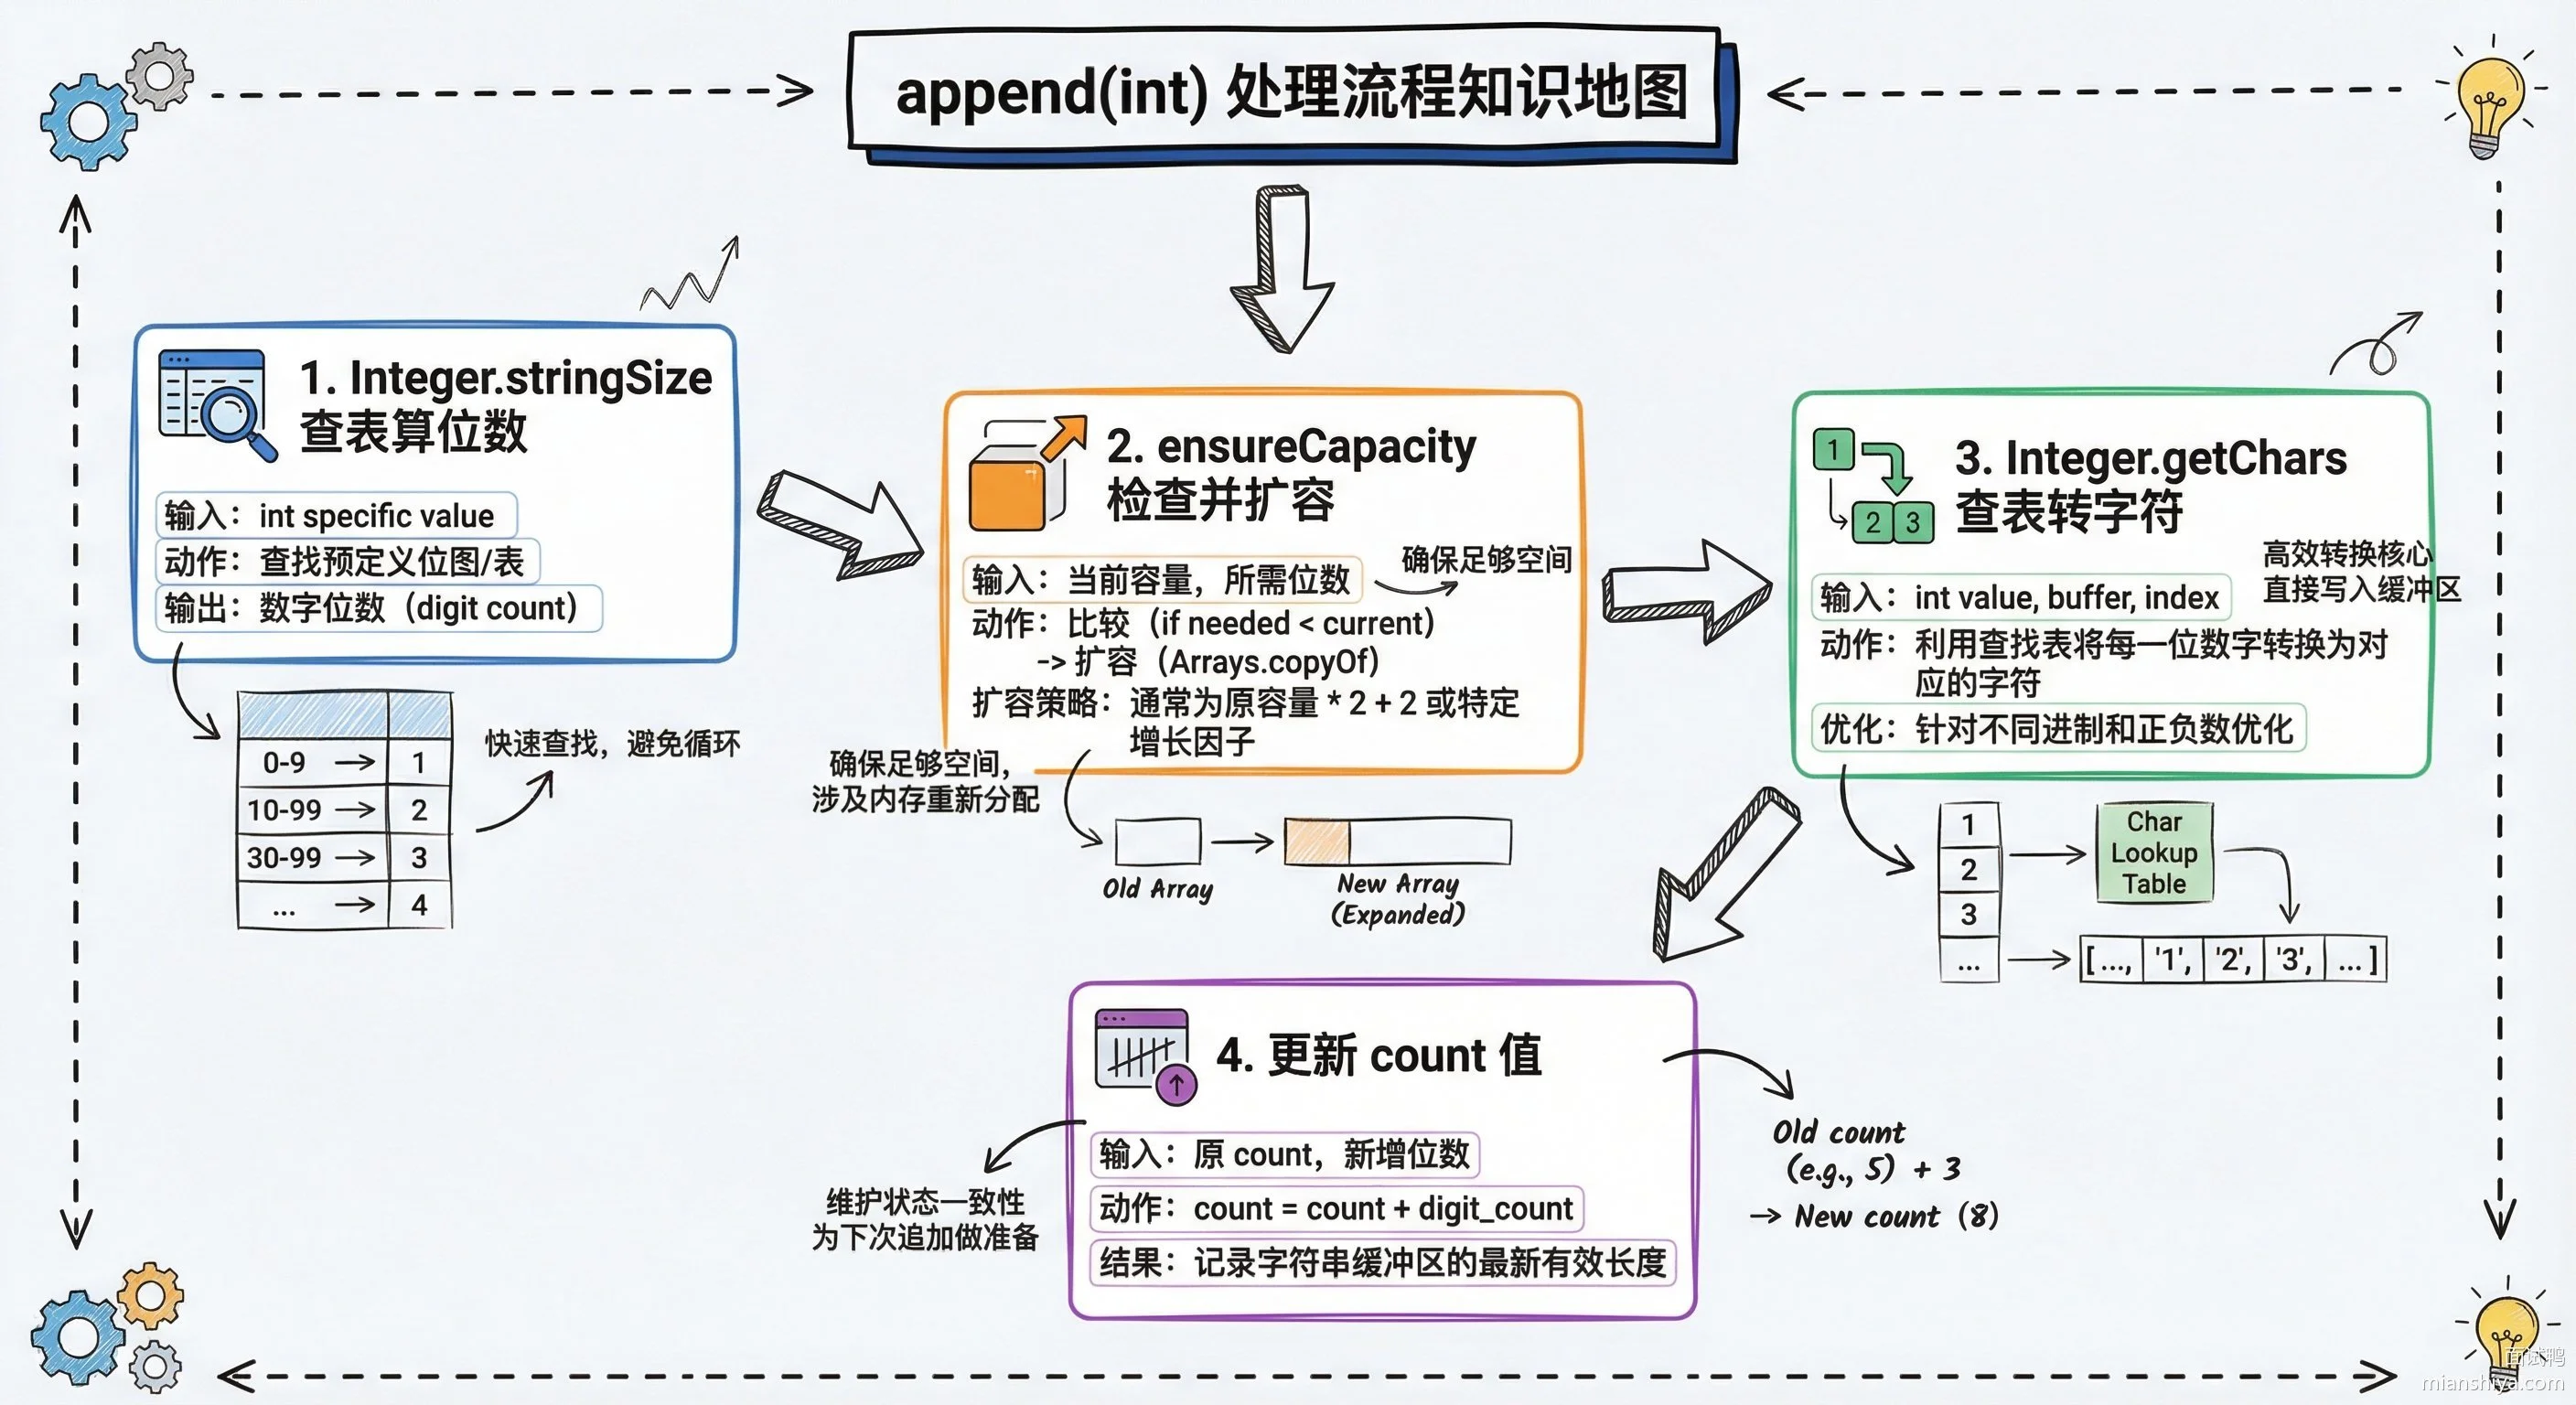
append 操作的流程: 1)先算一下要追加的内容转成字符需要占几位 2)检查当前数组容量够不够,不够就扩容 3)把内容拷贝到数组末尾 4)更新 count 值
扩容策略是原容量乘 2 再加 2,比如当前容量 16,扩容后就是 34。扩容本质就是 Arrays.copyOf,创建新数组把旧数据拷过去,开销不小。所以创建 StringBuilder 时最好预估最终长度,用带参构造函数指定初始容量。
// 如果知道最终长度大概 1000 字符
StringBuilder sb = new StringBuilder(1000);
insert 和 delete 也是数组操作。insert 要先把插入位置后面的元素往后挪,腾出空间再插入;delete 就是把后面的元素往前挪,覆盖掉要删除的部分。
6.2. 扩展知识
6.2.1. append 如何处理不同类型
append 有一堆重载方法,int、long、double、Object 都能往里塞。以 append(int) 为例
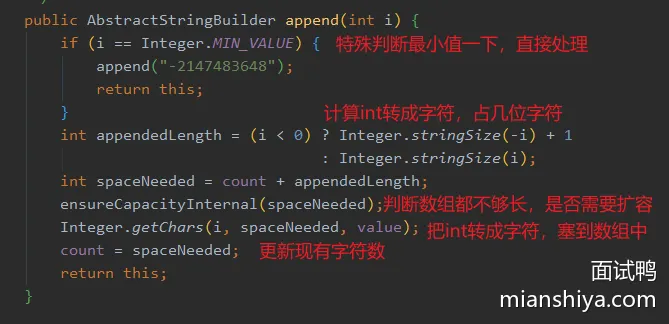
主要分两步:
1)先用 Integer.stringSize 算出这个 int 转成字符串需要几位。这里用的是查表法,直接列出各个位数的边界值:
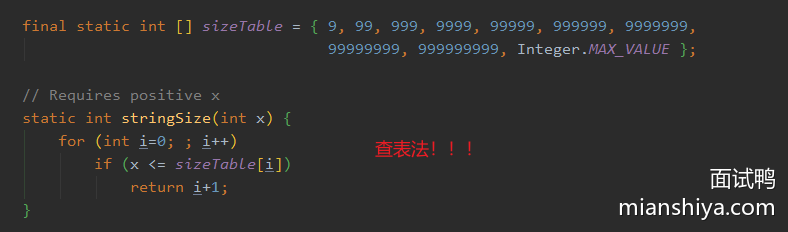
拿 int 值跟这些边界值比大小,就能快速知道需要几位,比一位一位算快多了。
2)再用 Integer.getChars 把 int 转成字符写入数组。
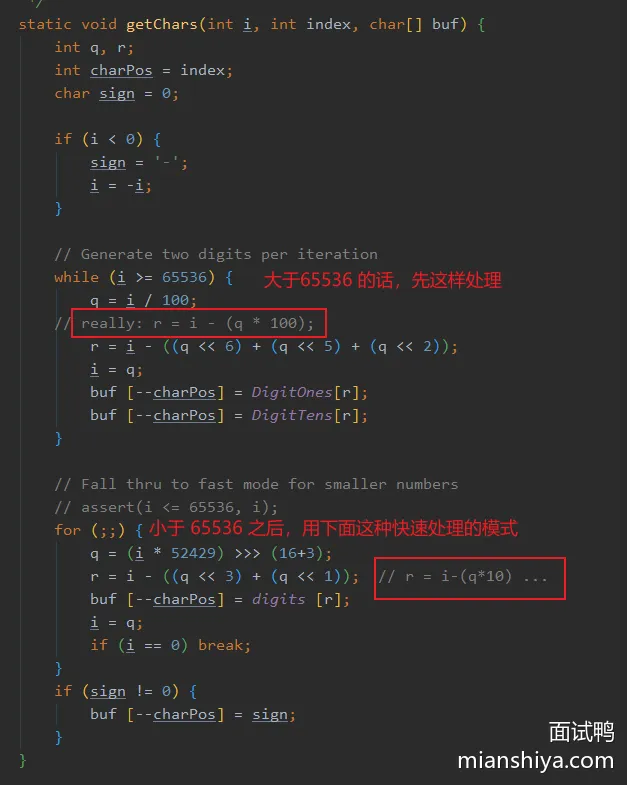
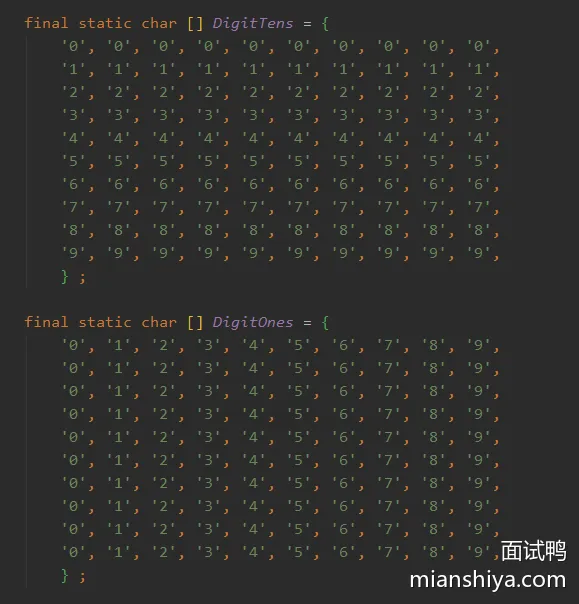
这里也有技巧,每次处理两位数字,也用查表法(DigitOnes 和 DigitTens)直接查出对应的字符,减少除法和取模运算次数。
6.2.2. JDK 9 的底层改造
JDK 9 把 char 数组换成了 byte 数组,同时加了个 coder 字段标记编码:
abstract class AbstractStringBuilder {
    byte[] value;
    byte coder;  // LATIN1=0, UTF16=1
}
为什么改?char 固定占 2 字节,但大部分英文、数字只需要 1 字节。改成 byte 数组后,纯 Latin-1 字符串内存直接砍半。
append 的时候会根据 coder 走不同分支:
public AbstractStringBuilder append(String str) {
    if (isLatin1()) {
        // Latin-1 编码,1 字符 1 字节
    } else {
        // UTF-16 编码,1 字符 2 字节
    }
}
如果往一个 Latin-1 的 StringBuilder 里追加了中文,会触发编码升级,把整个 byte 数组从 Latin-1 转成 UTF-16。
6.2.3. 为什么扩容是 2 倍加 2
扩容代码长这样:
private int newCapacity(int minCapacity) {
    int newCapacity = (value.length << 1) + 2;
    if (newCapacity - minCapacity < 0) {
        newCapacity = minCapacity;
    }
    // ...
}
乘 2 是为了均摊复杂度,每次扩容翻倍能保证 n 次 append 的总扩容次数是 O(log n)。加 2 主要是处理边界情况,比如初始容量是 0 的时候,乘 2 还是 0,加 2 之后至少有空间用。
6.2.4. StringBuilder 没有缩容
源码里只有扩容逻辑,没有缩容。delete 删掉一大堆字符后,数组还是那么大,内存不会释放。
如果真的删了很多字符想省内存,可以手动调用 trimToSize 方法:
sb.delete(0, 10000);
sb.trimToSize();  // 把数组缩到 count 大小
不过一般不用管,StringBuilder 本来就是临时用的,用完就被 GC 回收了。
6.2.5. 和 StringBuffer 的区别
StringBuilder 和 StringBuffer 都继承自 AbstractStringBuilder,代码几乎一模一样,唯一区别是 StringBuffer 的方法都加了 synchronized:
// StringBuffer 的 append
@Override
public synchronized StringBuffer append(String str) {
    toStringCache = null;
    super.append(str);
    return this;
}
StringBuffer 还多了个 toStringCache 字段,调用 toString 时会缓存结果,下次再调直接返回。但只要调了任何修改方法,缓存就失效了。这个优化在实际场景下意义不大,因为很少有人会反复调 toString 而中间不修改内容。
6.3. 常见问题
6.3.1. String 底层也是 char 数组,为什么 String 不可变而 StringBuilder 可变?
回答:关键在于 String 的 char 数组被 private final 修饰,而且 String 类本身是 final 的,没有任何方法能修改这个数组的内容。StringBuilder 的数组虽然也是 private 的,但它提供了 append、insert 这些公开方法来修改数组内容,而且数组引用不是 final 的,扩容时可以换成新数组。
6.3.2. StringBuilder 的初始容量是多少?不传参数的话默认多大?
回答:默认 16 个字符。无参构造函数里写死了 super(16)。如果第一次 append 的字符串长度超过 16,会立刻触发扩容。所以如果知道大概要拼多长的字符串,最好指定初始容量。
6.3.3. StringBuilder 是线程安全的吗?多线程下会出什么问题?
回答:不安全。多线程同时 append 会出问题。比如两个线程同时判断容量够用,都不扩容,然后同时往数组写数据,其中一个线程的数据就被另一个覆盖了。更严重的是 count 变量的并发更新,可能导致最终 count 值不对,toString 的时候内容就乱了。
6.3.4. 循环里拼接字符串,编译器不是会优化成 StringBuilder 吗?为什么还要手动写?
回答:编译器的优化是针对单条语句的。比如 a + b + c 会优化成 new StringBuilder().append(a).append(b).append(c).toString()。但循环里每次迭代都是独立的语句,每次都会 new 一个 StringBuilder,跟直接用 String 拼接没本质区别。所以循环里的拼接必须手动在循环外创建 StringBuilder,循环里只调 append。
7. 接口和抽象类有什么区别?
7.1. 核心要点
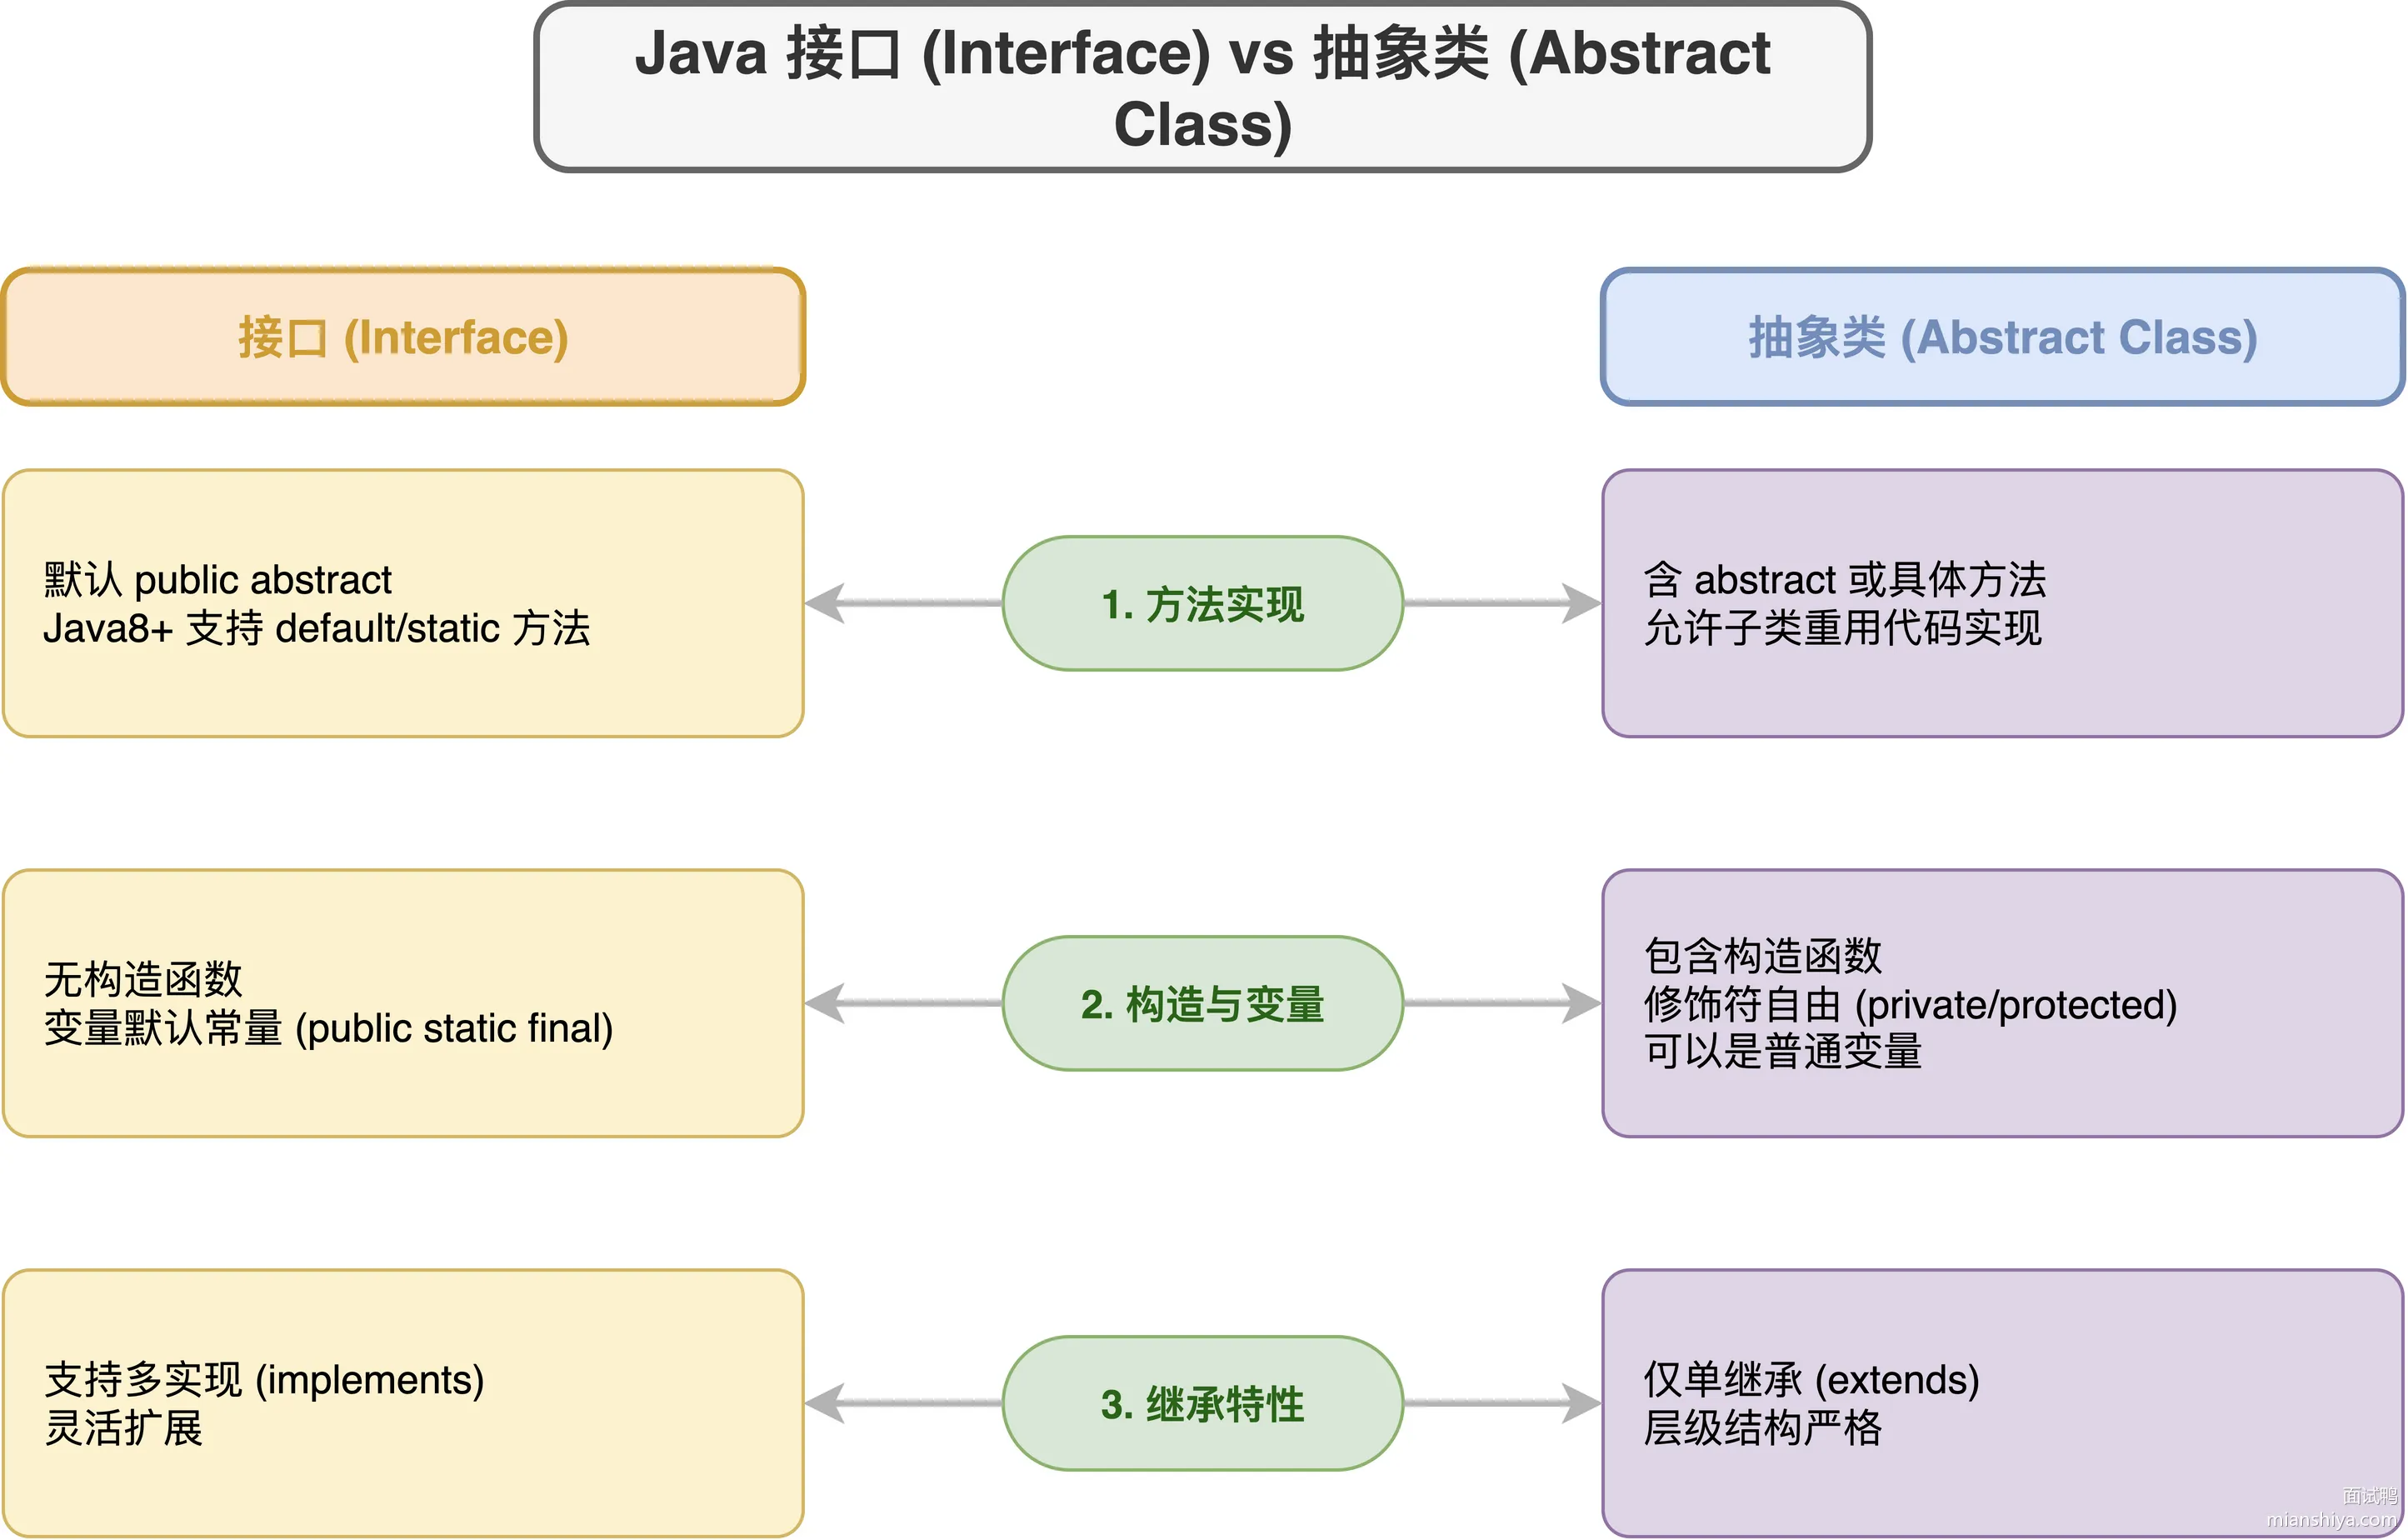
接口和抽象类在设计动机上有所不同。
接口的设计是自上而下的。我们知晓某一行为,于是基于这些行为约束定义了接口,一些类需要有这些行为,因此实现对应的接口。
抽象类的设计是自下而上的。我们写了很多类,发现它们之间有共性,有很多代码可以复用,因此将公共逻辑封装成一个抽象类,减少代码冗余。
所谓的自上而下指的是先约定接口,再实现。而自下而上的是先有一些类,才抽象了共同父类。可能和学校教的不太一样,但是实战中很多时候都是因为重构才有的抽象。
其他区别:
1)方法实现:接口中的方法默认是 public 和 abstract,但在 Java8 之后可以设置 default 方法或者静态方法。抽象类可以包含 abstract 方法和具体方法,允许子类继承并重用抽象类中的方法实现。
2)构造函数和成员变量:接口不能包含构造函数,接口中的成员变量默认为 public static final,也就是常量。抽象类可以包含构造函数,成员变量可以有不同的访问修饰符如 private、protected、public,并且可以不是常量。
3)多继承:抽象类只能单继承,接口可以有多个实现。扩展可看:为什么 Java 不支持多重继承?
7.2. 扩展知识
7.2.1. 接口的演变
| Java 版本 | 新特性 | 说明 |
|---|---|---|
| Java 8 | default 方法、static 方法 | 接口不仅是方法声明,还可以提供具体实现 |
| Java 9 | 私有方法 | 用于 default 方法的内部逻辑复用 |
| Java 17 | sealed 接口 | 限定只有特定子类可以实现该接口 |
Java 8 引入 default 方法是一个重大变化。在此之前,给接口加一个新方法,所有实现类都得改代码补上实现,维护成本很高。有了 default 方法,接口可以提供默认实现,老代码不用动就能兼容新方法。
Java 9 的私有方法主要是解决代码复用问题。如果多个 default 方法有重复逻辑,以前只能复制粘贴,现在可以抽到私有方法里统一调用。
7.2.2. 如何选择接口还是抽象类
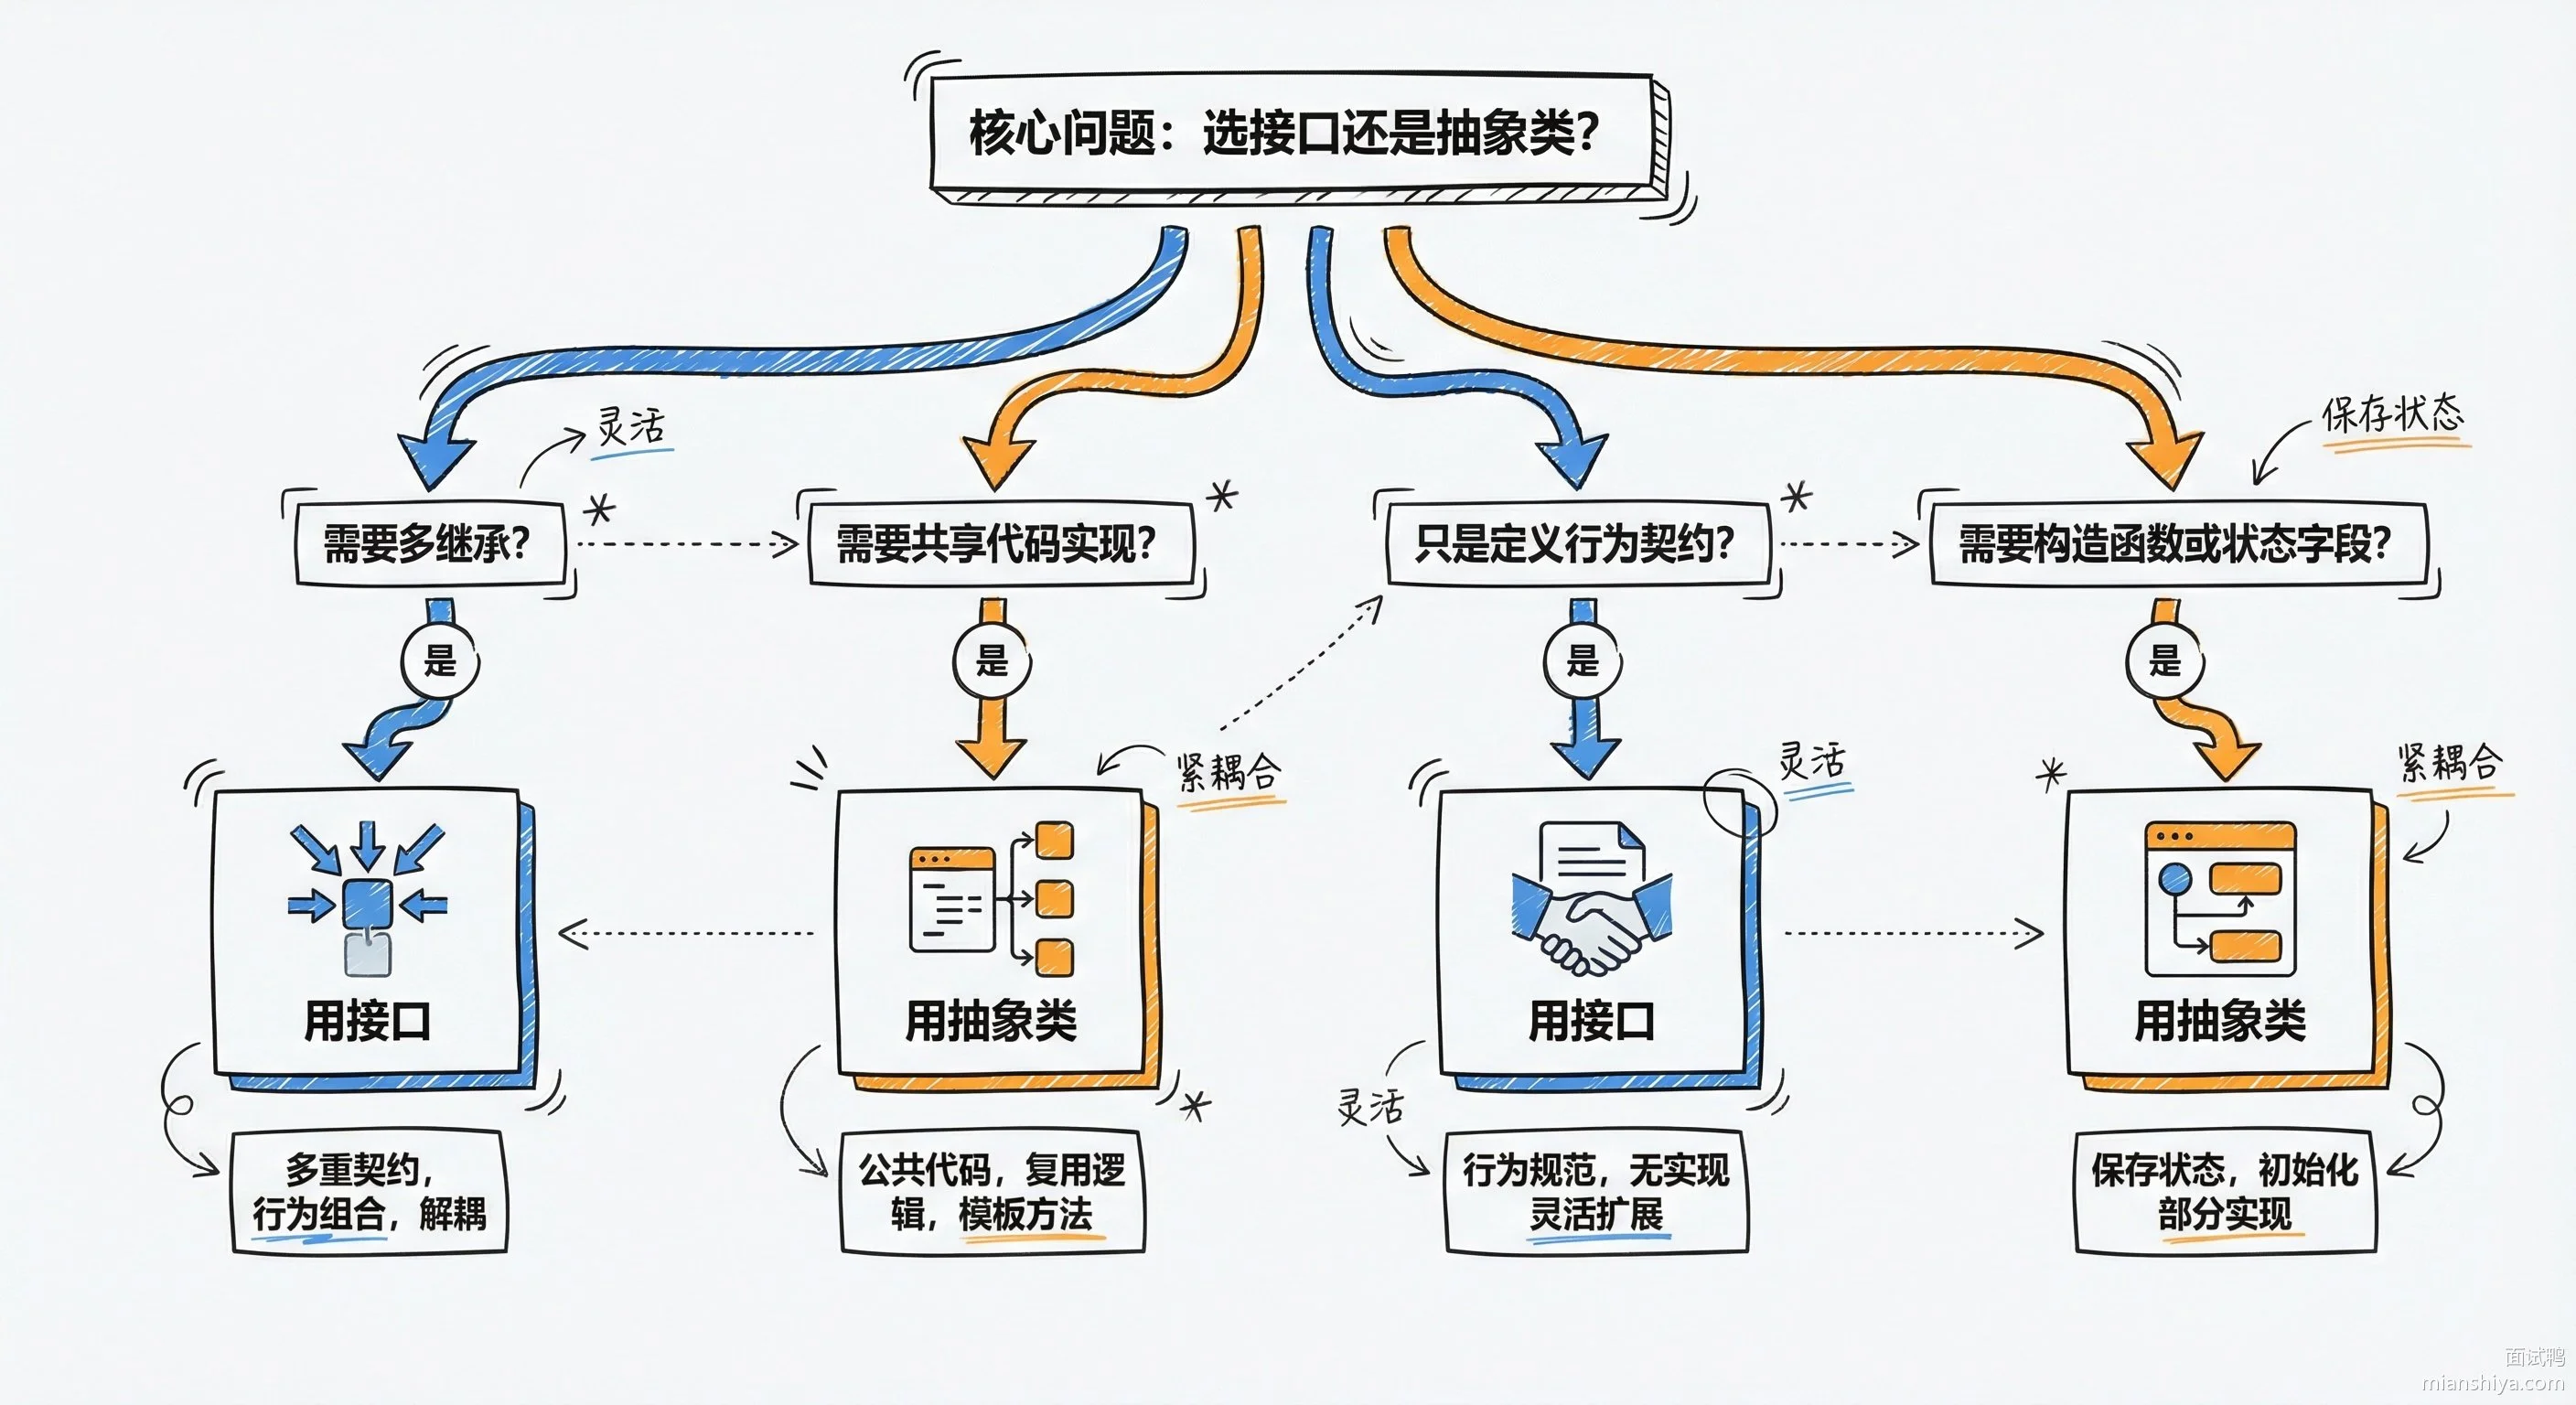
选择的核心原则:
1)如果只是定义一组行为规范,不涉及状态和实现细节,优先用接口。比如 Comparable、Serializable、Runnable 这些都是典型的接口使用场景。
2)如果有公共代码需要复用,比如模板方法模式里的骨架逻辑,用抽象类更合适。像 AbstractList、AbstractMap 这些就是抽象类的经典应用。
3)如果一个类需要具备多种能力,只能用接口,因为 Java 不支持多继承。比如一个类既要能排序又要能序列化,只能同时实现 Comparable 和 Serializable 两个接口。
7.2.3. 实际项目中的使用场景
Spring 框架大量使用接口做依赖注入,Controller 层调 Service 接口,Service 实现类可以随时替换,这就是面向接口编程的好处。
MyBatis 的 Mapper 接口就是典型的接口使用,根本不需要实现类,框架动态代理帮你生成。
模板方法模式一般用抽象类,比如 HttpServlet 的 doGet、doPost,父类定好骨架流程,子类只管实现具体步骤。
7.3. 常见问题
7.3.1. Java 8 的 default 方法会不会导致多继承的问题?
回答:会有类似的问题。如果一个类实现了两个接口,这两个接口有同名的 default 方法,编译器会报错,必须在实现类里显式重写这个方法来解决冲突。可以用 InterfaceA.super.method() 这种语法指定调用哪个接口的默认实现。
7.3.2. 抽象类能不能有构造函数?有什么用?
回答:可以有。抽象类的构造函数不是给自己用的,抽象类本身不能被实例化。它的构造函数是给子类调用的,子类构造的时候会先调父类的构造函数。一般用来初始化抽象类中定义的成员变量,或者做一些通用的校验逻辑。
7.3.3. 接口里的变量为什么默认是 public static final?
回答:接口的设计初衷是定义行为契约,不是用来存状态的。变量设成 final 就是常量,不会变;设成 static 是因为接口不能实例化,只能通过类名访问;设成 public 是因为接口就是给别人用的,没必要藏着。这三个修饰符组合起来,就是说接口只能定义公开的类级别常量。
7.3.4. 一个类可以同时继承抽象类和实现接口吗?
回答:可以。Java 允许一个类继承一个抽象类的同时实现多个接口。这也是 Java 解决单继承限制的常用手段,核心代码复用放抽象类里,额外的能力通过接口来补充。比如 class Dog extends Animal implements Runnable, Comparable<Dog>,Animal 提供动物的通用属性和方法,Runnable 和 Comparable 提供额外能力。
8. JDK 和 JRE 有什么区别?
8.1. 核心要点
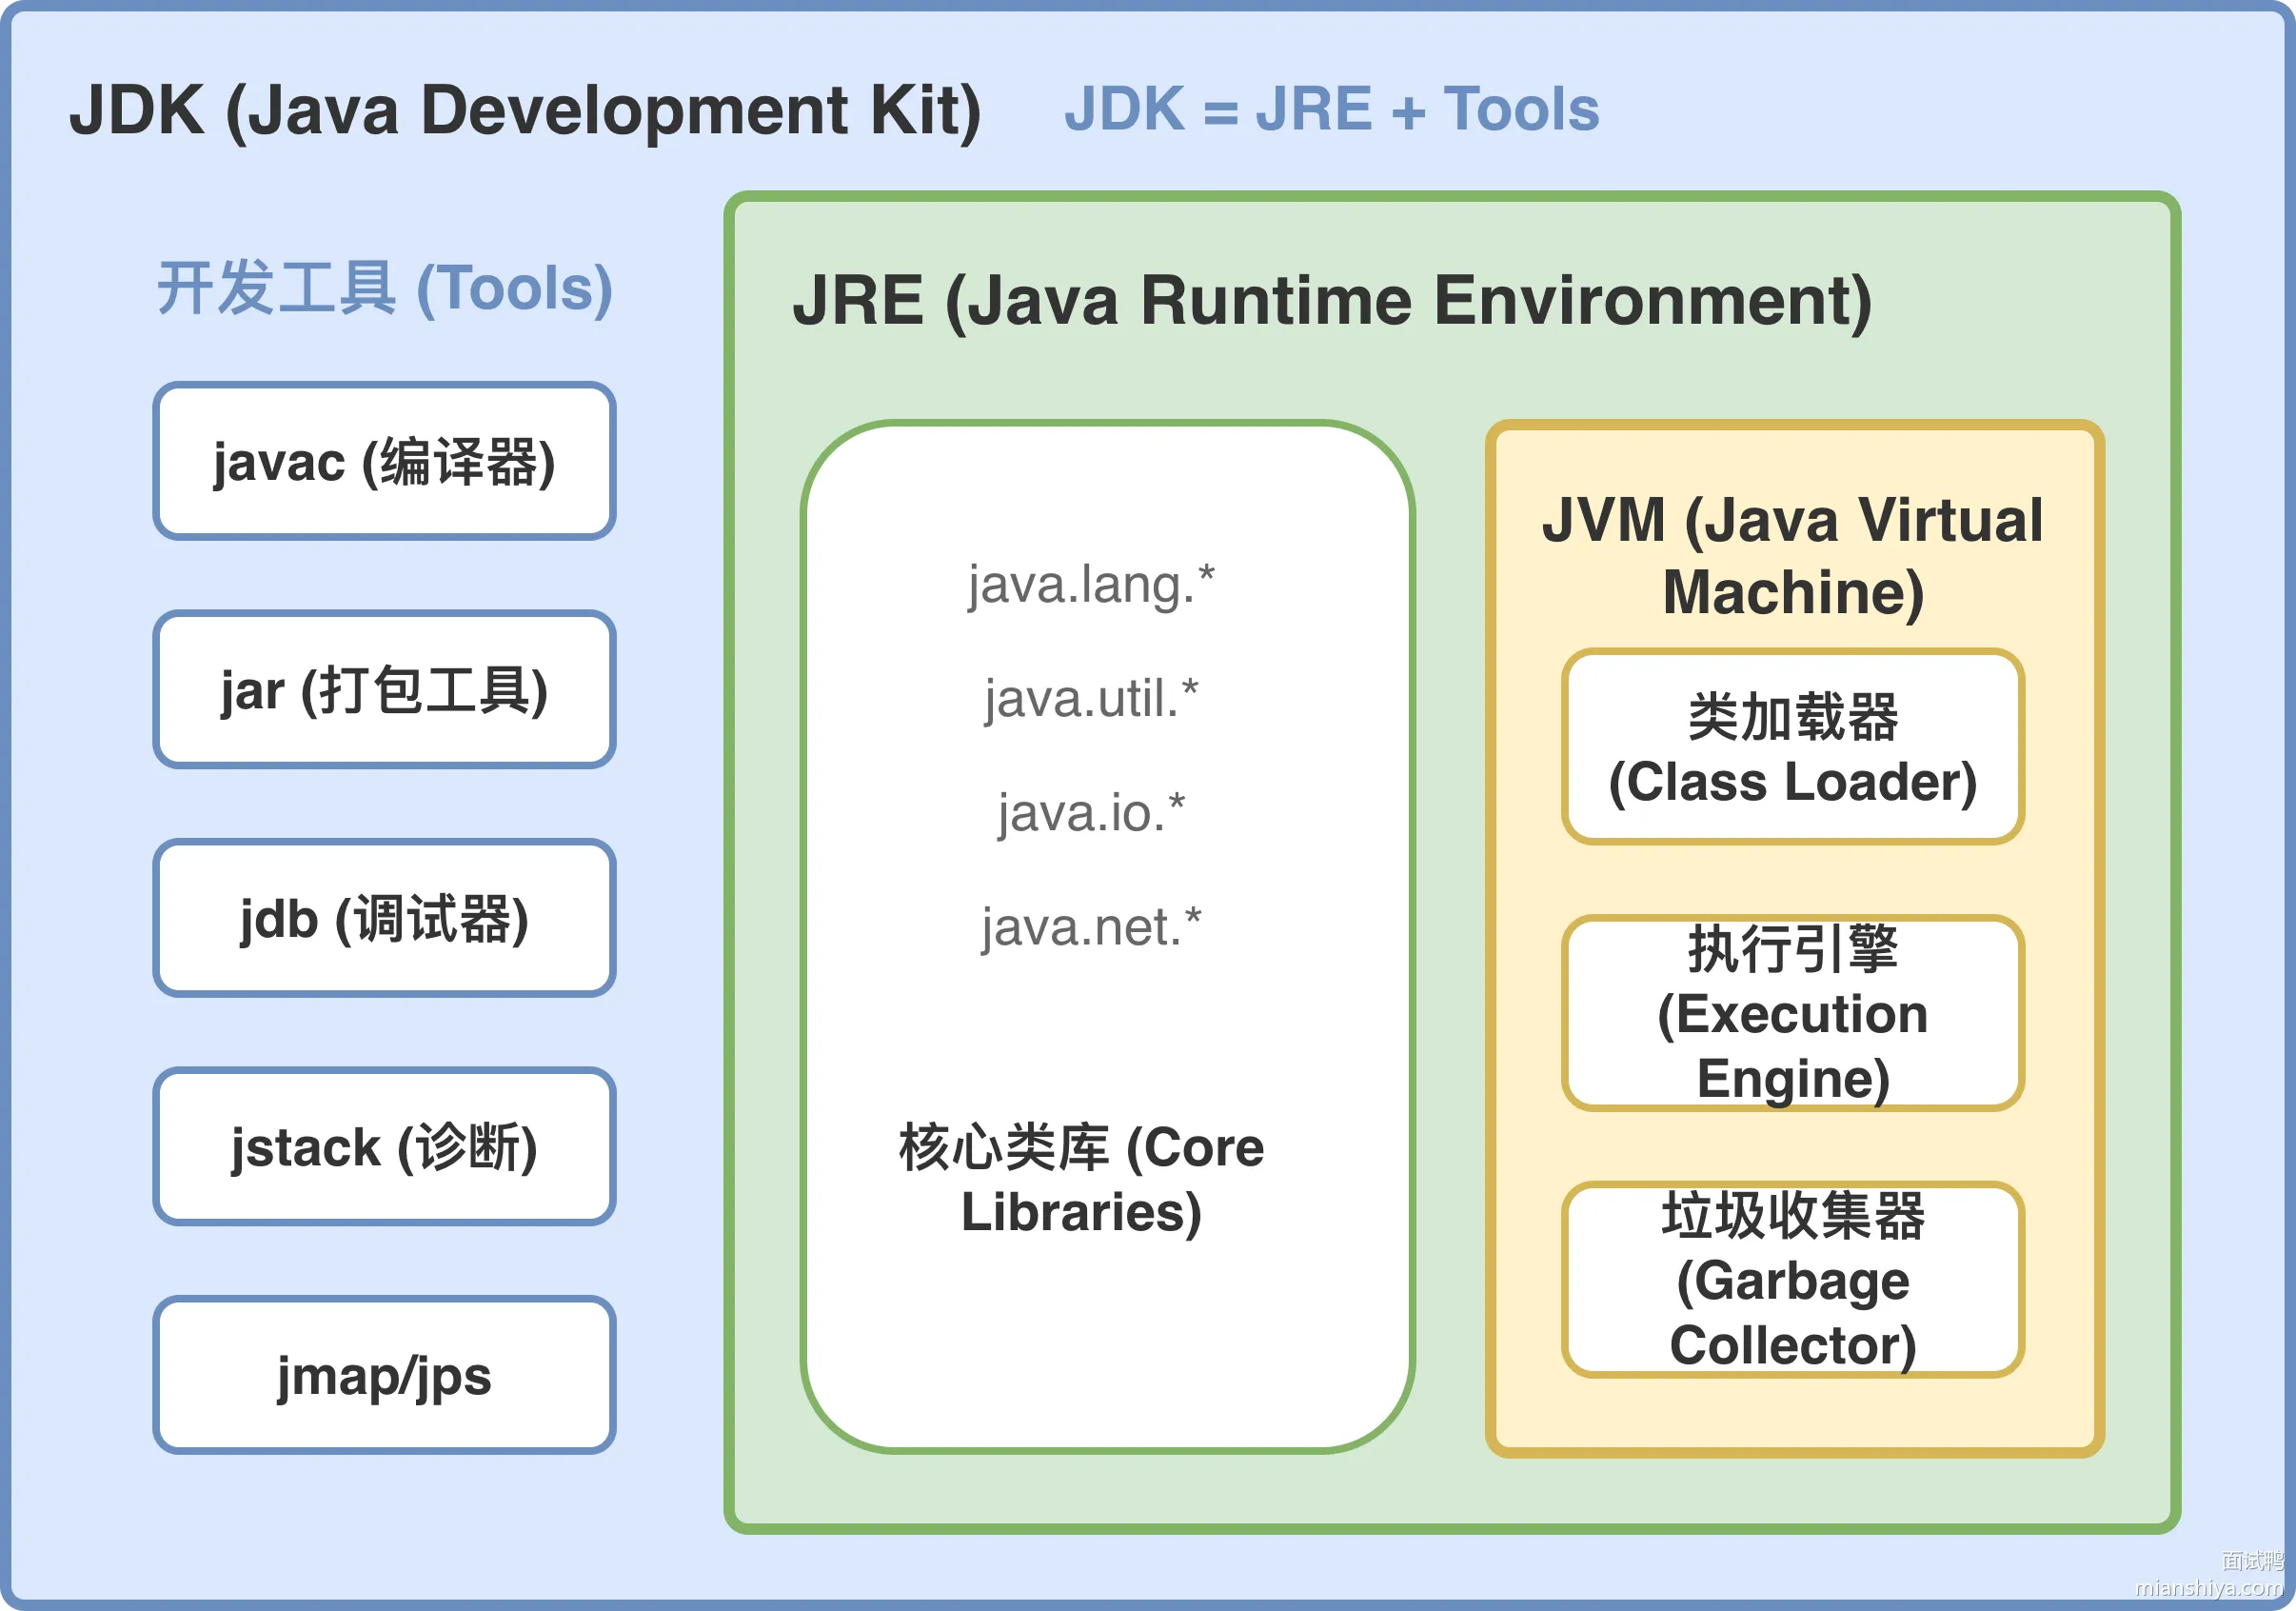
JRE 是 Java 运行环境,只能跑 Java 程序;JDK 是 Java 开发工具包,既能跑程序,又能写程序、编译程序。简单讲,JDK 包含了 JRE,再加上一堆开发工具。
JRE 里面有什么:
1)JVM,负责执行字节码 2)核心类库,比如 java.lang、java.util 这些标准 API 3)一些配置文件和本地库
JDK 在 JRE 基础上多了:
1)编译器 javac,把 .java 文件编成 .class 字节码 2)调试器 jdb,排查问题用 3)打包工具 jar,把一堆 class 文件打成一个包 4)各种监控诊断工具,比如 jps、jstack、jmap
8.2. 扩展知识
8.2.1. JDK 9 之后的重大变化
JDK 9 引入了模块化系统 JPMS,彻底改变了 JDK 和 JRE 的关系。在 JDK 8 及之前,Oracle 官网会单独提供 JRE 下载,服务器上只需要跑程序不用开发,装个 JRE 就够了,省空间。
但从 JDK 9 开始,Oracle 不再单独发布 JRE 了。原因是模块化之后,你可以用 jlink 工具按需裁剪运行时镜像,只打包程序实际依赖的模块,体积比以前的完整 JRE 还小。比如一个简单的 Hello World 程序,裁剪后可能只有 30-40MB,比完整 JRE 的 200MB+ 小很多。
# 用 jlink 创建自定义运行时
jlink --module-path $JAVA_HOME/jmods \
      --add-modules java.base,java.logging \
      --output my-runtime
这个变化对部署影响挺大的。以前是"一个 JRE 跑所有 Java 程序",现在提倡"每个应用带自己的运行时",更像 Go 那种静态编译的风格。
8.2.2. 为什么 JVM 不直接执行源码
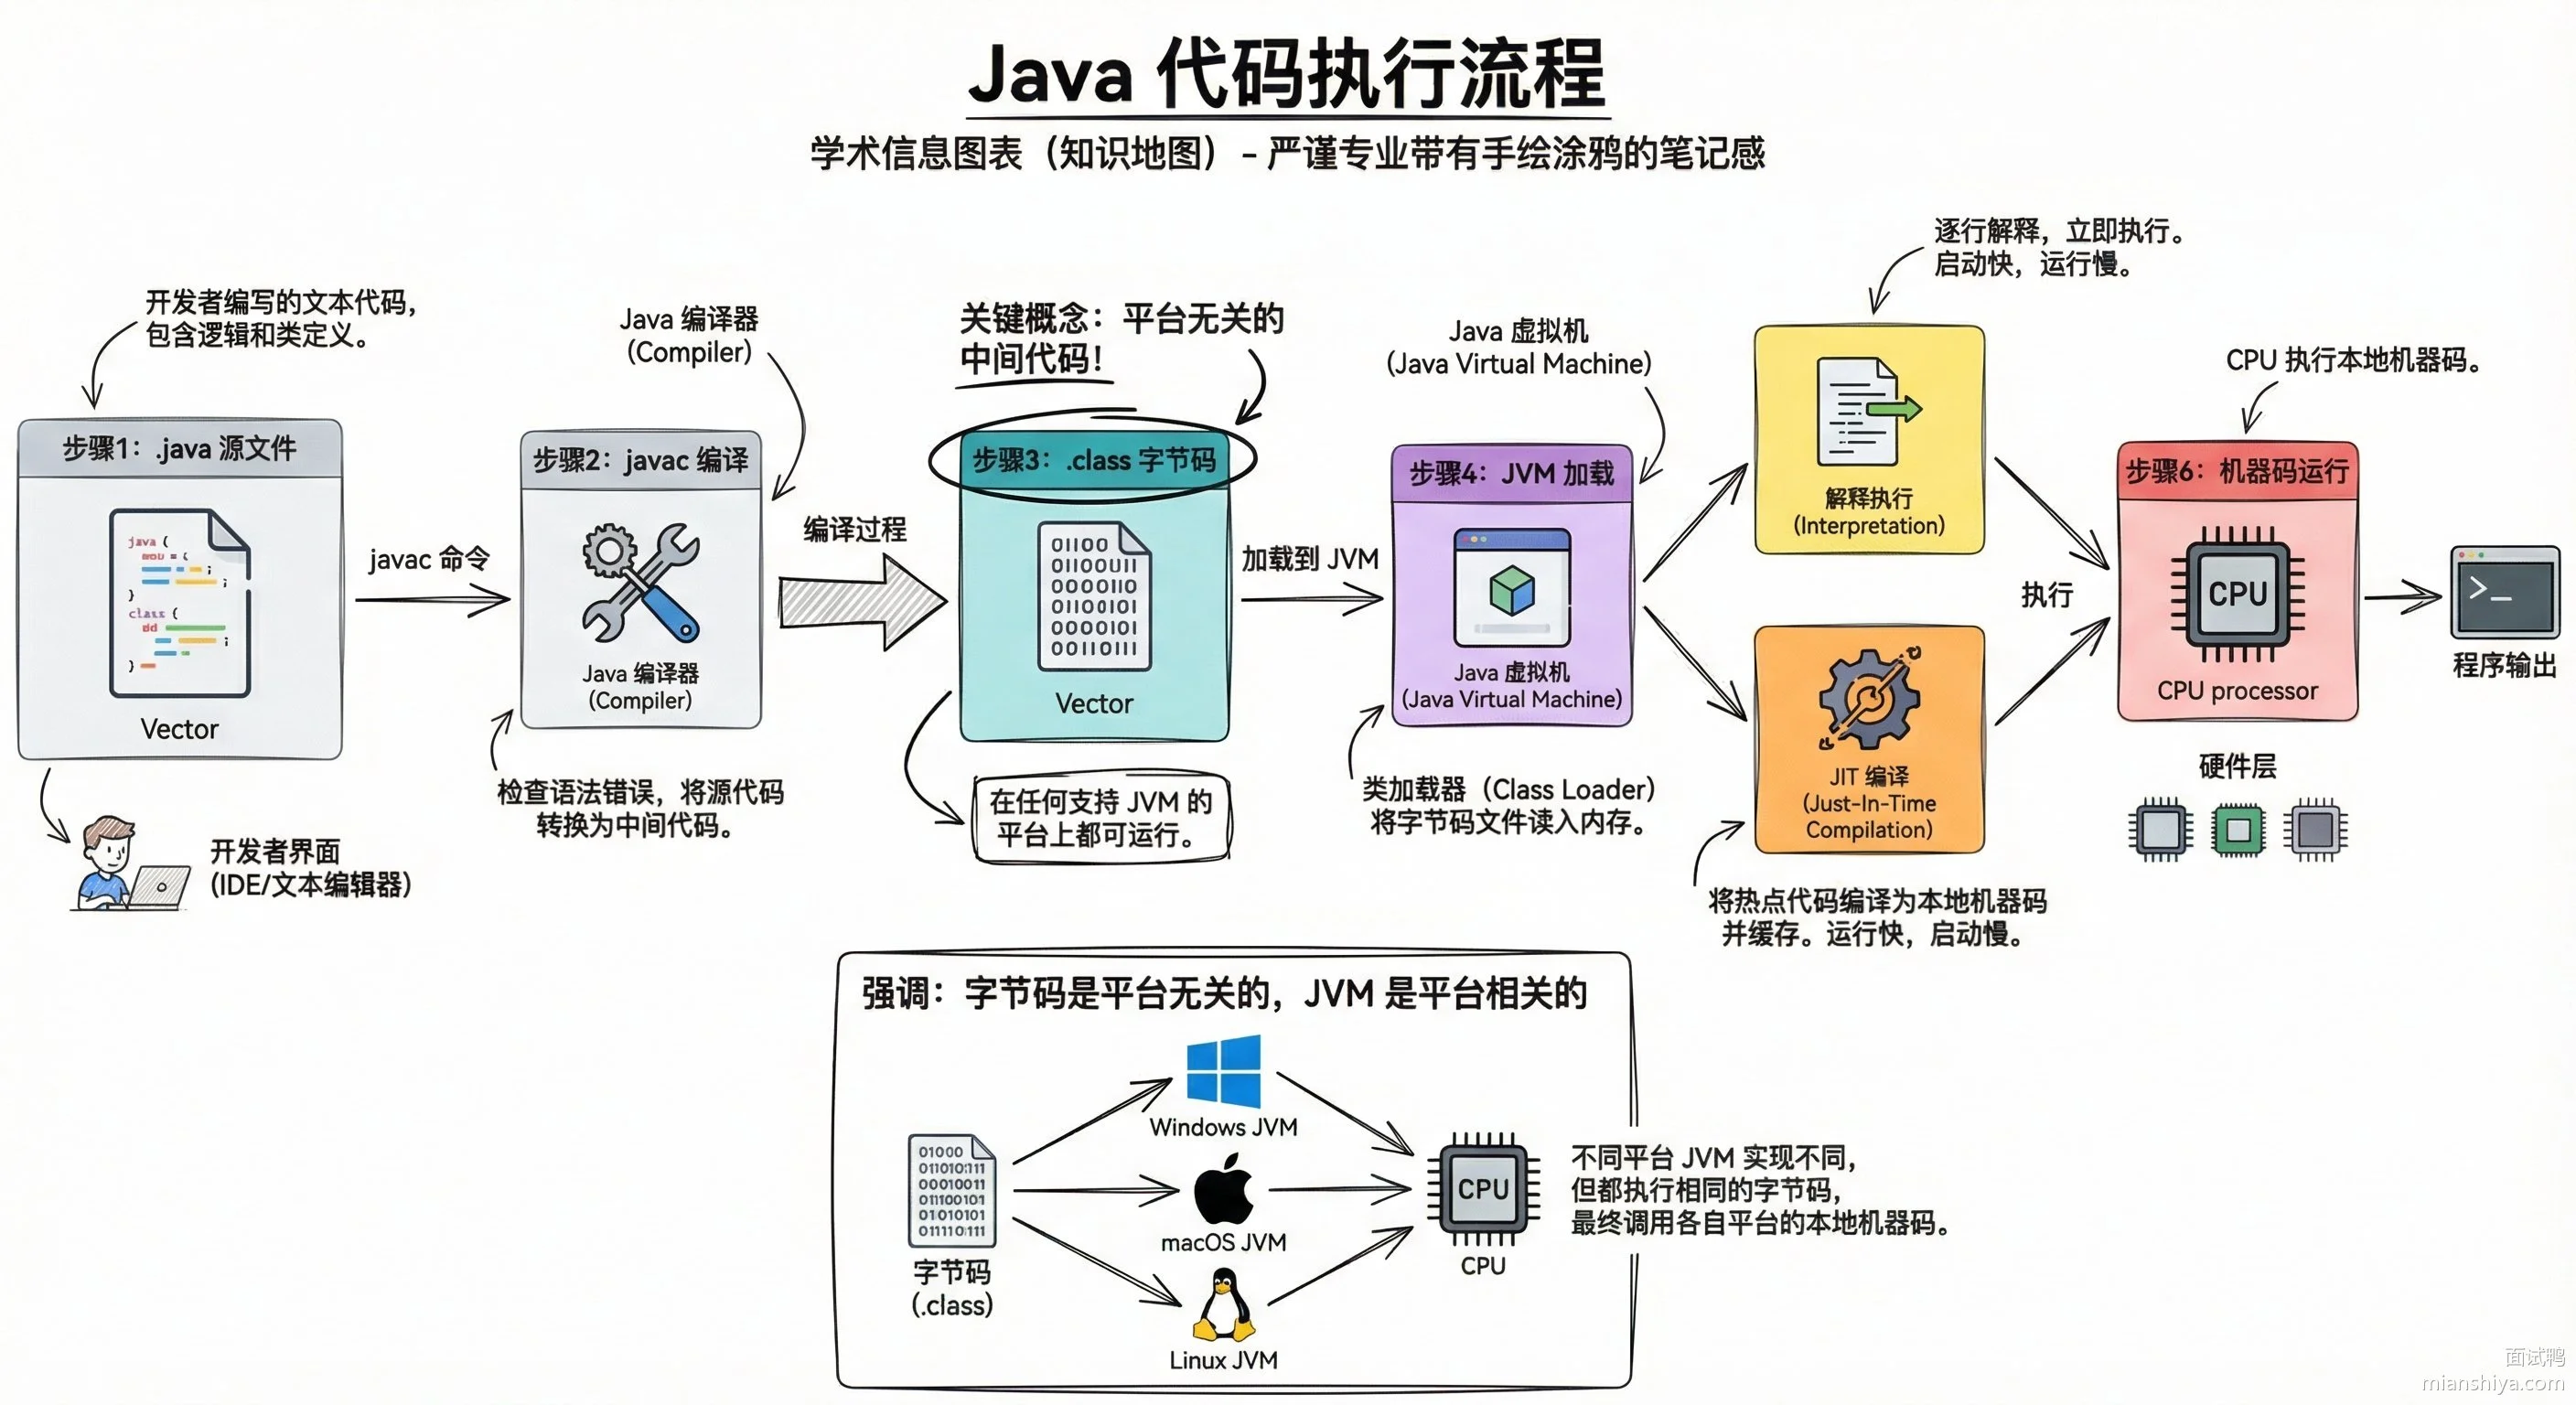
Java 设计之初就定下了"一次编译,到处运行"的目标。源码先编译成字节码,字节码在不同平台的 JVM 上都能跑,这样开发者不用针对 Windows、Linux、Mac 分别编译。
字节码是一种中间形态,比源码更接近机器码,但又不是真正的机器指令。JVM 在运行时把字节码翻译成当前平台的机器码,这个翻译过程就是 JIT 编译。热点代码会被 JIT 编译成本地机器码缓存起来,后面再执行就直接跑机器码,速度接近 C/C++。
8.2.3. 常见 JDK 发行版对比
除了 Oracle JDK,还有不少替代品:
| 发行版 | 维护方 | 特点 |
|---|---|---|
| Oracle JDK | Oracle | 商用收费,LTS 版本支持周期长 |
| OpenJDK | Oracle + 社区 | 开源免费,功能和 Oracle JDK 基本一致 |
| Amazon Corretto | AWS | 免费,AWS 环境优化,提供长期支持 |
| Azul Zulu | Azul | 免费 + 商业版,有专门的低延迟 GC |
| GraalVM | Oracle | 支持多语言,AOT 编译,适合云原生场景 |
生产环境选哪个?如果是部署在 AWS 上,Corretto 是首选;追求低延迟,Azul 的 Zing 版本有 C4 垃圾收集器;想做 Native Image 打包,GraalVM 更合适。
8.3. 常见问题
8.3.1. 生产环境只有 JRE 没有 JDK,怎么排查线上问题?
回答:没有 jstack、jmap 这些工具确实麻烦,但可以用 arthas 这种 agent 工具,不依赖 JDK 自带命令。arthas attach 到目标进程后,thread 命令看线程栈,heapdump 命令导堆快照,dashboard 看实时指标,基本能覆盖 JDK 工具的功能。另一个办法是把诊断工具单独拷到服务器上,jstack、jmap 这些其实只是可执行文件,不需要完整 JDK 也能用。
8.3.2. JDK 11 和 JDK 8 的 JRE 目录结构有什么不同?
回答:JDK 8 的目录里有独立的 jre 文件夹,里面是完整的运行时环境。JDK 11 之后这个 jre 文件夹没了,因为模块化之后整个 JDK 就是运行时,不再区分开发包和运行时。以前依赖 JAVA_HOME/jre/lib 路径的老代码可能会出问题,要改成 JAVA_HOME/lib。
8.3.3. 为什么 JDK 自带那么多诊断工具,像 jps、jstat 这些原理是什么?
回答:这些工具大部分是读取 JVM 暴露出来的信息。比如 jps 是读 /tmp/hsperfdata_<user> 目录下的文件,每个 Java 进程启动时会在这里写一个以 pid 命名的文件。jstat 也是读这个目录拿 GC 统计数据。jstack 和 jmap 则是通过 Attach API 连接到目标 JVM 进程,发送指令让 JVM 导出线程栈或堆信息。所以这些工具必须和目标进程是同一个用户启动的,不然没权限读取。
9. Java 中 hashCode 和 equals 方法是什么?它们与 == 操作符有什么区别?
9.1. 核心要点
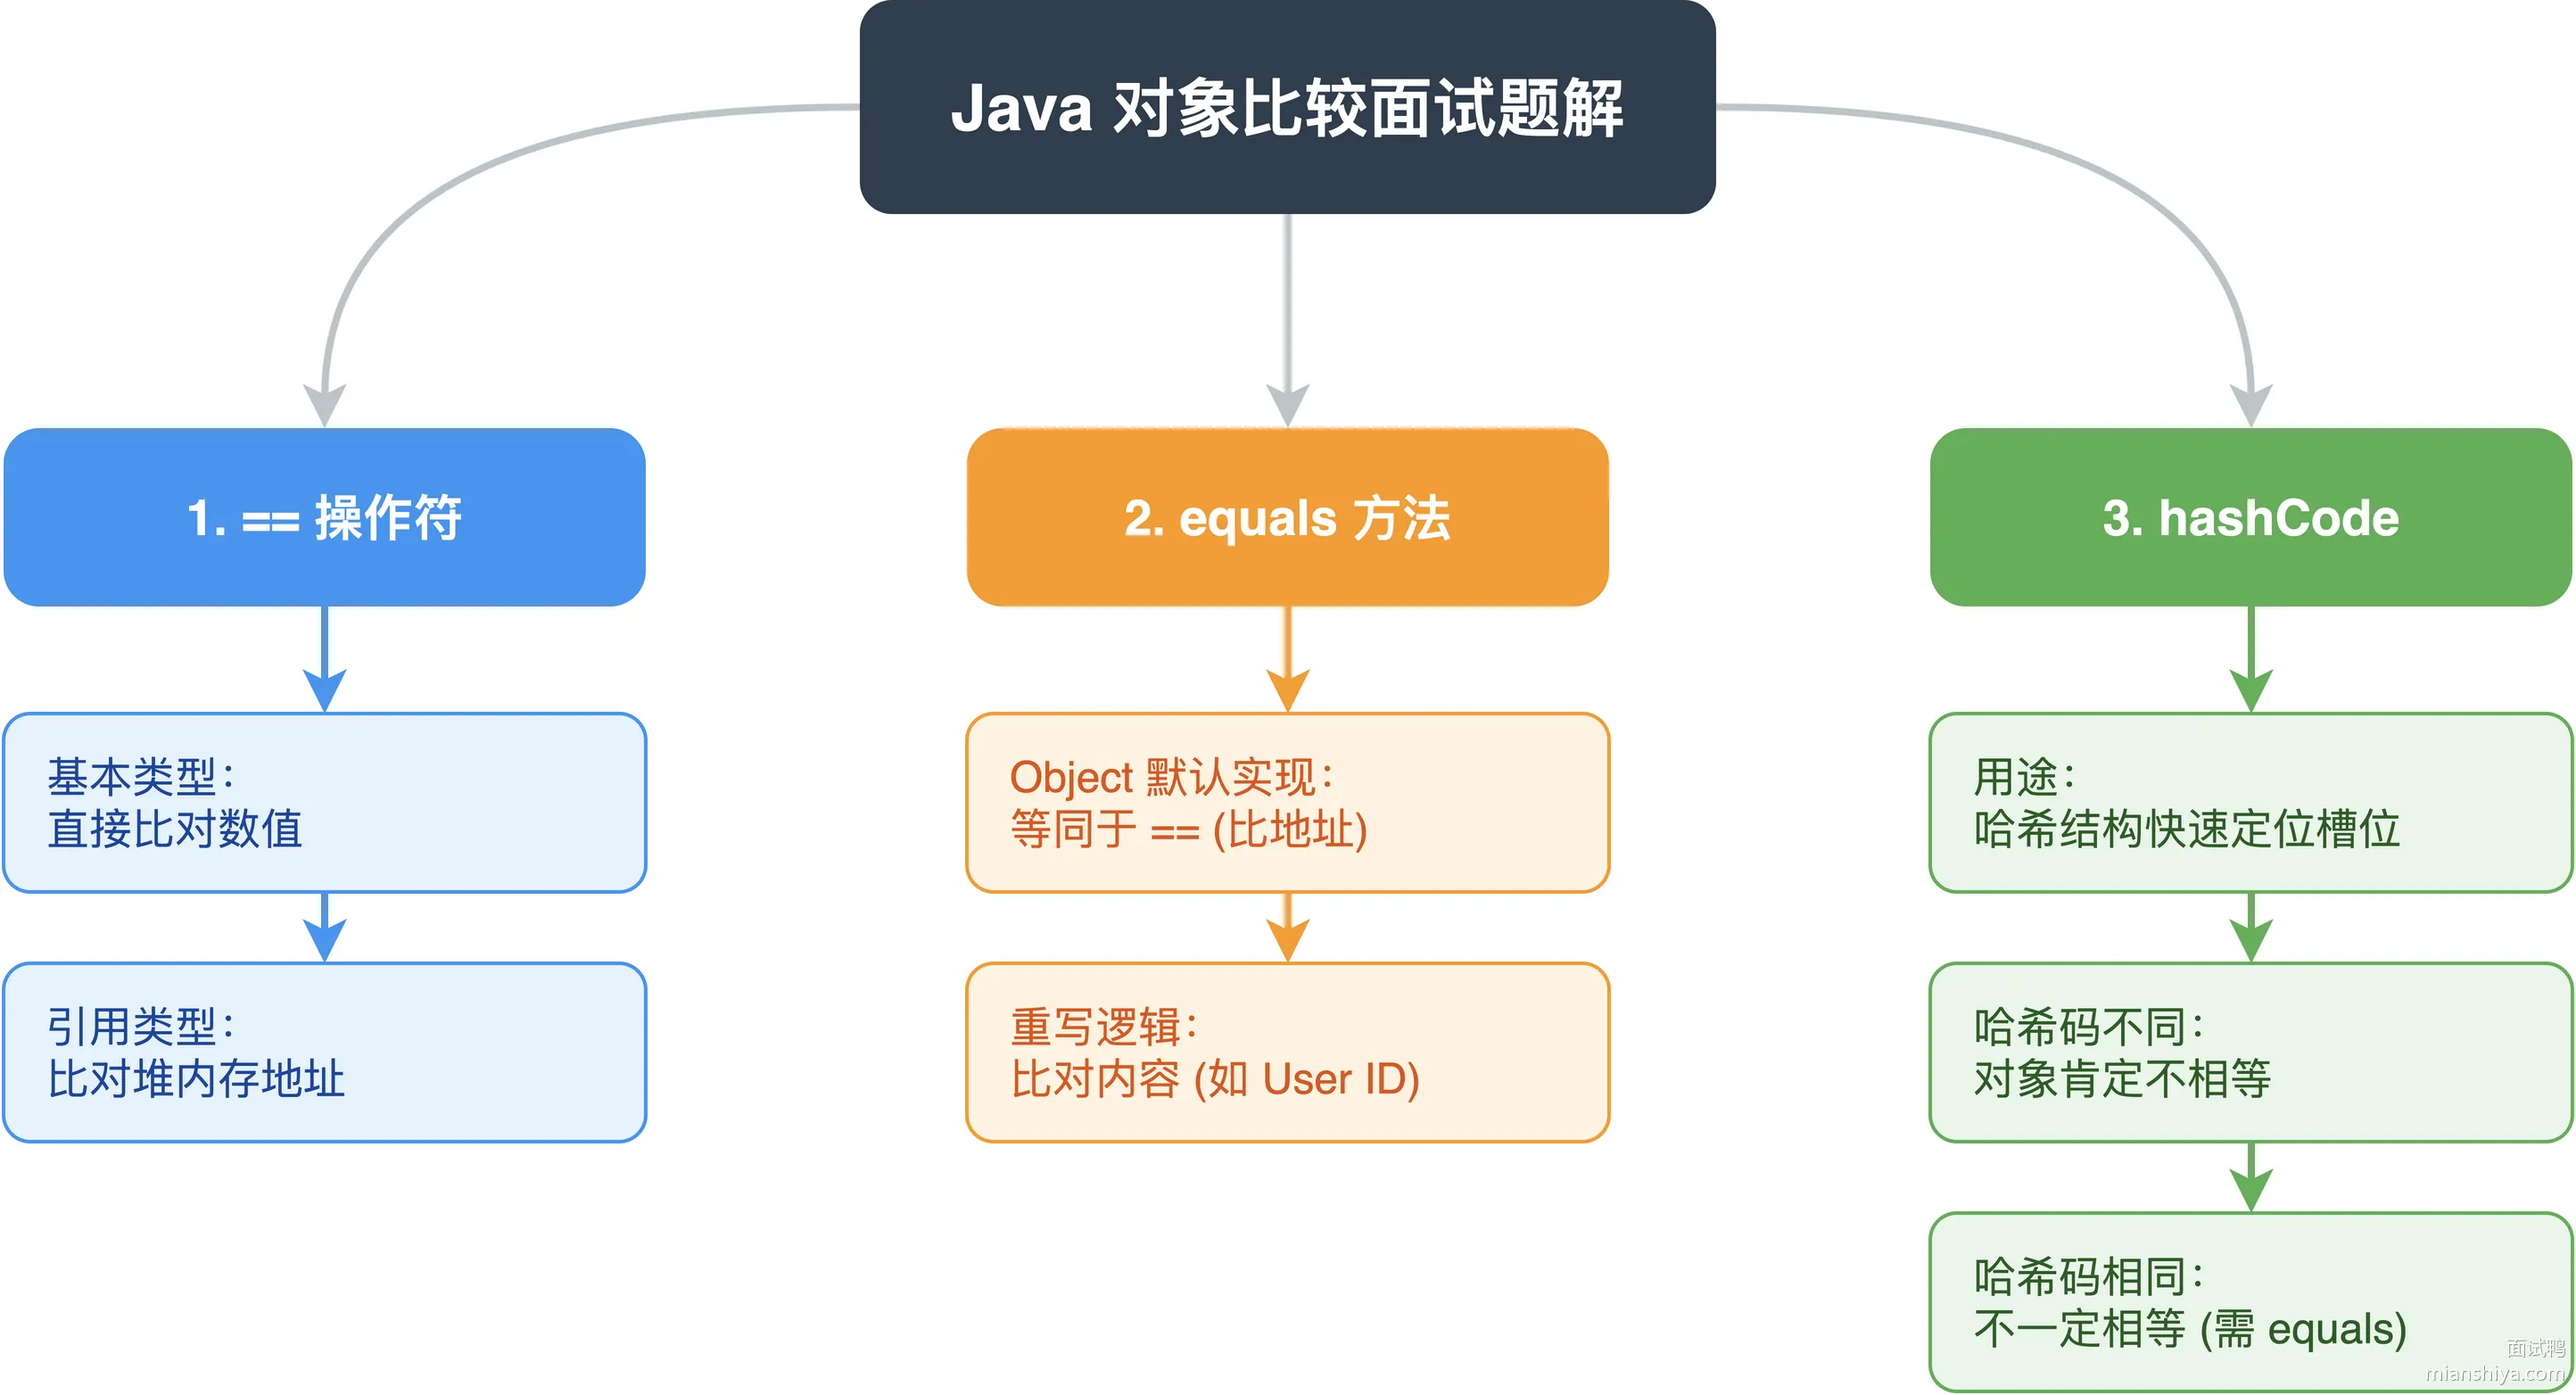
hashCode、equals 和 == 是 Java 中三种不同层面的比较方式:
1)== 比较的是内存地址,看两个引用是不是指向堆里同一块内存。对于基本类型,直接比值。
2)equals 比较的是对象内容,Object 类默认实现就是 ==,但我们通常会重写它来定义"内容相等"的逻辑。比如两个 User 对象,id 一样就算相等。
3)hashCode 返回一个整数哈希值,主要给 HashMap、HashSet 这类哈希结构用,快速定位对象在数组中的槽位。哈希码不同,对象肯定不相等;哈希码相同,对象不一定相等。
举个实际的例子:
String s1 = new String("hello");
String s2 = new String("hello");
String s3 = s1;

System.out.println(s1 == s2);      // false,两个不同对象
System.out.println(s1 == s3);      // true,指向同一对象
System.out.println(s1.equals(s2)); // true,内容相同
System.out.println(s1.hashCode() == s2.hashCode()); // true,内容相同哈希码也相同
9.2. 扩展知识
9.2.1. hashCode 和 equals 的契约关系
Java 规范里对这两个方法有个硬性约定:
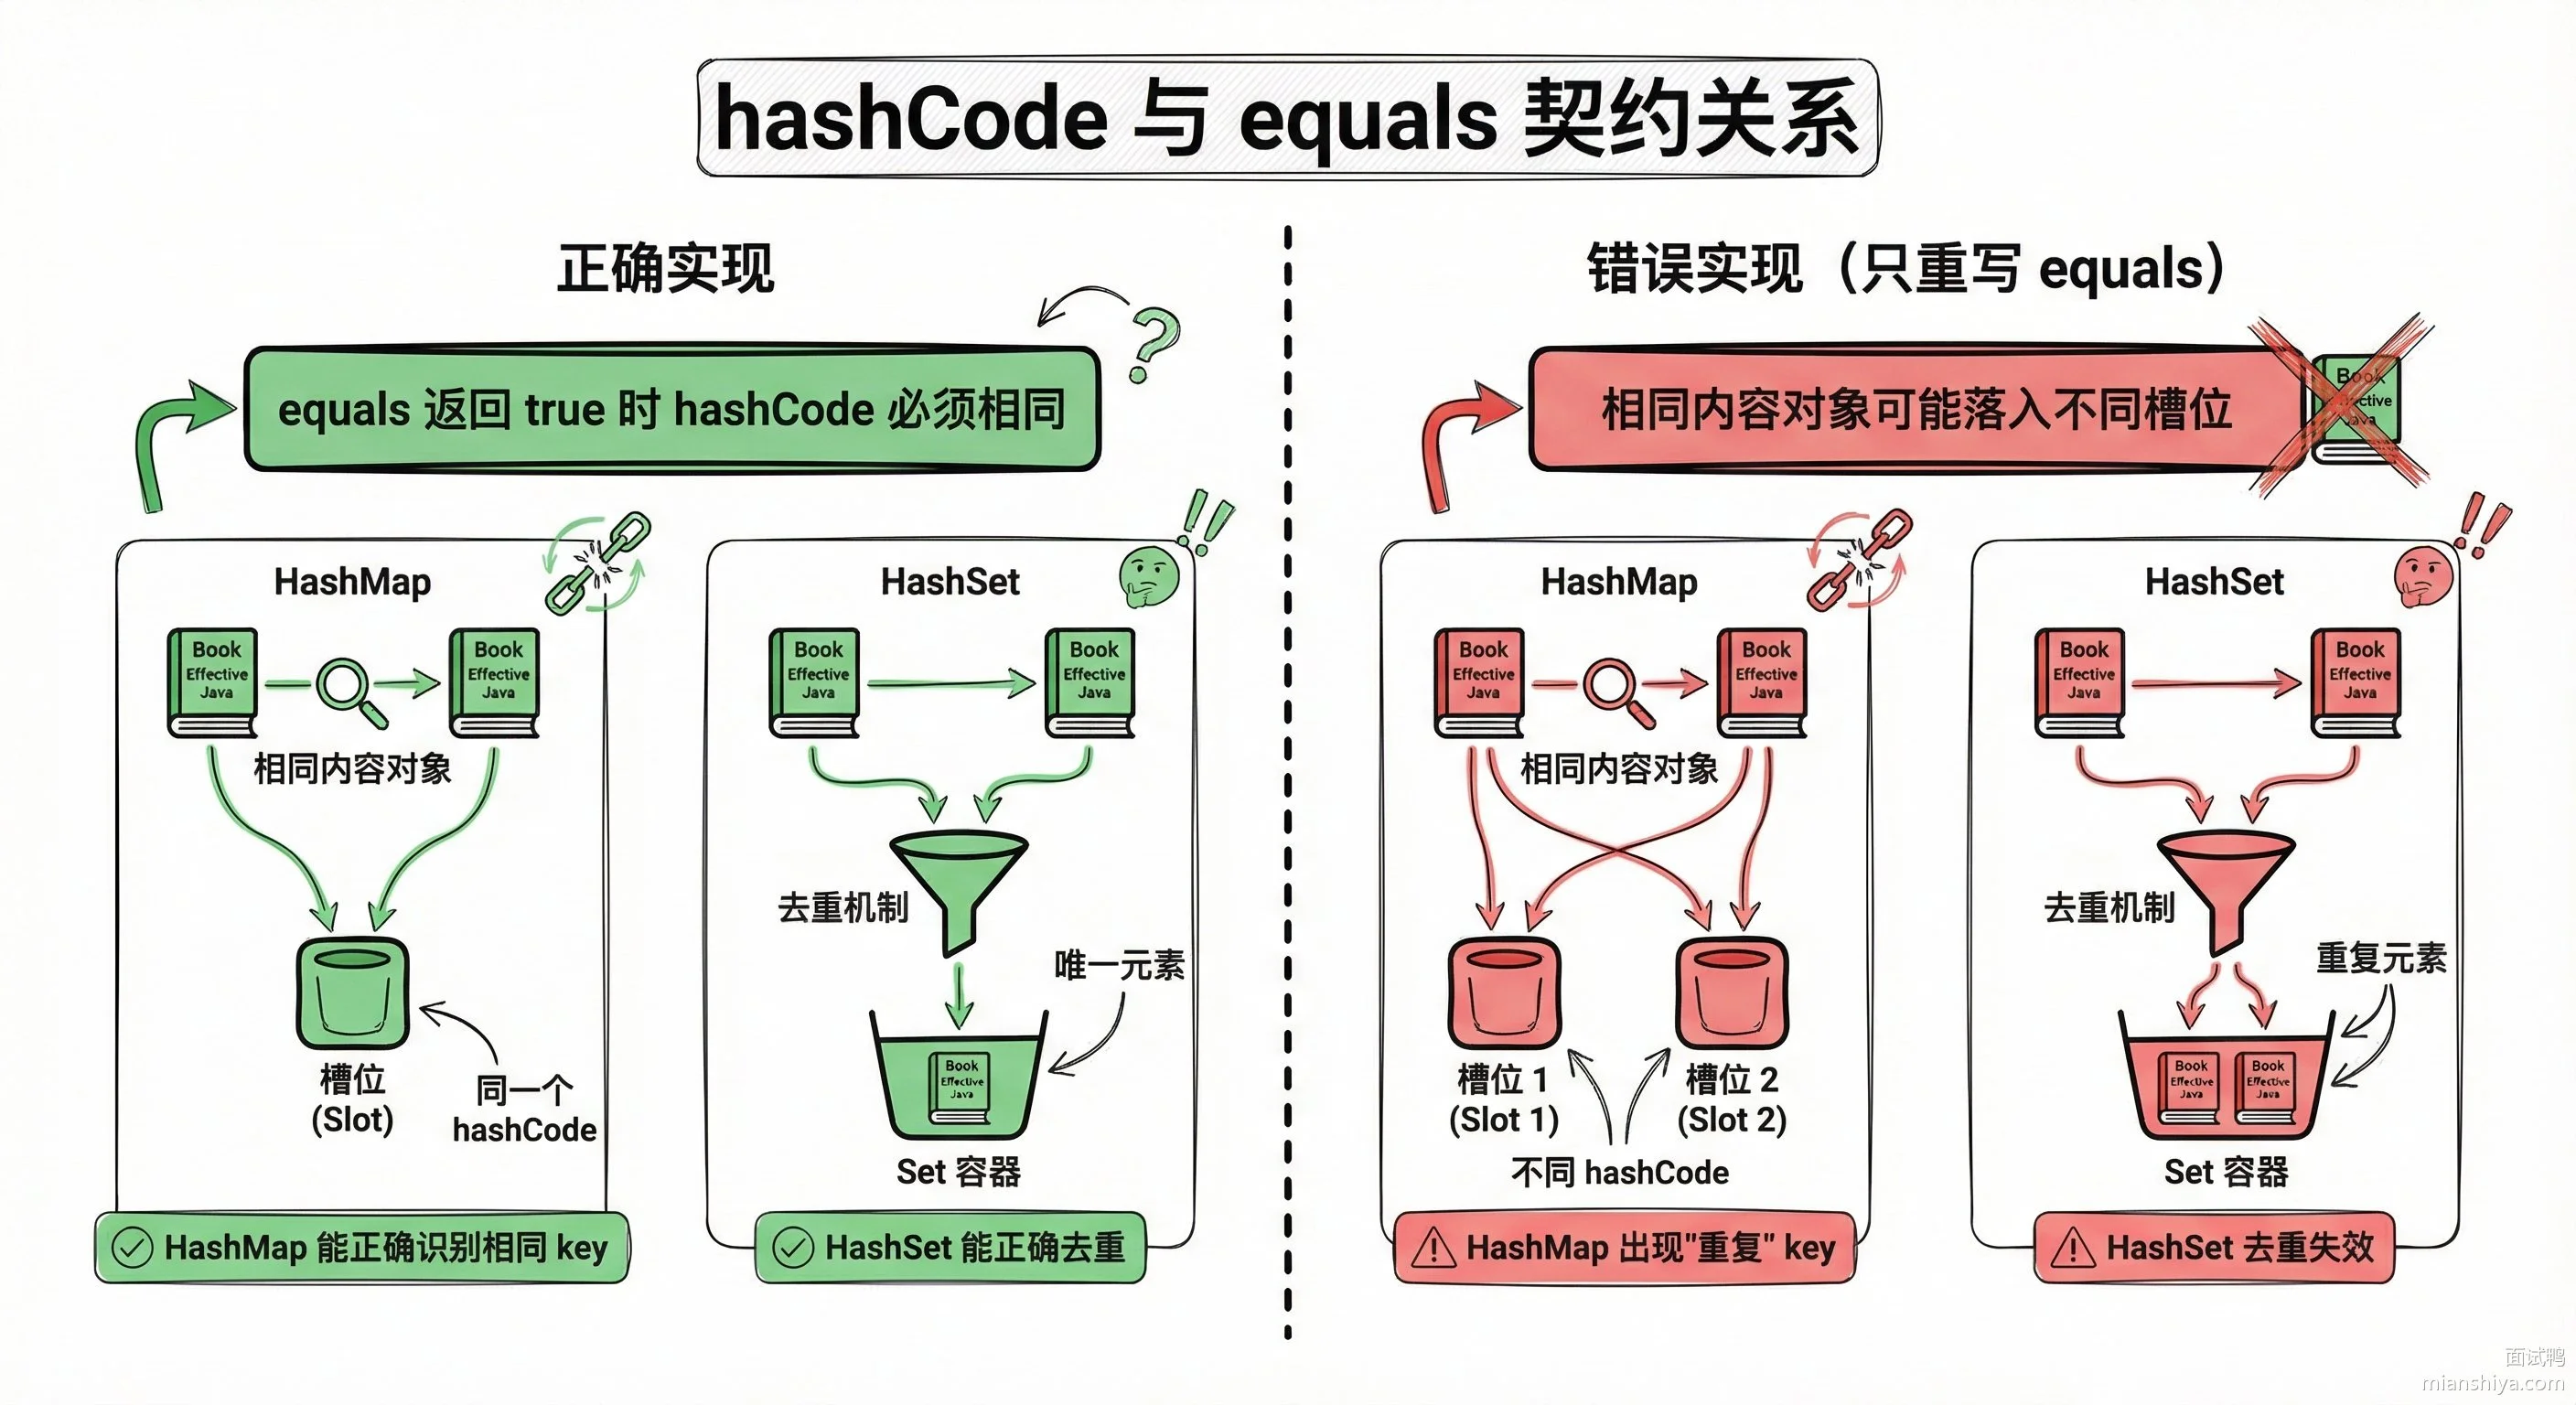
1)如果 equals 返回 true,那 hashCode 必须相同 2)如果 hashCode 不同,那 equals 必定返回 false 3)如果 hashCode 相同,equals 不一定返回 true
为什么有这个约定?因为 HashMap 在查找 key 的时候,先用 hashCode 定位到数组槽位,再用 equals 在链表或红黑树里精确匹配。如果你只重写 equals 不重写 hashCode,同样内容的两个对象可能被分到不同槽位,导致 HashMap 里存了"重复"的 key。
9.2.2. 重写 equals 的五大原则
1)自反性:x.equals(x) 必须返回 true 2)对称性:x.equals(y) 返回 true,那 y.equals(x) 也必须返回 true 3)传递性:x.equals(y) 返回 true,y.equals(z) 返回 true,那 x.equals(z) 必须返回 true 4)一致性:对象没变的情况下,多次调用 equals 结果要一致 5)非空性:x.equals(null) 必须返回 false
违反对称性的经典坑是继承关系,子类重写 equals 时如果没处理好,可能出现 parent.equals(child) 和 child.equals(parent) 结果不一致的情况。
9.2.3. hashCode 的默认实现
Object 类的 hashCode 是 native 方法,HotSpot 虚拟机的默认实现跟对象头里的信息有关。OpenJDK 8 默认用的是 Xorshift 随机数算法,每个对象第一次调用 hashCode 会生成一个随机值并缓存到对象头的 Mark Word 里。
注意,这个默认实现跟内存地址没有必然联系,虽然很多文章这么说,但实际上 HotSpot 有 6 种不同的 hashCode 生成策略,可以通过 -XX:hashCode 参数切换。
9.2.4. 字符串常量池的特殊情况
字符串有个特殊的地方:
String a = "hello";
String b = "hello";
System.out.println(a == b); // true,都指向常量池同一个对象

String c = new String("hello");
System.out.println(a == c); // false,c 在堆里新建了对象
System.out.println(a.equals(c)); // true,内容相同
这里 a == b 返回 true 是因为字符串字面量会被放进常量池复用,跟 equals 的语义没关系,纯粹是 JVM 的优化手段。
9.2.5. Integer 缓存池的坑
类似的还有 Integer 缓存池:
Integer x = 127;
Integer y = 127;
System.out.println(x == y); // true,缓存池复用

Integer m = 128;
Integer n = 128;
System.out.println(m == n); // false,超出缓存范围,新建对象
默认缓存范围是 -128 到 127,超出这个范围每次自动装箱都会 new 一个新对象。所以包装类型之间比较,永远用 equals,别用 ==。
9.3. 常见问题
9.3.1. 如果我只重写了 equals 没重写 hashCode,会出什么问题?
回答:HashMap 和 HashSet 会出问题。比如你 new 两个内容一样的 User 对象当 key,equals 返回 true,但 hashCode 不同,HashMap 会认为是两个不同的 key,都能存进去。取的时候用一个新 new 的 User 去 get,哈希码又不一样,根本定位不到原来的槽位,返回 null。
9.3.2. 为什么 String 重写了 hashCode,它的实现是怎样的?
回答:String 的 hashCode 是根据字符内容计算的,公式是 s[0]*31^(n-1) + s[1]*31^(n-2) + ... + s[n-1]。选 31 这个质数是因为它能被 JIT 优化成位运算 (i << 5) - i,计算快,而且 31 的离散性好,哈希冲突少。
10. 你使用过 Java 的反射机制吗?如何应用反射?
10.1. 核心要点
反射机制就是让程序在运行时能够"照镜子"看自己,动态获取类的结构信息,包括方法、字段、构造函数,还能直接操作它们。编译期不需要知道具体类型,运行时再决定要用哪个类、调哪个方法。
反射的核心流程:
1)获取 Class 对象:通过类名字符串、.class 语法或对象实例获取 2)获取成员信息:从 Class 对象中获取 Field、Method、Constructor 3)操作目标对象:创建实例、读写字段、调用方法
反射的三种获取 Class 对象的方式:
// 1. 通过全限定类名,框架常用这种
Class<?> clazz = Class.forName("com.mianshiya.MyClass");

// 2. 通过类字面量,编译期就确定
Class<?> clazz = MyClass.class;

// 3. 通过对象实例获取
Class<?> clazz = obj.getClass();
拿到 Class 对象后就可以搞事情了:
// 创建实例,newInstance() 在 JDK9 已标记过时
Constructor<?> constructor = clazz.getConstructor();
Object obj = constructor.newInstance();

// 访问私有字段
Field field = clazz.getDeclaredField("secretField");
field.setAccessible(true);  // 暴力破解访问权限
Object value = field.get(obj);

// 调用方法
Method method = clazz.getMethod("doSomething", String.class);
Object result = method.invoke(obj, "参数");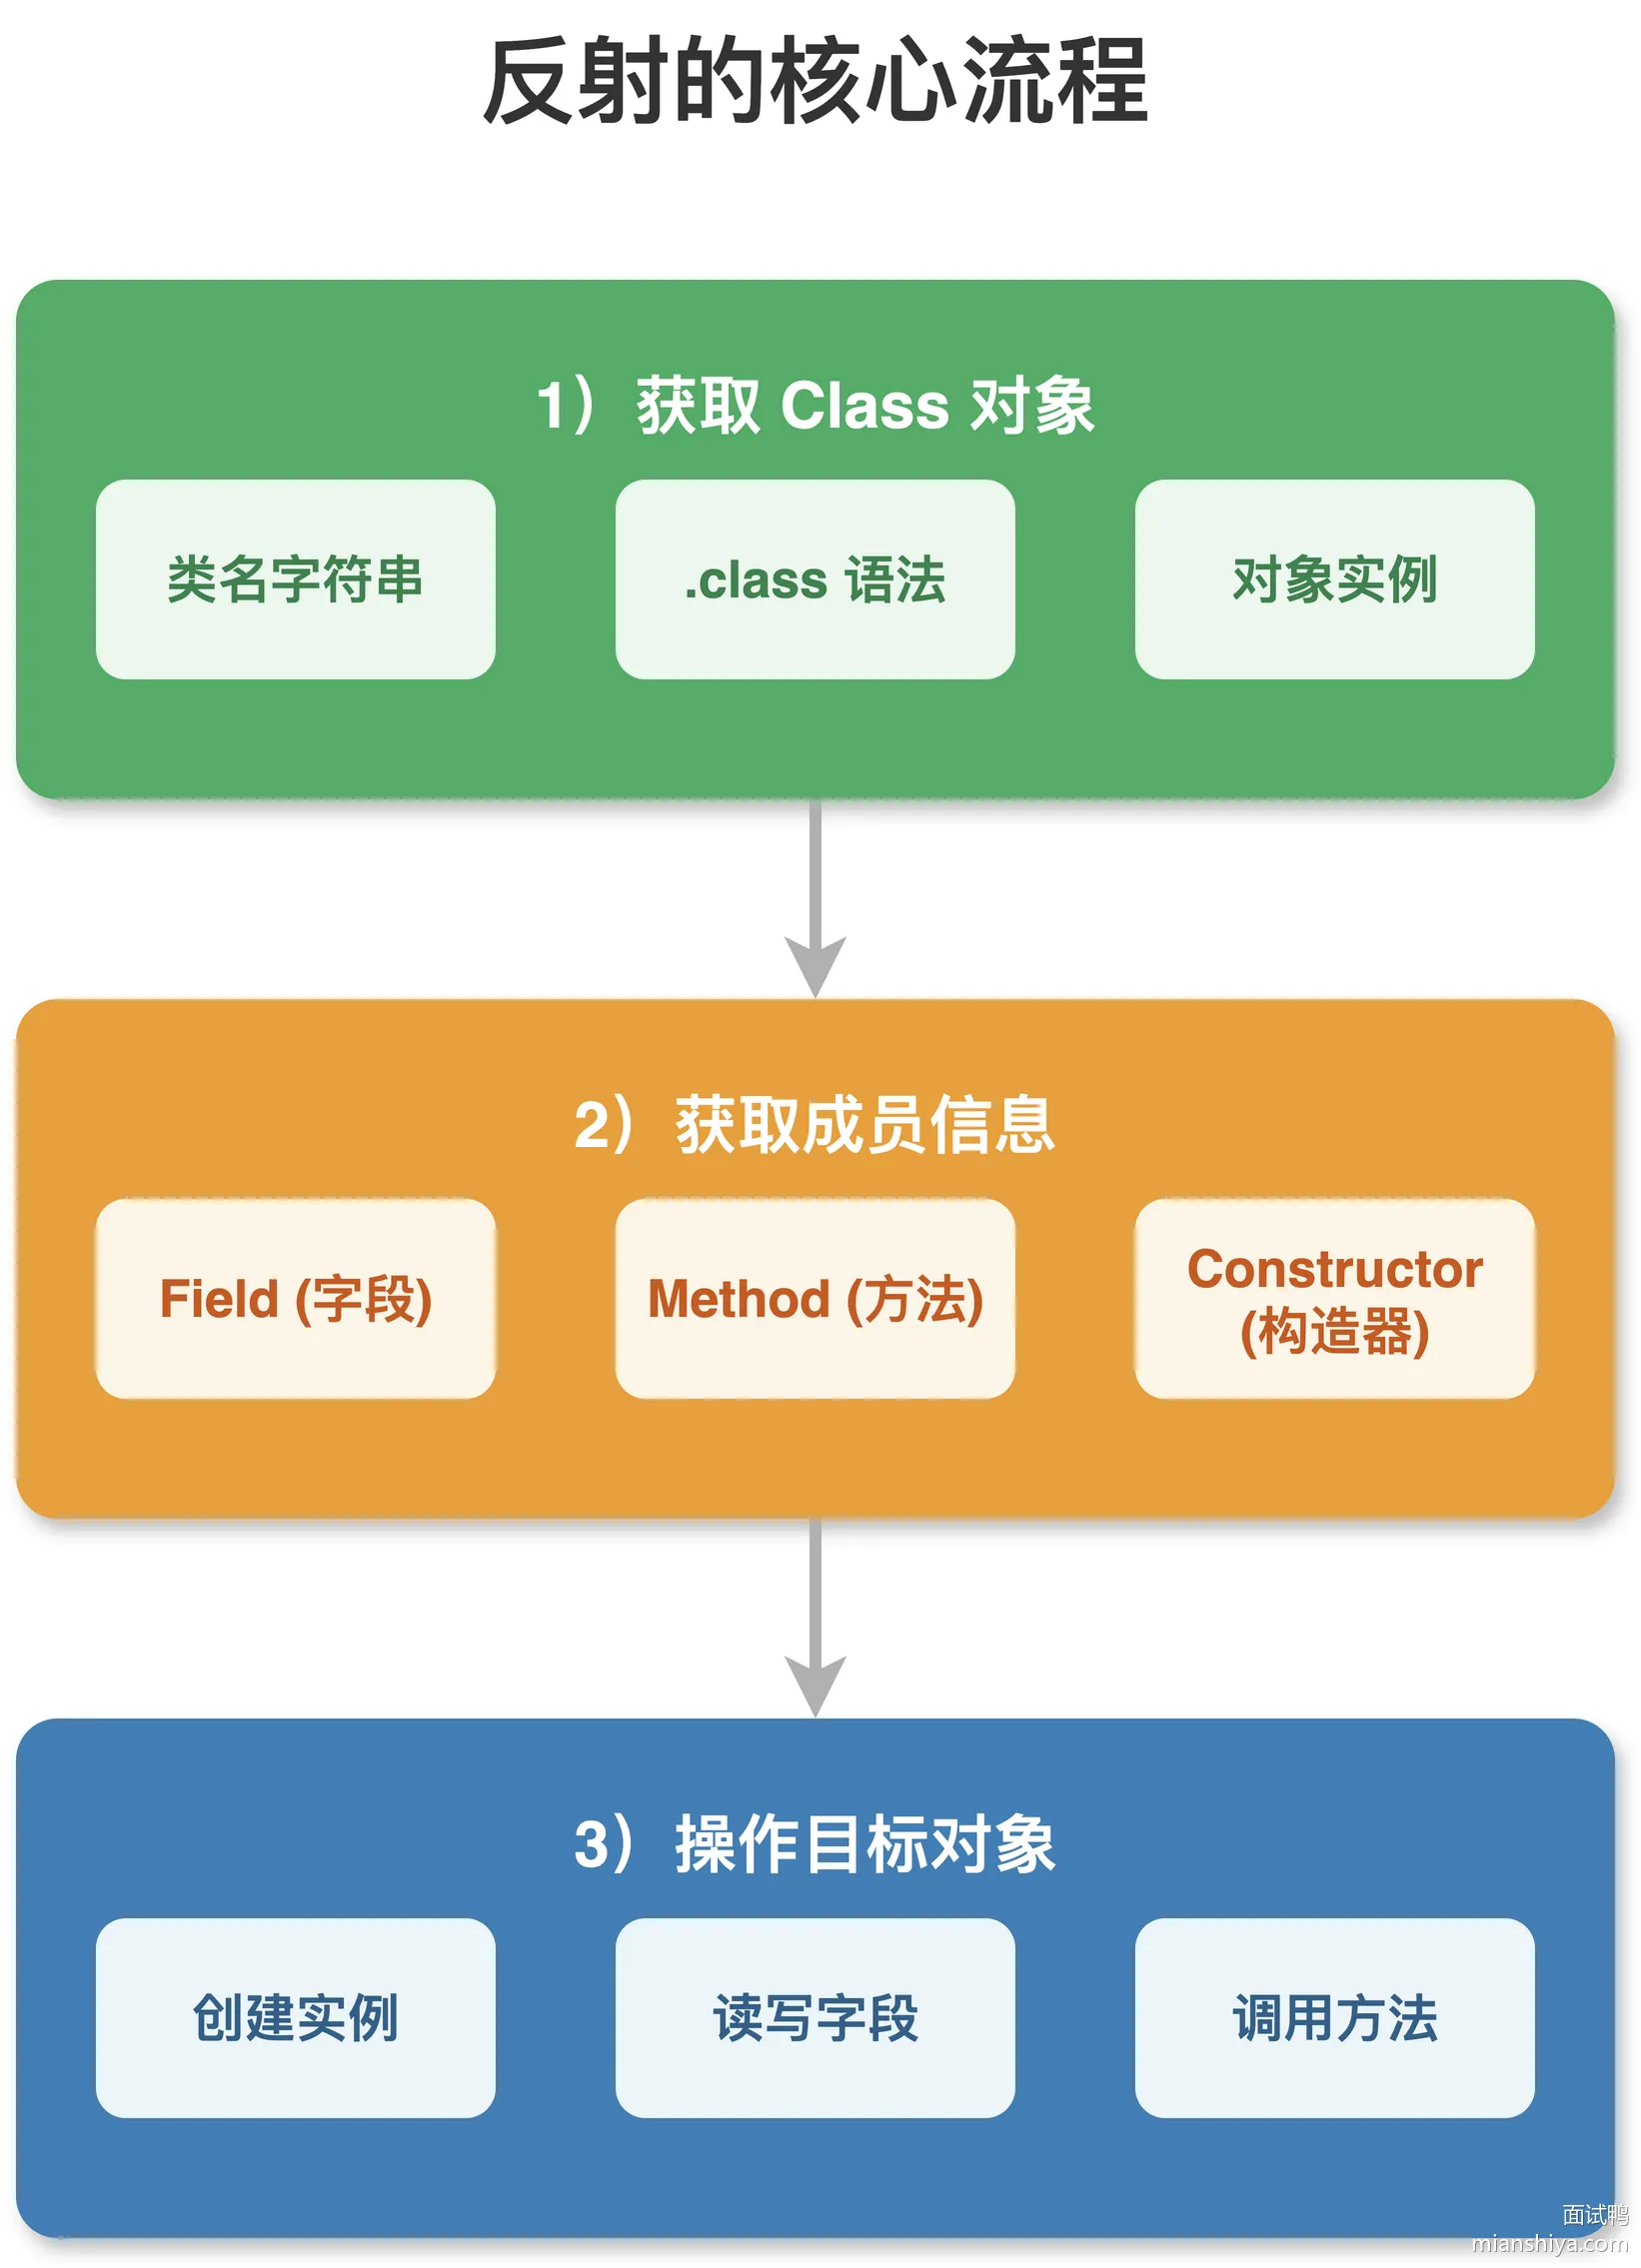
10.2. 扩展知识
10.2.1. 为什么需要反射
业务代码里很少直接用反射,但框架层面离不开它。Spring 的 IoC 容器启动时扫描到一堆 @Component 注解的类名,它不可能提前知道你写了哪些类,只能通过 Class.forName() 动态加载,再用 Constructor.newInstance() 创建 Bean。同样的道理,MyBatis 把 SQL 查询结果映射到实体类,也是靠反射往字段里塞值。
10.2.2. 反射为什么慢
直接调用方法,JVM 编译后就是几条固定的机器指令,地址都定死在那了。反射调用就麻烦了:
1)每次调用都要做安全检查,验证调用者有没有权限访问目标成员 2)参数要装箱拆箱,invoke 方法签名是 Object 类型,基本类型得包一层 3)JIT 编译器很难对反射调用做内联优化,因为目标方法运行时才确定
实测下来,反射调用比直接调用慢 10-50 倍左右。不过 JVM 有个小优化:同一个 Method 对象调用超过 15 次后,会生成一个专门的 MethodAccessor 来加速,能把性能差距缩小到 3-5 倍。
10.2.3. 性能优化手段
最有效的办法是缓存反射结果。Class.getDeclaredMethod() 每次调用都要遍历方法表,开销不小。把拿到的 Method、Field 对象缓存起来复用,后续调用直接 invoke,省掉查找过程:
public class ReflectionCache {
    private static final Map<String, Method> methodCache = new ConcurrentHashMap<>();

    public static Method getMethod(Class<?> clazz, String name, Class<?>... paramTypes)
            throws NoSuchMethodException {
        String key = clazz.getName() + "#" + name;
        return methodCache.computeIfAbsent(key, k -> {
            try {
                Method method = clazz.getDeclaredMethod(name, paramTypes);
                method.setAccessible(true);
                return method;
            } catch (NoSuchMethodException e) {
                throw new RuntimeException(e);
            }
        });
    }
}
另一个思路是用 MethodHandle,JDK7 引入的 API,性能接近直接调用。不过写起来比反射还绕,一般在框架底层才会用到。
10.2.4. setAccessible 的安全问题
setAccessible(true) 能绕过 private 访问限制,听起来很危险,但 JVM 有安全管理器兜底。生产环境如果开启了 SecurityManager,随便调 setAccessible 会抛 SecurityException。
JDK9 引入模块系统后限制更严格了,跨模块反射访问默认被禁止。想访问 JDK 内部类,得在启动参数里加 --add-opens,不然直接报 InaccessibleObjectException。
10.3. 常见问题
10.3.1. Spring 用反射创建 Bean 不会有性能问题吗?
回答:Bean 创建主要发生在容器启动阶段,运行时 Bean 都是从单例池里直接取,不会重复反射创建。启动慢一点用户感知不到,运行时性能才是关键。Spring 内部也做了大量缓存,BeanDefinition 解析一次就缓存起来了。
10.3.2. 反射能调用私有方法,那 final 字段能改吗?
回答:能改,但有坑。对于实例字段,setAccessible(true) 后可以直接修改。但如果是 static final 的编译期常量,编译器会把值内联到使用的地方,改了字段值但其他地方还是老值。JDK12 之后对 final 字段的反射修改做了更严格的限制,需要加 --add-opens 才行。
10.3.3. MethodHandle 和反射有什么区别?
回答:MethodHandle 是 JDK7 引入的,定位是"方法指针"。反射每次调用都要做权限检查,MethodHandle 把检查提前到 lookup 阶段,调用时直接走,性能接近直接调用。缺点是 API 比反射复杂,要处理各种 MethodType 的匹配,写错了运行时才报错。
10.3.4. 为什么 newInstance() 方法被标记过时了?
回答:Class.newInstance() 只能调无参构造器,遇到异常还会把受检异常包成 InstantiationException 抛出来,调用方没法精确捕获原始异常。JDK9 推荐用 Constructor.newInstance(),能调任意构造器,异常也透传出来,不会被吞掉。
11. Java 中的注解原理是什么?
11.1. 核心要点
注解本质上就是个标记,是一种给代码添加元数据的机制。你可以把注解打在类上、方法上、字段上、参数上,标记里还能带一些属性值。
注解本身不会改变程序的运行逻辑,但编译器、框架、工具可以读取这些标记来做特定处理,比如编译时检查、生成代码、运行时做依赖注入。
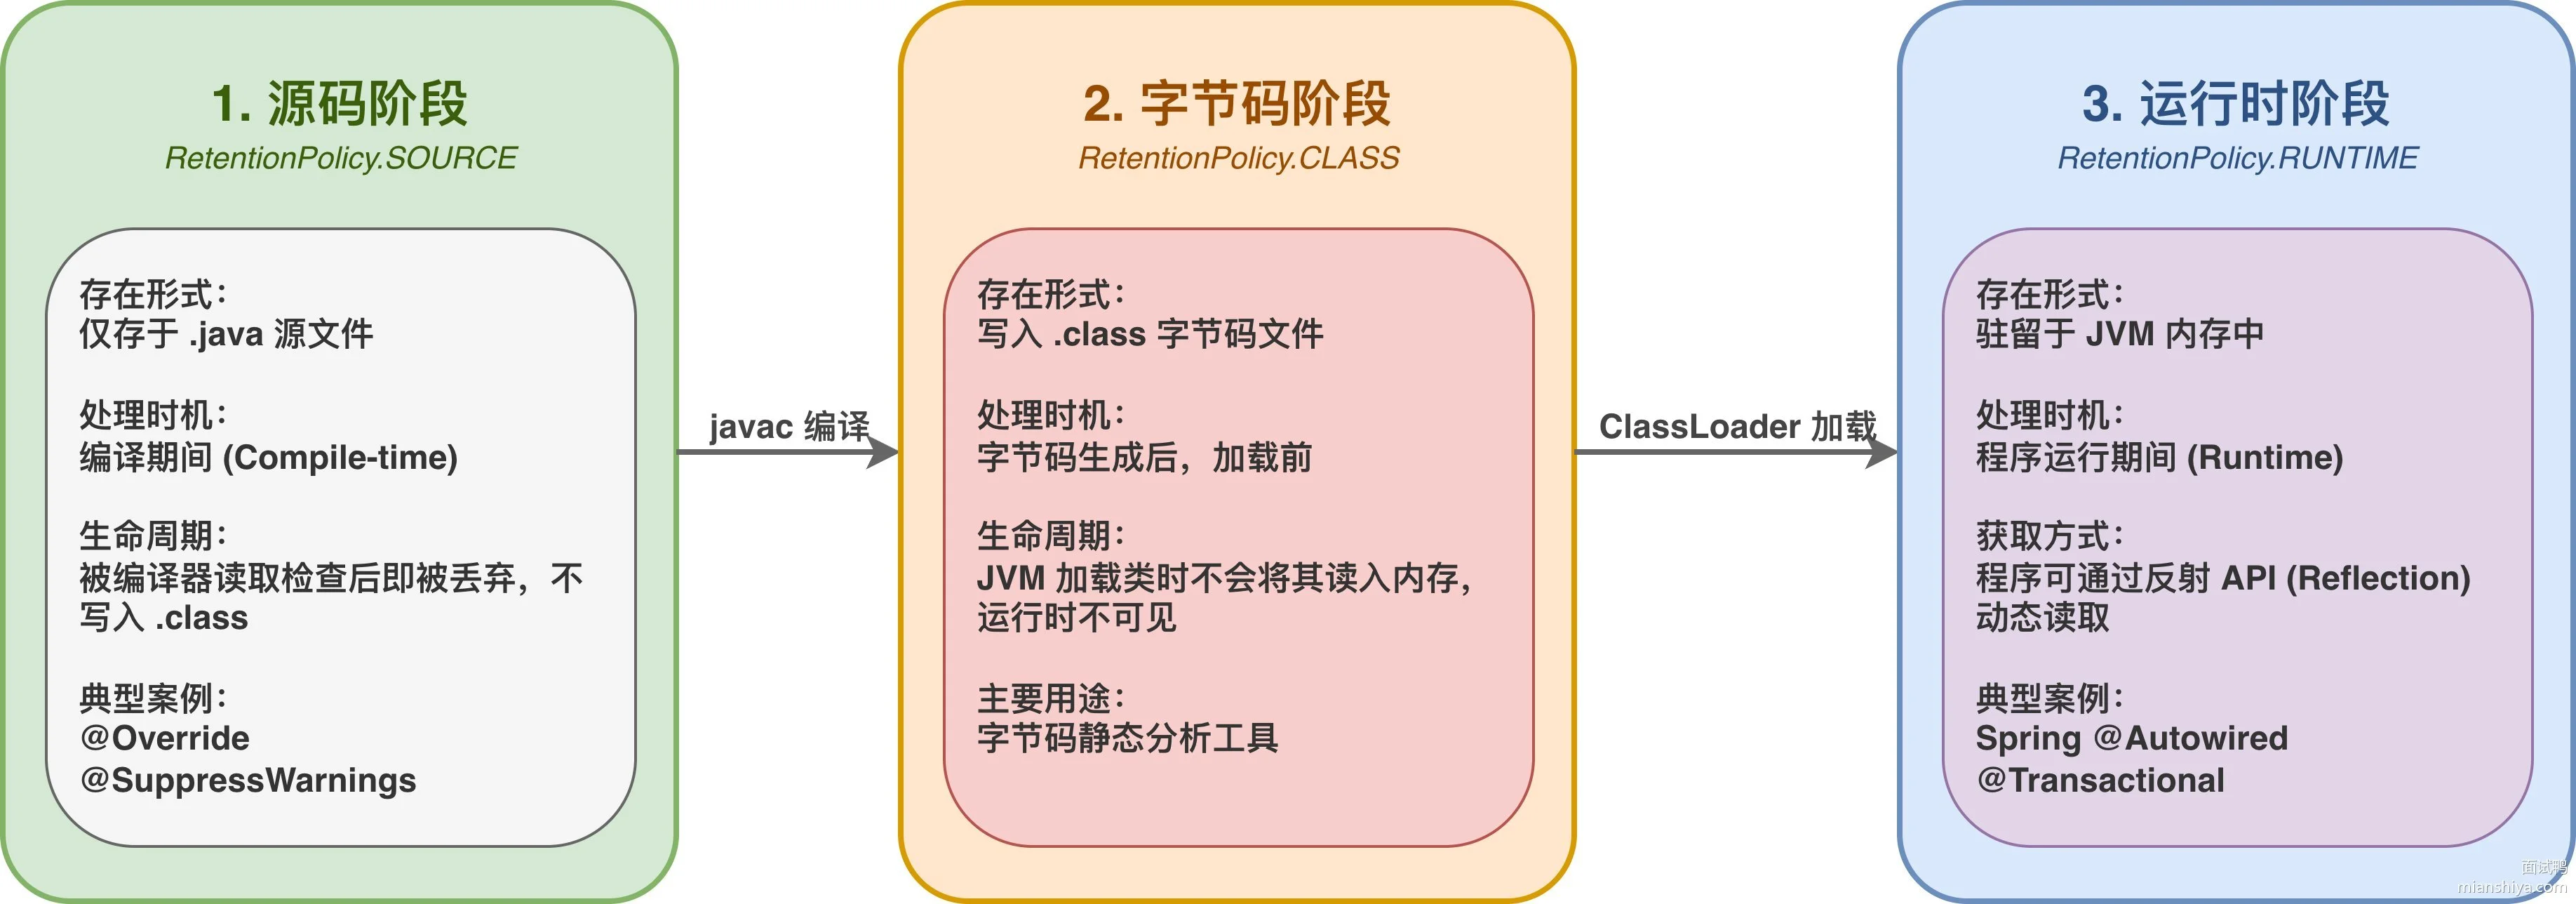
注解处理的三个阶段:
- 源码阶段:注解只存在于 .java 文件中,编译时被编译器读取处理,编译完就丢弃。典型例子是 @Override,编译器检查方法签名是否正确,class 文件里不保留这个注解。
- 字节码阶段:注解会写进 .class 文件,但 JVM 加载类的时候不会把注解信息加载到内存。用于字节码工具做静态分析。
- 运行时阶段:注解信息会被加载到 JVM 内存,程序可以通过反射 API 读取注解。Spring 的 @Autowired、@Transactional 都是这种。
定义注解用 @interface 关键字:
@Retention(RetentionPolicy.RUNTIME)  // 运行时保留
@Target(ElementType.METHOD)          // 只能标记在方法上
public @interface MyAnnotation {
    String value() default "";       // 属性,可以设默认值
}
运行时读取注解:
Method method = MyClass.class.getMethod("myMethod");
if (method.isAnnotationPresent(MyAnnotation.class)) {
    MyAnnotation annotation = method.getAnnotation(MyAnnotation.class);
    System.out.println(annotation.value());
}
11.2. 扩展知识
11.2.1. 元注解
元注解就是注解的注解,用来定义注解的行为。
@Retention 控制注解的生命周期:
1)RetentionPolicy.SOURCE 只在源码里,编译完就没了。@Override、@SuppressWarnings 就是这种 2)RetentionPolicy.CLASS 会写进 class 文件,但运行时拿不到。这是默认值 3)RetentionPolicy.RUNTIME 运行时可以通过反射拿到。框架用的注解基本都是这种
@Target 限制注解能标在哪:
1)ElementType.TYPE 类、接口、枚举 2)ElementType.METHOD 方法 3)ElementType.FIELD 字段 4)ElementType.PARAMETER 方法参数 5)ElementType.CONSTRUCTOR 构造器 6)ElementType.LOCAL_VARIABLE 局部变量 7)ElementType.ANNOTATION_TYPE 注解本身 8)ElementType.PACKAGE 包
JDK 8 新增了 ElementType.TYPE_USE,可以标在任何类型使用的地方,比如 List<@NonNull String>。
@Inherited 让注解可以被子类继承。父类上打了 @MyAnnotation,子类也能通过反射拿到这个注解。
@Repeatable(JDK 8)允许同一个地方打多次相同的注解。
11.2.2. 注解的底层实现
注解在编译后会变成一个继承自 java.lang.annotation.Annotation 的接口。比如你定义的 @MyAnnotation 编译后大致是:
public interface MyAnnotation extends Annotation {
    String value();
}
运行时调用 getAnnotation() 获取的注解对象其实是 JDK 动态代理生成的代理类实例。代理类实现了你的注解接口,属性值存在一个 Map 里,调用 value() 方法时就从 Map 里取值返回。
11.2.3. 常见注解实例分析
看看 @Override:
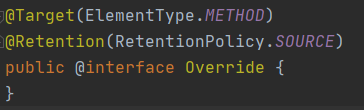
RetentionPolicy 是 SOURCE,编译器检查完方法签名就扔了,class 文件里没有这个注解的痕迹。
再看 Spring 的 @Autowired:
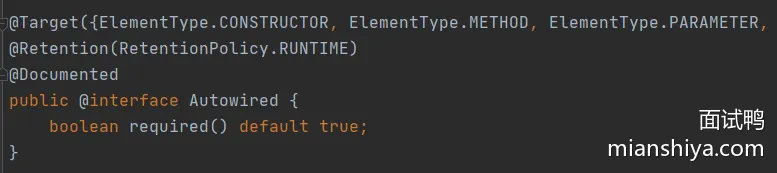
RetentionPolicy 是 RUNTIME,Spring 容器启动时通过反射扫描所有类,找到带 @Autowired 的字段,然后从容器里找到对应类型的 Bean 注入进去。
11.2.4. 注解处理器 APT
除了运行时用反射读注解,还有一种方式是在编译期处理注解,叫 APT(Annotation Processing Tool)。
APT 的原理是:编译时 javac 会调用注册的注解处理器,处理器可以读取注解信息,然后生成新的 Java 源文件,这些新文件会参与下一轮编译。
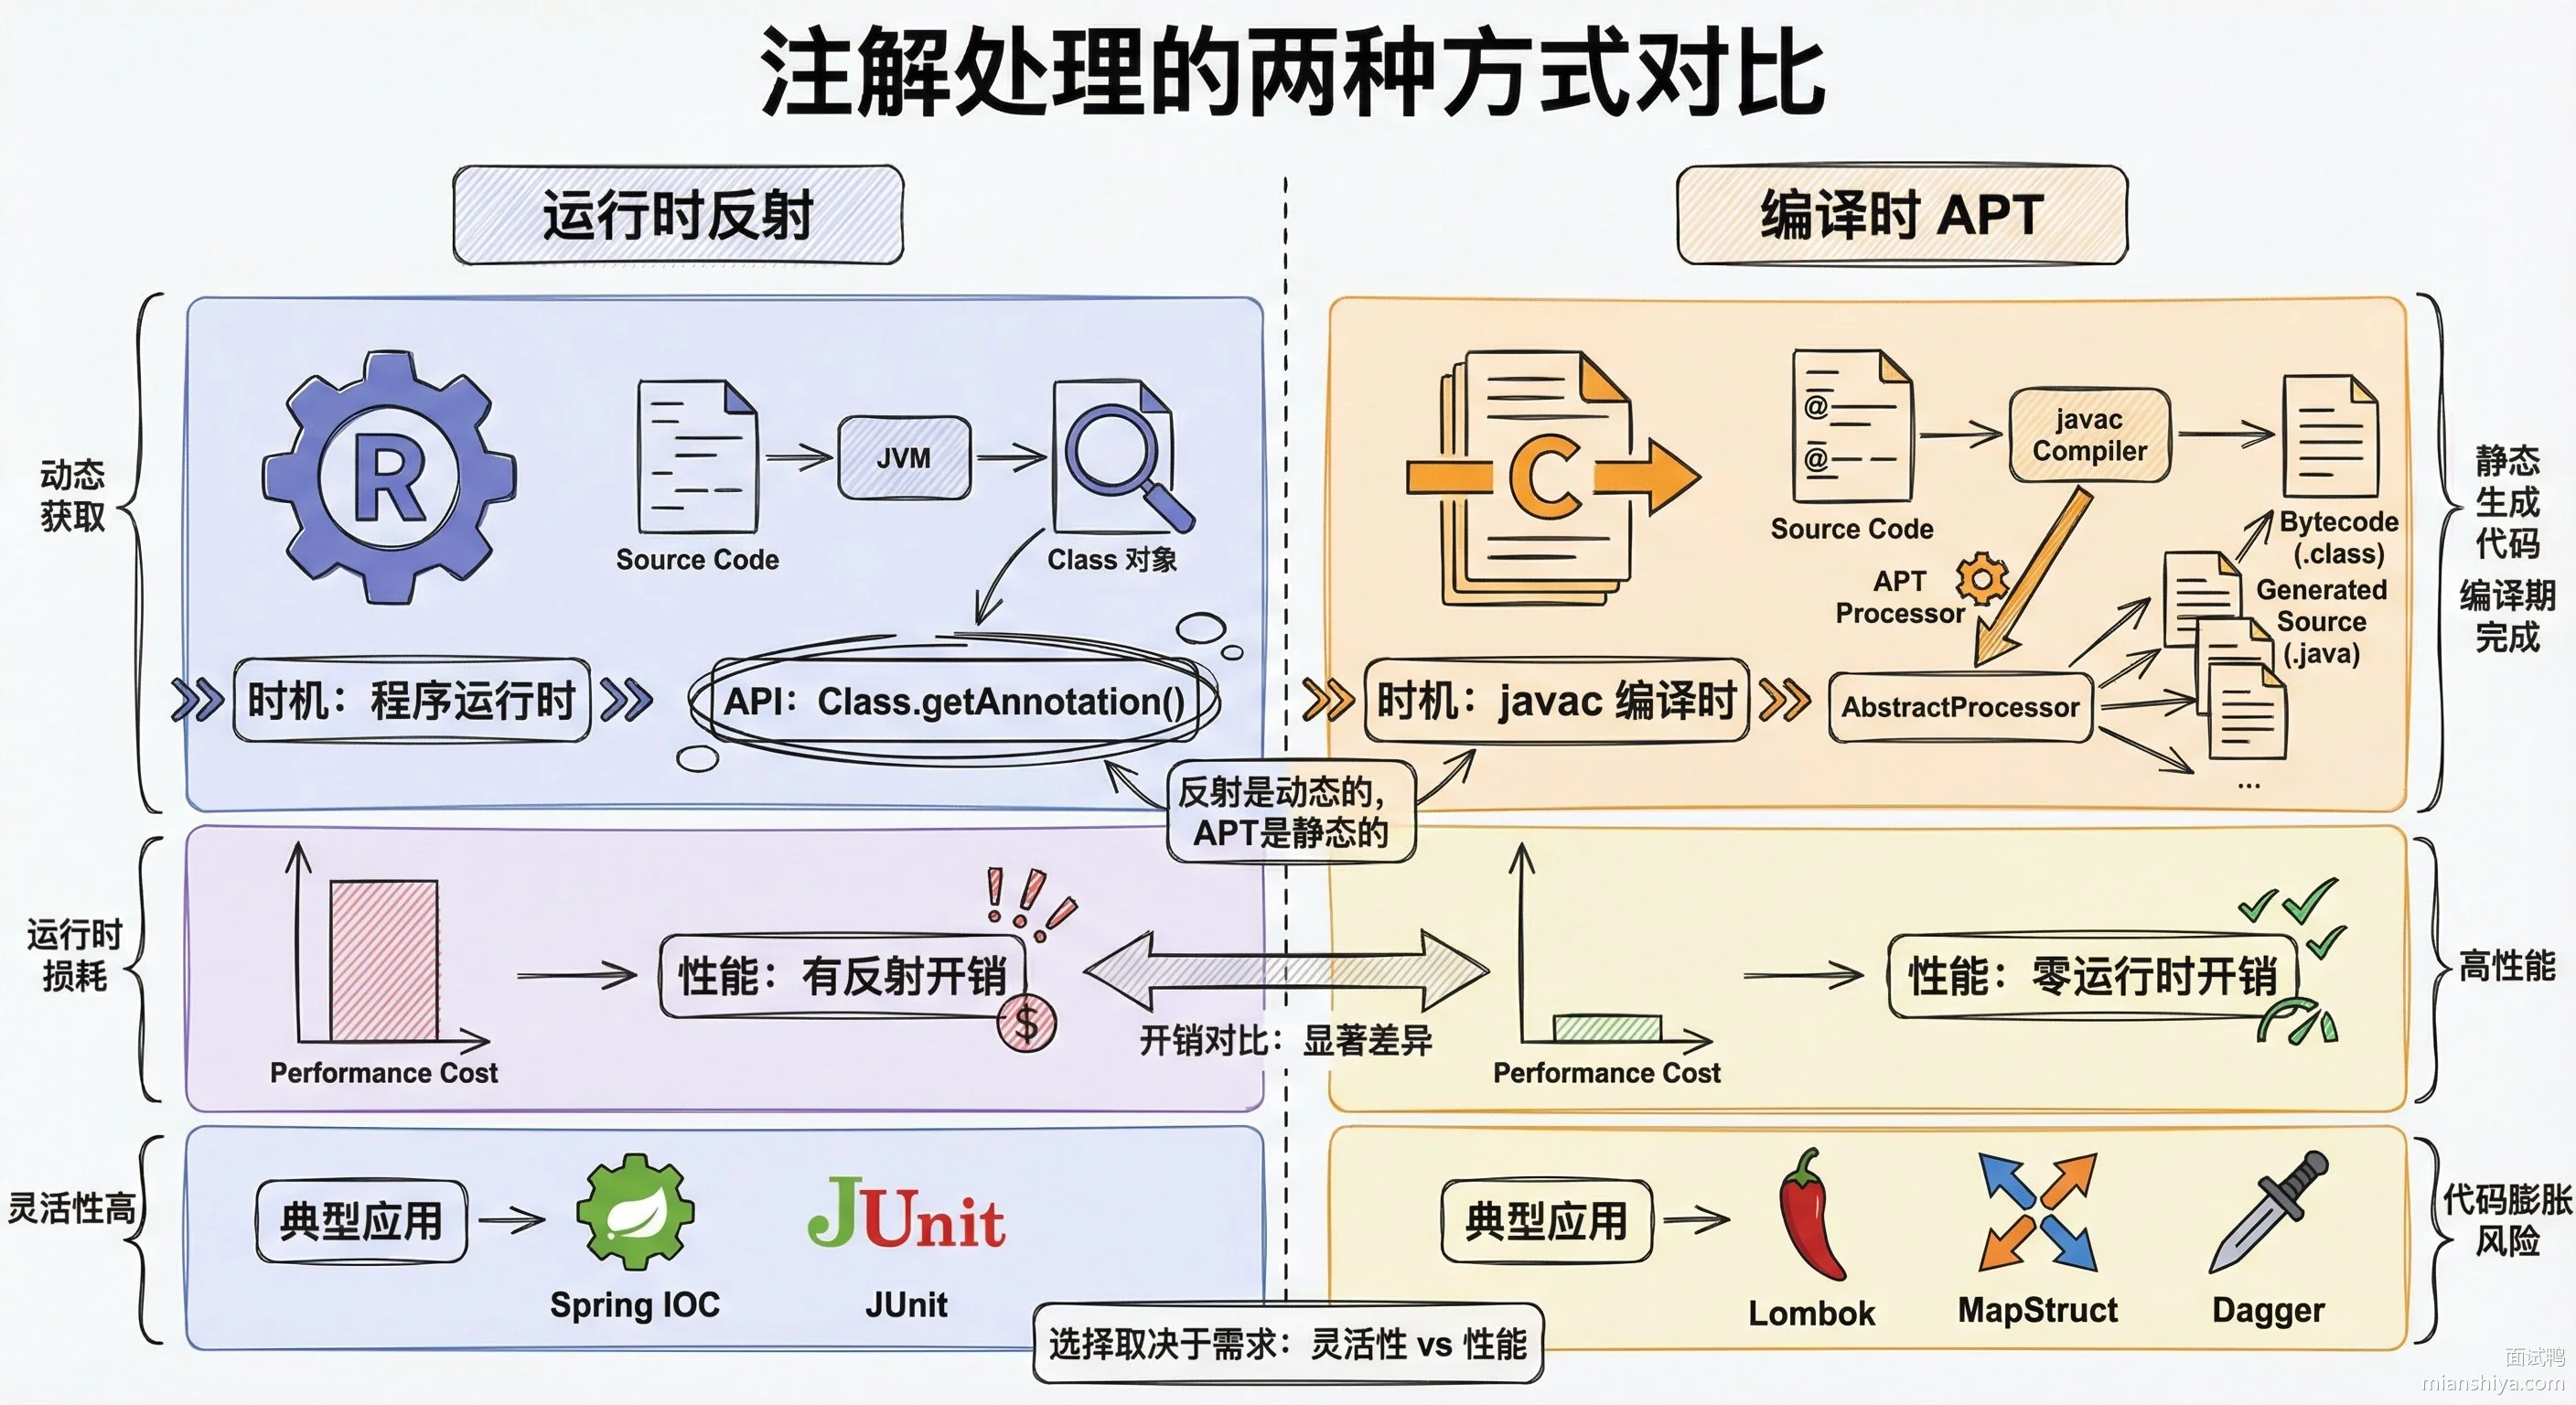
Lombok 的 @Data、@Getter 就是 APT 的典型应用。编译时 Lombok 的注解处理器读到 @Data,直接生成 getter/setter/toString 等方法的字节码,塞进 class 文件。运行时压根不需要 Lombok 的 jar 包,因为代码已经生成好了。
11.2.5. Spring 中注解的工作原理
Spring 框架大量使用运行时注解。以 @Autowired 为例,处理流程是:
1)Spring 容器启动时扫描指定包路径下所有类 2)找到带 @Component、@Service 等注解的类,创建 Bean 定义 3)实例化 Bean 时,通过反射遍历所有字段和方法 4)发现带 @Autowired 的字段,从容器中查找匹配类型的 Bean 5)用反射把找到的 Bean 赋值给这个字段
这也是为什么 Spring 注解必须是 RUNTIME 保留策略,否则运行时根本拿不到注解信息。
11.3. 常见问题
11.3.1. 为什么 @Override 不需要 RUNTIME 保留策略?
回答:因为 @Override 的作用是让编译器检查方法签名是否正确,检查完就完事了,运行时不需要这个信息。保留到 RUNTIME 只会白白占用元数据空间,没有任何意义。
11.3.2. Lombok 的 @Data 和 Spring 的 @Autowired 处理方式有什么区别?
回答:完全不同的机制。Lombok 是编译期处理,用的是 APT 注解处理器,编译时直接把 getter/setter 方法的字节码生成好塞进 class 文件,运行时 @Data 这个注解已经不存在了。Spring 的 @Autowired 是运行时处理,注解会保留到 RUNTIME,Spring 容器启动时通过反射扫描注解,然后做依赖注入。Lombok 零运行时开销,Spring 有反射开销但更灵活。
11.3.3. 自定义注解能实现像 @Transactional 那样的效果吗?
回答:可以,但只靠注解本身不行,得配合 AOP。自己定义一个 @MyTransactional 注解,然后写个切面拦截所有带这个注解的方法,在切面里开启事务、捕获异常、提交或回滚。Spring 的 @Transactional 就是这么实现的,核心是 TransactionInterceptor 这个切面类。
11.3.4. 注解可以继承吗?
回答:注解本身不能用 extends 继承另一个注解,但有两种变通方式。第一种是用 @Inherited 元注解,让类上的注解可以被子类继承,但只对类注解生效,方法和字段上的注解不会继承。第二种是组合注解,比如 @SpringBootApplication 就是把 @Configuration、@EnableAutoConfiguration、@ComponentScan 组合到一起,Spring 会递归解析注解上的注解。
12. 什么是 Java 泛型的上下界限定符?
12.1. 核心要点
Java 泛型的上下界限定符用来限制泛型参数的类型范围,让你在保证类型安全的同时获得更大的灵活性。
? extends T 叫上界限定符,表示类型必须是 T 或 T 的子类,主要用于读取场景。因为你知道拿出来的东西至少是个 T,所以读取安全;但你不知道具体是哪个子类,所以没法往里塞东西。
? super T 叫下界限定符,表示类型必须是 T 或 T 的父类,主要用于写入场景。因为容器里装的是 T 的父类,你往里塞 T 肯定没问题;但读出来的时候只能当 Object 用,因为不确定具体类型。
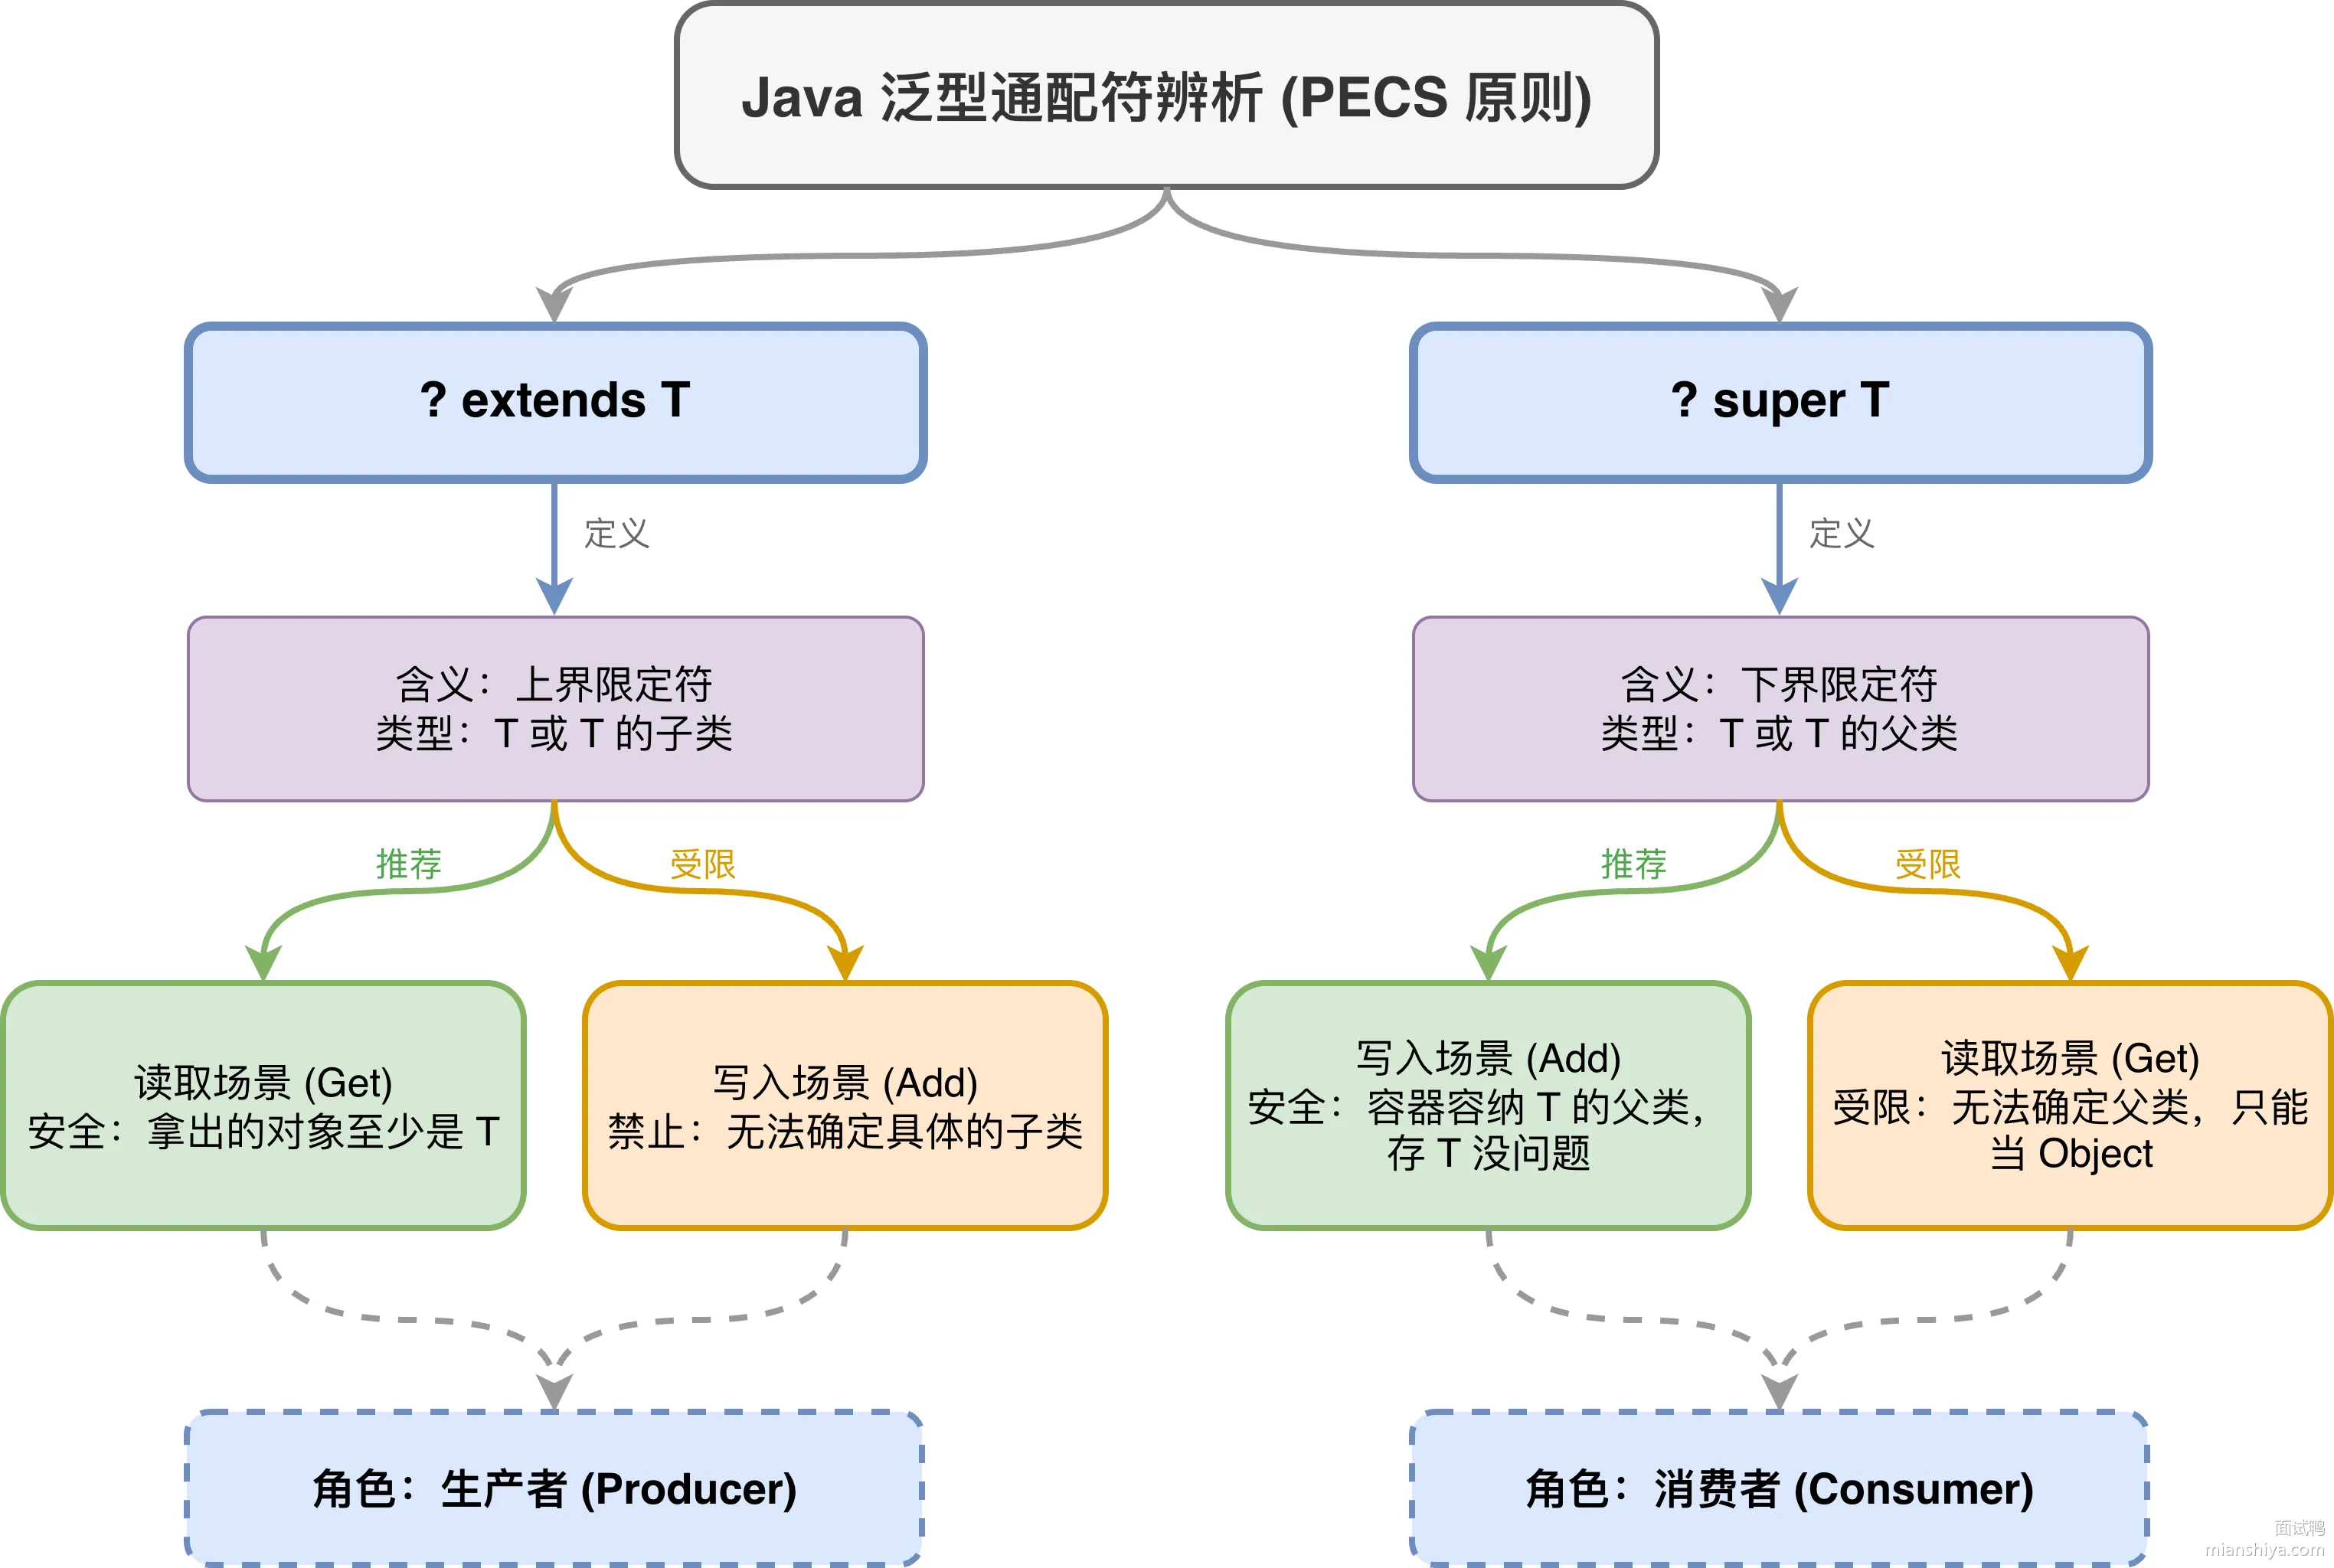
看个例子就明白了:
// 上界:只读不写
public void process(List<? extends Number> list) {
    Number num = list.get(0);  // 读取安全,返回 Number 或其子类
    // list.add(1);            // 编译错误,不能往里加东西
}

// 下界:只写不读
public void addToList(List<? super Integer> list) {
    list.add(1);               // 写入安全,Integer 肯定能放进去
    // Integer v = list.get(0); // 编译错误,读出来只能当 Object
}
12.2. 扩展知识
12.2.1. PECS 原则
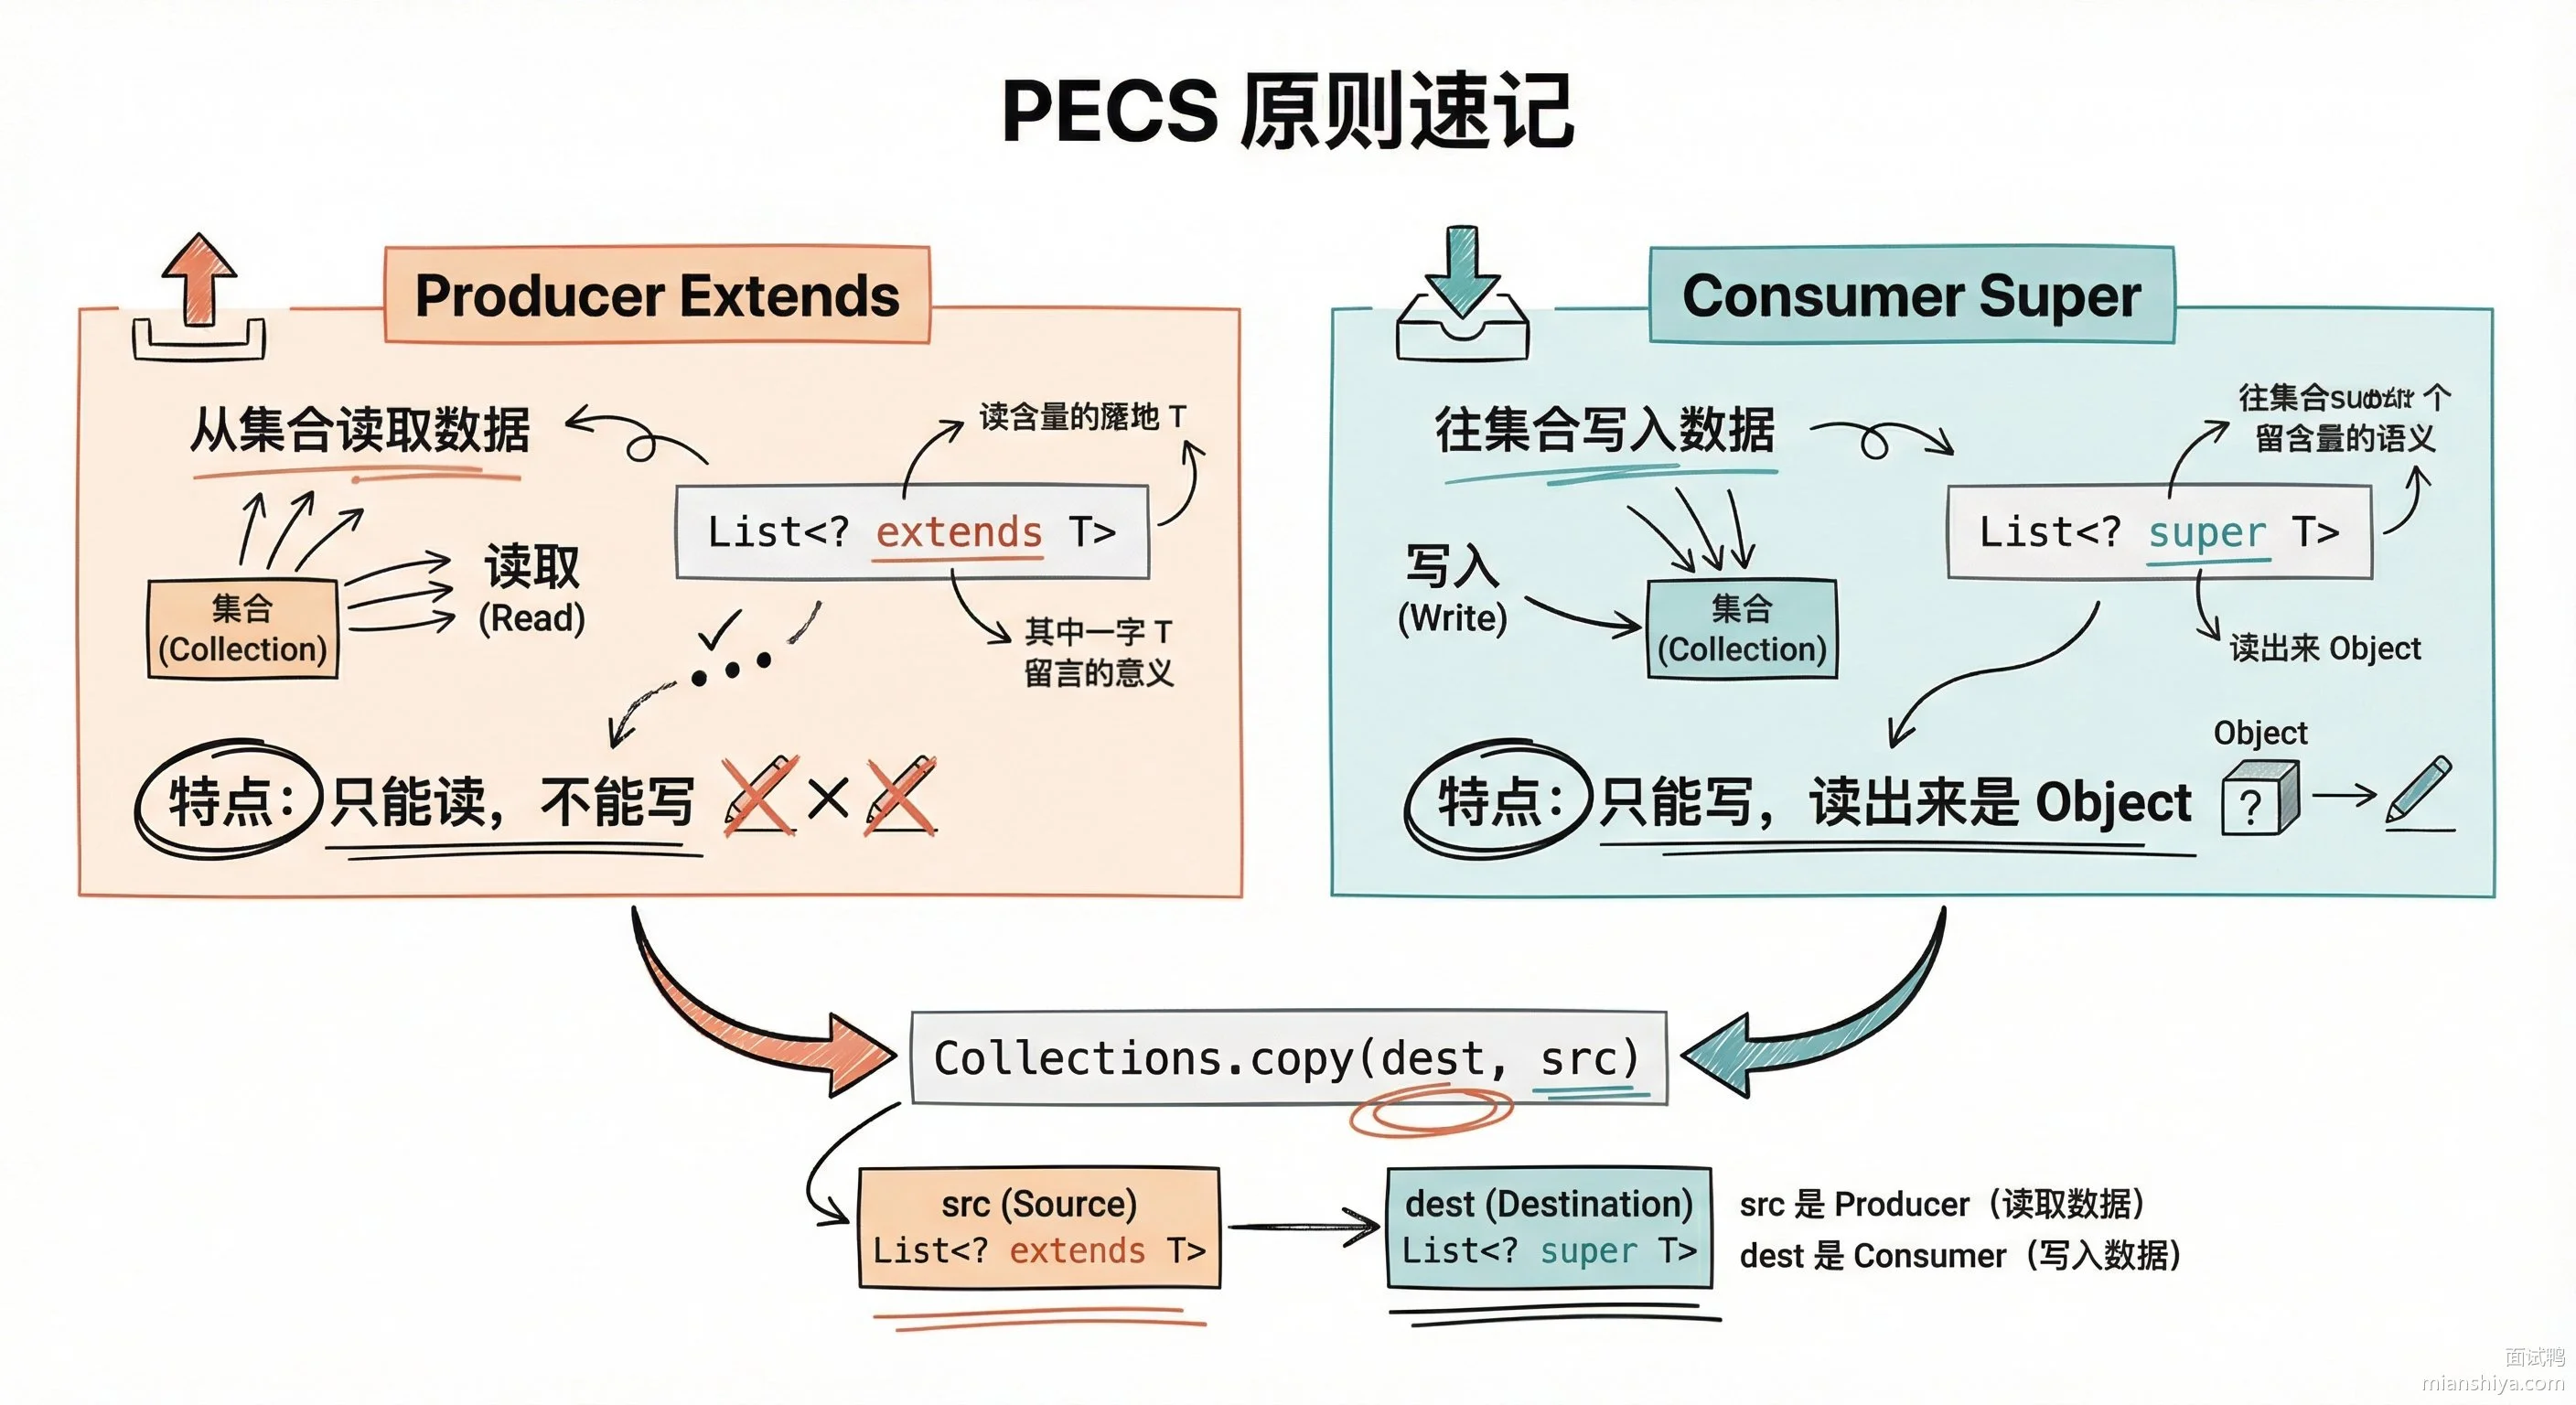
记住 PECS 原则就不会用错:Producer Extends, Consumer Super。
1)如果你要从集合里拿东西出来用,集合就是生产者,用 extends 2)如果你要往集合里塞东西进去,集合就是消费者,用 super
Collections.copy 方法就是个典型例子:
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
    // src 是生产者,往外掏数据,用 extends
    // dest 是消费者,往里塞数据,用 super
}
12.2.2. 协变和逆变
上界限定符实现的是协变,下界限定符实现的是逆变。
协变就是子类型可以替换父类型。List<Dog> 可以赋值给 List<? extends Animal>,因为 Dog 是 Animal 的子类,类型方向是一致的。
List<? extends Animal> animals = new ArrayList<Dog>(); // 协变逆变正好反过来,父类型可以替换子类型。List<Animal> 可以赋值给 List<? super Dog>,因为 Animal 是 Dog 的父类,类型方向是相反的。
List<? super Dog> dogs = new ArrayList<Animal>(); // 逆变为啥要搞这么复杂?因为 Java 的泛型不像数组那样天然支持协变。Dog[] 可以直接赋值给 Animal[],但 List<Dog> 赋值给 List<Animal> 会编译报错。有了通配符和边界限定,才能在保证类型安全的前提下实现灵活的类型转换。
12.2.3. 类型擦除的影响
Java 泛型是假泛型,编译完就把类型信息擦掉了。List<Integer> 和 List<String> 在运行时都是 List,靠边界限定符在编译期做检查。
上界限定符 <T extends Number> 擦除后会变成 Number,下界限定符擦除后变成 Object。编译器会在必要的地方插入强制类型转换,所以运行时的类型安全全靠编译期的检查来保证。
// 编译前
public <T extends Number> void print(T value) {
    System.out.println(value.intValue());
}

// 擦除后相当于
public void print(Number value) {
    System.out.println(value.intValue());
}
12.2.4. 多重边界
上界限定符支持多重边界,用 & 连接,但只能有一个类,接口不限:
// T 必须同时是 Number 的子类,并且实现 Comparable 和 Serializable
public <T extends Number & Comparable<T> & Serializable> void process(T value) {
    // 可以调用 Number 的方法,也可以调用 Comparable 的方法
}
注意类必须写在第一个,接口写后面,否则编译不过。
12.2.5. Java 泛型相关面试题
- Java 泛型的作用是什么?
12.3. 常见问题
12.3.1. 为什么 List<? extends T> 不能 add 元素?
回答:因为编译器不知道这个 List 里面装的具体是 T 的哪个子类。假设声明了 List<? extends Number>,实际可能指向 ArrayList<Integer> 也可能指向 ArrayList<Double>。如果允许 add,你塞个 Integer 进去,结果实际是个 Double 的列表,类型系统就崩了。所以编译器干脆禁止所有 add 操作,只放行 null。
12.3.2. 那 List<? super T> 为什么读出来只能是 Object?
回答:因为只知道下界是 T,不知道上界是啥。List<? super Integer> 可能指向 ArrayList<Integer>,也可能指向 ArrayList<Number> 或 ArrayList<Object>。你从里面 get 出来的东西,唯一能确定的就是它是个 Object,没法保证更具体的类型。
12.3.3. 实际项目中什么时候会用到这些边界限定符?
回答:写工具类和框架代码的时候用得多。比如你要写个通用的集合处理方法,需要同时支持 List<Integer> 和 List<Number>,就得用通配符。Spring 框架里大量使用,像 BeanFactory.getBean(Class<T> requiredType) 返回值用的就是泛型边界。还有就是回调接口设计,比如 Comparator<? super T> 让你可以用父类的比较器来比较子类对象。
12.3.4. Kotlin 的 in 和 out 跟 Java 的 super 和 extends 是什么关系?
回答:本质一样,就是换了个更直观的名字。Kotlin 的 out 对应 Java 的 extends,表示协变,只能输出不能输入;in 对应 super,表示逆变,只能输入不能输出。Kotlin 还支持声明处型变,在类定义的时候就指定 in/out,比 Java 每次使用都要写通配符方便多了。